Questo protocollo presenta la Tri-stream Disentangled Network (TDE-Net), un framework per la ricostruzione di immagini a partire dall'EEG che combina rappresentazioni complementari dell'EEG, allineamento visivo in doppio spazio e decodifica diffusiva.
Articolo metodologico
Rete a tre flussi disaccoppiati con fusione adattiva a doppio spazio per la ricostruzione di immagini basata su elettroencefalografia su THINGS-EEG2
In questo articolo
Sommario
Abstract
La ricostruzione di stimoli visivi a partire dall'elettroencefalografia (EEG) non invasiva richiede di mappare brevi risposte neurali rumorose in rappresentazioni visive significative, nonostante un campionamento spaziale limitato. Gli approcci esistenti per la ricostruzione da EEG a immagine utilizzano diverse rappresentazioni neurali e strategie generative, rendendo necessari flussi di lavoro riproducibili in grado di separare i contributi strutturali e semantici. Questo protocollo presenta la Tri-stream Disentangled Network (TDE-Net), un framework computazionale per la ricostruzione di immagini basata su EEG. Il protocollo utilizza registrazioni preelaborate di THINGS-EEG2 e organizza le informazioni EEG in un ancoraggio di EEG grezzo, un flusso grafico funzionale specifico per campione e un flusso semantico temporale multiscalare. Il flusso grafico cattura le relazioni nel dominio della frequenza tra i canali EEG mediante convoluzione su grafi e apprendimento contrastivo intersperimento, mentre il flusso semantico estrae caratteristiche rilevanti per il compito attraverso un pesamento spaziale adattativo e convoluzioni temporali multiscala. Le caratteristiche strutturali e semantiche vengono mappate separatamente negli spazi latenti dell'autoencoder variazionale (VAE) e del Contrastive Language-Image Pre-training (CLIP), combinate utilizzando pesi di fusione selezionati tramite un insieme di sviluppo e decodificate mediante Stable UnCLIP. Su 10 partecipanti, TDE-Net ha raggiunto un'accuratezza media nella identificazione pairwise CLIP di 0,8135, con metriche complementari che dimostrano corrispondenza strutturale e nello spazio delle caratteristiche. Analisi di ablazione e a livello di rappresentazione hanno ulteriormente caratterizzato i contributi dei singoli flussi. Questo protocollo fornisce un framework riproducibile per lo studio di rappresentazioni EEG complementari e della ricostruzione visiva basata su modelli diffusivi.
Introduzione
La decodifica della percezione visiva è un'area di ricerca interdisciplinare nelle interfacce cervello-computer (BCI) e nelle neuroscienze cognitive. La risonanza magnetica funzionale (fMRI) ha permesso la ricostruzione di immagini realistiche1,2,3,4, ma il suo costo, la portabilità limitata e il ritardo emodinamico ne restringono alcune applicazioni. L'elettroencefalografia (EEG) fornisce misurazioni temporali su scala millisecondi con strumentazione relativamente accessibile, ma il suo basso rapporto segnale-rumore e il campionamento spaziale limitato rendono difficile la ricostruzione di immagini a partire dai segnali EEG.
La complessità del metodo deve essere interpretata alla luce del generale compromesso tra bias e varianza5. I primi metodi di decodifica visiva utilizzavano rappresentazioni poco profonde o lineari, mentre studi successivi hanno introdotto encoder compatti basati su convoluzioni, su grafi e sull'attenzione6,7,8,9,10,11. L'allineamento cross-modale è progredito anche, passando dall'apprendimento di caratteristiche multimodali12,13 ai modelli di diffusione latente e agli encoder visivi di grandi dimensioni14,15,16. Questi approcci stabiliscono basi di riferimento utili, ma le loro rappresentazioni in ingresso, le variabili latenti e i decoder differiscono, pertanto i risultati devono essere interpretati all'interno dei rispettivi contesti sperimentali.
L'obiettivo di TDE-Net è fornire un framework modulare per la ricostruzione di immagini a partire dall'EEG, che separa le rappresentazioni strutturali e semantiche dell'EEG, le allinea a spazi latenti visivi complementari e integra queste previsioni per la ricostruzione dell'immagine basata sulla diffusione. Studi recenti sul decodificare visivo a partire dall'EEG hanno introdotto la generazione guidata da trasformatori nell'EEG-CLIP17, l'allineamento sensibile al primo piano con reti cerebrali dinamiche in FSDBN18, lo sfocamento adattivo guidato dal pensiero con allineamento vincolato dall'informazione19 e l'apprendimento biomimetico bidirezionale multilivello20. Altre pipeline per la conversione da EEG a immagine, come Perceptogram e la diffusione guidata basata su embedding dell'EEG, forniscono ulteriori riferimenti per la previsione latente21,22. TDE-Net si differenzia per l'organizzazione del modello: separa esplicitamente un ancoraggio EEG grezzo, una rappresentazione grafica funzionale specifica per campione e una rappresentazione semantica temporale, per poi eseguire un allineamento asimmetrico agli spazi VAE e CLIP prima della fusione. Questa organizzazione permette di esaminare separatamente i contributi strutturali e semantici mediante analisi nello spazio latente e a livello di immagine. Rispetto agli approcci per la conversione da EEG a immagine basati su un'unica rappresentazione o su allineamento diretto, questo design modulare offre percorsi distinti per la struttura e il significato, preserva un riferimento lineare dell'EEG durante la previsione latente e consente di valutare in modo indipendente il contributo di ciascuna rappresentazione attraverso analisi di ablazione e nello spazio latente.
TDE-Net è progettato per esperimenti con risposte EEG abbinate a stimoli visivi, condizioni di addestramento sufficienti e una finestra post-stimolo breve in cui la ricostruzione semantica è l'obiettivo principale. La sua organizzazione articolata in fasi consente un'esame separata dell'estrazione delle caratteristiche, dell'allineamento latente, della fusione e della decodifica diffusiva. Le trasformazioni lineari rimangono adatte per dataset molto piccoli o contesti che privilegiano una complessità minima del modello, mentre i decodificatori neurali end-to-end possono risultare preferibili quando sono disponibili ampi dataset specifici per il compito e un'implementazione in tempo reale.
Il presente protocollo valuta la configurazione proposta nell'ambiente di presentazione visiva seriale rapida (RSVP) THINGS-EEG2. I principali contributi includono uno schema di rappresentazione EEG a tripla serie, costituito da un ancoraggio lineare grezzo, un flusso grafico funzionale specifico per campione e un flusso semantico temporale multi-risoluzione. Queste rappresentazioni complementari vengono mappate negli spazi latenti VAE e CLIP, e le relative previsioni vengono combinate prima della decodifica diffusiva. Il framework viene valutato su tutti e 10 i soggetti THINGS-EEG2 mediante misure di ricostruzione a livello soggetto, analisi di ablazione e finestre temporali, e visualizzazioni a livello di rappresentazione, con mappe di attenzione spaziale interpretate come analisi topografiche sui canali del cuoio capelluto.
Protocollo
Il protocollo comprende sei fasi sequenziali: preparazione delle prove EEG e dei latenti delle immagini; costruzione del flusso strutturale del grafo; addestramento dell'encoder semantico per l'EEG; adattamento delle mappe CLIP/VAE; fusione delle predizioni latenti, seguita dalla decodifica delle immagini; e valutazione dei risultati a livello di immagine e a livello di rappresentazione (Figura 1).
1. Preparare le prove di EEG e gli embedding delle immagini
- Documentare la coorte di origine e il protocollo di acquisizione.
NOTA: La coorte di origine era composta da 10 adulti sani (età media 28,5 anni, DS 4,0; otto femmine e due maschi) con vista normale o corretta alla norma. I partecipanti hanno fornito consenso informato scritto, hanno ricevuto un compenso monetario e hanno completato il protocollo originale con l'approvazione del comitato etico del Dipartimento di Scienze dell'Educazione e della Psicologia della Freie Universität Berlin, in conformità con la Dichiarazione di Helsinki23.- Utilizzare il dataset pubblicamente disponibile THINGS-EEG2 come risorsa per analisi secondarie.
- Utilizzare la suddivisione originale di 1.654 concetti di addestramento e 200 concetti di test non sovrapposti tratti da THINGS, con le proporzioni di 27 categorie di livello superiore bilanciate tra le suddivisioni. Selezionare dieci immagini con sfondo naturale per ogni concetto di addestramento e un'immagine per ogni concetto di test, ottenendo così 16.540 condizioni di addestramento e 200 condizioni di test escluse dall'addestramento.
NOTA: Nello studio attuale, il compito di rilevamento dell'obiettivo ha utilizzato immagini di controllo separate di Buzz Lightyear che sono state escluse dall'analisi di ricostruzione presentata23. - Seguire la tempistica del protocollo originale di presentazione seriale rapida visiva durante l'interpretazione delle epoche.
NOTA: Ogni sequenza iniziava con un intervallo vuoto di 750 ms, seguito da 20 immagini presentate al centro. Ogni immagine sottendeva 7 gradi di angolo visivo, rimaneva sullo schermo per 100 ms e aveva un asincronismo dell'inizio dello stimolo di 200 ms, corrispondente a 5 immagini/s. Un secondo intervallo vuoto di 750 ms precedeva un periodo di risposta fino a 2 s, durante il quale i partecipanti chiudevano prima gli occhi e poi indicavano se era apparsa un'immagine bersaglio. Un punto di fissazione centrale a forma di bersaglio rimaneva visibile per tutta la durata della sequenza23. - Considerare la struttura originale delle sessioni di registrazione durante l'organizzazione del dataset. Utilizzare i dati delle quattro sessioni di registrazione completate da ciascun partecipante, ognuna composta da quattro serie di test e 15 serie di addestramento della durata di circa 5 minuti ciascuna. Mantenere quattro ripetizioni per ogni condizione di addestramento e 80 ripetizioni per ogni condizione di test, corrispondenti a 82.160 prove con immagini non bersaglio analizzate per partecipante23.
- Utilizzare i dati EEG acquisiti con la configurazione originale di registrazione THINGS-EEG2. Queste registrazioni sono state effettuate a 1.000 Hz mediante un EASYCAP a 64 elettrodi posizionati secondo il sistema internazionale 10-10 e un amplificatore BrainVision actiCHamp, con Fz come riferimento in tempo reale e un filtro passa-banda online 0,1–100 Hz.
- Utilizzare i dati preelaborati resi pubblici, che sono stati epoche da -200 a 800 ms rispetto all'inizio dell'immagine, corretti per la baseline usando l'intervallo pre-stimolo, sottocampionati a 100 Hz, limitati a 17 canali parieto-occipitali, privati delle prove con stimoli bersaglio e sottoposti a normalizzazione multivariata del rumore separatamente all'interno di ciascuna sessione di registrazione23.
- Preparare i tensori delle prove EEG
- Caricare i tensori preelaborati THINGS-EEG2 resi pubblici per tutti e 10 i partecipanti. Da ciascuna epoca originale, selezionare l'intervallo post-stimolo da 0 a 800 ms e i 17 canali parieto-occipitali, mantenendo la frequenza di campionamento di 100 Hz per ottenere 80 punti temporali per prova. Mantenere la suddivisione originale di 16.540 condizioni di immagini di addestramento e 200 condizioni di test escluse per ciascun partecipante23 (Figura 2).
- Per il pre-addestramento del flusso grafico, mantenere le quattro ripetizioni indipendenti di addestramento per ogni condizione di immagine e campionare due ripetizioni per formare una coppia positiva. Per i flussi grezzo e semantico, mediare le quattro ripetizioni di addestramento e mediare le 80 ripetizioni di test disponibili per ogni condizione.
- Utilizzare i tensori THINGS-EEG2 preelaborati prodotti dalla pipeline originale MVNN; all'interno di ciascun estrattore di caratteristiche implementato, applicare la standardizzazione Z a livello di file documentata prima del calcolo delle caratteristiche.
NOTA: Questo uso asimmetrico delle ripetizioni è intenzionale: le prove ripetute forniscono coppie positive per il pre-addestramento contrastivo del flusso grafico, mentre i flussi grezzo e semantico utilizzano medie a livello di condizione per la mappatura supervisionata. Il disegno risultante combina l'apprendimento dell'invarianza a livello di ripetizione nel flusso strutturale con la previsione latente a livello di condizione nei flussi grezzo e semantico.
- Preparare i latenti delle immagini accoppiati
- Utilizzare l'encoder visivo CLIP a 1.024 dimensioni e l'encoder VAE associato a sd2-community/stable-diffusion-2-1-unclip per estrarre le coppie di immagini bersaglio. Ridimensionare le immagini di input del VAE a 768 x 768 pixel, memorizzare la moda della distribuzione a posteriori del VAE come vettore a 36.864 dimensioni (4 x 96 x 96) e mantenere l'ordine delle condizioni delle immagini.
- Salvare tre forme di input: tensori di prove ripetute per l'apprendimento contrastivo grafico, tensori EEG mediati per i flussi grezzo e semantico e latenti delle immagini CLIP/VAE accoppiati per la mappatura supervisionata.
- Normalizzare e memorizzare temporaneamente gli input
- Memorizzare temporaneamente i tensori EEG preelaborati, le caratteristiche estratte per il grafico e il semantico e i latenti delle immagini accoppiati con un ordine fisso delle condizioni.
- Durante la mappatura ridge, stimare i parametri di standardizzazione per ogni caratteristica dagli input di addestramento e applicare tali parametri agli input di sviluppo e di test.
2. Costruire il flusso strutturale del grafo
- Costruire il flusso del grafo a partire da prove di addestramento ripetute ed esportare le caratteristiche a livello di nodo dopo il pre-addestramento contrastivo. Utilizzare la stessa regola di costruzione del grafo per l'estrazione delle caratteristiche di test, senza impiegare i latenti delle immagini di test durante il calcolo delle caratteristiche.
- Trasformare le prove EEG in ingressi grafici nel dominio della frequenza
- Trasformare ogni prova mediante una trasformata di Fourier veloce (FFT) di 80 punti e mantenere i primi 40 bin di frequenza non negativa, che coprono l'intervallo da 0 Hz a 48,75 Hz con una frequenza di campionamento di 100 Hz. Utilizzare lo spettro logaritmico dell'ampiezza come matrice di caratteristiche nodali X di dimensione 17 x 40. Per ogni campione EEG, calcolare C_ij = |corr(X_i, X_j)| tra ogni coppia dei 17 vettori di caratteristiche dei canali.
- In ogni riga, mantenere la correlazione diagonale (auto-correlazione) e le tre correlazioni fuori diagonale più forti (k = 4 elementi mantenuti, inclusa l'auto-correlazione), quindi simmetrizzare la matrice risultante per definire la matrice di adiacenza funzionale pesata A specifica per ogni campione. Applicare la normalizzazione per grado simmetrico prima della convoluzione sul grafo.
- Utilizzare questa procedura sia durante l'addestramento che durante il test; le coordinate fisiche degli elettrodi non vengono utilizzate per definire un grafo fisso.
NOTA: Mantenere la connettività auto-ricorrente preserva il segnale di ciascun nodo, mentre limitare le connessioni tra canali a 3 per riga controlla la densità del grafo prima della simmetrizzazione. La rappresentazione nel dominio della frequenza fornisce una descrizione compatta basata sull'ampiezza per la costruzione del grafo, ma non conserva la fase né tutti i dettagli temporali fini degli ERP sincronizzati; questi aspetti temporali rimangono disponibili nei flussi temporali grezzi e semantici.
- Aggregare la topologia degli elettrodi mediante convoluzione spettrale su grafi
- Applicare una rete convoluzionale su grafi (GCN)24 a cinque strati con 80 unità nascoste per strato, attivazioni ReLU, dropout 0,3, normalizzazione per grado simmetrico e pooling medio del grafo.
- Utilizzare una testa di proiezione a due strati con dimensione 80 per l'obiettivo contrastivo ed esportare la rappresentazione a livello di nodo di dimensione 17 x 80 per la fusione strutturale. Applicare la convoluzione spettrale sulla matrice di adiacenza dipendente dall'ingresso; non introdurre un operatore di convoluzione dinamico separato.
- Addestrare il flusso del grafo con apprendimento contrastivo tra prove
- Nella partizione di addestramento, selezionare casualmente due ripetizioni della stessa condizione di immagine come coppia positiva e considerare le rappresentazioni provenienti da altre condizioni nel batch come negativi. Ottimizzare l'obiettivo contrastivo InfoNCE25 con temperatura τ = 0,5, dimensione del batch 32, Adam con tasso di apprendimento 5 x 10⁻⁴, 20 epoche, annealing cosenoide fino a eta_min = 10–6 e seme casuale 42.
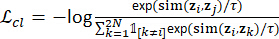 (1)
- Definire la similarità coseno nell'obiettivo contrastivo e utilizzare la funzione indicatore per identificare le ripetizioni accoppiate. Mantenere la dimensione della proiezione a 80 e applicare la stessa temperatura in entrambe le direzioni della perdita contrastiva.
- Nella partizione di addestramento, selezionare casualmente due ripetizioni della stessa condizione di immagine come coppia positiva e considerare le rappresentazioni provenienti da altre condizioni nel batch come negativi. Ottimizzare l'obiettivo contrastivo InfoNCE25 con temperatura τ = 0,5, dimensione del batch 32, Adam con tasso di apprendimento 5 x 10⁻⁴, 20 epoche, annealing cosenoide fino a eta_min = 10–6 e seme casuale 42.
- Esportare le caratteristiche del grafo a livello di nodo per la fusione precoce
- Bloccare l'encoder del grafo dopo il pre-addestramento ed esportare le caratteristiche nodali a 17 canali con 80 dimensioni per nodo. Concatenare queste caratteristiche con il segnale EEG grezzo mediato lungo la dimensione delle caratteristiche per ottenere l'ingresso strutturale raw-plus-graph per la mappatura VAE.
- Salvare il tensore risultante delle caratteristiche raw-plus-graph e utilizzarlo esclusivamente come ingresso strutturale per il ramo di regressione VAE.
3. Addestrare l'encoder semantico EEG
- Addestrare l'encoder semantico EEG sui tensori EEG medi di 17 canali e 80 punti.
- Ottimizzare la perdita di embedding coseno con AdamW (tasso di apprendimento 5 x 10⁻⁴; decadimento del peso 0,01), dimensione del batch 64, 50 epoche, annealing coseno con eta_min = 10–6, seme casuale 42 e output di dimensione 1.024.
- Applicare un filtraggio spaziale adattativo basato sui dati
- Applicare un'operazione imparabile di pesatura dei canali mediante prodotto tensoriale al tensore EEG in ingresso ed espandere la rappresentazione fino a una profondità di 9. Considerare questa operazione come un livello di pesatura dei canali guidato dai dati piuttosto che un'implementazione del classico filtro spaziale Common Spatial Pattern (CSP)26.
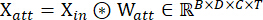 (2)
- Utilizzare l'operazione di pesatura dei canali appresa per produrre nove mappe di caratteristiche, quindi trasmetterle al blocco di convoluzione temporale multi-scala.
- Applicare un'operazione imparabile di pesatura dei canali mediante prodotto tensoriale al tensore EEG in ingresso ed espandere la rappresentazione fino a una profondità di 9. Considerare questa operazione come un livello di pesatura dei canali guidato dai dati piuttosto che un'implementazione del classico filtro spaziale Common Spatial Pattern (CSP)26.
- Modellare campi recettivi temporali a più scale
- Applicare tre convoluzioni temporali in parallelo con dimensioni del kernel di 5, 15 e 31 campioni, utilizzando un padding di lunghezza uguale. Concatenare i tre output per ottenere 24 canali di caratteristiche temporali e applicare normalizzazione del batch e attivazione GELU.
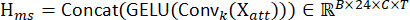 (3)
NOTA: Le convoluzioni forniscono campi recettivi temporali multi-scala all'interno del più ampio framework di modellazione convoluzionale temporale27. - Utilizzare le tre dimensioni del kernel come filtri temporali multi-scala; interpretare i loro output come rappresentazioni del segnale apprese piuttosto che come assegnazioni dirette a specifici componenti ERP.
- Applicare tre convoluzioni temporali in parallelo con dimensioni del kernel di 5, 15 e 31 campioni, utilizzando un padding di lunghezza uguale. Concatenare i tre output per ottenere 24 canali di caratteristiche temporali e applicare normalizzazione del batch e attivazione GELU.
- Ricalibrare i canali di caratteristiche rilevanti per il compito
- Applicare l'attenzione per profondità con pooling medio adattivo sulla dimensione temporale e una convoluzione con kernel di dimensione 7 seguita da normalizzazione Softmax, in linea con i principi di ricalibrazione dei canali28. Moltiplicare gli eventuali pesi di attenzione elemento per elemento con il tensore delle caratteristiche multi-scala.
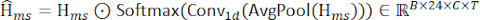 (4)
- Utilizzare l'output dell'attenzione come ingresso al blocco di convoluzione spaziale e non interpretare i pesi appresi come localizzazione neurale causale.
- Applicare l'attenzione per profondità con pooling medio adattivo sulla dimensione temporale e una convoluzione con kernel di dimensione 7 seguita da normalizzazione Softmax, in linea con i principi di ricalibrazione dei canali28. Moltiplicare gli eventuali pesi di attenzione elemento per elemento con il tensore delle caratteristiche multi-scala.
- Esportare la caratteristica EEG semantica globale
- Applicare una convoluzione 1 x 1 seguita da una convoluzione depthwise che copre i 17 canali degli elettrodi, normalizzazione del batch, attivazione GELU, pooling medio con fattore 2 e dropout p = 0,5. Appiattire il risultato e proiettarlo in un vettore di caratteristiche semantiche di dimensione 1.024.
- Salvare un vettore di caratteristiche semantiche di dimensione 1.024 per ogni campione EEG mediato.
4. Mappare le caratteristiche dell'EEG negli spazi latenti di CLIP e VAE
- Accoppia ogni tensore di caratteristiche EEG con il latente dell'immagine avente lo stesso indice di condizione. Addestra mapping separati per gli obiettivi CLIP e VAE, e mantieni tutte le condizioni delle immagini nella partizione di addestramento distinte da quelle nella partizione di test tenuta a parte.
- Addestra una regressione ridge29 con un termine noto e un massimo di 50.000 iterazioni. Utilizza λCLIP = 1.000 per i mapping da grezzo a CLIP e da semantico a CLIP, λVAE = 0 per l'ancoraggio da grezzo a VAE e λVAE, struct = 1.000 per il mapping da flusso strutturale a VAE. Standardizza gli ingressi del mapping utilizzando le statistiche della partizione di addestramento.
NOTA: Il flusso strutturale è la concatenazione delle caratteristiche EEG grezze e delle caratteristiche grafiche; il flusso semantico contiene l'uscita del codificatore semantico senza concatenazione di caratteristiche grezze. - Mappa le caratteristiche strutturali nello spazio latente VAE
- Addestra il mapping ridge da flusso strutturale a VAE con λVAE,struct = 1.000 e predici il latente VAE di dimensione 36.864. Questo ramo riceve le rappresentazioni concatenate di EEG grezzo e grafiche; è l'unico ramo non lineare che concatena esplicitamente caratteristiche grezze.
- Mappa le caratteristiche semantiche nello spazio latente CLIP
- Addestra il mapping ridge da flusso semantico a CLIP con λCLIP = 1.000 e predici la rappresentazione CLIP di dimensione 1.024. L'ingresso semantico non viene concatenato con l'EEG grezzo.
NOTA: In questo articolo, λ indica la regolarizzazione ridge e α indica un peso di fusione latente. - Valuta l'allineamento nello spazio latente mediante il coefficiente di correlazione di Pearson (PCC) per ogni campione. Utilizza le condizioni di sviluppo per la selezione del peso di fusione e valuta le 200 condizioni di test tenute a parte solo dopo che i mapping e i pesi di fusione sono stati congelati.
- Addestra il mapping ridge da flusso semantico a CLIP con λCLIP = 1.000 e predici la rappresentazione CLIP di dimensione 1.024. L'ingresso semantico non viene concatenato con l'EEG grezzo.
5. Unire le previsioni latenti ed eseguire la ricostruzione diffusiva
- Selezionare αVAE e αCLIP utilizzando una suddivisione di sviluppo a livello di condizione derivata esclusivamente dalle 16.540 condizioni di addestramento. Con il seme casuale 42, utilizzare gli stessi indici di adattamento (90%) e indici di sviluppo (10%) per tutti e 10 i soggetti; le 200 condizioni di test tenute in riserva rimangono esterne a questa procedura.
NOTA: Le penalità ridge e il coefficiente di conservazione strutturale sono stati fissati come valori di configurazione prima della valutazione finale con dati tenuti in riserva e non sono stati ottimizzati rispetto alle 200 condizioni di test. - Per ciascun soggetto e ciascun valore candidato di α in {0,00; 0,05; ..., 1,00}, adattare l'encoder supervisionato dal target e le mappe ridge sul sottoinsieme di adattamento e calcolare il coefficiente di correlazione di Pearson (PCC) latente medio per campione sul sottoinsieme di sviluppo.
- Mediare i valori di PCC a livello di soggetto assegnando un peso uguale ai 10 soggetti e selezionare i pesi nello spazio CLIP e nello spazio VAE indipendentemente in base alla media massima tra soggetti. Fissare entrambi i valori prima di riadattare i modelli di addestramento finali e valutare le condizioni di test tenute in riserva.
NOTA: Questa procedura ha selezionato αCLIP = 0,55 e αVAE = 0,65. - Per lo spazio VAE, definire la previsione fusa come somma pesata dell'ancora da grezzo a VAE e della previsione VAE del flusso strutturale:
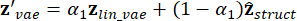 (5)
- Impostare αVAE = 0,65, in modo che l'ancora da grezzo a VAE contribuisca con 0,65 e la previsione del flusso strutturale contribuisca con 0,35. Mantenere fisso questo valore per ogni soggetto e condizione di test.
- Per lo spazio CLIP, definire la previsione fusa come somma pesata dell'ancora da grezzo a CLIP e della previsione CLIP del flusso semantico:
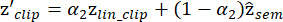 (6)
- Impostare αCLIP = 0,55, in modo che l'ancora da grezzo a CLIP contribuisca con 0,55 e la previsione del flusso semantico contribuisca con 0,45. Mantenere fisso questo valore per ogni soggetto e condizione di test.
NOTA: Interpretare l'operazione di fusione come un insieme pesato fisso di previsioni latenti nel senso generale della combinazione di ensemble30. Non descriverla come una riduzione garantita dell'overfitting né come una soluzione uniformemente ottimale per tutti i metri. - Caricare la pipeline fissa Stable UnCLIP da immagine a immagine da sd2-community/stable-diffusion-2-1-unclip con pesi della variante fp16. Utilizzare l'embedding CLIP fuso come condizione semantica e il latente VAE fuso come inizializzazione strutturale.
NOTA: Il decodificatore segue i principi della diffusione rumorosa e della guida senza classificatore31,32. - Applicare l'inizializzazione strutturale rumorosa ai latenti di diffusione. Ridimensionare ogni previsione VAE di dimensione 36.864 a 4 x 96 x 96, seguendo la formulazione latente dell'autocodificatore variazionale33, e aggiungere rumore gaussiano dopo aver moltiplicato il latente strutturale per il coefficiente di scala strutturale gamma = 0,02. Utilizzare i passi temporali di addestramento della diffusione T_diff = 1.000 e un seme di diffusione fisso pari a 0 per la procedura di ricostruzione riportata.
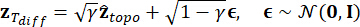 (7)
- Impostare il coefficiente di conservazione strutturale gamma a 0,02 nell'inizializzazione rumorosa e mantenere fisso questo valore per tutte le condizioni di test. Passare il latente risultante al decodificatore senza utilizzare informazioni dell'immagine reale.
- Applicare la guida con attenzione incrociata e decodificare il latente dell'immagine. Concatenare il vettore CLIP fuso di dimensione 1.024 con l'estensione di condizionamento di dimensione 1.024 utilizzata dalla pipeline, anteporre un vettore negativo di condizione zero per la guida senza classificatore (CFG) e decodificare con una scala di guida pari a 7,5. Utilizzare il valore predefinito della pipeline di 20 passi di rimozione del rumore e salvare un'immagine PNG per ogni condizione di test.
- Salvare l'immagine ricostruita con l'indice originale della condizione di test e mantenere lo stesso indice per tutti i calcoli successivi delle metriche.
NOTA: Tabella 1 riassume la partizione dei dati, la preelaborazione, la costruzione del grafo, l'addestramento del modello, la mappatura latente, la fusione e le impostazioni di decodifica utilizzate nel flusso di lavoro descritto. Il foglio di lavoro allegato fornisce lo stesso riepilogo dei parametri in un formato leggibile da macchina.
6. Valutare la ricostruzione e l'allineamento a livello di rappresentazione
- Calcolare la fedeltà a basso livello mediante la correlazione tra pixel (PixCorr) e la similarità strutturale (SSIM). Calcolare le accuratezze di identificazione a coppie per AlexNet Layer 2, AlexNet Layer 5, Inception-v3 e OpenAI CLIP ViT-L/14; calcolare le distanze di correlazione per EfficientNet (EffNet) e SwAV, per cui valori più bassi indicano rappresentazioni delle caratteristiche più simili.
- Per l'analisi CLIP, costruire la matrice di correlazione tra le caratteristiche estratte da 200 immagini ricostruite e le corrispondenti 200 immagini reali. Per ogni ricostruzione, confrontare la correlazione con l'immagine corretta rispetto alle correlazioni con le altre 199 immagini e calcolare la media delle 200 × 199 comparazioni binarie risultanti per ottenere l'accuratezza di identificazione a coppie CLIP.
- Per finestre crescenti che terminano ai punti temporali 8, 16, ..., 80, adattare le mappe EEG grezze con ridge regression e calcolare il coefficiente di correlazione di Pearson (PCC) medio a livello di campione tra i latenti CLIP e VAE predetti e quelli reali, nei 200 test condizioni del soggetto sub-01. Utilizzare le predizioni CLIP e VAE basate sull'intera finestra e relative solo al flusso semantico come livelli di riferimento tratteggiati.
- Costruire matrici di similarità rappresentazionale (RSM) a partire dalle caratteristiche CLIP normalizzate con norma L2, utilizzando la similarità del coseno. Ordinare entrambe le matrici mediante clustering gerarchico di Ward degli embedding CLIP reali, usando la distanza euclidea.
- Per la visualizzazione bidimensionale, derivare cinque cluster k-means dagli embedding reali e applicare una proiezione congiunta PCA-50 più t-distributed stochastic neighbor embedding (t-SNE) sia alle caratteristiche reali che predette; utilizzare t-SNE esclusivamente per la visualizzazione qualitativa.
- Visualizzare i pattern EEG whitenati e i pesi del modello per i canali del cuoio capelluto con canali etichettati, scale di colore esplicite e regole di ordinamento riproducibili. Interpretare questi grafici come analisi ausiliarie dei segnali misurati al cuoio capelluto e dei parametri del modello, non come evidenza di localizzazione delle sorgenti corticali, attivazione anatomica o causalità.
Risultati
TDE-Net è stato valutato da sei prospettive complementari: prestazioni di ricostruzione, risultati visivi rappresentativi, contributo dei componenti, dipendenza temporale, struttura rappresentazionale semantica e attenzione ai canali del cuoio capelluto. La fedeltà a basso livello è stata valutata utilizzando PixCorr e SSIM, l'allineamento nello spazio delle caratteristiche mediante misure di AlexNet, Inception-v3, CLIP, EffNet e SwAV, e le prestazioni a livello di soggetto utilizzando i risultati di tutti e 10 i soggetti THINGS-EEG2. Salvo diversamente indicato, ogni figura qualitativa identifica il soggetto corrispondente e il sottoinsieme della condizione di test.
Prestazioni di ricostruzione e risultati rappresentativi
Come modello di riferimento interno, abbiamo inoltre implementato una baseline leggera basata su un encoder EEG convoluzionale con attenzione. Questo modello estrae una singola rappresentazione EEG di 1024 dimensioni da ogni prova e la mappa in modo indipendente negli spazi latenti CLIP e VAE, utilizzando lo stesso protocollo di regressione ridge e di decodifica diffusiva del metodo proposto. Nelle sezioni seguenti, questo modello è indicato come Baseline. L'encoder è il riferimento semantico convoluzionale con attenzione in stile LMDA utilizzato nell'implementazione locale, con 373.950 parametri addestrabili e un'uscita di 1.024 dimensioni.
Tabella 2 confronta TDE-Net con il baseline interno basato su convoluzione-attenzione e con metodi rappresentativi di ricostruzione di immagini basati sull'EEG, relativamente alle metriche riportate. Per una valutazione coerente, i metodi sono stati implementati all'interno di un framework sperimentale unificato, utilizzando la stessa partizione THINGS-EEG2, un ingresso di 17 canali, lo stesso preelaborazione, le stesse condizioni di test tenute in riserva e le stesse definizioni delle metriche, mantenendo al contempo le loro architetture specifiche per ciascun metodo. Nella sintesi complessiva relativa a dieci soggetti, TDE-Net ha ottenuto valori medi ± deviazione standard di 0,2531 ± 0,0138 per PixCorr, 0,3388 ± 0,0025 per SSIM, 0,8777 ± 0,0115 per AlexNet Layer 2, 0,9153 ± 0,0116 per AlexNet Layer 5, 0,7606 ± 0,0213 per Inception-v3, 0,8135 ± 0,0074 per l'accuratezza di identificazione a coppie CLIP, 0,8285 ± 0,0122 per la distanza EffNet e 0,5085 ± 0,0101 per la distanza SwAV. La sintesi a livello di soggetto integra gli esempi qualitativi relativi a singoli soggetti.
Il valore CLIP indica l'accuratezza dell'identificazione a coppie piuttosto che la similarità coseno o un punteggio generico della caratteristica CLIP. Poiché il flusso semantico viene addestrato verso una destinazione nello spazio CLIP, questa misura riflette sia la ricostruzione semantica sia l'allineamento con l'obiettivo di un singolo ramo. È pertanto considerato insieme a PixCorr, SSIM, AlexNet, Inception-v3, EffNet e SwAV, che caratterizzano aspetti complementari della fedeltà a basso livello e dell'accordo nello spazio delle caratteristiche.
Per caratterizzare le prestazioni a livello di soggetto, abbiamo applicato la procedura completa del test TDE-Net ai soggetti da sub-01 a sub-10, utilizzando le stesse 200 condizioni di immagine escluse per ogni soggetto. Tabella 3 riporta tutte e otto le misure di valutazione per ciascun soggetto, insieme alla media tra i soggetti e alla deviazione standard campionaria. L'accuratezza media della identificazione a coppie CLIP è stata 0,8135 (DS, 0,0074). I valori medi di PixCorr e SSIM sono stati rispettivamente 0,2531 e 0,3388. Le accuratezze medie degli strati 2 e 5 di AlexNet sono state 0,8777 e 0,9153, mentre l'accuratezza media di Inception-v3 è stata 0,7606. Le distanze EffNet e SwAV, per cui valori inferiori indicano prestazioni migliori, hanno avuto una media rispettivamente di 0,8285 e 0,5085. La limitata dispersione a livello di soggetto attraverso queste misure indica un comportamento quantitativo di ricostruzione comparabile tra i 10 soggetti di THINGS-EEG2.
Figura 3 presenta le ricostruzioni per gli stessi sette indici di condizione esclusi (1, 32, 62, 86, 87, 108 e 175; numerazione dei file con indice zero) per tutti e 10 i soggetti. La riga superiore mostra gli stimoli di riferimento, mentre le righe successive mostrano le rispettive ricostruzioni per sub-01 fino a sub-10. Le ricostruzioni mantengono categorie semantiche condivise e attributi visivi caratteristici degli stimoli, mentre l'identità fine degli oggetti, la forma e la texture locale variano tra i soggetti. Questo layout fornisce un corrispettivo qualitativo ai risultati intersoggetto riassunti nella Tabella 3.
Figura 4 presenta ricostruzioni qualitative per sei condizioni di prova sub-01 specificate. Le righe mostrano lo stimolo reale, un comparatore Perceptogram generato dalla nostra implementazione locale21 e la ricostruzione ottenuta con TDE-Net. Gli esempi evidenziano il mantenimento delle categorie degli oggetti, della forma, del colore e degli attributi dello sfondo, mentre i dettagli di identità fine e dello sfondo variano a seconda del metodo utilizzato.
Figura supplementare 1 mostra i gruppi con le migliori, mediane e peggiori ricostruzioni selezionati tra le 200 condizioni di test sub-01 in THINGS-EEG223. Le condizioni sono ordinate in base all'accordo del coseno tra l'embedding CLIP previsto dall'EEG fuso congelato e l'embedding CLIP dell'immagine reale corrispondente. I gruppi mostrati illustrano l'intervallo di accordo semantico osservato per questo soggetto.
Contributo dei componenti e comportamento di fusione
Tabella 4 presenta un'ablazione progressiva dei flussi strutturale e semantico basata sui valori medi tra soggetti ottenuti con la stessa procedura di valutazione. L'ancoraggio lineare prevede direttamente i latenti CLIP e VAE a partire dai dati EEG preelaborati utilizzando una regressione ridge e funge da punto di partenza controllato per lo studio ablativo. Segue il principio lineare generale di mappatura latente utilizzato in precedenti studi di trasformazione da EEG a immagine, inclusi Perceptogram21, adottando tuttavia il preelaborazione, la regolarizzazione, la decodifica e le impostazioni di valutazione della presente pipeline. Questa progettazione consente di esaminare il flusso strutturale, il flusso semantico e la fusione nei due spazi rispetto a un riferimento lineare comune.
Partendo dall'ancoraggio lineare, l'aggiunta del flusso strutturale ha aumentato l'SSIM da 0,331 a 0,339 e l'accuratezza dello strato 5 di AlexNet da 0,913 a 0,932, sebbene l'accuratezza dello strato 2 di AlexNet sia leggermente diminuita da 0,889 a 0,886. L'aggiunta del flusso semantico ha invece prodotto il valore più alto di PixCorr (0,237), mantenendo un'alta accuratezza nello strato 2 di AlexNet (0,888) e riducendo le distanze di EffNet e SwAV rispettivamente a 0,865 e 0,531. Quando entrambi i flussi sono stati integrati attraverso la fusione nello spazio doppio, TDE-Net ha raggiunto le più elevate accuratezze di identificazione a coppie di Inception-v3 (0,761) e CLIP (0,814), insieme alle distanze più basse di EffNet (0,829) e SwAV (0,509). La sua accuratezza nello strato 2 di AlexNet (0,878) è rimasta inferiore rispetto a quella dell'ancoraggio lineare, e il suo SSIM (0,339) è rimasto leggermente inferiore rispetto alla configurazione con flusso strutturale. Nel complesso, i risultati dell'ablazione intersoggetto mostrano che i flussi strutturale e semantico influenzano diversi aspetti della ricostruzione, mentre la loro fusione rafforza principalmente l'identificazione semantica e la coerenza nello spazio delle caratteristiche profonde.
Figura 5 mostra la sensibilità del set di sviluppo rispetto ai due pesi di fusione nell'intervallo α = 0,00–1,00 con incrementi di 0,05. La curva nello spazio CLIP raggiunge il suo massimo a αCLIP = 0,55, mentre la curva nello spazio VAE raggiunge il suo massimo a αVAE = 0,65. Sono stati osservati valori PCC simili per i candidati adiacenti, mentre i massimi si verificano a pesi diversi per i due spazi latenti.
Contributo temporale dei segnali EEG
Figura 6 mostra la media della PCC latente per condizione per finestre EEG grezze che terminano a 8, 16, ..., 80 punti temporali nel soggetto 01 (n = 200 condizioni di test). Le curve CLIP e VAE aumentano all'espandersi della finestra di analisi e raggiungono un plateau nelle finestre successive. Le linee tratteggiate indicano i corrispondenti valori di riferimento basati esclusivamente sul flusso semantico per l'intera finestra. Questa analisi caratterizza la dipendenza dalla finestra temporale secondo il protocollo di mappatura descritto.
Allineamento semantico e analisi a livello di rappresentazione
Figura 7 confronta il coefficiente di correlazione di Pearson (PCC) latente per campione tra l'ancora CLIP grezza e la previsione CLIP fusa congelata in 200 condizioni di test sub-01. Le stime della densità kernel gaussiana utilizzano la larghezza di banda di Scott e linee tratteggiate verticali indicano le medie campionarie. La distribuzione fusa mostra un aumento medio del PCC di circa 0,013 rispetto all'ancora grezza. L'accuratezza dell'identificazione a coppie a livello di immagine mediante CLIP è riportata separatamente nella Tabella 2.
Figura 8 confronta le RSM di similarità coseno per gli embedding CLIP delle immagini di riferimento e gli embedding CLIP predetti da EEG fusi. Entrambe le matrici condividono un intervallo comune di dati e un ordinamento Ward derivato dalle distanze euclidee tra gli embedding CLIP di riferimento. Il pannello residuo mostra l'RSM predetta meno l'RSM di riferimento su una scala simmetrica definita dal residuo assoluto massimo, fornendo una visualizzazione dell'accordo rappresentazionale.
Figura supplementare 2 mostra una proiezione congiunta di 200 embedding CLIP reali e 200 previsti tramite EEG. Cinque etichette sono ottenute mediante clustering k-means degli embedding reali normalizzati con norma L2 (n_init = 50; seed = 7). Le caratteristiche reali e previste concatenate sono ridotte a 50 dimensioni mediante PCA e proiettate congiuntamente tramite t-SNE con perplexity 28, distanza euclidea e seed 12. La proiezione fornisce una visione qualitativa dell'organizzazione dei due insiemi di rappresentazioni.
Modello EEG e interpretazione dell'attenzione spaziale
Figura supplementare 3 raggruppa i concetti di prova in Animali, Concetti relativi a cibo/piante e Altri oggetti utilizzando una mappatura esplicita tra concetti ed etichette. All'interno di ciascun gruppo, le righe sono ordinate in base al clustering di Ward degli embedding CLIP whitened del ground truth e campionate in modo uniforme fino a un massimo di 30 concetti per migliorare la leggibilità. La mappa termica mostra le ampiezze EEG whitened normalizzate e limitate su una scala da -1 a 1; gli embedding CLIP vengono utilizzati esclusivamente per determinare l'ordine all'interno di ciascun gruppo.
Figura supplementare 4 mostra una topografia standard del cuoio capelluto 10–20 dei pesi normalizzati assoluti dei canali del flusso semantico sui 17 elettrodi selezionati. La mappa riassume il peso relativo del modello attraverso i canali del cuoio capelluto misurati ed è interpretata come una visualizzazione a livello di canale dei pesi del modello.
Questo studio è un'analisi computazionale secondaria del dataset THINGS-EEG2 anonimizzato. Le registrazioni EEG originali, gli array EEG preelaborati, i metadati e le immagini degli stimoli, e i file dello stato di riposo sono disponibili tramite il progetto THINGS-EEG2 all'indirizzo https://osf.io/3jk45/ e su Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). Il software originale per l'acquisizione e il preelaboramento è disponibile all'indirizzo https://github.com/gifale95/eeg_encoding. L'accesso e il riutilizzo dei dati EEG e delle immagini degli stimoli sono regolati dalle licenze e dai requisiti di attribuzione specificati dai repository originali.
L'implementazione di TDE-Net, inclusi gli script per allineamento, fusione, ricostruzione, valutazione e visualizzazione, è disponibile all'indirizzo https://github.com/Yuan-ui198/TDE-Net. La versione corrispondente a questo manoscritto è bloccata al commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Per il presente studio non sono stati raccolti nuovi dati identificabili dai partecipanti.
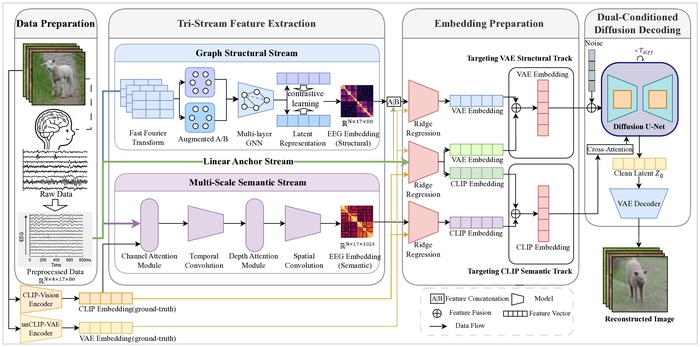
Figura 1: Schema della TDE-Net. Il diagramma mostra l'ancora EEG grezza, il flusso del grafo funzionale specifico per campione, il flusso temporale semantico, la mappatura duale nello spazio VAE e CLIP, la fusione pesata e la decodifica Stable UnCLIP a doppia condizione. Le dimensioni dei tensori sono indicate quando applicabili. Cliccare qui per visualizzare una versione ingrandita di questa figura.
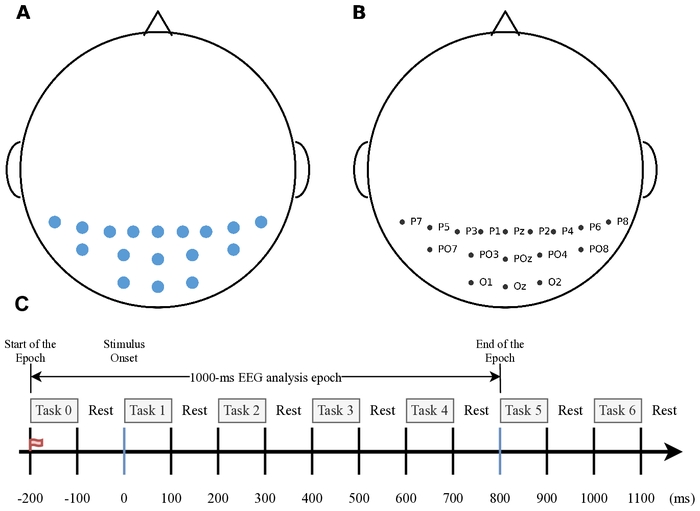
Figura 2: Selezione degli elettrodi EEG e tempistica sperimentale. (A) Distribuzione spaziale dei 17 elettrodi parieto-occipitali selezionati dall'acquisizione originale a 64 canali. (B) Etichette degli elettrodi: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 e P2. (C) Schema della tempistica RSVP e definizione dell'epoca EEG. Nello schema, “Task” indica un intervallo di presentazione dell'immagine, mentre “Rest” indica l'intervallo inter-immagine; i blocchi numerati di Task indicano intervalli di presentazione successivi e non diverse condizioni sperimentali. Ogni immagine è stata presentata per 100 ms con un asincronismo tra gli inizi dello stimolo di 200 ms. L'epoca EEG si estendeva da -200 a 800 ms rispetto all'inizio dello stimolo, corrispondente a un'epoca di analisi EEG di 1000 ms. Cliccare qui per visualizzare una versione ingrandita di questa figura.
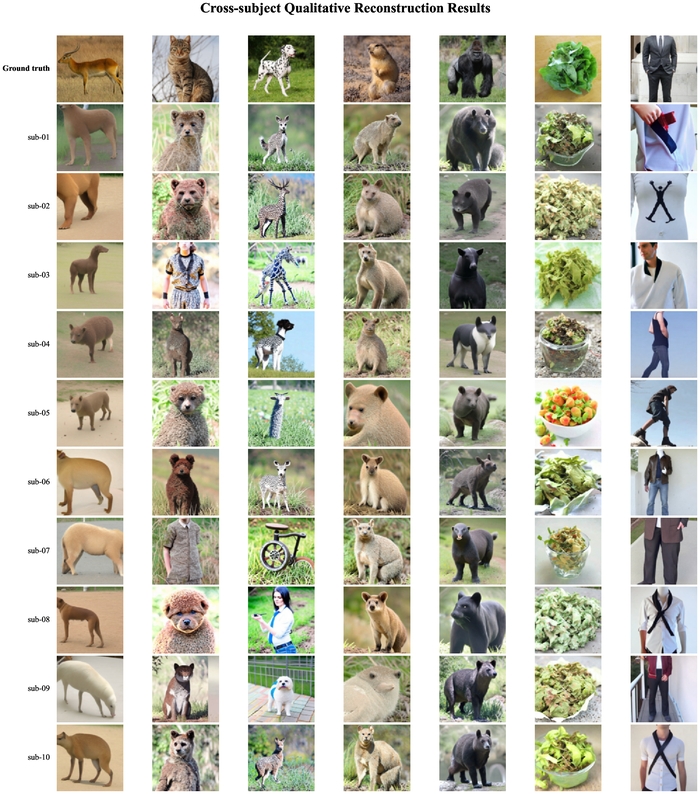
Figura 3: Risultati qualitativi di ricostruzione intersoggetto per sette condizioni di immagine escluse. Gli stessi indici di condizione a partire da zero (1, 32, 62, 86, 87, 108 e 175) sono utilizzati per i soggetti da sub-01 a sub-10. La riga superiore mostra i corrispondenti campioni di immagini reali del set di test THINGS-EEG2, le cui immagini sono state estratte dal database di immagini THINGS34, mentre le righe rimanenti mostrano le ricostruzioni ottenute con TDE-Net per ogni soggetto. La figura illustra contenuti semantici comuni e variazioni a livello individuale; i risultati quantitativi intersoggetto sono riportati nella Tabella 3. Cliccare qui per visualizzare una versione ingrandita di questa figura.
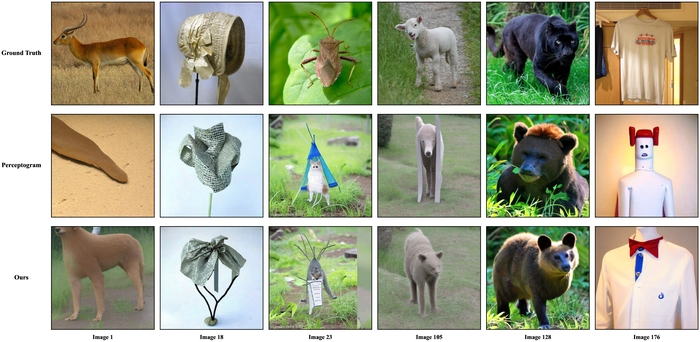
Figura 4: Confronto di ricostruzione qualitativa per sei condizioni di test sub-01 specificate. Le righe mostrano lo stimolo reale, una ricostruzione comparativa generata dall'implementazione locale e la ricostruzione ottenuta con TDE-Net; le colonne corrispondono agli indici individuali delle condizioni. I campioni delle immagini reali sono stati estratti dal database di immagini THINGS34. Cliccare qui per visualizzare una versione ingrandita di questa figura.
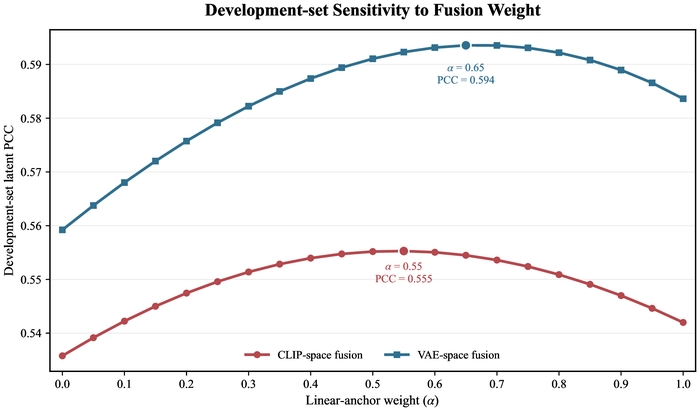
Figura 5: Sensibilità dei pesi della fusione latente nel set di sviluppo. L'asse orizzontale indica il peso lineare dell'ancora α, il peso del flusso complementare è 1 - α, e l'asse verticale indica il coefficiente di correlazione di Pearson (PCC) latente nel set di sviluppo. I valori candidati variano da 0,00 a 1,00 con incrementi di 0,05. I pesi nello spazio CLIP e nello spazio VAE vengono selezionati indipendentemente in base alla media massima di PCC a livello soggetto, pesata in modo uguale, su 10 soggetti, ottenendo αCLIP = 0,55 e αVAE = 0,65. PCC, coefficiente di correlazione di Pearson. Cliccare qui per visualizzare una versione ingrandita di questa figura.
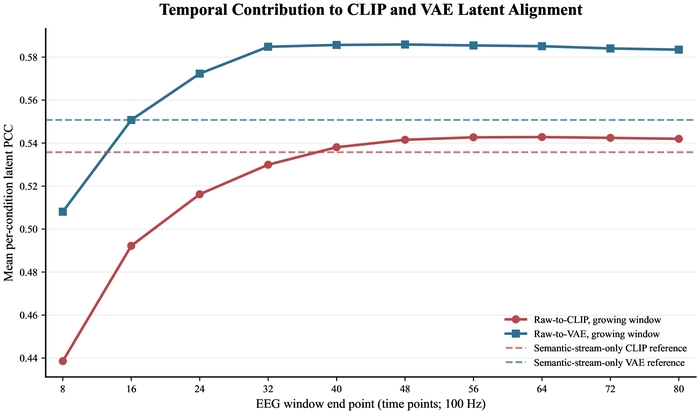
Figura 6: Analisi temporale della concordanza latente nel soggetto 01 (n = 200 condizioni escluse). Le curve continue mostrano il coefficiente di correlazione di Pearson (PCC) medio a livello di campione per le previsioni ridge da dati grezzi a CLIP e da dati grezzi a VAE, all'aumentare dell'estremità della finestra EEG da 8 a 80 punti temporali a 100 Hz. Le linee tratteggiate indicano i valori di riferimento per CLIP e VAE basati esclusivamente sul flusso semantico per l'intera finestra. PCC, coefficiente di correlazione di Pearson. Cliccare qui per visualizzare una versione ingrandita di questa figura.
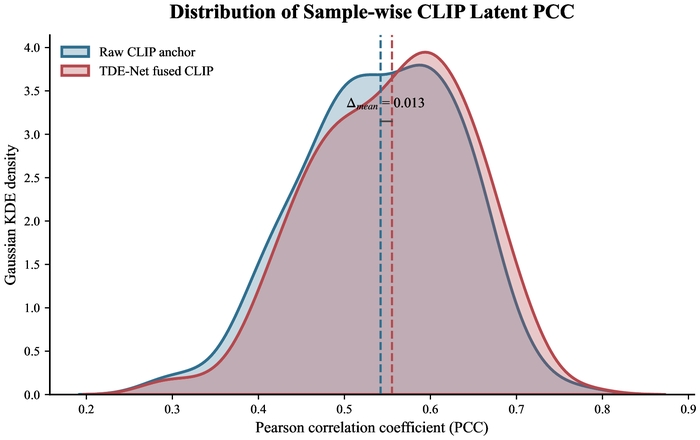
Figura 7: Distribuzione dell'allineamento latente CLIP per campione nel soggetto 01 (n = 200 condizioni escluse). Le curve rappresentano stime della densità kernel gaussiana con larghezza di banda di Scott per l'ancora CLIP grezza e la previsione CLIP fusa con TDE-Net congelata. Le linee verticali tratteggiate indicano le medie campionarie e l'annotazione mostra la loro differenza. PCC, coefficiente di correlazione di Pearson; KDE, stima della densità kernel. Cliccare qui per visualizzare una versione ingrandita di questa figura.
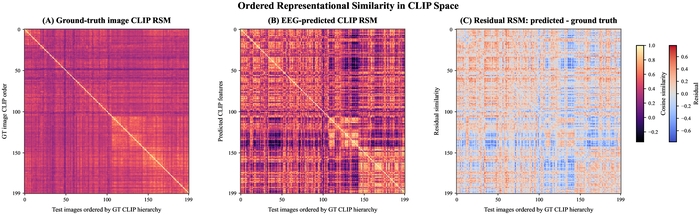
Figura 8: Similarità rappresentativa ordinata nello spazio CLIP per sub-01 (n = 200 condizioni escluse). (A) Matrice RSM di similarità coseno degli embedding CLIP delle immagini reali normalizzati L2. (B) Matrice RSM di similarità coseno degli embedding CLIP predetti dalla EEG fusi, visualizzata con lo stesso ordinamento e scala cromatica del pannello A. (C) Matrice RSM residua, calcolata come predetta meno reale, visualizzata su una scala simmetrica definita dal residuo assoluto massimo. L'ordinamento è ottenuto mediante distanza euclidea e collegamento Ward degli embedding CLIP reali. RSM, matrice di similarità rappresentativa. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Componente | Parametro | Impostazione |
| Dati e preelaborazione | Partizione del dataset | 16.540 condizioni di addestramento e 200 condizioni di test escluse; suddivisione 90%/10% per adattamento/sviluppo (seme 42) |
| Input EEG | 17 canali parieto-occipitali; 0-800 ms; 100 Hz; 80 punti temporali | |
| Rappresentazione spettrale | FFT a 80 punti; 40 bin di frequenza positiva; spettro logaritmico di ampiezza 0-50 Hz | |
| Flusso strutturale | Costruzione del grafo | Correlazione di Pearson assoluta specifica per campione; pesati i primi k = 4 vicini per nodo; simmetrizzazione e autoanelli |
| Architettura GCN | 5 strati; 80 unità nascoste; ReLU; dropout 0,3; normalizzazione del grado simmetrica; pooling medio | |
| Obiettivo contrastivo | Testa di proiezione 80-dimensionale; temperatura InfoNCE τ = 0,5 | |
| Addestramento | Adam; tasso di apprendimento 5 × 10⁻⁴; dimensione del batch 32; 20 epoche; annealing coseno; tasso di apprendimento minimo 10⁻⁶; seme 42 | |
| Flusso semantico | Architettura | Kernel temporali 5/15/31; profondità 9; 24 canali di caratteristiche; dropout 0,5; dimensione dell'output 1.024 |
| Addestramento | AdamW; tasso di apprendimento 5 × 10⁻⁴; decadimento del peso 0,01; dimensione del batch 64; 50 epoche; annealing coseno; tasso di apprendimento minimo 10⁻⁶; seme 42 | |
| Mappatura latente | Regressione ridge | Intercetta stimata; massimo di 50.000 iterazioni; input standardizzati utilizzando le statistiche della partizione di addestramento |
| Regolarizzazione | Penalità CLIP λ = 1.000; penalità VAE grezza λ = 0; penalità VAE strutturale λ = 1.000 | |
| Dimensioni target | CLIP: 1.024; VAE: 36.864 | |
| Fusione e decodifica | Pesi di fusione | Peso dell'ancora CLIP α = 0,55; peso dell'ancora VAE α = 0,65; selezionati sui dati di sviluppo e fissati prima del test |
| Modello di diffusione | sd2-community/stable-diffusion-2-1-unclip; scala strutturale γ = 0,02; passi temporali di diffusione T = 1.000 | |
| Campionamento | 20 passaggi di denoising; scala di guida 7,5; seme di diffusione 0 |
Tabella 1: Sintesi consolidata dei parametri per TDE-Net. La tabella elenca la partizione dei dati, la pre-elaborazione, la costruzione dell'adiacenza funzionale, le impostazioni dell'encoder grafico e semantico, le penalità per la mappatura latente, i pesi di fusione e le impostazioni di decodifica per la diffusione utilizzate in tutti gli esperimenti riportati.
| Metodo | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Baseline | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| EEGImageDecode | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Perceptogram (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (Proposto) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
Tabella 2: Risultati della ricostruzione quantitativa. I metodi di confronto, il Baseline con convoluzione-attenzione interna e TDE-Net sono stati valutati all'interno di un comune schema sperimentale, utilizzando la stessa partizione THINGS-EEG2, un ingresso di 17 canali, lo stesso preelaborazione, condizioni di test tenute in riserva e definizioni di metriche, mantenendo al contempo architetture specifiche per ciascun metodo. Il modello attuale è riportato come media ± DS su 10 soggetti. PixCorr, SSIM, AlexNet Livello 2, AlexNet Livello 5, Inception-v3 e CLIP sono misure in cui valori più alti indicano prestazioni migliori; EffNet e SwAV sono distanze di correlazione, per le quali valori più bassi sono migliori. La colonna CLIP riporta l'accuratezza di identificazione a coppie utilizzando il modello OpenAI CLIP ViT-L/14.
| Soggetto | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0,2260 | 0,3361 | 0,8831 | 0,9203 | 0,7533 | 0,8120 | 0,8567 | 0,5285 |
| sub-02 | 0,2488 | 0,3378 | 0,8699 | 0,9053 | 0,7268 | 0,8074 | 0,8335 | 0,5167 |
| sub-03 | 0,2564 | 0,3397 | 0,8728 | 0,9070 | 0,7658 | 0,8143 | 0,8268 | 0,5096 |
| sub-04 | 0,2420 | 0,3356 | 0,8598 | 0,9034 | 0,7854 | 0,8112 | 0,8255 | 0,5091 |
| sub-05 | 0,2499 | 0,3385 | 0,8760 | 0,8963 | 0,7251 | 0,8016 | 0,8394 | 0,5189 |
| sub-06 | 0,2621 | 0,3395 | 0,8910 | 0,9331 | 0,7818 | 0,8215 | 0,8202 | 0,5009 |
| sub-07 | 0,2489 | 0,3378 | 0,8643 | 0,9185 | 0,7704 | 0,8200 | 0,8222 | 0,5017 |
| sub-08 | 0,2786 | 0,3425 | 0,8951 | 0,9216 | 0,7524 | 0,8245 | 0,8214 | 0,5010 |
| sub-09 | 0,2609 | 0,3370 | 0,8775 | 0,9238 | 0,7662 | 0,8055 | 0,8250 | 0,5009 |
| sub-10 | 0,2571 | 0,3433 | 0,8871 | 0,9240 | 0,7792 | 0,8175 | 0,8140 | 0,4977 |
| Media | 0,2531 | 0,3388 | 0,8777 | 0,9153 | 0,7606 | 0,8135 | 0,8285 | 0,5085 |
| Media ± DS | 0,2531 ± 0,0138 | 0,3388 ± 0,0025 | 0,8777 ± 0,0115 | 0,9153 ± 0,0116 | 0,7606 ± 0,0213 | 0,8135 ± 0,0074 | 0,8285 ± 0,0122 | 0,5085 ± 0,0101 |
| IC 95% | 0,2432-0,2630 | 0,3370-0,3406 | 0,8695-0,8859 | 0,9070-0,9236 | 0,7454-0,7759 | 0,8082-0,8189 | 0,8198-0,8372 | 0,5013-0,5157 |
Tabella 3: Risultati quantitativi tra soggetti per TDE-Net. Ogni soggetto contribuisce con 200 condizioni di test escluse. La tabella riporta gli otto metrici per sub-01 fino a sub-10, seguiti dalla media tra soggetti, deviazione standard campionaria e intervallo di confidenza al 95%. CLIP indica l'accuratezza di identificazione a coppie di OpenAI CLIP ViT-L/14; EffNet e SwAV sono distanze di correlazione in cui valori più bassi sono migliori.
| Metodo | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Linear Anchor | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Linear + Struct-Stream | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Linear + Sem-Stream | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (Ours) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tabella 4: Risultati dell'ablazione riportati come valori medi tra i soggetti secondo la procedura di valutazione descritta nella Sezione 6 del Protocollo. L'ancoraggio lineare è un riferimento interno locale per il mapping diretto dei solchi; le configurazioni strutturale, semantica e completa utilizzano gli stessi indici di condizione e definizioni di metrica. PixCorr, SSIM, AlexNet Livello 2, AlexNet Livello 5, Inception-v3 e CLIP sono misure in cui valori più alti indicano prestazioni migliori; EffNet e SwAV sono distanze di correlazione in cui valori più bassi indicano prestazioni migliori. I valori sono mostrati con tre cifre decimali.
Figura supplementare 1: Casi rappresentativi di ricostruzione che coprono l'intervallo di accordo CLIP per il soggetto-01. Le 200 condizioni escluse sono ordinate in base alla similarità coseno tra gli embedding CLIP previsti dall'EEG fusi e quelli reali; vengono mostrati sei casi migliori, sei mediani e sei peggiori. Ogni colonna accoppia un campione dell'immagine reale dal set di test THINGS-EEG2 con la relativa ricostruzione ottenuta tramite TDE-Net. Le immagini reali sono state estratte dalla banca dati di immagini THINGS34. Cliccare qui per scaricare il file.
Figura supplementare 2: Visualizzazione congiunta delle rappresentazioni CLIP reali e predette dall'EEG nel soggetto sub-01 (n = 200 condizioni per rappresentazione). (A) Rappresentazioni CLIP reali. (B) Rappresentazioni CLIP predette dall'EEG. I colori indicano cinque cluster ottenuti con k-means applicati agli embedding CLIP reali normalizzati con norma L2 (k = 5, n_init = 50, seed = 7). I cluster sono gruppi basati sui dati e non corrispondono a categorie semantiche predefinite. Gli embedding reali e predetti sono concatenati, ridotti a 50 dimensioni mediante PCA e proiettati insieme tramite t-SNE (perplexity = 28, learning rate = auto, metrica euclidea, seed = 12). PCA, analisi delle componenti principali; t-SNE, embedding stocastico t-distribuito dei vicini più prossimi. Cliccare qui per scaricare il file.
Figura supplementare 3: Pattern di EEG raggruppati per categoria ampia di concetto-immagine per sub-01. I concetti sono assegnati ad Animali, concetti relativi a cibo/piante o Altri oggetti. All'interno di ogni categoria, le righe seguono l'ordinamento gerarchico di Ward degli embedding CLIP normalizzati e decorrelati e sono campionati uniformemente fino a un massimo di 30 concetti per migliorare la leggibilità. Le colonne mostrano 17 canali EEG, con 80 punti temporali per canale. La scala cromatica (-1 a 1) rappresenta l'ampiezza normalizzata e decorrelata dell'EEG, limitata tra -1 e 1. Cliccare qui per scaricare il file.
Figura supplementare 4: Topografia dell'attenzione ai canali scalpari del flusso semantico. I colori mostrano le grandezze relative normalizzate dei parametri ponderali appresi per i canali attraverso i 17 elettrodi selezionati in una proiezione scalpare standard 10–20; i punti e le etichette degli elettrodi identificano le posizioni di misurazione. La scala varia da 0 a 1 e riassume il peso relativo dei canali appreso dal modello. Cliccare qui per scaricare il file.
Discussione
Questo studio presenta un flusso di lavoro computazionale modulare che separa la pre-elaborazione dell'EEG, l'apprendimento delle rappresentazioni strutturali e semantiche, la mappatura latente CLIP/VAE, la fusione e la decodifica basata sulla diffusione. Questa organizzazione per fasi consente di esaminare separatamente gli output intermedi rispetto alle immagini generate e segue l'evoluzione più ampia dai codificatori compatti dell'EEG ai metodi di ricostruzione multimodali e basati sulla diffusione6,11,12,13,14,15,16,,17,18,19,20,21,22. L'analisi intersoggetto riporta i valori a livello di soggetto insieme alla media tra i soggetti e alla deviazione standard campionaria per la valutazione tenuta in riserva su dieci soggetti. Insieme all'ablazione progressiva riportata nella Tabella 4, questa analisi quantifica gli effetti specifici dei singoli flussi e la variabilità tra soggetti all'interno della pipeline descritta.
Fasi critiche e risoluzione dei problemi
I controlli di implementazione più importanti sono l'isolamento delle partizioni, la normalizzazione coerente, la conservazione dell'indice di condizione e le mappe separate per CLIP e VAE. I pesi di fusione devono essere selezionati in base alle condizioni di sviluppo e congelati prima della ricostruzione sui dati di test. Quando le prestazioni risultano inaspettatamente basse, verificare innanzitutto l'ordine e le dimensioni degli array, quindi esaminare il coefficiente di correlazione di Pearson (PCC) latente grezzo e specifico per ramo, i metadati della fusione e i risultati delle metriche a livello di immagine. Un fallimento nell'allineamento latente indica un problema nella mappatura a monte, mentre immagini variabili con latenti stabili possono riflettere un comportamento stocastico o dipendente dal decodificatore14,21,22,29.
La modifica della montatura degli elettrodi, della frequenza di campionamento o della finestra temporale richiede cambiamenti corrispondenti nella costruzione del grafo, nelle caratteristiche spettrali e nei kernel temporali. La qualità della ricostruzione deve essere valutata mediante misure complementari a livello basso e semantiche, poiché nessun singolo punteggio cattura fedeltà a livello di pixel, struttura e accordo a livello di oggetto6,11,21,22,23. La misura CLIP utilizzata in questo caso è l'accuratezza nell'identificazione a coppie, mentre Figura 7 e Figura 8 utilizzano il coefficiente di correlazione tra variabili latenti (PCC); queste quantità non sono intercambiabili.
L'organizzazione modulare di TDE-Net fornisce un quadro per esaminare se rappresentazioni complementari dell'EEG contribuiscano in modo diverso agli aspetti strutturali e semantici della ricostruzione visiva. Questo approccio potrebbe facilitare il confronto sistematico tra rappresentazioni delle caratteristiche dell'EEG, bersagli latenti e decoder generativi, senza fare affidamento esclusivamente sulle immagini ricostruite finali. Approcci alternativi includono il mapping lineare diretto da EEG a spazio latente, encoder a flusso singolo basati su convoluzione o attenzione, rappresentazioni basate su grafi e framework di decodifica neurale end-to-end6,7,8,9,10,11,17,18,19,20,21,22. Il flusso di lavoro attuale potrebbe essere particolarmente utile per la ricerca sulla decodifica della percezione visiva, sull'analisi delle rappresentazioni neurali e sulle interfacce cervello-computer non invasive, in cui la separazione delle predizioni intermedie da EEG a spazio latente può aiutare a caratterizzare quali componenti contribuiscono alle prestazioni di ricostruzione.
Limitazioni
I limiti principali sono l'acquisizione fissa THINGS-EEG2 RSVP, i 17 canali parieto-occipitali selezionati, le mappature specifiche per soggetto, un singolo decodificatore a diffusione e analisi qualitative dell'interpretabilità21,22,23. Il riassunto relativo a 10 soggetti affronta la variabilità intra-dataset tra soggetti, ma non stabilisce un trasferimento tra dataset o tra paradigmi. Le immagini generate possono contenere dettagli plausibili non supportati dall'input EEG, e le visualizzazioni RSM, t-SNE, dei pattern EEG e dell'attenzione non stabiliscono meccanismi neurali causali. L'ablazione progressiva caratterizza i contributi del flusso strutturale, del flusso semantico e della fusione nello spazio doppio in presenza di un ancoraggio comune ai dati grezzi EEG, obiettivi latenti, decodificatore a diffusione e protocollo di valutazione.
Prospettive future
Nel rispetto di questi vincoli, i risultati supportano la valutazione di rappresentazioni EEG complementari in spazi semantici e latenti per immagini separati, prima della decodifica diffusiva. Studi futuri dovrebbero testare dataset indipendenti, adattamento del soggetto, stime di incertezza, montaggi di canali alternativi e decodificatori con controlli più rigorosi sui dettagli visivi non supportati14,15,16,17,18,19,20,21,22,23. Tali studi sono necessari prima di estendere i risultati attuali a contesti più ampi di neuroscienze o di interfacce cervello-computer.
Conclusione:
TDE-Net combina un ancoraggio EEG grezzo con rappresentazioni strutturali e semantiche dell'EEG, allineandoli separatamente agli spazi latenti VAE e CLIP, e integra le previsioni risultanti prima della decodifica per diffusione. Nei 10 partecipanti di THINGS-EEG2, le immagini ricostruite hanno mantenuto una corrispondenza misurabile a livello di pixel, strutturale e semantica con gli stimoli visualizzati, mentre l'ablazione progressiva ha differenziato gli effetti del flusso strutturale, del flusso semantico e della fusione in doppio spazio. Esplicitando le caratteristiche intermedie dell'EEG, le previsioni latenti, gli output di fusione e le ricostruzioni finali, il protocollo fornisce un quadro riproducibile per l'indagine sulla ricostruzione visiva basata sull'EEG e per la valutazione della sua futura estensione a dataset indipendenti e a diverse configurazioni di acquisizione.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto o relazioni personali che potrebbero aver influenzato questo lavoro. Gli autori dichiarano che non sono stati utilizzati strumenti di intelligenza artificiale generativa nella stesura del manoscritto, nel codice, nell'analisi dei dati o nella preparazione delle figure.
Ringraziamenti
Questa ricerca è stata finanziata dalla National Natural Science Foundation of China (Grant No. 62433002) e (Grant No. 62476014), dal National Science and Technology Major Project (No. 2021ZD0113703), dal Beijing Municipal Social Science Foundation Annual Planning Project (No. 23GLB014), dal Project of Construction and Support for High-level Innovative Teams of Beijing Municipal Institutions (Grant No. BPHR20220104) e dal Beijing Scholars Program (Grant No. 099).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Accelerare | Hugging Face | 0.30.1 | Gestione del dispositivo nella pipeline di diffusione; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Codificatore di caratteristiche immagine utilizzato per obiettivi semantici e identificazione a coppie con CLIP; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Implementazione della pipeline Stable UnCLIP; https://github.com/huggingface/diffusers |
| Matplotlib | Squadra di sviluppo di Matplotlib | 3.10.6 | Generazione di figure scientifiche; https://matplotlib.org/ |
| MNE-Python | Sviluppatori MNE | 1.11.0 | Montaggio standard 10-20 e topografia dei canali del cuoio capelluto; https://mne.tools/ |
| NumPy | Sviluppatori di NumPy | 2.3.4 | Array EEG, incorporamenti latenti, fusione e aggregazione di metriche; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | GPU utilizzata per l'addestramento locale del codificatore e la ricostruzione mediante diffusione. |
| Pillow | Fork della libreria Python Imaging | 11.1.0 | Caricamento, ridimensionamento ed esportazione di immagini; https://python-pillow.org/ |
| Python | Fondazione Python Software | 3.12.12 | Ambiente di esecuzione principale; https://www.python.org/ |
| PyTorch | Fondazione PyTorch | 2.9.1+cu128 | Addestramento del codificatore EEG e inferenza con reti neurali; https://pytorch.org/ |
| scikit-image | Sviluppatori di scikit-image | 0.25.2 | Utilità per SSIM ed elaborazione delle immagini; https://scikit-image.org/ |
| scikit-learn | Sviluppatori di scikit-learn | 1.7.2 | Regressione ridge, k-means, PCA e t-SNE; https://scikit-learn.org/ |
| SciPy | Sviluppatori di SciPy | 1.16.3 | Correlazione, distanza statistica e clustering gerarchico; https://scipy.org/ |
| Seaborn | Sviluppatori di Seaborn | 0.13.2 | Visualizzazione della densità del kernel gaussiano; https://seaborn.pydata.org/ |
| Codificatore EEG del flusso semantico | Autori di TDE-Net; adattato da LMDA-Net | Commit del repository c99325d | Rappresentazione semantica temporale multiscala; l'implementazione e i metadati del checkpoint sono forniti nel repository del codice. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / Comunità SD2 | sd2-community/stable-diffusion-2-1-unclip | Decoder di diffusione congelato; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Codificatore EEG del flusso strutturale | Autori di TDE-Net | Commit del repository c99325d | Rappresentazione grafica auto-sorvegliata; i segnali EEG grezzi e le caratteristiche del grafo vengono concatenati solo per il mapping strutturale nello spazio VAE. |
| Script di allineamento, fusione, valutazione e visualizzazione di TDE-Net | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| Database THINGS | Hebart et al. | doi:10.1371/journal.pone.0223792 | Fonte di stimoli oggettuali naturalistici; https://things-initiative.org/ |
| Dati THINGS-EEG2 | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | EEG a 64 canali da 10 soggetti; questo studio seleziona 17 canali parieto-occipitali; https://osf.io/anp5v/ |
| timm | Ross Wightman e collaboratori | 1.0.22 | Utilità per modelli visivi preaddestrati utilizzate nella valutazione delle caratteristiche; https://github.com/huggingface/pytorch-image-models |
| torchvision | Fondazione PyTorch | 0.24.1+cu128 | Backbone di valutazione AlexNet, Inception-v3 ed EfficientNet; https://pytorch.org/vision/ |
| tqdm | Sviluppatori di tqdm | 4.67.1 | Segnalazione dello stato di avanzamento per estrazione delle caratteristiche, ricostruzione e valutazione; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Interfacce per componenti di modelli preaddestrati; https://github.com/huggingface/transformers |
Riferimenti
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Ristampe e permessi
Questo articolo è stato pubblicato
Video in arrivo