本研究は、分布の不一致と差異特徴重要性を統合し、正確な転がり軸受故障診断のためにk近傍法を提案します。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
転がり軸受はさまざまな回転機械の中で最も脆弱な部品の一つであり、正確な故障検出と位置特定が不可欠です。転がり軸受が破損すると、信号は非固定状態となり、振動信号のエネルギー分布は故障箇所によって異なります。従来のk近傍(KNN)故障診断アルゴリズムでは、ユークリッド距離は主にサンプル点間の距離を測定するために用いられますが、異なる空間分布間の類似性を捉えるには効果的ではありません。さらに、これらのアルゴリズムは同じ特徴重要度を想定しており、故障振動信号の実際の特性を反映していません。本研究は、分布の不一致と差異特徴の重要性を組み込んだKNNベースのローリングベアリング故障診断法を提案します。まず、振動信号は三準位ウェーブレットパケット分解を用いて分解され、三階位の各ノードのエネルギーが故障特徴として用いられます。次に、平均インパクトバリュー(MIV)アルゴリズムを用いて各特徴の相対的重要性を決定し、地中距離(EMD)を適用して空間分布間の差を測定します。ユークリッド距離とMIVおよびEMDを統合し、KNN多数決法則を適用することで、故障診断が行われます。実験結果によると、この方法は診断精度99.43%に達し、従来のKNN手法と比べて5.97%の向上を示しています。提案された方法は、本研究で使用されたローリングベアリングデータセットにおける正確かつ効果的な故障診断性能を示しています。
概要
技術の進歩に伴い、回転機械は統合、大規模システム、高速化、そしてインテリジェントな運転へとますます発展しています。さまざまな種類の回転電気機械の中で、転がり軸部品は最も脆弱で損傷しやすい部品です。起動が容易で、摩擦が少なく、潤滑が簡単で交換が便利で、精密計測、航空宇宙、自動車、工作機械、ロボットなどで広く使用されています。回転機械故障に関する関連統計データによると、異常振動故障が70%を占め、そのうち30%はローリングベアリング異常と密接に関連しています。したがって、転がり軸受断層の正確な診断は非常に重要で広く研究されている分野です。
転がり軸受故障の診断には一般的な手法と機械学習手法があります。一般的な診断手法は、時間領域および周波数領域における信号を解析・分解します。時間領域解析法は、波形パターン、統計的特徴、時間的関係を観察することで信号の性質と特性を記述し、故障診断を可能にします。一般的な指標には、平均値、平均二乗根、相関係数、マージン、有効価値、インパルスファクター3などがあります。しかし、これらの手法は外部ノイズの影響を受けやすく、精度が低下します。複雑なシステムでは、これらの手法はシステムの挙動を完全に特徴づけることができず、他の解析手法と組み合わせて組み合わせる必要があることが多いです。Chenらは振動時領域信号を前処理して異なる無次元特徴を抽出し、その後決定木ベースのランダムフォレストアルゴリズムを用いてトレーニングモデルを構築しました。この手法の有効性は、ロールベアリングの競争データと海洋ベアリング断層のシミュレーションデータを用いて検証されました。
周波数領域解析法は信号を周波数領域に変換し、周波数成分、スペクトル特性、周波数分布の理解を深めます。これらの手法には、フーリエ変換、スペクトル解析、パワースペクトル密度が含まれます。Liらは生成されたエンベロープスペクトル内の振動信号の周波数分布を解析し、ベアリング故障を診断しました。Wangらは、異なる周波数領域解析手法を用いて振動信号の特性周波数を特定し、それを機器固有の特性周波数と比較してスピンドルシステムにおける機械的故障同定を実現しました。
機器の複雑化に伴い、信号解析の需要はより多様化しています。非線形および非定常信号は時間変化する周波数成分を含むため、線形性や定常性の仮定に基づく従来の解析では、その過渡的な挙動や時間的相関を完全に明らかにすることはできません。これに対し、時間・周波数解析は時間と周波数の両次元にわたる信号エネルギー分布を共同で表現し、より包括的な解釈を可能にします。これらの手法により、信号が時間とともにどのように変化し、周波数成分が異なる区間でどのように変化するかを観察でき、動的な信号特性の捉えに役立ちます7,8。離散ウェーブレット変換、アンサンブル経験モード分解、変分モード分解などの主要な手法が時間周波数解析に広く用いられています。連続ウェーブレット変換と転移学習強化残留ニューラルネットワークを組み合わせ、Diaoらはハイブリッド診断フレームワークを提案しました。
従来の診断アプローチは主に手作業で経験主導であり、主観的なバイアスや操作者による不一致性が起こりやすく、不確実で一様でない診断を生み出します。信号処理後でも、抽出されたマルチドメイン特徴は正確な故障診断を得るためにさらなる最適化が必要なことが多いです。一方、機械学習手法は数学モデルを用いてベアリング断層を分類し、特徴データセット内のパターンを自動的に特定することで、人間の判断への依存を減らします。そのため、多くの研究者が信号処理と機械学習を組み合わせてベアリング故障の種類を診断・分類しています。一般的に使われる手法には、ランダムフォレストのようなアンサンブルモデル、サポートベクターマシンのようなカーネルベースの手法、極端な学習マシン11のような単層フィードフォワードネットワークがあります。
故障診断のための機械学習技術の発展に注力された注目すべき努力がなされています。近年では、グラフニューラルネットワークに基づくより高度な手法が開発されています。Zhangらは、ノイズ信号下でのロバスト故障診断のためのマルチスケールチャネル注意駆動グラフ動的融合学習法を提案しました。12。あなたらは、少ショット故障診断のためのチャネル適応生成再構築および融合フレームワークを開発しました13。これらの手法は最先端の精度を達成していますが、膨大な計算資源と大規模なラベル付きデータセットを必要とします。転がり軸受の故障診断に関して、郭らは適応重み付け14を用いたデータレベルの融合法を提案しました。この手法はk近傍(KNN)アルゴリズムを用いてマルチソース振動信号を処理し、最適な重み付け方式を決定します。振動信号における故障誘起の非定常性はスペクトルエネルギー分布を変化させ、これらのバンドごとのエネルギー変動が異なる故障状態の識別特徴として機能します。しかし、従来のKNNアルゴリズムは類似度測定にユークリッド距離に依存しており、複雑または多様な分布を持つデータには不十分です。さらに、これらは同じ特徴重要度を想定しますが、これは15、16、17の故障振動特性の実際の特性を反映していません。従来の分布類似度測定も分布の重なりの影響を強く受けており、18、19、20、21、22の真の不一致を捉える能力が制限されます。これに対し、アースムーバー距離(EMD)は、ある分布を別の分布に変換するために必要な最小コストを測定し、重複や位置変位に関係なく分布の違いを効果的に捉えます。この特性により、EMDは分布シフトが頻繁に起こるさまざまな動作条件下での堅牢な類似度測定を可能にし、本研究に特に適しています。
これらの限界に対処するため、本研究は分布の違いと特徴重要度の両方を組み込んだKNNベースの転がり軸受の故障診断手法を開発します。提案された方法は主に4つのステップで構成されています。まず、振動信号に3準位ウェーブレットパケット分解を適用し、3階のすべてのノードのエネルギー値を計算して故障特徴セットを構築します。次に、平均インパクトバリュー(MIV)アルゴリズムを用いて各特徴の相対的重要性を定量化します。第三に、特徴ベクトル間の分布差を測定するためにEMDが導入され、構造的な不一致を捉えます。最後に、KNNアルゴリズムの従来のユークリッド距離は、MIVベースの特徴重みとEMDベースの分布指標を統合することで強化されています。この類似度の改善指標と過半数投票を組み合わせて、故障の分類や診断精度の向上に用いられます。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
この研究は人間や動物被験者を含みませんでした。したがって、倫理的承認やインフォームド・コンセントは必要ありませんでした。提案された手法はMATLAB R2014bを用いて実装されました。使用されたツールボックスは以下の通りです:ウェーブレットパケット解析用のWavelet Toolbox(wpdecおよびwpcoef)、BPニューラルネットワーク実装用のNeural Network Toolbox(feedforwardnetおよびtrain)、EMD計算における線形計画問題解決のためのOptimization Toolbox(linprog)、およびKNN分類用のStatistics and Machine Learning Toolbox(fitcknnおよびpredict)。EMDは線形計画法を用いて輸送問題を解くことで実装されました。すべての実験は、Intel Core i7-10700 CPU(2.90 GHz)と16 GB RAMを搭載したWindows 10 PC上で実施されました。提案された方法は、公開されているCWRUベアリングデータセット(https://engineering.case.edu/bearingdatacenter/download-data-file)を用いて検証されました。故障は、電気放電加工(EDM)を用いて駆動端ベアリングSKF6205に、直径0.007インチ、0.014インチ、0.021インチの3箇所(内側レース、外側レース、ボール)で導入されました。振動信号は4つのモーター負荷(0–3馬力)で12kHzのサンプリング周波数で収集され、速度は1797〜1730rpmに相当します。各信号サンプルは2048のデータポイントで構成されており、スライディングウィンドウセグメンテーション方式で598ポイント(70.8%の重複)で得られました。
提案されたKNNベースの転がり軸受故障診断フレームワーク(図1)は、7つの連続した段階から成り、各段階の出力が次の段階への入力となります。第1段階では、ダウベシー3(db3)ウェーブレット基底を用いた三準位ウェーブレットパケット分解を用いて、転がり軸受の振動信号からエネルギー特徴を抽出します。第3分解レベルでの8つの部分バンドの正規化されたエネルギー値は特徴集合Q = (q1, q2, ..., qm)にまとめられ、ここでm = 8は特徴次元です。正規化は式66で定義された和正規化(相対エネルギー正規化)を用いて行われます。
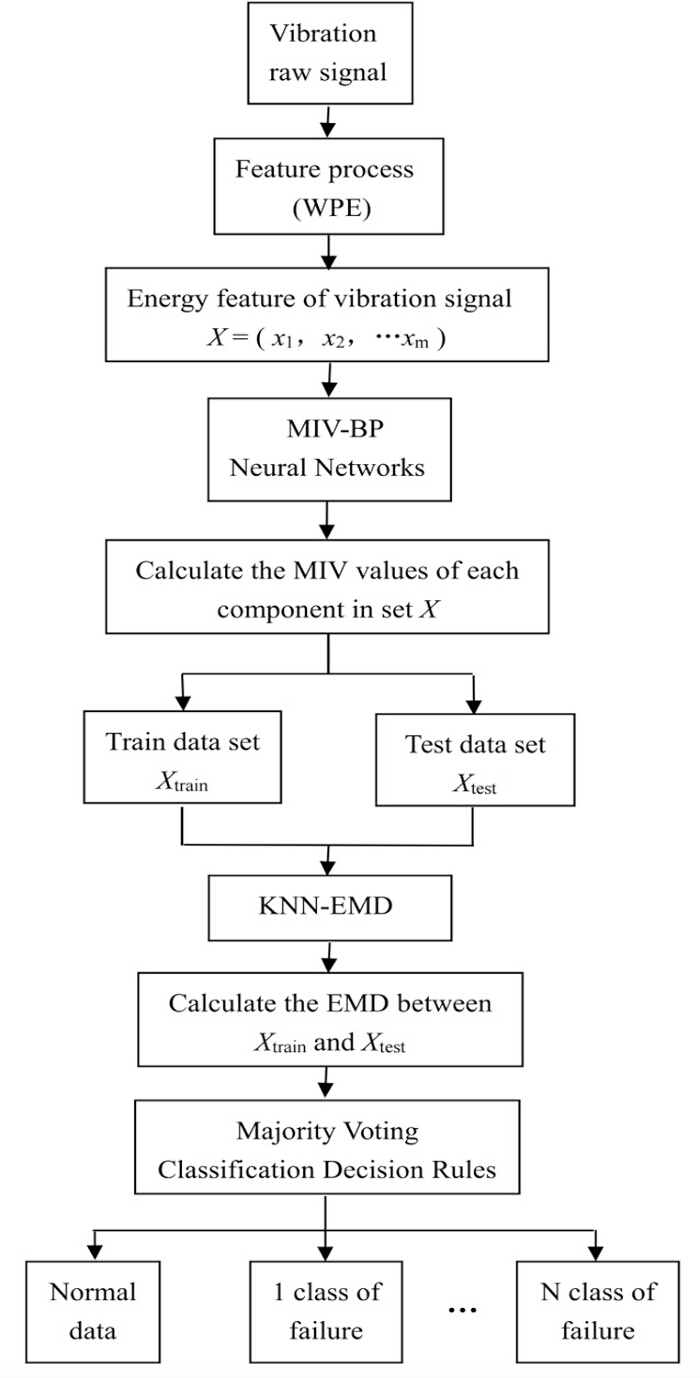
図1:提案されたアルゴリズムの実装フローチャート。 提案されたKNN–MIV–EMD手法のワークフローを示すフローチャートで、振動信号入力、ウェーブレットパケットエネルギー特徴抽出、MIVベースの特徴重み付け、EMDベースの類似度計算、そして多数決による最終分類が含まれます。 この図の拡大版はこちらをクリックしてご覧ください。
第2段階では、各特徴のMIVはBPニューラルネットワーク(10ニューロンを持つ単一隠れ層、最大2000回の反復、ターゲット誤差1.0×10⁻5、摂動ステップサイズδ=各特徴の平均値の±10%)を用いて計算されます。これは式10–1323に定義されています。ネットワークは隠れ層で活性化関数θ sとして双曲接線シグモイド関数(tansig)を、出力層で線形関数(ピューレリン)として用いています。ネットワークはLevenberg–Marquardtアルゴリズム(trainlm)を用いて訓練されます。MIV値はその特徴の相対重要度の重みとして割り当てられます。
第3段階では、生の振動信号を200サンプルに分割し、2048のデータポイントのスライディングウィンドウ(ステップサイズは598ポイント、70.8%の重複)を用います。ウィンドウは信号の開始点から順に移動します。データセット(Q)はトレーニングセット(Qトレイン)とテストセット(Qテスト)に分割され、52/48の分割比率で分類されます。各故障条件に対して、104サンプルがランダムにトレーニングセットとして選ばれ、残りの96サンプルがテストセットとして使用されます。分割は異なるランダムシードを用いて10回繰り返され、平均性能指標が統計的な堅牢性を評価するために報告されます。このアプローチにより、結果が特定のランダム分割に依存しないことを保証します。分割はセグメンテーション後にサンプルレベルで行われるため、トレーニングセットとテストセットの間にデータポイントの重複はありません。
第4段階では、訓練セットに対する5分割交差検証を用いて最適数の最近傍Kを選択します。フォールドは固定されたランダムシードを用いてランダムに生成され、クラス分布を保つためにクラスごとに階層化されます。候補Kの値は範囲 内で探索され、特にK = 1、3、5、7、9を評価します。5つのフォールドで平均分類精度が最も高いKの値が最適値として選ばれます。この研究では、最適Kは3と決まります。
第5段階では、MIVからの特徴重要度重みとEMDによる分布差を統合することで類似度測定が強化されます。各サンプルは、和正規化( 式4–76に定義された通り)を用いて得られた8次元正規化エネルギー特徴ベクトルとして表されます。従来のKNN分類器は、サンプル間の類似性を測定するためにユークリッド距離を用いています。しかし、この手法は特徴分布の違いをよりよく捉えるために拡張されています。EMDは特徴分布間の距離を測定し、ウェーブレットパケット分解によって得られるベアリング振動信号のエネルギー分布解析に特に適しています。EMD計算前に追加の正規化は適用されません。EMDで使用されるグラウンド距離は、特徴成分間のユークリッド距離です。複数の分布間の距離を測定する際、EMDは分布の位置差に影響されず、抽出されたエネルギー特徴の効果的な比較や、KNN決定規則と組み合わせることで分類の改善が可能となります。
式1–3は本研究で提案された新しい定式化です。式4–7および8–26はそれぞれの分野における標準的な定式化を表しています。テストサンプル(I)とトレーニングサンプル(Qトレイン)の場合、MIVを含む加重ユークリッド距離は式1として定義されます。ここでm = 8は特徴量次元、wiは第i個特徴量の正規化されたMIV重み、QがQ検定 、Qは第i個の特徴値、i はテストと訓練サンプルの第i個特徴値です。 それぞれです。
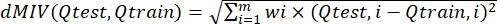 (1)
EMDに基づく分布距離は 式2で定義されており、ここでテスト(Htest)と訓練(Htrain)サンプルの特徴分布が用いられます。EMDは、ある分配から別の分配に変換するために必要な最低コストを測定します。
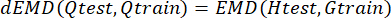 (2)
両成分を組み合わせた最終的な強化距離は式 3として定義され、 λ はEMDに基づく分布距離の寄与を制御するバランスパラメータです。本研究では、経験的調整に基づいて λ を0.5に設定し、最適な分類性能を実現します。値 λ = 0.5は、ステップサイズ0.1の範囲[0, 1]の検証セット上でグリッドサーチによって決定され、最も分類精度が高い値を最適と選びました。最適な λ はデータセット固有のものかもしれません。他のデータセットについては、トレーニングデータに対するクロスバリデーションを用いてλを再調整することを推奨します。
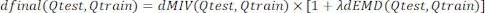 (3)
ステージ6では、すべてのトレーニングサンプルがテストサンプルまでの強化距離に基づいてソートされ、MIVベースの特徴重要度重みやEMDベースの分布指標が組み込まれています。上位 のK =3サンプルを最近傍として選びます。
第7段階では、 K =3の最近傍に多数決投票ルールを適用し、各テストサンプルの最終クラスラベルを決定します。
ウェーブレットパケット解析とエネルギー抽出
ウェーブレットパケット分解はウェーブレット変換に基づいていますが、従来のウェーブレット分解よりも精緻です。ウェーブレットパケット分解の特徴は、従来のウェーブレット分解が低周波パート5のみを精緻化するのに対し、低周波成分と高周波成分の両方を分解することで、よりバランスの取れた完全な時間周波数解析を行うことができる点です。ウェーブレット分解の固定解像度特性とは対照的に、このアプローチによりバランスの取れた表現が可能となり、信号帯域幅全体における時間と周波数の局在化の典型的な妥協を緩和します。
多重分解過程において、ウェーブレットパケット分解は関数空間6の段階的に直交する分解とみなされます。ウェーブレットパケット分解の公式は式 46に示されています。
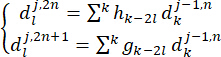 (4)
この定式化では、変数( 、
 、
 )はウェーブレットパケット分解から得られる係数に対応し、記号(hk-2l [ローパス]および gk-2l [ハイパス])は分解過程の中心となるフィルタ係数を表します。
本研究では、db3ウェーブレットがそのコンパクトな支持性と直交性からウェーブレット基底関数として選ばれ、振動信号から過渡的特徴を抽出するのに適しています。元の振動信号に対して3レベルのウェーブレットパケット分解が行われ、3段階で23 =8のサブバンドが得られます。
標準ウェーブレット変換と比べて、ウェーブレットパケット変換はより細かい信号分解を可能にします。元の信号を特定のスケールに分解することで、関心のある周波数帯を分離し、そのエネルギー分布を効果的な特徴として抽出します。ウェーブレットパケット変換は信号をサブバンドに分解し、そのエネルギー分布は元の信号の周波数成分を特徴づけ、この導出されたエネルギー特徴ベクトルは信号分類の堅牢な基盤となります。
信号の特徴ベクトルは、j層ウェーブレットパケット分解から得られる2つのj周波数帯にわたる正規化エネルギー分布として定義され、総信号エネルギーはこれらの直交する部分帯に分割されます。第j分解層のk番目の周波数帯に含まれるエネルギーは式56で表され、正規化されたエネルギー特徴は式66で示されます。
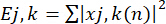 (5)
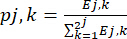 (6)
この手順に従い、各振動信号試料に対して、 式76に定義されたエネルギー特徴ベクトルが構成されます。
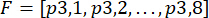 (7)
KNN–MIV–EMD 実装診断手続き実行
教師ありKNNアルゴリズムでは、新しいインスタンスの分類は、事前定義された距離指標で測定される 、 K個の最も類似した訓練サンプルの中から複数クラスによって決定されます。したがって、分類結果は K の選択と類似度計算の性質に依存します。このシンプルながら効果的な原理が、多様な分類分野での広範な応用を支えています。
KNNアルゴリズムのワークフローは以下の通りです。まず、 k-最近傍は、式 824に定義されたように、テストサンプルと各訓練インスタンス間のユークリッド距離を計算することで、訓練サンプルから特定されます。
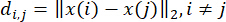 (8)
この表記法では、変数 x(i) と x(j) はそれぞれトレーニングサンプルとテストサンプルに対応します。
次に、検定サンプルのクラス確率分布をk個近傍から推定します。ここでkは最近傍の数を表し、これらのk個の隣接が特定のクラスa(a = 1,2,...,c)に属する数を用いて、検定サンプルがそのクラスaに属する確率P(a)を計算します。これは式924で定義されています。ここでcはデータセット内のクラスの総数を表します。
 (9)
最後に、故障診断は式 8を用いてk個近傍を特定し、 式9に従ってカウントを集計し、降順に並べて、最も高いカウントをテストサンプルの故障クラスに割り当てることで行われます。
MIVはBPニューラルネットワーク構造に基づいており、各変数の出力に対する重要度の重みを反映するために用いられます。BPニューラルネットワークは、入力層、隠層層、出力層を含む典型的な三層トポロジーを持つフィードフォワードネットワークです。誤りを逆方向に伝播させ、ニューロンの重みを反復的に調整して自己学習を実現します。
Xを、式1023および式1123に定義されたL群のサンプルデータセットとします。
XをL群のサンプルデータセットとします:
 (10)
 (11)
ここで、x(k)は時刻kでのサンプリングデータを表し、xiはx(k)の第i成分で、k = 1, 2, ..., L、i = 1, 2, ..., nを表します。
BPニューラルネットワークの動作原理は以下の通りです。入力サンプルx(k)はまず接続重みω Tで重み付けされ、隠れ層に伝播して隠れ層の入力データsiを生成する。これは式1223で定義され、ここで活性化関数(θ)が変換を支配する。
 (12)
ネットワークの出力は式 1323で定義された通りに得られます。
 (13)
ここで ωj = [ω1j, ω2j,...,ωnj] は入力重みベクトル、 β は出力重みベクトル、 j = 1, 2, ..., n を表します。本研究では、単一隠れ層は10ニューロン、最大反復回数は2000、最小期待ターゲット誤差は1.0×10⁻⁻5に設定されています。
入力層と隠れ層の間の重みに小さな摂動(Δωij)を適用すると、それが隠れ層の出力(Sj)に伝播し、最終的にネットワーク出力に変化をもたらす変化(ΔSj)が生じます。対応する重み(ωij と ωjk)はBPを通じて更新され、損失関数は 式1423で定義されます。
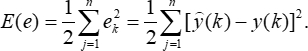 (14)
故障特徴セット  を補強するために、式 1523 および 式1623に定義されているように、サンプルデータ内の各特徴変数に小さな正の摂動と負の摂動が独立して適用されます。
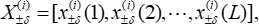 (15)
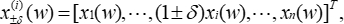 (16)
この定式化では、 L と n はそれぞれ故障特徴因子の数とサンプルグループ数を表します。本研究では、摂動ステップサイズを各特徴の平均値のδ±10%に設定しており、これはMIVベースの特徴重要度分析で一般的に用いられる設定です。したがって、ニューラルネットワークのフィッティング出力は式 1723 および式 1823で定義された通りに得られます。
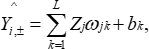 (17)
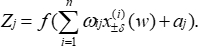 (18)
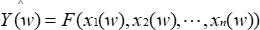 の場合、式1923に示されているように、対応する出力は摂動されたサンプルセットの結果を表します。
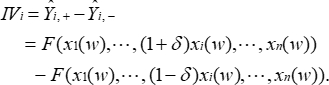 (19)
ここで、  と
 はそれぞれサンプルセット
 と
 の出力結果を表しています。断層タイプに対する各断層特徴変数の衝撃度は式 2023に定義されています。
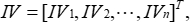 (20)
観測数に対して影響値を平均化することで、最終出力断層タイプ上の各断層特徴の平均影響値を方程式2123に定義して計算します。
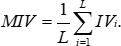 (21)
EMDは2つの分布間の類似度を測る指標です。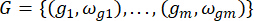 をソース分布、
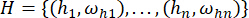 をターゲット分布とします。ここで gi と hj は、それぞれソース分布とターゲット分布における 第iおよび 第j番目のクラスタの位置(または特徴ベクトル)です。 ωgi は位置 gj における確率質量(重さ)であり、
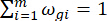 を満たす。 ωhj は位置 hj における確率質量(重さ)であり、
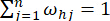 を満たす。 m と n は、それぞれソース分布とターゲット分布におけるクラスターの数です。
GとHの間のEMDは、源分布を目標分布に変換するために必要な最小コストとして定義され、式227に示されています。
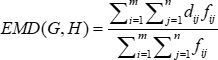 (22)
ここで、最適流量(fij)は 式23–267で定義された制約に従います。
 (23)
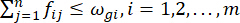 (24)
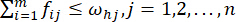 (25)
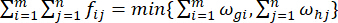 (26)
ここで fij は、源分布の 第iクラスタからターゲット分布の 第jクラスタへの流量(質量輸送量)です。その次元は m × n です。 dij は gi と hj の間の地面距離であり、通常ユークリッド距離として定義されます: 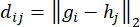 。次元も m × n です。最初の制約は非負の流量を保証し、2番目と3番目の制約は各ソースクラスターから各ターゲットクラスタへの総流量が利用可能な質量を超えないこと、4番目の制約は総流量が総質量(正規化分布では1)に等しくなることを保証します。
実際には、EMDは線形計画法(例:シンプレックスアルゴリズム)を用いて輸送問題を解決し、総輸送コストを最小化する最適な流れ(fij)を決定することで計算されます。得られるEMD値は、ある分布を別の分布に変換するために必要な最小コストを示し、提案された故障診断手法における特徴分布を比較するための堅牢な類似度指標として機能します。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
実験環境とプラットフォームは 図2に示されています。プラットフォームは左から右へ、ファンベアリングアセンブリ、誘導モーター、駆動ユニットで構成されています。中央部分はこれらの部品をカップリングを介してトルクトランスデューサー/エンコーダーに接続し、最も右側の部分がダイナモメーターとして機能します。制御電子機器は描かれていません。EDM技術は、弱い条件から厳しい条件まで軸受のピッティング断層をシミュレートするために用いられました。振動データは、モーター駆動側とファン側のベアリング付近に配置されたセンサーで収集されました。データセットには、ノーマルステート、内側レースフォルト、ローリング要素フォルト、アウターレースフォルトの4つの条件が含まれています。各条件ごとに200点のサンプルが採取されました。各故障タイプのデータセットは、訓練用(パラメータ推定)用104サンプルとモデル精度テスト用96サンプルに分割されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究は、EMDを通じて分布差を統合し、MIVを通じて特徴重要度を統合するKNNベースの転がり軸受の故障診断手法を提案しています。4つの健康状態(正常、内側レース故障、ローリング要素故障、外レース故障)を含むローリングベアリングデータセットでの実験結果は、提案されたアプローチの有効性を示しています。提案されたKNN–MIV–EMD法はK = 3で99.43%の分類精度を達成し、従来のKNN(93.46%)およびKNN–EMD(95.23%)を上回る性能を発揮します。3つの方法すべてにおいて、K = 3は一貫して最良の性能を示し、適度な数の最近傍がこの故障診断タスクにおいて局所感度とノイズの堅牢性のバランスを取ることを裏付けています。これらの結果は、KNNフレームワーク内で類似度測定と特徴重み付けを改善することで診断精度を大幅に向上できることを示しています。この文脈で、提案された手法は、従来のKNNアプローチの主要な限界、特に特徴重要度の等等の仮定や、類似度測定におけるユークリッド距離への...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者たちは利益相反を一切認めていない。
謝辞
この研究は河南省高校重点科学研究プロジェクト(25A580011)および河南省科学技術研究プロジェクト(262102210057)から財政的に支援されました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Acquisition System | |||
| データレコーダー(16チャンネル) | アンチエイリアシングフィルター、24ビットADC;ダイナミックレンジ>90 dB;ケース・ウェスタン・リザーブ大学(オハイオ州クリーブランド、アメリカ合衆国) 故障の種類とサイズ(インチ):すべての故障タイプ 負荷(HP):全 サンプリング周波数:12 kHzまたは48 kHz 研究目的:高品質なデータ取得 ファイル命名規則:該当なし | ||
| Data Subset | |||
| 本研究のデータ選択 | 駆動端データ、12 kHzサンプリング、4種類の負荷条件;CWRUベアリングデータセンター(https://engineering.case.edu/bearingdatacenter/download-data-file) 故障タイプおよびサイズ(インチ):7つの条件と時間;4つの負荷 = 28サブセット 負荷(HP):すべて サンプリング周波数:12 kHz 研究目的:モデルの訓練およびテスト ファイル命名規則:カスタム選択 | ||
| Label Information | |||
| 故障クラスラベル | ワンホット符号化フォーマット 故障タイプおよびサイズ(インチ):ノーマルおよびヘリリップ用[1,0,0,0,0,0]; 負荷(HP):全 サンプリング頻度:該当なし 研究目的:教師あり学習ラベル ファイル命名規則:Label_vector.mat | ||
| <ストロング>センサー | |||
| 加速度計(ドライブエンド) | ICP加速度計;位置:12時時計;感度 ~500 mV/g;駆動端ベアリングハウジング 故障タイプおよびサイズ(インチ):すべての故障タイプ 負荷(HP):全 サンプリング周波数:12 kHzまたは48 kHz 研究目的:一次振動信号の取得 ファイル命名規則:DE_time_series | ||
| 加速度計(ファンエンド) | ICP加速度計;感度 ~500 mV/g;ファンエンドベアリングハウジング 故障タイプおよびサイズ(インチ):すべての故障タイプ 負荷(HP):すべて サンプリング周波数:12 kHzまたは48 kHz 研究目的:補助信号/比較信号 ファイル命名規則:FE_time_series | ||
| <強力>テストベアリング<強さ> | |||
| ボールベアリング(健康) | 深溝ボールベアリング(6205型);SKF(CWRUセットアップで一般的に使用) 故障の種類とサイズ(インチ):標準 負荷(HP):0, 1, 2, 3 サンプリング周波数:12 kHzまたは48 kHz 研究目的:ベースライン条件 ファイル命名規則:Normal_0.mat | ||
| ボールベアリング(内側レース断層) | EDMによる単点故障 故障の種類およびサイズ(インチ):内側レース(IR)@ 0.007"、0.014"、0.021"、0.028" 負荷(HP):0、1、2、3 サンプリング周波数:12 kHzまたは48 kHz 研究目的:内側レース故障の検証 ファイル命名規則: IR007_1.マット | ||
| ボールベアリング(外レース断層) | EDMによる単一点故障(6 o'クロック位置) 故障の種類とサイズ(インチ):外側レース(OR)@ 0.007", 0.014", 0.021", 0.028" 負荷(HP):0, 1, 2, 3 サンプリング周波数:12 kHzまたは48 kHz 研究目的:外側レース故障の検証 ファイル命名規則: OR021_2.マット | ||
| ボールベアリング(ボール故障) | EDMによる単点故障 故障の種類とサイズ(インチ):ボール(B)@ 0.007"、0.014"、0.021"、0.028" 負荷(HP):0、1、2、3 サンプリング周波数:12 kHz または48 kHz 研究目的:ボール要素故障の検証 ファイル命名規則: B014_3.マット | ||
| <ストロング>テストリグ | |||
| 機械故障シミュレーター | モーター駆動で負荷調整可能なシステム;加速度計はベアリングハウジングに搭載されています。ケース・ウェスタン・リザーブ大学(オハイオ州クリーブランド、アメリカ合衆国) 故障の種類とサイズ(インチ):該当なし 負荷(HP):0、1、2、3 サンプリング周波数:12 kHzまたは48 kHz 研究目的:故障データセットの出所 ファイル命名規則:該当なし |