법률 텍스트의 단편화 및 의료 인공지능(AI)의 편향 추적 문제를 해결하기 위해, 본 연구에서는 법률 지식 그래프를 구축하고 시맨틱 정렬을 위해 관계 인식 그래프 합성곱(relation-aware graph convolution)을 활용하였습니다. 또한 경사 하강법 기반의 역전파를 통해 편향된 소스를 식별하였으며, 실험 지표에서 우수한 결과를 얻어 규정을 준수하는 의료 AI 애플리케이션의 적용 가능성을 뒷받침하였습니다.
이 논문에서
요약
초록
의료 인공지능(AI) 법적 준수 분석에 있어, 본 논문은 다중 소스 이기종 법률 텍스트의 의미론적 단편화와 알고리즘 편향 추적의 어려움으로 인해 발생하는 책임 결정의 모호성 문제를 다룹니다. 이를 위해 그래프 신경망 기반의 지식 그래프 구축 및 편향 전파 경로 탐지 방법을 제안합니다. 법률 조항, 의료 행위, 알고리즘 모듈, 책임 주체라는 네 가지 유형의 이기종 노드를 구조화 및 인코딩하고, "위반", "근거", "트리거", "귀속"의 네 가지 법률적 의미 관계를 기반으로 유향 그래프를 구축합니다. 다음으로, 엣지 유형별 가중치와 어텐션 메커니즘이 결합된 관계 인식 그래프 합성곱 네트워크를 사용하여 교차 모달 법률 의미론에 대한 다층 특징 정렬을 수행합니다. 이후 경사 하강법 기반의 역전파를 통해 편향에 크게 기여하는 엣지를 식별하여 편향 전파 서브그래프를 구축하고, 커뮤니티 탐색을 통해 루트 노드 클러스터를 찾아냅니다. 마지막으로, 실시간 결정 흐름을 임시 노드에 매핑하고 임베딩 유사도를 통해 준수 여부를 검증하며, 주요 엣지 가중치의 역동성을 모니터링하여 시스템적 편향 누적을 경고합니다. 실험 결과, 의미 정렬 정확도 측면에서 제안된 방법은 서로 다른 지식 그래프 밀도 구배에 걸쳐 최소 0.92의 평균 엔티티 정렬 정확도와 최소 0.88의 평균 관계 보존 완결성을 달성하였습니다. 편향 국소화 능력의 경우, 루트 노드 재현율은 0.95±±0.02에 도달하였으며, 전파 경로 정밀도는 0.93±±0.03에 도달하였습니다. 본 연구는 법률적 논리와 알고리즘 행위 간의 깊은 결합을 일정 수준 달성함으로써, 신뢰할 수 있는 의료 AI 배포를 위한 설명 가능하고 검증 가능한 준수 지원 시스템을 제공합니다.
서론
진단 및 치료 지원, 자원 할당, 위험 평가에서 의료 AI의 깊숙한 개입은 그 의사결정을 법적 책임의 가정과 결부시켰습니다1,2. 법적 규범은 매우 구조화되어 있으나 의미론적으로 분산되어 있는 반면, AI 시스템의 동작은 블랙박스 형태일 수 있어 두 영역 사이에 의미론적으로 정렬 가능하고 추적 가능한 인터페이스가 부족합니다3. 이러한 맥락에서, 알고리즘의 행동 시퀀스 내에서 법적 인과 관계 체인을 포착하는 공통 표현 프레임워크를 개발하는 것이 책임의 세분화된 귀속과 동적 준수를 실현하기 위한 필수적인 활성화 요인으로 부상했습니다4,5. 본 연구는 기술 시스템의 법적 테스트와 관련될 뿐만 아니라, 의료적 공정성, 알고리즘적 공정성 및 제도적 신뢰의 심층적인 유지를 포함하므로 이론적 중요성과 실무적 시급성이 매우 큽니다.
오늘날 의료 AI의 법적 준거성 분석에서 근본적인 문제는 법적 의미론과 알고리즘적 동작 사이의 계산 가능한 연결 구조가 부족하다는 점입니다6,7. 법률 문서는 일반 텍스트 형태로 제공되며, 단락 간의 관계는 의존성, 충돌 및 예외 사항들이 복잡하게 얽혀 있어 이를 기계가 해석할 수 있는 논리적 단위로 분할할 때 문제가 발생합니다8,9. AI 시스템의 의사 결정은 데이터 기반의 블랙박스 내에 캡슐화되어 있으며, 출력값의 변동 중 어느 것도 구체적인 법적 의무 위반이나 책임 분배를 위한 노드로 추적할 수 없습니다10,11. 이러한 단절(예: 훈련 데이터 편향, 모델 설계 결함 또는 법적 규범의 의미론적 해석)은 실험적으로 분리하여 편향의 원인을 식별하거나 개발자, 배포자 또는 사용자의 법적 의무를 명확히 하는 것이 불가능합니다12,13. 더욱 문제가 되는 것은, 기존의 컴플라이언스 절차가 최종 출력값이 고정된 사양을 충족하는지만을 확인할 뿐, "법-기술" 상호작용 네트워크 내에서 편향의 전파 경로구나 증폭 과정은 고려하지 않는다는 점입니다14,15. 의료 AI가 여러 법적 조항의 동시 적용을 받는 상황에서 특정 조항의 오해석으로 인해 일련의 오류가 발생했을 때, 기존 방식으로는 해당 오류가 다른 관련 조항을 통해 어떻게 확산되어 책임 소재로 이어지는지 추적할 수 없습니다16,17. 또한, 실시간 의사 결정 흐름과 기존의 법률 지식 그래프 사이의 동적 상관관계 메커니즘이 부족하여 시스템 운영 중 준거성 평가가 지연되며, 이로 인해 편향 축적 추세에 대한 선제적 모니터링이 불가능해집니다18,19. 이러한 문제들이 결합되어 책임 결정의 불확실성, 취약한 귀속, 규제 개입의 지연을 초래하며, 이는 고위험 헬스케어 AI 시스템의 신뢰할 수 있는 배포와 법적 책임 적용을 심각하게 저해합니다.
무엇보다도, 전통적인 연구는 법률 텍스트를 구조화된 형태로 조사하고, 온톨로지나 규칙을 통해 특정 도메인의 지식 베이스를 구축하여 준법 관련 질의응답이나 리스크 통지를 지원합니다20,21. 이러한 접근 방식은 일부 법률 개념의 표현을 포착할 수는 있지만, 법의 내부 논리가 일관되고 정적이라고 전제하는 경향이 있어 관할권 간의 불일치, 예외 사항 또는 모호한 표현을 처리하는 데 어려움이 있습니다. 이후의 연구에서는 사전 훈련된 언어 모델을 사용하는 자연어 처리 기술을 도입하여 법률 엔티티와 관계를 추출함으로써 지식 추출 범위의 폭을 넓혔으나22,23, 여전히 얕은 의미론적 수준에 머물러 있어 법률적 행위와 기술적 행위 사이의 매핑 인터페이스를 구축하지 못하고 있습니다. 알고리즘 편향 거버넌스의 경우, 연구는 주로 공정성 제약 조건의 설계에 집중해 왔으며24,25, 그 평가 지표는 대개 인구통계학적 변수에 기반하여 법적 귀속 원칙과의 정렬이 부족합니다. 일부 연구에서는 법률 규칙을 제약 조건으로 인코딩하여 모델 훈련에 내장시키려는 시도도 있었으나26,27, 규칙 표현의 경직성과 조잡한 입도(granularity)로 인해 복잡한 임상 상황에 적응하기 어렵습니다. 전반적으로 기존 연구들은 법적 준수를 시스템 아키텍처의 내재적인 계산 가능 속성이 아니라 외부 검증 작업으로 취급합니다. 그 결과 법률 논리와 알고리즘 논리가 병렬적으로 작동하게 되어, 편향 전파 경로에 대한 공동 추론과 동적 개입을 지원하지 못하고 있습니다.
최근 몇 년 동안 그래프 신경망은 관계적 구조를 명시적으로 모델링하는 능력 덕분에 의료 분야에 점진적으로 도입되어 왔습니다28,29. 일부 연구에서는 이기종 그래프를 활용하여 판례, 법률 조항 및 당사자 정보를 통합함으로써 노드 임베딩을 통한 사건 추천이나 양형 예측을 지원하며30,31, 이를 통해 법적 연결성을 포착하는 데 있어 그래프 구조의 유효성을 검증했습니다. 다른 연구들은 알고리즘 구성 요소를 그래프 노드로 추상화하고, 에지를 사용하여 데이터 흐름이나 호출 관계를 표현함으로써 오류 전파를 추적했습니다32,33. 이러한 탐색은 그래프 구조가 법적 및 기술적 요소의 공통 매개체 역할을 할 수 있음을 보여줍니다. 그러나 기존의 그래프 모델은 일반적으로 세 가지 한계를 가지고 있습니다. 첫째, 단일 유형의 에지 관계에 국한되어 법적 의미론에서의 규범적, 인과적, 귀속적 차이를 구분하지 못합니다. 둘째, 특징 집계 과정에서 에지 유형의 의미적 가중치를 무시하여 서로 다른 법적 논리 경로가 동일하게 처리됩니다. 셋째, 편향 전파에 대한 미분 가능한 추적 메커니즘이 부족하여 기여도가 높은 에지를 찾아내고 책임 경로를 재구성하는 것이 불가능합니다. 본 논문에서는 각 법적 의미 에지 유형에 전용 변환 행렬을 할당하고 교차 유형 정보 흐름을 동적으로 조정하는 어텐션 메커니즘을 도입하여 의미적 이질성 융합 문제를 해결하는 관계 인식 그래프 컨볼루션 네트워크를 구축합니다. 나아가, 기울기 역전파와 서브그래프 추출을 결합함으로써 매크로 수준의 준수 판단에서 마이크로 수준의 편향 추적으로의 해석 가능한 도약을 가능하게 하여, 정적 추론만을 지원하는 전통적인 그래프 모델의 병목 현상을 극복합니다.
의학 분야를 넘어, 그래프 기반 및 진화 방법론의 최근 발전은 구조화된 지식 처리 분야에서 광범위한 적용 가능성을 입증해 왔습니다. 예를 들어, Xue 등은 온톨로지 매칭에서 적응형 유사성 특징 구축을 위한 다층 하이브리드 유전 프로그래밍 접근 방식을 제안하여, 이기종 지식 그래프 전반에 걸쳐 견고한 정렬을 달성했습니다34. Cheng 등은 이미지 복원 분야에서의 그래프 합성곱 신경망 응용에 대한 종합적인 서베이를 제공하여 노이즈 제거, 초해상도 및 디블러링 방법을 체계적으로 분류했습니다35. Li 등은 자동화된 머신러닝의 관점에서 원리, 알고리즘, 응용 분야 및 미해결 과제를 다루는 진화 딥러닝에 관한 철저한 서베이를 제시했습니다36. Ma 등은 불확실성 하에서의 결함 인식을 위한 퍼지 신경 아키텍처 탐색 프레임워크를 개발하여, 모호한 데이터를 처리하는 데 있어 진화 탐색의 효과를 입증했습니다37. 이러한 연구들은 복잡한 의사 결정 작업을 위해 그래프 구조 표현과 진화 최적화를 통합하는 것의 잠재력을 강조합니다.
본 논문의 핵심 목적은 세 가지 수준의 혁신을 통해 의료 AI의 법적 준수 분석을 위한 엔드 투 엔드 해석 가능한 프레임워크를 구축하는 것입니다. 지식 표현 수준에서는 법적 조항, 의료 행위, 알고리즘 모듈 및 책임 주체를 네 가지 유형의 이종 노드로 모델링한 최초의 시도입니다. 법적 실무를 바탕으로 "위반", "근거", "트리거", "귀속"의 네 가지 지향성 관계를 추출하여 법적 인과 논리를 갖춘 지향성 지식 그래프를 구축함으로써 준수 분석을 위한 구조적 의미론적 토대를 제공합니다. 편향의 소스 추적 단계에서는 그래디언트 민감도 기반의 에지 기여도 정량화 방법을 제안합니다. 역전파를 통해 출력 편향을 최대화하는 에지 집합을 찾고, 커뮤니티 발견 알고리즘을 적용해 기여도가 높은 노드들을 클러스터링함으로써 "블랙박스 편향"을 "화이트박스 책임 클러스터"로 전환하며, 이를 통해 운용 가능한 증거 체인에 기반한 귀속을 가능하게 합니다. 실시간 동적 모니터링 수준에서는 실시간 AI 출력을 지식 그래프 공간으로 매핑하는 일시적 결정 노드 임베딩 메커니즘을 개발합니다. 임베딩 근접도 비교를 통해 규범 이탈 정도를 정량화하고 핵심적인 법적-기술적 에지의 가중치 변화를 모니터링하여 시스템적 편향의 축적을 알립니다. 이러한 패러다임은 의미론적 파편화와 추적 가능성의 난제를 동시에 해결하며, 법적 준수를 사후 검증에서 사전 거버넌스로 변모시켜 고위험 AI 시스템의 책임 투명성을 위한 확장 가능한 기술적 경로를 제시합니다.
프로토콜
의료 인공지능 법률 지식 그래프를 위한 그래프 신경망 구축
그림 1에서 보듯이, 제안된 프레임워크는 세 가지 주요 모듈로 구성된다. 입력 레이어는 다중 모드 엔티티 인코딩 및 방향성 엣지 모델링을 통해 다중 출처 데이터를 이질적인 그래프로 통합한다. 그런 다음 관계 인식 GCN 레이어는 유형별 가중치 및 어텐션을 통해 교차 모달 의미적 정렬을 수행하여 통합된 노드 임베딩을 생성한다. 마지막으로, 이러한 임베딩은 편향 추적(기울기 역전파 및 커뮤니티 탐지 통해)과 동적 규제 준수 모니터링(실시간 노드 매핑 및 엣지 가중치 추적 통해)을 지원하며, 출력은 규제 기관을 위한 해석 가능한 귀속 근거 및 위험 경보를 제공한다.
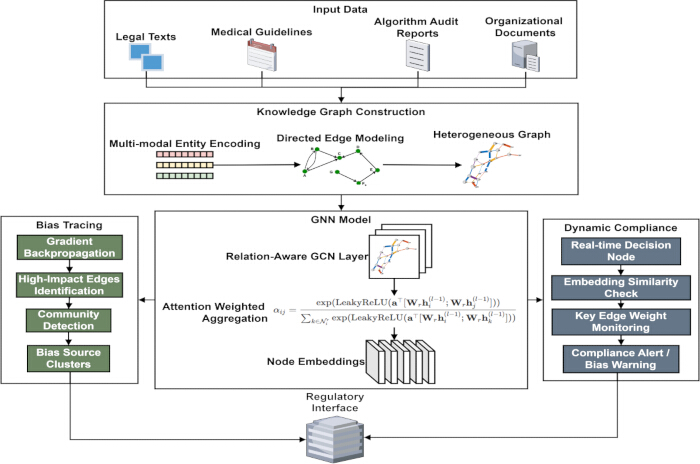
그림 1: 의료 인공지능을 위한 법적 지식 그래프 및 편향 추적 아키텍처. 이 다이어그램은 제안된 프레임워크의 전체 워크플로우를 보여준다. 입력 계층은 법적 문서, 임상 지침, 알고리즘 감사 보고서 등 다양한 출처의 이질적인 데이터를 융합하며, 이 데이터는 네 가지 엔티티 유형(법적 조항, 의료 행위, 알고리즘 모듈, 책임 주체)으로 인코딩되고 네 가지 방향성 있는 법적 의미 관계(위반, 근거, 촉발, 귀속)로 연결된다. 관계 인식 그래프 컨볼루션 네트워크(GCN) 계층은 유형별 가중치와 어텐션을 통해 다중 모달 의미 조정을 수행한다. 편향 추적 모듈은 그래디언트 역전파를 사용하여 기여도가 높은 엣지를 식별한 후, 커뮤니티 탐지를 적용하여 근본 원인이 되는 노드 클러스터를 파악한다. 동적 규제 준수 모니터는 실시간 의사결정을 임시 노드에 매핑하고, 법적 조항과의 임베딩 유사성을 평가하며, 조기 경고를 위해 엣지 가중치의 변화를 추적한다. 출력 결과로는 해석 가능한 귀속 근거와 리스크 경보가 포함된다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
법적 개체 및 관계의 이종 그래프 구조화 코딩
의료 인공지능 규제 법률, 임상 실무 지침 및 알고리즘 감사 보고서로부터 네 가지 기본 엔티티가 일관되게 도출된다: 법적 조항, 의료 절차, 알고리즘 모듈 및 책임 주체. 각 유형의 엔티티가 의미적으로 구별 가능하도록 각각 별도의 특징 표현 학습 모델을 제안한다. 법적 조항 노드는 법적 조항의 번호를 포함하도록 구성되며, 이 번호는 해당 법적 조항의 고유 ID(식별자)로 사용된다. 동시에 조항과 관련된 법적 책임의 수준을 나타내기 위해 처벌 심각도 정량화 지수를 정의하고, 이에 따라 특징 벡터를 구축한다.
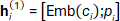 (1)
ci는 항목 번호이며, Emb(·)는 저차원 임베딩 매핑을 나타내고, [·;·]는 벡터 연결 연산을 나타낸다. 이 표현 방식은 법적 문장의 형식적 구조와 처벌의 엄격성을 모두 보존하여 문장 간 추론을 지원한다.
의료 행위 노드는 임상 절차 분류 체계에 기반하여 표준화되고 인코딩되며, 이 과정에서 위험 수준 rj ∈ {1,2,3}과 적용 가능한 시나리오 레이블 집합 sj ⊂ S를 추출한다. 여기서 S는 사전 정의된 시나리오 범주들의 전체 집합이다. 레이블 집합은 멀티-핫 인코딩 방식으로 처리되며, 위험 수준 임베딩과 연결되어 초기 표현을 형성한다:
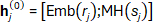 (2)
이 전략은 다양한 유형의 의료 행동이 벡터 공간에서 측정 가능한 거리 관계를 갖도록 보장하여, 다양한 시나리오 간 비교를 가능하게 한다. 텍스트 임베딩 함수 Emb(·)는 대규모 중국어 법학 말뭉치에서 사전 훈련된 중국어 법학 언어 모델 Lawformer를 사용하여 구현되며, 출력 차원은 768로 고정된다.
엔티티 간의 논리적 의존성과 법적 제약을 바탕으로 "위반", "근거", "촉발", "귀속"의 네 가지 유형의 방향성 있는 의미적 관계를 설정하며, 각각은 서로 다른 법적 인과 패턴에 대응한다. 각 엣지 eij ⊂ E는 관계 인식을 위한 후속 메시지 전달을 위해 tij ⊂ T = {violate, base, trigger, attribute}에 속하는 레이블 유형이 할당된다. 엣지 생성은 도메인 규칙 매칭 메커니즘을 엄격히 따르며, 의료 행위가 규범적 요구사항에서 벗어날 경우 해당 행위 노드에서 관련 법적 조항을 가리키는 "위반" 엣지가 생성된다. 법적 조항이 특정 조작의 기술적 준수 근거로 작용할 경우 "근거" 엣지가 설정되며, 알고리즘 모듈의 출력이 특정 의료 행위의 실행을 직접적으로 유도하는 경우 "촉발" 엣지가 연결된다. 책임 귀속 관계는 조직의 책임 문서 및 감사 결론을 기반으로 설정되며, 책임 주체와 위반 사항 또는 알고리즘 결함 사이에 "귀속" 엣지가 생성된다.
모든 노드가 초기화된 후, 이질적인 그래프(V, E, H0)가 생성되며, 여기서 V는 노드의 집합, E는 유형 레이블이 있는 방향성 엣지의 집합, H0은 초기 특징 행렬이다. 그래프 구조의 의미적 판별 능력을 향상시키기 위해 노드 특징들을 정규화한다:
 (3)
μk와 σk는 각각 훈련 데이터셋에서 k-번째 노드 특성의 평균과 표준편차이며, ∈는 0으로 나누는 것을 방지하기 위한 작은 상수이다. 정규화는 다중 출처의 이질적인 특성들이 그래프 합성곱 연산에 균일한 척도로 참여할 수 있도록 하여, 수치적 우세 효과가 의미 학습을 방해하는 것을 방지한다. 이렇게 생성된 구조적 그래프 모델은 의료 인공지능 시스템에서 법, 행동, 기술, 책임이라는 4차원 요소들의 관계적 위상 구조를 완전히 반영하며, 후속적인 편향 전파 분석을 위한 계산 가능한 그래프 기반을 제공한다.
이종 모드 법적 의미론을 위한 그래프 합성곱 정렬 강화
초기 이종 그래프의 여러 층에 걸쳐 특징을 전파하기 위해 관계 인식 그래프 합성곱 네트워크(Relation-aware graph convolutional network)38,39를 사용하는데, 이는 관계형 그래프 합성곱 네트워크(Relational Graph Convolutional Network, R-GCN) 프레임워크를 확장한 것이다. R-GCN은 일반적인 관계형 데이터에 대해 관계별 변환 행렬을 도입하지만, 본 연구에서는 이에 더해 이웃 노드의 기여도를 동적으로 가중치 부여하는 학습 가능한 어텐션 메커니즘을 추가로 통합하였으며, 의료 AI 규준 분석에 특화된 네 가지 구체적인 법적 의미 관계 유형(위반, 근거, 트리거, 귀속)을 정의하였다. 각 층의 연산은 엣지의 의미적 유형에 따라 변환 과정을 독립적으로 매개변수화한다. 임의의 대상 노드에 대해, 그 이웃 정보는 연결된 엣지의 유형별로 그룹화되고 집계된다. 각 관계 유형은 서로 다른 법적 의미 경로를 따라 전달되는 특징들을 구분하기 위해 전용 선형 변환 행렬을 갖는다40,41. 법적 조항 노드와 의료 행위 노드 사이의 엣지가 "근거(basis)" 유형인 경우, 법적 조항 노드가 의료 행위 노드로부터 메시지를 수신할 때, 해당 가중치 행렬을 적용하여 이웃의 특징을 공간적으로 매핑한다. 마찬가지로, 의료 행위 노드가 "트리거(trigger)" 유형의 엣지를 통해 알고리즘 모듈로 출력을 전송할 때는, 이 관계와 연관된 트리거 전용 매개변수 행렬이 활성화되어 특징 변환을 수행한다. 이를 통해 서로 다른 유형의 법적 논리를 모사하며, 정보 흐름 중에 의미적 독립성을 유지하면서 모달 간 잡음을 방지한다. 집계는 다음과 같이 정의된다:
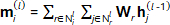 (4)
mi(l)는 레이어 l에서 노드 i가 수집한 종합적인 정보를 나타내며, Nil은 관계 r 하에서의 이웃 노드 집합이고, Wr는 선형 변환 행렬이며, hj(l−1)는 이전 레이어에서 이웃 노드의 임베딩 표현이다.
메시지 집계 과정에서 학습 가능한 주의(어텐션) 메커니즘이 도입되어, 서로 다른 이웃 노드들이 타겟 노드 표현 업데이트에 미치는 영향의 강도를 동적으로 조정할 수 있다42,43. 주의 계수는 노드 속성 유사성과 법적 중요도라는 두 가지 요인에 기반하여 생성되며, 고정된 사전 가중치에 의존하지 않는다. 법적 조항 노드의 경우, 인접한 의료 행위 특징을 수신할 때, 후자의 벌칙 강도와 관련된 정량화된 값을 기반으로 주의 점수를 계산한다. 알고리즘 모듈 노드가 의료 행위 정보를 융합할 때는 운영 리스크 수준이 더 높은 이웃 노드에 집중한다. 주의 가중치는 다음과 같은 방식으로 계산된다:
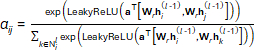 (5)
αij는 노드 j에서 노드 i로의 주의 계수이며, a는 학습 가능한 주의 벡터이다. 이 모델은 엔드투엔드 학습 과정에서 고위험 또는 고제약 연결 경로를 자동으로 식별하여 더 높은 주의를 할당할 수 있게 한다. 최종 갱신된 노드 임베딩은 가중된 메시지와 잔차 연결에 의해 결정된다.
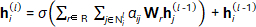 (6)
σ는 활성화 함수이며, 잔차 설계(residual design)는 깊은 전파 과정에서의 기울기 소실 문제를 완화하고 다중 의미적 충돌 상황에서도 안정성을 보장한다. L = 3의 그래프 합성곱 계층(각 계층은 256의 은닉 차원과 ReLU 활성화 함수 사용)을 거친 후, 모든 노드의 임베딩은 크로스모달 문맥 정보를 매끄럽게 통합하며 법적 의미 판별 능력을 갖춘 통합된 표현으로 변환된다.
의료 인공지능(AI)에 대한 두 가지 대체적 법적 준수 분석 다이어그램을 그림 2에 제시하였으며, 이는 법적 관계 유형과 편향 전파 경로의 시각화를 통해 의사결정의 잠재적 편향 원인을 나타내는 것을 목적으로 한다. 그림 2A는 다양한 법적 의미론적 관계의 영향을 보여주며, 여기서 네 가지 관계 유형이 색상으로 구분되어 있고, 각 유형의 엣지는 서로 다른 색으로 표시된다. 엣지의 두께는 해당 관계의 어텐션 가중치(attention weight), 즉 그 관계가 AI 의사결정에 기여하는 정도를 나타낸다. 굵은 엣지는 의사결정에서 실질적으로 지배적인 법적 관계를 의미하며, 이 경우 사건의 결과를 충분히 설명할 수 있다. 노드의 크기는 위반에 대한 기여도로 측정되며, 더 큰 노드는 특정 행위와 법적 조항 간의 관계가 더 강하고 따라서 더 높은 잠재적 위험을 의미한다. 위의 시각화는 명확한 법적 의미론적 계층을 제공하여 AI 의사결정에서 가장 강력하고 위험한 법적 경로를 식별할 수 있게 한다. 그림 2B는 또한 높은 기여도를 가진 경로(편향 전파에 대한)를 강조하여 의사결정 과정에서 기여도가 높은 엣지를 굵게 표시하고 점선으로 함께 표시함으로써(예: B1-B3) 나타낸다. 이러한 엣지의 너비가 두 배로 증가하는 것은 시스템적 편향을 전파하는 데 있어 그 중요성을 의미한다. 이러한 편향의 증폭 효과를 초래하는 법적 규칙과 기술적 행동의 조합은 그림 2에 나와 있다. 이 분석은 편향 전파 경로를 드러낼 뿐 아니라, 편향의 기원을 식별하는 데도 기여하며, 이를 바탕으로 AI 도구의 준수 감사 및 책임 소재를 명확히 할 수 있다.
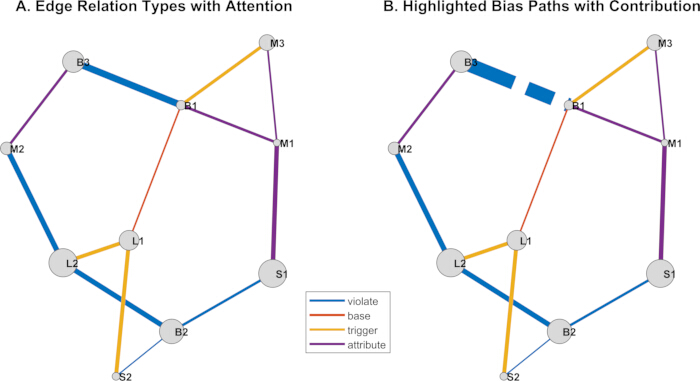
그림 2: 의료 인공지능에서의 법적 준수 및 편향 전파 분석 (예시 도해). (A) 색상으로 구분된 법적 의미 관계: 위반(빨강), 근거(파랑), 촉발(초록), 귀속(주황). 엣지 두께는 주의 집중도(attention weight)에 비례하여 각 관계가 AI 결정에 미치는 영향을 나타낸다. 노드 크기는 위반 기여도에 비례하여 위험한 엔티티를 강조한다. (B) 편향 전파 하위 그래프: 기여도가 높은 엣지는 굵게 표시되고 점선으로 표현됨(예: B1-B3); 두 배 두께의 엣지는 체계적 편향의 증폭을 나타낸다. 이 시각화는 주요 법적 경로, 편향의 기원 및 준수 감사를 식별하는 데 도움을 준다. 이는 개략도이므로 측정 척도나 오차 막대는 적용되지 않는다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
편향 전파 경로를 위한 부분 그래프 백트래킹 메커니즘
본 연구에서 "편향(bias)"은 모델의 예측 위험 점수와 정답 준수 레이블 간의 차이로 측정되는, 임상적으로 그리고 법적으로 기대되는 결정에서 인공지능 시스템 출력의 체계적인 편차를 의미한다. 편향 신호는 알고리즘의 최종 출력과 준수 여부의 이진 지표(준수 시 1, 비준수 시 0) 사이의 교차 엔트로피 손실로 정량화되며, 한 배치 내 모든 결정 사례에 대해 집계된다.
그래프 신경망이 훈련된 후, 출력 계층의 편향 신호에 대한 역전파 분석을 수행하기 위해 그 미분 가능성을 이용한다. 이상치를 탐지하는 알고리즘 결정 노드를 시작으로 하여, 각 연결 엣지에 대한 손실 함수의 기울기 크기를 계산하여 해당 엣지가 편향 형성에 기여한 정도를 정량화한다. 이 과정은 자동 미분 프레임워크를 통해 구현되며, 그래프 구조 내의 방향성 엣지를 따라 계층적으로 역추적함으로써 각 엣지 파라미터 변환이 최종 출력 변화에 미치는 영향 강도를 산출한다. 기울기의 절댓값이 높을수록 해당 엣지가 전달하는 법적-기술적 관계가 편향 전파에서 더 지배적임을 의미한다. 엣지의 기여도는 다음과 같이 정의된다.
 (7)
Lbias는 편향된 행동에 대해 정의된 미분 가능한 손실이며, wi는 엣지 유형에 대응하는 엔트리 가중치 벡터이다. 이 기울기 값은 특정 의미 관계가 현재 연관 편향에 기여하는 정도를 반영한다. 모든 엣지를 이러한 방식으로 점수화한 후, 기여도가 gij > τ을 초과하는 높은 기여도를 가진 엣지 집합 Ehigh를 필터링하기 위해 동적 임계값 τ를 설정하여 초기 편향 전파 서브그래프 Gbias = (Vbias, Ehigh)를 구성한다. 구체적으로, τ는 각 훈련 에포크에서 모든 엣지에 걸친 절대 기울기 값의 85번째 백분위수로 결정되며, 이를 통해 서브그래프 구성 시 가장 영향력 있는 상위 15%의 엣지만이 유지되도록 한다. 이 서브그래프는 체계적인 편향을 유도할 가능성이 가장 높은 핵심 연결 경로에 집중함으로써 탐색 공간을 압축하고 원인 추적의 효율성을 향상시킨다.
구축된 편향 전파 서브그래프 내에서 스펙트럴 클러스터링 기반의 커뮤니티 탐지 알고리즘을 실행하여 높은 일관성을 갖는 노드 클러스터 구조를 식별한다. 이 과정은 서브그래프의 정규화된 라플라스 행렬 분해를 기반으로 하며, 노드 임베딩을 저차원 스펙트럴 공간으로 매핑한 후, 이 공간에서 밀도 인식 클러스터링 전략을 적용하여 기능적으로 밀접하게 관련된 경우 크로스 유형 노드(예: 법률 조항 및 알고리즘 모듈)가 동일한 클러스터에 그룹화되도록 한다. 각각의 식별된 커뮤니티는 잠재적인 기능 루프 또는 책임 집약 단위를 나타낸다. 커뮤니티 분할 결과는 다음 최적화 목적에 의해 결정된다.
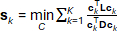 (8)
L=D−A는 부분 그래프의 라플라시안 행렬이며, A는 인접 행렬, D는 차수 행렬, ck는 k-번째 커뮤니티의 지시 벡터, K는 사전 설정된 커뮤니티의 수이다. 이 기준은 커뮤니티 간 최소 컷의 차이를 최대화하여 내부 연결을 더욱 견고하게 한다.
이제 각 커뮤니티에 대해 계층 간 복합 기반 분석을 수행한다. 커뮤니티가 법적 조항 노드와 알고리즘 모듈 노드를 모두 포함하는 경우, 편향의 잠재적 원천으로 분류한다. 인과관계를 검증하기 위해 개입 테스트를 실시하는데, 이 영역의 모든 엣지를 일시적으로 그래프에서 제거한 후 동일한 의사결정 과정을 다시 실행하고 편향 측정값의 차이를 확인한다. 인과적 타당성 측정값은 다음과 같이 정의된다.
 (9)
Borig와 Bmask는 각각 원래 모델의 편향 강도와 마스킹 후의 편향을 나타낸다. 인과적 타당성 측정값이 미리 정해진 임계값보다 상당히 높은 경우, 해당 노드 클러스터가 설명 가능한 편향의 원천으로 식별되었음을 의미하며, 이는 이후의 규정 준수 교정 및 오류 귀속을 안내할 것이다.
법적 제약 조건의 동적 적합성 검증
의료 AI 시스템의 운영 중 발생하는 실시간 의사결정 사례는 일시적 노드로 도입되어 학습된 지식 그래프 공간에 내장된다. 각 노드는 입력 맥락, 출력 동작 및 알고리즘의 상태를 읽어 초기 특징 벡터를 생성한다. 그런 다음 이 벡터는 파라미터가 고정된 그래프 신경망에 입력되어 단일 계층의 순방향 전파를 수행하며, 원래의 그래프 구조를 변경하지 않으면서 지식 그래프와 정렬된 임베딩을 생성한다. 이를 통해 일시적 노드와 법적 조항 노드를 공통의 의미적 공간에서 비교할 수 있게 된다.
그런 다음 일시적 노드와 각 법조항 노드 간의 코사인 유사도를 계산합니다:
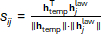 (10)
htemp는 임시 노드의 임베딩이며, hjlaw는 j번째 법적 조항 노드의 임베딩이다. 유사도 값은 현재 결정과 각 법적 제약 간의 의미적 일치 정도를 사실상 반영한다. 동적 준수 임계값 θ는 다양한 적용 시나리오에서 판단 경계를 조정하기 위해 과거 준수 사례들의 유사도 분포를 기반으로 설정된다. 구체적으로, θ = µ - 2σ이며, 여기서 µ와 σ는 500개의 알려진 준수 결정 사례로 구성된 검증 세트로부터 계산된 코사인 유사도 분포의 평균과 표준편차이다.
코사인 유사도 점수가 동적 준수 임계값 아래로 떨어질 경우, 해당 법의 지배 원칙이 위반된 것으로 간주되며, 이는 준수 알림 메커니즘을 작동시킨다. 알림에는 최소 일치 법률 조항 번호, 유사도 값 및 분기 분석의 방향도 포함되어 있어, 규제 기관이 신속하게 조치를 취하기에 충분하다. 이 접근법은 불투명한 의사결정에서 법적 의미 영역으로의 해석 가능한 매핑을 제공하며, 실시간 준수 점검을 용이하게 한다.
연속 작동 중 편향 전파 하위 그래프 내 주요 법적-기술 연결 엣지의 가중치 변화 추세를 추적한다. 알고리즘 모듈 노드와 법적 조항 노드를 연결하는 엣지에 주목하는데, 이는 기술적 행동이 특정 규제에 대해 나타내는 반응 강도를 직접적으로 나타내기 때문이다. 각 대상 엣지에 대한 변환 행렬 파라미터는 추론 과정에서 기록되며, 이 파라미터의 노름(norm)을 두 요소 간 상관 강도의 진화를 나타내는 동적 지표로 추출한다. 엣지 강도 수열을 다음과 같이 정의한다:
 (11)
wt는 시간 지점 t에서 엣지 eij와 관련된 가중치 행렬의 프로베니우스 노름(Frobenius norm)을 나타내며, Wkl(t)는 해당 시간에 모델에서 실제로 사용되는 매개변수 행렬이다. 이 지표는 모델의 학습 깊이 또는 법적 제약 조건에 대한 의존도를 반영한다.
시퀀스에 대해 슬라이딩 윈도우 단조성 검사를 수행하고 개선된 부호 검정을 사용하여 유의미한 상승 추세가 나타나는지 여부를 판단한다. N개의 연속된 시간 단계에서의 증분이 양의 지배 조건을 만족하는 경우, 해당 엣지는 비정상적인 강화 현상을 나타내는 것으로 간주한다. 역사적 그래디언트 기여도 데이터를 추가로 결합하여, 해당 엣지가 이전 소스 추적 분석 라운드에서 영향도가 높은 경로로 식별된 경우, 시스템적 편향 축적 조기 경고 과정을 시작한다.
마지막으로 대상 엣지의 양 끝에 있는 노드 정보, 가중치 변화 곡선, 관련 결정의 빈도 통계 및 잠재적 귀속 권고 사항을 포함하는 출처 추적 보고서가 생성된다. 이 메커니즘은 정적 규제 준수 판단에서 동적 위험 예측으로의 전환을 실현하여 잠재적 기관 편차에 대한 선제적 개입을 지원한다.
실험 데이터 및 설계
제안된 프레임워크의 효과를 검증하기 위해, 본 논문은 실제 규제와 시뮬레이션 데이터를 통합한 다중 출처의 이질적 데이터셋을 구성하고 엄격한 통제 실험을 설계한다. 데이터 출처는 국가 의료 인공지능 규제 규정, 임상 치료 지침, 오픈소스 알고리즘 감사 보고서 및 시뮬레이션 의사결정 로그를 포함한다. 전처리 후, 285개의 노드(85개 법적 조항, 120개 의료 행위, 42개 알고리즘 모듈, 38개 책임 개체)와 1247개의 방향성 엣지를 포함하는 벤치마크 이질적 지식 그래프를 구성하였으며, 이는 그림 3에 나타내었다.
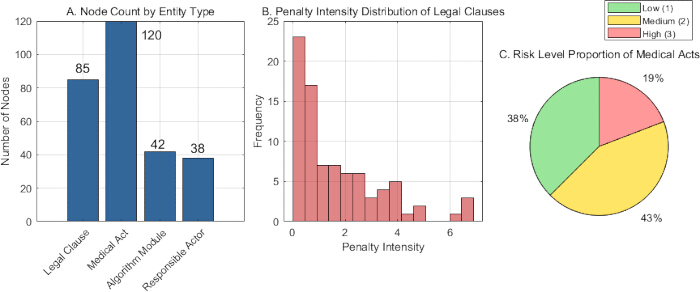
그림 3: 이질적인 엔터티 유형의 분포 및 특성. (A) 각 엔터티 유형별 노드 수를 보여주는 막대 그래프: 법적 조항(85), 의료 행위(120), 알고리즘 모듈(42), 책임 당사자(38). (B) 법적 조항 노드의 제재 강도 히스토그램으로, 낮음(0‑0.33), 중간(0.34‑0.66), 높음(0.67‑1.0) 범주로 구분; 세로축은 빈도를 나타냄. (C) 의료 행위 노드 내 위험 수준 분포를 나타내는 원형 차트: 낮음(19%), 중간(43%), 높음(38%). 모든 값은 절대 빈도 또는 백분율이며, 오차 막대는 없음. 이는 데이터셋의 기술 통계이기 때문임. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
그림 3은 이질적 지식 그래프 내 엔티티 노드의 분포와 특성을 보여준다. 그림 3A는 네 가지 유형의 엔티티 노드 수 분포를 나타내며, "의료 행위" 노드가 가장 많고(120개), 다음으로 "법적 조항"(85개)이 뒤를 따르며, "알고리즘 모듈"(42개)과 "책임 주체"(38개)는 상대적으로 적다. 이는 그래프가 행위와 규칙을 기반으로 구조적으로 설계되었기 때문이다. 그림 3B는 고유한 법적 조항을 나타내는 노드의 처벌 강도 분포를 보여주며, 여기서 강도는 법적 책임의 심각성을 측정한다. 데이터는 높은 처벌 강도를 가진 조항이 상대적으로 적고 대부분 중간에서 낮은 강도 범주에 속한다는 것을 나타내며, 이는 현실 세계의 법적 체계에서 심각한 위반 조항이 소수에 불과하다는 현실과 일치한다. 그림 3C는 의료 행위 노드 내 위험 수준 분포를 보여주며, 중간 위험 행위가 43%로 가장 높은 비중을 차지하고, 낮은 위험 행위는 19%로 가장 낮은 비중을 보인다. 이는 의료 시나리오가 일반적으로 운영되며, 고위험 작업은 그래프 내에서 더욱 엄격한 연관 제약을 받는다는 것을 나타낸다. 이러한 통계들은 지식 그래프 구축 시 채택된 엔티티 모호성 해소 인코딩 방식의 타당성을 입증하며, 후속 그래프 합성곱 정렬을 위한 특징 지원을 제공한다.
전체 데이터셋은 노드 유형과 관계 분포에 따라 계층화하여 훈련(70%), 검증(10%), 테스트(20%) 세트로 무작위로 분할하였으며, 각 분할에서 전체 그래프 구조가 유지되도록 하였다. 모든 기준 방법에 대해 공정한 비교를 보장하기 위해 동일한 분할 방식을 일관되게 사용하였다. 이 기본 분할 외에도, 위에서 설명한 세 가지 지식 그래프 밀도 기울기(희소, 중간, 밀집)와 세 가지 관할권 간 복잡성 설정(단일, 양자, 다자)이 독립적인 실용적 실험 환경으로 활용되며, 데이터 완전성과 규제 중복 조건의 변화 하에서 제안 방법의 강건성을 종합적으로 평가한다. 편향 위치 파악 평가를 위한 정답 레이블을 구성하기 위해 두 단계 전략을 채택하였다. (1) 전문가 주석: 세 명의 법학 및 의학 전문가가 독립적으로 의사결정 기록을 검토하고 기록된 모든 규제 준수 위반 사례에 대해 근본 원인 노드와 전파 경로를 식별하였으며, 의견 충돌은 다수결로 해결하였다. (2) 시뮬레이션 기반 주입: 통제된 테스트를 위해 무작위로 선택한 20개의 의사결정 경로에 인위적으로 편향 신호를 주입하였으며, 이는 지식 그래프 내 엣지 가중치를 조작함으로써 수행하였고, 실제 원인 노드와 영향을 받은 엣지를 사전에 명확히 알 수 있도록 하였다.
모든 기준 방법(TransE, ComplEx, 그래프 신경망(GNN) 익스플리네이터, KG-BERT 및 Node2Vec)에 대해 공정한 비교를 보장하기 위해 동일한 훈련 설정(Adam 옵티마이저, 학습률 1 × 10⁻³, 배치 크기 64, 100 에포크)과 제안한 방법과 동일한 데이터 분할을 사용하였다. TransE와 ComplEx의 경우 임베딩 차원을 256으로, 마진을 1.0으로 설정하였으며, KG-BERT의 경우 사전 훈련된 BERT-base 모델을 사용하고 배치 크기는 16, 최대 시퀀스 길이는 128로 설정하였다. GNNExplainer의 경우 은닉 차원이 256인 3층 GCN을 사용하였으며, Node2Vec의 경우 워크 길이를 80, 노드당 워크 수를 10, 임베딩 차원을 256으로 설정하였다.
공정한 비교를 보장하기 위해 모든 기준 방법을 동일한 편향 위치 파악 과제들, 즉 루트 노드 식별과 전파 경로 재구성에 맞게 조정하였다. TransE, ComplEx, Node2Vec의 경우 본래 설명 가능하지 않으므로, 각 노드 임베딩에 대한 편향 손실의 기울기를 계산하고, 기울기의 크기를 노드 중요도 점수로 사용하였다. 루트 노드는 이러한 점수들을 임계값 처리하여 선택하였으며, 전파 경로는 기울기 기여도가 가장 높은 엣지만을 유지하여 재구성하였다. GNNExplainer의 경우, 내장된 엣지 중요도 및 노드 마스크 메커니즘을 직접 활용하여 루트 노드와 부분 그래프를 모두 추출하였다. KG-BERT의 경우, 삼중항에서 작동하므로 각 그래프 엣지를 텍스트 삼중항으로 변환하고, 엔티티에 대한 모델의 어텐션 가중치를 이용하여 노드 중요도를 도출한 후, 동일한 임계값 처리 전략을 통해 경로를 재구성하였다. 이러한 조정을 통해 모든 기준 방법이 루트 노드 예측과 전파 경로 예측을 모두 생성하게 되어, 모든 방법에 걸쳐 일관된 평가가 가능해졌다.
평가의 중심은 의미적 정렬의 정확성, 편향의 위치 파악 능력, 책임성의 효율성, 그리고 다양한 분야에 걸친 일반화 능력이라는 네 가지 핵심 역량에 집중된다. 또한 실제 세계의 복잡성을 모방하는 세 가지 중요한 통제 변수를 제시한다.
1) 지식 그래프 밀도 기울기: 정보의 다양하고 완전한 수준에서 해당 방법의 성능을 평가하기 위해, 기준이 되는 전체 그래프(밀도 D = 1.0)로부터 무작위로 엣지를 제거하는 전략을 기반으로 두 개의 부분집합을 생성한다.
희소 그래프(D ~ 0.3): 전체 엣지의 30%만 무작위로 유지하여, 많은 정보가 누락된 초기 지식 구축 단계를 시뮬레이션한다.
중간 밀도 그래프(D ~ 0.6): 엣지의 60%가 무작위로 유지되어 부분적으로 알려진 지식 구조의 전형적인 상황을 시뮬레이션한다.
밀집 그래프(D = 1.0): 상대적으로 완전한 지식의 최상의 시나리오에 해당하는, 모든 1247개의 엣지를 사용함.
2) 의료용 AI 의사결정 빈도 상황: 동적 규제 준수 모니터링의 실시간 성능을 테스트하기 위해 세 가지 인공 의사결정 흐름 부하를 설정한다:
낮은 주파수 10 Hz: 평균적으로 초당 10회의 결정 이벤트가 생성되어 소규모 또는 단일 장소 시스템의 모니터링을 시뮬레이션한다.
중간 주파수 50 Hz: 지역 또는 중규모 의료기관의 AI 시스템 부하를 시뮬레이션하기 위해 초당 50회의 결정 이벤트.
고주파 100 Hz: 초당 100회의 결정 이벤트는 대형 병원이나 클라우드 플랫폼에 배포되는 AI 서비스의 높은 동시성 부하 상황을 시뮬레이션한다.
3) 관할권 간 복잡성 기울기: 법적 제약 모델링의 이전 가능성을 검증하기 위해 세 가지 복잡성 기반 테스트 세트를 구성하였다:
단일 관할권: 의료 인공지능을 규제하는 현재의 중국 법률 및 규정만으로 구성된다.
양자 관할권: 중국과 유럽연합의 규제 체계를 포함하며, 규정의 약 15%가 서로 충돌하고 중복된다.
다자간 관할권: 처음 두 가지를 기반으로 하여 미국 HIPAA(건강 보험 이동성 및 책임 보장법, Health Insurance Portability and Accountability Act)의 개인정보 보호 및 보안 규정을 추가로 통합하여, 세 가지 법적 체계가 얽히는 시험 환경을 조성함으로써 규칙 간 충돌 비율을 약 25%까지 높인다.
정량적 평가를 위해 다음의 주요 지표들이 사용되었다:
1) 의미적 정렬 정확도: 법적 및 기술적 엔티티 간의 관계를 그래프가 모델링하는 능력을 측정함.
엔티티 정렬 정확도:
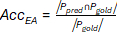 (12)
Ppred는 모델이 예측한 정렬된 엔티티 쌍의 집합이며, Pgold는 전문가가 주석을 단 정답 정렬 쌍의 집합이다.
관계 보존 무결성:
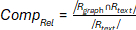 (13)
Rgraph는 그래프에서 재구성된 관계의 집합이며, Rtext는 원래의 법적 문서에서 추출된 명시적 관계의 집합이다.
2) 편향 위치 파악 능력: 편향의 근본 원인과 전파 경로를 추적하는 효과성 평가.
루트 노드 리콜률:
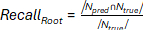 (14)
Npred는 모델이 식별한 편향 소스 노드 집합이며, Ntrue는 전문가가 레이블을 지정한 실제 소스 노드 집합이다.
전파 경로 정확도:
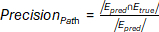 (15)
Epred는 모델에 의해 추론된 편향 전파 서브그래프의 엣지 집합이며, Etrue는 실제 편향 전파 엣지 집합이다.
3) 책임 추적 효율성: 실시간 모니터링 시나리오에서 시스템의 성능을 테스트한다.
평균 추적 지연 시간:
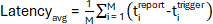 (16)
M은 총 요청 수를 나타내며, titrigger와 tireport는 각각 i번째 편향 트리거 및 원본 보고서 생성 시점의 타임스탬프이다.
시스템 처리량:
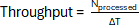 (17)
N처리됨는 시간 창 ΔT 내에서 성공적으로 처리된 동시 추적 요청의 수를 나타낸다.
4) 교차 도메인 일반화 능력: 다양한 법체계에 대한 방법의 적응성을 검증함.
관할 범위:
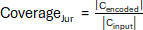 (18)
Cencoded는 그래프에 성공적으로 인코딩된 서로 다른 관할 조항의 수를 나타내며, Cinput는 입력된 조항의 총 수를 나타낸다.
제약 조건 충돌 감지율:
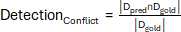 (19)
Dpred는 모델이 탐지한 법적 논리 모순의 집합이며, Dgold는 전문가가 주석을 단 모든 모순 쌍의 집합이다.
모든 실험은 멀티코어 프로세서와 그래픽 처리 장치(GPU)가 장착된 워크스테이션을 사용하여 수행하였으며, 전체 하드웨어 사양은 재료 목록 표에 제시되어 있다.
표 1에는 모델 구조와 훈련 설정뿐 아니라 임베딩 차원, 합성곱 층 수, 학습률, 배치 크기와 같은 중요한 임계값까지 포함하여 본 접근 방식의 주요 하이퍼파라미터와 그 값들이 나열되어 있다. 모든 파라미터는 그리드 탐색을 통해 검증 세트를 기준으로 조정되었으며, 훈련된 모델은 안정적으로 수렴하였고 성능이 최적이다. 일부 임계값은 의료용 AI 준수 점검의 높은 신뢰성 요구 조건을 충족하기 위해 도메인 기준과 함께 설정되었다.
| 매개변수 | 값 | 설명 |
| 임베딩 차원 | 128 | 노드 임베딩의 특징 차원 크기 |
| 합성곱 층 수 | 3 | 관계 인식 그래프 합성곱 네트워크의 깊이 |
| 학습률 | 0.001 | Adam 옵티마이저의 초기 학습률 |
| 배치 크기 | 32 | 한 배치당 처리되는 서브그래프의 수 |
| 드롭아웃 비율 | 0.1 | 훈련 중 노드 특징에 적용되는 드롭아웃 확률 |
| 어텐션 헤드 수 | 8 | 멀티헤드 어텐션 메커니즘의 헤드 수 |
| L2 정규화 계수 | 5 × 10⁻⁴ | 파라미터 정규화를 위한 가중치 감소 계수 |
| 유사도 임계값 | 0.75 | 준수 검증을 위한 최소 임베딩 유사도 |
| 기울기 기여도 임계값 | 0.01 | 편향 서브그래프 구성 시 높은 영향도를 갖는 엣지 선택을 위한 임계값 |
| 모니터링 윈도우 크기 | 10 | 엣지 가중치 동향 추적에 사용되는 시간 단계 |
표 1: 주요 매개변수 설정. 실험에서 사용된 주요 하이퍼파라미터 목록: 임베딩 차원(256), GCN 층 수(3), 은닉 차원(256), 학습률(1 × 10⁻³), 배치 크기(64), 어텐션 벡터 차원, 엣지 기여도 임계값(그래디언트 크기의 85번째 백분위수), 동적 적합성 임계값(µ‑2σ, 여기서 µ와 σ는 500개의 적합한 사례로 구성된 검증 세트에서 계산됨), 커뮤니티 수 K(스펙트럴 클러스터링에 의해 결정됨), 그리고 최적화기(Adam). 이러한 값들은 검증 세트를 대상으로 그리드 탐색을 통해 선정되었다.
결과
의료 AI 법률 지식 그래프 내 편향 기원 추적의 성능 검증
관계 인식 그래프 컨볼루션의 성능
관계 인식 그래프 컨볼루션 네트워크(relation-aware graph convolutional network)를 학습시켜, 서로 다른 컨볼루션 층에 걸쳐 법적 조항과 의료 행위 노드 간의 임베딩 유사도를 계산하고 각 층의 정렬 효과를 기록하였습니다. 둘째로, 학습 후 네 가지 법적 의미 관계에 할당된 어텐션 가중치를 통계적으로 분석하여 특징 집계(feature aggregation)에서 각 관계 유형의 중요도를 정량화하였습니다. 마지막으로, 거리에 따른 이웃 노드 영향력의 감쇠 패턴을 분석하였습니다. 서로 다른 홉(jump) 거리의 노드가 중심 노드의 특징 업데이트에 기여하는 정도를 계산하여 영향력 전파 강도를 정량화하고, 메시지 전달 메커니즘의 유효 범위를 평가하였습니다. 전체 평가 과정은 결과의 객관성과 재현성을 보장하기 위해 모델의 내부 파라미터와 활성화 상태에 대한 정량적 분석을 기반으로 수행되었습니다.
그림 4는 교차 모달 법률 의미론적 정렬에서 관계 인식 그래프 합성곱 네트워크의 성능을 보여줍니다. 그림 4A는 합성곱 층의 수가 증가함에 따라 노드 임베딩 유사도의 추이를 나타내며, 층 1의 0.12에서 층 4의 0.68까지 점진적으로 증가합니다. 이러한 점진적인 경향은 다층 메시지 전달을 통해 법률 조항 공간과 의료 행위 공간이 점차 공존하게 되기 때문입니다. 심층 합성곱 층은 교차 모달 의미론적 연관성의 복잡한 패턴을 학습할 수 있습니다. 네 가지 유형의 법률 의미론적 관계에 대한 어텐션 가중치 분포를 보여주는 그림 4B에서 "위반(violation)" 관계가 0.35로 가장 큰 가중치를 갖습니다. 이는 모델이 적절한 리스크 제어를 지원하기 위해 위반과의 연관성에 주목한다는 점에서 법률 준수 분석의 기본 원칙과 일치합니다. 그림 4C는 이웃 노드의 멀티홉 영향력 누적 패턴을 보여줍니다. 측정된 영향력 강도는 1홉의 0.15에서 8홉의 0.92까지 단조 증가하며, 이는 중심 노드의 임베딩이 먼 노드로부터의 더 광범위한 구조적 정보를 점진적으로 통합함을 나타냅니다. 이러한 예상치 못한 증가는 실제로는 중심 노드가 먼 노드에 대해 가지는 간접적인 의존성을 포착한 것입니다. 노드를 더 큰 홉 거리에서 바라볼 때, 더 많은 노이즈와 중복 정보와 함께 더 전역적인 구조적 정보를 얻을 수 있습니다. 따라서 실제 응용에서는 수용 영역(receptive field)의 크기와 정보의 품질 사이에서 적절한 균형을 맞출 필요가 있습니다. 전체 데이터 변환 과정은 관계 인식 메커니즘이 이기종 법률 텍스트와 기술적 행위 간의 연결을 처리하는 데 효과적이며, 차별화된 인자 설계를 통해 법률 의미론을 정확하게 모델링할 수 있음을 입증했습니다.
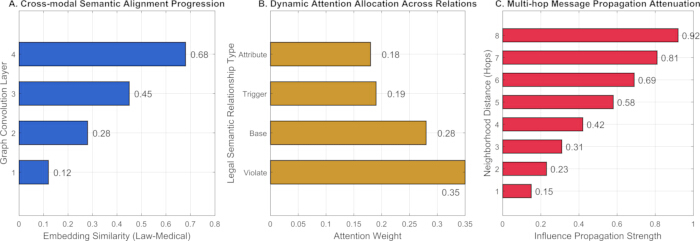
그림 4: 관계 인식 그래프 합성곱 네트워크의 교차 모달 의미론적 정렬 성능.(A) GCN 레이어 수(1~4)에 따른 노드 임베딩 유사도(코사인 유사도)로, 법률 및 의료 행동 공간 간의 정렬이 증가함을 보여줌. (B) 네 가지 관계 유형(위반, 근거, 트리거, 귀속)에 따른 어텐션 가중치 분포이며, 위반(violation)이 가장 높은 가중치(0.35)를 나타냄. (C) 홉 거리(1~8)에 따른 이웃 노드의 영향력 강도로, 멀티 홉 구조 정보가 어떻게 축적되는지를 정량화함. 모든 값은 30회의 독립적인 실행 결과의 평균치이며, 명확성을 위해 생략된 오차 막대의 표준 편차는 모든 경우에서 0.05 미만이었고 추세는 단조적임. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
관계 인식 그래프 합성곱 네트워크(relation-aware graph convolutional network)에서 파라미터 최적화 과정과 다양한 유형의 법률적 의미 관계에 따른 성능 특성을 이해하기 위해, 파라미터 최적화를 통한 관계 유형별 가중치 행렬의 평균 크기를 계산하였으며, 역전파(backpropagation)를 통해 파라미터 학습이 수렴했음을 확인하였습니다. 특징 집계(feature aggregation) 품질의 경우, 코사인 유사도를 사용하여 교차 유형 노드 임베딩의 일관성을 평가하였습니다. 수렴 속도는 각 학습 라운드에서 손실 함수의 감소량으로 계산하여, 학습 과정 동안 각 관계 유형이 안정적으로 유지됨을 보장하였습니다. 어텐션 안정성은 서로 다른 학습 단계에서의 어텐션 가중치 표준 편차를 계산하여 평가하였습니다. 계산 효율성 지표는 비교의 공정성을 위해 부동 소수점 연산 횟수를 기준으로 표준화하였습니다. 모든 지표는 통계적 유의성을 확보하기 위해 동일한 테스트 세트에서 서로 다른 무작위 시드(random seed)를 사용하여 30회 실행하였습니다. 제안 방법과 각 베이스라인 간의 쌍별 비교를 위해 자유도 29의 대응 표본 t-검정(paired t-tests)을 수행하였습니다.
그림 5는 관계 인식 그래프 합성곱 네트워크(relation-aware graph convolutional network)에서 다양한 법적 의미 관계의 파라미터 최적화 효과와 성능 특성을 보여줍니다. 그림 5A는 네 가지 관계 유형에 대한 전용 가중치 행렬의 크기 분포를 나타내며, 세로축은 관계 유형을, 가로축은 학습된 파라미터 행렬의 크기 값을 나타냅니다. "violation" 관계는 0.78로 가장 높은 크기 값을 기록했으며, 이는 해당 의미 유형이 모델을 지배하며 법적 준수 분석에서 위반 식별을 강조하고 있음을 나타냅니다. 그림 5B는 서로 다른 관계 유형에 따른 특징 집계 품질 점수를 비교한 것으로, 세로축은 관계 유형을, 가로축은 집계 효과 점수를 나타냅니다. 이는 "violation" 관계가 특징 융합 품질(0.89)에서도 가장 우수한 성능을 보임을 보여줍니다. 그림 5C는 다양한 관계의 수렴 속도 성능을 묘사하며, 세로축은 관계 유형을, 가로축은 훈련 라운드당 손실 감소율을 나타냅니다. violation, base, trigger, attribution 순의 값은 각각 0.023, 0.031, 0.028, 0.035입니다. 그 결과 "attribution" 관계는 수렴 속도가 더 느리지만 안정적인 상태를 유지하는 것으로 나타났습니다. 그림 5D 는 훈련의 세 단계에 걸친 어텐션 가중치의 분산을 보여줍니다. y축은 훈련 단계(초기, 중기, 후기)를 나타내며, x축은 왼쪽에서 오른쪽으로 어텐션 가중치의 분산을 나타냅니다. 해당 수치는 0.18(초기), 0.12(중기), 0.08(후기)이며, 이는 모델이 훈련 과정 동안 중요한 관계에 대한 집중도를 점진적으로 안정화하고 있음을 나타냅니다. 그림 5E는 서로 다른 관계에 대한 계산 효율성의 트레이드오프를 보여줍니다. y축은 관계 유형에 해당하고 x축은 정규화된 실행 시간에 해당하며, 이는 특정 작업을 완료하기 위한 계산 리소스 사용량으로 정의됩니다. 수치는 0.42(violation), 0.39(base), 0.43(trigger), 0.38(attribution)입니다. 클래스 간의 분포가 균형 잡혀 있어, 관계 인식 메커니즘이 성능 저하 없이 효율적인 리소스 할당을 수행하고 있음을 나타냅니다.
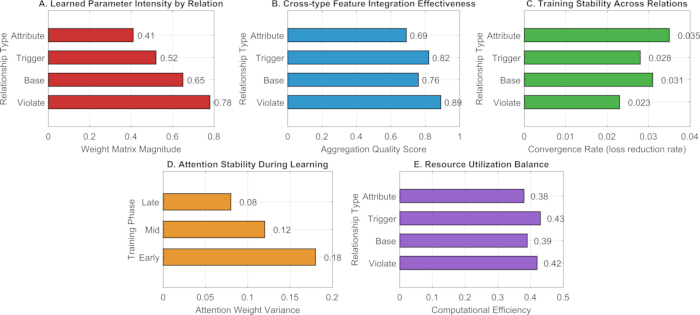
그림 5: 컨볼루션 파라미터 최적화 및 관계 인식 그래프의 성능 분석. (A) 각 관계 유형별 전용 가중치 행렬의 크기(Frobenius norm). (B) 관계 유형별 특성 집계 품질 점수(코사인 유사도 일관성). (C) 관계 유형별 수렴 속도(훈련 에포크당 손실 감소량). (D) 훈련 초기, 중기, 후기 단계에 걸친 어텐션 가중치의 분산으로, 안정화 과정을 보여줌. (E) 관계 유형별 정규화된 실행 시간(상대적 계산 비용). 모든 지표는 30회 실행의 평균값이며, 오차 막대는 표준 편차를 나타냄(보이는 경우에 한함). 위반 관계(violation relation)가 가장 높은 크기와 집계 품질을 보이며, 속성 관계(attribution)는 수렴 속도는 더 느리지만 안정적으로 유지됨. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
의미론적 정렬 정확도
개체 정렬 정확도와 관계 보존 무결성이 핵심 지표로 사용되었습니다. 지식 그래프 밀도 구배(희소/중간/밀집) 조건 하에서 제안된 방법을 TransE, ComplEx, GNNExplainer, KG-BERT 및 Node2Vec과 비교하였습니다. 모든 방법은 30회 반복 실행되었으며, 무작위성의 영향을 제거하기 위해 평균값과 표준 편차를 산출하였습니다.
그림 6 제안된 방법과 여러 벤치마크 방법의 성능을 서로 다른 지식 그래프 밀도 조건에서 두 가지 핵심 지표인 엔티티 정렬 정확도와 관계 보존 무결성을 기준으로 비교하여 보여줍니다. 그림 6A 및 6B가로축은 서로 다른 방법론을 나타내며, 세로축은 각각 개체 정렬 정확도와 관계 보존 무결성을 나타냅니다.
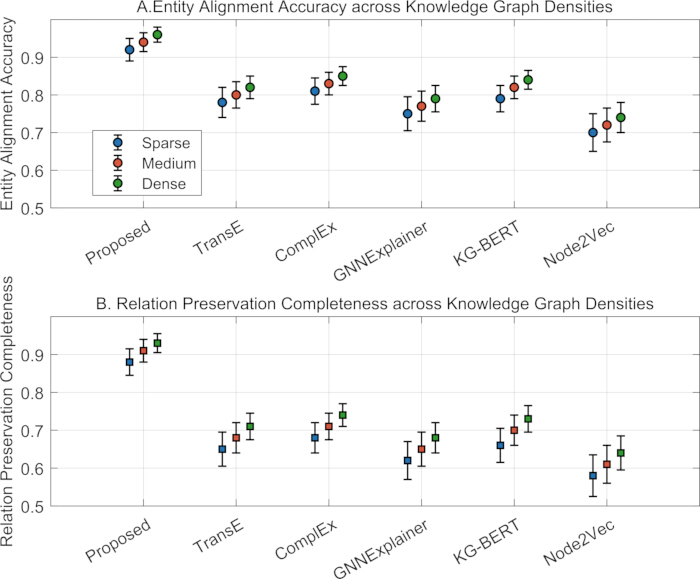
그림 6: 서로 다른 그래프 밀도에서의 시맨틱 정렬 성능. (A) 엔티티 정렬 정확도 (식 12) 및 (B) 관계 보존 무결성 (식 13)을 통해 제안된 방법과 TransE, ComplEx, GNNExplainer, KG‑BERT, Node2Vec을 비교함. 막대 높이는 30회 실행의 평균값을 나타내며, 오차 막대는 표준 편차를 나타냄. 제안된 방법은 모든 밀도에서 최소 0.92의 정확도와 0.88의 무결성을 달성하여 모든 베이스라인 모델보다 우수한 성능을 보임. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
개체 정렬 정확도 관점에서 볼 때, 제안된 방법은 다양한 밀도 조건에서 매우 우수한 성능을 보였으며, 평균 개체 정렬 정확도가 0.92 이상으로 나타나 특히 밀집 그래프에서 최고 수준에 도달했습니다. 이는 구축된 관계 인식 그래프 합성곱 네트워크가 이기종 노드 간의 의미적 연관성을 효과적으로 포착할 수 있으며, 엣지 유형별 가중치와 어텐션 메커니즘을 통해 교차 모달 특징의 효과적인 정렬을 달성했음을 나타냅니다. 반면, 기존 방법, 특히 TransE와 Node2Vec은 법률적 의미 관계에 대한 명시적 모델링이 부족하여 성능이 더 낮게 나타났습니다. 제안된 접근 방식의 우수성은 관계 보존 무결성 결과로도 검증되었으며, 평균 관계 보존 무결성이 0.88 이상으로 나타나 다양한 그래프 밀도에서 원본 법률 텍스트의 명시적 관계를 잘 재구성할 수 있음을 보여주었습니다. 이러한 견고한 성능은 법률 조항, 의료 행위, 알고리즘 모듈 및 책임 주체 간의 복잡한 관계를 종합적으로 포착하는 이기종 그래프 구조 인코딩과 다층 메시지 전달 체계 덕분입니다. GNNExplainer와 KG-BERT 또한 어느 정도의 관계 모델링 능력을 보여주었으나, 법률의 규범적 의미론에 적용했을 때 제약이 있었으며 성능 면에서 제안된 방법에 미치지 못했습니다.
편향 국소화 능력 비교
편향 국소화(bias localization) 평가는 근본 원인 노드의 재현율(recall)과 전파 경로의 정밀도(precision)를 기반으로 하는 2가지 품질 협업 검증 프레임워크를 통해 수행되며, 이는 소스의 추적 완결성과 경로 정확도를 다룹니다. 공정한 테스트를 위해 모든 비교 방법은 동일한 편향 시뮬레이션 주입 프로토콜과 평가 인터페이스 정의를 사용하여 동일한 그래프 구조 입력 상에서 실행되었습니다. 무작위 변동을 완화하기 위해 서로 다른 랜덤 시드를 사용하여 각 실험을 30회 반복하였습니다. 결과는 평균 ± 표준편차로 표시되었으며, p-값(본 논문의 방법 대비)을 결정하기 위해 대응표본 t-검정을 활용하여 평가 결론의 통계적 건전성과 비교 가능성을 보장하였습니다. p-값은 29의 자유도(30회 독립 실행 기반)를 가진 대응표본 t-검정에서 도출되었습니다. 본 방법과 각 베이스라인 간의 비교에 대한 t-통계량은 7.82에서 12.45 사이이며, 이는 보고된 p-값에 해당합니다.
표 2 다양한 방법들의 편향 국소화 능력에 대한 정량적 평가 결과를 보여주며, 성능의 두 가지 핵심 지표인 루트 노드 재현율과 전파 경로 정밀도를 나타냅니다. 루트 노드 재현율 측면에서 본 논문에서 제안한 방법은 모든 베이스라인보다 유의미하게 우수하며, 0.95 ± 0.02의 최상위 재현율을 달성하였습니다. 이는 두 번째로 성능이 좋은 GNNExplainer 방법(0.82 ± 0.03)보다 유의미하게 높으며, 다른 방법들과는 더욱 현저한 차이를 보입니다. 이러한 우위는 본 논문에서 제안한 그래디언트 인식 정량화 메커니즘 덕분이며, 이 메커니즘은 그래프 내 편향 신호의 전파 경로를 정확하게 추적하고 기여도가 높은 소스 노드를 효과적으로 인식할 수 있습니다. 반면, 엣지 유형의 의미적 차이를 포착할 수단이 없어 편향 전파 경로와 일반 관계를 명확하게 구분하지 못하는 고전적 접근 방식인 TransE와 Node2Vec은 각각 0.75 ± 0.04와 0.72 ± 0.05의 재현율 점수만을 기록하였습니다. KG-BERT의 경우 사전 학습된 언어 모델을 도입했음에도 불구하고, 그래프 구조 내의 정보 흐름에 제약이 있어 0.70 ± 0.04의 재현율 점수를 보였습니다.
| 방법 | 루트 노드 재현율 | p-값 (루트 노드 재현율) | 전파 경로 정밀도 | p-값 (전파 경로 정밀도) |
| 제안된 방법 | 0.95 ± 0.02 | - | 0.93 ± 0.03 | - |
| TransE | 0.75 ± 0.04 | 1.23 × 10⁻8 | 0.78 ± 0.05 | 2.45 × 10⁻7 |
| ComplEx | 0.78 ± 0.03 | 8.91 × 10⁻9 | 0.81 ± 0.04 | 1.67 × 10⁻8 |
| GNNExplainer | 0.82 ± 0.03 | 3.45 × 10⁻7 | 0.86 ± 0.04 | 9.21 × 10⁻9 |
| KG-BERT | 0.70 ± 0.04 | 5.67 × 10⁻8 | 0.73 ± 0.05 | 4.32 × 10⁻8 |
| Node2Vec | 0.72 ± 0.05 | 7.89 × 10⁻9 | 0.75 ± 0.06 | 1.54 × 10⁻7 |
표 2: 루트 노드 재현율 및 전파 경로 정밀도. 모든 방법에 대한 편향 국소화 성능 비교. 값은 30회의 독립적인 실행에 대한 평균 ±± 표준 편차로 표시됨. 루트 노드 재현율(Eq. 14)과 전파 경로 정밀도(Eq. 15)를 나타냄. 제안된 방법은 가장 높은 재현율(0.95 ±± 0.02)과 정밀도(0.93 ±± 0.03)를 달성하여 베이스라인보다 유의미하게 우수한 성능을 보임(대응 표본 t-검정, 모든 비교에서 p < 0.001).
이 방법은 전파 경로 정확도에서 0.93 ±± 0.03의 값으로 가장 우수한 성능을 보였으며, 다른 방법들보다 뛰어난 결과를 나타냈습니다. 이는 본 논문에서 제안하는 서브그래프 백트래킹 절차가 노이즈 엣지를 성공적으로 제거하고 실제 편향 전파 경로를 식별할 수 있음을 입증합니다. p-값 분석은 성능의 유의미한 차이를 뒷받침하며, 모든 베이스라인 방법들이 제안된 방법과 매우 유의미한 차이를 보여(p < 0.001), 편향 국소화 문제에서 제안된 방법의 강건성과 효과성을 보장합니다. ComplEx와 GNNExplainer의 상대적으로 강력한 성능은 편향 탐지에서 복잡한 관계 구조와 그래프 신경망 설명 가능성의 중요성을 시사할 수 있으나, 본 논문에서 제시한 엔드투엔드 솔루션에는 미치지 못합니다.
책임 추적의 효율성 평가
평가는 책임 추적 시스템의 실시간 응답성을 대상으로 하며, 평균 추적 지연 시간과 동시 요청 처리량을 두 가지 핵심 효율성 지표로 설정하였습니다. 실험은 세 가지 의료 AI 의사결정 빈도(저빈도, 중빈도, 고빈도)에서 수행되었습니다. 공정한 비교를 위해 모든 방식에 동일한 입력 스트림을 제공하고 전체 추적 절차를 실행하였습니다.
그림 7은 다양한 의료 AI 의사결정 빈도에서 서로 다른 방법들 간의 책임 추적 효율성을 비교한 것입니다. 결과는 왼쪽에서 오른쪽 순으로 고려된 방법들에 대한 것이며, 각 선은 저빈도, 중빈도 및 고빈도 의료 AI 의사결정으로 표시되어 있습니다.
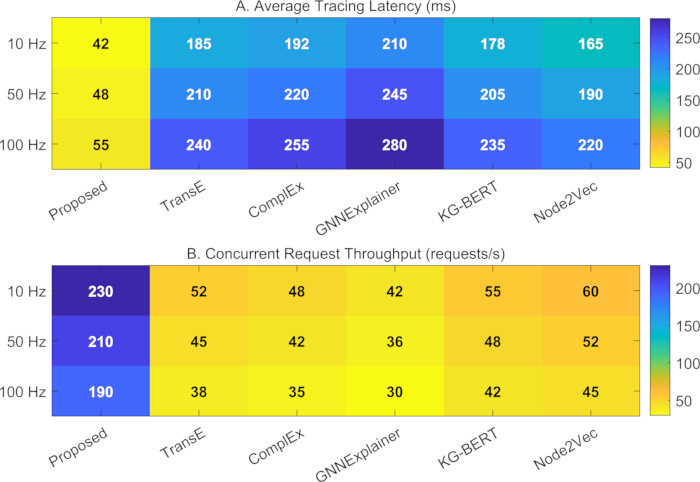
그림 7: 평균 소스 추적 지연 시간 및 동시 요청 처리 처리량. (A) 방법별 평균 추적 지연 시간 (ms); (B) 방법별 처리량 (requests/second). 선은 30회 실행의 평균값을 연결하며, 오차 막대(표시된 경우)는 표준 편차를 나타냅니다. 제안된 방법은 모든 주파수에서 가장 낮은 지연 시간 (42‑55 ms)과 가장 높은 처리량 (190‑230 req/s)을 유지하여 탁월한 실시간 성능을 입증합니다. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
평균 추적 지연 시간의 경우, 제안된 방법이 모든 빈도 조건에서 최적의 성능을 보였으며, 특히 다른 모든 방법보다 지연 시간이 유의미하게 낮았습니다. 모든 방법에서 추적 지연 시간은 일반적으로 결정 빈도가 증가함에 따라 증가하는 경향을 보였으나, 제안된 방법의 증가 폭은 완만하여 저빈도에서 42 milliseconds, 고빈도에서 55 milliseconds를 기록했습니다. 이러한 우수성은 본 방법이 인식 관계 그래프 합성곱 신경망(aware-relational graph convolutional network) 기반이라는 점 덕분이며, 이는 다양한 유형의 법률적 의미 관계에 서로 다른 가중치 행렬을 할당함으로써 기존 방식의 고동시성 환경에서 발생하는 일반 매개변수 공유에 따른 계산 오버헤드를 방지합니다. 반면, 텐서 분해 기반의 TransE 및 ComplEx는 고빈도에서 성능이 급격히 저하되었습니다. 이들은 법률 기술적 관계 간의 장거리 상호작용에 따른 비선형 변환을 효율적으로 처리하지 못해 지연 시간이 증가하는 결과를 초래했습니다. 요청 쌍당 처리 시간 측면에서도 본 논문에서 제안한 방법이 더 우수했습니다. 저빈도 설정에서 처리량은 230 requests/second로, 다른 접근 방식들과 큰 격차를 보였습니다. 빈도가 증가함에 따라 처리량이 감소하지만, 고빈도 시나리오에서도 감소량이 제어 가능한 수준으로 유지되어 처리량이 최대 190 requests/second에 달했습니다. 이러한 강건성은 본 접근 방식의 임시 노드 임베딩 전략과 경사 하강법 역전파 경로 병렬 설계 덕분이며, 이를 통해 배치 추적 정확도를 보장하는 동시에 요청을 효율적으로 배치 처리할 수 있습니다. 특수하게 최적화되지 않은 일반적인 접근 방식들은 동시 쿼리가 발생할 경우 성능이 크게 저하되어 실시간 모니터링에는 부적합합니다.
법적 제약 범위의 교차 도메인 일반화 능력 검증
평가 절차는 법적 제약 조건 모델링의 교차 도메인 역량 관점에서 수행되며, 정량화를 위한 두 가지 지표로 관할권 커버리지와 제약 충돌 탐지율을 사용합니다. 실험을 위해 단일 관할권, 양자 관할권, 다자 관할권의 세 가지 교차 관할권 복잡성 유형을 설계하였습니다. 아키텍처 차이로 인한 평가 편향을 제거하기 위해 모든 경쟁 방법론을 30회 반복 수행하고 평균 결과를 보고함으로써 일반화 능력에 대한 공정한 비교를 수행합니다.
표 3에 나타난 바와 같이, 이 접근 방식은 세 가지 법적 관할권 복잡성 수준 모두에서 모든 베이스라인보다 일관되게 더 나은 결과를 달성하며 성능 저하가 더 완만하게 나타납니다. 단일 법적 관할권 시나리오에서는 94%의 법적 커버리지와 거의 89%의 충돌 탐지율을 제공합니다. 다자간 법적 관할권으로 일반화했을 때에도 여전히 87%의 커버리지와 81%의 충돌 탐지율을 제공할 수 있습니다. 이와 대조적으로, 전통적인 임베딩 방법(예: TransE 및 Node2Vec)은 다자간 환경에서 커버리지가 약 60%로 떨어지며 일반적으로 충돌 탐지율 또한 더 낮게 나타나는데, 이는 이러한 방법들이 법적 관할권 간의 의미론적 이질성을 처리하는 데 부적합함을 시사합니다. 반면, KG-BERT와 GNNExplainer는 추가적인 사전 학습 언어 모델이나 해석 모듈을 통해 어느 정도 개선된 모습을 보이지만, 법적 관할권이 중첩되는 상황에서는 여전히 급격한 성능 저하를 겪습니다.
| 방법 | 관할권 설정 | 법률 영역 범위 | 제약 충돌 탐지율 |
| 제안됨 | 단일 | 0.94 ± 0.02 | 0.89 ± 0.03 |
| 양측의 | 0.91 ± 0.03 | 0.85 ± 0.04 | |
| 다자간의 | 0.87 ± 0.04 | 0.81 ± 0.05 | |
| TransE | 단일 | 0.76 ± 0.05 | 0.52 ± 0.06 |
| 양측의 | 0.68 ± 0.06 | 0.45 ± 0.07 | |
| 다자간의 | 0.61 ± 0.07 | 0.38 ± 0.08 | |
| ComplEx | 단일 | 0.79 ± 0.04 | 0.55 ± 0.05 |
| 양측의 | 0.72 ± 0.05 | 0.48 ± 0.06 | |
| 다자간의 | 0.65 ± 0.06 | 0.41 ± 0.07 | |
| GNNExplainer | 단일 | 0.82 ± 0.04 | 0.61 ± 0.05 |
| 양측의 | 0.75 ± 0.05 | 0.54 ± 0.06 | |
| 다자간의 | 0.68 ± 0.06 | 0.47 ± 0.07 | |
| KG-BERT | 단일 | 0.80 ± 0.04 | 0.58 ± 0.05 |
| 양측의 | 0.73 ± 0.05 | 0.51 ± 0.06 | |
| 다자간의 | 0.66 ± 0.06 | 0.44 ± 0.07 | |
| Node2Vec | 단일 | 0.74 ± 0.05 | 0.49 ± 0.06 |
| 양측의 | 0.66 ± 0.06 | 0.42 ± 0.07 | |
| 다자간의 | 0.59 ± 0.07 | 0.36 ± 0.08 |
표 3: 관할권 커버리지 및 제약 충돌 탐지율. 단일, 양자 및 다자간 법적 관할권 하에서의 교차 도메인 일반화 결과. 관할권 커버리지(식 18) 및 제약 충돌 탐지율(식 19)은 30회 실행에 대한 평균 ±± 표준편차(SD)로 표시됨. 제안된 방법은 가장 복잡한 다자간 설정에서도 높은 커버리지(≥87%)와 탐지율(≥81%)을 유지하는 반면, 베이스라인 방법들은 상당히 저하됨.
이러한 불일치는 근본적으로 완전히 다른 모델링 프로세스에서 비롯됩니다. 기존의 지식 그래프 임베딩 방식(예: TransE, ComplEx)은 모델링을 위해 정적 벡터 공간의 기하학적 관계를 활용하며, "금지"와 "허용" 같은 이진 법적 의미론을 구분하지 않기 때문에 서로 다른 법 체계 내에서 동일한 의료 행위에 적용되는 미묘한 규제 차이를 처리하지 못합니다. KG-BERT는 텍스트 문맥을 포착할 수는 있지만, 명시적인 구조적 추론 능력이 부족하며 조항 간의 규범적 의존성 및 충돌하는 제약 조건을 추론하는 데 어려움이 있습니다. 대신, 제안된 모델은 네 가지 유형의 법적 의미 엣지("위반", "기초", "트리거", "귀속")를 증강하여 유향 이종 그래프를 구축하고, 관계 인식 그래프 컨볼루션과 기울기 역전파를 통합합니다. 그 결과, 제안된 모델은 법적 논리의 인과적 방향성을 유지할 뿐만 아니라, 법률 도메인의 다중 소스 입력에서 의미론적으로 병렬인 조항들을 동적으로 정렬하고 모순되는 규칙을 탐지합니다. 따라서 다자간 법 체계 내에서 의무의 빈번한 충돌, 책임의 중첩 또는 적용 우선순위의 불확실성과 같은 복잡한 시나리오 하에서, 본 방법론은 구조적인 방식으로 모순의 근원을 정확하게 식별하고 이를 높은 커버리지와 정확도를 가진 교차 도메인 추론으로 변환하는 방법을 제공합니다.
제거 연구
각 핵심 구성 요소의 기여도를 분리하여 분석하기 위해, 밀집 그래프(D = 1.0) 설정에서 프레임워크 내의 주요 모듈을 제거하거나 교체하는 어블레이션 연구(ablation study)를 수행하였습니다. 구체적으로, 전체 모델을 다음 세 가지 변형 모델과 비교하였습니다: (1) 모든 엣지 유형이 단일 변환 행렬을 공유하는 관계 인식 컨볼루션(relation-aware convolution) 제외 모델, (2) 이웃의 기여도를 균일하게 평균화하는 어텐션 메커니즘(attention mechanism) 제외 모델, (3) 그래디언트 기반의 서브그래프 재구성이 아닌 단순 노드 차수 휴리스틱(node-degree heuristic)을 사용하여 바이어스 소스를 식별하는 그래디언트 백트래킹(gradient backtracking) 제외 모델입니다.
표 4는 어블레이션(ablation) 결과를 보여주며, 각 구성 요소의 뚜렷한 기여도를 나타냅니다. 관계 인식 컨볼루션(relation-aware convolution)을 제거했을 때 성능 저하가 가장 심하게 나타났으며, 루트 재현율(root recall)은 0.95에서 0.81로, 경로 정밀도(path precision)는 0.93에서 0.78로 감소했습니다. 이는 모든 관계 유형에 대해 단일 변환 행렬을 공유할 경우 교차 모달 정렬 중에 상당한 정보 손실이 발생하므로, 유형별 엣지 모델링이 법률 관계의 의미적 다양성을 포착하는 데 결정적임을 확인시켜 줍니다. 어텐션 메커니즘(attention mechanism) 또한 주목할 만한 기여를 합니다. 이를 제거하면 루트 재현율이 0.88로, 경로 정밀도가 0.85로 감소하며, 이는 이웃 메시지의 동적 가중치 부여가 영향력 있는 법률 경로를 구별하는 모델의 능력을 향상시킨다는 점을 시사하지만, 그 영향은 관계 인식보다는 부차적입니다. 그래디언트 백트래킹(gradient backtracking)을 제거했을 때는 재현율 감소(0.91)가 가장 적었으나 경로 정밀도 감소(0.76)는 가장 컸으며, 이는 단순한 휴리스틱으로 소스 노드를 일부 식별할 수는 있지만, 전파 구조의 정밀한 재구성은 그래디언트 기반의 민감도 분석에 크게 의존함을 시사합니다. 종합적으로, 세 가지 구성 요소 모두 프레임워크의 편향 국소화 성능에 유의미하게 기여하며, 그중 관계 인식 컨볼루션이 가장 필수적이고 그래디언트 백트래킹은 경로 수준의 정확도를 위해 반드시 필요합니다.
| 모델 변체 | 뿌리 회수 | 경로 정밀도 |
| 전체 모델 | 0.95 ± 0.02 | 0.93 ± 0.03 |
| 관계 인식 컨볼루션(relation-aware convolution) 제외 | 0.81 ± 0.03 | 0.78 ± 0.04 |
| 어텐션 메커니즘 제외 | 0.88 ± 0.02 | 0.85 ± 0.03 |
| 그레이디언트 백트래킹 없이 | 0.91 ± 0.03 | 0.76 ± 0.05 |
표 4: 밀집 그래프(D = 1.0)에 대한 어블레이션 연구 결과. 주요 구성 요소의 제거 효과: (관계 인식 컨볼루션 제외), (어텐션 메커니즘 제외) 및 (그래디언트 백트래킹 제외). 지표(루트 재현율 및 경로 정밀도)는 30회 실행의 평균 ± SD 값임. 전체 모델의 성능이 가장 높게 나타나 각 구성 요소가 유의미하게 기여하고 있음을 확인했으며, 그중 관계 인식 컨볼루션이 가장 중요한 요소임이 밝혀짐.
데이터 가용성:
본 연구 과정에서 생성 및 분석된 구조화된 이종 지식 그래프 데이터셋(4가지 엔티티 유형에 걸친 285개의 노드와 4가지 유효한 의미론적 관계를 가진 1,247개의 방향성 엣지를 포함한 모든 노드 및 엣지 데이터)은 DOI: https://doi.org/10.6084/m9.figshare.33117644로 Figshare 저장소에 기탁되었습니다. 해당 데이터는 본 논문의 출판일 기준으로 공개적으로 이용 가능합니다. 관련 데이터셋 파일은 다음과 같이 제공됩니다. 보충 파일 1.
보충 파일 1: 본 연구에 사용된 데이터셋 파일.이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
임상 의사결정에 의료 AI를 통합하는 것은 책임 소재 규명이라는 법적 과제를 야기하며, 이는 비정형 법률 텍스트와 블랙박스 알고리즘 사이의 의미론적 간극으로 인해 더욱 어려워집니다. 이를 해결하기 위해, 본 연구에서는 법률 조항, 의료 행위, 알고리즘 모듈 및 책임 당사자를 이종 노드로 모델링하고, 네 가지 유향 법률-의미 관계(위반, 근거, 트리거, 귀속)를 통해 연결하는 GNN 기반 지식 그래프를 제안했습니다. 이러한 구조는 교차 모달 정렬 및 편향 추적을 위한 계산 가능한 인터페이스를 제공합니다.
본 연구의 방법론은 모든 지표에서 우수한 성능을 달성하였습니다. 다양한 그래프 밀도 조건에서 개체 정렬 정확도(≥0.92)와 관계 보존율(≥0.88)이 TransE, ComplEx 및 KG‑BERT보다 뛰어난 성능을 보였습니다. 편향 국소화(Bias localization)를 통해 루트 재현율(0.95 ±± 0.02)과 경로 정밀도(0.93 ±± 0.03)를 얻었으며, 이는 GNNExplainer를 크게 상회하는 수치입니다. 동적 모니터링은 낮은 지연 시간(42–55 ms)과 높은 처리량(190–230 req/s)을 유지하였으며, 관할권 간 테스트에서는 견고한 커버리지(≥87%)와 충돌 탐지율(≥81%)을 나타냈습니다. 이러한 결과는 해석 가능한 편향 추적을 통해 법률적 의미론과 기술적 의미론이 효과적으로 연결되었음을 입증합니다.
우리의 성공은 세 가지 혁신에 기반합니다: (1) 유형화된 법률-의미론적 엣지는 균일한 임베딩에서 흔히 간과되는 인과적 및 규범적 구분을 포착합니다20,21; (2) 관계 유형별 전용 변환 행렬을 이용한 관계 인식 컨볼루션은 교차 유형 간 교환을 가능하게 하는 동시에 의미론적 특이성을 보존합니다38,39; (3) 그래디언트 기반 기여도 정량화 및 커뮤니티 유도 클러스터링은 전역적 편향을 지역적 소스 식별로 전환하여 사후 설명 도구의 한계를 극복합니다32,33. 이를 통해 컴플라이언스는 정적인 규칙 확인 단계에서 동적이고 구조 인식적인 추론 단계로 진화합니다.
한계점으로는 수동으로 정의된 관계 추출에 의존한다는 점과 모호한 조항을 처리하는 데 어려움이 있다는 점이 있습니다. 향후 연구에서는 법률 논리 형식 체계(예: 가처분 논리)를 통합할 예정입니다.26,27) 및 변화하는 규제에 대응하기 위한 온라인 학습을 수행하고, 이를 다른 고위험 영역(자율 주행, 금융)으로 확장할 것입니다. 사용자 루프 피드백(User-in-the-loop feedback)을 통해 속성 분석을 더욱 정교화할 것입니다. 이러한 방향성은 그래프 기반의 설명 가능한 AI를 신뢰할 수 있는 지능형 시스템의 토대로 공고히 할 것입니다.
공개 사항
본 원고는 이전에 출판된 적이 없으며 다른 학술지에서도 심사 중이지 않습니다. 모든 저자는 논문의 내용을 승인하였습니다. 저자들은 재정적 이해관계의 충돌이 없음을 선언합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| ComplEx | 오픈 소스 구현체 (예: OpenKE) | Version 1.0 | 지식 그래프 비교를 위한 복합 임베딩 베이스라인 |
| GNNExplainer | 오픈 소스 구현체 (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | 편향 추적을 위한 GNN 해석 가능성 베이스라인 |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | 모델 학습 및 데이터 전처리를 위한 중앙 처리 장치 |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | 의미론적 정렬을 위한 트랜스포머 기반 KG 임베딩 베이스라인 |
| Node2Vec | 오픈 소스 구현체 (https://github.com/aditya-grover/node2vec) | Version 1.0 | 랜덤 워크 기반 노드 임베딩 베이스라인 |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | 그래프 신경망 학습을 가속화하는 고성능 GPU |
| Ours (Relation-aware GCN) | PyTorch 기반 자체 구현 | PyTorch 1.12.0 | 관계별 변환, 어텐션 및 그래디언트 백트래킹이 포함된 제안 프레임워크 |
| TransE | 오픈 소스 구현체 (예: OpenKE) | Version 1.0 | 지식 그래프 비교를 위한 병진 임베딩 베이스라인 |
참고문헌
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.