Fosfolipide vetzuren geven informatie over de structuur van de bodem microbiële gemeenschappen. We presenteren extractiemethoden uit grondmonsters met een eenfasige chloroformmengsel, fractionering van geëxtraheerde lipiden die vaste fase extractie kolommen en methanolyse tot vetzuurmethylesters, die met behulp van capillaire gaschromatografie produceren.
Methodenartikel
Extractie en analyse van Microbiële Phospholipid vetzuren in de bodem
In dit artikel
Samenvatting
Samenvatting
Fosfolipide vetzuren (PLFAs) zijn belangrijke componenten van microbiële celmembranen. De analyse van PLFAs gewonnen uit de bodem kan informatie over de algemene structuur van terrestrische microbiële gemeenschappen. PLFA profilering is op grote schaal gebruikt in een reeks van ecosystemen als een biologische index van de algehele kwaliteit van de bodem, en als een kwantitatieve indicator van de bodem reactie aan het management en andere milieu-invloeden te landen.
De standaardmethode hier gepresenteerde beschrijft vier stappen: 1. lipide extractie uit grondmonsters met een eenfasig mengsel chloroform, 2. fractionering middels vaste fase extractie kolommen fosfolipiden uit andere geëxtraheerde lipiden isoleren 3. methanolyse van fosfolipiden tot vetzuur methyl esters (FAME), en 4 FAME geanalyseerd met capillaire gaschromatografie met een vlamionisatiedetector (GC-FID). Twee standaard wordt gebruikt, zoals 1,2-dinonadecanoyl- sn glycero-3-fosfocholine (PC (19:0/19: 0)) met de algemene winning van de extractiewerkwijze beoordelen en methyldecanoaat (MeC10: 0) als een interne standaard (ISTD) voor GC-analyse.
Inleiding
Fosfolipide vetzuren (PLFAs) deel uitmaken van microbiële celmembranen van de domeinen Bacteriën en Eukarya. Micro-organismen produceren PLFAs van verschillende ketenlengten en samenstelling als middel voor celmembraan integriteit en celfunctie in reactie op hun directe omgevingscondities te handhaven; dus het kan worden aangevoerd dat microbiële gemeenschappen die geografisch gescheiden, maar zijn onderworpen aan soortgelijke bodemgesteldheid vergelijkbaar PLFAs zal uitdrukken. PLFAs bodem met een ketenlengte tussen 14 en 20 C-atomen worden gewoonlijk beschouwd voornamelijk uit bacteriële en fungale oorsprong 1 is. In gemengde culturen kunnen PLFA analyse niet worden gebruikt om individuele microbiële species te identificeren, maar het kan een algemeen vingerafdruk van de microbiële gemeenschappen in de bodem bieden. Bovendien, omdat PLFAs snel worden afgebroken op celdood kunnen worden als representatief voor de levensvatbare microbiële gemeenschap bodem 2 zijn. dit technique is uitgebreid gebruikt om de structurele samenstelling van de microbiële gemeenschappen gevonden in een breed scala aan omgevingen, variërend van bossen 3-4 tot 5-6 prairies en akkers 7 karakteriseren. Het is met succes toegepast bij het karakteriseren bodemreacties op veranderingen grondbeheer, onder forest kaalslag 8, 9 kalken, regeneratie 10-12, alsook verstoringen zoals brand 13 verontreiniging door metalen en koolwaterstoffen 14 15 en 16 insecten uitbraak .
De moderne PLFA analysemethode ontwikkeld in de afgelopen zes decennia door middel van een aantal belangrijke ontwikkelingen door een aantal onderzoeksgroepen. In 1958, een aanzienlijke verbetering ontstond het aanpassen van het chloroform: methanol: water verhouding in de extractie-oplossing aan het mengsel verschuiven van monofasische een tweefasen systeem 17. Deze geoptimaliseerde vetextractie en de herziene isolatie proprotocol werd bekend als de Bligh en Dyer methode. Het protocol werd goedgekeurd door veel laboratoria in de komende decennia, en gedurende deze tijd, Wit en collega's hebben bijgedragen aanzienlijke verbeteringen van de methode; Zo verbeterde zij extractiestap door uitwisseling van een fosfaatbuffer voor water, en ze geoptimaliseerd analyse door gaschromatografie (GC) door meer piek identificeren en kwantificeren. Misschien relevanter bodemkunde, zij vastgesteld 1979 de geëxtraheerde lipiden kunnen worden gebruikt als een index van microbiële structuur als zij de microbiële biomassa van mariene sedimenten 18 onderzocht.
Verdere ontwikkelingen plaatsgevonden in 1980 als de methode werd op grotere schaal gebruikt in bodemkunde, specifiek met betrekking tot de rhizosfeer 19. Op dat moment, de methode opgenomen methyl nonadecanoate (MeC19: 0) als interne standaard 19 en het gebruik van een kiezelzuur kolom voor lipide fractionering 21 </ Sup>. Na zijn werk met White 19,21, Tunlid keerde terug naar Zweden en begon gezamenlijk onderzoek met de Baath en Frostegård. Door onderzoek van de efficiëntie van verschillende extractiebuffers een reeks bodems variërend in organische stof, de groep toonde dat de citraatbuffer verhoogde de hoeveelheid lipide fosfaat geëxtraheerd vergelijking met fosfaatbuffer 22. Verder, hun 1993 publicatie 23 over de invloed van kalken van de bodem microbiële gemeenschappen ging over tot een citaat klassieker in Soil Biology & Biochemistry 24 geworden. De onderzoekers gebruikt principal component analyse in hun verwerking van gegevens. PLFA analyse als de methode nu genoemd, ontstaan grote datasets en toepassing van multivariate statistische procedures om deze gegevens te verwerken was zeer innovatief voor de tijd en inspirerend velen. Concurrent om het werk wordt gedaan in Zweden, werden aanpassingen aan de PLFA procedure wordt onderzocht inDuitsland door Zelles en collega's 25-26. De versie van de procedure werd gekenmerkt door het gebruik van een vaste-fase-extractie (SPE) kolom in plaats van de kiezelzuurkolom maar over het algemeen was laboratorium intensief.
Frostegård's papier 23, samen met de gedetailleerde methodologie van White & Ringelberg 27, op voorwaarde dat de basis voor een explosie in het gebruik van de PLFA techniek om fundamentele vragen in de bodemkunde te onderzoeken. Sindsdien verdere verfijningen van de methode van Firestone en zijn collega's hebben opgenomen toevoeging van een interne GC-norm (C10: 0) en C19: 0 als een surrogaat standaard kwantificering 28 te verbeteren, en het vervangen van het gebruik van schei-trechters voor ronde bodem flacons te vereenvoudigen extractie 29. Recenter Chowdhury en Dick 30 onderzochten de methyleringsstap en gerapporteerd dat van de twee methylering procedures in de bodem wetenschappelijke literatuur KOH / MeOH methode identceerd een grotere waaier van vetzuren.
De onderhavige methode is grotendeels gebaseerd op de originele methode ontwikkeld door Bligh en Dyer, en omvat de bovengenoemde modificaties, zoals het gebruik van methanolische KOH voor methyleringsstap. Twee standaard wordt gebruikt voor elk monster: een surrogaat standaard 1,2-dinonadecanoyl- sn glycero-3-fosfocholine (PC (19: 0/19: 0)), die wordt toegevoegd aan het grondmonster voor de eerste extractie efficiëntie en herstel van het gehele protocol en een instrument standaard van methyldecanoaat beoordelen (MeC10: 0), die voorafgaand aan de identificatie en kwantificering van GC toegevoegd.
Wij erkennen dat de PLFA methode die gewoonlijk wordt gebruikt door veel microbiële ecologie laboratoria over de hele wereld, en is vele malen gedocumenteerd, onder meer door de International Organization for Standardization 2. Het doel van dit document is een eenvoudig te volgen en robuuste protocol dat nuttig bodem juist presenterenwetenschappers die proberen om de PLFA techniek te leren.
Protocol
LET OP: Zorg er altijd voor dat de juiste persoonlijke beschermingsmiddelen (PBM) wordt gedragen gedurende het protocol. Glaswerk mag niet worden aangeraakt met de blote hand. Lipiden uit vingers, haar, vet, olie en koolwaterstoffen zijn allemaal potentiële verontreinigingen. Draag altijd nitril handschoenen en spoelen handschoenen met 70% alcohol bij het hanteren van schone glaswerk.
1. Bereiding van Glaswerk voor Analysis
- Wegwerp glaswerk (bijvoorbeeld centrifugebuizen)
- Wikkel in aluminiumfolie en warmte in moffeloven voor vier en een half uur op 450 ºC.
- Polytetrafluoroethyleen (PTFE) heeft post gevat caps
- Geniet caps voor een uur in fosfaat wasmiddel, en daarna wassen met scrub borstel in warm water en fosfaat wasmiddel. Afspoelen zeep met kraanwater.
- Plaats in zuurbad (5% HCl) gedurende een uur alleen (niet langer als liners uit de doppen als ze doorweekt te lang kan vallen vertrekken. Spoel drie keerin leidingwater. Spoel driemaal in gedestilleerd water. Droog in de oven op 40 ° C.
- Herbruikbare glaswerk (bijvoorbeeld 10 ml, 15 ml, 45 ml flesjes / potten)
- Wassen met scrub borstel in warm water en fosfaat wasmiddel. Afspoelen zeep met leidingwater en plaats in zuurbad (5% HCl) gedurende de nacht. Spoel drie keer in leidingwater, spoel dan drie keer in gedestilleerd water en vervolgens drogen in de oven op 40 ° C.
- Wikkel in schone aluminiumfolie (50 ml potjes zijn individueel verpakt en andere glaswerk is verpakt in monsterbatches, bijvoorbeeld 20) en warmte in moffeloven voor vier en een half uur op 450 ºC.
- Glaswerk (bijv maatkolf)
- Wassen met scrub borstel in warm water en fosfaat wasmiddel. Afspoelen zeep met leidingwater en plaats in zuurbad (5% HCl) gedurende de nacht. Spoel drie keer in leidingwater, spoel drie keer in gedestilleerd water en daarna drogen in een oven op 40 &# 186; C.
- Voor gebruik spoelen 3 maal met een kleine hoeveelheid oplosmiddel (bijvoorbeeld methanol) - plaats geen glaswerk in de moffeloven.
2. inzameling en verwerking van bodemmonsters Voorafgaand aan PLFA Analyse
- Verzamel grondmonsters in steriele zakken en tenzij deze onmiddellijk worden geanalyseerd, invriezen zo snel mogelijk. Store monsters in de vriezer (-80 ºC) tot klaar om verder te gaan met vriesdrogen van monsters. Freeze droge batches van monsters volgens de instructies van de vriesdroger.
- Transfer elke gevriesdroogde monster nieuwe gelabelde steriele zak. Weeg monster van gevriesdroogde materiaal in zak in pre-gelabelde gedempt centrifugebuis voor PLFA extractie.
OPMERKING: Een algemene richtlijn dat 0,5 g organische materialen (carbon content> 17% wt) en tot 3,0 g minerale bodemmonsters gebruiken. Record monster gewicht voor elk monster. - Voor elke 10 monsters, ook wegen uit eenextra duplo voor analyse en voor elke 20 monsters omvatten een blanco (dwz een centrifugebuis die geen monster daarin heeft - gebruikt als controle om mogelijke verontreiniging tijdens de PLFA extractie identificeren). Werkwijze batches monsterbuizen tegelijkertijd.
OPMERKING: Een reeks van 20 monsters overeen met een batch van 23 monsterbuizen (monsters 1 tot 10, een duplicaat van monster 10, monsters 12 tot 22, een duplicaat van monster 22 en een blanco = batch van 23 monsterbuizen).
LET OP: Voer extractie, dan scheiden, dan methylatie in batches van monsters vóór hen voor te bereiden GC-analyse en loopt ze allemaal samen. Dit helpt om te bepalen waar fouten zijn gebeurd als er iets mis gaat, en kunnen helpen verlagen van het aantal noodzakelijke herhaalde extracties.
3. PLFA Technique (stappen zijn voor individuele sample maar volledige één hele partij op een moment)
LET OP: Alle stappen van de PLFA techniek in de stappen beschreven1-3 hieronder in een zuurkast moet worden uitgevoerd met behulp van de juiste PPE en na lab veiligheidsrichtlijnen.
- Extractie (stap 1):
- Bereid 5,0 M KOH door het oplossen van 14 g KOH in 50 ml gedestilleerd, gedemineraliseerd water (dH 2 O).
- Bereid 0,15 M citraatbuffer door het oplossen van 31,52 g citroenzuurmonohydraat in 400 ml dH 2 O. Op pH 4,00 ± 0,02 door het toevoegen van 5,0 M KOH; ongeveer 45-50 ml 5,0 M KOH nodig zijn om de pH op 4,00. Wanneer de pH Verdun citraatbuffer met 1000 ml met een maatkolf. WINKEL citraatbuffer in de koelkast wanneer niet in gebruik (tot één maand).
- Bereid dagelijkse PC (19: 0/19: 0) nonadecanoate surrogaat maatstaf verdunnen 250 ul van de voorraadoplossing (10 mg / ml) in 25 ml chloroform (dit levert voldoende surrogaat standaard voor een batch van 23 monsters). Voeg 0,5 ml van PC (19: 0/19: 0) surrogaat standaardoplossing aan het monster centrifugebuis.
- EENdd de Bligh en Dyer extractiemiddel aan het bodemmonster in de volgende volgorde: i) 2,0 ml citraatbuffer, ii) 2,5 ml chloroform, en iii) 5,0 ml methanol. Cap monster met een met PTFE beklede dop en vortex gedurende 30 seconden; plaatsen end-over-end schudder gedurende 2 uur.
- Centrifugeer bij 226 xg gedurende 15 min met dop op. Teken bovenstaande vloeistof af met een Pasteur pipet en overbrengen naar een gelabelde 45 ml glazen flacon.
- Voeg een tweede ronde van Bligh en Dyer extractiemiddel aan elk monster, en herhaalt u de bovenstaande stappen 4 en 5. Teken bovenstaande vloeistof af met een Pasteur pipet en transfer naar dezelfde gelabelde 45 ml glazen flacon.
- Voeg toe aan gelabelde 45 ml glazen flacon met bovenstaande: i) 5,0 ml chloroform, en ii) 5,0 ml citraatbuffer. Cap met wit-PTFE beklede dop en vortex glazen flesje voor 30 sec. Laten zitten 's nachts bij kamertemperatuur in het donker (om oxidatie te voorkomen).
- vacuüm voorzichtig de bovenste waterfase van de 45 ml flacon (indien geen vacuüm beschikbaar is, moet de pipet worden verlaagd door de aquelende fase zeer zorgvuldig om niet te verzamelen enige in de pipet wanneer pipetteren de organische fase). Pipette lagere organische fase in gelabelde 15 ml flacon.
- Plaats batch van 15 ml buisjes onder N2 gecomprimeerd (om oxidatie te voorkomen) bij kamertemperatuur. Damp chloroform langzaam af, instellen van de N2-stroom aan het oppervlak van de vloeistof in de flacon ruffle maar niet klimmen de zijkanten van de flacon.
- Schroef-PTFE beklede kap en bewaar monsters in de vriezer bij -20 ° C verpakt in aluminiumfolie (folie in partijen in plaats van individueel) tot direct doorgaan naar Stap 2.
- Lipide fractionering (Stap 2)
- Plaats SPE houder zuil met tuiten op de glazen bak. Plaats nieuwe SPE kolommen (silica, 500 mg, 6 ml) in tappen. Label kolommen als nodig (aanbevolen om te voorkomen dat het mengen van monsters).
- Conditie elke kolom door toevoeging van 5 ml aceton en laten leeglopen met, en voeg vervolgens twee toevoeging van 5 ml chloroform (totaalvolume = 10 ml). Laat tweede chloroform wassen om uit te stromen tot ~ 1 mm boven de frit en sluit vervolgens de spie.
- Re-ontbinden monster (opgeslagen in 15 ml flacon aan het einde van stap 1) door het toevoegen van 0,5 ml chloroform aan flacon en vortex voorzichtig. Overdracht opnieuw opgeloste monster op de SPE-kolom met een Pasteur pipet; herhalen voor een totaal van 2 transfer (overdracht totaal volume van 1 ml chloroform per monster).
- Leg lipide monster rechtstreeks naar het centrum van de kolom en laat oplosmiddel volledig afwateren in tank.
- Elueer neutrale lipiden door toevoeging van 5 ml chloroform aan elke kolom. Laat oplosmiddel volledig afwateren in tank.
- Elueer glycolipiden door toevoeging van 5 ml aceton aan elke kolom. Laat oplosmiddel volledig afwateren in de collectie tank.
- Verwijder kolom staan uit de tank en afvoer tank met vacuüm apparatuur. Plaats rek met schoon en gelabelde centrifugebuizen in de tank. Vervang kolom staan op de tank; gelabeld kolom boven moeten op een lijn met gemerkt centrifuge tube hieronder.
- Elueren fosfolipiden in centrifugebuizen door toevoeging van 5 ml methanol op elke kolom. Wacht tot SPE kolommen uit te drogen in zuurkast voordat het wordt verwijderd van hen. Droge neer fosfolipide fracties bij kamertemperatuur onder samengeperste N2.
- Purge buizen met N 2. Schroef on-PTFE beklede dop en bewaar de monsters in de diepvries bij -20 ºC gewikkeld in aluminiumfolie (wrap in batches in plaats van individueel) tot klaar om verder te gaan naar stap 3.
- Lipide methylering (stap 3).
- Zet de warm waterbad ingesteld op 37 ºC. Bereid 1M azijnzuur (indien nog niet gedaan) door het oplossen van 57,1 ml ijsazijn in 1000 ml dH 2 O met behulp van een 1000 ml maatkolf. Deze oplossing kan worden bewaard bij kamertemperatuur gedurende drie maanden. .
- Bereid batch methanolische KOH. Bereid 0,2 M KOH oplossing door het oplossen van 0,45 g KOH in 40 ml methanol. Volume van KOH en methanol volgens eennticipated partijgrootte in Stap 3. Maak deze oplossing dagelijks; niet bewaren voor langere periodes.
- monsters nemen (in centrifugebuizen opgeslagen na stap 2) uit diepvriezer en laat monsters op kamertemperatuur komen. Voeg 0,5 ml chloroform en 0,5 ml methanol aan elk monster, gevolgd door 1,0 ml methanolische KOH. Cap buizen goed af met PTFE bekleed cap. Swirl te mengen.
- Plaats verzegelde monsters in 37 ° C bad gedurende 30 minuten. Zorg ervoor dat het waterpeil is een minimum van 1-2 mm boven het niveau van het monster vloeistof. Opheffen en monsters afkoelen. Terwijl de monsters in een waterbad, etiketteren kleine glazen flesjes met het monster-ID's (10 ml glazen flesje met PTFE beklede cap).
- Voeg 2,0 ml hexaan aan elk monster en kolken. Voeg vervolgens 0,2 ml 1,0 M azijnzuur aan elk monster en swirl opnieuw mengen; fasescheiding moet zichtbaar worden.
- Voeg 2,0 ml dH 2 O aan elk monster fase breken. Vortex monsters gedurende 30 sec. Vervolgens centrifuge monsters bij 226 xg gedurende 2 minuten.
- gebruikKortom Pasteur pipet de bovenste fase te reinigen gelabelde 10 ml flesjes. Wees voorzichtig om geen van de lagere (waterige) fase over te dragen.
- Voeg 2,0 ml hexaan aan elk monster centrifugebuis en kolken. Vortex monsters gedurende 30 sec. Vervolgens centrifuge monsters bij 226 xg gedurende 2 minuten.
- Met behulp van korte Pasteur pipet, opnieuw toe te voegen aan de top fase naar de gelabelde 10 ml glazen flacon.
- Damp oplosmiddel in gelabelde 10 ml glazen flesje bij kamertemperatuur onder N2. Schroef-PTFE beklede kap en bewaar monsters in de vriezer bij -20 ° C verpakt in aluminiumfolie (folie in partijen in plaats van individueel) tot zover om met GC-analyse. Zorg ervoor dat alle monsters te labelen.
- Gaschromatograaf (GC) analyse
OPMERKING: Identificatie en kwantificering van de individuele PLFAs wordt bewerkstelligd met behulp van GC aangesloten op een FID of een MS-detector. Terwijl de onderstaande instructies zijn voor GC-FID, zou het monster voorbereiding geldig zijn voor GC-MS als well. Een voorbeeld set-up voor een GC-FID systeem zou onder meer een 25 meter x 0,2 mm × 0,33 micrometer (5% -fenyl) -methylpolysiloxane kolom met de volgende temperatuur protocol: aanvankelijke temperatuur 190 ºC, oprit 10 ºC / min tot 285 ºC Houd 9,5 min, helling van 60 ° C / min tot 310 ° C, houd 0,42 min 31.- Bereid de GC interne standaard (ISTD) door het toevoegen van een druppel MeC10: 0 (methyl decanoaat) tot 100 ml hexaan (verslag extra gewicht tot 0,1 mg). Schakel gassen aan GC en zet vervolgens de GC. Zorg ervoor dat H2, N2 en luchtcilinders zijn open en dat er voldoende gas voor de analyse werking (H 2 mag nooit onder 500 psi).
- Controleer of omstandigheden van een goede calibratie voldoet draaien kalibratienormen met een mengsel van vetzuren, gevolgd door hexaan leeg. Identiteit van de individuele vetzuren kunnen handmatig worden toegewezen op basis van vergelijkingen met retentietijden verkregen voor normen, of dit kan worden automatically toegewezen met behulp van in de handel verkrijgbare software 31. In alle gevallen kan duidelijke identificatie worden bereikt door een MS-detector 2.
LET OP: Extra tekenen van een goede kalibratie onder andere een flatscreen baseline en geen verontreiniging in het hexaan spoelen. - Lossen elk PLFA monster residu (in 10 ml glazen flesje van lipide methylering stap 3) in 150 pl van de ISTD bevat en hevel in GC flesje (gebruik als alternatief 50 tot 75 gl of voorbeeldresponsbestand verwachting zwak, bijvoorbeeld in een te zandgronden).
- Stel de steekproef injectievolume tot 2 pl. Stel de FID temperatuur tot 300 ºC. Run de monsters onder toepassing van een inlaattemperatuur van 250 ° C, met H2 als dragergas (stroomsnelheid 1,3 ml / min) en een split verhouding van 30: 1.
Resultaten
Vetzuren worden aangeduid als X: YωZ, waarbij X het aantal koolstofatomen, Y het aantal dubbele bindingen, en Z geeft de positie van de eerste dubbele binding van alifatische (ω) uiteinde van het molecuul. De achtervoegsels "c" en "t" geven cis en trans geometrische isomeren. De voor- en achtervoegsels 'a' en 'i' te verwijzen naar anteiso en iso vertakking and Me en OH specificeren methylgroepen en hydroxyl groepen, respectievelijk.
Post-GC run, controleer dan of monsters ontvangen adequate ISTD door te kijken naar de 10: 0 piek. Controleer ook de reactie van de GC-normen, dat wil zeggen, de flesjes met hexaan met toegevoegde ISTD oplossing; deze mag geen andere pieken. Interne standaard reactie moet gelijk zijn in alle runs zijn.
Figuur 1 toont een vertegen-tieve monster run. De grote hexaan oplosmiddel piek verschijnt karakteristiek bij een retentietijd (RT) ongeveer 1,8 min. De ISTD standaard piek (C10: 0) wordt weergegeven bij een kamertemperatuur van 3,4 min, terwijl de C19: 0 heeft een RT van 16,2 minuten. De GC-analyse scheidt de PLFAs basis van hun ketenlengte, met langere ketens langzamer eluerend; bijvoorbeeld C18: 0 elueert bij 14,4 min, terwijl C16: 0 elueert bij 10,8 minuten. Bovendien kan deze analytische protocol PLFAs scheiden op basis van de mate van onverzadiging en de positie van de dubbele binding; bijvoorbeeld, C18: 0 elueert bij 14,4 min, terwijl C18: 1 9c en C18: 1 7c elueren bij 14,0 en 14,1 min, respectievelijk (figuur 1). Ten slotte kan PLFAs van soortgelijke ketenlengte en verzadiging, maar verschillende vertakking configuratie (anteiso versus ISO) worden gescheiden; bijvoorbeeld, C15: 0i en C15: 0a elueren bij 8,6 en 8,7 min, respectievelijk (figuur 1).
De gebieden van de verschillende GC pieken kan worden imgeport naar een spreadsheet om het gas chromatogram informatie verder te verwerken. Elke geïdentificeerde PLFA gekwantificeerd (nmol g -1 droge bodem) met de volgende vergelijking:
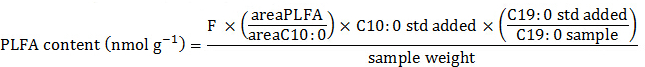
waarbij F is een correctie factor die rekening houdt met FID selectiviteit en de molariteit verschillen tussen vetzuren 32, areaPLFA is de piek gebied voor elk geïdentificeerd PLFA, areaC10: 0 is de piek gebied voor de ISTD (MeC10: 0), C10: 0 std toegevoegd is de hoeveelheid ISTD (nmol) aan elk monster toegevoegd voorafgaand aan de GC-run, de verhouding (C19: 0 std toegevoegd / C19: 0 monster) komt overeen met het herstel van de PC (C19: 0 / C19: O) surrogaat standaard en het monstergewicht de hoeveelheid oven gedroogde bodem (g) toegevoegd aan het oorspronkelijke monster centrifugebuis en voor het afzuigen PLFAs.
LET OP: De gebieden onder de different pieken worden uitgedrukt piekoppervlakken, respons of respons% afhankelijk van het GC-systeem. Binnen het bereik bodem PLFA karakterisering relevant kunnen gebieden worden aangenomen lineair evenredig met het gewicht van vetzuren zijn; Als alternatief kunnen kleine correctiefactoren worden toegepast om rekening te houden FID selectiviteit 32. Bovendien, omdat de resultaten aanvankelijk uitgedrukt in gewichtspercentage basis, moeten ze worden genormaliseerd molaire hoeveelheden verkregen. Correctie van verschillen molariteit wordt bereikt door rekening te houden met moleculaire gewichten van de individuele vetzuren; gepubliceerde tabellen 32 en 31 commerciële software zijn ook beschikbaar om te helpen bij het normaliseren voor molariteit.
De hoeveelheid ISTD (nmol) toegevoegd aan elk monster kan verder als volgt berekend:
C10: 0std = [ISTD] × V toegevoegd (STD toegevoegd)
waarin [ISTD] de concentratie (nmol l -1) van de MeC10: 0 (methyldecanoaat) opgelost in hexaan (zie stap 3.4.1), en V (STD toegevoegd) het volume (L) van bereide ISTD oplossing toegevoegd aan elk monster voor de GC-run (dwz 150 pi volgens stap 3.4.4).
De hoeveelheid C19: 0 (nmol) in elk monster tijdens GC-analyse overeen met:
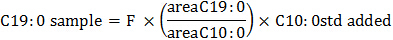
waarbij areaC19: 0 is het piekoppervlak van C19: O, terwijl de overeenkomstige hoeveelheid C19: 0 (nmol) toegevoegd aan elk monster aan het begin van de PLFA extractie methode (zie stap 3.1.3) is:
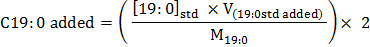
waarbij [19: 0] Std (mg L -1 ) is de concentratie van de C19: 0 nonadecanoate surrogaat standaard opgelost in chloroform (stap 3.1.3), V (19: 0 std toegevoegd) wordt de hoeveelheid bereide surrogaat standaard toegevoegd aan elk monster aan het begin van de PLFA extractie methode (zie stap 3.1.3), M 19: 0 is het molecuulgewicht van 1,2-dinonadecanoyl- sn glycero-3-fosfocholine (PC (19: 0/19: 0)).
LET OP: Een mol C19: 0 nonadecanoate surrogaat standaard opbrengsten twee mol C19: 0 naar aanleiding van de methylering stap, terwijl de C10: 0 standaard wordt toegevoegd na methylatie.
De volgende PLFAs worden typisch uitgesloten van analyse van de bodem microbiële gemeenschappen: i) PLFAs die <14 C en> 20 C lang en ii) PLFAs met minder dan 0,5% van het totale piekoppervlak in. Zodra deze PLFAs uitgesloten, kan de antwoorden van alle overblijvende PLFAs worden opgeteld om de totale PLFA bi vindenomass (nmol g -1 van de droge bodem). Univariate PLFA data (bijvoorbeeld ANOVA volgende gegevenstransformatie die overeenstemt met de uitgangspunten van de proef wordt uitgevoerd aan) kan worden gebruikt ter vergelijking totaal PLFA biomassa en / of PLFA biomassa van geselecteerde groepen binnen monstergroepen / behandelingen. Bijvoorbeeld, figuur 2 worden de resultaten voor de relatieve verdeling van de verschillende groepen PLFA zoals rechte keten verzadigde PLFAs, verzadigd PLFAs met hetzij mid-keten (10-methyl) of eindstandige vertakking en mono- of polyonverzadigde PLFAs, alsmede de som van de totale PLFAs (nmol g -1 van de droge bodem). In dit specifieke voorbeeld, de leeftijd van de bomen (die afneemt van Site 1 Site 3) is te zien dat zowel de totale PLFAs en de relatieve verdeling van de verschillende groepen PLFA beïnvloeden.
Om de algemene patronen in PLFA samenstelling tussen monsters te evalueren, kan multivariate analyse van alle PLFAs condu zijncted 33. De PLFA data nodig voor de geselecteerde multivariate analyse moet worden omgevormd tot de aannames van de statistische test en de vraagstelling voldoen aangepakt, bijvoorbeeld, is een Hellinger transformatie vaak gebruikt om de gegevens relativeren. Figuur 3 toont de resultaten van een niet -metric multidimensionale schaling (MVG) wijding van dezelfde gegevens die werden gebruikt in figuur 2; MVG is een niet-parametrische multivariate techniek die 2- of 3-dimensionale positionering gegevenspunten basis van de gelijkenis van positiescores tussen monsters produceert.
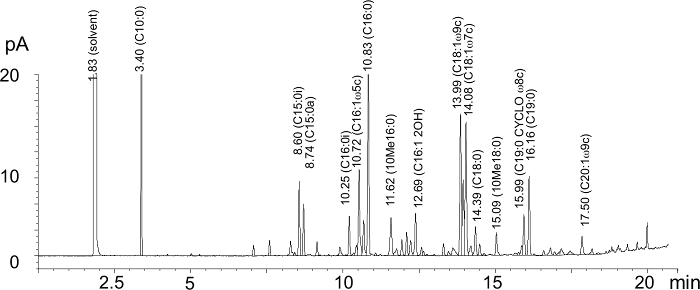
Figuur 1. Representatieve GC-FID chromatogram. Een monster verkregen uit een gekweekte Brown Chernozemic grond werd gebruikt voor deze analyse. De retentietijden en overeenkomstige PLFAs (tussen haakjes) en het piekgebied (pA) eenre aangegeven op de afbeelding voor representatieve pieken. Voor de duidelijkheid zijn niet alle pieken aangegeven op de figuur, hoewel dit bepaald monster leverde 33 geïdentificeerd PLFAs. Klik hier om een grotere versie van deze figuur te bekijken.
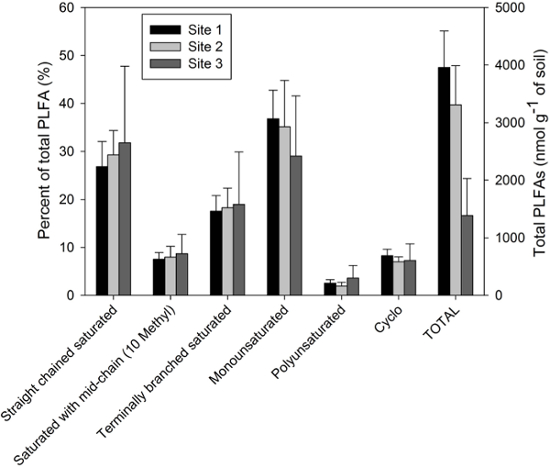
Figuur 2. Relatieve overvloed van zes verschillende soorten PLFAs (% van totaal PLFAs) en totale PLFA biomassa (nmol g -1 van de droge bodem). Monsters van beboste Luvisolic bodems werden gebruikt voor deze analyse. De resultaten geven een grotere totale PLFAs voor de bodem op Site 1, dat zich onder oudere bomen (> 50 jaar), gevolgd door de tussenliggende leeftijd (25 jaar) bomen (Site 2), en tenslotte de jongste (10 jaar) bomen ( Site 3). Relatief meer verzadigd PLFAs zijn aanwezig op de jongstesite, terwijl meer onverzadigde PLFAs bij het oudste site. Fout balken geven standaarddeviaties. Klik hier om een grotere versie van deze figuur te bekijken.
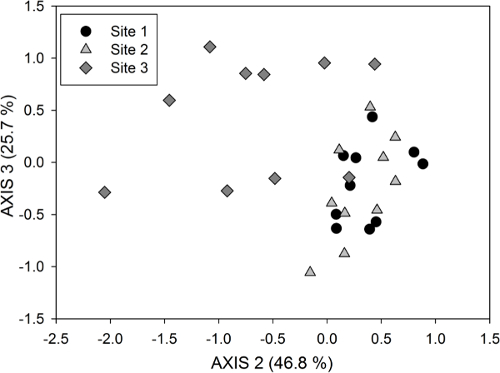
Figuur 3. Niet-metrische multidimensionale schaling (MVG) wijding van PLFAs (gebruik% van de totale PLFAs data) voor assen 2 en 3 van een 3-dimensionale oplossing. Deze ordening werd berekend onder toepassing van dezelfde data als die voor figuur 2. De jongste website (site 3) scheidt heel duidelijk uit de oudere twee locaties (locaties 2 en 3), die overlap in hun PLFA microbiële gemeenschap samenstelling te laten zien. De hoeveelheid variatie in de PLFA communitygegevens toegelicht aan elke as is opgenomen tussen haakjes; 72,5% van de variatie wordt verklaard door deze twee assen voor een 3-dimensionMVG voorlopige oplossing. Klik hier om een grotere versie van deze figuur te bekijken.
Discussie
Om te minimaliseren en een verkeerde interpretatie van PLFA gegevens te voorkomen, moet voorzichtig gegevens screening worden gedaan omdat sommige PLFAs die zijn gevonden in de bodem microbiële gemeenschap zijn ook aanwezig in een- en meercellige eukaryote organismen, zoals wortels, algen en bodemdieren. Daarnaast hebben Archaea niet PLFAs bevatten; in plaats daarvan worden Archaea membranen bestaan uit lipiden fosfolipiden ether (PLELs). Bijgevolg kan de PLFA protocol niet gebruikt om Archaea gemeenschappen karakteriseren bodem.
Associëren individuele PLFAs specifieke microbiële groepen moet worden betracht (zie de 2011 publicatie van Frostegård en collega's 34 voor een uitstekende bespreking van een aantal van de beperkingen van de PLFA methode). In plaats daarvan kan het beter zijn, zoals bij figuur 2, groeperen PLFAs basis van hun chemische structuur, bijvoorbeeld i) een rechte keten verzadigde PLFAs, ii) verzadigd PLFAs met mid-chain (10-methyl) vertakking, iii) terminale vertakte verzadigde vetzuren, iv) enkelvoudig onverzadigde PLFAs, v) meervoudig onverzadigde PLFAs en vi) hydroxy vetzuren.
Monstergewicht moet mogelijk worden aangepast op basis van de hoeveelheid extraheerbare PLFAs in een bepaald bodemmonster. Door niet aanpassen van de hoeveelheid grond geëxtraheerd minder microbieel actief bodems, gebruikers lopen risico van een voldoende PLFA responsen (pieken) bij de totale microbiële nauwkeurig te vertegenwoordigen niet verkregen. In sterk microbieel actief bodems met hoge concentraties PLFAs gebruikers lopen risico van overbelasting van de GC-kolom, waardoor kwantificatie van PLFAs voorkomen. In beide gevallen bodemmonsters moeten opnieuw worden geanalyseerd op PLFAs. Een goed uitgangspunt is om 0,5 g voor biologische bodemmonsters (zoals bos vloeren), en ongeveer 3 g voor minerale bodemmonsters toe te voegen. Aangezien de hoeveelheid extraheerbare PLFAs typisch samenhangt met de hoeveelheid organische koolstof in een bodem monster weechts kan worden aangepast op basis bodemkoolstofvoorraden, bijvoorbeeld, kan 1 g minerale grondmonster voldoende om een goede PLFA kwantificering verkrijgen wanneer koolstofgehalte is 10-15%, terwijl> 5 g nodig zijn wanneer het koolstofgehalte 0,5 ≤ %. Het is altijd een goed idee om een proefvaart met een paar voorbeelden te doen om het monster gewicht optimaliseren voordat de gehele set wordt uitgevoerd.
Gemeenschappelijke strategieën voor het oplossen van problemen van de PLFA protocol en GC-analyse zijn als volgt. Als het GC chromatogram basislijn te hoog is, moet het H2 gascilinder veranderd. Als het oplosmiddel of ISTD pieken ontbreken in het chromatogram, is er mogelijk een probleem met het monster injectie (bijvoorbeeld aangesloten spuit, probleem met autosampler, lege of ontbrekende flacon, fout met flesje positionering). Indien meer dan drie pieken worden gedetecteerd in de werkwijze / sample blank, van besmetting van de plano, en er is een grote kans dat eenzelfde verontreiniging (en) aanwezig in het monster GC c wordthromatograms. Vind de bron van contaminatie (gewoonlijk waterige media), of althans op dat de pieken die overeenkomen met de verontreiniging van het monster chromatogrammen en dat deze pieken niet opgenomen in een statistische analyse van de gegevens PLFA verwijderd. Ook is het een goed idee om te draaien hexaan spoelt tussen de monsters als carry-over wordt vermoed. Extra pieken in de hexaan spoeling wordt carry-over (dwz zwaardere componenten eluerende van de vorige run) te geven.
Lipiden zijn bijzonder gevoelig voor oxidatie, en bijzondere zorg moet worden uitgeoefend gedurende het protocol om monsters van de lucht en blootstelling aan licht, zoals ze op te slaan in het donker en houden ze onder stikstof te beschermen. 0 surrogaat standaard: Alle monsters en blanco's moeten voldoende C19 hebben. Een ontbrekende C19: 0 piek, in beide monsters of blanks, duidt op een slechte herstel of een volledig verlies van analyten. Een reactie van C19: 0 in de monsters die aanzienlijk lager is dan de methode / sample blanks duidt op een verlies van analyten ergens in het PLFA methodologie. Wanneer geconfronteerd met slechte C19: 0 terugwinning, alle aspecten van de procedure moeten zorgvuldig worden overwogen en onderzocht zoals de aanvankelijke extractie, alle stadia van monsteroverdrachtsstrook, SPE extractie, vetzuur methylering, drogen, opslag en monster manipuleren om het isoleren stadium of de stadia waarin analyten verloren. Anderzijds kan het zijn dat de winning van bepaalde bodemmonsters kan opleveren C19: 0, waarbij herstel van de surrogaat norm worden overschat. Tijdens het gebruik van twee standaarden ((PC (19: 0/19: 0) en MeC10: 0) is niet een absolute vereiste, we hebben dit zeer nuttig te zijn wanneer nodig om problemen op te lossen Zolang de MeC10:. 0 reactie is voldoende , het oplossen van problemen kan concentreren op de stappen voorafgaand aan GC-analyse.
Zoals eerder opgemerkt, moet voorzichtigheid worden betracht bij de interpretatie van ecologische betekenis en het ecosysteem relaties uitsluitend op basis van biomarkers ontlenend van PLFA data, omdat zuivere cultuur studies blijkt dat geïsoleerde bacteriestammen verschillende categorieën PLFAs zal bevatten. In plaats daarvan moet biomarker PLFAs worden beschouwd als een nuttige toevoeging in een reeks van gegevens bij het maken bredere ecologische gevolgtrekkingen. In de literatuur zijn individuele PLFAs voorgesteld en gebruikt als biomarkers voor verschillende microbiële groepen. Verzadigde PLFAs worden gewoonlijk gebruikt om gram-positieve bacteriën vertegenwoordigen en enkelvoudig onverzadigde PLFA worden gebruikt voor gram-negatieve bacteriën. Erkend biomarkers voor gram-negatieve bacteriën omvatten MOV met onverzadiging op de ω5 of ω7 positie, zoals C16: 1ω7, C18: 1ω7 en C18: 1ω5. Bovendien kunnen cyclopropyl vetzuren ook representatief gramnegatieve bacteriën 35 zijn. Derhalve kan PLFAs van gram-negatieve bacteriën worden berekend gelijk aan de som van A: 1ω5 + A: 1ω7 + A: 0cyclo. Erkend biomarkers voor gram-positieve bacteriën zijn terminaal vertakt sadigde vetzuren, iso-vertakte zoals C15: 0i, C16: 0i, C17: 0i; of anteiso-vertakte, zoals C15: 0a en C17: 0 bis. Verzadigde PLFAs met mid-keten (10-methyl) vertakking, zoals 10Me16: 0 en 10Me18: 0 zijn kenmerkend aanwezig in actinomyceten 36. Aldus kan PLFAs van gram-positieve bacteriën worden berekend gelijk aan de som van A: 0 (ISO, ANTEISO, 10-methyl).
Veel biomarkers in verband met schimmel PLFA worden vaak meervoudig onverzadigde, maar sommige schimmels biomarkers zijn enkelvoudig onverzadigde. Bijvoorbeeld in termen van fungale monounsaturated biomarkers, C16: 1ω5 is geïdentificeerd als indicator van arbusculaire mycorrhiza fungi (AMF) 37, C18: 1ω9 gebruikelijk in saprofytische schimmels en ectomycorrhizae bevatten doorgaans C16: 1ω9. De aanwezigheid van di-onverzadigde C18: 2ω6,9 komt vaak voor in combinatie met C18: 1ω9 en correleert ook goed met de schimmel sterol ergosterol, wat aangeeft dat C18: 2ω6,9 adequaat vertegenwoordigen ectomycorrhizae en saprofytische schimmels 38. De tri-onverzadigde C18: 3ω 6,9,12 is ook gebruikt als een biomarker voor schimmels 10; echter, C18: kan 3ω6c worden gevonden in andere eukaryotische organismen, met inbegrip van planten en algen, maar het is meestal niet gevonden in bacteriën. In termen van de bodem protisten, C20: heeft 4ω6c erkend als een protist biomarker 39, hoewel andere werkzaamheden niet C20 detecteren: 4ω6c zelfs wanneer levensvatbare populaties protist visueel werden bevestigd met behulp van licht microscopie 40.
Veel studies richten ecologische vragen met betrekking tot de totale bodem microbiële gemeenschap door gebruik te maken van multivariate wijding technieken als PLFA data analyse-instrument. Bij gebruik van deze benadering, hebben sommige auteurs gekozen zeldzame PLFAs uit de dataset uitsluiten verwijderen PLFAs die in minder dan 5% van de monsters 4 zijn. De normale verzadigde C16: 0 en C18: 0 zijn er in overvloed in alle bodem micro-organismen, met inbegrip van prokaryoten en eukaryotes. Vandaar dat sommige onderzoekers kiezen om deze PLFAs voorafgaand aan de statistische analyse aan de hand dat ze niet kunnen worden gevoelige indicatoren van de samenstelling van de bodem microbiële gemeenschap te verwijderen - hoewel C16: 0 en C18: 0 moeten nog worden meegenomen bij het optellen van alle PLFAs voor een index van microbiële biomassa. In termen van de statistische analyses veel onderzoekers kiezen voor een niet-metrische multidimensionale schaling (MVG) ordinatie voeren als deze techniek is geschikt om gegevens die niet normaal kan worden verdeeld 33. Aanvullende analyses met betrekking tot categorische variabelen kunnen onder andere indicatorsoorten analyse, die het optreden van specifieke PLFAs om categorische groeperingen en multi reactie permutatie procedures (MRPP), die kan helpen bij het bepalen gelijkenissen of verschillen tussen microbiële gemeenschappen toegewezen aan categorische groepen kunnen betrekking hebben. Bovendien kan multivariate regressie bomen (MRT) bijzonder nuttig zijn wanneer de invloed van verschillende experimentele variabelen ofbehandelingen moet worden beoordeeld als mogelijke verklarende variabelen 5 (bijvoorbeeld, bodem textuur, vocht, regeneratie leeftijd).
Eenmaal gevestigd, de PLFA protocol is een relatief eenvoudige analytische methode die zeer nuttig kunnen zijn bij het kwantificeren van de bodem microbiële reactie op veranderingen in het milieu en antropogene verstoring. Hoewel moleculaire technieken zoals genetische fingerprinting zijn beter geschikt voor de gedetailleerde karakterisering van microbiële gemeenschappen, de PLFA werkwijze biedt het voordeel dat kwantitatieve informatie over de totale microbiële biomassa 34. In ons onderzoekslaboratorium, kan een persoon gemakkelijk verwerken van een set van 20 monsters meer dan 4 dagen, en we hebben het protocol hier gepresenteerd aan een robuuste en reproduceerbare techniek om de bodem biologische kwaliteit te beoordelen zijn gevonden.
De kracht van de PLFA werkwijze kan sterk worden verlengd door koppeling aan stabiele isotopen analyse 41, 42. Specifiek toevoeging oF 13 C-gelabelde substraten bodem maakt de kwantificering van substraat opname in bodemmicro-organismen hoewel isotopische analyse van individuele PLFAs 41. Bovendien lijkt deze methode om een veelbelovend instrument om trofische schakels in de bodem voedselwebben 42 helderen.
Openbaarmakingen
De auteurs hebben niets te onthullen.
Dankbetuigingen
Dit werk werd gedeeltelijk gefinancierd door de Natural Sciences and Engineering Council of Canada. De auteurs danken Jela Burkus, Donna Macey en Jennifer Lloyd voor hun technische expertise en hun bijdrage aan de optimalisatie van deze methode.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Pierce Reacti-Vap III-evaporator gassing manifold with 27 ports | Gebaat in stappen 1-3 | ||
| Compressed Nitrogen | Praxair | Ni-T | Gevaarlijk: alleen gebruiken na training en minimaliseer contact en gebruik; Gebruikt in stappen 1-3 |
| Disposable centrifuge tube and Teflon-lined cap | Fisher Scientific | 05-569-3 | Gebruikt voor stap 1 (1 per monster) en stap 2 (1 per monster) |
| Disposable glass long-necked Pasteur pipettes | Fisher Scientific | 13-678-20D | Gebruikt voor stap 1 (2 per monster) |
| Disposable glass short-necked Pasteur pipettes | Fisher Scientific | 13-678-4 | Gebruikt voor stap 2 (1 per monster), stap 3 (1 per monster), GC-analyse (1 per monster) en een voor elk type oplossing dat wordt gedispenseerd tijdens PLFA-methoden (~10 per batch monsters) |
| Elastic band | Grand & Toy | 42199 | 1 per monster voor vriesdrogen |
| Freeze Dryer-Labconco 7806002 en 7753000 | Gebruikt voor het bereiden van monsters voor PLFA-analyse - gebruik welk model uw lab ook heeft | ||
| Freezer (-20 °C, -80 °C) | Revco | ULT2586-5-A36 | Minus 80 °C wordt gebruikt voor het invriezen van vers verzamelde bodemmonsters, -20 °C wordt gebruikt voor het bewaren van monsters aan het einde van elk van de 3 stappen van PLFA-analyse |
| Gas chromatograph - Agilent 6890 Series capillary gas chromatograph (GC; Wilmington, DE) equipped with a 50 m Ultra 2 (5%-phenyl)-methylpolysiloxane column | Agilent Technologies | Gebruikt voor GC-analyse, andere modellen van GC kunnen ook worden gebruikt (1 nodig) | |
| Analytical column | Agilent Technologies | 19091B-105 | |
| Gas chromatograph insert | Agilent Technologies | 5183-4692 | Gebruikt voor GC-analyse (1 per monster) |
| Gas chromatograph vial and lid | Agilent Technologies | 5188-6592 | Gebruikt voor GC-analyse (1 per monster) |
| Hexanes | Fisher Scientific | H292-4 | Gevaarlijk: alleen gebruiken in afzuiging, Lees MSDS, minimaliseer gebruik en draag geschikte PPE; Totaal volume per monster = 4 ml (2,0 ml + 2,0 ml (stap 3)) |
| Hot water bath -Isotemp 220 | Fisher Scientific | Gebruikt voor stap 3 (1 per batch monsters) | |
| Kimwipe | Fisher Scientific | 06-666-2 | Gebruikt voor het vriesdrogen van monsters |
| KOH, ACS grade | Fisher Scientific | P250-500 | Gevaarlijk: Alleen gebruiken in afzuiging, Lees MSDS, minimaliseer gebruik en draag geschikte PPE; Gebruikt voor het maken van citraatbuffer (gebruikt in stap 1) en methanolische KOH (stap 3) |
| Lab quake end-over-end shaker for centrifuge tubes | Barnstead/Thermolyne | 3,625,485 | Gebruikt voor stap 1 (1 per batch monsters met geschikte houdcapaciteit) |
| MeC10:0 methyl decanoate internal standard | Sigma-Aldrich | 299030-2.5G | Gebruikt voor GC-analyse |
| Methanol | Fisher Scientific | A454-4 | Gevaarlijk: Alleen gebruiken in afzuiging, Lees MSDS, minimaliseer gebruik en draag geschikte PPE; Totaal volume per monster = 15,5 ml (5 ml + 5 ml (stap 1) + 5 ml (stap 2) + 0,5 ml (stap 3)) |
| MIDI Peak Identification Software | MIDI, Inc., Newark, DE | Gebruikt voor het interpreteren van GC-analyse-uitvoer | |
| MIDI Calibration Standard Mix for Microbial Identification System | Lab Sphere Inc | 1200-A | Gebruikt als een kalibratiemix voor TSBA 40 |
| Nitrile gloves | Fisher Scientific | 27-058-52 | Altijd gebruikt bij het uitvoeren van PLFA-labwerk |
| pH Meter - Accumet XL200 | Fisher Scientific | Gebruikt voor het maken van citraatbuffer | |
| Pipette (0.2 - 2 ml) - Socorex - Calibra Digital 832 Macropipette | Socorex | 832.02 | Gebruikt in alle stappen (1 per monster) |
| 250 µl gastight syringe | Hamilton | 1725 | Gebruikt voor GC-analyse (1 per monster) |
| silver shield gloves | Sigma-Aldrich | Z529575 | Voor gebruik bij het hanteren van chloroform |
| solid phase extraction (SPE) column | Agilent Technologies | 5982-2265 | Gebruikt voor stap 2 (1 per monster) |
| SPE glass column holder with spigots and vacuum apparatus attached | Sigma-Aldrich | Gebruikt voor stap 2 (1 per batch monsters) | |
| Vortex - Barnstead International Maxi Mix II- M37615 | Barnstead International | M37615 | Gebruikt in stappen 1-3 |
| Water - ultra-pure and Chromosolv HPLC grade | Sigma-Aldrich | 270733-4L | Gebruikt gedurende de analyse |
| Whirl-Pak® bags | Fisher Scientific | 01-812-120 | Gebruikt bij monsterverzameling - 2 zakjes vereist per verzameld monster |
Referenties
- Zelles, L. Fatty acid patterns of phospholipids and lipopolysaccharides in the characterisation of microbial communities in soil: a review. Biol. Fert. Soils. 29, 111-129 (1999).
- ISO/TS 29843-1: 2010-Soil quality-determination of soil microbial diversity. , ISO/TC. Geneva, Switzerland. Available from: http://www.iso.org/iso/home.htm (2010).
- Swallow, M. J. B., Quideau, S. A. Moisture effects on microbial communities in boreal forest floors are stand-dependent. Appl. Soil Ecol. 63, 120-126 (2012).
- McIntosh, A. C. S., Macdonald, S. E., Quideau, S. A. Linkages between the forest floor microbial community and resource heterogeneity within mature lodgepole pine forests. Soil Biol. Biochem. 63, 61-72 (2013).
- Card, S. M., Quideau, S. A. Microbial community structure in restored riparian soils of the Canadian prairie pothole region. Soil Biol. Biochem. 42, 1463-1471 (2010).
- McKinley, V. L., Peacock, A. D., White, D. C. Microbial community PLFA and PHB responses to ecosystem restoration in tallgrass prairie soils. Soil Biol. Biochem. 37, 1946-1958 (2005).
- Bossio, D. A., Scow, K. M., Gunapala, N., Graham, K. J. Determinants of soil microbial communities: effects of agricultural management, season, and soil type on phospholipid fatty acid profiles. Microbial Ecol. 36, 1-12 (1998).
- Hannam, K. D., Quideau, S. A., Kishchuk, B. E. Forest floor microbial communities in relation to stand composition and timber harvesting in northern Alberta. Soil Biol. Biochem. 38, 2565-2575 (2006).
- Pettersson, M., Bååth, E. The rate of change of a soil bacterial community after liming as a function of temperature. Microbial Ecol. 46, 177-186 (2003).
- Degrood, S. H., Claassen, V. P., Scow, K. M. Microbial community composition on native and drastically disturbed serpentine soils. Soil Bio.l Biochem. 37, 1427-1435 (2005).
- Quideau, S. A., Swallow, M. J. B., Prescott, C. E., Grayston, S. J., Oh, S. -W. Comparing soil biogeochemical processes in novel and natural boreal forest ecosystems. Biogeosciences. 10, 5651-5661 (2013).
- Hahn, A. S., Quideau, S. A. Long-term effects of organic amendments on the recovery of plant and soil microbial communities following disturbance in the Canadian boreal forest. Plant Soil. 363, 331-334 (2013).
- Swallow, M., Quideau, S. A., MacKenzie, M. D., Kishchuk, B. E. Microbial community structure and function: The effect of silvicultural burning and topographic variability in northern Alberta. Soil Biol. Biochem. 41, 770-777 (2009).
- Pennanen, T. Microbial communities in boreal coniferous forest humus exposed to heavy metals and changes in soil pH-a summary of the use of phospholipid fatty acids. Biolog (R) and H-3-thymidine incorporation methods in field studies. Geoderma. 100, 91-126 (2001).
- Margasin, R., Hämmerle, M., Tscherko, D. Microbial activity and community composition during bioremediation of diesel-oil-contaminated soil: effects of hydrocarbon concentration, fertilizers, and incubation time. Microbial Ecol. 53, 259-269 (2007).
- Štursová, M., Šnajdr, J., Cajthaml, T., Bárta, J., Šantrůčková, H., Baldrian, P. When the forest dies: the response of forest soil fungi to a bark beetle-induced tree dieback. ISME J. 8, 1920-1931 (2014).
- Bligh, E. G., Dyer, W. J. A rapid method of total lipid extraction. Can. J. Biochem. Phys. 37, 911-917 (1959).
- White, D. C., Davis, W. M., Nickels, J. S., King, J. D., Bobbie, R. J. Determination of the sedimentary microbial biomass by extractible lipid phosphate. Oecologia. 40, 51-62 (1979).
- Tunlid, A., Hoitink, H. A. J., Low, C., White, D. C. Characterization of bacteria that suppress Rhizoctonia damping-off in bark compost media by analysis of fatty acid biomarkers. Appl. Environ. Microb. 55, 1368-1374 (1989).
- Bobbier, J., White, D. C. Characterization of benthic microbial community structure by high resolution gas chromatography of fatty acid methyl esters. Appl. Environ. Microb. 39, 1212-1222 (1980).
- Tunlid, A., et al. Determination of phospholipid ester-linked fatty acids and poly P-hydroxybutyrate for the estimation of bacterial biomass and activity in the rhizosphere of the rape plant Brassica napus (L.). Can. J. Microbiol. 31, 1113-1119 (1985).
- Frostegård, A., Tunlid, A., Bååth, E. Microbial biomass measured as total lipid phosphate in soils of different organic content. J. Microbiol. Meth. 14, 151-163 (1991).
- Frostegård, Å, Bååth, E., Tunlid, A. Shifts in the structure of soil microbial communities in limed forests as revealed by phospholipid fatty acid analysis. Soil Biol. Biochem. 25, 723-730 (1993).
- Burns, R. G. Soil Biology and Biology Citation Classic X. Soil Biol. Biochem. 43, 1619-1620 (2011).
- Zelles, L., Bai, Q. Y., Beck, T., Beese, F. Signature fatty acids in phospholipid and lipopolysaccharides as indicators of microbial biomass and community structure in agricultural soils. Soil Biol. Biochem. 24, 317-323 (1992).
- Zelles, L., Bai, Q. Y. Fractionation of fatty acids derived from soil lipids by solid phase extraction and their quantitative analysis by GC-MS. Soil Biol. Biochem. 25, 495-507 (1993).
- White, D. C., Ringelberg, D. B. Signature lipid biomarker analysis. Techniques in Microbial Ecology. Burlage, R. S., Atlas, R., Stahl, D., Geesey, G., Sayler, G. , Oxford University Press. New York. 255-272 (1998).
- Bird, J. A., Herman, D. J., Firestone, M. K. Rhizosphere priming of soil organic matter by bacterial groups in a grassland soil. Soil Biol. Biochem. 43, 718-725 (2011).
- Waldrop, M. P., Firestone, M. K. Microbial community utilization of recalcitrant and simple carbon compounds: impact of oak-woodland plant communities. Oecologia. 138, 275-284 (2004).
- Chowdhury, T. R., Dick, R. P. Standardizing methylation method during phospholipid fatty acid analysis to profile soil microbial communities. J. Microbiol. Meth. 88, 285-291 (2012).
- Buyer, J. S., Sasser, M. High throughput phospholipid fatty acid analysis of soils. Appl. Soil Ecol. 61, 127-130 (2012).
- Christie, W. W., Han, X. Gas chromatographic analysis of fatty acid derivatives. Lipid analysis, isolation, separation, identification, and lipidomic analysis. , Woodhead Publishing Ltd. Cambridge, UK. 159-180 (2010).
- McCune, B., Grace, J. B. Analysis of ecological communities. , MjM Software Design. Oregon. 300(2002).
- Frostegård, A., Tunlid, A., Bååth, E. Use and misuse of PLFA measurements in soils. Soil Biol. Biochem. 43, 1621-1625 (2011).
- Högberg, M. N., Högberg, P., Myrold, D. D. Is microbial community composition in boreal forest soils determined by pH, C-to-N ratio, the trees, or all three. Oecologia. 150, 590-601 (2007).
- Brennan, P. Mycobacterium and other actinomycetes. Microbial Lipids. Ratledge, C., Wilkinson, S. , Academic Press. London. 203-298 (1988).
- Olsson, P. A. Signature fatty acids provide tools for determination of the distribution and interactions of mycorrhizal fungi in soil. FEMS Microbiol. Ecol. 29, 303-310 (1999).
- Frostegård, Å, Bååth, E. The use of phospholipid fatty acid analysis to estimate bacterial and fungal biomass in soil. Biol. Fert. Soils. 22, 59-65 (1996).
- Myers, R. T., Zak, D. R., White, D. C., Peacock, A. Landscape-level patterns of microbial community composition and substrate use in upland forest ecosystems. Soil Sci. Soc. Am. J. 65, 359-367 (2001).
- Swallow, M. J. B., Quideau, S. A., Norris, C. E. Ciliate dependent production of microbial anthranilic acid occurring within aspen litter. Soil Biol. Biochem. 60, 113-121 (2013).
- Norris, C. E., Quideau, S. A., Macey, D. E. Processing of 13C glucose in mineral soil from aspen, spruce, and novel ecosystems in the Athabasca Oil Sands Region. Appl. Soil Ecol. 71, 24-32 (2013).
- Ruess, L., Chamberlain, P. M. The fat that matters: Soil food web analysis using fatty acids and their carbon stable isotope signature. Soil Biol. Biochem. 42, 1898-1910 (2010).
Herprints en machtigingen
