Dit protocol leidt beginners in de bio-informatica door een inleidende CUT&RUN-analysepijplijn die gebruikers in staat stelt om een eerste analyse en validatie van CUT&RUN-sequencinggegevens te voltooien. Het voltooien van de hier beschreven analysestappen, in combinatie met stroomafwaartse piekannotatie, stelt gebruikers in staat om mechanistische inzichten te verkrijgen in chromatineregulatie.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Inleidende analyse en validatie van CUT&RUN-sequencinggegevens
In dit artikel
Samenvatting
Samenvatting
De CUT&RUN-techniek maakt het mogelijk om eiwit-DNA-interacties in het genoom te detecteren. Typische toepassingen van CUT&RUN zijn onder meer profileringsveranderingen in histonstaartmodificaties of het in kaart brengen van transcriptiefactorchromatinebezetting. De wijdverbreide acceptatie van CUT&RUN wordt deels gedreven door technische voordelen ten opzichte van conventionele ChIP-seq, waaronder lagere celinvoervereisten, lagere sequencingdieptevereisten en verhoogde gevoeligheid met verminderd achtergrondsignaal als gevolg van een gebrek aan verknopingsmiddelen die anders antilichaamepitopen maskeren. De wijdverbreide acceptatie van CUT&RUN is ook bereikt door het genereuze delen van reagentia door het Henikoff-lab en de ontwikkeling van commerciële kits om de acceptatie voor beginners te versnellen. Naarmate de technische acceptatie van CUT&RUN toeneemt, worden CUT&RUN-sequencing, analyse en validatie kritieke knelpunten die moeten worden overwonnen om volledige acceptatie door voornamelijk natte laboratoriumteams mogelijk te maken. CUT&RUN-analyse begint meestal met kwaliteitscontroles op onbewerkte sequencing-lezingen om de sequencingdiepte, leeskwaliteit en mogelijke vooroordelen te beoordelen. Reads worden vervolgens uitgelijnd met een referentiegenoomsequentie-assemblage en vervolgens worden verschillende bio-informaticatools gebruikt om genomische regio's van eiwitverrijking te annoteren, de interpreteerbaarheid van gegevens te bevestigen en biologische conclusies te trekken. Hoewel er meerdere in silico-analysepijplijnen zijn ontwikkeld om CUT&RUN-gegevensanalyse te ondersteunen, maken hun complexe multi-modulestructuur en het gebruik van meerdere programmeertalen de platforms moeilijk voor beginners in de bio-informatica die misschien niet bekend zijn met meerdere programmeertalen, maar de CUT&RUN-analyseprocedure willen begrijpen en hun analysepijplijnen willen aanpassen. Hier bieden we een stap-voor-stap CUT&RUN-analysepijplijnprotocol in één taal, ontworpen voor gebruikers met elk niveau van bioinformatica-ervaring. Dit protocol omvat het uitvoeren van kritische kwaliteitscontroles om te valideren dat de sequentiegegevens geschikt zijn voor biologische interpretatie. We verwachten dat het volgen van het inleidende protocol in dit artikel in combinatie met downstream piekannotatie gebruikers in staat zal stellen biologische inzichten te halen uit hun eigen CUT&RUN-datasets.
Inleiding
Het vermogen om interacties tussen eiwitten en genomisch DNA te meten is van fundamenteel belang voor het begrijpen van de biologie van chromatineregulatie. Effectieve tests die de chromatinebezetting voor een bepaald eiwit meten, leveren ten minste twee belangrijke stukjes informatie op: i) genomische lokalisatie en ii) eiwitovervloed in een bepaald genoomgebied. Het volgen van de rekruterings- en lokalisatieveranderingen van een eiwit dat van belang is voor chromatine kan directe doelloci van het eiwit onthullen en mechanistische rollen van dat eiwit onthullen in op chromatine gebaseerde biologische processen zoals regulatie van transcriptie, DNA-reparatie of DNA-replicatie. De technieken die vandaag beschikbaar zijn om eiwit-DNA-interacties te profileren, stellen onderzoekers in staat om regulatie met een ongekende resolutie te onderzoeken. Dergelijke technische vooruitgang is mogelijk gemaakt door de introductie van nieuwe chromatineprofileringstechnieken, waaronder de ontwikkeling van Cleavage Under Targets and Release Using Nuclease (CUT&RUN) door het Henikoff-laboratorium. CUT&RUN biedt verschillende technische voordelen ten opzichte van conventionele chromatine-immunoprecipitatie (ChIP), waaronder lagere vereisten voor celinvoer, lagere vereisten voor sequencingdiepte en een verhoogde gevoeligheid met een verminderd achtergrondsignaal als gevolg van een gebrek aan verknopingsmiddelen die anders antilichaamepitopen maskeren. Het toepassen van deze techniek om chromatineregulatie te bestuderen vereist een grondig begrip van het principe dat ten grondslag ligt aan de techniek, en een goed begrip van hoe CUT&RUN-gegevens moeten worden geanalyseerd, gevalideerd en geïnterpreteerd.
De CUT&RUN-procedure begint met het binden van cellen aan Concanavalin A geconjugeerd aan magnetische kralen om manipulatie van lage celaantallen gedurende de hele procedure mogelijk te maken. Geïsoleerde cellen worden gepermeabiliseerd met behulp van een mild wasmiddel om de introductie van een antilichaam te vergemakkelijken dat zich richt op het eiwit van belang. Microkokkennuclease (MNase) wordt vervolgens gerekruteerd naar het gebonden antilichaam met behulp van een proteïne A- of proteïne A/G-tag die aan het enzym is vastgemaakt. Calcium wordt geïntroduceerd om enzymatische activiteit op gang te brengen. MNase-spijsvertering resulteert in mono-nucleosomale DNA-eiwitcomplexen. Calcium wordt vervolgens gechelateerd om de verteringsreactie te beëindigen, en korte DNA-fragmenten van de MNase-vergisting worden vrijgegeven uit kernen en vervolgens onderworpen aan DNA-zuivering, bibliotheekvoorbereiding en high-throughput sequencing1 (Figuur 1).
In silico-benaderingen om de eiwitbezetting in het genoom in kaart te brengen en te kwantificeren, hebben zich parallel ontwikkeld met de natte laboratoriumbenaderingen die worden gebruikt om die DNA-eiwitinteracties te verrijken. Identificatie van regio's met verrijkte signalen (pieken) is een van de meest kritieke stappen in de bioinformatica-analyse. Initiële ChIP-seq-analysemethoden gebruikten algoritmen zoals MACS2 en SICER3, die statistische modellen gebruikten om bonafide eiwit-DNA-bindingsplaatsen te onderscheiden van achtergrondruis. De lagere achtergrondruis en de hogere resolutie van CUT&RUN-gegevens maken sommige piekaanroepprogramma's die worden gebruikt in ChIP-seq-analyse echter ongeschikt voor CUT&RUN-analyse4. Deze uitdaging benadrukt de behoefte aan nieuwe tools die beter geschikt zijn voor de analyse van CUT&RUN-gegevens. SEACR4 is zo'n tool die onlangs is ontwikkeld om piekaanroepen van CUT&RUN-gegevens mogelijk te maken, terwijl de beperkingen worden overwonnen die gepaard gaan met tools die doorgaans worden gebruikt voor ChIP-seq-analyse.
Biologische interpretaties van CUT&RUN-sequentiegegevens worden getrokken uit de outputs stroomafwaarts van piekoproepen in de analysepijplijn. Er kunnen verschillende functionele annotatieprogramma's worden geïmplementeerd om de potentiële biologische relevantie van de opgeroepen pieken te voorspellen op basis van CUT&RUN-gegevens. Het Gene Ontology (GO)-project biedt bijvoorbeeld een gevestigde functionele identificatie van genen die van belang zijn 5,6,7. Verschillende softwaretools en bronnen vergemakkelijken GO-analyse om genen en genensets te onthullen die verrijkt zijn tussen CUT&RUN-pieken 8,9,10,11,12,13,14. Bovendien maakt visualisatiesoftware zoals Deeptools15, Integrative genomics viewer (IGV)16 en UCSC Genome Browser17 visualisatie van signaaldistributie en patronen in interessante regio's in het genoom mogelijk.
Het vermogen om biologische interpretaties te trekken uit CUT&RUN-gegevens hangt in belangrijke mate af van de validatie van de gegevenskwaliteit. Kritieke componenten die moeten worden gevalideerd, zijn onder meer de beoordeling van: i) de kwaliteit van de CUT&RUN-bibliotheeksequencing, ii) het repliceren van gelijkenis, en iii) signaaldistributie in piekcentra. Het voltooien van de validatie van alle drie de componenten is van cruciaal belang om de betrouwbaarheid van de CUT&RUN-bibliotheekvoorbeelden en de downstream-analyseresultaten te garanderen. Daarom is het essentieel om inleidende CUT&RUN-analysegidsen op te stellen om bio-informatica-beginners en natte laboratoriumonderzoekers in staat te stellen dergelijke validatiestappen uit te voeren als onderdeel van hun standaard CUT&RUN-analysepijplijnen.
Naast de ontwikkeling van het natte lab CUT&RUN-experiment zijn er verschillende in silico CUT&RUN-analysepijplijnen, zoals CUT&RUNTools2.0 18,19, nf-core/cutandrun20 en CnRAP21, ontwikkeld om CUT&RUN-data-analyse te ondersteunen. Deze tools bieden krachtige benaderingen voor het analyseren van single-cell en bulk CUT&RUN- en CUT&Tag-datasets. De relatief complexe modulaire programmastructuur en de vereiste vertrouwdheid met meerdere programmeertalen om deze analysepijplijnen uit te voeren, kunnen echter de acceptatie belemmeren door beginners in de bio-informatica die de CUT&RUN-analysestappen grondig willen begrijpen en hun eigen pijplijnen willen aanpassen. Het omzeilen van deze barrière vereist een nieuwe inleidende CUT&RUN-analysepijplijn die wordt geleverd in eenvoudige stap-voor-stap scripts die zijn gecodeerd met behulp van een eenvoudige programmeertaal.
In dit artikel beschrijven we een eenvoudig CUT&RUN-analysepijplijnprotocol in één taal dat stapsgewijze scripts biedt die worden ondersteund met gedetailleerde beschrijvingen om nieuwe en beginnende gebruikers in staat te stellen CUT&RUN-sequencinganalyse uit te voeren. Programma's die in deze pijplijn worden gebruikt, zijn openbaar beschikbaar door de oorspronkelijke ontwikkelaarsgroepen. De belangrijkste stappen die in dit protocol worden beschreven, zijn onder meer leesuitlijning, piekoproepen, functionele analyse en, het meest kritisch, validatiestappen om de monsterkwaliteit te beoordelen om de geschiktheid en betrouwbaarheid van de gegevens voor biologische interpretatie te bepalen (Figuur 2). Bovendien biedt deze pijplijn gebruikers de mogelijkheid om analyseresultaten te vergelijken met openbaar beschikbare CUT&RUN-datasets. Uiteindelijk dient dit CUT&RUN-analysepijplijnprotocol als een inleidende gids en referentie voor beginners op het gebied van bio-informatica-analyse en natte laboratoriumonderzoekers.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
OPMERKING: Informatie voor CUT&RUN fastq-bestanden in GSE126612 is beschikbaar in Tabel 1. Informatie met betrekking tot de softwaretoepassingen die in dit onderzoek zijn gebruikt, staat vermeld in de materiaaltabel.
1. Easy-Shells_CUTnRUN pipeline downloaden van de Github-pagina
- Open de terminal van het besturingssysteem.
OPMERKING: Als de gebruiker niet zeker weet hoe de terminal in macOS en Windows moet worden geopend, raadpleegt u deze webpagina (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Voor Linux, zie deze webpagina (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Download de gecomprimeerde analysepijplijn van Github door wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip in de terminal te typen.
- Na het downloaden van het zip-bestand, decomprimeert u het gedownloade zipbestand door unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ in de terminal te typen.
- Verwijder na de decompressie het zip-bestand door rm ~/Desktop/Easy-Shells_CUTnRUN.zip in de terminal te typen en wijzig de mapnaam door mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN te typen.
- Nadat u het gecomprimeerde bestand hebt verwijderd, typt u chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh in de terminal om de uitvoerbare machtiging voor alle shell-scripts binnen de werkmap in te stellen. Vanaf nu typt u gewoon het pad en de naam van deze shell-scripts in terminal of sleept u de scripts naar terminal en enter om deze shell-scripts in terminal uit te voeren.
OPMERKING: De Bash-shell is meestal vooraf geïnstalleerd op de meeste Linux-distributies. Recente macOS-versies bieden echter niet langer een vooraf geïnstalleerde Bash-shell. Als het systeem geen Bash heeft, installeer dan eerst de Bash-shell. Bezoek de onderstaande links voor instructies die beschrijven hoe u de Bash-shell installeert in Linux OS (https://ioflood.com/blog/install-bash-shell-linux/) en macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The%20first%20thing%20you%20will,you%20will%20see%20the%20following:). Deze stap-voor-stap shell scripts zijn geschreven om één map ~/Desktop/GSE126612 te creëren om het grootste deel van deze CUT&RUN analyse binnen deze directory uit te voeren zonder dat er wijzigingen nodig zijn. Als de gebruiker begrijpt hoe deze shell-scripts moeten worden gebruikt, kunnen gebruikers deze shell-scripts herzien en aanpassen om andere CUT&RUN-datasets te analyseren en opties aan te passen aan projectspecifieke behoeften. Als u deze shellscripts wilt lezen en bewerken, kunt u overwegen Visual Studio Code (https://code.visualstudio.com/) te gebruiken als een optie voor een gebruiksvriendelijk programma dat beschikbaar is voor de belangrijkste besturingssystemen.
2. Installeren van de programma's die nodig zijn voor Easy Shells CUTnRUN
- Onder de shell-scripts met de naam van Script_01_installation_***.sh, ontdek het shell-script waarvan de naam het besturingssysteemtype van het systeem van de gebruiker bevat. Momenteel ondersteunt Easy Shells CUTnRUN het installatiescript voor macOS-, Debian/Ubuntu- en CentOS/RPM-gebaseerde systemen.
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Bedien in de terminal het installatieshell-script door ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh te typen of sleep het shell-scriptbestand naar de terminal en voer in.
- Lees Test_README.md-bestand in de map /path/to/SEACR-1.3/Testfiles. Volg de instructies in het README-bestand om te verduidelijken of de SEACR in het systeem van de gebruiker correct werkt.
OPMERKING: Het is van cruciaal belang om de SEACR-functie te valideren met testbestanden die door de SEACR Github-pagina worden gegeven om de juiste piekoproepresultaten te verkrijgen uit CUT&RUN-gegevens. Volg daarom direct na de installatie van SEACR de instructie van Test_README.md in /path/to/SEACR-1.3/Testfiles . Hoewel Easy Shells CUTnRUN installatieshell-scripts biedt voor sommige besturingssystemen, werken deze scripts mogelijk niet in het systeem van sommige gebruikers om alle programma's te installeren die nodig zijn voor Easy Shells CUTnRUN. Als er een probleem is met de installatie, raadpleeg dan de originele website van het verwijderde programma of vraag hulp via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
3. Downloaden van de publiek beschikbare CUT&RUN dataset van Sequence Read Archive (SRA)
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script zal: (i) Maak een map (~/Desktop/GSE126612/fastq) en download een lijst met SRA-bestanden geschreven in een tekstbestand (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) in de fastq-map. De SRR_list.txt bevat bijvoorbeeld de fastq-bestanden van een subset van GSE126612 CUT&RUN-samples. (ii) Download de onbewerkte fastq-bestanden in de fastq-map. (iii) Maak één map aan (~/Desktop/GSE126612/log/fastq) en noteer een logbestand (download-fastq_log.txt) en een gedownload voorbeeldinformatiebestand (SRR_list_info.txt) in deze logmap. - Controleer na het uitvoeren van het script het logboekbestand. Als er een foutmelding in het logboekbestand staat, corrigeert u de fout en probeert u stap 3.3 opnieuw. Als er een probleem is om het probleem op te lossen, vraag dan hulp op de webpagina met Easy Shells CUTnRUN github-problemen (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Om de praktijk van deze CUT&RUN-analysepijplijn te vergemakkelijken, worden de volgende openbaar beschikbare monsters uit SRA gehaald: één monster van nepcontrole (IgG), drie monsters van een chromatinearchitectuur- en transcriptiefactoreiwit (CTCF), vier monsters die overeenkomen met een 'actieve' histonmarkering (H3K27Ac) en drie monsters die overeenkomen met regio's van transcriptionele initiatie gemarkeerd door RNA-polymerase II (RNAPII-S5P). Sequencing werd uitgevoerd als paired-end, daarom worden twee bestanden per monster gekoppeld.
4. Eerste kwaliteitscontrole van de onbewerkte sequentiebestanden
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh in de terminal of sleep het shell-script naar de terminal en voer in.
OPMERKING: Dit shell-script zal: (i) het FastQC-programma uitvoeren voor alle onbewerkte fastq-bestanden in de map ~/Desktop/GSE126612/fastq en de bestanden van het kwaliteitscontrolerapport opslaan in de map ~/Desktop/GSE126612/fastqc.1st . (ii) Noteer een logbestand (fastqc.1st.log.SRR-number.txt) per een FastQC-run in een logmap (~/Desktop/GSE126612/log/fastqc.1st). - Nadat u het shellscript hebt uitgevoerd, bekijkt u het logboekbestand om het succes van de uitvoering te verduidelijken. Als er een foutmelding in het logbestand staat, corrigeert u de fout en herhaalt u stap 4.3. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Onder de uitvoerbestanden bevatten fastqc.html bestanden gebruiksvriendelijke kwaliteitscontroleresultaten. Als er ernstige kwaliteitsproblemen zijn, bespreek dit dan met collega's van bio-informatica om te bepalen of de gegevens geschikt zijn voor downstream-analyse. Vergelijkbare kwaliteitscontrolerapporten worden gebruikt om een verbeterde gegevenskwaliteit te bevestigen na het trimmen van de adapter. Als u dit script voor andere gegevenssets wilt gebruiken, bewerkt u het pad van de werk- en uitvoermappen om aan de behoeften van de gebruiker te voldoen. Een opmerkelijk verschil bij het interpreteren van QC van CUT&RUN in vergelijking met ChIP-seq reads is dat dubbele reads in CUT&RUN niet noodzakelijkerwijs PCR-duplicaten aangeven. Dit komt omdat gerekruteerde MNase op dezelfde of vergelijkbare locaties binnen experimentele groepen zal verteren.
5. Kwaliteit en adapter trimmen voor onbewerkte sequencing-bestanden
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh in de terminal of sleep het Script_04_trimming.sh script naar de terminal en voer in.
OPMERKING: Dit shell-script zal: (i) Voer het Trim-Galore-programma uit voor alle onbewerkte fastq-bestanden in ~/Desktop/GSE126612/fastq om adapter- en kwaliteitstrimmen uit te voeren. (ii) Maak één map (~/Desktop/GSE126612/trimmed) en sla de Trim-Galore uitvoerbestanden op in de bijgesneden map. (iii) Maak één logmap aan (~/Desktop/GSE126612/log/trim_galore) en noteer een logbestand trim_galore_log_RSS-number.txt per Trim-Galore run. - Controleer na voltooiing van de uitvoering het logboekbestand zorgvuldig. Als er een foutmelding in het logbestand staat, corrigeert u de fout en herhaalt u stap 5.3. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
- Vergelijk na voltooiing van dit proces de .html uitvoerbestanden met de fastqc.html bestanden die in 4.3 zijn gemaakt. Wijzig het pad van invoer- en uitvoermappen om de trimstap uit te voeren voor alle fastq-bestanden die zich elders bevinden.
6. Downloaden van de bowtie2-index voor de referentiegenomen voor daadwerkelijke en spike-in controlemonsters
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh in de terminal of sleep het shell-script naar de terminal en voer in.
OPMERKING: Dit script zal: (i) Bowtie2-indexen downloaden voor daadwerkelijke monsterreferentiegenomen (menselijk; hg19; gebruikt in originele publicatie22) en Spike-in controlereferentiegenomen (ontluikende gist; R64-1-1) in de map bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Noteer een logbestand (bowtie2-index-log.txt) in een logmap (~/Desktop/GSE126612/log/bowtie2-index). - Controleer na voltooiing van de uitvoering het logbestand. Als er een foutmelding wordt weergegeven, corrigeert u de fout en herhaalt u stap 6.3. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Momenteel zijn Bowtie2-indexen voor verschillende referentiegenomen beschikbaar op de Bowtie2-website (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Gebruikers kunnen Script_05_bowtie2-index.sh bewerken om elke Bowtie2-index te downloaden om aan de eisen van de gebruiker te voldoen. Als de gebruiker de Bowtie2-index van het referentiegenoom van belang niet kan vinden, zoek dan de fasta-bestanden van de referentiegenoomsequentie uit:- Ensembl ftp (https://ftp.ensembl.org/pub/current_fasta/)
- UCSC-webpagina (https://hgdownload.soe.ucsc.edu/downloads.html)
- of andere soortspecifieke databanken.
Nadat u de fasta-bestanden van de referentiegenoomsequentie hebt gevonden, maakt u een Bowtie2-index voor het gedownloade referentiegenoom door de sectie "The bowtie2-build indexer" (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) van de Bowtie2-website te volgen.
7. Het in kaart brengen van getrimde CUT&RUN-sequencing-lezingen naar de referentiegenomen
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit shell-script zal: (1) het bowtie2-programma uitvoeren om alle adapter- en kwaliteitsgetrimde fastq-bestanden toe te wijzen aan zowel experimentele (menselijke; hg19) als spike-in-controle (ontluikende gist; R64-1-1) referentiegenomen onafhankelijk. (ii) Voer de samtools-weergavefunctie uit om de in kaart gebrachte bestanden voor leesparen te comprimeren als bam-indeling. (iii) Maak één map (~/Desktop/GSE126612/bowtie2-mapped) en sla het bestand met gecomprimeerde toegewezen leesparen op in de map bowtie2-map. (iv) Maak één map (~/Desktop/GSE126612/log/bowtie2-mapped) en noteer het logboek van het mappingproces als tekstbestand bowtie2_log_hg19_SRR-number.txt voor leesparen die in kaart zijn gebracht op het hg19-referentiegenoom en bowtie2_log_R64-1-1_SRR-number.txt voor leesparen die zijn toegewezen op R64-1-1) om de mapping-efficiëntie binnen de bowtie2-mapping logmap aan te geven. - Controleer na voltooiing van de uitvoering het logbestand. Als er een foutmelding in het logboekbestand staat, corrigeert u de fout en voert u het shellscript opnieuw uit. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Dit shell-script voert bowtie2 uit met opties om sequencingbestanden met een gekoppeld uiteinde toe te wijzen om concordant toegewezen leesparen te vinden met fragmentlengtes van 10 bp-700 bp. Ontdek optiebeschrijvingen door bowtie2 --help in terminal te typen of door de bowtie2-website (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner) te bezoeken om opties te begrijpen en indien nodig te wijzigen. Gebruik dit shellscript om andere fastq-bestanden in kaart te brengen door het pad en de naamindeling van de fastq-bestanden en Bowtie2-indexen te wijzigen.
8. Sorteren en filteren van de in kaart gebrachte bestanden met leesparen
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door "chsh -s $(which bash)" in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script zal: (i) de samtools-weergavefunctie uitvoeren voor alle gecomprimeerde toegewezen leespaarbestanden in de map ~/Desktop/GSE126612/bowtie2-mapped om leesparen uit te filteren die zijn toegewezen aan niet-canonieke chromosoomregio's, openbaar geannoteerde zwarte lijst en TA-herhalingsregio's. (ii) Voer de samtools-sorteerfunctie uit om de gefilterde bam-bestanden te sorteren op de namen of coördinaten van fragmenten binnen dezelfde map. (iii) Noteer een logbestand per een input bam-bestand in de map ~/Desktop/GSE126612/log/filter-sort-bam . - Controleer na voltooiing van de uitvoering de logboekbestanden zorgvuldig. Als er een foutmelding in de logbestanden staat, corrigeer dan de fout en probeer het shellscript opnieuw uit te voeren. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: De resulterende bam-bestanden (uitvoer) gesorteerd op de namen van fragmenten zullen dienen als invoerbestanden om fragment BED en ruwe readcounts bedGraph-bestanden te maken. De bam-bestanden gesorteerd op coördinaat dienen als invoerbestanden om fragment-BEDPE-bestanden te genereren. Alle BED, bedGraph en BEDPE worden gebruikt voor piekoproepen en visualisatie in downstream-analyse. Alle annotatiebedbestanden voor canonieke chromosoomregio's (chr1~22, chrX, chrY en chrM), openbaar geannoteerde blacklist-regio's23 en TA-herhalingsregio's18 bevinden zich in de map ~/Desktop/Easy-Shells_CUTnRUN/blacklist . Gebruik indien nodig deze map om extra blacklist-bestanden toe te voegen. Gebruik dit shellscript om dezelfde functies uit te voeren voor andere toegewezen bam-bestanden van leesparen door het pad en de naam van de bam-bestanden te wijzigen. Typ samtools view --help en samtools sort --help in terminal voor meer informatie over deze functies.
9. Converteer toegewezen leesparen naar fragmenteren van BEDPE-, BED- en onbewerkte readcounts-bedGraph-bestanden
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script zal: (i) Voer de macs3 filterdup- en awk-functie uit om bam-bestanden gesorteerd op coördinaat te converteren om BEDPE-bestanden te fragmenteren waarvan de fragmentlengtes korter zijn dan 1 kb, en sla de BEDPE-bestanden op in ~/Desktop/GSE126612/BEDPE. (ii) Maak een logmap aan (~/Desktop/GSE126612/log/bam-to-BEDPE) en noteer een logbestand per bestand met toegewezen leesfragmenten. (iii) Voer de functies BAMTOBED en AWK, Cut, Sort uit om BAM-bestanden gesorteerd op naam van fragmenten te converteren naar BED-bestanden waarvan de fragmentlengtes korter zijn dan 1 kb. (iv) Maak één map aan (~/Desktop/GSE126612/bam-to-bed) en sla de fragment-BED-bestanden op in de bam-to-bed-map. (v) Noteer een logbestand per BED-bestand van toegewezen leesfragmenten in een logmap (~/Desktop/GSE126612/log/bam-to-bed). (vi) Voer de bedtools genomecov-functie uit om ruwe readcounts bedGraph-bestanden te genereren met behulp van de fragment BED-bestanden in één map (~/Desktop/GSE126612/bedGraph). - Controleer na voltooiing van de run de logbestanden zorgvuldig. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Output ruwe readcounts bedGraph-bestanden worden gebruikt als invoerbestanden voor het SEACR-programma voor piekbellers met normalisatieoptie in sectie 12 en normalisatie van geschaalde fractionele readcount (SFRC)22 in sectie 10. De fragment-BED-bestanden zullen dienen als invoerbestanden voor Spike-in genormaliseerde Reads Per Million mapped reads in de negatieve Control (SRPMC)-normalisatie 24,25 in sectie10.To korte fragmenten (>100 bp) alleen vastleggen voor CUT&RUN-gegevens van chromatine-geassocieerde factoren, de fragmentfiltratiestap in dit script wijzigen en de normalisatiestap voortzetten. Om de CUT&RUN-signalen tussen fragmenten van korte en normale grootte binnen dezelfde steekproef te vergelijken, kan SFRC-normalisatie nuttig zijn om het potentiële down-sampling-effect te verminderen dat wordt veroorzaakt door alleen korte fragmenten vast te leggen. Gebruik dit shellscript om dezelfde processen uit te voeren voor andere gesorteerde bam-bestanden met een gepaarde eindsequentie door het pad en de naamindeling van bam- en bed-bestanden te wijzigen.
10. Ruwe readcounts bedGraph-bestanden converteren naar genormaliseerde bedGraph- en bigWig-bestanden
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) een for-loop uit te voeren met de awk-functie om SFRC-genormaliseerde bedGraph-bestanden te maken met behulp van ruwe readcounts bedGraph-bestanden binnen ~/Desktop/GSE126612/bedGraph. (ii) Voer de functie bedGraphToBigWig uit om een gecomprimeerd formaat (.bw) van de SFRC-genormaliseerde bedGraph-bestanden te maken in ~/Desktop/GSE126612/bigWig. (iii) Noteer één logbestand om de normalisatiefactor vast te leggen die wordt gebruikt voor de SFRC-berekening per run en sla het logbestand op in ~/Desktop/GSE126612/log/SFRC. - Controleer na voltooiing van de uitvoering de logbestanden. Als er een foutmelding is, corrigeert u de fout en voert u het shellscript opnieuw uit. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: De geschaalde normalisatie van het fractionele aantal readcounts werd gebruikt in de oorspronkelijke publicatie22 van GSE126612 CUT&RUN-dataset. De formule van de normalisatie bij bin i is hetzelfde als hieronder: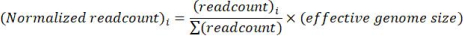
Aangezien deze normalisatiemethode geen normalisatie met negatieve controle (bijvoorbeeld IgG-monster) of spike-in-controle omvat, is deze benadering mogelijk niet ideaal om genoombreed signaalverschil tussen monsters waar te nemen. Aangezien deze methode echter theoretisch vergelijkbaar is met andere normalisatie op basis van totale readcounts (bijvoorbeeld Count Per Million), zou het goed genoeg zijn om lokaal signaalverschil tussen monsters waar te nemen. - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script: (i) Voer een for-loop uit met de genomecov-functie van bedtools om SRPMC-genormaliseerde bedgraph-bestanden te maken in ~/Desktop/GSE126612/bedGraph met behulp van fragment BED-bestanden in ~/Desktop/GSE126612/bam-to-bed. (ii) Noteer een logbestand om de normalisatiefactoren vast te leggen die worden gebruikt voor de SRPMC-normalisatie per run in ~/Desktop/GSE126612/log/SRPMC. (iii) Voer de functie bedGraphToBigWig uit om een gecomprimeerd formaat (.bw) van de genormaliseerde bedGraph-bestanden te maken en sla de genormaliseerde bigWig-bestanden op in de map ~/Desktop/GSE126612/bigWig . - Controleer na voltooiing van de uitvoering de logboekbestanden zorgvuldig. Als er een foutmelding in de logboekbestanden staat, corrigeert u de fout en voert u het shellscript opnieuw uit. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: De formule van SRPMC-normalisatie is ontwikkeld om het werkelijke aantal leesbewerkingen van monsters te normaliseren met zowel negatieve controle (bijvoorbeeld IgG-monster) als spike-in-controle door RPM (Reads Per Million mapped reads) normalisatiefactor, RPS (ratio Reads Per Spike-in read) en relatieve signaalverhouding te combineren tot controle24,25. De definitie van RPS is hetzelfde als hieronder:
Door RPS toe te passen voor zowel de werkelijke steekproef als de negatieve controlesteekproef, kan de relatieve signaalverhouding (RS) ten opzichte van de controle voor de werkelijke steekproef als volgt worden berekend: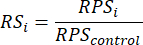
En de definitie van RPM-normalisatiefactor (RPM:NF) is hetzelfde als hieronder: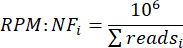
Vanaf hier is de SRPMC-normalisatiefactor (SRPMC:NF) naar voren gekomen door de RS en RPM:NF samen te combineren: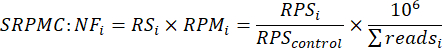
En deze formule kan als volgt worden vereenvoudigd:
Daarom normaliseert de SRPMC-methode de leeswaarden door de (1) verhouding van spike-in-metingen tussen controle en monster, en (2) RPM-genormaliseerde controlemetingen. Aangezien deze normalisatiefactor rekening houdt met spike-in-metingen en controle-uitlezingen vergelijkbaar maakt tussen monsters samen, zou deze methode geschikt zijn om genoombreed verschil tussen monsters waar te nemen en het batch-effect te verminderen in het totale aantal metingen van werkelijke monsters en controles in verschillende batch-experimenten. Deze genormaliseerde bedGraph-bestanden worden invoerbestanden om pieken aan te roepen met behulp van SEACR in sectie 11. En deze genormaliseerde bigWig-bestanden zullen worden gebruikt bij loci-visualisatie via IGV en het maken van heatmap en gemiddelde plot via Deeptools. Het wordt sterk aanbevolen om een genoombrowser te gebruiken om het landschapspatroon van de CUT&RUN-dataset te visualiseren met behulp van de genormaliseerde bigWig-bestanden in representatieve genomische regio's om de gegevenskwaliteit te evalueren. CUT&RUN-monsters die luidruchtige achtergrondsignaalpatronen vertonen die lijken op de IgG-regeling, zijn waarschijnlijk geschikt om weg te laten voor stroomafwaartse analyses. Gebruik deze shellscripts om andere leesbedbestanden en onbewerkte leestellingen bedGraph-bestanden te normaliseren door het pad en de bestandsnamen voor zowel invoer- als uitvoerbed- en bedgraph-bestanden te wijzigen. Bewerk deze scripts om andere normalisatieberekeningen toe te passen door de factoren en formule in dit script te wijzigen.
11. Validatie van de verdeling van de fragmentgrootte
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) picard.jar functie CollectInsertSizeMetrics uit te voeren met behulp van toegewezen bam-bestanden voor leesparen in de map ~/Desktop/GSE126612/filtered-bam om de verdeling van de invoeggrootte te identificeren. (ii) Maak één map aan (~/Desktop/GSE126612/insert-size-distribution) en sla de resultaten van de analyse van de insert grootteverdeling op in de gemaakte map. (iii) Noteer een logbestand per een input bam-bestand in de map ~/Desktop/GSE126612/log/insert-size-distribution . - Controleer na voltooiing van de run de logbestanden zorgvuldig. Als er een foutmelding in de logboekbestanden staat, corrigeert u de fout en probeert u het shellscript opnieuw uit te voeren. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Over het algemeen vertoont de analyse van de wisselplaatgrootte (Output) voor CUT&RUN-monsters grote pieken in mono- (100-300 bp) en di- (300-500 bp) nucleosomale groottebereiken. Technische fouten/beperkingen (zoals over-/onderdigestie van MNase tijdens de voorbereiding van CUT&RUN-monsters of onjuiste grootteselectie tijdens de voorbereiding van de bibliotheek) kunnen leiden tot verrijking van fragmenten die hetzelfde zijn of groter zijn dan trinucleosomaal (500-700 bp) en hetzelfde of korter zijn dan subnucleosomaal (<100 bp). Soms kan de afwezigheid van pieken in de mononucleosomale grootte bij de verrijking van de lange (>500 bp) en korte fragmenten (<100 bp) te wijten zijn aan het feit dat de selectiebereiken van de bibliotheekgrootte zijn gekozen in de natte laboratoriumfase of aan een lage sequentiediepte. Vergelijk de sequentiediepte ('totale sequentiebasen' / 'totale referentiegenoomgrootte'), het overzicht van het genomische landschap met behulp van genormaliseerde readcounts bigWig-bestanden in sectie 10 en het verdelingspatroon van de insertgrootte samen om de kwaliteit van verwerkte CUT&RUN-monsters te verduidelijken. De stippellijnen in de histogrammen vertegenwoordigen de 'cumulatieve fractie' van lezingen met een invoeggrootte groter dan of gelijk aan de waarde op de x-as. Deze stippellijn maakt het mogelijk om de verdeling van de wisselplaatgroottes in het invoerbestand met toegewezen leesbestanden te identificeren. Progressie langs de x-as wordt geassocieerd met een toenemende wisselplaatgrootte. De stippellijn geeft het aandeel van de toegewezen leesparen in het invoerbam-bestand aan met een invoeggrootte die ten minste even groot is als aangegeven op de kruisende x-aspositie. Daarom begint de interpretatie bij 1 aan de linkerkant, wat aangeeft dat alle lezingen een insteekgrootte hebben die groter is dan of gelijk is aan de kleinste grootte, en afneemt naar 0 naarmate de invoeggrootte toeneemt.
12. Oproeppieken met MACS2, MACS3 en SEACR
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) macs2 callpeak en macs3 callpeak functies uit te voeren met en zonder IgG-besturing met behulp van fragment BEDPE-bestanden om pieken op te roepen en de piek oproepresultaten op te slaan in uitvoermappen (~/Desktop/GSE126612/MACS2 en ~/Desktop/GSE126612/MACS3). (ii) Noteer het logboek van deze piekoproepen als tekstbestand in de logdirectory (~/Desktop/GSE126612/log/MACS2 en ~/Desktop/GSE126612/log/MACS3) - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) SEACR_1.3.sh script uit te voeren met en zonder IgG-besturing, met strikte en ontspannen opties met behulp van ruwe readcounts bedGraph- en genormaliseerde bedGraph-bestanden om pieken aan te roepen. (ii) Maak een uitvoerdirectory (~/Desktop/GSE126612/SEACR-peaks) en sla de piekoproepresultaten op door SEACR. (iii) Noteer het logboek van deze piekoproepen als tekstbestand in de logdirectory (~/Desktop/GSE126612/log/SEACR). - Controleer na voltooiing van het uitvoeren van shell-scripts de logbestanden zorgvuldig. Als er een foutmelding in de logbestanden staat, corrigeer dan eerst de fout. Sommige programma's roepen mogelijk geen pieken aan voor IgG-besturingsvoorbeeld met IgG-besturingsoptie samen, dus laat het foutbericht met betrekking tot IgG-besturingsvoorbeeld met IgG-besturingsoptie achterwege. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Deze twee shell-scripts voeren piekaanroep uit voor CUT&RUN-voorbeelden met behulp van drie piekaanroepers (MACS2, MACS3 en SEACR) met verschillende opties: met/zonder IgG-besturingsoptie, met behulp van ruwe leestellingen bedGraph-bestanden met normalisatie-optie van piekaanroeper of genormaliseerde leestellingen bedGraph-bestanden zonder normalisatie-optie van piekaanroeper, en strikte en ontspannen SEACR-piekaanroepopties. Aangezien de piekaanroepende uitvoerbestanden niet voldoende zijn om direct in stroomafwaartse analyses te worden gebruikt, bevat Easy Shells CUTnRUN één script om deze aangeroepen piekuitvoerbestanden te verwerken om nieuwe piekbestanden te maken, waaronder chromosoom, start, einde en naam van pieken. Door middel van intensieve benaderingen voor piekoproepen biedt Easy Shells CUTnRUN de mogelijkheid om het piekbelprogramma te kiezen dat het meest geschikt is voor het CUT&RUN-project van een gebruiker door de pieken die worden opgeroepen over drie piekbellers te vergelijken. Bovendien biedt deze CUT&RUN-analysepijplijn ook de mogelijkheid om piekaanroepopties te selecteren die het meest geschikt zijn voor het CUT&RUN-project van een gebruiker. Deze vergelijkingen worden gedaan door middel van een Venn-diagram en visualisatie als heatmap en gemiddelde plot.
13. Aangeroepen piekbedbestanden maken
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de awk-functie uit te voeren met behulp van bedbestanden in de map ~/Desktop/GSE126612/SEACR om twee soorten SEACR-piekbedbestanden ~ /Desktop/GSE126612/peak-bed_SEACR map te maken. De bestanden van het hele piekbed bevatten het begin en einde van elke piek, en de bestanden van het gefocuste piekbed bevatten het begin en het bed van de hoogste signaalbak binnen elke piek. (ii) Voer de awk-functie uit met behulp van _peaks.xls bestanden in de mappen ~/Desktop/GSE126612/MACS2 en ~/Desktop/GSE126612/MACS3 om volledige piekbedbestanden te maken, inclusief het begin en einde van elke piek die door MACS2 en MACS3 wordt aangeroepen in de mappen ~/Desktop/GSE126612/peak-bed_MACS2 en ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) Voer de awk-functie uit met behulp van _summits.bed-bestanden in de mappen ~/Desktop/GSE126612/MACS2 en ~/Desktop/GSE126612/MACS3 om gerichte piekbedbestanden te maken, inclusief het begin en einde van de meest significante opslaglocatie binnen elke piek. (iv) Logbestanden worden geschreven in tekstbestandsformaat in de map ~/Desktop/GSE126612/log/peak-bed . - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de bedtools intersect-functie uit te voeren met behulp van piekbedbestanden die worden aangeroepen zonder IgG-besturingsoptie om pieken te verwijderen die overlappen met IgG-besturingspieken. (ii) De gefilterde piekbedbestanden worden opgeslagen in de mappen ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 en ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) Een logbestand log_filter-peaks.txt wordt aangemaakt in de map ~/Desktop/GSE126612/log/filter-peaks . - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) Cat en Sort functies uit te voeren om de MACS2 en MACS3 volledige piekbedbestanden van de replicaten samen te voegen tot één piekbedbestand en het aaneengeschakelde piekbedbestand te sorteren in de map ~/Desktop/GSE126612/bed-for-comparison . (ii) Voer de samenvoegfunctie van bedtools uit met behulp van de aaneengeschakelde hele piekbedbestanden om pieken samen te voegen die elkaar overlappen. (iii) Een logbestand log_cat-merged-peak-bed_MACS.txt is geschreven in logmap ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de cat - en sorteerfuncties uit te voeren om de hele SEACR-piekbedbestanden van de replicaten samen te voegen tot één piekbedbestand en het aaneengeschakelde piekbedbestand te sorteren in de map ~/Desktop/GSE126612/bed-for-comparison . (ii) Voer de samenvoegfunctie van bedtools uit met behulp van de aaneengeschakelde hele piekbedbestanden om pieken samen te voegen die elkaar overlappen. (iii) Een logbestand log_cat-merged-peak-bed_SEACR.txt is geschreven in logmap ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Na voltooiing van het uitvoeren van de shell-scripts, controleert u de logboekbestanden zorgvuldig. Als er een foutmelding in de logbestanden staat, corrigeert u de fout en voert u de scripts opnieuw uit. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: De bestanden van de piekbedden in het hele piekgebied worden gebruikt als invoerbestanden voor de analyse van het Venn-diagram om de gelijkenis te vergelijken tussen piekaanroepopties, piekaanroepmethoden, replicaten en genomische landschapswaarnemingen in de buurt van piekgebieden. De samengevoegde piekbedbestanden van hele piekregio's zullen worden gebruikt voor de analyse van de hoofdcomponent (pc) en de correlatieanalyse van de Pearson-coëfficiënt met behulp van deeptools. De gefocuste piekbedbestanden worden gebruikt voor Heatmap en gemiddelde plotanalyse met behulp van Deeptools.
14. Validatie van gelijkenis tussen replicaten met behulp van Pearson-correlatie en Principal component (PC)-analyse.
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash-shell de standaardshell is in de huidige terminal, kunnen gebruikers het volgende zien: /path/to/bash (of een vergelijkbaar bericht zoals /bin/bash) in de terminal.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal standaard Bash-shell gebruikt, slaat u deze stap over.
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de multiBamSummary BED-file-functie uit te voeren met behulp van de bam-bestanden van replicaten, die zijn gesorteerd op coördinaat, en hele piekbedbestanden voor CTCF, H3K27Ac en RNAPII-S5P samen te voegen om matrixbestanden te genereren voor Pearson-correlatieanalyse in de map Desktop/GSE126612/deeptools_multiBamSummary . (ii) Voer de plotCorrelatie-functie uit met behulp van de matrixbestanden om de berekening van de Pearson-correlatiecoëfficiënt en heatmap-clustering uit te voeren en sla het resultaat op in de map ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Noteer een logbestand log_plotCorrelation.txt in de map ~/Desktop/GSE126612/log/correlatie . - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de multiBamSummary BED-file-functie uit te voeren met behulp van de bam-bestanden, die zijn gesorteerd op coördinaat, en hele piekbedbestanden samen te voegen, waaronder alle CTCF-, H3K27ac- en RNAPII-S5P-pieken, om matrixbestanden te genereren voor Principal Component analysis (PCA) in de map Desktop/GSE126612/deeptools_multiBamSummary . (ii) Voer de plotPCA-functie uit met behulp van de matrixbestanden om PCA uit te voeren en sla het resultaat op in de map ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Noteer een logbestand log_plotPCA.txt in de map ~/Desktop/GSE126612/log/correlatie . - Controleer na voltooiing van het uitvoeren van shell-scripts de logbestanden. Als er een foutmelding is, corrigeer dan de fout en voer de shellscripts opnieuw uit. Als er een probleem is om het probleem op te lossen, vraag dan hulp aan via de Easy Shells CUTnRUN github-problemen webpagina (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: In principe vertonen goed voorbereide en verwerkte replicaten hogere Pearson-correlatiecoëfficiëntwaarden binnen dezelfde clustergroep en nauwe positionering in de analyse van de hoofdcomponenten. Elke replicaat met een lagere Pearson-correlatiecoëfficiënt en een grote afstand tot andere replicaten in de hoofdcomponentengrafiek kan een potentiële uitbijter onder de replicaten vertegenwoordigen. Dit shellscript is van toepassing op alle bam-indelingen die in kaart zijn gebracht, leesgegevens die zijn toegewezen. Wijzig het pad en de bestandsnaam van bigwig-bestanden om te voldoen aan projectspecifieke vereisten.
15. Valideren van gelijkenis tussen replicaten, piekaanroepmethoden en opties met behulp van een Venn-diagram
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash shell de standaard shell is in de huidige terminal, kan er iets als /path/to/bash (bijvoorbeeld /bin/bash) in de terminal zijn.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal de Bash-shell als standaard gebruikt, overweeg dan deze stap over te slaan
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de intervene-venn-functie uit te voeren met behulp van piekbedbestanden in het hele piekgebied om overlappingen te vinden tussen de pieken die door verschillende opties worden aangeroepen (met/zonder IgG-besturingsoptie, met/zonder normalisatie en strenge/ontspannen piekaanroepopties voor SEACR). (ii) Maak één map (~/Desktop/GSE126612/intervene_methods) en sla de resultaten van de analyse van het Venn-diagram op in deze map. (iii) Noteer één logbestand log_intervene_methods.txt in de map ~/Desktop/GSE126612/log/interveniëren . - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de intervene venn-functie uit te voeren met behulp van piekbedbestanden in het hele piekgebied om overlappingen tussen de pieken van de replicaten te vinden. (ii) Maak één map (~/Desktop/GSE126612/intervene_replicates) en sla de resultaten van de analyse van het Venn-diagram op in deze map. (iii) Noteer één logbestand log_intervene_replicates.txt in de map ~/Desktop/GSE126612/log/intervene. - Nadat u klaar bent met het uitvoeren van de shellscripts, bekijkt u de logboekbestanden. Als er een foutmelding is, corrigeer dan de fout en voer de shellscripts opnieuw uit. Als er een probleem is met het gebruik van Easy Shells CUTnRUN-analysepijplijn, vraag dan hulp op de webpagina met problemen met Easy Shells CUTnRUN github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Deze analyseresultaten van het Venn-diagram geven inzicht in het kiezen van de meest geschikte piekaanroepopties, methoden en replicaten met een hoge reproduceerbaarheid voor stroomafwaartse analyse. Het kan de voorkeur hebben om de piekbelopties en -methoden te kiezen die de hoogst gebelde pieknummers laten zien met een goede overlap met andere piekbelmethoden en -opties.
16. Analyse van heatmaps en gemiddelde plots om genoemde pieken te visualiseren.
- Open de terminal en typ echo $SHELL om de standaardshell in de actieve terminal te controleren. Als Bash shell de standaard shell is in de huidige terminal, kan er iets als /path/to/bash (bijvoorbeeld /bin/bash) in de terminal zijn.
- Als de standaardshell niet Bash is, stel dan de Bash-shell in als standaardshell door chsh -s $(welke bash) in de terminal te typen. Als de terminal de Bash-shell als standaard gebruikt, overweeg dan deze stap over te slaan
- Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
OPMERKING: Dit script is geschreven om: (i) de computeMatrix-referentiepuntfunctie uit te voeren met behulp van genormaliseerde bigWig-bestanden en gefocuste piekbedbestanden om genormaliseerde readcounts-matrixen te maken in het midden van de gefocuste pieken in de map ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Voer de plotHeatmap-functie uit met behulp van de matrix voor genormaliseerde leestellingen om heatmaps en gemiddelde plots te genereren die het distributiepatroon van genormaliseerde leestellingen visualiseren op de gerichte pieklocaties. (iii) Maak één map (~/Desktop/GSE126612/deeptools_plotHeatmap) en sla de plotHeatmap-uitvoerbestanden op in deze map. (iv) Noteer één logbestand log_plotHeatmap_focused.txt in de map ~/Desktop/GSE126612/log/plotHeatmap . - Typ ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh in de terminal of sleep het shell-scriptbestand naar de terminal en voer in.
Dit script is geschreven om: (i) de computeMatrix-referentiepuntfunctie uit te voeren met behulp van genormaliseerde bigWig-bestanden en hele piekbedbestanden om genormaliseerde readcounts-matrixen te maken in het midden van de hele pieken in de map ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Voer de plotHeatmap-functie uit met behulp van de matrix voor genormaliseerde leestellingen om heatmaps en gemiddelde plots te genereren die het distributiepatroon van genormaliseerde leestellingen op de hele pieklocaties visualiseren. (iii) Maak één map (~/Desktop/GSE126612/deeptools_plotHeatmap) en sla de plotHeatmap-uitvoerbestanden op in deze map. (iv) Noteer één logbestand log_plotHeatmap_whole.txt in de map ~/Desktop/GSE126612/log/plotHeatmap . - Nadat u klaar bent met het uitvoeren van de shellscripts, bekijkt u de logboekbestanden. Als er een foutmelding is, corrigeer dan de fout en voer de shellscripts opnieuw uit. Als er een probleem is met het gebruik van Easy Shells CUTnRUN-analysepijplijn, vraag dan hulp op de webpagina met problemen met Easy Shells CUTnRUN github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
OPMERKING: Idealiter vertonen de pieklocaties van MACS2/3-pieken en de gerichte pieklocaties van SEACR-pieken een scherpe en gerichte signaalverdeling in het midden van de plots. Als het algoritme voor piekoproepen echter niet goed werkt voor CUT&RUN-gegevens, kan er een minder gerichte 'ruisige' signaalverdeling in de grafieken verschijnen. Daarom zal het gebruik van het aantal opgeroepen pieken en de pieksignaalverdelingspatronen van de outputplots als leidraad dienen voor het bepalen van de piekvaliditeit voor verdere CUT&RUN-analyse die downstream piekannotatie omvat.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Kwaliteit en adaptertrimming behoudt reads met hoge sequencing-kwaliteit
High-throughput sequencingtechnieken zijn gevoelig voor het genereren van sequentiefouten zoals sequentie-'mutaties' in reads. Bovendien kunnen sequencing-adapterdimeren worden verrijkt in sequencing-datasets als gevolg van een slechte verwijdering van adapters tijdens de voorbereiding van de bibliotheek. Overmatige sequentiefouten, zoals leesmutaties, het genereren van leeswaarden die korter zij...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het vermogen om de eiwitbezetting op chromatine in kaart te brengen is van fundamenteel belang voor het uitvoeren van mechanistische studies op het gebied van chromatinebiologie. Naarmate laboratoria nieuwe natte laboratoriumtechnieken toepassen om chromatine te profileren, wordt het vermogen om sequentiegegevens van die natte laboratoriumexperimenten te analyseren een veelvoorkomend knelpunt voor natte laboratoriumwetenschappers. Daarom beschrijven we een inleidend stap-voor-stap protoc...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren geen openbaarmakingen.
Dankbetuigingen
Alle geïllustreerde figuren zijn gemaakt met BioRender.com. CAI erkent de steun die wordt geboden door middel van een Ovarian Cancer Research Alliance Early Career Investigator Award, een Forbeck Foundation Accelerator Grant en de Minnestoa Ovarian Cancer Alliance National Early Detection Research Award.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Software om readcounts bedGraph te comprimeren en om te zetten naar bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ the U. of Utah | https://bedtools.readthedocs.io/en/latest/index.html | Software om bam/bed/bedGraph bestanden te verwerken |
| bowtie2 2.5.4 | Johns Hopkins University | https://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Software om bowtie index te bouwen en alignering uit te voeren |
| CollectInsertSizeMetrics (Picard) | Broad institute | https://github.com/broadinstitute/picard | Software om insert size distributie analyse uit te voeren |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Software om adapter trimming uit te voeren |
| Deeptoolsv3.5.1 | Max Planck Institute | https://deeptools.readthedocs.io/en/develop/index.html | Software om Pearson coefficient correlatie analyse, Principal component analyse en Heatmap/gemiddelde plot analyse uit te voeren |
| FastQC Version 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Software om de kwaliteit van fastq bestand te controleren |
| Intervenev0.6.1 | Computational Biology & Gene regulation - Mathelier group | https://intervene.readthedocs.io/en/latest/index.html | Software om Venn diagram analyse uit te voeren met behulp van piek bestanden |
| MACSv2.2.9.1 | Chan Zuckerberg initiative | https://github.com/macs3-project/MACS/tree/macs_v2 | Software om pieken te callen |
| MACSv3.0.2 | Chan Zuckerberg initiative | https://github.com/macs3-project/MACS/tree/master | Software om pieken te callen |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Software om sam/bam bestanden te verwerken |
| SEACRv1.3 | Howard Hughes Medial institute | https://github.com/FredHutch/SEACR | Software om pieken te callen |
| SRA Toolkit Release 3.1.1 | NCBI | https://github.com/ncbi/sra-tools | Software om SRR van GEO te downloaden |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | Software om kwaliteit en adapter trimming uit te voeren |
Referenties
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
