Deze studie identificeert acht prognostische genen gerelateerd aan mitotische catastrofe (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) bij longadenocarcinoom, stelt een risicomodel vast met een acceptabele voorspellende waarde en onthult onderscheidende kenmerken van de immuunmicro-omgeving tussen de risicogroepen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Identificatie van prognostische genen gerelateerd aan mitotische catastrofe bij longadenocarcinoom via transcriptoomanalyse
In dit artikel
Samenvatting
Samenvatting
Longadenocarcinoom (LUAD), het meest voorkomende subtype longkanker, vertoont een slechte prognose. Hoewel mitotische catastrofe kan worden geïnduceerd in LUAD, wat leidt tot celdood, blijven de prognostische en biologische betekenis van genen gerelateerd aan mitotische catastrofe (MCRGs) bij deze ziekte onduidelijk. Differentieel tot expressie gebrachte genen (DEGs) geassocieerd met LUAD werden gescreend uit de TCGA-LUAD-cohort, en overlappende genen werden gedefinieerd door DEGs te kruisen met MCRGs. Kandidaat-prognostische genen werden geselecteerd via machine learning, waarna een multigen prognostisch model werd geconstrueerd. Er werd een prognostische signatuur van acht kandidaten vastgesteld, bestaande uit PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 en S100B, die een acceptabele voorspellende betrouwbaarheid vertoonde in de training met 2-jaar, 3-jaar en 5-jaar area under the curves (AUCs) van respectievelijk 0.723, 0.715 en 0.625 in de trainingsset (bootstrap-gecorrigeerde C-index: 0.699, 95% CI: 0.657-0.742) en consistente validatie in GSE31210 (AUCs: 0.812, 0.766 en 0.814). Patiënten met een laag risico vertoonden significant betere overlevingsuitkomsten, verhoogde immuuninfiltratie, hogere immuun- en stromascores, verhoogde immunophenoscores en actievere immuniteitscycli van de kanker. Significante verschillen in tumor-mutatielast en genevoeligheid werden waargenomen tussen de hoogrisico- en laagrisicogroepen. Kwantitatieve polymerasekettingreactie (qPCR) valideerde de transcriptomische profielen van zes kandidaat-uitkomstgerelateerde genen in klinische monsters. Een nomogram waarin de risicoscore en het klinische stadium waren opgenomen, vertoonde een goede voorspellende prestatie. Deze bevindingen tonen aan dat de acht MCRG-gerelateerde kandidaatgenen een sterk potentieel hebben om patiëntuitkomsten te voorspellen en risico's te stratificeren bij LUAD, met duidelijke kenmerken van de immuunmicro-omgeving tussen de risicogroepen.
Inleiding
Longkanker behoort wereldwijd tot de meest voorkomende en dodelijke vormen van kanker1,2. Niet-kleincellig longcarcinoom (NSCLC) wordt gedomineerd door longadenocarcinoom (LUAD), wat verantwoordelijk is voor ongeveer 40% van alle gevallen van longkanker3,4. Hoewel er aanzienlijke stappen zijn gezet in operatieve procedures, moleculair gerichte therapieën, immuuncheckpointremmers en combinatieregimes, blijft de klinische prognose voor LUAD-patiënten ongunstig5,6. Hoewel pathologische en op beeldvorming gebaseerde diagnostische benaderingen veelvuldig worden gebruikt bij LUAD, hebben zij inherente beperkingen bij het vastleggen van tumorheterogeniteit en moleculaire kenmerken. Daarentegen kan tumorweefselanalyse op basis van moleculaire biomarkers uitgebreidere informatie verschaft over de tumorbiologie en kan dit bijdragen aan de prognostische beoordeling en geïndividualiseerde behandelstrategieën7. Daarom blijft het identificeren van betrouwbare moleculaire biomarkers belangrijk voor het verbeteren van de prognostische voorspelling en het biologische begrip van LUAD.
Mitose, een essentieel mechanisme van cellulaire replicatie, garandeert de getrouwe verdeling van gerepliceerde chromosomen tussen twee dochtercellen8. Ontregeling van mitotische processen kan ongecontroleerde celproliferatie, genomische instabiliteit en tumorprogressie bevorderen. Mitotische catastrofe (MC) definieert een celdoodpad dat wordt geactiveerd bij het falen van de voltooiing van de mitose, wat doorgaans het gevolg is van beschadiging van het spoelapparaat of defecte celcyclus-controlepunten9. Op morfologisch niveau manifesteert MC zich door cellulaire abnormaliteiten, waaronder multinucleatie, micronuclei, multipolaire spoelconfiguraties en polyploïdisatie10. Als mechanisme voor het elimineren van cellen met ernstige mitotische defecten kan MC bijdragen aan de onderdrukking van tumorprogressie9. De p53-deletie in A549 LUAD-cellen kan mitotische catastrofe en uiteindelijk celdood induceren11, wat wijst op een potentiële link tussen MC en LUAD-gerelateerde cellulaire processen. Desalniettemin blijven de prognostische betekenis en biologische functies van MC-gerelateerde genen (MCRGs) in LUAD onvoldoende opgehelderd.
In dit onderzoek werden het prognostisch belang en de vermeende biologische relevantie van MCRG's bij LUAD systematisch onderzocht met behulp van gegevens uit TCGA en GEO. Kandidaat-MCRG's werden eerst geïdentificeerd via differentiële expressie- en intersectieanalyses. Verschillende machine learning-benaderingen screenden de kandidaatgenen en stelden een prognostische risicosignatuur vast, die vervolgens extern werd gevalideerd. Er werd daarnaast een nomogram ontwikkeld waarin de risicoscore in combinatie met klinische kenmerken werd opgenomen om de overlevingsvoorspelling te verbeteren. Daarnaast dienden de karakterisering van de immuunmicro-omgeving, de beoordeling van somatische mutaties en de evaluatie van de chemosensitiviteit om de biologische implicaties en het klinische nut van de geïdentificeerde genen te onderzoeken. Gezamenlijk tonen deze bevindingen het prognostisch potentieel van MCRG's bij LUAD aan en kunnen ze bijdragen aan de ontwikkeling van biomarkers en geïndividualiseerd management.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
De studie werd uitgevoerd in overeenstemming met de Verklaring van Helsinki, en het protocol werd op 22 april 2025 goedgekeurd door de ethische commissie van het Anhui Chest Hospital (K2025-007). Geïnformeerde toestemming werd verkregen van alle proefpersonen die aan de studie deelnamen.
Data-extractie en normalisatie
Transcriptomische profielen en overeenkomstige klinische datasets voor LUAD werden verkregen uit de TCGA- en GEO-cohorten. De TCGA-LUAD-dataset werd aangewezen als de trainingsset, waarbij GSE72094, GSE31210 en GSE26939 dienden als cohorten voor externe validatie (Tabel 1). Daarnaast werden 900 MCRG's verzameld uit een eerdere studie12(Aanvullende Tabel 1). Transcriptoomgegevens werden geannoteerd met behulp van GENCODE v36 of de overeenkomstige GPL-platform-annotatiebestanden. Probe-ID's werden omgezet in gensymbolen, gedupliceerde genen werden samengevoegd met de avereps-functie, en alleen proteïne-coderende genen werden behouden om expressiematrices op genniveau te genereren. Voor de TCGA-LUAD-trainingsset werden genen met Fragments per kilobase of exon model per million mapped fragments (FPKM) < 1 in meer dan 50% van de monsters gefilterd, en de overgebleven expressiewaarden werden log2-getransformeerd (log2[FPKM+1]). Voor de GEO-validatiecohorten werden ruwe expressiegegevens gedownload, werden probe-ID's gekoppeld aan gensymbolen met behulp van de respectievelijke platform-annotatiebestanden, en werden meerdere probes die overeenkwamen met hetzelfde gen samengevoegd door hun expressiewaarden te middelen. Deze datasets werden indien nodig log2-getransformeerd. Er werd geen cross-platform batch-effectcorrectie toegepast tussen TCGA en GEO, aangezien we een per-cohort standaardisatiestrategie hanteerden om relatieve vergelijkbaarheid te waarborgen. Specifiek werden voor zowel de trainings- als de validatiecohorten de genexpressiewaarden gecentreerd en geschaald (z-score transformatie) met gebruik van het gemiddelde en de standaarddeviatie van elke dataset afzonderlijk. Dezelfde Cox-regressiecoëfficiënten die uit de trainingsset waren afgeleid, werden vervolgens gebruikt om risicoscores voor alle cohorten te berekenen. Om de klinische toepasbaarheid te behouden en overfitting aan een validatieset te voorkomen, werd de mediaan risicoscore van de trainingscohort gebruikt als een vaste afkapwaarde om patiënten in hoog- en laagrisicogroepen in te delen over alle externe validatiecohorten. Klinische informatie, waaronder leeftijd, geslacht, pathologisch stadium, Tumor-Node-Metastasis (TNM) stadium, histologisch type, overlevingstijd, overlevingsstatus en weefseltype, werd geëxtraheerd wanneer beschikbaar. Het eindpunt was de algehele overleving (OS). Monsters met onvolledige overlevingsinformatie of een overlevingstijd < 30 dagen werden uitgesloten. Overlevingstijd werd omgezet in jaren, en overlevingsstatus werd gecodeerd als 0 voor in leven en 1 voor overleden.
Identificatie en functionele analyses van kandidaatgenen
Het Limma-pakket identificeerde differentieel tot expressie gebrachte genen (DEGs) tussen LUAD-tumor- en normaalmonsters in de trainingsset13. DEGs werden gedefinieerd aan de hand van de volgende criteria: |log2FC| > 0,5 en een gecorrigeerde p-waarde < 0,05. Vervolgens werd het mfuzz fuzzy clustering-algoritme in het R-pakket ClusterGVis gebruikt om de DEGs te verdelen in verschillende expressieclusters. Een Gene Ontology–Biological Process (GO-BP)-analyse werd uitgevoerd op de vijf meest representatieve genen in elk cluster op basis van hun membership scores. Een set gedeelde genen werd afgeleid door de intersectie van de DEGs met MCRGs te bepalen. Functionele verrijkingsanalyse met behulp van Gene Ontology/Kyoto Encyclopedia of Genes and Genomes (GO/KEGG) beoordeelde de biologische relevantie van de overlappende genen. Protein–protein interaction (PPI)-netwerken zijn afkomstig uit de STRING-database14. Alleen interacties met confidence scores > 0,7 werden behouden om de betrouwbaarheid van het netwerk te verbeteren.
Screening van prognostische genen
Het Survival-pakket werd gebruikt om een univariate Cox-regressieanalyse uit te voeren om waarschijnlijke genen te identificeren die gekoppeld zijn aan de algehele overleving bij LUAD15. Genen met een p-waarde < 0,05 werden beschouwd als potentiële prognostische indicatoren. De TCGA-LUAD trainingscohort omvatte 500 patiënten met volledige overlevingsgegevens, van wie 216 (43,2%) overleden waren tijdens de follow-up. De verhouding tussen kandidaatgenen (n = 108) en events (n = 216) was ongeveer 1:2, wat acceptabel is voor een Cox-regressieanalyse. Vervolgens werden kenmerken verder geselecteerd middels Least Absolute Shrinkage and Selection Operator (LASSO) regressieanalyse en een Extreme Gradient Boosting (XGBoost) model. Cox-proportional hazards modellen werden gebouwd met family = "cox" via de cv.glmnet-functie van het glmnet-pakket. De optimale regularisatieparameter werd bepaald met 10-voudige kruisvalidatie, waarbij de λ.min-waarde de minimale kruisvalidatiefout vertegenwoordigde en werd geselecteerd als de optimale λ-waarde. Genen met niet-nul regressiecoëfficiënten werden geëxtraheerd als kandidaatkenmerken. Voor het XGBoost-model werden de overlevingstijd en de overlevingsstatus gecombineerd als de uitkomstvariabele, waarbij positieve waarden werden toegekend aan sterfgevallen en negatieve waarden aan gecensureerde gevallen. De parameters werden ingesteld op objective = "survival: cox" en eval_metric = "cox-nloglik", met 100 iteraties en een learning rate van 0,1. Na de modeltraining werden de gen-belangrijkheidsscores berekend met behulp van feature gain-waarden. De top 20 genen werden behouden na het sorteren van de belangrijkheidsscores in aflopende volgorde om de dimensionaliteit van de kenmerken en de complexiteit van het model te verminderen. Genen die overlapten tussen de LASSO- en XGBoost-resultaten werden geïdentificeerd als kandidaat prognostische genen.
Constructie en beoordeling van een prognostisch model
Er is een prognostisch model ontwikkeld met behulp van multivariate Cox-regressieanalyse van de geïdentificeerde kandidaatgenen. Risicoscores werden als volgt individueel berekend:
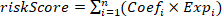 .
waarbij Coefi verwijst naar de coëfficiënt voor gen i, en Expi de respectievelijke genexpressiewaarde aangeeft. Individuen werden vervolgens verdeeld in twee groepen: hoog risico en laag risico, waarbij de mediane risicoscore als afkapwaarde werd gebruikt. Daarna werden tijdsafhankelijke receiver operating characteristic (ROC)-curves opgesteld. Om de potentie voor overfitting te beoordelen, werd bootstrap interne validatie met 1.000 resamplingsiteraties uitgevoerd om de bias-gecorrigeerde C-index en tijdsafhankelijke AUC's met 95% betrouwbaarheidsintervallen te berekenen. Kalibratiecurves werden gegenereerd om de overeenkomst tussen de voorspelde en geobserveerde overlevingskansen na 2 jaar, 3 jaar en 5 jaar te evalueren. Verder werd een decision curve analysis (DCA) uitgevoerd met het ggDCA-pakket in R om het klinische netto voordeel van het model op tijdstippen van 2, 3 en 5 jaar te evalueren, waarbij de potentiële waarde van de risicoscore bij klinische besluitvorming over verschillende drempelwaarschijnlijkheden werd gekwantificeerd. Overlevingsverschillen tussen risicostratificatiegroepen en over andere klinische categorieën werden vergeleken met behulp van Kaplan–Meier(KM)-overlevingscurves met log-rank toetsing. Bovendien werd voor het verduidelijken van de individuele genbijdragen aan de modelprestatie gebruikgemaakt van Shapley Additive exPlanations (SHAP)-analyse voor post-hoc verklarende interpretatie.
Ontwikkeling en externe validatie van een nomogram
De relaties tussen de berekende risicoscores en diverse klinische kenmerken (waaronder geslacht, leeftijd en TNM-stadium) werden onderzocht met Wilcoxon rank-sum of Kruskal-Wallis testen om de klinische toepasbaarheid van het model te evalueren. Om vast te stellen of de risicoscore fungeerde als een onafhankelijke prognostische factor, werden klinische variabelen, samen met de risicoscore, opgenomen in multivariate Cox-regressiemodellering. Vervolgens werd een prognostisch nomogram geconstrueerd via het regplot R-pakket, waarbij de onafhankelijke klinische risicofactoren (bijv. stadium) en de genetische risicoscore werden gecombineerd om overlevingskansvoorspellingen te individualiseren. Kalibratiecurves werden gebruikt om de overeenkomst tussen de door het nomogram voorspelde overlevingskans en de werkelijke overlevingsuitkomsten te beoordelen. Ten slotte werden de uiteindelijke voorspellende capaciteit en generaliseerbaarheid van het geïntegreerde nomogramsysteem rigoureus gevalideerd via tijdsonafhankelijke ROC-curves en uitgebreide KM klinische subgroepanalyses over de cohorten heen.
Analyses van immuuninfiltratie en immuunsubtypes
CIBERSORT, met gebruik van de leukocyten-gen (LM22) signatuurmatrix, werd gebruikt om de relatieve proporties van 22 immuunceltypen te schatten om de infiltratie van immuuncellen bij LUAD-patiënten te beoordelen. De relaties tussen prognostische genexpressieniveaus en immunologische infiltratie werden geëvalueerd via Spearman-correlatieanalyse. Scores voor immuun-, stroma- en tumorzuiverheid, evenals ESTIMATE-scores, werden afgeleid via het ESTIMATE-algoritme, en de Wilcoxon-toets werd gebruikt om verschillen tussen risicogroepen te beoordelen. LUAD-patiënten werden toegewezen aan zes immuunsubtypen met behulp van het ImmuneSubtypeClassifier-pakket16. De Wilcoxon-toets werd bovendien gebruikt om de verdeling van immuunsubtypen tussen de risicogroepen te vergelijken.
Analyses van immuuncheckpoints, immunophenoscores en de immuuncyclus van kanker
In deze studie werd de Wilcoxon-rangsomtoets gebruikt om 21 immuuncheckpoint-genen17 in risicostratificatiegroepen te beoordelen, met als doel het immuunlandschap van LUAD te karakteriseren. De Spearman-correlatie koppelde kandidaat-prognostische genen aan immuuncheckpoint-genen. Om verschillen in de respons op immuuncheckpointremmers (ICIs) bij LUAD-patiënten met verschillende risiconiveaus te beoordelen, werden immunophenoscore (IPS)-gegevens voor anti-PD-1 en anti-CTLA-4 behandelingen verkregen uit The Cancer Immunome Atlas (TCIA)18, en werd de Tracking Tumor Immunophenotype (TIP)19 database gebruikt om de activiteit van de kanker-immuniteitscyclus te evalueren door de overeenkomstige scores tussen de risicogroepen te vergelijken.
Analyse van somatische mutaties en druggevoeligheid
De TCGA-mutatietool retrieve somatic mutatieprofielen voor TCGA-LUAD-gevallen om variaties in mutatiepatronen over risicogroepen te onderzoeken. Het maftools-pakket werd gebruikt voor het verwerken en visualiseren van de mutatiedata. De tumor-mutatiebelasting (TMB) werd voor elk specimen bepaald en vergeleken tussen de twee risicocategorieën. De farmacogenomische sensitiviteitsanalyse werd uitgevoerd met het pRRophetic-pakket op basis van de Genomics of Drug Sensitivity in Cancer(GDSC)-database20. De half-maximale inhiberende concentratie (IC50) waarden voor antikankergeneesmiddelen werden voorspeld voor elke LUAD-patiënt, en de verschillen tussen de risicogroepen werden gekwantificeerd met de Wilcoxon rank-sum test.
Evaluatie van expressieniveaus voor prognostische genen
Elke dataset diende om de transcriptieniveaus van geselecteerde kandidaatgenen die gerelateerd zijn aan de uitkomst te beoordelen. Om genexpressie te koppelen aan de prognose van de patiënt, werden optimale afkapwaarden afgeleid via de surv_cutpoint-functie in het survminer R-pakket. Op basis van deze drempelwaarden werden LUAD-gevallen gecategoriseerd in subsets met een hoge en lage expressie voor daaropvolgende overlevingsanalyses.
Daarnaast werden vijf gepaarde LUAD-tumoren en aangrenzende normale weefselparen verkregen van het Anhui Chest Hospital, waarna qPCR-validatie werd uitgevoerd. Elke deelnemer gaf schriftelijke geïnformeerde toestemming. Zes kandidaat-prognostische genen (PDGFB, LDHA, ZEB2, FKBP4, DMD en S100B) werden geselecteerd voor qPCR-validatie. RNA werd geëxtraheerd uit gehomogeniseerde weefselmonsters met behulp van een RNA-extractiereagens, gevolgd door chloroformextractie en isopropanolprecipitatie. Met de spectrofotometer werd de RNA-concentratie en -zuiverheid gemeten. qPCR-validatie van de zes kandidaat-prognostische genen werd uitgevoerd met een SYBR Green-gebaseerde PCR-mastermix op een real-time PCR-systeem: initiële denaturatie bij 95 °C gedurende 30 s, gevolgd door 40 cycli van 95 °C gedurende 20 s, 55 °C gedurende 20 s en 72 °C gedurende 20 s. De relatieve expressie werd berekend en genormaliseerd ten opzichte van Glyceraldehyde-3-Phosphate Dehydrogenase (GAPDH) met de 2-ΔΔCt-techniek. Details van alle reagentia en instrumenten zijn opgenomen in de Tabel met materialen.
Statistische analyse
Statistische analyses werden uitgevoerd met behulp van software voor statistische berekeningen en grafische weergave. Het netwerk van eiwit-eiwitinteracties werd gevisualiseerd met software voor netwerkanalyse. Na beoordeling van de normaliteit werd de t-toets van Student gebruikt voor normaal verdeelde continue variabelen en de Mann-Whitney U-toets voor niet-normaal verdeelde variabelen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Identificatie en functionele analyse van kandidaatgenen
In totaal werden 4.915 DEGs gedetecteerd, waaronder 2.485 down-DEGs en 2.430 up-DEGs (Figuur 1A). Functionele module-clusteringanalyse classificeerde deze DEGs in zes expressiemodules (C1-C6), waarbij de modules C1, C2, C3 en C5 een relatief hogere expressie vertoonden in tumorstalen (Figuur 1B). Functionele annotatie gaf aan dat deze modules gekoppeld waren aan ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
LUAD behoort tot de belangrijkste vormen van longkanker en blijft een aanzienlijke last vormen voor de volksgezondheid21. MC is een proces gerelateerd aan celdood dat kan bijdragen aan het verwijderen van cellen met ernstige mitotische afwijkingen en aan de onderdrukking van tumorprogressie22. Daarom kan het onderzoeken van de potentiële rol van MCRGs bij LUAD helpen bij het identificeren van prognostische biomarkers en het verbeteren van het begrip van de biologie van LUAD...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat er geen belangenverstrengeling is.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| ClusterGVis | CRAN | versie 0.1.2 | Clustering en visualisatie van genexpressie |
| Cytoscape | Cytoscape Consortium | versie 3.9.1 | Visualisatie van eiwitinteractienetwerken RRID:SCR_003032 |
| CFX384 Real-Time Quantitative Fluorescent PCR System | Bio-Rad | CFX384 Touch | qPCR-reagens |
| DMD-primer | Tsingke | N/A | Forward: 5’-GCTCAACCATCGATTTGCAGCC-3’ Reverse: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| FKBP4-primer | Tsingke | N/A | Forward: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Reverse: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Online tool | Verkrijgen van de LUAD externe validatiedataset RRID:SCR_005012 |
| GAPDH-primer | Tsingke | N/A | Forward: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Reverse: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | versie 4.1-8 | Kenmerkselectie in LASSO-regressie RRID:SCR_015505 |
| LDHA-primer | Tsingke | N/A | Forward: 5’-GGATCTCCAACATGGCAGCCTT-3’ Reverse: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | versie 3.60.6 | DEG-screening RRID:SCR_010943 |
| maftools | Bioconductor | versie 2.20.0 | Visualisatie van somatische mutatiedata RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Voorspelling van drug IC50-waarden RRID:SCR_024417 |
| PDGFB-primer | Tsingke | N/A | Forward: 5’-GAGATGCTGAGTGACCACTCGA-3’ Reverse: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | qPCR-reagens |
| R-software | R Foundation | versie 4.2.2 | Bio-informatische analyse |
| regplot | CRAN | versie 1.1 | Maken van lijndiagrammen |
| survival | CRAN | versie 3.8-3 | Overlevingsanalyse en Cox-regressie RRID:SCR_021137 |
| STRING | STRING Consortium | Online tool | Analyse van eiwitinteractienetwerken RRID:SCR_005223 |
| S100B-primer | Tsingke | N/A | Forward: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Reverse: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | versie 0.5.0 | Plotten en optimalisatie van overlevingcurves RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | qPCR-reagens |
| TCGA | NCI | Online tool | Acquisitie van LUAD-transcriptoom en klinische data RRID:SCR_003193 |
| ZEB2-primer | Tsingke | N/A | Forward: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Reverse: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Referenties
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar