Om problemen met de fragmentatie van juridische teksten en het traceren van bias in medische kunstmatige intelligentie (AI) aan te pakken, construeert deze studie een juridische kennisgraaf en maakt deze gebruik van relatie-bewuste graafconvolutie voor semantische uitlijning. Gekleurde bronnen worden geïdentificeerd via gradiëntgebaseerde backpropagation, waarbij gunstige experimentele metrieken een compliant medische AI-applicatie ondersteunen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Het construeren van juridische kennisgrafieken en het traceren van bias in medische kunstmatige intelligentie op basis van grafen-neurale netwerken
In dit artikel
Samenvatting
Samenvatting
In de analyse van de juridische naleving van medische kunstmatige intelligentie (AI) behandelt dit artikel de ambiguïteit bij de vaststelling van aansprakelijkheid, veroorzaakt door de semantische fragmentatie van heterogene juridische teksten uit meerdere bronnen en de moeilijkheden bij het traceren van algoritmische bias. Er wordt een methode ontwikkeld voor de constructie van een kennisgraaf en het detecteren van paden voor biaspropagatie op basis van graph neural networks. Vier typen heterogene knooppunten — juridische clausules, medische handelingen, algoritmische modules en verantwoordelijke partijen — worden gestructureerd en gecodeerd, waarna een gericht grafiek wordt geconstrueerd op basis van vier typen juridische semantische relaties: "schending", "basis", "trigger", en "attributie"Vervolgens wordt een relation-aware graph convolutional network, gecombineerd met edge-type-specifieke gewichten en een attention-mechanisme, gebruikt om multi-layer feature alignment voor cross-modale juridische semantiek te bereiken. Daarna wordt gradiëntgebaseerde backpropagation ingezet om randen te identificeren die significant bijdragen aan bias, een bias-propagatie-subgraaf te construeren en community discovery te gebruiken om root-node clusters te lokaliseren. Ten slotte worden real-time besluitvormingsstromen gekoppeld aan tijdelijke knopen, wordt compliance geverifieerd via embedding similarity en wordt de dynamiek van cruciale edge weights gemonitord om te waarschuwen voor systemische bias-accumulatie. Experimenten tonen aan dat de voorgestelde methode, wat betreft de nauwkeurigheid van de semantische alignment, een gemiddelde entity alignment-nauwkeurigheid van ten minste 0,92 en een gemiddelde relation preservation completeness van ten minste 0,8 behaalt over verschillende gradiënten van kennisgraaf-dichtheid. Wat betreft het vermogen tot bias-lokalisatie bereikt de recall-rate van de root nodes 0,95.±±0,02, en de precisie van het voortplantingspad bereikt 0,93±±0.03. Dit onderzoek realiseert tot op zekere hoogte een diepe koppeling tussen juridische logica en algoritmisch gedrag, waardoor een uitlegbaar en verifieerbaar compliance-ondersteuningssysteem wordt geboden voor de betrouwbare implementatie van medische AI.
Inleiding
De diepgaande betrokkenheid van medische AI bij diagnostiek en behandelondersteuning, resource-allocatie en risicobeoordeling heeft de besluitvorming ervan gekoppeld aan de aanname van juridische verantwoordelijkheid1,2. Juridische normen zijn sterk gestructureerd maar semantisch verspreid, en het gedrag van AI-systemen kan als een black box functioneren, zonder een semantisch afstembare en traceerbare interface tussen beide3. In deze context is de ontwikkeling van een gemeenschappelijk representatiekader dat juridische causale ketens binnen algoritmische gedragssequenties vastlegt, noodzakelijk geworden om een fijnmazige toerekening van verantwoordelijkheid en dynamische naleving te realiseren4,5. Deze studie heeft niet alleen betrekking op de juridische toetsing van technologische systemen, maar raakt ook aan het fundamentele behoud van medische rechtvaardigheid, algoritmische eerlijkheid en institutioneel vertrouwen, en heeft daarom een grote theoretische betekenis en praktische urgentie.
Het fundamentele probleem bij de analyse van de juridische conformiteit van medische AI op dit moment is het gebrek aan een berekenbare verbindingsstructuur tussen juridische semantiek en algoritmisch gedrag6,7. Juridische documenten zijn beschikbaar als platte tekst, en de relaties tussen paragrafen zijn verweven met afhankelijkheden, conflicten en uitzonderingen, wat problemen veroorzaakt bij het opdelen ervan in logische eenheden die door machines kunnen worden geïnterpreteerd8,9. Hoewel de besluitvorming van het AI-systeem is ingekapseld in een datagestuurde black box, kan geen van de variaties in de output worden herleid tot specifieke schendingen van juridische plichten of knooppunten voor de toewijzing van aansprakelijkheid10,1. Een dergelijke ontkoppeling (bijvoorbeeld door bias in trainingsdata, fouten in het modelontwerp of de semantische interpretatie van juridische normen) kan niet experimenteel worden geïsoleerd om de bron van bias te identificeren of om juridische plichten voor ontwikkelaars, implementeerders of gebruikers te verduidelijken12,13. Nog problematischer is dat bestaande compliance-procedures alleen controleren of een definitieve output voldoet aan een vaste specificatie, zonder rekening te houden met het propagatiepad of de versterking van bias in het netwerk van interacties tussen wetgeving en technologie14,15. Wanneer medische AI gelijktijdig onderhevig is aan meerdere wettelijke bepalingen en het systeem een keten van fouten produceert door een verkeerde interpretatie van één clausule, kunnen conventionele benaderingen niet herleiden hoe de fout zich verspreidt via andere gerelateerde bepalingen om vervolgens bij de aansprakelijkheid uit te komen16,17. Daarnaast ontbreekt er een dynamisch correlatiemechanisme tussen de real-time besluitvormingsstroom en de bestaande kennisgraaf van het recht, wat resulteert in een vertraagde evaluatie van de conformiteit tijdens de systeemwerking, waardoor proactieve monitoring van de trend in bias-accumulatie wordt belemmerd18,19. Deze problemen leiden samen tot onzekerheid bij de vaststelling van de aansprakelijkheid, een fragiele toeschrijving en vertraagde regelgevende interventie, wat de betrouwbare implementatie van hoogrisico AI-systemen in de gezondheidszorg en de toepassing van juridische verantwoordelijkheid aanzienlijk belemmert.
Bovenal bestudeert traditioneel onderzoek juridische teksten in een gestructureerde vorm en bouwt kennisbases van specifieke domeinen op met ontologieën of regels om vragen en antwoorden over compliance of risicomeldingen te ondersteunen20,21. Hoewel deze benaderingen representaties van sommige juridische concepten kunnen vastleggen, gaan ze er vaak vanuit dat de interne logica van de wet coherent en statisch is, wat het moeilijk maakt om om te gaan met interjurisdictionele inconsistenties, uitzonderingen of vage formuleringen. Latere studies introduceerden technologie voor natuurlijke taalverwerking, waarbij vooraf getrainde taalmodellen werden gebruikt om juridische entiteiten en relaties te extraheren, wat de breedte van de kennisextractie verbeterde2,23, maar dit blijft nog steeds op een ondiep semantisch niveau, waardoor het niet lukt om een mapping-interface tussen juridisch en technisch gedrag vast te stellen. Wat betreft het bestuur van algoritmische bias is het onderzoek zich voornamelijk gericht op het ontwerp van fairness-restricties24,25, en de evaluatie-indicatoren hiervan zijn meestal gebaseerd op demografische variabelen, waardoor er een gebrek is aan afstemming met juridische toerekeningsprincipes. Sommige studies hebben zelfs geprobeerd juridische regels als restricties te coderen en deze in de modeltraining te implementeren26,27, maar vanwege de rigiditeit en grove granulariteit van de regeluitdrukking zijn deze moeilijk aan te passen aan complexe klinische situaties. In het algemeen behandelt bestaand werk juridische compliance als een externe verificatietaak in plaats van als een intrinsiek berekenbaar kenmerk van de systeemarchitectuur. Dit resulteert erin dat juridische logica en algoritmische logica parallel opereren, waardoor gezamenlijke redenering en dynamische interventie op bias-propagatiepaden niet worden ondersteund.
In recente jaren zijn graph neural networks geleidelijk geïntroduceerd in het medische veld vanwege hun vermogen om relationele structuren expliciet te modelleren28,29. Sommige studies maken gebruik van heterogene grafen om jurisprudentie, wettelijke bepalingen en partijinformatie te integreren, waarbij case-aanbevelingen of straftoemetingsvoorspellingen worden ondersteund via node-embeddings30,31, waardoor de effectiviteit van grafstructuren bij het vastleggen van juridische verbanden wordt bevestigd. Andere werken abstraheren algoritmische componenten als graafknopen, waarbij edges worden gebruikt om datastromen of aanroeprelaties weer te geven voor het volgen van foutpropagatie32,3. Deze verkenningen tonen aan dat grafstructuren kunnen dienen als een gemeenschappelijke drager van juridische en technologische elementen. Bestaande graafmodellen kampen echter over het algemeen met drie beperkingen: ten eerste zijn ze beperkt tot één type edge-relatie, waardoor ze geen onderscheid kunnen maken tussen normatieve, causale en attributieve verschillen in de juridische semantiek; ten tweede negeert het feature-aggregatieproces de semantische gewichten van edge-typen, waardoor verschillende juridische logische paden als gelijkwaardig worden behandeld; en ten derde ontbreekt een differentieerbaar trackingmechanisme voor biaspropagatie, waardoor het onmogelijk is om edges met een hoge bijdrage te lokaliseren en verantwoordelijkheidspaden te reconstrueren. Dit artikel construeert een relation-aware graph convolutional network dat het probleem van semantische heterogeniteitsfusie aanpakt door een specifieke transformatiematrix toe te wijzen aan elk type juridische semantische edge en een attention-mechanisme te introduceren om de cross-type informatiestroom dynamisch aan te passen. Bovendien maakt het, door de combinatie van gradient backpropagation en subgraph-extractie, een interpreteerbare overgang mogelijk van compliance-beoordeling op macroniveau naar bias-tracing op microniveau, waarmee de bottleneck van traditionele graafmodellen die enkel statische redenering ondersteunen, wordt overwonnen.
Buiten het medische domein hebben recente vorderingen in grafiekgebaseerde en evolutionaire methoden een brede toepasbaarheid aangetoond voor de verwerking van gestructureerde kennis. Zo stelden Xue et al. een multilagen hybride genetische programmeringsbenadering voor voor adaptieve constructie van gelijkeniskenmerken bij ontologiematching, waarmee een robuuste uitlijning over heterogene kennisgrafieken werd bereikt34. Cheng et al. boden een uitgebreid overzicht van toepassingen van graph convolutional networks bij beeldherstel, waarbij methoden voor ruisonderdrukking, superresolutie en onscherptecorrectie systematisch werden gecategoriseerd35. Li et al. presenteerden een grondig overzicht van evolutionair deep learning vanuit het perspectief van geautomatiseerd machine learning, met aandacht voor principes, algoritmen, toepassingen en open uitdagingen36. Ma et al. ontwikkelden een fuzzy neuraal architectuurzoekraamwerk voor defectherkenning onder onzekerheid, waarmee de effectiviteit van evolutionair zoeken bij het verwerken van ambigue data werd aangetoond37. Deze studies benadrukken het potentieel van het integreren van grafiekgestructureerde representaties en evolutionaire optimalisatie voor complexe besluitvormingstaken.
Het hoofddoel van dit artikel is het vaststellen van een end-to-end interpreteerbaar raamwerk voor de analyse van juridische naleving van medische AI, met innovaties op drie niveaus. Op het niveau van kennisrepresentatie is dit het eerste model dat juridische clausules, medische praktijken, algoritmische modules en verantwoordelijke partijen modelleert als vier typen heterogene knopen. Op basis van de juridische praktijk extraheert het vier typen gerichte relaties: "schending", "basis", "trigger" en "toerekening", waarmee een gerichte kennisgraaf met juridische causale logica wordt geconstrueerd die een gestructureerde semantische basis biedt voor nalevingsanalyse. Voor het traceren van de bron van bias stelt het een methode voor de kwantificering van randbijdragen op basis van gradiëntgevoeligheid. Via backpropagation identificeert het de set randen die de output-bias maximaliseert, om vervolgens een community-discovery-algoritme toe te passen om knopen met een hoge bijdrage te clusteren. Hierdoor wordt "black-box bias" omgezet in "white-box verantwoordelijkheidclusters", wat toerekening mogelijk maakt op basis van een hanteerbare bewijsketen. Op het niveau van real-time dynamische monitoring ontwikkelt het een tijdelijk embedding-mechanisme voor beslissingsknopen dat real-time AI-outputs projecteert in de ruimte van de kennisgraaf. Op basis van de vergelijking van embedding-nabijheid kwantificeert het de mate van normafwijking en monitort het de gewichtsverandering van die essentiële juridisch-technische randen, om zo de accumulatie van systemische bias te signaleren. Dit paradigma pakt zowel semantische fragmentatie als traceerbaarheidsproblemen aan en transformeert juridische naleving van ex post verificatie naar ex ante governance, waardoor een schaalbare technische weg wordt geboden voor de transparantie van verantwoordelijkheid in AI-systemen met een hoog risico.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Constructie van een grafisch neuraal netwerk voor een medische AI-juridische kennisgraaf
Zoals weergegeven in Figuur 1, bestaat het voorgestelde raamwerk uit drie hoofdmodules. De inputlaag integreert data uit meerdere bronnen in een heterogene graaf via multimodale entiteitsencodering en gerichte randmodellering. De relatiebewuste GCN-laag voert vervolgens cross-modale semantische uitlijning uit via typespecifieke gewichten en aandacht, wat resulteert in uniforme node-embeddings. Tot slot ondersteunen deze embeddings bias-tracing (via gradiënt-backpropagatie en community-detectie) en dynamische nalevingsbewaking (via real-time node-mapping en tracking van randgewichten), waarbij de output interpreteerbaar attributiebewijs en risico-alerts voor toezichthouders levert.
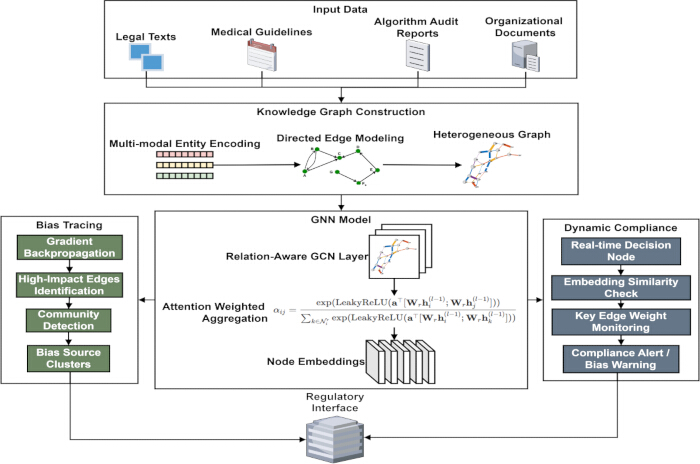
Figuur 1Juridische kennisgraaf en architectuur voor het traceren van bias voor medische AI. Dit diagram illustreert de algemene workflow van het voorgestelde raamwerk. De inputlaag fuseert heterogene gegevens uit meerdere bronnen (juridische teksten, klinische richtlijnen, auditrapporten van algoritmen), die worden gecodeerd in vier entiteitstypen (juridische clausules, medische gedragingen, algoritmische modules, verantwoordelijke partijen) en worden verbonden door vier gerichte juridisch-semantische relaties (schending, basis, trigger, attributie). De relatiebewuste GCN-laag voert cross-modale semantische uitlijning uit via typespecifieke gewichten en aandacht. De bias-tracingsmodule maakt gebruik van gradiënt-backpropagatie om randen met een hoge bijdrage te identificeren, waarna community-detectie wordt toegepast om clusters van wortelknooppunten te lokaliseren. De dynamische compliance-monitor koppelt realtime beslissingen aan tijdelijke knooppunten, evalueert de embedding-overeenkomst met juridische clausules en volgt de evolutie van het randgewicht voor vroegtijdige waarschuwing. De outputs omvatten interpreteerbaar attributiebewijs en risicowaarschuwingen. Klik hier om een grotere versie van deze figuur te bekijken.
Heterogene graafgestructureerde codering van juridische entiteiten en relaties
Vier fundamentele entiteiten worden consistent afgeleid uit regelgeving voor medische AI, klinische praktijkrichtlijnen en auditrapporten van algoritmen: juridische clausules, medische procedures, algoritmische modules en verantwoordelijke entiteiten. Voor elk type entiteit wordt een apart model voor feature representation learning voorgesteld om ze semantisch onderscheidbaar te maken. De knopen voor juridische clausules zijn zo georganiseerd dat ze het nummer van de juridische clausule bevatten, wat wordt gebruikt als een uniek ID (identificatiekenmerk) voor de clausule. Tegelijkertijd wordt een index voor de kwantificering van de ernst van de sanctie gedefinieerd om het niveau van juridische verantwoordelijkheid dat aan de clausule is gekoppeld aan te geven, waarna een featurevector wordt vastgesteld.
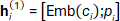 (1)
ci is het vermelgingsnummer, Emb(·) stelt de laagdimensionale embedding-mapping voor, en [·;·] staat voor de vector-concatenatie-operatie. Deze representatie behoudt zowel de formele structuur als de ernst van de straf van de juridische tekst, wat redenering over verschillende verklaringen heen ondersteunt.
Medische gedragsknopen zijn gestandaardiseerd en gecodeerd op basis van een classificatiesysteem voor klinische operaties, waarbij hun risiconiveau rj ∈ {1,2,3} en de set van toepasbare scenario-labels sj ⊂ S worden geëxtraheerd, waarbij S de volledige set van vooraf gedefinieerde scenariocategorieën is. Multi-hot encoding wordt gebruikt om de labelset te verwerken, en deze wordt samengevoegd met de embedding van het risiconiveau om een initiële representatie te vormen:
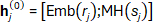 (2)
Deze strategie zorgt ervoor dat verschillende typen medisch gedrag meetbare afstandrelaties hebben in de vectorruimte, wat cross-scenario vergelijkingen ondersteunt. De tekst-embeddingfunctie Emb(·) is geïmplementeerd met behulp van het vooraf getrainde Chinese juridische taalmodel Lawformer (voorgetraind op een grootschalig Chinees juridisch corpus), waarbij de outputdimensie is vastgesteld op 768.
Op basis van de logische afhankelijkheden en juridische beperkingen tussen entiteiten worden vier typen gerichte semantische relaties vastgesteld: "schending", "basis", "trigger" en "toeschrijving", die elk corresponderen met verschillende juridische causale patronen. Aan elke zijde eij ⊂ E wordt een type label tij ⊂ T = {violate, base, trigger, attribute} toegewezen voor de daaropvolgende berichtverzending voor relatiebewustzijn. De constructie van de zijden volgt strikt het mechanisme voor het matchen van domeinregels: wanneer een medisch gedrag afwijkt van de normatieve vereisten, wordt een "schending"-zijde vastgesteld die wijst van de gedragsknoop naar de relevante juridische bepaling; wanneer de juridische bepaling dient als de technische basis voor naleving van een handeling, wordt een "basis"-zijde vastgesteld; als de output van de algoritmische module direct de uitvoering van een specifiek medisch gedrag triggert, wordt een "trigger"-zijde verbonden; de relatie met betrekking tot de toeschrijving van verantwoordelijkheid wordt vastgesteld op basis van de verantwoordelijkheidsdocumenten van de organisatie en auditconclusies, waarbij een "toeschrijving"-zijde wordt vastgesteld tussen de verantwoordelijke partij en de schending of het algoritmische defect.
Nadat alle knooppunten zijn geïnitialiseerd, wordt een heterogene graaf (V, E, H0) gevormd, waarbij V de verzameling knooppunten is, E de verzameling gerichte randen met typelabels is en H0 de initiële kenmerkenmatrix is. Om het semantische onderscheidend vermogen van de graafstructuur te verbeteren, worden de knooppuntkenmerken genormaliseerd:
 (3)
μk en σk zijn respectievelijk het gemiddelde en de standaarddeviatie van de k-de knooppunkenmerk in de trainingsset, en ∈ is een kleine constante om deling door nul te voorkomen. Normalisatie zorgt ervoor dat heterogene kenmerken uit meerdere bronnen op een uniforme schaal deelnemen aan graafconvolutie-operaties, waardoor wordt voorkomen dat numerieke dominantie-effecten het semantische leerproces beïnvloeden. Het resulterende gestructureerde graafmodel bevat volledig de relationele topologie van de vierdimensionale elementen van recht, gedrag, technologie en verantwoordelijkheid in het medische AI-systeem, wat een berekenbare graafbasis biedt voor de daaropvolgende analyse van bias-propagatie.
Verbetering van graph convolution alignment voor cross-modale juridische semantiek
Een relatie-bewust graph convolutional network38,39, dat het Relational Graph Convolutional Network (R-GCN) framework uitbreidt, wordt gebruikt om kenmerken over meerdere lagen van de initiële heterogene graaf te propageren. Waar R-GCN per-relatie transformatiematrices introduceert voor algemene relationele gegevens, incorporeert onze aanpak verder een leerbaar aandachtmechanisme om bijdragen van buren dynamisch te wegen en definieert het vier specifieke juridisch-semantische relatietypen (schending, basis, trigger, attributie), afgestemd op de nalevingsanalyse van medische AI. De operatie van elke laag parametriseert het transformatieproces onafhankelijk op basis van het semantische type van de randen. Voor elke doelnode worden de informatie van de naburigheid gegroepeerd en geaggregeerd op basis van de typen verbindende randen. Elk type relatie is uitgerust met een specifieke lineaire transformatiematrix om de kenmerken te differentiëren die via verschillende juridische semantische paden worden verzonden40,41. Als de rand tussen de juridische clausule-node en de medische gedragsnode van het type "basis" is, past de juridische clausule-node de overeenkomstige gewichtsmatrix toe om de kenmerken van de buur ruimtelijk af te beelden wanneer deze een bericht van een medische gedragsnode ontvangt. Op dezelfde manier, wanneer een medische gedragsnode een output via de randintegratieschemamodule-node "trigger" naar een algoritmische module stuurt, wordt de parametermatrix "triggered", geassocieerd met deze relatie, gebruikt voor de kenmerktransformatie. Dit bootst de vloeibaarheid van verschillende typen juridische logica na, waarbij verschillende logische lagen worden gerealiseerd/geïnformeerd om semantische onafhankelijkheid tijdens de informatiestroom te behouden zonder cross-modale ruis. De aggregatie is als volgt gedefinieerd:
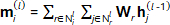 (4)
mi(l) representeert de uitgebreide informatie verzameld door knoop i in laag l, Nil is de set naburige knopen onder relatie r, Wr is de lineaire transformatiematrix, en hj(l−1) is de embedding-representatie van de naburige knoop in de vorige laag.
Tijdens de berichtenaggregatie wordt een leerbaar aandachtmechanisme geïntroduceerd om de intensiteit van de invloed van verschillende buurnodes op de representatie-update van de doelnode dynamisch aan te passen42,43. De attentiecoëfficiënt wordt gegenereerd op basis van de dubbele factoren van knooppunktributsimilariteit en juridische belangrijkheid, zonder te vertrouwen op vaste a-priori gewichten. Voor nodes van juridische clausules wordt, bij het ontvangen van kenmerken van naburige medische handelingen, de attentiescore berekend op basis van de gekwantificeerde waarde van de strafintensiteit die met deze laatste is verbonden; wanneer de algoritme-module node medische gedragsinformatie fuseert, richt deze zich op buren met hogere operationele risiconiveaus. Het attentiegewicht wordt op de volgende manier berekend:
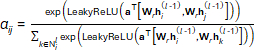 (5)
αij is de attentiecoëfficiënt van knoop j ten opzichte van knoop i, en a is de leerbare attentievector. Dit model maakt de automatische identificatie van verbonden paden met een hoog risico of hoge restricties mogelijk tijdens end-to-end training, waarbij aan deze paden een hogere attentie wordt toegekend. De uiteindelijke bijgewerkte knoop-embedding wordt bepaald door gewogen berichten en residuele verbindingen.
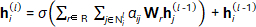 (6)
σ is de activeringsfunctie, en het residuele ontwerp vermindert het probleem van het verdwijnen van de gradiënt bij diepe propagatie en garandeert stabiliteit bij de aanwezigheid van meerdere semantische conflicten. Na L = 3 grafenconvolutionele lagen (elk met een verborgen dimensie van 256 en ReLU-activering), integreren de embeddings van alle knooppunten naadloos cross-modale contextuele informatie en worden zij uniforme representaties met juridische semantische discriminatievermogens.
Twee alternatieve diagrammen voor de analyse van juridische naleving voor de AI in de gezondheidszorg worden weergegeven in Figuur 2, met als doel de visualisatie van typen juridische relaties en routes voor bias-propagatie aan te pakken, wat wijst op potentiële bronnen van bias bij deze besluitvorming. Figuur 2A toont de invloed van diverse juridische semantische relaties, waarbij vier relatietypen kleurgecodeerd zijn en voor elk type de randen door een verschillende kleur worden onderscheiden. De dikte van de rand komt overeen met het aandachtsgewicht van die specifieke relatie, oftewel in hoeverre deze relatie bijdraagt aan de AI-beslissing. Een dikke rand duidt in wezen op een dominante juridische relatie in de beslissing en in dit geval motiveerde dit voldoende de uitkomst van de zaak. De knoopgrootte wordt gemeten aan de hand van de bijdrage aan schendingen: grotere knopen duiden op een sterkere relatie tussen het gedrag en specifieke juridische clausules, en dus een hoger potentieel risico. De bovenstaande visualisatie biedt een heldere juridische semantische laag, waardoor we de sterkste en risicovolleste juridische paden in de AI-besluitvorming kunnen identificeren. Figuur 2B geeft ook paden met een hoge bijdrage (aan bias-propagatie) aan, met de nadruk op randen met hoge bijdragen, die vetgedrukt zijn en vergezeld gaan van stippellijnen (bijv. B1-B3) in het besluitvormingsproces. Een verdubbeling van de breedte van deze randen vertegenwoordigt hun belang bij het verspreiden van systemische bias. Welke combinaties van juridische regels en technisch gedrag resulteren in dit versterkingseffect voor bias wordt getoond in Figuur 2. Deze analyse onthult niet alleen het pad van bias-propagatie, maar vergemakkelijkt ook het identificeren van de oorsprong van de bias, op basis waarvan compliance-auditing en de verantwoordelijkheid van de AI-tool kunnen worden vastgesteld.
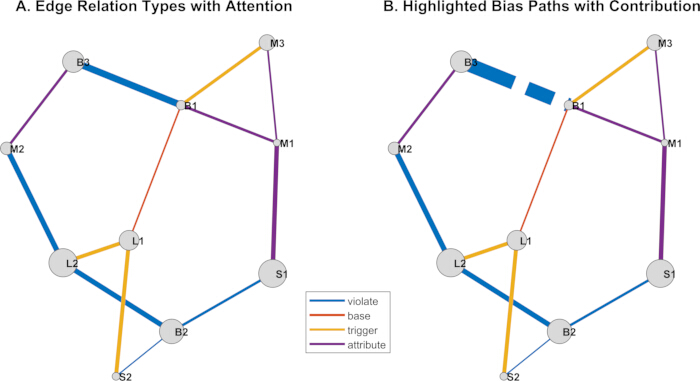
Figuur 2Analyse van juridische naleving en biaspropagatie in AI voor de gezondheidszorg (illustratief voorbeeld). (A) Kleurgecodeerde juridische semantische relaties: schending (rood), grondslag (blauw), trigger (groen), attributie (oranje). De lijndikte is proportioneel aan het aandachtsgewicht, wat de invloed van elke relatie op de AI-beslissing aangeeft. De knoopgrootte is proportioneel aan de bijdrage aan de schending, waardoor risicovolle entiteiten worden geaccentueerd. (B) Subgraaf van biaspropagatie: randen met een hoge bijdrage zijn vetgedrukt en gestippeld (bijv. B1‑B3); randen met een dubbele breedte duiden op amplificatie van systemische bias. Deze visualisatie ondersteunt de identificatie van dominante juridische paden, de oorsprong van bias en compliance-auditing. Er zijn geen meetschalen of foutenbalken van toepassing, aangezien dit een schematische illustratie is. Klik hier om een grotere versie van deze figuur te bekijken.
Subgraph-backtrackingmechanisme voor bias-propagatiepaden
In deze studie wordt "bias" gedefinieerd als de systematische afwijking van de output van een AI-systeem ten opzichte van de klinisch en juridisch verwachte beslissing, gemeten aan de hand van het verschil tussen de door het model voorspelde risicoscore en het ground-truth compliance-label. Het bias-signaal wordt gekwantificeerd als het cross-entropy verlies tussen de uiteindelijke output van het algoritme en een binaire indicator van compliance (1 voor compliant, 0 voor non-compliant), geaggregeerd over alle beslisinstanties in een batch.
Nadat het graph neurale netwerk is getraind, wordt de differentieerbaarheid ervan gebruikt om een backpropagation-analyse uit te voeren op het bias-signaal in de outputlaag. Uitgaande van de beslissingsnode van het algoritme die anomalieën detecteert, wordt de gradiëntmagnitude van de verliesfunctie ten opzichte van elke verbindende edge berekend om de bijdrage van elke edge aan de bias-vorming te kwantificeren. Dit proces wordt geïmplementeerd via een framework voor automatische differentiatie, waarbij laag voor laag wordt teruggegaan langs de gerichte edges in de graph-structuur om de invloedssterkte van elke edge-parameter-transformatie op de uiteindelijke outputwijziging te bepalen. Hoe hoger de absolute waarde van de gradiënt, hoe dominanter de juridisch-technische relatie die door die edge wordt gedragen is in de bias-propagatie. De bijdrage van een edge wordt gedefinieerd als:
 (7)
Lbias is het differentieerbare verlies gedefinieerd voor bevooroordeeld gedrag, en wi is de gewichtsvector van de invoer die overeenkomt met het type rand. Deze gradiëntwaarde weerspiegelt de mate van participatie van een specifieke semantische relatie in de huidige associatiebias. Nadat alle randen op deze manier zijn gescoord, wordt een dynamische drempelwaarde τ ingesteld om de set randen met een hoge bijdrage Ehigh te filteren waarvan de bijdrage gij > τ is, waardoor de initiële bias-propagatie-subgraaf Gbias = (Vbias, Ehigh) wordt gevormd. Specifiek wordt τ bepaald als het 85ste percentiel van de absolute gradiëntwaarden over alle randen in elke trainingsepoch, zodat alleen de top 15% van de meest invloedrijke randen behouden blijft voor de constructie van de subgraaf. Deze subgraaf richt zich op de belangrijkste verbindingspaden die waarschijnlijk systematische bias veroorzaken, waardoor de zoekruimte wordt gecomprimeerd en de efficiëntie van de bronspooring wordt verbeterd.
Binnen de geconstrueerde bias-propagatie-subgraaf wordt een door spectrale clustering geleid community-detectie-algoritme uitgevoerd om sterk in-line knoopclusterstructuren te identificeren. Dit proces is gebaseerd op de genormaliseerde Laplace-matrixfactorisatie van de subgraaf, waarbij knoop-embeddings worden geprojecteerd op een laagdimensionale spectrale ruimte en een dichtheidsbewuste clusteringstrategie in deze ruimte wordt toegepast om ervoor te zorgen dat cross-type knopen (zoals juridische clausules en algoritmische modules) in dezelfde cluster worden gegroepeerd wanneer ze functioneel nauw verwant zijn. Elke geïdentificeerde community vertegenwoordigt een potentiële functionele lus of verantwoordelijkheidsaggregatie-eenheid. De resultaten van de community-partitionering worden gestuurd door de volgende optimalisatiedoelen:
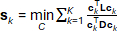 (8)
L=D−A is de Laplace-matrix van de subgraaf, A is de adjacentiematrix, D is de graadmatrix, ck is de indicatorvector van de k-de gemeenschap, en K is het vooraf ingestelde aantal gemeenschappen. Dit criterium maximaliseert het minimumverschil van de snede (cut difference) tussen gemeenschappen, wat zorgt voor sterke interne verbindingen.
Vervolgens wordt voor elke community een cross-layer composite-analyse uitgevoerd. Indien een community zowel knooppunten van juridische clausules als knooppunten van algoritmische modules bevat, wordt deze gemarkeerd als een potentiële bron van bias. Om de causaliteit hiervan te testen, wordt een interventietest uitgevoerd: alle verbindingen in deze regio worden tijdelijk uit de graaf verwijderd, waarna hetzelfde besluitvormingsproces opnieuw wordt uitgevoerd en de verschillen in de bias-metingen worden vastgesteld. De maatstaf voor causale validiteit is als volgt gedefinieerd:
 (9)
Borig en Bmask vertegenwoordigen respectievelijk de biassterkte van het oorspronkelijke model en de bias na maskering. Als de maatstaf voor causale validiteit aanzienlijk boven de vooraf vastgestelde drempelwaarde ligt, impliceert dit dat de nodecluster is geïdentificeerd als een verklaarbare bron van bias, wat verdere nalevingscorrectie en fouttoewijzing zal sturen.
Dynamische nalevingsverificatie van wettelijke beperkingen
Beslismomenten in realtime die optreden tijdens de werking van een medisch AI-systeem worden geïntroduceerd als tijdelijke knopen en ingebed in een aangeleerde knowledge graph-ruimte. Elke knoop genereert een initiële kenmerkvector door de inputcontext, het outputgedrag en de status van het algoritme uit te lezen. Vervolgens wordt deze vector gevoed aan een graph neural network met bevroren parameters om eenlaagse forward propagation uit te voeren, wat resulteert in een embedding die is afgestemd op de knowledge graph zonder de oorspronkelijke grafstructuur te wijzigen. Hierdoor kunnen tijdelijke knopen en knopen met juridische clausules worden vergeleken in een gemeenschappelijke semantische ruimte.
Bereken vervolgens de cosinus-overeenkomst tussen de tijdelijke knoop en elke knoop van de juridische clausule:
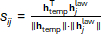 (10)
htemp is de embedding van de tijdelijke node, en hjlaw is de embedding van de j-de node van de juridische clausule. De similarity-waarde weerspiegelt in feite de graad van semantische overeenstemming tussen de huidige beslissing en elke juridische beperking. Een dynamische compliantiedrempel θ wordt vastgesteld op basis van de similarity-distributie van historische compliantie-samples om de beoordelingsgrens aan te passen aan verschillende applicatiescenario's. Specifiek is θ = µ - 2σ, waarbij µ en σ het gemiddelde en de standaarddeviatie zijn van de cosinus-similarity-distributie, berekend op basis van een validatieset van 50 bekende compliantie-beslissingsinstanties.
Wanneer een cosinus-similariteitsscore onder de dynamische nalevingsdrempel valt, wordt de overeenkomstige rechtsregel als geschonden beschouwd, wat het nalevingswaarschuwingsmechanisme activeert. De melding bevat ook het nummer van de minimaal overeenkomende juridische clausule, de similariteitswaarde en de richting van de divergentieanalyse, wat voldoende zou moeten zijn voor toezichthouders om prompt actie te ondernemen. Deze aanpak biedt een interpreteerbare mapping van ondoorzichtige besluitvorming naar de ruimte van juridische semantiek en faciliteert on-the-fly nalevingscontrole.
Tijdens continue werking wordt de trend van gewichtsveranderingen van belangrijke verbindingsranden tussen juridische en technologische entiteiten in de subgraaf van bias-propagatie gevolgd. De nadruk ligt op de randen die algoritmemodulenode-knopen en juridische clausule-knopen verbinden, aangezien deze direct de responssterkte van technisch gedrag op specifieke regelgeving vertegenwoordigen. De parameters van de transformatiematrix voor elke doelrand worden tijdens de inferentie geregistreerd, en hun norm wordt geëxtraheerd als een dynamische indicator voor de evolutie van de correlatiesterkte tussen beide. De sequentie van de randsterkte wordt gedefinieerd als:
 (11)
wt stelt de Frobenius-norm voor van de gewichtsmatrix die overeenkomt met de relatie tussen rand eij op tijdstempel t, en Wkl(t) is de parametermatrix die op dat moment daadwerkelijk in het model wordt gebruikt. Deze indicator weerspiegelt de leerdiepte van het model of de afhankelijkheid van de wettelijke beperking.
Er wordt een monotonietest met een schuifvenster uitgevoerd op de sequentie, en een verbeterde tekentoets wordt gebruikt om vast te stellen of er een significante opwaartse trend wordt waargenomen. Als de incrementen over N opeenvolgende tijdstappen voldoen aan de voorwaarde van positieve dominantie, dan wordt beschouwd dat de rand een abnormaal versterkingsfenomeen vertoont. Door daarnaast historische gegevens over de gradiëntbijdrage te combineren, wordt er een vroegtijdig waarschuwingsproces voor systemische bias-accumulatie gestart indien de rand in de vorige ronde van de bronspooringanalyse is geïdentificeerd als een pad met een grote impact.
Ten slotte wordt een bronherleidingsrapport gegenereerd, met informatie over de knooppunten aan beide uiteinden van de doelrand, gewijzigingscurven, statistieken over de frequentie van gerelateerde beslissingen en potentiële aanbevelingen voor attributie. Dit mechanisme realiseert een sprong van statisch compliance-oordeel naar dynamische risicovoorspelling, wat proactieve interventie bij potentiële institutionele afwijkingen ondersteunt.
Experimentele gegevens en ontwerp
Om de effectiviteit van het voorgestelde raamwerk te verifiëren, construeert dit artikel een multi-source heterogene dataset die echte regelgeving en simulatiedata integreert, en ontwerpt het strikte controle-experimenten. De databronnen omvatten nationale regelgeving voor medische AI, klinische behandelrichtlijnen, open-source auditrapporten van algoritmen en simulatie-beslissingslogs. Na voorbewerking wordt een benchmark heteroge kennisgraaf geconstrueerd met 285 knopen (85 juridische clausules, 120 medische handelingen, 42 algoritmische modules en 38 verantwoordelijke entiteiten) en 1247 gerichte randen, zoals weergegeven in Figuur 3.
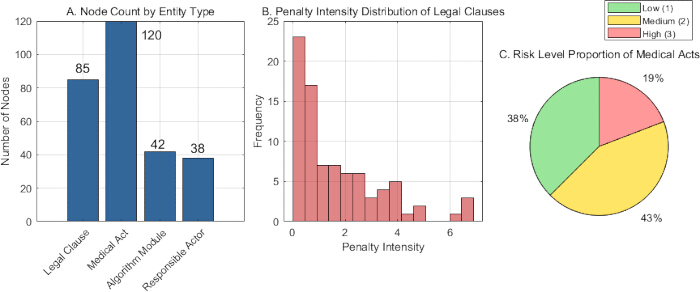
Figuur 3Distributie en kenmerken van heterogene entiteitstypen. (A) Staafdiagram dat het aantal knooppunten per entiteitstype weergeeft: juridische clausules (85), medische gedragingen (120), algoritmische modules (42), verantwoordelijke partijen (38). (B) Histogram van de boete-intensiteit voor juridische clausuleknopen, ingedeeld in de categorieën laag (0‑0,3), medium (0,34‑0,66) en hoog (0,67‑1,0); de verticale as geeft het aantal weer. (C) Cirkeldiagram van de risiconiveausverdeling onder de medische gedragsknooppunten: laag (19%), gemiddeld (43%), hoog (38%). Alle waarden zijn absolute aantallen of percentages; er worden geen foutbalken weergegeven omdat dit beschrijvende statistieken van de dataset zijn. Klik hier om een grotere versie van deze figuur te bekijken.
Figuur 3 illustreert de distributie en kenmerken van entiteitsknopen in de heterogene kennisgraaf. Figuur 3A toont de distributie van het aantal van vier typen entiteitsknopen, waarbij knopen voor "medisch gedrag" het talrijkst zijn (120), gevolgd door "juridische clausules" (85), terwijl "algoritmemodules" (42) en "verantwoordelijke entiteiten" (38) relatief minder talrijk zijn. Dit komt doordat de graaf structureel is ontworpen op basis van gedrag en regels. Figuur 3B presenteert de distributie van strafintensiteiten voor knopen die een unieke juridische clausule vertegenwoordigen, waarbij de intensiteit de ernst van de juridische aansprakelijkheid meet. De gegevens geven aan dat er relatief weinig bepalingen zijn met een hoge strafintensiteit en dat de meeste zich in een medium-tot-lage intensiteitsklasse bevinden, wat overeenstemt met de realiteit dat er in praktijkjuridische systemen slechts enkele clausules voor ernstige overtredingen zijn. Figuur 3C illustreert de distributie van het risiconiveau in knopen voor medisch gedrag, waarbij gedragingen met een medium risico het grootste aandeel hebben (43%) en gedragingen met een laag risico het kleinste aandeel (19%), wat onthult dat medische scenario's normaal worden uitgevoerd en dat operaties met een hoog risico onderworpen zijn aan strengere associatiebeperkingen in de graaf. Deze statistieken rechtvaardigen gezamenlijk het schema voor entiteitsdisambiguatie-codering dat is toegepast bij de constructie van de kennisgraaf om kenmerkondersteuning te bieden voor de daaropvolgende graafconvolutionele uitlijning.
De volledige dataset werd willekeurig verdeeld in trainings- (70%), validatie- (10%) en testsets (20%), gestratificeerd naar knooppunttype en relatieverdeling om de algemene grafiekstructuur in elke split te behouden. Dezelfde partitionering werd consistent gebruikt voor alle baseline-methoden om een eerlijke vergelijking te waarborgen. Naast deze basispartitionering dienen de drie gradiënten van kennislengraf-dichtheid (ijjl, gemiddeld, dicht) en de drie instellingen voor cross-jurisdictionele complexiteit (enkelvoudig, bilateraal, multilateraal), zoals hierboven beschreven, als onafhankelijke praktische testomgevingen die gezamenlijk de robuustheid van de methode evalueren onder variërende omstandigheden van datavolledigheid en regelgevende overlap. Om ground-truth-labels te construeren voor de evaluatie van bias-lokalisatie, hebben we een tweestapsstrategie gehanteerd: (1) Expert-annotatie—drie juridische en medische experts beoordeelden onafhankelijk de besluitvormingslogboeken en identificeerden de root-cause-knooppunten en propagatiepaden voor elke geregistreerde nalevingsschending, waarbij discrepanties via een meerderheidsstem werden opgelost; (2) Gesimuleerde injectie—voor gecontroleerde tests hebben we kunstmatig bias-signalen geïnjecteerd in 20 willekeurig geselecteerde besluitvormingspaden door de edge-gewichten in de kennisgraaf te verstoren, waardoor werd gewaarborgd dat de werkelijke bronknooppunten en beïnvloede edges a priori bekend waren.
Voor alle baseline-methoden (TransE, ComplEx, Graph Neural Networks (GNN) Explainer, KG-BERT en Node2Vec) hebben we dezelfde trainingsconfiguratie gebruikt (Adam-optimizer, leerpercentage 1 × 10⁻³, batchgrootte 64, 10 epochs) en dezelfde datapartities als onze methode om een eerlijke vergelijking te waarborgen. Voor TransE en ComplEx werd de embedding-dimensie ingesteld op 256 met een marge van 1.0; voor KG-BERT gebruikten we het vooraf getrainde BERT-base-model met een batchgrootte van 16 en een maximale sequentielengte van 128; voor GNNExplainer gebruikten we een GCN met 3 lagen en dezelfde verborgen dimensie van 256; en voor Node2Vec stelden we de walk-lengte in op 80, het aantal walks per node op 10 en de embedding-dimensie op 256.
Om een eerlijke vergelijking te waarborgen, hebben we alle basislijnmethoden aangepast aan dezelfde taken voor bias-lokalisatie, namelijk de identificatie van de root-node en de reconstructie van het propagatiepad. Voor TransE, ComplEx en Node2Vec, die inherent niet uitlegbaar zijn, hebben we de gradiënt van het bias-verlies ten opzichte van de embedding van elke node berekend en de grootte van de gradiënt gebruikt als score voor de belangrijkheid van de node; root-nodes werden geselecteerd door deze scores te drempelen, en propagatiepaden werden gereconstrueerd door de randen met de hoogste gradiëntbijdragen te behouden. Voor GNNExplainer hebben we direct de ingebouwde mechanismen voor edge-belangrijkheid en node-maskering gebruikt om zowel root-nodes als subgrafen te verkrijgen. Voor KG‑BERT, dat op triplets werkt, hebben we elke grafenrand omgezet in een tekstueel triplet en de attention-gewichten van het model over entiteiten gebruikt om de belangrijkheid van de nodes af te leiden, gevolgd door dezelfde drempelstrategie voor padreconstructie. Door middel van deze aanpassingen produceert elke basislijnmethode zowel voorspellingen voor de root-node als voorspellingen voor het propagatiepad, wat een uniforme evaluatie over alle methoden mogelijk maakt.
De evaluatie is gecentreerd rond vier fundamentele vermogens: de nauwkeurigheid van de semantische afstemming, het vermogen om bias te lokaliseren, de efficiëntie van de verantwoording en de generalisatie over verschillende domeinen. Er worden tevens drie belangrijke controlevariabelen gepresenteerd, die de complexiteit van de echte wereld nabootsen.
1) Dichtheidsgradiënt van de kennisgraaf: Om te beoordelen hoe de methode presteert bij verschillende niveaus van informatievolledigheid, worden twee subsets van de volledige basisgraaf (dichtheid D = 1.0) gemaakt op basis van een strategie voor het willekeurig verwijderen van verbindingen als volgt:
Ijl grafiek (D ~ 0,3): 30% van de verbindingen wordt willekeurig behouden, wat de fase van vroege kennisconstructie simuleert waarbij veel informatie ontbreekt.
Graaf met gemiddelde dichtheid (D ~ 0,6): 60% van de randen wordt willekeurig behouden, wat een typisch scenario van een gedeeltelijk bekende kennisstructuur simuleert.
Dichte graaf (D = 1.0): Hierbij worden alle 1247 randen gebruikt, wat overeenkomt met een best-case scenario van relatief volledige kennis.
2) Situatie van de beslissingsfrequentie van medische AI: Drie kunstmatige beslissingsstroombelastingen zijn ingesteld om de realtime prestaties van dynamische nalevingsbewaking te testen:
Lage frequentie 10 Hz: Gemiddeld worden er 10 beslissingsgebeurtenissen per seconde gegenereerd, wat de monitoring van kleinschalige systemen of systemen met één site simuleert.
Mediume frequentie 50 Hz: 50 beslissingsgebeurtenissen per seconde die de AI-systeembelasting van regionale of middelgrote medische instellingen simuleren.
Hoge frequentie 100 Hz: 10 beslissingsgebeurtenissen per seconde simuleren de scenario's met hoge gelijktijdigheidsdruk voor AI-diensten die worden geïmplementeerd in een groot ziekenhuis of cloudplatform.
3) Gradiënt van cross-juridische complexiteit: Om de overdraagbaarheid van de modellering van juridische beperkingen te testen, werden drie op complexiteit gebaseerde testsets samengesteld:
Enkele rechtsmacht: Bestaat uitsluitend uit de huidige Chinese wetten en regelgeving die betrekking hebben op medische AI.
Bilaterale jurisdictie: Omvat de regelgevende regimes van China en de Europese Unie, waarbij ongeveer 15% van de regels conflicterend en overlappend is.
Multilaterale jurisdictie: Voortbouwend op de eerste twee, integreert dit verder privacy- en beveiligingsregels uit de Amerikaanse HIPAA (Health Insurance Portability and Accountability Act), waardoor een testomgeving ontstaat waarin de rechtssystemen van de drie juridische regimes in elkaar grijpen, wat de mate van regelconflicten verhoogt tot ongeveer 25%.
De volgende belangrijkste indicatoren werden gebruikt voor kwantitatieve evaluatie:
1) Nauwkeurigheid van de semantische uitlijning: Meet het vermogen van de graaf om de relaties tussen juridische en technische entiteiten te modelleren.
Nauwkeurigheid van entiteitsuitlijning:
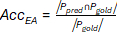 (12)
Ppred is de set van uitgelijnde entiteitsparen die door het model zijn voorspeld, en Pgold is de set van gouden uitlijningen die door experts zijn geannoteerd.
Integriteit van relatiebehoud:
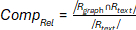 (13)
Rgraph is de gereconstrueerde verzameling relaties in de graaf, en Rtext is de verzameling expliciete relaties die uit de oorspronkelijke juridische tekst zijn geëxtraheerd.
2) Vermogen tot lokalisatie van bias: Evaluatie van de effectiviteit bij het traceren van de grondoorzaken en propagatiepaden van bias.
Recall-percentage van de wortelknoop:
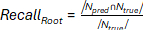 (14)
Npred is de verzameling knopen van bias-bronnen geïdentificeerd door het model, en Ntrue is de verzameling werkelijke bronknopen gelabeld door experts.
Nauwkeurigheid van het voortplantingspad:
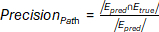 (15)
Epred is de verzameling randen in de bias-propagatie-subgraaf die door het model is afgeleid, en Etrue is de werkelijke verzameling bias-propagatie-randen.
3) Efficiëntie van de verantwoordelijkheidsmodellering: Test de prestaties van het systeem in scenario's voor real-time monitoring.
Gemiddelde tracing-latentie:
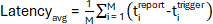 (16)
M staat voor het totale aantal verzoeken, en titrigger en tireport zijn respectievelijk de tijdstempels van de i-de bias-trigger en de generatie van het bronrapport.
Systeemdoorvoersnelheid:
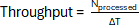 (17)
Nprocessed staat voor het aantal gelijktijdige tracing-aanvragen dat succesvol is verwerkt binnen het tijdsinterval ΔT.
4) Cross-domein generalisatievermogen: Het verifiëren van de aanpasbaarheid van de methode aan verschillende rechtssystemen.
Jurisdictionele dekking:
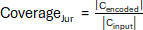 (18)
Cencoded stelt het aantal verschillende jurisdictieclausules voor dat succesvol in de graaf is gecodeerd, en Cinput stelt het totale aantal inputclausules voor.
Detectiesnelheid van conflictbeperkingen:
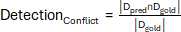 (19)
Dpred is de verzameling wettelijke logische tegenstrijdigheden die door het model zijn gedetecteerd, en Dgold is de verzameling van alle tegenstrijdigheidparen die door experts zijn geannoteerd.
Alle experimenten werden uitgevoerd met een workstation die is uitgerust met een multicore-processor en een grafische processor; de volledige hardware-specificaties zijn opgenomen in de Tabel met Materialen.
De belangrijkste hyperparameters van deze benadering en hun waarden zijn vermeld in Tabel 1, inclusief de modelstructuur en trainingsconfiguratie, evenals cruciale drempelwaarden zoals de embedding-dimensie, het aantal convolutionele lagen, de leersnelheid en de batchgrootte. Alle parameters zijn afgestemd op basis van de validatieset via grid search; het getrainde model is stabiel geconvergeerd en de prestaties zijn optimaal. Sommige drempelwaarden zijn vastgesteld in overeenstemming met domeincriteria om te voldoen aan de vereisten voor een hoge betrouwbaarheid van medische AI-compliancecontrole.
| Parameter | Waarde | Beschrijving |
| Inbeddingsdimensie | 128 | Kenmerkdimensie voor node-embeddings |
| Aantal convolutionele lagen | 3 | Diepte van het relatiebewuste graafconvolutienetwerk |
| Leersnelheid | 0.001 | Initiële leerfrequentie voor de Adam-optimizer |
| Batchgrootte | 32 | Aantal subgrafen verwerkt per batch |
| Uitvalpercentage | 0.1 | Dropoutkans toegepast op knooppunkenmerken tijdens training |
| Aantal attention heads | 8 | Aantal koppen in multi-head attention-mechanisme |
| L2-regularisatiecoëfficiënt | 5 × 10⁻⁴ | Weight decay-coëfficiënt voor parameterregularisatie |
| Similariteitsdrempel | 0.75 | Minimale embedding-gelijkenis voor compliantievalidatie |
| Drempelwaarde voor gradiëntbijdrage | 0.01 | Drempelwaarde voor het selecteren van edges met een hoge impact bij de constructie van een bias-subgraaf |
| Grootte van het monitoringvenster | 10 | Tijdstappen gebruikt voor het volgen van de dynamiek van het gewicht van de verbindingen |
Tabel 1: Belangrijkste parameterinstellingen. Lijst van belangrijke hyperparameters die in de experimenten zijn gebruikt: embedding-dimensie (256), aantal GCN-lagen (3), verborgen dimensie (256), leerpercentage (1 × 10⁻³), batchgrootte (64), dimensie van de attention-vector, drempelwaarde voor randbijdrage (85ste percentiel van de gradiëntmagnituden), dynamische compliantiedrempel (µ‑2σ, waarbij µ en σ afkomstig zijn van de validatieset van 50 compliante instanties), aantal communities K (bepaald via spectrale clustering) en optimizer (Adam). Deze waarden zijn geselecteerd via grid search op de validatieset.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Prestatieverificatie van het traceren van de oorsprong van bias in een medische AI-juridische kennisgraaf
Prestaties van relatiebewuste graafconvolutie
Door het trainen van een relatiebewust grafisch convolutioneel netwerk werden de embedding-overeenkomsten tussen juridische clausules en knooppunten van medisch gedrag over verschillende convolutionele lagen berekend, en werd het uitlijningseffect van elke laag vastgelegd. Ten tweede...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De integratie van medische AI in klinische besluitvorming brengt juridische uitdagingen met zich mee wat betreft de toewijzing van verantwoordelijkheid, wat wordt belemmerd door de semantische kloof tussen ongestructureerde juridische teksten en black-box-algoritmen. Om dit te overbruggen, hebben we een op GNN gebaseerde kennisgraaf voorgesteld die juridische clausules, medisch handelen, algoritmische modules en verantwoordelijke partijen modelleert als heterogene knooppunten, die via vier gerichte juridisch-semantische ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
Het manuscript is noch eerder gepubliceerd, noch in overweging bij een ander tijdschrift. Alle auteurs hebben de inhoud van het artikel goedgekeurd. De auteurs verklaren dat er geen financiële belangenverstrengelingen zijn.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| ComplEx | Open-source implementatie (bijv. OpenKE) | Versie 1.0 | Baseline voor complex embedding voor vergelijking van kennisgrafen |
| GNNExplainer | Open-source implementatie (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Baseline voor GNN-interpreteerbaarheid voor bias-tracing |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Centrale processor voor modeltraining en data-preprocessings |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Transformer-gebaseerde KG-embedding baseline voor semantische uitlijning |
| Node2Vec | Open-source implementatie (https://github.com/aditya-grover/node2vec) | Versie 1.0 | Baseline voor node embedding op basis van random-walk |
| NVIDIA Tesla V10 (GPU) | NVIDIA Corporation | 90-2G50-0010-0 | Hoge-performance GPU voor het versnellen van de training van graph neural networks |
| Ours (Relation-aware GCN) | Custom implementatie in PyTorch | PyTorch 1.12.0 | Voorgesteld framework met per-relatie transformaties, attention en gradient backtracking |
| TransE | Open-source implementatie (bijv. OpenKE) | Versie 1.0 | Translationele embedding baseline voor vergelijking van kennisgrafen |
Referenties
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.