Dit protocol presenteert het Tri-stream Disentangled Network (TDE-Net), een raamwerk voor EEG-naar-beeldreconstructie dat complementaire EEG-representaties, dual-space visuele uitlijning en diffusiedecodering combineert.
Methodenartikel
Tri-Stream Ontvlochten Netwerk met Adaptieve Dual-Space Fusie voor Elektro-encefalografie-gebaseerde Beeldreconstructie op THINGS-EEG2
In dit artikel
Samenvatting
Samenvatting
Het reconstrueren van visuele stimuli op basis van niet-invasieve elektro-encefalografie (EEG) vereist het koppelen van korte, ruizige neurale responsen aan betekenisvolle visuele representaties, ondanks de beperkte ruimtelijke bemonstering. Bestaande EEG-naar-beeldbenaderingen maken gebruik van diverse neurale representaties en generatieve strategieën, wat reproduceerbare workflows vereist die structurele en semantische bijdragen van elkaar scheiden. Dit protocol presenteert het Tri-stream Disentangled Network (TDE-Net), een computationeel raamwerk voor EEG-gebaseerde beeldreconstructie. Het protocol maakt gebruik van gepreprocessede THINGS-EEG2 opnamen en organiseert EEG-informatie in een raw EEG anchor, een monster-specifieke functionele graafstroom en een multi-schaal temporele semantische stroom. De graafstroom legt frequentiedomeinrelaties tussen EEG-kanalen vast via graafconvolutie en cross-trial contrastief leren, terwijl de semantische stroom taakrelevante kenmerken extraheert via adaptieve ruimtelijke weging en multi-schaal temporele convoluties. Structurele en semantische kenmerken worden afzonderlijk gekoppeld aan latent spaces van een variational autoencoder (VAE) en Contrastive Language-Image Pre-training (CLIP), gecombineerd met behulp van fusiegewichten die zijn geselecteerd via een ontwikkelingsset, en gedecodeerd met Stable UnCLIP. Over 10 participanten behaalde TDE-Net een gemiddelde CLIP paarwijze identificatienauwkeurigheid van 0,8135, waarbij aanvullende metrieken de correspondentie in de structurele en kenmerkruimte aantoonden. Ablatie- en representatieniveau-analyses karakteriseerden verder de bijdragen van de individuele stromen. Dit protocol biedt een reproduceerbaar raamwerk voor het onderzoeken van complementaire EEG-representaties en diffusie-gebaseerde visuele reconstructie.
Inleiding
Het decoderen van visuele perceptie is een interdisciplinisch onderzoeksgebied binnen hersen-computerschnittstellen (BCI's) en de cognitieve neurowetenschappen. Functionele magnetische resonantiebeeldvorming (fMRI) heeft realistische beeldreconstructie mogelijk gemaakt1,2,3,4, maar de kosten, de beperkte draagbaarheid en de hemodynamische vertraging beperken sommige toepassingen. Elektro-encefalografie (EEG) biedt temporele metingen op milliseconde-schaal met relatief toegankelijke instrumentatie, maar de lage signaal-ruisverhouding en de beperkte ruimtelijke bemonstering maken EEG-naar-beeldreconstructie moeilijk.
De complexiteit van de methode moet worden geïnterpreteerd in het licht van de algemene bias-variantie-afweging5. Vroege methoden voor visuele decodering maakten gebruik van ondiepe of lineaire representaties, terwijl latere studies compacte convolutionele, graafgebaseerde en attention-gebaseerde encoders introduceerden6,7,8,9,10,11. Cross-modale uitlijning is evenzo geëvolueerd van multimodale feature-learning12,13 naar latente diffusiemodellen en grote vision-encoders14,15,16. Deze benaderingen vormen nuttige baselines, maar hun input-representaties, latente targets en decoders verschillen, waardoor de resultaten binnen hun respectievelijke experimentele settings moeten worden geïnterpreteerd.
Het doel van TDE-Net is het bieden van een modulair raamwerk voor EEG-naar-beeldreconstructie dat structurele en semantische EEG-representaties scheidt, deze afstemt op complementaire visuele latente ruimtes en deze voorspellingen integreert voor diffusiegebaseerde beeldreconstructie. Recente studies naar EEG-visuele decodering hebben transformer-gebaseerde EEG-gestuurde generatie geïntroduceerd in EEG-CLIP17, foreground-aware uitlijning met dynamische hersennetwerken in FSDBN18, cognitief-gestuurde adaptieve vervaging met informatiebeperkte uitlijning19, en multi-level bidirectioneel biomimetisch leren20. Verwante EEG-naar-beeld pipelines, waaronder Perceptogram en gestuurde diffusie op basis van EEG-embeddings, bieden aanvullende referenties voor latente voorspelling21,22. TDE-Net verschilt in de modelorganisatie: het scheidt expliciet een ruw EEG-anker, een monsterspecifieke functionele graafrepresentatie en een temporele semantische representatie, om vervolgens asymmetrische uitlijning met de VAE- en CLIP-ruimtes uit te voeren vóór de fusie. Deze organisatie maakt het mogelijk om de structurele en semantische bijdragen afzonderlijk te onderzoeken via latente-ruimte- en beeldniveau-analyses. In vergelijking met benaderingen voor EEG-naar-beeld met een enkele representatie of directe uitlijning, biedt dit modulaire ontwerp afzonderlijke structurele en semantische paden, behoudt het een lineaire EEG-referentie tijdens latente voorspelling en maakt het de onafhankelijke evaluatie van de bijdrage van elke representatie mogelijk via ablatie- en latente-ruimte-analyses.
TDE-Net is ontworpen voor experimenten met gepaarde EEG-responsen en visuele stimuli, voldoende trainingscondities en een kort poststimulus-venster waarin semantische reconstructie het hoofddoel is. De gefaseerde organisatie ondersteunt het afzonderlijk onderzoeken van feature-extractie, latente uitlijning, fusie en diffusie-decodering. Lineaire mappingen blijven geschikt voor zeer kleine datasets of instellingen waarbij minimale modelcomplexiteit prioriteit heeft, terwijl end-to-end neurale decoders mogelijk verkieslijk zijn wanneer grote taakspecifieke datasets en real-time implementatie beschikbaar zijn.
Het huidige protocol evalueert de voorgestelde configuratie in de THINGS-EEG2 rapid serial visual presentation (RSVP) setting. De belangrijkste bijdragen omvatten een tri-stream EEG-representatieschema bestaande uit een raw linear anchor, een sample-specifieke functionele grafiekstream en een multi-scale temporele semantische stream. Deze complementaire representaties worden gemapt naar VAE- en CLIP-latente ruimtes, en de overeenkomstige voorspellingen worden gecombineerd vóór diffusiereconstructie. Het raamwerk wordt geëvalueerd bij alle 10 THINGS-EEG2 proefpersonen met behulp van reconstructiematen op proefpersoonsniveau, ablatie- en temporele-vensteranalyses, en visualisaties op representatieniveau, waarbij ruimtelijke attention-maps worden geïnterpreteerd als scalp-kanaal (topografische) analyses.
Protocol
Het protocol bestaat uit zes opeenvolgende fasen: de voorbereiding van de EEG-trials en beeldlatents; de constructie van de graph structural stream; het trainen van de semantische EEG-encoder; het fitten van de CLIP/VAE-mappings; de fusie van de latente voorspellingen, gevolgd door beelddecodering; en de evaluatie van de resultaten op beeldniveau en representatieniveau (Figuur 1).
1. EEG-trials en beeldembeddings voorbereiden
- Documenteer de broncohort en het acquisitieprotocol.
OPMERKING: De broncohort bestond uit 10 gezonde volwassenen (gemiddelde leeftijd 28,5 jaar, SD 4,0; acht vrouwen en twee mannen) met een normaal of tot normaal gecorrigeerd gezichtsvermogen. De deelnemers gaven schriftelijke geïnformeerde toestemming, ontvingen een monetaire vergoeding en voltooiden het oorspronkelijke protocol met goedkeuring van de ethische commissie van de Department of Education and Psychology aan de Freie Universität Berlin, in overeenstemming met de Verklaring van Helsinki23.- Gebruik de publiek beschikbare THINGS-EEG2 dataset als bron voor secundaire analyse.
- Gebruik de bronpartitie van 1.654 trainingsconcepten en 200 niet-overlappende testconcepten afgeleid van THINGS, waarbij de proporties van 27 categorieën op hoger niveau gebalanceerd zijn tussen de partities. Selecteer tien afbeeldingen met een natuurlijke achtergrond voor elk trainingsconcept en één afbeelding voor elk testconcept, om 16.540 trainingscondities en 200 apart gehouden testcondities te verkrijgen.
OPMERKING: In de huidige studie werden voor de target-detectietaak aparte Buzz Lightyear-catch-afbeeldingen gebruikt die zijn uitgesloten van de huidige reconstructieanalyse23. - Volg de timing van het oorspronkelijke rapid serial visual presentation-protocol bij het interpreteren van de epochs.
OPMERKING: Elke sequentie begon met een blanco interval van 750 ms, gevolgd door 20 centraal gepresenteerde afbeeldingen. Elke afbeelding besloeg 7 graden visuele hoek, bleef 100 ms op het scherm staan en had een stimulus-onset asynchrony van 200 ms, wat overeenkomt met 5 afbeeldingen/s. Een tweede blanco interval van 750 ms ging vooraf aan een responsperiode van maximaal 2 s, waarin de deelnemers eerst knipperden en vervolgens rapporteerden of er een target-afbeelding was verschenen. Een centraal bull's-eye fixatie-target bleef gedurende de hele sequentie zichtbaar23. - Houd rekening met de oorspronkelijke opzet van de opnamesessies bij het organiseren van de dataset. Gebruik gegevens van de vier opnamesessies die door elke deelnemer zijn voltooid, waarbij elke sessie bestond uit vier testruns en 15 trainingsruns van ongeveer 5 min elk. Behoud vier herhalingen voor elke trainingsconditie en 80 herhalingen voor elke testconditie, wat overeenkomt met 82.160 geanalyseerde non-target-afbeeldingstrials per deelnemer23.
- Gebruik de EEG-gegevens die zijn verkregen met de oorspronkelijke THINGS-EEG2 opnameconfiguratie. Deze opnames werden gemaakt op 1.000 Hz met een 64-elektrode EASYCAP ingericht volgens het internationale 10-10 systeem en een BrainVision actiCHamp versterker, met Fz als online referentie en een online banddoorlaatfilter van 0,1–100 Hz.
- Gebruik de vrijgegeven gepreprocesste gegevens, die in epochs zijn verdeeld van -200 tot 800 ms relatief aan de onset van de afbeelding, baseline-gecorrigeerd met behulp van het prestimulus-interval, gedownsampled naar 100 Hz, beperkt tot 17 parieto-occipitale kanalen, ontdaan van target-trials en onderworpen aan multivariate ruisnormalisatie onafhankelijk binnen elke opnamesessie23.
- Bereid EEG-trial-tensors voor
- Laad de vrijgegeven gepreprocesste THINGS-EEG2 tensors voor alle 10 deelnemers. Selecteer uit elke bron-epoch het poststimulus-interval van 0–800 ms en de 17 parieto-occipitale kanalen, waarbij de bemonsteringsfrequentie van 100 Hz behouden blijft om 80 tijdspunten per trial te verkrijgen. Behoud de bronpartitie van 16.540 trainingsafbeeldingscondities en 200 apart gehouden testafbeeldingscondities voor elke deelnemer23 (Figuur 2).
- Behoud voor graph-stream pre-training de vier onafhankelijke trainingsherhalingen voor elke afbeeldingsconditie en sample twee herhalingen om een positief paar te vormen. Voor de raw- en semantic-streams worden de vier trainingsherhalingen gemiddeld en worden de 80 beschikbare testherhalingen per conditie gemiddeld.
- Gebruik de gepreprocesste THINGS-EEG2 tensors die zijn gegenereerd door de oorspronkelijke MVNN-pipeline; pas binnen elke geïmplementeerde feature-extractor de gedocumenteerde Z-scoring op bestandsniveau toe voordat de feature-berekening plaatsvindt.
OPMERKING: Dit asymmetrische gebruik van herhalingen is opzettelijk: herhaalde trials leveren positieve paren voor graph-stream contrastieve pre-training, terwijl de raw- en semantic-streams conditie-gemiddelden gebruiken voor gesuperviseerde mapping. Het resulterende ontwerp combineert invariantieleren op herhalingsniveau in de structurele stream met latente voorspelling op conditieniveau in de raw- en semantic-streams.
- Bereid gepaarde beeldlatents voor
- Gebruik de 1.024-dimensionale CLIP vision encoder en de VAE encoder geassocieerd met sd2-community/stable-diffusion-2-1-unclip om gepaarde beeldtargets te extraheren. Pas de grootte van VAE-ingangsafbeeldingen aan naar 768 x 768 pixels, sla de VAE-posterior-modus op als een 36.864-dimensionale vector (4 x 96 x 96) en behoud de volgorde van de afbeeldingscondities.
- Sla drie invoervormen op: tensors van herhaalde trials voor graph contrastive learning, gemiddelde EEG-tensors voor de raw- en semantic-streams, en gepaarde CLIP/VAE-beeldlatents voor gesuperviseerde mapping.
- Normaliseer en cache de inputs
- Cache de gepreprocesste EEG-tensors, geëxtraheerde graph- en semantic-features en gepaarde beeldlatents met een vaste conditievolgorde.
- Schat tijdens ridge mapping de standaardisatieparameters per feature in op basis van de trainingsinputs en pas deze parameters toe op de development- en testinputs.
2. De graafstructurele stroom construeren
- Construeer de graafstroom uit herhaalde trainingsessies en exporteer kenmerken op knooppuntniveau na contrastieve pre-training. Gebruik dezelfde regel voor graafconstructie voor de extractie van testkenmerken, zonder testafbeelding-latents te gebruiken tijdens de berekening van de kenmerken.
- Transformeer EEG-sessies naar graafinputs in het frequentiedomein
- Transformeer elke sessie met een fast Fourier transform (FFT) van 80 punten en behoud de eerste 40 bins van de niet-negatieve frequentie, over een bereik van 0 Hz–48,75 Hz bij een bemonsteringssnelheid van 100 Hz. Gebruik het log-amplitudespectrum als een 17 x 40 knooppunt-kenmerkenmatrix X. Bereken voor elk EEG-monster C_ij = |corr(X_i, X_j)| tussen elk paar van de 17 kanaal-kenmerkvectoren.
- Behoud in elke rij de diagonale zelfcorrelatie en de drie sterkste off-diagonale correlaties (k = 4 behouden vermeldingen inclusief zelf), en symmetriseer vervolgens de behouden matrix om de monsterspecifieke gewogen functionele redundantie A te definiëren. Pas symmetrische graadnormalisatie toe vóór de graafconvolutie.
- Gebruik deze constructie tijdens training en testen; fysieke coördinaten van elektroden worden niet gebruikt om een vaste graaf te definiëren.
OPMERKING: Het behouden van zelfconnectiviteit bewaart het signaal van elk knooppunt, terwijl het beperken van cross-kanaalverbindingen tot 3 per rij de graafdichtheid vóór symmetrisatie controleert. De representatie in het frequentiedomein biedt een compacte op amplitude gebaseerde beschrijving voor de graafconstructie, maar bewaart geen fase of alle fijnmazige fase-gekoppelde ERP-timing; deze temporele aspecten blijven beschikbaar in de ruwe anker- en semantische temporele stromen.
- Aggregeer elektrode-topologie met spectrale graafconvolutie
- Pas een vijflaags graph convolutional network (GCN)24 toe met 80 hidden units per laag, ReLU-activaties, 0,3 dropout, symmetrische graadnormalisatie en mean graph pooling.
- Gebruik een 80-dimensionale twee-laags projectiehead voor het contrastieve doel en exporteer de 17 x 80 representatie op knooppuntniveau voor structurele fusie. Pas spectrale graafconvolutie toe op de input-afhankelijke redundantiematrix; introduceer geen aparte dynamische convolutie-operator.
- Train de graafstroom met cross-trial contrastief leren
- Selecteer binnen de trainingspartitie willekeurig twee herhalingen van dezelfde afbeeldingconditie als een positief paar en behandel representaties van andere condities in de batch als negatieven. Optimaliseer het InfoNCE contrastieve doel25 met temperatuur τ = 0,5, batchgrootte 32, Adam met een leersnelheid van 5 x 10⁻⁴, 20 epochs, cosine annealing naar eta_min = 10–6 en random seed 42.
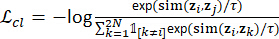 (1)
- Definieer cosinus-gelijkenis in het contrastieve doel en gebruik de indicatorfunctie om gepaarde herhalingen te identificeren. Houd de projectiedimensie op 80 en pas dezelfde temperatuur toe op beide richtingen van het contrastieve verlies.
- Selecteer binnen de trainingspartitie willekeurig twee herhalingen van dezelfde afbeeldingconditie als een positief paar en behandel representaties van andere condities in de batch als negatieven. Optimaliseer het InfoNCE contrastieve doel25 met temperatuur τ = 0,5, batchgrootte 32, Adam met een leersnelheid van 5 x 10⁻⁴, 20 epochs, cosine annealing naar eta_min = 10–6 en random seed 42.
- Exporteer graafkenmerken op knooppuntniveau voor vroege fusie
- Bevries de graafencoder na de pre-training en exporteer de 17-kanaals knooppuntkenmerken met 80 dimensies per knooppunt. Concateneer deze kenmerken met de gemiddelde ruwe EEG langs de kenmerkdimensie om de ruwe-plus-graaf structurele input voor VAE-mapping te verkrijgen.
- Sla de resulterende ruwe-plus-graaf kenmerktensor op en gebruik deze uitsluitend als de structurele input voor de VAE-regressietak.
3. De semantische EEG-encoder trainen
- Train de semantische EEG-encoder op de gemiddelde 17-kanaals, 80-punts EEG-tensoren.
- Optimaliseer het cosinus-embeddingverlies met AdamW (leersnelheid 5 x 10⁻⁴; weight decay 0,01), batchgrootte 64, 50 epochs, cosinus-annealing tot eta_min = 10–6, random seed 42, en een 1.024-dimensionale output.
- Pas datagestuurde adaptieve ruimtelijke filtering toe
- Pas een leerbare tensorproduct-kanaalwegingsoperatie toe op de input-EEG-tensor en breid de representatie uit tot een diepte van 9. Behandel deze operatie als een datagestuurde kanaalwegingslaag in plaats van een implementatie van het klassieke Common Spatial Pattern (CSP) ruimtelijke filter26.
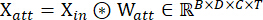 (2)
- Gebruik de geleerde kanaalwegingsoperatie om negen feature-maps te produceren en voer deze vervolgens door naar het multi-schaal temporele convolutieblok.
- Pas een leerbare tensorproduct-kanaalwegingsoperatie toe op de input-EEG-tensor en breid de representatie uit tot een diepte van 9. Behandel deze operatie als een datagestuurde kanaalwegingslaag in plaats van een implementatie van het klassieke Common Spatial Pattern (CSP) ruimtelijke filter26.
- Modelleer temporele receptieve velden op meerdere schalen
- Pas drie parallelle temporele convoluties toe met kernelgroottes van 5, 15 en 31 samples, gebruikmakend van same-length padding. Concateneer de drie outputs om 24 temporele feature-kanalen te verkrijgen en pas batch-normalisatie en GELU-activatie toe.
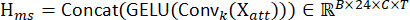 (3)
OPMERKING: De convoluties leveren multi-schaal temporele receptieve velden binnen het bredere kader van temporele convolutionele modellering27. - Gebruik de drie kernelgroottes als multi-schaal temporele filters; interpreteer hun output als geleerde signaalrepresentaties in plaats van als directe toewijzingen aan specifieke ERP-componenten.
- Pas drie parallelle temporele convoluties toe met kernelgroottes van 5, 15 en 31 samples, gebruikmakend van same-length padding. Concateneer de drie outputs om 24 temporele feature-kanalen te verkrijgen en pas batch-normalisatie en GELU-activatie toe.
- Recalibreer taakrelevante feature-kanalen
- Pas diepte-attentie toe met adaptieve gemiddelde pooling op de temporele dimensie en een kernel-7 convolutie gevolgd door Softmax-normalisatie, consistent met principes van kanaalrecalibratie28. Vermenigvuldig de resulterende attentiegewichten elementgewijs met de multi-schaal feature-tensor.
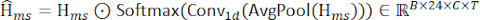 (4)
- Gebruik de attentie-output als input voor het ruimtelijke convolutieblok en interpreteer de geleerde gewichten niet als causale neurale lokalisatie.
- Pas diepte-attentie toe met adaptieve gemiddelde pooling op de temporele dimensie en een kernel-7 convolutie gevolgd door Softmax-normalisatie, consistent met principes van kanaalrecalibratie28. Vermenigvuldig de resulterende attentiegewichten elementgewijs met de multi-schaal feature-tensor.
- Exporteer de globale semantische EEG-feature
- Pas een 1 x 1 convolutie toe, gevolgd door een depthwise convolutie over de 17 elektrodenkanalen, batch-normalisatie, GELU-activatie, gemiddelde pooling met factor 2 en dropout p = 0,5. Flatten het resultaat en projecteer dit naar een 1.024-dimensionale semantische feature-vector.
- Sla voor elk gemiddeld EEG-monster één 1.024-dimensionale semantische feature-vector op.
4. EEG-kenmerken mappen naar CLIP- en VAE-latente ruimten
- Koppel elke EEG-feature-tensor aan de image latent met dezelfde conditie-index. Pas afzonderlijke mappings toe voor CLIP- en VAE-targets, en zorg dat alle image-condities in de trainingspartitie volledig gescheiden zijn van die in de uitgespaarde testpartitie.
- Pas ridge-regressie29 toe met een intercept en een maximum van 50.000 iteraties. Gebruik λCLIP = 1.000 voor de raw-to-CLIP en semantic-to-CLIP mappings, λVAE = 0 voor de raw-to-VAE anchor, en λVAE, struct = 1.000 voor de structural-stream-to-VAE mapping. Standaardiseer de mapping-inputs met statistieken van de fit-partitie.
OPMERKING: De structural stream is de concatenatie van ruwe EEG en graaf-features; de semantic stream bevat de output van de semantische encoder zonder concatenatie van ruwe features. - Map structural features naar de VAE latent space
- Pas de structural-stream-to-VAE ridge mapping toe met λVAE,struct = 1.000 en voorspel de 36.864-dimensionale VAE latent. Deze branch ontvangt de geconcateneerde ruwe EEG- en graafrepresentaties; dit is de enige niet-lineaire branch die expliciet ruwe features concateneert.
- Map semantic features naar de CLIP latent space
- Pas de semantic-stream-to-CLIP ridge mapping toe met λCLIP = 1.000 en voorspel de 1.024-dimensionale CLIP-representatie. De semantische input wordt niet geconcatenereerd met ruwe EEG.
OPMERKING: In dit artikel staat λ voor ridge-regularisatie en α voor een latent-fusion gewicht. - Beoordeel de latent-space uitlijning met de sample-wise Pearson-correlatiecoëfficiënt (PCC). Gebruik ontwikkelcondities voor de selectie van het fusion-gewicht en beoordeel de 200 uitgespaarde testcondities pas nadat de mappings en fusion-gewichten zijn vastgelegd.
- Pas de semantic-stream-to-CLIP ridge mapping toe met λCLIP = 1.000 en voorspel de 1.024-dimensionale CLIP-representatie. De semantische input wordt niet geconcatenereerd met ruwe EEG.
5. Voeg latente voorspellingen samen en voer diffusiereconstructie uit
- Selecteer αVAE en αCLIP met behulp van een split voor ontwikkeling op conditieniveau, afgeleid van uitsluitend de 16.540 trainingscondities. Gebruik met random seed 42 dezelfde 90% fit-indices en 10% ontwikkelingsindices voor alle 10 subjecten; de 200 gereserveerde testcondities blijven buiten deze procedure.
OPMERKING: De ridge-penalties en de coëfficiënt voor structurele behoud waren vastgesteld als configuratiewaarden vóór de uiteindelijke evaluatie van de gereserveerde set en werden niet afgestemd op de 200 testcondities. - Fit voor elk subject en elke kandidaat α in {0,00, 0,05, ..., 1,00} de target-supervised encoder en ridge-mappings op de fit-subset en bereken de gemiddelde sample-gewijze latente PCC op de ontwikkelingssubset.
- Bereken het gemiddelde van de PCC-waarden op subjectniveau met een gelijk gewicht over de 10 subjecten, en selecteer de gewichten voor de CLIP- en VAE-ruimte onafhankelijk op basis van het maximale cross-subject gemiddelde. Bevries beide waarden voordat de uiteindelijke trainingsmodellen opnieuw worden gefit en de gereserveerde testcondities worden geëvalueerd.
OPMERKING: Deze procedure selecteerde αCLIP = 0,55 en αVAE = 0,65. - Definieer voor de VAE-ruimte de gefuseerde predictie als de gewogen som van de raw-to-VAE-anchor en de structural-stream VAE-predictie:
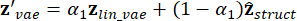 (5)
- Stel αVAE = 0,65 in, zodat de raw-to-VAE-anchor voor 0,65 bijdraagt en de structural-stream-predictie voor 0,35. Houd deze waarde vast voor elk subject en elke testconditie.
- Definieer voor de CLIP-ruimte de gefuseerde predictie als de gewogen som van de raw-to-CLIP-anchor en de semantic-stream CLIP-predictie:
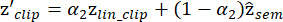 (6)
- Stel αCLIP = 0,55 in, zodat de raw-to-CLIP-anchor voor 0,55 bijdraagt en de semantic-stream-predictie voor 0,45. Houd deze waarde vast voor elk subject en elke testconditie.
OPMERKING: Interpreteer de fusie-operatie als een vaste gewogen ensemble van latente predicties in de algemene zin van ensemble-combinatie30. Beschrijf dit niet als een gegarandeerde vermindering van overfitting of als een uniform optimale oplossing over alle metrieken. - Laad de bevroren Stable UnCLIP image-to-image pipeline van sd2-community/stable-diffusion-2-1-unclip met fp16-variatiegewichten. Gebruik de gefuseerde CLIP-embedding als de semantische conditie en de gefuseerde VAE-latent als de structurele initialisatie.
OPMERKING: De decoder volgt de principes van denoising diffusion en classifier-free guidance31,32. - Pas ruisige structurele initialisatie toe op de diffusie-latents. Reshape elke 36.864-dimensionale VAE-predictie naar 4 x 96 x 96, volgens de variational autoencoder latent-formulering33, en voeg Gaussiaanse ruis toe nadat de structurele latent is vermenigvuldigd met de structurele schaal gamma = 0,02. Gebruik diffusie-trainingstappen T_diff = 1.000 en een vaste diffusie-seed van 0 voor de gerapporteerde reconstructieprocedure.
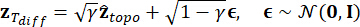 (7)
- Stel de coëfficiënt voor structureel behoud gamma in op 0,02 bij de ruisige initialisatie en houd deze waarde vast voor alle testcondities. Geef de resulterende latent door aan de decoder zonder gebruik te maken van ground-truth beeldinformatie.
- Pas cross-attention guidance toe en decodeer de beeldlatent. Concateneer de gefuseerde 1.024-dimensionale CLIP-vector met de 1.024-dimensionale conditioneringsextensie die door de pipeline wordt gebruikt, voeg een nul-negatief-conditioneringsvector toe voor classifier-free guidance (CFG), en decodeer met een guidance scale van 7,5. Gebruik de pipeline-standaard van 20 denoising-stappen en sla één PNG-afbeelding per testconditie op.
- Sla de gereconstrueerde afbeelding op met de oorspronkelijke testconditie-index en behoud dezelfde index voor alle daaropvolgende metriekberekeningen.
OPMERKING: Tabel 1 vat de datapartitionering, preprocessing, graafconstructie, modeltraining, latente mapping, fusie en decoderingsinstellingen samen die zijn gebruikt in de gerapporteerde workflow. Het bijbehorende werkblad biedt dezelfde parametersamenvatting in een machineleesbaar formaat.
6. Evalueer reconstructie en uitlijning op representatieniveau
- Bereken de getrouwheid op laag niveau met pixelcorrelatie (PixCorr) en structurele gelijkenis (SSIM). Bereken de paarsgewijze identificatienauwkeurigheden voor AlexNet Laag 2, AlexNet Laag 5, Inception-v3 en OpenAI CLIP ViT-L/14; bereken de correlatieafstanden voor EfficientNet (EffNet) en SwAV, waarbij lagere waarden duiden op nauwer bij elkaar liggende kenmerkrepresentaties.
- Stel voor de CLIP-analyse de correlatiematrix op tussen kenmerken geëxtraheerd uit 200 gereconstrueerde beelden en de corresponderende 200 ground-truth beelden. Vergelijk voor elke reconstructie de correlatie van het correcte beeld met de correlaties met de overige 199 beelden en bereken het gemiddelde van de resulterende 200 x 199 binaire vergelijkingen om de paarsgewijze identificatienauwkeurigheid van CLIP te verkrijgen.
- Pas voor uitbreidende vensters die eindigen bij 8, 16, ..., 80 tijdspunten raw EEG ridge mappings toe en bereken de gemiddelde steekproefgewijze PCC tussen de voorspelde en ground-truth CLIP- en VAE-latents over de 200 sub-01 testcondities. Gebruik de CLIP- en VAE-voorspellingen van de volledige venster-semantische stroom als gestreepte referentieniveaus.
- Construeer representatieve gelijkenismatrices (RSMs) op basis van L2-genormaliseerde CLIP-kenmerken met behulp van cosinusgelijkenis. Orden beide matrices via Ward hiërarchische clustering van ground-truth CLIP-embeddings met behulp van de Euclidische afstand.
- Leid voor de tweedimensionale visualisatie vijf k-means clusters af uit ground-truth embeddings en pas één gezamenlijke PCA-50 plus t-distributed stochastic neighbor embedding (t-SNE) projectie toe op ground-truth en voorspelde kenmerken; gebruik t-SNE uitsluitend voor kwalitatieve visualisatie.
- Visualiseer gewitende EEG-patronen en modelgewichten van hoofdhuidkanalen met gelabelde kanalen, expliciete kleurschalen en reproduceerbare ordeningsregels. Interpreteer deze plots als aanvullende analyses van gemeten hoofdhuidsignalen en modelparameters, en niet als bewijs voor corticale bronlokalisatie, anatomische activatie of causaliteit.
Resultaten
TDE-Net werd geëvalueerd vanuit zes complementaire perspectieven: reconstructieprestaties, representatieve visuele resultaten, componentbijdrage, temporele afhankelijkheid, semantische representatiestructuur en scalp-kanaalattenie. Getrouwheid op laag niveau werd beoordeeld met PixCorr en SSIM, uitlijning in de kenmerkruimte met AlexNet-, Inception-v3-, CLIP-, EffNet- en SwAV-maten, en prestaties op subjectniveau met resultaten van alle 10 THINGS-EEG2 subjecten. Tenzij anders vermeld, identificeert elke kwalitatieve figuur het overeenkomstige subject en de subset van de testconditie.
Reconstructieprestaties en representatieve resultaten
Als intern referentiemodel hebben we daarnaast een lichtgewicht convolutionele-attention EEG-encoder-baseline geïmplementeerd. Dit model extraheert een enkele 1024-dimensionale EEG-representatie uit elke trial en koppelt deze onafhankelijk aan de CLIP- en VAE-latente ruimtes, waarbij hetzelfde ridge-regressie- en diffusie-decodingsprotocol wordt gebruikt als bij de voorgestelde methode. In de volgende secties wordt dit model aangeduid als Baseline. De encoder is de LMDA-stijl convolutionele-attention semantische referentie die in de lokale implementatie is gebruikt, met 373.950 trainbare parameters en een 1.024-dimensionale output.
Tabel 2 vergelijkt TDE-Net met de interne convolutionele-attentie baseline en representatieve EEG-gebaseerde beeldreconstructiemethoden op basis van de gerapporteerde metrieken. Voor een consistente evaluatie werden de methoden geïmplementeerd binnen een uniform experimenteel kader met gebruik van dezelfde THINGS-EEG2 partitie, 17-kanaals input, preprocessing, uitgesloten testcondities en metriekdefinities, terwijl hun methodespecifieke architecturen behouden bleven. In het overzicht van de tien proefpersonen behaalde TDE-Net gemiddelde ± SD-waarden van 0,2531 ± 0,0138 voor PixCorr, 0,3388 ± 0,0025 voor SSIM, 0,8777 ± 0,0115 voor AlexNet Layer 2, 0,9153 ± 0,0116 voor AlexNet Layer 5, 0,7606 ± 0,0213 voor Inception-v3, 0,8135 ± 0,0074 voor CLIP paarwijze identificatienauwkeurigheid, 0,8285 ± 0,0122 voor EffNet distance en 0,5085 ± 0,0101 voor SwAV distance. Het overzicht op proefpersoonniveau vult de kwalitatieve voorbeelden van individuele proefpersonen aan.
De CLIP-waarde duidt op de nauwkeurigheid van paarsgewijze identificatie in plaats van de cosinus-overeenkomst of een algemene CLIP-feature-score. Omdat de semantische stroom is getraind op een CLIP-ruimte-doel, weerspiegelt deze maatstaf zowel de semantische reconstructie als de uitlijning met één tak-doel. Deze wordt daarom samen met PixCorr, SSIM, AlexNet, Inception-v3, EffNet en SwAV beschouwd, die complementaire aspecten van lage-niveau getrouwheid en overeenstemming in de feature-ruimte karakteriseren.
Om de prestaties op proefpersoonsniveau te karakteriseren, hebben we de volledige TDE-Net testprocedure toegepast op sub-01 tot en met sub-10, waarbij voor elke proefpersoon dezelfde 200 apart gehouden beeldcondities zijn gebruikt. Tabel 3 vermeldt alle acht evaluatiematen voor elke proefpersoon, samen met het gemiddelde over alle proefpersonen en de standaarddeviatie (SD) van de steekproef. De gemiddelde CLIP-pairwise identificatienauwkeurigheid was 0,8135 (SD, 0,0074). De gemiddelde PixCorr en SSIM waren respectievelijk 0,2531 en 0,3388. De nauwkeurigheden van AlexNet Laag 2 en Laag 5 waren gemiddeld 0,8777 en 0,9153, en de Inception-v3 nauwkeurigheid was gemiddeld 0,7606. De EffNet- en SwAV-afstanden, waarbij een lagere waarde beter is, waren gemiddeld respectievelijk 0,8285 en 0,5085. De beperkte spreiding op proefpersoonsniveau over deze maten duidt op een vergelijkbaar kwantitatief reconstructiegedrag tussen de 10 THINGS-EEG2 proefpersonen.
Figuur 3 presenteert reconstructies voor dezelfde zeven uitgesloten conditie-indexen (1, 32, 62, 86, 87, 108 en 175; nul-gebaseerde bestandsnummering) over alle 10 proefpersonen. De bovenste rij toont de ground-truth stimuli, en de daaropvolgende rijen tonen de overeenkomstige reconstructies voor sub-01 tot en met sub-10. De reconstructies behouden gedeelde semantische categorieën en kenmerkende visuele attributen van de stimuli, terwijl de fijnmazige objectidentiteit, vorm en lokale textuur per proefpersoon variëren. Deze indeling vormt een kwalitatieve tegenhanger van de cross-subject resultaten die zijn samengevat in Tabel 3.
Figuur 4 presenteert kwalitatieve reconstructies voor zes gespecificeerde sub-01 testcondities. De rijen tonen de ground-truth stimulus, een Perceptogram-comparator gegenereerd door onze lokale implementatie21, en de TDE-Net-reconstructie. De voorbeelden benadrukken het behoud van objectcategorie, vorm, kleur en achtergrondeigenschappen, terwijl fijnmazige identiteits- en achtergronddetails variëren tussen de methoden.
Aanvullende figuur 1 presenteert de beste, mediane en slechtste reconstructiegroepen, geselecteerd uit de 200 sub-01 testcondities in THINGS-EEG223. Condities zijn gerangschikt op basis van de cosinus-overeenkomst tussen de bevroren gefuseerde EEG-voorspelde CLIP-embedding en de overeenkomstige ground-truth image CLIP-embedding. De getoonde groepen illustreren het bereik van de semantische overeenkomst dat voor dit subject is waargenomen.
Bijdrage van componenten en fusiegedrag
Tabel 4 presenteert een stapsgewijze ablatie van de structurele en semantische stromen op basis van de gemiddelde waarden over proefpersonen die zijn verkregen onder dezelfde evaluatieprocedure. De Linear Anchor voorspelt de CLIP- en VAE-latents direct vanuit gepreprocesseerde EEG-data met behulp van ridge-regressie en dient als het gecontroleerde startpunt voor de ablatiestudie. Dit volgt het algemene lineaire latent-mapping-principe dat is gebruikt in eerdere EEG-naar-afbeelding-studies, waaronder Perceptogram21, terwijl de preprocessing-, regularisatie-, decodering- en evaluatie-instellingen van de huidige pijplijn worden gehanteerd. Dit ontwerp maakt het mogelijk om de structurele stroom, de semantische stroom en de dual-space-fusie te onderzoeken ten opzichte van een gemeenschappelijke lineaire referentie.
Beginnend bij de Lineaire Anker, zorgde de toevoeging van de structurele stroom voor een stijging van de SSIM van 0,331 naar 0,339 en van de nauwkeurigheid van AlexNet Laag 5 van 0,913 naar 0,932, hoewel de nauwkeurigheid van AlexNet Laag 2 licht daalde van 0,889 naar 0,886. De toevoeging van de semantische stroom in plaats daarvan produceerde de hoogste PixCorr (0,237), terwijl een hoge nauwkeurigheid voor AlexNet Laag 2 (0,888) werd behouden en de EffNet- en SwAV-afstanden werden verlaagd tot respectievelijk 0,865 en 0,531. Wanneer beide stromen werden geïncorporeerd via dual-space fusie, behaalde TDE-Net de hoogste Inception-v3 (0,761) en CLIP paarsgewijze identificatienauwkeurigheden (0,814), samen met de laagste EffNet (0,829) en SwAV (0,509) afstanden. De nauwkeurigheid van AlexNet Laag 2 (0,878) bleef lager dan die van de Lineaire Anker, en de SSIM (0,339) bleef iets lager dan die van de configuratie met de structurele stroom. Over het algemeen tonen de cross-subject ablatieresultaten aan dat de structurele en semantische stromen verschillende aspecten van de reconstructie beïnvloeden, terwijl hun fusie primair de semantische identificatie en de consistentie van de diepe kenmerkruimte versterkt.
Figuur 5 toont de gevoeligheid van de ontwikkelingsset voor de twee fusiegewichten over het bereik α = 0.00–1.00 in stappen van 0.05. De CLIP-ruimtecurve bereikt zijn maximum bij αCLIP = 0.55, terwijl de VAE-ruimtecurve zijn maximum bereikt bij αVAE = 0.65. Vergelijkbare PCC-waarden werden waargenomen voor naburige kandidaten, terwijl de maxima bij verschillende gewichten optraden voor de twee latente ruimtes.
Temporele bijdrage van EEG-signalen
Figuur 6 toont de gemiddelde latente PCC per conditie voor ruwe EEG-vensters die eindigen bij 8, 16, ..., 80 tijdspunten in sub-01 (n = 200 testcondities). De CLIP- en VAE-curven stijgen naarmate het analysevenster wordt uitgebreid en bereiken een plateau bij latere vensters. Gestreepte lijnen geven de overeenkomstige referentiewaarden aan voor het volledige venster van uitsluitend de semantische stroom. Deze analyse karakteriseert de afhankelijkheid van het tijdsvenster onder het gerapporteerde mapping-protocol.
Semantische uitlijning en analyse op representatieniveau
Figuur 7 vergelijkt de sample-gewijze CLIP-latente PCC voor het ruwe CLIP-anker en de bevroren gefuseerde CLIP-voorspelling over 200 sub-01 testcondities. De Gaussische kernel-densiteitsschattingen maken gebruik van de bandbreedte van Scott, en de verticale stippellijnen geven de steekproefgemiddelden aan. De gefuseerde distributie vertoont een gemiddelde toename in PCC van ongeveer 0,013 ten opzichte van het ruwe anker. De CLIP-paarsgewijze identificatienauwkeurigheid op beeldniveau wordt afzonderlijk gerapporteerd in Tabel 2.
Figuur 8 vergelijkt cosinus-similariteit RSM's voor ground-truth afbeelding-CLIP-embeddings en gefuseerde EEG-voorspelde CLIP-embeddings. Beide matrices delen een gemeenschappelijk databereik en een Ward-ordening afgeleid van Euclidische afstanden tussen de ground-truth CLIP-embeddings. Het residu-paneel toont de voorspelde RSM minus de ground-truth RSM op een symmetrische schaal gedefinieerd door het maximale absolute residu, wat een visualisatie van de representatieve overeenstemming biedt.
Aanvullende Figuur 2 toont een gezamenlijke projectie van 200 ground-truth en 200 EEG-voorspelde CLIP-embeddings. Vijf labels zijn verkregen via k-means clustering van L2-genormaliseerde ground-truth embeddings (n_init = 50; seed = 7). Geconcateneerde ground-truth en voorspelde kenmerken zijn via PCA gereduceerd tot 50 dimensies en gezamenlijk geprojecteerd met t-SNE met een perplexiteit van 28, Euclidische afstand en seed 12. De projectie biedt een kwalitatief overzicht van de organisatie van de twee sets representaties.
EEG-patroon en interpreteerbaarheid van ruimtelijke aandacht
Aanvullende Figuur 3 groepeert testconcepten in Dieren, Voedings-/plantgerelateerde concepten en Andere objecten met behulp van een expliciete concept-labelkoppeling. Binnen elke groep zijn de rijen geordend via Ward-clustering van gewitende ground-truth CLIP-embeddings en uniform gesampled tot maximaal 30 concepten voor de leesbaarheid. De heatmap toont afgeknotte, genormaliseerde gewitende EEG-amplitudes op een schaal van -1 tot 1; CLIP-embeddings worden uitsluitend gebruikt om de volgorde binnen de groep te bepalen.
Aanvullende figuur 4 toont een standaard 10–20 hoofdhuidtopografie van genormaliseerde absolute gewichten van de semantische stroomkanalen over de geselecteerde 17 elektroden. De kaart vat de relatieve modelweging over de gemeten hoofdhuidkanalen samen en wordt geïnterpreteerd als een visualisatie van de modelweging op kanaalniveau.
Deze studie is een secundaire computationele analyse van de gede-identificeerde THINGS-EEG2 dataset. De bron-EEG-opnames, gepreprocessede EEG-arrays, stimulus-metadata en afbeeldingen, en rusttoestand-bestanden zijn beschikbaar via het THINGS-EEG2 project op https://osf.io/3jk45/ en Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). De originele software voor acquisitie en preprocessing is beschikbaar op https://github.com/gifale95/eeg_encoding. Toegang tot en hergebruik van de EEG-gegevens en stimulus-afbeeldingen worden beheerst door de licenties en attributievereisten die zijn gespecificeerd door de bronrepositories.
De implementatie van TDE-Net, inclusief scripts voor uitlijning, fusie, reconstructie, evaluatie en visualisatie, is beschikbaar op https://github.com/Yuan-ui198/TDE-Net. De versie die overeenkomt met dit manuscript is vastgelegd in commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Voor de huidige studie zijn geen nieuwe identificeerbare deelnemersgegevens verzameld.
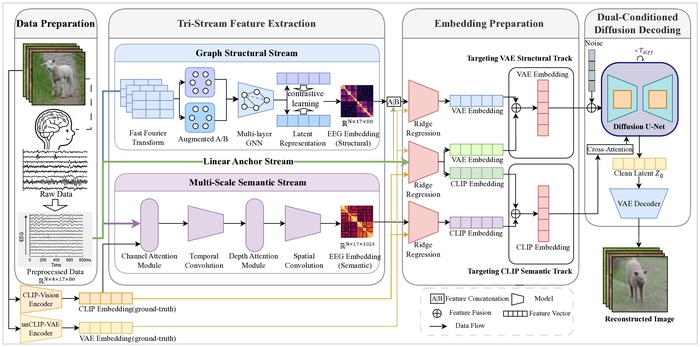
Figuur 1: Schema van TDE-Net. Het diagram toont het ruwe EEG-anker, de monster-specifieke functionele graafstroom, de semantische temporele stroom, dual-space mapping naar VAE en CLIP, gewogen fusie en dual-conditioned Stable UnCLIP-decodering. Tensor-dimensies zijn aangegeven waar van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
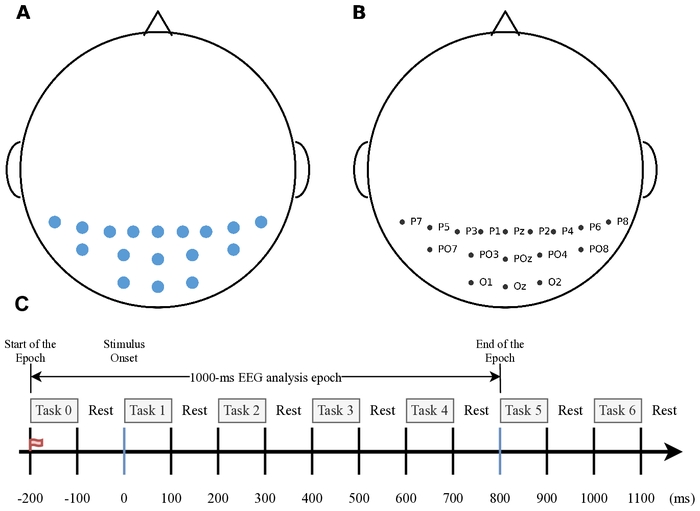
Figuur 2: Selectie van EEG-elektroden en experimentele timing. (A) Ruimtelijke distributie van de geselecteerde 17 parieto-occipitale elektroden uit de oorspronkelijke 64-kanaals acquisitie. (B) Elektrode-labels: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 en P2. (C) Schema van de RSVP-timing en de definitie van de EEG-epoch. In het schema duidt “Task” een interval van beeldpresentatie aan, terwijl “Rest” het interval tussen beelden aanduidt; de genummerde Task-blokken geven opeenvolgende presentatie-intervallen aan in plaats van verschillende experimentele condities. Elk beeld werd gedurende 100 ms gepresenteerd met een stimulus-onset asynchronie van 200 ms. De EEG-epoch liep van -200 tot 800 ms ten opzichte van het begin van de stimulus, wat overeenkomt met een EEG-analyse-epoch van 1000 ms. Klik hier om een grotere versie van deze figuur te bekijken.
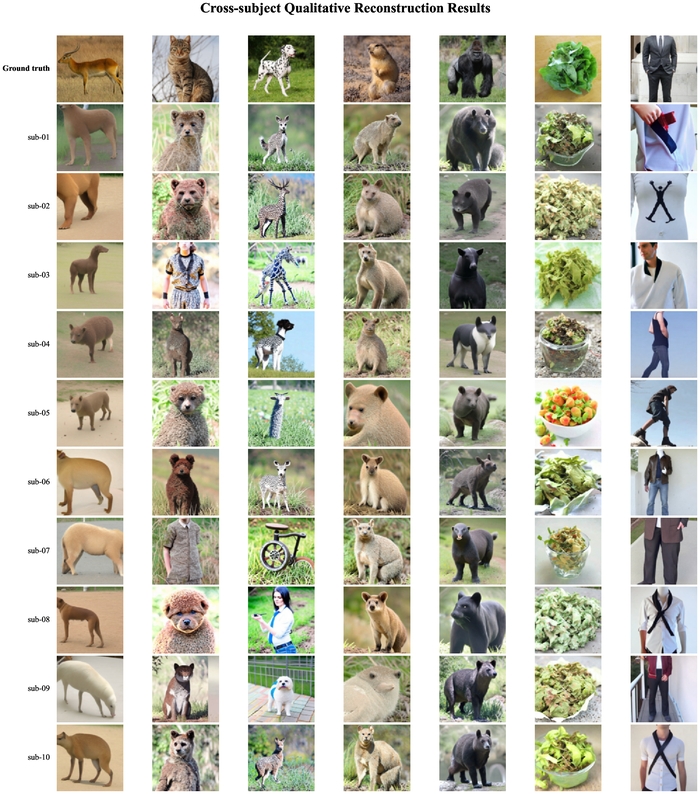
Figuur 3: Kwalitatieve reconstructieresultaten over verschillende proefpersonen voor zeven uitgesloten beeldcondities. Dezelfde nul-gebaseerde conditie-indices (1, 32, 62, 86, 87, 108 en 175) worden gebruikt voor sub-01 tot en met sub-10. De bovenste rij toont de overeenkomstige ground-truth beeldmonsters uit de THINGS-EEG2 testset, waarvan de beelden zijn afkomstig uit de THINGS-beelddatabase34, terwijl de overige rijen de TDE-Net reconstructies voor elke proefpersoon tonen. De figuur illustreert gemeenschappelijke semantische inhoud en variatie op het niveau van de proefpersoon; kwantitatieve resultaten over verschillende proefpersonen worden gerapporteerd in Tabel 3. Klik hier om een grotere versie van deze figuur te bekijken.
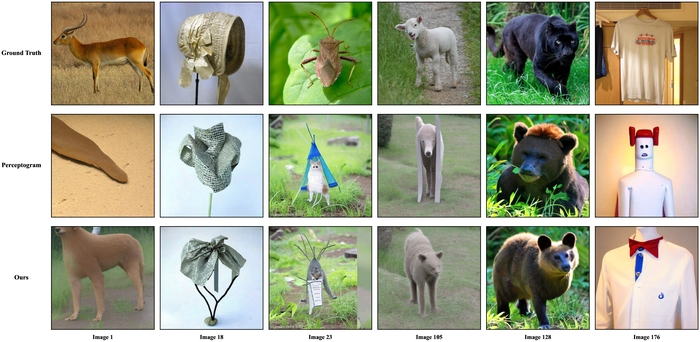
Figuur 4: Kwalitatieve vergelijking van reconstructies voor zes specifieke sub-01 testcondities. De rijen tonen de ground-truth stimulus, een vergelijkingsreconstructie gegenereerd door de lokale implementatie en de TDE-Net reconstructie; de kolommen komen overeen met individuele conditie-indexen. Ground-truth beeldvoorbeelden zijn getrokken uit de THINGS-beeldbank34. Klik hier om een grotere versie van deze figuur te bekijken.
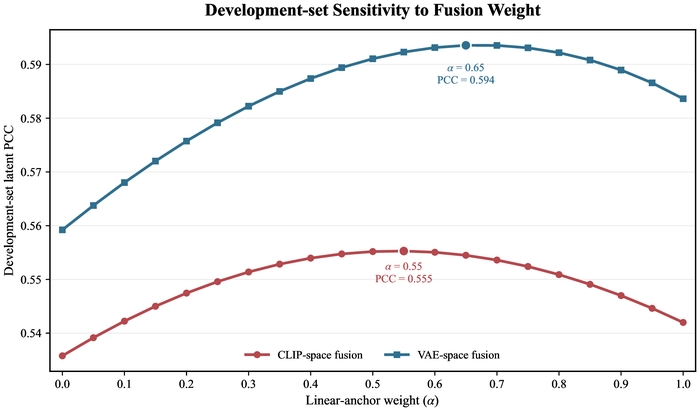
Figuur 5: Gevoeligheid van de latent-fusiegewichten voor de ontwikkelingsset. De horizontale as geeft het lineaire ankergewicht α aan, het complementaire streamgewicht is 1 - α, en de verticale as geeft de latente PCC van de ontwikkelingsset aan. Kandidaatwaarden variëren van 0,00 tot 1,00 in stappen van 0,05. CLIP- en VAE-ruimtewichten worden onafhankelijk geselecteerd op basis van de maximale gelijk gewogen gemiddelde PCC op subjectniveau over 10 subjecten, wat resulteert in αCLIP = 0,55 en αVAE = 0,65. PCC, Pearson correlatiecoëfficiënt. Klik hier om een grotere versie van deze figuur te bekijken.
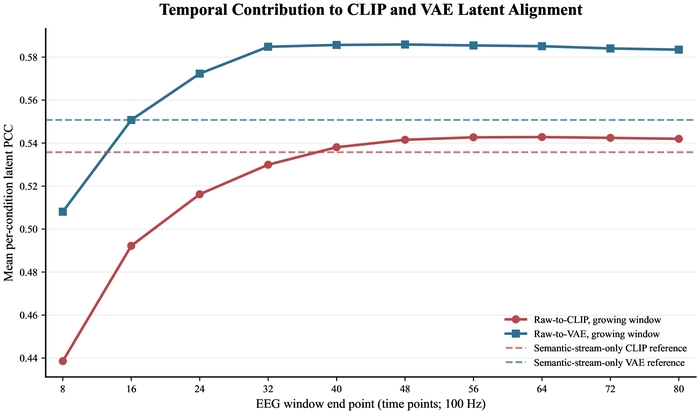
Figuur 6: Temporele-vensteranalyse van latente uitlijning in sub-01 (n = 200 uitgesloten condities). Doorlopende lijnen tonen de gemiddelde sample-gewijze PCC voor raw-to-CLIP en raw-to-VAE ridge-voorspellingen terwijl het eindpunt van het EEG-venster uitbreidt van 8 naar 80 tijdspunten bij 100 Hz. Gestreepte lijnen geven de referentiewaarden aan voor CLIP en VAE op basis van alleen de semantische stroom voor het volledige venster. PCC, Pearson-correlatiecoëfficiënt. Klik hier om een grotere versie van deze figuur te bekijken.
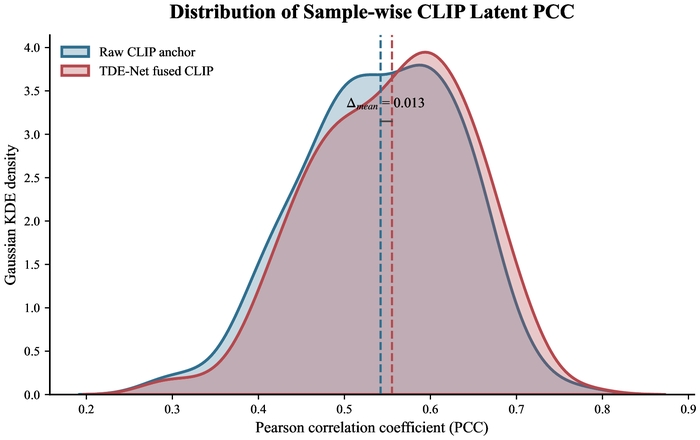
Figuur 7: Distributie van de CLIP latent alignment per monster in sub-01 (n = 200 held-out condities). De curven zijn Gaussian kernel density estimates met Scott's bandbreedte voor de ruwe CLIP-anker en de bevroren TDE-Net-fused CLIP-voorspelling. Verticale stippellijnen geven de monstergemiddelden aan, en de annotatie geeft het verschil daartussen weer. PCC, Pearson-correlatiecoëfficiënt; KDE, kernel density estimate. Klik hier om een grotere versie van deze figuur te bekijken.
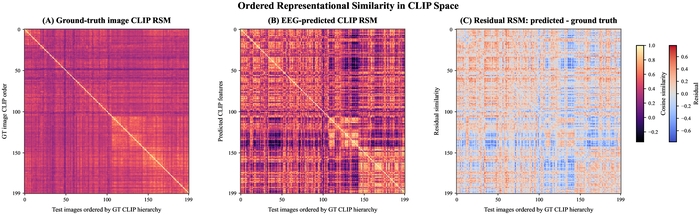
Figuur 8: Geordende representatieve gelijkenis in de CLIP-ruimte voor sub-01 (n = 200 uitgesloten condities). (A) Cosinus-gelijkenis RSM van L2-genormaliseerde ground-truth beeld-CLIP-embeddings. (B) Cosinus-gelijkenis RSM van gefuseerde EEG-voorspelde CLIP-embeddings, weergegeven met dezelfde ordening en kleurenschaal als paneel A. (C) Residuele RSM, berekend als voorspeld minus ground-truth, weergegeven op een symmetrische schaal gedefinieerd door het maximale absolute residu. De ordening is verkregen via de Euclidische afstand en Ward linkage van ground-truth CLIP-embeddings. RSM, representatieve gelijkenismatrix. Klik hier om een grotere versie van deze figuur te bekijken.
| Component | Parameter | Omgeving |
| Gegevens en voorbewerking | Datasetpartitionering | 16.540 trainings- en 200 aparte testcondities; 90%/10% verdeling voor fitting/ontwikkeling (seed 42) |
| EEG-input | 17 parieto-occipitale kanalen; 0-800 ms; 100 Hz; 80 tijdspunten | |
| Spectrale representatie | 80-punts FFT; 40 bins met positieve frequenties; 0-50 Hz log-amplitudespectrum | |
| Structurele stroom | Graafconstructie | Monster-specifieke absolute Pearson-correlatie; gewogen top-k = 4 buren per knoop; symmetrisering en self-loops |
| GCN-architectuur | 5 lagen; 80 hidden units; ReLU; dropout 0,3; symmetrische graadnormalisatie; mean pooling | |
| Contrastieve doelstelling | 80-dimensionale projectiekop; InfoNCE-temperatuur τ = 0.5 | |
| Training | Adam; leerpercentage 5 × 10⁻⁴; batchgrootte 32; 20 epochs; cosine annealing; minimale leerfrequentie 10⁻⁶; seed 42 | |
| Semantische stroom | Architectuur | Temporele kernels 5/15/31; diepte 9; 24 feature-kanalen; dropout 0,5; outputdimensie 1.024 |
| Training | AdamW; leerpercentage 5 × 10⁻⁴; weight decay 0,01; batchgrootte 64; 50 epochs; cosine annealing; minimale leersnelheid 10⁻⁶; seed 42 | |
| Latente mapping | Ridge-regressie | Intercept gefit; maximaal aantal iteraties 50.000; inputs gestandaardiseerd met behulp van fitting-partitionstatistieken |
| Regularisatie | CLIP-straf λ = 1.000; ruwe VAE-straf λ = 0; structurele VAE-straf λ = 1,000 | |
| Doelafmetingen | CLIP: 1.024; VAE: 36.864 | |
| Fusie en decodering | Fusiegewichten | CLIP-ankerweight α = 0,55; VAE-ankergewicht α = 0,65; geselecteerd op basis van ontwikkelingsgegevens en vastgelegd vóór de testfase |
| Diffusiemodel | sd2-community/stable-diffusion-2-1-unclip; structurele schaal γ = 0,02; diffusietijdstappen T = 1.000 | |
| Bemonstering | 20 denoising-stappen; guidance scale 7,5; diffusie-seed 0 |
Tabel 1: Geconsolideerd overzicht van parameters voor TDE-Net. De tabel vermeldt de datapartitie, voorbewerking, constructie van functionele adjacentie, instellingen voor de graaf- en semantische encoder, latent-mapping straffen, fusiegewichten en instellingen voor diffusie-decodering die zijn gebruikt in de gerapporteerde experimenten.
| Methode | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Begin | CLIP | EffNet | SwAV |
| Nulmeting | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| EEGImageDecode | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Perceptogram (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (van ons) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
Tabel 2: Resultaten van de kwantitatieve reconstructie. De vergelijkingsmethoden, de interne convolutional-attention Baseline en TDE-Net, werden geëvalueerd binnen een gemeenschappelijk experimenteel kader met behulp van dezelfde THINGS-EEG2 partitie, 17-kanaals input, preprocessing, uitgesloten testcondities en metriekdefinities, terwijl de methodespecifieke architecturen behouden bleven. Het huidige model wordt samengevat als gemiddelde ± SD over 10 proefpersonen. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 en CLIP zijn maten waarbij een hogere waarde beter is; EffNet en SwAV zijn correlatieafstanden, waarbij een lagere waarde beter is. De CLIP-kolom rapporteert de nauwkeurigheid van paarsgewijze identificatie met behulp van het OpenAI CLIP ViT-L/14 model.
| Proefpersoon | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0.2260 | 0.3361 | 0.8831 | 0.9203 | 0.7533 | 0.8120 | 0.8567 | 0.5285 |
| sub-02 | 0.2488 | 0.3378 | 0.8699 | 0.9053 | 0.7268 | 0.8074 | 0.8335 | 0.5167 |
| sub-03 | 0.2564 | 0.3397 | 0.8728 | 0.9070 | 0.7658 | 0.8143 | 0.8268 | 0.5096 |
| sub-04 | 0.2420 | 0.3356 | 0.8598 | 0.9034 | 0.7854 | 0.8112 | 0.8255 | 0.5091 |
| sub-05 | 0.2499 | 0.3385 | 0.8760 | 0.8963 | 0.7251 | 0.8016 | 0.8394 | 0.5189 |
| sub-06 | 0.2621 | 0.3395 | 0.8910 | 0.9331 | 0.7818 | 0.8215 | 0.8202 | 0.5009 |
| sub-07 | 0.2489 | 0.3378 | 0.8643 | 0.9185 | 0.7704 | 0.8200 | 0.8222 | 0.5017 |
| sub-08 | 0.2786 | 0.3425 | 0.8951 | 0.9216 | 0.7524 | 0.8245 | 0.8214 | 0.5010 |
| sub-09 | 0.2609 | 0.3370 | 0.8775 | 0.9238 | 0.7662 | 0.8055 | 0.8250 | 0.5009 |
| sub-10 | 0.2571 | 0.3433 | 0.8871 | 0.9240 | 0.7792 | 0.8175 | 0.8140 | 0.4977 |
| Gemiddelde | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7606 | 0.8135 | 0.8285 | 0.5085 |
| Gemiddelde ± SD | 0.2531 ± 0.0138 | 0.3388 ± 0.0025 | 0.8777 ± 0.0115 | 0.9153 ± 0.0116 | 0.7606 ± 0.0213 | 0.8135 ± 0.0074 | 0.8285 ± 0.0122 | 0.5085 ± 0.0101 |
| 95% BI | 0.2432-0.2630 | 0.3370-0.3406 | 0.8695-0.8859 | 0.9070-0.9236 | 0.7454-0.7759 | 0.8082-0.8189 | 0.8198-0.8372 | 0.5013-0.5157 |
Tabel 3: Kwantitatieve cross-subject resultaten voor TDE-Net. Elk subject draagt 200 apart gehouden testcondities bij. De tabel rapporteert de acht metrieken voor sub-01 tot en met sub-10, gevolgd door het gemiddelde over alle subjecten, de steekproef-SD en het 95% BI. CLIP duidt de paarsgewijze identificatienauwkeurigheid van OpenAI CLIP ViT-L/14 aan; EffNet en SwAV zijn correlatieafstanden waarbij een lagere waarde beter is.
| Methode | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Lineair anker | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Lineair + Struct-Stream | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Lineair + Sem-Stream | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (eigen methode) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tabel 4: Ablatieresultaten gerapporteerd als gemiddelde waarden over de proefpersonen onder de evaluatieprocedure beschreven in Protocol Sectie 6. De Linear Anchor is een lokaal geëvalueerde interne directe ridge-mapping referentie; de structurele, semantische en volledige configuraties gebruiken dezelfde conditie-indexen en metrische definities. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 en CLIP zijn maten waarbij een hogere waarde beter is; EffNet en SwAV zijn correlatieafstanden waarbij een lagere waarde beter is. Waarden worden weergegeven met drie decimalen.
Aanvullende figuur 1: Representatieve reconstructiegevallen over het bereik van de CLIP-overeenkomst voor sub-01. De 200 gereserveerde condities zijn gerangschikt op basis van de cosinusgelijkenis tussen de gefuseerde EEG-voorspelde en de ground-truth CLIP-embeddings; de zes beste, zes middelste en zes slechtste gevallen worden getoond. Elke kolom koppelt een ground-truth beeldsample uit de THINGS-EEG2 testset aan de bijbehorende TDE-Net reconstructie. De ground-truth beelden zijn afkomstig uit de THINGS-beeldenbank34. Klik hier om dit bestand te downloaden.
Aanvullende figuur 2: Gezamenlijke visualisatie van ground-truth en EEG-voorspelde CLIP-representaties in sub-01 (n = 200 condities per representatie). (A) Ground-truth CLIP-representaties. (B) EEG-voorspelde CLIP-representaties. Kleuren duiden vijf k-means clusters aan die zijn gefit op L2-genormaliseerde ground-truth CLIP-embeddings (k = 5, n_init = 50, seed = 7). De clusters zijn datagestuurde groepen en komen niet overeen met vooraf gedefinieerde semantische categorieën. Ground-truth en voorspelde embeddings zijn geconcateneerd, gereduceerd tot 50 dimensies middels PCA en gezamenlijk geprojecteerd door t-SNE (perplexity = 28, learning rate = auto, Euclidische metriek, seed = 12). PCA, principale componentenanalyse; t-SNE, t-distributed stochastic neighbor embedding. Klik hier om dit bestand te downloaden.
Aanvullende Figuur 3: EEG-patronen gegroepeerd per brede beeldconceptcategorie voor sub-01. Concepten zijn toegewezen aan Dieren, Voedings-/plantgerelateerde concepten of Andere objecten. Binnen elke categorie volgen de rijen de hiërarchische ordening van Ward van gewitende ground-truth CLIP-embeddings en zijn ze uniform bemonsterd tot maximaal 30 concepten voor de leesbaarheid. De kolommen tonen 17 EEG-kanalen, met 80 tijdspunten per kanaal. De kleurenschaal (-1 tot 1) representeert de afgeknotte, genormaliseerde gewitende EEG-amplitude. Klik hier om dit bestand te downloaden.
Aanvullende figuur 4: Topografie van de aandacht voor hoofdhuidkanalen in de semantische stroom. Kleuren geven de genormaliseerde relatieve grootten weer van de aangeleerde kanaalgewichtsparameters over de geselecteerde 17 elektroden in een standaard 10–20 projectie van de hoofdhuid; elektrodepunten en labels identificeren de meetposities. De schaal loopt van 0 tot 1 en vat de aangeleerde relatieve kanaalgewichtingsfactor van het model samen. Klik hier om dit bestand te downloaden.
Discussie
Deze studie presenteert een modulaire computationele workflow die EEG-preprocessing, structureel en semantisch representatieleren, CLIP/VAE latent mapping, fusie en diffusie-decodering scheidt. Deze gefaseerde organisatie maakt het mogelijk om tussenuitvoer apart van de gegenereerde beelden te onderzoeken en volgt de bredere progressie van compacte EEG-encoders naar cross-modale en op diffusie gebaseerde reconstructiemethoden6,11,12,13,14,15,16,,17,18,19,20,21,22. De cross-subject analyse rapporteert waarden op subjectniveau samen met het gemiddelde over alle subjecten en de standaarddeviatie (SD) van de steekproef voor de evaluatie van de uitgesloten groep van tien subjecten. Samen met de stapsgewijze ablatie in Tabel 4 kwantificeert deze analyse stroomspecifieke effecten en variatie tussen subjecten binnen de gerapporteerde pipeline.
Kritieke stappen en probleemoplossing
De meest bepalende implementatiecontroles zijn partitie-isolatie, consistente normalisatie, behoud van de conditie-index en gescheiden CLIP/VAE-mappings. Fusiegewichten moeten worden geselecteerd op basis van ontwikkelingscondities en worden bevroren vóór de testreconstructie. Wanneer de prestaties onverwacht laag zijn, dient eerst de volgorde en de dimensies van de array te worden geverifieerd, waarna de ruwe en takspecifieke latente PCC, de fusiemetadata en de metric-outputs op beeldniveau moeten worden geïnspecteerd. Een fout in de latente uitlijning duidt op een mappingprobleem stroomopwaarts, terwijl variabele beelden met stabiele latente variabelen kunnen wijzen op stochastisch of decoder-afhankelijk gedrag14,21,22,29.
Het wijzigen van de elektrodemontage, de bemonsteringsfrequentie of het temporele venster vereist overeenkomstige aanpassingen in de constructie van de grafieken, de spectrale kenmerken en de temporele kernels. De reconstructiekwaliteit moet worden beoordeeld met aanvullende low-level en semantische maten, omdat geen enkele score de pixeltrouw, structuur en overeenstemming op objectniveau volledig vastlegt6,11,21,22,23. De CLIP-maat die hier wordt gebruikt is de pairwise identificatienauwkeurigheid, terwijl Figuur 7 en Figuur 8 de PCC op latent-niveau gebruiken; deze grootheden zijn niet uitwisselbaar.
De modulaire organisatie van TDE-Net biedt een kader om te onderzoeken of complementaire EEG-representaties verschillend bijdragen aan structurele en semantische aspecten van visuele reconstructie. Deze aanpak kan een systematische vergelijking van EEG-kenmerkrepresentaties, latente doelen en generatieve decoders vergemakkelijken zonder uitsluitend te vertrouwen op de uiteindelijke gereconstrueerde beelden. Alternatieve benaderingen omvatten directe lineaire EEG-naar-latent mapping,convolutionele of op attention gebaseerde encoders met een enkele stroom, graafgebaseerde representaties en end-to-end neurale decoding-frameworks6,7,8,9,10,11,17,18,19,20,21,22. De huidige workflow kan bijzonder nuttig zijn voor onderzoek naar het decoderen van visuele perceptie, analyse van neurale representaties en niet-invasieve hersen-computerinterfaces, waarbij het scheiden van intermediaire EEG-naar-latent voorspellingen kan helpen bepalen welke componenten bijdragen aan de reconstructieprestaties.
Beperkingen
De belangrijkste beperkingen zijn de vaste THINGS-EEG2 RSVP-acquisitie, de geselecteerde 17 parieto-occipitale kanalen, proefpersoonspecifieke mappings, een enkele diffusie-decoder en kwalitatieve interpreteerbaarheidsanalyses21,22,23. De samenvatting van 10 proefpersonen behandelt de variabiliteit tussen proefpersonen binnen de dataset, maar stelt geen overdracht tussen datasets of paradigma's vast. Gegenereerde afbeeldingen kunnen plausibele details bevatten die niet worden ondersteund door de EEG-input, en RSM-, t-SNE-, EEG-patroon- en attention-weergaven stellen geen causale neurale mechanismen vast. De stapsgewijze ablatie kenmerkt de bijdragen van de structurele stroom, de semantische stroom en de dual-space fusie onder een gedeelde raw EEG-anker, latente doelen, diffusie-decoder en evaluatieprotocol.
Toekomstige richtingen
Binnen deze beperkingen ondersteunen de resultaten de evaluatie van complementaire EEG-representaties in afzonderlijke semantische en image-latent ruimtes voorafgaand aan diffusie-decodering. Toekomstig onderzoek dient onafhankelijke datasets, subject-adaptatie, onzekerheidsschattingen, alternatieve kanaalmontages en decoders met sterkere controles op niet-ondersteunde visuele details te testen14,15,16,17,18,19,20,21,22,23. Dergelijke studies zijn noodzakelijk voordat de huidige bevindingen kunnen worden uitgebreid naar bredere neurowetenschappelijke contexten of hersen-computerinterface-toepassingen.
Conclusie:
TDE-Net combineert een ruwe EEG-anchor met structurele en semantische EEG-representaties, lijnt deze afzonderlijk uit met de VAE- en CLIP-latente ruimtes, en integreert de resulterende voorspellingen voorafgaand aan de diffusie-decodering. Bij 10 deelnemers van THINGS-EEG2 behielden de gereconstrueerde beelden een meetbare correspondentie op pixelniveau, structureel en semantisch met de bekeken stimuli, terwijl de stapsgewijze ablatie de effecten van de structurele stroom, de semantische stroom en de dual-space fusie differentieerde. Door het presenteren van intermediaire EEG-kenmerken, latente voorspellingen, fusie-outputs en uiteindelijke reconstructies, biedt het protocol een reproduceerbaar kader voor het onderzoeken van EEG-gebaseerde visuele reconstructie en voor het evalueren van de toekomstige uitbreiding naar onafhankelijke datasets en acquisitie-instellingen.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende financiële belangen of persoonlijke relaties zijn die dit werk hebben kunnen beïnvloeden. De auteurs verklaren dat er geen generatieve AI-instrumenten zijn gebruikt bij het manuscript, de code, de data-analyse of de voorbereiding van de figuren.
Dankbetuigingen
Dit onderzoek werd gefinancierd door de National Natural Science Foundation of China onder (Grant No. 62433002) en (Grant No. 62476014), het National Science and Technology Major Project (No. 2021ZD0113703), het Beijing Municipal Social Science Foundation Annual Planning Project (No. 23GLB014), het Project of Construction and Support for High-level Innovative Teams of Beijing Municipal Institutions onder (Grant No. BPHR20220104), en het Beijing Scholars Program onder (Grant No. 099).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Accelerate | Hugging Face | 0.30.1 | Beheer van apparaten in de diffusie-pipeline; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Image-feature encoder gebruikt voor semantische doelen en CLIP-paarsgewijze identificatie; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Implementatie van de Stable UnCLIP-pipeline; https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib Development Team | 3.10.6 | Generatie van wetenschappelijke figuren; https://matplotlib.org/ |
| MNE-Python | MNE Developers | 1.11.0 | Standaard 10-20 montage en hoofdhuidkanaal-topografie; https://mne.tools/ |
| NumPy | NumPy Developers | 2.3.4 | EEG-arrays, latente embeddings, fusie en metriekaggregatie; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | GPU gebruikt voor lokale encoder-training en diffusie-reconstructie. |
| Pillow | Python Imaging Library Fork | 11.1.0 | Laden, schalen en exporteren van afbeeldingen; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | Primaire runtime-omgeving; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | Training van EEG-encoder en neurale-netwerk-inferentie; https://pytorch.org/ |
| scikit-image | scikit-image Developers | 0.25.2 | SSIM- en beeldbewerkingshulpprogramma's; https://scikit-image.org/ |
| scikit-learn | scikit-learn Developers | 1.7.2 | Ridge-regressie, k-means, PCA en t-SNE; https://scikit-learn.org/ |
| SciPy | SciPy Developers | 1.16.3 | Correlatie, statistische afstand en hiërarchische clustering; https://scipy.org/ |
| Seaborn | Seaborn Developers | 0.13.2 | Visualisatie van Gaussische kernel-dichtheid; https://seaborn.pydata.org/ |
| Semantic-stream EEG encoder | TDE-Net auteurs; aangepast van LMDA-Net | Repository commit c99325d | Multi-schaal temporele semantische representatie; implementatie en checkpoint-metadata zijn beschikbaar in de coderepository. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 Community | sd2-community/stable-diffusion-2-1-unclip | Bevroren diffusie-decoder; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Structural-stream EEG encoder | TDE-Net auteurs | Repository commit c99325d | Zelfgesuperviseerde graafrepresentatie; ruwe EEG- en graafkenmerken worden alleen geconcateneerd voor de structurele mapping in de VAE-ruimte. |
| TDE-Net alignment, fusion, evaluation, and visualization scripts | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| THINGS-database | Hebart et al. | doi:10.1371/journal.pone.0223792 | Bron voor naturalistische objectstimuli; https://things-initiative.org/ |
| THINGS-EEG2 dataset | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | 64-kanaals EEG van 10 proefpersonen; deze studie selecteert 17 parieto-occipitale kanalen; https://osf.io/anp5v/ |
| timm | Ross Wightman and contributors | 1.0.22 | Pre-getrainde vision-model hulpprogramma's gebruikt bij feature-evaluatie; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | Evaluatie-backbones voor AlexNet, Inception-v3 en EfficientNet; https://pytorch.org/vision/ |
| tqdm | tqdm Developers | 4.67.1 | Voortgangsrapportage voor feature-extractie, reconstructie en evaluatie; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Interfaces voor pre-getrainde modelcomponenten; https://github.com/huggingface/transformers |
Referenties
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar