Pytanie o to, jak regulatory chromatyny i stany chromatyny wpływają na genom in vivo, jest kluczowe dla naszego zrozumienia, jak wcześnie podejmowane są decyzje dotyczące losu komórki w rozwijającym się zarodku. ChIP-Seq – najpopularniejsze podejście do badania cech chromatyny na poziomie globalnym – zostało przedstawione tutaj dla zarodków Xenopus.
Artykuł metodologiczny
Migawka całego genomu regulatorów i stanów chromatyny w zarodkach Xenopus za pomocą ChIP-Seq
W tym artykule
Podsumowanie
Streszczenie
Rekrutacja regulatorów chromatyny i przypisywanie stanów chromatyny do określonych loci genomowych są kluczowe dla decyzji dotyczących losu komórki oraz tworzenia tkanek i organów podczas rozwoju. Określenie lokalizacji i poziomów takich cech chromatyny in vivo dostarczy cennych informacji na temat czasoprzestrzennej regulacji elementów genomu i wesprze aspiracje do naśladowania rozwoju tkanki embrionalnej in vitro. Najczęściej stosowaną metodą profilowania całego genomu i profilowania w wysokiej rozdzielczości jest immunoprecypitacja chromatyny, a następnie sekwencjonowanie nowej generacji (ChIP-Seq). Protokół ten określa, w jaki sposób zarodki bogate w żółtko, takie jak zarodki żaby Xenopus, mogą być przetwarzane do eksperymentów ChIP-Seq, i oferuje proste wiersze poleceń do analizy po sekwencjonowaniu. Ze względu na wysoką skuteczność, z jaką protokół ekstrahuje jądra z tkanki utrwalonej formaldehydem, metoda ta umożliwia łatwe skalowanie w celu uzyskania wystarczającej ilości materiału ChIP do profilowania całego genomu. Nasz protokół został z powodzeniem wykorzystany do mapowania różnych białek wiążących DNA, takich jak czynniki transkrypcyjne, mediatory sygnałowe, składniki maszynerii transkrypcyjnej, modyfikatory chromatyny i potranslacyjne modyfikacje histonów, a także do robienia tego na różnych etapach embriogenezy. Wreszcie, protokół ten powinien mieć szerokie zastosowanie do innych organizmów modelowych i niemodelowych, w miarę jak dostępnych będzie coraz więcej zestawów genomu.
Wprowadzenie
Pierwsze próby scharakteryzowania interakcji białko-DNA in vivo zostały zgłoszone około 30 lat temu w celu zrozumienia transkrypcji genów za pośrednictwem polimerazy RNA u bakterii i muszki owocowej1,2. Od tego czasu zastosowanie immunoprecypitacji w celu wzbogacenia odrębnych cech chromatyny (ChIP) zostało szeroko przyjęte w celu wychwytywania zdarzeń wiązania i stanów chromatyny z wysoką wydajnością3. Następnie, wraz z pojawieniem się potężnych technologii mikromacierzy, metoda ta doprowadziła do scharakteryzowania krajobrazów chromatyny w całym genomie4. Ostatnio profilowanie chromatyny stało się jeszcze bardziej wszechstronne i ma wysoką rozdzielczość, ponieważ miliony matryc DNA współimmunoprecypitowanych mogą być teraz sekwencjonowane równolegle i mapowane do genomu (ChIP-Seq)5. Ponieważ dostępna jest coraz większa liczba zespołów genomów, ChIP-Seq jest atrakcyjnym podejściem, aby dowiedzieć się więcej o regulacji genomu, która leży u podstaw procesów biologicznych.
Tutaj udostępniamy protokół do wykonywania ChIP-Seq na zarodkach bogatych w żółtko, takich jak te należące do żaby Xenopus. Szkice genomów obu powszechnie stosowanych gatunków Xenopus – X. tropicalis i X. laevis – zostały opublikowane przez Międzynarodowe Konsorcjum Genomu Xenopus 6. Zarodki z gatunku Xenopus mają wiele wspólnych pożądanych cech, które ułatwiają i umożliwiają interpretację badań chromatyny w całym genomie, w tym produkcję dużej liczby zarodków wysokiej jakości, duży rozmiar samych zarodków i ich rozwój zewnętrzny. Ponadto zarodki są podatne na klasyczne i nowatorskie manipulacje, takie jak śledzenie linii komórkowych, hybrydyzacja in situ w całości montowanej, nadekspresja RNA i technologia nokautu za pośrednictwem TALEN/CRISPR.
Poniższy protokół opiera się na pracy Lee et al., Blythe et al. oraz Gentsch et al. 7-9. Krótko mówiąc, zarodki Xenopus są utrwalane formaldehydem na etapie rozwoju będącym przedmiotem zainteresowania w celu kowalencyjnego wiązania (sieciowania) białek z powiązanym z nimi genomowym DNA. Po ekstrakcji jądrowej usieciowana chromatyna jest fragmentowana w celu skoncentrowania kolejnego sekwencjonowania na określonych miejscach wiązania lub modyfikacji genomu oraz w celu zminimalizowania udziału flankujących sekwencji DNA. Następnie fragmenty chromatyny są immunoprecypitowane przeciwciałem klasy ChIP w celu wzbogacenia tych zawierających białko będące przedmiotem zainteresowania. Koimmunoprecypitowane DNA jest usuwane z białka i oczyszczane przed utworzeniem indeksowanej (sparowanej) biblioteki do sekwencjonowania nowej generacji (NGS). Na końcu oferowane są proste wiersze poleceń do analizy danych ChIP-Seq po sekwencjonowaniu.
Protokół
UWAGA: Wszystkie prace Xenopus są w pełni zgodne z brytyjską ustawą o zwierzętach (procedury naukowe) z 1986 roku, wdrożoną przez MRC National Institute for Medical Research.
1. Przygotowania
- Oszacuj liczbę zarodków potrzebnych do eksperymentu ChIP (patrz dyskusja).
- Przygotować następujące roztwory, które są przechowywane w temperaturze pokojowej: 500 ml 10x zmodyfikowanych pierścieni Marca (MMR) bez EDTA, pH dostosowane do 7,5 i wysterylizowane w autoklawie (1 M NaCl, 20 mM KCl, 20 mM CaCl2, 10 mM MgSO4, 50 mM HEPES pH 7,5)10, 1 ml buforu elucyjnego SDS (50 mM Tris-HCl pH 8,0, 1 mM EDTA, 1% SDS) i 1 ml 5x buforu ładującego DNA (0,2% Orange G, 30% glicerol, 60 mM EDTA pH 8,0).
- Przygotować następujące roztwory, które są przechowywane w temperaturze 4 °C: 50 ml buforu HEG (50 mM HEPES-KOH pH 7,5, 1 mM EDTA pH 8,0, 20% glicerol), 500 ml ekstrakcyjnych E1 (50 mM HEPES-KOH pH 7,5, 150 mM NaCl, 1 mM EDTA. 10% glicerol, 0,5% Igepal CA-630, 0,25% Triton X-100), E2 (10 mM Tris-HCl pH 8,0, 150 mM NaCl, 1 mM EDTA, 0,5 mM EGTA) i E3 (10 mM Tris-HCl pH 8,0, 150 mM NaCl, 1 mM EDTA, 1% Igepal CA-630, 0,25% Na-Deoksycholan, 0,1% SDS), 500 ml buforu RIPA (50 mM HEPES-KOH pH 7,5, 500 mM LiCl, 1 mM EDTA, 1% Igepal CA-630, 0,7% Na-deoksycholanu) i 50 ml buforu TEN (10 mM Tris-HCl pH 8,0, 1 mM EDTA, 150 mM NaCl).
- Naciąć i przyciąć stożkową rurkę z polistyrenu o pojemności 15 ml w miejscu oznaczonym 7 ml. Użyj tej probówki, aby pomieścić ekstrakty jądrowe poddawane sonikacji.
- Do analizy po sekwencjonowaniu należy użyć wielordzeniowego komputera operacyjnego typu Unix z co najmniej 8 GB pamięci RAM i 500 GB wolnego miejsca na dysku. Zainstaluj lokalnie następujące oprogramowanie, z których większość jest używana w wierszu poleceń: FastQC, filtr jakości Illumina CASAVA-1.8, Bowtie11, SAMtools12, HOMER13, MACS214, IGV15,16, Cluster317, Java TreeView, BLAST+18 i b2g4pipe19. Zapoznaj się z instrukcjami instalacji i wymaganiami dotyczącymi kompilatorów i oprogramowania innych firm.
- Zbuduj indeks Bowtie, aby dopasować krótkie odczyty NGS do genomu Xenopus. Przykład jest pokazany tutaj dla genomu X. tropicalis v7.1 (listopad 2011), który można pobrać jako plik FASTA (genome.fa) z serwera ftp Xenbase (/pub/Genomics/JGI). Przenieś plik FASTA do podkatalogu index programu Bowtie.
- Użyj następującego wiersza poleceń (tutaj po znaku zachęty >), aby wygenerować pliki indeksu xenTro7:
>> muszka-zbuduj /ścieżka/do/muszki/index/genome.fa xenTro7
>> eksport BOWTIE_INDEXES=/ścieżka/do/muszki/indeks/
- Użyj następującego wiersza poleceń (tutaj po znaku zachęty >), aby wygenerować pliki indeksu xenTro7:
- Pobierz plik adnotacji genów (GTF) z przeglądarki genomu UCSC lub witryny lustrzanej na serwerze NIMR, aby uzyskać najnowsze wersje genomu (genomes.nimr.mrc.ac.uk) za pomocą Tools/Table Browser. Użyj pliku genomu FASTA i pliku GTF, aby dostosować HOMER dla Xenopus (np. X. tropicalis genome v7.1, -name xenTro7).
- Alternatywnie, użyj gotowych pakietów HOMER dla niektórych starszych wersji genomu Xenopus.
> loadGenome.pl -name xenTro7 -org null -fasta /ścieżka/do/genomu.fa -gtf ścieżka/do/genów.gtf
- Alternatywnie, użyj gotowych pakietów HOMER dla niektórych starszych wersji genomu Xenopus.
- Utwórz ślad genomu (plik .genome) dla przeglądarki genomu IGV, przesyłając zindeksowany plik FASTA (genome.fa z plikiem genome.fa.fai w tym samym folderze) i plik adnotacji (genes.gtf). Utwórz indeks rusztowania genomu (genome.fa.fai) dla genomu Xenopus w następujący sposób:
> samtools faidx /ścieżka/do/genomu.fa - Użyj BLAST+, aby przekazać terminy ontologii genów (GO) z kilku gatunków modelowych (człowiek, mysz, danio pręgowany, muszka owocowa i drożdże) do genów Xenopus w następujący sposób:
- Pobierz wszystkie sekwencje kodujące (CDS) jako pojedynczy plik FASTA (cds.fa) z UCSC Genome Browser za pomocą Tools/Table Browser i zaktualizuj BLAST+ za pomocą wstępnie sformatowanej bazy danych BLAST nieredundantnych białek (nr):
> update_blastdb.pl nr - Wyszukaj białka ludzkie (txid9606), myszy (txid10090), danio pręgowanego (txid7955), muszki owocowej (txid7227) i drożdży (txid4932) z witryny NCBI za pomocą funkcji wyszukiwania zaawansowanego (http://www.ncbi.nlm.nih.gov/protein/advanced) i wyślij wynikową listę GI (identyfikator sekwencji) (sequence.gi.txt) do komputera.
- Przypisz geny Xenopus do najbardziej podobnych białek z listy GI, wykonując BLASTx z określoną oczekiwaną wartością odcięcia (E) (tutaj 10-20). Upewnij się, że format wyjściowy to xml (-outfmt 5 -out blastx_results.xml). Korzystaj z oszczędzających czas wątków (-num_threads), które są skorelowane z liczbą dostępnych rdzeni komputera.
> blastx -db /ścieżka/do/nr -gilist /ścieżka/do/sequence.gi.txt -query /ścieżka/do/cds.fa -ewartość 1e-20 \
>-outfmt 5 -out /ścieżka/do/blastx_results.xml -num_threads [# wątki] - Otwórz plik b2gPipe.properties folderu b2g4pipe za pomocą edytora tekstu i zaktualizuj właściwości bazy danych do Dbacces.dbname=b2go_sep13 i Dbacces.dbhost=publicdb.blast2go.com. Uruchom b2g4pipe z folderu instalacyjnego.
> java Xmx1000m -cp *:ext/*: es.blast2go.prog.B2GAnnotPipe -in /ścieżka/do/blastx_results.xml \
>-out wyniki/xenTro7 -prop b2gPipe.properties -v -annot
UWAGA: Ten program wyodrębnia warunki GO dla każdego trafienia BLAST i przypisuje je do odpowiednich genów Xenopus (xenTro7.annot). Najbardziej aktualne ustawienia bazy danych można znaleźć w Narzędzia/Ustawienia ogólne/Ustawienia dostępu do danych aplikacji Blast2GO Java Web Start (patrz 9.11.1).
- Pobierz wszystkie sekwencje kodujące (CDS) jako pojedynczy plik FASTA (cds.fa) z UCSC Genome Browser za pomocą Tools/Table Browser i zaktualizuj BLAST+ za pomocą wstępnie sformatowanej bazy danych BLAST nieredundantnych białek (nr):
2. Sieciowanie chromatyny
- Zapłodnić jaja Xenopus, galaretkę i posaz zarodki zgodnie ze standardowymi protokołami20.
- Przenieść zarodki poddane dejellicji (maksymalnie 2 500 X. laevis lub 10 000 X. tropicalis) w interesującym stadium rozwoju do 8 ml szklanej fiolki z próbką z nakrętką i przemyć je krótko raz 0,01x MMR.
- Utrwalić zarodki 1% formaldehydem w 0,01x MMR (np. dodać 225 μl 36,5-38% formaldehydu do 8 ml 0,01x MMR) przez 15 do 40 minut w RT (patrz Dyskusja na temat czasu utrwalania i liczby zarodków wymaganych na eksperyment ChIP).
UWAGA: Formaldehyd jest i wysoce toksyczny. Jest niebezpieczny w przypadku kontaktu z oczami i skórą, niestrawności i wdychania. Podczas dodawania formaldehydu do fiolki należy używać dygestoria. - Zatrzymaj fiksację, krótko myjąc zarodki trzykrotnie zimnym 0,01x MMR. Nie pozwól, aby embryos stykały się z powierzchnią cieczy, ponieważ napięcie powierzchniowe powoduje ich pękanie.
- Podwielokrotność zarodków rozmieścić na lodzie w probówkach do mikrowirówek o pojemności 2 ml z maksymalnie 250 zarodkami w probówce, które przed wykluciem zajmują objętość około 250 μl (X. tropicalis) lub 600 μl (X. laevis).
- Odpipetować jak najwięcej 0,01x MMR. Pomiń następny krok, jeśli od razu przejdziesz do sekcji 3.
- Zrównoważyć zarodki w 250 μl zimnego buforu HEG. Gdy zarodki osiądą na dnie probówki, usuń jak najwięcej płynu i zamroź w ciekłym azocie. Przechowywać w temperaturze -80 °C.
3. Ekstrakcja chromatyny
UWAGA: Następująca ekstrakcja usieciowanej chromatyny z zarodków Xenopus działa najefektywniej z czasami utrwalania wskazanymi w kroku 2.3 i 50 do 80 X. tropicalis lub 25 do 40 X. laevis zarodków na ml buforu ekstrakcyjnego E1, E2 i E3. Każdy etap ekstrakcji jest powtarzany, tak aby wymagana była dwukrotność obliczonej objętości buforu. Do zwiększania skali użyj wielu probówek wirówkowych o pojemności 2 ml lub probówek wirówkowych o pojemności 50 ml. Próbki i należy przechowywać na lodzie podczas ekstrakcji chromatyny.
- Uzupełnij odpowiednie objętości E1, E2 i E3 tabletkami 1 mM DTT i inhibitorami proteazy. W przypadku wykonywania ChIP z przeciwciałem specyficznym dla fosfo, należy dalej uzupełniać 5 mM NaF i 2 mM Na3VO4.
- Homogenizuj utrwalone zarodki za pomocą E1, pipetując w górę iw dół. Odwirować homogenaty w wirówce z chłodzeniem (4 °C) przy 1 000 x g przez 2 minuty (lub 5 minut w przypadku stosowania probówek o pojemności 50 ml). Odessać supernatant i wszelkie lipidy przyłączone do ściany.
- Zawieś ponownie granulki w E1. Próbki należy przechowywać na lodzie przez 10 minut. Odwirować i odrzucić supernatanty, jak w kroku 3.2.
- Zawieś ponownie pelety w E2. Odwirować i odrzucić supernatanty, jak w kroku 3.2.
- Powtórzyć krok 3.4, ale przed odwirowaniem należy przechowywać próbki na lodzie przez 10 minut.
- Zawieś ponownie pelety w E3. Próbki należy przechowywać na lodzie przez co najmniej 10 minut. Odwirować i odrzucić supernatanty, jak w kroku 3.2.
UWAGA: Na tym etapie zawieszenia powinny stać się dość przejrzyste. Anionowe detergenty zawarte w E3 ekstrahują usieciowane jądra, sprawiając, że większość pozostałych płytek żółtka jest rozpuszczalna. - Zawiesić i zebrać osady usieciowanych jąder (zwykle zabarwionych na brązowo od nierozpuszczalnych granulek pigmentu) w całkowitej objętości 1 ml E3. Rozcieńczyć próbkę E3 do 2 lub 3 ml, jeżeli wydaje się bardzo lepka i trudno ją odpipetować. Przechowywać na lodzie lub w temperaturze 4 °C, aby przejść do kroku 4 tego samego lub następnego dnia. Błyskawiczne zamrożenie w ciekłym azocie i przechowywanie w temperaturze -80 °C do późniejszego wykorzystania.
4. Fragmentacja chromatyny
UWAGA: Sonikacja jest używana zarówno do solubilizacji, jak i do ścinania usieciowanej chromatyny. Oto parametry do uruchomienia Misonix Sonicator 3000 wyposażonego w zwężającą się mikrokońcówkę 1/16 cala i obudowę dźwiękochłonną. W przypadku korzystania z innych sonikatorów należy postępować zgodnie z zaleceniami producentów dotyczącymi ścinania usieciowanej chromatyny lub używać od 6 do 12 W łącznie przez 4 do 8 minut.
- Przenieść próbkę jądrową z kroku 3.7 do specjalnie skonstruowanej probówki do sonikacji (krok 1.4). Utrzymuj próbkę schłodzoną podczas sonikacji, umieszczając probówkę w plastikowej zlewce o pojemności 800 ml wypełnionej lodowatą wodą za pomocą krótkiego termometru clamp.
- Umieść zlewkę na podnośniku laboratoryjnym. Wyreguluj podnośnik tak, aby mikrokońcówka sonikatora była zanurzona w próbce do około dwóch trzecich głębokości objętości i wyśrodkowana bez dotykania ścianki rurki.
- Sonizacja próbki trwa łącznie 7 minut, przerywana co 30 sekund z 1-minutowymi przerwami. Ustaw moc na 1.0. Rozpocznij sonikację i natychmiast zwiększ ustawienie mocy (zwykle od 2 do 4), aby osiągnąć odczyt od 9 do 12 W. Natychmiast wstrzymaj, jeśli próbka zacznie się pienić. Zmień położenie rurki i uruchom ponownie, gdy piana całkowicie zniknie.
- Przenieść ściętą chromatynę do wstępnie schłodzonych probówek mikrowirówek o pojemności 1,5 ml i wirować z pełną prędkością (>15 000 x g) przez 5 minut w temperaturze 4 °C.
- Przenieść supernatant do wstępnie schłodzonych probówek wirówkowych o pojemności 1,5 ml. Zebrać 50 μl supernatantu (najlepiej zawierającego chromatynę o około 400 000 lub więcej jąder), aby uwidocznić stopień fragmentacji chromatyny (sekcja 5). Resztę supernatantu należy użyć dla ChIP (sekcja 6).
- Próbki należy przechowywać w temperaturze 4 °C przez okres do jednego dnia. Szybkie zamrażanie próbek w postaci podwielokrotności (po jednej na doświadczenie ChIP) w ciekłym azocie w celu długotrwałego przechowywania w temperaturze -80 °C.
5. Obrazowanie fragmentacji chromatyny
- Dodać 50 μl buforu elucyjnego SDS, 4 μl 5 M NaCl i 1 μl proteinazy K (20 μg/μl) do 50 μl supernatantu z kroku 4.6.
- Inkubować przez 6 do 15 godzin (O/N) w piecu do hybrydyzacji ustawionym na 65 °C.
- Oczyść DNA za pomocą komercyjnego zestawu do oczyszczania PCR. W razie potrzeby użyj 3 M octanu sodu (pH 5,2), aby dostosować pH zgodnie z zaleceniami producenta. Dwukrotnie eluować DNA za pomocą 11 μl buforu elucyjnego (10 mM Tris-HCl pH 8,5).
- Dodać 0,4 μl RNazy A (20 μg/μl) i 5 μl 5-krotnego buforu ładującego DNA, a następnie przeprowadzić całą próbkę wraz z drabinką 100 pz i 1 kb DNA na 1,4% żelu agarozowym metodą elektroforezy. Aby uzyskać optymalne wyniki, po elektroforezie zabarwić żel bezpiecznym roztworem do barwienia kwasów nukleinowych.
6. Immunoprecypitacja chromatyny
UWAGA: W tej sekcji użyj probówek mikrowirówek o niskiej retencji 1,5 ml i co najmniej 1 ml wskazanego buforu na probówkę do mycia kulek magnetycznych przez 5 minut w temperaturze 4 °C. Przed wyjęciem buforu z kulek należy pozostawić probówki w stojaku magnetycznym na 20 do 30 sekund za każdym razem lub do momentu, gdy roztwór będzie klarowny.
- Przenieść od 10 do 30 μl supernatantu (chromatyny ścinanej) z kroku 4.6 do nowej probówki, która ma być później wykorzystana jako próbka wejściowa, co odpowiada około 1% całkowitej chromatyny użytej do ChIP. Przechowywać w temperaturze 4 °C do momentu, gdy próbki ChIP będą gotowe do odwrócenia usieciowania.
- Przenieś pozostałą chromatynę do nowej probówki. W przypadku eksperymentów ChIP-qPCR wymagających kontroli przeciwciał, rozprowadź równe objętości chromatyny do dwóch probówek.
- Dodaj przeciwciało klasy ChIP (lub odpowiadające mu przeciwciało kontrolne) do chromatyny. Jako przybliżoną wskazówkę użyj około 1 μg przeciwciała na milion komórek wyrażających interesujący nas epitop.
- Aby dokładniej oszacować ilość przeciwciał wymaganą w eksperymencie ChIP, należy przeprowadzić ten sam ChIP z różnymi ilościami przeciwciał (np. 0,25 μg, 1 μg i 2,5 μg) i porównać wydajność w ujemnych i pozytywnych loci kontrolnych za pomocą ChIP-qPCR (patrz sekcja 10). Jako kontrolę przeciwciał należy użyć normalnej surowicy o tym samym izotypie i gatunku zwierząt gospodarza co przeciwciało.
- Inkubować na rotatorze (10 obr./min) O/N w temperaturze 4 °C.
- Przemyć odpowiednią ilość kulek magnetycznych kompatybilnych z przeciwciałami raz E3 przez 5 minut w temperaturze 4 °C. Sprawdź specyfikację producenta dotyczącą zdolności wiązania przeciwciał przez kulki (zwykle 5 do 20 μl kulek wiąże 1 μg przeciwciała IgG).
- Dodaj umyte kulki do wstępnie inkubowanej chromatyny przeciwciała. Dalszą inkubację na rotatorze (10 obr./min) przez 4 godziny.
- Przemyć kulki czterokrotnie (ChIP-qPCR) lub dziesięć razy (ChIP-Seq) wstępnie schłodzonym buforem RIPA, a następnie raz wstępnie schłodzonym buforem TEN.
- Ten krok należy wykonać tylko w przypadku wykonywania eksperymentu ChIP-Seq.
- Ponownie zawiesić umyte kulki w 50 μl buforu TEN na probówkę. Zbierz wszystkie koraliki z jednego eksperymentu ChIP, przenosząc je do jednej nowej probówki. Użyj stojaka magnetycznego i schłodzonego (4 °C) wirowania o stężeniu 1 000 x g, aby zebrać kulki na dnie probówki. Wylej jak najwięcej płynu, nie naruszając osadu kulek.
- Usunąć materiał ChIP z kulek poprzez ponowne zawieszenie kulek w 50 do 100 μl buforu elucyjnego SDS i wirowanie ich w sposób ciągły za pomocą termomiksera (1 000 obr./min) przez 15 minut w temperaturze 65 °C. Następnie wirować z pełną prędkością (>15 000 x g) przez 30 sekund. Przenieść supernatant (eluat ChIP) do nowej probówki.
- Powtórz ostatni krok i połącz eluaty ChIP.
7. Odwrotne sieciowanie chromatyny i oczyszczanie DNA
- Dodać wystarczającą ilość buforu elucyjnego SDS do próbki wejściowej (krok 6.1), aby osiągnąć objętość próbki ChIP, która wynosi od 100 do 200 μl (etap 6.10). Uzupełnić zarówno ChIP, jak i próbki wejściowe o 1/20 objętości 5 M NaCl. Inkubować próbki przez 6-15 godzin (O/N) w temperaturze 65 °C w piecu do hybrydyzacji.
- Dodać 1 objętość buforu TE i RNazy A w stężeniu 200 μg/ml. Inkubować przez 1 godzinę w temperaturze 37 °C.
- Dodać proteinazę K w stężeniu 200 μg/ml. Inkubować przez 2-4 godziny w temperaturze 55 °C.
- Oczyść DNA przez ekstrakcję alkoholem fenol: chloroform: izoamyl, a następnie wytrącanie etanolu, jak opisano wcześniej9. W przypadku ChIP-Seq dodać 32 μl buforu elucyjnego (10 mM Tris-HCl, pH 8,5), aby rozpuścić osad DNA. Pozostaw próbki na lodzie na 30 minut, aby upewnić się, że DNA jest całkowicie rozpuszczone.
UWAGA: Komercyjne zestawy do oczyszczania PCR mają niższy odzysk DNA, ale są wygodniejsze i mogą być używane do próbek ChIP-qPCR. - W przypadku ChIP-Seq należy oznaczyć stężenie 1 μl ChIP i wprowadzić DNA za pomocą metod opartych na fluorometrii. Postępuj zgodnie z instrukcjami producenta i upewnij się, że stężenie DNA mieści się w niezawodnym zakresie wykrywania fluorometru.
8. Budowa i walidacja biblioteki ChIP-Seq
UWAGA: Obecne metody przygotowania biblioteki DNA pozwalają na budowę bibliotek o wysokim stopniu złożoności dla NGS od 1 do 2 ng. Kosztem pewnej złożoności, biblioteki mogą być wykonane z zaledwie 50 pg DNA (patrz Tabela Konkretnych Materiałów/Sprzętu). Użyj tej samej ilości DNA zarówno dla ChIP, jak i biblioteki wejściowej. Krótko mówiąc, aby stworzyć indeksowane (sparowane) biblioteki ChIP-Seq, ChIP i wejściowe DNA muszą zostać naprawione na końcu, ligowane do specjalnych adapterów (patrz Tabela Specyficznych Materiałów/Sprzętu), dobrane pod kątem rozmiaru i amplifikowane PCR.
- Postępuj zgodnie ze wskazówkami producenta, aby utworzyć biblioteki ChIP-Seq. Zobacz dyskusję, aby uzyskać dalsze zalecenia.
- Eluować każdą bibliotekę w 12 μl buforu elucyjnego i określić stężenie 1 μl każdej biblioteki ChIP i wejściowej za pomocą fluorometru. Spodziewaj się stężeń od 5 do 25 ng/μl. Należy rozważyć zmniejszenie liczby cykli PCR (mniej niż 18 cykli), jeśli stężenia są wyższe niż 25 ng/μl.
UWAGA: Dokładna kwantyfikacja jest kluczem do osiągnięcia optymalnych wyników NGS. Biblioteki o stężeniach tak niskich jak 1 ng/μl po 18 cyklach PCR mogą być sekwencjonowane, ale często mają mniejszą złożoność. - Użyj 1 μl biblioteki, aby określić rozkład wielkości fragmentów i sprawdzić, czy nie ma zanieczyszczenia dimerem adaptera (pasmo około 120 pz) za pomocą elektroforezy kapilarnej opartej na chipie. Powtórz odwracalne oczyszczanie unieruchamiające w fazie stałej ze stosunkiem kulek do próbki 1:1 (zamiast 1,6:1), jeśli biblioteka zawiera dimery adapterowe.
- Przeprowadzić qPCR na zwalidowanych loci kontroli dodatniej i ujemnej (patrz punkt 10), aby sprawdzić, czy obserwuje się podobne trendy wzbogacania DNA przed i po przygotowaniu biblioteki. Przesyłanie bibliotek zatwierdzonych przez kontrolę jakości do sekwencjonowania.
9. Analiza po sekwencjonowaniu i wizualizacja danych
UWAGA: Obecnie NGS jest często przeprowadzany przez wewnętrzne lub komercyjne urządzenia do sekwencjonowania (zobacz dyskusję, aby zapoznać się z niektórymi wytycznymi NGS). Standardowym wyjściem są pojedyncze lub wiele skompresowanych plików FASTQ (*.fastq.gz) skompresowanych przez gzip, przechowujących miliony odczytów sekwencjonowania. Zwykle odczyty multipleksowane są już oddzielone zgodnie z ich indeksem, a każdy odczyt zawiera identyfikator sekwencji i wynik kontroli jakości (Phred+33 dla Illumina 1.8+) dla każdego wywołania podstawowego. Takie podejście jest tylko jednym z wielu sposobów analizy danych NGS. Czytelnik jest zachęcany do sprawdzenia, czy któryś z poniższych wierszy poleceń wymaga zmian, ponieważ to pole szybko się rozwija, a aktualizacje są regularnie aktualizowane.
- Połącz skompresowane gzipem pliki FASTQ i sprawdź jakość danych sekwencjonowania za pomocą skryptu FastQC. Wykonaj to i większość poniższych poleceń zarówno dla ChIP, jak i wejściowych danych sekwencjonowania (przykłady pokazane dla ChIP) z terminala:
> cat /ścieżka/do/*.fastq.gz > ChIP.fastq.gz
>> Fastqc ChIP.fastq.gz
UWAGA: Surowe dane z pomyślnego sekwencjonowania biblioteki ChIP-Seq o wysokiej złożoności powinny przejść większość testów. Niepowodzenia wynikają głównie ze słabych przebiegów sekwencjonowania i artefaktów eksperymentalnych, takich jak stronnicza amplifikacja PCR lub zanieczyszczenie adaptera. Oczekuje się pewnego stopnia duplikacji (redundancji), ponieważ nadmiarowe odczyty mogą reprezentować wzbogacenie DNA >w dobrej wierze 21. Można jednak później ograniczyć znaczniki odczytu - koniec 5' lub odczyty - do jednego na parę podstaw, aby wyeliminować wszelkie nadmiarowe odczyty bez wpływu na czułość wykrywania pików (krok 9.4)21. - Wstępnie przetwarzaj dane sekwencjonowania w celu usunięcia zanieczyszczenia adaptera (homerTools trim -3 ), dopuszczając jedno niedopasowanie (-mis 1). Użyj pierwszych 20 zasad (indeksowanego) adaptera (5' do 3') proksymalnie do interesującego fragmentu DNA podczas ligacji (pokazano dla adaptera wymienionego w Tabeli Określonych Materiałów/Sprzętu).
> gzip -cd ChIP.fastq.gz | fastq_illumina_filter -vN > ChIP.fastq
> homerTools trim -3 GATCGGAAGAGCACACGTCT -mis 1 -min 36 ChIP.fastq
UWAGA: Usunięcie filtrowanych odczytów (>-N) jest wymagane domyślnie tylko w plikach FASTQ generowanych przez Illumina 1.8. Pomiń polecenie fastq_illumina_filter (np. '| fastq_illumina_filter –vN'), jeśli wersja starsza niż 1.8 wygenerowała identyfikator sekwencji. - Dopasuj wstępnie przetworzone odczyty do genomu referencyjnego (xenTro7) za pomocą Bowtie. Zachowaj tylko unikalnie zmapowane odczyty (-m 1) przy użyciu ustawień domyślnych, tj. maksymalnie dwóch niezgodności w pierwszych 28 bazach i łączny wynik jakości Phred+33 wszystkich niezgodności na odczyt wynoszący maksymalnie 70. Wyrównanie raportu w formacie SAM (-S). Zwiększ liczbę megabajtów na wątek (--chunkmbs), jeśli pamięć fragmentów jest wyczerpana:
> muszka -m 1 -S -p [# wątki] --chunkmbs [np. 200] xenTro7 ChIP.fastq.trimmed > ChIP.sam
UWAGA: Muszka domyślnie oczekuje wyników jakości Phred+33. Dołącz opcję -->phred64-quals, jeśli plik FASTQ został wygenerowany z wynikami jakości Phred+64 przez Illumina starszymi niż 1.8. - Użyj dwóch poleceń HOMER, aby przekształcić plik wyrównania (SAM) w plik bigWig (.bw):
> makeTagDirectory ChIP/ -single -tbp 1 ChIP.sam
> makeUCSCfile ChIP/ -bigWig /ścieżka/do/ genome.fa.fai -fsize 1e20 -norm 1e7 -o ChIP.bw
UWAGA: Transformacja wymaga indeksu rusztowania (>genome.fa.fai) genomu referencyjnego (krok 1.8). Tutaj profil jest ograniczony do jednego znacznika na parę bazową (-tbp 1) i znormalizowany do 10 milionów odczytów (-norm 1e7). bigWig jest jednym z preferowanych formatów do dynamicznej wizualizacji profili chromatyny za pomocą przeglądarki genomu, takiej jak IGV (krok 9.12). - Określ rozkład znaczników (-d ChIP/) w genomowych punktach orientacyjnych (np. +/- 10 kb z przedziałami 25 pz, -size 20000 -hist 25), takich jak miejsca rozpoczęcia transkrypcji (tss, przykład pokazany tutaj) i zakończenia (tts). Uruchom skrypt perl HOMER annotatePeaks.pl z adnotacjami Xenopus xenTro7 (krok 1.7):
> annotatePeaks.pl tss xenTro7 -rozmiar 20000 -hist 25 -d ChIP/ > ChIP_tagDensity.tss - Znajdź znaczące szczyty wzbogacenia DNA między ChIP (-t ChIP.sam) a Input (-c Input.sam) w genomie X. tropicalis za pomocą MACS2 z 1% odcięciem FDR (-q 0,01) i fragmentami DNA (po sonikacji) 200 bp (--bw=200) do budowy modelu. Dodaj flagę --broad do tego wiersza poleceń, jeśli spodziewasz się szerokiego rozkładu interesującej cechy chromatyny, takiej jak znaczniki histonów lub polimeraza RNA.
> macs2 callpeak -t ChIP.sam -c Input.sam -f SAM -n ChIP -g 1.4376e9 -q 0.01 --bw=200
UWAGA: Efektywna wielkość zespołu genomu >X. tropicalis v7.1 wynosi około 1,4376 miliarda bp (-g 1,4376e9). MACS2 generuje plik BED (ChIP_peaks.bed) zawierający piki wraz z ich lokalizacjami genomowymi. - Porównaj kilka profili chromatyny w postaci zgrupowanej mapy cieplnej:
- Utwórz macierz rozkładu znaczników z interesujących katalogów gęstości znaczników (-d ChIP/ other_ChIP/) w szczytach MACS2 (np. +/- 1 kb z przedziałami 25 bp, -size 2000 -hist 25 -ghist):
> annotatePeaks.pl ChIP_peaks.bed xenTro7 -rozmiar 2000 -hist 25 -ghist -d ChIP/ other_ChIP/ > ChIP.matrix - Użyj graficznego interfejsu użytkownika Cluster3, aby przesłać plik ChIP.matrix i hierarchicznie pogrupować te gęstości znaczników na podstawie minimalnej odległości euklidesowej do najbliższego środka ciężkości. Otwórz wygenerowany plik CTD w Java TreeView, aby zwizualizować klastrowanie.
- Utwórz macierz rozkładu znaczników z interesujących katalogów gęstości znaczników (-d ChIP/ other_ChIP/) w szczytach MACS2 (np. +/- 1 kb z przedziałami 25 bp, -size 2000 -hist 25 -ghist):
- Znajdź nowatorskie i wcześniej znane motywy opraw, które są wzbogacone na szczytach szczytów +/- 100 pz (-rozmiar 200). Za pomocą annotatePeaks.pl można mapować występowanie motywów i wykreślać gęstości motywów:
> findMotifsGenome.pl ChIP_peaks.bed xenTro7 ChIP_motifs/ -size 200 -p [# gwinty]
> annotatePeaks.pl ChIP_peaks.łóżko xenTro7 -m motif1.motif > ChIP_peaks.motif1
> annotatePeaks.pl ChIP_peaks.łóżko xenTro7 -m motif1.motif -rozmiar 800 -hist 25 > motif1.gęstość
UWAGA: Skrypt >findMotifsGenome.pl wnioskuje o wzbogaceniu na podstawie porównania z losowo wybranymi sekwencjami tła skoncentrowanymi na genach. Najbardziej wzbogacony motyw powieściowy jest zapisany w motif1.motif w formacie macierzy wag pozycji. Czytelnik jest zachęcany do poparcia tych wyników innymi metodami odkrywania motywów de novo, takimi jak cisFinder22 i MEME23. - Opisuj piki, obliczając ich odległość do najbliższego genu i określając ich znormalizowaną liczbę odczytów w oknach 400 bp (-size 400):
> annotatePeaks.pl ChIP_peaks.bed xenTro7 -size 400 -d ChIP/ Wejście/ > ChIP_peaks.genes - Podsumuj dane wyjściowe za pomocą następującego polecenia awk, aby wyświetlić liczbę (N), lokalizację i znormalizowaną liczbę odczytów poszczególnych (R) i wszystkich (LR) pików na najbliższy (docelowy) gen.
> awk 'BEGIN{ FS='\t' } $7 >= -5000 && $7 <= 1000 \
{ N[$8]+=1; R[$8]+=$9; LR[$8]=LR[$8]','$7'('$9')' } END{ for(i in N) \
{ print i '\t' N[i] '\t' R[i]' \t' substr(LR[i],2)}}' ChIP_peaks.genes > ChIP_peaks.summary
UWAGA: Liczba po> znaku $ odnosi się do numeru kolumny, który może wymagać modyfikacji, aby pasował do pliku ChIP_peaks.genes utworzonego w poprzednim kroku. Ten przykład skryptu odfiltrowuje szczyty powyżej 5 kb w górę i 1 kb w dół od TSS. $7, $8 i $9 odnoszą się odpowiednio do odległości do TSS, identyfikatora genu i znormalizowanej liczby odczytów na szczyt. - Przeprowadź analizę wzbogaconych warunków GO wśród genów docelowych w następujący sposób:
- Uruchom graficzny interfejs użytkownika Blast2GO z wiersza poleceń za pomocą Java Web Start (javaws)19.
> javaws http://blast2go.com/webstart/blast2go1000.jnlp - Postępuj zgodnie z instrukcjami programistów, aby przesłać plik adnotacji dla genów Xenopus (xenTro7.annot) wygenerowany w wersji 1.9.4 oraz płaski plik ze zidentyfikowanymi genami docelowymi. Upewnij się, że w obu plikach używane są te same identyfikatory genów.
- Uruchom graficzny interfejs użytkownika Blast2GO z wiersza poleceń za pomocą Java Web Start (javaws)19.
- Wizualizuj profile chromatyny, dodając pliki bigWig (ChIP.bw, Input.bw) i BED (ChIP_peaks.bed) do IGV jako ścieżki. Uzupełnij dane śladami RNA-Seq, jeśli są dostępne dla tego samego etapu rozwoju. Zapisz wyniki jako sesję.
- Użyj platform programistycznych R (www.r-project.org) lub MATLAB, aby dalej manipulować i wizualizować dane wygenerowane powyżej. Alternatywnie można wykreślić małe zestawy danych za pomocą programu Excel.
10. ChIP-qPCR do testowania ChIP i potwierdzania ChIP-Seq
- Za pomocą platformy on-line Primer3 zaprojektowano startery otaczające około 100 pz DNA w temperaturze 60 °C (Tm) zarówno dla dodatnich (specyficznych dla piku), jak i ujemnych loci kontrolnych. Potwierdź swoistość startera za pomocą wyszukiwania in silico PCR zaimplementowanego w przeglądarce genomu UCSC.
- Utworzyć 8-punktową krzywą wzorcową o trzykrotnych rozcieńczeniach, zaczynając od około 1% danych wejściowych lub zastosować metodę 2−ΔΔC(T) 8,24 do ilościowego określenia wzbogacenia DNA.
- Wykonaj PCR w czasie rzeczywistym w trzech próbkach technicznych dla wszystkich próbek, tj. ChIP, kontrolnych i, w razie potrzeby, próbek o krzywej standardowej.
- Wykreślić wzbogacenie DNA jako procent wejściowego DNA lub jako stosunek ChIP do próbki kontrolnej zarówno w dodatnich, jak i ujemnych loci kontrolnych.
Wyniki
Równoważne wyniki do tych przedstawionych tutaj są oczekiwane, jeśli protokół jest dobrze wykonany, a używane przeciwciało ma jakość klasy ChIP (zobacz dyskusję). Protokół ten umożliwia ekstrakcję jąder z zarodków Xenopus związanych formaldehydem i skuteczne ścinanie chromatyny za pomocą sonikacji (ryc. 1A-C). Chromatyna ścięta wykazuje asymetryczny rozkład fragmentów DNA głównie w zakresie od 100 do 1,000 pz i osiągający szczyt między 300 a 500 pz (ryc. 1C). Wymagane jest co najmniej 50 pg immunoprecypitowanego DNA, aby pomyślnie utworzyć indeksowaną bibliotekę ChIP-Seq z parami końcowymi z podobnymi wstawkami DNA (Figura 2A). Biblioteka powinna być w dużej mierze pozbawiona dimerów adapterowych, które można zobaczyć na elektroferogramie przy około 120 pz.
Po sekwencjonowaniu przez syntezę, wstępnie przetworzone odczyty są mapowane na genom (Rysunek 2B, C). W udanym eksperymencie z zarodkami X. tropicalis, zwykle od 50 do 70% odczytów pojedynczego końca 40 pz można zmapować jednoznacznie do zespołu genomu v7.1 z maksymalnie dwoma niezgodnościami. Podczas gdy odczyty wejściowe są dość równomiernie wyrównane w całym genomie, wyrównanie odczytów ChIP powoduje wzbogacenia specyficzne dla nici, które otaczają interesującą cechę chromatyny. Dzieje się tak, ponieważ wszystkie fragmenty są sekwencjonowane od końca 5' (Rysunek 2C)25. Rozszerzenie wyrównania w kierunku odczytu do średniego rozmiaru fragmentu pozwala uzyskać dokładne profile dla cech pojedynczej chromatyny, takich jak zdarzenia wiązania czynnika transkrypcyjnego. Te zajęcia DNA pojawiają się jako szczyty, gdy są wizualizowane w IGV lub dowolnej innej kompatybilnej przeglądarce genomu. Metody wywołujące szczyty, takie jak MACS, służą do określania lokalizacji tych szczytów (Rysunek 3A). W ten sposób w genomie X. tropicalis wyznaczono dziesiątki tysięcy miejsc wiązania dla czynników transkrypcyjnych T-box, takich jak VegT26. Eksperymenty ChIP-qPCR powinny potwierdzić lokalne wzbogacenie stwierdzone przez ChIP-Seq (Figura 3B).
Eksperymenty ChIP-Seq pozwalają na zbadanie cech chromatyny w całym genomie. Na przykład obliczenie rozkładu odczytu na elementach genomu, takich jak miejsca rozpoczęcia i zakończenia transkrypcji, może uwypuklić wszelkie preferencje dotyczące wiązań przestrzennych wokół genów (Figura 3C). Podobnie, mapa cieplna rozkładów odczytu w lokalizacjach pików jest używana do porównywania różnych cech chromatyny w skali całego genomu (ryc. 3D). Niektóre czynniki transkrypcyjne wiążą sekwencję DNA w sposób specyficzny. Analiza motywów de novo genomowego DNA leżącego u podstaw pików może uzyskać tego rodzaju informacje, w tym współwzbogacone motywy potencjalnych kofaktorów (ryc. 3E). Zdecydowana większość genów docelowych wykazuje zajętość DNA na niższym, a nie wyższym poziomie (Figura 3F). Ta cecha bezskalowa wydaje się być dość powszechna wśród czynników transkrypcyjnych i sugeruje, że tylko niewielka część docelowych genów jest bezpośrednio regulowana z biologicznym znaczeniem27,28. Analiza wzbogaconych terminów GO lub innych atrybutów, takich jak zróżnicowana ekspresja genów docelowych, może dodatkowo ujawnić wgląd w biologiczną funkcję cechy chromatyny w zarodku Xenopus (Figura 3G).
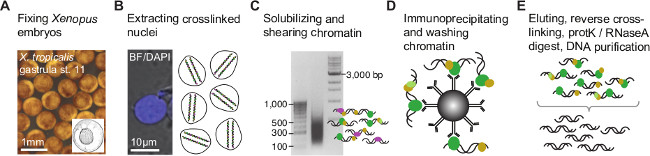
Rycina 1. Procedura immunoprecypitacji chromatyny dla zarodków Xenopus. (A) Zarodki są utrwalane formaldehydem na etapie rozwoju będącym przedmiotem zainteresowania w celu kowalencyjnego wiązania (sieciowania) wszelkich białek związanych z genomowym DNA. Po ekstrakcji jądrowej (B) usieciowana chromatyna ulega fragmentacji w celu zawężenia miejsc wiązania genomowego DNA lub modyfikacji chromatyny poprzez zminimalizowanie flankującej sekwencji DNA (C). Następnie fragmenty chromatyny są immunoprecypitowane przeciwciałem klasy ChIP w celu wzbogacenia tych zawierających epitop będący przedmiotem zainteresowania (D). Koimmunoprecypitowane DNA jest usuwane z białka i oczyszczane (E) przed utworzeniem biblioteki fragmentów ChIP dla NGS (ryc. 2). Kliknij tutaj, aby zobaczyć większą wersję tego rysunku.
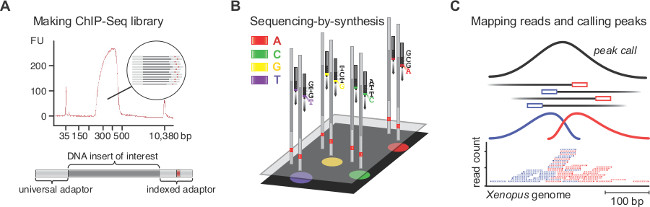
Rysunek 2. Przygotowanie biblioteki ChIP-Seq, sekwencjonowanie przez syntezę, mapowanie i wywoływanie pików. (A) Elektroferogram wykazuje dobrą bibliotekę ChIP-Seq z matrycami DNA o wielkości od 250 do 450 pz. Matryce te obejmują wkładkę DNA będącą przedmiotem zainteresowania otoczoną uniwersalnym (58 pz) i indeksowanym (63 pz) adapterem. (B) Miliony klastrów, z których każdy zawiera identyczne matryce, są sekwencjonowane zasada po zasadzie w obecności wszystkich czterech nukleotydów posiadających odwracalne, odrębne właściwości fluoroforowe i identyczne właściwości terminacji. Obrazy fluorescencyjne są przetwarzane w czasie rzeczywistym w celu wywołania odpowiednich baz, które ostatecznie są łączone w odczyty. (C) Przechowywane są tylko te odczyty, które są jednoznacznie odwzorowane na genomie Xenopus. Ponieważ wszystkie fragmenty są sekwencjonowane od końca 5', mapowanie odczytów ChIP skutkuje pikami specyficznymi dla nici, które otaczają interesującą cechę chromatyny. W ten sposób osoby wywołujące szczyt wykrywają wzbogacenie pochodzące z immunoprecypitacji i rozszerzają odczyty do średniej długości fragmentu, aby dokładnie zlokalizować cechy chromatyny. Kliknij tutaj, aby zobaczyć większą wersję tego rysunku.
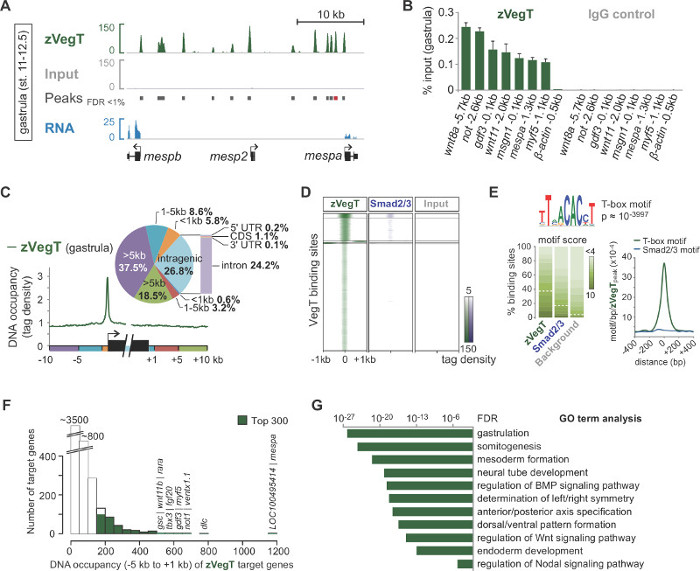
Rysunek 3. Przykład analizy po sekwencjonowaniu i wizualizacji danych za pomocą zygotycznego czynnika transkrypcyjnego T-box VegT (zVegT). Wszystkie pokazane tutaj liczby odczytów są znormalizowane do 10 milionów unikatowych i nienadmiarowych odczytów. (A) Wyciąg z całego genomu profilu wiązania zVegT w zarodkach X. tropicalis gastrula (stadium 11 do 12,5 za Nieuwkoopem i Faberem29). Każdy szczyt, nagromadzenie rozszerzonych odczytów, reprezentuje jedno miejsce wiązania. Te piki są wywoływane przez MACS2 ze wskaźnikiem fałszywych odkryć (FDR) mniejszym niż 1%. Każdy gen mesp wykazuje bardzo proksymalne i poprzedzające wiązanie zVegT, ale tylko mespa i mespb ulegają ekspresji na tym etapie (dane RNA-Seq30). (B) Poziomy zajętości DNA zVegT określone za pomocą ChIP-qPCR w kilku loci (w tym w niezwiązanym regionie 0,5 kb przed β-aktyną) potwierdzają specyficzne wzbogacenie stwierdzone przez ChIP-Seq. Porównaj wyniki dla mespa z pikiem zwanym (czerwony pasek) w (A). Poziom zajętości DNA jest wizualizowany jako procent danych wejściowych zarówno dla ChIP z przeciwciałem VegT (króliczy poliklonalny izotyp IgG), jak i ChIP z kontrolą przeciwciała (normalna królicza IgG). Słupki błędów odzwierciedlają odchylenie standardowe dwóch kontrprób biologicznych. (C) Analiza metagenów wykazuje preferencyjne wiązanie zVegT (znaczniki zgrupowane powyżej 25 pz) z promotorem w stosunku do dowolnego innego regionu genomowego wokół i w obrębie ciał genów. (D) Mapa cieplna pokazuje k-średnie, zgrupowane (k = 5) poziomy zajętości DNA (znaczniki podzielone na ponad 25 pz) zVegT i Smad2/Smad3 (dane ChIP-Seq31) w odniesieniu do wszystkich regionów związanych z zVegT na etapie gastruli. Mapa cieplna jest oparta na logarytmie2 i wyśrodkowana na 5 znacznikach na pz. (E) Analiza motywu de novo odkrywa kanoniczny motyw wiążący czynnik transkrypcyjny T-box w 38% regionów związanych z zVegT, jeśli podstawowy wynik motywu jest znormalizowany do 5% współczynnika odkrywania w sekwencjach tła. Mapa gęstości wykazuje największe wzbogacenie dla motywu T-box w centrum miejsc wiązania zVegT, podczas gdy kanoniczny motyw wiązania Smad2/Smad3 jest prawie nieznacznie wzbogacony. (F) Histogram pokazuje poziomy zajętości DNA zVegT, które są obliczane dla każdego genu docelowego ze wszystkich pików (+/- 200 pz) między 5 kb w górę [-] a 1 kb w dół [+] odpowiednich miejsc rozpoczęcia transkrypcji. (G) 300 pierwszych genów o najwyższych poziomach zajętości DNA w zakresie od -5 kb do +1 kb jest wzbogaconych o procesy biologiczne wczesnego rozwoju embrionalnego. Te warunki GO są zgodne z przypuszczalną funkcją zVegT. FDR opiera się na dokładnym teście Fishera z dwoma stronami i jest skorygowany o wielokrotne testy. Kliknij tutaj, aby zobaczyć większą wersję tego rysunku.
Dyskusja
Nasz protokół określa, w jaki sposób tworzyć i analizować profile chromatyny całego genomu z zarodków Xenopus . Obejmuje on każdy etap, od sieciowania białek przez endogenne loci in vivo , po przetwarzanie milionów odczytów reprezentujących wzbogacone miejsca genomowe in silico. Ponieważ dostępnych jest coraz więcej szkiców genomu, protokół ten powinien mieć zastosowanie do innych organizmów modelowych i niemodelowych. Najważniejszą sekcją eksperymentalną, która odróżnia ten protokół od poprzednich prac8,31,33,34, jest procedura po utrwaleniu w celu ekstrakcji usieciowanych jąder. Ułatwia wydajną solubilizację i ścinanie chromatyny oraz łatwe skalowanie. Wraz z poprawą wydajności przygotowania biblioteki, protokół ten pozwala na budowę bibliotek ChIP-Seq o wysokiej złożoności od pół do dwóch milionów komórek eksprymujących epitop związany z chromatyną, który jest przedmiotem zainteresowania. W przypadku eksperymentów ChIP-qPCR zwykle wystarcza kilkadziesiąt tysięcy tych komórek, aby sprawdzić wzbogacenie DNA w być może sześciu różnych loci genomu. Liczby te są ostrożnymi szacunkami, ale mogą się różnić w zależności od poziomu ekspresji białka, jakości przeciwciał, skuteczności sieciowania i dostępności epitopów. Jako wskazówkę, pojedynczy zarodek Xenopus zawiera około 4000 komórek w środkowym stadium blastuli (8,5 za Nieuwkoopem i Faberem29), 40 000 komórek w późnym stadium gastruli (12) i 100 000 komórek we wczesnym stadium pąka ogonowego (20).
Dokładny czas wiązania dla skutecznej immunoprecypitacji należy określić empirycznie za pomocą ChIP-qPCR (sekcja 10). Ogólnie rzecz biorąc, dłuższe czasy fiksacji są wymagane, jeśli eksperyment obejmuje zarodki X. laevis , wczesne stadia rozwojowe i słabe (lub pośrednie) właściwości wiązania DNA. Nie zaleca się jednak utrwalania zarodków Xenopus dłużej niż 40 minut lub przetwarzania większej liczby zarodków niż wskazano (punkt 3), ponieważ ścinanie chromatyny staje się mniej efektywne. Ważne jest, aby nie używać glicyny po utrwaleniu, ponieważ ten powszechny etap gaszenia formaldehydu może bardzo utrudnić ekstrakcję jądrową z zarodków bogatych w żółtko. Obecnie przyczyna takiego stanu rzeczy nie jest znana. Można sobie wyobrazić, że addukt formaldehyd-glicyna dalej reaguje z N-końcowymi grupami aminowymi lub resztami argininy35.
Przeciwciało ma kluczowe znaczenie w każdym eksperymencie ChIP i należy przeprowadzić wystarczające kontrole, aby wykazać jego specyficzność dla epitopu będącego przedmiotem zainteresowania (patrz wytyczne Landta i wsp.36). Jeśli nie jest dostępne przeciwciało klasy ChIP, wprowadzenie odpowiednich białek fuzyjnych znakowanych epitopami może być uzasadnioną alternatywą, ponieważ białka te mogą zajmować endogenne miejsca wiązania37. W takim przypadku zarodki, którym nie wstrzyknięto, najlepiej stosować jako kontrolę negatywną, a nie ChIP z niespecyficzną surowicą. Strategia ta może być również zastosowana, jeśli białko będące przedmiotem zainteresowania ulega ekspresji na niskich poziomach, co skutkuje słabym odzyskiwaniem wzbogaconego DNA.
Jeśli chodzi o tworzenie bibliotek ChIP-Seq, ze względu na niewielką ilość używanego DNA, zaleca się wybór procedur, które zmniejszają liczbę etapów czyszczenia i łączą reakcje, aby zminimalizować utratę DNA. Adaptery i startery muszą być kompatybilne z sekwencjonowaniem multipleksowym i platformą NGS (patrz Tabela Specyficznych Materiałów/Sprzętu). W przypadku korzystania z adapterów Y (zawierających długie jednoniciowe ramiona), bardzo ważne jest, aby wstępnie amplifikować bibliotekę trzema do pięciu rundami PCR przed wyborem rozmiaru wstawek DNA (np. 100 do 300 pz) za pomocą elektroforezy żelowej. Jednoniciowe końce powodują niejednorodną migrację fragmentów DNA. Zaleca się przeprowadzenie prób z różnymi ilościami wejściowego DNA (np. 0,1, 0,5, 1, 2, 5, 10 i 20 ng) w celu określenia całkowitej liczby cykli PCR (mniejszej lub równej 18 cyklom) wymaganych do stworzenia biblioteki o wybranej wielkości od 100 do 200 ng. Zmniejszenie liczby cykli PCR sprawia, że sekwencjonowanie nadmiarowych odczytów jest mniej prawdopodobne. Odwracalne kulki immobilizacyjne w fazie stałej są dobrymi odczynnikami czyszczącymi, które skutecznie odzyskują interesujące DNA i niezawodnie usuwają wszelkie wolne adaptory i dimery z reakcji ligacji i PCR.
Jeśli chodzi o liczbę, rodzaj i długość odczytów, około 20 do 30 milionów odczytów pojedynczych końcówek o długości 36 pz wystarczy, aby większość eksperymentów ChIP-Seq pokryła cały genom Xenopus z wystarczającą głębokością. Najbardziej rozpowszechnione maszyny NGS są rutynowo w stanie spełnić te kryteria. Jednak korzystne może być zwiększenie liczby odczytów, jeśli oczekuje się szerokiego rozkładu odczytów, jak obserwuje się w przypadku modyfikacji histonów, a nie ostrych pików. W przypadku wielu eksperymentów ChIP-Seq 4 do 5 różnie indeksowanych bibliotek można połączyć i zsekwencjonować w jednym torze komórek przepływowych przy użyciu wysokowydajnej maszyny NGS. Czasami zaleca się również wydłużenie długości odczytu i sekwencjonowanie obu końców matrycy DNA (sparowany koniec) w celu zwiększenia podatności na mapowanie podczas analizy chromatyny w powtarzalnych regionach genomu.
Protokół ten został z powodzeniem zastosowany do szerokiej gamy cech chromatyny, takich jak czynniki transkrypcyjne, mediatory sygnałowe i potranslacyjne modyfikacje histonów. Jednak w miarę rozwoju zarodki nabywają coraz większego stopnia heterogeniczności komórkowej, a profile chromatyny stają się trudniejsze do interpretacji. U rzodkiewnika i Drosophila poczyniono obiecujące kroki w celu specyficznego dla tkanek profilowania krajobrazów chromatyny poprzez ekstrakcję jąder specyficznych dla typu komórki38,39. Nasz protokół obejmuje etap ekstrakcji jądrowej, który może utorować drogę do specyficznego tkankowo ChIP-Seq w innych zarodkach.
Oświadczenia
Autorzy oświadczają, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
Dziękujemy Chrisowi Bennerowi za implementację genomu X. tropicalis (xenTro2, xenTro2r) do HOMER oraz laboratorium Gilchrista za dyskusje na temat analizy po sekwencjonowaniu. I.P. asystował przy analizie terminologicznej GO. G.E.G i J.C.S. były wspierane przez Wellcome Trust, a obecnie są wspierane przez Radę ds. Badań Medycznych (program numer U117597140).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Stożkowa mikrokońcówka 1/16 cala | Qsonica | 4417 | Ta mikrokońcówka jest kompatybilna z Sonicator 3000 firmy Misonix i Q500/700 firmy Qsonica. |
| 8 ml szklana fiolka na próbkę z nakrętką | Wheaton | 224884 | ml fiolki na próbki z przezroczystego szkła do próbek wodnych z nakrętkami wyłożonymi kauczukiem fenolowym w rozmiarze 15-425. |
| Adapter | np. uniwersalny IDT lub Sigma | NA | TruSeq,
AATGATACGGCGACCACCGAG ATCTACACTCTTTCCCTACAC GACGCTCTTCCGATC*T. Adapter indeksowany TruSeq, P-GATCGGAAGAGCACACGTC TGAACTCCAGTCAC ‐ NNNNNN‐ ATCTCGTATGCCGTCTCT TCTGCTT*G. *, grupa fosforanowo-fosforanowa wiązania w 5' koniec. NNNNNN, indeks (patrz Przewodnik przygotowania próbki TruSeq ChIP dla sekwencji DNA). Zamów adaptery oczyszczone HPLC. Adaptery można przygotować, łącząc ilości równomolowe (każde 100 µ M) adaptera uniwersalnego i indeksowanego i schładzanie ich powoli od 95 ° C do temperatury pokojowej. Użyć 1,5 pmol na ng wejściowego DNA. Przechowywać w temperaturze -20 °C. |
| b2g4pipe (oprogramowanie) | Blast2GO | niekomercyjne | http://www.blast2go.com/data/blast2go/b2g4pipe_v2.5.zip |
| BLAST+ (oprogramowanie) | Camacho et al. | niekomercyjne | http://blast.ncbi.nlm.nih.gov/Blast.cgi?PAGE_TYPE=BlastDocs& DOC_TYPE=Pobierz |
| Bowtie (oprogramowanie) | Langmead et al. | niekomercyjne | http://bowtie-bio.sourceforge.net/index.shtml |
| cisFinder (oprogramowanie) | Sharov et al. | niekomercyjny | http://lgsun.grc.nia.nih.gov/CisFinder/ |
| Chip do elektroforezy kapilarnej | Agilent Technologies | 5067-1504 | Załaduj ten chip za pomocą 1 µ l DNA do kontroli jakości biblioteki. Przechowywać w temperaturze 4 stopni Celsjusza. |
| System elektroforezy kapilarnej oparty na chipach | Agilent Technologies | G2940CA | Agilent 2100 BioAnalyzer służy do sprawdzania jakości bibliotek ChIP-Seq. Przechowywać odczynniki w temperaturze 4 stopni Celsjusza. |
| Zestaw do przygotowania biblioteki ChIP-Seq (KAPA Hyper Prep Kit) | Zestaw Kapa Biosystems | KK8504 | zawiera mieszankę enzymów naprawczych i ogoniastych KAPA końca, bufor naprawczy i ogoniasty A, ligazę DNA, bufor ligacyjny, KAPA HiFi HotStart ReadyMix (2X) oraz mieszankę starterów wzmacniających bibliotekę KAPA (10X) (patrz także startery PCR). Adaptery nie są dołączone. Przechowywać w temperaturze -20 stopni Celsjusza. |
| Zestaw do przygotowania biblioteki ChIP-Seq (alternatywny, zestaw przygotowawczy ThruPLEX-FD) | Zestaw Rubicon Genomics | R40048 | wykorzystuje własne adaptery i startery pętli trzpienia. Ten zestaw eliminuje pośrednie etapy oczyszczania i jest tak samo czuły jak zestaw KAPA Hyper Prep Kit. Przechowywać w temperaturze -20 stopni Celsjusza. |
| Cluster3 (software) | de Hoon et al. | niekomercyjne | http://bonsai.hgc.jp/~mdehoon/software/cluster |
| FastQC (oprogramowanie) | Simon Andrews | niekomercyjne | http://www.bioinformatics.babraham.ac.uk/projects/fastqc |
| Technologie żywotności | fluorometru | Q32866 | Fluorometr Qubit 2.0 Odczynniki do fluorometrów |
| Technologie żywotności | Q32851 | Zestaw zawiera skoncentrowany odczynnik testowy, bufor rozcieńczający i wstępnie rozcieńczone wzorce DNA dla fluorometru Qubit. Przechowuj wzorce DNA w temperaturze 4 stopni; C, bufor i barwnik w temperaturze pokojowej. | |
| Formaldehyd | Sigma | F8775-4X25ML | Roztwór formaldehydu, do biologii molekularnej, 36,5-38% w H2O, stabilizowany 10-15% metanolem. Przechowywać w temperaturze pokojowej. UWAGA: Formaldehyd jest i wysoce toksyczny. |
| Żel (E-Gel EX agaroza, 2%) | life technologies | G4010 | Pre-cast gel z 11 dołkami, otwierany format. Pozostaw jeden pas między drabiną a biblioteką pusty, aby uniknąć zanieczyszczenia krzyżowego. Przechowuj żele w temperaturze pokojowej. |
| Technologie żywotności | systemu elektroforezy żelowej | G6465 | E-Gel iBase i zestaw combo E-Gel Safe Imager do wyboru rozmiaru bibliotek ChIP-Seq. |
| Zestaw do ekstrakcji żelu | Qiagen | 28706 | Przechowuj wszystkie odczynniki w temperaturze pokojowej. Użyj 500 &mikro; l buforu QG na 100 mg 2% plastra żelu agarozowego w celu ekstrakcji DNA. Użyj kolumn MinElute (z zestawu do oczyszczania MinElute PCR), aby dwukrotnie wymyć DNA. |
| HOMER (oprogramowanie) | Chris Benner | niekomercyjny | http://homer.salk.edu/homer/index.html |
| Piec do hybrydyzacji | Techne | FHB1D | Hybridizer HB-1D |
| IGV (oprogramowanie) | Robinson et al. | niekomercyjny | filtr jakości http://www.broadinstitute.org/igv/home |
| Illumina CASAVA-1.8 (oprogramowanie) | Assaf Gordon | niekomercyjny | http://cancan.cshl.edu/labmembers/gordon/fastq_illumina_filter |
| Java TreeView (oprogramowanie) | Alok Saldanha | niekomercyjny | |
| http://jtreeview.sourceforge.net Podnośnik laboratoryjny | Edu-Lab | CH0642 | To gniazdo służy do podnoszenia próbki w obudowie dźwiękowej w celu sonizacji. |
| Drabina, 100 pz | New England BioLabs | N3231 | Przechowywać 1x roztwór w temperaturze pokojowej. Przechowywać zapasy w temperaturze -20 stopni Celsjusza. |
| Drabina, 1 kb | New England BioLabs | N3232 | Przechowywać 1x roztwór w temperaturze pokojowej. Przechowywać zapasy w temperaturze -20 stopni Celsjusza. |
| Probówki wirówkowe o niskiej retencji 1,5 ml | życia | AM12450 | nieprzywierające, wolne od RNaz probówki do mikrofugowania, 1,5 ml |
| MACS2 (oprogramowanie) | Tao Liu | niekomercyjne | https://github.com/taoliu/MACS |
| Kulki magnetyczne | technologie życia | 11201D | Te Dynabeads to superparamagnetyczne kulki o powinowactwie, oczyszczone poliklonalne owce anty-mysie IgG kowalencyjnie związane z powierzchnią koralika. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Kulki magnetyczne | technologie życia | 11203D | Te Dynabeads są superparamagnetycznymi kulkami o powinowactwie, oczyszczonymi poliklonalnymi owcami anty-króliczymi IgG kowalencyjnie związanymi z powierzchnią koralika. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Kulki magnetyczne | technologie życia | 10001D | Te Dynabeads to superparamagnetyczne kulki z rekombinowanym białkiem A kowalencyjnie związanym z powierzchnią koralika. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Kulki magnetyczne | technologie życia | 10003D | Te koraliki Dynabeads to superparamagnetyczne kulki z rekombinowanym białkiem G kowalencyjnie związanym z powierzchnią koralika. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Technologie żywotności | stojaków magnetycznych | 12321D | Magnes DynaMag-2 |
| MEME | Bailey i wsp. | niekomercyjne | http://meme.nbcr.net/meme/ |
| Na3VO4 | New England BioLabs | P0758 | Ortowanadan sodu (100 mM) jest powszechnie stosowanym ogólnym inhibitorem białkowych fosfataz fosfatyrozylowych. Przechowywać w temperaturze -20 stopni Celsjusza. |
| NaF | New England BioLabs | P0759 | Fluorek sodu (500 mM) jest powszechnie stosowany jako ogólny inhibitor fosfataz fosfosferyloowych i fosfotreonylowych. Przechowywać w temperaturze -20 stopni Celsjusza. |
| Maszyna NGS | Illumina | SY-301-1301 | Analizator genomu IIx |
| Maszyna NGS (wysoka wydajność) | Illumina | SY-401-2501 | HiSeq |
| Normalna surowica (kontrola przeciwciał) | Santa Cruz Biotechnology | sc-2028 | Stosować jako kontrolę kozich przeciwciał poliklonalnych IgG w eksperymentach ChIP-qPCR. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Normalna surowica (kontrola przeciwciał) | Santa Cruz Biotechnology | sc-2025 | Stosować jako kontrolę mysich przeciwciał poliklonalnych IgG w eksperymentach ChIP-qPCR. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Normalna surowica (kontrola przeciwciał) | Santa Cruz Biotechnology | sc-2027 | Stosować jako kontrolę dla króliczych przeciwciał poliklonalnych IgG w eksperymentach ChIP-qPCR. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Roztwór do barwienia kwasów nukleinowych | iNtRON | 21141 | Użyj roztworu do barwienia kwasów nukleinowych RedSafe w stosunku 1:50 000. Przechowywać w temperaturze pokojowej. |
| Sól | Sigma | O3756-25G | . Przechowywać w temperaturze 4 stopni Celsjusza. |
| Startery PCR | , np. IDT lub Sigma | Primers do wzbogacania fragmentów DNA ligowanych adaptorowo metodą PCR: AATGATACGGCGACCGA*G i CAAGCAGAAGACGGCATACGA*G, wiązanie fosforotionowe. Podkłady zaprojektowane przez Ethana Forda. Połącz podkłady w 5 &mikro; M każdy. Użyj 5 i mikro; l w 50 & mikro; l Reakcja PCR. Przechowywać w temperaturze -20 stopni Celsjusza. | |
| Zestaw do oczyszczania MinElute PCR | Qiagen | 28006 | do oczyszczania ChIP-qPCR i ścinania próbek testowych. Przechowuj kolumny wirujące MinElute w temperaturze 4 & stopni; C, wszystkie inne i probówki zbiorcze w temperaturze pokojowej. |
| Fenol:Chloroform:alkohol izoamylowy (25:24:1, pH 7,9) | life technologies | AM9730 | Fenol:Chloroform:IAA (25:24:1) jest wstępnie zmieszany i dostarczany w pH 6,6. Użyj dostarczonego buforu alkalicznego Tris, aby podnieść pH do 7,9. Przechowywać w temperaturze 4 stopni Celsjusza. UWAGA: fenol:chloroform:alkohol izoamylowy jest, wysoce toksyczny i palny. |
| Primer3 (oprogramowanie) | Steve Rozen & Helen Skaletsky | niekomercyjne | tabletki |
| http://biotools.umassmed.edu/bioapps/primer3_www.cgi inhibitora proteazy | Roche | 11836170001 | cOmplete, Mini, wolne od EDTA. Stosować 1 tabletkę na 10 ml. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Tabletki z inhibitorem proteazy | Roche | 11873580001 | cOmplete, wolne od EDTA. Stosować 1 tabletkę na 50 ml. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Proteinaza K | life technologies | AM2548 | roztwór proteinazy K (20 &mikro; g/&mikro; l). Przechowywać w temperaturze -20 stopni Celsjusza. |
| Technologie życia | RNazy A | 12091-039 | RNaza A (20 &mikro; g/&mikro; Przechowywać w temperaturze pokojowej. |
| Rotator | Stuart | SB3 | Rotator SB3 |
| SAMtools (oprogramowanie) | Li i wsp. | Niekomercyjne | http://samtools.sourceforge.neta |
| Odwracalne kulki unieruchamiające w fazie stałej | Beckman Coulter | A63882 | Koraliki Agencourt AMPure XP są stosowane w celu zminimalizowania zanieczyszczenia dimerów adapterów w bibliotekach ChIP-Seq. Przechowywać w temperaturze 4 stopni Celsjusza. |
| Sonicator 3000 | Misonix/Qsonica | Nowsze modele są już dostępne. Q125, Q500 lub Q700 nadają się do ścinania usieciowanej chromatyny. | |
| Obudowa dźwiękochłonna | Misonix/Qsonica | opcjonalna: postępuj zgodnie z zaleceniami producenta, aby uzyskać odpowiednią obudowę dźwiękochłonną. | |
| Thermomixer | eppendorf | 22670000 | Termomixer do probówek 24 x 1,5 mL. Precyzyjna regulacja temperatury od 4 & deg; C powyżej temperatury pokojowej do 99 °C. |
Bibliografia
- Gilmour, D. S., Lis, J. T. Detecting protein-DNA interactions in vivo: distribution of RNA polymerase on specific bacterial genes. Proc Natl Acad Sci U S A. 81 (14), 4275-4279 (1984).
- Gilmour, D. S., Lis, J. T. In vivo interactions of RNA polymerase II with genes of Drosophila melanogaster. Mol Cell Biol. 5 (8), 2009-2018 (1985).
- Solomon, M. J., Larsen, P. L., Varshavsky, A. Mapping protein-DNA interactions in vivo with formaldehyde: evidence that histone H4 is retained on a highly transcribed gene. Cell. 53 (6), 937-947 (1988).
- Ren, B., et al. Genome-wide location and function of DNA binding proteins. Science. 290 (5500), 2306-2309 (2000).
- Johnson, D., Mortazavi, A., Myers, R., Wold, B. Genome-wide mapping of in vivo protein-DNA interactions. Science. 316 (5830), 1497-1502 (2007).
- Hellsten, U., et al. The genome of the Western clawed frog Xenopus tropicalis. Science. 328 (5978), 633-636 (2010).
- Lee, T. I., Johnstone, S. E., Young, R. A. Chromatin immunoprecipitation and microarray-based analysis of protein location. Nature Protocols. 1 (2), 729-748 (2006).
- Blythe, S. A., Reid, C. D., Kessler, D. S., Klein, P. S. Chromatin immunoprecipitation in early Xenopus laevis embryos. Dev Dyn. 238 (6), 1422-1432 (2009).
- Gentsch, G. E., Smith, J. C. Investigating physical chromatin associations across the Xenopus genome by chromatin immunoprecipitation. Cold Spring Harb Protoc. 2014 (5), (2014).
- Ubbels, G. A., Hara, K., Koster, C. H., Kirschner, M. W. Evidence for a functional role of the cytoskeleton in determination of the dorsoventral axis in Xenopus laevis eggs. J Embryol Exp Morphol. 77, 15-37 (1983).
- Langmead, B., Trapnell, C., Pop, M., Salzberg, S. L. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biol. 10 (3), R25(2009).
- Li, H., et al. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Heinz, S., et al. Simple combinations of lineage-determining transcription factors prime cis-regulatory elements required for macrophage and B cell identities. Mol Cell. 38 (4), 576-589 (2010).
- Zhang, Y., et al. Model-based analysis of ChIP-Seq (MACS). Genome Biol. 9 (9), R137(2008).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Thorvaldsdottir, H., Robinson, J. T., Mesirov, J. P. Integrative Genomics Viewer (IGV): high-performance genomics data visualization and exploration. Brief Bioinform. 14 (2), 178-192 (2013).
- Imoto, S., Nolan, J., Bioinformatics Miyano, S. 20 (9), 1453-1454 (2004).
- Camacho, C., et al. BLAST+: architecture and applications. BMC Bioinformatics. 10, 421(2009).
- Conesa, A., et al. Blast2GO: a universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Sive, H., Grainger, R., Harland, R. Early development of Xenopus laevis: A laboratory manual. , Cold Spring Harbor Laboratory Press. Cold Spring Harbor, New York. (2000).
- Chen, Y., et al. Systematic evaluation of factors influencing ChIP-seq fidelity. Nat Methods. 9 (6), 609-614 (2012).
- Sharov, A. A., Ko, M. S. H. Exhaustive search for over-represented DNA sequence motifs with CisFinder. DNA Res. 16 (5), 261-273 (2009).
- Bailey, T. L., et al. MEME SUITE: tools for motif discovery and searching. Nucl Acids Res. 37 (2), W202-W208 (2009).
- Livak, K. J., Schmittgen, T. D. Analysis of relative gene expression data using real-time quantitative PCR and the 2(-Delta Delta C(T)) Method. Methods. 25 (4), 402-408 (2001).
- Park, P. J. ChIP-seq: advantages and challenges of a maturing technology. Nat Rev Genet. 10 (10), 669-680 (2009).
- Gentsch, G. E., et al. In vivo T-box transcription factor profiling reveals joint regulation of embryonic neuromesodermal bipotency. Cell Rep. 4 (6), 1185-1196 (2013).
- Barabasi, A. L., Oltvai, Z. N. Network biology: understanding the cell's functional organization. Nat Rev Genet. 5 (2), 101-113 (2004).
- Biggin, M. D. Animal transcription networks as highly connected, quantitative continua. Dev Cell. 21 (4), 611-626 (2011).
- Nieuwkoop, P. D., Faber, J. Normal table of Xenopus laevis (Daudin): a systematical and chronological survey of the development from the fertilized egg till the end of metamorphosis. , Garland. New York & London. (1994).
- Akkers, R. C., et al. A hierarchy of H3K4me3 and H3K27me3 acquisition in spatial gene regulation in Xenopus embryos. Dev Cell. 17 (3), 425-434 (2009).
- Yoon, S. J., Wills, A. E., Chuong, E., Gupta, R., Baker, J. C. HEB and E2A function as SMAD/FOXH1 cofactors. Genes Dev. 25 (15), 1654-1661 (2011).
- Jallow, Z., Jacobi, U. G., Weeks, D. L., Dawid, I. B., Veenstra, G. J. Specialized and redundant roles of TBP and a vertebrate-specific TBP paralog in embryonic gene regulation in Xenopus. Proc Natl Acad Sci U S A. 101 (37), 13525(2004).
- Buchholz, D. R., Paul, B. D., Shi, Y. -B. Gene-specific changes in promoter occupancy by thyroid hormone receptor during frog metamorphosis. Implications for developmental gene regulation. J Biol Chem. 280 (50), 41222-41228 (2005).
- Wills, A. E., Guptaa, R., Chuonga, E., Baker, J. C. Chromatin immunoprecipitation and deep sequencing in Xenopus tropicalis and Xenopus laevis. Methods. 66 (3), 410-421 (2014).
- Metz, B., et al. Identification of formaldehyde-induced modifications in proteins: reactions with model peptides. J Biol Chem. 279 (8), 6235-6243 (2004).
- Landt, S. G., et al. ChIP-seq guidelines and practices of the ENCODE and modENCODE consortia. Genome Res. 22 (9), 1813-1831 (2012).
- Mazzoni, E. O., et al. Embryonic stem cell-based mapping of developmental transcriptional programs. Nat Methods. 8 (12), 1056-1058 (2011).
- Deal, R. B., Henikoff, S. A simple method for gene expression and chromatin profiling of individual cell types within a tissue. Dev Cell. 18 (6), 1030-1040 (2010).
- Bonn, S., et al. Tissue-specific analysis of chromatin state identifies temporal signatures of enhancer activity during embryonic development. Nat Genet. 44 (2), 148-156 (2012).
Przedruki i uprawnienia
