Ten artykuł przedstawia czułą metodę o nazwie Circle-Seq do oczyszczania pozachromosomalnego kolistego DNA (eccDNA). Metoda obejmuje oczyszczanie kolumny, usuwanie pozostałego liniowego chromosomalnego DNA, amplifikację w okręgu toczonym i sekwencjonowanie wysokoprzepustowe. Circle-Seq ma zastosowanie do badań przesiewowych eukariotycznego eccDNA w skali genomu oraz badania niestabilności genomu i zmienności liczby kopii.
Artykuł metodologiczny
Oczyszczanie całego genomu pozachromosomalnego kolistego DNA z komórek eukariotycznych
W tym artykule
Podsumowanie
Streszczenie
Pozachromosomalne koliste DNA (eccDNAs) są powszechnymi elementami genetycznymi u Saccharomyces cerevisiae i są również opisywane u innych eukariontów. ECCDN przyczyniają się do zmienności genetycznej między komórkami somatycznymi w organizmach wielokomórkowych oraz do ewolucji jednokomórkowych eukariontów. Potrzebne są czułe metody wykrywania eccDNA, aby wyjaśnić, w jaki sposób te elementy wpływają na stabilność genomu oraz w jaki sposób czynniki środowiskowe i biologiczne indukują ich powstawanie w komórkach eukariotycznych. Ten film przedstawia czułą metodę oczyszczania eccDNA o nazwie Circle-Seq. Metoda obejmuje oczyszczanie kolumnowe z kolistego DNA, usuwanie pozostałego liniowego chromosomalnego DNA, amplifikację eccDNA w toczonym okręgu, głębokie sekwencjonowanie i mapowanie. Intensywne leczenie egzonukleazą było konieczne w celu uzyskania wystarczającej liniowej degradacji chromosomalnego DNA. Wzmocnienie toczącego się koła krok po φ29 polimeraza wzbogacona o koliste DNA nad liniowym DNA. Walidacja metody Circle-Seq na trzech S. cerevisiae CEN. Populacje farmakokinetyczne składające się z10-10 komórek wykryły setki profili eccDNA o rozmiarach większych niż 1 kilozasada. Powtarzające się odkrycia genów ASP3-1, COS111, CUP1, RSC30, HXT6, HXT7 na kolistym DNA zarówno w S288c, jak i CEN. PK sugeruje, że krążenie DNA jest zachowane między szczepami w tych loci. Podsumowując, metoda Circle-Seq ma szerokie zastosowanie w badaniach przesiewowych w skali genomu pod kątem eccDNA u eukariontów, a także do wykrywania określonych typów eccDNA.
Wprowadzenie
Wykrycie wczesnej lub przejściowej amplifikacji chromosomów jest trudne, ponieważ wymaga identyfikacji zmian w pojedynczych cząsteczkach DNA w dużych populacjach komórek. Wariacje liczby kopii chromosomów (CNV) są na ogół wykrywane długo po ich ustaleniu, pozostawiając tylko końcową strukturę CNV jako dowód mechanizmu, który wygenerował zmianę1,2. Wykrycie i odzyskanie pozachromosomalnego kolistego DNA (eccDNA) na wcześniejszych etapach tworzenia CNV może wyjaśnić trwające procesy w rearanżacjach genomu.
Poprzednio, odkrycie de novo eccDNA polegało na mikrografiach elektronowych3, barwieniu chromosomów metafazyGiemsa 4 lub dwuwymiarowej elektroforezie żelowej5. Metody te dostarczają niewiele lub nie dostarczają żadnych informacji na temat sekwencji kolistego DNA. Ukierunkowane techniki, takie jak Southern blot6,7, odwrotny PCR8 lub fluorescencyjna hybrydyzacja in situ 9 dostarczają dowodów tylko na temat określonych elementów eccDNA. Żadna z tych metod nie zapewnia sekwencji wszystkich istniejących typów eccDNA w populacji komórek.
Dywergencja genomowa w puli komórek może być scharakteryzowana przez sekwencjonowanie genomu i/lub układanie tablickafelkowych 10,11. Wykrycie delecji lub amplifikacji za pomocą konwencjonalnych metod oczyszczania DNA zwykle wymaga, aby zmutowany allel reprezentował co najmniej 0,1-1% populacji komórek12,13. Oczekuje się, że acentryczne eccDNA będą jeszcze bardziej przejściowe w hodowli komórkowej ze względu na brak centromerów i potencjalny brak syntezy DNA podczas replikacji. W związku z tym, że większość eccDNA przypuszczalnie występuje w małych ilościach, a ich sekwencje przypominają genom, potrzebne są alternatywne metody ekstrakcji DNA w celu wykrycia eccDNA.
Kilka technik oczyszczania DNA metodą kolistego wykorzystuje różnice strukturalne między chromosomami a DNA kolistym. Na przykład szybkie ultrawirowanie w gradientach chlorku cezu stosuje się do izolowania 350-3000 par zasad (bp) dużych eccDNA z ludzkiej liniikomórkowej raka HeLa 14. Jednak duża prędkość może złamać lub naciąć szkielet superskręconych kolistych struktur DNA, zmieniając prędkość sedymentacji15 i wydajność eccDNA. Dutta i współpracownicy opracowali metodę identyfikacji de novo w skali genomu kolistego DNA z tkanek myszy, a także z kultur komórek kurczaka i komórek ludzkich16,17. Ich metoda polega na ekstrakcji jąder z homogenizowanej tkanki za pomocą ultrawirowania sacharozy, a następnie oczyszczania plazmidu i kilku rund reakcji enzymatycznych oraz ekstrakcji DNA. Ich protokół identyfikuje przede wszystkim eccDNA o długości 200-400 pz, zwane mikroDNA. Dutta i współpracownicy próbowali również oczyścić mikroDNA z Saccharomyces cerevisiae, ale nie byli w stanie zarejestrować mikroDNA z tego gatunku drożdży.
Opracowaliśmy nowatorską metodę wykrywania de novo eccDNA z drożdży o nazwie Circle-Seq. Metoda ta umożliwia badania w skali genomu w poszukiwaniu kolistych cząsteczek DNA wystarczająco dużych, aby przenosić całe geny i tak dużych, jak mitochondrialne DNA (mtDNA) o wielkości 86 kilozasad (kb). Metoda Circle-Seq została opracowana na podstawie dobrze znanej metody oczyszczania plazmidu prokariotycznego18,19, zoptymalizowanej pod kątem komórek drożdży eukariotycznych i połączonej z głębokim sekwencjonowaniem. Stosując podejście Circle-Seq, wykryto 1756 różnych eccDNA, wszystkie większe niż 1 kb, w dziesięciu populacjach S. cerevisiae S288c 20. Wybrano punkt odcięcia wielkości, aby skupić się na eccDNA, które było wystarczająco duże, aby przenosić całe geny. Circle-Seq był bardzo wrażliwy; wykrył pojedyncze eccDNA w tysiącach komórek20. W obecnym badaniu Circle-Seq wykorzystano do wyizolowania i zidentyfikowania 294 eccDNA z trzech biologicznych powtórzeń innego szczepu drożdży S. cerevisiae, CEN.PK. Dane ujawniają, że eccDNA jest powszechnym elementem genetycznym szczepów S. cerevisiae.
Protokół
UWAGA: Przegląd metody oczyszczania i sekwencjonowania DNA w cyklu (Circle-Seq) przedstawiono na rysunku 1.
1. Uprawa, zbieranie komórek i niszczenie błony komórkowej
- Zaszczepić komórki drożdży (na przykład Saccharomyces cerevisiae) z kultury O/N w 50 ml kompletnej pożywki z dekstrozy peptonowej drożdży (YPD). Zaszczepiać przy niskiej początkowej gęstości komórek 1-3 x 10⁵ komórek/ml lub gęstości optycznej około 0,01 OD600.
- Inkubować komórki w temperaturze 30 °C z mieszaniem przy 150 obrotach na minutę (obr./min), aż komórki osiągną maksymalną gęstość komórek około 1 x10 10 komórek, około po 24 do 48 godzinach lub gęstość optyczną przy OD600 > 10,0,
UWAGA: Czas uprawy nie jest kluczowy, ponieważ można stosować niższe stężenia komórek.
- Inkubować komórki w temperaturze 30 °C z mieszaniem przy 150 obrotach na minutę (obr./min), aż komórki osiągną maksymalną gęstość komórek około 1 x10 10 komórek, około po 24 do 48 godzinach lub gęstość optyczną przy OD600 > 10,0,
- Przenieść wyrośniętą kulturę do stożkowej probówki o pojemności 50 ml, osadzać komórki przez odwirowanie przy 800 x g przez 3 minuty i odrzucić supernatant.
- Przepłukać osad 25 ml roztworu buforowego 10 mM Tris-Cl, 1 mM EDTA, pH 8,0, ponownie zagnieździć komórki przez odwirowanie przy 800 x g przez 3 minuty i odrzucić supernatant.
- Zawiesić osad komórkowy w 1,2 ml buforu do resuspensji dostarczonego z zestawu do oczyszczania kolumny plazmidowej.
- Opcjonalny krok: Dodaj wysoce rozcieńczone plazmidy jako kontrole do oczyszczania kolistych elementów DNA20,
UWAGA: W obecnym zestawie danych mieszaninę plazmidu o stężeniu 7,7 μl zastosowano do każdej próbki zawierającej 1010 komórek. Podstawowa mieszanina plazmidów składała się z trzech plazmidów w różnych stężeniach; pBR322 przy 38 ng/próbkę, pUC19 przy 0,5 ng/próbkę i pUG72 przy 0,01 ng/próbkę. - Przenieść zawiesinę komórek do dwóch probówek mikrowirówek o pojemności 2 ml, z których każda jest uzupełniona szklanymi kulkami o średnicy 0,5 mm w stosunku 1:3 całkowitej objętości zawiesiny.
- Wiruj każdą probówkę z maksymalną prędkością przez 10 minut, aby rozerwać błony komórek plazmatycznych. Granulki zagnieździć przez odwirowanie przy 268 x g przez 30 sekund i przenieść 1,2 ml połączonego supernatantu z dwóch probówek do mikrowirówki do nowej probówki.
UWAGA: Alternatywą dla kroku 1.6-1.7 jest użycie zymoliazy do rozbicia komórek w 0,6 ml roztworu buforowego do recytacji. Dziesięć jednostek zymoliazy może rozbić 5 x 10⁷ komórek w ciągu 1,5 godziny w temperaturze 35 °C.
2. Wzbogacanie EccDNA metodą chromatografii kolumnowej
- Postępuj zgodnie z protokołem z zestawu do kolumnowego oczyszczania plazmidów. Krótko mówiąc, potraktować każdą próbkę 1,2 ml roztworu alkalicznego, delikatnie wymieszać i inkubować przez 3 minuty w temperaturze pokojowej.
- Dodać 1,2 ml buforu neutralizacyjnego, delikatnie wymieszać i odwirować przy 9650 x g przez 5 minut.
- Załadować roztwór do kolumny zrównoważonej 1 ml roztworu równoważącego i pozwolić, aby ciecz przepływała przez kolumnę pod wpływem grawitacji.
- Przemyć kolumnę 4 ml roztworu myjącego. Gdy roztwór przejdzie przez żywicę, ostrożnie dodaj 0,3 ml roztworu elucyjnego, aby zastąpić większość pustej objętości 0,35 ml kolumny.
- Wypłukać DNA do nowej probówki zbiorczej z 1 ml roztworu elucyjnego i wytrącić DNA, dodając 0,8 ml mieszaniny wytrącającej. Wirować przy 9650 x g przez 10 min.
- Przemyć osad DNA 0,5 ml 70% etanolu, odwirować przy 9650 x g przez 5 minut, wysuszyć na powietrzu przez 5 do 15 minut i rozpuścić oczyszczone DNA w 25 μl sterylnej wody.
UWAGA: Zaleca się tylko krótkotrwałe przechowywanie DNA w wodzie. Preferencyjnie przejdź bezpośrednio do kroku 3.
3. Trawienie pozostałego liniowego chromosomalnego DNA
- Opcjonalny krok: Aby ułatwić specyficzne trawienie liniowego DNA przez egzonukleazę, należy potraktować oczyszczone DNA rzadkim endonukleazą, taką jak NotI. W przypadku 5 μg DNA należy użyć 1 jednostki NotI, 5 μl 10x buforu wytrawiającego i sterylnej wody do całkowitej objętości 50 μl. Inkubować reakcję w temperaturze 37°C przez 16 godzin i podgrzewać, dezaktywować endonukleazę w temperaturze 80°C przez 5 minut.
- Dodaj 20 jednostek egzonukleazy (2 μl), 4 μl ATP (25 mM), 34 μl sterylnej wody i 10 μl 10x buforu reakcyjnego bezpośrednio do 50 μl DNA rozszczepionego endonukleazą, aby osiągnąć 1x objętość reakcyjną 100 μl, używając zestawu egzonukleazy zależnej od ATP.
- Przeprowadzić hydrolizę liniowego jednoniciowego i dwuniciowego DNA w temperaturze 37°C przez 5 dni lub dłużej. Dodawaj dodatkowe 4 μl ATP (25 mM), 0,6 μl 10x buforu reakcyjnego i 20 jednostek egzonukleazy co 24 godziny, aby kontynuować trawienie enzymatyczne DNA przy 1x objętości reakcji.
- Po usunięciu liniowego DNA pobrać próbkę 2 μl z roztworu poddanego działaniu egzonukleazy, aby potwierdzić eliminację chromosomalnego liniowego DNA w ilościowej reakcji łańcuchowej polimerazy (qPCR), przy użyciu markera chromosomalnego, takiego jak gen aktyny ACT120.
- Każda objętość reakcyjna qPCR o objętości 20 μl zawiera 2 μl próbki poddanej działaniu egzonukleazy, 150 nM starterów ACT1 5'-TCCGTCTGGATTGGTGGTTTTA-3' i 5'-TGGACCACTTTCGTCGTATTC-3', 2% (objętość/objętość) dimetylosulfotlenku i 10 μl zielonej fluorescencyjnej mieszaniny wzorcowej.
- Stosować warunki reakcji: 3 minuty w temperaturze 95°C, a następnie 45 cykli po 15 sekund w temperaturze 95°C i 30 sekund w temperaturze 60°C.
UWAGA: ACT1 jest szczególnie odpowiednim markerem dla liniowego DNA, ponieważ zmiany liczby kopii w tym genie są szkodliwe21-23, więc eccDNA nie powinno być nosicielem ACT1. - Alternatywą dla analizy trawienia DNA za pomocą qPCR jest standardowy PCR (4.3) lub barwienie jodkiem propidyny (4.4).
- Użyj 2 μl próbki poddanej egzonukleazie jako matrycy PCR ze starterami ACT1 5'-TGGATTCTGGTATGTTCTAGC-3' i 5'-GAACGACGTGAGTAACACC-3'. Jako pozytywną kontrolę ACT1 użyj 50-100 ng genomowego DNA S. cerevisiae jako matrycy. warunki reakcji PCR; 3 minuty w temperaturze 95°C, a następnie 35 cykli po 30 sekund w temperaturze 95°C, 30 sekund w temperaturze 56°C i 1 minuta w temperaturze 72°C.
- Przeprowadź reakcje PCR metodą elektroforezy żelowej na 1% agarozie z 0,5 μg/ml bromku etydyny. Poszukaj pasma ACT1 o rozmiarze 0,8 kb.
- Brak lub obecność liniowego DNA można również zbadać za pomocą barwienia jodkiem propidyny przed i po amplifikacji DNA.
- Zmieszać każdą próbkę DNA w objętości 1:1 z roztworem 1:1000 H 2O-rozcieńczonym 20 mM jodku propidyny. Pozostaw roztwór w ciemności na 10-20 minut w temperaturze pokojowej i przeanalizuj barwienie DNA za pomocą mikroskopii fluorescencyjnej przy 100-krotnym powiększeniu przy użyciu czerwonego filtra fluorescencyjnego wzbudzenia przy 663-738 nm i czasie naświetlania od 5 do 30 sekund. Jako kontrolę barwienia DNA użyj amplifikowanego ø29 genomowego DNA z drożdży i/lub plazmidu amplifikowanego ø29.
- Podgrzewać roztwór egzonukleazy w temperaturze 70°C przez 30 minut.
4. Amplifikacja DNA
- Amplifikować oczyszczone i wzbogacone eccDNA z kroku 3.5) za pomocą polimerazy DNA ø2924-26 zgodnie z protokołem producenta polimerazy.
- Krótko mówiąc, wymieszaj 5 μl wzbogaconego eccDNA z 5 μl buforu denaturacyjnego.
- Po 3 minutach w suchej temperaturze dodać 10 μl buforu neutralizującego. Delikatnie wymieszać i dodać 30 μl mieszanki wzorcowej zawierającej 29 μl buforu reakcyjnego i 1 μl polimerazy DNA ø29. Inkubować reakcję w temperaturze 30°C przez 16 godzin lub dłużej (do 72 godzin). Podgrzewać dezaktywację polimerazy DNA ø29 w temperaturze 65°C przez 3 min.
5. Sekwencjonowanie i analiza danych
- Ścinać amplifikowane eccDNA za pomocą zogniskowanego ultrasonografu do średniej docelowej wielkości piku 300 pz. Użyj następujących ustawień dla próbki DNA 130 μl: moc szczytowa 450 W, obróbka 60 sekund, 30% współczynnik aktywności, 200 cykli na serię, temperatura 7°C.
- Dodaj etykiety indeksów kodów kreskowych i adaptery do pofragmentowanych odczytów w celu syntezy bibliotek do sekwencjonowania, przy użyciu odpowiedniej metody przygotowania biblioteki.
- Uruchamiaj głębokie sekwencjonowanie, na przykład jako odczyty 141-nukleotydowe pojedynczego końca na platformie sekwencjonowania o wysokiej przepustowości.
- Mapuj odczyty do badanego genomu referencyjnego drożdży i zezwalaj na odczyty w celu mapowania do wielu regionów. Na przykład można skorzystać z ogólnodostępnego systemu przepływu pracy27,28 i oprogramowania do mapowania nakładek z krótkim odczytem29.
- Zidentyfikuj odczyty z regionów przypuszczalnych eccDNA przy użyciu ciągłych odczytów, na przykład więcej niż siedmiu ciągłych odczytów (>1 kb) bez przerw20.
UWAGA: Oprogramowanie jest dostępne>27,28 do eksploracji zmapowanych odczytów w interesujących regionach genomu.
Wyniki
Aby zwalidować metodę Circle-Seq, przesiewowo zbadano trzy populacje S. cerevisiae CEN.PK o liczebności 1 x 10¹⁰ komórek, po ich oddzielnej hodowli w pożywce YPD przez dziesięć generacji. Eliminację liniowego DNA chromosomowego potwierdzono brakiem sygnału qPCR dla genu ACT1 , zgodnie z wcześniejszym opisem20 (dane niepokazane). Oczyszczone i wzbogacone eccDNA poddano sekwencjonowaniu, uzyskując do 68 milionów odczytów (odczyty jednostronne o długości 141 nukleotydów), a następnie zmapowano je do genomu referencyjnego CEN.PK113-7D (wersja z 19 czerwca 2012 r.). Odczyty prawdopodobnych eccDNA z trzech próbek nazwanych C1, C2 i C4 przypisano do regionów genomowych zmapowanych przez ciągłe odczyty dłuższe niż 1 kb. Na podstawie 10 00 symulacji Monte Carlo oszacowano istotność każdego regionu zmapowanego przez ciągłe odczyty dłuższe niż 1 kb. W ten sposób 79, 159 i 56 regionów adnotowano jako prawdopodobne sekwencje eccDNA (p < 0.1, Dataset 1). Liczba zarejestrowanych ciągłych odczytów > 1 kb rosła w funkcji głębokości sekwencjonowania, co sugeruje, że przy głębszym sekwencjonowaniu próbek wykryto by jeszcze więcej elementów eccDNA (Figure 2). Zgodnie z oczekiwaniami, metoda Circle-Seq pozwoliła na wyodrębnienie licznych odczytów z wielu znanych kolistych elementów DNA, w tym z plazmidu 2µ, DNA mitochondrialnego, genów rRNA na chromosomie XII oraz trzech wewnętrznych plazmidów kontrolnych pBR32, pUC19 i pUG72, które dodano do próbek bezpośrednio przed oczyszczaniem kolumnowym (Figure 3).
Wideo przedstawia przykład sąsiednich odczytów zmapowanych do locus HXT7_ARS432_HXT6 na chromosomie IV. Wcześniej [HXT6/7circle] został wykryty za pomocą metody Circle-Seq w dziesięciu populacjach S28c (każda zawierająca 1 x 10¹⁰ komórek), a kolista struktura DNA została potwierdzona analizą odwrotnej PCR20. [HXT6/7circle] odnotowano również w każdej z trzech populacji CEN.PK (Rysunek 4A). Ponadto większość wspólnych genów eccDNA w próbkach powtórzonych CEN.PK pokrywała się z genami eccDNA z zestawów danych S28c (Rysunek 4B).
Aby przetestować specyficzność protokołu Circle-Seq w zakresie oczyszczania kolistego DNA, przygotowano dwie próbki, z których każda zawierała 30 µg przebadano genomowe DNA. Jedną z próbek uzupełniono o 10 ng plazmidowego DNA, a następnie z obu próbek oczyszczono eccDNA zgodnie z protokołem Circle-Seq. Po rozdziale kolumnowym wydajność DNA wyniosła 1,27% (380 ng) dla próbki bez plazmidu (GD) oraz 1,60% (480 ng) dla próbki z plazmidem (GD+P). Efektywność traktowania egzonukleazą w odniesieniu do zawartości liniowego DNA przetestowano po 29 h oraz 72 h za pomocą reakcji PCR przeciwko ACT1. W żadnych próbkach nie stwierdzono amplifikacji ACT1 (dane nie pokazano). Część każdej próbki traktowanej egzonukleazą poddano dalszej amplifikacji za pomocą ø29 polimerazę oraz produkty reakcji enzymatycznych przeanalizowano za pomocą barwienia jodkiem propidyny (Rysunek 5A-F) oraz elektroforezę w żelu agarozowym (Rysunek 5G). Próbki po traktowaniu egzonukleazą wykazały minimalne barwienie jodkiem propidyny (Rysunek 5A-B). ø29-próbka wzbogacona, zawierająca wyłącznie DNA genomowe, ujawniła struktury przypominające nici (Rycina 5C) podobne do próbki kontrolnej (Rycina 5E). The ø29-wz wzmocnionej próbce z dodatkiem plazmidu zaobserwowano ogniska (Rycina 5D) przypominający kontrolę plazmidową (Rycina 5F). Obrazy wskazały, że polimeraza ø29 wzbogaca frakcję kolistego DNA w stosunku do liniowego DNA. Większość liniowego DNA chromosomalnego została usunięta z próbek po 29-godzinnej inkubacji z egzonukleazą (Rysunek 5A-B, G). Jednakże, aby usunąć całe chromosomalne liniowe DNA, wymagana była intensywna obróbka egzonukleazą przez ponad 100 h z użyciem więcej niż 100 jednostek, ponieważ ø29-próbki po amplifikacji nadal wykazywały obecność w tle struktur przypominających nici po 72-godzinnej inkubacji z egzonukleazą (Rycina 5C-D).
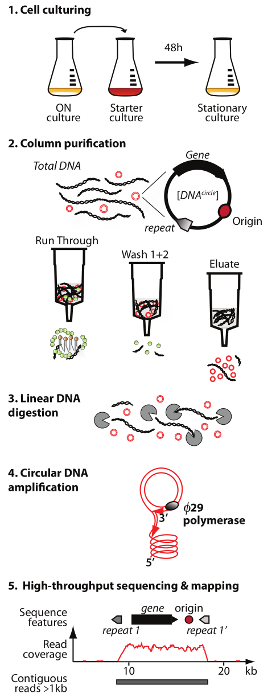
Rysunek 1. Schemat metody Circle-Seq. Protokół składa się z 5 etapów: 1) hodowli komórek, 2) oczyszczania i wzbogacania eccDNA za pomocą chromatografii kolumnowej, 3) trawienia pozostałego liniowego DNA chromosomalnego w frakcji eluate, 4) amplifikacji DNA za pomocą polimerazy DNA ø29 oraz 5) sekwencjonowania silnie wzbogaconego eccDNA i mapowania odczytów do S. cerevisiae genom referencyjny Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
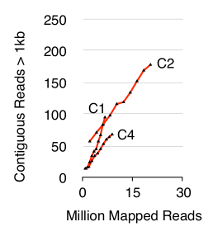
Rysunek 2. Odczyty kontigowe > 1 kb w funkcji głębokości sekwencjonowania. eccDNA z 1 x 10¹⁰ liczba komórek wzrasta w funkcji głębokości sekwencjonowania (w milionach zmapowanych odczytów). Przedstawiono: triplikaty biologiczne z haploidalnego szczepu CEN.PK S. cerevisiae populacje (C1, C2, C4) oddzielone przez 1010 podziały komórkowe. Prosimy o kliknięcie tutaj, aby wyświetlić powiększoną wersję tej ryciny.
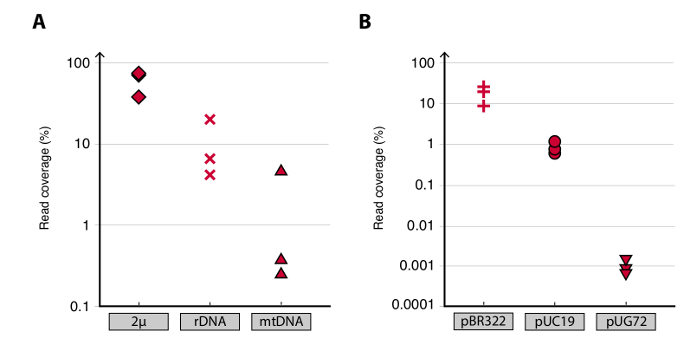
Rysunek 3. Detekcja znanych kolistych elementów DNA. (A-B) Wykresy rozrzutu pokrycia odczytów (gęstości odczytów) w procentach dla plazmidów w powtórzeniach biologicznych CEN.PK: C1, C2 i C4. (A) Liczba odczytów zmapowanych do endogennych plazmidów drożdżowych wynosiła: 2µ; [rDNAokrąg] (geny rRNA z chromosomu XII) oraz mtDNA (mitochondrialne DNA). (B) Unikalne odczyty zmapowane do plazmidów kontrolnych. Plazmidy kontrolne dodano do próbek przed oczyszczaniem kolumnowym. Stosunki plazmidów na komórkę wynosiły: pBR32 (plusy) 1:1, pUC19 (kółka) 1:50 oraz pUG72 (trójkąty) 1:2 50.
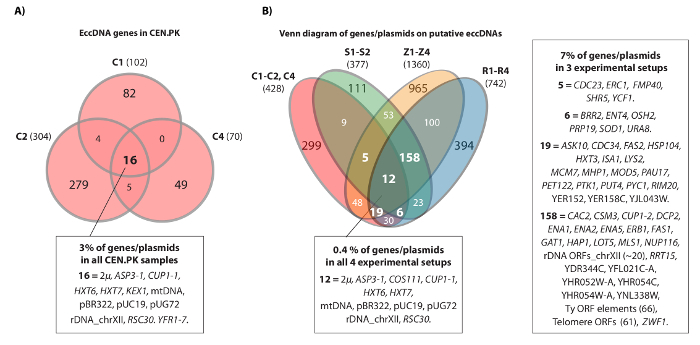
Rysunek 4. Wspólne elementy eccDNA w szczepach CEN.PK i S28c. (A) Diagram Venna przedstawiający nakładanie się 476 geny na 294 elementach eccDNA w trzech próbkach CEN.PK (C1, C2, C4). Adnotowano 16 wspólnych, nakładających się genów/plazmidów eccDNA (wszystkie nazwy genów znajdują się w Zbiór danych 1). (B) Diagram Venna wszystkich genów zidentyfikowanych w domniemanych ekstrachromosomalnych kołowych cząsteczkach DNA (eccDNA) z trzech próbek CEN.PK (C1, C2, C4), w porównaniu do wszystkich genów zidentyfikowanych w domniemanych eccDNA z 10 próbek S28c: S1-S2, R1-R4, Z1-Z4 (patrz odniesienie20). Przedstawiono 13 powtórzeń biologicznych (S1-S2, R1-R4, Z1-Z4, C1-C3) z genami/plazmidami oraz domniemanymi regionami eccDNA, które nakładały się na co najmniej 2 tła szczepowe oraz na 3 lub więcej układów doświadczalnych. Próbki C: CEN.PK; próbki R i Z: S28c BY4741; próbki S: S28c M3750. Prosimy o kliknięcie tutaj, aby wyświetlić powiększoną wersję tej ilustracji.
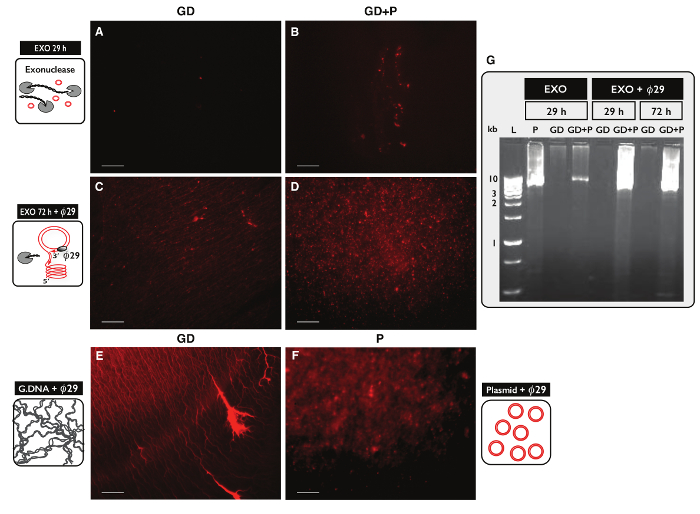
Rysunek 5. Wizualizacja próbek DNA po zastosowaniu egzonukleazy i ø29 traktowanie. (A-F) Barwienie DNA jodkiem propidium. Pasek skali, 10 µm. (A, C i E) Próbki z kwasem DNA genomowym (GD); (B i D) próbki z GD oraz plazmidem (GD+P). (A-B) Po 29-godzinnej inkubacji z egzonukleazą (EXO 29 h); (C-D) po 72-godzinnej inkubacji z egzonukleazą, a następnie amplifikacji za pomocą polimerazy ø29 (EXO 72 h + ø29). (E) kontrola genomowego DNA po amplifikacji polimerazą ø29; (F) kontrola plazmidowa (5,5 kb) po 29 amplifikacja polimerazowa; (Gø) elektroforeza w żelu agarozowym. Od lewej: L, markery 1 kb; P, kontrola plazmidowa (5,5 kb) po 29 godz. działania EXO; GD, po 29 godz. działania EXO (próbka tak jak w A); GD+P, po 29 godzinach EXO (próbka jako B); GD i GD+P, po EXO 29 h + ø29; GD i GD+P, po EXO 72 h + ø29 (próbka jak w C-D). Patrz Tabela S1 po dodatkowe szczegóły. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
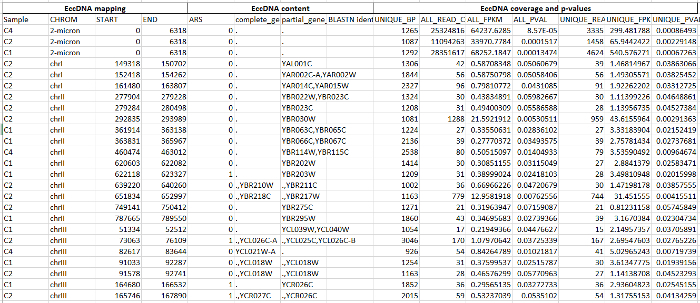
Zbiór danych 1. Potencjalne regiony cyrkularyzacji DNA w CEN.PK. Prosimy kliknąć tutaj, aby pobrać ten plik.
Przedstawiono dane sekwencyjne i analizy dla 348 regionów. Kolumny A-D obejmują mapowanie eccDNA. A (pierwsza kolumna od lewej) to próbka, w której zidentyfikowano domniemane eccDNA; B to chromosom; C-D to współrzędne początkowe i końcowe domniemanych eccDNA. Kolumny E-H określają zawartość eccDNA. E to autonomicznie replikująca się sekwencja (ARS) w regionie; F to kompletny gen w regionie; G to fragment genu zawarty w regionie; H to gen zidentyfikowany za pomocą BLASTN. Kolumny I-O obejmują pokrycie eccDNA i wartości p. I to najdłuższy region z unikalnie adnotowaną sekwencją w bp; J to liczba wszystkich zmapowanych odczytów; K to pokrycie wszystkich zmapowanych odczytów wyrażone jako liczba fragmentów na kb z miliona zmapowanych odczytów (FPKM); L to wartość p dla domniemanych eccDNA w porównaniu do występowania przypadkowego w symulacjach Monte Carlo; M to liczba unikalnie zmapowanych odczytów; N-O to odpowiednio K i L z wykorzystaniem wyłącznie unikalnie zmapowanych odczytów (UFPKM). Parametry mapowania odczytów i symulacji Monte Carlo były zgodne z opisem20.
Dyskusja
Metoda Circle-Seq umożliwia wykrywanie eccDNA w skali genomu z komórek drożdży z rozdzielczością na poziomie sekwencji. Metoda ta polega na łagodnym oczyszczaniu eccDNA, które nie wymaga intensywnego wirowania ani pipetowania i wykorzystuje separację kolumn grawitacyjnie w celu ograniczenia pękania eccDNA, które prowadziłoby do trawienia egzonukleazą na kolejnym etapie. Te cechy metody mogą mieć kluczowe znaczenie dla wykrywania dużych eccDNA, które zawierają sekwencje genów. Circle-Seq wykrył liczne eccDNA, w tym pełne geny (zestaw danych 1). Wykryto również mitochondrialne DNA drożdży o wielkości 86 kb. W ten sposób protokół ten ułatwia oczyszczanie dużych kolistych elementów DNA. Ograniczenie liczby etapów ekstrakcji DNA do minimum zmniejsza ryzyko utraty eccDNA i maksymalizuje wydajność. Opierając się na wynikach dla kontroli, wzbogaconych plazmidów, Circle-Seq jest bardzo czuły, wykrywając pojedyncze koliste DNA z 2500 komórek. Co więcej, usunięcie licznych endogennych plazmidów, takich jak plazmid 2μ lub mitochondrialne DNA, może znacznie zwiększyć wrażliwość. Utwardzanie 2μ z kultur drożdży opisano30. Alternatywnie, usunięcie 2μ i mitochondrialnego DNA można osiągnąć za pomocą rzadkiej endonukleazy tnącej, takiej jak SwaI. Jednak etap enzymu restrykcyjnego może być ukierunkowany na inne interesujące eccDNA i ograniczyć całkowitą wydajność eccDNA.
Krytycznymi etapami wykrywania eccDNA było usunięcie liniowego DNA (krok 3) i sekwencjonowanie DNA (krok 5) na odpowiednią głębokość. Aby zarejestrować większość eccDNA z populacji komórek, może być wymagane głębokie sekwencjonowanie20. Sekwencjonowanie sparowanych końców powinno zapewnić jeszcze większą pewność wykrywania eccDNA, ponieważ oczekuje się, że okrągłe połączenia DNA dadzą odczyty sparowanych końców, które mapują się niezgodnie z przepisami. Rozbieżności te wspierają odkrycie kolistych struktur DNA i mogą być potencjalnie wykorzystane jako dodatkowy filtr do wykrywania eccDNA.
Metodę Circle-Seq zwalidowano przy użyciu trzech niezależnych S. cerevisiae CEN. Populacje farmakokinetyki. Wykryte sekwencje obejmowały wcześniej zgłoszone eccDNA, endogenne plazmidy i plazmidy z kolcami oraz setki domniemanych eccDNA (zestaw danych 1). Wyniki te potwierdzają poprzednie zestawy danych Circle-Seq z S. cerevisiae S288c 20. Odkrycie kilku eccDNA wspólnych dla CEN. Populacje PK i S288c wskazują, że loci te mają skłonność do istnienia jako elementy koliste (ryc. 4). Wcześniej wykazaliśmy, że [krąg GAP1] jest wzbogacany w warunkach ograniczonych azotem w CEN. Tło PK8, chociaż nie znaleziono dowodów na [krąg GAP1] w innych tłach szczepów. Znalezienie eccDNA z loci CUP1-1 RSC30, ASP3-1, COS111 i HXT6 HXT7 zarówno w S288c, jak i CEN. PK sugeruje, że predyspozycja do krążenia DNA jest zachowana między szczepami drożdży. Pozostaje do pokazania, czy [koło HXT6/7], [koło ASP3-1], [koło COS111] i [koło CUP1-1 RSC30] przyznają komórkom selektywne korzyści, czy też ich istnienie jest jedynie efektem wysokich wskaźników krążenia DNA.
Podsumowując, wyniki wskazują, że Circle-Seq dobrze nadaje się do wykrywania eccDNA o rozmiarach kilozasad i ma zalety w identyfikacji eccDNA z kompletnymi genami. Circle-Seq to bardzo czuła metoda, która umożliwia badania przesiewowe eccDNA drożdży w skali całego genomu. Metoda Circle-Seq może otworzyć nową dziedzinę badań mających na celu wyjaśnienie roli eccDNA w generowaniu delecji i amplifikacji genów. Biorąc pod uwagę, że architektura i struktura DNA są w dużej mierze zachowane od drożdży eukariotycznych do wyższych eukariontów, metoda Circle-Seq powinna w zasadzie mieć zastosowanie do wszystkich komórek eukariotycznych, z niewielkimi modyfikacjami. Obecnie wydaje się, że metoda ta nie ma żadnych ograniczeń, chociaż jej zdolność do oczyszczania eccDNA o rozmiarach megazasad nie została jeszcze wykazana. Ponadto zastosowanie polimerazy DNA ø29, która wykorzystuje metodę amplifikacji w kształcie koła31, powoduje skłonność do mniejszych eccDNA, co utrudnia kwantyfikację eccDNA. Circle-Seq wykrywa eccDNA wystarczająco duże, aby przenosić pełne geny, dzięki czemu nadaje się do badań nad podwójnymi minutami - kolistym DNA z ludzkich komórek somatycznych. Podwójne minuty mogą przyczyniać się do raka, gdy protoonkogeny są amplifikowane na tych pierwiastkach32-37. Badania eccDNA w komórkach linii rozrodczej mogą być wykorzystane do pomiaru częstości mutacji w linii zarodkowej i oceny jakości nasienia, na przykład u zwierząt gospodarskich. W związku z tym projekt Circle-Seq ma potencjał, aby uzyskać wgląd w tempo, w jakim zmienność genetyczna pojawia się w postaci zmienności liczby kopii, i doprowadzić do nowego zrozumienia chorób, które obejmują zmienność liczby kopii genów38-40.
Oświadczenia
Autorzy oświadczają, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
Podziękowania dla Kenna D. Møllera i Clausa Sternberga (DTU) za pomoc techniczną oraz dla Tue S. Jørgensena za ilościową analizę PCR.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Można zastosować pepton | Bacto BD Difco | 211677 | Produkt alternatywny. |
| Brilliant III SYBR Green PCR Master Mix | Agilent Technologies | 600882 | Do analizy qPCR. Można użyć produktu alternatywnego. |
| Dekstroza (D-glukoza) | Carl Roth | HN06.4 | Można zastosować produkt alternatywny. |
| Koraliki zakłócające, 0,5 mm | Scientific Industries, Inc. | SI-BG05 | Szklane kulki do rozbijania błon komórek plazmatycznych. Można użyć produktu alternatywnego. |
| Bromek etydyny | Carl Roth | 2218.2 | Barwienie żelem agarozowym do wykrywania DNA/RNA. |
| Zestaw do miniprzygotowania plazmidu GeneJet | Thermo Fisher | K0502 | Oczyszczanie plazmidu z bakterii. Można użyć produktu alternatywnego. |
| NotI, Technologie | FastDigest Life - Thermo Fisher Scientific, USA | FD0594 | Endonukleaza. Można użyć alternatywnego produktu. |
| Zestaw Plasmid Mini AX | A& A Biotechnology, Poland | 010-50 | Zestaw do oczyszczania plazmidu służący do oczyszczania eccDNA. |
| Bezpieczny dla plazmidu zestaw DNazy zależny od ATP | Epicentre, USA | E3105K | zestaw egzonukleazy zależny od ATP. Można użyć produktu alternatywnego. |
| Jodek propidyny | Sigma-Aldrich, USA | 81845 | Można użyć produktu alternatywnego. |
| plazmid pUG6 | EUROSCARF, Niemcy | P30114 | Gen markerowy: loxP-PAgTEF1-kanMX-TAgTEF1-loxP. |
| Końcówka genomiczna QIAGEN 100/G | Qiagen, USA | 13343 | Oczyszczanie genomowego DNA z drożdży. Można użyć produktu alternatywnego. |
| Protokół REPLI-g Mini Kit | Qiagen, USA | 150023 | Amplifikacja eccDNA przez polimerazę phi29. |
| Można użyć ekstraktu drożdżowego | BD Difco | 210929 | Produkt alternatywny. |
| Zymoliaza 100T (Lyticase, Yeast Lytic Enzyme) | Nordic BioSite, Szwecja | Z1004-3 | Można zastosować produkt alternatywny. |
| Dostęp do plików sekwencyjnych | European Nucleotide Archive | Zbiór danych EccDNA z Saccharomyces cerevisiae CEN. PK113-7D. Numer dostępu do badania PRJEB9684. 2. numer akcesyjny to ERP010820. Prefiks znacznika locus to BN2032. | |
| Nazwa | Firma | Numer katalogowy | Komentarze |
| Szczepy | |||
| Saccharomyces cerevisiae CEN. PK113-7D | Genotyp MATa MAL2-8c SUC2 | ||
| Saccharomyces cerevisiae pula bibliotek delecji drożdży | EUROSCARF, Niemcy | S288c BY4741 pula 4400 żywotnych mutantów delecji pojedynczego genu usuniętych przez moduł KanMX. Genotypy MATa his3Δ 1 leu2Δ 0 met15 i Delta; 0 ura3 i Delta; 0 genexxx::KanMX. | |
| Nazwa | Company | Numer katalogowy | Komentarze |
| Equipments | |||
| Spektrofotometr DNA | Spektrofotometr NanoDrop 1000, Thermo Fisher | Pomiar stężenia DNA. Można użyć produktu alternatywnego. | |
| Mikroskopia fluorescencyjna | Nikon Optronics Magnafire. Czerwony filtr fluorescencyjny wzbudzenia, 663-738 nm. | Można użyć produktu alternatywnego. | |
| Zrobotyzowany system budowy biblioteki | Apollo 324, IntegenX Inc. | Przygotowanie biblioteki DNA. Można użyć produktu alternatywnego. | |
| Platforma sekwencjonowania | Platforma Illumina HiSeq 2000, Illumina Inc. | Sekwencjonowanie DNA. Można użyć produktu alternatywnego. | |
| Ultradźwiękowiec | Covaris LE220, mikrorurka AFA Rurki światłowodowe | Można zastosować produkt alternatywny. | |
| Nazwa< | silny>Firma | Numer katalogowy | Komentarze |
| Metody | |||
| 2% YPD media | Wymieszaj 10 g dekstrozy, 10 g ekstraktu drożdżowego, 20 g peptonu Bacto i dodaj H2O do całkowitej objętości 1000 ml i autoklawu. | ||
| Test Circle-Seq na genomowym DNA | Genomowe DNA oczyszczono (Qiagen) z puli biblioteki delecji drożdży (Euroscarf). Stężenie DNA mierzono za pomocą nanokropli i 30 &mikro; g genomowe DNA pipetowano do dwóch mikroprobówek wirówkowych. Jedna mikroprobówka wirówkowa została uzupełniona plazmidem o nanagramaturze 100 nanogramów (pUG6). Próbki DNA oczyszczono za pomocą Circle-Seq, pomijając kroki protokołu 1.1-1.3 i 1.5-1.7. Stężenia eluowanego DNA mierzono za pomocą nanokropli, a cały plon DNA z próbki GD i GD+P traktowano egzonukleazą przez okres 29 godzin. Pobrano 10% frakcję do amplifikacji phi29 i analizy PCR, podczas gdy pozostałe DNA poddano 72-godzinnemu zabiegowi egzonukleazy. Próbki analizowano pod kątem liniowej zawartości DNA metodą PCR, wykorzystując gen ACT1 jako marker chromosomowy. 5% frakcja każdej z próbek poddanych działaniu egzonukleazy amplifikowano przez polimerazę DNA phi29 przez 16 godzin (Qiagen). Obecność DNA w każdej próbce badano poprzez obciążenie równą ilością (7 &mikro; l) w studniach na 0,5 &mikro; g/ml bromku etydyny 0,9% żelu agarozowego po uruchomieniu elektroforezy żelowej. | ||
| Oprogramowanie do mapowania | Bowtie2 aligner, John Hopkins University | Ultraszybkie wyrównanie krótkiego odczytu. Numer referencyjny: 29. | |
| jodkiem propidyny | Obrazy DNA barwionego jodem propidyny uchwycono za pomocą mikroskopii fluorescencyjnej przy 100-krotnym powiększeniu (100x/1,30 olej, Nikon) w kanale RFP (czerwony filtr fluorescencyjny wzbudzenia, 663-738 nm) przy identycznym czasie ekspozycji (5 sekund). | ||
| System bioinformatyczny przepływu pracy | Galaxy, Open source. | Bezpłatna platforma internetowa do badań biomedycznych wymagających dużej ilości danych. Bibliografia: 27-28. |
Bibliografia
- Kugelberg, E., Kofoid, E., et al. The Tandem Inversion Duplication in Salmonella enterica.: Selection Drives Unstable Precursors to Final Mutation Types. Genetics. 185 (1), 65-80 (2010).
- Reams, A. B., Kofoid, E., Savageau, M., Roth, J. R. Duplication Frequency in a Population of Salmonella enterica. Rapidly Approaches Steady State With or Without Recombination. Genetics. 184 (4), 1077-1094 (2010).
- Smith, C. A., Vinograd, J. Small polydisperse circular DNA of HeLa cells. Journal of Molecular Biology. 69 (2), 163-178 (1972).
- Carroll, S. M., DeRose, M. L., et al. Double Minute Chromosomes Can Be Produced from Precursors Derived from a Chromosomal Deletion. Molecular and cellular biology. 8 (4), 1525-1533 (1988).
- Cohen, S., Yacobi, K., Segal, D. Extrachromosomal Circular DNA of Tandemly Repeated Genomic Sequences in Drosophila. Genome research. 13 (6A), 1133-1145 (2003).
- Horowitz, H., Haber, J. E. Identification of Autonomously Replicating Circular Subtelomeric Y' Elements in Saccharomyces cerevisiae. Molecular and cellular biology. 5 (9), 2369-2380 (1985).
- Moore, I. K., Martin, M. P., Dorsey, M. J., Paquin, C. E. Formation of Circular Amplifications in Saccharomyces cerevisiae by a Breakage-Fusion-Bridge Mechanism. Environmental and molecular mutagenesis. 36 (2), 113-120 (2000).
- Gresham, D., Usaite, R., Germann, S. M., Lisby, M., Botstein, D., Regenberg, B. Adaptation to diverse nitrogen-limited environments by deletion or extrachromosomal element formation of the GAP1 locus. Proceedings of the National Academy of Sciences of the United States of America. 107 (43), 18551-18556 (2010).
- Windle, B., Draper, B. W., Yin, Y. X., O'Gorman, S., Wahl, G. M. A central role for chromosome breakage in gene amplification, deletion formation, and amplicon integration. Genes & development. 5 (2), 160-174 (1991).
- Gresham, D., Ruderfer, D. M., et al. Genome-Wide Detection of Polymorphisms at Nucleotide Resolution with a Single DNA Microarray. Science. 311 (5769), 1932-1936 (2006).
- Kidd, J. M., Cooper, G. M., et al. Mapping and sequencing of structural variation from eight human genomes. Nature. 453 (7191), 56-64 (2008).
- Gresham, D., Desai, M. M., Botstein, D., Dunham, M. J. The Repertoire and Dynamics of Evolutionary Adaptations to Controlled Nutrient-Limited Environments in Yeast. PLoS Genetics. 4 (12), 1-19 (2008).
- Lang, G. I., Botstein, D., Desai, M. M. Genetic Variation and the Fate of Beneficial Mutations in Asexual Populations. Genetics. 188 (3), 647-661 (2011).
- van Loon, N., Miller, D., Murnane, J. P. Formation of extrachromosomal circular DNA in HeLa cells by nonhomologous recombination. Nucleic Acids Research. 22 (13), 2447-2452 (1994).
- Vinograd, J., Lebowitz, J. Physical and Topological Properties of Circular Dna. Journal of General Physiology. 49 (6P2), 103(1966).
- Shibata, Y., Kumar, P., et al. Extrachromosomal MicroDNAs and Chromosomal Microdeletions in Normal Tissues. Science. 336 (6077), 82-86 (2012).
- Dillon, L. W., Kumar, P., et al. Production of Extrachromosomal MicroDNAs Is Linked to Mismatch Repair Pathways and Transcriptional Activity. Cell Reports. 11 (11), 1749-1759 (2015).
- Li, L. L., Norman, A., Hansen, L. H., Sørensen, S. J. Metamobilomics - our knowledge on the pool of plasmid encoded traits in natural environments using high-throughput sequencing. Clinical microbiology and infection : the official publication of the European Society of Clinical Microbiology and Infectious Diseases. 18, 5-7 (2012).
- Brown Kav, A., Sasson, G., Jami, E., Doron-Faigenboim, A., Benhar, I., Mizrahi, I. Insights into the bovine rumen plasmidome. Proceedings of the National Academy of Sciences of the United States of America. 109 (14), 5452-5457 (2012).
- Møller, H. D., Parsons, L., Jørgensen, T. S., Botstein, D., Regenberg, B. Extrachromosomal circular DNA is common in yeast. Proceedings of the National Academy of Sciences of the United States of America. , 201508825(2015).
- Drubin, D. G., Miller, K. G., Botstein, D. Yeast Actin-Binding Proteins - Evidence for a Role in Morphogenesis. The Journal of cell biology. 107 (6), 2551-2561 (1988).
- Magdolen, V., Drubin, D. G., Mages, G., Bandlow, W. High levels of profilin suppress the lethality caused by overproduction of actin in yeast cells. FEBS letters. 316 (1), 41-47 (1993).
- Sandrock, T. M., Brower, S. M., Toenjes, K. A., Adams, A. Suppressor analysis of fimbrin (Sac6p) overexpression in yeast. Genetics. 151 (4), 1287-1297 (1999).
- Blanco, L., Bernad, A., Lázaro, J. M., Martìn, G., Garmendia, C., Salas, M. Highly Efficient DNA Synthesis by the Phage ø29 DNA Polymerase. The Journal of biological chemistry. 264 (15), 8935-8940 (1989).
- Dean, F. B. Rapid Amplification of Plasmid and Phage DNA Using Phi29 DNA Polymerase and Multiply-Primed Rolling Circle Amplification. Genome research. 11 (6), 1095-1099 (2001).
- Hutchison, C. A., Smith, H. O., Pfannkoch, C., Venter, J. C. Cell-free cloning using ø29 DNA polymerase. Proceedings of the National Academy of Sciences of the United States of America. 102 (48), 17332-17336 (2005).
- Goecks, J., Nekrutenko, A., Taylor, J., Galaxy Team, T. Galaxy: a comprehensive approach for supporting accessible, reproducible, and transparent computational research in the life sciences. Genome Biology. 11 (8), 86(2010).
- Giardine, B., Riemer, C., et al. Galaxy: A platform for interactive large-scale genome analysis. Genome research. 15 (10), 1451-1455 (2005).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. 9 (4), 357(2012).
- Tsalik, E. L., Gartenberg, M. R. Curing Saccharomyces cerevisiae of the 2 micron plasmid by targeted DNA damage. Yeast. 14 (9), Chichester, England 847-852 (1998).
- Norman, A., Riber, L., Luo, W., Li, L. L., Hansen, L. H., Sørensen, S. J. An Improved Method for Including Upper Size Range Plasmids in Metamobilomes. PLoS ONE. 9 (8), e104405(2014).
- Storlazzi, C. T., Lonoce, A., et al. Gene amplification as double minutes or homogeneously staining regions in solid tumors: Origin and structure. Genome research. 20 (9), 1198-1206 (2010).
- Von Hoff, D. D., Needham-VanDevanter, D. R., Yucel, J., Windle, B. E., Wahl, G. M. Amplified human MYC localized to replicating submicroscopic circular DNA molecules. Proceedings of the National Academy of Sciences of the United States of America. 85 (13), 4804-4808 (1988).
- Raymond, E., Faivre, S., et al. Effects of hydroxyurea on extrachromosomal DNA in patients with advanced ovarian carcinomas. Clinical cancer research : an official journal of the American Association for Cancer Research. 7 (5), 1171-1180 (2001).
- Shimizu, N. Extrachromosomal Double Minutes and Chromosomal Homogeneously Staining Regions as Probes for Chromosome Research. Cytogenetic and genome research. 124 (3-4), 3-4 (2009).
- Eckhardt, S. G., Dai, A., Davidson, K. K., Forseth, B. J., Wahl, G. M., Von Hoff, D. D. Induction of differentiation in HL60 cells by the reduction of extrachromosomally amplified c-myc. Proceedings of the National Academy of Sciences of the United States of America. 91 (14), 6674-6678 (1994).
- Vogt, N., Lefèvre, S. -H., et al. Molecular structure of double-minute chromosomes bearing amplified copies of the epidermal growth factor receptor gene in gliomas. Proceedings of the National Academy of Sciences of the United States of America. 101 (31), 11368-11373 (2004).
- Ahn, K., Gotay, N., et al. High rate of disease-related copy number variations in childhood onset schizophrenia. Molecular psychiatry. 19 (5), 568-572 (2013).
- Girirajan, S., Johnson, R. L., et al. Global increases in both common and rare copy number load associated with autism. Human molecular genetics. 22 (14), 2870-2880 (2013).
- Vogt, N., Gibaud, A., Lemoine, F., de la Grange, P., Debatisse, M., Malfoy, B. Amplicon rearrangements during the extrachromosomal and intrachromosomal amplification process in a glioma. Nucleic Acids Research. , (2014).
Przedruki i uprawnienia
