Ten protokół przedstawia porównawczy proces tworzenia transkryptomu i adnotacji de novo dla początkujących bioinformatyków. Przepływ pracy jest dostępny bezpłatnie całkowicie za pośrednictwem CyVerse i połączony przez magazyn danych. Używany jest wiersz poleceń i graficzne interfejsy użytkownika, ale cały potrzebny kod jest dostępny do skopiowania i wklejenia.
Artykuł metodologiczny
Wykorzystanie zasobów CyVerse do transkryptomiki porównawczej de novo organizmów nieobjętych modelem
W tym artykule
Podsumowanie
Streszczenie
Ten przepływ pracy pozwala początkującym badaczom na wykorzystanie zaawansowanych zasobów obliczeniowych, takich jak chmura obliczeniowa, do przeprowadzenia transkryptomiki porównawczej parami. Służy również jako elementarz dla biologów do rozwijania umiejętności obliczeniowych analityków danych, np. wykonywania poleceń bash, wizualizacji i zarządzania dużymi zbiorami danych. Cały kod wiersza poleceń i dalsze wyjaśnienia każdego polecenia lub kroku można znaleźć na wiki (https://wiki.cyverse.org/wiki/x/dgGtAQ). Platformy Discovery Environment i Atmosphere są połączone ze sobą za pośrednictwem CyVerse Data Store. W związku z tym, po przesłaniu początkowych surowych danych sekwencjonowania, nie ma już potrzeby przesyłania dużych plików danych przez połączenie internetowe, co minimalizuje czas potrzebny na przeprowadzenie analiz. Protokół ten ma na celu analizę tylko dwóch eksperymentalnych metod leczenia lub stanów. Różnicowa analiza ekspresji genów jest przeprowadzana poprzez porównania parami i nie będzie odpowiednia do testowania wielu czynników. Ten przepływ pracy jest również zaprojektowany tak, aby był ręczny, a nie zautomatyzowany. Każdy krok musi zostać wykonany i zbadany przez użytkownika, co zapewnia lepsze zrozumienie danych i wyników analitycznych, a tym samym lepsze wyniki dla użytkownika. Po zakończeniu, protokół ten pozwoli uzyskać transkryptom (transkryptomy) złożony de novo dla organizmów niedostatecznie obsługiwanych (niemodelowych) bez konieczności mapowania do wcześniej złożonych genomów referencyjnych (które zwykle nie są dostępne w organizmach niedostatecznie obsługiwanych). Te transkryptomy de novo są dalej wykorzystywane w analizie różnicowej ekspresji genów parami w celu zbadania genów różniących się między dwoma warunkami eksperymentalnymi. Geny o zróżnicowanej ekspresji są następnie funkcjonalnie opisywane, aby zrozumieć genetyczną reakcję organizmów na warunki eksperymentalne. Ogólnie rzecz biorąc, dane pochodzące z tego protokołu są wykorzystywane do testowania hipotez dotyczących reakcji biologicznych organizmów o niedostatecznym zasięgu.
Wprowadzenie
Homo sapiens i kilka kluczowych modelowych gatunków zwierząt, takich jak Drosophila melanogaster, Mus musculus i Danio rerio, reprezentują większość obecnych i przeszłych prac genomiki funkcjonalnej. Jednak szybko spadające koszty technologii sekwencjonowania o wysokiej przepustowości stwarzają możliwości dla genomiki funkcjonalnej w modelach (a.k.a. "zaniedbane" lub "niedostatecznie obsługiwane") gatunki zwierząt1. Jest to ważna zmiana w genomice, ponieważ organizmy niemodelowe często reprezentują gatunki istotne z ekonomicznego punktu widzenia (np. ostrygi, krewetki, kraby) i oferują możliwości badania nowych fenotypów i systemów biologicznych wykraczających poza zakres występujących u gatunków modelowych.
Chociaż organizmy o niedostatecznym zasięgu stanowią atrakcyjną okazję do badania unikalnych systemów biologicznych, przed badaczami stoi kilka wyzwań, szczególnie podczas analizy bioinformatycznej. Niektóre z tych wyzwań są nieodłącznie związane z przetwarzaniem dużych zbiorów danych, podczas gdy inne wynikają z braku zasobów genetycznych dostępnych dla badaczy pracujących nad organizmami o niedostatecznym dostępie, takich jak genom referencyjny, ontologie specyficzne dla organizmu itp. Wyzwania związane z izolacją i sekwencjonowaniem kwasów nukleinowych są często rutynowe w porównaniu z wyzwaniami związanymi z analizą danych, a zatem analizy bioinformatyczne na ogół okazują się być najbardziej niedocenianym kosztem projektów sekwencjonowania2. Na przykład podstawowa analiza bioinformatyczna sekwencjonowania nowej generacji może składać się z następujących kroków: wysokiej jakości filtrowania i przycinania surowych odczytów sekwencjonowania, składania krótkich odczytów w większe ciągłe części oraz adnotacji i/lub porównań z innymi systemami w celu uzyskania zrozumienia biologii. Choć wydaje się prosty, ten przykładowy przepływ pracy wymaga specjalistycznej wiedzy i zasobów obliczeniowych wykraczających poza zakres komputera laboratoryjnego, co stawia go poza zasięgiem wielu naukowców badających organizmy niemodelowe.
Wrodzone wyzwania mogą być oparte na infrastrukturze lub wiedzy. Klasycznym wyzwaniem infrastrukturalnym jest dostęp do odpowiednich zasobów obliczeniowych. Na przykład zestaw i adnotacje opierają się na algorytmach intensywnie korzystających z obliczeń, które wymagają wydajnych komputerów lub klastrów komputerowych, mających dużą ilość pamięci RAM (256 GB-1 TB) i kilka procesorów/rdzeni do działania. Niestety, wielu badaczy albo nie ma dostępu do takich zasobów obliczeniowych, albo nie posiada wiedzy potrzebnej do interakcji z tymi systemami. Inni badacze mogą mieć dostęp do klastrów obliczeniowych o wysokiej wydajności za pośrednictwem swoich uniwersytetów lub instytucji, ale dostęp do tych zasobów może być ograniczony i czasami powoduje naliczanie opłat za godzinę obliczeniową, tj. liczbę procesorów CPU pomnożoną przez liczbę "godzin zegarowych" czasu rzeczywistego, które te procesory działają. Wykorzystanie systemu infrastruktury cybernetycznej finansowanego przez amerykańską Narodową Fundację Nauki, takiego jak CyVerse3, który zapewnia bezpłatny dostęp do zasobów obliczeniowych naukowcom w Stanach Zjednoczonych i na całym świecie, może pomóc w złagodzeniu wyzwań związanych z infrastrukturą, jak zostanie to zademonstrowane tutaj.
Przykładem typowego wyzwania opartego na wiedzy jest zrozumienie oprogramowania potrzebnego do kompletnych analiz. Aby skutecznie przeprowadzić projekt oparty na sekwencjonowaniu, naukowcy muszą być zaznajomieni z niezliczonymi narzędziami programowymi, które zostały opracowane do analiz bioinformatycznych. Nauka każdego pakietu jest trudna sama w sobie, ale pogarsza ją fakt, że pakiety są stale aktualizowane, ponownie wydawane, łączone w nowe przepływy pracy, a czasami są ograniczane do użytku na nowych licencjach. Ponadto powiązanie danych wejściowych i wyjściowych tych narzędzi czasami wymaga przekształcenia typów danych w celu zapewnienia ich zgodności, co powoduje dodanie kolejnego narzędzia do przepływu pracy. Wreszcie, trudno jest również określić, który pakiet oprogramowania jest "najlepszy" do analizy, a często identyfikacja najlepszego oprogramowania dla określonych warunków eksperymentalnych jest kwestią subtelnych różnic. W niektórych przypadkach dostępne są przydatne recenzje oprogramowania, ale ze względu na ciągłe wydawanie nowych aktualizacji i opcji oprogramowania szybko stają się one nieaktualne.
Dla badaczy badających organizmy o niedostatecznym zasięgu, te wrodzone wyzwania są dodatkiem do wyzwań związanych z analizą danych w nowym organizmie. Te niedostatecznie obsługiwane wyzwania specyficzne dla organizmu najlepiej ilustruje się podczas adnotacji genów. Na przykład organizmy o niedostatecznym zasięgu często nie mają blisko spokrewnionego organizmu modelowego, który można by racjonalnie wykorzystać do identyfikacji ortologii i funkcji genów (np. bezkręgowce morskie i Drosophila). Wiele narzędzi bioinformatycznych wymaga również "szkolenia" w zakresie identyfikacji motywów strukturalnych, które można wykorzystać do identyfikacji funkcji genów. Jednak dane treningowe są zwykle dostępne tylko dla organizmów modelowych, a trenowanie ukrytych modeli Markowa (HMM) jest poza kompetencjami biologów, a nawet wielu bioinformatyków. Wreszcie, nawet jeśli adnotacje można przeprowadzić przy użyciu danych z organizmów modelowych, niektóre ontologie genetyczne związane z organizmami modelowymi nie mają sensu, gdy weźmie się pod uwagę biologię i historię naturalną organizmu zaniedbanego (np. transfer informacji od Drosophila do krewetek).
W świetle tych wyzwań, zasoby bioinformatyczne muszą być rozwijane z myślą o badaczach przeprowadzających analizy de novo na organizmach o niedostatecznym dostępie. Najbliższe kilka lat projektów sekwencjonowania genomiki funkcjonalnej pomoże wypełnić lukę między organizmami modelowymi a organizmami niedostatecznie obsługiwanymi (https://genome10k.soe.ucsc.edu/), ale istnieje wiele narzędzi, które będą musiały zostać opracowane, aby sprostać wyzwaniom omówionym powyżej. CyVerse zajmuje się tworzeniem ekosystemów interoperacyjności poprzez łączenie istniejącej infrastruktury cybernetycznej i aplikacji innych firm w celu dostarczania zarządzania danymi, narzędzi do analizy bioinformatycznej i wizualizacji danych naukowcom zajmującym się naukami przyrodniczymi. Interoperacyjność pomaga płynnie przechodzić między aplikacjami i platformami bioinformatycznymi, zapewniając skalowalne zasoby obliczeniowe oraz ograniczając konwersje formatów plików i ilość danych przesyłanych między platformami. CyVerse oferuje kilka platform, w tym Discovery Environment (DE4, Atmosphere5 oraz Data Store3. DE jest oparty na sieci Web i zawiera wiele popularnych narzędzi analitycznych bioinformatycznych przekonwertowanych na przyjazne dla użytkownika formaty typu "wskaż i kliknij" (zwanych "aplikacjami") i jest graficznym interfejsem użytkownika (GUI) dla magazynu danych, w którym przechowywane są duże zestawy danych (tj. odczyty sekwencjonowania surowego, złożone genomy) i zarządzane nimi. Atmosphere to usługa przetwarzania w chmurze, która oferuje naukowcom większą elastyczność w korzystaniu z zasobów obliczeniowych maszyn wirtualnych, które mają preinstalowaną szeroką gamę narzędzi bioinformatycznych. Obie te platformy są połączone z magazynem danych i mogą być używane razem do tworzenia przepływów pracy, takich jak opisany tutaj. Niniejszy raport koncentruje się na składaniu transkryptomu de novo i przepływach pracy związanych z różnicową analizą ekspresji genów, a także omawia niektóre najlepsze praktyki związane z opracowywaniem i przeprowadzaniem analiz bioinformatycznych. Wyjaśnienie szerszej misji CyVerse (http://www.cyverse.org/about) oraz szczegółowe opisy platformy (http://www.cyverse.org/learning-center) są publicznie dostępne. Wszystkie analizy opisane w niniejszym dokumencie korzystają z Discovery Environment4 (DE) oraz Atmosphere5 i są prezentowane w taki sposób, aby były dostępne dla badaczy na wszystkich poziomach obliczeniowych. Przepływy pracy DE i obrazy Atmosphere mogą być przywoływane bezpośrednio za pomocą adresów URL, aby zapewnić długoterminowe pochodzenie, możliwość ponownego użycia i odtwarzalność.
Protokół
UWAGA: Cały protokół został ponumerowany zgodnie z folderami, które zostaną utworzone i nazwane w kroku 1.2 (Rycina 1 i 2). Niniejszy protokół stanowi standardowe porównanie de novo analiza transkryptomu, a każdy z opisanych tutaj kroków nie musi być niezbędny dla wszystkich badaczy. Ten schemat postępowania jest szczegółowo udokumentowany w towarzyszącym wiki z tutorialem, które zawiera również wszystkie dodatkowe pliki oraz linki do interesujących dokumentów 3rd zespoły programistyczne dla każdego pakietu analitycznego (Tabela 1). Odnośniki do tych materiałów zostaną zamieszczone w całym protokole, aby zapewnić łatwy dostęp do tych informacji. Najlepsze praktyki to uwagi przekazywane użytkownikom w formie sugestii dotyczących optymalnych sposobów wykonywania zadań lub kwestii, które użytkownicy powinny rozważyć; zostaną one przekazane w formie notatek w protokole. Folder z przykładowymi danymi wejściowymi i wynikami analiz jest publicznie dostępny dla użytkowników i zorganizowany zgodnie z sugestiami zawartymi w protokole (de novo składanie i analiza transkryptomu.
1. Konfiguracja projektu, przesyłanie surowych odczytów sekwencyjnych i ocena odczytów za pomocą FastQC
- Uzyskaj dostęp do Atmosphere oraz Discovery Environment.
- Zawnioskuj o bezpłatne konto CyVerse, przechodząc do strony rejestracyjnej (np. person@institution.edu).
- Wypełnij wymagane informacje i prześlij formularz.
- Przejdź do strony głównej (http://www.cyverse.org/) i wybierz „Sign In” na górnym pasku narzędzi. Wybierz „Cyverse Login” i zaloguj się, używając swoich danych uwierzytelniających CyVerse.
- Przejdź do karty Apps & Services i poproś o dostęp do Atmosphere. Dostęp do Discovery Environment jest przyznawany automatycznie.
- Skonfiguruj projekt i przenieś dane do Data Store.
- Zaloguj się do Discovery Environment (https://de.iplantcollaborative.org/de). Wybierz kartę „Data”, aby wyświetlić menu zawierające wszystkie foldery w Data Store.
- Utwórz główny folder projektu, w którym będą przechowywane wszystkie dane związane z projektem. Znajdź pasek narzędzi u góry okna danych i wybierz File | New Folder. Nie używaj spacji ani znaków specjalnych w nazwach folderów ani w nazwach plików wejściowych/wyjściowych np. "!@#()[]{}:;$%^&*." Zamiast tego używaj podkreślników lub myślników, tzn. "_" lub "-", w zależności od potrzeb.
- Utwórz pięć folderów w głównym folderze projektu w celu organizacji analiz (Rysunek 1). Nazwij foldery w następujący sposób, bez przecinków i cudzysłowów: „1_Raw_Sequence”, „2_High_Quality_Sequence”, „3_Assembly”, „4_Differential_Expression”, „5_Annotated_Assembly”. W każdym z tych głównych folderów projektu zostaną utworzone podfoldery (Rysunek 2).
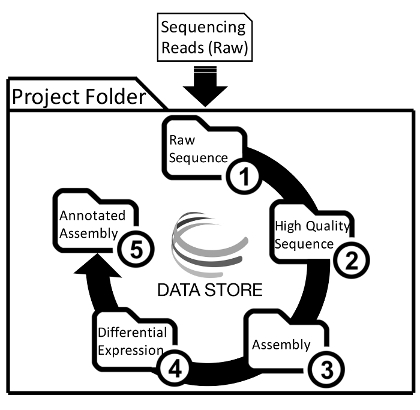
Rysunek 1: Ogólny przegląd organizacji folderów projektu oraz schematu składania i analizy transkryptomu De Novo. Użytkownicy prześlą surowe odczyty sekwencyjne do głównego folderu projektu w magazynie danych (Data Store), a następnie umieszczą wyniki z każdego kroku w oddzielnych folderach. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
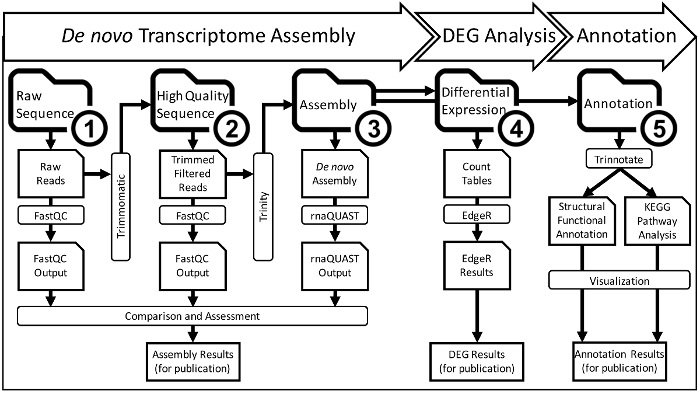
Rycina 2: Szczegółowy przegląd przepływu pracy składania i analizy transkryptomu de novo realizowanego w ramach cyberinfrastruktury CyVerse.Cały proces składania i analizy zostanie ukończony w pięciu krokach, z których każdy posiada własny folder (pogrubione, numerowane ikony folderów). Każdy z pięciu numerowanych folderów kroków przepływu pracy posiada podfoldery zawierające dane wyjściowe z analiz bioinformatycznych (ikony folderów). Dane wejściowe do analizy pochodzą z jednego podfolderu, a następnie trafiają do innego folderu jako wynik działania programu analitycznego (prostokątne pola). Końcowe dane z trzech pierwszych kroków są porównywane i przygotowywane do publikacji. Ostatecznie schemat ten pozwala uzyskać główny folder projektu z analizą etapową, dzięki której współpracownicy i/lub recenzenci manuskryptu mogą szybko zrozumieć przepływ pracy i powtórzyć go, korzystając z każdego pliku, jeśli jest to konieczne. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
- Prześlij surowe pliki sekwencji FASTQ do folderu „1_Raw_Sequence” do podfolderu o nazwie „A_Raw_Reads”, korzystając z jednej z trzech poniższych metod.
- Użyj funkcji prostego przesyłania Data Store, aby przejść do paska narzędzi okna Data, klikając przycisk danych na głównym pulpicie DE, a następnie wybierz Upload | Simple Upload from Desktop. Kliknij przycisk Browse, aby przejść do surowych plików sekwencjonowania FASTQ na komputerze lokalnym. Metoda ta jest odpowiednia tylko dla plików o rozmiarze poniżej 2 GB.
- Wybierz przycisk Upload na dole ekranu, aby zatwierdzić przesyłanie. W prawym górnym rogu DE, pod ikoną dzwonka, pojawi się powiadomienie o przesłaniu danych. Kolejne powiadomienie pojawi się po zakończeniu przesyłania.
- Alternatywnie, użyj programu Cyberduck do przesyłania większych plików (https://wiki.cyverse.org/wiki/x/pYcVAQ). Zainstaluj program Cyberduck, a następnie uruchom go na pulpicie komputera lokalnego.
- Na koniec pobierz iCommands i zainstaluj je na komputerze lokalnym zgodnie z instrukcjami (https://wiki.cyverse.org/wiki/display/DS/Using+iCommands).
- Oceń przesłane, surowe odczyty sekwencjonowania za pomocą aplikacji FastQC w DE.
- Wybierz przycisk „Apps” na głównym pulpicie DE, aby otworzyć okno zawierające wszystkie aplikacje analityczne dostępne w DE.
- Wyszukaj i otwórz okno narzędzia FastQC w pasku wyszukiwania u góry okna. Otwórz wersję wieloplikową, jeśli dostępnych jest więcej niż jeden plik FASTQ. Wybierz File | New Folder, aby utworzyć folder o nazwie „B_FastQC_Raw_Reads”, a następnie wybierz ten folder jako folder wyjściowy.
- Wczytaj pliki odczytów FASTQ do okna narzędzia o nazwie „Select input data” i wybierz „Launch Analysis”.
- Po zakończeniu analizy otwórz plik .html lub .pdf, aby wyświetlić wyniki. FastQC przeprowadza kilka analiz testujących różne aspekty plików z odczytami (Rysunek 3).
2. Przycinanie i filtrowanie jakościowe surowych odczytów w celu uzyskania wysokiej jakości sekwencji
Uwaga: Należy użyć aplikacji Trimmomatic lub aplikacji Sickle.
- Wyszukaj programowalną aplikację Trimmomatic w środowisku DE i otwórz ją w taki sam sposób jak poprzednio.
- Prześlij folder z surowymi plikami odczytów FASTQ do sekcji „Settings”.
- Wybierz, czy pliki sekwencjonowania są jednoniciowe (single-end), czy parzyste (paired-end).
- Użyj standardowego pliku kontrolnego, wybierając przycisk Browse i wklejając ścieżkę /iplant/home/shared/Trinity_transdecoder_trinotate_databases do pola „Viewing:”. Wybierz plik o nazwie Trimmomaticv0.33_control_file i uruchom analizę. Plik można pobrać, edytować jego ustawienia, a następnie przesłać do drugiego folderu projektu, aby stworzyć własny skrypt przycinania.
- Opcjonalnie: Jeśli analiza FastQC zidentyfikowała sekwencje adapterów, użyj ustawienia ILLUMINACLIP, aby przyciąć adaptery Illumina. Wybierz odpowiedni plik adapterów w folderze /iplant/home/shared/Trinity_transdecoder_trinotate_databases, analogicznie jak powyżej.
- Wykonaj przycinanie jakościowe odczytów sekwencji przy użyciu programu Sickle.
- Wyszukaj i otwórz aplikację Sickle w środowisku DE. Jako odczyty wejściowe wybierz przycięte odczyty FASTQ i zmień nazwy plików wyjściowych. W opcjach uwzględnij ustawienia jakości. Typowe ustawienia to: Quality format: illumina, sanger, solexa; Quality threshold: 20; Minimum length: 50.
- Przenieś wszystkie pliki wyjściowe do folderu z odczytami przyciętymi i przefiltrowanymi (2_High_Quality_Sequence).
- Oceń końcowe odczyty za pomocą programu FastQC i porównaj je z poprzednimi raportami FastQC. Wybierz plik .html, aby otworzyć stronę internetową ze wszystkimi wynikami. Jeśli nie można jej wyświetlić, wybierz folder z plikami obrazów (.png) dostarczonymi w wynikach.
3. Asemblacja transkryptomu de novo przy użyciu Trinity w Atmosphere
- Otwórz aktualną wersję instancji Atmosphere, przechodząc do strony wiki (https://wiki.cyverse.org/wiki/x/dgGtAQ). Wybierz link do najnowszej wersji obrazu Trinity i Trinotate. Alternatywnie, wyszukaj frazę „Trinotate” w narzędziu wyszukiwania obrazów Atmosphere (https://atmo.iplantcollaborative.org/application/images), aby wyświetlić wszystkie wersje obrazów Trinity i Trinotate.
- Wybierz przycisk „Log in to launch”, a następnie nazwij instancję Atmosphere.
- Wybierz rozmiar instancji „medium3” (CPU: 4, Mem: 32GB) lub „large3” (CPU: 8, Mem: 64 GB). Uruchom instancję i poczekaj na jej zbudowanie. W rzadkich przypadkach CyVerse przeprowadza prace konserwacyjne w celu aktualizacji platform. Istniejące instancje są dostępne podczas tych aktualizacji, ale tworzenie nowych instancji może być niemożliwe. Odwiedź stronę statusu CyVerse, aby sprawdzić aktualny stan platformy ( http://status.cyverse.org/ ).
- Otwórz instancję po jej przygotowaniu, klikając jej nazwę, a następnie wybierając „Remote Desktop” na dole menu po prawej stronie. Jeśli zostaniesz poproszony, zezwól na działanie programów Java i VNC Viewer. Wybierz przycisk „Connect” w oknie VNC Viewer, a następnie wybierz „Continue”.
- Zaloguj się, aby otworzyć oddzielne okno, które będzie nową instancją obliczeń w chmurze.
- Przenieś przycięte i/lub przefiltrowane pliki odczytów FASTQ do instancji, korzystając z jednej z trzech metod opisanych w krokach 1.3.1 - 1.3.4. Użyj przeglądarki internetowej, aby uzyskać dostęp do DE i pobrać pliki tak samo, jak wcześniej na komputerze lokalnym. Możesz również użyć iCommands zainstalowanych w tych obrazach, aby szybko przesłać duże zestawy danych.
- Uruchomienie programu Trinity w celu złożenia wysokiej jakości odczytów.
- Skonfiguruj folder analizy w instancji Atmosphere. Skorzystaj ze skryptu dostępnego w DE (/iplant/home/shared/Trinity_transdecoder_trinotate_databases) lub skopiuj i wklej polecenia ze strony wiki (https://wiki.cyverse.org/wiki/x/dgGtAQ). Wyjaśnienie wszystkich poleceń znajduje się na stronie wiki.
- Po utworzeniu folderu analizy i baz danych Trinotate, uruchom asembler Trinity, korzystając z powyższych poleceń. Powstanie kilka plików wyjściowych, z których najważniejszym jest końcowy plik złożenia o nazwie „Trinity.fasta”. Zmień nazwę tego pliku FASTA na unikalną dla danego organizmu i obróbki złożonych odczytów przed przeniesieniem go do Magazynu Danych (folder 3_Assembly), aby zminimalizować ryzyko pomyłki.
UWAGA: Pliki z tabelami zliczeń do analizy różnicowej ekspresji genów zapisz w folderze (4_Differential_Expression).
- Oceń złożenie za pomocą rnaQUAST (Rycina 4).
- Przenieś pliki wyjściowe z Trinity do folderu „3_Assembly” w DE i nazwij folder „A_Trinity_de_novo_assembly”. Dla każdego złożonego transkryptomu utwórz podfolder wewnątrz folderu „A_Trinity_de_novo_assembly” z unikalnymi nazwami, zawierającymi nazwę naukową organizmów i obróbki przypisane do każdego transkryptomu. Utwórz kolejny podfolder o nazwie „B_rnaQUAST_Output” w folderze „3_Assembly”.
- Otwórz aplikację o nazwie „rnaQUAST 1.2.0 (denovo based)”, nazwij analizę i wybierz „B_rnaQUAST_Output” jako folder wyjściowy.
- Dodaj plik(i) FASTA złożenia de novo do sekcji „Data Input”. W sekcji „Data Output” wpisz unikalną nazwę dla złożenia de novo. Spowoduje to utworzenie folderu z plikami wyjściowymi rnaQUAST wewnątrz folderu „B_rnaQUAST_Output”.
- Wybierz dodatkowe opcje w sekcjach „GenemarkS-T Gene Prediction”, „BUSCO” i „Parameters”.
- W sekcji „GenemarkS-T Gene Prediction” wybierz prokariotę, jeśli organizm nie jest eukariotą.
- Aby uruchomić BUSCO, wybierz przycisk przeglądania, skopiuj ścieżkę iplant/home/shared/iplantcollaborative/example_data/BUSCO.sample.data do pola „Viewing:” i naciśnij enter. Wybierz najbardziej specyficzny folder BUSCO dostępny dla danego organizmu.
UWAGA: BUSCO oceni złożenie pod kątem rdzeniowych genów specyficznych dla linii ewolucyjnej i poda procent znalezionych genów rdzeniowych. Dostępne są foldery ogólne, np. eukaryote, oraz linie bardziej specyficzne, np. arthropoda.
- Wyszukaj „Transcript decoder” i uruchom Transdecoder na pliku wyjściowym FASTA z Trinity assembly de novo w Discovery Environment.
- Przenieś wyjściowy plik .pep do folderu złożenia de novo (3_Assembly) do wykorzystania w kroku 5 Adnotacja.
4. Analiza różnicowej ekspresji par w programie DESeq2 w środowisku DE
- Otwórz aplikację DESeq2 w module DE zgodnie z wcześniejszym opisem. Nadaj nazwę analizie i wybierz folder wyjściowy jako 4_Differential_Expression.
- W sekcji „Inputs” wybierz plik z tabelą liczby odczytów (counts table) z przebiegu asemblacji Trinity oraz kolumnę w tej tabeli, w której znajdują się nazwy kontigów.
- Wprowadź nagłówki kolumn z pliku z danymi liczby odczytów, aby określić, które kolumny mają zostać porównane. Rozdziel poszczególne warunki przecinkami. Nie wpisuj pierwszego nagłówka kolumny zawierającego nazwy kontigów.
- W przypadku powtórzeń powtórz tę samą nazwę (np. Treatment1rep1, Treatment1rep2, Treatment1rep3 zamienią się w Treatment1, Treatment1, Treatment1). W drugiej linii podaj nazwy dwóch porównywanych warunków (np. Treatment1, Treatment2). Muszą one odpowiadać nazwom nagłówków kolumn podanym w pierwszej linii.
UWAGA: Nagłówki kolumn muszą być alfanumeryczne i nie mogą zawierać znaków specjalnych.
5. Adnotacja przy użyciu Trinotate
- Uruchom każdy moduł programu Trinotate w instancji chmury obliczeniowej Atmosphere. Uwaga: polecenia Bash zostały udostępnione w pliku txt do skopiowania i wklejenia, a następnie zmodyfikowania przed uruchomieniem w katalogu DE (/iplant/home/shared/Trinity_transdecoder_trinotate_databases) lub na stronie wiki (https://wiki.cyverse.org/wiki/x/dgGtAQ). W przypadku adnotacji wielu asemblacji, adnotuj każdą asemblację pojedynczo, a następnie przenieś ukończone pliki adnotacji z powrotem do folderu „5_Annotation”, tworząc dla każdej z nich osobny folder odpowiadający nazwie asemblacji.
- Uruchom polecenie bash w celu przeszukiwania transkryptów Trinity. Zmień liczbę wątków tak, aby odpowiadała liczbie procesorów CPU w instancji, t.j. instancja medium posiada 4 procesory CPU, a large posiada 8 procesorów CPU. Szczegóły znajdują się w kroku 3.1.2. Zmień nazwę pliku Trinity.fasta tak, aby odpowiadała nazwie pliku FASTA danej asemblacji.
UWAGA: Przeszukiwania BLAST+ zajmą najwięcej czasu. Ich zakończenie może potrwać kilka dni. Aktywność komputera w chmurze można monitorować w Atmosphere bez konieczności uruchamiania VNC Viewer. - Uruchom polecenie bash w celu przeszukiwania białek przewidzianych przez Transdecoder. Podobnie jak wcześniej, zmień liczbę wątków oraz nazwę pliku zgodnie z warunkami opisanymi w punkcie 5.2.1.
- Uruchom polecenie bash dla HMMER i zmień liczbę wątków w sposób opisany powyżej.
- W razie potrzeby uruchom polecenie bash dla signalP i tmHMM. SignalP służy do przewidywania peptydów sygnałowych, a tmHMM do przewidywania motywów białek transbłonowych.
- Uruchom polecenie bash w celu przeszukiwania transkryptów Trinity. Zmień liczbę wątków tak, aby odpowiadała liczbie procesorów CPU w instancji, t.j. instancja medium posiada 4 procesory CPU, a large posiada 8 procesorów CPU. Szczegóły znajdują się w kroku 3.1.2. Zmień nazwę pliku Trinity.fasta tak, aby odpowiadała nazwie pliku FASTA danej asemblacji.
- Ładowanie wyników do bazy danych SQLite
- Po zakończeniu wszystkich powyższych analiz uruchom polecenie bash, aby załadować pliki wyjściowe do końcowej bazy danych adnotacji SQLite. Usuń polecenia dotyczące analiz, które nie zostały przeprowadzone.
- Wyeksportuj bazę danych SQLite do pliku .xls w celu wyświetlenia w popularnych programach do obsługi tabel.
Wyniki
Po utworzeniu plików organizacyjnych projektu (Rysunek 1 i 2), pierwszym zadaniem w tym przepływie pracy jest ocena surowych plików sekwencjonowania, a następnie ich oczyszczenie poprzez obcinanie i filtrowanie jakościowe. FastQC wygeneruje czytelne dla człowieka podsumowanie statystyk jakości odczytów oraz ich długości w formacie plików FASTQ. Wykresy FastQC są następnie porównywane przed i po obcinaniu, aby ocenić, czy końcowe odczyty są wysokiej jakości i odpowiednie do sekwencjonowania. „Jakość sekwencji na parę zasad” pokazuje średnią jakość odczytów dla każdej pary zasad w sekwencji. Najlepiej, aby wynik jakości Phred był powyżej 20–28, co wskazują kolory na wykresach FastQC. „Średnia jakość sekwencji” określa, czy konieczne może być filtrowanie jakościowe odczytów. Jeśli zbyt wiele odczytów ma średni wynik poniżej 20–25, może być konieczne filtrowanie na podstawie średniej jakości odczytu. „Zawartość sekwencji na parę zasad” powinna pokazywać równomierne rozłożenie we wszystkich czterech zasadach nukleotydowych. Jeśli występuje obciążenie zawartości nukleotydów, może być konieczne obcinanie końców. „Zawartość GC na parę zasad” również powinna być równomierne we wszystkich pozycjach. Jeśli występuje wahanie, odczyty mogą wymagać obcięcia, jak w punkcie 1.4.4.3. „Zawartość GC na sekwencję” powinna mieć rozkład normalny. Adaptery lub produkty reakcji łańcuchowej polimerazy (PCR) mogą zanieczyszczać bibliotekę sekwencjonowania i zaburzać normalny rozkład. W takim przypadku może być konieczne usunięcie adapterów. „Rozkład długości sekwencji” podaje średnią długość wszystkich odczytów. Odczyty krótsze niż 35–45 par zasad są zazwyczaj odrzucane. „Poziom duplikacji sekwencji” pokazuje, ile razy dana sekwencja odczytu występuje w bibliotece. Wysoko zduplikowane sekwencje i ich liczba są podane w sekcji „Przedstawione sekwencje”. FastQC próbuje również określić, czy zduplikowane odczyty to sekwencje adapterów lub inne znane sekwencje związane z platformami sekwencjonowania. Etykieta „No Hit” oznacza, że sekwencję należy dodatkowo przeanalizować za pomocą NCBI BLAST6, aby ustalić, czy jest to sekwencja biologicznie istotna, czy też powinna zostać usunięta. DE oferuje również kilka wersji BLAST. Aplikacja DE BLASTn jest dostępna pod adresem: https://de.iplantcollaborative.org/de/?type=apps&app-id=6f94cc92-6d28-45c6-aef1-036be697671d.
Po przesiewie surowych danych sekwencjonowania w celu uzyskania odczytów wysokiej jakości, odczyty te należy zestawić, aby utworzyć sekwencje ciągłe (contigi). W skrócie, zestawienia tworzy się poprzez wyrównanie wszystkich krótkich odczytów sekwencji, aby znaleźć podobne sekwencje. Obszary podobnych sekwencji dłuższe niż określona długość uznaje się za tę samą sekwencję, ponieważ prawdopodobieństwo przypadkowego wystąpienia podobnej sekwencji o danej długości jest niemal zerowe. Program Trinity wygeneruje pliki dziennika oraz pliki fasta dla każdego etapu procesu zestawiania. Najważniejszym jednak wynikiem jest końcowy plik zestawienia zawierający contigi, oznaczony jako „Trinity.fasta” i znajdujący się w głównym folderze. Plik ten zawiera wszystkie zestawione contigi i sam w sobie nie jest praktycznie „czytelny dla człowieka”. Dlatego do głębszego zrozumienia zestawienia można wykorzystać narzędzie rnaQUAST. Narzędzie rnaQUAST generuje rysunki, które pozwolą użytkownikom porównać zestawienia i określić, które z nich są najbardziej kompletne (Rysunek 4). Dodatkowe informacje dotyczące każdego rysunku z rnaQUAST są dostępne w wiki (https://wiki.cyverse.org/wiki/x/fwuEAQ). Jeśli uruchomiono BUSCO7, szczególnym zainteresowaniem będzie plik specificity.txt, który pokazuje liczbę kompletnych i częściowych genów BUSCO oraz liczbę predykcji genów GeneMarkS-T w zestawieniu. Geny BUSCO to skatalogowane zestawy genów wspólnych dla grupy organizmów. Można ich użyć do oceny, jak dobrze zestawienie odzwierciedla zestawy genów, które powinny występować u danego typu organizmów, co oparte jest na kladach filogenetycznych. Autonomiczna aplikacja BUSCO jest również dostępna w DE (https://de.iplantcollaborative.org/de/?type=apps&app-id=112b8a52-efd8-11e5-a15c-277125fcb1b1).
Analiza różnicowej ekspresji genów identyfikuje transkrypty o różnych wzorcach ekspresji w różnych warunkach na podstawie prostych danych liczbowych uzyskanych z tabel transkryptów. DESeq2 wykorzystuje uogólniony model liniowy (GLM) do określenia zmienności względem znormalizowanej średniej. Eksperymenty z replikami są preferowane, aby algorytm DESeq2 mógł znormalizować techniczną zmienność wynikającą z sekwencjonowania. Analiza DEG za pomocą DESeq2 generuje wykresy oraz plik raportu w formacie .html zawierający wszystkie wygenerowane wykresy i opisy. Alternatywnie zamiast DESeq2 można wykorzystać EdgeR, co skutkuje wygenerowaniem tego samego pliku raportu w formacie .html, lecz z wizualizacjami utworzonymi przez EdgeR. Badacze mogą chcieć uruchomić zarówno DESeq2, jak i EdgeR, aby znaleźć geny różnicowo eksprymowane, które zostaną zidentyfikowane przez oba algorytmy w ramach danego eksperymentu. Trinotate utworzy plik wyjściowy w formacie .xls, który można otworzyć w każdym programie do arkuszy kalkulacyjnych. Pliki .txt z wynikami DEG oraz plik adnotacji w formacie .xls mogą zostać przeanalizowane i zwizualizowane za pomocą wielu dostępnych narzędzi analitycznych spoza platformy CyVerse.
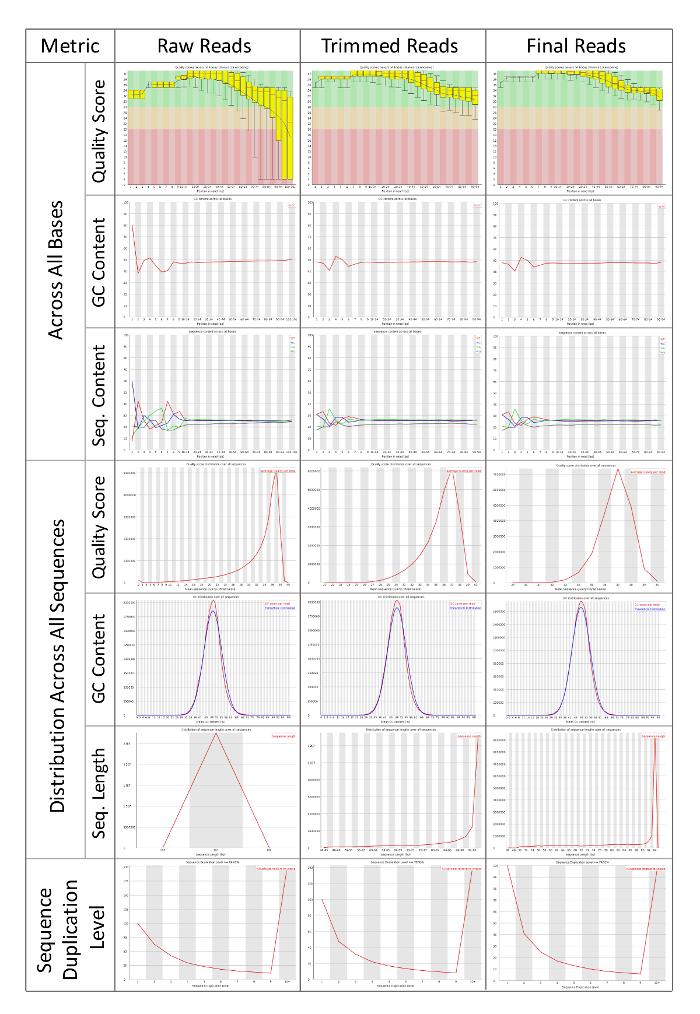
Rycina 3: Raporty FastQC dla surowych odczytów sekwencjonowania, przyciętych odczytów oraz końcowych przyciętych i odfiltrowanych odczytów. Systematyczne porównanie odczytów sekwencjonowania po każdym etapie wstępnego przetwarzania. Wysokiej jakości odczyty są niezbędne do wykonania sekwencjonowania de novo de novo transkryptomów. FastQC może pomóc badaczom w ocenie jakości początkowych danych sekwencjonowania oraz w śledzeniu skuteczności wstępnego przetwarzania odczytów. Wyniki uzyskane za pomocą FastQC zależą od organizmów i próbek poddawanych sekwencjonowaniu, jednak głównym celem przetwarzania wstępnego odczytów jest osiągnięcie jednolitości we wszystkich próbkach, które będą porównywane na etapach kolejnych. Autorzy i twórcy FastQC udostępniają instruktażowy film wideo oraz dokumentację. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
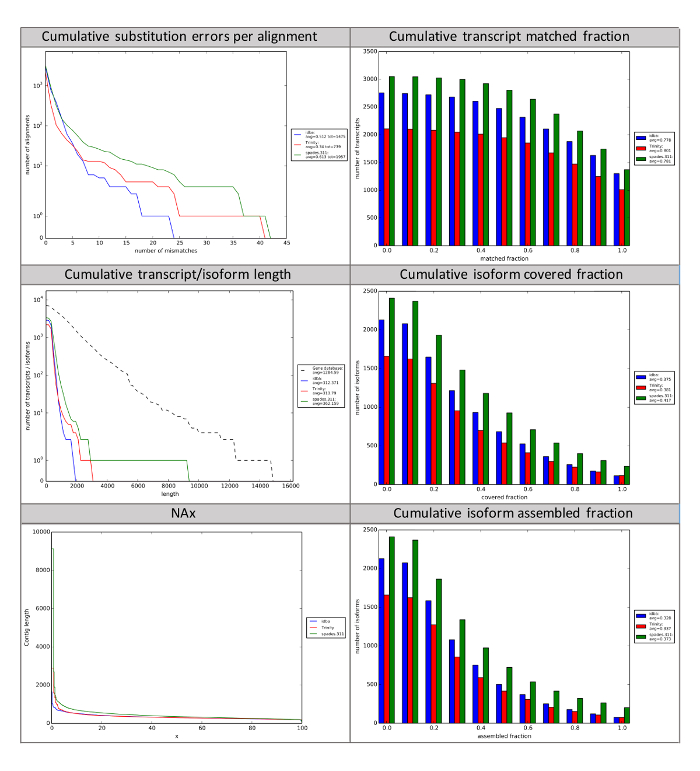
Rycina 4: Raporty rnaQUAST trzech oddzielnych zestawów skonstruowanych sekwencji. Program rnaQUAST może służyć do porównywania wielu zestawów skonstruowanych sekwencji uzyskanych tym samym programem do konstrukcji, albo wielu programów do konstrukcji wykorzystujących te same początkowe odczyty. rnaQUAST wykorzystuje BUSCO do generowania statystyk podsumowujących jakość konstrukcji na podstawie obecności znanych genów rdzeniowych występujących w danej grupie taksonomicznej. Liczba niezgodności na transkrypt oraz liczba transkryptów pasujących do genów kanonicznych, czyli ułamek dopasowanych, dostarczają informacji na temat dokładności programów do konstrukcji. Cztery ostatnie wykresy przedstawione tutaj zawierają statystyki podsumowujące długość kontigów i izoform oraz pokrycie oczekiwanych izoform. NAx oznacza procent (x) kontigów o długości przekraczającej wartość (w parze zasad) na osi y. Ułamek skonstruowany to najdłuższy pojedynczy skonstruowany transkrypt podzielony przez jego długość. Ułamek pokryty to procent kompletnych skonstruowanych transkryptów/izoform, zgodnie z oczekiwaniami wynikającymi z rdzeniowych genów prokariotycznych lub eukariotycznych z bazy BUSCO. Opis wszystkich wykresów generowanych przez rnaQUAST jest dostępny pod adresem (https://wiki.cyverse.org/wiki/x/fwuEAQ). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Nazwa aplikacji | Platforma CyVerse | Dokumentacja strony trzeciej | Dokumentacja CyVerse | Szacowany czas działania dla przykładowego zestawu danych | Łącze do aplikacji |
| FastQC | DE | http://www.bioinformatics. babraham.ac.uk/projects/fastqc/ https://www.youtube.com/watch?v=bz93ReOv87Y | https://wiki.cyverse.org/wiki/pages/viewpage.action?pageId=9316768 | 15 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=112b9aa8-c4a7-11e5-8209- 5f3310948295 |
| Trimmomatic v0.33 | DE | https://github.com/timflutre/trimmomatic | https://wiki.cyverse.org/wiki/display/DEapps/Trimmomatic-programmable-0.33 | 30 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=9c2a30dc-028d- 11e6-a915-ab4311791e69 |
| Sickle | DE | https://github.com/najoshi/sickle | https://wiki.cyverse.org/wiki/display/DEapps/Sickle-quality-based-trimming | 30 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=68b278f8-d4d6-414d-9a64-b685a7714f7c |
| Trinity | Atmosphere | https://github.com/trinityrnaseq/trinityrnaseq/wiki | https://pods.iplantcollaborative. org/wiki/display/atmman/Trinity+-+Trinotate+Atmosphere+Image | 1 tydzień | https://atmo.iplantcollaborative. org/application/images/1261 |
| DE | https://wiki.cyverse.org/wiki/display/DEapps/Trinity-64GB-2.1.1 | 2–5 dni | https://wiki.cyverse.org/wiki/display/DEapps/Trinity-64GB-2.1.1 | ||
| rnaQUAST v1.2.0 | DE, Atmosphere | http://spades.bioinf.spbau.ru/rnaquast/release1.2.0/manual.html | https://pods.iplantcollaborative. org/wiki/display/TUT/rnaQUAST+1.2.0+%28denovo+based%29+using+DE | 30 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=980dd11a-1666- 11e6-9122-930 ba8f23352 |
| Transdecoder | DE | https://transdecoder.github.io | https://wiki.cyverse.org/wiki/display/DEapps/Transcript+decoder+2.0 | 2–3 godziny | https://de.iplantcollaborative. org/de/?type=apps&app-id=5a0ba87e-b0fa-4994-92a2- 0d48ee881179 |
| DESeq2 | DE | https://bioconductor.org/packages/release/bioc/html/DESeq2.html | https://pods.iplantcollaborative. org/wiki/pages/viewpage.action?pageId=28115142 | 2–3 godziny | https://de.iplantcollaborative. org/de/?type=apps&app-id=9574e87c-4f90- 11e6-a594-008 cfa5ae621 |
| EdgeR | DE | https://bioconductor.org/packages/release/bioc/vignettes/edgeR/inst/doc/edgeR.pdf | https://wiki.cyverse.org/wiki/pages/viewpage.action?pageId=28115144 | 2–3 godziny | https://de.iplantcollaborative. org/de/?type=apps&app-id=4a08ceda-54fe- 11e6-862f-008 cfa5ae621 |
| Trinotate | Atmosphere | https://trinotate.github.io/ | https://pods.iplantcollaborative. org/wiki/display/atmman/Trinity+-+Trinotate+Atmosphere+Image | 1 tydzień | https://atmo.iplantcollaborative. org/application/images/1261 |
Tabela 1: Programy analityczne, platformy, na których są dostępne, oraz dodatkowe zasoby dostępne dla poszczególnych procedur roboczych, uporządkowane według pierwszego wystąpienia. Wszystkie wersje pakietów są aktualne na kwiecień 2016 roku.
Dyskusja
W protokole znajduje się pięć krytycznych kroków, z których każdy utworzy swój własny oddzielny folder w głównym folderze projektu (rysunki 1 i 2). Wszystkie podstawowe surowe dane sekwencjonowania są nienaruszalne: powinny być przesłane i przechowywane w pierwszym folderze oznaczonym jako "1_Raw_Sequence" i nie powinny być w żaden sposób zmieniane. Dane można przesłać na jeden z trzech sposobów. Interfejs DE może być używany do bezpośredniego przesyłania plików. Jest to najłatwiejszy sposób przesyłania danych, ale również jego transfer zajmie najwięcej czasu. Cyberduck ma interfejs graficzny i umożliwia użytkownikom przeciąganie i upuszczanie plików w celu przesłania do DE. iCommands to narzędzie wiersza poleceń, którego można używać do przesyłania danych do i z magazynu danych, tworzenia katalogów i zarządzania zestawami danych, a także jest prawdopodobnie najszybszym sposobem przesyłania plików danych. Wszystkie dane w Magazynie Danych mogą być udostępniane innym użytkownikom CyVerse (https://wiki.cyverse.org/wiki/display/DEmanual/Sharing+Data+Files+and+Folders+Via+the+Discovery+Environment), upubliczniane za pośrednictwem wygenerowanego adresu URL ( https://wiki.cyverse.org/wiki/display/DEmanual/Sharing+Data+Files+Via+Public+Links) lub mogą być hostowane jako publicznie i anonimowo (bez nazwy użytkownika) dostępne dane społeczności ( http://data.iplantcollaborative.org; http://mirrors.cyverse.org). Wewnątrz tego folderu odczyty nieprzetworzonej sekwencji są analizowane za pomocą FastQC (http://www.bioinformatics.bbsrc.ac.uk/projects/fastqc/) w celu oceny, jak przycinać i filtrować odczyty w celu wygenerowania odczytów o wysokiej jakości. Po przycięciu i filtrowaniu jakości przydatne jest porównanie danych wyjściowych FastQC w celu określenia, czy jakość odczytu uległa zmianie, w celu ustalenia, czy uległa poprawie, bez utraty informacji (Rysunek 3). Należy pamiętać, że oś x FastQC nie jest liniowa, ale raczej jest podzielona na grupy dla wielu wykresów wyjściowych, co może prowadzić do błędnej interpretacji wyników. Przycięte i przefiltrowane odczyty są następnie wykorzystywane do składania transkryptomów de novo przy użyciu instancji przetwarzania w chmurze Atmosphere. Ten komputer w chmurze korzysta z lokalnego ekranu, klawiatury i myszy, ale ma zainstalowane własne oprogramowanie (Trinity i Trinotate) oraz sprzęt. Uruchamianie programów w instancji komputera w chmurze nie wpłynie w żaden sposób na komputer lokalny. Montaż de novo i dalsza adnotacja będą najprawdopodobniej dwoma najdłużej działającymi krokami w tym procesie pracy. W związku z tym są one wykonywane w programie Atmosphere, aby uniknąć typowych problemów z komputerem współdzielonych w laboratorium, które mogłyby zakłócić analizę, takich jak przerwy w dostawie prądu, ponowne uruchomienie po automatycznych aktualizacjach późno w nocy lub awarie spowodowane przez innych użytkowników. Adnotacja trójdzielna używa BLAST+8, HMMER9, tmHMM10 i PFAM11. Końcowym wynikiem adnotacji jest baza danych SQLite i plik .xls. Wyniki mogą być używane poza CyVerse na platformach analizy podrzędnej, takich jak KEGG12,13.
Ten przepływ pracy jest gotowy do użycia w DE i Atmosphere. Eliminuje to konieczność poświęcania czasu na instalowanie, konfigurowanie i rozwiązywanie problemów z każdym pakietem analitycznym oraz wszystkimi zależnościami wymaganymi przez każde narzędzie. Usprawnia to analizy badaczy, minimalizuje marnotrawstwo wysiłku i obniża barierę wejścia dla wielu naukowców. Ten przepływ pracy w szczególności składa się z odczytów jedno- lub sparowanych końców z platformy sekwencjonowania Illumina, ale w DE i Atmosphere istnieje wiele narzędzi do obsługi innych rodzajów technologii sekwencjonowania. Narzędzia w tym przepływie pracy można łatwo zastąpić odpowiednim alternatywnym narzędziem do obsługi dowolnego rodzaju przychodzącej technologii sekwencjonowania. Dotyczy to również nowych wersji narzędzi analitycznych lub zupełnie nowych narzędzi.
Ten przepływ pracy został specjalnie zaprojektowany do składania, porównywania i opisywania tylko kilku transkryptomów jednocześnie. Dlatego użytkownicy mogą uznać za czasochłonne składanie wielu transkryptomów do porównawczej genetyki populacyjnej. Potoki analiz będą dostępne dla użytkowników genetyki populacyjnej w najbliższej przyszłości, a link do potoku można znaleźć na stronie wiki ( https://wiki.cyverse.org/wiki/x/dgGtAQ). Etap różnicowej analizy ekspresji genów może obsłużyć kontrpróby, ale jest to porównanie parami i nie pozwoli dokładnie ocenić wielu czynników (np. warunków, które zmieniają się w czasie, więcej niż dwóch terapii). W przypadku organizmów z genomami referencyjnymi istnieją zautomatyzowane przepływy pracy (np. TRAPLINE14). Podczas gdy zautomatyzowane przepływy pracy są najłatwiejsze w użyciu dla nowicjuszy, zgromadzenia de novo wymagają oceny i rozważenia każdego kroku opisanego tutaj. Ponadto użytkownicy są zobowiązani do korzystania ze zautomatyzowanych rurociągów w miarę ich konstruowania, a zatem z natury nie są elastyczni, aby sprostać zmieniającym się wymaganiom użytkowników.
Ponieważ większość tego protokołu odbywa się przez Internet, użytkownicy mogą napotkać problemy z ustawieniami przeglądarki. Po pierwsze, programy blokujące wyskakujące okienka mogą w ogóle uniemożliwiać otwieranie okien lub mogą uniemożliwiać otwieranie okien, dopóki nie zostanie udzielone pozwolenie CyVerse w przeglądarce. Atmosphere używa VNC do uzyskiwania dostępu do zdalnych pulpitów, ale może być używane inne oprogramowanie. Cały ten protokół został przeprowadzony w Firefoksie w wersji 45.0.2 i powinien działać ze wszystkimi popularnymi przeglądarkami internetowymi, ale mogą pojawić się pewne niespójności. Przepływ pracy będzie aktualizowany w miarę wydawania nowych wersji przez Trinity ( https://github.com/trinityrnaseq/trinityrnaseq/wiki). Najnowsze wersje i aktualne informacje na temat przepływu pracy można znaleźć na stronie samouczka wiki (Tabela 1, https://wiki.cyverse.org/wiki/x/dgGtAQ). Użytkownicy mogą kontaktować się bezpośrednio z pomocą techniczną lub zadawać pytania na stronie Ask CyVerse (ask.cyverse.org/), aby rozwiązać wszelkie problemy z przepływem pracy.
W DE istnieje kilka aplikacji, które wykonują każdy krok tego protokołu. Na przykład użytkownicy mogą chcieć uruchomić Scythe ( https://github.com/najoshi/sickle) zamiast Trimmomatic15 do przycinania odczytu lub uruchomić EdgeR16 zamiast DESeq17,18. Chociaż wykracza to poza zakres tego manuskryptu, aplikacje DE mogą być kopiowane, edytowane i wydawane przez użytkowników ( https://wiki.cyverse.org/wiki/display/DEmanual/Creating,+Copying,+and+Editing+DE+Apps) lub nowe aplikacje mogą być dodawane przez użytkowników (https://wiki.cyverse.org/wiki/display/DEmanual/Dockerizing+Your+Tools+for+the+CyVerse+Discovery+Environment). Obrazy Atmosphere mogą być również modyfikowane i przekształcane w celu tworzenia nowych lub zmodyfikowanych przepływów pracy, które bardziej szczegółowo odpowiadają potrzebom użytkowników (https://wiki.cyverse.org/wiki/x/TwHX). Ta praca służy jako wprowadzenie do wykorzystania wiersza poleceń do przenoszenia danych i wykonywania analiz. Użytkownicy mogą rozważyć wykorzystanie bardziej zaawansowanych zasobów wiersza poleceń, takich jak interfejsy programowania aplikacji (API) CyVerse (http://www.cyverse.org/science-apis) lub projektowanie własnych aplikacji DE, które wymagają wiedzy na temat tego, jak narzędzie analityczne jest uruchamiane w wierszu poleceń ( https://wiki.cyverse.org/wiki/display/DEmanual/Creating+a+New+App+Interface).
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Autorzy chcieliby podziękować za finansowanie z grantu USDA-NIFA 2013-00984, grantu NSF IOS - 1339156, IOS - 1444490, oraz CyVerse (NSF: DBI - 1265383).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Trimmomatic v0.33 | USADELLAB.org | https://github.com/timflutre/trimmomatic | https://de.iplantcollaborative.org/de/?type=apps&app-id=9c2a30dc-028d-11e6-a915-ab4311791e69 |
| Sierp | Joshi i Fass | https://github.com/najoshi/sickle | https://de.iplantcollaborative.org/de/?type=apps&app-id=68b278f8-d4d6-414d-9a64-b685a7714f7c |
| Trinity | Broad Institute i Uniwersytet Hebrajski w Jerozolimie | https://github.com/trinityrnaseq/trinityrnaseq/wiki | https://atmo.iplantcollaborative.org/application/images/1261 |
| rnaQUAST v1.2.0 | Laboratorium Biologii Algorytmicznej, Petersburski Uniwersytet Akademicki Rosyjskiej Akademii Nauk | http://spades.bioinf.spbau.ru/rnaquast/release1.2.0/manual.html | https://de.iplantcollaborative.org /de/?type=aplikacje& app- id=980dd11a-1666-11e6-9122- 930ba8f23352 |
| Transdecoder | Broad Institute and Commonwealth Scientific and Industrial Research Organisation | https://transdecoder.github.io | https://de.iplantcollaborative.org/de/?type=apps&app-id=5a0ba87e-b0fa-4994-92a2-0d48ee881179 |
| EdgeR | , Robinson et al. 2010. | https://bioconductor.org/packages/release/bioc/vignettes/edgeR/inst/doc/edgeR.pdf | https://de.iplantcollaborative.org/de/?type=apps&app-id=5aa9e294-6f95-42f9-98e9-c9c96b44f499 |
| Trinotate | Broad Institute i Uniwersytet Hebrajski w Jerozolimie | https://trinotate.github.io/ | https://atmo.iplantcollaborative.org/application/images/1261 |
Bibliografia
- Hasselmann, M., Ferretti, L., Zayed, A. Beyond fruit-flies: population genomic advances in non-Drosophila arthropods. Brief. Funct. Genomics. 14 (6), 424-431 (2015).
- Scholz, M. B., Lo, C. -C., Chain, P. S. Next generation sequencing and bioinformatic bottlenecks: the current state of metagenomic data analysis. Anal. Biotech. 23 (1), 9-15 (2012).
- Merchant, N., et al. The iPlant Collaborative: Cyberinfrastructure for Enabling Data to Discovery for the Life Sciences. PLoS Biol. 14 (1), e1002342(2016).
- Oliver, S. L., Lenards, A. J., Barthelson, R. A., Merchant, N., McKay, S. J. Using the iPlant collaborative discovery environment. Cur. Protoc. Bioinformatics. , 1-22 (2013).
- Skidmore, E., Kim, S., Kuchimanchi, S., Singaram, S., Merchant, N., Stanzione, D. iPlant atmosphere: a gateway to cloud infrastructure for the plant sciences. Proc. 2011 ACM. , 59-64 (2011).
- Altschul, S. F., Gish, W., Miller, W., Myers, E. W., Lipman, D. J. Basic local alignment search tool. J. Mol. Bio. 215 (3), 403-410 (1990).
- Simão, F. A., Waterhouse, R. M., Ioannidis, P., Kriventseva, E. V., Zdobnov, E. M. BUSCO: assessing genome assembly and annotation completeness with single-copy orthologs. Bioinformatics. , (2015).
- Camacho, C., et al. BLAST+: architecture and applications. BMC Bioinformatics. 10, 421(2009).
- Eddy, S. R. Profile hidden Markov models. Bioinformatics. 14 (9), 755-763 (1998).
- Krogh, A., Larsson, B., von Heijne, G., Sonnhammer, E. L. Predicting transmembrane protein topology with a hidden markov model: application to complete genomes. J. Mol. Biol. 305 (3), 567-580 (2001).
- Finn, R. D., Coggill, P., et al. The Pfam protein families database: towards a more sustainable future. Nucleic Acids Res. 44 (D1), D279-D285 (2016).
- Kanehisa, M., Sato, Y., Kawashima, M., Furumichi, M., Tanabe, M. KEGG as a reference resource for gene and protein annotation. Nucleic Acids Res. 44 (D1), D457-D462 (2016).
- Kanehisa, M., Goto, S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 28 (1), 27-30 (2000).
- Wolfien, M., et al. TRAPLINE: a standardized and automated pipeline for RNA sequencing data analysis, evaluation and annotation. BMC Bioinformatics. 17, 21(2016).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30 (15), 2114-2120 (2014).
- Robinson, M. D., McCarthy, D. J., Smyth, G. K. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 26 (1), 139-140 (2010).
- Anders, S. Analysing RNA-Seq data with the DESeq package. Mol. Biol. 43 (4), 1-17 (2010).
- Love, M. I., Huber, W., Anders, S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Bio. 15 (12), 1-21 (2014).
Przedruki i uprawnienia
