Tutaj opisujemy innowacyjną metodę określania polimorfizmów długości receptora dopełniacza 1 (CR1) do wykorzystania w wielu zastosowaniach, szczególnie w ocenie podatności na choroby takie jak choroba Alzheimera (AD). Metoda ta może być przydatna do lepszego zrozumienia roli izoform CR1 w patogenezie choroby Alzheimera.
Artykuł metodologiczny
Genotypowanie polimorfizmu długości receptora dopełniacza 1 metodą topnienia w wysokiej rozdzielczości: innowacyjne narzędzie do oceny podatności genów choroby Alzheimera
W tym artykule
Podsumowanie
Streszczenie
Receptor dopełniacza 1 (CR1), transbłonowa glikoproteina, która odgrywa kluczową rolę we wrodzonym układzie odpornościowym, ulega ekspresji na wielu typach komórek, ale szczególnie na czerwonych krwinkach (RBC). Jako receptor dla składników dopełniacza C3b i C4b, CR1 reguluje aktywację kaskady dopełniacza i promuje fagocytozę kompleksów immunologicznych i resztek komórkowych, a także peptydu amyloidu beta (Aβ) w chorobie Alzheimera (AD). Kilka badań potwierdziło polimorfizmy pojedynczego nukleotydu (SNP) związane z chorobą Alzheimera, a także zmienność liczby kopii (CNV) w genie CR1. W tym miejscu opisujemy innowacyjną metodę wyznaczania polimorfizmu długości receptora CR1. Receptor obejmuje trzy domeny, zwane długimi powtórzeniami homologicznymi (LHR)-LHR-A, LHR-C i LHR-D-oraz domenę n, LHR-B, gdzie n jest liczbą całkowitą z zakresu od 0 do 3. Wykorzystując pojedynczą parę specyficznych starterów, materiał genetyczny jest używany do amplifikacji pierwszego fragmentu domeny LHR-B (wariant amplikonu B) i drugiego fragmentu domeny LHR-C (niezmienniczy amplikon). Wariant amplikon B i niezmienniczy amplikon wykazują różnice w pięciu nukleotydach poza obszarami hybrydyzacji wspomnianych starterów. Liczbę amplikonów wariantowych B i amplikonów niezmienniczych dedukuje się za pomocą narzędzia ilościowego (krzywe topnienia o wysokiej rozdzielczości (HRM)), a stosunek amplikonu wariantowego B do amplikonu niezmienniczego różni się w zależności od polimorfizmu długości CR1. Metoda ta ma kilka zalet w porównaniu z metodą fenotypu kanonicznego, ponieważ nie wymaga świeżego materiału i jest tańsza, szybsza, a zatem ma zastosowanie do większych populacji. Tym samym zastosowanie tej metody powinno być pomocne w lepszym zrozumieniu roli izoform CR1 w patogenezie chorób takich jak AZS.
Wprowadzenie
AD, najczęstsza przyczyna demencji, dotyka ponad 30 milionów ludzi na całym świecie i stanowi poważny problem zdrowia publicznego1. Klinicznie AD charakteryzuje się zaburzeniami neuropoznawczymi prowadzącymi do postępującej utraty autonomii2. AD charakteryzuje się dwoma neuropatologicznymi cechami charakterystycznymi, a mianowicie zewnątrzkomórkowymi złogami amyloidu i wewnątrzkomórkowymi splątkami neurofibrylarnymi3.
Tradycyjnie, w zależności od wieku wystąpienia choroby, AD dzieli się na dwie formy. Pierwszym z nich jest choroba Alzheimera o wczesnym początku (EOAD), której początek występuje najczęściej przed 65 rokiem życia; ta forma stanowi mniej niż 5% przypadków AD. Jest to rzadka, autosomalnie dominująca postać choroby Alzheimera, która powoduje w pełni penetrujące mutacje w genach białka prekursorowego amyloidu (APP)4, presenilina 1 (PSEN1)5, czy presenilina 2 (PSEN2)6. Po drugie, bardziej powszechna postać choroby (>90% przypadków choroby Alzheimera) nazywana jest "sporadyczną" chorobą Alzheimera o późnym początku (LOAD) i najczęściej występuje u osób w wieku 65 lat lub starszych. Wynika to z wielu genetycznych i środowiskowych czynników ryzyka7. W LOAD allel 4 genu apolipoproteiny E (APOE) jest głównym genetycznym czynnikiem ryzyka8,9. Ponadto ponad 20 loci genów zostało zidentyfikowanych w badaniach asocjacyjnych całego genomu (GWAS) jako związanych z ryzykiem choroby Alzheimera, z których jednym jest gen receptora 1 (CR1) składnika dopełniacza (3b/4b) (CR1) 10, zlokalizowany na chromosomie 1q32 w klastrze białek związanych z dopełniaczem. Gen CR1 koduje białko receptora dopełniacza typu 1 (CR1), składnik regulatorów aktywności dopełniacza.
CR1 (receptor C3b/C4b, CD35), transbłonowa glikoproteina o sile około 200 kDa11, wiąże się z białkami dopełniacza C3b, C4b, C3bi, C1q, lektyną wiążącą mannan (MBL) i fikoliną class12. Funkcja biologiczna CR1 różni się w zależności od typów komórek, w których ulega ekspresji. U ludzi 90% całkowitego krążącego CR1 znajduje się w czerwonych krwinkach (RBC)13. Obecny na powierzchni erytrocytów, CR1 wiąże się z mikroorganizmami lub kompleksami immunologicznymi opsonizowanymi C3b lub C4b, ułatwiając ich usuwanie z krążenia. Kompleksy związane z CR1 są rzeczywiście przenoszone do fagocytów, gdy erytrocyty przechodzą przez wątrobę i śledzionę11,14. Ograniczając odkładanie się C3b i C4b, CR1 może zapobiegać nadmiernej aktywacji dopełniacza. Dlatego ekspresja CR1 na krwinkach czerwonych jest uważana za niezbędny element ochrony tkanek, takich jak mózgowy układ nerwowy, przed odkładaniem się kompleksu immunologicznego i wynikającymi z tego chorobami. Wiadomo również, że CR1 na krwinkach czerwonych odgrywa ważną rolę w infekcjach chorobotwórczych15,16. Ponadto CR1, jako kluczowy gracz w odporności wrodzonej, bierze udział w regulacji kaskady dopełniacza oraz w transporcie i klirensie kompleksów immunologicznych. CR1 wywiera tę aktywność poprzez wiązanie fragmentów C3b i C4b oraz dysocjację klasycznych i alternatywnych konwertaz (dysocjacja C2a od kompleksu C4b2a i dysocjacja C3b od kompleksu C3bBb). Jako kofaktor czynnika proteazy seryny I (FI) w osoczu, CR1 hamuje klasyczne i alternatywne szlaki dopełniacza poprzez zwiększenie rozszczepienia C4b i C3b przez FI, właściwość znaną jako aktywność kofaktora (CA), oraz poprzez hamowanie pętli amplifikacji C3, co z kolei zapobiega dalszej aktywacji dopełniacza. Rogers i współpracownicy dostarczają dowodów na to, że peptyd Aβ może wiązać i aktywować szlak dopełniacza przy braku przeciwciał17 i sugerują, że peptyd Aβ jest usuwany z krążenia poprzez zależne od dopełniacza przyleganie do CR1 wyrażonego na krwinkach czerwonych18.
CR1 wykazuje trzy typy polimorfizmów: polimorfizmy strukturalne lub długość, polimorfizmy gęstości i polimorfizmy grup krwi Knopsa11,19. Polimorfizm strukturalny jest związany ze zmianą liczby długich powtórzeń homologicznych (LHR) i w ten sposób definiuje cztery izoformy. W rzeczywistości domena zewnątrzkomórkowa białka CR1 składa się z serii powtarzających się jednostek, zwanych krótkimi powtórzeniami konsensusu (SCR) lub powtórzeniami kontrolnymi dopełniacza (CCP). Te SCR wykazano z kwasu dezoksyrybonukleinowego dopełniacza (cDNA) kodującego CR1. SCR są ułożone w tandemowe grupy po siedem, znane jako LHR. CR1 jest ułożony w cztery LHR, oznaczone jako LHR-A, -B, -C i -D, powstałe w wyniku duplikacji jednostki z siedmioma SCR19,20,21.
W rosnącej kolejności częstotliwości, te izoformy CR1 określone przez Western blot (WB) to CR1*1 (A/F) (szybka migracja w elektroforezie żelowej), CR1*2 (B/S) (powolna migracja w elektroforezie żelowej), CR1*3 (C/F') i CR1*4 (D). Dwa najczęstsze izoformy, CR1*1 (A/F) i CR1*2 (B/S), składają się odpowiednio z czterech i pięciu LHR, podczas gdy CR1*3 (C/F') i CR1*4 (D) składają się odpowiednio z 3 i 6 LHR. Najpowszechniejsza izoforma (CR1*1), składająca się z 30 SCR, zawiera trzy miejsca wiązania C4b (SCR 1-3; 8-10 i 15-17) i dwa miejsca wiązania C3b (SCR 8-10 i 15-17), podczas gdy SCR 22-28 wiążą C1q, fikoliny i MBL12,20,21,22,23,24,25. Tak więc CR1*2 zawiera jedno dodatkowe miejsce wiązania C3b/C4b w porównaniu z CR1*1. Rysunek 1 ilustruje struktury, nomenklatury i masy cząsteczkowe czterech różnych izoform CR1.
Polimorfizm gęstości odpowiada stabilnemu fenotypowi, który reprezentuje poziom konstytutywnej ekspresji CR1 na krwinkach czerwonych. U zdrowych osób rasy kaukaskiej wykazano, że liczba cząsteczek CR1 na RBC może różnić się nawet dziesięciokrotnie (od 150 do 1200 cząsteczek na komórkę)26. Erytrocyty czerwone fenotypu Helgeson mają bardzo niską gęstość CR1, która okazała się niższa niż 150 cząsteczek na komórkę27,28. Gęstość CR1 na krwinkach czerwonych jest genetycznie związana z autosomalnym kodominującym układem biallelicznym w genie CR1, skorelowanym z polimorfizmem długości fragmentu restrykcyjnego HindIII (RFLP)29. Jednopunktowa mutacja w Intronie 27 genu CR1, pomiędzy eksonami kodującymi drugi SCR w LHR-D, powoduje powstanie polimorficznego miejsca HindIII w tym regionie30. Genomowe fragmenty HindIII o masie 7,4 i 6,9 kDa identyfikują allele związane odpowiednio z wysoką (allel H) lub niską (allel L) gęstością CR1 na krwinkach czerwonych. Nie stwierdzono jednak korelacji między gęstością CR1 na krwinkach czerwonych a polimorfizmami HindIII w niektórych populacjach Afryki Zachodniej31,32. Mechanizm łączący regulację gęstości CR1 z niekodującym polimorfizmem HindIII pozostaje nieznany. Wśród kilku polimorfizmów, Q981H w SCR16 i P1786R w SCR28 stwierdzono, że są powiązane z gęstością CR1 na RBCs30,33.
Polimorfizm Knops (KN), zgodnie z międzynarodową nomenklaturą, jest 22. systemem grup krwi indeksowanym przez Międzynarodowe Towarzystwo Transfuzji Krwi. Zawiera 9 specyficzności antygenowych wyrażanych przez CR1 na krwinkach czerwonych, w tym trzy antytetyczne pary antygenowe, KN1/KN2, KN3/KN6 i KN4/KN7, a także 3 izolowane antygeny, KN5, KN8, KN9. Antygeny KN1, KN3, KN4 i KN5 są antygenami układu KN o wysokiej częstotliwości (tj. ulegającymi ekspresji u ponad 99% populacji ogólnej). Jednak rola tego polimorfizmu w AD pozostaje do ustalenia13.
Protokół opisany w tej pracy został zaprojektowany w celu określenia genotypów polimorfizmu długości CR1 związanych z podatnością na kilka chorób, takich jak AD, toczeń rumieniowaty układowy i malaria. Nasza metoda wyznaczania polimorfizmu długości CR1 wykorzystuje liczbę LHR-B składających się na izoformy CR1 oraz różnice sekwencji między LHR-B i LHR-C (rysunek 2).
Protokół
Protokół pobierania i przetwarzania krwi ludzkiej został przejrzany i zatwierdzony przez regionalną komisję etyczną (CPP Est II), a numer protokołu to 2011-A00594-37.
UWAGA: Poniższy protokół opisuje obchodzenie się z ludzką krwią. Podczas utylizacji materiałów biologicznie niebezpiecznych należy przestrzegać wytycznych instytucjonalnych. Należy stosować sprzęt ochronny, taki jak fartuchy laboratoryjne i rękawiczki. Schemat blokowy opisujący protokół przedstawiono na Rysunku 3.
1. Izolacja DNA z krwi i płynów ustrojowych
- Pipeta 20 µL proteinazy K (15 µg/µL) na dno probówki o pojemności 1,5 ml.
- Dodaj 200 µL próbki do probówki o pojemności 1,5 ml. Należy użyć do 200 µL całej krwi, osocza, surowicy, warstwy leukocytarnej (buffy coat) lub płynów ustrojowych, lub do 5 x 10⁶ limfocyty w 200 µL buforu PBS.
- Dodaj 200 µL buforu lizującego do próbki. Wymieszać za pomocą pulsacyjnego wstrząsania w wirówce (vortexingu) przez 15 s.
- Inkubować w temperaturze 56 °C przez 10 min w kąpieli wodnej.
- Krótko odwiruj probówkę o pojemności 1,5 ml, aby usunąć krople ze wewnętrznej strony zakrętki.
- Dodaj 200 µL etanolu (96-100%) do próbki i ponownie wymieszaj, stosując pulsacyjne wstrząsanie w wirówce (vortex) przez 15 s. Po wymieszaniu krótko odwiruj probówkę 1,5 ml, aby usunąć krople z wewnętrznej strony nakrętki.
- Ostrożnie nanieś mieszaninę z kroku 1.6 na kolumnę membranową (umieszczoną w 2-ml probówce zbiorczej). Zamykając zakrętkę, uważaj, aby nie zamoczyć jej krawędzi, a następnie wiruj z prędkością 6 000 x g przez 1 min. Przenieś kolumnę membranową do czystej 2-ml probówki zbiorczej i zutylizuj probówkę zawierającą filtrat.
- Ostrożnie otwórz kolumnę membranową i dodaj 500 µL buforu płuczącego 1, nie mocząc krawędzi. Zamknąć zakrętkę i wirować z prędkością 6 000 x g przez 1 min. Umieścić kolumnę membranową w czystej probówce zbiorczej o pojemności 2 mL i odrzucić probówkę zawierającą filtrat.
- Ostrożnie otwórz kolumnę membranową i dodaj 500 µL buforu płuczącego 2, nie dotykając krawędzi. Zamknąć zakrętkę i wirować z maksymalną prędkością (20 000 x g) przez 3 min.
- Umieść kolumnę membranową w nowej probówce do zbierania o pojemności 2 ml, a probówkę z filtratem wyrzuć. Wiruj z prędkością 20 000 x g przez 1 min.
- Umieścić kolumnę membranową w czystej probówce o pojemności 1,5 ml, a probówkę odbiorczą zawierającą filtrat usunąć.
- Ostrożnie otwórz kolumnę membranową i dodaj 200 µL wody destylowanej. Inkubować w temperaturze pokojowej przez 5 min, a następnie wirować z prędkością 6 000 x g przez 1 min.
- Przejdź do etapu oznaczania stężenia DNA lub zamroź próbki DNA w temperaturze -20 °C
2. Oznaczanie stężenia DNA
UWAGA: Patrz Rysunek 4.
- Naciśnij 1, aby wybrać tryb DNA w spektrofotometrze. Za pomocą strzałek lewo i prawo wybierz długość drogi optycznej 5 mm. Za pomocą strzałek lewo i prawo wybierz współczynnik rozcieńczenia 1.
- Za pomocą strzałek lewo i prawo wybierz jednostkę (µg/mL). Za pomocą strzałek lewo i prawo wybierz współczynnik 50. Naciśnij OK.
- Pipetuj 10 µL wody destylowanej do kuwety. Włóż kuwetę do spektrofotometru. Naciśnij przycisk OA/100%T.
- Pipetuj 10 µL próbki DNA (rozcieńczenie 1/4 w wodzie destylowanej) do kuwety. Włóż kuwetę do spektrofotometru. Naciśnij zielony przycisk (odczyt/start). Odnotuj stężenie.
- Zamroź próbkę DNA w temperaturze -20 °C.
3. Protokół HRM-PCR
- Rozmrozić próbki DNA. Rozcieńczyć próbki DNA w probówkach 1,5 mL wodą w celu uzyskania stężenia 10 ng/µL
UWAGA: Całkowita objętość rozcieńczonego DNA powinna wynosić od 2 µL do 10 µL. - Rozmrozić roztwory starterów. Rozcieńczyć roztwory starterów w probówkach 1,5 mL wodą w celu uzyskania tego samego stężenia 6 µM.
UWAGA: Sekwencje starterów oraz warunki reakcji podano w Tabeli 1.
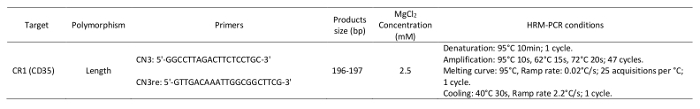
Tabela 1: Startery i parametry użyte w analizie wysokorozdzielczego topnienia (HRM).
- Odmrozić roztwory z zestawu HRM-PCR i dokładnie wymieszać w wirówce typu vortex, aby zapewnić całkowite odzyskanie zawartości. Przed otwarciem trzech probówek zawierających mieszaninę enzymatyczną z barwnikiem wiążącym DNA, MgCl2 oraz wodę, krótko odwirować je w mikrowirówce. Przechowywać w temperaturze pokojowej.
- W probówce 1,5 mL w temperaturze pokojowej przygotować mieszaninę PCR dla jednej reakcji o objętości 20 µL, dodając następujące składniki w podanej kolejności:
- 10 µL mieszaniny enzymatycznej z barwnikiem wiążącym DNA;
- 2 µL 25 mM MgCl2;
- 1 µL primera 1, 6 µM (stężenie końcowe: 300 nM);
- 1 µL primera 2, 6 µM (stężenie końcowe: 300 nM); oraz
- 5 µL wody.
UWAGA: Aby przygotować mieszaninę PCR dla więcej niż jednej reakcji, pomnożyć powyższe objętości przez liczbę reakcji do przeprowadzenia, dodając jedną dodatkową reakcję.
- Dokładnie wymieszać w wirówce typu vortex.
- Pipetować 19 µL przygotowanej powyżej mieszaniny PCR do każdego dołka białej płytki wielodołkowej.
- Dodać 1 µL matrycy DNA o skorygowanym stężeniu, przygotowanej w kroku 3.1.
UWAGA: W przypadku reakcji kontrolnych zawsze należy przeprowadzić kontrolę negatywną wraz z próbkami. Aby przygotować kontrolę negatywną, należy zastąpić matrycę DNA wodą. - Uszczelnić białą płytkę wielodołkową folią uszczelniającą.
- Umieścić białą płytkę wielodołkową w wirówce i zrównoważyć ją odpowiednim przeciwobciążeniem (t.j. inną płytką wielodołkową). Wirować przez 1 min przy 1,500 x g w standardowej wirówce z koszykiem wahadłowym, wyposażonej w rotor do płytek wielodołkowych z odpowiednimi adapterami.
- Włożyć białą płytkę wielodołkową do urządzenia HRM-PCR.
- Uruchomić program HRM-PCR z następującymi warunkami PCR:
Denaturacja: 95 °C przez 10 min; 1 cykl.
Amplifikacja: 95 °C przez 10 s, 62 °C przez 15 s oraz 72 °C przez 20 s; 47 cykli.
Krzywa topnienia: 95 °C; szybkość wzrostu temperatury: 0,02 °C/s; 25 akwizycji na °C; 1 cykl.
Chłodzenie: 40 °C przez 30 s; szybkość spadku temperatury 2,2 °C/s; 1 cykl.
4. Analiza HRM w celu określenia polimorfizmu długości CR1
UWAGA: Opisana metodologia (Rysunek 5) jest specyficzna dla naszego oprogramowania (patrz Tabela materiałów), choć można wykorzystać inne pakiety oprogramowania.
- Otwórz oprogramowanie do skanowania genów, aby przeprowadzić analizę polimorfizmu długości genu CR1.
- Otwórz eksperyment zawierający program amplifikacji oraz program krzywej topnienia.
- Kliknij Przykładowy edytor w Moduł pasek, a następnie wybierz Skanowanie przepływ pracy.
- Zdefiniuj właściwości próbek (t. j. nazwa; kontrola nieznana lub negatywna).
- Kliknij Analiza w Moduł pasek
- W Utwórz nową analizę lista, wybierz Skanowanie genów.
- Kliknij Normalizacja zakładka służąca do normalizacji krzywych topnienia.
- Kliknij w Zmiana temperatury zakładka służąca do resetowania osi temperatury (osi x) krzywych topnienia.
UWAGA: Dolny wykres przedstawia krzywe topnienia, które zostały znormalizowane oraz przesunięte pod względem temperatury. - Kliknij w Oblicz przycisk służący do analizy wyników i określenia grupowania.
- Kliknij w Wykres różnic przejdź do karty w obszarze wykresów, aby wyświetlić Znormalizowane i przesunięte krzywe topnienia oraz Wykres różnic znormalizowanych i przesuniętych temperaturowo.
Wyniki
Rycina 6A przedstawia fenotypowanie polimorfizmu długości CR1 za pomocą metody WB. Rycina 6B i C przedstawiają krzywe uzyskane podczas analizy HRM-PCR, umożliwiającej określenie polimorfizmu długości CR1. Analiza krzywych topnienia przy użyciu oprogramowania po wysokorozdzielczym topnieniu amplikonów PCR otrzymanych z genomowego DNA osób z różnymi izoformami CR1 pozwala na uzyskanie krzywych rozróżniających badanych pod kątem ich allotypowych fenotypów ekspresji CR1.
Rysunek 6B przedstawia pierwszy sposób prezentacji, nazwany „Znormalizowane i przesunięte krzywe topnienia”, podczas gdy Rysunek 6C przedstawia drugi sposób prezentacji, nazwany „Znormalizowany i przesunięty temperaturowo wykres różnic”.
Profilem krzywych są rozłożone zgodnie z grupami reprezentującymi fenotypy przedstawione na Ryc. 6A: (CR1*3, CR1*1); (CR1*1, CR1*2); CR1*1; CR1*2; oraz (CR1*2, CR1*4). Umożliwia to genotypowanie polimorfizmu długości CR1 z wykorzystaniem tej nowej metody biologii molekularnej.
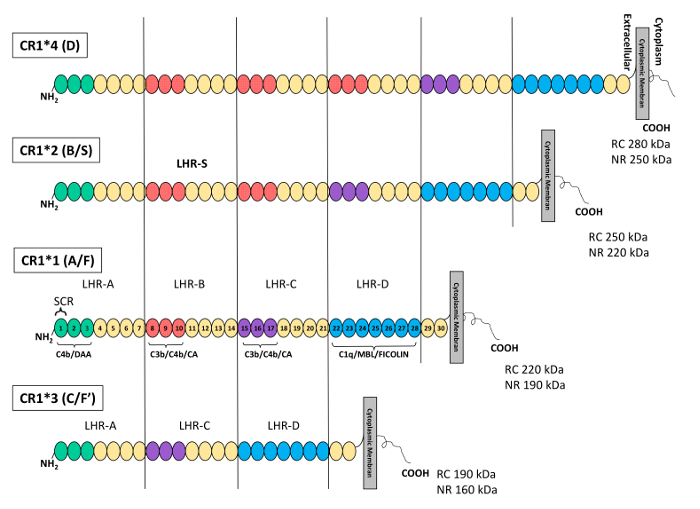
Rysunek 1: Schematyczne przedstawienie struktury i polimorfizmów białka receptora dopełniacza 1. Każda krótka sekwencja powtórzona (SCR) lub białko kontrolne dopełniacza (CCP) jest reprezentowana przez koło. Jednostki SCR są pogrupowane w powtarzalne struktury wyższego rzędu zwane LHR. Od domeny zewnątrzkomórkowej do błony komórkowej LHR to: LHR-A, -B, -C, -D oraz -S (LHR uzupełniający lub dodatkowy). W najczęstszej izoformie CR1 (CR1*1) miejsce wiązania dla aktywności przyspieszania rozpadu (DAA) C4b znajduje się w LHR-A (SCR 1-3, zielone koła), miejsce wiązania dla aktywności kofaktorowej (CA) C3b/C4b znajduje się w 3 N-terminalnych SCR LHR-B (SCR 8-10, czerwone koła) i LHR-C (SCR 15-17, fioletowe koła), a miejsce wiązania dla C1q/MBL i fikoliny znajduje się w LHR-D (SCR 22-28, niebieskie koła). Struktury homologiczne są oznaczone identycznymi kolorami. Izoforma CR1*2 (S) posiada dodatkowy LHR (LHR-S), a tym samym zawiera dodatkowe miejsce wiązania C3b/C4b. KDa, kilodalton. NRC, warunki nieredukujące. RC, warunki redukujące. TM, domena transbłonowa. Rysunek został zaadaptowany z pracy Brouwers et al.36 za zgodą Nature Publishing Group. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.

Rysunek 2: Schematyczne przedstawienie struktury izoform CR1 wraz z pozycjami amplikonów sekwencji uzyskanych metodą HRM-PCR. Każdy prostokąt reprezentuje SCR. Jednostki SCR są zgrupowane w LHR: LHR-A, -B, -C i -D. Homologiczne struktury są zaznaczone tym samym kolorem. Izoformy CR1*2 i CR1*4 posiadają dodatkowe LHR (LHR-B), a tym samym zawierają dodatkowy obszar amplikonu (amplikon B, na czerwono). W izoformie CR1*3 brakuje LHR-B, przez co obszar amplikonu jest mniejszy (brak amplikonu B). Różnice nukleotydowe między amplikonem B (196 bp) a amplikonem niezmiennym (197 bp) przedstawiono odpowiednio w kolorze czerwonym i niebieskim. Różnice w stosunku (amplikon B, na czerwono / amplikon niezmienny, na niebiesko) pomiędzy poszczególnymi izoformami CR1 są określane przez HRM-PCR, co umożliwia genotypowanie. Sekwencje starterów CN3 i CN3re są podkreślone. TM, domena transbłonowa. CYT, ogon cytoplazmatyczny. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
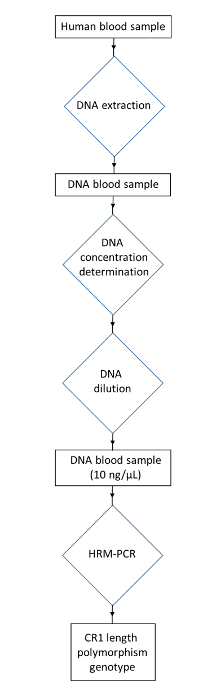
Rycina 3: Schemat blokowy protokołu genotypowania polimorfizmu długości CR1 z próbek krwi ludzkiej. Pobranie próbki ludzkiego DNA. Ekstrakcja DNA w celu uzyskania próbki DNA z krwi. Oznaczenie stężenia DNA i rozcieńczenie do uzyskania stężenia DNA 10 ng/µL. Zastosowanie HRM-PCR w celu wyznaczenia genotypu polimorfizmu długości CR1. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
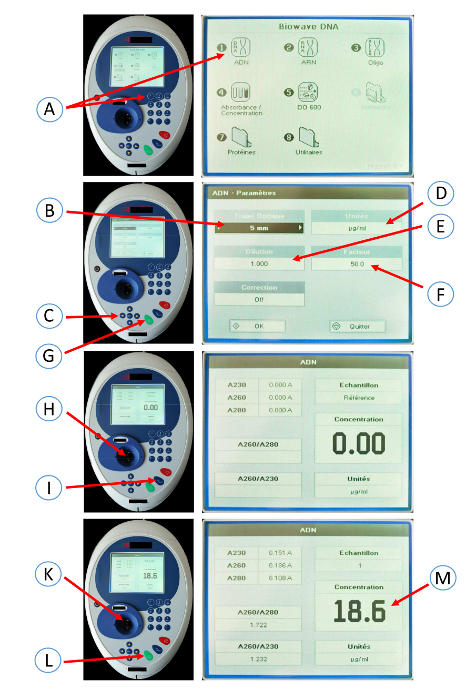
Rycina 4: Zrzuty ekranu ze spektrofotometru użytego do oznaczenia stężenia DNA. Naciśnij 1 (A), aby wybrać tryb DNA w spektrofotometrze. Wybierz długość drogi optycznej 5 mm (B) za pomocą strzałek lewo i prawo (C). Wybierz jednostkę (µg/mL) (D) za pomocą strzałek lewo i prawo (C). Wybierz czynnik rozcieńczenia 1 (E) za pomocą strzałek lewo i prawo (C). Wybierz mnożnik 50 (F) za pomocą strzałek lewo i prawo. Naciśnij OK (G). Pipetuj 10 µL wody destylowanej do kuwety. Włóż kuwetę do spektrofotometru (H). Naciśnij przycisk OA/100%T (I). Pipetuj 10 µL próbki DNA (rozcieńczenie 1/4 w wodzie destylowanej) do kuwety. Włóż kuwetę do spektrofotometru (K). Naciśnij zielony przycisk (odczyt/start) (L). Odczytaj stężenie (M). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
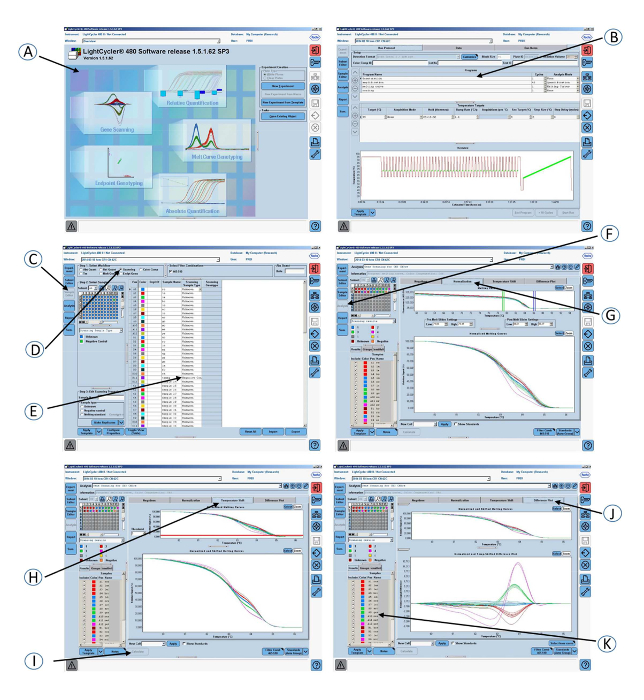
Rysunek 5: Zrzuty ekranu interfejsu graficznego oprogramowania użytego w kroku 4 protokołu. (A) Otwórz oprogramowanie do skanowania genów. (B) Program amplifikacji i program krzywej topnienia. (C) Kliknij Sample editor w pasku Module. (D) Wybierz Scanning. (E) Zdefiniuj właściwości próbek. (F) Kliknij Analysis w pasku Module. (G) Kliknij kartę Normalization, aby znormalizować krzywe topnienia. (H) Kliknij kartę Temperature shift, aby wyświetlić krzywe topnienia, które są zarówno znormalizowane, jak i przesunięte temperaturowo. (I) Kliknij przycisk Calculate, aby przeanalizować wyniki i określić grupowanie. (J) Kliknij kartę Difference plot, aby wyświetlić Normalized and Shifted Melting Curves oraz Normalized and Temperature Shifted Difference Plot. (K) Kolorowe grupowanie próbek zgodnie z genotypami długości CR1. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 6: Fenotypowanie polimorfizmów długości CR1 zaobserwowanych w WB oraz odpowiadające im krzywe profilu uzyskane metodą HRM-PCR. (A) Fenotypowanie polimorfizmów długości CR1 z wykorzystaniem WB. (B) i (C) Genotypowanie polimorfizmów długości CR1 z wykorzystaniem analizy HRM-PCR. Analiza krzywych HRM amplikonów PCR uzyskanych z DNA genomowego badanych wykazujących różne izoformy CR1 doprowadziła do identyfikacji specyficznych profili krzywych: (CR1*3, CR1*1) (fioletowy); (CR1*1, CR1*2) (niebieski); CR1*1 (zielony); CR1*2 (czerwony); oraz (CR1*2, CR1*4) (szary). Odpowiadają one allelom polimorfizmu długości CR1. Jak pokazują dwa tryby prezentacji — „Znormalizowane i przesunięte krzywe topnienia” (B) oraz „Znormalizowany i przesunięty temperaturowo wykres różnic” (C) — profile krzywych są rozłożone zgodnie z grupami (CR1*3, CR1*1); (CR1*1, CR1*2); CR1*1; CR1*2; oraz (CR1*2, CR1*4). Rycina została zaadaptowana z pracy Mahmoudi et al.38 za zgodą wydawnictwa Elsevier. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dyskusja
W tym miejscu opisujemy szeroko dostępną metodologię badania polimorfizmów długości CR1. Techniki biologii molekularnej dotyczące amplifikacji lub hybrydyzacji segmentowej nigdy nie były w stanie dać zadowalających wyników, które pozwoliłyby na określenie polimorfizmów długości CR1 u wszystkich osobników. Dzieje się tak ze względu na powtarzalną strukturę genu CR1 (tj. wysoce powtarzalne SCR CR1). Opisana tutaj metoda biologii molekularnej wykorzystuje ilościowy rozkład LHR-B w cząsteczce CR1. Cząsteczka CR1 zawiera n domen LHR-B, gdzie n jest liczbą z zakresu od 0 do 3 i tylko jedną domenę LHR-C, jak opisano i zilustrowano na rysunku 2. Ilościowe wykrywanie domeny B umożliwia doskonałe rozróżnienie jednej dodatkowej lub brakującej domeny B.
Z wyekstrahowanego materiału genetycznego pierwszy fragment DNA z LHR-B jest amplifikowany metodą PCR przy użyciu pojedynczej pary specyficznych starterów, reprezentujących charakterystyczny wariant LHR-B zwany "wariantem amplikonu B". Drugi fragment DNA, zwany "niezmiennym amplikonem" i należący do LHR-C, jest również amplifikowany. Ten drugi fragment DNA jest fragmentem LHR-C, ale można również użyć innego niezmienniczego fragmentu LHR-A lub -D.
Dwa fragmenty DNA, wariant amplikonu B i niezmienny amplikon, są amplifikowane przez te same startery i wykazują pięć różnic w sekwencjach nukleotydowych. Cecha ta umożliwia w kolejnym kroku określenie liczby wariantów amplikonów B i liczby niezmiennych amplikonów za pomocą dostosowanego do tego celu ilościowego narzędzia biologii molekularnej, HRM. Stosunek liczby amplikonów B do niezmienniczego amplikonu (stosunek: amplikon B / niezmienniczy amplikon) zmienia się w zależności od długości cząsteczki CR1. Rzeczywiście, CR1*4 wyświetla 3 jednostki amplikonu B na 1 niezmienniczy amplikon, CR1*2 wyświetla 2 jednostki amplikonu B na 1 niezmienniczy amplikon, CR1*1 wyświetla 1 amplikon B na 1 niezmienniczy amplikon, a CR1*3 wyświetla 0 jednostek amplikonu B na 1 niezmienniczy amplikon (rysunek 2). Tak więc ta metoda HRM-PCR umożliwia genotypowanie polimorfizmu długości CR1.
Niemniej jednak, na początku badania, technika ta wymaga wykorzystania osób referencyjnych, których fenotypy CR1 są już znane (tj. wcześniej ustalone przez WB), aby móc ustalić genotypowanie CR1 zgodnie z profilem referencyjnym krzywych uzyskanych metodą HRM-PCR. Dostępne są dwa typy reprezentacji, a mianowicie "Znormalizowane i przesunięte krzywe topnienia" oraz "Znormalizowany i przesunięty temperaturowo wykres różnicowy". Wykazują one wyraźne grupy profili krzywych pokolorowanych zgodnie z fenotypowaniem polimorfizmu długości CR1 uzyskanym przez WB (Rysunek 6). Począwszy od kroku "Znormalizowane i przesunięte krzywe topnienia", nasza metoda umożliwia rozróżnienie odrębnych grup krzywych odpowiadających izoformom CR1, pogrupowanych według koloru. Jednak "Znormalizowany i przesunięty temperaturowo wykres różnicowy", który odpowiada innej reprezentacji matematycznej, pozwala na łatwiejszą wizualizację odrębnych grup krzywych. Chociaż oprogramowanie producenta było rutynowo używane w tym badaniu, inne oprogramowanie (takie jak uANALYSE) może być używane jako program do ekstrakcji danych do analizy krzywych.
Do tej pory technika analizy WB jest oryginalną techniką, która umożliwia identyfikację różnych polimorfizmów długości CR1 na poziomie białka. Jednak ta technika ma szereg wad. W szczególności analizę białek za pomocą WB można przeprowadzić dopiero po ekstrakcji błon komórkowych. W związku z tym jest to skomplikowane i bardzo czasochłonne. Co więcej, technika ta wymaga pobrania próbki świeżej krwi w odpowiednich warunkach na początku zabiegu, aby osiągnąć użyteczne wyniki. Wręcz przeciwnie, HRM-PCR wykonywany na DNA umożliwia wykorzystanie nawet suchych plam krwi lub próbek po długotrwałym przechowywaniu. HMR-PCR wymaga specjalistycznego przyrządu do topienia DNA, dedykowanego instrumentu lub termocyklera o pojemności HMR z oprogramowaniem HRM. Wykrywanie SNP zależy od kilku czynników: i) SNP zawarte w dużych fragmentach PCR są trudniejsze do wykrycia niż te same SNP w małych fragmentach PCR; ii) SNP należące do klas III i IV są trudniejsze do wykrycia niż te z klas I i II34; oraz iii) SNP, które są otoczone symetrią podstawy najbliższego sąsiada (np. 5'-G(G/C) C-3') nie mogą być sortowane przez topnienie, niezależnie od mocy rozdzielczości platformy HMR. Przydatne może być przetestowanie przewidywanych fragmentów PCR zawierających SNP będący przedmiotem zainteresowania za pomocą oprogramowania uMELT35 w celu oceny ważności testu. Wreszcie, HMR-PCR jest metodą analogiczną, co oznacza, że podobieństwo krzywych topnienia między odniesieniem a matrycą niekoniecznie oznacza, że sekwencja szablonu jest identyczna z odniesieniem, ponieważ sekwencja szablonu może różnić się od odniesienia, ale termodynamicznie równoważna. Ograniczenia te nie dotyczą jednak opisywanej tu metody, która opiera się na stopieniu mieszaniny amplikonów różniących się pod względem 5 sekwencji nukleotydowych.
Ponadto opisana tutaj technika, oparta na analizie HRM, ma wiele zalet. Po pierwsze, polimorfizmy długości CR1 są oznaczane szybciej, ponieważ wyniki uzyskuje się w ciągu około 2 godzin od przeprowadzenia ekstrakcji materiału genetycznego. I odwrotnie, tradycyjne techniki biochemiczne oparte na analizie białek WB wymagają etapów, które są stosunkowo długie: elektroforezy ekstraktów błony komórkowej przez żel akrylamidowy, etapu przenoszenia białek do membrany nitrocelulozowej lub polifluorku winylidenu (PVDF) oraz etapu identyfikacji izoform cząsteczki CR1 za pomocą immunochemiluminescencji. Po drugie, technika HRM-PCR ma również tę zaletę, że nie jest zbyt droga, co jest szczególnie ważne w przypadku metody, która może być stosowana u wielu osób (tj. na dużą skalę) w celu określenia ich podatności na rozwój patologii, takich jak choroba Alzheimera, toczeń czy malaria.
Ostatnio my i inni wykazaliśmy, że izoforma CR1*2, która zawiera jedno dodatkowe miejsce wiązania C3b/C4b, była związana z AD 36,37,38. W naszym wcześniej opublikowanym badaniu polimorfizmy długości CR1 na poziomie genu i białka były spójne u 98,9% badanych38. Niezgodne wyniki uzyskane przy porównaniu polimorfizmów długości uzyskanych metodą HRM-PCR z polimorfizmami uzyskanymi metodą WB odpowiadały osobom z profilem genotypu (CR1*1, CR1*2) określonym przez HRM (gen), ale wykazującym ekspresję tylko izoformy CR1*1 na powierzchni erytrocytów zgodnie z WB (białko). W naszym badaniu brak ekspresji izoformy CR1 * 2 (osoby z cichym allelem) był powtarzalny, gdy WB wykonywano z dłuższym czasem ekspozycji i można go wytłumaczyć istnieniem cichego allelu CR1 (CR1 * 2), opisanego w literaturze przez Helgesona39. Niemniej jednak potrzebne są dalsze badania na większych populacjach, aby potwierdzić tę hipotezę.
Należy zauważyć, że prywatne SNP (SNP występujące tylko w małej grupie rodzinnej lub nawet u pojedynczej osoby) prowadziły do odrębnych profili krzywych, które powinny być rozszyfrowane za pomocą referencyjnego określania fenotypu (WB), ale nie można ich mylić z profilem kanonicznym, aby uniknąć błędnej interpretacji genotypu polimorfizmu długości CR1.
Oświadczenia
Autorzy są wynalazcami patentu należącego do Uniwersytetu Szampanii-Ardenów w Reims (URCA) (numer patentu WO 2015166194)
Podziękowania
Dziękujemy wszystkim członkom Plateforme Régionale de Biologie Innovante, personelowi Zakładu Immunologii oraz personelowi Oddziału Chorób Wewnętrznych i Geriatrii, którzy przyczynili się do optymalizacji i walidacji protokołu. Praca ta została sfinansowana przez Szpital Uniwersytecki w Reims (grant nr AOL11UF9156). Dziękujemy również Fionie Ecarnot (EA3920, Szpital Uniwersytecki w Besançon, Francja) za pomoc redakcyjną.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Ochrona fartucha | |||
| SensiCareBezpudrowe rękawice nitrylowe do lodu | Medline Industries, Inc, Mundelein, IL 60060, USA | 486802 | ochrona próbki |
| Pipeta Eppendorf Reference 2, 0,5-10 i mikro; L | Eppendorf France SAS, F-78360 Montesson, Francja | Pipeta | pipetowania próbek |
| 4920000024 Eppendorf Reference 2, 20-100 i mikro; L | Eppendorf France SAS, F-78360 Montesson, Francja | 4920000059 | pipetowanie próbek Pipeta |
| Eppendorf Reference 2, 100-1000 i mikro; L | Eppendorf France SAS, F-78360 Montesson, Francja | 4920000083 | pipetowanie próbek |
| TipOne 10µ L Stopniowana, końcówka filtra | Starlab GmbH, D-22926 Ahrenburg, Niemcy | S1121-3810 | pipetowanie próbek |
| TipOne 1-100µ L fazowana, końcówka filtra | Starlab GmbH, D-22926 Ahrenburg, Niemcy | S1120-1840 | pipetowanie próbek |
| ART 1000E Końcówka barierowa | Thermo Fischer Scientific , F-67403 Illkirch, Francja | 2079E | pipetowanie próbek |
| Probówki Eppendorf Safe-Lock, 1,5 mL, Eppendorf Quality | Eppendorf France SAS, F-78360 Montesson, Francja | 0030120086 | mix |
| Vortex-Genie 2 | Scientific Industries, Inc, Bohemia, NY 111716, USA | SI-0236 | mix |
| QIAamp DNA Mini Kit (250) | Qiagen SA, F-91974 Courtaboeuf, Francja | 51306 | Bufor do ekstrakcji DNA |
| AL | Qiagen SA, F-91974 Courtaboeuf, Francja | 19075 | Bufor do lizy |
| QIAamp Mini Spin Column | Qiagen SA, F-91974 Courtaboeuf, Francja | 1011706 | wiążący DNA |
| AW1 | Qiagen SA, F-91974 Courtaboeuf, Francja | 19081 | Bufor płuczący |
| Bufor AW2 | Qiagen SA, F-91974 Courtaboeuf, Francja | 19072 | Bufor płuczący |
| Spektrofotometr DNA | Biowave Biochrom Ltd, Cambridge CB4 OFJ, Anglia | 80-3004-70 | Koncentracja DNA |
| Wirówka Mikro 200 | Hettich Zentrifugen, D-78532, Niemcy | 0002020-02-00 | wirówka |
| Multipette E3 | Eppendorf France SAS, F-78360 Montesson, Francja | 4987000010 | dystrybucja |
| Light Cycler 480 multiwell plate 96, biały | Roche Diagnostics GmbH, D-68305 Mannheim, Niemcy | 04729692001 | miejsce reakcji |
| Folia uszczelniająca Light Cycler 480 | Roche Diagnostics GmbH, D-68305 Mannheim, Niemcy | 04429757001 | zasięg |
| Wirówka Heraeus Megafuge 11R | Thermo Fischer Scientific , F-67403 Illkirch, Francja | 75004412 | wirówka |
| LightCycler 480 Instrument II, 96-well | Roche Diagnostics GmbH, D-68305 Mannheim, Niemcy | 05015278001 | wysokiej rozdzielczości topnienie polimerazy reakcja łańcuchowa |
| LightCycler 480 High Resolution Melting Master | Roche Diagnostics GmbH, D-68305 Mannheim, Niemcy | 04909631001 | odczynniki |
| reakcyjneoprogramowanie light cycler 480 SW 1.5.1 | Roche Diagnostics GmbH, D-68305 Mannheim, Niemcy | oprogramowanie używane do analizy danych polimorfizmu HRM PCR CR1 | |
| Starter CN3: 5'ggccttagacttcctgc 3'Eurogentec | Biologics Division, B-4102 Seraing, Belgia | odczynnik reakcyjny | |
| Starter CN3re: 5'gttgacaaaattggcggcttcg 3'Eurogentec | Biologics Division, B-4102 Seraing, Belgia | reakcja Odczynnik |
Bibliografia
- Prince, M., et al. World Alzheimer Report 2015, The Global Impact of Dementia: An analysis of prevalence, incidence, cost and trends. Alzheimer's Disease International. , (2015).
- McKhann, G. M., et al. The diagnosis of dementia due to Alzheimer's disease: recommendations from the National Institute on Aging-Alzheimer's Association workgroups on diagnostic guidelines for Alzheimer's disease. Alzheimers Dement. 7 (3), 263-269 (2011).
- Serrano-Pozo, A., Frosch, M. P., Masliah, E., Hyman, B. T. Neuropathological alterations in Alzheimer disease. Cold Spring Harb Perspect Med. 1 (1), 006189(2011).
- Goate, A., et al. Segregation of a missense mutation in the amyloid precursor protein gene with familial Alzheimer's disease. Nature. 349 (6311), 704-706 (1991).
- Sherrington, R., et al. Cloning of a gene bearing missense mutations in early-onset familial Alzheimer's disease. Nature. 375 (6534), 754-760 (1995).
- Levy-Lahad, E., et al. A familial Alzheimer's disease locus on chromosome 1. Science. 269 (5226), 970-973 (1995).
- Mayeux, R., Stern, Y. Epidemiology of Alzheimer disease. Cold Spring Harb Perspect Med. 2 (8), (2012).
- Corder, E. H., et al. Gene dose of apolipoprotein E type 4 allele and the risk of Alzheimer's disease in late onset families. Science. 261 (5123), 921-923 (1993).
- Yu, J. T., Tan, L., Hardy, J. Apolipoprotein E in Alzheimer's disease: an update. Annu Rev Neurosci. 37, 79-100 (2014).
- Lambert, J. C., et al. Genome-wide association study identifies variants at CLU and CR1 associated with Alzheimer's disease. Nat Genet. 41 (10), 1094-1099 (2009).
- Liu, D., Niu, Z. X. The structure, genetic polymorphisms, expression and biological functions of complement receptor type 1 (CR1/CD35). Immunopharmacol Immunotoxicol. 31 (4), 524-535 (2009).
- Jacquet, M., et al. Deciphering complement receptor type 1 interactions with recognition proteins of the lectin complement pathway. J Immunol. 190 (7), 3721-3731 (2013).
- Pham, B. N., et al. Analysis of complement receptor type 1 expression on red blood cells in negative phenotypes of the Knops blood group system, according to CR1 gene allotype polymorphisms. Transfusion. 50 (7), 1435-1443 (2010).
- Cosio, F. G., Shen, X. P., Birmingham, D. J., Van Aman, M., Hebert, L. A. Evaluation of the mechanisms responsible for the reduction in erythrocyte complement receptors when immune complexes form in vivo in primates. J Immunol. 145 (12), 4198-4206 (1990).
- Krych-Goldberg, M., Moulds, J. M., Atkinson, J. P. Human complement receptor type 1 (CR1) binds to a major malarial adhesin. Trends Mol Med. 8 (11), 531-537 (2002).
- Cohen, J. H., Geffriaud, C., Caudwell, V., Kazatchkine, M. D. Genetic analysis of CR1 (the C3b complement receptor, CD35) expression on erythrocytes of HIV-infected individuals. Aids. 3 (6), 397-399 (1989).
- Rogers, J., et al. Complement activation by beta-amyloid in Alzheimer disease. Proc Natl Acad Sci USA. 89 (21), 10016-10020 (1992).
- Rogers, J., et al. Peripheral clearance of amyloid beta peptide by complement C3-dependent adherence to erythrocytes. Neurobiol Aging. 27 (12), 1733-1739 (2006).
- Krych-Goldberg, M., Atkinson, J. P. Structure-function relationships of complement receptor type 1. Immunol Rev. 180, 112-122 (2001).
- Klickstein, L. B., et al. Human C3b/C4b receptor (CR1). Demonstration of long homologous repeating domains that are composed of the short consensus repeats characteristics of C3/C4 binding proteins. J Exp Med. 165 (4), 1095-1112 (1987).
- Hourcade, D., Miesner, D. R., Atkinson, J. P., Holers, V. M. Identification of an alternative polyadenylation site in the human C3b/C4b receptor (complement receptor type 1) transcriptional unit and prediction of a secreted form of complement receptor type 1. J Exp Med. 168 (4), 1255-1270 (1988).
- Krych, M., Hourcade, D., Atkinson, J. P. Sites within the complement C3b/C4b receptor important for the specificity of ligand binding. Proc Natl Acad Sci USA. 88 (10), 4353-4357 (1991).
- Krych-Goldberg, M., et al. Decay accelerating activity of complement receptor type 1 (CD35). Two active sites are required for dissociating C5 convertases. J Biol Chem. 274 (44), 31160-31168 (1999).
- Klickstein, L. B., Barbashov, S. F., Liu, T., Jack, R. M., Nicholson-Weller, A. Complement receptor type 1 (CR1, CD35) is a receptor for C1q. Immunity. 7 (3), 345-355 (1997).
- Ghiran, I., et al. Complement receptor 1/CD35 is a receptor for mannan-binding lectin. J Exp Med. 192 (12), 1797-1808 (2000).
- Cornillet, P., Philbert, F., Kazatchkine, M. D., Cohen, J. H. Genomic determination of the CR1 (CD35) density polymorphism on erythrocytes using polymerase chain reaction amplification and HindIII restriction enzyme digestion. J Immunol Methods. 136 (2), 193-197 (1991).
- Moulds, J. M., Nickells, M. W., Moulds, J. J., Brown, M. C., Atkinson, J. P. The C3b/C4b receptor is recognized by the Knops, McCoy, Swain-langley, and York blood group antisera. J Exp Med. 173 (5), 1159-1163 (1991).
- Moulds, J. M., Moulds, J. J., Brown, M., Atkinson, J. P. Antiglobulin testing for CR1-related (Knops/McCoy/Swain-Langley/York) blood group antigens: negative and weak reactions are caused by variable expression of CR1. Vox Sang. 62 (4), 230-235 (1992).
- Wilson, J. G., et al. Identification of a restriction fragment length polymorphism by a CR1 cDNA that correlates with the number of CR1 on erythrocytes. J Exp Med. 164 (1), 50-59 (1986).
- Wong, W. W., et al. Structure of the human CR1 gene. Molecular basis of the structural and quantitative polymorphisms and identification of a new CR1-like allele. J Exp Med. 169 (3), 847-863 (1989).
- Herrera, A. H., Xiang, L., Martin, S. G., Lewis, J., Wilson, J. G. Analysis of complement receptor type 1 (CR1) expression on erythrocytes and of CR1 allelic markers in Caucasian and African American populations. Clin Immunol Immunopathol. 87 (2), 176-183 (1998).
- Rowe, J. A., et al. Erythrocyte CR1 expression level does not correlate with a HindIII restriction fragment length polymorphism in Africans; implications for studies on malaria susceptibility. Genes Immun. 3 (8), 497-500 (2002).
- Birmingham, D. J., et al. A polymorphism in the type one complement receptor (CR1) involves an additional cysteine within the C3b/C4b binding domain that inhibits ligand binding. Mol Immunol. 44 (14), 3510-3516 (2007).
- Venter, J. C., et al. The sequence of the human genome. Science. 291 (5507), 1304-1351 (2001).
- Dwight, Z., Palais, R., Wittwer, C. T. uMELT: prediction of high-resolution melting curves and dynamic melting profiles of PCR products in a rich web application. Bioinformatics. 27 (7), 1019-1020 (2011).
- Brouwers, N., et al. Alzheimer risk associated with a copy number variation in the complement receptor 1 increasing C3b/C4b binding sites. Mol Psychiatry. 17 (2), 223-233 (2012).
- Hazrati, L. N., et al. Genetic association of CR1 with Alzheimer's disease: a tentative disease mechanism. Neurobiol Aging. 33 (12), 2945-2949 (2012).
- Mahmoudi, R., et al. Alzheimer's disease is associated with low density of the long CR1 isoform. Neurobiol. Aging. 36, 1712-1765 (2015).
- Helgeson, M., Swanson, J., Polesky, H. F. Knops-Helgeson (Kna), a high-frequency erythrocyte antigen. Transfusion. 10 (3), 137-138 (1970).
Przedruki i uprawnienia
