Opisujemy tutaj technikę, która łączy mutagenezę transpozonów z sekwencjonowaniem o wysokiej przepustowości w celu identyfikacji i ilościowego określenia transpozonów mutantów leptospiralnych w tkankach po wyzwaniu chomików. Protokół ten może być stosowany do badań przesiewowych mutantów pod kątem przeżycia i rozprzestrzeniania się u zwierząt, a także może być stosowany w badaniach in vitro.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Wysokoprzepustowe sekwencjonowanie równoległe w celu pomiaru sprawności Leptospira interrogans Mutanty insercji transpozonów podczas infekcji złotego chomika syryjskiego
W tym artykule
Podsumowanie
Streszczenie
W tym manuskrypcie opisujemy technikę sekwencjonowania transpozonów (Tn-Seq) w celu identyfikacji i ilościowego określenia mutantów Leptospira interrogans, które zmieniły swoją przydatność podczas infekcji złotych chomików syryjskich. Tn-Seq łączy losową mutagenezę transpozonów z mocą technologii sekwencjonowania o wysokiej przepustowości. Zwierzęta są poddawane próbie pobrania puli mutantów transpozonów (pula wejściowa), a następnie pobraniu krwi i tkanek kilka dni później w celu zidentyfikowania i ilościowego określenia liczby mutantów w każdym narządzie (pule wyjściowe). Pule wyjściowe są porównywane z pulą wejściową w celu oceny dopasowania in vivo każdego mutanta. Takie podejście umożliwia badania przesiewowe dużej puli mutantów u ograniczonej liczby zwierząt. Z niewielkimi modyfikacjami protokół ten można przeprowadzić z dowolnym zwierzęcym modelem leptospirozy, modelami żywiciela rezerwuarowego, takimi jak szczury i modelami ostrej infekcji, takimi jak chomiki, a także z badaniami in vitro. Tn-Seq stanowi potężne narzędzie do badań przesiewowych w kierunku mutantów z wadami sprawności in vivo i in vitro.
Wprowadzenie
Identyfikacja genów wirulencji dla niektórych bakterii, takich jak Leptospira spp., jest trudna ze względu na ograniczoną liczbę dostępnych narzędzi genetycznych. Jednym z powszechnie stosowanych podejść jest stworzenie kolekcji mutantów poprzez losową mutagenezę transpozonów, a następnie identyfikację miejsca insercji w każdym mutancie i testowanie wirulencji poszczególnych mutantów transpozonów w modelu zwierzęcym. Takie podejście jest czasochłonne, kosztowne i wymaga dużej liczby zwierząt.
Gdy po raz pierwszy opracowano losową mutagenezę dla patogenu Leptospira interrogans, geny odpowiedzialne za wirulencję zostały zidentyfikowane poprzez testowanie poszczególnych mutantów na modelu zwierzęcym1. Mutanty wybrano na podstawie takich kryteriów, jak ich potencjalna rola w sygnalizacji lub ruchliwości lub przewidywane położenie błony zewnętrznej lub powierzchni. Ponieważ większość genów leptospirali koduje hipotetyczne białka o nieznanej funkcji2, selekcja mutantów na podstawie tych kryteriów ogranicza możliwość odkrycia nowych genów wirulencji leptospirali.
Niedawno, pule mutantów transpozonów L. interrogans zostały przebadane pod kątem zakaźności w modelach chomików i myszy3. Każde zwierzę zostało wyzwane, a pula składająca się z maksymalnie 10 mutantów. Zakaźność mutanta została oceniona jako pozytywna, jeśli została wykryta za pomocą PCR kultur uzyskanych z krwi i nerek. Testy PCR były pracochłonne, ponieważ wymagały indywidualnej reakcji PCR dla każdego mutanta w puli. Ponieważ częstość występowania każdego mutanta w kulturach nie została określona ilościowo, podejście było skłaniane ku identyfikacji wysoce atenuowanych mutantów.
Opisujemy technikę sekwencjonowania transpozonów (Tn-Seq), jako strategię bardziej efektywnego badania genów wirulencji. Tn-seq polega na stworzeniu biblioteki mutantów poprzez mutagenezę transpozonów, po której następuje masowe sekwencjonowanie równoległe4,5,6. Krótko mówiąc, mutanty transpozonów są łączone, szczepione zwierzętom, a następnie odzyskiwane z różnych narządów (pule wyjściowe). DNA z pul wyjściowych jest ekstrahowane i trawione za pomocą enzymów restrykcyjnych lub ścinane za pomocą sonikacji. Wykonywane są dwie rundy PCR ukierunkowane na połączenia miejsc wprowadzania transpozonów. Ten krok umożliwia dodanie adapterów niezbędnych do sekwencjonowania. Otrzymane produkty PCR są analizowane za pomocą sekwencjonowania o wysokiej przepustowości w celu zidentyfikowania miejsca insercji transpozonów każdego mutanta w puli wraz z ich względną liczebnością, która jest porównywana z początkowym składem puli mutantów.
Główną zaletą tego podejścia jest możliwość jednoczesnego badania dużej liczby mutantów z małą liczbą zwierząt. Tn-Seq nie wymaga wcześniejszej wiedzy na temat miejsc insercji transpozonów, co zwiększa szanse na odkrycie nowych genów specyficznych dla Leptospira zaangażowanych w wirulencję w krótszym czasie i z większą wydajnością. Ponieważ obciążenie leptospiralą w tkankach jest stosunkowo wysokie w modelach gryzoni podatnych na śmiertelną infekcję (zwykle 104 do 108 bakterii/g tkanki)7,8,9, a także w zbiornikach hostów10,11, tkanki mogą być bezpośrednio analizowane bez konieczności hodowli, zmniejszając odchylenia spowodowane wzrostem in vitro.
W badaniach Tn-Seq z większością opisanych do tej pory patogenów bakteryjnych, wysoka częstotliwość mutagenezy insercyjnej pozwoliła na infekcję dużymi pulami zawierającymi mutanty mające łącznie wiele blisko rozmieszczonych insercji transpozonów w obrębie każdego genu4,12,13,14. Tn-Seq został również opracowany dla bakterii, dla której częstość mutagenezy jest znacznie niższa6. W przypadku Leptospira biblioteka mutantów transpozonów może być generowana przez wprowadzenie transpozonu do mobilizowalnego plazmidu przez koniugację, jak opisano przez Slamti et al15. Jednak częstość mutagenezy transpozonów L. interrogans jest niska. Kiedy transpozon Himar1 został wprowadzony na plazmidzie koniugacyjnym, stwierdzono, że częstość transkoniugantów wynosi tylko 8,5 x 10⁻⁸ na komórkę biorcy ze szczepem Lai L. interrogans16 i prawdopodobnie będzie podobnie słaba w przypadku większości innych szczepów L. interrogans. Opisany tutaj protokół jest częściowo oparty na protokole opracowanym dla Borrelia burgdorferi, w którym częstość mutagenezy insercyjnej transpozonów jest również niska6.
Dla naszego eksperymentu pilotażowego z protokołem17, przeprowadziliśmy mutagenezę transpozonów z L. interrogans serowar Manilae szczep L495 ze względu na sukces innych grup w izolowaniu mutantów inserozyjności transpozonów w szczepie wraz z jego niską LD50 (dawką śmiertelną) dla zjadliwości1. Przebadaliśmy 42 mutanty za pomocą Tn-Seq i zidentyfikowaliśmy kilku kandydatów na mutanty z wadami zjadliwości, w tym dwa z insercjami w kandydującym genie cyklazy adenylanowej. Indywidualne testy dwóch mutantów u chomików potwierdziły, że mają one niedobór zjadliwości17.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
OSTROŻNIE: Patogenne szczepy Leptospira spp. muszą być przetwarzane zgodnie z procedurami poziomu bezpieczeństwa biologicznego 2 (BSL-2). Należy stosować odpowiednie środki ochrony indywidualnej (PPE). Wszystkie manipulacje z patogennymi Leptospira spp. muszą być wykonywane w komorze bezpieczeństwa biologicznego klasy II.
1. Tworzenie biblioteki mutantów transpozonowych15
- Transfer transpozonu do Leptospira gat.. poprzez konjugację (Rycina 1)
- Zaszczepić objętość hodowli patogennej w fazie wykładniczej Leptospira gatunki odpowiadające 107 komórki do 10 ml pożywki Ellinghausen-McCullough-Johnson-Harris (EMJH)18,19Inkubować w temperaturze 30 °C przy wstrząsaniu z prędkością 150 obr./min, aż do osiągnięcia gęstości 2–8 x 10⁸ komórek/ml
UWAGA: Czas podwojenia liczby patogennych leptospir jest od 12 do 24 h, w zależności od szczepu. - Zaszczepić 50 µL dawcy Escherichia coli szczep β216320 noszący mobilizowalny plazmid transpozonalny (pCjTKS2)16 do 5 ml pożywki Luria Broth (LB) uzupełnionej o 0,3 mM kwasu 2,6-diaminopimeliowego (DAP), 50 µg/mL kanamycyny (Km) oraz 50 µg/mL spektynomycyny (Spc) i pozostawić na noc w 37 °C inkubator przy 255 obr./min.
- Zaszczepić 60 µL z *E. coli* komórki do 3 ml pożywki EMJH uzupełnionej o 0,3 mM DAP (EMJH+DAP). Inkubować w 37 °C przy wytrząsaniu z prędkością 255 obr./min przez 3–4 h aż do osiągnięcia OD600 nm≈ 0.3.
- Aby złożyć jednostkę filtracyjną (Rycina 1), umieścić podstawkę na kolbie Erlenmeyera z odbojnicą o pojemności 125 ml, umieścić filtr z octanu celulozy (wielkość porów 0,1 mm; średnica 25 mm) na podstawce, a następnie zamocować lejek do podstawki za pomocą zacisku. Podłączyć zestaw filtracyjny do systemu próżniowego.
- Dodać 5 ml Leptospira spp.hodowlę i 0,5 ml *E. coli* przenieść kulturę do lejka. Odessać ciecz przez filtr.
- Przenieś filtr powierzchnią z bakteriami skierowaną do góry na płytkę z pożywką EMJH+DAP. Inkubuj w temperaturze 30 °C przez noc z filtrem skierowanym do góry.
- Umieść filtr w probówce o pojemności 15 ml zawierającej 1 ml pożywki EMJH i mieszaj w wstrząsarce (vortex) przez 10 s, aby uwolnić bakterie do medium. Rozsmaruj 200 µL zawiesiny na 5 płytki EMJH zawierające 50 µg/mL K₂using 10-15 1 mm sterylnych szklanych kulek lub sterylnego jednorazowego rozpylacza. Szalki owinąć parafilmem i inkubować w pozycji odwróconej w temperaturze 30 °C przez 3 do 4 tygodni, aż do pojawienia się kolonii.
- Przenieś pojedyncze kolonie do 3 ml pożywki EMJH zawierającej 50 µg/mL Km (EMJH+Km) w stanie 30°C pod wpływem mieszania przy prędkości poniżej 150 obr./min przez 7 do 10 dni, aż hodowla osiągnie gęstość ≈ 108/ml.
UWAGA: Hodowle można przechowywać w temperaturze -80 °C lub w ciekłym azocie (z dodatkiem 4% glicerolu).
- Zaszczepić objętość hodowli patogennej w fazie wykładniczej Leptospira gatunki odpowiadające 107 komórki do 10 ml pożywki Ellinghausen-McCullough-Johnson-Harris (EMJH)18,19Inkubować w temperaturze 30 °C przy wstrząsaniu z prędkością 150 obr./min, aż do osiągnięcia gęstości 2–8 x 10⁸ komórek/ml
- Identyfikacja miejsca insercji transpozonu za pomocą nested PCR (Rycina 2)
- Lizaż 50 µL każdego mutanta transpozonowego w probówkach do PCR poprzez inkubację w temperaturze 95 °C przez 15 min.
UWAGA: Można zamiast tego przeprowadzić puryfikację DNA, używając zestawu do izolacji DNA. - Przygotuj mieszaninę PCR z primerami Deg1 i Tnk1 (Tabela 3zgodnie z Tabela 1Przeniesienie 23.7 µL mieszaniny do każdej probówki PCR i dodać 1.3 µL zlizowanych komórek. Uruchom program: 95°C przez 5 min; 40 cykli: 95 °C przez 15 s, 40 °C przez 1 min, 72 °C przez 2 min; 72 °C przez 10 min.
- Przygotować mieszaninę do PCR z primerami Tag i TnkN1 (Tabela 3zgodnie z Tabela 2Przenieś 24.2 µL mieszaniny do każdej probówki PCR, a następnie dodać 0.8 µL reakcji PCR nr 1. Uruchom program: 95 °C przez 5 min; 35 cykli: 95 °C przez 15 s, 55 °C przez 30 s, 72 °C przez 2 min; 72 °C przez 10 min.
- Uruchom 3 µL produktów PCR w 1% żelu agarozowym z użyciem 1X buforu Tris-Octan-EDTA (TAE) przy napięciu 10–15 V/cm (Rycina 2B).
- Oczyścić produkty PCR z próbek dodatnich, używając zestawu do oczyszczania PCR. Eluować DNA przy zastosowaniu najmniejszej objętości dopuszczalnej przez zestaw, aby zmaksymalizować stężenie odzyskanego DNA.
- Przesłać oczyszczone produkty PCR do sekwencjonowania metodą Sangera z użyciem startera TnkN1 (Tabela 3).
- Zidentyfikuj miejsca insercji, porównując otrzymaną sekwencję z sekwencją genomu szczepu rodzicielskiego za pomocą analizy BLASTN (http://blast.ncbi.nlm.nih.gov/) lub korzystając z bazy danych SpiroScope (http://www.genoscope.cns.fr/agc/mage)21.
- Potwierdź miejsce insercji transpozonu za pomocą techniki PCR, wykorzystując primery przyłączające się do flankujących sekwencji gospodarza.
UWAGA: Transpozon zwiększa rozmiar sekwencji typu dzikiego o ≈ 2 kb.
- Lizaż 50 µL każdego mutanta transpozonowego w probówkach do PCR poprzez inkubację w temperaturze 95 °C przez 15 min.
2. Eksperyment na zwierzętach (Rycina 3)
- Hodowla Leptospira mutanty
- Hodować osobno każdy z wybranych mutantów transpozonowych w 10 ml pożywki EMJH+Km w temperaturze 30 °C przy mieszaniu przy 150 obr./min do gęstości wynoszącej 107-108 leptospir w/ml
- Należy policzyć leptospiry za pomocą mikroskopii w ciemnym polu z wykorzystaniem komory Petroffa-Haussera lub zgodnie z metodą opisaną przez Millera.23.
- Rozcieńczyć każdą kulturę w EMJH do tej samej gęstości, na przykład 106 komórek/ml
- Aby przygotować pulę wejściową, należy zmieszać rozcieńczone kultury w równych objętościach.
UWAGA: Wprowadzić kontrole do puli wejściowej poprzez dodanie mutantów o znanych defektach przystosowania, takich jak loa2217,24 or mutanty o niezmienionej sprawności, takie jak ligB17,25odpowiednio. Pule mutantów można przechowywać w 4% glicerolu w temperaturze -80 °C lub w ciekłym azocie.
- Wyzwanie
UWAGA: Opisane tutaj metody zostały zatwierdzone przez Komitet ds. Opieki i Korzystania ze Zwierząt (Institutional Animal Care and Use Committee) Veterans Affairs Greater Los Angeles (protokół nr 09018-14).- Wstrzyknąć dojamistrznie 1 ml puli wejściowej każdemu zwierzęciu za pomocą strzykawki insulinowej U-100 z igłą 26G x ½" igła
UWAGA: W eksperymencie pilotażowym 8 zwierząt poddano ekspozycji na 1 ml puli wejściowej, tj. 106 całkowita liczba bakterii17Infekcję kontynuowano przez 4 dni przed eutanazją. - Należy pobrać 10 ml puli wejściowej i wirować przez 20 min przy 3220 x g. Ostrożnie usunąć nadsącz, tak aby nie naruszyć osadu. Osad komórkowy przechowywać w temperaturze -80°C.˚w temperaturze C do momentu użycia (krok 3.1.3).
- Monitorować zwierzęta codziennie aż do ich uśmiercenia w określonym punkcie końcowym. Codziennie ważyć chomiki i sprawdzać, czy wystąpiły kryteria punktu końcowego: utrata apetytu, trudności w poruszaniu się lub oddychaniu, prostracja, zmierzwione futro lub utrata > 10% maksymalnej osiągniętej masy.
- Wstrzyknąć dojamistrznie 1 ml puli wejściowej każdemu zwierzęciu za pomocą strzykawki insulinowej U-100 z igłą 26G x ½" igła
- In vitro eksperyment
- W dniu zakażenia zaszczepić 3 kolby zawierające 25 ml pożywki EMJH+Km, dodając 5 ml puli wejściowej. Hodować kultury w 30 °C przy mieszaniu z prędkością poniżej 150 obr./min.
- Należy codziennie przeliczać leptospiry, stosując jedną z metod opisanych w sekcji 2.1.2. Gdy gęstość osiągnie ≈ 1 x 10⁸/ml, każdą zawiesinę wirować przez 20 min przy 3220 x g.
- Przechowywać osady komórkowe w temperaturze -80 °C do momentu użycia.
- Pobieranie i przechowywanie tkanek
- Uśmiercić zwierzęta poprzez inhalację izofluranu, a następnie dwustronną torakotomię.26.
- Należy niezwłocznie pobrać od 1 do 2 ml krwi poprzez punkcję serca, używając strzykawki o objętości 3 ml i igły 25G x 5/8." igłę. Przenieś krew do probówki zawierającej EDTA. Wymieszaj poprzez odwracanie, 5–6 razy.
- Pobrać jedną nerkę i ⅓ Proszę podać tekst źródłowy do tłumaczenia. ½ brzusznego płata środkowego wątroby do probówek kriogenicznych.
- Przechowywać tkanki w temperaturze -80 °C do momentu użycia.
3. Konstrukcja bibliotek genomicznych do sekwencjonowania wysokoprzepustowego (Rysunek 4)
- Ekstrakcja DNA
- Ekstrakcja DNA z krwi.
- Przenieść 100 µL krwi z probówki z EDTA do probówki do mikrocentryfugi.
- Oczyścić DNA za pomocą zestawu do ekstrakcji DNA. Postępować zgodnie z instrukcjami producenta.
- Ekstrakcja DNA z tkanek.
- Używając skalpela i nożyczek, pociąć od 50 do 80 mg każdego organu na małe kawałki (1 mm x 1 mm) i przenieść je do sterylnej probówki z nakrętką. Zmierzyć masę tkanki za pomocą wagi precyzyjnej.
- Dodać do probówki 500 µL sterylnego PBS.
- Zhomogenizować próbki za pomocą disruptora przez 1 min przy 5 ruchach na sekundę.
- Obliczyć objętość odpowiadającą 25 mg tkanki, korzystając z następującego równania:
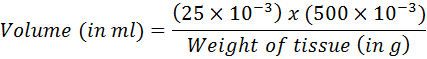
- Przenieść obliczoną objętość do zestawu do ekstrakcji DNA. Przeprowadzić puryfikację DNA zgodnie z instrukcjami producenta.
- Ekstrakcja DNA z puli wejściowej i hodowli in vitro.
- Rozmrozić pellety bakteryjne w temperaturze pokojowej przez 5-10 min.
- Przeprowadzić ekstrakcję DNA zgodnie z instrukcjami dołączonymi do zestawu.
- Przechowywać DNA w temperaturze -80 °C do czasu użycia.
- Ekstrakcja DNA z krwi.
- Fragmentacja DNA (Rysunek 5)
- Przenieść 50 µL wyekstrahowanego DNA do probówki do mikrocentryfugi o pojemności 1,5 mL.
- Umieścić probówki w statywie sonikatora w kąpieli z zimnej wody (4 °C).
- Uruchomić sonikator na 3 min przy intensywności 80%, z impulsem 10 s włączony i 5 s wyłączony.
OSTROŻNIE: Należy używać nauszników lub zatyczek do uszu w celu ochrony słuchu. - Nałożyć 2,5 µL sfragmentowanego DNA na żel agarozowy 2%, aby potwierdzić, że większość fragmentów DNA ma rozmiar <600 bp.
- Dodanie ogona C (C-tail)
- Zmierzyć stężenie DNA za pomocą spektrofotometru do małych objętości.
- Obliczyć objętość odpowiadającą 500 ng DNA, korzystając z następującego równania:
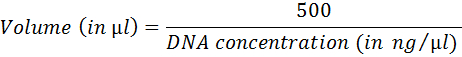
- Przygotować reakcję dopełniania ogona (Tabela 4). Inkubować przez 1 h w 37 °C; inaktywować w 75 °C przez 20 min.
UWAGA: W przypadku próbek wymagających dostosowania do objętości większej niż 14,5 µL, zwiększyć objętość końcową reakcji do 40 µL i odpowiednio przeskalować pozostałe składniki. - Oczyścić próbki za pomocą zestawu do puryfikacji PCR. Eluować DNA w 12 µL buforu elucyjnego.
- Nested PCR
- PCR #1
- Przygotować mieszaniny do PCR zgodnie z Tabelami 3 i 5. Przenieść 22 µL mieszaniny bibliotecznej do każdej probówki PCR i dodać 3 µL oczyszczonego DNA. Postąpić analogicznie z mieszaniną kontrolną.
UWAGA: Starter TnkN317 jest specyficzny dla transpozonu, a starter olj3766 jest specyficzny dla ogona C. W mieszaninie kontrolnej brakuje startera TnkN3, który specyficznie celuje w transpozon. - Przeprowadzić następujący program: 95 °C przez 2 min; 24 cykle: 95 °C przez 30 s, 60 °C przez 30 s, 72 °C przez 2 min; 72 °C przez 2 min.
- Przygotować mieszaniny do PCR zgodnie z Tabelami 3 i 5. Przenieść 22 µL mieszaniny bibliotecznej do każdej probówki PCR i dodać 3 µL oczyszczonego DNA. Postąpić analogicznie z mieszaniną kontrolną.
- PCR #2.
- Przygotować drugie mieszaniny do PCR zgodnie z Tabelami 3 i 6. Przenieść 49 µL mieszaniny bibliotecznej do każdej probówki PCR i dodać 1 µL reakcji bibliotecznej z PCR #1. Przenieść 24,5 µL mieszaniny kontrolnej do każdej probówki PCR i dodać 0,5 µL reakcji kontrolnej z PCR #1.
UWAGA: Starter pMargent2 jest specyficzny dla transpozonu, a startery IP6 zawierają kod kreskowy o długości sześciu par zasad oraz sekwencje specyficzne, rozpoznawane przez platformę sekwencjonowania nowej generacji (NGS). - Przeprowadzić następujący program: 95 °C przez 2 min; 18 cykli: 95 °C przez 30 s, 60 °C przez 30 s, 72 °C przez 2 min; 72 °C przez 2 min.
- Przygotować drugie mieszaniny do PCR zgodnie z Tabelami 3 i 6. Przenieść 49 µL mieszaniny bibliotecznej do każdej probówki PCR i dodać 1 µL reakcji bibliotecznej z PCR #1. Przenieść 24,5 µL mieszaniny kontrolnej do każdej probówki PCR i dodać 0,5 µL reakcji kontrolnej z PCR #1.
- Nałożyć 3 µL na żel agarozowy 2%. Biblioteka powinna wykazać rozmaz (smear), przy czym większość sygnału powinna znajdować się między 200 a 600 bp (Rysunek 6), a w reakcji kontrolnej nie powinno dojść do amplifikacji.
- PCR #1
- Puryfikacja produktów PCR.
UWAGA: Oczyścić biblioteki genomowe za pomocą zestawu do puryfikacji PCR zgodnie z instrukcjami producenta. Eluować DNA w 30 µL buforu elucyjnego. - Zmierzyć stężenie DNA za pomocą fluorometru. Wykonać średnio od 2 do 3 pomiarów.
- Obliczyć objętość każdej biblioteki odpowiadającą 15 lub 20 ng, korzystając z poniższego równania:
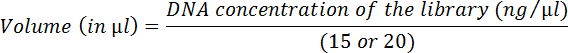
- Zmieszać wszystkie biblioteki zgodnie z poprzednimi obliczeniami. Wyznaczyć stężenie molowe DNA, korzystając z równania na poniższej stronie internetowej:
http://www.molbiol.edu.ru/eng/scripts/01_07.html
OSTROŻNIE: Wymagania dotyczące stężenia i objętości DNA zależą od zastosowanej platformy sekwencjonowania.
4. Sekwencjonowanie wysokoprzepustowe i analiza danych
- Sekwencjonowanie
- Sekwencjonuj biblioteki jako odczyty pojednoczowe (single-end) o długości 64 bp, używając niestandardowego primera do sekwencjonowania pMargent3 oraz standardowego komercyjnego primera do sekwencjonowania. Platforma sekwencjonująca dostarczy pliki FastQ ze wszystkimi odczytami z sekwencjonowania.
- Analiza za pomocą oprogramowania Galaxy
- Pobierz plik z sekwencją genomu
- Na stronie głównej bazy danych SpiroScope (link znajduje się w kroku 1.2.7) wybierz organizm wykorzystany w eksperymencie i kliknij „LOAD INTO GENOME BROWSER”.
- W pasku narzędzi (u góry strony głównej) wybierz „Search/Export > Download data”, a w wierszu „Sequence (fasta)” kliknij „Genome”, aby pobrać sekwencję.
- Otwórz plik w Notatniku (PC) lub TextEdit (Mac) i zmień nazwę chromosomu (na przykład na „ChrI”). Zachowaj format fasta.
- Wykonaj te same kroki, aby pobrać sekwencję chromosomu II. Połącz sekwencje obu chromosomów w jeden plik .txt poprzez kopiowanie i wklejanie.
UWAGA: Sekwencje chromosomów można również pobrać ze strony internetowej NCBI (https://www.ncbi.nlm.nih.gov) i połączyć w jeden plik .txt.
- Prześlij pliki na serwer Galaxy
UWAGA: Galaxy to otwarta, internetowa platforma do zarządzania intensywnymi danymi w ramach przepływów pracy bioinformatycznych27,28,29,30, dostępna pod adresem https://usegalaxy.org/.- W menu Tools wybierz „Get data > Upload File from your computer”. Przeciągnij i upuść plik(i) .fastq wygenerowane przez platformę sekwencjonującą do okna, a następnie kliknij „Start”.
- Wykonaj te same kroki, aby przesłać plik .txt z sekwencją genomu Leptospira.
- Przygotowanie odczytów (Grooming)
- W menu Tools wybierz „NGS: QC and manipulation > FASTQ Groomer”.
- W polu File to groom wybierz biblioteki przesłane w kroku 4.2.2. W polu Input FASTQ quality scores type wybierz odpowiedni system sekwencjonowania. W sekcji Advanced Options pozostaw zaznaczoną opcję Hide Advanced Office.
- Kliknij „Execute”.
- Usuwanie artefaktów sekwencjonowania
- Wybierz „NGS: QC and manipulation > Remove sequencing artifacts”. W polu Library to filter wybierz pliki po groomingu wygenerowane w kroku 4.2.3. Kliknij „Execute”.
- Usuwanie sekwencji ogonów C
UWAGA: Powtórz te kroki raz lub dwa razy, aby upewnić się, że wszystkie ogony C zostały usunięte.- Wybierz „NGS: QC and manipulation > Clip adapter sequences”.
- Wybierz lub wprowadź następujące parametry:
Library to clip: wybierz pliki wygenerowane w kroku 4.2.4.
Minimum sequence length: 15
Source: enter custom sequence
Enter custom clipping sequence: CCCCCCC
Enter non-zero value to keep the adapter sequences and x bases that follow it: 0
Discard sequences with unknown (N) bases: Yes
Output options: Output both clipped and non-clipped sequences - Kliknij „Execute”.
- Usuwanie sekwencji adapterów
- Wybierz „NGS: QC and manipulation > Clip adapter sequences”.
- Wybierz lub wprowadź następujące parametry:
- Library to clip: wybierz pliki wygenerowane w kroku 4.2.5.
- Minimum sequence length: 15
- Source: enter custom sequence
- Enter custom clipping sequence: CGTATGCCGTCTTCTGCTTG
- Enter non-zero value to keep the adapter sequences and x bases that follow it: 0
- Discard sequences with unknown (N) bases: yes
- Output options: Output both clipped and non-clipped sequences
- Kliknij „Execute”.
- Filtrowanie odczytów na podstawie ich jakości
- Wybierz „NGS: QC and manipulation > Filter by quality”.
UWAGA: Narzędzie to wybiera odczyty na podstawie wyników jakości (quality scores). - Wybierz następujące parametry:
Library to filter: wybierz pliki wygenerowane w kroku 4.2.6.
Quality cut-off value: 20
Percent of bases in sequence that must have quality equal to/higher than cut-off value: 95 - Kliknij „Execute”.
UWAGA: Przy tych ustawieniach odczyty krótsze niż 20 nukleotydów lub z wynikiem jakości 20 lub mniej dla 95% cykli są odrzucane. Dostosuj ustawienia rygorystyczności do swojego eksperymentu.
- Wybierz „NGS: QC and manipulation > Filter by quality”.
- Mapowanie odczytów32
- Wybierz „NGS: Mapping > Bowtie2”32.
- W polach w głównym oknie wybierz następujące opcje:
Is this single or paired library: single-end
FASTQ file: wybierz bibliotekę przefiltrowaną pod kątem jakości z kroku 4.2.7.
Write unaligned (in fastq format) reads to separate file(s): no
Write aligned (in fastq format) reads to separate file(s): no
Will you select a reference genome from your history or use a built-in index?: Use a genome from the history and build index
Select the reference genome: wybierz plik Leptospira genome.txt przesłany w kroku 4.2.2.
Set read groups information?: do not set
Select analysis mode: 1: default setting only
Do you want to use presets?: No, just use defaults
Save the bowtie2 mapping statistics to the history: No
Job resource parameters: Use default job resource parameters - Kliknij „Execute”, aby dopasować odczyty do genomu.
- Konwersja plików
- Wybierz „NGS: SAMtools > BAM-to-SAM convert BAM to SAM”.
- Wybierz następujące opcje:
BAM file to convert: Wybierz zmapowaną bibliotekę z kroku 4.2.8.
Header options: include header in SAM output (-h) - Kliknij „Execute”.
- Konwersja plików
- Wybierz „NGS: SAMtools > Convert SAM to interval”.
- Wybierz następujące opcje:
Select dataset to convert: Wybierz plik zmapowanej biblioteki SAM wygenerowany w kroku 4.2.9.
Print all?: Yes - Kliknij „Execute”.
- Sortowanie odczytów
- Wybierz „Filter and Sort > Sort data in ascending or descending order”.
- Wybierz następujące opcje:
Sort dataset: Wybierz plik przedziałowy (interval file) wygenerowany w kroku 4.2.10.
on column: 2
with flavor: Numerical order
everything in: Ascending order - Kliknij „Execute”.
- Wybór odczytów pasujących do chromosomu I
- Wybierz „Filter and Sort > Select lines that match an expression”.
- Wybierz następujące opcje:
Select lines from: wybierz plik z posortowanymi odczytami wygenerowany w kroku 4.2.11.
that: Matching
the pattern: Wprowadź nazwę chromosomu I określoną w kroku 4.2.1.3 (np. „ChrI”). - Kliknij „Execute”.
- Wybór odczytów pasujących do chromosomu II
Postępuj zgodnie z krokiem 4.2.12. - Grupowanie odczytów według miejsc insercji w chromosomie I
- Wybierz „Join, Subtract and Group > Group data by a column and perform aggregate operation on other columns”.
- Wybierz następujące opcje:
Select data: wybierz plik wynikowy z kroku 4.2.12.
Group by column: 2
Ignore case while grouping?: No
Ignore lines beginning with these characters: Ø
Operation > + insert operation
Type: Count
On column: 2
Round result to nearest integer: NO - Kliknij „Execute”.
- Grupowanie odczytów według miejsc insercji w chromosomie II
Postępuj zgodnie z krokiem 4.2.14. - Sortowanie miejsc insercji w chromosomie I
- Wybierz „Filter and Sort > Sort data in ascending or descending order”.
- Wybierz następujące opcje:
Sort Dataset: Wybierz plik z kroku 4.2.14.
on column: 1
with flavor: Numerical order
everything in: Ascending order - Kliknij „Execute”.
- Sortowanie miejsc insercji w chromosomie II
Postępuj zgodnie z krokiem 4.2.16.
- Pobierz plik z sekwencją genomu
- Analiza statystyczna
- Przenieś dane z Galaxy do plików arkusza kalkulacyjnego, kopiując i wklejając dwie kolumny z kroków 4.2.16 i 4.2.17 do pliku Excel.
UWAGA: Pierwsza kolumna to współrzędna nukleotydowa miejsca insercji transpozonu, a druga kolumna to liczba odczytów w każdym miejscu insercji. - Zidentyfikuj gen zawierający transpozon, korzystając ze współrzędnych nukleotydowych podanych w tabeli.
UWAGA: Na przykład transpozon wstawiony w nukleotydzie nr 30718 chromosomu I znajduje się w genie LIC10024, który obejmuje nukleotydy 29263-31539 w chromosomie I. - Oblicz częstotliwości względne (F) dla każdego mutanta w każdej tkance oraz w puli wejściowej zgodnie z poniższym równaniem:
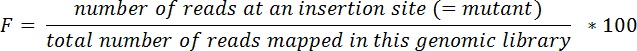
- Oblicz stosunki wyjście/wejście (R) dla każdego mutanta i tkanki, korzystając z poniższego równania:
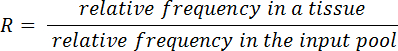
- Test znakowy Wilcoxona
- Znormalizuj wszystkie stosunki wyjście/wejście, ustawiając medianę stosunku dla każdej tkanki w każdym zwierzęciu na 1,0. Stosunek 1,0 jest neutralny, >1,0 oznacza niekorzystną fitness, a <1,0 korzystną fitness33.
- Porównaj stosunki wyjście/wejście do wartości 1,0 (neutralna fitness), stosując test rang Wilcoxona, przyjmując wartości P <0,05 za statystycznie istotne.
- Przenieś dane z Galaxy do plików arkusza kalkulacyjnego, kopiując i wklejając dwie kolumny z kroków 4.2.16 i 4.2.17 do pliku Excel.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Tworzenie biblioteki mutantów transpozonych u L. interrogans poprzez koniugację wymaga zastosowania jednostki filtracyjnej, jak pokazano na Rysunku 1. Z każdego procesu kojarzenia odzyskano 100-200 transkonjugantów.
Miejsce insercji transpozonu identyfikuje się w każdym mutancie poprzez sekwencjonowanie produktu PCR uzyskanego za pomocą półlosowej reakcji PCR, która celuje w koniec transpoz...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Chociaż wyniki naszego eksperymentu pilotażowego dla chomików z prowokacją dootrzewnową z 42 mutantami L. interrogans są przedstawione17, spodziewamy się, że większe pule mutantów mogą być badane przez Tn-Seq. Ponieważ częstość transkoniugantów jest niska (100-200 transkoniugantów/krycie), konieczne jest kilka kryć, aby wygenerować wystarczającą liczbę mutantów do dużych eksperymentów Tn-Seq. Utrzymanie dużej liczby mutantów w płynnych kulturach stanowi wyzwanie logistyczne, z którym nale...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca była wspierana przez Veterans Affairs Merit Award (dla D.A.H.) oraz grant National Institute of Health R01 AI 034431 (dla D.A.H.).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Siarczan kanamycyny z Streptomyces kanamyceticus | Sigma-Aldrich | K4000 | |
| Kwas 2,6-diaminopimeliczny | Sigma-Aldrich | D1377 | |
| Spektynomycyna dichlorowodorek pentahydrat | Sigma-Aldrich | S4014 | |
| Axio Lab A1 z kondendensem ciemnego pola | Zeiss | 490950-001-000 | |
| Zestaw do oczyszczania krwi i tkanek DNeasy | Qiagen | 69504/69506 | |
| MinElute PCR Purification | Qiagen | 28004/28006 | |
| QIAquick PCR zestaw do oczyszczania | Qiagen | 28104/28106 | |
| Model 505 Sonic Dismembrator | Fisher Scientific | FB-505 | |
| 2,5-calowy róg kubkowy | Fisher Scientific | FB-4625 | |
| Koralik Ruptor 24 | Omni International | 19-010 | Krok 3.1.2.4 |
| Końcowa deoksynukleotydylotransferaza | Promega | M828C | |
| Master mix Phusion | Thermo Scientific | F531 | Przygotowanie bibliotek genomicznych, krok 3.4. |
| DreamTaq Master Mix | Thermo Scientific | K9011/K9012 | Identyfikacja miejsca wprowadzenia transpozonu, krok 1.2. |
| dCTP | Thermo Scientific | R0151 | |
| ddCTP | Affymetrix/ USBProducts | 77112 | |
| T100 Termocykler | BioRad | 1861096 | |
| Qubit 2.0 fluorometr | Invitrogen | Q32866 | krok 3.6. |
| Zestaw testowy Qubit dsDNA HS | Invitrogen | Q32851/Q32854 | krok 3.6. |
| Technologie żywotności | probówek do testów kubitowych | Q32856 | krok 3.6. |
| PBS pH 7,2 (1X) | Gibco | 20012-027 20012-050 | |
| Jednorazowy skalpel No10 | Feather | 2975#10 | |
| Plastikowe probówki K2 EDTA 2 ml | Vacutainer 367841 | ||
| strzykawka BD U-100 z 26G x ½ ” igły | BD vacutainer | 329652 | wyzwanie IP, krok 2.2.1. |
| 3 ml strzykawka z końcówką Luer-Lok | Vacutainer BD | 309657 | Nakłucie serca, krok 2.4.2. |
| Vacutainer BD | z igłą 25G X 5/8" | 305901 | Nakłucie serca, krok 2.4.2. |
| Podstawa ze szkła spiekanego 25 mm z korkiem | EMD Millipore | XX1002502 | System filtracji, krok 1.1.7. |
| Aluminiowy zacisk sprężynowy 25 mm | EMD Millipore | XX1002503 | System jednostki filtracyjnej, krok 1.1.7. |
| Lejek ze szkła borokrzemianowego o pojemności 15 ml | EMD Millipore | XX1002514 | System filtracji, krok 1.1.7. |
| Kolba Erlenmeyera z ramieniem bocznym o pojemności 125 ml | EMD Millipore | XX1002505 | System jednostki filtracyjnej, krok 1.1.7. |
| Filtr octanowo-celulozowy VVPP (wielkość porów 0,1 mm; średnica 25 mm) | EMD Millipore | VVLP02500 |
Bibliografia
- Murray, G. L., et al. Genome-wide transposon mutagenesis in pathogenic Leptospira species. Infect Immun. 77 (2), 810-816 (2009).
- Adler, B., Lo, M., Seemann, T., Murray, G. L. Pathogenesis of leptospirosis: the influence of genomics. Vet Microbiol. 153 (1-2), 73-81 (2011).
- Marcsisin, R. A., et al. Use of a high-throughput screen to identify Leptospira mutants unable to colonize the carrier host or cause disease in the acute model of infection. J Med Microbiol. 62, 1601-1608 (2013).
- van Opijnen, T., Bodi, K. L., Camilli, A. Tn-seq: high-throughput parallel sequencing for fitness and genetic interaction studies in microorganisms. Nat Methods. 6 (10), 767-772 (2009).
- van Opijnen, T., Lazinski, D. W., Camilli, A. Genome-wide fitness and genetic interactions determined by Tn-seq, a high-throughput massively parallel sequencing method for microorganisms. Curr Protoc Microbiol. 36, 1E.3.1-1E.3.24 (2015).
- Troy, E. B., et al. Understanding barriers to Borrelia burgdorferi dissemination during infection using massively parallel sequencing. Infect Immun. 81 (7), 2347-2357 (2013).
- Wunder, E. A. Jr, et al. Real-time PCR reveals rapid dissemination of Leptospira interrogans after intraperitoneal and conjunctival inoculation of hamsters. Infect Immun. 84 (7), 2105-2115 (2016).
- Lourdault, K., Aviat, F., Picardeau, M. Use of quantitative real-time PCR for studying the dissemination of Leptospira interrogans in the guinea pig infection model of leptospirosis. J Med Microbiol. 58, 648-655 (2009).
- Coutinho, M. L., et al. Kinetics of Leptospira interrogans infection in hamsters after intradermal and subcutaneous challenge. PLoS Negl Trop Dis. 8 (11), e3307(2014).
- Athanazio, D. A., et al. Rattus norvegicus as a model for persistent renal colonization by pathogenic Leptospira interrogans. Acta Trop. 105 (2), 176-180 (2008).
- Ratet, G., et al. Live imaging of bioluminescent Leptospira interrogans in mice reveals renal colonization as a stealth escape from the blood defenses and antibiotics. PLoS Negl Trop Dis. 8 (12), e3359(2014).
- Gutierrez, M. G., Yoder-Himes, D. R., Warawa, J. M. Comprehensive identification of virulence factors required for respiratory melioidosis using Tn-seq mutagenesis. Front Cell Infect Microbiol. 5 (78), (2015).
- Gawronski, J. D., Wong, S. M., Giannoukos, G., Ward, D. V., Akerley, B. J. Tracking insertion mutants within libraries by deep sequencing and a genome-wide screen for Haemophilus genes required in the lung. Proc Natl Acad Sci U S A. 106 (38), 16422-16427 (2009).
- Gallagher, L. A., Shendure, J., Manoil, C. Genome-scale identification of resistance functions in Pseudomonas aeruginosa using Tn-seq. MBio. 2 (1), (2011).
- Slamti, L., Picardeau, M. Construction of a library of random mutants in the spirochete Leptospira biflexa using a mariner transposon. Methods Mol Biol. 859, (2012).
- Picardeau, M. Conjugative transfer between Escherichia coli and Leptospira spp. as a new genetic tool. Appl Environ Microbiol. 74 (1), 319-322 (2008).
- Lourdault, K., Matsunaga, J., Haake, D. A. High-throughput parallel sequencing to measure fitness of Leptospira interrogans transposon insertion mutants during acute infection. PLoS Negl Trop Dis. 10 (11), e0005117(2016).
- Ellinghausen, H. C., McCullough, W. G. Nutrition of Leptospirapomona and growth of 13 other serotypes: Fractionation of oleic albumin complex and a medium of bovine albumin and polysorbate 80. Am J Vet Res. 26, 45-51 (1965).
- Johnson, R. C., Harris, V. G. Differentiation of pathogenic and saprophytic letospires. I. Growth at low temperatures. J Bacteriol. 94 (1), 27-31 (1967).
- Demarre, G., et al. A new family of mobilizable suicide plasmids based on broad host range R388 plasmid (IncW) and RP4 plasmid (IncPa) conjugative machineries and their cognate Escherichia coli host strains. Res Microbiol. 156 (2), 245-255 (2005).
- Vallenet, D., et al. MicroScope: a platform for microbial genome annotation and comparative genomics. Database (Oxford). , bap021(2009).
- Goodman, A. L., Wu, M., Gordon, J. I. Identifying microbial fitness determinants by insertion sequencing using genome-wide transposon mutant libraries. Nat. Protocols. 6 (12), 1969-1980 (2011).
- Miller, J. Spirochetes in body fluids and tissues manual of investigative methods. , 22-23 (1971).
- Ristow, P., et al. The OmpA-like protein Loa22 is essential for leptospiral virulence. PLoS Pathog. 3 (7), (2007).
- Croda, J., et al. Targeted mutagenesis in pathogenic Leptospira species: disruption of the LigB gene does not affect virulence in animal models of leptospirosis. Infect Immun. 76 (12), 5826-5833 (2008).
- Haake, D. A. Hamster model of leptospirosis. Curr Protoc Microbiol. 12, 2(2006).
- Giardine, B., et al. Galaxy: a platform for interactive large-scale genome analysis. Genome Res. 15 (10), 1451-1455 (2005).
- Goecks, J., Nekrutenko, A., Taylor, J., Galaxy, T. Galaxy: a comprehensive approach for supporting accessible, reproducible, and transparent computational research in the life sciences. Genome Biol. 11 (8), R86(2010).
- Blankenberg, D., et al. Galaxy: a web-based genome analysis tool for experimentalists. Curr Protoc Mol Biol. (Chapter 19), 11-21 (2010).
- Afgan, E., et al. The Galaxy platform for accessible, reproducible and collaborative biomedical analyses: 2016 update. Nucleic Acids Res. 8 (44), (2016).
- McCoy, K. M., Antonio, M. L., van Opijnen, T. MAGenTA; a Galaxy implemented tool for complete Tn-Seq analysis and data visualization. Bioinformatics. , 1367(2017).
- Langmead, B., Trapnell, C., Pop, M., Salzberg, S. L. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biol. 10 (3), R25(2009).
- Kamp, H. D., Patimalla-Dipali, B., Lazinski, D. W., Wallace-Gadsden, F., Camilli, A. Gene fitness landscapes of Vibrio cholerae at important stages of its life cycle. PLoS Pathog. 9 (12), e1003800(2013).
- Poggi, D., Oliveira de Giuseppe, P., Picardeau, M. Antibiotic resistance markers for genetic manipulations of Leptospira spp. Appl Environ Microbiol. 76 (14), 4882-4885 (2010).
- van Opijnen, T., Camilli, A. Transposon insertion sequencing: a new tool for systems-level analysis of microorganisms. Nat Rev Microbiol. 11 (7), 435-442 (2013).
- Pappas, C. J., Picardeau, M. Control of gene expression in Leptospira spp. by Transcription activator-like effectors demonstrates a potential role for LigA and LigB in Leptospira interrogans virulence. Appl Environ Microbiol. 81 (22), 7888-7892 (2015).
- Koskiniemi, S., Sun, S., Berg, O. G., Andersson, D. I. Selection-driven gene loss in bacteria. PLoS Genet. 8 (6), e1002787(2012).
- Troy, E. B., et al. Global Tn-seq analysis of carbohydrate utilization and vertebrate infectivity of Borrelia burgdorferi. Mol Microbiol. 101 (6), 1003-1023 (2016).
- Ramsey, M. E., et al. A high-throughput genetic screen identifies previously uncharacterized Borrelia burgdorferi genes important for resistance against reactive oxygen and nitrogen species. PLoS Negl Trop Dis. 13 (2), e1006225(2017).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
