Tutaj opisujemy metodę umożliwiającą jednoczesne ilościowe oznaczanie i mapowanie całego genomu rybonukleotydów w wysoce nienaruszonym DNA w rozdzielczości pojedynczego nukleotydu, łącząc enzymatyczne rozszczepienie genomowego DNA z jego alkaliczną hydrolizą i późniejszym sekwencjonowaniem 5'-końca.
Artykuł metodologiczny
Jednoczesne mapowanie i oznaczanie ilościowe rybonukleotydów w ludzkim mitochondrialnym DNA
W tym artykule
Podsumowanie
Streszczenie
Przyjęte podejścia do szacowania liczby rybonukleotydów obecnych w genomie ograniczają się do ilościowego oznaczania włączonych rybonukleotydów przy użyciu krótkich syntetycznych fragmentów DNA lub plazmidów jako matryc, a następnie ekstrapolacji wyników na cały genom. Alternatywnie, liczbę rybonukleotydów obecnych w genomie można oszacować za pomocą żeli alkalicznych lub południowych plam. Nowsze podejścia in vivo wykorzystują sekwencjonowanie nowej generacji, które umożliwia mapowanie rybonukleotydów w całym genomie, zapewniając pozycję i tożsamość osadzonych rybonukleotydów. Nie pozwalają jednak na ilościowe określenie liczby rybonukleotydów, które są włączone do genomu. W tym miejscu opisujemy, jak jednocześnie mapować i określać ilościowo liczbę rybonukleotydów, które są włączane do ludzkiego mitochondrialnego DNA in vivo za pomocą sekwencjonowania nowej generacji. Używamy wysoce nienaruszonego DNA i wprowadzamy specyficzne dla sekwencji pęknięcia podwójnej nici, trawiąc je endonukleazą, a następnie hydrolizując włączone rybonukleotydy alkaliami. Wygenerowane końce są ligowane za pomocą adapterów, a końce te są sekwencjonowane na maszynie do sekwencjonowania nowej generacji. Bezwzględną liczbę rybonukleotydów można obliczyć jako liczbę odczytów poza miejscem rozpoznawania na średnią liczbę odczytów w miejscu rozpoznawania dla endonukleazy specyficznej dla sekwencji. Protokół ten może być również wykorzystany do mapowania i ilościowego oznaczania wolnych nacięć w DNA i umożliwia adaptację do mapowania innych zmian DNA, które mogą być przetwarzane na końce 5'-OH lub 5'-fosforanowe. Ponadto metoda ta może być stosowana do każdego organizmu, pod warunkiem, że dostępny jest odpowiedni genom referencyjny. Protokół ten stanowi zatem ważne narzędzie do badania replikacji DNA, przetwarzania końca 5', uszkodzenia DNA i naprawy DNA.
Wprowadzenie
W komórce eukariotycznej stężenie rybonukleotydów (rNTP) jest znacznie wyższe niż stężenie deoksyrybonukleotydów (dNTPs)1. Polimerazy DNA dyskryminują rybonukleotydy, ale ta dyskryminacja nie jest doskonała, w wyniku czego rybonukleotydy zamiast dezoksyrybonukleotydów mogą być włączane do genomów podczas replikacji DNA. Rybonukleotydy mogą być najpowszechniejszymi niekanonicznymi nukleotydami włączonymi do genome2. Większość z tych rybonukleotydów jest usuwana podczas dojrzewania fragmentu Okazaki przez naprawę przez wycinanie rybonukleotydów inicjowaną przez RNazę H2 (RER) lub przez topoizomerazę 1 (recenzja w referencji3). Rybonukleotydy, których nie można usunąć, pozostają stabilnie włączone do DNA2,4 i mogą wpływać na niego zarówno w szkodliwy, jak i korzystny sposób (recenzja w reviewed5). Oprócz tego, że mogą działać jako sygnały pozytywne, na przykład w przełączaniu typu krycia w Schizosaccharomyces pombe6 i oznaczaniu powstającej nici DNA podczas naprawy niedopasowania (MMR)7,8, rybonukleotydy wpływają na strukturę9 i stabilność otaczającego DNA dzięki grupie 2'-hydroksylowej ich rybozy10, powodujący stres replikacyjny i niestabilność genomu11. Obfitość rybonukleotydów w genomowym DNA (gDNA) i ich znaczenie w mechanizmach replikacji i naprawy, a także implikacje dla stabilności genomu, dają powód do zbadania ich dokładnego występowania i częstości w sposób obejmujący cały genom.
Aktywność H2 RNazy nie została znaleziona w ludzkich mitochondriach, a rybonukleotydy nie są skutecznie usuwane w mitochondrialnym DNA (mtDNA). W dostarczaniu nukleotydów do ludzkich mitochondriów zaangażowanych jest kilka szlaków i aby zbadać, czy zaburzenia w puli nukleotydów mitochondrialnych powodują podwyższoną liczbę rybonukleotydów w ludzkim mtDNA, opracowaliśmy protokół mapowania i ilościowego oznaczania tych rybonukleotydów w ludzkim mtDNA wyizolowanym z fibroblastów, komórek HeLa i linii komórkowych pacjenta12.
Większość podejść in vitro (recenzowanych w recenzowanym13) do określenia selektywności polimeraz DNA wobec rNTP opiera się na eksperymentach z pojedynczą insercją rybonukleotydów lub przedłużaniem starterów, gdzie konkurencyjne rNTP są włączone do mieszaniny reakcyjnej, co pozwala na identyfikację lub względną ocenę ilościową inkorporacji rybonukleotydów w krótkich matrycach DNA. Podejścia ilościowe do krótkich sekwencji mogą nie odzwierciedlać pul dNTP i rNTP w stężeniach komórkowych, a zatem zapewniają wgląd w selektywność polimerazy, ale mają ograniczone znaczenie w odniesieniu do całych genomów. Wykazano, że względna ilość rybonukleotydów włączonych podczas replikacji dłuższej matrycy DNA, takiej jak plazmid, może być wizualizowana na żelu do sekwencjonowania przy użyciu znakowanych radioaktywnie dNTP i hydrolizie DNA w środowisku alkalicznym14. Ponadto gDNA zostało przeanalizowane na Southern blot po hydrolizie alkalicznej, co pozwoliło na sondowanie specyficzne dla nici i określenie bezwzględnych wskaźników inkorporacji rybonukleotydów in vivo15. Podejścia te pozwalają na względne porównanie częstotliwości włączania, ale nie dostarczają wglądu w położenie ani tożsamość włączonych rybonukleotydów. Nowsze podejścia do analizy zawartości rybonukleotydów w gDNA in vivo, takie jak HydEn-Seq16, Ribose-Seq17, Pu-Seq18 lub emRiboSeq19, wykorzystują wrażliwość osadzonych rybonukleotydów odpowiednio na leczenie alkaliczne lub RNazę H2 i wykorzystują sekwencjonowanie nowej generacji do identyfikacji rybonukleotydów w całym genomie. Metody te nie dają wglądu w bezwzględną częstotliwość inkorporacji wykrytych rybonukleotydów. Dodając do protokołu HydEn-seq etap enzymatycznego rozszczepienia specyficznego dla sekwencji, metoda, którą tutaj opisujemy, wygodnie rozszerza informacje uzyskane z podejścia sekwencjonowania, umożliwiając jednoczesne mapowanie i kwantyfikację osadzonych rybonukleotydów12. Metoda ta ma zastosowanie do praktycznie każdego organizmu, biorąc pod uwagę, że można uzyskać wysoce nienaruszone ekstrakty DNA i dostępny jest odpowiedni genom referencyjny. Metodę można dostosować do ilościowego określenia i lokalizacji dowolnej zmiany, która może zostać strawiona przez nukleazę i pozostawia koniec 5'-fosforanu lub 5'-OH.
Aby zmapować i określić ilościowo rybonukleotydy w genomowym DNA, metoda łączy rozszczepienie przez specyficzną sekwencję endonukleazy i hydrolizę alkaliczną, generując końcówki 5'-fosforanowe w miejscach, w których znajduje się specyficzna sekwencja rozpoznawania endonukleazy i 5'-OH kończy się w miejscach, w których znajdowały się rybonukleotydy. Ponieważ wygenerowane wolne końce są następnie ligowane za pomocą adapterów i sekwencjonowane przy użyciu sekwencjonowania nowej generacji, ważne jest, aby używać wysoce nienaruszonego DNA i unikać losowej fragmentacji podczas ekstrakcji DNA i przygotowywania biblioteki. Ocena tych odczytów znormalizowanych do odczytów w miejscach cięcia endonukleazy pozwala na jednoczesną ocenę ilościową i mapowanie wykrytych rybonukleotydów. Wolne 5'-końce są wykrywane w eksperymentach kontrolnych, w których alkaliczna hydroliza DNA jest zastępowana przez traktowanie KCl. Pozyskane dane dają wgląd w lokalizację i ilość rybonukleotydów oraz umożliwiają analizy pod kątem zawartości rybonukleotydów i częstotliwości ich włączania.
Protokół
Ten protokół jest opisany w Rysunek 1 i obejmuje izolację gDNA, trawienie enzymami restrykcyjnymi, aby móc określić ilościowo liczbę rybonukleotydów, leczenie alkaliami w celu hydrolizy wiązań fosfodiestrowych rybonukleotydów włączonych do gDNA, fosforylację wolnych końców 5'-OH, ligację adapterów ssDNA, syntezę drugiej nici i amplifikację PCR przed sekwencjonowaniem.
1. Adaptery i startery indeksowe
- Otrzymać ARC49, oligonukleotydy ARC140, ARC76/77, adapter i startery indeksowe ARC78-ARC107 (patrz tabela 1).
UWAGA: Oligonukleotydy należy oczyścić metodą HPLC. ARC76/77 są zamawiane jako dupleks. - Przygotować 100 μM roztwory podstawowe każdego oligonukleotydu w buforze Tris-EDTA (TE) (patrz tabela materiałów) i przechowywać w temperaturze -20 °C.
- Przygotować 10 μM roztwory ARC67/77 i 2 μM roztwory ARC49 i startery indeksowe, rozcieńczając w buforze elucyjnym (EB; patrz tabela materiałów). Przechowywać w temperaturze -20 °C.
2. Wzrost i zbieranie komórek
- Hoduj komórki HeLa w 70 ml zmodyfikowanego podłoża Eagle Medium (DMEM) firmy Dulbecco, uzupełnionego 10% płodową surowicą bydlęcą w 250 ml kolbie Spinner w temperaturze 37 °C.
- Policz liczbę komórek i zbierz5x10 6 komórek w probówce o pojemności 50 ml, odwiruj przez 5 minut przy 200 x g i odrzuć supernatant.
- Przemyć komórki 20 ml 1x PBS, odwirować przez 5 minut przy 200 x g i wyrzucić supernatant.
- Zamrozić granulki w temperaturze -20 °C lub kontynuować oczyszczanie DNA.
3. Oczyszczanie i kwantyfikacja DNA
- Oczyść gDNA za pomocą ekstrakcji fenolowo-chloroformowej, jak opisano poniżej.
- Ponownie zawiesić komórki w 2 ml buforze do lizy (patrz tabela materiałów) i inkubować przez 30 minut w temperaturze 42 °C na bloku grzewczym.
UWAGA: Bufor do lizy zawiera niebezpieczne składniki. Roztwór SDS jest drażniący, proteinaza K działa uczulająco, drażniąco i toksycznie. Nosić odzież ochronną i rękawice. - Podzielić próbkę na dwie probówki o pojemności 2 ml i dodać 1 objętość (V) alkoholu fenolowo-chloroformowo-izoamylowego (25:24:1).
UWAGA: Alkohol fenolowo-chloroformowo-izoamylowy jest toksyczny, mutagenny, i niebezpieczny dla środowiska wodnego. Stosować w dygestorium, nosić odzież ochronną i rękawice ochronne oraz wyrzucać do specjalnych odpadów fenolowo-chloroformowych. - Mieszać przez odwrócenie przez 30-60 s i wirować przez 5 minut przy 15 000 x g w temperaturze pokojowej.
UWAGA: Nie należy wirować DNA, aby uniknąć wprowadzenia losowych pęknięć nici, które mogłyby zniekształcić wyniki. - Przenieść górną, wodną fazę do nowej probówki o pojemności 2 ml i dodać 1 V alkoholu fenolowo-chloroformowo-izoamylowego (25:24:1).
- Mieszać przez inwersję i wirować przez 5 minut w temperaturze 15 000 x g w temperaturze 4 °C.
- Przenieść górną fazę wodną do nowej probówki o pojemności 2 ml i dodać 20 μl NaCl (5 M) i 1 V zimnego izopropanolu.
UWAGA: Izopropanol jest łatwopalny, drażniący i toksyczny. Przechowuj go w wentylowanej szafce, noś odzież ochronną i rękawice ochronne oraz trzymaj z dala od płomieni. - Wymieszać przez odwrócenie i inkubować przez co najmniej 1 godzinę w temperaturze -20 °C.
- Wirować przez 20 minut w temperaturze 15 000 x g, w temperaturze 4 °C i odrzucić supernatant.
- Przepłukać osad DNA 200 μl zimnego 70% etanolu, odwirować przez 20 minut w temperaturze 15 000 x g w temperaturze 4 °C i odrzucić supernatant.
UWAGA: 70% etanol jest łatwopalny i drażniący. Roztwór roboczy należy przechowywać w temperaturze -20 °C, w przeciwnym razie przechowywać w wentylowanej szafce, nosić odzież ochronną i rękawice oraz trzymać z dala od źródeł ognia. - Suszyć osad DNA w temperaturze pokojowej przez 20-25 minut.
- Rozpuść granulki DNA w 100 μl buforze TE i zbierz próbki w jednej probówce.
- Ponownie zawiesić komórki w 2 ml buforze do lizy (patrz tabela materiałów) i inkubować przez 30 minut w temperaturze 42 °C na bloku grzewczym.
- Określić ilościowo stężenie DNA za pomocą odczynnika do oznaczania ilościowego dsDNA zgodnie ze specyfikacją producenta (patrz Tabela materiałów).
UWAGA: Użyj odczynnika do oznaczania ilościowego dsDNA, ponieważ spektrofotometryczne oznaczanie ilościowe DNA może mieć wpływ resztkowy fenol. - Przechowywać DNA w temperaturze -20 °C lub kontynuować leczenie HincII.
4. Leczenie HincII i hydroliza alkaliczna
- Trawić 1 μg DNA w mieszaninie reakcyjnej zawierającej 5 μl 10x bufor 3,1, 1 μl (10 U) HincII i H2Owolny od nukleaz do końcowej objętości 50 μL.
UWAGA: Aby osiągnąć optymalne warunki do ligacji, syntezy drugiej nici i amplifikacji PCR, może być konieczne zwiększenie ilości wejściowego DNA, jeśli oczekuje się, że DNA zawiera bardzo małą liczbę rybonukleotydów. Podobnie, może być konieczne zmniejszenie wejściowego DNA, jeśli liczba rybonukleotydów jest bardzo wysoka. - Inkubować przez 30 minut w temperaturze 37 °C.
- Oczyść DNA poddane działaniu HincII za pomocą kulek paramagnetycznych.
UWAGA: Pozostaw pokrywy probówek otwarte w następujących krokach, aby nie przeszkadzać granulkom przez otwieranie probówek.- Dodać 1,8 V kulek paramagnetycznych do każdej próbki, ostrożnie wymieszać pipetując i inkubować w temperaturze pokojowej przez 10 minut.
- Użyj stojaka magnetycznego, aby granulować kulki przez 5 minut, a następnie usuń i wyrzuć supernatant .
- Przemyć osad 150 μl 70% etanolu (temperatura pokojowa) przez około 30 s, a następnie usunąć i wyrzucić supernatant.
- Przemyć osad 200 μl 70% etanolu (temperatura pokojowa) przez około 30 s, a następnie usunąć i wyrzucić supernatant.
UWAGA: Resztki etanolu można usunąć za pomocą pipety o pojemności 10 μl. Kropelki można wcześniej na krótko odwirować. - Suszyć próbki w temperaturze pokojowej przez około 15-20 minut
UWAGA: Dokładny czas zależy od objętości kulek i kształtu granulki, dlatego granulki należy sprawdzić wizualnie. - Wyjąć probówki ze stojaka magnetycznego i wymyć osad w 45 μl EB, dokładnie wymieszać pipetując.
- Inkubować przez 5 minut, a następnie zagnieździć kulki na stojaku magnetycznym i użyć 45 μl oczyszczonego DNA w kroku 4.4.
- Dodać 5 μl KOH (3 M) lub KCl (3 M) do DNA, uzyskując całkowitą objętość 50 μL.
UWAGA: Roztwór 3 M KOH jest. Nosić odzież ochronną i rękawice. - Inkubować przez 2 godziny w temperaturze 55 °C w piecu do hybrydyzacji, a następnie 5 minut na lodzie.
UWAGA: Zaleca się wykonanie zabiegu KOH w piekarniku, a nie w bloku grzewczym, aby utrzymać równomierne nagrzewanie rurki i zapobiec kondensacji pary wodnej na pokrywie. - Wytrącić DNA, dodając 10 μl octanu sodu (3 M, pH = 5,2) i 125 μl zimnego 100% etanolu. Inkubować na lodzie przez 5 min.
UWAGA: 100% etanol jest łatwopalny i drażniący. Przechowywać w wentylowanej szafce, nosić odzież ochronną i rękawice oraz trzymać z dala od ognia. - Osad gDNA przez odwirowanie w temperaturze 21 000 x g, w temperaturze 4 °C przez 5 minut i odrzucić supernatant.
- Przepłukać osad DNA 250 μl zimnego 70% EtOH, odwirować w temperaturze 21 000 x g, 4 °C przez 5 minut i wyrzucić supernatant.
UWAGA: Aby usunąć kropelki, probówkę można ponownie na krótko odwirować, a supernatant usunąć za pomocą pipety o pojemności 10 μl. - Pozostaw granulkę do wyschnięcia w otwartej tubie przez około 5-10 minut, aż widoczny płyn wyparuje.
- Pozwól osadowi DNA rozpuścić się w 20 μl EB przez 30 minut w temperaturze pokojowej.
5. 5' Koniec fosforylacji
- Przygotować wcześniej mieszaninę reakcyjną dla każdej próbki, składającą się z 2,5 μl 10x buforu reakcyjnego kinazy polinukleotydowej T4, 1 μl (10 U) kinazy polinukleotydowej 3'-fosfatazy minus T4 i 2,5 μl ATP (10 mM).
- Przenieść 19 μl każdej próbki DNA do nowej probówki o pojemności 200 μl i poddać denaturacji przez 3 minuty w temperaturze 85 °C w termocyklerze.
- Schłodzić próbki DNA na lodzie i dodać 6 μl mieszanki reakcyjnej do każdej próbki.
- Inkubować mieszaniny reakcyjne w temperaturze 37 °C przez 30 minut i zatrzymać reakcję poprzez inkubację próbek w temperaturze 65 °C przez 20 minut.
- Oczyść DNA zgodnie z opisem w 4.3, używając 1,8 V kulek paramagnetycznych, ale eluuj w 14 μl EB.
6. Ligacja ssDNA
- Przygotuj wcześniej mieszaninę reakcyjną dla każdej próbki składającą się z 0,5 μl ATP (2 mM), 5 μl 10 x buforu reakcyjnego ligazy RNA T4, 5 μl CoCl3(NH3)6 (10 mM), 0,5 μL ARC140 (100 μM) i 25 μL 50% PEG 8000. Dobrze wymieszać pipetując.
UWAGA: CoCl3(NH3)6 jest rakotwórczy, uczulający i niebezpieczny dla środowiska wodnego. Nosić odzież ochronną i rękawice. - Przenieś 13 μl oczyszczonego DNA z etapu 5.5 do nowej probówki o pojemności 200 μl i denaturuj przez 3 minuty w temperaturze 85 °C w termocyklerze.
- Schłodzić DNA na lodzie i dodać 36 μl mieszaniny reakcyjnej do każdej próbki, wymieszać pipetując i krótko odwirować.
- Dodać 1 μl (10 U) ligazy T4 RNA do każdej reakcji, wymieszać pipetując i krótko odwirować.
- Próbki należy inkubować w temperaturze pokojowej w ciemności przez noc.
7. Synteza drugiej nici
- Oczyścić zligowane DNA zgodnie z opisem w ppkt 4.3, ale użyć 0,8 V kulek paramagnetycznych, otulić kulki przez 10 minut i wymyć w 20 μl EB.
UWAGA: Ze względu na wyższą lepkość mieszaniny reakcyjnej ligacji, pierwszy etap granulowania jest wydłużony. - Przenieś 20 μl próbki DNA do nowej probówki PCR o pojemności 200 μl. Powtórzyć etap oczyszczania przy użyciu 0,8 V kulek paramagnetycznych zgodnie ze specyfikacjami producenta i wymyć w 14 μl EB.
- Przygotować wcześniej mieszaninę reakcyjną dla każdej próbki, składającą się z 2 μl 10x buforu reakcyjnego polimerazy DNA T7, 2 μl ARC76/77 (2 μM), 2 μl dNTP (2 mM) i 0,8 μl BSA (1 mg/ml).
- Przenieś 12,8 μl oczyszczonego DNA do nowej probówki o pojemności 200 μl, denaturuj przez 3 minuty w temperaturze 85 °C w termocyklerze.
- Schłodzić DNA na lodzie i dodać 6,8 μl mieszaniny reakcyjnej do każdej próbki, wymieszać pipetując, krótko odwirować i inkubować przez 5 minut w temperaturze pokojowej.
- Dodać 0,4 μl (4 U) polimerazy DNA T7 do każdej reakcji i inkubować przez 5 minut w temperaturze pokojowej.
- Oczyścić DNA zgodnie z opisem w ppkt 4.3 za pomocą 0,8 V kulek paramagnetycznych i wymyć w 11 μl EB.
8. Amplifikacja PCR i kwantyfikacja biblioteki
- Przygotuj wcześniej mieszaninę reakcyjną dla każdej próbki w nowej probówce o pojemności 200 μl, składającej się z 7,5 μl ARC49 (2 μM), 7,5 μl startera indeksowego (2 μM, unikalne dla każdej próbki) i 25 μl 2x gotowa mieszanka gorącego startu.
- Do każdej reakcji dodać 10 μl próbki DNA. Amplifikować bibliotekę, stosując następujące warunki: denaturacja w temperaturze 95 °C przez 45 s, a następnie 18 cykli w temperaturze 98 °C przez 15 s, 65 °C przez 30 s, 72 °C przez 30 s, kończąc na końcowym wydłużeniu w temperaturze 72 °C przez 2 minuty. Utrzymać próbki w temperaturze 4 °C po amplifikacji.
- Oczyść biblioteki zgodnie z opisem w 4.3, używając 0,8 V kulek paramagnetycznych i eluuj w buforze 20 μl TE.
- Ilościowo oceniać biblioteki za pomocą odczynnika do oznaczania ilościowego dsDNA, zgodnie ze specyfikacjami producenta (patrz Tabela materiałów).
- Przechowywać próbki w temperaturze -20 °C lub kontynuować analizę biblioteczną.
9. Analiza i łączenie bibliotek
- Określ jakość każdej biblioteki i oszacuj średni rozmiar fragmentu za pomocą cyfrowego systemu elektroforezy.
UWAGA: Średnią wielkość fragmentu ocenia się, szacując, gdzie obszar pod krzywą elektroferogramu jest zmniejszony o połowę, z pominięciem pików ze znaczników. Reprezentatywne wyniki odpowiednich profili bibliotecznych po leczeniu KOH lub KCl są podane w Rysunek 2A. - Oblicz stężenie (nM) bibliotek jako:
(c/103)/(p*650)]*109
gdzie c jest stężeniem biblioteki w ng/μL, a p jest średnią wielkością fragmentu w bp, oszacowaną w pz. - Pula równych ilości molowych do 24 bibliotek amplifikowanych różnymi starterami indeksowymi do sekwencjonowania. Dodać bufor TE do końcowej objętości 25 μl i stężeniu 10 nM.
UWAGA: W zależności od liczby bibliotek, które mają zostać połączone, ilość DNA z każdej biblioteki jest dostosowywana. Jeśli dimery starterów zostały wykryte w kroku 9.1 jako wyraźny pik około 130 pz, końcowa objętość puli bibliotecznej może przekroczyć 25 μl, ponieważ etap oczyszczania powtarza się zgodnie z opisem w 4.3, używając 0,8 V kulek paramagnetycznych, a DNA jest eluowane w 25 μl buforu TE.- Określ stężenie nowej puli bibliotecznej za pomocą odczynnika do oznaczania ilościowego dsDNA zgodnie ze specyfikacjami producenta i średnią wielkością piku, jak opisano powyżej. Przejdź do sekwencjonowania i analizy danych (sekcje 10 i 11).
10. Sekwencjonowanie
- Wykonaj sekwencjonowanie sparowanych końców 75 baz w bibliotekach w puli12.
11. Analiza danych
- Przytnij wszystkie odczyty, aby usunąć sekwencje adapterów, przefiltruj pod kątem jakości i długości odczytu.
UWAGA: Można to zrobić za pomocą cutadapt 1.2.120 z poleceniem 'cutadapt -f fastq --match-read-wildcards --quiet -m 15 -q 10 -a NNNNNNN ', gdzie NNNNNNN jest zastępowane właściwą sekwencją adaptera, a jest zastępowany nazwą pliku fastq. - Usuń wiązania odczytów, które zostały odrzucone w poprzednim kroku przy użyciu skryptów niestandardowych.
- Dopasuj Wiązanie 1 pozostałych par do indeksu zawierającego sekwencję wszystkich oligonukleotydów użytych w przygotowaniu biblioteki (np. za pomocą Bowtie 0.12.821 i opcji wiersza poleceń -m1 -v2). Odrzuć wszystkie pary z udanym wyrównaniem.
- Dopasuj pozostałe pary do genomu referencyjnego organizmu za pomocą Bowtie z opcjami wiersza poleceń -v2 -X10000-best.
- Mapa odczytuje, że rozpiętość między cząsteczką mitochondrialną zaczyna się i kończy, wyrównując Mate 1 wszystkich niewyrównanych par (przy użyciu Bowtie z opcjami wiersza poleceń -v2).
- Określ liczbę końców 5' dla wszystkich pojedynczych i sparowanych wyrównań końców. Przesuń ich położenie o jedną zasadę w górę rzeki do pozycji, w której znajdowały się hydrolizowane rybonukleotydy.
- Eksportuj dane z formatu pliku muszki do formatu pliku wykresu łóżka przy użyciu niestandardowych skryptów do wizualizacji w popularnych przeglądarkach genomu. Znormalizuj odczyty dla każdej nitki do odczytów na milion.
- Korzystając z pozycji i zliczeń z pliku wykresu łóżkowego, odwołaj się do sekwencji genomu organizmu, aby określić tożsamość włączonych rybonukleotydów.
UWAGA: W przypadku ludzkiego genomu mitochondrialnego odczyty z regionów 16,200-300 i 5,747-5,847 dla każdej nici powinny być wykluczone, ponieważ regiony te zawierają wiele wolnych końców 5' niezwiązanych z inkorporacją rybonukleotydów przez polimerazę DNA γ. - Podziel łączną liczbę odczytów, nie uwzględniając odczytów w jedenastu miejscach HincII, przez średnią liczbę odczytów na miejsce HincII, aby uzyskać liczbę rybonukleotydów na pojedyncze pęknięcie nici (tj. liczbę rybonukleotydów na cząsteczkę mitochondrialną).
Wyniki
W celu zilustrowania opisaną powyżej metodologii, wygenerowano reprezentatywne dane z analizy ludzkiego mitochondrialnego DNA z komórek HeLa12. Rycina 2B przedstawia podsumowanie odczytów we wszystkich miejscach cięcia HincII w ciężkiej (HS) i lekkiej nici (LS) ludzkiego mtDNA po traktowaniu KCl (panele lewe). Około 70% wszystkich wykrytych końców 5´ lokalizuje się w miejscach cięcia, co świadczy o wysokiej wydajności trawienia enzymem HincII. Traktowanie bibliotek KOH w celu hydrolizy DNA w miejscach wbudowanych rybonukleotydów zmniejsza liczbę odczytów w miejscach HincII do około 40% (Rycina 2B, panele prawe). Jest to wynik oczekiwany, ponieważ znaczna liczba końców 5´ powstaje w miejscach inkorporacji rybonukleotydów, co wskazuje na odpowiednią jakość biblioteki. Rycina 2C ilustruje lokalizację i częstotliwość końców 5´ (kolor zielony) po traktowaniu KCl oraz odczyty wygenerowane metodą HydEn-seq (kolor magenta) po traktowaniu KOH, co pozwala na wykrycie zarówno wolnych końców 5´, jak i końców powstałych w wyniku hydrolizy alkalicznej rybonukleotydów. Wolne końce 5´ i rybonukleotydy zlokalizowane w nici HS ludzkiego mtDNA przedstawiono na panelu lewym, a te zlokalizowane w nici LS na panelu prawym. Względna liczba surowych odczytów w miejscach rybonukleotydów (Rycina 2D, panel górny) lub miejsc HincII (panel dolny) w niciach HS i LS mtDNA wykazuje odpowiednio 14- lub 31-krotnie silniejsze pokrycie nici LS w stosunku do HS, podczas gdy podobnego skrzywienia nie zaobserwowano dla DNA jądrowego. To skrzywienie nici można wyjaśnić wyraźną różnicą w składzie zasad obu nici, co ilustruje znaczenie normalizacji do odczytów w miejscach HincII.
Normalizacja liczby odczytów do HincII daje ilościową miarę liczby rybonukleotydów na genom mitochondrialny (Rysunek 3A). Jak pokazano na Rysunku 3B, odczyty po traktowaniu KOH dla każdego rybonukleotydu, znormalizowane do składu sekwencyjnego każdej nici, wykazują stosunek inny niż 1, co wskazuje na nierandomowy rozkład odczytów, sugerując odrębny wzór rybonukleotydów i wysoką jakość biblioteki. Stosunek ten nie ulega zmianie pod wpływem wcześniejszego trawienia enzymem HincII, co potwierdza specyficzność cięcia tego enzymu. Normalizacja odczytów w miejscach wbudowanych rybonukleotydów względem odczytów w miejscach cięcia HincII, a także względem nukleotydowej zawartości genomu, pozwala na wyznaczenie ilościowej miary tego, ile każdego rybonukleotydu jest wbudowanych na 1 000 zasad komplementarnych (Rysunek 3C).
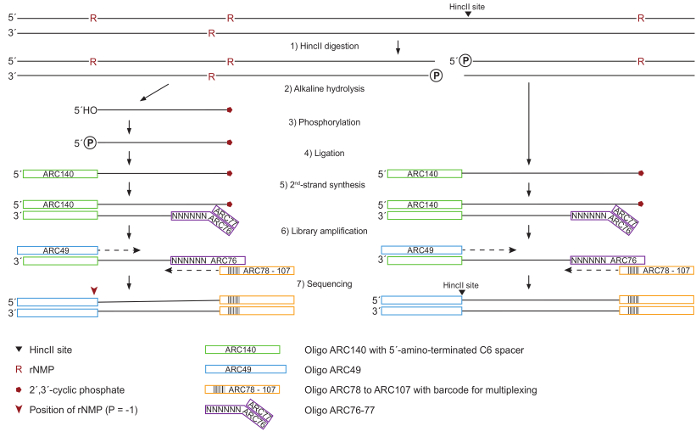
Rycina 1: Schemat przetwarzania DNA i przygotowania biblioteki. (1) Całkowite DNA genomiczne jest cięte za pomocą HincII w celu normalizacji w późniejszym oznaczaniu ilości rybonukleotydów, co generuje tępe końce w miejscach cięcia HincII (czarna strzałka). (2) DNA jest traktowane KOH w celu hydrolizy w miejscach rybonukleotydowych, co prowadzi do powstania 2´,3´-cyklicznego fosforanu (czerwony pięciobok) na końcach 3´ oraz wolnych końców 5´-OH. (3) Końce 5´-OH są fosforylowane przez T4 Polynucleotide Kinase 3´-phosphatase-minus. (4) Wszystkie końce 5´ posiadające grupę fosforanową są ligowane do oligonukleotydu ARC140 za pomocą T4 RNA ligazy. (5) Druga nić jest syntetyzowana przy użyciu T7 DNA Polymerazy i oligonukleotydów ARC76-77 zawierających losowe sekwencje N6. (6) Biblioteka jest amplifikowana przez wysokowierną DNA Polimerazę przy użyciu ARC49 oraz jednego z primerów indeksujących od ARC78 do ARC107, zawierającego unikalny kod kreskowy do multipleksowania. (7) Końce 5´ są lokalizowane poprzez sekwencjonowanie par końcowych (paired-end sequencing). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
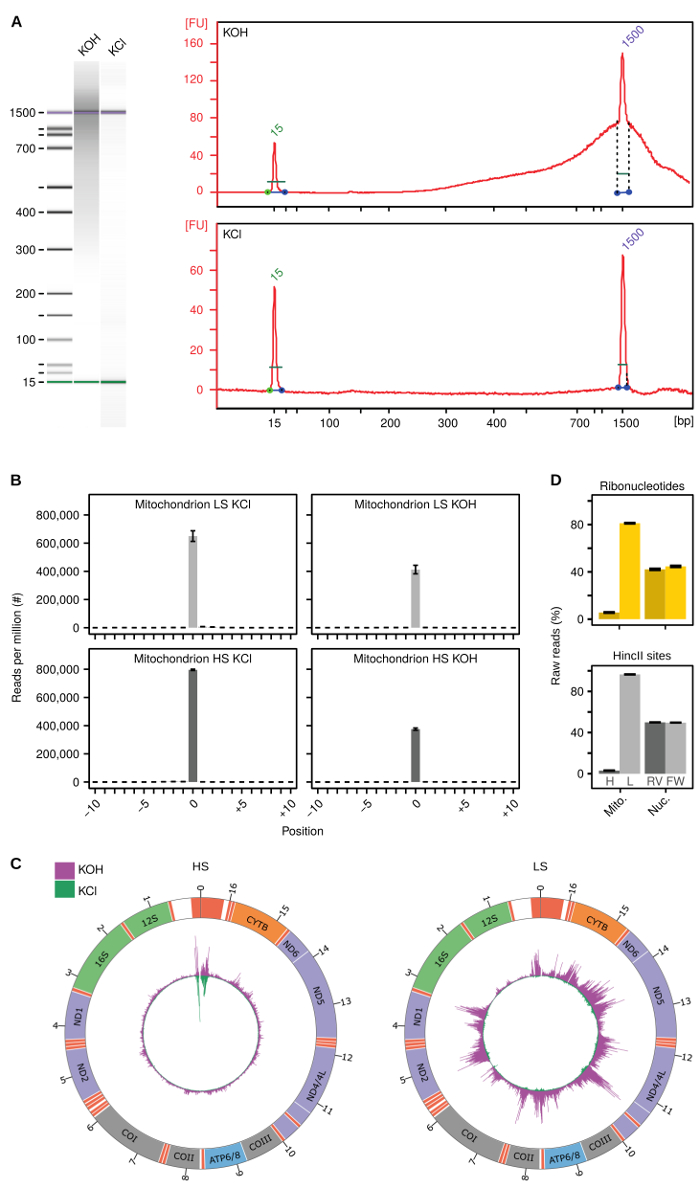
Rysunek 2: Walidacja metody. (A) Reprezentatywne elektroferogramy wygenerowane za pomocą zautomatyzowanego systemu elektroforezy w celu określenia jakości bibliotek otrzymanych po traktowaniu KOH lub KCl. (B) Zsumowany sygnał w miejscach cięcia HincII w ciężkiej (HS) i lekkiej nici (LS) ludzkiego mtDNA po traktowaniu KCl (panele lewe) lub KOH (panele prawe). (C) Wykres Circos wolnych końców 5´ (zielony) oraz danych z HydEn-Seq (wolne końce 5´ i rybonukleotydy, purpurowy) w HS (panel lewy) i LS (panel prawy) ludzkiego mtDNA. Piki zostały znormalizowane do liczby odczytów na milion, a maksymalny pik dostosowano do maksymalnej liczby odczytów w bibliotece HydEn-seq. (D) Zsumowane surowe odczyty w miejscach rybonukleotydów (panel górny) i miejscach cięcia HincII (panel dolny) w ciężkiej (H) i lekkiej (L) nici ludzkiego mtDNA (Mito.) lub w nici odwrotnej (RV) bądź przedniej (FW) jądrowego (Nuc.) DNA. Rysunki B, C i D zostały zaadaptowane z referencji12. Słupki błędów reprezentują standardowy błąd średniej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
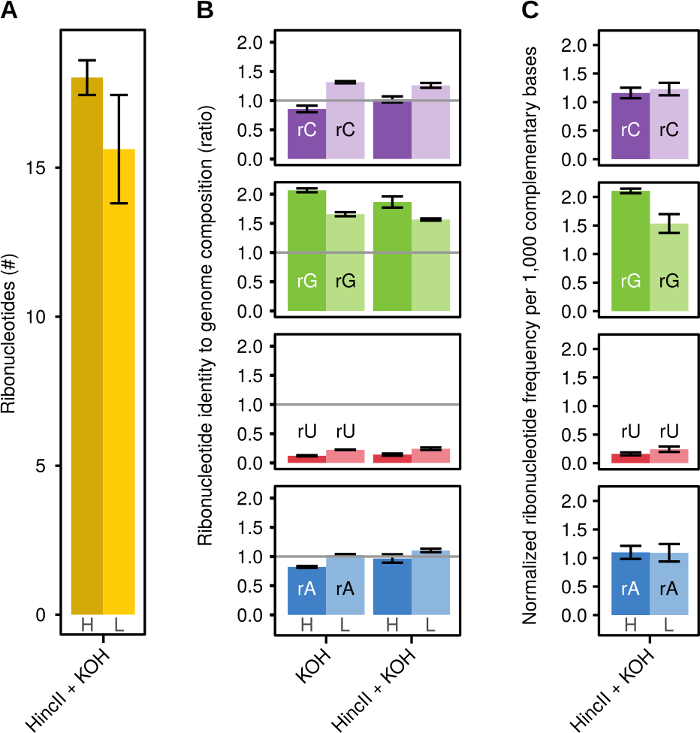
Rycina 3: Reprezentatywne wyniki. (A) Względna liczba rybonukleotydów znormalizowana do odczytów w miejscach HincII dla bibliotek traktowanych KOH w nici ciężkiej (H) lub lekkiej (L). (B) Stosunek tożsamości rybonukleotydów do składu genomu mtDNA dla bibliotek traktowanych KOH (KOH) oraz ciętych HincII i traktowanych KOH (HincII+KOH) w nici ciężkiej (H) lub lekkiej (L) mtDNA. (C) Częstotliwość rybonukleotydów znormalizowana do 1 000 zasad komplementarnych dla bibliotek traktowanych HincII i KOH w nici ciężkiej (H) lub lekkiej (L) mtDNA. Ryciny zostały zaadaptowane z referencji12. Słupki błędów reprezentują błąd standardowy średniej. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Nazwa | Sekwencja | |||
| ARC49 | AATGATACGGCGACCACCGAGATCTACACTCTTTCCCTACACGACGCTCTTCCGATCT | |||
| ARC76 | GTGACTGGAGTTCAGACGTGTGCTCTTCCGATCTNNNN*N*N | |||
| ARC77 | AGATCGGAAGAGCACACGTCTGAACTCCAGTC*A*C | |||
| ARC78 | CAAGCAGAAGACGGCATACGAGATCGTGATGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC84 | CAAGCAGAAGACGGCATACGAGATACATCGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC85 | CAAGCAGAAGACGGCATACGAGATGCCTAAGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC86 | CAAGCAGAAGACGGCATACGAGATTGGTCAGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC87 | CAAGCAGAAGACGGCATACGAGATCACTGTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC88 | CAAGCAGAAGACGGCATACGAGATATTGGCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC89 | CAAGCAGAAGACGGCATACGAGATGATCTGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC90 | CAAGCAGAAGACGGCATACGAGATTCAAGTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC91 | CAAGCAGAAGACGGCATACGAGATCTGATCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC93 | CAAGCAGAAGACGGCATACGAGATAAGCTAGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC94 | CAAGCAGAAGACGGCATACGAGATGTAGCCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC95 | CAAGCAGAAGACGGCATACGAGATTACAAGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC96 | CAAGCAGAAGACGGCATACGAGATTGTTGACTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC97 | CAAGCAGAAGACGGCATACGAGATACGGAACTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC98 | CAAGCAGAAGACGGCATACGAGATTCTGACATGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC99 | CAAGCAGAAGACGGCATACGAGATCGGGACGGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC100 | CAAGCAGAAGACGGCATACGAGATGTGCGGACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC101 | CAAGCAGAAGACGGCATACGAGATCGTTTCACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC102 | CAAGCAGAAGACGGCATACGAGATAAGGCCACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC103 | CAAGCAGAAGACGGCATACGAGATTCCGAAACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC104 | CAAGCAGAAGACGGCATACGAGATTACGTACGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC105 | CAAGCAGAAGACGGCATACGAGATATCCACTCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC106 | CAAGCAGAAGACGGCATACGAGATATATCAGTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC107 | CAAGCAGAAGACGGCATACGAGATAAAGGAATGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC140 | /5AmMC6/ACACTCTTTCCCTACACGACGCTCTTCCGATCT | |||
Tabela 1: Oligonukleotydy. Wykaz oligonukleotydów zastosowanych w metodzie HydEn-Seq. Pogrubiona czcionka oznacza indeksowanie. * oznacza wiązanie fosforotioatowe. ARC140 zawiera grupę 5´-aminową zamiast grupy 5´-OH, w połączeniu z łącznikiem C6. Modyfikacja ta ogranicza tworzenie konkatemerów ARC140 podczas ligacji.
Dyskusja
W tym miejscu przedstawiamy technikę jednoczesnego mapowania i ilościowego oznaczania rybonukleotydów w gDNA, a w szczególności mtDNA, poprzez proste wprowadzenie rozszczepienia DNA w określonych sekwencjonalnie miejscach w genomie jako dodatek do ustalonego protokołu HydEn-seq. Chociaż badanie to koncentruje się na ludzkim mtDNA, pierwotnie metoda HydEn-seq została opracowana w Saccharomyces cerevisiae, ilustrując translację metody na inne organizmy12,16.
Aby uzyskać wiarygodne wyniki uzyskane dzięki temu podejściu, należy zwrócić uwagę na kilka krytycznych kroków: (A) Ponieważ adaptery sekwencjonowania ligują do wszystkich dostępnych końców 5', ważne jest, aby pracować z wysoce nienaruszonym DNA. DNA należy wyizolować, a biblioteki najlepiej sporządzić natychmiast po wyizolowaniu DNA, w przeciwnym razie DNA można przechowywać w temperaturze -20 °C. Nie zaleca się przechowywania DNA w lodówce przez długi czas ani wielokrotnego zamrażania i rozmrażania. (B) Aby wygenerować odpowiednie biblioteki za pomocą tej metody, kluczowe jest przeprowadzenie obróbki KOH DNA w piecu inkubacyjnym, a nie w bloku grzewczym, zapewniając jednorodne ogrzewanie całej próbki i hydrolizę ilościową. (C) Ponadto kluczowe znaczenie ma kontrola jakości bibliotek przed ich łączeniem i sekwencjonowaniem. DNA należy określić ilościowo i przeanalizować za pomocą zautomatyzowanego systemu elektroforezy, aby zapewnić odpowiednią ilość DNA z biblioteki, potwierdzić odpowiednie rozmiary fragmentów i sprawdzić, czy nie ma dimerów starterów.
Aby uzyskać miarodajną analizę danych, należy również zauważyć, że wartość informacyjna tej metody zależy od odpowiednich kontroli w celu oceny liczby tła i odchyleń sekwencji lub pasm. Rutynowo osiągamy skuteczność mapowania w próbkach KCl bliską 70%, gdy trawimy tylko endonukleazą specyficzną dla sekwencji (Figura 2B, lewe panele). Ponadto ważne jest, aby potwierdzić, że leczenie endonukleazą nie wpływa na ogólne wykrywanie włączonych rybonukleotydów, porównując próbki traktowane i nietraktowane HincII (Figura 3B). W tych eksperymentach użyliśmy HincII do wprowadzenia cięć specyficznych dla miejsca, chociaż można również zastosować inne enzymy restrykcyjne o wysokiej wierności.
Protokół może zostać zaadaptowany do badania innych rodzajów zmian DNA, które mogą być przetwarzane na końce 5'-fosforanu lub 5'-OH. Dokładność wyników zależy od specyfiki przetwarzania i wymaga odpowiednich kontroli (np. typu dzikiego lub niepoddanego obróbce) w celu weryfikacji. Ponadto, dostosowując tę metodę do innych zastosowań lub do użytku z innymi organizmami, należy wziąć pod uwagę, że metoda w obecnej konfiguracji wymaga około 1 μg DNA, które jest przetwarzane do biblioteki. Ponieważ liczba końców zależy od liczby osadzonych rybonukleotydów, która różni się w zależności od organizmu lub mutanta, próbki zawierające mniejszą liczbę rybonukleotydów wymagałyby więcej wejściowego DNA, aby wygenerować wystarczającą liczbę końców w późniejszej konstrukcji biblioteki. Podobnie, jeśli próbki DNA mają znacznie większą liczbę rybonukleotydów, wymagałoby to również użycia mniejszej ilości wejściowego DNA, aby uzyskać optymalne warunki do ligacji, syntezy drugiej nici i amplifikacji PCR. Warto zauważyć, że konstrukcja biblioteki opisana w tym protokole również generowała dane obejmujące genom jądrowy (jak pokazano na rysunku 2D) i tylko analiza danych koncentrowała się na mtDNA. Ilustruje to, że za pomocą tej metody wychwytuje się również większe genomy o umiarkowanie niższych częstościach rybonukleotydów.
Rozważając tę metodę, należy wziąć pod uwagę pewne ograniczenia: Chociaż metoda ta powinna teoretycznie mieć zastosowanie do praktycznie każdego organizmu, odpowiedni genom referencyjny jest niezbędny do wyrównania odczytów. Ponadto wyniki uzyskane z naszego protokołu reprezentują odczyty z dużej liczby komórek. Za pomocą tego podejścia nie można zidentyfikować specyficznych wzorców inkorporacji rybonukleotydów w podzbiorze komórek. Jeśli rybonukleotydy są mapowane w większych genomach z bardzo małą liczbą rybonukleotydów, odróżnienie rybonukleotydów od losowych nacięć może być trudne i dlatego potrzebne są odpowiednie kontrole.
Metoda, którą tutaj opisujemy, rozszerza dostępne techniki in vivo , takie jak HydEn-Seq16, Ribose-Seq17, Pu-Seq18 czy emRiboSeq19. Podejścia te wykorzystują wrażliwość osadzonych rybonukleotydów odpowiednio na traktowanie alkaliami lub RNazą H2, wykorzystując sekwencjonowanie nowej generacji do identyfikacji rybonukleotydów w całym genomie, co umożliwia ich mapowanie i porównanie względnej inkorporacji. Poprzez rozszczepienie sekwencji DNA, jak opisano powyżej, oprócz hydrolizy alkalicznej w osadzonych rybonukleotydach, odczyty rybonukleotydów można znormalizować do tych miejsc cięcia, umożliwiając nie tylko identyfikację i mapowanie rybonukleotydów, ale także ich ilościowe określenie dla każdej cząsteczki DNA. Zastosowanie naszej techniki w kontekście chorób związanych z replikacją DNA, naprawą DNA i TLS może zapewnić głębsze zrozumienie roli rybonukleotydów w podstawowych mechanizmach molekularnych i ogólnej integralności genomu.
Oświadczenia
Autorzy oświadczają, że nie mają konkurencyjnych interesów finansowych.
Podziękowania
To badanie było wspierane przez Szwedzką Radę ds. Badań Naukowych (www.vr.se) granty dla ARC (2014-6466) oraz Szwedzką Fundację Badań Strategicznych (www.stratresearch.se) dla ARC (ICA14-0060). Chalmers University of Technology udzielił MKME wsparcia finansowego podczas tych prac. Fundatorzy nie odgrywali żadnej roli w projektowaniu badania, gromadzeniu i analizie danych, podejmowaniu decyzji o publikacji lub przygotowaniu manuskryptu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 10x bufor reakcyjny kinazy polinukleotydowej T4 | New England Biolabs | B0201S | |
| 10x bufor reakcyjny ligazy RNA T4 | New England Biolabs | B0216L | |
| 1x PBS | Medicago | 09-9400-100 | rozpuścić 1 tabletkę w H2O do końcowej objętości 1 L |
| 2-Propanol | Sigma-Aldrich | 33539-1L-GL-R | |
| 2100 Bioanalizator | Agilent Technologies | G2940CA | |
| 50 ml probówka wirówkowa | VWR | 525-0610 | |
| 5'-trifosforan adenozyny (ATP, 10 mM) | New England Biolabs | P0756S | rozcieńczony EB do 2 mM |
| Zestaw Agilent DNA 1000 | Agilent Technologies | 5067-1504 | |
| BSA, klasa biologii molekularnej (20 mg / ml) | New England Biolabs | B9000S | rozcieńczyć wolnym od nukleaz H2O do 1 mg/ml |
| Bufor EB | QIAGEN | 19086 | określany jako |
| kulki paramagnetyczne EB CleanPCR | CleanNA | CPCR-0050 | |
| Mieszanina roztworów deoksynukleotydów (dNTP) (10 mM każdy) | New England Biolabs | N0447L | rozcieńczony EB do 2 mM |
| DMEM, wysoki poziom glukozy, GlutaMAX Suplement | Gibco | 61965026 | |
| DynaMag 96 Side | Thermo Fisher | 12331D | |
| Etanol 99,5% klasy analitycznej | Solveco | 1395 | rozcieńczyć wodą miliQ do 70% |
| roztworu kwasu etylenodiaminotetraoctowego (EDTA, 0,5 M) | Sigma-Aldrich | 03690-100ML | |
| Płodowa surowica bydlęca | Gibco | 10500056 | |
| HEPES bufor pH 8,0 (1 M) sterylny BC | AppliChem | A6906,0125 | |
| Chlorek heksamaminy kobaltu(III) (CoCl3(NH3)6) | Sigma-Aldrich | H7891-5G | rozpuszcza się w wolnych od nukleaz H2O przez 10 M roztwór, sterylny filtr. UWAGA: rakotwórcze, uczulające i niebezpieczne dla środowiska wodnego. |
| HincII | New England Biolabs | R0103S dostarczany | z NEBuffer 3.1 |
| Hybridiser HB-1D | Techne | FHB4DD | |
| KAPA HiFi HotStart ReadyMix (2X) | Kapa Biosystems | KK2602 | |
| Bufor | 50 mM EDTA, 20 mM HEPES, NaCl 75 mM, Proteinaza K (200 &mikro; g/ml), 1% SDS | ||
| Mikroprobówka 1,5 ml | Sarstedt | 72.690.001 | |
| Mikrowirówka 5424R | Eppendorf | 5404000014 | |
| Mikrowirówka MiniStar silverline VWR | 521-2844 | ||
| Mnożenie &mikro; Probówka StripPro 0,2 ml | Sarstedt | 72.991.992 | |
| Woda bez nukleaz | Ambion | AM9937 | |
| Fenol – chloroform – alkohol izoamylowy (25:24:1) | Sigma-Aldrich | 77617-500ML | |
| Chlorek potasu (KCl) | VWR | 26764.232 | rozpuścić w nienukleazie H2O przez 3 M roztwór, sterylny filtr |
| Wodorotlenek potasu (KOH) | VWR | 26668.296 | rozpuścić w wolnym od nukleaz H2O przez 3 Roztwór M, sterylny filtr |
| Proteinaza K | Ambion | AM2546 | |
| Fluorometr Qubit 3.0 | Invitrogen | Q33216 | |
| Probówki do oznaczania kubitów | Invitrogen | Q32856 | |
| Zestaw testowy Qubit dsDNA BR | Invitrogen | Q32850 | UWAGA: Zawiera składniki łatwopalne i toksyczne |
| Zestaw testowy Qubit dsDNA HS | Invitrogen | Q32851 | UWAGA: Zawiera łatwopalne i toksyczne składniki |
| Wirówka z chłodzeniem 4K15 | Wirówki laboratoryjne Sigma | nr 10740 | |
| Roztwór SDS, 10% | Invitrogen | 15553-035 | |
| Roztwór buforowy octanu sodu, pH 5,2, 3 M (NaAc) | Sigma-Aldrich | S7899 | |
| Chlorek sodu (NaCl) | VWR | 27810.295 | rozpuścić w wolnym od nukleaz H2O przez 5 Roztwór M, sterylny filtr |
| T100 Thermal Cycler | Bio-Rad | 1861096 | |
| Kinaza polinukleotydowa T4 (fosfataza 3' minus) | New England Biolabs | M0236L | |
| T4 RNA Ligaza 1 (ligaza ssRNA) | New England Biolabs | M0204L | dostarczany z PEG 8000 (50%) |
| Polimeraza DNA T7 (niemodyfikowana) | New England Biolabs | M0274S | dostarczany z 10x T7 DNA Polymerase Reaction |
| Buffer TE Buffer | Invitrogen | 12090015 | |
| ThermoMixer F2.0 | Eppendorf | 5387000013 |
Bibliografia
- Traut, T. W. Physiological Concentrations of Purines and Pyrimidines. Mol. Cell. Biochem. 140, 1-22 (1994).
- McElhinny, S. A. N., et al. Abundant ribonucleotide incorporation into DNA by yeast replicative polymerases. Proc. Natl. Acad. Sci. USA. 107, 4949-4954 (2010).
- Williams, J. S., Lujan, S. A., Kunkel, T. A. Processing ribonucleotides incorporated during eukaryotic DNA replication. Nat. Rev. Mol. Cell Biol. 17, 350-363 (2016).
- Clausen, A. R., Zhang, S., Burgers, P. M., Lee, M. Y., Kunkel, T. A. Ribonucleotide incorporation, proofreading and bypass by human DNA polymerase delta. DNA Repair. 12, 121-127 (2013).
- Potenski, C. J., Klein, H. L. How the misincorporation of ribonucleotides into genomic DNA can be both harmful and helpful to cells. Nucleic Acids Res. 42, 10226(2014).
- Vengrova, S., Dalgaard, J. Z. RNase-sensitive DNA modification(s) initiates S. pombe mating-type switching. Gene. Dev. 18, 794-804 (2004).
- Lujan, S. A., Williams, J. S., Clausen, A. R., Clark, A. B., Kunkel, T. A. Ribonucleotides Are Signals for Mismatch Repair of Leading-Strand Replication Errors. Mol. Cell. 50, 437-443 (2013).
- Ghodgaonkar, M. M., et al. Ribonucleotides Misincorporated into DNA Act as Strand-Discrimination Signals in Eukaryotic Mismatch Repair. Mol. Cell. 50, 323-332 (2013).
- DeRose, E. F., Perera, L., Murray, M. S., Kunkel, T. A., London, R. E. Solution Structure of the Dickerson DNA Dodecamer Containing a Single Ribonucleotide. Biochemistry. 51, 2407-2416 (2012).
- Li, Y. F., Breaker, R. R. Kinetics of RNA degradation by specific base catalysis of transesterification involving the 2 '-hydroxyl group. J. Am. Chem. Soc. 121, 5364-5372 (1999).
- McElhinny, S. A. N., et al. Genome instability due to ribonucleotide incorporation into DNA. Nat. Chem. Biol. 6, 774-781 (2010).
- Berglund, A. K., et al. Nucleotide pools dictate the identity and frequency of ribonucleotide incorporation in mitochondrial DNA. Plos Genet. 13, (2017).
- Brown, J. A., Suo, Z. C. Unlocking the Sugar "Steric Gate" of DNA Polymerases. Biochemistry. 50, 1135-1142 (2011).
- Sparks, J. L., et al. RNase H2-Initiated Ribonucleotide Excision Repair. Mol. Cell. 47, 980-986 (2012).
- Miyabe, I., Kunkel, T. A., Carr, A. M. The Major Roles of DNA Polymerases Epsilon and Delta at the Eukaryotic Replication Fork Are Evolutionarily Conserved. Plos Genet. 7, (2011).
- Clausen, A. R., et al. Tracking replication enzymology in vivo by genome-wide mapping of ribonucleotide incorporation. Nat. Struct. Mol. Biol. 22, 185-191 (2015).
- Koh, K. D., Balachander, S., Hesselberth, J. R., Storici, F. Ribose-seq: global mapping of ribonucleotides embedded in genomic DNA. Nat. Methods. 12, 251(2015).
- Keszthelyi, A., Daigaku, Y., Ptasinska, K., Miyabe, I., Carr, A. M. Mapping ribonucleotides in genomic DNA and exploring replication dynamics by polymerase usage sequencing (Pu-seq). Nat. Protoc. 10, 1786-1801 (2015).
- Ding, J., Taylor, M. S., Jackson, A. P., Reijns, M. A. M. Genome-wide mapping of embedded ribonucleotides and other noncanonical nucleotides using emRiboSeq and EndoSeq. Nat. Protoc. 10, 1433-1444 (2015).
- Martin, M. Cutadapt removes adapter sequences from high-throughput sequencing reads. EMBnet.journal. 17, 10-12 (2011).
- Langmead, B., Trapnell, C., Pop, M., Salzberg, S. L. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biol. 10, (2009).
Przedruki i uprawnienia
