Tutaj prezentujemy narzędzie proteogenomiczne PoGo i protokoły do szybkiej, ilościowej, potranslacyjnej modyfikacji i umożliwionego mapowania wariantów peptydów zidentyfikowanych za pomocą spektrometrii mas na genomy referencyjne. To narzędzie jest przydatne do integracji i wizualizacji proteogenomicznych i osobistych badań proteomicznych w połączeniu z ortogonalnymi danymi genomicznymi.
Artykuł metodologiczny
Szybka i ilościowa metoda modyfikacji potranslacyjnej i wariantów umożliwiła mapowanie peptydów do genomów
W tym artykule
Podsumowanie
Streszczenie
Wzajemne oddziaływanie między genami, transkryptami i białkami jest kluczem do odpowiedzi komórkowych; stąd analiza poziomów molekularnych jako odrębnych jednostek jest powoli rozszerzana na badania integracyjne, aby zwiększyć zrozumienie dynamiki molekularnej w komórkach. Obecne narzędzia do wizualizacji i integracji proteomiki z innymi zbiorami danych omicznych są nieodpowiednie do badań na dużą skalę. Co więcej, rejestrują tylko podstawową identyfikację sekwencji, odrzucając modyfikacje potranslacyjne i ocenę ilościową. Aby rozwiązać te problemy, opracowaliśmy PoGo do mapowania peptydów z powiązanymi modyfikacjami potranslacyjnymi i kwantyfikacją w celu odniesienia adnotacji genomu. Ponadto narzędzie zostało opracowane, aby umożliwić mapowanie peptydów zidentyfikowanych na podstawie niestandardowych baz danych sekwencji zawierających warianty pojedynczych aminokwasów. Podczas gdy PoGo jest narzędziem wiersza poleceń, interfejs graficzny PoGoGUI umożliwia badaczom niezajmującym się bioinformatyką łatwe mapowanie peptydów do 25 gatunków obsługiwanych przez adnotację genomu Ensembl. Wygenerowane dane wyjściowe zapożyczają formaty plików z dziedziny genomiki, dlatego wizualizacja jest obsługiwana w większości przeglądarek genomu. W przypadku badań na dużą skalę, PoGo jest wspierane przez TrackHubGenerator w celu tworzenia dostępnych w Internecie repozytoriów danych zmapowanych do genomów, które umożliwiają również łatwe udostępnianie danych proteogenomicznych. Przy niewielkim wysiłku narzędzie to może w ciągu zaledwie kilku minut zmapować miliony peptydów w celu odniesienia do genomów referencyjnych, przewyższając inne dostępne narzędzia oparte na tożsamości sekwencji. Protokół ten demonstruje najlepsze podejścia do mapowania proteogenomiki za pomocą PoGo z publicznie dostępnymi zestawami danych ilościowych i fosfoproteomicznych, a także badaniami na dużą skalę.
Wprowadzenie
W komórkach genom, transkryptom i proteom wpływają na siebie nawzajem, modulując reakcję na bodźce wewnętrzne i zewnętrzne oraz współdziałając ze sobą, aby wykonywać określone funkcje prowadzące do zdrowia i choroby. Dlatego charakterystyka i kwantyfikacja genów, transkryptów i białek ma kluczowe znaczenie dla pełnego zrozumienia procesów komórkowych. Sekwencjonowanie nowej generacji (NGS) jest jedną z najczęściej stosowanych strategii identyfikacji i ilościowego określania ekspresji genów i transkryptów. Jednak ekspresja białek jest powszechnie oceniana za pomocą spektrometrii mas (MS). Znaczący postęp w technologii SM w ciągu ostatniej dekady umożliwił bardziej kompletną identyfikację i kwantyfikację proteomów, dzięki czemu dane są porównywalne z transkryptomiką1. Proteogenomika i multiomika jako sposoby integracji danych NGS i MS stały się potężnymi podejściami do oceny procesów komórkowych na wielu poziomach molekularnych, identyfikując podtypy raka i prowadząc do nowych potencjalnych celów leków w raku2,3. Należy zauważyć, że proteogenomika była początkowo używana do dostarczania dowodów proteomicznych dla adnotacji genów i transkryptów4. Kilka genów, które wcześniej uważano za niekodujące, zostało niedawno poddanych ponownej ocenie, biorąc pod uwagę duże zbiory danych o tkankach ludzkich5,6,7. Ponadto dane proteomiczne są z powodzeniem wykorzystywane do wspierania działań adnotacyjnych w organizmach niemodelowych8,9. Integracja danych proteogenomicznych może być jednak dalej wykorzystywana do podkreślenia ekspresji białek w odniesieniu do cech genomowych i wyjaśnienia wzajemnych oddziaływań między transkryptami a białkami poprzez zapewnienie połączonego systemu referencyjnego i metod wspólnej wizualizacji.
W celu zapewnienia wspólnego punktu odniesienia dla danych proteomicznych, transkryptomicznych i genomicznych, zaimplementowano liczne narzędzia do mapowania peptydów zidentyfikowanych przez MS na współrzędne genomu10,11,12,13,14,15,16,17. Podejścia różnią się takimi aspektami, jak odniesienie do mapowania, obsługa przeglądarek genomu i stopień integracji z innymi narzędziami proteomicznymi, jak pokazano na Rysunek 1. Podczas gdy niektóre narzędzia mapują peptydy poddane odwrotnej translacji na genome16, inne używają adnotacji w wyszukiwarce w adnotacji białka i genu, aby zrekonstruować sekwencję nukleotydów peptide15. Jeszcze inni używają 3- lub 6-ramkowej translacji genomu do mapowania peptydów przeciwko11,13. Wreszcie, kilka narzędzi pomija sekwencje nukleotydowe i wykorzystuje translacje sekwencji aminokwasów z transkryptów zmapowanych sekwencjonowaniem RNA jako produkt pośredni do mapowania peptydów do powiązanych współrzędnych genomu10,12,14,17. Jednak translacja sekwencji nukleotydowych jest powolnym procesem, a niestandardowe bazy danych są podatne na błędy, które propagują się do mapowania peptydów. W przypadku szybkiego mapowania o wysokiej przepustowości kluczowe znaczenie ma małe i kompleksowe odniesienie. Dlatego standaryzowane odniesienie do białka z powiązanymi współrzędnymi genomu jest niezbędne do dokładnego mapowania peptydu do genomu. Nowatorskie aspekty proteogenomiki, takie jak włączanie wariantów i modyfikacji potranslacyjnych (PTM)2,3, nabierają rozpędu dzięki najnowszym badaniom. Jednak na ogół nie są one obsługiwane przez obecne narzędzia do mapowania proteogenomicznego, jak pokazano na Rysunek 1. Aby poprawić szybkość i jakość mapowania, opracowano PoGo, narzędzie, które umożliwia szybkie i ilościowe mapowanie peptydów do genomów18. Ponadto PoGo umożliwia mapowanie peptydów z maksymalnie dwoma wariantami sekwencji i adnotowanymi modyfikacjami potranslacyjnymi.
PoGo zostało opracowane, aby poradzić sobie z szybkim wzrostem ilościowych zestawów danych o wysokiej rozdzielczości, rejestrujących proteomy i globalne modyfikacje, i stanowi centralne narzędzie do analiz na dużą skalę, takich jak zmienność osobista i medycyna precyzyjna. W artykule opisano zastosowanie tego narzędzia do wizualizacji obecności modyfikacji potranslacyjnej w odniesieniu do cech genomowych. Ponadto w artykule tym zwrócono uwagę na identyfikację alternatywnych zdarzeń splicingu za pomocą zmapowanych peptydów oraz mapowanie peptydów zidentyfikowanych za pomocą niestandardowych baz danych wariantów do genomu referencyjnego. Protokół ten wykorzystuje publicznie dostępne zestawy danych pobrane z archiwum PRIDE19 w celu zademonstrowania tych funkcji PoGo. Ponadto protokół ten opisuje zastosowanie TrackHubGenerator do tworzenia dostępnych online węzłów peptydów zmapowanych do genomów do badań proteogenomicznych na dużą skalę.
Protokół
1. Przygotowanie, pobieranie i konfiguracja
UWAGA: Przykłady ścieżek do plików i folderów są pokazane w formacie Windows dla łatwego dostępu dla standardowych użytkowników. PoGo i PoGoGUI są również dostępne dla systemów operacyjnych macOS i Linux.
- Pobierz PoGo i PoGoGUI z GitHub
- Otwórz przeglądarkę internetową i przejdź do PoGo na GitHub (http://github.com/cschlaffner/PoGo/). Wybierz pozycję Wydania i pobierz najnowszy skompresowany plik zip w wersji. Wyodrębnij skompresowany plik do folderu plików wykonywalnych (np. C:\PoGo\executables\).
- Przejdź w przeglądarce internetowej do PoGoGUI na GitHub (http://github.com/cschlaffner/PoGoGUI/). Wybierz pozycję Wydania i pobierz najnowszy plik jar wydania (np. "PoGoGUI-v1.0.2.jar"). Zapisz plik jar w folderze plików wykonywalnych.
- Pobierz adnotację genomu i przetłumaczone sekwencje kodujące białka
UWAGA: Pobierz adnotację genomu i przetłumaczone sekwencje kodujące białka dla obsługiwanych gatunków z GENCODE7 (www.gencodegenes.org) lub Ensembl20 (www.ensembl.org) w formacie General Transfer Format (GTF) oraz sekwencje białek w formacie FASTA.- W przeglądarce internetowej przejdź do www.gencodegenes.org i wybierz Dane | Człowiek | Bieżąca wersja. Pobierz kompleksową adnotację genu za pomocą linku GTF i rozpakuj skompresowany plik gz do folderu danych (np. C:\PoGo\Data\) za pomocą programu do rozpakowywania (np. 7-Zip).
- Pobierz sekwencje translacji transkryptu kodującego białko za pośrednictwem łącza FASTA i rozpakuj skompresowany plik gz do folderu danych wygenerowanego w poprzednim kroku.
- Możesz też przejść w przeglądarce internetowej do www.ensembl.org i wybrać Pobrane, a następnie Pobierz dane przez FTP. Znajdź obsługiwany gatunek (np. Człowiek). Pobierz najnowszy plik wersji do adnotacji transkrypcji, korzystając z linku GTF w kolumnie Zestaw genów. Wybierz plik ze strukturą nazw "species.release.gtf.gz" i rozpakuj plik skompresowany gz do folderu danych.
- Pobierz najnowszą wersję sekwencji translacji transkryptu kodującego białka, korzystając z linku FASTA w kolumnie Sekwencja białka (FASTA). Wybierz plik o strukturze nazw "species.release.pep.all.fa.gz" i rozpakuj plik skompresowany gz do folderu danych.
- Przygotuj pliki identyfikacyjne peptydów
UWAGA: PoGo obsługuje tylko format 4-kolumnowy zawierający identyfikator próbki, sekwencję peptydów, liczbę dopasowań widma peptydów (PSM) i wartość ilościową. Jednak PoGoGUI obsługuje standardowe formaty plików identyfikacyjnych mzIdentML, mzid i mzTab i konwertuje je na 4-kolumnowy format PoGo przy użyciu publicznie dostępnego frameworka ms-data-core-api21. Pliki w formacie mzIdentML, mzid lub mzTab można pobrać z PRIDE archive19. Alternatywnie dane mogą być dostarczane w formacie pliku rozdzielanego tabulatorami z rozszerzeniem .tsv lub .pogo. Format zawiera 4 kolumny z następującymi nagłówkami kolumn: identyfikator próbki (próbka), sekwencje peptydowe (peptyd), liczba dopasowań widma peptydów (PSM) i kwantyfikacja peptydów (Quant). Przykład pokazano na rysunku 2.- Pobierz przykładowy plik w formacie mzTab z badania proteomicznego na ludzkich jądrach z archiwum PRIDE19 (https://www.ebi.ac.uk/pride/archive/projects/PXD006465/files22).
- Zapisz i rozpakuj skompresowany plik gz do folderu danych utworzonego w kroku 1.2.1.
UWAGA: Alternatywnie, pobierz przykładowe dane dla ludzkiej fosfoproteomiki przeszukanej za pomocą MaxQuant z archiwum PRIDE (plik "Traktman_2013_MaxQuantOutput-full.zip" z https://www.ebi.ac.uk/pride/archive/projects/PXD005246/files23). - Zapisz i rozpakuj skompresowany plik zip w folderze danych, który został utworzony w kroku 1.2.1.
- Otwórz pusty arkusz kalkulacyjny i zaimportuj plik peptides.txt z folderu C:/PoGo/Data/Traktman_2013_MaxQuantOutput-full/combined/txt/ za pomocą opcji Dane | Z tekstu/CSV. W oknie otwierającym kliknij przycisk Edytuj.
- Usuń wszystkie kolumny z wyjątkiem "Sekwencja", "Eksperyment BR1", "Eksperyment BR2", "Eksperyment BR3", "Stosunek H/L znormalizowany BR1", "Stosunek H/L znormalizowany BR2" i "Stosunek H/L znormalizowany BR3".
- Zaznacz kolumny "Stosunek H/L znormalizowany BR1", "Stosunek H/L znormalizowany BR2" i "Stosunek H/L znormalizowany BR3" i kliknij Przekształć | Cofanie przestawiania kolumn. Zaznacz kolumny "Eksperyment BR1", "Eksperyment BR2" i "Eksperyment BR3" i powtórz operację cofania obrotu.
- Wybierz wynikową kolumnę "Atrybut" i podziel zawartość za pomocą Przekształć | Podziel kolumnę | Według ogranicznika. Wybierz spację jako ogranicznik z menu rozwijanego. Powtórz operację dla kolumny "Atrybut.1".
- Usuń wynikowe kolumny "Atrybut.1.1", "Atrybut.2", "Atrybut.3" i "Atrybut.1.1.1".
- Dodawanie kolumny przy użyciu przycisku Dodaj kolumnę | Opcja Kolumna niestandardowa. Dostosuj formułę kolumny niestandardowej, aby reprezentowała następujące elementy: "=[Atrybut.4]=[Atrybut.1.2]".
- Zastosuj filtr do wygenerowanej kolumny niestandardowej, aby odfiltrować wszystkie wiersze zawierające wartość "FALSE"; pozostaną tylko wiersze zawierające wartość "TRUE".
- Usuń kolumny "Atrybut.1.2" i "Niestandardowy" i zmień kolejność pozostałych kolumn na następującą: "Atrybut.4", "Sekwencja", "Wartość.1" i "Wartość".
- Zmień nazwy kolumn odpowiednio na "Eksperyment", "Peptyd", "PSM" i "Quant". Załaduj plik za pomocą narzędzia Home | Zamknij i załaduj.
- Zapisz plik jako plik rozdzielany tabulatorami za pomocą punktu menu Plik | Zapisz jako i wybierz typ "Tekst (rozdzielany tabulatorami) (*.txt)". Zmień nazwę na "peptides_pogo.txt" i zapisz ją w folderze C:/PoGo/Data.
2. Mapowanie peptydów z adnotacjami Modyfikacje potranslacyjne i wizualizacja, w tym kwantyfikacja
UWAGA: Wynikowy plik wyjściowy może być załadowany do dowolnej przeglądarki genomu obsługującej format Browser Extensible Data (BED). Wybrane przeglądarki to Integrative Genome Browser (IGV)24 (który jest używany w poniższym opisie), UCSC Genome Browser25 oraz Ensembl Genome Browser20. Ważne jest, aby pamiętać, że adnotacja GTF i wersje białka FASTA używane do mapowania PoGo są zgodne z wersją genomu w przeglądarce genomu. W przypadku ludzkich wydań Ensembl 57-75 i wersji GENCODE 3d-19 użyj GRCh37/hg19; w przypadku wersji Ensembl 76 lub nowszej i GENCODE 20 lub nowszej użyj GRCh38/hg38. W przypadku myszy Ensembl w wersji 74 lub nowszej i GENCODE M2 lub nowszej użyj GRCm38.
- Mapowanie peptydów za pomocą PoGoGUI (patrz rysunek 3).
- Przejdź do folderu plików wykonywalnych. Uruchom program, klikając dwukrotnie ikonę PoGoGUI-vX.X.X.jar.
UWAGA: Zostanie uruchomiony graficzny interfejs użytkownika, który umożliwi łatwy i wizualny wybór opcji. - Użyj przycisku Select obok "PoGo Executable". Następnie przejdź do folderu plików wykonywalnych do odpowiedniego podfolderu systemów operacyjnych (np. C:\PoGo\Executables\Windows\). Wybierz plik wykonywalny PoGo (np. PoGo.exe) i potwierdź jego wybór, klikając przycisk Otwórz.
- Wybierz referencyjny plik wejściowy dla sekwencji białek, klikając przycisk Wybierz. Przejdź do folderu z danymi i wybierz plik tłumaczenia FASTA. Potwierdź jego wybór, klikając przycisk Otwórz.
- Wybierz plik adnotacji transkrypcji za pomocą przycisku Wybierz. Przejdź do folderu danych i wybierz plik GTF adnotacji. Potwierdź wybór, klikając przycisk Otwórz.
- Dodaj plik identyfikacyjny peptydów — włączony jest wybór wielu plików — za pomocą przycisku Dodaj obok pozycji "Pliki peptydów". Wybierz plik w obsługiwanym formacie mzTab, mzIdentML lub mzid albo w formacie 4-kolumnowym rozdzielanym tabulatorami, pobranym i przygotowanym w kroku 1.3.
- Usuń zaznaczenie pól wyboru obok BED i GTF w wyborze formatów wyjściowych. Pozostaw zaznaczone tylko PTM BED i GCT.
- Wybierz odpowiedni gatunek dla danych z listy rozwijanej. Istotne jest, aby plik FASTA, plik GTF i wybór rozwijany dotyczyły tego samego gatunku.
- Rozpocznij mapowanie, klikając przycisk START.
UWAGA: W razie potrzeby PoGoGUI przekonwertuje plik wejściowy do formatu pogo, dostarczy pliki pogo w tym samym folderze dla wygody w przyszłości i rozpocznie proces mapowania. Konwersja pojedynczego pliku mzTab pobranego w kroku 1.3.1 potrwa od 10 do 20 minut przed rozpoczęciem mapowania.
- Przejdź do folderu plików wykonywalnych. Uruchom program, klikając dwukrotnie ikonę PoGoGUI-vX.X.X.jar.
- Wizualizacja w przeglądarce genomiki integracyjnej
UWAGA: Patrz rysunek 4.- Załaduj plik wyjściowy PoGo kończący się na "_ptm.bed" w IGV za pomocą Plik | Załaduj z pliku i wybierz plik.
UWAGA: Ze względu na rozmiar, niektóre pliki mogą wymagać wygenerowania indeksu, aby umożliwić szybkie ponowne załadowanie regionów genomu. IGV automatycznie poprosi użytkownika o wygenerowanie. Postępuj zgodnie ze wskazanymi instrukcjami. - Powtórz krok ładowania pliku kończącego się na "_noptm.bed". Ten plik zawiera wszystkie peptydy znalezione bez żadnych modyfikacji.
- Zwróć uwagę, że każdy załadowany plik będzie wyświetlany jako osobne ścieżki z nazwą pliku identyfikującą ścieżkę. Zmień kolejność ścieżek, przeciągając je i upuszczając w żądane miejsce na liście.
- Zwróć uwagę, że każda ścieżka jest początkowo wyświetlana w sposób zwinięty. Aby je rozwinąć, kliknij prawym przyciskiem myszy nazwę ścieżki i wybierz opcję Rozwinięte, aby uzyskać pełny widok peptydów, w tym sekwencji, lub zgniecione, aby uzyskać widok stosowy.
- Powtórz krok ładowania dla pliku kończącego się na ".gct". Plik ten zawiera ocenę ilościową peptydów dla próbki z adnotacjami.
- W przeciwieństwie do plików załadowanych powyżej, każda próbka z adnotacjami zostanie załadowana jako osobna ścieżka. Reorganizacja próbek za pomocą operacji przeciągnij i upuść.
- Poruszaj się po genomie, wybierając chromosom z menu rozwijanego, wpisz współrzędne genomowe, wyszukaj symbol genu lub kliknij i przytrzymaj, aby wybrać sekcję chromosomu do powiększenia.
- Załaduj plik wyjściowy PoGo kończący się na "_ptm.bed" w IGV za pomocą Plik | Załaduj z pliku i wybierz plik.
3. Mapowanie peptydów zidentyfikowanych za pomocą niestandardowej bazy danych wariantów do genomu referencyjnego
UWAGA: Mapowanie PoGo może być przeprowadzone za pomocą graficznego interfejsu użytkownika (GUI) lub za pomocą interfejsu wiersza poleceń. Są wymienne. W tej części protokołu interfejs wiersza poleceń służy do podkreślenia wymienności. Druga część tej sekcji protokołu wymaga narzędzia programowego R26. Upewnij się, że pakiet jest zainstalowany.
- Mapuj peptydy referencyjne do genomu referencyjnego.
- Otwórz wiersz polecenia (cmd) i przejdź do folderu plików wykonywalnych PoGo (np. C:\PoGo\Executables\).
- Wpisz poniższe polecenie:
PoGo.exe -gtf \ŚCIEŻKA\DO\GTF -fasta \ŚCIEŻKA\DO\FASTA -in \ŚCIEŻKA\DO\IN -format BED -gatunek MÓJGATUNEK- Zastąp \PATH\TO\GTF, \PATH\TO\FASTA i \PATH\TO\IN odpowiednio ścieżkami do adnotacji GTF, sekwencji białka FASTA i pliku identyfikacji peptydów (w formacie 4-kolumnowym z plikiem kończącym się ".tsv" lub ".pogo"). Zastąp również MYSPECIES gatunkiem zgodnym z danymi (np. Człowiek).
- Potwierdź wykonanie, naciskając "Enter". Poczekaj, aż wykonanie zostanie zakończone, zanim przejdziesz dalej.
UWAGA: Może to potrwać kilka minut. Plik wynikowy będzie przechowywany w tym samym folderze, co plik wejściowy peptydu i będzie traktowany jako \PATH\TO\OUT.pogo.bed w dalszej części.
- Wyodrębnij tylko peptydy wariantowe z pliku wejściowego.
- Otwórz R i załaduj plik wejściowy \PATH\TO\IN za pomocą następującego polecenia:
inputdata <- read.table("ŚCIEŻKA/DO/W",header=PRAWDA,sep="\t") - Załaduj już zmapowane peptydy za pomocą polecenia:
mappedpeptides <- read.table("ŚCIEŻKA/DO/WYJŚCIA.pogo.bed",sep="\t",header=FALSE) - Usuń peptydy, które zostały już zmapowane z danych wejściowych:
peptydy, notmapowane <- dane wejściowe[!( inputdata$Peptide %in% mappedpeptides$V4),] - Wydrukuj niezmapowane peptydy do nowego pliku wejściowego:
write.table(peptidesnotmapped, "PATH\TO\IN.notmapped.pogo", header=FALSE, sep="\t", col.names=TRUE,row.names=FALSE,quote=FALSE)
- Otwórz R i załaduj plik wejściowy \PATH\TO\IN za pomocą następującego polecenia:
- Zmapuj pozostałe peptydy do genomu referencyjnego, co pozwala na niezgodności.
- Podobnie jak w kroku 3.1, otwórz wiersz polecenia i przejdź do folderu plików wykonywalnych PoGo.
- Wpisz poniższe polecenie, zezwalając na niezgodność 1 aminokwasu i zastąp \PATH\TO\GTF, \PATH\TO\FASTA i \PATH\TO\IN.notmapped.pogo ścieżkami do adnotacji GTF, sekwencji białka FASTA i pliku identyfikacji peptydu utworzonego w kroku 3.2. Zastąp również MYSPECIES gatunkiem zgodnym z danymi (np. Człowiek).
- PoGo.exe -gtf \ŚCIEŻKA\DO\GTF -fasta \ŚCIEŻKA\DO\FASTA -in \ŚCIEŻKA\DO\IN -format BED -gatunek MÓJGATUNEK -mm 1
- Potwierdź wykonanie polecenia, naciskając "Enter". Poczekaj, aż wykonanie zostanie zakończone, zanim przejdziesz dalej.
UWAGA: Może to potrwać kilka minut. Wynikowy plik będzie przechowywany w tym samym folderze, co plik wejściowy peptydu i będzie traktowany jako \PATH\TO\OUT.pogo_1MM.bed w dalszej części.
- Wizualizuj peptydy zmapowane bez i z niezgodnością w IGV, jak opisano w kroku 2.2.
4. Mapowanie przy użyciu wielu plików i generowanie węzłów ścieżek dla dużych zbiorów danych
- Mapowanie peptydów z wielu plików za pomocą PoGoGUI
- Przejdź do folderu plików wykonywalnych i uruchom graficzny interfejs użytkownika, uruchamiając PoGoGUI-vX.X.X.jar.
- Wybierz plik wykonywalny PoGo dla używanego systemu operacyjnego (tutaj Linux), a także plik FASTA z referencyjnymi sekwencjami wejściowymi białek i plik GTF z adnotacją, zgodnie z opisem w krokach protokołu 2.1.2 - 2.1.4.
- Dodaj pliki identyfikacyjne peptydów za pomocą przycisku Dodaj obok "Pliki peptydów"; włączony jest wybór wielu plików, a także przeciągnij i upuść do pustego pola pod "Plikami peptydowymi".
- Odznacz pola wyboru obok PTM BED, GTF i GCT w sekcji formatów wyjściowych i pozostaw zaznaczone tylko BED.
- Wybierz opcję Scal wiele plików wejściowych w jedno wyjście.
UWAGA: Spowoduje to powstanie pojedynczego pliku wyjściowego łączącego wszystkie peptydy plików wejściowych. Pozostawienie tej opcji niezaznaczonej spowoduje sekwencyjne wykonanie programu dla każdego pliku wejściowego z osobna. - Wybierz odpowiednie gatunki dla danych z listy rozwijanej zgodnej z plikami FASTA i GTF.
- Rozpocznij mapowanie, klikając przycisk START. W razie potrzeby program przekonwertuje pliki wejściowe do formatu pogo. Może to zająć trochę czasu. W międzyczasie pobierz wymagane narzędzia i skrypty do generowania koncentratora ścieżek.
- Przygotowanie do generowania węzła torów
- Otwórz przeglądarkę internetową, przejdź do https://github.com/cschlaffner/TrackHubGenerator i pobierz plik "TrackHubGenerator.pl". Zapisz plik w folderze plików wykonywalnych.
- W przeglądarce internetowej przejdź do www.hgdownload.soe.ucsc.edu/admin/exe/ i wybierz folder dla używanego systemu operacyjnego (tutaj Linux). Pobierz narzędzie bedToBigBed i skrypt fetchChromSizes do folderu plików wykonywalnych27.
- Generowanie węzła ścieżek z mapowanych peptydów
UWAGA: Po zakończeniu mapowania peptydów przez PoGoGUI, może zostać automatycznie wygenerowany hub ścieżek dla wszystkich wynikowych plików w formacie BED przechowywanych w tym samym folderze.- Otwórz okno terminala i wpisz następujące polecenie:
Perl TrackHubGenerator.pl ŚCIEŻKA/DO/NAZWA ZESTAW FBED UCSC E-MAIL- Zastąp PATH/TO/NAME ścieżką pliku i nazwą węzła ścieżki (np. ~/PoGo/Data/Mytrackhub), ASSEMBLY zestawem genomu, na którym oparta jest adnotacja (np. hg38 dla człowieka), FBED ścieżką do folderu zawierającego pliki BED, na których będzie oparty węzeł ścieżki (np. ~/PoGo/Data/), UCSC folderem, w którym przechowywane są narzędzia pobrane z UCSC (np., ~/PoGo/Executables/) i EMAIL z adresem e-mail osoby odpowiedzialnej za hub ścieżek.
- Potwierdź wykonanie, naciskając "Enter"; wykonanie zajmie tylko krótki czas.
- Przenieś wygenerowany hub ścieżek (tj. utworzony folder ~/PoGo/Data/Mytrackhub/) wraz z całą jego zawartością na dostępny w sieci serwer FTP.
UWAGA: Preferowany jest serwer FTP z powiązanym serwerem WWW umożliwiającym dostęp do koncentratora ścieżek za pośrednictwem protokołów ftp i http. Repozytoria github (github.com) i figshare (figshare.com) obsługują ten typ dostępu i mogą być używane zamiast serwera FTP.
- Otwórz okno terminala i wpisz następujące polecenie:
- Wizualizacja węzła ścieżek w przeglądarce genomu UCSC
- W przeglądarce internetowej przejdź do https://genome.ucsc.edu/ i wybierz MyData | Węzły ścieżek. Kliknij zakładkę Moje centra.
- Skopiuj adres URL do centrum ścieżek w polu tekstowym.
UWAGA: Adres URL składa się z adresu serwera, lokalizacji i nazwy koncentratora śledzenia oraz pliku hub.txt (np. http://ngs.sanger.ac.uk/production/proteogenomics/WTSI_proteomics_PandeyKusterCutler_tissues_hi/hub.txt). - Załaduj węzeł ścieżek, klikając przycisk Dodaj centrum.
UWAGA: Hub zostanie załadowany i pojawi się krótki komunikat zawierający szczegółowe informacje o węźle ścieżek, takie jak jego nazwa, dane kontaktowe osoby odpowiedzialnej za węzeł ścieżek oraz używany zestaw genomu. Witryna powróci na stronę główną. - Wybierz GenomeBrowser, aby przejść do widoku przeglądarki.
UWAGA: Niestandardowy hub ścieżek zostanie wyświetlony na górze listy. Jeśli wiele plików BED zbudowało podstawę dla koncentratora ścieżek, każdy z plików będzie reprezentowany jako oddzielna ścieżka w centrum.
Wyniki
Na rysunku 5 przedstawiono schematycznie, na którym etapie standardowego procesu proteomicznego stosowane jest narzędzie PoGo18, a także dostępne opcje późniejszej wizualizacji. Proteomika typu shotgun (i.e. proteolityczne trawienie białek, a następnie chromatografia cieczowa sprzężona z tandemową spektrometrią mas) stanowi jeden z etapów wstępnych mapowania proteogenomicznego. Uzyskane tandemowe widma mas są powszechnie porównywane z widmami teoretycznymi pochodzącymi z baz danych sekwencji białkowych. Badania proteogenomiczne wprowadzają do bazy danych sekwencje translacyjne nowych transkryptów o potencjale kodującym oraz niesynonimiczne warianty pojedynczego nukleotydu (SNVs), co utrudnia ich łatwe powiązanie z genomem referencyjnym8. Graficzny interfejs użytkownika PoGo (PoGoGUI) obsługuje formaty plików służące do ustandaryzowanego raportowania identyfikacji peptydów z eksperymentów spektrometrii mas i konwertuje je na uproszczony, 4-kolumnowy format pogo. PoGoGUI stanowi nakładkę na narzędzie wiersza poleceń PoGo, umożliwiając tym samym mapowanie peptydów na współrzędne genomowe z wykorzystaniem referencyjnej adnotacji genów kodujących białka, zazwyczaj dostarczanej w formacie GTF, oraz przetłumaczonych sekwencji transkryptów w formacie FASTA. PoGo generuje różne formaty wyjściowe, aby umożliwić wizualizację różnych aspektów peptydów zidentyfikowanych za pomocą spektrometrii mas, w tym modyfikacji potranslacyjnych oraz kwantyfikacji na poziomie peptydów. Pliki wyjściowe w formacie BED mogą być dalej konwertowane i łączone w dostępnych online katalogach zwanych track hubs. Pojedyncze pliki wyjściowe, jak i track hubs, mogą być następnie wizualizowane w przeglądarkach takich jak UCSC Genome Browser25, Ensembl Genome Browser20, IGV24 oraz Biodalliance28 (patrz rysunek 5, dół).
Zastosowaliśmy PoGo do reanalizy roboczych map proteomu ludzkiego, przefiltrowanych pod kątem wysokiej istotności, zgodnie z opisem Wright et al.7, a następnie porównaliśmy wyniki z dwoma innymi narzędziami do mapowania proteogenomicznego, mianowicie iPiG14 oraz PGx10. Zbiór danych obejmował 233 055 unikalnych peptydów z 59 tkanek dorosłych i płodowych, co dało łącznie ponad 3 miliony sekwencji. PoGo okazało się wydajniejsze od tych narzędzi zarówno pod względem czasu wykonania (odpowiednio 6,9x i 96,4x szybciej), jak i zużycia pamięci (odpowiednio o 20% i 60% mniej), co przedstawiono na Rysunku 618. Przykład pomyślnie zmapowanego peptydy przedstawiono na Rysunku 7.
Choć PoGo znacznie przewyższył inne narzędzia pod względem szybkości i zużycia pamięci, pozwala on również na mapowanie modyfikacji potranslacyjnych oraz informacji ilościowych powiązanych z peptydami na genom. Rycina 8A schematycznie przedstawia wizualizację formatu BED w przeglądarce genomu dla peptydów mapujących do jednego eksonu oraz w obrębie miejsc splicingowych. PoGo wykorzystuje opcję kolorowania, aby ułatwić wizualną ocenę unikalności mapowania peptydów w obrębie genomu. Mapowania koloru czerwonego wskazują unikalność dla pojedynczego transkryptu, natomiast kolor czarny wyróżnia mapowanie do pojedynczego genu, przy czym peptyd ten jest wspólny dla różnych transkryptów. Mapowania szare pokazują peptyd wspólny dla wielu genów. Są one, na przykład, mniej wiarygodne przy kwantyfikacji genu lub niewiarygodne do określenia ekspresji genu. Opcja PTM BED w programie PoGo redefiniuje kod kolorystyczny, aby uwzględnić różne rodzaje modyfikacji potranslacyjnych, co pokazano na Rycynie 8B. Dodatkowo modyfikacje potranslacyjne są oznaczone grubymi blokami (patrz Rycina 8B). Pojedyncza modyfikacja potranslacyjna danego typu jest wyróżniona grubym blokiem w pozycji zmodyfikowanego reszty aminokwasowej, natomiast wiele modyfikacji potranslacyjnych tego samego typu jest objętych grubym blokiem od pierwszej do ostatniej zmodyfikowanej reszty aminokwasowej.
Zastosowaliśmy narzędzia PoGo, a następnie TrackHubGenerator do zbioru danych obejmującego 50 linii komórkowych raka jelita grubego, w tym pełny proteom i fosfoproteom29. Choć hub ścieżek załadowany w przeglądarce UCSC Genome Browser pokazuje peptydy zmapowane do genomu i podkreśla unikalność mapowań oraz miejsc fosforylacji (patrz Rysunek 9), dodatkowe dane zostały udostępnione w folderze uzupełniającym. Pliki GCT umożliwiają następnie wizualizację ilościową peptydów i fosfopeptydów w kontekście genomicznym. Jednakże pliki GCT nie zapewniają łatwej wizualizacji peptydów obejmujących miejsca splicingowe (patrz Rysunek 10 góra). Peptydy obejmujące miejsca splicingowe są dzielone na poszczególne części mapujące do egzonów. Choć identyfikacja peptydów splicingowych jest możliwa dzięki identycznym wartościom ilościowym mapowań egzonowych, załadowanie plików mapowania opartych na sekwencjach, takich jak BED lub GTF, które łączą egzony cienką linią obejmującą intron, ułatwia interpretację (patrz Rysunek 10 dół).
Aby podkreślić użyteczność mapowania z uwzględnieniem wariantów, zastosowaliśmy PoGo w dwóch konfiguracjach do zbioru danych proteomu jąder człowieka, przeszukanego w bazie neXtProt w celu poszukiwania brakujących białek przy użyciu strategii wieloenzymatycznej22. Baza neXtProt zawiera, oprócz referencyjnych sekwencji białek, ponad 5 milionów pojedynczych wariantów aminokwasowych30. Mapowanie peptydów zidentyfikowanych z pojedynczym wariantem aminokwasowym nie jest wspierane przez inne narzędzia mapujące. Zidentyfikowano łącznie 177 012 unikalnych peptydów. Z tej liczby 99,8% (176 694) peptydów zostało początkowo pomyślnie zmapowanych bez dopuszczania niedopasowań. Usunięcie ich z listy zidentyfikowanych peptydów pozwoliło wyodrębnić 0,2% (318) peptydów, które następnie zmapowano, dopuszczając jedną substytucję aminokwasową. Przyniosło to 3 446 mapowań dla 162 peptydów, które nie zostałyby zmapowane do genomu referencyjnego za pomocą żadnego innego dostępnego narzędzia. Choć średnia liczba mapowań z uwzględnieniem niedopasowania jest wysoka, 62 peptydy zmapowano tylko do jednego locus, co wskazuje na rzeczywiste sekwencje wariantowe. Przykład peptydu zmapowanego z pojedynczą substytucją aminokwasową, wraz z jego sekwencją i przetłumaczoną sekwencją genomiczną, przedstawiono na Rysunku 11.

Rycina 1. Wizualne porównanie różnych narzędzi do mapowania peptydów na genom. Porównanie przedstawiono w odniesieniu do różnych aspektów. Aspekty te obejmują referencję mapowania, poziom integracji z ramami systemowymi oraz wsparcie dla przeglądarek online i offline. Dodatkowo, oddzielnie wyróżniono nowe aspekty proteogenomiki i ich wspierane funkcje. PoGo, w porównaniu z innymi narzędziami, nie posiada jedynie możliwości bezpośredniego mapowania na sekwencję genomu. Wspiera jednak wszystkie nowe funkcje, których większość pozostałych narzędzi nie obsługuje. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rysunek 2. Przykład pliku wejściowego do mapowania peptydów. PoGo przyjmuje dane wejściowe w formacie rozdzielanym tabulatorami z 4 kolumnami. Nagłówki kolumn w pierwszej linii to „Experiment”, „Peptide”, „PSMs” oraz „Quant”, które wskazują odpowiednio w kolejnych liniach identyfikator eksperymentu lub próbki, sekwencję peptydu, liczbę dopasowań widma do peptydów (PSM) oraz wartość ilościową dla peptydu. Obsługiwane rozszerzenia plików to *.txt, *.tsv oraz *.pogo. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 3. Interfejs PoGoGUI z zaznaczonymi krokami wyboru plików i opcjami parametrów. Rycina przedstawia kolejne kroki wyboru i przesyłania wszystkich wymaganych plików oraz wybór opcji mapowania peptydów z modyfikacjami potranslacyjnymi na referencyjny genom ludzki. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rysunek 4. Zrzut ekranu procedury przesyłania danych do Integrative Genomics Viewer (IGV). Rysunek przedstawia kroki przesyłania plików wyjściowych z PoGo do przeglądarki IGV. Ponadto pokazano opcję rozwinięcia ścieżki zmapowanych peptydów w celu wyróżnienia mapowania i sekwencji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rysunek 5. Uproszczony schemat etapów od LC-MS/MS do wizualizacji w przeglądarkach genomu. Mapowanie PoGo następuje po identyfikacji peptydów z tandemowych widm mas. Aby przeprowadzić mapowanie do genomu, PoGo wykorzystuje adnotacje referencyjne dostarczone w formie adnotacji genomowych (GTF) oraz sekwencji translacji transkryptów (FASTA). Generowane są różne formaty wyjściowe, które mogą być oddzielnie ładowane do przeglądarek genomu. Dodatkowo pliki w formacie BED mogą być łączone w huby ścieżek (track hubs) umożliwiające wizualizację wielkoskalowych zbiorów danych. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 6. Porównanie wydajności PoGo z PGx i iPiG. PoGo przewyższa pozostałe narzędzia w testach wydajnościowych. Przy mapowaniu 233 055 unikalnych peptydów w 59 tkankach dorosłych i płodowych, co dało ponad 3 miliony sekwencji, PoGo był odpowiednio 6,9x i 96,4x szybszy niż PGx i iPiG. Co więcej, PoGo wymagał odpowiednio o 20% i 60% mniej pamięci w porównaniu do PGx i iPiG. Podczas gdy PoGo i PGx zakończyły pracę pomyślnie, w przypadku iPiG wystąpił błąd pamięci przy 16 GB. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rycina 7. Przykład widoku z przeglądarki genomu UCSC dla zmapowanych peptydów. Rycina przedstawia peptydy zmapowane do genu mTOR. Podczas gdy ścieżka zbiorcza pokazuje peptydy obejmujące miejsca splicingowe oraz zmapowane tylko do jednego eksonu wraz z powiązanymi sekwencjami, ścieżki specyficzne dla tkanek podkreślają mapowanie w formacie skondensowanym. Aby wyświetlić większą wersję tej ryciny, kliknij tutaj.

Rycina 8. Schemat wizualizacji mapowania i kodowania kolorami. (A) W standardowym pliku wyjściowym BED peptydy mapujące do jednego eksonu są przedstawione jako pojedyncze bloki (lewo), natomiast peptydy mapujące na wiele eksonów zaznaczają części pokrywające eksony w formie bloków (prawo). Introny są przedstawione jako cienkie linie łączące. Program PoGo koduje kolorami unikalność mapowania lub peptydów do genów i transkryptów, stosując system trzystopniowy. (B) Oprócz struktury blokowej formatu BED, wyjście PTM BED zaznacza pozycje modyfikacji potranslacyjnych w formie grubych bloków. Obecność pojedynczej modyfikacji PTM danego typu zaznacza zmodyfikowany resztę aminokwasu grubym blokiem, natomiast wiele miejsc tej samej modyfikacji PTM jest łączonych w długie bloki rozciągające się od pierwszego do ostatniego miejsca modyfikacji. Mapowania peptydów są dodatkowo podzielone według typu PTM i kodowane kolorami na podstawie modyfikacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.

Rysunek 9. Widok centrum ścieżek (track hub) w przeglądarce genomu UCSC dla danych proteomu i fosfoproteomu raka jelita grubego. Centrum ścieżek obejmuje dane całego proteomu oraz fosfoproteomu. Podczas gdy kolor czerwony w ścieżkach proteomu i fosfoproteomu wskazuje na unikalność mapowania do pojedynczego transkryptu SFN, ścieżki kończące się na _ptm pokazują miejsca fosforylacji w obrębie peptydów. Tutaj kolor czerwony oznacza rodzaj modyfikacji jako fosforylację. Zidentyfikowano tylko dwa peptydy, z których każdy wykazuje pojedynczą fosforylację (grube bloki). Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rycina 10. Widok fosfopeptydów raka jelita grubego i powiązanej kwantyfikacji w IGV. Na rycinie przedstawiono podzbiór 50 linii komórkowych nowotworowych. Widoczne są ponadto cztery kolumny bloków w różnych odcieniach jasnej czerwieni. Kolor wskazuje względną obfitość od niskiej (biały) do wysokiej (czerwony). Choć cztery kolumny mogą początkowo sugerować obecność 4 peptydów, z powiązanego pliku wyjściowego GTF opartego na sekwencji wynika jasno, że w rzeczywistości są to dwa peptydy, z których każdy obejmuje miejsce złączenia splicingowego. Aby wyświetlić większą wersję tej ryciny, należy kliknąć tutaj.
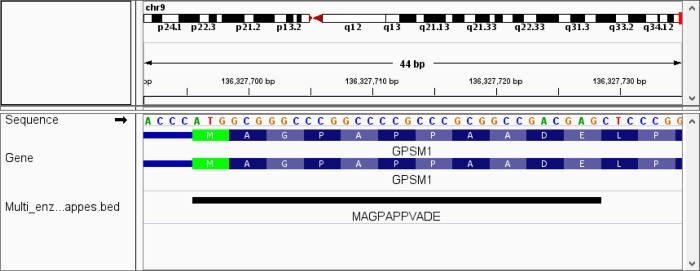
Rycina 11. Widok peptydy z wariantem aminokwasowym w IGV. Rycina przedstawia peptyd z pojedynczym wariantem aminokwasowym zmapowanym do genomu referencyjnego na początku translacji genu GPSM1. Wariant znajduje się przy 8. reszcie aminokwasowej i skutkuje substytucją alaniny na walinę (A→V). Sekwencje translacyjne adnotowanych transkrypcji (kolor niebieski) podkreślają wariant w porównaniu z sekwencją peptydu. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dyskusja
Protokół ten opisuje, w jaki sposób narzędzie programowe PoGo i jego graficzny interfejs użytkownika PoGoGUI umożliwiają szybkie mapowanie peptydów na współrzędne genomu. Narzędzie oferuje unikalne funkcje, takie jak ilościowa, potranslacyjna modyfikacja i mapowanie genomów z obsługą wariantów za pomocą adnotacji referencyjnych. W artykule przedstawiono metodę na dużej skali badaniu proteogenomicznym i podkreślono jej szybkość i wydajność pamięci w porównaniu z innymi dostępnymi narzędziami18. W połączeniu z narzędziem TrackHubGenerator, które tworzy dostępne online centra danych genomicznych i powiązanych z genomem, PoGo, dzięki graficznemu interfejsowi użytkownika, umożliwia badania proteogenomiczne na dużą skalę w celu szybkiej wizualizacji danych w kontekście genomicznym. Ponadto demonstrujemy unikalne cechy PoGo za pomocą zestawów danych przeszukiwanych w bazach danych wariantów i fosfoproteomiki ilościowej22,29.
Pojedyncze pliki, takie jak plik GCT, zapewniają cenną wizualizację i powiązania między cechami peptydów a loci genomu. Należy jednak zauważyć, że interpretacja oparta wyłącznie na nich może być trudna lub myląca ze względu na ich ograniczenie do pojedynczych aspektów proteogenomiki, takich jak unikalność, modyfikacje potranslacyjne i wartości ilościowe. Dlatego ważne jest, aby starannie wybrać, które pliki wyjściowe, opcje i kombinacje są odpowiednie dla danego pytania proteogenomicznego i zmodyfikować kombinacje. Na przykład informacje o unikalności mapowania do określonego locus genomowego mogą mieć wielką wartość dla adnotacji cechy genomowej7, podczas gdy kwantyfikacja w różnych próbkach może być bardziej odpowiednia w przypadku badań wiążących cechy genomu ze zmianami liczebności białek29. Dane wyjściowe powinny być generowane przez PoGo dla każdego ustawienia. W przypadku, gdy nie są generowane żadne dane wyjściowe lub w folderze wyjściowym wyświetlane są puste pliki, zaleca się sprawdzenie plików wejściowych pod kątem żądanej zawartości i wymaganego formatu pliku. W przypadkach, gdy format lub zawartość pliku nie jest zgodna z oczekiwaniami PoGo (np. plik FASTA rzekomo zawierający sekwencje translacji transkrypcji zawiera sekwencje nukleotydowe transkrypcji), komunikaty o błędach poproszą użytkownika o sprawdzenie plików wejściowych.
Ograniczenia protokołu i narzędzia opierają się głównie na ponownym wykorzystaniu formatów plików powszechnie stosowanych w genomice. Zmianie przeznaczenia formatów plików stosowanych w genomice do zastosowań proteogenomicznych towarzyszą określone ograniczenia. Wynika to z różnych zestawów wymagań dotyczących skoncentrowanej na genomie wizualizacji danych genomicznych i proteogenomicznych, takich jak potrzeba wizualizacji modyfikacji potranslacyjnych na podstawie danych proteomicznych. Jest to ograniczone w formatach plików genomiki przez użycie pojedynczej funkcji. Opracowano wiele podejść i narzędzi dla proteomiki, aby pewnie lokalizować modyfikacje potranslacyjne w sekwencjach peptydowych 31,32,33,34. Jednak wizualizacja wielu modyfikacji w unikalny i dostrzegalny sposób na genomie jest utrudniona przez strukturę formatów plików genomowych. W związku z tym jednoblokowa wizualizacja wielu PTM tego samego typu nie stanowi żadnej niejednoznaczności miejsc modyfikacji, ale jest konsekwencją odmiennego wymagania społeczności genomicznej, aby wizualizować tylko pojedyncze cechy na raz. Niemniej jednak PoGo ma tę zaletę, że mapuje modyfikacje potranslacyjne na współrzędne genomowe, aby umożliwić badania skoncentrowane na wpływie cech genomicznych, takich jak warianty pojedynczych nukleotydów, na modyfikacje potranslacyjne. Korzystając z PoGo, mapowanie wariantów zwiększa liczbę całkowitych mapowań. Jednak unikalne kodowanie kolorami mapowanych peptydów odróżnia wiarygodne mapowania od niewiarygodnych. Mapowaniu wariantów peptydów zidentyfikowanych na podstawie znanych wariantów pojedynczego nukleotydu może towarzyszyć wizualizacja zmapowanych peptydów wraz z wariantami w formacie VCF. W ten sposób kod kolorystyczny wskazujący na niewiarygodne mapowanie wariantu peptydu jest unieważniany przez obecność znanego wariantu nukleotydu.
Kluczowym krokiem korzystania z PoGo jest użycie odpowiednich plików i formatów. Głównym kryterium jest wykorzystanie translowanych sekwencji transkryptów jako sekwencji białek towarzyszących adnotacji w formacie GTF. Kolejnym krytycznym elementem przy rozważaniu użycia PoGo do mapowania peptydów z niezgodnością aminokwasów jest pamięć. Chociaż jest to wysoce wydajne pod względem pamięci w przypadku standardowej aplikacji, znacznie i wykładniczo rosnąca liczba możliwych mapowań z jednym lub dwoma niezgodnościami prowadzi do podobnie wykładniczego wzrostu użycia pamięci18. Proponujemy mapowanie etapowe, jak opisano w niniejszym protokole, aby najpierw zmapować peptydy bez niezgodności i usunąć je ze zbioru. Kolejne, wcześniej niezmapowane peptydy mogą być następnie mapowane przy użyciu jednego niedopasowania, a procedura może być powtórzona z dwoma niedopasowaniami dla peptydów pozostających niezmapowanych.
Ponieważ przepustowość spektrometrii mas znacznie wzrosła, a badania łączące dane genomiczne i proteomiczne stają się w ostatnich latach coraz częstsze, coraz bardziej niezbędne stają się narzędzia umożliwiające łączenie tego typu danych w tym samym układzie współrzędnych. Zaprezentowane tutaj narzędzie pomoże w połączeniu danych genomicznych i proteomicznych w celu lepszego zrozumienia badań integracyjnych w małych i dużych zbiorach danych poprzez mapowanie peptydów na adnotację referencyjną. Zachęcające jest to, że PoGo zostało zastosowane do mapowania peptydów do kandydatów na geny dostarczonych w tym samym formacie, co adnotacja referencyjna, aby wesprzeć wysiłki związane z adnotacją nowych genów ulegających ekspresji w ludzkich jądrach35. Przedstawione tutaj podejście jest niezależne od baz danych wykorzystywanych do identyfikacji peptydów. Protokół może pomóc w identyfikacji i wizualizacji nowatorskich produktów translacyjnych przy użyciu dostosowanych plików wejściowych z sekwencji translacji i powiązanych plików GTF z eksperymentów sekwencyjnych RNA.
Wprowadzono kilka podejść i narzędzi z szerokim zakresem specjalnych scenariuszy zastosowań do mapowania peptydów do współrzędnych genomowych, począwszy od mapowania peptydów bezpośrednio do sekwencji genomu, a skończywszy na mapowaniu kierowanym sekwencjonowaniem RNA. 10,11,12,13,14,15,16,17. Mogą one jednak spowodować niepowodzenie w prawidłowym mapowaniu peptydów, gdy obecne są modyfikacje potranslacyjne, a błędy w podstawowym mapowaniu odczytów sekwencjonowania RNA mogą być propagowane do poziomu peptydów. PoGo zostało opracowane specjalnie w celu pokonania tych przeszkód i poradzenia sobie z szybkim wzrostem ilościowych zestawów danych proteomicznych o wysokiej rozdzielczości w celu integracji z ortogonalnymi platformami genomicznymi. Opisane tutaj narzędzie można zintegrować z przepływami pracy o wysokiej przepustowości. Dzięki interfejsowi graficznemu PoGoGUI narzędzie jest proste w obsłudze i nie wymaga specjalistycznego szkolenia bioinformatycznego.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca została sfinansowana przez Wellcome Trust (WT098051) i grant NIH (U41HG007234) na projekt GENCODE.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| PoGo (oprogramowanie) | NA | NA | https://github.com/cschlaffner/PoGo |
| PoGoGUI (oprogramowanie) | NA | NA | https://github.com/cschlaffner/PoGoGUI |
| TrackHubGenerator (oprogramowanie) | NA | NA | https://github.com/cschlaffner/TrackHubGenerator |
| Integrative Genomics Viewer (oprogramowanie) | NA | NA | http://software.broadinstitute.org/software/igv/ |
| UCSC genome browser (strona internetowa) | NA | NA | https://genome.ucsc.edu/ |
| GENCODE (strona internetowa) | NA | NA | http://gencodegenes.org |
| Ensembl (strona internetowa) | NA | NA | |
| http://ensembl.org bedToBigBed (oprogramowanie) | NA | NA | http://hgdownload.soe.ucsc.edu/admin/exe/ |
| fetchChromSizes.sh (oprogramowanie) | NA | NA | http://hgdownload.soe.ucsc.edu/admin/exe/ |
Bibliografia
- Aebersold, R., Mann, M. Mass-spectrometric exploration of proteome structure and function. Nature. 537 (7620), 347-355 (2016).
- Mertins, P., et al. Proteogenomics connects somatic mutations to signalling in breast cancer. Nature. 534 (7605), 55-62 (2016).
- Zhang, H., et al. Integrated proteogenomic characterization of human high-grade serous ovarian cancer. Cell. 166 (3), 755-765 (2016).
- Jaffe, J. D., Berg, H. C., Church, G. M. Proteogenomic mapping as a complementary method to perform genome annotation. Proteomics. 4 (1), 59-77 (2004).
- Wilhelm, M., et al. Mass-spectrometry-based draft of the human proteome. Nature. 509 (7502), 582-587 (2014).
- Kim, M. S., et al. A draft map of the human proteome. Nature. 509 (7502), 575-581 (2014).
- Wright, J. C., et al. Improving GENCODE reference gene annotation using a high-stringency proteogenomics workflow. Nature Communications. 7, 11778(2016).
- Nesvizhskii, A. I. Proteogenomics: concepts, applications and computational strategies. Nature Methods. 11 (11), 1114-1125 (2014).
- Armengaud, J., et al. Non-model organisms, a species endangered by proteogenomics. Journal of Proteomics. 105, 5-18 (2014).
- Askenazi, M., Ruggles, K. V., Fenyo, D. PGx: putting peptides to BED. Journal of Proteome Research. 15 (3), 795-799 (2016).
- Choi, S., Kim, H., Paek, E. ACTG: novel peptide mapping onto gene models. Bioinformatics. 33 (8), 1218-1220 (2017).
- Ghali, F., et al. ProteoAnnotator-open source proteogenomics annotation software supporting PSI standards. Proteomics. 14 (23-24), 2731-2741 (2014).
- Has, C., Lashin, S. A., Kochetov, A. V., Allmer, J. PGMiner reloaded, fully automated proteogenomic annotation tool linking genomes to proteomes. Journal of Integrative Bioinformatics. 13 (4), 293(2016).
- Kuhring, M., Renard, B. Y. iPiG: integrating peptide spectrum matches into genome browser visualizations. PLoS One. 7 (12), e50246(2012).
- Pang, C. N., et al. Tools to covisualize and coanalyze proteomic data with genomes and transcriptomes: validation of genes and alternative mRNA splicing. Journal of Proteome Research. 13 (1), 84-98 (2014).
- Sanders, W. S., et al. The proteogenomic mapping tool. BMC Bioinformatics. 12 (115), (2011).
- Wang, X., et al. ProBAMsuite, a bioinformatics framework for genome-based representation and analysis of proteomics data. Molecular & Cellular Proteomics. 15 (3), 1164-1175 (2016).
- Schlaffner, C. N., Pirklbauer, G. J., Bender, A., Choudhary, J. S. Fast, quantitative and variant enabled mapping of peptides to genomes. Cell Systems. 5 (2), 152-156 (2017).
- Vizcaino, J. A., et al. The PRoteomics IDEntifications (PRIDE) database and associated tools: status in 2013. Nucleic Acids Research. 41, D1063-D1069 (2013).
- Aken, B. L., et al. Ensembl 2017. Nucleic Acids Research. 45 (D1), D635-D642 (2017).
- Perez-Riverol, Y., et al. Ms-data-core-api: an open-source, metadata-oriented library for computational proteomics. Bioinformatics. 31 (17), 2903-2905 (2015).
- Wang, Y., et al. Multi-protease strategy identifies three PE2 missing proteins in human testis tissue. Journal of Proteome Research. , (2017).
- Greseth, M. D., Carter, D. C., Terhune, S. S., Traktman, P. Proteomic screen for cellular targets of the vaccinia virus F10 protein kinase reveals that phosphorylation of mDia regulates stress fiber formation. Molecular & Cellular Proteomics. 16 (4 Suppl 1), S124-S143 (2017).
- Thorvaldsdottir, H., Robinson, J. T., Mesirov, J. P. Integrative genomics viewer (IGV): high-performance genomics data visualization and exploration. Briefings in Bioinformatics. 14 (2), 178-192 (2013).
- Kent, W. J., et al. The human genome browser at UCSC. Genome Research. 12 (6), 996-1006 (2002).
- The R Development Core Team. R: A Language and Environment for Statistical Computing. , R Foundation for Statistical Computing. Vienna, Austria. (2008).
- Kent, W. J., Zweig, A. S., Barber, G., Hinrichs, A. S., Karolchik, D. BigWig and BigBed: enabling browsing of large distributed datasets. Bioinformatics. 26 (17), 2204-2207 (2010).
- Down, T. A., Piipari, M., Hubbard, T. J. Dalliance: interactive genome viewing on the web. Bioinformatics. 27 (6), 889-890 (2011).
- Roumeliotis, T. I., et al. Genomic determinants of protein abundance variation in colorectal cancer cells. Cell Reports. 20 (9), 2201-2214 (2017).
- Gaudet, P., et al. The neXtProt knowledgebase on human proteins: 2017 update. Nucleic Acids Research. 45, D177-D182 (2017).
- Fermin, D., Walmsley, S. J., Gingras, A. C., Choi, H., Nesvizhskii, A. I. LuciPHOr: algorithm for phosphorylation site localization with false localization rate estimation using modified target-decoy approach. Molecular & Cellular Proteomics. 12 (11), 3409-3419 (2013).
- Fermin, D., Avtonomov, D., Choi, H., Nesvizhskii, A. I. LuciPHOr2: site localization of generic post-translational modifications from tandem mass spectrometry data. Bioinformatics. 31 (7), 1141-1143 (2015).
- Hansen, T. A., Sylvester, M., Jensen, O. N., Kjeldsen, F. Automated and high confidence protein phosphorylation site localization using complementary collision-activated dissociation and electron transfer dissociation tandem mass spectrometry. Analytical Chemistry. 84 (22), 9694-9699 (2012).
- Taus, T., et al. Universal and confident phosphorylation site localization using phosphoRS. Journal of Proteome Research. 10 (12), 5354-5362 (2011).
- Weisser, H., Wright, J. C., Mudge, J. M., Gutenbrunner, P., Choudhary, J. S. Flexible data analysis pipeline for high-confidence proteogenomics. Journal of Proteome Research. 15 (12), 4686-4695 (2016).
Przedruki i uprawnienia
