Prezentujemy protokół i związany z nim szablon metadanych do ekstrakcji tekstu opisującego koncepcje biomedyczne w raportach przypadków klinicznych. Ustrukturyzowane wartości tekstowe utworzone za pomocą tego protokołu mogą wspierać głęboką analizę tysięcy narracji klinicznych.
Artykuł metodologiczny
Podejście do ekstrakcji metadanych w opisach przypadków klinicznych w celu umożliwienia zaawansowanego zrozumienia pojęć biomedycznych
W tym artykule
Podsumowanie
Streszczenie
Kliniczne opisy przypadków (CCR) są cennym sposobem dzielenia się obserwacjami i spostrzeżeniami w medycynie. Forma tych dokumentów jest zróżnicowana, a ich treść zawiera opisy licznych, nowatorskich prezentacji chorób i metod leczenia. Jak dotąd, dane tekstowe w CCR są w dużej mierze nieustrukturyzowane, co wymaga znacznego wysiłku ludzkiego i obliczeniowego, aby dane te były przydatne do dogłębnej analizy. W niniejszym protokole opisujemy metody identyfikacji metadanych odpowiadających konkretnym pojęciom biomedycznym często obserwowanym w CCR. Udostępniamy szablon metadanych jako przewodnik do adnotacji dokumentów, uznając, że narzucanie struktury CCR może być realizowane poprzez połączenie wysiłku ręcznego i zautomatyzowanego. Przedstawione tutaj podejście jest odpowiednie do organizowania tekstów związanych z koncepcjami z dużego korpusu literatury (np. tysięcy CCR), ale może być łatwo zaadaptowane w celu ułatwienia bardziej ukierunkowanych zadań lub małych zestawów raportów. Uzyskane w ten sposób ustrukturyzowane dane tekstowe zawierają wystarczający kontekst semantyczny, aby wspierać różne późniejsze przepływy pracy związane z analizą tekstu: metaanalizy w celu określenia, w jaki sposób zmaksymalizować szczegółowość CCR, badania epidemiologiczne chorób rzadkich oraz rozwój modeli języka medycznego mogą być łatwiejsze do zrealizowania i zarządzania dzięki wykorzystaniu ustrukturyzowanych danych tekstowych.
Wprowadzenie
Kliniczne opisy przypadków (CCR) są podstawowym sposobem dzielenia się obserwacjami i spostrzeżeniami w medycynie. Służą one jako podstawowy mechanizm komunikacji i edukacji dla klinicystów i studentów medycyny. Historycznie rzecz biorąc, CCR dostarczały również opisy pojawiających się chorób, ich leczenia i tła genetycznego1,2,3,4. Na przykład, pierwsze leczenie ludzkiej wścieklizny przez Louisa Pasteura w 1885 roku5,6 oraz pierwsze zastosowanie penicyliny u pacjentów7 zostały zgłoszone za pośrednictwem CCR. Do kwietnia 2018 r. opublikowano ponad 1,87 mln CCR, z czego ponad pół miliona w ciągu ostatniej dekady; Czasopisma nadal udostępniają nowe miejsca dla tych raportów8. Chociaż CCR są unikalne pod względem formy i treści, zawierają dane tekstowe, które są w dużej mierze nieustrukturyzowane, zawierają obszerne słownictwo i dotyczą powiązanych ze sobą zjawisk, co ogranicza ich wykorzystanie jako ustrukturyzowanego zasobu. Konieczne jest znaczne wysiłki, aby wyodrębnić szczegółowe metadane (tj. "dane o danych" lub w tym przypadku opisy zawartości dokumentów) z CCR i ustanowić je jako możliwy do znalezienia, dostępny, interoperacyjny i wielokrotnego użytku (FAIR)9 zasób danych.
Tutaj opisujemy proces wyodrębniania tekstu i wartości liczbowych w celu standaryzacji opisu konkretnych koncepcji biomedycznych w opublikowanych CCR. Ta metodologia zawiera szablon metadanych do kierowania adnotacjami; zobacz Rysunek 1, aby zapoznać się z tym procesem. Zastosowanie procesu adnotacji do dużego zbioru raportów (np. kilku tysięcy o określonym typie prezentacji choroby) pozwala na złożenie łatwego w zarządzaniu i ustrukturyzowanego zestawu tekstów klinicznych z adnotacjami, uzyskując czytelną maszynowo dokumentację i zjawiska biomedyczne osadzone w każdym obrazie klinicznym. Chociaż formaty danych, takie jak te dostarczane przez HL7 (np. wersja 3 standardu przesyłania wiadomości10 lub Fast Healthcare Interoperability Resources [FHIR]11), LOINC12 i wersja 10 Międzynarodowej Statystycznej Klasyfikacji Chorób i Powiązanych Problemów Zdrowotnych (ICD-10)13 zapewniają standardy opisu i wymiany obserwacji klinicznych, nie przechwytują tekstu otaczającego te dane, ani nie są do tego przeznaczone. Wyniki naszej metodologii najlepiej wykorzystać do narzucenia struktury na CCR i ułatwienia późniejszej analizy, normalizacji za pomocą kontrolowanego słownictwa i systemów kodowania (np. ICD-10) i/lub konwersji do formatów danych klinicznych wymienionych powyżej.
Górnictwo CCR to aktywny obszar pracy w informatyce biomedycznej i klinicznej. Chociaż poprzednie propozycje standaryzacji struktury opisów przypadków (np. przy użyciu HL7 v2.514 lub ustandaryzowanej terminologii fenotypowej15) są godne pochwały, jest prawdopodobne, że CCR będą nadal podążać za różnymi formami języka naturalnego i układami dokumentów, tak jak to miało miejsce przez większą część ubiegłego stulecia. W idealnych warunkach autorzy nowych opisów przypadków postępują zgodnie z wytycznymi CARE16, aby upewnić się, że są one kompleksowe. Podejścia wrażliwe zarówno na język naturalny, jak i jego związek z pojęciami medycznymi mogą być zatem najbardziej efektywne w pracy z nowymi i archiwalnymi raportami. Zasoby takie jak CRAFT17 oraz te opracowane przez Informatics for Integrating Biology and the Bedside (i2b2)18 wspierają podejścia do przetwarzania języka naturalnego (NLP), ale nie koncentrują się konkretnie na CCR lub narracjach klinicznych. Podobnie, medyczne narzędzia NLP, takie jak cTAKES19 i CLAMP20, zostały opracowane, ale generalnie identyfikują konkretne słowa lub frazy (tj. jednostki) w dokumentach, a nie ogólne pojęcia powszechnie opisywane w CCR.
Zaprojektowaliśmy ustandaryzowany szablon metadanych dla funkcji często zawartych w CCR. Ten szablon definiuje funkcje narzucające strukturę na CCR — niezbędny prekursor do dogłębnych porównań zawartości dokumentów — a jednocześnie zapewnia wystarczającą elastyczność, aby zachować kontekst semantyczny. Chociaż zaprojektowaliśmy format powiązany z tym szablonem tak, aby był odpowiedni zarówno do ręcznego dodawania adnotacji, jak i do wyszukiwania tekstu wspomaganego komputerowo, upewniliśmy się, że jest on szczególnie łatwy w użyciu dla ręcznych adnotatorów. Nasze podejście zauważalnie różni się od bardziej skomplikowanych (a zatem mniej zrozumiałych dla nieprzeszkolonych badaczy) frameworków, takich jak FHIR21. Poniższy protokół opisuje sposób izolowania cech dokumentu odpowiadających poszczególnym typom danych szablonu, przy czym pojedynczy zestaw wartości odpowiada tym w pojedynczym CCR.
Typy danych w szablonie są najbardziej opisowe dla CCR i ogólnie dokumentów medycznych skoncentrowanych na pacjencie. Adnotacje do tych funkcji zwiększają wyszukiwalność, dostępność, interoperacyjność i możliwość ponownego wykorzystania tekstu CCR, przede wszystkim poprzez nadanie mu struktury. Typy danych dzielą się na cztery ogólne kategorie: identyfikacja dokumentów i adnotacji, identyfikacja opisu przypadku (tj. właściwości na poziomie dokumentu), koncepcje treści medycznych (głównie właściwości na poziomie koncepcji) oraz podziękowania (tj. cechy potwierdzające finansowanie). W tym procesie adnotacji każdy dokument zawiera pełny tekst CCR, pomijając wszelkie treści dokumentu niezależne od sprawy (np. protokoły eksperymentalne). CCR mają zazwyczaj mniej niż 1,000 słów każdy; Najlepiej byłoby, gdyby pojedynczy korpus był indeksowany przez tę samą bibliograficzną bazę danych i był napisany w tym samym języku pisanym.
Produkt opisanego tutaj podejścia, zastosowany do korpusu CCR, jest ustrukturyzowanym zestawem adnotowanego tekstu klinicznego. Chociaż metodologia ta może być wykonywana w pełni ręcznie i została zaprojektowana do wykonywania przez ekspertów dziedzinowych bez doświadczenia w dziedzinie informatyki, uzupełnia ona określone powyżej podejścia do przetwarzania języka naturalnego i dostarcza danych odpowiednich do analizy obliczeniowej. Takie analizy mogą być interesujące dla odbiorców badaczy nie tylko tych, którzy często czytają CCR, w tym:
- osoby zajmujące się prezentacją choroby, jej kluczowymi objawami, typowymi metodami diagnostycznymi i leczeniem
- tych, którzy chcą porównać wyniki badań klinicznych ze zdarzeniami opisanymi w literaturze klinicznej, potencjalnie dostarczając dodatkowych obserwacji i większej mocy statystycznej.
- badacze zajmujący się bioinformatyką, informatyką biomedyczną i informatyką, którzy wymagają ustrukturyzowanych zestawów danych języka medycznego lub wysokiego poziomu zrozumienia narracji medycznych
- Naukowcy zajmujący się polityką rządową koncentrują się na tym, w jaki sposób badania kliniczne mogą najlepiej odzwierciedlać to, jak diagnoza i leczenie zachodzą w rzeczywistości
Egzekwowanie struktury na CCR może wesprzeć wiele późniejszych wysiłków na rzecz lepszego zrozumienia zarówno języka medycznego, jak i zjawisk biomedycznych.
Protokół
1. Identyfikacja dokumentu i adnotacji
Uwaga: Wartości w tej kategorii wspierają proces adnotacji.
- Korzystając z szablonu adnotacji, podaj identyfikator specyficzny dla tego zestawu metadanych, np. Case123. Format identyfikatora powinien być spójny w całym projekcie (np. od Case001 do Case500).
- Określ datę, w której dokument został przeczytany i opatrzony adnotacjami. Użyj formatu przypominającego "10 stycznia 2018 r.", aby zapewnić spójność i czytelność.
2. Identyfikacja opisu przypadku
Uwaga: Wartości w tej kategorii dostarczają funkcji na poziomie dokumentu i przyczyniają się do jego odnalezienia.
- Format każdego pola powinien być spójny we wszystkich adnotacjach, np. poszczególne wartości powinny być oddzielone średnikami bez następujących po nich spacji we wszystkich wpisach. Używaj formatów identycznych z tymi, które są używane w oryginalnym dokumencie lub w bibliograficznej bazie danych, takiej jak MEDLINE.
- Podaj tytuł dokumentu.
- Podaj imiona i nazwiska wszystkich autorów dokumentu w podanej kolejności. Znormalizuj format wszystkich imion, tak aby wszystkie imiona miały postać jednego nazwiska, po którym następuje dowolna liczba inicjałów, np. Jane B. Park staje się Park JB. Nie dołączaj tytułów. Oddziel wielu autorów średnikiem bez dodatkowych znaków interpunkcyjnych, tak aby John A. Smith, Jane B. Park przyjmowali formę Smith JA; Park JB.
- Należy podać rok publikacji dokumentu.
- Podaj pełny tytuł czasopisma, w którym dokument został opublikowany. Lista kontrolowanych nazw czasopism jest dostępna w katalogu NLM (https://www.ncbi.nlm.nih.gov/nlmcatalog).
- Należy podać adres instytucji macierzystej autorów dokumentu, zgodnie z informacją zawartą w dokumencie. Może to obejmować działy, lokalizacje geograficzne i dane adresowe pocztowe.
- Jeśli podano wiele lokalizacji (np. jeśli afiliacje różnią się między autorami), podaj tylko szczegóły dotyczące autora korespondencyjnego. Jeśli nie można zidentyfikować autora korespondencyjnego, należy użyć autora pierwszego autora lub nie określać instytucji. Jeśli autor korespondencyjny ma wiele afiliacji, określ je i oddziel średnikiem.
- Podaj odpowiedniego autora dokumentu, określonego w nagłówku dokumentu, przy użyciu tego samego formatu, który jest używany w typie danych Autorzy.
- Podaj identyfikator dokumentu (np. PMID).
- Podaj cyfrowy identyfikator obiektu, o ile jest to możliwe i dostępny, rozpoznawalny jako adres URL dokumentu (za pośrednictwem https://www.doi.org/), a nie stronę PubMed Central.
- Podaj stabilny adres URL pełnego tekstu dokumentu, jeśli jest dostępny. Aby zmaksymalizować dostępność, może to odnosić się do wersji PubMed Central.
- Podaj język dokumentu. W przypadku dokumentów dostępnych w wielu językach podaj oba te elementy, oddzielając je średnikami.
3. Treści medyczne
Uwaga: Wartości w tej kategorii identyfikują cechy na poziomie dokumentu, koncepcji i tekstu. Służą one do zwiększenia dostępności, interoperacyjności i możliwości ponownego użycia dokumentu. Te funkcje umożliwiają obserwowanie podobieństw koncepcyjnych i semantycznych między treścią dokumentów, ze szczególnym uwzględnieniem tematów i wydarzeń biomedycznych. Większość kategorii w tej sekcji może zawierać wiele stwierdzeń tekstowych, a każda z nich powinna być oddzielona średnikiem.
- Uwzględnij szczegóły kontekstowe w każdym polu (np. "matka miała raka piersi w wieku 50 lat"), zamiast podawać tylko terminy z kontrolowanego słownictwa (np. nie tylko "rak piersi"). Nie podawaj obszernych szczegółów poza każdą obserwacją.
- Pomiń często powtarzające się słowa i wyrażenia (np. zaimki, słowo "pacjent" i wyrażenia "skarży się" lub "przedstawiono mu"). Chociaż subiektywność wielu adnotatorów jest prawdopodobna, może zostać zmniejszona przez posiadanie wielu adnotatorów dla każdego dokumentu i przez automatyczną normalizację po zebraniu danych. Podejścia do przetwarzania końcowego obliczeń będą się różnić w zależności od potrzeb kolejnej analizy i nie są tutaj szczegółowo omawiane.
- Podaj następujące informacje w szablonie adnotacji.
- Podaj konkretne terminy określone w dokumencie, zwykle w jego nagłówku, jako terminy kluczowe. Oddziel średnikiem, ponieważ terminy mogą zawierać inne znaki interpunkcyjne.
- Podaj wartości demograficzne, w szczególności wszelkie stwierdzenia tekstowe opisujące pochodzenie pacjenta, w tym płeć i/lub płeć, wiek, pochodzenie etniczne lub narodowość.
- Należy podać lokalizacje geograficzne wymienione w narracji klinicznej, inne niż adresy konkretnych instytucji. Nie powinno to obejmować lokalizacji/części anatomicznych, ale może obejmować dowolne miejsce geograficzne, w którym pacjent mieszka lub podróżuje.
- Podaj wartości stylu życia, w tym wszelkie stwierdzenia tekstowe opisujące częste czynności lub zachowania pacjentów związane z ich ogólnym stanem zdrowia. W praktyce często wiąże się to z nawykami związanymi z paleniem tytoniu lub spożywaniem alkoholu, ale może również obejmować ekspozycję na słońce, dietę lub częstotliwość określonych rodzajów aktywności fizycznej.
- Podaj wartości historii medycznej odnoszące się do historii rodziny. Dołącz wszelkie stwierdzenia tekstowe opisujące obserwacje kliniczne i zdarzenia doświadczane przez rodzeństwo, rodziców i innych członków rodziny. Obejmuje to uwarunkowania genetyczne i negatywne obserwacje (tj. wywiad rodzinny był ujemny dla choroby).
- Podaj wartości odnoszące się do historii społecznej, w tym wszelkie stwierdzenia tekstowe opisujące pochodzenie pacjenta, które nie zostały uwzględnione w Demografii lub Stylu życia. Treści tych kategorii mogą się pokrywać. Oświadczenia mogą obejmować historię zawodową i nawyki społeczne.
- Podaj wartości odnoszące się do historii medycznej i chirurgicznej pacjenta. Dołącz wszelkie stwierdzenia tekstowe opisujące wszelkie obserwacje medyczne, zabiegi lub inne zdarzenia, które miały miejsce przed rozpoczęciem prezentacji klinicznej. Obejmuje to historię położniczą i okresy dobrego stanu zdrowia, jeśli zaznaczono.
- Określ co najmniej jedną z następujących 16 kategorii systemu chorobowego. Należy pamiętać, że te wartości są jakościowe, a nie dowolnego. Kategorie nie są wyczerpujące, ale powinny wskazywać większość układów, na które mają wpływ zdarzenia opisane w obrazie klinicznym i zdiagnozowanej chorobie.
- Postępuj zgodnie z określonym zestawem kategorii, opartym na kategoriach używanych w systemie kodów Międzynarodowej Statystycznej Klasyfikacji Chorób i Powiązanych Problemów Zdrowotnych, wersja 10 (ICD-10). W tabeli 1 znajduje się wykaz kategorii układów chorobowych wraz z odpowiadającymi im zakresami kodów ICD-10.
- Podaj szczegółowe informacje na temat wszystkich oznak i objawów. Dołącz wszelkie stwierdzenia tekstowe opisujące wszelkie obserwacje medyczne dotyczące oznak lub objawów, począwszy od początkowej prezentacji, w tym ich początek, czas trwania, nasilenie i ustąpienie, jeśli zostały dostarczone. Nie uwzględniaj objawów opisanych w wyniku. Wartości te mogą pokrywać się z innymi typami, jeśli objawy utrzymują się od historii do początkowej prezentacji.
- Podaj szczegółowe informacje na temat wszelkich chorób współistniejących. Należy uwzględnić wszelkie terminy lub wyrażenia opisujące różne choroby obecne w momencie początkowego obrazu klinicznego. Prawdopodobnie wartości te pokrywają się z tymi w historii klinicznej, chociaż choroby współistniejące nie powinny obejmować terminów identycznych z tymi w diagnozie.
- Podaj szczegółowe informacje na temat wszystkich technik i procedur diagnostycznych. Należy podać nazwy procedur medycznych wykonywanych w celach diagnostycznych, w tym badań, testów i obrazowania, a także warunki, w jakich te testy zostały wykonane, oraz odpowiednie lokalizacje anatomiczne (np. "USG żył kończyn górnych"). Wyklucz wyniki testu.
- Podaj szczegóły diagnozy. Dołącz wszelkie stwierdzenia tekstowe opisujące diagnozy choroby, nawet jeśli ostateczna diagnoza jest niejednoznaczna.
- Podaj wszystkie wartości laboratoryjne i wyniki testów. Uwzględnij nazwy testów diagnostycznych, ich wartości i warunki, w jakich zostały wykonane. Będzie się to wiązało z pokrywaniem się terminów używanych w typie danych Techniki i procedury diagnostyczne. Dopuszczalne są zarówno wartości liczbowe, jak i jakościowe (np. pełna morfologia krwi mieściła się w granicach normy). Jeśli nazwy badań diagnostycznych nie są podane, należy użyć terminów opisujących wyniki (np. leukopenia), chociaż powinny one również znaleźć się w Przedmiotowych i Podmiotowych.
- Podaj szczegółowe informacje na temat patologii. Dołącz wszelkie stwierdzenia tekstowe opisujące wyniki badań patologicznych i histologicznych, w tym patologii ogólnej, immunologii i badań mikroskopowych. Terminy mogą pokrywać się z terminami stosowanymi w technikach i procedurach diagnostycznych (krok 3.11), np. z procedurami wykonywanymi w celu uzyskania próbek, takich jak biopsja.
- Zapewnij wszystkie terapie farmakologiczne. Uwzględnij wszelkie stwierdzenia tekstowe opisujące terapie lekowe stosowane w trakcie leczenia, w tym ogólne terminy, takie jak antybiotyki lub konkretne nazwy leków. Dołącz również opisy, kiedy i w jaki sposób terapie lekowe zostały przerwane.
- Zapewnij wszystkie procedury interwencyjne. Zawierać wszelkie oświadczenia tekstowe opisujące procedury terapeutyczne stosowane w trakcie leczenia, w tym procedury inwazyjne, implantację wyrobów medycznych oraz procedury wykonywane w celu ułatwienia innych terapii. W razie potrzeby dołącz również opisy, kiedy i w jaki sposób trwające procedury terapeutyczne zostały przerwane.
- Przedstaw wynik pacjenta. Należy dołączyć wszelkie oświadczenia tekstowe opisujące stan zdrowia pacjenta na koniec prezentacji klinicznej opisanej w raporcie, w tym wszelkie badania kontrolne.
- Podaj liczbę wszystkich obrazów diagnostycznych, rysunków, filmów/animacji i tabel. Uwzględnij wszystkie liczby nośników wizualnych uwzględnionych w raporcie, w następującym formacie: liczba obrazów; Liczba figur; Liczba filmów lub animacji; Liczba tabel.
- Rozróżnij obrazy i rysunki w ten sposób: obrazy obejmują wszelkie produkty diagnostyki klinicznej, w tym fotografie, mikrofotografie, obrazy rytmu elektrokardiogramu i inne produkty obrazowania diagnostycznego, podczas gdy rysunki to wszystkie inne obrazy, w tym zazwyczaj wykresy danych i ilustracje.
- Przedstaw dowody powiązań z innymi CCR. Pole to może zawierać identyfikatory (np. identyfikatory PMID) innych raportów w zbiorze danych, na które powołuje się ten raport lub do którego się odwołuje.
- Przedstaw dowody na powiązania z badaniami klinicznymi. W polu tym mogą znajdować się identyfikatory badań klinicznych, w których powoływano się na ten CCR. Identyfikuj badania na podstawie ich identyfikatorów ClinicalTrials.gov, poprzedzonych NCT lub innego stabilnego identyfikatora.
- Dołącz linki do bazy danych odpowiadające temu dokumentowi, w tym identyfikatory, najlepiej jako nazwy baz danych i stabilne adresy URL.
4. Podziękowania
Uwagi: Wartości w tej kategorii identyfikują cechy na poziomie dokumentu, ale mają mało spójną strukturę w publikacjach. Zawierają one szczegółowe informacje na temat organizacji udzielających wsparcia dla CCR i związanych z tym prac. Ta kategoria zawiera również pole dla całkowitej liczby odniesień cytowanych w artykule: ma to na celu zapewnienie przybliżonej metryki stopnia, w jakim dokument ma koncepcyjne powiązania z innymi dokumentami biomedycznymi dowolnego typu. Spośród czterech typów danych w tej sekcji podaj następujące elementy.
- Należy określić wszystkie źródła finansowania wspierające prace i odpowiadające im PI, a także odpowiednie numery nagród. Pierwsza wartość, Źródło finansowania, powinna zawierać nazwy wszystkich organizacji udzielających wsparcia finansowego na prace.
- Oddzielne organizacje ze średnikami i spacjami, np. National Institutes of Health/National Cancer Institute; DOE; Fundacja Smith-Park.
- Dla następującej wartości (Numer nagrody) należy podać wszelkie numery nagród lub konkretne oznaczenia podane wraz z laureatami nagród, w stosownych przypadkach, jako inicjały laureatów w nawiasach, np. R01HL123123 (do JP), NS12312 (do JP, JS), stypendium naukowe (do JS). Autorzy mogą wyraźnie stwierdzić, że nie są dostępne żadne odpowiednie informacje (np. "nie otrzymano żadnego finansowania"); w takich przypadkach należy użyć tekstu dostarczonego przez autorów jako wartości Źródła finansowania. W przeciwnym razie wartość powinna być NA.
- Określ ujawnienia/konflikty interesów określone przez autorów, np. JP jest konsultantem DrugCo. Autorzy mogą wyraźnie stwierdzić, że nie są dostępne żadne odpowiednie informacje (np. "nie deklaruje się konfliktu interesów"); w takich przypadkach należy użyć tekstu dostarczonego przez autorów jako wartości Ujawnienia/Konflikt interesów. W przeciwnym razie, jak powyżej, wartość powinna wynosić NA.
- Należy podać liczbową liczbę wszystkich odniesień cytowanych w dokumencie, nie wliczając w to odniesień zawartych w materiałach dodatkowych. W tym polu nie należy umieszczać tekstu referencyjnego.
Wyniki
Przykład procesu adnotacji przedstawiono na Rysunku 2. Ten przypadek22 opisuje obraz kliniczny zakażenia bakteryjnym patogenem Burkholderia thailandensis. Dla odniesienia, odpowiednia część tego raportu CCR została udostępniona w formacie tekstowym w Pliku uzupełniającym 1; w raporcie przedstawiono również niektóre wyniki badań, które dołączono w celu porównania. W praktyce konwersja raportów dostarczonych w formacie HTML lub PDF do tekstu niesformatowanego może zwiększyć wydajność i ułatwić ekstrakcję metadanych.
Przykłady dwóch zestawów wypełnionych adnotacji metadanych CCR przedstawiono w Tabeli 2. Pierwszy z tych przykładów to dane symulowane, które mają na celu zilustrowanie idealnego formatu każdej wartości, natomiast drugi przykład zawiera wartości wyodrębnione z opublikowanego CCR dotyczącego rzadkiej choroby, jaką jest acrodermatitis enteropathica23.
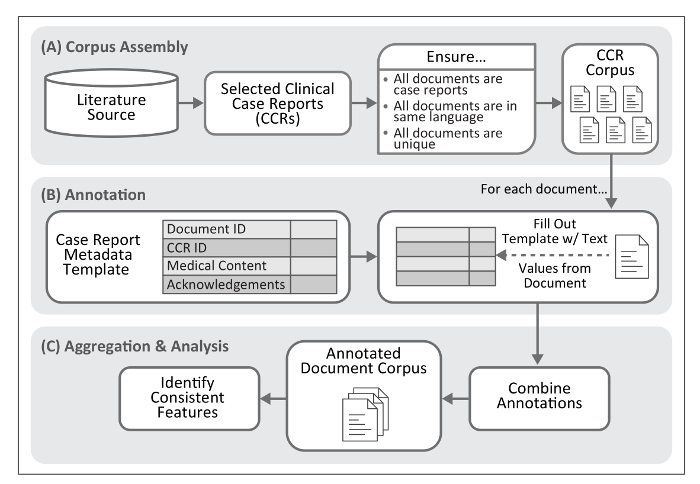
Rysunek 1. Przepływ pracy w procesie adnotowania raportów przypadków. Opisany tutaj protokół przedstawia metodę identyfikacji cech tekstowych często występujących w raportach przypadków klinicznych. Proces ten wymaga zgromadzenia korpusu dokumentów. Wynik procesu adnotowania, po zaggregowaniu w jednym pliku, umożliwia identyfikację cech tekstu powiązanych z pojęciami medycznymi i ich opisami w raportach przypadków. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
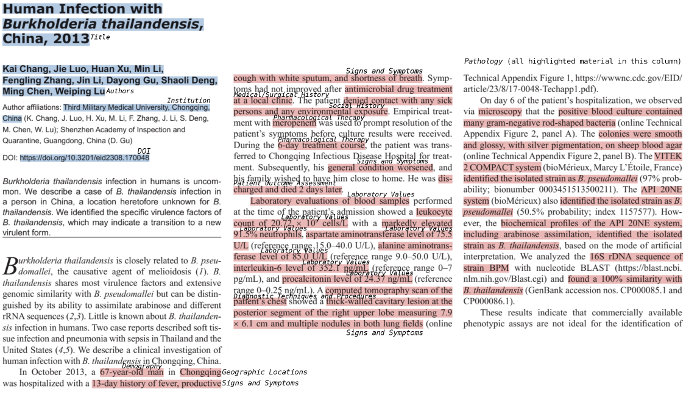
Rysunek 2. Identyfikacja tekstu specyficznego dla pojęcia w raporcie z przypadku klinicznego. Zaczynając od tekstu raportu z przypadku, manualny anotator może przejść przez dokument, identyfikując fragmenty tekstu odpowiadające każdemu elementowi szablonu metadanych. Cechy identyfikacyjne są wyróżnione na niebiesko. Tekst odpowiadający pojęciom medycznym zaznaczono na czerwono i oznaczono ich typem; cały wyróżniony tekst w trzeciej kolumnie odnosi się do typu Pathology. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
| Kategoria | Opis | Rozdział ICD-10 | Zakres kodów ICD-10 |
| nowotwór | Wszelkie rodzaje nowotworów lub nowotworów złośliwych. | II | C00-D49 |
| nerwowy | Każda choroba mózgu, rdzenia kręgowego lub nerwów. | VI | G00-G99 |
| sercowo-naczyniowy | Każda choroba serca lub układu naczyniowego. Nie obejmuje chorób hematologicznych. | IX | I00-I99 |
| układu mięśniowo-szkieletowego i reumatologiczne | Każda choroba mięśni, układu szkieletowego, stawów i tkanek łącznych. | XIII | M00-M99 |
| trawienny | Każda choroba przewodu pokarmowego i narządów trawiennych, w tym wątroby i trzustki. | XI | K00-K95 |
| położniczo-ginekologiczny | Wszelkie schorzenia związane z ciążą, porodem, żeńskim układem rozrodczym lub piersiami. | XIV; XV | O00-O9A; N60-N98 |
| zakaźny | Wszelkie choroby wywoływane przez mikroorganizmy zakaźne. | I | A00-B99 |
| oddechowy | Każda choroba płuc i dróg oddechowych. | X | J00-J99 |
| hematologiczny | Wszelkie choroby krwi, szpiku kostnego, węzłów chłonnych lub śledziony. | III | D50-D89 |
| nefrologiczne i urologiczne | Każda choroba nerek lub pęcherza moczowego, w tym moczowodów, a także męskich narządów rozrodczych, w tym prostaty. | XIV | N00-N53; N99 |
| endokrynny | Wszelkie choroby gruczołów dokrewnych, a także zaburzenia metaboliczne. | IV | E00-E89 |
| szczękowo-twarzowy | Wszelkie schorzenia obejmujące jamę ustną, szczęki, głowę, twarz lub szyję. | XI; XIII | K00-K14; M26-M27 |
| oko | Wszelkie schorzenia dotyczące oczu, w tym ślepota. | VII | H00-H59 |
| otolaryngologiczny | Wszelkie schorzenia uszu, nosa i/lub gardła. | VIII | H60-H95; J30-J39 |
| skóra | Wszelkie choroby skóry. | XII | L00-L99 |
| rzadki | Specjalna kategoria zastrzeżona dla raportów dotyczących chorób rzadkich, definiowanych jako schorzenia dotykające mniej niż 200 000 osób w Stanach Zjednoczonych (patrz https://rarediseases.info.nih.gov/diseases) | NA | Brak danych |
Tabela 1. Kategorie chorób do adnotacji dokumentów. Kategorie wymienione w tym miejscu są tymi, które należy stosować dla typu danych System Chorób w szablonie metadanych dokumentu. Ponieważ każda prezentacja choroby może obejmować wiele układów organów lub etiologii, pojedynczy raport z przypadku klinicznego może odpowiadać wielu kategoriom. Kategorie te w dużej mierze odpowiadają tym, które są wykorzystywane do rozróżniania sekcji w systemie kodowania Międzynarodowej Statystycznej Klasyfikacji Chorób i Problemów Zdrowotnych, rewizja 10 (ICD-10): podano odpowiadające im rozdziały i zakresy kodów ICD-10. Niektóre kategorie, takie jak kategoria chorób jamy ustnej i twarzoczaszki, odpowiadają wielu sekcjom systemu ICD-10.
| Typ danych | Przykład nr 1 | Przykład nr 2 (Cameron i McClain 1986) |
| Identyfikacja dokumentu i adnotacji | ||
| Identyfikator wewnętrzny | CCR005 | CCR2000 |
| Data adnotacji | 2 mar 2018 | 1 marca 2018 |
| Identyfikacja raportu przypadku | ||
| Tytuł | Przypadek zapalenia wsierdzi. | Histopatologia oka w akrodermatitis enteropathica. |
| Autorzy | Grant AB;Chang CD | Cameron JD;McClain CJ |
| Rok | 2017 | 1986 |
| Czasopismo | World Journal of Medicine and Case Reports | British Journal of Ophthalmology |
| Instytucja | Wydział Medycyny, Oddział Kardiologii, Pierwszy Szpital Ogólny, Boston, Massachusetts, USA | Katedra Okulistyki, University of Minnesota Medical School, Minneapolis, Minnesota 55455 |
| Autor korespondujący | Grant AB | Cameron JD |
| PMID | 25555555 | 3756122 |
| DOI | 10.1011/wjmcr.2017.11.001 | Brak danych |
| Łącze | **Sztuczna inteligencja w diagnostyce obrazowej raka piersi: przegląd aktualnych trendów i przyszłych perspektyw** **Streszczenie** Rak piersi jest najczęściej diagnozowanym nowotworem u kobiet na całym świecie i jedną z głównych przyczyn zgonów z powodu nowotworów. Wczesne wykrywanie odgrywa kluczową rolę w poprawie wskaźników przeżywalności i umożliwia zastosowanie mniej inwazyjnych strategii leczenia. Tradycyjne metody obrazowania, takie jak mammografia, ultrasonografia i rezonans magnetyczny (MRI), są niezbędne w procesie przesiewowym i diagnostycznym, jednak ich skuteczność jest ograniczona przez subiektywność interpretacji radiologicznej oraz wysoki odsetek wyników fałszywie dodatnich i fałszywie ujemnych. W ostatnich latach sztuczna inteligencja (AI), w szczególności uczenie głębokie (deep learning) i konwolucyjne sieci neuronowe (CNN), zrewolucjonizowała analizę obrazów medycznych, oferując potencjał do zwiększenia dokładności diagnostycznej, redukcji obciążenia pracą radiologów oraz personalizacji opieki nad pacjentkami. W niniejszym artykule przedstawiamy kompleksowy przegląd zastosowań AI w obrazowaniu raka piersi, analizując jej rolę w detekcji zmian, klasyfikacji nowotworów oraz prognozowaniu wyników leczenia. Omówione zostaną również wyzwania związane z wdrażaniem tych technologii do rutynowej praktyki klinicznej, w tym kwestie związane z jakością danych, interoperacyjnością systemów oraz etyką i regulacjami prawnymi. **Słowa kluczowe:** rak piersi, sztuczna inteligencja, uczenie głębokie, diagnostyka obrazowa, mammografia, detekcja nowotworów **Wstęp** Rak piersi stanowi znaczące obciążenie dla zdrowia publicznego w ujęciu globalnym. Pomimo postępów w terapiach celowanych i chirurgii oszczędzającej pierś, wczesna i precyzyjna diagnoza pozostaje fundamentem skutecznego leczenia. Standardowe protokoły obrazowania obejmują mammografię jako podstawowe narzędzie przesiewowe, uzupełniane o ultrasonografię w przypadku gęstej tkanki gruczołowej oraz rezonans magnetyczny (MRI) w celu oceny rozległości zmian lub u pacjentek z grupy wysokiego ryzyka. Niemniej jednak, interpretacja obrazów medycznych jest procesem złożonym i podatnym na błędy ludzkie wynikające ze zmęczenia, różnic w doświadczeniu klinicznym oraz naturalnej zmienności morfologicznej tkanek. W tym kontekście systemy oparte na sztucznej inteligencji (AI) pojawiają się jako obiecujące narzędzia wsparcia decyzji klinicznych (Computer-Aided Detection, CAD; Computer-Aided Diagnosis, CADx). AI potrafi identyfikować subtelne wzorce i cechy teksturalne obrazu, które mogą być niedostrzegalne dla ludzkiego oka, co pozwala na wcześniejsze wykrycie mikrozwapnień oraz małych guzów. **Zastosowania AI w obrazowaniu raka piersi** **Detekcja i segmentacja zmian** Pierwszym i najważniejszym krokiem w diagnostyce jest lokalizacja podejrzanych obszarów. Algorytmy uczenia głębokiego, a w szczególności architektury typu U-Net, są szeroko stosowane do segmentacji guza, co pozwala na dokładne określenie jego granic i objętości. Automatyczna detekcja zmian w mammografii cyfrowej (FFDM) i tomosyntezie piersi (DBT) znacząco redukuje liczbę pominiętych zmian, pełniąc rolę „drugiego czytającego” (second reader). **Klasyfikacja i charakterystyka zmian** Po detekcji kluczowe jest rozróżnienie między zmianami łagodnymi a złośliwymi. Modele AI są trenowane na ogromnych zbiorach danych (np. CBIS-DDSM, INbreast), aby klasyfikować masy i zwapnienia zgodnie z systemem BI-RADS (Breast Imaging-Reporting and Data System). Dzięki analizie radiomicznej, AI może wyodrębnić cechy ilościowe obrazu, które korelują z podtypami biologicznymi nowotworu, co może ograniczyć liczbę niepotrzebnych biopsji. **Multimodalna fuzja danych** Nowoczesne podejścia integrują dane z różnych źródeł obrazowania (mammografia, USG, MRI) oraz dane kliniczne i genetyczne. Taka fuzja danych pozwala na stworzenie bardziej kompletnego profilu pacjentki, co przekłada się na wyższą czułość i swoistość diagnostyczną w porównaniu do analizy pojedynczej modalności. **Wyzwania i ograniczenia** Mimo obiecujących wyników w badaniach retrospektywnych, implementacja AI w codziennej praktyce klinicznej napotyka szereg przeszkód: 1. **Jakość i dostępność danych:** Modele AI wymagają dużych, zróżnicowanych i starannie opisanych zbiorów danych. Brak standaryzacji w opisywaniu obrazów oraz problemy z prywatnością danych pacjentów ograniczają rozwój uniwersalnych algorytmów. 2. **Problem „czarnej skrzynki” (Black Box):** Wiele modeli uczenia głębokiego oferuje wynik bez wyjaśnienia procesu decyzyjnego. W medycynie kluczowa jest wyjaśnialna sztuczna inteligencja (Explainable AI, XAI), która wskazywałaby konkretne cechy obrazu prowadzące do danej diagnozy. 3. **Generalizacja:** Modele wytrenowane na jednej populacji lub przy użyciu sprzętu jednego producenta mogą wykazywać niższą skuteczność w innych ośrodkach (tzw. przesunięcie danych). 4. **Kwestie etyczne i prawne:** Odpowiedzialność za błędną diagnozę postawioną przez system AI pozostaje kwestią sporną i wymaga opracowania nowych ram prawnych. **Przyszłe perspektywy** Przyszłość diagnostyki raka piersi leży w synergii między radiologiem a sztuczną inteligencją. Przewiduje się rozwój systemów w czasie rzeczywistym wspomagających biopsje pod kontrolą USG oraz wykorzystanie AI w monitorowaniu odpowiedzi na chemioterapię neoadjuwantową poprzez analizę zmian w perfuzji tkankowej w MRI. Ponadto, rozwój uczenia federacyjnego (federated learning) może pozwolić na trenowanie modeli na danych z wielu szpitali bez konieczności ich fizycznego przesyłania, co rozwiąże problemy z prywatnością. **Wnioski** Sztuczna inteligencja nie zastąpi radiologów, ale radiolodzy wykorzystujący AI prawdopodobnie zastąpią tych, którzy tego nie robią. Integracja zaawansowanych algorytmów z rutynową praktyką kliniczną ma potencjał, aby znacząco zredukować liczbę błędów diagnostycznych, zoptymalizować procesy przesiewowe i spersonalizować leczenie raka piersi, co w ostateczności przełoży się na uratowanie większej liczby istnień ludzkich. | Tytuł: Metody obrazowania i analizy w badaniach nad transportem wewnątrzkomórkowym Streszczenie Transport wewnątrzkomórkowy jest kluczowym procesem w każdej komórce eukariotycznej, umożliwiającym precyzyjne przemieszczanie białek, lipidów i organelli między różnymi przedziałami komórkowymi. Zrozumienie mechanizmów sterujących tymi procesami wymaga zastosowania zaawansowanych technik obrazowania, które pozwalają na wizualizację dynamiki transportu w czasie rzeczywistym z wysoką rozdzielczością przestrzenną. W niniejszym artykule przedstawiamy przegląd i porównanie najczęściej stosowanych metod obrazowania stosowanych w badaniach nad transportem wewnątrzkomórkowym, ze szczególnym uwzględnieniem mikroskopii fluorescencyjnej, mikroskopii konfokalnej oraz nowoczesnych technik superrozdzielczych (super-resolution microscopy). Omówiono zasady działania poszczególnych metod, ich zalety oraz ograniczenia w kontekście analizy transportu pęcherzykowego, ruchu wzdłuż cytoszkieletu oraz fuzji i pączkowania błon. Ponadto opisano narzędzia analityczne i algorytmy śledzenia pojedynczych cząsteczek (single-particle tracking), które pozwalają na ilościową ocenę parametrów kinetycznych transportu. Słowa kluczowe: transport wewnątrzkomórkowy, mikroskopia fluorescencyjna, mikroskopia konfokalna, mikroskopia superrozdzielcza, śledzenie pojedynczych cząsteczek, dynamika organelli Wprowadzenie Transport wewnątrzkomórkowy jest niezbędny do utrzymania homeostazy komórkowej, wzrostu, podziału oraz komunikacji międzykomórkowej. Procesy te zachodzą poprzez zorganizowaną sieć pęcherzyków transportowych, które przemieszczają się wzdłuż elementów cytoszkieletu (mikrotubul i filamentów aktynowych) przy udziale białek motorycznych. Precyzyjna kontrola kierunkowości i specyficzności transportu jest kluczowa dla prawidłowego funkcjonowania komórki, a zaburzenia w tych procesach są powiązane z wieloma chorobami, w tym z chorobami neurodegeneracyjnymi. Metody Obrazowania Mikroskopia Fluorescencyjna i Konfokalna Podstawą wizualizacji transportu wewnątrzkomórkowego jest zastosowanie znaczników fluorescencyjnych, takich jak białka fluorescencyjne (np. GFP) lub barwniki organiczne. Mikroskopia konfokalna, dzięki zastosowaniu otworu przypiny (pinhole), pozwala na eliminację światła spoza płaszczyzny ogniskowania, co umożliwia uzyskanie obrazów optycznych przekrojów komórki (optical sections) o znacznie wyższym kontraście i rozdzielczości niż w konwencjonalnej mikroskopii szerokopolowej. Jest to metoda z wyboru do badania lokalizacji organelli oraz analizy kolokalizacji białek. Mikroskopia Superrozdzielcza Klasyczna mikroskopia świetlna jest ograniczona przez dyfrakcję światła, co uniemożliwia obrazowanie struktur mniejszych niż ok. 200 nm. Techniki superrozdzielcze, takie jak STED (Stimulated Emission Depletion), PALM (Photoactivated Localization Microscopy) oraz STORM (Stochastic Optical Reconstruction Microscopy), pozwalają na przełamanie tej bariery, osiągając rozdzielczość rzędu kilku do kilkunastu nanometrów. Umożliwia to szczegółową analizę architektury pęcherzyków transportowych oraz interakcji białek w obrębie kompleksów białkowych odpowiedzialnych za transport. Analiza Dynamiki i Śledzenie Pojedynczych Cząsteczek W celu badania kinetyki transportu stosuje się techniki obrazowania w czasie rzeczywistym (live-cell imaging). Algorytmy śledzenia pojedynczych cząsteczek (single-particle tracking, SPT) pozwalają na analizę trajektorii ruchu pojedynczych pęcherzyków lub białek. Poprzez analizę średniego kwadratu przemieszczenia (MSD), możliwe jest rozróżnienie między ruchem dyfuzyjnym a transportem aktywnym (ukierunkowanym). Podsumowanie i Perspektywy Integracja zaawansowanych metod obrazowania z ilościową analizą danych pozwala na głębsze zrozumienie molekularnych mechanizmów transportu wewnątrzkomórkowego. Przyszłe kierunki badań obejmują rozwój metod obrazowania czterowymiarowego (4D), łączących wysoką rozdzielczość przestrzenną z wysoką częstotliwością próbkowania w czasie, co pozwoli na pełne odwzorowanie dynamiki przepływu materiałów wewnątrz komórki w jej naturalnym środowisku. |
| Język | Angielski | Angielski |
| Treść medyczna | ||
| Słowa kluczowe | bruceloza; zapalenie wsierdzia; zastawka mitralna | Brak danych |
| Demografia | 37-letni mężczyzna | dziecko płci męskiej |
| Lokalizacje geograficzne | Floryda; Rio de Janeiro, Brazylia | Brak danych |
| Styl życia | palacz; okazjonalnie spożywa alkohol | Nie dotyczy |
| Wywiad rodzinny | trzecie z pięciorga dzieci rodziców spokrewnionych; młodszy brat cierpi na przewlekły wyprysk | ND |
| Wywiad społeczny | pracownik budowlany | ND |
| Wywiad medyczny i chirurgiczny | historia zmęczenia | Produkt ciąży pełnoobciążeniowej, niepowikłanej, o masie 8 funtów i 9 uncji (3884 g); w dobrym stanie zdrowia do 1. miesiąca życia, kiedy wystąpiła pęcherzowa wysypka na policzkach; wysypka rozprzestrzeniła się na skórę wokół oczu, nosa i ust; zmiany skórne odnotowano również na brzuchu i kończynach; biegunka i zaburzenia przyrostu masy ciała; biopsja skóry wykonana w tym czasie wykazała parakeratozę typową dla acrodermatitis enteropathica; w ciągu następnych sześciu lat leczony przerywanymi kuracjami antybiotykami o szerokim spektrum działania, mlekiem matki oraz diodoquinem; uzyskano częściową odpowiedź na leczenie; rozwinęła się całkowita łysina, nawracająca acrodermatitis oraz okresowa biegunka z nieoptymalnym przyrostem masy ciała; do 8. miesiąca życia rozwinęła spastyczność przypisywana zajęciu ośrodkowego układu nerwowego przez ae; kilka epizodów zatrzymania krążenia i oddechu w 11. miesiącu życia; brak koordynacji strun głosowych; tracheostomia; do 18. miesiąca życia u dziecka rozwinął się nystagmus poszukujący związany z obustronnym zanikiem nerwu wzrokowego i lekkim zwężeniem naczyń siatkówki, a także objawy opóźnienia psychomotorycznego; obustronne zapalenie rogówki i spojówek; wysypka skórna; druga biopsja skóry wykonana w wieku 3 lat ponownie wykazała parakeratozę typową dla ae; ciężka wysypka skórna i biegunka; stwierdzono obustronne, rozległe zmętnienia przedniej części rogówki, które całkowicie ustąpiły do czasu ponownego badania w wieku pięciu lat; częste infekcje, w tym zapalenie ucha środkowego, zakażenia układu moczowego oraz infekcje skóry |
| Układ chorobowy | sercowo-naczyniowe; zakaźne | pokarmowy; skóra; oko; rzadki |
| Objawy i symptomy | kołatania serca i duszność w poprzednim tygodniu; zgłosił letarg, ból głowy i dreszcze | ciężkie zapalenie powiek i spojówek oraz obustronna unaczynienie przedniej części rogówki; ciężka wysypka skórna i biegunka; sepsa bakteryjna wywołana bakteriami gram-ujemnymi; zmiany skórne typowe dla acrodermatitis enteropathica, brak tkanki grasicy, wyraźna degeneracja nerwów wzrokowych, skrzyżowania wzrokowego i dróg wzrokowych oraz rozległa degeneracja móżdżku |
| Współchorobowość | nadciśnienie tętnicze; hiperlipidemia | Brak danych |
| Techniki i procedury diagnostyczne | Badanie fizykalne; elektrokardiografia; posiewy krwi | badanie okulistyczne; nekropsja |
| Diagnostyka | Zapalenie wsiernia wywołane przez Brucella | acrodermatitis enteropathica |
| Wartości laboratoryjne | wzrost poziomu białka C-reaktywnego (9 mg/dl); fosfatazy alkalicznej (250 U/l) | ND |
| Patologia | Wykulturowano Brucella melitensis z próbek krwi | Wygląd prawego i lewego oka był podobny; grubość nabłonka rogówki była zredukowana do jednej do trzech warstw spłaszczonych łuskowatych komórek nabłonkowych na całej powierzchni rogówki; utracono całkowicie polaryzację nabłonka. Błonę Bowmana można było zidentyfikować jedynie w obwodowej części prawej rogówki. W lewej rogówce nie stwierdzono obecności błony Bowmana. W żadnym z oczu nie zidentyfikowano pannusa o charakterze degeneracyjnym ani zapalnym; stwierdzono rozległy zanik mięśni kolistych i skośnych ciała rzęskowego; odnotowano częściową migrację tylną nabłonka torebki soczewki oraz wczesne zmiany degeneracyjne kory; stwierdzono rozległą degenerację nabłonka pigmentowego siatkówki w obrębie całego bieguna tylnego; siatkówka była przytwierdzona i wykazywała łagodne zmiany autolityczne w całym obszarze; w obrębie bieguna tylnego zachowały się niektóre zewnętrzne odcinki pręcików i czopków, jednak struktury te były całkowicie utracone przed równikiem; stwierdzono rozległy zanik warstwy komórek zwojowych i warstwy włókien nerwowych w obu oczach; odnotowano niemal całkowity zanik tarczy oraz przylegającego nerwu wzrokowego. |
| Terapia farmakologiczna | gentamycyna 240 mg/dobowo/i.v. | Brak danych |
| Terapia interwencyjna | wymiana zastawki na protezę | ND |
| Ocena wyników leczenia pacjenta | rekonwalescencja przebiegła bez powikłań; pacjent został wypisany do domu | zmarł w 1971 roku (w wieku 7 lat) |
| Diagnostyka obrazowa/Nagrywanie wideo | 2;1;0;1 | 7;0;0;0 |
| Związek z innymi raportami przypadków | 5555555 | 23430849 |
| Związek z badaniem klinicznym | NCT05555123 | Brak danych |
| Powiązanie z bazą danych | Informacje zdrowotne MedlinePlus: https://medlineplus.gov/ency/article/000597.htm | HighWire - PDF: http://bjo.bmj.com/cgi/pmidlookup?view=long&pmid=3756122; Europe PubMed Central: http://europepmc.org/abstract/MED/3756122; Genetic Alliance: http://www.diseaseinfosearch.org/result/143 |
| Podziękowania | ||
| Źródło finansowania | National Institutes of Health/National Heart, Lung, and Blood Institute | The Minnesota Lions Club; Research to Prevent Blindness; Veterans Administration; Office of Alcohol and Other Drug Abuse Programming of the State of Minnesota |
| Numer grantu | R01HL123123 (do AG) | ND |
| Oświadczenia/Konflikt interesów | Dr Grant jest płatnym rzecznikiem firmy DrugCo. | Brak danych |
| Bibliografia | 4 | 27 |
Tabela 2. Ustandaryzowany szablon metadanych dla opisów przypadków klinicznych wraz z przykładowymi adnotacjami. Przedstawiono tutaj zestaw cech wspólnych dla opisów przypadków klinicznych, które ułatwiają ich adnotację na poziomie koncepcji. Szablon ten jest podzielony na trzy główne sekcje: Identyfikacja, Treść medyczna i Podziękowania, co określa przeznaczenie i dodatkową wartość każdej z cech opisu przypadku. Tabela zawiera dwa zestawy przykładowych adnotacji: jeden z fikcyjnego opisu przypadku oraz drugi pochodzący z raportu na temat acrodermatitis enteropathica23.
Plik uzupełniający 1. Tekst raportu z przypadku klinicznego (Chang et al. 2017). Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Wdrożenie ustandaryzowanego szablonu metadanych dla CCR może sprawić, że ich treści będą bardziej FAIR, poszerzą grono odbiorców i rozszerzą ich aplikacje. Zgodnie z tradycyjnym zastosowaniem CCR jako narzędzi edukacyjnych w komunikacji medycznej, stażyści opieki zdrowotnej (np . studenci medycyny, stażyści i stypendyści) oraz badacze biomedyczni mogą uznać, że streszczona treść opisu przypadku umożliwia szybsze zrozumienie. Największą zaletą standaryzacji metadanych za pomocą CCR jest jednak to, że indeksowanie tych danych przekształca odizolowane obserwacje w możliwe do zinterpretowania wzorce. Przedstawiony tutaj protokół może służyć jako pierwszy krok w procesie pracy z CCR, niezależnie od tego, czy ten przepływ pracy obejmuje analizę epidemiologiczną, nadzór nad lekiem lub leczeniem po wprowadzeniu do obrotu, czy też szersze badania patogenezy lub skuteczności terapeutycznej. Ustrukturyzowane cechy zidentyfikowane w ramach CCR mogą stanowić użyteczne źródło informacji dla badaczy zajmujących się prezentacją chorób i ich leczeniem, szczególnie w przypadku rzadkich schorzeń. Badacze kliniczni mogą znaleźć dane na temat wcześniejszych schematów leczenia, aby przeanalizować zarejestrowane objawy lub skutki uboczne oraz stopień poprawy w ramach poprzednich standardów opieki. Dane te mogą również stanowić podstawę do szerszych analiz nowych metod leczenia w oparciu o skuteczność, brak działań niepożądanych lub toksyczność, a także różnice w celowaniu leków pod względem płci, grupy wiekowej lub tła genetycznego.
Korzyści zapewniane przez ustrukturyzowane metadane mają podobne zastosowanie do obliczeniowych przepływów pracy zaprojektowanych do analizowania lub modelowania języka medycznego. Ustrukturyzowane funkcje CCR mogą również dostarczyć dowodów na obszary, w których autorzy raportów mogą łatwiej dostarczać treści czytelne dla maszyn (a w niektórych przypadkach czytelne dla człowieka). Różnice między CCR mogą wynikać z braku wyraźnie przedstawionych obserwacji: np. dokładny wiek pacjenta może nie być określony. Podobnie klinicyści mogą nie wspominać o testach, jeśli diagnostyka lub jej wyniki zostały uznane za trywialne. Dostarczając przykładów luk niezbędnych do dogłębnej analizy, egzekwowanie struktury w zakresie CCR uwypukla potencjalne ulepszenia. W szerszej perspektywie większa dostępność ustrukturyzowanych danych tekstowych z dokumentów medycznych wspiera wysiłki w zakresie przetwarzania języka naturalnego (NLP) w celu uczenia się na podstawie dużych zbiorów danych w opiece zdrowotnej24,25.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca była częściowo wspierana przez National Heart, Lung, and Blood Institute: R35 HL135772 (do P. Pinga); Narodowy Instytut Ogólnych Nauk Medycznych: U54 GM114833 (do P. Pinga, K. Watsona i W. Wanga); Narodowy Instytut Obrazowania Biomedycznego i Bioinżynierii: T32 EB016640 (do A. Bui); upominek od Fundacji Hoag i dr S. Setty; oraz fundacja T.C. Laubischa na UCLA (do P. Pinga).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Korpus opisów przypadków klinicznych | nie dotyczy | Pełne | teksty opisów przypadków można uzyskać za pośrednictwem PubMed (np. za pomocą hasła "Opisy przypadków"[Filtr]), innych baz cytowań, takich jak Europe PMC (https://europepmc.org/) lub bezpośrednio u wydawców. |
Bibliografia
- Ban, T. A. The role of serendipity in drug discovery. Dialogues in Clinical Neuroscience. 8 (3), 335-344 (2006).
- Cabán-Martinez, A. J., García-Beltrán, W. F. Advancing medicine one research note at a time: the educational value in clinical case reports. BMC Research Notes. 5 (1), 293(2012).
- Vandenbroucke, J. P. In Defense of Case Reports and Case Series. Annals of Internal Medicine. 134 (4), 330(2001).
- Bayoumi, A. M. The storied case report. Canadian Medical Association Journal. 171 (6), 569-570 (2004).
- Pasteur, L. Méthode pour prévenir la rage après morsure. Comptes rendus de l'Académie des Sciences. 101, 765-774 (1885).
- Pearce, J. Louis Pasteur and Rabies: a brief note. Journal of Neurology, Neurosurgery & Psychiatry. 73 (1), 82-82 (2002).
- Keefer, C. S., Blake, F. G., Marshall, E. K. J., Lockwood, J. S., Wood, W. B. J. PENICILLIN IN THE TREATMENT OF INFECTIONS. Journal of the American Medical Association. 122 (18), 1217(1943).
- Akers, K. G. New journals for publishing medical case reports. Journal of the Medical Library Association JMLA. 104 (2), 146-149 (2016).
- Wilkinson, M. D., et al. The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data. 3, 160018(2016).
- Beeler, G. W. HL7 Version 3-An object-oriented methodology for collaborative standards development. International Journal of Medical Informatics. 48 (1-3), 151-161 (1998).
- HL7 FHIR Release 3 (STU; v3.0.1-11917). , Available from: http://hl7.org/implement/standards/fhir/ (2018).
- McDonald, C. J. LOINC, a Universal Standard for Identifying Laboratory Observations: A 5-Year Update. Clinical Chemistry. 49 (4), 624-633 (2003).
- CDC/National Center for Health Statistics ICD-10-CM Official Guidelines for Coding and Reporting. , Available from: https://www.cdc.gov/nchs/data/icd/10cmguidelines_fy2018_final.pdf (2017).
- Rajeev, D., et al. Development of an electronic public health case report using HL7 v2.5 to meet public health needs. Journal of the American Medical Informatics Association. 17 (1), 34-41 (2010).
- Biesecker, L. Mapping phenotypes to language: a proposal to organize and standardize the clinical descriptions of malformations. Clinical Genetics. 68 (4), 320-326 (2005).
- Riley, D. S., et al. CARE guidelines for case reports: explanation and elaboration document. Journal of Clinical Epidemiology. 89, 218-235 (2017).
- Cohen, K. B., et al. Coreference annotation and resolution in the Colorado Richly Annotated Full Text (CRAFT) corpus of biomedical journal articles. BMC Bioinformatics. 18 (1), 372(2017).
- Sun, W., Rumshisky, A., Uzuner, O. Evaluating temporal relations in clinical text: 2012 i2b2 Challenge. Journal of the American Medical Informatics Association. 20 (5), 806-813 (2013).
- Savova, G. K., et al. Mayo clinical Text Analysis and Knowledge Extraction System (cTAKES): architecture, component evaluation and applications. Journal of the American Medical Informatics Association. 17 (5), 507-513 (2010).
- Soysal, E., et al. CLAMP - a toolkit for efficiently building customized clinical natural language processing pipelines. Journal of the American Medical Informatics Association. 25 (3), 331-336 (2018).
- Bender, D., Sartipi, K. HL7 FHIR: An Agile and RESTful approach to healthcare information exchange. Proceedings of the 26th IEEE International Symposium on Computer-Based Medical Systems. , 326-331 (2013).
- Chang, K., et al. Human Infection with Burkholderia thailandensis, China, 2013. Emerging Infectious Diseases. 23 (8), 1416-1418 (2013).
- Cameron, J. D., McClain, C. J. Ocular histopathology of acrodermatitis enteropathica. British Journal of Ophthalmology. 70 (9), 662-667 (1986).
- Maddox, T. M., Matheny, M. A. Natural Language Processing and the Promise of Big Data. Circulation: Cardiovascular Quality and Outcomes. 8 (5), 463-465 (2015).
- Kreimeyer, K., et al. Natural language processing systems for capturing and standardizing unstructured clinical information: A systematic review. Journal of Biomedical Informatics. 73, 14-29 (2017).
Przedruki i uprawnienia
