CRISPR-Cas to potężna technologia do inżynierii złożonych genomów roślin i zwierząt. W tym miejscu szczegółowo opisujemy protokół skutecznej edycji ludzkiego genomu przy użyciu różnych endonukleaz Cas. Zwracamy uwagę na ważne kwestie i parametry projektowe, aby zoptymalizować wydajność edycji.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Edycja genomu w liniach komórkowych ssaków przy użyciu CRISPR-Cas
W tym artykule
Podsumowanie
Streszczenie
System CRISPR (clustered regularly interspaced short palindromic repeats) funkcjonuje naturalnie w bakteryjnej odporności adaptacyjnej, ale został z powodzeniem wykorzystany do inżynierii genomu w wielu różnych organizmach żywych. Najczęściej endonukleaza 9 (Cas9) lub Cas12a związana z CRISPR typu dzikiego jest używana do rozszczepiania określonych miejsc w genomie, po czym dwuniciowe pęknięcie DNA jest naprawiane za pośrednictwem szlaku niehomologicznego łączenia końców (NHEJ) lub szlaku naprawy kierowanej homologią (HDR) w zależności od tego, czy szablon dawcy jest odpowiednio nieobecny, czy obecny. Do tej pory wykazano, że systemy CRISPR pochodzące od różnych gatunków bakterii są zdolne do edycji genomu w komórkach ssaków. Jednak pomimo pozornej prostoty technologii, należy wziąć pod uwagę wiele parametrów projektowych, które często pozostawiają użytkowników w zakłopotaniu, jak najlepiej przeprowadzić eksperymenty z edycją genomu. W tym miejscu opisujemy kompletny przepływ pracy od projektu eksperymentalnego do identyfikacji klonów komórkowych, które zawierają pożądane modyfikacje DNA, w celu ułatwienia pomyślnego przeprowadzenia eksperymentów z edycją genomu w liniach komórkowych ssaków. Zwracamy uwagę na kluczowe kwestie, na które użytkownicy powinni zwrócić uwagę, w tym wybór systemu CRISPR, długość przekładki i projekt jednoniciowego szablonu dawcy oligodeoksynukleotydu (ssODN). Przewidujemy, że ten przepływ pracy będzie przydatny w badaniach nad nokautem genów, modelowaniu chorób lub generowaniu reporterowych linii komórkowych.
Wprowadzenie
Zdolność do edycji genomu każdego organizmu żywego znajduje wiele zastosowań biomedycznych i biotechnologicznych, takich jak korekcja mutacji wywołujących choroby, tworzenie precyzyjnych modeli komórkowych do badań nad chorobami czy generowanie upraw rolniczych o pożądanych cechach. Od początku stulecia opracowano różne technologie inżynierii genomu w komórkach ssaków, w tym meganukleazy1,2,3, nukleazy z palcem cynkowym4,5 oraz nukleazy z efektorami podobnymi do aktywatorów transkrypcji (TALENs)6,7,8,9. Jednakże te wcześniejsze technologie są albo trudne do zaprogramowania, albo żmudne w składaniu, co hamuje ich powszechne zastosowanie w badaniach naukowych i przemyśle.
W ostatnich latach system CRISPR (clustered regularly interspaced short palindromic repeats) – Cas (CRISPR-associated) wyłonił się jako potężna, nowa technologia inżynierii genomu10,11. Pierwotnie będący adaptacyjnym układem odpornościowym bakterii, został z sukcesem wdrożony do modyfikacji genomu roślin i zwierząt, w tym ludzi. Głównym powodem, dla którego CRISPR-Cas zyskał tak dużą popularność w tak krótkim czasie, jest fakt, że element doprowadzający kluczową endonukleazę Cas, taką jak Cas9 lub Cas12a (znaną również jako Cpf1), w odpowiednie miejsce w genomie, stanowi po prostu krótki fragment chimerycznego pojedynczego przewodniego RNA (sgRNA), który jest łatwy do zaprojektowania i tani w syntezie. Po zwerbowaniu do miejsca docelowego, enzym Cas działa jak molekularne nożyczki i przecina związane DNA za pomocą swoich domen RuvC, HNH lub Nuc12,13,14. Powstałe w ten sposób pęknięcie dwuniciowe (DSB) jest następnie naprawiane przez komórki za pośrednictwem drogi niehomologicznego łączenia końców (NHEJ) lub naprawy kierowanej homologią (HDR). W przypadku braku matrycy naprawczej, DSB jest naprawiane przez podatną na błędy drogę NHEJ, co może prowadzić do pseudolosowych insercji lub delecji nukleotydów (indeli) w miejscu cięcia, potencjalnie powodując mutacje przesunięcia ramki odczytu w genach kodujących białka. Jednak w obecności matrycy donorowej zawierającej pożądane zmiany w DNA, DSB jest naprawiane przez wysokowierną drogę HDR. Do powszechnie stosowanych typów matryc donorowych należą jednoniciowe oligonukleotydy (ssODN) oraz plazmidy. Te pierwsze są zazwyczaj stosowane, gdy zamierzone zmiany w DNA są niewielkie (na przykład zmiana pojedynczej pary zasad), natomiast te drugie są zazwyczaj wykorzystywane, gdy chce się wprowadzić stosunkowo długą sekwencję (na przykład sekwencję kodującą zielone białko fluorescencyjne lub GFP) do locus docelowego.
Aktywność endonukleazy białka Cas wymaga obecności motywu PAM (protospacer adjacent motif) w miejscu docelowym15. PAM dla Cas9 znajduje się na końcu 3’ protospacera, natomiast PAM dla Cas12a (zwanego również Cpf1) znajduje się na końcu 5’16. Kompleks Cas-przewodzące RNA nie jest w stanie wprowadzić DSB, jeśli PAM jest nieobecny17. Zatem PAM nakłada ograniczenia na lokalizacje genomiczne, w których dana nukleaza Cas jest w stanie dokonać cięcia. Na szczęście nukleazy Cas z różnych gatunków bakterii wykazują zazwyczaj różne wymagania dotyczące PAM. Dzięki zintegrowaniu różnych systemów CRISPR-Cas w naszym zestawie narzędzi inżynieryjnych możemy rozszerzyć zakres miejsc w genomie, które mogą być celem modyfikacji. Co więcej, naturalny enzym Cas może zostać zmodyfikowany lub ewoluować tak, aby rozpoznawał alternatywne sekwencje PAM, co dodatkowo poszerza zakres celów genomicznych dostępnych do manipulacji18,19,20.
Choć do celów inżynierii genomu dostępnych jest wiele systemów CRISPR-Cas, większość użytkowników tej technologii polegała głównie na nukleazie Cas9 z Streptococcus pyogenes (SpCas9) z kilku powodów. Po pierwsze, wymaga ona stosunkowo prostej sekwencji PAM NGG, w przeciwieństwie do wielu innych białek Cas, które mogą przecinać DNA tylko w obecności bardziej złożonych PAM. Po drugie, jest to pierwsza endonukleaza Cas, która została z sukcesem zastosowana w komórkach ludzkich21,22,23,24. Po trzecie, SpCas9 jest do tej pory najlepiej scharakteryzowanym enzymem. Gdyby badacz chciał użyć innej nukleazy Cas, często nie byłby pewien, jak najlepiej zaprojektować eksperyment i jak inne enzymy będą funkcjonować w różnych kontekstach biologicznych w porównaniu do SpCas9.
Aby wyjaśnić względną wydajność różnych systemów CRISPR-Cas, przeprowadziliśmy niedawno systematyczne porównanie pięciu endonukleaz Cas – SpCas9, enzymu Cas9 z Staphylococcus aureus (SaCas9), enzymu Cas9 z Neisseria meningitidis (NmCas9), enzymu Cas12a z Acidaminococcus sp. BV3L6 (AsCas12a) oraz enzymu Cas12a z bakterii Lachnospiraceae ND2006 (LbCas12a)25. Dla zapewnienia rzetelnego porównania, oceniliśmy poszczególne nukleazy Cas, wykorzystując ten sam zestaw miejsc docelowych oraz inne identyczne warunki eksperymentalne. Badanie to określiło również parametry projektowe dla każdego systemu CRISPR-Cas, które mogą służyć jako przydatny punkt odniesienia dla użytkowników tej technologii. W niniejszym opracowaniu, aby lepiej umożliwić badaczom wykorzystanie systemu CRISPR-Cas, przedstawiamy protokół krok po kroku dla optymalnej edycji genomu z użyciem różnych enzymów Cas9 i Cas12a (patrz Rycina 1). Protokół ten zawiera nie tylko szczegóły eksperymentalne, ale także istotne uwagi projektowe, mające na celu zmaksymalizowanie prawdopodobieństwa sukcesu edycji genomu w komórkach ssaków.
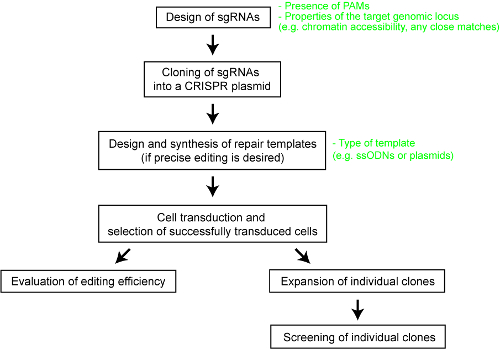
Rysunek 1: Przegląd schematu postępowania w celu generowania zmodyfikowanych linii komórkowych człowieka. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Projektowanie sgRNA
- Wybierz odpowiedni system CRISPR-Cas.
- Po pierwsze, sprawdź region docelowy pod kątem sekwencji PAM wszystkich nukleaz Cas9 i Cas12a, które wykazały funkcjonalność w komórkach ssaków16,21-32. Pięć często stosowanych enzymów wraz z ich odpowiednimi sekwencjami PAM przedstawiono w Tabeli 1.
UWAGA: Poza endonukleazami wymienionymi w Tabeli 1, istnieją inne, rzadziej stosowane enzymy Cas, które również zostały z powodzeniem wykorzystane w komórkach ssaków, takie jak nukleaza Cas9 z Streptococcus thermophilus (St1Cas9), która rozpoznaje PAM NNAGAAW. Jeśli pożądane miejsce docelowe nie zawiera znanej sekwencji PAM, system CRISPR-Cas nie będzie mógł zostać użyty do inżynierii genomu. - Po drugie, weź pod uwagę znane właściwości docelowego locus genomowego lub genu. Do właściwości, które należy rozważyć, należą poziomy ekspresji genów lub dostępność chromatyny, a także obecność innych blisko spokrewnionych sekwencji.
UWAGA: Niektóre enzymy są lepiej dostosowane do konkretnych kontekstów biologicznych. Na przykład w celu edycji powtarzalnego locus genomowego lub genu z kilkoma innymi bliskimi paralogami zaleca się stosowanie AsCas12a (ze względu na niższą tolerancję na niedopasowania między sgRNA a docelowym DNA niż w przypadku SpCas9 i LbCas12a) lub SaCas9 (ze względu na wymóg dłuższych spacerów, co zapewnia wyższą specyficzność celowania)25.
- Po pierwsze, sprawdź region docelowy pod kątem sekwencji PAM wszystkich nukleaz Cas9 i Cas12a, które wykazały funkcjonalność w komórkach ssaków16,21-32. Pięć często stosowanych enzymów wraz z ich odpowiednimi sekwencjami PAM przedstawiono w Tabeli 1.
| Endonukleaza Cas | PAM | Optymalna długość łącznika |
| SpCas9 | NGG | od 17 do 22 nt włącznie |
| SaCas9 | NNGRRT | ≥ 21 nt |
| NmCas9 | NNNNGATT | ≥ 19 nt |
| AsCas12a i LbCas12a | TTTV | ≥ 19 nt |
Tabela 1: Niektóre powszechnie stosowane enzymy Cas wraz z ich kognatywnymi sekwencjami PAM i optymalnymi długościami sgRNA. N = dowolny nukleotyd (A, T, G lub C); R = A lub G; V = A, C lub G.
- Wybierz odpowiednią sekwencję spacera. Zidentyfikuj sekwencję jak najbardziej unikalną, aby zminimalizować ryzyko zdarzeń cięcia poza celem (off-target), analizując genom docelowy za pomocą BLAST33 lub korzystając z kilku bezpłatnych narzędzi online, takich jak: (a) Program z laboratorium Feng Zhanga34 (http://crispr.mit.edu/); (b) CHOPCHOP35 (http://chopchop.cbu.uib.no/); (c) E-CRISP36 (http://www.e-crisp.org/E-CRISP/); (d) CRISPOR37 (http://crispor.tefor.net/); (e) Cas-OFFinder38 (http://www.rgenome.net/cas-offinder/).
UWAGA: Optymalna długość spacera może wynosić od 17 do 25 nukleotydów (nt) włącznie, w zależności od użytego enzymu Cas (patrz Tabela 1). W przypadku Cas9 spacer znajduje się powyżej (upstream) sekwencji PAM, natomiast dla Cas12a spacer znajduje się poniżej (downstream) PAM. Ponadto wydajność HDR gwałtownie spada wraz ze wzrostem odległości od miejsca cięcia. Dlatego w celu precyzyjnej edycji DNA należy umieścić sgRNA jak najbliżej zamierzonego miejsca modyfikacji. - Zsyntetyzuj oligonukleotydy DNA z odpowiednimi nawisami dla używanego plazmidu CRISPR.
- Dodaj nukleotyd G przed spacerem, jeśli pierwsza pozycja przewodnika nie jest nukleotydem G. Wyznacz sekwencję odwrotną komplementarną spacera. Dodaj niezbędne nawisy do celów klonowania.
UWAGA: Przykładowo, dla plazmidów użytych w naszym badaniu oceniającym25, oligonukleotydy do syntezy przedstawiono w Tabeli 2. W razie potrzeby kieruj się przykładem podanym na Rysunku 2. Wiele plazmidów CRISPR jest dostępnych z komercyjnych źródeł (np. Addgene). Niektóre z popularniejszych plazmidów wymieniono w Tabeli Materiałów.
- Dodaj nukleotyd G przed spacerem, jeśli pierwsza pozycja przewodnika nie jest nukleotydem G. Wyznacz sekwencję odwrotną komplementarną spacera. Dodaj niezbędne nawisy do celów klonowania.
| Plazmid CRISPR | Sekwencja |
| pSpCas9 i pSaCas9 | Sens: 5' - CACC(G)NNNNNNNNNNNNNNNNNNNNN - 3' Antysens: 3' - (C)NNNNNNNNNNNNNNNNNNNNNCAAA - 5' |
| pNmCas9 | Sens: 5' - CACC(G)NNNNNNNNNNNNNNNNNNNNN - 3' Antysens: 3' - (C)NNNNNNNNNNNNNNNNNNNNNCAAC - 5' |
| pAsCas12a i pLbCas12a | Sens: 5' - AGATNNNNNNNNNNNNNNNNNNNNN - 3' Antysens: 3' - NNNNNNNNNNNNNNNNNNNNNAAAA - 5' |
Tabela 2: Oligonukleotydy wymagane do klonowania sekwencji sgRNA do plazmidów CRISPR wykorzystanych w niedawnym badaniu ewaluacyjnym25. Nawisy są zapisane kursywą.
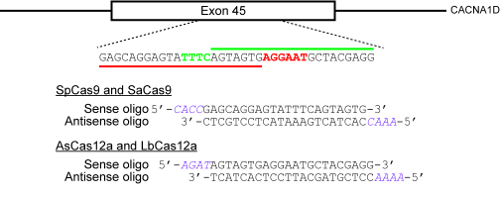
Rycina 2: Przykład ilustrujący sposób wyboru miejsc docelowych i projektowania oligonukleotydów do klonowania w plazmidach CRISPR. Docelowym locus genomicznym jest tutaj ekson 45 ludzkiego genu CACNA1D. Sekwencje PAM dla SpCas9 i SaCas9 to odpowiednio NGG i NNGRRT i są one zaznaczone na czerwono, natomiast PAM dla AsCas12a i LbCas12a to TTTN i jest zaznaczona na zielono. Czerwony poziomy pasek wskazuje protospacer dla SpCas9 i SaCas9, natomiast zielony poziomy pasek wskazuje protospacer dla dwóch enzymów Cas12a. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
2. Klonowanie oligonukleotydów do wektora szkieletowego
- Przeprowadź fosforylację i hybrydyzację oligonukleotydów sensownych i antysensownych.
- Jeśli oligonukleotydy są liofilizowane, rozpuść je do stężenia 100 µM w buforze TRIS-kwas etylenodiaminotetraoctowy (EDTA) (bufor TE, patrz Tabela materiałów) lub w ddH2O.
- Przygotuj 10 µL mieszaniny reakcyjnej zawierającej 1 µL oligonukleotydu sensownego, 1 µL oligonukleotydu antysensownego, 1 µL buforu do ligazy T4 DNA (10x), 1 µL kinazy polinukleotydowej T4 (PNK) oraz 6 µL ddH2O. Wymieszaj dokładnie pipetując i umieść mieszaninę w termocyklerze, stosując następujące parametry: 37 °C przez 30 min, 95 °C przez 5 min, a następnie schładzaj do 25 °C w tempie 6 °C/min.
- Rozcieńcz mieszaninę reakcyjną 1:100 w ddH2O (np. 2 µL mieszaniny reakcyjnej + 198 µL ddH2O).

Rysunek 3: Przykład plazmidu CRISPR. (a) Mapa wskazująca różne istotne elementy plazmidu. W tym przypadku promotor EF-1a steruje ekspresją Cas9, natomiast promotor U6 steruje ekspresją sgRNA. Amp(R) oznacza gen oporności na ampicylinę w plazmidzie. (b) Sekwencja „miejsca klonowania BbsI-BplI” w plazmidzie. Sekwencja rozpoznawania BbsI to GAAGAC i jest zaznaczona na czerwono, natomiast sekwencja rozpoznawania BplI to GAG-N5-CTC i jest zaznaczona na zielono. (c) Startery, które można wykorzystać do kolonialnej reakcji PCR w celu sprawdzenia, czy sekwencja sgRNA została pomyślnie sklonowana do plazmidu. Starter hU6_forward jest zaznaczony fioletową strzałką na mapie plazmidu, natomiast uniwersalny starter M13R(-20) jest zaznaczony różową strzałką na mapie plazmidu. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
- Przeprowadzić trawienie plazmidu CRISPR odpowiednim enzymem restrykcyjnym.
UWAGA: Klonowanie sgRNA opiera się zazwyczaj na assemblacji Golden Gate z wykorzystaniem enzymów restrykcyjnych typu IIs. W zależności od użytego plazmidu CRISPR można stosować różne enzymy. Dla pSpCas9 należy użyć BbsI lub BplI (patrz Rycina 3). Dla pSaCas9, pNmCas9, pAsCas12a i pLbCas12a należy użyć BsmBI.- Przygotować 20 µL mieszaniny reakcyjnej zawierającej 1 µg kolistego wektora plazmidowego, 2 µL buforu (10x), 1 µL enzymu restrykcyjnego (np. BbsI, BplI lub BsmBI) oraz ddH2O do uzyskania końcowej objętości 20 µL. Inkubować reakcję w temperaturze 37 °C przez 2,5 h.
- Dodać do reakcji 1 µL fosfataz alkalicznych z krewetek (SAP) i inkubować w 37 °C przez kolejne 30 min.
- Zatrzymać reakcję, dodając 5 µL 6x barwnika do ładowania DNA (patrz Tabela materiałów), wymieszać i rozdzielić produkty reakcji w 0,8% żelu agarozowym z użyciem 1x buforu TAE (tris-acetat-EDTA). Następnie wyciąć odpowiedni prążek i przeprowadzić oczyszczanie zżelowanego liniowego wektora.
- Ligować zdenaturowane oligonukleotydy do strawionego plazmidu CRISPR.
- Przygotować 10 µL mieszaniny reakcyjnej: 50 ng liniowego wektora, 1 µL rozcieńczonych zhybrydyzowanych oligonukleotydów, 1 µL buforu do ligazy T4 DNA (10x), 1 µL ligazy T4 DNA oraz ddH2O do uzyskania końcowej objętości 10 µL (patrz Tabela materiałów). Inkubować reakcję w 16 °C przez noc lub w temperaturze pokojowej przez 2 h.
UWAGA: Aby przyspieszyć proces ligacji, można użyć skoncentrowanej ligazy T4 DNA i inkubować mieszaninę reakcyjną w temperaturze pokojowej przez 15 min (patrz Tabela materiałów).
- Przygotować 10 µL mieszaniny reakcyjnej: 50 ng liniowego wektora, 1 µL rozcieńczonych zhybrydyzowanych oligonukleotydów, 1 µL buforu do ligazy T4 DNA (10x), 1 µL ligazy T4 DNA oraz ddH2O do uzyskania końcowej objętości 10 µL (patrz Tabela materiałów). Inkubować reakcję w 16 °C przez noc lub w temperaturze pokojowej przez 2 h.
- Transformować produkty ligacji do chemicznie kompetentnych komórek E. coli (patrz Plik uzupełniający 1). Wysiać transformowane komórki bakteryjne na płytki z agarem LB z dodatkiem 100 µg/mL ampicyliny.
- Przeprowadzić kolonialną reakcję łańcuchową polimerazy (PCR), aby zidentyfikować bakterie z insertem.
- Przygotować dwa zestawy sterylnych probówek PCR w paskach. Do zestawu 1 dodać 4,7 µL ddH2O, a do zestawu 2 dodać 50 µL pożywki LB z odpowiednim antybiotykiem (np. 100 µg/mL ampicyliny).
- Za pomocą sterylnego końcówki do pipety pobrać kolonię z płytki, krótko przenieść ją do probówki z zestawu 1, a następnie pozostawić końcówkę w probówce z zestawu 2. Powtórzyć czynność dla kilku kolonii, używając za każdym razem innych probówek PCR.
UWAGA: Zazwyczaj wystarczające jest przesiewanie czterech kolonii, jednak liczba ta może się różnić w zależności od wydajności klonowania. - Dodać następujące odczynniki do każdej probówki z zestawu 1 (dla reakcji PCR o objętości 10 µL): 5 µL 2x PCR master mix (z barwnikiem do ładowania, patrz Tabela materiałów), 0,15 µL oligonukleotydu sensownego lub antysensownego (100 µM), 0,15 µL primera (100 µM) celującego odpowiednio poniżej lub powyżej kasety sgRNA w plazmidzie CRISPR (patrz Rycina 3).
UWAGA: Produkt PCR powinien idealnie mieć wielkość około 150 bp lub więcej, aby pozytywne prążki nie zostały pomylone z dimerami primerów. - Przeprowadzić reakcje PCR w termocyklerze, stosując następujące parametry: 95 °C przez 3 min, 95 °C przez 30 s (krok 2), 60 °C przez 30 s (krok 3), 72 °C przez 30 s (krok 4), powtórzyć kroki 2‒4 przez kolejne 34 cykle, 72 °C przez 5 min, a następnie utrzymać w 4 °C.
UWAGA: Temperaturę przyłączania 60 °C może być konieczne zoptymalizować dla zaprojektowanych primerów. Czas elongacji 30 s może być również zmienny w zależności od przewidywanej wielkości amplikonu PCR i użytej polimerazy DNA. - Rozdzielić produkty reakcji w 1% żelu agarozowym z użyciem 1x buforu TAE.
- Zaszczepić kolonię, która dała pozytywny prążek w PCR, przenosząc 50 µL jej kultury z odpowiadającej jej probówki z zestawu 2 do większej probówki stożkowej zawierającej 5 mL LB z odpowiednim antybiotykiem. Pozostawić kulturę do wzrostu przez noc w inkubatorze z wytrząsaniem w temperaturze 37 °C.
- Wyizolować plazmidy z nocnej kultury za pomocą zestawu do miniprepu (patrz Tabela materiałów) i zsekwencjonować próbkę, używając primera z kolonialnego PCR, który nie jest oligonukleotydem sensownym ani antysensownym (hU6_forward lub M13R(-20) na Rycynie 3).
UWAGA: W razie potrzeby przeprowadzić maxiprep plazmidu CRISPR po weryfikacji sekwencji, aby uzyskać większą ilość materiału do dalszych eksperymentów.
3. Projektowanie i synteza matryc naprawczych
UWAGA: W przypadku precyzyjnej edycji genomu, wraz z odczynnikami CRISPR należy dostarczyć matrycę określającą pożądane modyfikacje DNA. Do niewielkich edycji DNA, takich jak zmiana pojedynczego nukleotydu, najodpowiedniejsze są matryce donorowe ssODN (patrz sekcja 3.1). Do większych edycji DNA, takich jak wstawienie znacznika GFP na końcu 5’ lub 3’ konkretnego genu kodującego białko, najodpowiedniejsze są plazmidowe matryce donorowe (patrz sekcja 3.2).
- Zaprojektuj i zsyntezuj matrycę donorową ssODN (patrz Rysunek 4).
- Określ prawidłową nić, której sekwencji powinna odpowiadać matryca.
UWAGA: Cas12a wykazuje preferencję dla ssODN o sekwencji nici nietargetowej, podczas gdy Cas9 wykazuje preferencję dla ssODN o sekwencji nici targetowej25 (patrz Rysunek 4a). - Upewnij się, że naprawiona sekwencja nie może być ponownie rozpoznana przez wybraną nukleazę Cas. Na przykład zmutuj PAM w taki sposób, aby nie spowodowało to zmiany aminokwasu, lub usuń PAM z matrycy donorowej, jeśli nie ma to konsekwencji funkcjonalnych. W razie potrzeby skorzystaj z przykładu podanego na Rysunku 4b jako wskazówki.
- Zdecyduj, czy pożądana jest symetryczna, czy asymetryczna matryca donorowa. W przypadku donorów symetrycznych upewnij się, że każde ramię homologii flankujące miejsce modyfikacji DNA ma co najmniej 17 nt długości25. W przypadku asymetrycznych matryc donorowych zastosuj dłuższe ramiona po stronie 5′ względem pożądanych zmian w DNA (patrz Rysunek 4a). Ważne jest, aby krótsze ramię miało długość około 37 nt, podczas gdy drugie ramię homologii powinno mieć długość około 77 nt25,39.
- Zsyntezuj zaprojektowaną matrycę jako fragment jednoniciowego DNA.
UWAGA: Asymetryczne ssODN mogą, choć nie zawsze, wykazywać wyższą wydajność HDR niż symetryczne ssODN. Zazwyczaj, przy prawidłowym zaprojektowaniu, donor asymetryczny działa co najmniej tak samo dobrze jak donor symetryczny. Jednak matryca asymetryczna jest znacznie droższa, ponieważ jest dłuższa i w związku z tym wymaga oczyszczania za pomocą elektroforezy w żelu poliakrylamidowym (PAGE) lub specjalnej procedury syntezy. Rutynowe nokauty genów zazwyczaj opierają się na szlaku naprawy NHEJ i nie wymagają matrycy naprawczej. Jeśli jednak wydajność nokautu jest niska, zaprojektuj matrycę donorową ssODN zawierającą mutację przesunięcia ramki odczytu o długości co najmniej 120 nt25,40.
- Określ prawidłową nić, której sekwencji powinna odpowiadać matryca.

Rycina 4: Projektowanie matryc donorowych ssODN. (a) Schemat ilustrujący różne możliwe warianty projektowania. Czerwone poziome prostokąty oznaczają niestandardową nić (NT), natomiast niebieskie prostokąty oznaczają nić docelową (T). Dodatkowo małe zielone prostokąty wskazują pożądane modyfikacje DNA (takie jak zmiany pojedynczych nukleotydów). W przypadku zastosowania symetrycznego ssODN minimalna długość każdego ramienia homologii powinna wynosić co najmniej 17 nt (ale może być dłuższa). Dla asymetrycznych ssODN matryca 37/77 T ssODN wydaje się optymalna dla HDR indukowanego przez SpCas9, podczas gdy 77/37 NT ssODN wydaje się optymalna dla HDR indukowanego przez Cas12a. L = lewe ramię homologii; R = prawe ramię homologii. (b) Konkretny przykład demonstrujący sposób projektowania matryc ssODN. W tym przypadku docelowym locus genomowym jest ekson 45 ludzkiego genu CACNA1D. PAM dla Cas9 jest zaznaczony na różowo i podkreślony, natomiast PAM dla Cas12a jest brązowy i podkreślony. Celem jest wprowadzenie mutacji missense (wyróżnionej na zielono) poprzez zamianę AGU (kodującego serynę) na AGG (kodujące argininę). Aby zapobiec ponownemu celowaniu przez Cas12a, sekwencja PAM TTTC zostaje zmutowana na CTTC. Należy zauważyć, że nie powoduje to zmiany aminokwasu (zarówno UAU, jak i UAC kodują tyrozynę). Aby dodatkowo zapobiec ponownemu celowaniu przez Cas9, kodon AGU zastąpiono kodonem UCC (pogrubiony), z których oba kodują serynę. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
- Zaprojektować i sklonować odpowiedni plazmid będący matrycą donora. Może on na przykład zawierać sekwencję GFP flankowaną długimi ramionami homologicznymi do docelowego locus genomowego (patrz Rysunek 5).
- Upewnić się, że zmodyfikowana sekwencja nie może być ponownie rozpoznana przez wybraną nukleazę Cas. Na przykład protospacer może zostać rozdzielony przez wstawiony znacznik (GFP). Alternatywnie, sekwencja PAM może zostać zmutowana lub usunięta z matrycy donora w sposób, który nie wpływa na funkcję genu.
- Namnożyć ramiona homologiczne z DNA genomowego za pomocą PCR. Długość każdego ramienia homologicznego wynosi zazwyczaj od 1000 do 1500 bp.
UWAGA: Aby ułatwić klonowanie, należy upewnić się, że starter forward dla lewego ramienia homologicznego oraz starter reverse dla prawego ramienia homologicznego posiadają sekwencję nakładającą się z wybranym szkieletem wektora o długości co najmniej 20 nt. Dodatkowo należy upewnić się, że starter reverse dla lewego ramienia homologicznego i starter forward dla prawego ramienia homologicznego posiadają również sekwencje nakładające się ze znacznikiem epitopowym. - Sklonować dwa ramiona homologiczne oraz znacznik (GFP) do szkieletu wektora, stosując metodę Gibson assembly41 (patrz Tabela materiałów). Zweryfikować plazmid za pomocą sekwencjonowania metodą Sangera, używając starterów forward i reverse znajdujących się odpowiednio powyżej i poniżej matrycy donora.
UWAGA: Sekwencjonowanie metodą Sangera jest powszechnie i tanio dostępne jako usługa komercyjna. Należy wysłać alikwot plazmidu wraz ze starterami do sekwencjonowania do dostawcy usług. - Zlinearyzować matrycę donora za pomocą enzymu restrykcyjnego, który przecina plazmid tylko raz, albo powyżej lewego ramienia homologicznego, albo poniżej prawego ramienia homologicznego.
UWAGA: Wykazano ostatnio, że donor z podwójnym cięciem, który jest flankowany przez sekwencje sgRNA-PAM i uwalniany z plazmidu po przecięciu przez odpowiednią nukleazę Cas, zwiększa wydajność HDR42. Gdy sekwencje sgRNA-PAM zostaną wstawione odpowiednio powyżej i poniżej lewego i prawego ramienia homologicznego (na przykład za pomocą Gibson assembly), długość ramienia homologicznego może zostać zredukowana do 300 bp i nie ma potrzeby linearyzacji plazmidu.
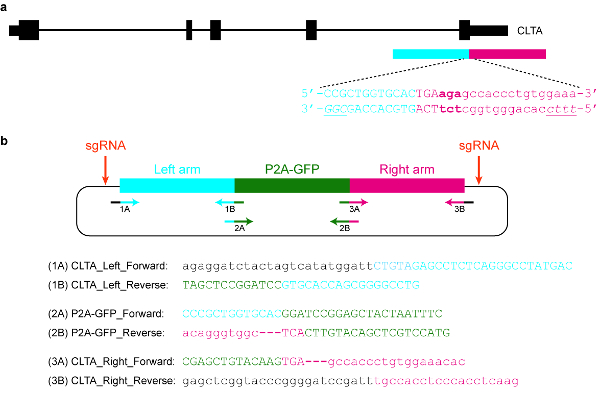
Rysunek 5: Projektowanie i klonowanie plazmidowej matrycy donorowej. (a) Celem w tym konkretnym przykładzie jest fuzja P2A-GFP z końcem C-terminalnym białka CLTA. Niebieski poziomy prostokąt oznacza lewe ramię homologii, natomiast czerwony poziomy prostokąt oznacza prawe ramię homologii. Wielkie litery oznaczają sekwencje kodujące białko, a małe litery oznaczają sekwencje niekodujące. Sekwencje PAM dla SpCas9 i Cas12a są zapisane kursywą i podkreślone. (b) Plazmidowa matryca donorowa, która może być użyta do endogennego znakowania P2A-GFP na końcu C-terminalnym CLTA. Podane sekwencje starterów mogą być wykorzystane do klonowania plazmidu metodą montażu Gibsona. Warunki PCR są następujące: 98 °C przez 3 min, 98 °C przez 30 s (krok 2), 63 °C przez 30 s (krok 3), 72 °C przez 1 min (krok 4), powtórzyć kroki 2‒4 przez kolejne 34 cykle, 72 °C przez 3 min i przechowywanie w 4 °C. Czarne litery odpowiadają sekwencjom wektora, niebieskie litery odpowiadają lewemu ramieniu homologii, zielone litery odpowiadają P2A-GFP, a czerwone litery odpowiadają prawemu ramieniu homologii. Należy zauważyć, że po pomyślnym zintegrowaniu sekwencji kodującej P2A-GFP w locus docelowym ponowne celowanie przez SpCas9 nie będzie możliwe, ponieważ nienaruszone pozostanie tylko 9 nt jego protospacera (GTGCACCAG). Ponadto, aby zapobiec ponownemu celowaniu przez Cas12a, trzy pary zasad bezpośrednio za kodonem STOP (pogrubione) zostały usunięte z sekwencji plazmidu. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
4. Transfekcja komórek
UWAGA: Pozostałe części protokołu zostały opracowane z myślą o komórkach HEK293T. Stosowane pożywka hodowlana składa się z Dulbecco Modified Eagle Medium (DMEM) uzupełnionego o 4,5 g/L glukozy, 10% płodowej surowicy bydlęcej (FBS), 2 mM L-glutaminy oraz 0,1% penicyliny/streptomycyny. Poszczególne etapy protokołu mogą wymagać modyfikacji w zależności od faktycznie użytej linii komórkowej. Wszystkie prace z kulturami komórkowymi są wykonywane w komorze z laminarnym przepływem powietrza klasy II (Biosafety Cabinet Class II), aby zapewnić sterylne warunki pracy.
- Na jeden dzień przed transfekcją wysiej 1,8 x 10⁵ komórek do 24-dołkowej płytki hodowlanej.
- Dysocjuj komórki poprzez odessanie medium, a następnie dodanie 150 µL 0,25% Trypsyny-EDTA do każdego dołka. Inkubuj komórki w temperaturze 37 °C przez 2 min.
- Zneutralizuj trypsynę, dodając 150 µL (lub 1x objętość) medium do hodowli komórek. Przenieś zawiesinę komórkową do probówki stożkowej. Odwiruj komórki w wirówce laboratoryjnej przy 1000 x g przez 5 min.
- Odsij nadsącz i resuspenduj komórki w 5 mL medium do hodowli komórek. Do oddzielnej probówki wirówkowej odmierz 10 µL 0,4% roztworu błękitu trypanu. Następnie dodaj 10 µL resuspendowanych komórek z kroku 4.1.2 i dokładnie wymieszaj.
- Pipetuj 10 µL mieszaniny (komórki + błękit trypanu) do hemocytometru. Przystąp do zliczenia komórek ręcznie lub za pomocą automatycznego licznika komórek.
- Wysiej 1,8 x 10⁵ komórek do jednego dołka 24-dołkowej płytki hodowlanej.
- Przygotuj mieszaninę do transfekcji zawierającą albo 500 ng plazmidu CRISPR (dla edycji zapośredniczonej przez NHEJ), albo 300 ng plazmidu CRISPR i 300 ng matrycy donorowej (dla edycji zapośredniczonej przez HDR), zgodnie z instrukcjami dołączonymi do odczynnika do transfekcji (patrz Tabela materiałów). Inkubuj w temperaturze pokojowej przez zalecany czas (zazwyczaj około 10‒20 min).
- Dodawaj mieszaninę do transfekcji do komórek kroplami, a następnie delikatnie zakręć płytką.
- Inkubuj w temperaturze 37 °C w nawilżonym inkubatorze z 5% CO2 przez 24 h (dla eksperymentów opartych na NHEJ) lub 72 h (dla eksperymentów opartych na HDR).
5. Sortowanie komórek metodą FACS (fluorescence activated cell sorting) z transfected cells
- Zdysocjuj komórki, odsysając pożywkę, a następnie dodając 150 µL 0,25% trypsyny-EDTA na każdą studzienkę. Inkubuj komórki w temperaturze 37 °C przez 2 min.
- Zneutralizuj trypsynę, dodając 150 µL (lub 1x objętość) pożywki do hodowli komórkowej. Przenieś zawiesinę komórkową do probówki wirówkowej. Odwiruj komórki w mikrowirówce przy 235 x g przez 5 min.
- Odsyj supernatant i resuspenderuj komórki w 2% płodowej surowicy bydlęcej (FBS) w soli fizjologicznej z buforem fosforanowym (PBS). Przefiltruj komórki przez siatkę o oczkach 30 µm lub sitko do komórek do probówki FACS o pojemności 5 mL.
- Przygotuj inną probówkę wirówkową z około 100 µL pożywki hodowlanej lub 2% FBS w PBS do zbierania komórek.
- Na cytometrze przepływowym wyznacz bramkę dla komórek, używając komórek nietransfekowanych jako kontroli negatywnej. Posortuj i zbierz komórki transfekowane, w zależności od tego, który marker fluorescencyjny znajduje się na użytym plazmidzie CRISPR. Na przykład, jeśli plazmid niesie gen mCherry, sortuj komórki RFP-dodatnie.
UWAGA: Różne plazmidy CRISPR będą posiadać różne markery selekcyjne. Zestaw plazmidów (pSpCas9, pSaCas9, pNmCas9, pAsCpf1 i pLbCpf1) użyty w ninzym badaniu ewaluacyjnym niesie albo pomarańczowe białko fluorescencyjne (OFP), albo gen mCherry.
6. Ekspansja poszczególnych klonów
- Odwirować posortowane komórki w wirówce stołowej z maksymalną prędkością (18,000 x g) przez 5 min. Odessać nadsącz i resuspender osad w 300 µL pożywki hodowlanej. Przesiać 200 µL zawiesiny komórek do 24-dołkowej płytki do hodowli tkanek i pozostawić do regeneracji przez kilka dni w inkubatorze w temperaturze 37 °C. Pozostałe 100 µL komórek zachować do sekcji 7.
- Gdy komórki zaczną osiągać konfluencję, przeprowadzić pasaż zgodnie z krokami 4.1.1‒4.1.3. Przesiać komórki rzadko do 100 mm naczynia do hodowli tkanek, aby zapewnić wystarczającą przestrzeń do wzrostu poszczególnych kolonii. Inkubować w temperaturze 37 °C w nawilżonym inkubatorze z 5% CO2.
UWAGA: Należy wypróbować różne rozcieńczenia. Pojedyncze komórki potrzebują wystarczającej przestrzeni, aby rosnąć jako oddzielne kolonie. Jednocześnie nie mogą być zbyt rzadko rozsiane, ponieważ niektóre linie komórkowe nie rosną dobrze, gdy liczba komórek jest zbyt mała. - Gdy zaczną formować się kolonie, pobrać je pod mikroskopem (przy powiększeniu 4x) i umieścić każdy klon w oddzielnym dołku 24-dołkowej płytki zawierającej pożywkę do hodowli komórkowej. Inkubować w temperaturze 37 °C w nawilżonym inkubatorze z 5% CO2 aż do momentu, gdy komórki zaczną osiągać konfluencję.
UWAGA: Alternatywą dla rozcieńczeń szeregowych i pobierania kolonii jest wykorzystanie cytometrii przepływowej do sortowania pojedynczych komórek do płytki 96-dołkowej. Może to jednak nie przynieść efektów w przypadku niektórych linii komórkowych, które nie rosną dobrze przy obecności tylko jednej komórki.
7. Ocena wydajności edycji
- Wyekstrahuj DNA genomowe, odwirugując pozostałe 100 µL posortowanych komórek (z kroku 6.1) w wirówce laboratoryjnej z maksymalną prędkością (18,000 x g) przez 5 min. Odessij nadsącz i przystąp do izolacji DNA genomowego przy użyciu zestawu do ekstrakcji (patrz Tabela materiałów).
- Wykonaj test cięcia endonukleazą T7 I (T7EI) (patrz Rycina 6).
- Przygotuj 50 µL reakcji PCR zawierającej 10 µL buforu do reakcji PCR (5x), 1 µL mieszaniny dNTP (10 mM), 2,5 µL zdefiniowanego przez użytkownika primera forward (10 µM), 2,5 µL zdefiniowanego przez użytkownika primera reverse (10 µM), 0,5 µL polimerazy DNA, 2‒5 µL matrycy DNA genomowego (w zależności od liczby posortowanych komórek), a następnie uzupełnij do 50 µL wodą ddH2O (patrz Tabela materiałów).
UWAGA: Primery są zaprojektowane tak, aby flankować docelowy locus genomowy i dawać produkt PCR o długości około 400‒700 bp. Zazwyczaj jeden primer jest umieszczony bliżej miejsca cięcia enzymu Cas niż drugi primer, tak aby wynikiem testu T7EI były dwa wyraźne prążki na żelu agarozowym (patrz Rycina 6). - Przeprowadź PCR w termocyklerze z następującymi parametrami: 98 °C przez 3 min, 98 °C przez 30 s (krok 2), 63 °C przez 30 s (krok 3), 72 °C przez 30 s (krok 4), powtórz kroki 2‒4 przez kolejne 34 cykle, 72 °C przez 2 min, a następnie utrzymuj w 4 °C.
- Rozdziel produkt reakcji na 2% żelu agarozowym przy użyciu buforu 1x TAE.
- Wytnij produkt PCR z żelu za pomocą czystego, ostrego skalpela i oczyść DNA przy użyciu zestawu do ekstrakcji z żelu, zgodnie z instrukcjami producenta. Zmierz stężenie produktu PCR za pomocą spektrofotometru przy długości fali absorbancji 260 nm (patrz Tabela materiałów).
- Przygotuj mieszaninę do testu zawierającą 200 ng DNA, 2 µL buforu do reakcji T7EI (10x) i uzupełnij do 19 µL wodą ddH2O (patrz Tabela materiałów).
- Ponownie zdenaturuj i wyżarzuj produkt PCR w termocyklerze, stosując następujące parametry: 95 °C przez 5 min, obniżaj temperaturę do 25 °C w tempie 6 °C/min, a następnie utrzymuj w 4 °C.
- Dodaj 5 U T7EI do ponownie wyżarzowanego produktu PCR, wymieszaj dokładnie pipetując i inkubuj w 37 °C przez 50 min.
- Rozdziel DNA trawione T7EI na 2,5% żelu agarozowym przy użyciu buforu 1x TAE.
- Wykonaj obrazowanie żelu, określ ilościowo intensywność prążków za pomocą programu ImageJ i oblicz wskaźnik tworzenia indeli, korzystając z następującego wzoru:
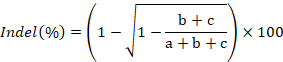
gdzie a reprezentuje intensywność nienaruszonego produktu PCR, a b i c odpowiadają intensywnościom produktów cięcia43.- Aby określić ilościowo intensywność prążka w programie ImageJ, najpierw narysuj prostokąt wokół prążka, jak najbliżej jego krawędzi. Po drugie, kliknij Analyze, a następnie Set Measurements. Upewnij się, że opcje area, mean gray value oraz integrated density są zaznaczone. Wyjdź z okna ustawień, klikając ok. Po trzecie, kliknij Analyze, a następnie Measure. Wartość mean lub RawIntDen jest używana jako intensywność prążka.
- Przygotuj 50 µL reakcji PCR zawierającej 10 µL buforu do reakcji PCR (5x), 1 µL mieszaniny dNTP (10 mM), 2,5 µL zdefiniowanego przez użytkownika primera forward (10 µM), 2,5 µL zdefiniowanego przez użytkownika primera reverse (10 µM), 0,5 µL polimerazy DNA, 2‒5 µL matrycy DNA genomowego (w zależności od liczby posortowanych komórek), a następnie uzupełnij do 50 µL wodą ddH2O (patrz Tabela materiałów).

Rysunek 6: Weryfikacja pomyślnych wyników edycji genomu w komórkach. (a) Schemat ilustrujący dwa powszechnie stosowane testy: test cięcia niedopasowań z zastosowaniem enzymu endonukleazy T7 I (T7EI) oraz sekwencjonowanie następnej generacji (NGS) lub ukierunkowane sekwencjonowanie amplikonów. Niebieskie poziome prostokąty oznaczają DNA, a żółte kółka wskazują modyfikacje wywołane przez system CRISPR-Cas. Primery do testu T7E1 oznaczone są kolorem zielonym, natomiast primery do generowania amplikonów do NGS – kolorem czerwonym. (b) Projekt sekwencji primerów do testu cięcia T7EI oraz do NGS. W tym przypadku docelowym locus genomowym jest egzon 45 ludzkiego genu CACNA1D. Planowane miejsce modyfikacji zaznaczono gwiazdką. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
- Przeprowadź ukierunkowane sekwencjonowanie amplikonów (patrz Rysunek 6).
- Zaprojektuj startery PCR do amplifikacji docelowego locus genomowego. Jeden z starterów umieść w odległości mniejszej niż 100 bp, ale większej niż 20 bp od protospacera.
UWAGA: Zazwyczaj całkowity rozmiar produktu PCR projektuje się na około 150‒300 bp (patrz Rysunek 6). - Do starterów dołącz dodatkowe sekwencje w następujący sposób: (a) 5’‒GCGTTATCGAGGTC-NNNN-[Forward Primer] – 3’; (b) 5’ - GTGCTCTTCCGATCT-[Reverse Primer]–3’.
- Przygotuj 50 µL mieszaniny reakcyjnej PCR zawierającej 10 µL buforu do reakcji PCR (5x), 1 µL dNTP (10 mM), 5 µL startera a (10 µM), 5 µL startera b (10 µM), 0.5 µL polimerazy DNA, 2‒5 µL matrycy DNA genomowego (zależnie od liczby posortowanych komórek), a następnie uzupełnij do 50 µL wodą ddH20.
- Przeprowadź PCR w termocyklerze z następującymi parametrami: 98 °C przez 3 min, 98 °C przez 30 s (krok 2), 63 °C przez 30 s (krok 3), 72 °C przez 15 s (krok 4), powtórz kroki 2‒4 przez kolejne 34 cykle, 72 °C przez 2 min i inkubuj w 4 °C.
- Rozdziel produkt reakcji w 2% żelu agarozowym i oczyść produkt PCR za pomocą zestawu do ekstrakcji z żelu zgodnie z instrukcjami producenta. Oznacz ilość DNA za pomocą spektrofotometru przy długości fali 260 nm (patrz Tabela materiałów).
- Zsyntetyzuj następujące startery do drugiej rundy PCR: (c) 5’‒ AATGATACGGCGACCACCGAGATCTACACCCTACACGAGCGTTATCGAGGTC–3’; (d) 5’‒CAAGCAGAAGACGGCATACGAGAT-[barcode]-GTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT–3’
- Przygotuj 20 µL mieszaniny reakcyjnej PCR zawierającej 4 µL buforu do reakcji PCR (5x), 0.4 µL dNTP (10 mM), 2 µL startera c (10 µM), 2 µL startera d (10 µM), 0.2 µL polimerazy DNA, 2 µL matrycy DNA (z kroku 7.3.5, rozcieńczonej 1:100) oraz 9.4 µL ddH2O.
UWAGA: Współczynnik rozcieńczenia matrycy DNA może się różnić w zależności od jej pierwotnego stężenia. Jeśli stężenie wynosi około 20‒40 ng/µL, zastosuj rozcieńczenie 1:100. Ponadto dla każdej próbki eksperymentalnej wybierz inny kod kreskowy (barcode), jeżeli w kroku 7.3.3 użyto tych samych starterów a i b. - Przeprowadź PCR w termocyklerze z następującymi parametrami: 98 °C przez 3 min, 98 °C przez 30 s (krok 2), 65 °C przez 30 s (krok 3), 72 °C przez 30 s (krok 4), powtórz kroki 2‒4 przez kolejne 14 cykli, 72 °C przez 2 min i inkubuj w 4 °C.
- Naniesienie 5 µL każdej reakcji na 2% żel agarozowy w celu sprawdzenia powodzenia reakcji PCR. Połącz wszystkie próbki (zakładając, że dla każdej próbki użyto innego kodu kreskowego) i oczyść połączony DNA za pomocą zestawu do oczyszczania PCR zgodnie z instrukcjami producenta. Jeśli niektóre reakcje PCR wykazują więcej niż jeden prążek (co wskazuje na obecność produktów nieswoistych), przeprowadź dodatkowy etap ekstrakcji z żelu.
- Wykonaj sekwencjonowanie biblioteki na urządzeniu do sekwencjonowania wysokoprzepustowego (patrz Tabela materiałów) zgodnie z instrukcjami producenta, aby uzyskać sparowane odczyty o długości 151 bp. Starter sekwencjonujący dla odczytu 1 jest projektowany specjalnie i musi zostać dostarczony osobno. Jego sekwencja to: Read1_seq: 5’–CCACCGAGATCTACACCCTACACGAGCGTTATCGAGGTC–3’. Starter sekwencjonujący dla odczytu 2 oraz starter sekwencjonujący indeks są standardowe i znajdują się w kartridżu z odczynnikami.
UWAGA: Test T7EI oraz ukierunkowane sekwencjonowanie amplikonów są powszechnie stosowane do sprawdzania wydajności edycji genomu. Jednak w zależności od rodzaju wprowadzonych modyfikacji DNA można przeprowadzić inne doświadczenia w celu oceny wydajności edycji. Na przykład, jeśli w miejscu docelowym powstanie miejsce restrykcyjne, można przeprowadzić analizę polimorfizmu długości fragmentów restrykcyjnych (RFLP). Jest ona podobna do testu T7EI, z tą różnicą, że do trawienia produktu PCR używa się endonukleazy restrykcyjnej.
- Zaprojektuj startery PCR do amplifikacji docelowego locus genomowego. Jeden z starterów umieść w odległości mniejszej niż 100 bp, ale większej niż 20 bp od protospacera.
8. Przesiewanie poszczególnych klonów
- Zgodnie z krokiem 6.3, rozdziel komórki w momencie, gdy zaczną stawać się konfluentne. Dla każdego pojedynczego klonu zbierz pozostałe komórki i wyizoluj genomiczne DNA zgodnie z krokiem 7.1.
- Wykonaj test T7EI dla wszystkich pojedynczych klonów zgodnie z sekcją 7.2, z jedną modyfikacją. Namnóż docelowy locus genomiczny z komórek typu dzikiego a w kroku 7.2.5, zamiast używać wyłącznie 200 ng DNA testowego, zmieszaj 100 ng DNA testowego z 100 ng DNA typu dzikiego.
UWAGA: Powodem modyfikacji tego kroku jest fakt, że niektóre klony mogły przejść pomyślną konwersję bialleliczną i są mutantami homozygotycznymi. W takich przypadkach w teście T7EI nie pojawi się prążek cięcia, jeśli nie zostanie dodane DNA typu dzikiego. - Wykonaj sekwencjonowanie miejsca docelowego w klonach, które wykazują prążki cięcia w teście T7EI.
- Namnóż zmodyfikowany locus genomiczny zgodnie z krokami 7.2.1–7.2.4.
- Przygotuj następującą reakcję klonowania: 4 µL produktu PCR, 1 µL roztworu soli, 1 µL wektora TOPO (patrz Tabela materiałów).
- Wymieszaj delikatnie za pomocą pipety i inkubuj w temperaturze pokojowej przez co najmniej 5 min.
- Przenieś 3 µL mieszaniny reakcyjnej do chemicznie kompetentnych komórek E. coli (takich jak TOP10 lub Stbl3) (patrz Plik uzupełniający 1). Wysiej przekształcone komórki bakteryjne na płytkę z agarem LB z dodatkiem 50 μg/mL kanamycyny.
- Następnego dnia zaszczep co najmniej 10 kolonii w płynnej pożywce LB zawierającej 50 μg/mL kanamycyny.
- Gdy kultury bakteryjne staną się mętne, wyizoluj plazmidy za pomocą zestawu do miniprep (patrz Tabela materiałów) i zsekwencjonuj je, używając standardowego primera M13 forward lub M13 reverse.
- Wykonaj western blot (znany również jako immunoblot), aby określić brak lub obecność docelowego białka (jeśli eksperyment edycji genomu polega na znokautowaniu genu kodującego białko poprzez mutacje przesuwające ramkę odczytu). Patrz Plik uzupełniający 1.
UWAGA: Można przeprowadzić inne eksperymenty w celu zidentyfikowania klonu posiadającego pożądane modyfikacje genomiczne. Na przykład można przeprowadzić test fenotypowy, jeśli wiadomo, że znokautowanie konkretnego genu powoduje określone zmiany w zachowaniu komórek.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Aby przeprowadzić eksperyment edycji genomu, należy sklonować plazmid CRISPR wykazujący ekspresję sgRNA skierowanego do badanego locus. W pierwszej kolejności plazmid jest trawiony enzymem restrykcyjnym (zazwyczaj enzymem typu IIs) w celu jego linearyzacji. Zaleca się rozdzielenie produktu trawienia w 1% żelu agarozowym wraz z nietrawionym plazmidem, aby odróżnić trawienie całkowite od częściowego. Ponieważ nietrawione plazmidy są superzwinięte, mają one tendencję do szybszej migracji niż ich liniowe odpowiedniki (patrz ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
System CRISPR-Cas to potężna, rewolucyjna technologia inżynierii genomów i transkryptomów roślin i zwierząt. Stwierdzono, że wiele gatunków bakterii zawiera systemy CRISPR-Cas, które mogą być potencjalnie przystosowane do celów inżynierii genomu i transkryptomu44. Chociaż endonukleaza Cas9 ze Streptococcus pyogenes (SpCas9) była pierwszym enzymem, który został z powodzeniem zastosowany w komórkach ludzkich 21,22,23,24, wykazano również, że enzymy z innych gatunków bakterii, w tym te pokaz...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają konkurencyjnych interesów finansowych.
Podziękowania
M.H.T. jest wspierany przez grant Biura Wspólnej Rady Agencji ds. Nauki, Technologii i Badań (1431AFG103), grant Narodowej Rady Badań Medycznych (OFIRG/0017/2016), granty National Research Foundation (NRF2013-THE001-046 i NRF2013-THE001-093), grant Ministerstwa Edukacji Tier 1 (RG50/17 (S)), grant na rozpoczęcie działalności z Uniwersytetu Technologicznego Nanyang oraz fundusze na konkurs International Genetically Engineering Machine (iGEM) od Nanyang Technological Uniwersytet.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Kinaza polinukleotydowa T4 (PNK) | NEB | M0201 | |
| Fosfataza alkaliczna krewetek (rSAP) | NEB | M0371 | |
| Bufor tris-octano-EDTA (TAE), 50X | 1st Base | BUF-3000-50X4L | Rozcieńczyć do 1X przed użyciem. Roztwór 1X zawiera 40 mM Tris, 20 mM kwasu octowego i 1 mM EDTA. |
| Bufor Tris-EDTA (TE), 10X | 1st Base | BUF-3020-10X4L | Rozcieńczyć do 1X przed użyciem. Roztwór 1X zawiera 10 mM Tris (pH 8,0) i 1 mM EDTA. |
| BbsI | NEB | R0539 | |
| BsmBI | NEB | R0580 | |
| T4 Ligaza DNA | NEB | M0202 | 400 000 jednostek/ml |
| Zestaw do szybkiego ligowania | NEB | M2200 | Alternatywa dla ligazy DNA T4. |
| Zestaw do szybkiej ligacji DNA | Thermo Scientific | K1423 | Alternatywa dla ligazy DNA T4. |
| Zestaw do klonowania Zero Blunt TOPO PCR | Thermo Scientific | 451245 | Roztwór soli jest dostarczany z wektorem TOPO w zestawie. |
| NEBuilder HiFi DNA Assembly Master Mix | NEB | E2621L | Zestaw do montażu Gibsona. |
| One Shot Stbl3 Chemicznie kompetentny bulion E.Coli | Thermo Scientific | C737303 | |
| LB (Lennox), proszek | Sigma Aldrich | L3022 | Rozpuszcza w ddH20 i autoklaw przed użyciem |
| Bulion z agarem (Lennox), proszek | Sigma Aldrich | L2897 | Rozpuszcza w ddH20 i autoklaw przed użyciem |
| SOC | - | 2,5 mM KCl, 10 mM MgCl2, 20 mM glukozy w 1 l bulionu LB | |
| Ampicylina (sód), USP | Grade Gold Biotechnology | A-301 | |
| REDiant 2X PCR Mastermix | 1st Base | BIO-5185 | |
| Agaroza | 1st Base | BIO-1000 | |
| T7 Endonukleaza I | NEB | M0302 | |
| Zestaw miniprep do ekstrakcji plazmidowego DNA | Favorgen | FAPDE 300 | |
| Zmodyfikowana pożywka Dulbecco's Eagle (DMEM), hyklon o wysokiej zawartości glukozy | SH30081,01 | 4,5 g / l glukozy, bez L-glutaminy, HEPES i pirogronianu sodu | |
| L-glutamina, 200mM | Gibco | 25030 | |
| Penicylina-Streptomycyna, 10, 000U/ml | Gibco | 15140 | |
| 0,25% trypsyna-EDTA, 1X | Gibco | 25200 | |
| Bydło płodowe Serum | Hyclone | SV30160 | FBS jest inaktywowane termicznie przed użyciem w temperaturze 56 oC przez 30 minut |
| Sól fizjologiczna buforowana fosforanami, 1X | odczynnik | 20012 | |
| jetPRIME | Polyplus Transfection | 114-75 | |
| Roztwór do ekstrakcji DNA QuickExtract, 1,0 | Epicentrum | LUCG-QE09050 | |
| Zestaw do genomowego DNA ISOLATE II | Bioline | BIO-52067 | Alternatywa dla QuickExtract |
| Q5 High-Fidelity DNA Polymeraza | NEB | M0491 | |
| Deoxynukleotyd (dNTP) Mieszanina roztworów | NEB | N0447 | |
| 6X Barwnik ładujący DNA | Thermo Scientific | R0611 | 10 mM Tris-HCl (pH 7,6) 0,03% błękitu bromofenolowego, 0,03% cyjanolu ksylenu FF, 60% glicerolu, 60 mM |
| Koktajl inhibitorów proteazy EDTA, Set3 | Merck | ||
| Membrana nitrocelulozowa, 0,2 i mikro; m | Bio-Rad | 1620112 | |
| Bufor Tris-glycine-SDS, 10X | Bio-Rad | 1610772 | Rozcieńczyć do 1X przed użyciem. Roztwór 1x zawiera 25 mM Tris, 192 mM glicyny i 0,1% SDS. |
| Bufor tris-glicynowy, 10X | 1st base | BUF-2020 | Rozcieńczyć do 1X przed użyciem. Roztwór 1x zawiera 25 mM Tris i 192 mM glicyny. |
| Ponceau S roztwór | Sigma Aldrich | P7170 | |
| TBS, 20X | 1st base | BUF-3030 | Rozcieńczyć do 1X przed użyciem. 1x roztwór zawiera 25 mM Tris-HCl (pH 7,5) i 150 mM NaCl. |
| Tween 20 | Sigma Aldrich | P9416 | |
| Odtłuszczone mleko do testu immunologicznego | Nacalai Tesque | 31149-75 | |
| WesternBright Sirius-femtogram HRP | Advansta | K12043 | |
| Przeciwciało dla β-aktyny (C4) | Santa Cruz Biotechnology | sc-47778 | Numer partii: C0916 |
| System MiSeq | Illumina | SY-410-1003 | |
| Spektrofotometr NanoDrop | Thermo Scientific | ND-2000 | |
| Fluorometr kubitowy | Thermo Scientific | Q33226 | |
| EVOS FL System obrazowania komórek | Thermo Scientific | AMF4300 | |
| Plazmid CRISPR: pSpCas9(BB)-2A-GFP (PX458) | Addgene | 48138 | System pojedynczego wektora: gRNA ulega ekspresji z tego samego plazmidu. |
| Plazmid CRISPR: pX601-AAV-CMV::NLS-SaCas9-NLS-3xHA-bGHpA | Addgene | 61591 | System pojedynczego wektora: gRNA ulega ekspresji z tego samego plazmidu. |
| Plazmid CRISPR: xCas9 3.7 | Addgene | 108379 | System podwójnego wektora: gRNA ulega ekspresji z innego plazmidu. |
| Plazmid CRISPR: pX330-U6-Chimeric_BB-CBh-hSpCas9 | Addgene | 42230 | System pojedynczych wektorów: gRNA ulega ekspresji z tego samego plazmidu. |
| Plazmid CRISPR: hCas9 | Addgene | 41815 | System podwójnego wektora: gRNA ulega ekspresji z innego plazmidu. |
| Plazmid CRISPR: eSpCas9(1.1) | Addgene | 71814 | System pojedynczego wektora: gRNA ulega ekspresji z tego samego plazmidu. |
| Plazmid CRISPR: VP12 (SpCas9-HF1) | Addgene | 72247 | System dwuwektorowy: gRNA ulega ekspresji z innego plazmidu. |
Bibliografia
- Epinat, J. C., et al. A novel engineered meganuclease induces homologous recombination in yeast and mammalian cells. Nucleic Acids Research. 31 (11), 2952-2962 (2003).
- Arnould, S., et al. Engineered I-CreI derivatives cleaving sequences from the human XPC gene can induce highly efficient gene correction in mammalian cells. Journal of Molecular Biology. 371 (1), 49-65 (2007).
- Chapdelaine, P., Pichavant, C., Rousseau, J., Paques, F., Tremblay, J. P. Meganucleases can restore the reading frame of a mutated dystrophin. Gene Therapy. 17 (7), 846-858 (2010).
- Carroll, D. Genome engineering with zinc-finger nucleases. Genetics. 188 (4), 773-782 (2011).
- Urnov, F. D., Rebar, E. J., Holmes, M. C., Zhang, H. S., Gregory, P. D. Genome editing with engineered zinc finger nucleases. Nature Reviews Genetics. 11 (9), 636-646 (2010).
- Miller, J. C., et al. A TALE nuclease architecture for efficient genome editing. Nature Biotechnology. 29 (2), 143-148 (2011).
- Zhang, F., et al. Efficient construction of sequence-specific TAL effectors for modulating mammalian transcription. Nature Biotechnology. 29 (2), 149-153 (2011).
- Boch, J., et al. Breaking the code of DNA binding specificity of TAL-type III effectors. Science. 326 (5959), 1509-1512 (2009).
- Moscou, M. J., Bogdanove, A. J. A simple cipher governs DNA recognition by TAL effectors. Science. 326 (5959), 1501(2009).
- Hsu, P. D., Lander, E. S., Zhang, F. Development and applications of CRISPR-Cas9 for genome engineering. Cell. 157 (6), 1262-1278 (2014).
- Sander, J. D., Joung, J. K. CRISPR-Cas systems for editing, regulating and targeting genomes. Nature Biotechnology. 32 (4), 347-355 (2014).
- Jinek, M., et al. A programmable dual-RNA-guided DNA endonuclease in adaptive bacterial immunity. Science. 337 (6096), 816-821 (2012).
- Nishimasu, H., et al. Crystal structure of Cas9 in complex with guide RNA and target DNA. Cell. 156 (5), 935-949 (2014).
- Yamano, T., et al. Crystal Structure of Cpf1 in Complex with Guide RNA and Target DNA. Cell. 165 (4), 949-962 (2016).
- Swarts, D. C., Mosterd, C., van Passel, M. W., Brouns, S. J. CRISPR interference directs strand specific spacer acquisition. PLoS One. 7 (4), e35888(2012).
- Zetsche, B., et al. Cpf1 is a single RNA-guided endonuclease of a class 2 CRISPR-Cas system. Cell. 163 (3), 759-771 (2015).
- Sternberg, S. H., Redding, S., Jinek, M., Greene, E. C., Doudna, J. A. DNA interrogation by the CRISPR RNA-guided endonuclease Cas9. Nature. 507 (7490), 62-67 (2014).
- Hu, J. H., et al. Evolved Cas9 variants with broad PAM compatibility and high DNA specificity. Nature. 556 (7699), 57-63 (2018).
- Kleinstiver, B. P., et al. Broadening the targeting range of Staphylococcus aureus CRISPR-Cas9 by modifying PAM recognition. Nature Biotechnology. 33 (12), 1293-1298 (2015).
- Kleinstiver, B. P., et al. Engineered CRISPR-Cas9 nucleases with altered PAM specificities. Nature. 523 (7561), 481-485 (2015).
- Cong, L., et al. Multiplex genome engineering using CRISPR/Cas systems. Science. 339 (6121), 819-823 (2013).
- Mali, P., et al. RNA-guided human genome engineering via Cas9. Science. 339 (6121), 823-826 (2013).
- Jinek, M., et al. RNA-programmed genome editing in human cells. Elife. 2, e00471(2013).
- Cho, S. W., Kim, S., Kim, J. M., Kim, J. S. Targeted genome engineering in human cells with the Cas9 RNA-guided endonuclease. Nature Biotechnology. 31 (3), 230-232 (2013).
- Wang, Y., et al. Systematic evaluation of CRISPR-Cas systems reveals design principles for genome editing in human cells. Genome Biology. 19 (1), 62(2018).
- Ran, F. A., et al. In vivo genome editing using Staphylococcus aureus Cas9. Nature. 520 (7546), 186-191 (2015).
- Hou, Z., et al. Efficient genome engineering in human pluripotent stem cells using Cas9 from Neisseria meningitidis. Proceedings of the National Academy of Sciences U S A. 110 (39), 15644-15649 (2013).
- Kim, E., et al. In vivo genome editing with a small Cas9 orthologue derived from Campylobacter jejuni. Nature Communications. 8, 14500(2017).
- Edraki, A., et al. A Compact, High-Accuracy Cas9 with a Dinucleotide PAM for In Vivo Genome Editing. Molecular Cell. , (2018).
- Chatterjee, P., Jakimo, N., Jacobson, J. M. Minimal PAM specificity of a highly similar SpCas9 ortholog. Science Advances. 4 (10), (2018).
- Muller, M., et al. Streptococcus thermophilus CRISPR-Cas9 Systems Enable Specific Editing of the Human Genome. Mol Therapy. 24 (3), 636-644 (2016).
- Esvelt, K. M., et al. Orthogonal Cas9 proteins for RNA-guided gene regulation and editing. Nature Methods. 10 (11), 1116-1121 (2013).
- Boratyn, G. M., et al. BLAST: a more efficient report with usability improvements. Nucleic Acids Research. 41 (Web Server issue), W29-W33 (2013).
- Hsu, P. D., et al. DNA targeting specificity of RNA-guided Cas9 nucleases. Nature Biotechnology. 31 (9), 827-832 (2013).
- Montague, T. G., Cruz, J. M., Gagnon, J. A., Church, G. M., Valen, E. CHOPCHOP: a CRISPR/Cas9 and TALEN web tool for genome editing. Nucleic Acids Research. 42 (Web Server issue), W401-W407 (2014).
- Heigwer, F., Kerr, G., Boutros, M. E-CRISP: fast CRISPR target site identification. Nature Methods. 11 (2), 122-123 (2014).
- Haeussler, M., et al. Evaluation of off-target and on-target scoring algorithms and integration into the guide RNA selection tool CRISPOR. Genome Biology. 17 (1), 148(2016).
- Bae, S., Park, J., Kim, J. S. Cas-OFFinder: a fast and versatile algorithm that searches for potential off-target sites of Cas9 RNA-guided endonucleases. Bioinformatics. 30 (10), 1473-1475 (2014).
- Richardson, C. D., Ray, G. J., DeWitt, M. A., Curie, G. L., Corn, J. E. Enhancing homology-directed genome editing by catalytically active and inactive CRISPR-Cas9 using asymmetric donor DNA. Nature Biotechnology. 34 (3), 339-344 (2016).
- Richardson, C. D., Ray, G. J., Bray, N. L., Corn, J. E. Non-homologous DNA increases gene disruption efficiency by altering DNA repair outcomes. Nature Communications. 7, 12463(2016).
- Gibson, D. G., et al. Enzymatic assembly of DNA molecules up to several hundred kilobases. Nature Methods. 6 (5), 343-345 (2009).
- Zhang, J. P., et al. Efficient precise knockin with a double cut HDR donor after CRISPR/Cas9-mediated double-stranded DNA cleavage. Genome Biology. 18 (1), 35(2017).
- Ran, F. A., et al. Genome engineering using the CRISPR-Cas9 system. Nature Protocols. 8 (11), 2281-2308 (2013).
- Shmakov, S., et al. Diversity and evolution of class 2 CRISPR-Cas systems. Nature Reviews Microbiology. 15 (3), 169-182 (2017).
- Moreno-Mateos, M. A., et al. CRISPR-Cpf1 mediates efficient homology-directed repair and temperature-controlled genome editing. Nature Communications. 8 (1), 2024(2017).
- Lin, S., Staahl, B. T., Alla, R. K., Doudna, J. A. Enhanced homology-directed human genome engineering by controlled timing of CRISPR/Cas9 delivery. Elife. 3, e04766(2014).
- Yang, L., et al. Optimization of scarless human stem cell genome editing. Nucleic Acids Research. 41 (19), 9049-9061 (2013).
- Watanabe, K., et al. A ROCK inhibitor permits survival of dissociated human embryonic stem cells. Nature Biotechnology. 25 (6), 681-686 (2007).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
