Tutaj prezentujemy podejście bioinformatyczne i analizy mające na celu zidentyfikowanie ekspresji LINE-1 na poziomie specyficznym dla locus.
Artykuł metodologiczny
Sekwencjonowanie RNA nowej generacji i proces bioinformatyczny w celu identyfikacji ekspresji LINE-1 na poziomie specyficznym dla locus
W tym artykule
Podsumowanie
Streszczenie
Długie Elementy-1 (LINEs/L1s) to powtarzające się elementy, które mogą kopiować i losowo wstawiać do genomu, powodując niestabilność genomu i mutagenezę. Zrozumienie wzorców ekspresji loci L1 na poziomie indywidualnym przyczyni się do zrozumienia biologii tego pierwiastka mutagennego. Ten autonomiczny element stanowi znaczną część ludzkiego genomu z ponad 500 000 kopii, choć 99% z nich jest okrojonych i wadliwych. Jednak ich obfitość i dominująca liczba wadliwych kopii utrudniają identyfikację autentycznie wyrażonych L1 na podstawie sekwencji związanych z L1 wyrażanych jako część innych genów. Trudno jest również określić, który konkretny locus L1 jest wyrażany ze względu na powtarzalny charakter elementów. Pokonując te wyzwania, przedstawiamy bioinformatyczne podejście RNA-Seq do identyfikacji ekspresji L1 na poziomie specyficznym dla locus. Podsumowując, zbieramy cytoplazmatyczne RNA, wybieramy poliadenylowane transkrypty i wykorzystujemy analizy RNA-Seq specyficzne dla nici, aby jednoznacznie zmapować odczyty do loci L1 w ludzkim genomie referencyjnym. Wizualnie dobieramy każdy locus L1 z unikalnie zmapowanymi odczytami, aby potwierdzić transkrypcję z własnego promotora i dostosować zmapowane odczyty transkryptu, aby uwzględnić mapowalność każdego pojedynczego locus L1. Podejście to zastosowano do linii komórkowej guza gruczołu krokowego, DU145, aby zademonstrować zdolność tego protokołu do wykrywania ekspresji z niewielkiej liczby pełnowymiarowych elementów L1.
Wprowadzenie
Retrotranspozony to powtarzalne elementy DNA, które mogą "przeskakiwać" w genomie w mechanizmie kopiowania i wklejania za pośrednictwem produktów pośrednich RNA. Jeden podzbiór retrotranspozonów jest znany jako Long INterspersed Elements-1 (LINEs/L1s) i stanowi jedną szóstą ludzkiego genomu z ponad 500 0000 kopii1. Pomimo ich obfitości, większość z tych kopii jest wadliwa i okrojona, a tylko około 80-120 elementów L1 uważa się za aktywne2. Pełnowymiarowy L1 ma około 6 kb długości z nietranslowanymi obszarami 5' i 3', wewnętrznym promotorem i powiązanym promotorem antysensownym, dwiema nienakładającymi się ramkami otwartego odczytu (ORF) oraz sygnałem i wielobiegunowym ogonem 3,4,5. U ludzi L1 składają się z podrodzin wyróżnionych wiekiem ewolucyjnym, przy czym starsze rodziny z czasem zgromadziły więcej unikalnych mutacji sekwencji w porównaniu z najmłodszą podrodziną, L1HS6,7. L1 są jedynymi autonomicznymi, ludzkimi retrotranspozonami, a ich ORF kodują odwrotną transkryptazę, endonukleazę i RNP z aktywnościami wiążącymi RNA i opiekuńczymi wymaganymi do retrotranspozycji i wstawienia do genomu w procesie zwanym odwrotną transkrypcją zapoczątkowaną przez cel8,9,10,11,12.
Retrotranspozycja L1s została zgłoszona jako powodująca choroby ludzkiej linii zarodkowej poprzez różne mechanizmy, w tym mutagenezę insercyjną, delecje w miejscu docelowym i rearanżacje13,14,15,16. Ostatnio wysunięto hipotezę, że L1 mogą odgrywać rolę w onkogenezie i / lub progresji nowotworu, ponieważ zaobserwowano zwiększoną ekspresję i insercję tego mutagennego pierwiastka w różnych nowotworach nabłonka17,18. Szacuje się, że na każde 200 urodzeń przypada jedno nowe wstawienie L119. Dlatego konieczne jest lepsze zrozumienie biologii aktywnie wyrażających się L1. Powtarzalność i obfitość wadliwych kopii znalezionych w transkryptach innych genów sprawiły, że ten poziom analizy jest wyzwaniem.
Na szczęście, wraz z pojawieniem się technologii sekwencjonowania o wysokiej przepustowości, poczyniono postępy w celu przeanalizowania i zidentyfikowania autentycznie wyrażających L1 na poziomie specyficznym dla locus. Istnieją różne filozofie dotyczące tego, jak najlepiej zidentyfikować ekspresję L1 za pomocą sekwencjonowania RNA nowej generacji. Zaproponowano tylko dwa rozsądne podejścia do mapowania transkryptów L1 na poziomie specyficznym dla locus. Skupia się tylko na potencjalnej transkrypcji, która odczytuje sygnał poliadenylacji L1 do sekwencji flankujących20. Nasze podejście wykorzystuje niewielkie różnice w sekwencji między elementami L1 i mapuje tylko te odczyty RNA-Seq, które jednoznacznie mapują na jeden locus21. Obie te metody mają ograniczenia w zakresie ilościowego oznaczania poziomów transkryptów. Kwantyfikacja może być potencjalnie ulepszona, dodając poprawkę na "unikalną mapowalność" każdego locus21, lub używając bardziej złożonych algorytmów, które redystrybuują odczyty z wieloma mapami, których nie można było jednoznacznie zmapować do określonego locus22. W tym miejscu szczegółowo omówimy krok po kroku ekstrakcję RNA oraz protokół sekwencjonowania i bioinformatyki nowej generacji w celu identyfikacji wyrażonych elementów L1 na poziomie specyficznym dla locus. Nasze podejście maksymalnie wykorzystuje naszą wiedzę z zakresu biologii funkcjonalnych elementów L1. Obejmuje to wiedzę, że funkcjonalne elementy L1 muszą być generowane z promotora L1, inicjowane na początku elementu L1, muszą być translowane w cytoplazmie i że ich transkrypty powinny być współliniowe z genomem. Krótko mówiąc, zbieramy świeże, cytoplazmatyczne RNA, wybieramy poliadenylowane transkrypty i wykorzystujemy analizy RNA-Seq specyficzne dla nici, aby jednoznacznie mapować odczyty do loci L1 w ludzkim genomie referencyjnym. Te wyrównane odczyty nadal wymagają obszernej ręcznej selekcji w celu określenia, czy odczyty transkrypcji pochodzą z promotora L1 przed wyznaczeniem locus jako autentycznie wyrażonego L1. Stosujemy to podejście na próbce linii komórkowej guza prostaty DU145, aby pokazać, w jaki sposób identyfikuje ona stosunkowo niewiele aktywnie transkrybowanych członków L1 z masy nieaktywnych kopii.
Protokół
1. Ekstrakcja cytoplazmatycznego RNA
- Uzyskaj komórki za pomocą następujących metod.
- Zbierz żywe komórki z kolb T-75 o splocie 2,75%–100% zlewających się.
- Przemyć kolbę 2 razy w 5 ml zimnego PBS, a w ostatnim płukaniu zeskrobać komórki i przenieść do stożkowej probówki o pojemności 15 ml. Wirować przez 2 minuty w temperaturze 1 000 x g i temperaturze 4 °C, a następnie ostrożnie usunąć i wyrzucić supernatant (tabela materiałów).
- Zbierz komórki z próbek tkanek.
- Przygotuj tkankę do ekstrakcji cytoplazmatycznego RNA w ciągu godziny od wycięcia i zawsze trzymaj na lodzie. Do długotrwałego przechowywania należy używać roztworów inhibitorów RNA do przechowywania tkanki do 72 godzin po sekcji zgodnie z protokołem producenta (tabela materiałów).
- Próbkę o objętości 10μm3 należy pokroić w kostkę i homogenizować świeżą próbkę z 5 ml zimnego PBS w sterylnym homogenizatorze z dounce, przenieść do stożkowej probówki o pojemności 15 ml, wirować przez 2 minuty przy 1 000 x g w temperaturze 4 °C, a następnie ostrożnie usunąć i wyrzucić supernatant (tabela materiałów).
- Zbierz żywe komórki z kolb T-75 o splocie 2,75%–100% zlewających się.
- Dodaj 2 ml buforu do lizy do osadu komórkowego - wymieszaj i inkubuj na lodzie przez 5 minut.
- Przygotuj świeży bufor do lizy ze 150 mM NaCl, 50 mM HEPES (pH 7,4) i 25 μg/ml digitoniny (tabela materiałów).
- Ponieważ minimalne stężenie digitoniny w buforze do lizy wymagane do przeniknięcia przez błonę plazmatyczną może się różnić w zależności od typu komórki, mikroskopijnie potwierdź, że komórki potraktowane buforem do lizy tracą błonę plazmatyczną i zachowują nienaruszoną błonę jądrową.
- Tuż przed użyciem dodaj 1,000 U/ml inhibitora RNazy (tabela materiałów).
- Wirować przez 1 minutę przy 1 000 x g i temperaturze 4 °C i zebrać supernatant.
- Dodać supernatant do wstępnie schłodzonych 7,5 ml Trizolu i 1,5 ml chloroformu. Wszystkie czynności, które wymagają chloroformu, muszą być wykonane w czystym okapie chemicznym (Tabela materiałów).
- Wirować przez 35 minut przy 3,220 x g i 4 °C.
- Przenieś wodną część (górną warstwę) do świeżej, wstępnie schłodzonej probówki o pojemności 15 ml.
- Dodać 4,5 ml chloroformu i odwirować.
- Wirować przez 10 minut w temperaturze 3 220 x g i temperaturze 4 °C.
- Przenieś wodną część do świeżej, wstępnie schłodzonej probówki.
- Dodać 4,5 ml izopropanolu, dobrze wstrząsnąć i inkubować w temperaturze -80 °C przez noc (tabela materiałów).
- Wirować przy 3,220 x g i temperaturze 4 °C przez 45 minut.
- Usuń izopropanol, dodaj 15 ml 100% etanolu (tabela materiałów).
- Wirować przy 3 220 g przez 10 min.
- Usuń etanol, odcedź i susz przez około 1 godzinę.
- Użyj sterylnego bawełnianego wacika, aby usunąć pozostały etanol (Tabela materiałów).
- Ponownie zawiesić próbkę w 100 do 200 μl wody wolnej od RNaz w zależności od wielkości granulek (Tabela materiałów).
- Frakcjonowanie próbek przy użyciu technologii elektroforezy w celu określenia jakości i stężenia próbek zgodnie z instrukcjami producenta23 (Tabela materiałów).
- Próbki kwalifikują się do analizy RNA-Seq, jeśli RIN > 824.
2. Sekwencjonowanie nowej generacji
- Prześlij próbki cytoplazmatycznego RNA do sekwencjonowania przy użyciu platformy sekwencjonowania nowej generacji, której celem jest wygenerowanie co najmniej 50 milionów odczytów sparowanych końców 100 pz.
- Wybierz poli-adenylowane RNA i sekwencjonowanie specyficzne dla nici.
3. Tworzenie adnotacji (opcjonalnie, jeśli ktoś ma istniejącą adnotację)
- Utwórz pełną adnotację L1 lub pobierz pełną adnotację L1 (plik uzupełniający 1a-b).
- Pobierz adnotacje Repeat Masker dla elementów LINE-1 z przeglądarki genomu UCSC za pomocą narzędzia przeglądarki tabel (https://genome.ucsc.edu/cgi-bin/hgTables). Określ klad ssaków, genom człowieka, zestaw hg19 (lub hg38 dla bardziej zaktualizowanego genomu) i przefiltruj pod kątem "LINE1" w polu Nazwa klasy. Pobierz jako plik .gtf i oznacz jako FL-L1-BLAST.gtf.
- Przeprowadź lokalne wyszukiwanie BLAST pierwszych 300 pz pełnoziarnistego elementu L1 L1.3 obejmującego region promotora w ludzkim genomie i dodaj 6 000 pz w dół, aby utworzyć koniec współrzędnych L1 do pliku adnotacji. Zapisz w pliku gtf i oznacz jako FL-L1-RM.gtf.
- Przetnij adnotację RepeatMasker i adnotację L1 opartą na promotorze za pomocą bedtools i oznacz jako FL-L1-BLAST_RM.txt (pakiety oprogramowania).
- Użyj tego polecenia w terminalu Linux: bedtools intersect -a FL-L1-BLAST.gtf -b FL-L1-RM.gtf > FL-L1-BLAST_RM.txt.
- Oddziel przeciętą adnotację FL-L1 górnym i dolnym pasmem.
- Skopiuj FL-L1-BLAST_RM.txt do arkusza kalkulacyjnego i posortuj według nici "minus" i "plus", a następnie posortuj według lokalizacji chromosomu.
- Utwórz dwa nowe dokumenty arkusza kalkulacyjnego, jeden z przeciętymi współrzędnymi dla pełnej długości L1 na nitce ujemnej, a drugi na dolnym pasmie, a następnie zapisz jako FL-L1-BLAST_RM_minus.xls i FL-L1-BLAST_RM_plus.xls.
- Zapisz dwa nowe dokumenty jako pliki .txt.
- Użyj programu mac2unix, aby przekonwertować .txt pliki na poprawne pliki adnotacji (pakiety oprogramowania).
- Użyj tego polecenia w terminalu: mac2unix.sh FL-L1-BLAST_RM_minus.gff.
- Użyj tego polecenia w terminalu: mac2unix.sh FL-L1-BLAST_RM_plus.gff.
- Zapisz nowe pliki z rozszerzeniem .gff.
- Alternatywnie użyj AWK, aby filtrować wiersze skojarzone z pasmem + i –.
- Użyj następującego polecenia, aby uzyskać pasmo +: awk '/+/' FL-L1_BLAST_RM.gtf > FL-L1_BLAST_RM_plus.gtf.
- Użyj następującego wiersza poleceń, aby pobrać pasmo -: awk '/-/' FL-L1_BLAST_RM.gtf > FL-L1_BLAST_RM_minus.gtf.
4. Odczyt potoku wyrównania w celu zidentyfikowania wyrażonych L1
szt.| opcja | opis |
| –p | Zawiera szczegółowe informacje o liczbie wątków, których komputer powinien użyć podczas wyrównywania. Większa pamięć komputera pozwoli na więcej wątków i powinna być empirycznie d. |
| –m 1 | To mówi programowi, aby akceptował tylko odczyty, które mają jedno dopasowanie w genomie, które jest lepsze niż jakiekolwiek inne dopasowanie genomu. |
| – y | Jest to przełącznik tryhard, który sprawia, że mapowanie wyszukuje wszystkie możliwe dopasowania i nie pozwala na zamknięcie po osiągnięciu określonej liczby dopasowań. |
| –V 3 | Dzięki temu program może wykorzystywać pamięć tylko do zmapowanych odczytów z 3 lub mniej niezgodnościami z genomem. |
| –X 600 | Zezwala to tylko na sparowane odczyty, które są mapowane w odległości 600 baz od siebie. Dzięki temu pary odczytu są współliniowe w genomie i dokonują selekcji względem s obejmujących przetworzone cząsteczki RNA. |
| –Porcja MBS 8184 | To polecenie przydziela dodatkową pamięć do obsługi dużej liczby wyrównań możliwych dla każdego odczytu związanego z L1. |
Tabela 1: Opcje wiersza poleceń dla muszki.
- Uruchom sekwencjonowanie sparowanych końców fastq z próbką RNA-Seq za pomocą Bowtie.
UWAGA: Muszka1 musi być używana, a nie Muszka2, ponieważ parametry wymagane do unikalnego wyrównania można znaleźć tylko w tej wersji muszki (pakiety oprogramowania). Muszka jest używana na nakładkach uwzględniających spawy, takich jak STAR, w celu oceny zgodnych, ciągłych odczytów bardziej istotnych dla biologii i ekspresji L1.- Użyj tego wiersza poleceń w terminalu Linux: bowtie -p 10 -m 1 -S -y -v 3 -X 600 --chunkmbs 8184 hg_X_Y_M_index -1 hg_sample_1.fq -2 hg_sample_2.fq | samtools view -hbuS - | samtools sort – hg_sample_sorted.bam. Zobacz Tabelę 1, aby zapoznać się z opisem opcji wiersza poleceń dla Bowtie.
- Pasmo oddziel wyjściowy plik bam za pomocą samtools (Software Packages) i następujących poleceń Linux. Należy pamiętać, że rzeczywiste wartości flag mogą się różnić, jeśli nie korzysta się ze standardowych protokołów sekwencjonowania nowej generacji.
- Użyj tego wiersza poleceń, aby wybrać dla górnej nici: samtools view -h hg_sample_sorted.bam | awk 'substr($0,1,1) == "@" || $2 == 83 || $2 == 163 {print}' | samtools view -bS - > hg_sample_sorted_topstrand.bam.
- Użyj tego wiersza poleceń, aby wybrać dolną nić: samtools view -h hg_sample_sorted.bam | awk 'substr($0,1,1) == "@" || $2 == 99 || $2 == 147 {print}' | samtools view -bS - > hg_sample_sorted_bottomstrand.bam.
- Generuj liczniki odczytów względem adnotacji dla loci L1 za pomocą bedtools (Software Packages).
- Użyj tego wiersza poleceń, aby wygenerować liczniki odczytów dla L1 w kierunku wyczuwania na górnym pasmie: bedtools coverage -abam FL-L1-BLAST_RM_plus.gff -b hg_sample_sorted_topstrand.bam > hg_sample_sorted_bowtie_tryhard_plus_top.txt.
- Użyj tego wiersza poleceń, aby wygenerować liczniki odczytów dla L1 w kierunku sensu na dolnym pasmie: bedtools coverage -abam FL-L1-BLAST_RM_minus.gff -b hg_sample_sorted_bottomstrand.bam > hg_sample_sorted_bowtie_tryhard_minus_bottom.txt.
- Zindeksuj plik bam z kroku 5.1.1, aby był widoczny w przeglądarce Integrative Genomics Viewer (IGV)25 (Software Packages).
- Użyj tego wiersza poleceń: samtools index hg_sample_sorted.bam
- Aby użyć trybu wsadowego w celu zwiększenia liczby próbek RNA-Seq przesyłanych jednocześnie przez instalację, należy użyć skryptu superkomputera do wykonania kroku 4.1 o nazwie human_bowtie.sh, skryptu do wykonania kroków 4.2-4.3 o nazwie human_L1_pipeline.sh, a następnie skryptu do wykonania kroku 4.4 o nazwie bam_index.sh. Skrypty te można znaleźć w pliku uzupełniającym 2 wraz z powiązanymi poleceniami superkomputera do uruchamiania skryptów.
5. Ręczna selekcja
- Utwórz arkusz kalkulacyjny dla odczytów zmapowanych do każdego miejsca L1 z adnotacjami.
- Skopiuj hg_sample_sorted_bowtie_tryhard_minus_bottom.txt utworzone w kroku 4.3.2 i oznacz stronę etykietą jako "minus-bottom".
- Posortuj wszystkie kolumny na podstawie od największej do najmniejszej liczby odczytów znalezionych w kolumnie J.
- Skopiuj ponad hg_sample_sorted_bowtie_tryhard_plus_top.txt utworzone w kroku 4.3.1 i oznaczone jako "top-plus" w innym arkuszu kalkulacyjnym.
- Posortuj wszystkie kolumny na podstawie od największej do najmniejszej liczby odczytów znalezionych w kolumnie J.
- Utwórz trzecią stronę oznaczoną jako "połączona" i dodaj wszystkie loci z dziesięcioma lub więcej odczytami ze stron "minus-dół" i "plus-góra".
- Posortuj wszystkie kolumny na podstawie od największej do najmniejszej liczby odczytów znalezionych w kolumnie J.
- Załaduj następujące pliki do IGV25 (pakiety oprogramowania): 1) genom referencyjny do wizualizacji genów z adnotacjami, 2) FL-L1-BLAST_RM.gff do wizualizacji adnotacji L1, 3) hg_sample_sorted.bam do wizualizacji zmapowanych transkryptów z próbki będącej przedmiotem zainteresowania oraz 4) hg_genomicDNA_sorted.bam do oceny możliwości mapowania regionów genomu.
- Usuń wiersze pokrycia i skrzyżowania skojarzone z każdym plikiem bam.
- Skompresuj hg_sample_sorted.bam i hg_genomicDNA_sorted.bam, aby wszystkie ścieżki IGV zmieściły się na jednym ekranie.
- Skopiuj hg_sample_sorted_bowtie_tryhard_minus_bottom.txt utworzone w kroku 4.3.2 i oznacz stronę etykietą jako "minus-bottom".
- Ręczne selekcjonowanie.
- Korzystając ze współrzędnych z loci wymienionych na stronie "połączonej" arkusza kalkulacyjnego, wyświetl nazwę loci w IGV25 (Software Packages).
- Selekcjonuj locus tak, aby był autentycznie wyrażony samodzielnie, jeśli nie ma żadnych odczytów w kierunku L1 do 5 kb.
- Oznacz wiersz kolorem zielonym i zwróć uwagę, dlaczego jest to autentycznie wyrażony L1.
UWAGA: Wyjątek od tej reguły istnieje, jeśli region przed L1 nie jest mapowalny. W takim przypadku należy oznaczyć wiersz kolorem czerwonym i zwrócić uwagę, że nie można ocenić wyrażenia regionu przed promotorem L1, a zatem nie można z całą pewnością określić wyrażenia L1.
- Oznacz wiersz kolorem zielonym i zwróć uwagę, dlaczego jest to autentycznie wyrażony L1.
- Zadbaj o to, aby locus nie był autentycznie wyrażony przez własny promotor, jeśli istnieją odczyty do 5 kb.
- Oznacz wiersz kolorem czerwonym i zanotuj, dlaczego nie jest to autentycznie wyrażony L1.
- Określ locus jako fałszywy, jeśli jest wyrażony w intronie wyrażonego genu w tym samym kierunku z odczytami przed L1, jeśli znajduje się za wyrażonym genem w tym samym kierunku z odczytami przed L1 lub dla nieanotowanych wzorców ekspresji z odczytami przed L1.
UWAGA: Wyjątek od tej reguły ma zastosowanie, gdy minimalne odczyty bezpośrednio nachodzą na miejsce startowe promotora L1, ale nieznacznie powyżej miejsca startowego L1. Jeśli nie ma innych odczytów przed przypadkiem L1, takim jak ten, należy uznać, że ten L1 jest autentycznie wyrażony. Oznacz wiersz kolorem zielonym i zanotuj, dlaczego jest to autentycznie wyrażony L1.
- Określ, czy locus L1 może być fałszywy, jeśli wzorzec zmapowanych odczytów do locus nie jest skorelowany z określonymi regionami mapowalności L1.
UWAGA: Na przykład, jeśli L1 jest wysoce mapowalny, ale ma tylko stos odczytów w skondensowanym regionie w L1, jest mniej prawdopodobne, że jest związany z ekspresją L1 poza własnym promotorem, a bardziej prawdopodobne, że pochodzi ze źródeł bez adnotacji, takich jak eksony lub LTR. W takich przypadkach należy nadać loci kolor pomarańczowy i zanotować, dlaczego locus jest podejrzany. Zweryfikuj źródła podejrzanych nagromadzeń, sprawdzając lokalizację L1 w przeglądarce genomu UCSC. - Zadbaj o to, aby locus nie był autentycznie wyrażany, jeśli znajduje się w środowisku genomowym sporadycznie wyrażanych regionów bez adnotacji
UWAGA: Na przykład odczyty mogą być wyrażone 10 kb przed L1, ale mniej więcej co 10 kb są mapowane odczyty, a niektóre z tych odczytów są wyrównane z L1. Te L1 są mniej prawdopodobne, że zostaną wyrażone przez własny promotor, a bardziej prawdopodobne jest, że mają zmapowane odczyty z powodu nieopisanych wzorców ekspresji genomu. W takich przypadkach należy nadać loci kolor pomarańczowy i zanotować, dlaczego locus jest podejrzany.
6. Przeczytaj strategię dopasowania, aby ocenić mapowalność w genomie referencyjnym (opcjonalnie, jeśli posiada się istniejący zestaw danych o dopasowanym genomowym DNA)
- Pobierz pliki sekwencji DNA całego genomu i przekonwertuj je na pliki .fq
- Wejdź na stronę NCBI znajdującą się tutaj: https://www.ncbi.nlm.nih.gov/
- Wpisz WGS HeLa sparowany koniec.
- Wybierz dla Homo sapiens w obszarze Wyniki według taksonu.
- Wybierz próbkę, która jest sparowana na końcu i ma odczyty z 100 lub więcej pz, jak w poniższym przykładzie: https://www.ncbi.nlm.nih.gov//ERX457838[accn]
- Potwierdź długość odczytu, wybierając pozycję Uruchom, a następnie Metadane, jak pokazano poniżej: https://trace.ncbi.nlm.nih.gov/Traces//?run=ERR492384
- Aby pobrać dane sekwencji DNA całego genomu, wprowadź to polecenie w terminalu Linux: sratoolkit.2.9.2-mac64/bin/prefetch -X 100G ERR492384
UWAGA: Funkcja pobierania z wyprzedzeniem zestawu narzędzi pobiera numer dostępu "ERR492384" znajdujący się na stronie NCBI (Pakiety oprogramowania). "100G" ogranicza ilość pobieranych danych do 100 gigabajtów. - Wprowadź to polecenie w terminalu Linux: fastq-dump --split-files ERR492384
UWAGA: Spowoduje to podzielenie pobranego zestawu danych genomowego DNA na dwa pliki fastq.
- Uruchom wyrównanie za pomocą muszki.
- Użyj tego polecenia w Linuksie do wyrównania: bowtie -p 10 -m 1 -S -y -v 3 -X 600 --chunkmbs 8184 hg_X_Y_M_index -1 hg_genomicDNA_1.fq -2 hg_genomicDNA_2.fq | samtools view -hbuS - | samtools sort – hg_genomicDNA_sorted.bam.
- Zapoznaj się z krokiem 4.1, aby zrozumieć parametry używane w wyrównaniu muszki (pakiety oprogramowania).
- Pobierz genomicznie dopasowany plik bam, aby ocenić mapowalność dostępną na żądanie autora.
- Użyj tego polecenia w Linuksie do wyrównania: bowtie -p 10 -m 1 -S -y -v 3 -X 600 --chunkmbs 8184 hg_X_Y_M_index -1 hg_genomicDNA_1.fq -2 hg_genomicDNA_2.fq | samtools view -hbuS - | samtools sort – hg_genomicDNA_sorted.bam.
- Zindeksuj plik bam z kroku 4.2.1 za pomocą samtools, aby był widoczny w IGV25 (Software Packages), aby dodatkowo informować o ręcznym sprawdzaniu.
- Użyj tego wiersza poleceń w systemie Linux: samtools index hg_genomicDNA_sorted.bam
- Ocena mapowalności każdego loci L1
- Określ liczbę unikalnie zmapowanych odczytów do loci L1 za pomocą programu bedtools, adnotacji FL-L1 i dopasowanych danych sekwencji genomowych (pakiety oprogramowania).
- Użyj tego wiersza poleceń w systemie Linux: bedtools coverage -abam FL-L1-BLAST_RM.gtf –b hg_genomicDNA_sorted.bam > L1_Mappability_hg_genomicDNA.txt.
- Oznacz locus L1 tak, aby miał pełną mapowalność pokrycia, gdy 400 unikalnych odczytów jest do niego wyrównanych.
- Określ czynnik wymagany do skalowania w górę lub w dół odczytów wyrównanych genomowego DNA do 400 dla każdego indywidualnego L1.
- Aby uzyskać skalowaną miarę ekspresji zgodnie z indywidualną mapowalnością locus L1, pomnóż czynnik określony w kroku 6.4.3 przez liczbę odczytów transkryptu RNA, które są zgodne z autentycznie wyrażonymi L1 określonymi w sekcjach 4–5.
- Określ liczbę unikalnie zmapowanych odczytów do loci L1 za pomocą programu bedtools, adnotacji FL-L1 i dopasowanych danych sekwencji genomowych (pakiety oprogramowania).
Wyniki
Kroki opisane powyżej oraz przedstawione graficznie na Ryc. 1 zastosowano do ludzkiej linii komórkowej raka prostaty DU145. Próbkę RNA przygotowano z frakcji cytoplazmatycznej, a następnie poddano sekwencjonowaniu nowej generacji (NGS) zgodnie z protokołem selekcji poly-A, specyficznym dla nici i z odczytami parowanymi (paired-end). Przy użyciu programu Bowtie pliki sekwencjonowania parowanego dopasowano do genomu, dopuszczając jedynie unikalne dopasowania, w których odczyt parowany lepiej pasował do jednej lokalizacji genomowej niż do jakiejkolwiek innej. Pliki sekwencyjne DU145 dopasowano do ludzkiego genomu referencyjnego, tworząc plik bam, który jest dostępny na żądanie autorów. Za pomocą narzędzia bedtools z plików bam DU145 z rozdzieleniem nici wyodrębniono dane dotyczące liczby odczytów zmapowanych do pełnowymiarowych L1s. Odczyty te posortowano w arkuszu kalkulacyjnym od największego do najmniejszego i poddano ręcznej kurateli poprzez analizę otoczenia genomowego każdego locus L1 w programie IGV w celu potwierdzenia jego autentyczności (Tabela uzupełniająca 1). Jeśli próbka została uznana za autentycznie eksprymowaną, oznaczono ją kolorem zielonym wraz z wyjaśnieniem przyczyny akceptacji w ostatniej kolumnie po prawej stronie. Przykłady loci L1 uznanych za autentycznie eksprymowane zgodnie z wytycznymi opisanymi w sekcji metod przedstawiono na Ryc. 2a-b. Jeśli próbka nie została uznana za autentycznie eksprymowaną, oznaczono ją kolorem czerwonym wraz z powodem odrzucenia w ostatniej kolumnie po prawej stronie. Przykłady loci L1 odrzuconych ze względu na ekspresję z promotora innego niż ich własny, zgodnie z wytycznymi opisanymi w sekcji metod, szczegółowo przedstawiono na Ryc. 2c-e.
W niniejszym badaniu analizowano wyłącznie pełnowymiarowe elementy L1 z nienaruszoną regionem promotora. Brak takiego rozróżnienia wprowadziłby znaczne źródło szumu transkrypcyjnego pochodzącego z uciętych elementów L1. Przykłady uciętych elementów L1 w linii DU145 przedstawiono na Rysunku 3a-b, gdzie zostały one zidentyfikowane na podstawie unikalnie zmapowanych odczytów RNA-Seq. Jednak w programie IGV widać wyraźnie, że transkrypty te nie zostały zainicjowane z uciętego elementu L1, lecz wynikają z włączenia sekwencji L1 do genu lub znajdują się poniżej eksprymowanego genu.
Ogólnie w DU145 odsetek pełnowymiarowych loci L1 oraz odczytów, które po ręcznej kurateli zostają odrzucone jako autentycznie wyrażone L1, wynosi około 50% (Supplemental Table 2), co wykazuje wysoki poziom zmapowanych odczytów transkryptów L1, które bez ręcznej kurateli zostałyby zarejestrowane jako wyniki fałszywie dodatnie. Konkretnie w DU145 stwierdzono łącznie 114 pełnowymiarowych loci L1 z unikalnie zmapowanymi odczytami w kierunku sensownym, co dało łącznie 3 152 odczyty, jednak po ręcznej kurateli zidentyfikowano jedynie 60 loci wyrażanych z własnych promotorów z 1 879 odczytami (Supplemental Table 1). Ma to miejsce nawet w przypadku podjęcia kroków w celu ograniczenia ekspresji nieistotnej dla biologii L1 poprzez selekcję cytoplazmatycznego mRNA. Należy zauważyć, że locus z najwyższym poziomem zmapowanych transkryptów w DU145 zostało odrzucone, ponieważ nie było autentycznie wyrażonym L1 (Figure 4). Ogólnie liczba zmapowanych transkryptów w konkretnych loci L1 mieści się w podobnym zakresie zarówno dla loci L1 zaakceptowanych, jak i odrzuconych jako autentycznie wyrażone po ręcznej kurateli (Figure 4).
Po ręcznej kuracji liczba odczytów wykazujących unikalne mapowanie do autentycznie eksponowanych specyficznych loci L1 w linii DU145 mieści się w przedziale od 175 odczytów do arbitralnie przyjętego minimalnego progu odcięcia wynoszącego 10 odczytów (Rysunek 5). To podejście, polegające na identyfikacji odczytów transkryptów jednoznacznie zmapowanych do L1, ogranicza możliwość dokładnego ilościowego określenia ekspresji. Aby to uwzględnić, opracowano czynnik korekcyjny dla każdego locus na podstawie jego mapowalności. W celu stworzenia tego czynnika korekcyjnego, najpierw wykorzystano program bedtools do wyodrębnienia liczby jednoznacznie zmapowanych odczytów z genomowego pliku bam komórek HeLa, które wyrównały się do wszystkich pełnowymiarowych loci L1, a następnie przedstawiono te loci na wykresie w kolejności malejącej liczby zmapowanych odczytów transkryptów (dodatkowe Rycina 1). Przyjęto umownie, że elementy L1 posiadające 400 odczytów charakteryzują się pełną mapowalnością pokrycia. Liczbę odczytów możliwych do zmapowania do locus L1 w próbce sekwencjonowania genomu HeLa przeskalowano względem 400 odczytów, a następnie uzyskaną wartość przemnożono przez liczbę odczytów zmapowanych do każdego autentycznie eksprymowanego locus L1 w linii DU145 (Tabela uzupełniająca 2). Zgodnie z oczekiwaniami, elementy L1, które miały wyższe wartości korekcji mapowalności, pochodziły z młodszych podrodzin, takich jak L1PA2 (Tabela uzupełniająca 2). Po skorygowaniu odczytów o wskaźniki mapowalności (mappability scores) dla każdego locus, ilościowe oznaczenie ekspresji dla większości loci wzrosło (Rysunek 6). Liczba odczytów, które zmapowano jednoznacznie do autentycznie eksprimowanych specyficznych locus L1 z korektami mapowalności w komórkach DU145, wynosiła od 612 do 4 odczytów, przy czym nastąpiła zmiana kolejności locus od najwyższej do najniższej ekspresji (Rysunek 6).
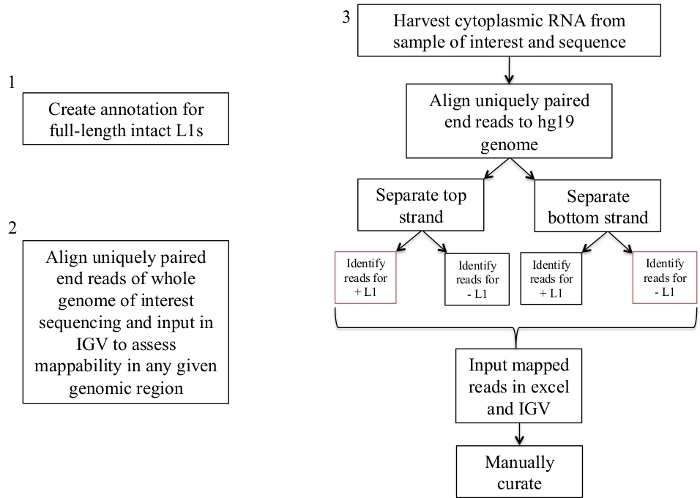
Rycina 1: Schemat przepływu pracy.
Przedstawiono graficznie kroki służące do identyfikacji ekspresyjnych L1 w próbce ludzkiej. Należy zauważyć, że kroki 1 i 2 nie muszą być powtarzane, jeśli odpowiednie pliki są już dostępne. Pliki te można pobrać z Pliku uzupełniającego 1a-b oraz Pliku uzupełniającego 2. Pola zaznaczone na czerwono wskazują kroki, w których program bedtools coverage jest wykorzystywany do zliczania liczby odczytów mapujących się do L1 w kierunku sensownym. Loci z odczytami mapującymi się w orientacji sensownej to te L1, które powinny zostać poddane ręcznej kuracji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
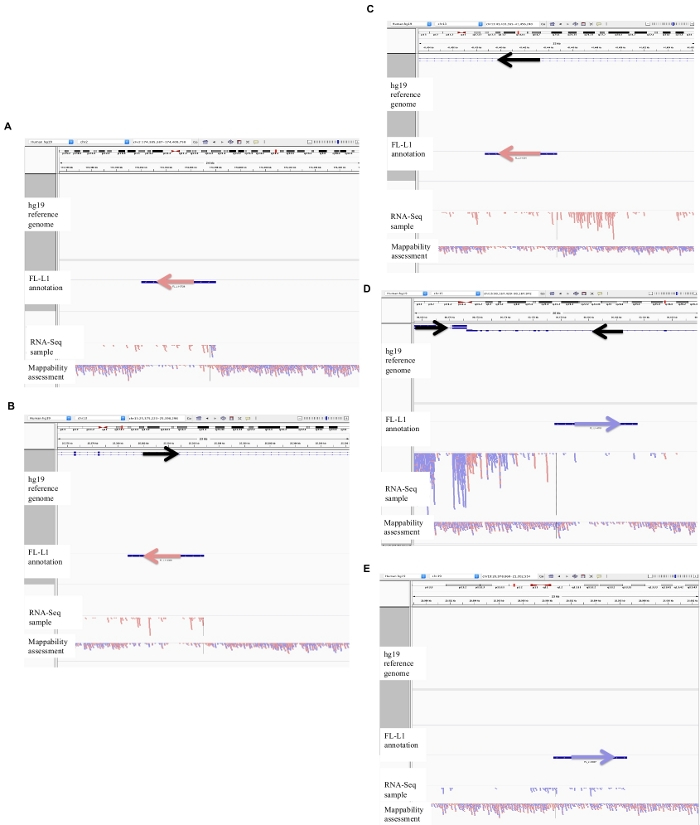
Rycina 2: Przykłady wyselekcjonowanych loci L1 w DU145.
Do programu IGV wczytano genom referencyjny, plik adnotacji gff dla pełnowymiarowych L1 zgodny z wersją genomu referencyjnego (Plik uzupełniający 1), plik bam dla DU145, a na koniec genomowy plik bam dla HeLa w celu oceny mapowalności; wszystkie są one dostępne na prośbę autora. Dodano strzałki, aby ułatwić wizualizację kierunku adnotowanego L1. Strzałki i odczyty w kolorze czerwonym są zorientowane w sekwencji od prawej do lewej. Strzałki i odczyty w kolorze niebieskim są zorientowane w sekwencji od lewej do prawej. a) W IGV to locus L1 wydaje się być wyrażane z własnego promotora, ponieważ w orientacji sens w obszarze powyżej 5 kb powyżej L1 nie występują żadne odczyty. Ten L1 charakteryzuje się niską mapowalnością, nie znajduje się w genie i istnieją dowody na oczekiwaną aktywność promotora antysensownego26. b) W IGV to locus L1 wydaje się być wyrażane z własnego promotora, ponieważ w orientacji sens w obszarze powyżej 5 kb powyżej L1 nie występują żadne odczyty. Ten L1 charakteryzuje się niską mapowalnością i znajduje się w obrębie genu o przeciwnym kierunku. c) W IGV to locus L1 zostało odrzucone jako wyrażane L1, ponieważ w obrębie 5 kb powyżej występują odczyty w tej samej orientacji. Ten L1 znajduje się w obrębie genu o tym samym kierunku, zatem odczyty transkryptów najprawdopodobniej pochodzą z promotora wyrażanego genu. d) W IGV to locus L1 zostało odrzucone jako wyrażane L1, ponieważ w obrębie 5 kb powyżej występują odczyty w tej samej orientacji. Ten L1 znajduje się za silnie wyrażanym genem o tym samym kierunku, zatem odczyty transkryptów najprawdopodobniej pochodzą z promotora tego wyrażanego genu i rozciągają się poza normalny terminator genu. e) W IGV to locus L1 zostało odrzucone jako wyrażane L1, ponieważ w obrębie 5 kb powyżej występują odczyty w tej samej orientacji. Ten L1 nie znajduje się w obrębie ani w pobliżu adnotowanego genu w genomie referencyjnym, zatem pochodzenie tych transkryptów wewnątrz i powyżej elementu L1 sugeruje nieadnotowany promotor. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
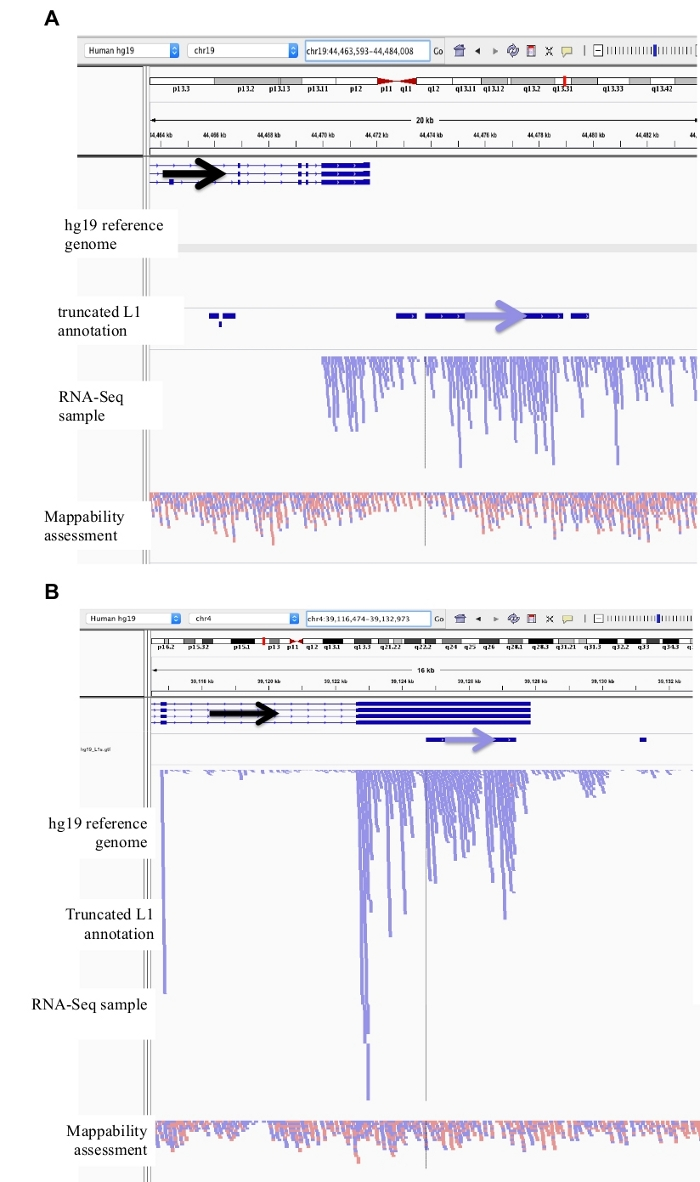
Rycina 3: Szum tła pochodzi również z przyciętych elementów L1.
Nasza adnotacja L1 nie obejmuje przyciętych elementów L1, ponieważ stanowią one główne źródło szumu tła. Dodano strzałki, aby ułatwić wizualizację kierunku adnotowanego L1. Strzałki i odczyty w kolorze niebieskim są zorientowane w sekwencji od lewej do prawej. a) Przedstawiono przykład przyciętego L1 z podrodziny L1MB5 o długości 2706 bps. W programie IGV widać, że odczyty pochodzą z przedłużenia w kierunku downstream wyrażonego genu. b) Pokazano inny przykład przyciętego L1. Ten L1 to L1PA11 o długości 4767 bps. W programie IGV widać, że odczyty mapujące się unikalnie do L1 pochodzą z wyrażonego eksonu, w którym znajduje się L1. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
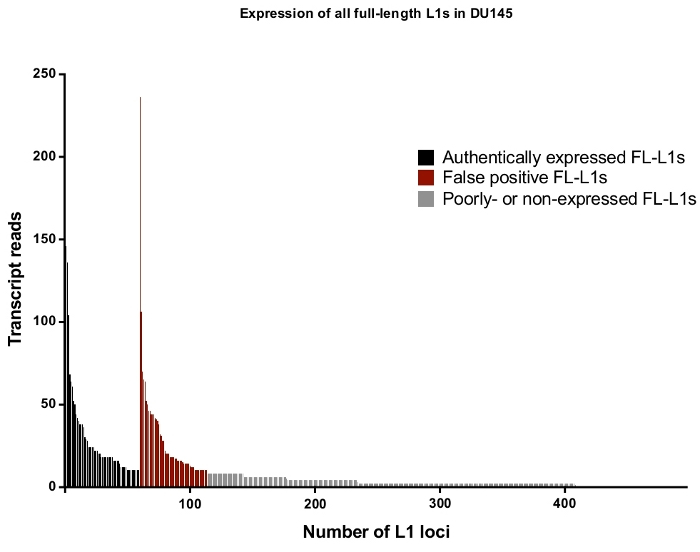
Rycina 4: Odczyty transkryptów mapujące się unikalnie do wszystkich pełnowymiarowych, nienaruszonych L1 w ludzkim genomie, wykazujących ekspresję w linii komórkowej raka prostaty DU145.
Kolorem czarnym zaznaczono specyficzne loci zidentyfikowane jako autentycznie eksponowane po manualnej kurateli, a kolorem czerwonym specyficzne loci odrzucone jako autentyczne odczyty po manualnej kurateli. Kolorem szarym zaznaczono loci, do których mapuje się mniej niż dziesięć odczytów. Ponieważ loci te stanowią niewielką frakcję odczytów transkryptów, nie poddano ich manualnej kurateli. Znaczniki na osi x oznaczają co 100 pełnowymiarowych, nienaruszonych L1. Około 4 500 loci nie zostało przedstawionych na wykresie, ponieważ miały zero zmapowanych odczytów. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
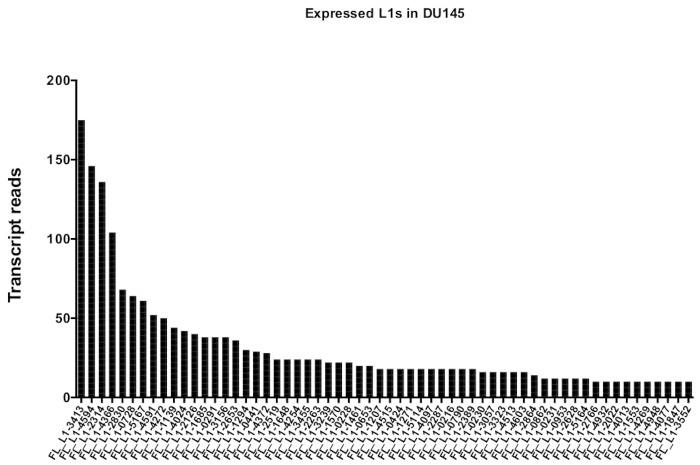
Rycina 5: Odczyty transkrypcji mapujące się jednoznacznie do autentycznie eksponowanych, pełnowymiarowych i nienaruszonych elementów L1 w linii komórkowej raka prostaty DU145.
Przedstawiono liczbę odczytów transkrypcji mapujących się do specyficznych loci w komórkach DU145 po ręcznej kurateli. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
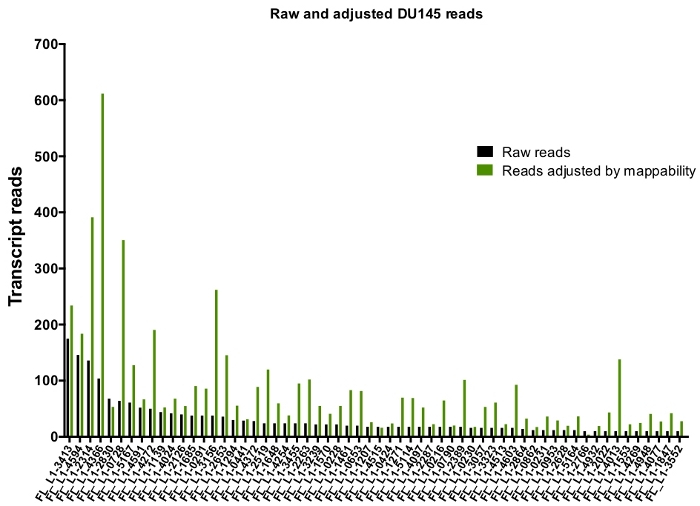
Rycina 6: Odczyty mapujące się do autentycznie ekspresyjnych L1 po korekcie o mapowalność.
Przedstawiono liczbę odczytów transkryptów skorygowaną o wyniki mapowalności specyficzne dla locus, które mapują się do ręcznie wyselekcjonowanych loci L1 w komórkach DU145. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Plik uzupełniający 1: Adnotacje dla pełnowymiarowych, nienaruszonych ludzkich L1s w zależności od orientacji. a) FL-L1-BLAST_RM_minus.gff. b) FL-L1-BLAST_RM_plus.gff. Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 2: Skrypty superkomputerowe wykorzystane do automatyzacji potoku bioinformatycznego szczegółowo opisanego w sekcji 4. Aby pobrać ten plik, kliknij tutaj.
Rysunek dodatkowy 1: Próbka genomowego DNA użyta do określenia możliwości mapowania L1.
Przedstawiono liczbę odczytów transkryptów genomowych z próbki linii komórkowej HeLa, które mapują się jednoznacznie do wszystkich 5 000 pełnowymiarowych loci L1 w genomie. Przyjęto, że L1 posiada pełną możliwość mapowania pokrycia, gdy do L1 mapuje się 400 odczytów. Kliknij tutaj, aby pobrać ten rysunek.
Tabela uzupełniająca 1: Ręczna kuratela L1 w DU145. Kliknij tutaj, aby pobrać tę tabelę.
Tabela uzupełniająca 2: Wyselekcjonowane L1 w DU145 z korektą mapowalności. Kliknij tutaj, aby pobrać tę tabelę.
Dyskusja
Wykazano, że aktywność L1 powoduje uszkodzenia genetyczne i niestabilność, przyczyniając się do choroby 27,28,29. Z około 5000 pełnometrażowych kopii L1 tylko kilkadziesiąt ewolucyjnie młodych L1 odpowiada za większość aktywności retrotranspozycyjnej2. Istnieją jednak dowody na to, że nawet niektóre starsze, niezdolne do retrotranspozycji L1 są nadal zdolne do wytwarzania białek uszkadzających DNA30. Aby w pełni docenić rolę L1 w niestabilności genomu i chorobach, należy zrozumieć ekspresję L1 na poziomie specyficznym dla locus. Jednak wysokie tło sekwencji związanych z L1 włączonych do innych RNA niezwiązanych z retrotranspozycją L1 stanowi poważne wyzwanie w interpretacji autentycznej ekspresji L1. Kolejnym wyzwaniem w identyfikacji, a tym samym zrozumieniu wzorców ekspresji poszczególnych loci L1 jest ich powtarzalny charakter, który nie pozwala na odwzorowanie wielu krótkich sekwencji odczytu na jeden unikalny locus. Aby sprostać tym wyzwaniom, opracowaliśmy opisane powyżej podejście do identyfikacji ekspresji poszczególnych loci L1 za pomocą danych RNA-Seq.
Nasze podejście filtruje wysoki poziom (ponad 99%) szumu transkrypcyjnego generowanego przez sekwencje L1, które nie są związane z retrotranspozycją L1, wykonując szereg kroków. Pierwszym krokiem jest przygotowanie cytoplazmatycznego RNA. Wybierając cytoplazmatyczne RNA, odczyty związane z L1 znajdujące się w wyrażonym intronowym mRNA w jądrze są znacznie zubożone. Kolejnym krokiem podjętym w celu zmniejszenia szumu transkrypcyjnego niezwiązanego z L1 jest wybór transkryptów poliadenylowanych. Usuwa to szum transkryptu związany z L1 występujący w gatunkach innych niż mRNA. Kolejnym krokiem jest sekwencjonowanie specyficzne dla nici w celu zidentyfikowania i wyeliminowania antysensownych transkryptów związanych z L1. Zastosowanie adnotacji dla pełnej długości L1 z funkcjonalnymi regionami promotorowymi podczas identyfikacji liczby transkryptów RNA-Seq, które mapują się na L1, eliminuje również szum tła, który w przeciwnym razie pochodzi z obciętych L1. Wreszcie, ostatnim krytycznym krokiem w eliminacji szumu transkrypcyjnego sekwencji L1 niezwiązanych z retrotranspozycją L1 jest ręczna selekcja pełnej długości L1, które zidentyfikowano jako mapowane transkrypty RNA-Seq. Ręczna selekcja polega na wizualizacji każdego bioinformatycznie zidentyfikowanego locus L1 do ekspresji w kontekście otaczającego go środowiska genomowego w celu potwierdzenia, że ekspresja pochodzi od promotora L1. Podejście to zastosowano do DU145, linii komórkowej guza prostaty. Nawet przy wszystkich krokach związanych z przygotowaniem podjętych w celu zmniejszenia szumu tła, około 50% loci L1 zidentyfikowanych bioinformacyjnie w DU145 zostało odrzuconych jako szum tła L1 pochodzący z innych źródeł transkrypcji (Figura 4), podkreślając rygor wymagany do uzyskania wiarygodnych wyników. To podejście wykorzystujące ręczną selekcję jest pracochłonne, ale niezbędne w rozwoju tego potoku w celu oceny i zrozumienia środowiska genomowego otaczającego L1 o pełnej długości. Kolejne kroki obejmują zmniejszenie ilości niezbędnej ręcznej kuracji poprzez automatyzację niektórych reguł selekcji, chociaż ze względu na wciąż nie do końca znaną naturę ekspresji genomowej, nieoznaczone źródła ekspresji w genomie referencyjnym, regiony o niskiej podatności na mapowanie, a nawet czynniki komplikujące związane z budową genomu referencyjnego, nie jest obecnie możliwe pełne zautomatyzowanie kuracji L1.
Drugie wyzwanie związane z identyfikacją ekspresji poszczególnych loci L1 za pomocą sekwencjonowania dotyczy mapowania powtarzających się transkryptów L1. W tej strategii dopasowania wymagane jest, aby transkrypt był jednoznacznie i współliniowo wyrównany z genomem referencyjnym, aby mógł zostać zmapowany. Wybierając sekwencje sparowanych końców, które mapują się zgodnie, zwiększa się liczba transkryptów, które jednoznacznie dopasowują się do loci L1 znalezionych w genomie referencyjnym. Ta unikatowa strategia mapowania zapewnia pewność wywoływania odczytów mapujących specyficznie do pojedynczego locus L1, chociaż potencjalnie zaniża ilość wyrażeń każdego zidentyfikowanego jako autentycznie wyrażonego, powtarzalnego L1. Aby w przybliżeniu skorygować to niedoszacowanie, opracowano wynik "mapowalności" dla każdego locus L1 na podstawie jego mapowalności i zastosowano go do liczby unikalnie zmapowanych odczytów transkryptu (Rysunek 6). Należy zauważyć, że idealnie byłoby, gdyby mapowalność była oceniana do odczytów pełnego pokrycia na całej długości L1 zgodnie z dopasowaną próbką WGS. Tutaj używamy WGS komórek HeLa do określenia wyników mapowalności każdego loci L1 w celu nadmuchania lub opróżnienia odczytów mapowania na loci L1 w liniach komórkowych guza prostaty DU145. To obliczenie maplakowalności jest surowym wynikiem korekcyjnym, ale wybrana "pełna mapowalność pokrycia" wynosząca 400 odczytów została określona z myślą o dynamicznej naturze linii komórek nowotworowych. Na rysunku uzupełniającym 1 można zaobserwować, że istnieje kilka loci L1 z HeLa WGS o wyjątkowo dużej liczbie zmapowanych odczytów. Prawdopodobnie pochodzą one ze zduplikowanych sekwencji chromosomów w obrębie HeLa, które nie znajdują się w genomie referencyjnym, dlatego te loci nie zostały wybrane jako reprezentatywne dla pełnego pokrycia mapowalności. Zamiast tego ustalono, że średnie pokrycie 100% odczytu występuje około 400 odczytów, zgodnie z rysunkiem uzupełniającym 1 , a następnie założono, że średnia ta dotyczy również linii komórkowej guza prostaty DU145.
Ta strategia dopasowania z odczytami 100-200 pz z technologii RNA-Seq preferencyjnie selekcjonuje również ewolucyjnie starsze L1 w genomie referencyjnym, ponieważ starsze L1 zgromadziły z czasem unikalne mutacje, które sprawiają, że są bardziej podatne na mapowanie. Podejście to ma zatem ograniczoną czułość, jeśli chodzi o identyfikację najmłodszych L1, a także niereferencyjnych, polimorficznych L1. Aby zidentyfikować najmłodszego z L1, sugerujemy użycie 5' RACE selekcji transkryptów L1 i technologii sekwencjonowania, takiej jak PacBio, która wykorzystuje dłuższe odczyty21. Pozwala to na bardziej unikalne mapowanie, a tym samym pewną identyfikację ekspresji, młodych L1. Połączenie RNA-Seq i PacBio może prowadzić do bardziej wyczerpującej listy autentycznie wyrażonych L1. Aby zidentyfikować autentycznie wyrażone polimorficzne L1, pierwsze kolejne kroki obejmują budowę i wstawienie sekwencji polimorficznych do genomu referencyjnego.
Biologiczne i techniczne wyzwania związane z badaniem powtarzających się sekwencji są ogromne, chociaż dzięki powyższej rygorystycznej procedurze usuwania szumu transkrypcyjnego sekwencji L1 niezwiązanych z retrotranspozycją przy użyciu technologii sekwencjonowania RNA, zaczynamy przesiewać duże poziomy transkrypcyjnego szumu tła i pewnie i rygorystycznie identyfikować wzorce ekspresji L1 i ilość na poziomie poszczególnych locus.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Chcielibyśmy podziękować doktorowi Yan Dongowi za komórki nowotworowe prostaty DU145. Chcielibyśmy podziękować dr Nathanowi Ungerleiderowi za jego wskazówki i rady w tworzeniu skryptów superkomputerowych. Niektóre z tych prac zostały sfinansowane z grantów NIH R01 GM121812 dla PD, R01 AG057597 dla VPB i 5TL1TR001418 dla TK. Chcielibyśmy również podziękować za wsparcie ze strony Cancer Crusaders i Tulane Cancer Center Bioinformatics Core.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 1 M HEPES | Affymetrix | AAJ16924AE | |
| 5 M Bioanalizator NaCl | Invitrogen | AM9760G | |
| Agilent 2100 | Agilent technologies | ||
| Zestaw Agilent RNA 6000 Nano | Agilent technologies | 5067-1511 | |
| bedtools.26.0 | https://bedtools.readthedocs.io/en/latest/content/installation.html | ||
| muszka-0.12.8 | Skrobak do https://sourceforge.net/projects/bowtie-bio/files/bowtie/0.12.8/ | ||
| komórek | Olympus plastics | 25-270 | |
| Chloroform | Fisher | C298-500 | |
| Digitonin | Research Products International Corp | 50-488-644 | |
| Etanol | Fisher | A4094 | |
| Gibco (sól fizjologiczna buforowana fosforanami) | Invitrogen | 10-010-049 | |
| Homogenizator | Thomas Scientific | BBI-8541906 | |
| IGV 2.4 | https://software.broadinstitute.org/software/igv/download | ||
| Isopropanol | Fisher | A416-500 | |
| mac2unix | https://sourceforge.net/projects/cs-cmdtools/files/mac2unix/ | ||
| Q-tips | Fisher | 23-400-122 | |
| Roztwór do usuwania RNAzyz później | Invitrogen | AM7022 | |
| RNaseZap RNase Dekontaminacja Roztwór | Invitrogen | AM9780 | |
| samtools-1.3 | https://sourceforge.net/projects/samtools/files/ | ||
| sratoolkit.2.9.2 | https://github.com/ncbi/-tools/wiki/Downloads | ||
| SUPERaza· W inhibitorze RNazy | Invitrogen | AM2694 | |
| Trizol | Invitrogen | 15-596-018 | |
| Woda (bez DNASE, RNAZY) | Fisher | BP2484100 |
Bibliografia
- International Human Genome Sequencing. Initial sequencing and analysis of the human genome. Nature. 409, 860(2001).
- Brouha, B., et al. Hot L1s account for the bulk of retrotransposition in the human population. Proceedings of the National Academy of Sciences of the United States of America. 100 (9), 5280-5285 (2003).
- Dombroski, B. A., Mathias, S. L., Nanthakumar, E., Scott, A. F., Kazazian, H. H. Isolation of an active human transposable element. Science. 254 (5039), 1805(1991).
- Swergold, G. D. Identification, characterization, and cell specificity of a human LINE-1 promoter. Molecular and Cellular Biology. 10 (12), 6718-6729 (1990).
- Speek, M. Antisense promoter of human L1 retrotransposon drives transcription of adjacent cellular genes. Molecular and Cellular Biology. 21 (6), 1973-1985 (2001).
- Deininger, L., Batzer, M. A., Hutchison, C. A., Edgell, M. H. Master genes in mammalian repetitive DNA amplification. Trends in Genetics. 8 (9), 307-311 (1992).
- Boissinot, S., Chevret, P., Furano, A. L1 (LINE-1) Retrotransposon Evolution and Amplification in Recent Human History. Molecular Biology and Evolution. 17 (6), 915-918 (2000).
- Khazina, E., Weichenrieder, O. Non-LTR retrotransposons encode noncanonical RRM domains in their first open reading frame. Proceedings of the National Academy of Sciences of the United States of America. 106 (3), 731-736 (2009).
- Martin, S. L., Bushman, F. D. Nucleic acid chaperone activity of the ORF1 protein from the mouse LINE-1 retrotransposon. Molecular and Cellular Biology. 21 (2), 467-475 (2001).
- Feng, Q., Moran, M. H., Kazazian, H. H., Boeke, J. D. Human L1 Retrotransposon Encodes a Conserved Endonuclease Required for Retrotransposition. Cell. 87 (5), 905-916 (1996).
- Mathias, S. L., Scott, A. F., Kazazian, H. H., Boeke, J. D., Gabriel, A. Reverse transcriptase encoded by a human transposable element. Science. 254 (5039), 1808(1991).
- Luan, D. D., Korman, M. H., Jakubczak, J. L., Eickbush, T. H. Reverse transcription of R2Bm RNA is primed by a nick at the chromosomal target site: A mechanism for non-LTR retrotransposition. Cell. 72 (4), 595-605 (1993).
- van den Hurk, J. A. J. M., et al. Novel types of mutation in the choroideremia (CHM) gene: a full-length L1 insertion and an intronic mutation activating a cryptic exon. Human Genetics. 113 (3), 268-275 (2003).
- Miné, M., et al. A large genomic deletion in the PDHX gene caused by the retrotranspositional insertion of a full-length LINE-1 element. Human Mutation. 28 (2), 137-142 (2007).
- Solyom, S., et al. Pathogenic orphan transduction created by a nonreference LINE-1 retrotransposon. Human Mutation. 33 (2), 369-371 (2012).
- Hancks, D. C., Kazazian, H. H. Roles for retrotransposon insertions in human disease. Mobile DNA. Mobile DNA. 7, 9-9 (2016).
- Tubio, J. M. C., et al. Mobile DNA in cancer. Extensive transduction of nonrepetitive DNA mediated by L1 retrotransposition in cancer genomes. Science. 345 (6196), 1251343-1251343 (2014).
- Ewing, A. D., et al. Widespread somatic L1 retrotransposition occurs early during gastrointestinal cancer evolution. Genome Research. 25 (10), 1536-1545 (2015).
- Beck, C. R., Garcia-Perez, J. L., Badge, R. M., Moran, J. V. LINE-1 elements in structural variation and disease. Annual Review of Genomics and Human Genetics. 12, 187-215 (2011).
- Philippe, C., et al. Activation of individual L1 retrotransposon instances is restricted to cell-type dependent permissive loci. eLife. 5, e13926(2016).
- Deininger, P., et al. A comprehensive approach to expression of L1 loci. Nucleic Acids Research. 45 (5), e31-e31 (2017).
- Jin, Y., Tam, O. H., Paniagua, E., Hammell, M. TEtranscripts: a package for including transposable elements in differential expression analysis of RNA-seq datasets. Bioinformatics. 31 (22), 3593-3599 (2015).
- Agilent RNA 6000 Nano Kit Guide. , Agilent. (2017).
- Mueller, O. L., Schroeder, A. RNA Integrity Number (RIN) –Standardization of RNA Quality Control. , Agilent Technologies. (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nature Biotechnology. 29, 24(2011).
- Speek, M. Antisense promoter of human L1 retrotransposon drives transcription of adjacent cellular genes. Molecular Cellular Biology. 21 (6), 1973-1985 (2001).
- Belancio, V. P., Deininger, L., Roy-Engel, A. M. LINE dancing in the human genome: transposable elements and disease. Genome Medicine. 1 (10), 97-97 (2009).
- Iskow, R. C., et al. Natural Mutagenesis of Human Genomes by Endogenous Retrotransposons. Cell. 141 (7), 1253-1261 (2010).
- Scott, E. C., et al. A hot L1 retrotransposon evades somatic repression and initiates human colorectal cancer. Genome Research. 26 (6), 745-755 (2016).
- Kines, K. J., Sokolowski, M., deHaro, D. L., Christian, C. M., Belancio, V. P. Potential for genomic instability associated with retrotranspositionally-incompetent L1 loci. Nucleic Acids Research. 42 (16), 10488-10502 (2014).
Przedruki i uprawnienia
