Analiza ekspresji genów (CAGE) to metoda ilościowego mapowania końca 5 mRNA w całym genomie w celu uchwycenia miejsc początkowych transkrypcji polimerazy II RNA w rozdzielczości pojedynczego nukleotydu. W niniejszej pracy opisano protokół o niskim nakładzie wejściowym (SLIC-CAGE) do generowania wysokiej jakości bibliotek przy użyciu nanogramów całkowitego RNA.
Artykuł metodologiczny
Mapowanie miejsca rozpoczęcia transkrypcji przy użyciu bardzo niskiego wskaźnika wejściowego Carrier-CAGE
W tym artykule
Podsumowanie
Streszczenie
Analiza ekspresji genów metodą (CAGE) jest metodą używaną do wykrywania miejsc rozpoczęcia transkrypcji polimerazy II RNA (TSS) w rozdzielczości pojedynczego nukleotydu. Dokładne wykrywanie TSS usprawnia identyfikację i odkrywanie głównych promotorów. Ponadto aktywne wzmacniacze można wykryć za pomocą sygnatur dwukierunkowej inicjacji transkrypcji. Opisany tutaj jest protokół do wykonywania KLATKI NOŚNEJ O BARDZO NISKIM NAKŁADZIE WEJŚCIOWYM (SLIC-CAGE). Ta adaptacja protokołu CAGE do SLIC minimalizuje straty RNA poprzez sztuczne zwiększanie ilości RNA poprzez zastosowanie mieszanki nośników RNA transkrybowanych in vitro, które są dodawane do próbki będącej przedmiotem zainteresowania, umożliwiając w ten sposób przygotowanie biblioteki z nanogramowych ilości całkowitego RNA (tj. tysięcy komórek). Nośnik naśladuje oczekiwany rozkład długości fragmentów biblioteki DNA, eliminując w ten sposób odchylenia, które mogą być spowodowane obfitością jednorodnego nośnika. W ostatnich etapach protokołu nośnik jest usuwany w wyniku degradacji za pomocą endonukleaz naprowadzających, a biblioteka docelowa jest amplifikowana. Docelowa biblioteka próbek jest chroniona przed degradacją, ponieważ miejsca rozpoznawania endonukleazy naprowadzającej są długie (od 18 do 27 pz), co sprawia, że prawdopodobieństwo ich istnienia w genomach eukariotycznych jest bardzo niskie. Efektem końcowym jest biblioteka DNA gotowa do sekwencjonowania nowej generacji. Wszystkie kroki w protokole, aż do sekwencjonowania, można wykonać w ciągu 6 dni. Przygotowanie przewoźnika wymaga pełnego dnia pracy; Można go jednak przygotowywać w dużych ilościach i przechowywać w stanie zamrożonym w temperaturze -80 °C. Po zsekwencjonowaniu odczyty mogą być przetwarzane w celu uzyskania TSS o rozdzielczości pojedynczego nukleotydu w całym genomie. TSS mogą być wykorzystywane do odkrywania głównych promotorów lub wzmacniaczy, zapewniając wgląd w regulację genów. Po zagregowaniu do promotorów dane można również wykorzystać do profilowania ekspresji 5'centrycznej.
Wprowadzenie
Analiza ekspresji genów (CAGE) jest metodą używaną do mapowania całego genomu polimerazy II RNA (TSSs)1. Jego ilościowy charakter pozwala również na profilowanie ekspresji 5'-końcowej. Regiony otaczające TSS (około 40 pz w górę i w dół) są głównymi promotorami i reprezentują fizyczną lokalizację, w której wiąże się polimeraza RNA II i ogólne czynniki transkrypcyjne (omówione wcześniej2,3). Informacje o dokładnych lokalizacjach TSS mogą być wykorzystane do wykrywania głównych promotorów i monitorowania dynamiki promotorów. Ponadto, ponieważ aktywne wzmacniacze wykazują sygnatury dwukierunkowej transkrypcji, dane CAGE mogą być również wykorzystywane do wykrywania wzmacniaczy i monitorowania dynamiki wzmacniacza4. Metodologia CAGE zyskała ostatnio na popularności ze względu na jej szerokie zastosowanie i zastosowanie w prestiżowych projektach badawczych, takich jak ENCODE5, modENCODE6, oraz FANTOM projects7. Ponadto informacje TSS okazują się być również ważne dla rozróżnienia tkanek zdrowych i chorych, ponieważ TSS specyficzne dla choroby mogą być używane do celów diagnostycznych8.
Mimo że dostępnych jest kilka metod mapowania TSS (CAGE, RAMPAGE, STRT, nanoCAGE, nanoCAGE-XL, oligo-capping), my i inni ostatnio wykazaliśmy, że CAGE jest najbardziej bezstronną metodą przechwytywania prawdziwych TSS z najmniejszą liczbą fałszywych alarmów9,10. Najnowszy protokół CAGE, nAnT-iCAGE11, jest najbardziej bezstronnym protokołem do profilowania TSS, ponieważ unika cięcia fragmentów na krótkie znaczniki za pomocą enzymów restrykcyjnych i nie wykorzystuje amplifikacji PCR. Ograniczeniem protokołu nAnT-iCAGE jest wymóg dużej ilości materiału wyjściowego (np. 5 μg całkowitego RNA na każdą próbkę). Aby odpowiedzieć na konkretne, biologicznie istotne pytania, często niemożliwe jest uzyskanie tak dużych ilości materiału wyjściowego (np. dla komórek posortowanych metodą FACS lub wczesnych stadiów embrionalnych). Wreszcie, jeśli nAnT-iCAGE zakończy się sukcesem, z każdej próbki dostępne są tylko 1-2 ng materiału z biblioteki DNA, co ogranicza osiągalną głębokość sekwencjonowania.
Aby umożliwić profilowanie TSS przy użyciu tylko nanogramów całkowitego RNA, niedawno opracowaliśmy Super-Low Input Carrier-CAGE10 (SLIC-CAGE, Rysunek 1). SLIC-CAGE wymaga tylko 10 ng całkowitego RNA, aby uzyskać biblioteki o wysokiej złożoności. Nasz protokół opiera się na starannie zaprojektowanym syntetycznym nośniku RNA dodawanym do interesującego nas RNA, aby uzyskać łącznie 5 μg materiału RNA. Syntetyczny nośnik naśladuje docelową bibliotekę DNA w rozkładzie długości, aby uniknąć potencjalnych odchyleń, które mogą być spowodowane nadmiarem jednorodnych cząsteczek. Sekwencja nośnika opiera się na sekwencji genu syntetazy leucylo-tRNA Escherichia coli (Tabela 1) z dwóch powodów. Po pierwsze, wszelkie resztki nośnika w końcowej bibliotece, nawet jeśli zostaną zsekwencjonowane, nie zostaną zmapowane na genom eukariotyczny. Po drugie, ponieważ E. coli jest gatunkiem mezofilnym, jego geny odpowiedzialne za gospodarowanie są zoptymalizowane pod kątem zakresu temperatur odpowiedniego dla SLIC-CAGE. Sekwencja nośnika jest również osadzona w naprowadzających się miejscach rozpoznawania endonukleazy, aby umożliwić specyficzną degradację DNA pochodzącego z cząsteczki nośnika RNA. Docelowa biblioteka pochodząca z próbki pozostaje nienaruszona, ponieważ miejsca rozpoznawania endonukleazy naprowadzającej są długie (I-CeuI = 27 pz; I-SceI = 18 pz) i statystycznie mało prawdopodobne, aby został znaleziony w genomach eukariotycznych. Po określonej degradacji nośnika i usunięciu fragmentów przez wykluczenie rozmiaru, biblioteka docelowa jest amplifikowana metodą PCR i gotowa do sekwencjonowania nowej generacji. W zależności od wyjściowej ilości RNA (1-100 ng) oczekuje się, że wymagane będzie od 13 do 18 cykli amplifikacji PCR. Ostateczna ilość DNA na każdą próbkę waha się między 5-50 ng, co daje wystarczającą ilość materiału do bardzo głębokiego sekwencjonowania. Przy użyciu tylko 1-2 ng całkowitego RNA można wykryć prawdziwe TSS; Oczekuje się jednak, że biblioteki będą miały mniejszą złożoność. Wreszcie, ponieważ SLIC-CAGE jest oparty na protokole nAnT-iCAGE 11, umożliwia multipleksowanie do ośmiu próbek przed sekwencjonowaniem.
Protokół
1. Przygotowanie przewoźnika
- Przygotowanie matryc DNA do transkrypcji in vitro
- Przygotuj mieszaninę PCR dla każdej matrycy PCR, łącząc 41 μl wody, 20 μl 5x buforu HF, 8 μl 2,5 mM dNTP, 10 μL 10 μM unikalnego startera do przodu (PCR_GN5_f1, Tabela 2; startery rozpuszcza się i rozcieńcza w wodzie), 10 μl plazmidu matrycowego 2 ng/μL zawierającego syntetyczny gen nośnikowy i 1 μl polimerazy Phusion. Wymieszać mieszaninę PCR przez pipetowanie. Mieszankę wzorcową dla wszystkich 10 szablonów można przygotować jednocześnie (przygotować się na 11 reakcji).
- Dodać 90 μl mieszanki PCR do 10 μl każdego 10 μM startera odwrotnego (PCR_N6_r1-r10, tabela 2). Wymieszać pipetując.
- PCR amplifikować matryce za pomocą następującego programu: 98 °C przez 60 s, (98 °C przez 10 s, 50 °C przez 30 s, 72 °C przez 30 s) 35 cykli, 72 °C przez 10 min, utrzymywać w temperaturze 4 °C.
- Oczyszczanie w żelu matryc DNA amplifikowanych PCR
- Przygotuj 1% żel agarozowy (zalecana jest agaroza niskotopliwa).
- Aby zmniejszyć objętość, należy zagęścić mieszaniny reakcyjne PCR od 100 μl do 20 μl całkowitej objętości za pomocą koncentratora próżniowego w niskiej temperaturze medium (30–40 °C).
- Dodaj 6 μl barwnika 6x ładującego, dobrze wymieszaj i nałóż na żel. Uruchomić elektroforezę przez 30 minut w 1x buforze TAE o napięciu odpowiednim dla używanego zbiornika do elektroforezy (5–10 V/cm). Równolegle przeprowadza się drabinę DNA o splocie 100 pz lub 1000 pz.
- Za pomocą czystego skalpela wyciąć plastry żelu zawierające docelowy produkt PCR. Unikaj nadmiaru żelu agarozowego. Oczyść produkty PCR za pomocą zestawu do ekstrakcji żelu (zgodnie z instrukcjami producenta).
nuta: Proporcje A260/A230 DNA wyizolowanego z żeli agarozowych są zwykle niskie (0,1–0,3). Oczekiwany produkt docelowy i produkty uboczne są pokazane w Rysunek 2A. Oczekiwana wydajność ze 100 μl reakcji PCR wynosi 1,2–3 μg. Reakcje można skalować w górę, aby uzyskać wyższą wydajność.
- Transkrypcja in vitro cząsteczek nośnikowych
- Transkrybować nośnik RNA in vitro przy użyciu polimerazy RNA T7 zgodnie z instrukcjami producenta. Przygotuj 10–20 μl reakcji (zalecany zestaw znajduje się w Tabeli materiałów).
- Oczyść transkrybowane RNA in vitro za pomocą zestawu do oczyszczania RNA. Ustawić trawienie DNA w roztworze przy użyciu DNazy I, postępując zgodnie ze standardowymi instrukcjami producenta, i wymyć RNA w 50 μl wody. Aby zwiększyć wydajność elucji, pozostaw wodę w kolumnie na 5 minut przed odwirowaniem.
nuta: Należy uważać, aby nie przekroczyć maksymalnej zdolności wiązania kolumn (w zestawie wymienionym w Tabeli Materiałów pojemność wynosi do 100 μg). Oczekiwany plon z matryc PCR 1–10 (o długości od 1 kbp do 200 pz) wynosi 25–50 μg z 10 μl reakcji transkrypcji in vitro. Reakcje można skalować w górę, aby uzyskać większy zapas cząsteczek nośnikowych.
- Zamykanie transkrybowanych in vitro cząsteczk nośnika RNA
- Przygotuj mieszankę zamykającą, łącząc 2 μl 10x buforu zamykającego, 1 μl 10 mM GTP, 1 μl 2 mM SAM (świeżo rozcieńczony) i 1 μl enzymu zamykającego Vaccinia na nośnik RNA.
- Wymieszać do 10 μg każdej cząsteczki nośnika w 15 μl całkowitej objętości i denaturować przez 10 minut w temperaturze 65 °C. Natychmiast umieścić na lodzie, aby zapobiec tworzeniu się drugorzędowej struktury.
- Wymieszać zdenaturowany nośnik RNA z 5 μl mieszanki zamykającej i inkubować przez 1 godzinę w temperaturze 37 °C.
- Oczyść cząsteczki RNA z czapeczką za pomocą zestawu do oczyszczania RNA — postępuj zgodnie z protokołem czyszczenia producenta. Eluować RNA w 30 μl wody. Aby zwiększyć wydajność elucji, pozostaw wodę w kolumnie na 5 minut przed odwirowaniem.
nuta: Zmierzyć stężenie za pomocą spektrofotometru mikroobjętościowego. Przewidywany stosunek A260/A280 wynosi >2, a A260/A230 wynosi >2. Należy pamiętać, że dla niektórych próbek RNA A260/A230 może wynosić od 1,3 do 2. Oczekiwana wydajność przy użyciu 10 μg nieosłoniętego RNA wynosi 9–10 μg ograniczonego RNA.
- Przygotować mieszaninę zamkniętego i niezamkniętego nośnika, łącząc ilości opisane w tabeli 3. Dobrze wymieszaj, przesuwając probówkę i zmierz stężenie za pomocą spektrofotometru mikroobjętościowego.
nuta: Jeżeli do reakcji odwrotnej transkrypcji wymagane jest wyższe stężenie nośnika (patrz poniżej), mieszaninę nośników można zagęszczać za pomocą koncentratora próżniowego w niskiej i średniej temperaturze (30-35 °C) aż do osiągnięcia pożądanego stężenia końcowego. Kroki 2–14 są modyfikowane w stosunku do standardowego protokołu nAnT-iCAGE zgłoszonego przez Murata et al.11
2. Odwrotna transkrypcja
- Połączyć 1 μl startera RT (2,5 mM TCT-N6 rozpuszczonego w wodzie, sekwencja patrz Tabela Uzupełniająca 1), 10 ng całkowitego RNA będącego przedmiotem zainteresowania i 4,990 ng mieszaniny nośników (Tabela 3) w 10 μL całkowitej objętości na płytce PCR o niskim poziomie wiązania. Wymieszaj, przesuwając rurkę.
nuta: Jeśli próbka RNA jest zbyt rozcieńczona, aby można było przeprowadzić odwrotną transkrypcję (patrz poniżej), połączyć ją z odpowiednią ilością nośnika, zagęścić za pomocą koncentratora próżniowego do 9 μl całkowitej objętości i dodać 1 μl startera RT. Dodanie mięśnia nośnego, aby osiągnąć łącznie 5 μg RNA, zapobiega utracie próbki. - Podgrzewać mieszaninę z kroku 2.1 w temperaturze 65 °C przez 5 minut i natychmiast umieścić na lodzie, aby zapobiec renaturyzacji.
- Przygotuj mieszaninę do odwrotnej transkrypcji (RT).
- Do każdej próbki należy dodać 6,1 μl wody (bez RNaz i DNaz), 7,6 μl 5x buforu pierwszej nici, 1,9 μl 0,1 M DTT, 1 μl 10 mM dNTP, 7,6 μl mieszaniny trehalozy/sorbitolu (patrz przepis w Murata et al.11) i 3,8 μl zalecanej odwrotnej transkryptazy (patrz Tabela materiałów). Dobrze wymieszaj, przesuwając rurkę.
- Dodać 28 μl mieszanki RT do probówki PCR z 10 μl RNA, nośnikiem i starterem RT (całkowita objętość 38 μL). Dobrze wymieszać pipetując.
nuta: Mieszanka jest bardzo lepka ze względu na trehalozę/sorbitol. Mieszaj, aż uzyskasz widoczną jednorodność. - Inkubować w termocyklerze w następującym programie: 25 °C przez 30 s, 50 °C przez 60 minut i utrzymywać w temperaturze 4 °C.
- Oczyszczanie hybryd cDNA:RNA za pomocą kulek magnetycznych SPRI
- Dodać 68,4 μl zalecanych kulek SPRI wolnych od RNAzowe i DNaz (patrz tabela materiałów) do 38 μl mieszanki RT (stosunek kulek do próbki 1,8:1). Dobrze wymieszać pipetując i inkubować przez 5 minut w temperaturze pokojowej (RT).
- Oddziel kulki na stojaku magnetycznym na 5 minut. Wyrzuć supernatant i umyj kulki dwukrotnie 200 μl 70% etanolu (świeżo przygotowanego).
nuta: Etanol jest dodawany do kulek bez mieszania i gdy rurka znajduje się na stojaku magnetycznym. Dodany etanol jest natychmiast usuwany. Należy uważać, aby nie zgubić żadnych kulek podczas prania, ponieważ może to prowadzić do utraty próbki. - Gdy rurka jest nadal na stojaku magnetycznym, usuń wszelkie ślady etanolu. Kropelki etanolu można usunąć i wypchnąć z rurki za pomocą pipety P10. Nie pozwól, aby koraliki wyschły.
- Dodać 42 μl wody podgrzanej do temperatury 37 °C do kulek i eluować próbkę, pipetując w górę i w dół 60x,
nuta: Należy uważać, aby nie spowodować pienienia się przez pipetowanie, ponieważ może to spowodować utratę kulek (tj. związanej próbki) w piance. - Inkubować w temperaturze 37 °C przez 5 minut bez pokrywy, aby umożliwić odparowanie śladowych ilości etanolu.
- Oddziel kulki na stojaku magnetycznym na 5 minut i przenieś supernatant na nową płytkę.
nuta: Spróbuj pobrać cały supernatant, aby zapobiec utracie próbki, unikając jednocześnie przeniesienia kulek. Użyj pipety P10, aby uzyskać ostatnie kropelki próbki.
3. Utlenianie
- Dodać 2 μl 1 M NaOAc (pH 4,5) do oczyszczonej reakcji RT. Wymieszać pipetując, dodać 2 μl 250 mM NaIO4 i ponownie wymieszać.
- Inkubować na lodzie przez 45 minut. Przykryj płytkę folią aluminiową, aby uniknąć światła.
- Dodać 16 μl Tris-HCl (pH 8,5) do mieszaniny utleniającej, aby zneutralizować pH.
- Oczyść utlenione hybrydy cDNA:RNA za pomocą kulek magnetycznych SPRI. Dodać 108 μl kulek SPRI do 60 μl mieszaniny utleniającej (stosunek 1,8:1 kulek do próbki). Powtórz oczyszczanie zgodnie z opisem w krokach 2.6.1–2.6.6. Eluować za pomocą 42 μl wody podgrzanej do temperatury 37 °C.
nuta: Świeżo przygotuj 250 mM NaIO4, dodając 18,7 μl wody na 1 mg NaIO4. NaIO4 jest światłoczuły; Dlatego roztwór należy przechowywać w probówce pokrytej folią aluminiową lub w probówce odpornej na światło.
4. Biotynylacja
- Dodać 4 μl 1 M NaOAc (pH 6,0) do probówki zawierającej oczyszczoną utlenioną próbkę i wymieszać pipetując.
- Dodać 4 μl 10 mM roztworu biotyny, wymieszać pipetując i inkubować przez 2 godziny w temperaturze 23 °C w termocyklerze, aby uniknąć światła.
nuta: Przygotuj roztwór biotyny, mieszając 50 mg biotyny z 13,5 ml DMSO. Przygotować porcje jednorazowego użytku i zamrozić w temperaturze -80 °C. - Oczyść biotynylowane hybrydy cDNA:RNA za pomocą kulek magnetycznych SPRI. Dodać 12 μl 2-propanolu i wymieszać pipetując. Dodać 108 μl kulek SPRI (stosunek kulek 1,8:1 do próbki) i powtórzyć oczyszczanie zgodnie z opisem w krokach 2.6.1–2.6.6. Eluować za pomocą 42 μl wody podgrzanej do temperatury 37 °C.
nuta: W tym miejscu można wstrzymać działanie protokołu, a próbki zamrozić w temperaturze -80 °C.
5. Trawienie RNazy I
- Przygotować mieszaninę RNazy I, mieszając 4,5 μl 10x buforu RNazy I z 0,5 μl RNazy I (10 U/μL) na każdą próbkę. Wymieszać pipetując.
- Dodać 5 μl mieszaniny do każdej oczyszczonej próbki (łącznie 45 μl). Wymieszać pipetując i inkubować przez 30 minut w temperaturze 37 °C.
6. Przygotowanie koralików Streptawidin
- Dla każdej próbki zmieszać 30 μl zawiesiny z kulkami streptawidyny z 0,38 μl 20 mg/ml tRNA. Inkubować na lodzie przez 30 minut i mieszać co 5 minut, przesuwając rurkę.
nuta: Ponownie zawiesić zawiesinę kulek streptawidyny przed pipetowaniem, przesuwając butelkę. Roztwór tRNA należy przygotować zgodnie z Murata et al.11 - Oddziel koraliki na stojaku magnetycznym na 2–3 minuty. Usuń supernatant.
- Umyj kulki przez ponowne podłączenie w 15 μl buforu A. Oddziel kulki na stojaku magnetycznym na 2–3 minuty i usuń supernatant. Powtórzyć pranie i usunąć supernatant.
- Ponownie zawiesić kulki w 105 μl buforu A i dodać 0,19 μl 20 mg/ml tRNA. Dobrze wymieszać pipetując.
nuta: Koraliki powinny być przygotowane świeże przed użyciem. Przygotowanie kulek należy rozpocząć podczas trawienia RNazy I. W przypadku wielu próbek przygotuj koraliki razem w jednej probówce.
7. Zatrzaskiwanie czapek
- Przykładowe wiązanie
- Dodać 105 μl przygotowanych kulek streptawidyny do 45 μl próbki poddanej działaniu RNazy I. Dobrze wymieszać pipetując i inkubować w temperaturze 37 °C przez 30 minut. Mieszać pipetując co 10 minut.
- Oddziel koraliki na stojaku magnetycznym na 2–3 minuty. Usuń supernatant.
- Koraliki do prania
- Dodać 150 μl buforu do przemywania A i ponownie zawiesić kulki przez pipetowanie. Oddziel koraliki na stojaku magnetycznym na 2–3 minuty i usuń supernatant.
- Dodać 150 μl buforu do przemywania B i ponownie zawiesić kulki przez pipetowanie. Oddziel koraliki na stojaku magnetycznym na 2–3 minuty i usuń supernatant.
- Dodać 150 μl buforu do przemywania C i ponownie zawiesić kulki przez pipetowanie. Oddziel kulki na stojaku magnetycznym na 2–3 minuty i usuń supernatant.
nuta: B i C należy wstępnie podgrzać do temperatury 37 °C. Przepisy na myjące A, B i C są opisane w Murata et al.11
- Uwalnianie cDNA
- Przygotuj 1x bufor RNazy I, mieszając 58,5 μl wody z 6,5 μl 10x buforu RNazy I.
- Ponownie zawiesić kulki w 35 μl 1x buforu RNazy I. Inkubować w temperaturze 95 °C przez 5 minut i przenosić bezpośrednio na lód przez 2 minuty, aby zapobiec ponownej asocjacji cDNA. Trzymaj pokrywki podczas przenoszenia do lodu, ponieważ mogą odskoczyć z powodu wzrostu ciśnienia.
- Oddziel kulki na 2-3 minuty na stojaku magnetycznym i przenieś supernatant na nową płytkę.
- Ponownie zawiesić kulki w 30 μl 1x buforu RNazy I. Oddzielamy kulki na podstawce magnetycznej na 2–3 minuty i przenosimy supernatant do wcześniej pobranego supernatantu (całkowita objętość wymytego cDNA powinna wynosić około 65 μL).
8. Usuwanie RNA przez trawienie RNazy H i RNazy I
- Na próbkę połącz 2,4 μl wody, 0,5 μl 10x buforu RNazy I, 0,1 μl RNazy H i 2 μl RNazy I.
- Dodać 5 μl mieszaniny do 65 μl uwolnionej próbki cDNA i wymieszać pipetując. Inkubować w temperaturze 37 °C przez 15 minut i utrzymywać w temperaturze 4 °C.
- Oczyść cDNA z mieszanki trawiennej RNazy za pomocą kulek magnetycznych SPRI. Dodać 126 μl kulek SPRI do 70 μl reakcji degradacji i wymieszać pipetując. Postępuj zgodnie z etapami oczyszczania opisanymi dla oczyszczania kulek SPRI w 2.6.1–2.6.6. Eluować za pomocą 42 μl wody podgrzanej do temperatury 37 °C, zgodnie z opisem.
- Przygotuj mieszaninę RNazy I, łącząc 4,5 μl 10x buforu RNazy I i 0,5 μl RNazy I.
- Dodać 5 μl mieszaniny RNazy do 40 μl oczyszczonej próbki cDNA. Mieszać pipetując i inkubować w temperaturze 37 °C przez 30 min. Przechowywać w temperaturze 4 °C.
- Oczyść próbkę za pomocą kulek magnetycznych SPRI. Dodać 81 μl kulek SPRI do 45 μl reakcji degradacji i wymieszać pipetując. Postępuj zgodnie z etapami oczyszczania opisanymi dla oczyszczania kulek SPRI w 2.6.1–2.6.6. Elute przy użyciu 42 μl wody zgodnie z opisem.
9. Podwiązanie łącznika 5'
- Zagęścić oczyszczoną próbkę cDNA do 4 μl za pomocą koncentratora próżniowego. Utrzymuj temperaturę na poziomie 30–35 °C. Zbadaj objętość za pomocą pipety. Jeśli próbka wyschła do kompletności, rozpuścić ją, dodając 4 μl wody.
nuta: Lepiej jest unikać suszenia do kompletności, aby zapobiec utracie próbki. - Inkubować zagęszczoną próbkę w temperaturze 95 °C przez 5 minut i natychmiast umieścić na lodzie na 2 minuty, aby zapobiec renaturyzacji. Przytrzymaj pokrywki podczas przenoszenia rurek, ponieważ pokrywki mogą wyskoczyć z powodu wzrostu ciśnienia.
- Inkubować 4 μl łącznika 2,5 μM 5' w temperaturze 55 °C przez 5 minut i natychmiast umieścić na lodzie na 2 minuty, aby zapobiec renaturyzacji.
- Zmieszać 4 μl łącznika 2,5 μM 5' z 4 μl próbki.
nuta: Łącznik 5' należy przygotować zgodnie z tabelą uzupełniającą 2, tabelą uzupełniającą 3, tabelą uzupełniającą 4 i tabelą uzupełniającą 5. Przed użyciem rozcieńczyć łącznik 10 μM 5' do stężenia 2,5 μM przy użyciu 100 mM NaCl. - Dodać 16 μl premiksu do ligacji (patrz tabela materiałów) do wymieszanego łącznika 5' i próbki, a następnie dobrze wymieszać przez pipetowanie. Inkubować w temperaturze 16 °C przez 16 godzin.
- Oczyść mieszankę do podwiązywania za pomocą kulek magnetycznych SPRI. Dodaj 43,2 μl kulek SPRI i postępuj zgodnie z krokami 2.6.1–2.6.6. Eluować zgodnie z opisem, używając 42 μl wody podgrzanej do temperatury 37 °C.
- Powtórzyć oczyszczanie wykonane w kroku 9.6, dodając 72 μl kulek SPRI do przeniesionego supernatantu (stosunek kulek 1,8:1 do próbki).
UWAGA: Łączniki 5' zawierają kody kreskowe, które umożliwiają zebranie do ośmiu próbek przed sekwencjonowaniem (dostępnych jest osiem kodów kreskowych trinukleotydów, zgodnie z opisem w Murata et al.11 i Tabela uzupełniająca 1).
10. Podwiązanie łącznika 3'
- Zagęścić oczyszczoną próbkę do 4 μl za pomocą koncentratora próżniowego, jak opisano w kroku 9.1.
- Inkubować zagęszczoną próbkę w temperaturze 95 °C przez 5 minut i natychmiast umieścić na lodzie na 2 minuty, aby zapobiec renaturyzacji. Przytrzymaj pokrywki podczas przenoszenia probówek, ponieważ pokrywki mogą odskoczyć z powodu wzrostu ciśnienia.
- Inkubować 4 μl łącznika 2,5 μM 3' w temperaturze 65 °C przez 5 minut i natychmiast umieścić na lodzie na 2 minuty, aby zapobiec renaturyzacji.
- Dodać 4 μl łącznika 2,5 μM 3' do 4 μl zagęszczonej próbki.
- Dodać 16 μl premiksu do podwiązywania i dobrze wymieszać pipetując. Inkubować w temperaturze 16 °C przez 16 godzin.
- Oczyść mieszankę do podwiązywania za pomocą kulek magnetycznych SPRI. Dodaj 43,2 μl kulek SPRI i postępuj zgodnie z krokami 2.6.1–2.6.6. Elutę zgodnie z opisem przy użyciu 42 μl wody podgrzanej do temperatury 37 °C.
nuta: Łącznik 3' należy przygotować zgodnie z tabelami uzupełniającymi 6 i tabelą uzupełniającą 7. Rozcieńczyć łącznik 10 μM 3' do stężenia 2,5 μM przy użyciu 100 mM NaCl.
11. Defosforylacja
- Przygotuj mieszankę SAP, łącząc 4 μl wody, 5 μl 10x buforu SAP i 1 μl enzymu SAP.
- Dodać 10 μl mieszanki SAP do oczyszczonej ligowanej próbki (całkowita objętość 50 μl) i inkubować w termocyklerze przy użyciu następującego programu: 37 °C przez 30 min, 65 °C przez 15 min i utrzymywać w temperaturze 4 °C.
12. Degradacja górnej nici łącznika 3' przy użyciu enzymu wycinającego specyficznego dla uracylu
- Dodać 2 μl enzymu do wycinania swoistego dla uracylu (patrz tabela materiałów) do odfosforylowanej próbki, wymieszać pipetując i inkubować w termocyklerze przy użyciu następującego programu: 37 °C przez 30 min, 95 °C przez 5 min i natychmiast umieścić na lodzie na 2 min, aby zapobiec ponownemu wyżarzaniu rozdrobnionej górnej nici.
- Oczyścić mieszaninę reakcyjną, dodając 93,6 μl kulek magnetycznych SPRI do mieszaniny 52 μl i dobrze wymieszać przez pipetowanie. Powtórzyć etapy oczyszczania 2.6.1–2.6.6. Eluować za pomocą 42 μl wody podgrzanej do temperatury 37 °C, zgodnie z opisem.
13. Synteza drugiej nici
- Przygotować mieszaninę do syntezy drugiej nici (objętości są wyrażone na próbkę) przez połączenie 5 μl 10x buforu reakcyjnego polimerazy DNA, 2 μl wody, 1 μl 10 mM dNTP, 1 μL 50 μM startera drugiej nici nAnT-iCAGE (sekwencja znajduje się w tabeli uzupełniającej 1) i 1 μl polimerazy z niedoborem egzonukleazy DNA (patrz zalecana polimeraza w Tabeli materiałów).
- Dodać 10 μl mieszaniny do oczyszczonej próbki i dobrze wymieszać przez pipetowanie (całkowita objętość wynosi 50 μl). Inkubować w termocyklerze w następującym programie: 95 °C przez 5 minut, 55 °C przez 5 minut, 72 °C przez 30 minut i utrzymywać w temperaturze 4 °C.
14. Degradacja startera syntezy drugiej nici przy użyciu egzonukleazy I
- Dodać 1 μl egzonukleazy I do mieszaniny do syntezy drugiej nici. Dobrze wymieszać pipetując i inkubować w temperaturze 37 °C przez 30 minut, a następnie przetrzymywać w temperaturze 4 °C.
- Oczyść dwuniciowy DNA, dodając 91,8 μl kulek magnetycznych SPRI do 51 μl próbki poddanej działaniu egzonukleazy I. Powtórzyć etapy oczyszczania opisane w pkt 2.6.1–2.6.6. i eluować za pomocą 42 μl wody podgrzanej do temperatury 37 °C, zgodnie z opisem.
- Zagęścić próbkę za pomocą koncentratora próżniowego do 15 μl, jak opisano w kroku 9.1.
15. Kontrola jakości i ilości
- Użyj 1 μl skoncentrowanych próbek i uruchom chip DNA o wysokiej czułości na analizatorze jakości DNA. Oczekiwany profil/ilość jest przedstawiona w Rysunek 3.
16. Pierwsza runda degradacji nośnika
- Przygotować mieszaninę degradacji, łącząc 2 μl wody, 2 μl 10-krotnego buforu enzymu restrykcyjnego, 1 μl I-SceI i 1 μl I-CeuI.
- Dodać 6 μl mieszaniny degradacji do 14 μl zagęszczonej próbki i wymieszać pipetując. Inkubować w temperaturze 37 °C przez 3 godziny, a następnie 20 minut dezaktywować w temperaturze 65 °C i utrzymywać w temperaturze 4 °C.
- Oczyść mieszaninę degradacji za pomocą kulek magnetycznych SPRI. Dodać 5 μl wody, aby zwiększyć objętość mieszaniny degradacji i dodać 45 μl kulek SPRI (stosunek kulek 1,8:1 do próbki). Powtórzyć oczyszczanie zgodnie z opisem w krokach 2.6.1–2.6.6. i wymyć za pomocą 42 μl wody podgrzanej do temperatury 37 °C.
- Zagęścić eluowaną próbkę od 42 μl do 20 μl całkowitej objętości, jak opisano w kroku 9.1.
17. Kontrola poziomu degradacji i określanie liczby cykli amplifikacji PCR
- Przygotuj miks qPCR do amplifikacji całych bibliotek (miks adaptorowy). Połącz 3,8 μl wody, 5 μl premiksu qPCR (2x), 0,1 μl 10 μM adaptor_f1 startera (5'-AATGATACGGCGACCGA-3') i 0,1 μL 10 μM adaptor_r1 startera (5'-CAAGCAGAAGACGGCATACGA-3') dla każdej próbki (patrz Tabela materiałów dla zalecanego premiksu qPCR).
- Połączyć 9 μl mieszanki z adapterem qPCR z 1 μl próbki z kroku 16.4 i dobrze wymieszać przez pipetowanie.
- Przygotować mieszaninę qPCR do amplifikacji DNA pochodzącego z nośnika (mieszanina nośników). Połącz 3,8 μl wody, 5 μl premiksu qPCR (2x), 0,1 μl 10 μM carrier_f1 startera (5'-GCGGCAGCGTTCGCTATAAC-3') i 0,1 μl 10 μM adaptor_r1 startera dla każdej próbki
- Połączyć 9 μl mieszaniny nośników qPCR z 1 μl próbki z kroku 16.4 i dobrze wymieszać przez pipetowanie.
- Ustaw program qPCR: 95 °C przez 3 min (95 °C przez 20 s, 60 °C przez 20 s, 72 °C przez 2 min) powtórz 40x, a następnie krzywą denaturacji specyficzną dla instrumentu (65–95 °C) i przytrzymaj w temperaturze 4 °C.
nuta: Przygotować kontrolę ujemną, zastępując próbkę wodą.
18. Amplifikacja PCR biblioteki docelowej
- Przygotuj mieszankę amplifikacyjną PCR, łącząc 6 μl wody, 0,5 μl 10 μM adaptor_f1 startera, 0,5 μl 10 μM adaptor_r1 startera i 25 μl premiksu PCR (2x). Wymieszać przez pipetowanie (patrz Tabela materiałów dla zalecanego premiksu do PCR).
- Dodać 32 μl mieszanki PCR do 18 μl próbki z kroku 16.4. Dokładnie wymieszać pipetując.
- Ustaw amplifikację PCR: 95 °C przez 3 min, (98 °C przez 20 s, 60 °C przez 15 s, 72 °C przez 2 min) 12-18 cykli, 72 °C przez 2 min i trzymaj w temperaturze 4 °C.
nuta: Dokładna liczba cykli PCR jest określana na podstawie wyników qPCR i odpowiada wartości Ct uzyskanej za pomocą mieszanki starterów adaptorowych (liczba cykli PCR jest równa wartości Ct). - Oczyścić amplifikowaną próbkę, dodając 90 μl kulek magnetycznych SPRI do 50 μl amplifikowanej próbki i dokładnie wymieszać przez pipetowanie. Powtórz kroki oczyszczania opisane w krokach 2.6.1–2.6.6. i eluować próbkę, używając 42 μl wody, jak opisano.
19. Druga runda degradacji nośnika
- Powtórz kroki 16.1–16.3.
- Oczyść mieszaninę degradacji za pomocą kulek magnetycznych SPRI. Dodać 10 μl wody do próbki, aby zwiększyć objętość i wymieszać z 30 μl kulek SPRI (stosunek kulek 1:1 do próbki). Powtórzyć oczyszczanie zgodnie z opisem w krokach 2.6.1–2.6.6. i eluować za pomocą 42 μl wody podgrzanej do temperatury 37 °C, jak opisano.
- Zagęścić eluowaną próbkę od 42 μl do 30 μl całkowitej objętości.
20. Wybór rozmiaru biblioteki
- Zmieszać 24 μl kulek magnetycznych SPRI z 30 μl próbki z kroku 19.3. (stosunek kulek 0,8:1 do próbki). Powtórz kroki oczyszczania zgodnie z opisem w krokach 2.6.1–2.6.6. i eluować próbkę w 42 μl wody, jak opisano.
- Zagęścić próbkę do około 14 μl, jak opisano w kroku 9.1.
21. Kontrola jakości
- Ocena rozkładu wielkości
- Umieścić 1 μl próbki na chipie DNA o wysokiej czułości. Oczekiwane wyniki są przedstawione w Rysunek 4.
nuta: Jeśli widoczne są fragmenty krótsze niż 200 pz (patrz przykład w Rysunek 4A,C), wybór rozmiaru (kroki 20.1–20.2) należy powtarzać, aż krótkie fragmenty zostaną usunięte (Rysunek 4B,D). Zwykle wystarczy jedna dodatkowa runda wyboru rozmiaru. Jeśli ilość krótkich fragmentów jest znaczna (jak w Rysunek 4C), stosunek kulek do próbki powinien zostać zmniejszony do 0,6:1.
- Umieścić 1 μl próbki na chipie DNA o wysokiej czułości. Oczekiwane wyniki są przedstawione w Rysunek 4.
- Kontrola jakości degradacji nośnika
- Powtórz kroki 17.1–17.5.
nuta: W zależności od stężenia bibliotek oszacowanego w serii chipa HS DNA (analiza regionów), próbki należy rozcieńczyć przed qPCR. Użyj 0,5 μl próbki, aby uniknąć utraty próbki i rozcieńczyć 100–500x w wodzie (rozcieńczyć do końcowego stężenia 1–20 pg/μl). Oczekiwana różnica między wartościami Ct uzyskanymi przy użyciu mieszanki adaptora i nośnika wynosi 5–10.
- Powtórz kroki 17.1–17.5.
- Kwantyfikacja biblioteki
- Przygotować robocze rozcieńczenie wzorca lambda DNA, mieszając 20 μl 100 mg/ml wzorca lambda DNA z 980 μl 1x TE (przygotować przez rozcieńczenie 20x TE dostarczonego w zestawie do oznaczania ilościowego DNA). Rozcieńczony DNA lambda może być przechowywany w temperaturze -20 °C.
- Przygotować seryjne rozcieńczenia wzorca lambda DNA, mieszając rozcieńczony wzorzec lambda i 1x TE zgodnie z tabelą uzupełniającą 8.
nuta: Aby uzyskać większą dokładność, zaleca się dodanie 100 μL buforu 1x TE do wszystkich probówek i usunięcie 1x objętości TE zgodnie z wymaganiami na objętość rozcieńczonej lambdy, która ma być dodana. Nie należy używać więcej niż 1 μl biblioteki; Do tego pomiaru zaleca się użycie płytek 384-dołkowych.
Wyniki
Niniejszy raport opisuje pełny protokół SLIC-CAGE służący do otrzymywania bibliotek gotowych do sekwencjonowania z nanogramowych ilości wyjściowego całkowitego RNA (Rysunek 1). Aby uzyskać mieszaninę syntetycznego nośnika RNA, najpierw należy przygotować matryce nośnika PCR i oczyścić je za pomocą elektroforezy żelowej w celu usunięcia produktów ubocznych PCR (Rysunek 2A). Każda matryca do PCR (łącznie dziesięć) jest otrzymywana przy użyciu wspólnego prawego, lecz różnych lewych starterów (Tabela 2), co prowadzi do uzyskania matryc PCR o różnych długościach, aby umożliwić zróżnicowanie rozmiaru syntetycznych nośników RNA. Po oczyszczeniu matryce PCR są wykorzystywane do transkrypcji in vitro cząsteczek nośnika. Oczekiwanym rezultatem jest pojedynczy produkt nośnika RNA, jeżeli matryce zostały oczyszczone za pomocą elektroforezy żelowej (patrz reprezentacyjna analiza żelowa w Rycina 2B). Przygotowanie nośnika można przeskalować w zależności od potrzeb, a po przygotowaniu wymieszać i zamrozić w temperaturze -80 °C do późniejszego wykorzystania.
Stosując zalecaną minimalną ilość całkowitego RNA z próbki (10 ng) w połączeniu z 16-18 cyklami amplifikacji PCR, można uzyskać biblioteki SLIC-CAGE o wysokiej złożoności. Liczba cykli PCR wymaganych do amplifikacji końcowej biblioteki w dużym stopniu zależy od ilości użytego całkowitego RNA wejściowego (oczekiwana liczba cykli jest przedstawiona w Tabeli 4).
Po pierwszej rundzie degradacji, w wynikach qPCR (krok 17), oczekiwana różnica między wartościami Ct uzyskanymi przy użyciu startera adaptor_f1 a carrier_f1 wynosi 1-2, przy czym wartości Ct uzyskane dla adaptor_f1 są niższe niż dla carrier_f1.
Rozkład długości fragmentów w końcowej bibliotece wynosi od 200 do 2 000 bp, przy średniej wielkości fragmentu od 700 do 900 bp (na podstawie analizy regionów przy użyciu oprogramowania Bioanalyzer, Rysunek 4B,D). Krótsze fragmenty, przedstawione na Rysunku 4A,C, muszą zostać usunięte poprzez dodatkowe cykle wykluczania wielkością (kroki 20-21). Krótkie fragmenty te są artefaktami amplifikacji PCR, a nie docelową biblioteką. Należy pamiętać, że krótsze fragmenty lepiej skupiają się na przepływowych komórkach sekwencjonujących i mogą powodować problemy z sekwencjonowaniem.
Oczekiwana ilość materiału biblioteki uzyskanego z jednej próbki wynosi od 5-50 ng. Znacznie niższe ilości wskazują na stratę próbki podczas protokołu. Jeśli uzyskana niska ilość jest wystarczająca do sekwencjonowania (wymagane jest 2-3 ng połączonych bibliotek), biblioteki mogą charakteryzować się mniejszą złożonością (patrz poniżej).
W zależności od sekwenatora konieczna może być optymalizacja ilości biblioteki załadowanej na ogniwo przepływowe. W przypadku zastosowania systemu Illumina HiSeq 2500, załadowanie bibliotek SLIC-CAGE o stężeniu 8-12 pM pozwala uzyskać średnio 150-200 milionów odczytów, z czego >80% odczytów spełnia próg jakości Q30.
Uzyskane odczyty są następnie mapowane do genomu referencyjnego [dla odczytów 50 bp można zastosować program Bowtie212 z parametrami domyślnymi, które dopuszczają zero niedopasowań na sekwencję ziarna (22 bp)]. Oczekiwana wydajność mapowania zależy od całkowitej ilości wprowadzonego RNA i jest przedstawiona w Tabeli 5. Unikalnie zmapowane odczyty można następnie załadować do środowiska obliczeń graficznych i statystycznych R13 i przetworzyć przy użyciu pakietu CAGEr (pakiet Bioconductor14). Winieta pakietu jest łatwa do śledzenia i szczegółowo wyjaśnia przebieg prac oraz przetwarzanie zmapowanych danych. Prostym sposobem wizualnej kontroli złożoności biblioteki jest rozkład szerokości promotora, ponieważ biblioteki o niskiej złożoności będą miały sztucznie zwężone promotory (Rysunek 5A, biblioteka SLIC-CAGE pochodząca z 1 ng całkowitego RNA, szczegóły w poprzedniej publikacji10). Jednak nawet biblioteki SLIC-CAGE o niskiej złożoności pozwalają na identyfikację rzeczywistych CTSS z większą precyzją niż alternatywne metody mapowania TSS przy niskiej/średniej ilości materiału wejściowego (Rysunek 5B,C).
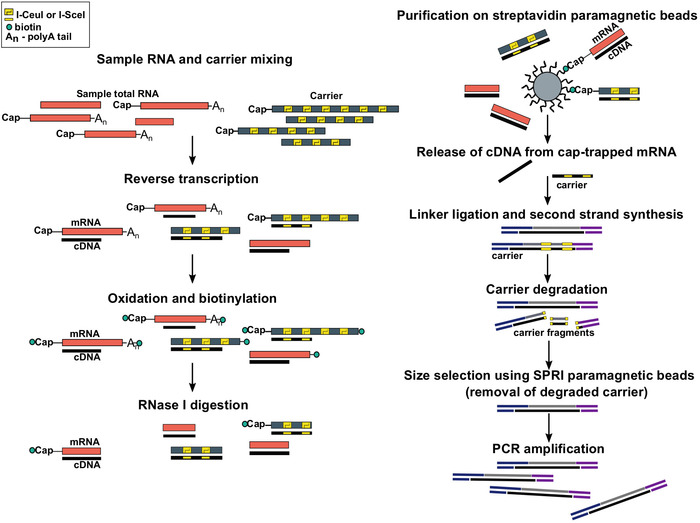
Rysunek 1: Etapy protokołu SLIC-CAGE. RNA z próbki miesza się z mieszaniną nośnika RNA, aby uzyskać 5 µg całkowitego materiału RNA. cDNA jest syntetyzowane poprzez transkrypcję odwrotną, a czapeczka zostaje utleniona przy użyciu nadjodynianu sodu. Utlenianie umożliwia przyłączenie biotyny do czapeczki za pomocą hydrazydy biotyny. Biotyna przyłącza się również do końca 3′ mRNA, ponieważ ten również jest utleniany nadjodynianem sodu. Aby usunąć biotynę z hybryd mRNA:cDNA z niepełnie zsyntetyzowanym cDNA oraz z końców 3′ mRNA, próbki traktuje się RNazą I. cDNA, które dotarło do końca 5′ mRNA, jest następnie wyodrębniane poprzez oczyszczanie powinowactwa na magnetycznych koralikach z streptawidyną (wychwytywanie czapeczki). Po uwolnieniu cDNA liguje się linkery 5′ oraz 3′. Cząsteczki biblioteki pochodzące z nośnika są degradowane za pomocą endonukleaz homingowych I-SceI i I-CeuI, a fragmenty są usuwane przy użyciu magnetycznych koralików SPRI. Następnie biblioteka jest amplifikowana metodą PCR. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.

Rysunek 2: Reprezentatywna analiza żelowa matryc PCR nośnikowych i transkryptów nośnikowych in vitro. (A) Matryce PCR nośnikowe przed oczyszczaniem żelowym: pierwsza studnia zawiera marker 1 kbp, a następnie matryce PCR nośnikowe 1, 1-10. (B) Transkrypty nośnikowe in vitro: pierwsza studnia zawiera marker 1 kbp, a następnie transkrypty nośnikowe 1-10. Transkrypty nośnikowe zostały zdenaturowane przez ogrzewanie przez 5 min w 95 °C przed nałożeniem. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
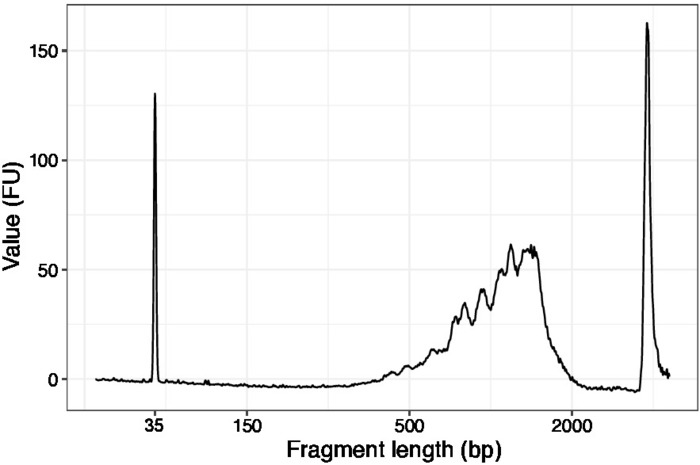
Rysunek 3: Reprezentatywny zapis jakości DNA (chip DNA o wysokiej czułości) SLIC-CAGE przed pierwszą rundą degradacji nośnika. Aby zobaczyć powiększoną wersję tego rysunku, kliknij tutaj.
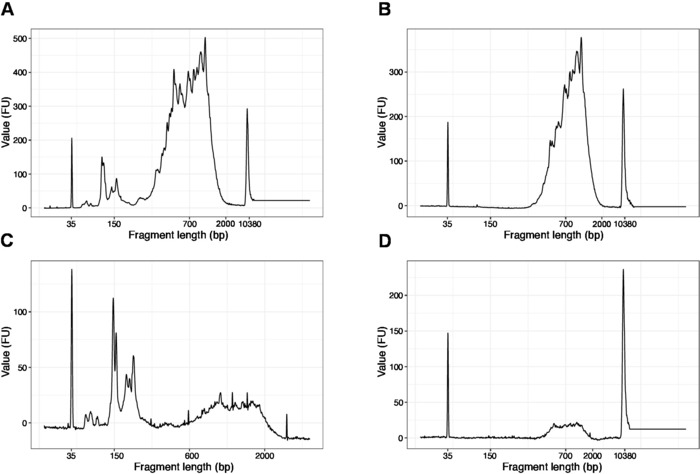
Rysunek 4: Reprezentatywne profile jakości DNA (chip DNA o wysokiej czułości) bibliotek SLIC-CAGE po amplifikacji PCR. (A) Biblioteka SLIC-CAGE wymagająca dodatkowej selekcji wielkości w celu usunięcia krótkich fragmentów. (B) Biblioteka SLIC-CAGE po selekcji wielkości z zastosowaniem kulek SPRI w stosunku 0,6x do próbki. (C) Biblioteka SLIC-CAGE o niższej wydajności, wymagająca selekcji wielkości w celu usunięcia krótkich fragmentów. (D) Biblioteka SLIC-CAGE o niższej wydajności po selekcji wielkości z zastosowaniem kulek SPRI w stosunku 0,6:1 do próbki. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
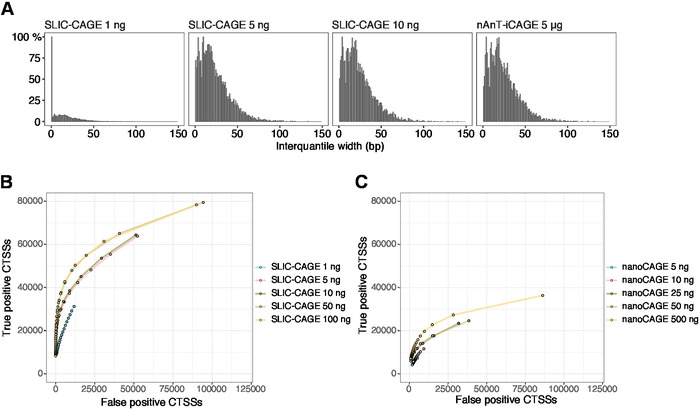
Rysunek 5: Walidacja bibliotek SLIC-CAGE. (A) Rozkład szerokości międzykwartylowej klastrów tagów w bibliotekach SLIC-CAGE przygotowanych z 1, 5 lub 10 ng całkowitego RNA S. cerevisiae oraz w bibliotece nAnT-iCAGE przygotowanej z 5 µg całkowitego RNA S. cerevisiae. Wysoka liczba wąskich klastrów tagów w bibliotece SLIC-CAGE 1 ng wskazuje na jej niską złożoność. (B) Krzywe ROC dla identyfikacji CTSS w bibliotekach SLIC-CAGE S. cerevisiae. Wszystkie CTSS nAnT-iCAGE S. cerevisiae zostały użyte jako zbiór prawdziwy. (C) Krzywe ROC dla identyfikacji CTSS w bibliotekach nanoCAGE S. cerevisiae. Wszystkie CTSS nAnT-iCAGE S. cerevisiae zostały użyte jako zbiór prawdziwy. Porównanie krzywych ROC pokazuje, że SLIC-CAGE znacznie przewyższa nanoCAGE w identyfikacji CTSS. Wykorzystano dane z ArrayExpress E-MTAB-6519. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Tabela 1: Sekwencja syntetycznego genu nośnika. Miejsca I-SceI są pogrubione, zapisane kursywą i zaznaczone kolorem fioletowym, a miejsca rozpoznawania I-CeuI są zielone. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
| nośnik | primer rewersyjny 5’-3’ | długość produktu PCR / bp | |
| 1 | PCR_N6_r1: NNNNNNCTACGTGTCGCAGACGAATT | 1034 | |
| 2 | PCR_N6_r2: NNNNNNTATCCAGATCGTTGAGCTGC | 966 | |
| 3 | PCR_N6_r3: NNNNNNCACTGCGGGATCTCTTTACG | 889 | |
| 4 | PCR_N6_r4: NNNNNNGCCGTCGATAACTTGTTCGT | 821 | |
| 5 | PCR_N6_r5: NNNNNNAGTTGACCGCAGAAGTCTTC | 744 | |
| 6 | PCR_N6_r6: NNNNNNGTGAAGAATTTCTGTTCCCA | 676 | |
| 7 | PCR_N6_r7: NNNNNNCTCGCGGCTCCAGTCATAAC | 599 | |
| 8 | PCR_N6_r8: NNNNNNTATACGCGATGTTGTCGTAC | 531 | |
| 9 | PCR_N6_r9: NNNNNNACCGCCGCGCCTTCCGCAGG | 454 | |
| 10 | PCR_N6_r10: NNNNNNCAGGACGTTTTTGCCCAGCA | 386 | |
| * Primer foremowy jest taki sam dla wszystkich matryc nośnika. Podkreślono sekwencję promotora T7. PCR_GN5_f1: TAATACGACTCACTATAGNNNNNCAGCGTTCGCTA | |||
Tabela 2: Primery do amplifikacji matrycy nośnikowej. Primer forward jest taki sam dla wszystkich matryc nośnikowych. Podkreślono sekwencję promotora T7. PCR_GN5_f1: TAATACGACTCACTATAGNNNNNCAGCGTTCGCTA. Dzięki zastosowaniu różnych primerów reverse otrzymuje się matryce PCR, a w konsekwencji RNA nośnikowe o różnej długości.
| nośnik | długość | bez zakrętki/µg | zamknięte/µg |
| 1 | 1034 | 3.96 | 0.45 |
| 2 | 966 | 8.36 | 0.95 |
| 3 | 889 | 4.4 | 0.5 |
| 4 | 821 | 6.6 | 0.75 |
| 5 | 744 | 4.4 | 0.5 |
| 6 | 676 | 3.08 | 0.35 |
| 7 | 599 | 4.4 | 0.5 |
| 8 | 531 | 3.96 | 0.45 |
| 9 | 454 | 2.64 | 0.3 |
| 10 | 386 | 2.2 | 0.25 |
Tabela 3: Mieszanina nośnika RNA. Łącznie 49 µg mieszaniny nośnika 0,3-1 kbp: niekapszowana = 44 µg, kapszowana = 5 µg.
| Całkowita ilość wprowadzonego RNA /ng | Cykle PCR |
| 1 ng | 18 |
| 2 ng | 17 |
| 5 ng | 16 |
| 10 ng | 15-16 |
| 25 ng | 14-15 |
| 50 ng | 13-15 |
| 100 ng | 12-14 |
Tabela 4: Przewidywana liczba cykli PCR w zależności od całkowitej ilości wprowadzonego RNA z próbki. Przybliżona liczba cykli opiera się na eksperymentach przeprowadzonych z użyciem całkowitego RNA z Saccharomyces cerevisiae, Drosophila melanogaster oraz Mus musculus.
| Całkowita ilość wprowadzonego RNA/ng | % całkowitego mapowania | % mapowania unikalnego | % nośnika |
| 1 ng | 30 | 20-30 | 30 |
| 2 ng | 60 | 20-50 | 10 |
| 5 ng | 60-70 | 40-60 | 5-10 |
| 10 ng | 60-70 | 40-60 | 5-10 |
| 25 ng | 65-80 | 40-70 | 0-5 |
| 50 ng | 65-80 | 40-70 | 0-3 |
| 100 ng | 70-85 | 40-70 | 0-2 |
Tabela 5: Przewidywana wydajność mapowania w zależności od całkowitej ilości wprowadzonego RNA. Przedstawiono wartości przybliżone, oparte na eksperymentach przeprowadzonych z wykorzystaniem całkowitego RNA z Saccharomyces cerevisiae i Mus musculus.
Tabela uzupełniająca 1: Sekwencje starterów. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 2: Hybrydyzacja linkerów 5’ i 3’. Aby wyświetlić tę tabelę, kliknij tutaj (kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 3: Wyżarzanie linkera 5’. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 4: Mieszanie linkerów 5’. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 5: Rozcieńczenie łącznika 5’. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 6: Wyżarzanie łącznika 3’. Kliknij tutaj, aby wyświetlić tę tabelę (Kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 7: Rozcieńczenie łącznika 3’. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
Tabela uzupełniająca 8: Przygotowanie standardowych rozcieńczeń seryjnych. Kliknij tutaj, aby wyświetlić tę tabelę (kliknij prawym przyciskiem myszy, aby pobrać).
Dyskusja
Aby preparaty z biblioteki SLIC-CAGE były skuteczne, konieczne jest stosowanie końcówek i probówek o niskim stopniu wiązania, aby zapobiec utracie próbki w wyniku adsorpcji próbki. Na wszystkich etapach związanych z pobraniem supernatantu zaleca się odzyskanie całej objętości próbki. Ponieważ protokół składa się z wielu kroków, ciągła utrata próbek doprowadzi do nieudanych bibliotek.
Jeśli CAGE (nAnT-iCAGE) nie był wykonywany rutynowo, najlepiej jest przetestować SLIC-CAGE z różnymi ilościami wejściowymi (10 ng, 20 ng, 50 ng, 100 ng, 200 ng) tej samej całkowitej próbki RNA i porównać z bibliotekami nAnT-iCAGE, które są przygotowywane przy użyciu 5 μg całkowitego RNA. Jeśli biblioteka nAnT-iCAGE nie powiedzie się (mniej niż 0,5-1 ng biblioteki DNA uzyskanej na próbkę), jest mało prawdopodobne, aby SLIC-CAGE zadziałał, a straty próbki należy zminimalizować.
Krytycznym krokiem w celu zapewnienia wysokiej jakości bibliotek pozbawionych nieograniczonego zdegradowanego RNA lub rRNA jest pułapkowanie czapeczki opisane w sekcji 7. Bardzo ważne jest, aby kulki streptawidyny zostały dokładnie zawieszone w płuczących i aby płuczące zostały usunięte przed przejściem do następnego etapu płukania lub elucji cDNA.
Jeśli wyniki qPCR po pierwszej rundzie degradacji nośnika nie wykazują różnicy między użyciem starterów adaptor_f1 i carrier_f1, nadal zaleca się kontynuowanie protokołu. Jeżeli po drugiej rundzie degradacji nośnika różnica w wartościach Ct jest mniejsza niż pięć, zaleca się trzecią rundę degradacji nośnika. Nigdy nie stwierdziliśmy, że konieczna jest trzecia runda degradacji, a jeśli do niej dojdzie, zaleca się wymianę zapasów endonukleazy naprowadzającej.
Do protokołu można dodać dodatkowe rundy amplifikacji PCR, jeśli ostateczna ilość uzyskanej biblioteki nie jest wystarczająca do sekwencjonowania. Amplifikację PCR można następnie ustawić z minimalną liczbą cykli amplifikacji potrzebnych do uzyskania wystarczającej ilości materiału do sekwencjonowania, biorąc pod uwagę utratę próbki, której nie można uniknąć przy doborze wielkości. Oczyszczanie lub wybór wielkości za pomocą kulek magnetycznych SPRI należy następnie przeprowadzać, aż wszystkie małe (<200 pz) fragmenty zostaną usunięte (w razie potrzeby użyj proporcji 0,6:1 kulek do próbki), a bibliotekę należy określić ilościowo za pomocą Picogreen.
Biblioteki mogą być sekwencjonowane w trybie single-end lub paired-end. Za pomocą sekwencjonowania sparowanych końców można uzyskać informacje o izoformach transkryptu. Ponadto, ponieważ odwrotna transkrypcja jest wykonywana przy użyciu losowego startera (TCT-N6, N6 jest losowym heksamerem), informacje z sekwencjonowanego końca 3' mogą być wykorzystane jako unikalne identyfikatory molekularne (UMI) do zwijania duplikatów PCR. Ponieważ stosuje się umiarkowaną liczbę cykli amplifikacji PCR (do 18), stosowanie UMI zostało wcześniej uznane za niepotrzebne.
Ponieważ rdzeń protokołu opiera się na nAnT-iCAGE11, SLIC-CAGE wykorzystuje osiem kodów kreskowych. W związku z tym multipleksowanie więcej niż ośmiu próbek nie jest obecnie obsługiwane. Ponadto zarówno SLIC-CAGE, jak i nAnT-iCAGE nie nadają się do wychwytywania RNA krótszego niż 200 pz, ponieważ protokoły są zaprojektowane tak, aby usuwać łączniki i artefakty PCR poprzez wykluczanie rozmiaru za pomocą kulek AMPure XP.
SLIC-CAGE jest jedyną bezstronną metodą rozdzielczości pojedynczego nukleotydu o niskim nakładzie wejściowym do mapowania miejsc początkowych inicjacji transkrypcji przy użyciu nanogramów całkowitego materiału RNA. Alternatywne metody opierają się na aktywności przełączania matryc odwrotnej transkryptazy na RNA z kodem kreskowym zamiast pułapkowania czapeczki (np. NanoCAGE15 i NanoPARE16). Ze względu na przełączanie szablonów, metody te wykazują specyficzne dla sekwencji odchylenia w wykrywaniu TSS, co prowadzi do zwiększenia liczby fałszywie dodatnich TSS i zmniejszenia liczby prawdziwych TSS 9,10.
Oświadczenia
Patent na degradowalny nośnik RNA/DNA został wypełniony.
Podziękowania
Ta praca została wsparta przez grant Wellcome Trust (106954) przyznany B. L. i Medical Research Council (MRC) Core Funding (MC-A652-5QA10). N. C. był wspierany przez EMBO Long-Term Fellowship (EMBO ALTF 1279-2016); E. P. był wspierany przez Medical Research Council UK; B. L. był wspierany przez Medical Research Council UK (MC UP 1102/1).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 2-propanol, Bioultra, do biologii molekularnej, ≥ 99,5% | Sigma-Aldrich | 59304-100ML-F | Stosowany w oczyszczaniu RNAclean XP. |
| Sekwencje łączników | są opisane w Murata et al. 2014 i w tabeli uzupełniającej 1 niniejszego manuskryptu. Wyżarzanie pasm w celu wytworzenia łączników 3' opisano w uzupełnieniu do niniejszego protokołu. | ||
| Sekwencje łączników | są opisane w Murata et al. 2014 i w tabeli uzupełniającej 1 tego manuskryptu. Wyżarzanie pasm w celu wytworzenia łączników 5' jest opisane w uzupełnieniu do niniejszego protokołu. | ||
| Agencourt AMPure XP, 60 ml | Beckman Coulter | A63881 | Oczyszczanie DNA |
| Agencourt RNAClean XP Kit | Beckman Coulter | A63987 | Oczyszczanie RNA i hybryd RNA:cDNA w krokach CAGE. |
| Axygen 0,2 ml polipropylenowe paski probówek do PCR i wypukłe paski z nakrętką | Axygen (dostępne przez Corning) | PCR-0208-CP-C | Lub dowolne 8-rurkowe paski do PCR (używane tylko do wody i mieszanek). |
| Axygen 1 x 8 pasków wypukłe nasadki do PCR | Axygen (dostępne przez Corning) | PCR-02CP-C | Kapsułki do płytek PCR. |
| Probówka do mikrowirówek Axygen 1,5 ml Maxymum Recovery Snaplock | Axygen (dostępna przez Corning) | MCT-150-L-C | Probówki 1,5 ml o niskim poziomie wiązania, używane do mieszanin enzymów lub zatężania próbek. |
| Axygen 96 well no no skirt PCR mikroplate | Axygen (dostępny przez Corning) | PCR-96-C | Płytki PCR o niskim poziomie wiązania - muszą być używane na wszystkich etapach protokołu. Należy pamiętać, że płytki powinny być przycięte tak, aby zawierały 2 x 8 dołków dla lepszej widoczności próbek |
| Bioanalizator (lub Tapestation): Zestawy DNA RNA nano i HS | Agilent | Aby określić jakość RNA, efektywny dobór rozmiaru i końcową jakość biblioteki (można również użyć Tapestation) | |
| Biotyna (długie ramię) Hydrazyd | Vector laboratoria | SP-1100 | Biotynylacja/znakowanie |
| Bufor | Cutsmart NEB | Bufor enzymu restrykcyjnego | |
| Deep Vent (egzo-) Polimeraza DNA | NEB | M0259S | do syntezy drugiej nici |
| , Mighty Mix | Takara | 6023 | Używany do ligacji 5' i 3'-linker |
| dNTP (10 mM każdy) | ThermoFisher Scientific | 18427013 | mieszanka dNTP do produkcji matryc nośnikowych (lub dowolnych dNTP odpowiednich do PCR) |
| Dynabeads M-270 Streptawidyna | Invitrogen | 65305 | Zatrzask czapki. Nie używaj innych kulek, ponieważ są one zoptymalizowane pod kątem zastosowanych. |
| DynaMag-2 Magnet | ThermoFisher Scientific | 12321D | Podstawka magnetyczna do probówek 1,5 ml - służy do przygotowania kulek Streptawidyny. |
| DynaMag-96 Magnes z listwą boczną | ThermoFisher Scientific | 12027 | Stojak magnetyczny na płytki PCR (płytki 96-dołkowe) - używany z płytkami ciętymi do przechowywania 2 x 8 dołków. |
| Etanol, BioUltra, do biologii molekularnej, ≥ 99,8% | Sigma-Aldrich | 51976-500ML-F | Stosowany w pralniach AMPure. Można użyć dowolnego etanolu odpowiedniego do biologii molekularnej. |
| Egzonukleaza I (E. coli) | NEB | M0293S Degradacja | resztek podkładu |
| Barwnik ładujący żel, fioletowy (6x), bez SDS | NEB | B7025S | barwnik ładujący żel agarozowy |
| HiScribe T7 Zestaw do syntezy RNA o wysokiej wydajności | England Biolabs | E2040S | Zestaw do transkrypcji in vitro |
| Aparatura | do elektroforezy poziomejoczyszczanie matryc DNA nośników z żeli agarozowych | ||
| I-Ceu | NEB | R0699S | Endonukleaza samonaprowadzająca stosowana do degradacji nośnika. |
| Endonukleaza samonaprowadzająca | SceI | NEB | R0694S |
| KAPA HiFi HS ReadyMix (2x) | Kapa Biosystems (Dostarczane przez Roche) | KK2601 | Mieszanka PCR do amplifikacji biblioteki docelowej |
| Zestaw KAPA SYBR FAST qPCR (uniwersalny) 2x | Kapa Biosystems (dostarczony przez Roche) | Mieszanka qPCR KK4600 | do oceny wydajności degradacji i wymaganej liczby cykli amplifikacji PCR |
| Mikropipety i mikropipety wielokanałowe (0,1-10 i mikro; L, 1-20 i mikro; L, 20-200 i mikro; L) | Zaleca | się stosowanie Gilsona z nisko wiążącymi końcówkami Sorenson. Inne mikropipety mogą nie być kompatybilne. Końcówki o niskim wiązaniu różnych marek mogą nie być jednakowej jakości i mogą zwiększać utratę próbki. | |
| mikropłytek | Do pomiaru stężenia Picogreen w bibliotece końcowej. Mikropłytki są stosowane w celu umożliwienia pomiaru małej objętości i zmniejszenia ilości odpadów próbki. | ||
| woda wolna od nukleaz | ThermoFisher Scientific | AM9937 | Lub dowolna woda wolna od nukleaz (DNazy i RNazy) |
| termocyklera | i amplficykacja PCR | ||
| Phusion Polimeraza DNA o wysokiej wierności Polimeraza | ThermoFisher Scientific | F530S | do amplifikacji matryc nośnikowych (lub dowolnej polimerazy o wysokiej wierności) |
| Zestaw do ekstrakcji żelu QIAquick (50) | Qiagen | 28704 | Oczyszczanie matryc nośnika PCR z żeli agarozowych. |
| qPCR | określająca liczbę cykli amplifikacji PCR i stopień degradacji nośnika | ||
| Quant-iT PicoGreen dsDNA Odczynnik | ThermoFisher Scientific | P11495 | Służy do pomiaru końcowego stężenia biblioteki - zalecane, ponieważ w naszych rękach jest dokładniejsze i bardziej powtarzalne niż Qubit. |
| Quick-Load Purple 100 bp Drabinka DNA | NEB | N0551S | Drabinka DNA |
| Quick-Load Purple 1 kb Plus Drabinka DNA | NEB | N0550S | Drabinka DNA |
| Rybonukleaza H | Takara | 2150A | Trawienie RNA po uwięzieniu czapeczki. |
| RNase ONE Rybonukleaza | Promega | M4261 | Degradacja jednoniciowego RNA niechronionego przez cDNA. |
| Zestaw DNazy bez RNaz | Qiagen | 79254 | Usuwanie matryc DNA nośnika po transkrypcji in vitro. |
| RNeasy Mini Kit | Qiagen | 74104 | Do oczyszczania nośnego RNA z transkrypcji lub cappingu in vitro |
| Octan sodu, 1 M, roztwór wody, pH 4,5 Roztwór wolny od RNAzy | VWR | AAJ63669-AK | lub dowolny roztwór wolny od nukleaz (DNaz i RNazy) |
| Octan sodu, 1 M, roztwór woda, pH 6,0 Bez RNAZ | Lub dowolny roztwór wolny od nukleaz (DNazy i RNazy) | ||
| Periodynian sodu | Sigma-Aldrich | 311448-100G | Utlenianie dioli vicinal |
| Końcówki barierowe aerozolowe o niskim poziomie wiązania Sorenson, MicroReach Guard, zakres objętości 10 μ L, Stopniowany | Sorenson (dostępny przez SIGMA-ALDRICH) | Z719390-960EA | Końcówki o niskim wiązaniu - zalecane stosowanie w całym protokole w celu zminimalizowania utraty próbki. |
| Końcówki barierowe aerozolowe o niskim poziomie wiązania Sorenson, MultiGuard, zakres objętości 1 000 μ L, Stopniowany | Sorenson (dostępny przez SIGMA-ALDRICH) | Z719463-1000EA | Końcówki o niskim poziomie wiązania - zalecane stosowanie w całym protokole w celu zminimalizowania utraty próbki. |
| Końcówki barierowe Sorenson o niskim poziomie wiązania, MultiGuard, zakres objętości 20 μ L, Stopniowany | Sorenson (dostępny przez SIGMA-ALDRICH) | Z719412-960EA | Końcówki o niskim wiązaniu - zalecane stosowanie w całym protokole w celu zminimalizowania utraty próbki. |
| Końcówki barierowe aerozolowe o niskim poziomie wiązania Sorenson, MultiGuard, zakres objętości 200 μ L, Stopniowany | Sorenson (dostępny przez SIGMA-ALDRICH) | Z719447-960EA | Końcówki o niskim poziomie wiązania - zalecane stosowanie w całym protokole w celu zminimalizowania utraty próbki. |
| próżniowy SpeedVac | zagęszczający próbki w różnych krokach w celu zmniejszenia objętości | ||
| SuperScript III Odwrotna transkryptaza | ThermoFisher Scientific | 18080044 | Używany do odwrotnej transkrypcji (1. krok CAGE) |
| roztworu | opisano w Murata i wsp. 2014. | ||
| Tris-HCl, 1 M roztwór aq.soln, pH 8,5 | 1 M roztwór, roztwór tRNA wolny od DNaz i RNaz | ||
| (20 mg / ml) | tRNA. Przygotowanie opisano w Murata et al. 2014. | ||
| UltraPure Agaroza o niskiej temperaturze topnienia | ThermoFisher Scientific | 16520050 | Lub dowolna odpowiednia czysta agaroza o niskiej temperaturze topnienia. |
| Fosfataza alkaliczna z krewetkami USB (SAP) | Applied Biosystems (dostarczone przez ThermoFisher Scientific) | 78390500UN | |
| USER Enzym | NEB | M5505S | Degradacja górnej nici łącznika 3', odczynnik do wycinania specyficznego uracylu/enzym |
| System zamykania krowianki | NEB | M2080S | Zestaw enzymatyczny do zamykania in vitro cząsteczek nośnikowych |
| Bufor do płukania A | Mycie zatrzaskowe nasadek. Przygotowanie opisano w Murata et al. 2014. | ||
| Bufor myjący B | Mycie pułapki płuczącej płuczki. Przygotowanie opisano w Murata et al. 2014. | ||
| Bufor myjący C | Mycie pułapki wychwytującej. Przygotowanie opisano w Murata et al. 2014. |
Bibliografia
- Shiraki, T., et al. Cap analysis gene expression for high-throughput analysis of transcriptional starting point and identification of promoter usage. Proceedings of the National Academy of Sciences of the United States of America. 100 (26), 15776-15781 (2003).
- Haberle, V., Lenhard, B. Promoter architectures and developmental gene regulation. Seminars in Cell and Developmental Biology. 57, 11-23 (2016).
- Haberle, V., Stark, A. Eukaryotic core promoters and the functional basis of transcription initiation. Nature Reviews Molecular Cell Biology. 19 (10), 621-637 (2018).
- Andersson, R., et al. An atlas of active enhancers across human cell types and tissues. Nature. 507 (7493), 455-461 (2014).
- Consortium, E. P. An integrated encyclopedia of DNA elements in the human genome. Nature. 489 (7414), 57-74 (2012).
- Celniker, S. E., et al. Unlocking the secrets of the genome. Nature. 459 (7249), 927-930 (2009).
- Consortium, F., et al. A promoter-level mammalian expression atlas. Nature. 507 (7493), 462-470 (2014).
- Boyd, M., et al. Characterization of the enhancer and promoter landscape of inflammatory bowel disease from human colon biopsies. Nature Communications. 9 (1), 1661(2018).
- Adiconis, X., et al. Comprehensive comparative analysis of 5'-end RNA-sequencing methods. Nature Methods. , (2018).
- Cvetesic, N., et al. SLIC-CAGE: high-resolution transcription start site mapping using nanogram-levels of total RNA. Genome Research. 28 (12), 1943-1956 (2018).
- Murata, M., et al. Detecting expressed genes using CAGE. Methods in Molecular Biology. 1164, 67-85 (2014).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. 9, 357(2012).
- R Core Team. A language and environment for statistical computing. , Available from: https://www.R-project.org/ (2017).
- Haberle, V., Forrest, A. R., Hayashizaki, Y., Carninci, P., Lenhard, B. CAGEr: precise TSS data retrieval and high-resolution promoterome mining for integrative analyses. Nucleic Acids Research. 43 (8), e51(2015).
- Poulain, S., et al. NanoCAGE: A Method for the Analysis of Coding and Noncoding 5'-Capped Transcriptomes. Methods in Molecular Biology. 1543, 57-109 (2017).
- Schon, M. A., Kellner, M. J., Plotnikova, A., Hofmann, F., Nodine, M. D. NanoPARE: parallel analysis of RNA 5' ends from low-input RNA. Genome Research. 28 (12), 1931-1942 (2018).
Przedruki i uprawnienia
