Gdy randomizowane badania kontrolowane nie są możliwe, kompleksowe źródło danych o opiece zdrowotnej, takie jak Repozytorium Danych Wojskowego Systemu Opieki Zdrowotnej, stanowi atrakcyjną alternatywę dla analiz retrospektywnych. Uwzględnienie danych dotyczących śmiertelności z krajowego indeksu zgonów i zrównoważenie różnic między grupami za pomocą ważenia skłonności pomaga zmniejszyć błędy systematyczne nieodłącznie związane z projektami retrospektywnymi.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Odwrotne prawdopodobieństwo ważenia leczenia (ocena skłonności) przy użyciu Repozytorium Danych Wojskowego Systemu Opieki Zdrowotnej i Krajowego Indeksu Zgonów
W tym artykule
Podsumowanie
Streszczenie
Gdy randomizowane badania kontrolowane nie są wykonalne, retrospektywne badania z wykorzystaniem dużych zbiorów danych stanowią efektywną i opłacalną alternatywę, chociaż są one narażone na błąd systematyczny w doborze leczenia. Błąd systematyczny związany z wyborem leczenia występuje w badaniu nierandomizowanym, gdy wybór leczenia opiera się na cechach przed leczeniem, które są również związane z wynikiem. Te cechy przed leczeniem lub czynniki zakłócające mogą wpływać na ocenę wpływu leczenia na wynik. Wyniki skłonności minimalizują to odchylenie poprzez równoważenie znanych czynników zakłócających między grupami leczenia. Istnieje kilka podejść do przeprowadzania analiz oceny skłonności, w tym stratyfikacja według oceny skłonności, dopasowanie skłonności i odwrotne prawdopodobieństwo ważenia leczenia (IPTW). Opisano tutaj zastosowanie IPTW do zrównoważenia wyjściowych chorób współistniejących w kohorcie pacjentów w repozytorium danych wojskowego systemu opieki zdrowotnej USA (MDR). MDR jest stosunkowo optymalnym źródłem danych, ponieważ zapewnia zamkniętą kohortę, w której dla uprawnionych beneficjentów dostępne są prawie pełne informacje na temat usług szpitalnych i ambulatoryjnych. Poniżej przedstawiono wykorzystanie MDR uzupełnionego informacjami z krajowego indeksu zgonów w celu uzyskania wiarygodnych danych dotyczących śmiertelności. Znajdują się tam również sugestie dotyczące korzystania z danych administracyjnych. Wreszcie, protokół współdzieli kod SAS do używania IPTW do równoważenia znanych czynników zakłócających i wykreślania skumulowanej funkcji częstości występowania dla interesującego wyniku.
Wprowadzenie
Randomizowane, kontrolowane placebo badania są najmocniejszym projektem badawczym do ilościowego określenia skuteczności leczenia, ale nie zawsze są one wykonalne ze względu na wymagania kosztowe i czasowe lub brak równowagi między grupami leczenia1. W takich przypadkach retrospektywny projekt kohorty wykorzystujący dane administracyjne na dużą skalę ("big data") często stanowi wydajną i opłacalną alternatywę, chociaż brak randomizacji wprowadza błąd systematyczny wyboru leczenia2. Błąd systematyczny związany z doborem leczenia występuje w badaniach nierandomizowanych, gdy decyzja o leczeniu zależy od cech przed leczeniem, które są związane z interesującym nas wynikiem. Te cechy są znane jako czynniki zakłócające.
Ponieważ wyniki skłonności minimalizują ten błąd poprzez równoważenie znanych czynników zakłócających między grupami leczenia, stają się coraz bardziej popularne3. Wyniki skłonności zostały wykorzystane do porównania podejść chirurgicznych4 i schematów medycznych5. Ostatnio wykorzystaliśmy analizę skłonności danych z Repozytorium Danych Wojskowego Systemu Zdrowia Stanów Zjednoczonych (MDR) w celu oceny wpływu statyn w prewencji pierwotnej wyników sercowo-naczyniowych w oparciu o obecność i nasilenie wapnia w tętnicach wieńcowych6.
MDR, używany rzadziej niż zestawy danych Medicare i VA do celów badawczych, zawiera obszerne informacje o roszczeniach administracyjnych i medycznych z usług szpitalnych i ambulatoryjnych świadczonych dla czynnej służby wojskowej, emerytów i innych beneficjentów opieki zdrowotnej Departamentu Obrony (DoD) oraz ich rodzin. Baza danych obejmuje usługi świadczone na całym świecie w amerykańskich wojskowych zakładach leczenia lub w obiektach cywilnych, na które rachunek wystawia Departament Obrony. Baza zawiera kompletne dane apteczne od 1 października 2001 roku. Dane laboratoryjne są dostępne od 2009 r., ale ograniczają się tylko do wojskowych zakładów leczniczych. W ramach MDR kohorty zostały zdefiniowane za pomocą metod obejmujących użycie kodów diagnoz (np. diabetes mellitus7) lub kodów procedur (np. chirurgia artroskopowa8). Alternatywnie, zewnętrznie zdefiniowana kohorta uprawnionych beneficjentów, taka jak rejestr, może zostać dopasowana do MDR w celu uzyskania danych wyjściowych i uzupełniających9. W przeciwieństwie do Medicare, MDR obejmuje pacjentów w każdym wieku. Jest również mniej stronniczy w stosunku do mężczyzn niż baza danych VA, ponieważ obejmuje osoby pozostające na utrzymaniu. Dostęp do MDR jest jednak ograniczony. Ogólnie rzecz biorąc, tylko śledczy, którzy są członkami Wojskowego Systemu Opieki Zdrowotnej, mogą ubiegać się o dostęp, analogicznie do wymagań dotyczących korzystania z bazy danych VA. Badacze pozarządowi ubiegający się o dostęp do danych wojskowych systemów opieki zdrowotnej muszą to zrobić na podstawie umowy o udostępnianiu danych pod nadzorem sponsora rządowego.
Podczas korzystania z dowolnego zestawu danych administracyjnych, ważne jest, aby pamiętać o ograniczeniach, jak również mocnych stronach kodowania administracyjnego. Czułość i swoistość kodu mogą się różnić w zależności od powiązanej diagnozy, niezależnie od tego, czy jest to diagnoza pierwotna, czy wtórna, czy jest to plik szpitalny czy ambulatoryjny. Kody pacjentów hospitalizowanych z powodu ostrego zawału mięśnia sercowego są na ogół podawane z dodatnimi wartościami predykcyjnymi powyżej 90%10, ale palenie tytoniu jest często niedostatecznie kodowane11. Takie niedostateczne kodowanie może, ale nie musi mieć znaczącego wpływu na wyniki badania12. Ponadto może istnieć kilka kodów dla danego schorzenia o różnym poziomie korelacji z daną chorobą13. Zespół dochodzeniowy powinien przeprowadzić kompleksowe przeszukanie literatury i przegląd podręczników kodowania Międzynarodowej Klasyfikacji Chorób, Dziewiątej Rewizji, Modyfikacji Klinicznej (ICD-9-CM) i/lub ICD-10-CM, aby upewnić się, że odpowiednie kody są włączone do badania.
Można zastosować kilka metod w celu poprawy czułości i dokładności kodów diagnostycznych do definiowania chorób współistniejących. Należy uwzględnić odpowiedni okres "retrospekcji" w celu ustalenia wyjściowych chorób współistniejących. Okres retrospekcji obejmuje usługi szpitalne i ambulatoryjne świadczone przed przystąpieniem do badania. Optymalny może być okres jednego roku14. Dodatkowo, wymaganie dwóch oddzielnych oświadczeń zamiast jednego oświadczenia może zwiększyć specyficzność, podczas gdy uzupełnienie danych kodowania danymi farmaceutycznymi może poprawić czułość15. Wybrane ręczne audyty wykresów na części danych mogą być wykorzystane do sprawdzenia dokładności strategii kodowania.
Po zdefiniowaniu i ocenie chorób współistniejących dla danej kohorty, można użyć oceny skłonności do zrównoważenia różnic w zmiennych towarzyszących między grupami leczenia. Wynik skłonności jest uzyskiwany na podstawie prawdopodobieństwa, że pacjent zostanie przypisany do leczenia na podstawie znanych zmiennych współistniejących. Uwzględnienie tej skłonności do leczenia zmniejsza wpływ, jaki zmienne towarzyszące mają na przypisanie leczenia i pomaga wygenerować dokładniejsze oszacowanie wpływu leczenia na wynik. Chociaż wyniki skłonności niekoniecznie zapewniają lepsze wyniki niż modele wielowymiarowe, pozwalają ocenić, czy grupy leczone i nieleczone są porównywalne po zastosowaniu wyniku skłonności3. Badacze prowadzący badanie mogą analizować bezwzględne standaryzowane różnice w współzmiennych przed i po dopasowaniu skłonności lub odwrotnym prawdopodobieństwie ważenia leczenia (IPTW), aby upewnić się, że znane czynniki zakłócające zostały zrównoważone między grupami. Co ważne, nieznane czynniki zakłócające mogą nie być zrównoważone i należy zdawać sobie sprawę z możliwości wystąpienia szczątkowych zakłóceń.
Jeśli jednak wyniki są wykonywane prawidłowo, są potężnym narzędziem, które może przewidywać i replikować wyniki randomizowanych kontrolowanych prób16. Spośród dostępnych technik oceny skłonności, ogólnie preferowane są dopasowywanie i IPTW17. W ramach IPTW pacjenci są ważeni na podstawie ich skłonności lub prawdopodobieństwa leczenia. Stabilizujące ciężary są ogólnie zalecane w stosunku do surowych mas, podczas gdy można również rozważyć przycinanie obciążników18,19,20,21.
Gdy grupy badawcze zostaną zrównoważone, mogą być obserwowane aż do interesującego wyniku. Badania wykorzystujące dane administracyjne mogą być zainteresowane wynikami, takimi jak wskaźniki readmisji i analizy czasu do wystąpienia zdarzenia. W badaniach dotyczących śmiertelności Repozytorium Danych Wojskowego Systemu Opieki Zdrowotnej zawiera pole dotyczące stanu życiowego, które można dodatkowo zwiększyć za pomocą krajowego wskaźnika zgonów (NDI)22,23. NDI to scentralizowana baza danych zawierająca informacje o aktach zgonu z urzędów stanowych, która jest zarządzana przez Centrum Kontroli Chorób. Śledczy mogą wnioskować o ustalenie podstawowego stanu cywilnego i/lub konkretnej przyczyny zgonu na podstawie aktu zgonu.
Poniższy protokół szczegółowo opisuje proces przeprowadzania administracyjnego badania bazy danych przy użyciu MDR wzbogaconego o informacje o śmiertelności z NDI. Szczegółowo opisano w nim zastosowanie IPTW w celu zrównoważenia różnic wyjściowych między dwiema grupami leczenia, w tym kod SAS i przykładowe dane wyjściowe.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Poniższy protokół jest zgodny z wytycznymi naszych instytucjonalnych komisji etyki badań z udziałem ludzi.
1. Definiowanie kohorty
- Określ i jasno zdefiniuj kryteria włączenia i wykluczenia planowanej kohorty, korzystając albo z 1) rejestru, albo z 2) punktów danych, które można wyodrębnić z MDR, takich jak kody administracyjne dla diagnoz lub procedur (np. wszyscy pacjenci z więcej niż dwiema diagnozami w trybie ambulatoryjnym lub jedną diagnozą w trybie stacjonarnym w kierunku migotania przedsionków).
- W przypadku korzystania z rejestru, uwzględnij dwa lub więcej identyfikatorów pacjenta w celu dokładnego dopasowania do Military Health System Data Repository, takich jak numer dokumentacji medycznej (wymieniany w różnych zestawach danych jako patuniq i edipn), pełne imię i nazwisko, data urodzenia i/lub numer ubezpieczenia społecznego sponsora.
UWAGA: Podobnie jak we wszystkich badaniach wykorzystujących osobiste informacje zdrowotne, wymagane jest zastosowanie i przestrzeganie środków ochronnych. Podczas procesu gromadzenia danych należy stosować odpowiednie szyfrowanie i zarządzanie danymi, a informacje powinny zostać zanonimizowane tak szybko, jak to możliwe.
UWAGA: Przy odwoływaniu się do numeru ubezpieczenia społecznego sponsora (sponssn), wszyscy pacjenci są wymieniani w odniesieniu do ich relacji z członkiem wojska (lub sponsorem), w tym z identyfikatorem dla sponsora, małżonka i dzieci. Należy pamiętać, że kod relacji i numer ubezpieczenia społecznego sponsora mogą zmieniać się w czasie w zestawie danych, gdy pacjenci stają się dorośli, wychodzą za mąż/żenią się lub rozwodzą. Dlatego wiele identyfikatorów pacjenta pomaga zapewnić dokładność. - W przypadku definiowania kohort za pomocą kodowania administracyjnego, przeprowadź kompleksowy przegląd literatury w celu zidentyfikowania wcześniejszych badań, które potencjalnie zwalidowały interesujące kody. Przejrzyj podręczniki ICD-9-CM24 i/lub ICD-10-CM25, aby wyjaśnić definicje kodów oraz kody sąsiednie, co pozwoli upewnić się, że stosowany jest odpowiedni zakres kodów. Dodatkowo przejrzyj tabele referencyjne zawarte w podręcznikach, aby rozważyć dodatkowe kody do włączenia/wykluczenia. Wcześniejsze badania walidacyjne zawierają raporty dotyczące dodatniej wartości predykcyjnej, czułości i swoistości dla różnych strategii kodowania administracyjnego. Pomagają one w optymalizacji wyboru kohorty, jak również w identyfikacji punktów końcowych.
- W przypadku korzystania z rejestru, uwzględnij dwa lub więcej identyfikatorów pacjenta w celu dokładnego dopasowania do Military Health System Data Repository, takich jak numer dokumentacji medycznej (wymieniany w różnych zestawach danych jako patuniq i edipn), pełne imię i nazwisko, data urodzenia i/lub numer ubezpieczenia społecznego sponsora.
- Określ, czy istnieją ograniczenia (np. związane z wiekiem) dla pożądanej kohorty lub inne kryteria wykluczenia, które należy uwzględnić w zapytaniu o dane.
- Zdefiniuj okres badania, uwzględniając czas przed datą indeksową w celu zgromadzenia współzmiennych bazowych (zazwyczaj 12 miesięcy w badaniach nad danymi administracyjnymi), a także datę zakończenia badania.
2. Definiowanie współzmiennych i wyników
- Zdefiniuj kody administracyjne dla czynników zakłócających poprzez przegląd literatury oraz korzystając z podręczników ICD-9-CM24 i/lub ICD-10-CM25, zgodnie z procedurą opisaną w kroku 1.1.2 powyżej.
- Określ pozostałe niezbędne współzmienne, w tym dane demograficzne, informacje o lekach oraz wyniki badań laboratoryjnych.
- Przejrzyj dostępne pola danych w Słowniku Danych MDR tutaj: https://health.mil/Military-Health-Topics/Technology/Support-Areas/MDR-M2-ICD-Functional-References-and-Specification-Documents.
3. Przesyłanie wniosku o MDR
- Uzyskać zgodę Instytucjonalnej Komisji Rewizyjnej (Institutional Review Board).
- Wypełnić wniosek o udostępnienie danych, który znajduje się tutaj: https://health.mil/Military-Health-Topics/Privacy-and-Civil-Liberties/Submit-a-Data-Sharing-Application?type=All#RefFeed. W ramach wniosku należy określić pola i pliki danych, o które wnioskuje się w arkuszu ekstrakcji danych z Repozytorium Danych Systemu Zdrowia Wojskowego (MDR) DRT (link dostępny w formularzu wniosku). Należy wskazać, czy zespół wnioskuje o dostarczenie surowych danych przez analityka danych, czy też zespół będzie uzyskiwał dostęp bezpośrednio do MDR. Należy ponadto określić, czy prośba dotyczy jednorazowego pobrania danych, czy też regularnych pobrań w trybie dziennym, miesięcznym lub rocznym.
UWAGA: Aby uzyskać dane z MDR jakąkolwiek metodą, niezbędny jest sponsor będący pracownikiem rządowym (czynny żołnierz lub pracownik GS), który zazwyczaj jest członkiem zespołu badawczego. - W przypadku bezpośredniego dostępu do MDR, wypełnić „MDR Authorization Request Form” oraz „MDR CS 2875 Form”, które znajdują się tutaj: https://health.mil/Military-Health-Topics/Technology/Support-Areas/MDR-M2-ICD-Functional-References-and-Specification-Documents.
4. Dostęp do MDR i ekstrahowanie odpowiednich danych
- W przypadku bezpośredniego dostępu do MDR należy postępować zgodnie z instrukcjami dotyczącymi uzyskiwania dostępu i korzystania z MDR, w tym z wymaganiami oprogramowania i przykładowymi programami SAS, które są dostępne w „MDR User's Guide” oraz „MDR Functional Guide” pod adresem: https://health.mil/Military-Health-Topics/Technology/Support-Areas/MDR-M2-ICD-Functional-References-and-Specification-Documents.
UWAGA: Pliki są zapisane w formacie SAS i są dostępne za pomocą powłoki unix, zazwyczaj z użyciem putty.exe oraz programu ftp. Wymagana jest znajomość SAS. - W celu uzyskania pomocnego przeglądu konfiguracji MDR należy zapoznać się z przewodnikiem DOD dla badaczy DOD dotyczącym korzystania z danych MHS: https://health.mil/Reference-Center/Publications/2012/10/10/Guide-for-DoD-Researchers-on-Using-MHS-Data.
- Podobnie jak w kroku 2.3, należy przejrzeć słownik danych MDR w celu uzyskania szczegółowych informacji o wszystkich dostępnych plikach danych: https://health.mil/Military-Health-Topics/Technology/Support-Areas/MDR-M2-ICD-Functional-References-and-Specification-Documents.
UWAGA: Nie wszystkie pliki danych zawierają wszystkie identyfikatory pacjentów niezbędne do dopasowania/scalania. Słownik danych pomaga wyliczyć identyfikatory dostępne dla każdego pliku danych. Numer DOD ID, określany również jako „patuniq” lub „edipn”, jest na przykład niezbędny do wyodrębnienia informacji z apteki. Posiadanie wszystkich odpowiednich identyfikatorów pacjentów na etapie eksploracji danych jest zatem istotne, aby zapewnić możliwość dopasowania wszystkich informacji o pacjentach w ciągu wielu lat i w wielu zestawach danych. Należy podkreślić, że w badaniach obejmujących PHI wymagane jest ścisłe przestrzeganie procedur zabezpieczania danych po uzyskaniu niezbędnej zgody, a PHI powinny zostać zniszczone, gdy nie będą już potrzebne. - Należy pozyskać niezbędne identyfikatory pacjentów dla kohorty, uzyskując dostęp do danych beneficjentów vm6 (wrzesień 2002–obecnie) lub pliku pben (wrzesień 2000–wrzesień 2002).
- Należy użyć poniższego makra lub podobnego programu, aby dopasować dane vm6 do pliku kohorty. W tym przypadku kod można zastosować w obecnej formie, aby znaleźć numery rekordów medycznych pacjentów (MRN) dla danego numeru ubezpieczenia społecznego pacjenta, który znajduje się już w pliku kohorty. W celu późniejszej weryfikacji błędów należy użyć różnych nazw zmiennych dla imion, nazwisk i dat urodzenia pacjentów w pobranych danych vm6 oraz w plikach kohorty. Aby zabezpieczyć PHI, dane z identyfikatorami pacjentów należy przechowywać na węźle usług w przestrzeni zapewnionej w ramach wniosku o dane (patrz MDR User's Guide).
UWAGA: W MDR numery MRN określa się jako numer DOD ID, PATUNIQ lub EDIPN).
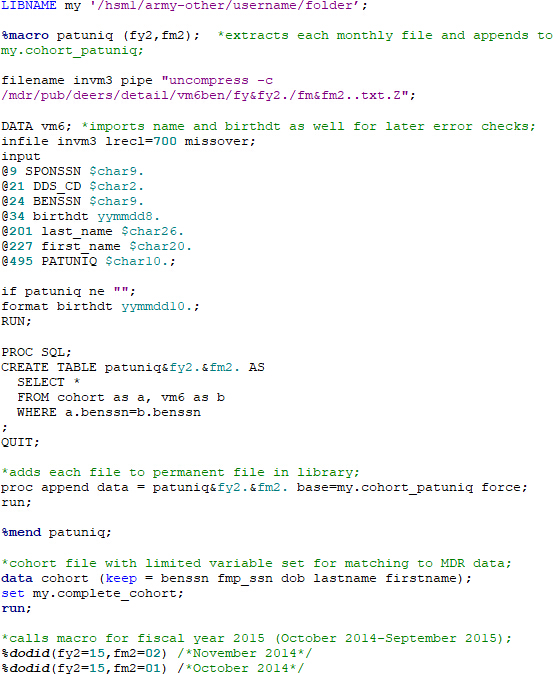
- Ponieważ wpisy w bazach danych nigdy nie są całkowicie wolne od błędów, po każdym głównym kroku należy przeprowadzić kontrolę błędów, a dodatkowo sprawdzić dziennik programu i wyniki pod kątem potencjalnych problemów. Należy użyć poniższego kroku danych, aby przejrzeć potencjalne niezgodności z powyższym kodem (pliki pacjentów są dopasowane na podstawie numeru ubezpieczenia społecznego pacjenta/beneficjenta). Podczas porównywania nazwisk i imion z pliku kohorty (lastname, firstname) z plikiem vm6 (last_name, first_name), należy dopasowywać tylko pierwsze trzy litery, aby zredukować liczbę błędnych wskazań wynikających z różnic w pisowni lub spacjach między plikami.

- Należy przejrzeć plik danych błędów („checkname”). Należy zignorować błędy spowodowane interpunkcją (np. O'Reilly vs. OReilly). Pozostałe istotne błędy należy zweryfikować poprzez ręczny przegląd dokumentacji medycznej lub rozważyć odrzucenie odpowiednich informacji o pacjencie, jeśli występują znaczące błędy, a weryfikacja nie jest możliwa.
- Należy użyć poniższego makra lub podobnego programu, aby dopasować dane vm6 do pliku kohorty. W tym przypadku kod można zastosować w obecnej formie, aby znaleźć numery rekordów medycznych pacjentów (MRN) dla danego numeru ubezpieczenia społecznego pacjenta, który znajduje się już w pliku kohorty. W celu późniejszej weryfikacji błędów należy użyć różnych nazw zmiennych dla imion, nazwisk i dat urodzenia pacjentów w pobranych danych vm6 oraz w plikach kohorty. Aby zabezpieczyć PHI, dane z identyfikatorami pacjentów należy przechowywać na węźle usług w przestrzeni zapewnionej w ramach wniosku o dane (patrz MDR User's Guide).
- Należy wyodrębnić pozostałe niezbędne dane z MDR.
- W razie potrzeby należy pobrać dane o rasie i płci z plików vm6ben (pliki pben przed wrześniem 2002), scalić je z plikiem kohorty i sprawdzić błędy w sposób opisany powyżej:

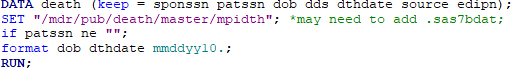
- Należy pobrać dane o zgonach z głównego pliku zgonów, scalić je z plikiem kohorty i sprawdzić błędy w sposób opisany powyżej:
- Należy pobrać dodatkowe pliki danych niezbędne do analizy (lokalizację danych oraz dodatkowe pomocne makra i kody SAS można znaleźć w MDR Functional User's Guide).
UWAGA: Dane są przechowywane w oddzielnych plikach, w zależności od tego, czy zostały dostarczone bezpośrednio przez wojskowy system opieki zdrowotnej, czy przekazane w inny sposób i rozliczone z tym systemem. Przykładowe pliki przedstawiono poniżej.
CAPER – opieka bezpośrednia, pliki ambulatoryjne od roku fiskalnego 2004 do obecnie
SADR – opieka bezpośrednia, pliki ambulatoryjne z lat 1998–2005
SIDR – opieka bezpośrednia, hospitalizacje w oddziałach stacjonarnych (opieka bezpośrednia) od 1989 do obecnie
TEDI – opieka rozliczana, pliki roszczeń instytucjonalnych od roku fiskalnego 2001 do obecnie
HCSRI – opieka rozliczana, roszczenia instytucjonalne z lat 1994–2005
TEDNI – opieka rozliczana, roszczenia poza instytucjonalne od roku fiskalnego 2001 do obecnie
HCSRNI – opieka rozliczana, roszczenia poza instytucjonalne z lat 1994–2005
PDTS – plik apteczny z poszczególnymi receptami od roku fiskalnego 2002 do obecnie
- W razie potrzeby należy pobrać dane o rasie i płci z plików vm6ben (pliki pben przed wrześniem 2002), scalić je z plikiem kohorty i sprawdzić błędy w sposób opisany powyżej:
5. Łączenie danych i tworzenie plików podsumowujących
- Niezależnie od tego, czy dane pochodzą od analityka danych, czy bezpośrednio z MDR, jak opisano w sekcji 4 powyżej, pliki danych będą wymagały zsumowania i scalenia w celu utworzenia pliku analizy. W całym procesie należy stosować metody zwiększające dokładność danych, w tym sprawdzanie błędów oraz analizę logów i wyników, co zostało omówione wcześniej.
- Podczas scalania danych, jeśli to możliwe, należy użyć co najmniej dwóch identyfikatorów pacjenta, aby zapewnić dokładne dopasowanie (np. numer dokumentacji medycznej i data urodzenia), ponieważ w dowolnym polu mogą wystąpić błędy. Po scaleniu danych należy je przejrzeć, aby upewnić się, że wyniki są zgodne z oczekiwaniami. Przydatne do weryfikacji poprawności dopasowań jest uruchomienie kodu sprawdzającego, czy trzy pierwsze litery nazwiska zgadzają się wraz z jednym lub dwoma innymi identyfikatorami (patrz krok 4.5.1).
UWAGA: Nazwisko może nie być zgodne, jeśli pacjent zmienił stan cywilny w badanym okresie. W polach z nazwiskiem mogą również wystąpić niewielkie różnice wynikające z użycia apostrofów, spacji lub literówek. - Należy zwrócić szczególną uwagę na dopasowania w końcowych etapach procesu, takich jak definiowanie pacjentów, u których wystąpiły wyniki.
- Podczas scalania danych, jeśli to możliwe, należy użyć co najmniej dwóch identyfikatorów pacjenta, aby zapewnić dokładne dopasowanie (np. numer dokumentacji medycznej i data urodzenia), ponieważ w dowolnym polu mogą wystąpić błędy. Po scaleniu danych należy je przejrzeć, aby upewnić się, że wyniki są zgodne z oczekiwaniami. Przydatne do weryfikacji poprawności dopasowań jest uruchomienie kodu sprawdzającego, czy trzy pierwsze litery nazwiska zgadzają się wraz z jednym lub dwoma innymi identyfikatorami (patrz krok 4.5.1).
- Należy wyekstrahować bazowe choroby współistniejące, korzystając z kodów ICD-9-CM lub ICD-10-CM z okresu poprzedzającego datę indeksową (datę uznaną za moment wejścia pacjenta do badania). Zazwyczaj do definiowania chorób współistniejących wykorzystuje się okres 12 miesięcy przed datą indeksową.
- Należy upewnić się, że pacjenci mieli uprawnienia do wojskowego systemu opieki zdrowotnej w okresie bazowym (można to zweryfikować miesięcznie w pliku vm6ben).
- Należy przeszukać kody rozpoznań bazowych w plikach ambulatoryjnych i/lub szpitalnych, aby ustalić bazowe choroby współistniejące w 12-miesięcznym okresie bazowym przed datą indeksową. Należy użyć kodów ICD-9-CM lub ICD-10-CM ustalonych w sekcji 1. W przypadku korzystania z chorób współistniejących według Elixhausera, należy użyć dostępnego oprogramowania z HCUP, pamiętając o modyfikacji nazw zmiennych rozpoznań i plików w razie potrzeby. (https://www.hcup-us.ahrq.gov/toolssoftware/comorbidity/comorbidity.jsp#download)
- Należy przeszukać pliki ambulatoryjne i/lub szpitalne po dacie indeksowej w poszukiwaniu interesujących wyników zdefiniowanych przez kody ICD-9-CM lub ICD-10-CM, takich jak hospitalizacja z powodu zawału mięśnia sercowego jako rozpoznań głównego (szukaj kodu 410.x1 w SIDR).
- Należy wyznaczyć datę końcową badania dla wszystkich pacjentów jako punkt odcięcia obserwacji dla osób, u których nie wystąpił interesujący wynik. Należy określić, których pacjentów trzeba ocenzurować przed zakończeniem badania.
- Należy przeszukać plik vm6ben, aby upewnić się, że uprawnienia do opieki zdrowotnej trwały do daty zakończenia badania; w przeciwnym razie pacjenta należy ocenzurować w momencie utraty uprawnień.
- Jeśli istotne jest ograniczenie badania do aktywnych użytkowników systemu opieki zdrowotnej niezależnie od uprawnień, np. aktywnych użytkowników apteki, należy ustalić datę ostatniego kontaktu z opieką zdrowotną (np. ostatnie wydanie leku) w plikach danych i ocenzurować pacjentów w tej dacie.
UWAGA: Należy zachować ostrożność przy uwzględnianiu kontaktów telefonicznych, ponieważ mogą one występować w dokumentacji medycznej po śmierci pacjenta lub jeśli beneficjent opuścił system opieki zdrowotnej w inny sposób.
6. Dopasowanie do krajowego indeksu zgonów (NDI)
- Po zidentyfikowaniu pełnej kohorty, w przypadku gdy punktem końcowym jest śmiertelność, prześlij dane do krajowego rejestru zgonów (National Death Index – NDI) w celu dopasowania.
- Najpierw uwzględnij zamiar dopasowania do NDI w zapytaniach o dane MDR oraz w wniosku o zgodę IRB. Przed przesłaniem chronionych informacji zdrowotnych (PHI) do NDI w celu dopasowania, upewnij się, że uzyskano zgodę i wykonano wszystkie kroki szyfrowania danych.
- „Formularz aplikacyjny National Death Index (NDI)” oraz instrukcje dotyczące zamawiania danych o zgonach z National Death Index można znaleźć tutaj: https://www.cdc.gov/nchs/ndi/index.htm.
- Prześlij dane do NDI na chronione hasłem CD pocztą ekspresową (overnight mail). Wyniki zostaną odesłane w ten sam sposób po około 2 tygodniach.
- Po otrzymaniu wyników z NDI przeanalizuj dopasowania częściowe pod kątem potencjalnego włączenia lub wykluczenia.
- „Chapter 4 - Assessing NDI Output” zawiera pomocny przegląd sposobu analizy wyników i znajduje się na tej samej stronie internetowej: https://www.cdc.gov/nchs/ndi/index.htm. Dopasowania na podstawie numeru ubezpieczenia społecznego (social security number) zazwyczaj stanowią najsilniejszą podstawę dopasowania.
- W razie potrzeby zweryfikuj zgony w Social Security Death Index i/lub Veterans Affairs Beneficiary Identification Records Locator Subsystem (BIRLS), aby zwiększyć dokładność. Należy pamiętać, że członkowie służby, którzy zmarli za granicą, prawdopodobnie nie pojawią się w wyszukiwaniu NDI, ale są często odnotowani w pliku statusu życiowego MDR lub w VA BIRLS.
- Po zakończeniu analizy połącz plik zgonów z głównym plikiem kohorty.
7. Deidentyfikacja danych
- Po zgromadzeniu wszystkich niezbędnych informacji, przeprowadź deidentyfikację plików danych, aby pomóc w ochronie PHI. Wygeneruj losowy identyfikator pacjenta dla każdego pacjenta za pomocą funkcji „ranuni” (patrz: MDR Functional User's Guide). Usuń z plików danych numer PESEL, numer dokumentacji medycznej, datę urodzenia (po obliczeniu wieku) itp. Jeśli jest to konieczne (i zatwierdzone), przechowuj klucz łączący losowy identyfikator pacjenta z PHI w bezpieczny sposób na węźle SCE.
8. Obliczanie wskaźnika skłonności18,19,26
- Zastosuj regresję logistyczną do modelowania prawdopodobieństwa leczenia (procedura proc logistic w programie SAS).
- Określ plik danych („dat” w przykładzie).
- Użyj instrukcji class, aby określić zmienne kategoryczne. Użyj „ref = first”, aby wskazać najniższą wartość (np. 0) jako wartość referencyjną.
- W instrukcji model określ zmienną leczenia jako zmienną zależną (Rx) i ustaw wartość dla „event” jako wartość oznaczającą otrzymanie leczenia (w tym przypadku 1).
- Uwzględnij wszelkie możliwe predyktory otrzymania leczenia jako współzmienne w modelu, zwłaszcza jeśli mogą one być predyktorami wyniku (np. zgonu). Rozważ, czy interakcje między czynnikami mogą wpływać na leczenie. Uwzględnij je w modelu, używając symbolu „*” (np. male*ckd) lub zastosuj składnię pokazaną poniżej, umieszczając „|” między współzmiennymi i „@2” na końcu, aby określić wszystkie interakcje 2 x 2, zgodnie z wymogami konkretnego modelu.
- Użyj instrukcji output, aby określić, że przewidywane prawdopodobieństwo leczenia (prob) zostanie zdefiniowane jako „ps” i zapisane w pliku „ps_data”.
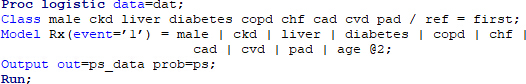
UWAGA: Zmienne w modelu: male: płeć męska (binarna), ckd: przewlekła choroba nerek (binarna), liver: przewlekła choroba wątroby (binarna), diabetes (binarna), copd: przewlekła obturacyjna choroba płuc (binarna), chf: niewydolność serca (binarna), cad: choroba wieńcowa (binarna), cvd: choroba naczyniowo-mózgowa (binarna), pad: obwodowa choroba tętnic (binarna), age (ciągła).
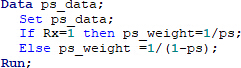
- Oblicz wagi na podstawie przewidywanego prawdopodobieństwa (wskaźnik skłonności – propensity score). Jeśli pacjent otrzymał leczenie (Rx = 1), waga wskaźnika skłonności wynosi 1/(propensity score). Jeśli pacjent nie otrzymał leczenia, waga wskaźnika skłonności wynosi 1/(1 - propensity score).
- Zstabilizuj wskaźnik skłonności, dzieląc go przez średnią wagę. W poniższym kodzie procedura Proc means przypisuje średnią wagę do zmiennej „mn_wt” w pliku danych „m”. Następnie zestaw danych poniżej, który zachowuje mn_wt z pliku danych „m”, oblicza zstabilizowane wagi wskaźnika skłonności (st_ps_weight) dla każdej obserwacji.
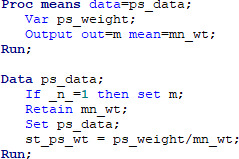
- Zweryfikuj zrównoważenie po zastosowaniu ważenia odwrotnością prawdopodobieństwa leczenia.
- Makro stddiff upraszcza obliczanie standaryzowanych różnic średnich dla współzmiennych przed i po ważeniu w programie SAS. Kod makra znajduje się tutaj: http://www.lerner.ccf.org/qhs/software/lib/stddiff.sas.
- Oblicz standaryzowaną różnicę średnich przed ważeniem. Jak w przypadku wszystkich makr, kod makra należy uruchomić w SAS przed jego wywołaniem. Poniżej znajduje się przykładowa instrukcja wywołania z interesującymi współzmiennymi.
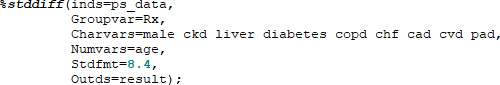
Inds – wejściowy zestaw danych, groupvar – zmienna definiująca grupy badawcze, charvars – zmienne kategoryczne, numvars – zmienne ciągłe, stdfmt – format standaryzowanej różnicy, outds – wyjściowy zestaw danych. - Wywołaj ponownie makro stddiff, aby obliczyć standaryzowaną różnicę średnich po ważeniu. „Wtvar” określa zmienną zawierającą zstandaryzowany wskaźnik skłonności i jest dodawany do instrukcji wywołania makra. Jeśli wszystkie standaryzowane różnice są mniejsze lub równe 0,1, zrównoważenie uznaje się za pomyślne.
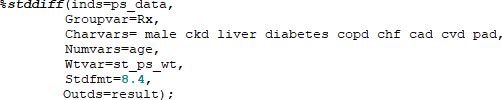
- ASD przed i po ważeniu można przedstawić w formie tabelarycznej lub graficznej. Instrukcje dotyczące wykorzystania makra SAS do generowania wykresu znajdują się w Materiałach uzupełniających (Supplementary Materials).
- Dane skorygowane metodą IPTW mogą być teraz wykorzystane w analizie jednowymiarowej po upewnieniu się, że zmierzone zmienne zakłócające zostały zrównoważone.
9. Tworzenie modelu wyniku i generowanie wykresu funkcji skumulowanej zapadalności
- Wynikową analizę czasu do wystąpienia zdarzenia można przedstawić na kilka sposobów, w tym przy użyciu procedury proc lifetest w celu wygenerowania wykresu przeżywalności. Należy użyć instrukcji weight, aby wskazać ustandaryzowaną wagę skłonności.
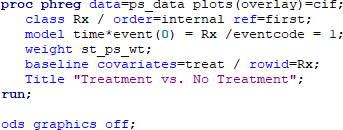
- Aby wygenerować wykres CIF przy użyciu wagi skłonności, należy użyć procedury proc phreg.
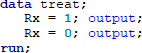
- W procedurze proc phreg należy odwołać się do pliku współzmiennych, aby określić wartości współzmiennych użytych do generowania wykresu. W tym przypadku plik współzmiennych zawiera tylko jedną zmienną Rx, która może przyjmować wartość 1 lub 0.
- Włącz funkcję ods graphics. W razie potrzeby użyj dodatkowych instrukcji, aby określić pliki wyjściowe dla wykresu lub typ pliku (jpeg itp.; patrz https://support.sas.com/documentation/cdl/en/statug/63962/HTML/default/viewer.htm#statug_odsgraph_sect014.htm).
- W składni proc phreg użyj instrukcji weight, aby określić zmienną ustandaryzowanego wskaźnika skłonności. Określ wartości dla współzmiennych bazowych za pomocą instrukcji baseline, aby móc wykreślić skumulowaną funkcję zapadalności. Określ warstwy do użycia na wykresie za pomocą „rowid” (w tym przypadku RX 1 vs. 0). Liczba w nawiasie następująca po zmiennej wynikowej („event”) określa wartość(y) zmiennej, która powinna zostać ocenzurowana, co powinno obejmować datę cenzurowania oraz wszelkie zdarzenia konkurencyjne. W tym przypadku 0 jest cenzurowane, a 1 jest zdarzeniem rzeczywistym.
- W procedurze proc phreg należy odwołać się do pliku współzmiennych, aby określić wartości współzmiennych użytych do generowania wykresu. W tym przypadku plik współzmiennych zawiera tylko jedną zmienną Rx, która może przyjmować wartość 1 lub 0.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Po zakończeniu procesu IPTW można wygenerować tabele lub wykresy bezwzględnych standaryzowanych różnic, korzystając odpowiednio z kodu makra stddiff lub kodu makra asdplot. Rycina 1 przedstawia przykład właściwego zrównoważenia w dużej kohorcie 10 000 uczestników przy użyciu makra asdplot. Po zastosowaniu wskaźnika skłonności (propensity score) bezwzględne standaryzowane różnice uległy znacznemu zmniejszeniu. Wartość progowa przyjęta dla bezwzględnej standary...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Analizy retrospektywne z wykorzystaniem dużych zbiorów danych administracyjnych stanowią wydajną i opłacalną alternatywę, gdy randomizowane badania kontrolowane nie są wykonalne. Odpowiedni zestaw danych będzie zależał od populacji i zmiennych będących przedmiotem zainteresowania, ale MDR jest atrakcyjną opcją, która nie ma ograniczeń wiekowych widocznych w przypadku danych Medicare. W przypadku każdego zestawu danych ważne jest, aby dokładnie zapoznać się z jego układem i słownikiem danych. Po drodze należy zadbać o to,...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Badania opisane w tej publikacji były wspierane przez National Center for Advancing Translational Sciences of the National Institutes of Health pod numerem nagrody UL1 TR002345. Wyłączną odpowiedzialność za treść ponoszą autorzy i nie muszą one reprezentować oficjalnych poglądów National Institutes of Health.
Zastrzeżenie: Dodatkowo, poglądy wyrażone w tym artykule są wyłącznie poglądami autora i nie powinny być interpretowane jako reprezentujące w jakikolwiek sposób poglądy rządu Stanów Zjednoczonych, Departamentu Obrony Stanów Zjednoczonych (DoD) lub Departamentu Armii Stanów Zjednoczonych. Identyfikacja konkretnych produktów lub oprzyrządowania naukowego jest uważana za integralną część przedsięwzięcia naukowego i nie stanowi poparcia ani dorozumianego poparcia ze strony autora, Departamentu Obrony ani żadnej agencji składowej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Nagrywarka CD (dla żądania NDI) | |||
| Komputer | |||
| Putty.exe | Putty.org | ||
| SAS 9.4 | SAS Institute Cary, NC | ||
| WinSCP lub innym oprogramowaniem FTP | https://winscp.net/eng/index.php |
Bibliografia
- Concato, J., Shah, N., Horwitz, R. I. Randomized, controlled trials, observational studies, and the hierarchy of research designs. New England Journal of Medicine. 342 (25), 1887-1892 (2000).
- Austin, P. C., Platt, R. W. Survivor treatment bias, treatment selection bias, and propensity scores in observational research. Journal of Clinical Epidemiology. 63 (2), 136-138 (2010).
- Sturmer, T., Wyss, R., Glynn, R. J., Brookhart, M. A. Propensity scores for confounder adjustment when assessing the effects of medical interventions using nonexperimental study designs. Journal of Internal Medicine. 275 (6), 570-580 (2014).
- Schermerhorn, M. L., et al. Long-Term Outcomes of Abdominal Aortic Aneurysm in the Medicare Population. New England Journal of Medicine. 373 (4), 328-338 (2015).
- Williams, R. J. II, et al. A Propensity-Matched Analysis Between Standard Versus Tapered Oral Vancomycin Courses for the Management of Recurrent Clostridium difficile Infection. Open Forum Infectious Diseases. 4 (4), (2017).
- Mitchell, J. D., et al. Impact of Statins on Cardiovascular Outcomes Following Coronary Artery Calcium Scoring. Journal of the American College of Cardiology. 72 (25), 3233-3242 (2018).
- Rush, T., McGeary, M., Sicignano, N., Buryk, M. A. A plateau in new onset type 1 diabetes: Incidence of pediatric diabetes in the United States Military Health System. Pediatric Diabetes. 19 (5), 917-922 (2018).
- Rhon, D. I., Greenlee, T. A., Marchant, B. G., Sissel, C. D., Cook, C. E. Comorbidities in the first 2 years after arthroscopic hip surgery: substantial increases in mental health disorders, chronic pain, substance abuse and cardiometabolic conditions. British Journal of Sports Medicine. , (2018).
- Mitchell, J., Paisley, R., Moon, P., Novak, E., Villines, T. Coronary Artery Calcium Score and Long-term Risk of Death, Myocardial Infarction and Stroke: The Walter Reed Cohort Study. Journal of the American College of Cardiology: Cardiovascular Imaging. , (2017).
- McCormick, N., Lacaille, D., Bhole, V., Avina-Zubieta, J. A. Validity of myocardial infarction diagnoses in administrative databases: a systematic review. PLoS ONE. 9 (3), e92286(2014).
- Huo, J., Yang, M., Tina Shih, Y. -C. Sensitivity of Claims-Based Algorithms to Ascertain Smoking Status More Than Doubled with Meaningful Use. Value in Health. , Available from: https://doi.org/10.1016/j.jval.2017.09.002 (2017).
- Nayan, M., et al. The value of complementing administrative data with abstracted information on smoking and obesity: A study in kidney cancer. Canadian Urological Association Journal. 11 (6), 167-171 (2017).
- Birman-Deych, E., et al. Accuracy of ICD-9-CM codes for identifying cardiovascular and stroke risk factors. Medical Care. 43 (5), 480-485 (2005).
- Preen, D. B., Holman, C. D., Spilsbury, K., Semmens, J. B., Brameld, K. J. Length of comorbidity lookback period affected regression model performance of administrative health data. Journal of Clinical Epidemiology. 59 (9), 940-946 (2006).
- Rector, T. S., et al. Specificity and sensitivity of claims-based algorithms for identifying members of Medicare+Choice health plans that have chronic medical conditions. Health Services Research. 39 (6 Pt 1), 1839-1857 (2004).
- Hernán, M. A., et al. Observational studies analyzed like randomized experiments: an application to postmenopausal hormone therapy and coronary heart disease. Epidemiology (Cambridge, Mass.). 19 (6), 766-779 (2008).
- Austin, P. C. The relative ability of different propensity score methods to balance measured covariates between treated and untreated subjects in observational studies. Medical Decision Making. 29 (6), 661-677 (2009).
- Robins, J. M., Hernan, M. A., Brumback, B. Marginal structural models and causal inference in epidemiology. Epidemiology. 11 (5), 550-560 (2000).
- Robins, J. Marginal structural models. 1997 Proceedings of the American Statistical Association, section on Bayesian statistical science. , 1-10 (1998).
- Thoemmes, F., Ong, A. D. A Primer on Inverse Probability of Treatment Weighting and Marginal Structural Models. Emerging Adulthood. 4 (1), 40-59 (2016).
- Xu, S., et al. Use of stabilized inverse propensity scores as weights to directly estimate relative risk and its confidence intervals. Value in Health: the Journal of the International Society for Pharmacoeconomics and Outcomes Research. 13 (2), 273-277 (2010).
- Cowper, D. C., Kubal, J. D., Maynard, C., Hynes, D. M. A primer and comparative review of major US mortality databases. Annals of Epidemiology. 12 (7), 462-468 (2002).
- Skopp, N. A., et al. Evaluation of a methodology to validate National Death Index retrieval results among a cohort of U.S. service members. Annals of epidemiology. 27 (6), 397-400 (2017).
- Buck, C. J. 2015 ICD-9-CM for Hospitals, Volumes 1, 2, & 3, Professional Edition. , Elsevier Saunders. (2015).
- Buck, C. J. 2018 ICD-10-CM for Hospitals, Professional Edition. , Elsevier Saunders. (2018).
- Guo, S., Fraser, W. M. Propensity Score Analysis: Statistical Methods and Applications, Second Edition. , Sage Publications. (2015).
- Elixhauser, A., Steiner, C., Harris, D. R., Coffey, R. M. Comorbidity measures for use with administrative data. Medical Care. 36 (1), 8-27 (1998).
- Charlson, M. E., Pompei, P., Ales, K. L., MacKenzie, C. R. A new method of classifying prognostic comorbidity in longitudinal studies: development and validation. Journal of Chronic Diseases. 40 (5), 373-383 (1987).
- Deyo, R. A., Cherkin, D. C., Ciol, M. A. Adapting a clinical comorbidity index for use with ICD-9-CM administrative databases. Journal of Clinical Epidemiology. 45 (6), 613-619 (1992).
- Austin, P. C., Stuart, E. A. The performance of inverse probability of treatment weighting and full matching on the propensity score in the presence of model misspecification when estimating the effect of treatment on survival outcomes. Statistical Methods in Medical Research. 26 (4), 1654-1670 (2017).
- Austin, P. C. Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine. 28 (25), 3083-3107 (2009).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
