Wzajemna hemizygotyczność poprzez sekwencjonowanie (RH-seq) to nowa, potężna metoda mapowania genetycznych podstaw różnic między gatunkami. Pule hemizygot są generowane przez mutagenezę transpozonów, a ich sprawność jest śledzona poprzez wzrost konkurencyjności przy użyciu sekwencjonowania o wysokiej długości czasu. Analiza uzyskanych danych wskazuje geny leżące u podstaw tej cechy.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Mapowanie genetyczne różnic w termotolerancji między gatunkami drożdży Saccharomyces za pomocą analizy wzajemnej hemizygotyczności całego genomu
W tym artykule
Podsumowanie
Streszczenie
Głównym celem współczesnej genetyki jest zrozumienie, jak i dlaczego organizmy żyjące na wolności różnią się fenotypem. Do tej pory dziedzina ta poczyniła postępy w dużej mierze dzięki metodom mapowania powiązań i asocjacji, które śledzą związek między wariantami sekwencji DNA a fenotypem w rekombinowanym potomstwie z krzyżowania się osobników gatunku. Podejścia te, choć skuteczne, nie są dobrze dostosowane do różnic w cechach między gatunkami izolowanymi reprodukcyjnie. W tym miejscu opisujemy nową metodę analizy zmienności cech naturalnych w całym genomie, którą można łatwo zastosować do niekompatybilnych gatunków. Nasza strategia, RH-seq, polega na wdrożeniu testu wzajemnej hemizygoty w całym genomie. Wykorzystaliśmy go do zidentyfikowania genów odpowiedzialnych za uderzająco wysoki wzrost temperatury drożdży Saccharomyces cerevisiae w stosunku do ich siostrzanego gatunku S. paradoxus. RH-seq wykorzystuje mutagenezę transpozonów do stworzenia puli wzajemnych hemizygot, które są następnie śledzone przez konkurencję w wysokiej temperaturze za pomocą sekwencjonowania o wysokiej przepustowości. Nasz przepływ pracy RH-seq, jak opisano tutaj, zapewnia rygorystyczny, bezstronny sposób analizowania starożytnych, złożonych cech w pączkującym kladzie drożdży, z zastrzeżeniem, że potrzebne jest głębokie sekwencjonowanie wymagające dużej ilości zasobów, aby zapewnić pokrycie genomu do mapowania genetycznego. Wraz ze spadkiem kosztów sekwencjonowania, podejście to jest bardzo obiecujące pod względem przyszłego zastosowania u eukariontów.
Wprowadzenie
Od zarania tej dziedziny, głównym celem genetyki było zrozumienie mechanistycznych podstaw zmienności wśród dzikich osobników. Gdy mapujemy loci leżące u podstaw interesującej nas cechy, pojawiające się geny mogą być natychmiast wykorzystane jako cele w diagnostyce i lekach, a także mogą rzucić światło na zasady ewolucji. Standardem branżowym w tym celu jest testowanie związku między genotypem a fenotypem w całej populacji poprzez powiązanie lub asocjację1. Choć podejścia te są potężne, mają jedno kluczowe ograniczenie - opierają się na dużych panelach rekombinowanego potomstwa z krzyżówek między osobnikami interpłodnymi. Nie są one przydatne w badaniach nad gatunkami, które nie mogą łączyć się w pary, aby stworzyć potomstwo. W związku z tym dziedzina ta ma niewielkie możliwości bezstronnej analizy różnic cech między gatunkami izolowanymi reprodukcyjnie2.
W tej pracy przedstawiamy techniczne podstawy nowej metody, RH-seq3, do badań w skali genomu genetycznych podstaw zmienności cech między gatunkami. To podejście jest masowo równoległą wersją testu wzajemnej hemizygoty4,5, który został po raz pierwszy pomyślany jako sposób oceny fenotypowych skutków różnic allelicznych między dwoma genetycznie odrębnymi tłami w określonym locus (Rysunek 1A). W tym schemacie dwa rozbieżne osobniki są najpierw łączone, aby utworzyć hybrydę, której połowa genomu pochodzi od każdego z odpowiednich rodziców. W tym tle generowanych jest wiele szczepów, z których każdy zawiera przerwaną lub usuniętą kopię allelu locus każdego z rodziców. Szczepy te są hemizygotyczne, ponieważ pozostają diploidalne w całym genomie, z wyjątkiem miejsca zainteresowania, gdzie są uważane za haploidalne, i są określane jako wzajemne, ponieważ każdy z nich nie ma tylko allelu jednego rodzica, a pozostały allel pochodzi od drugiego rodzica. Porównując fenotypy tych wzajemnych szczepów hemizygoty, można wywnioskować, czy warianty sekwencji DNA w manipulowanym locus przyczyniają się do cechy będącej przedmiotem zainteresowania, ponieważ warianty w locus są jedyną różnicą genetyczną między wzajemnymi szczepami hemizygoty. W ten sposób możliwe jest powiązanie różnic genetycznych między gatunkami z różnicą fenotypową między nimi w dobrze kontrolowanym układzie eksperymentalnym. Do tej pory zastosowania tego testu były w ramach genu kandydującego - to znaczy przypadków, w których istnieje już hipoteza, że naturalna zmienność w locus kandydata może wpływać na cechę.
W dalszej części przedstawiamy protokół badania przesiewowego wzajemnej hemizygotyczności w skali genomu, używając drożdży jako systemu modelowego. Nasza metoda tworzy genomowe uzupełnienie mutantów hemizygoty, generując żywotne, sterylne hybrydy F1 między gatunkami i poddając je mutagenezie transpozonów. Łączymy hemizygoty, mierzymy ich fenotypy w testach opartych na sekwencjonowaniu i testujemy różnice w częstości występowania między klonami puli zawierającymi allele dwojga rodziców danego genu. Rezultatem jest katalog loci, w których warianty między gatunkami wpływają na cechę będącą przedmiotem zainteresowania. Wdrażamy przepływ pracy RH-seq, aby wyjaśnić genetyczne podstawy różnic w termotolerancji między dwoma pączkującymi gatunkami drożdży, Saccharomyces cerevisiae i S. paradoxus, które rozdzieliły się ~5 milionów lat temu6.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
1. Przygotowanie plazmidu zawierającego piggyBac do transformacji
- Wykonaj posiew do pojedynczych kolonii szczepu E. coli zawierającego plazmid pJR487 na płytkę z agarem LB + karbenicylina. Inkubuj przez 1 noc w 37 °C lub do pojawienia się pojedynczych kolonii.
UWAGA: Opis sposobu klonowania plazmidu pJR487 znajduje się w naszej poprzedniej pracy3. - Zaszczep 1 L pożywki LB + karbenicylina w stężeniu 100 μg/mL pojedynczą kolonią E. coli zawierającą pJR487 w szklanej kolbie o pojemności 2 L. Hoduj przez noc w 37 °C przy wytrząsaniu z prędkością 200 rpm do momentu nasycenia (OD600 ≥ 1.0).
- Oczyść plazmidowe DNA z hodowli, używając zestawu do wielkoskalowego przygotowania plazmidów zgodnie z instrukcją w opublikowanym protokole producenta (szczegóły w Tabeli materiałów). Eluuj DNA po 10-minutowej inkubacji przy użyciu 5 mL buforu do elucji podgrzanego do 37 °C.
- Zmierz ilość i jakość plazmidowego DNA za pomocą spektrofotometru (szczegóły w Tabeli materiałów).
- Powtarzaj kroki 1.2 – 1.4, aż do wyizolowania łącznie co najmniej 11 mg plazmidowego DNA przy stosunku A260:A280 wynoszącym co najmniej 1.8. W zależności od wydajności może to wymagać przeprowadzenia kilku serii izolacji.
- Wymieszaj wszystkie preparaty plazmidowe w jednej probówce i uzupełnij objętość całkowitą do 20 mL buforem do elucji lub wodą. Ponownie zmierz końcową ilość i jakość za pomocą spektrofotometru. Stężenie plazmidu w tej końcowej objętości 20 mL powinno wynosić co najmniej 538 ng/μL. Jeśli stężenie jest wyższe niż 538 ng/μL, rozcieńcz plazmid buforem do elucji lub wodą do stężenia 538 ng/μL. Plazmid można przechowywać w 4 °C przez kilka tygodni do momentu użycia.
2. Tworzenie puli niecelowanych, genomowych reciprokalnych hemizygot
- Przygotowanie hybrydowych komórek drożdży do transformacji
- Wysiej szczep JR507 z -80 °C przenieść szczep z zamrażarki w celu wyizolowania pojedynczych kolonii na płytce z agarem YPD. Inkubować w 26 °C przez 2 dni lub do czasu pojawienia się kolonii.
UWAGA: JR507 jest szczepem hybrydowym otrzymanym w wyniku kojenia pojedynczych komórek haploidnych zarodników S. cerevisiae DBVPG1373 i S. paradoxus Z1 (przy użyciu mikroskopu do analizy tetrad).3. - Zaszczep 100 ml płynnej pożywki YPD w szklanej kolbie o pojemności 250 ml pojedynczą kolonią szczepu JR507 i inkubuj wstrząsowo przy 28 °C, 200 obr./min przez 24 godziny lub do momentu osiągnięcia fazy stacjonarnej.
- Następnego dnia zmierz gęstość optyczną przy 600 nm (OD600) hodowli nocnej. Przygotuj nową hodowlę, rozcieńczając część hodowli nocnej świeżą płynną pożywką YPD w nowej kolbie szklanej o pojemności 1 l do wartości OD600 o wartości 0,2 i objętości 500 mL.
UWAGA: Przykładowe obliczenie rozcieńczenia wstecznego, jeżeli hodowla nocna posiada wartość OD600 wynoszącej 5,0, gdzie C to gęstość optyczna, a V to objętość:
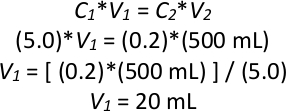
Zatem 20 ml nasyconej kultury z nocnej inkubacji należy dodać do 480 ml ciekłego medium YPD, aby otrzymać łącznie 500 ml kultury o gęstości optycznej (OD)600 wynoszącej 0,2. - Powtórz krok 2.1.3 jeszcze trzy razy, aby przygotować łącznie cztery hodowle o objętości 500 ml przy danej OD600 do 0,2 w czterech szklanych kolbach o pojemności 1 l, wykorzystując tę samą kulturę nocną dla wszystkich czterech nowych kultur. Inkubować je wszystkie w temperaturze 28 °C przez 6 godzin (2–3 generacje) przy wytrząsaniu z prędkością 200 obr./min.
- Połącz dwie z kultur o objętości 500 mL, aby otrzymać kulturę o objętości 1 L. Pozostałe dwie kultury o objętości 500 mL połącz, aby utworzyć kolejną kulturę o objętości 1 L. W tym momencie otrzymane zostaną dwie kultury o objętości 1 L. Każda z tych kultur zostanie poddana transformacji pJR487 w kolejnych krokach.
- Wysiej szczep JR507 z -80 °C przenieść szczep z zamrażarki w celu wyizolowania pojedynczych kolonii na płytce z agarem YPD. Inkubować w 26 °C przez 2 dni lub do czasu pojawienia się kolonii.
- Transformacja pJR487 do hybrydowych komórek drożdży
- Każdą z kultur o objętości 1 L podziel na dwadzieścia 50 ml alikwotów w 20 plastikowych probówkach stożkowych, co da łącznie 40 probówek. Odstaw 20 probówek i wykonuj następne kroki partiami po 20 probówek.
- Wirować każdą z dwudziestu probówek przez 3 min przy 1000 x g. g w celu odwirowania komórek drożdży. Odrzucić nadsącz.
- Resuspenduj każdy osad w 25 ml sterylnego H2Wymieszać w wirówce (vortex). Wirować przez 3 min w temperaturze 1000 x g. gOdrzuć nadsącz.
- Każdy osad resuspender w 5 ml buforu 1x TE, 0,1 M LiOAc za pomocą wirówka wortexowej. Wirować przez 3 min w temperaturze 1000 x gOdlej nadsącz.
- Powtórz krok 2.2.4. Podczas wirowania komórek przygotuj co najmniej 120 ml roztworu zawierającego 39,52% glikolu polietylenowego, 0,12 M LiOAc oraz 1,2x bufor Tris-EDTA (12 mM Tris-HCl i 1,2 mM EDTA). Przechowuj w lodzie.
- Aby przygotować plazmidowe DNA do transformacji, najpierw zagotować 4 ml DNA z nasienia łososia w temperaturze 100 °C przez 5 min, a następnie natychmiast schłodzić na lodzie przez 5 min. Następnie zmieszać 20 mL pJR487 (otrzymanego w sekcji 1) o stężeniu 538 ng/μL z 4 ml schłodzonego DNA z nasienia łososia do uzyskania całkowitej objętości 24 ml. Przechowywać w lodzie do momentu użycia.
- Dodaj 600 μL plazmidowego DNA zmieszanego z DNA sperm salmon sperm na wierzchu każdego osadu komórkowego. Nie resuspender jeszcze.
- Do każdego osadu należy dodać 3 ml roztworu PEG-LiOAc-TE przygotowanego w kroku 2.2.5. Osad należy resuspender poprzez pipetowanie w górę i w dół oraz mieszanie w wirówce typu vortex.
- Inkubować każdą probówkę przez 10 min w temperaturze pokojowej.
- Poddaj każdą probówkę szokowi termicznemu przez 26 min w łaźni wodnej ustawionej na 39 °C.
UWAGA: Co kilka minut należy odwrócić każdą probówkę, aby zapobiec osadzaniu się komórek na dnie. - Wiruj każdą probówkę przez 3 min w temperaturze 1000 x g gOdrzucić nadosad i zawiesić każdy osad w 10 ml pożywki YPD, mieszając na wirówce typu vortex. Przenieść zawartość wszystkich dwudziestu probówek do nowej kolby szklanej. Całkowita objętość komórek powinna wynosić ok. 200 ml.
- Przenieść 66,6 ml komórek do nowej szklanej kolby o pojemności 1 l i uzupełnić objętość do 500 ml za pomocą ciekłego podłoża YPD. Powtórzyć tę czynność jeszcze dwukrotnie, aby wykorzystać całe 200 ml przekształconych komórek. Zmierzyć OD600 z każdej nowej hodowli o objętości 500 ml (przewidywana wartość OD600 od ~0,35 do 4).
- Wstrząsaj wszystkie trzy kolby przy 28 °C przez 2 godziny w celu regeneracji (<1 generacja) przy 200 obr./min.
- Do każdej z trzech kolb dodać 0,5 ml G418 o stężeniu 300 mg/ml, aby uzyskać stężenie końcowe wynoszące 300 μg/mL G418 i ponownie inkubować z wytrząsaniem w 28 °C, 200 obr./min.
UWAGA: Przed tym krokiem transformowane komórki hybrydowe przechodziły regenerację po transformacji. Po dodaniu G418 przeprowadzana jest selekcja w kierunku obecności plazmidu pJR487. Wszystkie komórki, które nie pobrały plazmidu podczas transformacji, zaczną obumierać. - Powtórzyć kroki 2.2.2 – 2.2.14 dla pozostałych 20 probówek stożkowych z komórkami. Na tym etapie powinno powstać sześć 1-litrowych kolb szklanych, z których każda zawiera 500 ml komórek z dodatkiem G418.
- Inkubować wszystkie sześć kolb z komórkami w temperaturze 28 °Cpod wytrząsaniem z prędkością 200 obr./min przez około 2 dni lub do momentu uzyskania wartości OD600 w każdej kolbie osiągnięto wartość ~2,3. Połącz zawartość wszystkich sześciu kolb, aby stworzyć jedną kulturę.
UWAGA: Choć nie wszystkie komórki z tej hodowli zostaną wykorzystane w kolejnych etapach, celem zastosowania tak dużych objętości było wygenerowanie jak największej liczby unikalnych zdarzeń transformacji oraz znormalizowanie wszelkich błędów systematycznych występujących w ramach pojedynczej transformacji poprzez ich wspólne połączenie. - Użyj kultury przygotowanej w punkcie 2.2.16 do zaszczepienia dwóch nowych kolb o pojemności 1 l zawierających 500 ml pożywki YPD + G418 (300 μg/mLdo wartości OD600 wynoszącej 0,2. Pozostała część hodowli może zostać usunięta.
- Inkubować obie kolby o pojemności 1 l w 28 °C przez noc, wstrząsając z prędkością 200 obr./min, aż każda z kultur osiągnie wartość OD600 wynoszącej ~2,2 (~3,5 pokolenia). Połączyć obie kultury w jedną i zmierzyć OD600 ponownie z połączonej kultury.
UWAGA: Na tym etapie kultura powinna składać się prawie całkowicie z komórek zawierających plazmid pJR487. W części populacji komórek transpozon PiggyBac zostanie przetransportowany z plazmidu do genomu przez transpozazę ekspresjonowaną z plazmidu. Jednakże ciągła ekspresja transpozazy może prowadzić do transpozycji w trakcie selekcji, co zatarłoby związek między genotypem a fenotypem. Celem następnych kilku etapów jest przeprowadzenie kontroselekcji przeciwko obecności plazmidu, aby zapewnić brak dalszej ekspresji transpozazy. Powstała pula stanowi mieszaninę komórek z zintegrowanym w genomie transpozonem lub bez niego, jednak w kolejnych etapach mapowania wykrywane są wyłącznie komórki zawierające transpozon. Czas trwania transformacji, podczas którego transpozaza jest ekspresjonowana przed utratą kodującego ją plazmidu, może wpływać na prawdopodobieństwo, że dany klon po mutagenezie będzie posiadał więcej niż jedną insercję transpozonu. Częstotliwość tych zdarzeń, które w analizie pojedynczego genu przejawiają się jako mutacje „wtórne”, można oszacować poprzez wyselekcjonowanie określonej liczby kolonii po mutagenezie, a następnie połączenie ich DNA i potwierdzenie sekwencyjne liczby niezależnych pozycji insercji w puli. - Odwiruj 25 ml tej hodowli przez 3 min w temperaturze 1000 x g gOblicz całkowitą wartość OD.600 jednostek komórek znajdujących się w 25 ml (patrz poniższy przykład obliczeń). Odrzucić nadsącz i zawiesić ponownie w odpowiedniej ilości H2Aby przygotować zawiesinę komórkową o gęstości optycznej (OD) wynoszącej 1,85600/ml poprzez mieszanie w vortexie.
UWAGA: Przykładowe obliczenia dla resuspensji komórek w wodzie, jeśli OD600 kultur mieszanych wynosił 2,2:
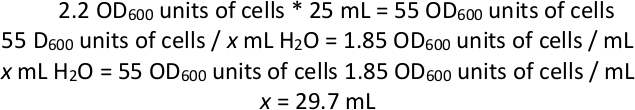
Po odwirowaniu 25 ml hodowli komórkowej i odlaniu supernatantu, należy dodać odpowiednią ilość H2Dodaj wodę do komórek, aby całkowita objętość komórek i wody wyniosła ok. 29,7 ml (ponieważ osad komórkowy również posiada określoną objętość, należy dodać mniej niż 29,7 ml H2O).2O). - Przy użyciu szklanych kulek wysiej 1 ml resuspenderowanych w wodzie komórek na każdą z 12 dużych kwadratowych płytek z kompletnym syntetycznym agarem z dodatkiem 5-FOA. Inkubuj każdą płytkę w 28 °C przez 1-2 dni lub do czasu powstania trawnika bakterii na płytce.
- Za pomocą małych sterylnych ściągaczek zeskrobcie komórki z każdej z 6 płytek do probówki zawierającej 35 ml sterylnej wody. Powtórzcie czynność z pozostałymi 6 płytkami, aby otrzymać łącznie dwie probówki z komórkami i wodą. Połączcie wszystkie zawiesiny komórkowe w jednej probówce. Zmierzcie OD600 tej zawiesiny, używając wody jako wzorca. Doprowadzić wartość OD600stężenie komórek /ml do 44,4 OD600 jednostek/ml w wodzie. W naszym doświadczeniu wydajność transpozycji (odsetek komórek KAN+, które są URA-) wynosi średnio 50%.
- Wyznaczenie liczby -80 °C zamrożone zapasy komórek do przechowywania. Każda alikwot może zostać wykorzystana w przyszłości do pojedynczego eksperymentu.
UWAGA: Ze względu na czasochłonność procesu tworzenia puli, należy przechować kilka fiolek na wypadek przypadkowego niewłaściwego użycia lub do przeprowadzenia powtórzeń eksperymentu. Rozsądna liczba zapasów to 20–30 fiolek. - Każda porcja zamrożona będzie zawierać 40 OD600 jednostek komórek w 1 ml 10% DMSO. Dodać 900 μL komórek do 100 μL DMSO. Powtórz procedurę dla całkowitej liczby przygotowanych zapasów zamrożonych. Przechowuj każdą próbkę w temperaturze -80 °C do późniejszego użycia.
3. Selekcja wzajemnych hemizygot w formacie zbiorczym
- Odmrozić w temperaturze pokojowej pojedynczą alikwotę połączonych wzajemnych hemizygot z sekcji 2 z zamrażarki -80 °C.
UWAGA: Po rozmrożeniu nie należy pozostawiać alikwoty w temperaturze pokojowej przez dłuższy czas; należy jej użyć natychmiast. - Użyć całej 1 mL alikwoty do zaszczepienia 150 mL płynnego medium YPD w szklanej kolbie o pojemności 250 mL. Zmierzyć OD600 tej hodowli, a następnie inkubować w temperaturze 28 °C przy wstrząsaniu 200 rpm przez około 7 godzin lub do momentu, aż hodowla przejdzie przez 2-3 podwojenia populacji. W tym punkcie hodowla jest gotowa do zaszczepienia kultur poddawanych selekcji.
UWAGA: Przykładowe obliczenie: Jeśli OD600 w oryginalnej kolbie wynosi 0,25, inkubować hodowlę do momentu osiągnięcia OD600 na poziomie co najmniej 1,0. Jeśli wymagane są punkty pomiarowe w „czasie zero” (T-0) w celu zbadania populacji hemizygot przed selekcją, można teraz pobrać osady komórkowe, wirując 5-10 mL hodowli na jeden osad przy 1 000 x g przez 3 min, odrzucając nadsącz i zamrażając w -80 °C. - Użyć namnożonej puli hemizygot do zaszczepienia kultur do selekcji zgodnie z odpowiednim schematem powtórzeń, zarówno w wysokiej temperaturze (39 °C), jak i temperaturze dopuszczalnej (28 °C). Należy przygotować co najmniej trzy biologiczne powtórzenia kultur selekcyjnych w każdej temperaturze, co daje łącznie sześć kultur selekcyjnych.
- Przygotować każdą kulturę selekcyjną o całkowitej objętości 500 mL w szklanej kolbie o pojemności 2 L z płynnym medium YPD i zaszczepić do OD600 równej 0,02. Wstrząsać każdą kulturę selekcyjną z prędkością 100 rpm w temperaturze 28 °C lub 39 °C, aż do wystąpienia 6-7 podwojeń populacji (co odpowiada OD600 wynoszącym ok. 1,28-2,56). Należy dążyć do jak najdokładniejszego dopasowania końcowego OD600 we wszystkich kulturach selekcyjnych.
UWAGA: Kultury selekcyjne w 28 °C będą rosły szybciej niż te w 39 °C. W konsekwencji kultury selekcyjne w 39 °C spędzą w inkubatorze więcej czasu. Należy przejść do kolejnych kroków z każdą kolbą w momencie, gdy będzie gotowa, niezależnie od całkowitej liczby godzin spędzonych w inkubatorze. Według naszego doświadczenia hodowle w 28 °C i 39 °C osiągały OD ok. 2,0 odpowiednio po około 12 lub 18 godzinach. Długa selekcja może mieć tę zaletę, że wzmacnia niewielkie efekty dostosowania, ale pozwala również na pojawienie się mutacji tła de novo, co wprowadziłoby szum do końcowego rozkładu dostosowania mutantów transpozonalnych w obrębie dowolnego genu/allelu. Dlatego ważne jest ograniczenie czasu selekcji w eksperymencie RH-seq.
- Przygotować każdą kulturę selekcyjną o całkowitej objętości 500 mL w szklanej kolbie o pojemności 2 L z płynnym medium YPD i zaszczepić do OD600 równej 0,02. Wstrząsać każdą kulturę selekcyjną z prędkością 100 rpm w temperaturze 28 °C lub 39 °C, aż do wystąpienia 6-7 podwojeń populacji (co odpowiada OD600 wynoszącym ok. 1,28-2,56). Należy dążyć do jak najdokładniejszego dopasowania końcowego OD600 we wszystkich kulturach selekcyjnych.
- Zebrać osady komórkowe z każdej kultury selekcyjnej. Obliczyć objętość wymaganą do uzyskania 7 jednostek OD600 komórek i odwirować co najmniej cztery osady o tej objętości z każdej kultury selekcyjnej (jako powtórzenia techniczne do przygotowania biblioteki i sekwencjonowania, patrz sekcje 4 i 5 poniżej) przy 1 000 x g przez 3 min. Odrzucić nadsącz i przechowywać w -80 °C.
UWAGA: Przykład dla kolby selekcyjnej o końcowym OD600 równym 2,0:
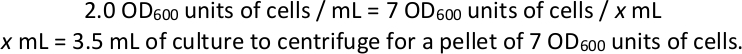
4. Konstrukcja biblioteki Tn-seq i sekwencjonowanie Illumina w celu określenia liczebności hemizygot mutantów transpozonowych
- Odmrozić na lodzie każdy osad komórkowy z sekcji 3, który ma zostać poddany sekwencjonowaniu.
- Wyizolować całkowite DNA genomiczne (gDNA) z każdego osadu komórkowego, używając zestawu do oczyszczania gDNA drożdży zgodnie z instrukcjami producenta. Resuspendować DNA w 50 μL buforu elucyjnego podgrzanego do 65 °C.
- Oznaczyć ilość gDNA z każdego osadu za pomocą fluorometru. Minimalna całkowita ilość gDNA wymagana dla każdego osadu komórkowego w celu stworzenia biblioteki do sekwencjonowania nowej generacji (NGS) dla Tn-seq przy użyciu poniższej procedury wynosi 1 μg.
UWAGA: Do stworzenia biblioteki można użyć mniej niż 1 μg gDNA, ale wpłynie to negatywnie na końcową ilość i jakość biblioteki. - Postępować zgodnie z ustalonym protokołem tworzenia bibliotek Tn-seq7. Należy zwrócić uwagę na następujące istotne informacje, które są specyficzne dla niniejszego protokołu:
- Po fragmentacji gDNA, naprawie końców i ligacji adapterów, namnożyć gDNA zawierający transposon za pomocą PCR. Do tej reakcji PCR użyć następujących starterów forward i reverse, które są specyficzne odpowiednio dla transposonu PiggyBac i adapterów NGS:
Forward (N – nukleotyd losowy)
5’ ATGATACGGCGACCACCGAGATCTACACTCTTTCCCTACACGACG
CTCTTCCGATCTNNNNNNAGCAATATTTCAAGAATGCATGCGTCAAT 3’
Reverse (ciąg N oznacza unikalny 6-bp indeks używany do multipleksowania. Więcej informacji na temat indeksów znajduje się poniżej)
5’ CAAGCAGAAGACGGCATACGAGATNNNNNNGTGACTGGAGTTCAG
ACGTGTGCTCTTCCGATCT 3’ - Zastosować dołączone etapy oczyszczania z użyciem koralików selektywnych względem wielkości, aby zminimalizować proporcję sklonowanych fragmentów w końcowej bibliotece, które byłyby zbyt krótkie, aby zawierały mapowalne sekwencje genomiczne.
UWAGA: Po spełnieniu minimalnych wymogów dotyczących liczby powtórzeń dla kultur selekcyjnych, do sekwencjonowania dostępnych będzie 24 oddzielne próbki gDNA. Biorąc pod uwagę obecne koszty sekwencjonowania, mało prawdopodobne jest, aby każda próbka była analizowana osobno. Aby połączyć próbki w jednym kanale (lane), należy stworzyć wiele starterów reverse, z których każdy posiada unikalny 6-bp indeks. Próbki z różnymi indeksami można połączyć w tym samym kanale sekwencjonowania, a następnie rozdzielić obliczeniowo.
- Po fragmentacji gDNA, naprawie końców i ligacji adapterów, namnożyć gDNA zawierający transposon za pomocą PCR. Do tej reakcji PCR użyć następujących starterów forward i reverse, które są specyficzne odpowiednio dla transposonu PiggyBac i adapterów NGS:
- Wykonać sekwencjonowanie odczytów single-end 150 bp z każdej biblioteki przy użyciu technologii NGS w ośmiu kanałach.
UWAGA: Wymagana liczba odczytów z sekwencjonowania w dużym stopniu zależy od jakości bibliotek przygotowanych w poprzednim kroku (tj. od proporcji DNA w bibliotece faktycznie zawierającego DNA transposonu, reprezentującego DNA pochodzące od reciprocal hemizygotes). Przyczyniają się do tego dwa główne czynniki. Po pierwsze, ponieważ komórki bez zintegrowanego transposonu nie są usuwane w drodze kontrselekcji podczas tworzenia puli, każda kultura będzie mieszaniną komórek z transposonem i bez niego. Po drugie, nawet w genomach reciprocal hemizygotes zawierających transposon, większość genomu nie składa się z sekwencji zawierającej transposon, a to gDNA nieuchronnie stanie się częścią przygotowania biblioteki. Celem końcowej amplifikacji PCR DNA zawierającego transposon jest zwiększenie stosunku DNA z transposonem do tych dwóch źródeł tła gDNA. Im bardziej wydajna jest ta amplifikacja, tym większa proporcja odczytów będzie mogła zostać wykorzystana w dalszych analizach. Im niższa jakość bibliotek, tym więcej sekwencjonowania będzie konieczne, ponieważ rosnąca proporcja odczytów nie będzie zawierać DNA transposonu i okaże się bezużyteczna. Biorąc pod uwagę powyższe ograniczenia, sekwencjonowanie w ośmiu kanałach pozwoliło na śledzenie liczebności reciprocal hemizygotes w rozsądnym stopniu. Większa liczba sekwencjonowań umożliwiłaby głębszą analizę.
5. Mapowanie lokalizacji insercji transpozonów i analiza RH-seq
UWAGA: Poniższa analiza danych została przeprowadzona przy użyciu niestandardowych skryptów Python (dostępnych online pod adresem https://github.com/weiss19/rh-seq), lecz można ją powtórzyć, korzystając z innych języków skryptowych. Poniżej przedstawiono główne etapy tego procesu. Wykonaj następujące kroki dla każdego pliku odczytów z pojedynczej powtórki, chyba że zaznaczono konieczność ich połączenia.
- Usuń sekwencje adapterów z odczytów i rozdziel odczyty każdego powtórzenia zgodnie z indeksem.
- Zidentyfikuj odczyty zawierające połączenia transpozon-genom. Aby to osiągnąć, wyszukaj w każdym odczycie ostatnie 20 par zasad transpozonu: CAGACTATCTTTCTAGGGTTAA. Odrzuć wszystkie odczyty, które nie zawierają tej sekwencji.
UWAGA: W naszym doświadczeniu proporcja odczytów mapujących się do końca transpozonu wynosi 83-95%. - Przytnij pozostałe odczyty zawierające transpozon tak, aby zawierały jedynie sekwencję znajdującą się poniżej końca 3’ transpozonu. Poprzez zmapowanie tej sekwencji do genomu drożdży, określ kontekst genomowy insercji transpozonu dla każdego odczytu (krok 5.4 poniżej).
- Użyj narzędzia BLAT lub równoważnego narzędzia mapującego, aby zmapować sekwencję poniżej transpozonu do genomu hybrydy S. cerevisiae DBVPG1373 x S. paradoxus Z1 (Nazwa skryptu: map_and_pool_BLAT.py).
- Odrzuć wszystkie odczyty, dla których poniżej końca 3’ transpozonu znajduje się mniej niż 50 par zasad użytecznej sekwencji. Krótkie sekwencje są trudne do jednoznacznego zmapowania.
- W przypadku użycia BLAT, zastosuj następujące parametry: identity = 95, tile size = 12.
- Utwórz podstawowy genom hybrydy do mapowania poprzez konkatenację najnowszych wersji genomów referencyjnych S. cerevisiae S288c i S. paradoxus CBS432.
UWAGA: Podstawowy plik adnotacji opisujący granice genomowe poszczególnych genów w całym genomie hybrydy znajduje się w repozytorium Github wymienionym powyżej (Nazwa pliku: YS2+CBS432+plasmid_clean). Używaj tylko odczytów, które mapują się do jednej lokalizacji w genomie hybrydy (tzn. są unikalne dla S. cerevisiae lub S. paradoxus). Oczekiwana jest jednolita częstotliwość zdarzeń insercji w całym genomie; rozkład pozycji insercji w genomach został opisany w innym opracowaniu3.
- Zsumuj całkowitą liczbę odczytów mapujących się do każdej unikalnej lokalizacji insercji transpozonu, z których wnioskujemy, że wszystkie pochodzą z komórek jednego klonu mutanta z insercją transpozonu. Sumę wszystkich takich wartości z jednej biblioteki określa się jako całkowitą liczbę zmapowanych odczytów dla tej biblioteki.
- W przypadkach, gdy wiele insercji mapuje się w odległości 3 par zasad od siebie, połącz je wszystkie w jeden punkt insercji, przypisując wszystkie odczyty do pojedynczej lokalizacji z najwyższą liczbą odczytów. Wartość ta, ninsert, reprezentuje obfitość tego klonu insercji w osadzie komórkowym, z którego zsekwencjonowano gDNA. Na tym etapie powstaną listy ninsert, z których każda stanowi obfitość unikalnej zmapowanej insercji transpozonu, jedna lista dla każdego zsekwencjonowanego osadu komórkowego.
UWAGA: Transpozon PiggyBac wstawia się w sekwencje TTAA w genomie, będące sekwencją o długości 4 par zasad. Zatem wnioskujemy, że insercje mapujące się w odległości 3 par zasad od siebie muszą pochodzić z tego samego miejsca TTAA. - Ponieważ całkowita liczba odczytów z każdej zsekwencjonowanej biblioteki będzie się nieco różnić, znormalizuj wartości ninsert we wszystkich plikach, jeśli mają być one porównywane. Zrób to, tabulując całkowitą liczbę zmapowanych odczytów z każdej poszczególnej biblioteki, npellet, i obliczając średnią ze wszystkich npellet we wszystkich bibliotekach, <npellet>. Pomnóż każdy ninsert w danych z pojedynczej biblioteki przez stosunek <npellet> / npellet, aby obliczyć ainsert, czyli znormalizowaną obfitość danego klonu insercji transpozonu.
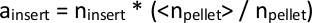
Alternatywnie, wielkość biblioteki można oszacować za pomocą dostępnych narzędzi, takich jak DESeq28 (Nazwa skryptu: total_reads_and_normalize.py). - Utwórz tabelę wszystkich insercji zmapowanych we wszystkich bibliotekach. Dla insercji znalezionych w niektórych bibliotekach, ale nie w innych, przyjmij ainsert = 1 do dalszych obliczeń.
- Przefiltruj odczyty, aby znaleźć te insercje, które znajdują się w obrębie genów zgodnie z plikiem adnotacji (Nazwa skryptu: remove_NC_and_plasmid_inserts.py).
- Dla każdej unikalnej insercji oblicz średnią obfitość w powtórzeniach technicznych każdej selekcji (każda hodowla w temperaturze 28 °C lub 39 °C), <ainsert>technical (Nazwa skryptu: combine_tech_reps_V2.py).
- Dla każdej unikalnej insercji oblicz średnią obfitość w powtórzeniach biologicznych dla każdej temperatury, <ainsert>total, wyliczając średnią ze wszystkich <ainsert>technical dla każdej temperatury. Jednocześnie oblicz współczynnik zmienności dla każdej insercji, CVinsert,total, w obrębie <ainsert>technical (Nazwa skryptu: combine_bio_reps.py).
UWAGA: Na tym etapie, dla każdej temperatury, 28 °C i 39 °C, istnieje lista unikalnych insercji transpozonu, ich średniej obfitości oraz współczynnika zmienności między powtórzeniami biologicznymi dla każdej z nich. Dane te dla naszego eksperymentu zostały przedstawione w innym opracowaniu3. - Przefiltruj listę wszystkich insercji, wybierając te, które w temperaturze 28 °C lub 39 °C spełniają warunki: <ainsert>total > 1.1 oraz CVinsert,total ≤ 1.5 (Nazwa skryptu: filter_inserts.py).
- Dla każdej unikalnej insercji oblicz log2(<ainsert>total,28 °C / <ainsert>total,39 °C). Wartość ta reprezentuje „termotolerancję” danego klonu mutanta z insercją transpozonu (Nazwa skryptu: fitness_ratios.py).
- Posortuj wszystkie unikalne insercje według genu i allelu (S. cerevisiae lub S. paradoxus) i ztabuluj liczbę insercji w każdym allelu. Przefiltruj geny tak, aby analizowane były tylko te, które mają co najmniej 5 insercji w każdym allelu (Nazwa skryptu: organize_and_filter_genes.py).
UWAGA: Wiele unikalnych insercji w każdym allelu pozwala na dokładniejszy pomiar termotolerancji tego reciprocal hemizygote. Zmniejszenie liczby wymaganych insercji na allel jest możliwe, ale obniży dokładność tego pomiaru i zwiększy obciążenie związane z wielokrotnym testowaniem poprzez dopuszczenie większej liczby genów do analizy. Dodatkowo, odfiltrowanie genów z zbyt małą liczbą insercji na allel pomoże ograniczyć wpływ na wyniki testów każdego pojedynczego klonu hemizygoty posiadającego mutację w miejscu wtórnym, która nadaje bardzo odmienny fenotyp. - Dla każdego genu pozostałego w zbiorze danych po powyższym filtrowaniu, porównaj termotolerancje (stosunki log2) wszystkich insercji w allelu S. cerevisiae do tych w allelu S. paradoxus za pomocą testu U Manna-Whitneya. Alternatywnie można zastosować model regresji zaadaptowany z DESeq28 (Nazwa skryptu: mann_whitney_u.py).
- Skoryguj wartości p dla wielokrotnego testowania za pomocą metody Benjamini-Hochberga.
- Geny z istotnymi wartościami p (np. ≤ 0.01) są kandydatami na geny ważne dla różnic w termotolerancji między dwoma gatunkami.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Skrzyżowaliśmy S. cerevisiae i S. paradoxus, aby utworzyć sterylnego hybryda, którą poddaliśmy mutagenezie transpozonom. Każdy zmutowany klon był hemizygotą, czyli hybrydą diploidalną, w której jeden allel jednego genu jest uszkodzony (Rysunek 1A, Rysunek 2). Przeprowadziliśmy konkurencję hemizygot między sobą poprzez wzrost w temperaturze 39 °C, a w osobnym eksperymencie kontrolnym w temperaturze 28 °C (Ry...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Przewaga RH-seq nad dotychczasowymi metodami statystyczno-genetycznymi jest kilkukrotna. W przeciwieństwie do analizy sprzężeń i asocjacji, RH-seq zapewnia rozdzielczość mapowania pojedynczego genu; W związku z tym będzie prawdopodobnie bardzo przydatny nawet w badaniach nad zmiennością cech u osobników danego gatunku, a także różnicami międzygatunkowymi. Ponadto wcześniejsze próby analizy wzajemnej hemizygotyczności całego genomu wykorzystywały zbiory mutantów delecji genów, z których niektóre zawierają wtórne mutacje, ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Dziękujemy J. Roopowi, R. Hackleyowi, I. Grigorievowi, A. Arkinowi i J. Skerkerkowi za ich wkład w oryginalne badanie, F. AlZabenowi, A. Flury'emu, G. Geiselmanowi, J. Hongowi, J. Kimowi, M. Maurerowi i L. Oltrogge za pomoc techniczną, D. Savage'owi za hojność w zakresie zasobów mikroskopowych, oraz B. Blackmanowi, S. Coradettiemu, A. Flamholzowi, V. Guacci, D. Koshlandowi, C. Nelsona i A. Sasikumara za dyskusje; Dziękujemy również J. Dueberowi (Wydział Bioinżynierii, UC Berkeley) za plazmid PiggyBac. Prace te były wspierane przez R01 GM120430-A1 oraz przez Community Sequencing Project 1460 dla RBB w Joint Genome Institute Departamentu Energii Stanów Zjednoczonych, DOE Office of Science User Facility. Prace prowadzone przez tę ostatnią były wspierane przez Biuro Nauki Departamentu Energii USA w ramach umowy nr 1. DE-AC02-05CH11231.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 1-2 plazmidowe zestawy Gigaprep | Zymo Research | D4204 | Liczba wymaganych zestawów zależy od tego, jak wydajne są twoje przygotowania w każdym zestawie. Ten zestaw jest dostarczany z 5 indywidualnymi kolumnami do przygotowania plazmidu. Przepuść 1 l nasyconej kultury E. coli przez każdą kolumnę przygotowawczą, ponieważ użycie więcej niż 1 l na kolumnę może spowodować zatkanie filtra przygotowawczego, prowadząc do niskiej wydajności i niskiej jakości DNA. |
| 10X bufor Tris-EDTA (TE) (100 mM Tris-HCl i 10 mM EDTA) | Dowolny | N / A | sterylizuje przez 0,22 μ m filtr przed użyciem. |
| 1M LiOAc | Dowolny | N/A | sterylizuje przez 0,22 μ m filtr przed użyciem. |
| 300 mg/ml Geneticin (G418) | Gibco | 11811023 | |
| 52% glikol polietylenowy (PEG) 3350 | Sigma | 1546547 | Rozpuść w wodzie i przefiltruj sterylizować przez 0,22 μ m filtr przed użyciem. 1X trafo mix: 228 uL 52% PEG, 36 uL 1M LiOAc, 36 uL 10X TE |
| buffer Autoklawizowany płynny bulion LB | BD Difco | 244620 | Przygotuj płynny bulion LB przy użyciu proszku dowolnej marki i wody miliQ. Autoklawuj go przed użyciem. |
| Zapas karbenicyliny w wodzie (100 mg / ml) | Dowolny | N / A | sterylizować przez 0,22 μ m filtr przed użyciem. |
| Kompletne syntetyczne płytki agarowe (24,1 cm x 24,1 cm) z kwasem 5-fluoroorotycznym (5-FOA) [0,2% mieszanka aminokwasów drop-out bez uracylu lub drożdżowej zasady azotowej (YNB), 0,005% uracylu, 2% D-glukozy, 0,67% YNB bez aminokwasów, 0,075% 5-FOA] | 5-FOA: Zymo Research, Drop-out mix: US Biological, Uracil: Sigma, D-glukoza: Sigm), YNB: Difco | 5-FOA: F9001-5, Drop-out mix: D9535, Uracyl: U0750, D-glukoza: G8270, YNB: DF0919 | |
| DMSO | Dowolny | N/A | |
| E. COLI przenoszący pJR487 (plazmid zawierający piggyBac) CEN-/ARS+ N | /A | Prośba z laboratorium Brem. | |
| Hybrydowy szczep drożdży JR507 (S. cerevisiae DBVPG1373 x S. paradoxus Z1, URA-/URA-) | N/A | N/A | Zapytanie z laboratorium Brem. |
| Illumina Hiseq 2500 | używany do odczytów SE-150 | ||
| Duże inkubatory z wytrząsaniem ze zmiennymi ustawieniami temperatury | Dowolne | N/A | |
| LB + karbenicylina (100 μ g / mL) | Agar: BD Difco | Agar: 214010 | Ułóż płytki agarowe LB jak zwykle i dodaj karbenicylinę do 100 μ g/ml przed suszeniem. |
| Spektrofotometr Nanodrop | Thermo Scientific | ND-2000 | |
| Fluorymetr kubitowy | Thermo Scientific | Q33240 | |
| DNA plemników łososia | Invitrogen | 15632011 | |
| Łaźnia wodna w temperaturze 39& C | Dowolna | Nie dotyczy | |
| Zestaw do przygotowania gDNA grzybów drożdżowych | Zymo Research | D6005 | |
| Płynne podłoże dekstrozy peptonu drożdżowego (YPD) Pepton | BD Difco | Pepton: 211677, Ekstrakt drożdżowy: 212750 | Dodaj sterylizowaną filtrem D-glukozę do 2% po autoklawowaniu. |
| Płytki agarowe YPD + G418 (300 μ g / mL) | Agar: BD Difco | Agar: 214010 | Zrób płytki agarowe YPD jak zwykle i dodaj G418 do 300 μ g/ml przed suszeniem. |
| Płytki agarowe YPD | Agar: BD Difco | Agar: 214010 |
Bibliografia
- Flint, J., Mott, R. Finding the molecular basis of quantitative traits: successes and pitfalls. Nature Reviews Genetics. 2, 437-445 (2001).
- Allen Orr, H. The genetics of species differences. Trends in Ecology and Evolution. 16, 343-350 (2001).
- Weiss, C. V., et al. Genetic dissection of interspecific differences in yeast thermotolerance. Nature Genetics. 50, 1501-1504 (2018).
- Stern, D. L. Identification of loci that cause phenotypic variation in diverse species with the reciprocal hemizygosity test. Trends in Genetics. 30, 547-554 (2014).
- Steinmetz, L. M., et al. Dissecting the architecture of a quantitative trait locus in yeast. Nature. 416, 326-330 (2002).
- Scannell, D. R., et al. The Awesome Power of Yeast Evolutionary Genetics: New Genome Sequences and Strain Resources for the Saccharomyces sensu stricto Genus. G3 (Bethesda). 1, 11-25 (2011).
- Wetmore, K. M., et al. Rapid quantification of mutant fitness in diverse bacteria by sequencing randomly bar-coded transposons. MBio. 6, e00306-e00315 (2015).
- Love, M. I., Huber, W., Anders, S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biology. 15, 550(2014).
- Wilkening, S., et al. An evaluation of high-throughput approaches to QTL mapping in Saccharomyces cerevisiae. Genetics. 196, 853-865 (2014).
- Kim, H. S., Huh, J., Riles, L., Reyes, A., Fay, J. C. A noncomplementation screen for quantitative trait alleles in saccharomyces cerevisiae. G3 (Bethesda). 2, 753-760 (2012).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
