Ten protokół prowadzi początkujących bioinformatyków przez wprowadzający potok analizy CUT&RUN, który umożliwia użytkownikom przeprowadzenie wstępnej analizy i walidacji danych sekwencjonowania CUT&RUN. Wykonanie opisanych tutaj kroków analizy, w połączeniu z adnotacją pików, pozwoli użytkownikom na uzyskanie mechanistycznego wglądu w regulację chromatyny.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Wstępna analiza i walidacja danych sekwencjonowania CUT&RUN
W tym artykule
Podsumowanie
Streszczenie
Technika CUT&RUN ułatwia wykrywanie interakcji białko-DNA w całym genomie. Typowe zastosowania CUT&RUN obejmują profilowanie zmian w modyfikacjach ogona histonowego lub mapowanie zajętości chromatyny czynnika transkrypcyjnego. Powszechne zastosowanie CUT&RUN jest częściowo napędzane przez zalety techniczne w porównaniu z konwencjonalnym sekwencją ChIP, które obejmują niższe wymagania dotyczące wprowadzania komórek, niższe wymagania dotyczące głębokości sekwencjonowania oraz zwiększoną czułość przy zmniejszonym sygnale tła ze względu na brak środków sieciujących, które w przeciwnym razie maskują epitopy przeciwciał. Powszechne przyjęcie CUT&RUN zostało również osiągnięte dzięki hojnemu udostępnianiu odczynników przez laboratorium Henikoff oraz opracowaniu komercyjnych zestawów w celu przyspieszenia wdrożenia przez początkujących. Wraz ze wzrostem technicznego zastosowania CUT&RUN, analiza sekwencjonowania CUT&RUN i walidacja stają się krytycznymi wąskimi gardłami, które muszą zostać pokonane, aby umożliwić pełne przyjęcie przez zespoły laboratoryjne, w których przeważają mokre laboratoria. Analiza CUT&RUN zazwyczaj rozpoczyna się od kontroli jakości surowych odczytów sekwencjonowania w celu oceny głębokości sekwencjonowania, jakości odczytu i potencjalnych odchyleń. Odczyty są następnie dopasowywane do referencyjnego zestawu sekwencji genomu, a następnie wykorzystuje się kilka narzędzi bioinformatycznych do opisywania regionów genomu wzbogacenia białek, potwierdzania możliwości interpretacji danych i wyciągania wniosków biologicznych. Chociaż opracowano wiele potoków analizy in silico w celu wsparcia analizy danych CUT&RUN, ich złożona, wielomodułowa struktura i wykorzystanie wielu języków programowania sprawiają, że platformy te są trudne dla początkujących bioinformatyków, którzy mogą nie znać wielu języków programowania, ale chcą zrozumieć procedurę analizy CUT&RUN i dostosować swoje potoki analityczne. W tym miejscu udostępniamy jednojęzyczny protokół potoku analizy krok po kroku CUT&RUN, przeznaczony dla użytkowników o dowolnym poziomie doświadczenia bioinformatycznego. Protokół ten obejmuje przeprowadzanie krytycznych kontroli jakości w celu sprawdzenia, czy dane sekwencjonowania są odpowiednie do interpretacji biologicznej. Oczekujemy, że przestrzeganie protokołu wprowadzającego przedstawionego w tym artykule w połączeniu z adnotacją o pikach w dół pozwoli użytkownikom na wyciąganie wniosków biologicznych z własnych zestawów danych CUT&RUN.
Wprowadzenie
Możliwość mierzenia interakcji między białkami a genomowym DNA jest fundamentalna dla zrozumienia biologii regulacji chromatyny. Skuteczne testy, które mierzą zajętość chromatyny dla danego białka, dostarczają co najmniej dwóch kluczowych informacji: i) lokalizacji genomowej oraz ii) obfitości białka w danym regionie genomu. Śledzenie zmian rekrutacji i lokalizacji białka będącego przedmiotem zainteresowania w chromatynie może ujawnić bezpośrednie docelowe loci białka i ujawnić mechanistyczne role tego białka w procesach biologicznych opartych na chromatynie, takich jak regulacja transkrypcji, naprawa DNA lub replikacja DNA. Dostępne obecnie techniki profilowania interakcji białko-DNA umożliwiają naukowcom badanie regulacji w niespotykanej dotąd rozdzielczości. Taki postęp techniczny był możliwy dzięki wprowadzeniu nowych technik profilowania chromatyny, które obejmują opracowanie przez laboratorium Henikoff metody rozszczepienia pod celami i uwalniania za pomocą nukleazy (Cleavage Under Targets and Release Using Nucleaase). CUT&RUN oferuje kilka zalet technicznych w porównaniu z konwencjonalną immunoprecypitacją chromatyny (ChIP), które obejmują niższe wymagania dotyczące wprowadzania komórek, niższe wymagania dotyczące głębokości sekwencjonowania oraz zwiększoną czułość przy zmniejszonym sygnale tła ze względu na brak środków sieciujących, które w przeciwnym razie maskują epitopy przeciwciał. Przyjęcie tej techniki do badania regulacji chromatyny wymaga dogłębnego zrozumienia zasady leżącej u podstaw tej techniki oraz zrozumienia, jak analizować, walidować i interpretować dane CUT&RUN.
Procedura CUT&RUN rozpoczyna się od wiązania komórek z konkanawaliną A sprzężoną z kulkami magnetycznymi, aby umożliwić manipulowanie niską liczbą komórek podczas całej procedury. Wyizolowane komórki są przepuszczane przy użyciu łagodnego detergentu, aby ułatwić wprowadzenie przeciwciała, które jest skierowane przeciwko białemu zainteresowaniu. Nukleaza mikrokokkowa (MNaza) jest następnie rekrutowana do związanego przeciwciała za pomocą znacznika białka A lub białka A / G połączonego z enzymem. Wapń jest wprowadzany w celu zainicjowania aktywności enzymatycznej. W wyniku trawienia MNazy powstają mononukleosomalne kompleksy DNA-białko. Wapń jest następnie chelatowany w celu zakończenia reakcji trawienia, a krótkie fragmenty DNA z trawienia MNazy są uwalniane z jąder, a następnie poddawane oczyszczaniu DNA, przygotowaniu biblioteki i sekwencjonowaniu o wysokiej przepustowości1 (Rysunek 1).
Podejścia in silico do mapowania i ilościowego określania obecności białek w całym genomie rozwinęły się równolegle z metodami mokrego laboratorium, używanymi do wzbogacania tych interakcji DNA-białko. Identyfikacja regionów wzbogaconych sygnałów (pików) jest jednym z najbardziej krytycznych etapów analizy bioinformatycznej. Początkowe metody analizy ChIP-seq wykorzystywały algorytmy, takie jak MACS2 i SICER3, które wykorzystywały modele statystyczne do odróżnienia bona fide miejsc wiązania białko-DNA od szumu tła. Jednak niższy szum tła i wyższa rozdzielczość danych CUT&RUN sprawiają, że niektóre programy wywołujące wartości szczytowe stosowane w analizie ChIP-seq nie nadają się do analizy CUT&RUN4. Wyzwanie to uwypukla potrzebę opracowania nowych narzędzi, które lepiej nadają się do analizy danych CUT&RUN. SEACR4 reprezentuje jedno z takich narzędzi, które zostało ostatnio opracowane w celu umożliwienia wywoływania szczytów z danych CUT&RUN, przy jednoczesnym pokonywaniu ograniczeń związanych z narzędziami zwykle stosowanymi do analizy ChIP-seq.
Biologiczne interpretacje z danych sekwencjonowania CUT&RUN są pobierane z danych wyjściowych poniżej wywołania piku w potoku analizy. Można zaimplementować kilka funkcjonalnych programów adnotacyjnych w celu przewidywania potencjalnego znaczenia biologicznego wywoływanych pików na podstawie danych CUT&RUN. Na przykład projekt Gene Ontology (GO) zapewnia ugruntowaną funkcjonalną identyfikację genów będących przedmiotem zainteresowania5,6,7. Różne narzędzia i zasoby programowe ułatwiają analizę GO w celu ujawnienia genów i zestawów genów wzbogaconych wśród szczytów CUT&RUN8,9,10,11,12,13,14. Ponadto oprogramowanie do wizualizacji, takie jak Deeptools15, Integrative genomics viewer (IGV)16 i UCSC Genome Browser17 umożliwiają wizualizację rozkładu sygnałów i wzorców w interesujących regionach genomu.
Zdolność do wyciągania interpretacji biologicznych z danych CUT&RUN zależy przede wszystkim od walidacji jakości danych. Kluczowe komponenty do walidacji obejmują ocenę: i) jakości sekwencjonowania biblioteki CUT&RUN, ii) podobieństwa replikacji oraz iii) dystrybucji sygnału w centrach szczytów. Zakończenie walidacji wszystkich trzech komponentów ma kluczowe znaczenie dla zapewnienia wiarygodności próbek z biblioteki CUT&RUN i wyników dalszej analizy. W związku z tym konieczne jest opracowanie wstępnych przewodników po analizie CUT&RUN, aby umożliwić początkującym bioinformatykom i badaczom w laboratoriach mokrych przeprowadzenie takich etapów walidacji w ramach standardowych procesów analizy CUT&RUN.
Wraz z rozwojem eksperymentu CUT&RUN w laboratorium mokrym, różne metody analizy in silico CUT&RUN, takie jak CUT&RUNTools 2.018,19, nf-core/cutandrun20 oraz CnRAP21, zostały opracowane do obsługi analizy danych CUT&RUN. Narzędzia te zapewniają zaawansowane podejścia do analizy jednokomórkowych i zbiorczych zestawów danych CUT&RUN i CUT&Tag. Jednak stosunkowo złożona modułowa struktura programu i wymagana znajomość wielu języków programowania do przeprowadzania tych potoków analitycznych może utrudniać przyjęcie ich przez początkujących bioinformatyków, którzy chcą dokładnie zrozumieć etapy analizy CUT&RUN i dostosować własne potoki. Obejście tej bariery wymaga nowego, wprowadzającego potoku analizy CUT&RUN, który jest dostarczany w postaci prostych skryptów krok po kroku zakodowanych przy użyciu prostego, pojedynczego języka programowania.
W tym artykule opisujemy prosty, jednojęzyczny protokół potoku analizy CUT&RUN, który dostarcza krok po kroku skrypty wspierane szczegółowymi opisami, aby umożliwić nowym i początkującym użytkownikom przeprowadzanie analizy sekwencjonowania CUT&RUN. Programy używane w tym potoku są publicznie dostępne przez oryginalne grupy deweloperów. Główne kroki opisane w tym protokole obejmują wyrównanie odczytu, wywołanie pików, analizę funkcjonalną i, co najważniejsze, etapy walidacji w celu oceny jakości próbki w celu określenia przydatności i wiarygodności danych do interpretacji biologicznej (Rysunek 2). Co więcej, potok ten daje użytkownikom możliwość porównywania wyników analiz z publicznie dostępnymi zestawami danych CUT&RUN. Ostatecznie, ten protokół procesu analizy CUT&RUN służy jako przewodnik wprowadzający i odniesienie dla początkujących analityków bioinformatycznych i badaczy w laboratoriach mokrych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
UWAGA: Informacje dotyczące plików fastq dla metody CUT&RUN w zbiorze GSE126612 znajdują się w Tabeli 1. Informacje dotyczące aplikacji programistycznych użytych w niniejszym badaniu wymieniono w Tabeli Materiałów.
1. Pobieranie potoku Easy-Shells_CUTnRUN z jego strony na Githubie
- Otwórz terminal w systemie operacyjnym.
UWAGA: Jeśli użytkownik nie wie, jak otworzyć terminal w systemach macOS i Windows, należy zapoznać się z tą stroną (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). W przypadku systemu Linux należy zapoznać się z tą stroną (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Pobierz skompresowany potok analizy z serwisu Github, wpisując w terminalu wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip .
- Po pobraniu pliku zip, rozpakuj go, wpisując w terminalu unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ .
- Po rozpakowaniu usuń plik zip, wpisując w terminalu rm ~/Desktop/Easy-Shells_CUTnRUN.zip i zmień nazwę folderu, wpisując mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN.
- Po usunięciu skompresowanego pliku, wpisz w terminalu chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh, aby nadać uprawnienia do wykonywania wszystkich skryptów powłoki w katalogu roboczym. Od teraz wystarczy wpisać ścieżkę i nazwę tych skryptów w terminalu lub przeciągnąć skrypty do terminala i nacisnąć enter, aby je uruchomić.
UWAGA: Powłoka Bash jest zazwyczaj wstępnie zainstalowana w większości dystrybucji Linuxa. Jednak nowsze wersje macOS nie oferują już wstępnie zainstalowanej powłoki Bash. Jeśli system nie posiada powłoki Bash, należy ją najpierw zainstalować. Instrukcje dotyczące instalacji powłoki Bash w systemie Linux (https://ioflood.com/blog/install-bash-shell-linux/) oraz macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The%20first%20thing%20you%20will,you%20will%20see%20the%20following:) znajdują się pod poniższymi linkami. Te krokowe skrypty powłoki zostały napisane tak, aby utworzyć jeden folder ~/Desktop/GSE126612 i przeprowadzić większość analizy CUT&RUN w tym katalogu bez potrzeby wprowadzania jakichkolwiek modyfikacji. Jeśli użytkownik rozumie sposób działania tych skryptów powłoki, może je zrewidować i dostosować do analizy innych zbiorów danych CUT&RUN oraz zmodyfikować opcje zgodnie ze specyficznymi potrzebami projektu. Do odczytu i edycji tych skryptów powłoki można wykorzystać Visual Studio Code (https://code.visualstudio.com/) jako jedną z opcji łatwego w użyciu programu dostępnego dla głównych systemów operacyjnych.
2. Instalacja programów wymaganych dla Easy Shells CUTnRUN
- Spośród skryptów powłoki o nazwie Script_01_installation_***.sh, znajdź skrypt, którego nazwa zawiera typ systemu operacyjnego używanego przez użytkownika. Obecnie Easy Shells CUTnRUN obsługuje skrypty instalacyjne dla systemów macOS, Debian/Ubuntu oraz systemów opartych na CentOS/RPM.
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy mogą zobaczyć następujący komunikat: /path/to/bash (lub podobny, np. /bin/bash) w terminalu.
- Jeśli domyślną powłoką nie jest Bash, ustaw powłokę Bash jako domyślną, wpisując w terminalu chsh -s $(which bash) . Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- W terminalu uruchom instalacyjny skrypt powłoki, wpisując ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh lub przeciągając plik skryptu do terminala i zatwierdzając klawiszem enter.
- Przeczytaj plik Test_README.md w folderze /path/to/SEACR-1.3/Testfiles. Postępuj zgodnie z instrukcjami zawartymi w pliku README, aby upewnić się, że program SEACR w systemie użytkownika działa prawidłowo.
UWAGA: W celu uzyskania prawidłowych wyników wywoływania pików (peak calling) z danych CUT&RUN kluczowe jest zwalidowanie funkcji SEACR za pomocą plików testowych udostępnionych na stronie SEACR na Githubie. Dlatego niezwłocznie po instalacji SEACR postępuj zgodnie z instrukcjami zawartymi w Test_README.md w /path/to/SEACR-1.3/Testfiles. Mimo że Easy Shells CUTnRUN dostarcza skrypty instalacyjne dla niektórych systemów operacyjnych, skrypty te mogą nie zadziałać w systemach niektórych użytkowników podczas instalacji wszystkich programów wymaganych dla Easy Shells CUTnRUN. W przypadku wystąpienia problemów z instalacją zapoznaj się z oryginalną stroną programu, którego nie udało się zainstalować, lub poproś o pomoc za pomocą strony z problemami (issues) Easy Shells CUTnRUN na githubie (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
3. Pobieranie publicznie dostępnego zbioru danych CUT&RUN z Sequence Read Archive (SRA)
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli powłoką domyślną w aktualnym terminalu jest Bash, użytkownicy zobaczą w terminalu następującą ścieżkę: /path/to/bash (lub podobny komunikat, np. /bin/bash).
- Jeśli powłoka domyślna nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash) . Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt spowoduje: (i) Utworzenie jednego folderu (~/Desktop/GSE126612/fastq) i pobranie listy plików SRA zapisanej w pliku tekstowym (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) do folderu fastq. Przykładowo, SRR_list.txt zawiera pliki fastq dla podzbioru próbek CUT&RUN z serii GSE126612. (ii) Pobranie surowych plików fastq do folderu fastq. (iii) Utworzenie jednego folderu (~/Desktop/GSE126612/log/fastq) i zapisanie w nim pliku dziennika (download-fastq_log.txt) oraz pliku z informacjami o pobranych próbkach (SRR_list_info.txt). - Po uruchomieniu skryptu sprawdź plik dziennika. Jeśli w pliku dziennika pojawi się jakikolwiek komunikat o błędzie, napraw błąd i ponownie wykonaj krok 3.3. W przypadku problemów z rozwiązaniem błędu, poproś o pomoc na stronie problemów GitHub Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Aby ułatwić ćwiczenie tego rurociągu analizy CUT&RUN, z SRA pobrano następujące ogólnodostępne próbki: jedną próbkę z kontroli pozorowanej (IgG), trzy próbki białka architektury chromatyny i czynnika transkrypcyjnego (CTCF), cztery próbki odpowiadające „aktywnej” modyfikacji histonowej (H3K27Ac) oraz trzy próbki odpowiadające regionom inicjacji transkrypcji znakowanym przez polimerazę RNA II (RNAPII-S5P). Sekwencjonowanie wykonano w trybie paired-end, dlatego dla każdej próbki sparowane są dwa pliki.
4. Wstępna kontrola jakości surowych plików z sekwencjonowania
- Otwórz terminal i wpisz echo $SHELL , aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy zobaczą w terminalu następujący komunikat: /path/to/bash (lub podobny, np. /bin/bash).
- Jeśli domyślna powłoka nie jest Bashem, ustaw powłokę Bash jako domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh lub przeciągnij skrypt powłoki do terminala i zatwierdź klawiszem enter.
UWAGA: Ten skrypt powłoki: (i) uruchomi program FastQC dla wszystkich surowych plików fastq w folderze ~/Desktop/GSE126612/fastq i zapisze raporty kontroli jakości w folderze ~/Desktop/GSE126612/fastqc.1st . (ii) utworzy plik dziennika (fastqc.1st.log.SRR-number.txt) dla każdego uruchomienia FastQC w folderze z logami (~/Desktop/GSE126612/log/fastqc.1st). - Po zakończeniu działania skryptu powłoki przejrzyj plik dziennika, aby potwierdzić pomyślne wykonanie procesu. Jeśli w pliku dziennika pojawi się jakikolwiek komunikat o błędzie, napraw błąd i powtórz krok 4.3. W przypadku problemów z rozwiązaniem błędu poproś o pomoc za pomocą strony problemów (issues) projektu Easy Shells CUTnRUN w serwisie GitHub (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Wśród plików wynikowych pliki fastqc.html zawierają przejrzyste wyniki kontroli jakości. W przypadku wystąpienia poważnych problemów z jakością skonsultuj się z bioinformatykami, aby określić przydatność danych do dalszych analiz. Podobne raporty kontroli jakości są wykorzystywane do potwierdzenia poprawy jakości danych po przycinaniu adapterów. Aby użyć tego skryptu dla innych zestawów danych, edytuj ścieżki katalogów roboczych i wyjściowych zgodnie z potrzebami użytkownika. Istotną różnicą przy interpretacji QC odczytów CUT&RUN w porównaniu do ChIP-seq jest to, że zduplikowane odczyty w CUT&RUN niekoniecznie wskazują na duplikaty PCR. Wynika to z faktu, że zrekrutowana nukleaza MNase trawi DNA w tych samych lub podobnych miejscach w grupach eksperymentalnych.
5. Kontrola jakości i przycinanie adapterów dla surowych plików z sekwencjonowania
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy mogą zobaczyć następujący komunikat: /path/to/bash (lub podobną informację, np. /bin/bash) w terminalu.
- Jeśli domyślną powłoką nie jest Bash, ustaw powłokę Bash jako domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh w terminalu lub przeciągnij skrypt Script_04_trimming.sh do terminala i zatwierdź klawiszem Enter.
UWAGA: Ten skrypt powłoki będzie: (i) uruchamiać program Trim-Galore dla wszystkich surowych plików fastq w ~/Desktop/GSE126612/fastq, aby przeprowadzić przycinanie adapterów i kontrolę jakości. (ii) tworzyć jeden folder (~/Desktop/GSE126612/trimmed) i zapisywać w nim pliki wyjściowe programu Trim-Galore. (iii) tworzyć jeden folder na logi (~/Desktop/GSE126612/log/trim_galore) i zapisywać plik logu trim_galore_log_RSS-number.txt dla każdego uruchomienia programu Trim-Galore. - Po zakończeniu procesu dokładnie przejrzyj plik logu. Jeśli w pliku logu pojawi się jakikolwiek komunikat o błędzie, napraw błąd i powtórz krok 5.3. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc za pośrednictwem strony z problemami (issues) projektu Easy Shells CUTnRUN na GitHubie (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
- Po zakończeniu tego procesu porównaj wyjściowe pliki .html z plikami fastqc.html utworzonymi w kroku 4.3. Zmień ścieżki katalogów wejściowych i wyjściowych, aby przeprowadzić krok przycinania dla plików fastq znajdujących się w innych lokalizacjach.
6. Pobieranie indeksu bowtie2 dla genomów referencyjnych dla próbek rzeczywistych i kontroli spike-in
- Otwórz terminal i wpisz echo $SHELL , aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy mogą zobaczyć w terminalu następujący komunikat: /path/to/bash (lub podobny, np. /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako domyślną powłokę, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh lub przeciągnij skrypt powłoki do terminala i zatwierdź klawiszem enter.
UWAGA: Ten skrypt spowoduje: (i) pobranie indeksów Bowtie2 dla rzeczywistych genomów referencyjnych próbek (człowiek; hg19; użyty w oryginalnej publikacji22) oraz genomów referencyjnych kontroli Spike-in (drożdże pączkujące; R64-1-1) do folderu bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) zapisanie pliku dziennika (bowtie2-index-log.txt) w katalogu logów (~/Desktop/GSE126612/log/bowtie2-index). - Po zakończeniu uruchamiania sprawdź plik dziennika. W przypadku wystąpienia jakiegokolwiek komunikatu o błędzie, napraw błąd i powtórz krok 6.3. Jeśli pojawi się problem z rozwiązaniem kwestii, poproś o pomoc za pośrednictwem strony problemów GitHub dla Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Obecnie indeksy Bowtie2 dla różnych genomów referencyjnych są dostępne na stronie Bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Użytkownicy mogą edytować Script_05_bowtie2-index.sh, aby pobrać dowolny indeks Bowtie2 zgodnie z ich wymaganiami. Jeśli użytkownik nie może zlokalizować indeksu Bowtie2 dla interesującego go genomu referencyjnego, należy odnaleźć pliki fasta sekwencji genomu referencyjnego w:- FTP Ensembl (https://ftp.ensembl.org/pub/current_fasta/)
- na stronie internetowej UCSC (https://hgdownload.soe.ucsc.edu/downloads.html)
- lub w innych bazach danych specyficznych dla danego gatunku.
Po zlokalizowaniu plików fasta sekwencji genomu referencyjnego, utwórz indeks Bowtie2 dla pobranego genomu referencyjnego, postępując zgodnie z sekcją "The bowtie2-build indexer" (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) na stronie internetowej Bowtie2.
7. Mapowanie przyciętych odczytów sekwencjonowania CUT&RUN do genomów referencyjnych
- Otwórz terminal i wpisz echo $SHELL , aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w aktualnym terminalu jest Bash, użytkownicy zobaczą w terminalu następujący komunikat: /path/to/bash (lub podobny, np. /bin/bash).
- Jeśli domyślna powłoka to nie Bash, ustaw powłokę Bash jako domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh lub przeciągnij plik skryptu powłoki do terminala i zatwierdź klawiszem enter.
UWAGA: Ten skrypt powłoki wykona następujące czynności: (i) uruchomi program bowtie2 w celu niezależnego zmapowania wszystkich przyciętych pod kątem adapterów i jakości plików fastq na genomy referencyjne zarówno eksperymentalne (ludzki; hg19), jak i kontrolne spike-in (drożdże pączkowe; R64-1-1). (ii) uruchomi funkcję samtools view, aby skompresować pliki zmapowanych par odczytów do formatu bam. (iii) utworzy folder (~/Desktop/GSE126612/bowtie2-mapped) i zapisze w nim skompresowane pliki zmapowanych par odczytów. (iv) utworzy folder (~/Desktop/GSE126612/log/bowtie2-mapped) i zapisze logi procesu mapowania w formie plików tekstowych bowtie2_log_hg19_SRR-number.txt dla par odczytów zmapowanych na genom referencyjny hg19 oraz bowtie2_log_R64-1-1_SRR-number.txt dla par odczytów zmapowanych na R64-1-1, aby wskazać wydajność mapowania w folderze logów bowtie2-mapping. - Po zakończeniu uruchamiania sprawdź plik logu. Jeśli w pliku logu pojawi się jakikolwiek komunikat o błędzie, popraw błąd i uruchom skrypt powłoki ponownie. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc, korzystając ze strony zgłoszeń GitHub Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Ten skrypt powłoki uruchamia bowtie2 z opcjami mapowania plików sekwencjonowania paired-end w celu znalezienia zgodnych zmapowanych par odczytów o długości fragmentów od 10 bp do 700 bp. Opisy opcji można znaleźć, wpisując bowtie2 --help w terminalu lub odwiedzając stronę internetową bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner), aby zrozumieć i w razie potrzeby zmienić opcje. Użyj tego skryptu do mapowania innych plików fastq, zmieniając ścieżkę i format nazwy plików fastq oraz indeksów Bowtie2.
8. Sortowanie i filtrowanie plików z zmapowanymi parami odczytów
- Otwórz terminal i wpisz echo $SHELL , aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w obecnym terminalu jest Bash, użytkownicy zobaczą w terminalu następującą treść: /path/to/bash (lub podobny komunikat, np. /bin/bash).
- Jeśli domyślna powłoka nie jest Bashem, ustaw powłokę Bash jako domyślną, wpisując w terminalu „chsh -s $(which bash)”. Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt wykona następujące czynności: (i) Uruchomi funkcję samtools view dla wszystkich skompresowanych plików z mapowanymi parami odczytów w folderze ~/Desktop/GSE126612/bowtie2-mapped, aby odfiltrować pary odczytów zmapowane do niekanonicznych regionów chromosomowych, publicznie adnotowanych regionów czarnej listy (blacklist) oraz regionów powtórzeń TA. (ii) Wykona funkcję samtools sort, aby posortować odfiltrowane pliki bam według nazw fragmentów lub współrzędnych w tym samym katalogu. (iii) Utworzy plik dziennika (log) dla każdego wejściowego pliku bam w katalogu ~/Desktop/GSE126612/log/filter-sort-bam. - Po zakończeniu uruchamiania dokładnie przejrzyj pliki dziennika. Jeśli w plikach dziennika pojawi się jakikolwiek komunikat o błędzie, napraw go i spróbuj ponownie uruchomić skrypt powłoki. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc za pomocą strony z problemami (issues) projektu Easy Shells CUTnRUN w serwisie GitHub (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Wynikowe pliki bam (wyjściowe) posortowane według nazw fragmentów będą służyć jako pliki wejściowe do utworzenia plików fragment BED oraz raw readcounts bedGraph. Pliki bam posortowane według współrzędnych będą służyć jako pliki wejściowe do generowania plików fragment BEDPE. Wszystkie pliki BED, bedGraph i BEDPE zostaną wykorzystane do wyznaczania pików (peak calling) i wizualizacji w analizie downstream. Wszystkie pliki adnotacji BED dla kanonicznych regionów chromosomowych (chr1~22, chrX, chrY oraz chrM), publicznie adnotowanych regionów czarnej listy23 oraz regionów powtórzeń TA18 znajdują się w katalogu ~/Desktop/Easy-Shells_CUTnRUN/blacklist. W razie potrzeby użyj tego katalogu, aby dodać dodatkowe pliki czarnej listy. Użyj tego skryptu powłoki do wykonania tych samych funkcji dla innych plików bam z zmapowanymi parami odczytów, zmieniając ścieżkę i nazwy plików bam. Wpisz w terminalu samtools view --help oraz samtools sort --help, aby uzyskać więcej informacji na temat tych funkcji.
9. Konwersja zmapowanych par odczytów do plików fragment BEDPE, BED oraz plików bedGraph z surową liczbą odczytów
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy powinni zobaczyć w terminalu następującą informację: /path/to/bash (lub podobny komunikat, np. /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij Enter.
UWAGA: Ten skrypt wykona następujące czynności: (i) uruchomi funkcje macs3 filterdup oraz awk, aby przekonwertować pliki bam posortowane według współrzędnych na pliki BEDPE fragmentów, których długość jest krótsza niż 1kb, a następnie zapisze pliki BEDPE w katalogu ~/Desktop/GSE126612/BEDPE. (ii) utworzy katalog logów (~/Desktop/GSE126612/log/bam-to-BEDPE) i zapisze plik logu dla każdego pliku fragmentów zmapowanych odczytów. (iii) uruchomi funkcje bedtools bamtobed oraz awk, cut, sort, aby przekonwertować pliki bam posortowane według nazw fragmentów na pliki BED fragmentów, których długość jest krótsza niż 1 kb. (iv) utworzy jeden folder (~/Desktop/GSE126612/bam-to-bed) i zapisze w nim pliki BED fragmentów. (v) zapisze plik logu dla każdego pliku BED fragmentów zmapowanych odczytów w katalogu logów (~/Desktop/GSE126612/log/bam-to-bed). (vi) wykona funkcję bedtools genomecov w celu wygenerowania surowych plików bedGraph z liczbą odczytów, wykorzystując pliki BED fragmentów, a wyniki zapisze w jednym folderze (~/Desktop/GSE126612/bedGraph). - Po zakończeniu uruchamiania dokładnie sprawdź pliki logów. W przypadku wystąpienia problemów z ich rozwiązaniem poproś o pomoc za pośrednictwem strony zgłoszeń GitHub Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Wyjściowe surowe pliki bedGraph z liczbą odczytów zostaną użyte jako pliki wejściowe dla programu peak caller SEACR z opcją normalizacji w sekcji 12 oraz normalizacją skalowanego ułamkowego odczytu (SFRC)22 w sekcji 10. Pliki BED fragmentów posłużą jako pliki wejściowe dla normalizacji Reads Per Million mapped reads in the negative Control (SRPMC) z wykorzystaniem Spike-in24,25 w sekcji 10. Aby przechwycić tylko krótkie fragmenty (>100 bp) dla danych CUT&RUN czynników związanych z chromatyną, należy zmienić krok filtrowania fragmentów w tym skrypcie, a następnie przejść do kroku normalizacji. Aby porównać sygnały CUT&RUN pomiędzy fragmentami krótkimi i o regularnej wielkości w obrębie tej samej próbki, normalizacja SFRC może być pomocna w celu zmniejszenia potencjalnego efektu down-samplingu spowodowanego przechwytywaniem wyłącznie krótkich fragmentów. Użyj tego skryptu powłoki, aby przeprowadzić analogiczne procesy dla innych posortowanych plików bam z sekwencjonowaniem paired-end, zmieniając ścieżkę i format nazw plików bam oraz bed.
10. Konwersja plików bedGraph z surowymi liczbami odczytów do znormalizowanych plików bedGraph i bigWig
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w aktualnym terminalu jest Bash, użytkownicy mogą zobaczyć w terminalu następującą informację: /path/to/bash (lub podobny komunikat, np. /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa już powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt został napisany w celu: (i) uruchomienia pętli for z funkcją awk w celu utworzenia plików bedGraph znormalizowanych metodą SFRC, wykorzystując surowe pliki bedGraph z liczbą odczytów znajdujące się w ~/Desktop/GSE126612/bedGraph. (ii) wykonania funkcji bedGraphToBigWig w celu utworzenia skompresowanego formatu (.bw) znormalizowanych plików bedGraph SFRC w ~/Desktop/GSE126612/bigWig. (iii) zapisania pliku dziennika rejestrującego czynnik normalizacji użyty do obliczeń SFRC dla każdego uruchomienia i zapisania pliku dziennika w ~/Desktop/GSE126612/log/SFRC. - Po zakończeniu uruchomienia sprawdź pliki dziennika. Jeśli pojawi się jakikolwiek komunikat o błędzie, popraw błąd i ponownie uruchom skrypt powłoki. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc za pomocą strony problemów (issues) projektu Easy Shells CUTnRUN na GitHubie (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Normalizacja skalowanej ułamkowej liczby odczytów (scaled fractional readcount normalization) została zastosowana w oryginalnej publikacji22 zbioru danych CUT&RUN GSE126612. Wzór normalizacji dla bin i jest następujący:
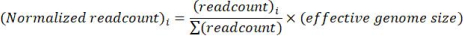
Ponieważ ta metoda normalizacji nie obejmuje normalizacji z kontrolą negatywną (na przykład próbką IgG) ani kontrolą spike-in, podejście to może nie być idealne do obserwacji różnic w sygnale w całym genomie między próbkami. Jednakże, ponieważ metoda ta jest teoretycznie podobna do innych normalizacji opartych na całkowitej liczbie odczytów (na przykład Count Per Million), powinna być wystarczająca do obserwacji lokalnych różnic w sygnale między próbkami. - Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt będzie: (i) uruchamiać pętlę for z funkcją bedtools genomecov w celu utworzenia plików bedgraph znormalizowanych metodą SRPMC w ~/Desktop/GSE126612/bedGraph, wykorzystując pliki fragment BED w ~/Desktop/GSE126612/bam-to-bed. (ii) zapisywać plik dziennika rejestrujący czynniki normalizacji użyte do normalizacji SRPMC dla każdego uruchomienia w ~/Desktop/GSE126612/log/SRPMC. (iii) wykonywać funkcję bedGraphToBigWig w celu utworzenia skompresowanego formatu (.bw) znormalizowanych plików bedGraph i zapisywania znormalizowanych plików bigWig w folderze ~/Desktop/GSE126612/bigWig. - Po zakończeniu uruchomienia dokładnie przejrzyj pliki dziennika. Jeśli w plikach dziennika znajduje się jakikolwiek komunikat o błędzie, popraw błąd i ponownie uruchom skrypt powłoki. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc za pomocą strony problemów (issues) projektu Easy Shells CUTnRUN na GitHubie (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Wzór normalizacji SRPMC został opracowany w celu normalizacji rzeczywistej liczby odczytów próbek zarówno z kontrolą negatywną (np. próbka IgG), jak i kontrolą spike-in, poprzez połączenie czynnika normalizacji RPM (Reads Per Million mapped reads), RPS (stosunek odczytów do odczytów spike-in) oraz względnego stosunku sygnału do kontroli24,25. Definicja RPS jest następująca:

Poprzez zastosowanie RPS zarówno dla rzeczywistej próbki, jak i próbki kontrolnej negatywnej, względny stosunek sygnału (RS) do kontroli dla rzeczywistej próbki można obliczyć następująco:
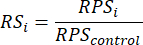
A definicja czynnika normalizacji RPM (RPM:NF) jest następująca:
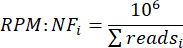
Na tej podstawie czynnik normalizacji SRPMC (SRPMC:NF) został uzyskany poprzez połączenie RS i RPM:NF:
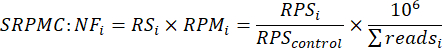
Wzór ten można uprościć do postaci:

Zatem metoda SRPMC normalizuje odczyty na podstawie (1) stosunku odczytów spike-in między kontrolą a próbką oraz (2) odczytów kontrolnych znormalizowanych RPM. Ponieważ czynnik normalizacji ten uwzględnia odczyty spike-in i sprawia, że odczyty kontrolne są porównywalne między próbkami, metoda ta byłaby odpowiednia do obserwacji różnic w całym genomie między próbkami i redukcji efektu serii (batch effect) w całkowitej liczbie odczytów rzeczywistych próbek i kontroli w różnych seriach eksperymentów. Znormalizowane pliki bedGraph staną się plikami wejściowymi do wywoływania piki za pomocą SEACR w sekcji 11. A te znormalizowane pliki bigWig będą wykorzystane w wizualizacji loci poprzez IGV oraz w tworzeniu map ciepła (heatmap) i wykresów średnich za pomocą Deeptools. Zdecydowanie sugeruje się użycie przeglądarki genomu do wizualizacji wzorca krajobrazu zbioru danych CUT&RUN przy użyciu znormalizowanych plików bigWig w reprezentatywnych regionach genomowych w celu oceny jakości danych. Próbki CUT&RUN wykazujące szumne wzorce sygnału tła przypominające kontrolę IgG powinny zostać prawdopodobnie pominięte w dalszych analizach. Użyj tych skryptów powłoki do normalizacji innych plików bed z odczytami i surowych plików bedGraph z liczbą odczytów, zmieniając ścieżki i nazwy plików dla plików bed i bedgraph wejściowych oraz wyjściowych. Edytuj te skrypty, aby zastosować inne obliczenia normalizacji, zmieniając czynniki i wzory wewnątrz skryptu.
11. Walidacja rozkładu wielkości fragmentów
- Otwórz terminal i wpisz echo $SHELL , aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką jest Bash, w terminalu pojawi się następujący komunikat: /path/to/bash (lub podobny, np. /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw ją jako domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal domyślnie używa powłoki Bash, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij Enter.
UWAGA: Skrypt ten został napisany w celu: (i) uruchomienia funkcji picard.jar CollectInsertSizeMetrics przy użyciu plików BAM z zmapowanymi parami odczytów znajdujących się w folderze ~/Desktop/GSE126612/filtered-bam, aby określić rozkład wielkości wstawek. (ii) utworzenia jednego folderu (~/Desktop/GSE126612/insert-size-distribution) i zapisania w nim wyników analizy rozkładu wielkości wstawek. (iii) wygenerowania pliku dziennika dla każdego wejściowego pliku BAM w folderze ~/Desktop/GSE126612/log/insert-size-distribution . - Po zakończeniu uruchamiania dokładnie sprawdź pliki dziennika. Jeśli w plikach dziennika pojawi się jakikolwiek komunikat o błędzie, popraw go i spróbuj ponownie uruchomić skrypt powłoki. W przypadku problemów z rozwiązaniem błędu poproś o pomoc za pośrednictwem strony zgłoszeń GitHub projektu Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Zazwyczaj analiza wielkości wstawek (wynik) dla próbek CUT&RUN wykazuje główne piki w zakresach wielkości mononukleosomowych (100-300 bp) i dinukleosomowych (300-500 bp). Błędy techniczne/ograniczenia (takie jak nadmierna lub niewystarczająca trawienie przez MNazę podczas przygotowania próbek CUT&RUN lub niewłaściwa selekcja wielkości podczas przygotowania biblioteki) mogą powodować wzbogacenie fragmentów o wielkości równej lub większej niż trinukleosomowe (500-700 bp) oraz równej lub mniejszej niż subnukleosomowe (<100 bp). Czasami brak pików o wielkości mononukleosomowej przy jednoczesnym wzbogaceniu fragmentów długich (>500 bp) i krótkich (<100 bp) może wynikać z zakresów selekcji wielkości biblioteki wybranych na etapie pracy w laboratorium mokrym lub niskiej głębokości sekwencjonowania. Aby ocenić jakość przetworzonych próbek CUT&RUN, porównaj ze sobą głębokość sekwencjonowania („total sequenced bases” / „total reference genome size”), ogólny obraz genomowy z wykorzystaniem znormalizowanych plików bigWig z liczbą odczytów z sekcji 10 oraz wzorzec rozkładu wielkości wstawek. Linie przerywane na histogramach reprezentują „cumulative fraction” odczytów o wielkości wstawki większej lub równej wartości na osi x. Linia przerywana ta umożliwia identyfikację rozkładu wielkości wstawek w wejściowym pliku zmapowanych odczytów. Postęp wzdłuż osi x wiąże się ze zwiększającą się wielkością wstawki. Linia przerywana wskazuje proporcję zmapowanych par odczytów w wejściowym pliku BAM, które mają wielkość wstawki co najmniej tak dużą, jak wskazano w przecinającym punkcie osi x. Zatem interpretacja zaczyna się od 1 po lewej stronie, co oznacza, że wszystkie odczyty mają wielkość wstawki większą lub równą najmniejszemu rozmiarowi, i maleje w stronę 0 wraz ze wzrostem wielkości wstawki.
12. Wyznaczanie szczytów (peak calling) przy użyciu programów MACS2, MACS3 i SEACR
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w aktualnym terminalu jest Bash, użytkownicy mogą zobaczyć w terminalu następującą ścieżkę: /path/to/bash (lub podobny komunikat, np. /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt został napisany w celu: (i) uruchomienia funkcji macs2 callpeak oraz macs3 callpeak z kontrolą IgG i bez niej, wykorzystując pliki BEDPE fragmentów do wyznaczania pików (peak calling) oraz zapisania wyników wyznaczania pików w katalogach wyjściowych (~/Desktop/GSE126612/MACS2 oraz ~/Desktop/GSE126612/MACS3). (ii) zapisania logów tych procesów wyznaczania pików w formie plików tekstowych w katalogu logów (~/Desktop/GSE126612/log/MACS2 oraz ~/Desktop/GSE126612/log/MACS3) - Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt został napisany w celu: (i) uruchomienia skryptu SEACR_1.3.sh z kontrolą IgG i bez niej, z opcjami rygorystyczną (stringent) i łagodną (relaxed), wykorzystując pliki bedGraph z surową liczbą odczytów (raw readcounts) oraz znormalizowane pliki bedGraph do wyznaczania pików. (ii) utworzenia katalogu wyjściowego (~/Desktop/GSE126612/SEACR-peaks) i zapisania wyników wyznaczania pików przez SEACR. (iii) zapisania logów tych procesów wyznaczania pików w formie plików tekstowych w katalogu logów (~/Desktop/GSE126612/log/SEACR). - Po zakończeniu uruchamiania skryptów powłoki dokładnie sprawdź pliki logów. Jeśli w plikach logów pojawi się jakikolwiek komunikat o błędzie, najpierw napraw błąd. Niektóre programy mogą nie wyznaczać pików dla próbki kontrolnej IgG przy jednoczesnym zastosowaniu opcji kontroli IgG, dlatego należy zignorować komunikaty o błędach dotyczące próbki kontrolnej IgG z włączoną opcją kontroli IgG. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc za pośrednictwem strony z problemami (issues) projektu Easy Shells CUTnRUN na GitHubie (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Te dwa skrypty powłoki wykonują wyznaczanie pików dla próbek CUT&RUN przy użyciu trzech programów (MACS2, MACS3 i SEACR) z różnymi opcjami: z opcją kontroli IgG lub bez niej, przy użyciu plików bedGraph z surową liczbą odczytów z opcją normalizacji programu do wyznaczania pików lub znormalizowanych plików bedGraph bez opcji normalizacji, a także z rygorystycznymi i łagodnymi opcjami wyznaczania pików w SEACR. Ponieważ pliki wyjściowe z wyznaczania pików nie nadają się do bezpośredniego użycia w analizach downstream, Easy Shells CUTnRUN zawiera jeden skrypt do przetwarzania tych plików wyjściowych w celu utworzenia nowych plików pików, które zawierają chromosom, początek, koniec i nazwę pików. Dzięki zastosowaniu intensywnych podejść do wyznaczania pików, Easy Shells CUTnRUN daje możliwość wyboru programu najlepiej dopasowanego do projektu CUT&RUN użytkownika poprzez porównanie pików wyznaczonych przez trzy różne programy. Dodatkowo, ten rurociąg analityczny CUT&RUN umożliwia wybór opcji wyznaczania pików najlepiej dopasowanych do projektu CUT&RUN użytkownika. Porównania te zostaną przeprowadzone za pomocą diagramów Venna oraz wizualizacji w postaci map ciepła (heatmap) i wykresów średnich.
13. Tworzenie plików BED dla zidentyfikowanych pików
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy mogą zobaczyć w terminalu następującą informację: /path/to/bash (lub podobny komunikat, taki jak /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt służy do: (i) uruchomienia funkcji awk z wykorzystaniem plików bed w folderze ~/Desktop/GSE126612/SEACR w celu utworzenia dwóch typów plików bed dla pików SEACR w folderze ~/Desktop/GSE126612/peak-bed_SEACR. Pełne pliki bed dla pików zawierają początek i koniec każdego piku, a skoncentrowane pliki bed dla pików zawierają początek i koniec bin z najwyższym sygnałem w obrębie każdego piku. (ii) uruchomienia funkcji awk z wykorzystaniem plików ***_peaks.xls w folderach ~/Desktop/GSE126612/MACS2 oraz ~/Desktop/GSE126612/MACS3 w celu utworzenia pełnych plików bed dla pików, które zawierają początek i koniec każdego piku wykrytego przez MACS2 i MACS3, w folderach ~/Desktop/GSE126612/peak-bed_MACS2 oraz ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) uruchomienia funkcji awk z wykorzystaniem plików ***_summits.bed w folderach ~/Desktop/GSE126612/MACS2 oraz ~/Desktop/GSE126612/MACS3 w celu utworzenia skoncentrowanych plików bed dla pików, które zawierają początek i koniec najbardziej znaczącego binu w obrębie każdego piku. (iv) pliki dziennika są zapisywane w formacie tekstowym w folderze ~/Desktop/GSE126612/log/peak-bed . - Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt służy do: (i) uruchomienia funkcji bedtools intersect z wykorzystaniem plików bed dla pików, które zostały wywołane bez opcji kontroli IgG, aby usunąć piki nakładające się na piki kontroli IgG. (ii) przefiltrowane pliki bed dla pików są zapisywane w folderach ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 oraz ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) plik dziennika log_filter-peaks.txt jest tworzony w folderze ~/Desktop/GSE126612/log/filter-peaks. - Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt służy do: (i) uruchomienia funkcji cat oraz sort w celu połączenia pełnych plików bed dla pików z powtórzeń MACS2 i MACS3 w jeden plik bed dla pików oraz posortowania połączonego pliku w folderze ~/Desktop/GSE126612/bed-for-comparison. (ii) uruchomienia funkcji bedtools merge z wykorzystaniem połączonych pełnych plików bed dla pików w celu scalenia pików, które na siebie nachodzą. (iii) plik dziennika log_cat-merged-peak-bed_MACS.txt jest zapisywany w folderze dzienników ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Wpisz ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh w terminalu lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt służy do: (i) uruchomienia funkcji cat oraz sort w celu połączenia pełnych plików bed dla pików z powtórzeń SEACR w jeden plik bed dla pików oraz posortowania połączonego pliku w folderze ~/Desktop/GSE126612/bed-for-comparison . (ii) uruchomienia funkcji bedtools merge z wykorzystaniem połączonych pełnych plików bed dla pików w celu scalenia pików, które na siebie nachodzą. (iii) plik dziennika log_cat-merged-peak-bed_SEACR.txt jest zapisywany w folderze dzienników ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Po zakończeniu uruchamiania skryptów powłoki dokładnie przejrzyj pliki dziennika. Jeśli w plikach dziennika pojawi się jakikolwiek komunikat o błędzie, napraw błąd i uruchom skrypt(y) ponownie. W przypadku problemów z rozwiązaniem kwestii, poproś o pomoc za pośrednictwem strony zgłaszania problemów projektu Easy Shells CUTnRUN na GitHubie (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Pełne pliki bed dla obszarów pików zostaną użyte jako pliki wejściowe do analizy diagramu Venna w celu porównania podobieństwa między opcjami wykrywania pików, metodami wykrywania pików, powtórzeniami oraz obserwacjami krajobrazu genomicznego w pobliżu obszarów pików. Scalone pełne pliki bed dla obszarów pików zostaną wykorzystane do analizy głównych składowych (PC) i analizy korelacji współczynnika Pearsona przy użyciu deeptools. Skoncentrowane pliki bed dla pików zostaną wykorzystane do analizy map ciepła (heatmap) i wykresów średnich przy użyciu Deeptools.
14. Walidacja podobieństwa między powtórzeniami z wykorzystaniem korelacji Pearsona i analizy głównych składowych (PC).
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, użytkownicy mogą zobaczyć w terminalu komunikat: /path/to/bash (lub podobny, np. /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal korzysta już z powłoki Bash jako domyślnej, pomiń ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh lub przeciągnij plik skryptu powłoki do terminala i zatwierdź klawiszem enter.
UWAGA: Skrypt ten został napisany w celu: (i) uruchomienia funkcji multiBamSummary BED-file z wykorzystaniem plików bam z powtórzeń, które zostały posortowane według współrzędnych, oraz połączonych plików bed wszystkich szczytów dla CTCF, H3K27Ac i RNAPII-S5P, aby wygenerować pliki macierzy do analizy korelacji Pearsona w folderze Desktop/GSE126612/deeptools_multiBamSummary. (ii) uruchomienia funkcji plotCorrelation z wykorzystaniem plików macierzy w celu obliczenia współczynnika korelacji Pearsona i przeprowadzenia klastrowania na mapie ciepła (heatmap), a następnie zapisania wyniku w folderze ~/Desktop/GSE126612/deeptools_plotCorrelation. (iii) zapisania pliku dziennika log_plotCorrelation.txt w folderze ~/Desktop/GSE126612/log/correlation. - Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh lub przeciągnij plik skryptu powłoki do terminala i zatwierdź klawiszem enter.
UWAGA: Skrypt ten został napisany w celu: (i) uruchomienia funkcji multiBamSummary BED-file z wykorzystaniem plików bam, które zostały posortowane według współrzędnych, oraz połączonych plików bed wszystkich szczytów, obejmujących wszystkie szczyty CTCF, H3K27ac i RNAPII-S5P, aby wygenerować pliki macierzy do analizy głównych składowych (PCA) w folderze Desktop/GSE126612/deeptools_multiBamSummary. (ii) uruchomienia funkcji plotPCA z wykorzystaniem plików macierzy w celu przeprowadzenia PCA i zapisania wyniku w folderze ~/Desktop/GSE126612/deeptools_plotPCA. (iii) zapisania pliku dziennika log_plotPCA.txt w folderze ~/Desktop/GSE126612/log/correlation. - Po zakończeniu działania skryptów powłoki sprawdź pliki dziennika. W przypadku wystąpienia jakiegokolwiek komunikatu o błędzie, popraw błąd i uruchom skrypty powłoki ponownie. Jeśli pojawią się problemy z rozwiązaniem problemu, poproś o pomoc za pośrednictwem strony z problemami (issues) w serwisie github dla Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Co do zasady, prawidłowo przygotowane i przetworzone powtórzenia wykazują wyższe wartości współczynnika korelacji Pearsona w obrębie tej samej grupy klastrowania oraz bliskie rozmieszczenie w analizie głównych składowych. Każde powtórzenie, które wykazuje niższy współczynnik korelacji Pearsona i dużą odległość od innych powtórzeń na wykresie głównych składowych, może reprezentować potencjalną wartość odstającą wśród powtórzeń. Ten skrypt powłoki jest odpowiedni dla wszelkich danych z odczytami zmapowanymi w formacie bam. Zmień ścieżkę i nazwę plików bigwig, aby spełnić specyficzne wymagania projektu.
15. Walidacja podobieństwa między powtórzeniami, metodami i opcjami wyznaczania pików za pomocą diagramu Venna
- Otwórz terminal i wpisz echo $SHELL, aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, w terminalu pojawi się ścieżka taka jak /path/to/bash (na przykład /bin/bash).
- Jeśli domyślna powłoka to nie Bash, ustaw powłokę Bash jako domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal używa powłoki Bash jako domyślnej, pomiń ten krok
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt został napisany, aby: (i) uruchomić funkcję intervene venn przy użyciu plików bed z całymi regionami peaków, aby znaleźć nakładanie się peaków wywołanych przez różne opcje (z opcją kontroli IgG lub bez niej, z normalizacją lub bez niej oraz przy rygorystycznych lub łagodnych opcjach wywołania peaków dla SEACR). (ii) utworzyć jeden folder (~/Desktop/GSE126612/intervene_methods) i zapisać w nim wyniki analizy diagramu Venna. (iii) utworzyć plik logu log_intervene_methods.txt w folderze ~/Desktop/GSE126612/log/intervene. - Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Ten skrypt został napisany, aby: (i) uruchomić funkcję intervene venn przy użyciu plików bed z całymi regionami peaków, aby znaleźć nakładanie się peaków pomiędzy replikatami. (ii) utworzyć jeden folder (~/Desktop/GSE126612/intervene_replicates) i zapisać w nim wyniki analizy diagramu Venna. (iii) utworzyć plik logu log_intervene_replicates.txt w folderze ~/Desktop/GSE126612/log/intervene. - Po zakończeniu uruchamiania skryptów powłoki przejrzyj pliki logów. W przypadku wystąpienia jakiegokolwiek komunikatu o błędzie, napraw błąd i ponownie uruchom skrypty powłoki. W przypadku jakichkolwiek problemów z użyciem potoku analizy Easy Shells CUTnRUN, poproś o pomoc na stronie problemów GitHub Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: Wyniki analizy diagramu Venna pozwalają dobrać najodpowiedniejsze opcje wywoływania peaków, metody oraz replikaty o wysokiej powtarzalności do dalszych analiz. Zaleca się wybór opcji i metod wywoływania peaków, które wykazują najwyższą liczbę wykrytych peaków przy dobrym nakładaniu się z innymi metodami i opcjami wywoływania peaków.
16. Analiza map ciepła i wykresów średnich w celu wizualizacji zidentyfikowanych pików.
- Otwórz terminal i wpisz echo $SHELL , aby sprawdzić domyślną powłokę w aktywnym terminalu. Jeśli domyślną powłoką w bieżącym terminalu jest Bash, w terminalu pojawi się ścieżka taka jak /path/to/bash (na przykład /bin/bash).
- Jeśli domyślna powłoka nie jest powłoką Bash, ustaw Bash jako powłokę domyślną, wpisując w terminalu chsh -s $(which bash). Jeśli terminal korzysta z powłoki Bash jako domyślnej, można pominąć ten krok.
- Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
UWAGA: Skrypt ten służy do: (i) uruchomienia funkcji computeMatrix reference-point z wykorzystaniem znormalizowanych plików bigWig oraz plików bed dla wybranych szczytów (focused peaks), aby utworzyć znormalizowane macierze liczby odczytów w centrum wybranych szczytów w folderze ~/Desktop/GSE126612/deeptools_computeMatrix. (ii) uruchomienia funkcji plotHeatmap z wykorzystaniem znormalizowanej macierzy liczby odczytów w celu wygenerowania map ciepła i wykresów średnich, które wizualizują wzorzec rozkładu znormalizowanej liczby odczytów w lokalizacjach wybranych szczytów. (iii) utworzenia jednego folderu (~/Desktop/GSE126612/deeptools_plotHeatmap) i zapisania w nim plików wyjściowych funkcji plotHeatmap. (iv) zapisania jednego pliku dziennika log_plotHeatmap_focused.txt w folderze ~/Desktop/GSE126612/log/plotHeatmap. - Wpisz w terminalu ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh lub przeciągnij plik skryptu powłoki do terminala i naciśnij enter.
Skrypt ten służy do: (i) uruchomienia funkcji computeMatrix reference-point z wykorzystaniem znormalizowanych plików bigWig oraz plików bed dla wszystkich szczytów (whole peaks), aby utworzyć znormalizowane macierze liczby odczytów w centrum wszystkich szczytów w folderze ~/Desktop/GSE126612/deeptools_computeMatrix. (ii) uruchomienia funkcji plotHeatmap z wykorzystaniem znormalizowanej macierzy liczby odczytów w celu wygenerowania map ciepła i wykresów średnich, które wizualizują wzorzec rozkładu znormalizowanej liczby odczytów w lokalizacjach wszystkich szczytów. (iii) utworzenia jednego folderu (~/Desktop/GSE126612/deeptools_plotHeatmap) i zapisania w nim plików wyjściowych funkcji plotHeatmap. (iv) zapisania jednego pliku dziennika log_plotHeatmap_whole.txt w folderze ~/Desktop/GSE126612/log/plotHeatmap. - Po zakończeniu działania skryptów powłoki przejrzyj pliki dziennika. W przypadku wystąpienia jakiegokolwiek komunikatu o błędzie, napraw go i ponownie uruchom skrypty. W razie problemów z korzystaniem z potoku analizy Easy Shells CUTnRUN, poproś o pomoc na stronie zgłaszania błędów projektu Easy Shells CUTnRUN w serwisie GitHub (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
UWAGA: W idealnych warunkach lokalizacje wierzchołków szczytów MACS2/3 oraz lokalizacje wybranych szczytów SEACR wykazują ostry i skoncentrowany rozkład sygnału w centrum wykresów. Jeśli jednak algorytm wyznaczania szczytów nie działa prawidłowo dla danych CUT&RUN, na wykresach może pojawić się mniej skoncentrowany, „zaszumiony” rozkład sygnału. Zatem liczba wyznaczonych szczytów oraz wzorce rozkładu sygnału szczytów na wykresach wyjściowych będą pomocne przy ocenie poprawności szczytów do dalszej analizy CUT&RUN, obejmującej m.in. adnotację szczytów.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Kontrola jakości i przycinanie adapterów pozwala na zachowanie odczytów o wysokiej jakości sekwencjonowania
Techniki sekwencjonowania wysokoprzepustowego są podatne na powstawanie błędów sekwencjonowania, takich jak „mutacje” sekwencji w odczytach. Ponadto w zbiorach danych sekwencyjnych mogą występować wzbogacone dimery adapterów sekwencjonujących z powodu niewystarczającego usunięcia adapterów podczas przygotowywania biblioteki. Nadmierne błędy sekwencjonowania, takie jak mutacje odczytów, genero...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Zdolność do mapowania zajętości białek na chromatynie ma fundamentalne znaczenie dla prowadzenia badań mechanistycznych w dziedzinie biologii chromatyny. W miarę jak laboratoria przyjmują nowe techniki mokrego laboratorium do profilowania chromatyny, możliwość analizowania danych sekwencjonowania z tych eksperymentów w mokrych laboratoriach staje się częstym wąskim gardłem dla naukowców pracujących w mokrych laboratoriach. W związku z tym opisujemy wstępny protokół krok po kroku, aby umożliwić początkującym bioinformatyk...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują brak ujawnień.
Podziękowania
Wszystkie ilustrowane postacie zostały stworzone za pomocą BioRender.com. CAI dziękuje za wsparcie udzielone poprzez nagrodę Ovarian Cancer Research Alliance Early Career Investigator Award, grant akceleracyjny Fundacji Forbeck oraz nagrodę Minnestoa Ovarian Cancer Alliance National Early Detection Research Award.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Oprogramowanie do kompresji i konwersji readcounts bedGraph do bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ the U. of Utah | https://bedtools.readthedocs.io/en/latest/index.html | Oprogramowanie do przetwarzania plików bam/bed/bedGraph |
| bowtie2 2.5.4 | Uniwersytet | Johnsa Hopkinsahttps://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Oprogramowanie do budowy indeksu muszki i wykonywania wyrównania |
| CollectInsertSizeMetrics (Picard) | Broad institute | https://github.com/broadinstitute/picard | Oprogramowanie do analizy rozkładu wielkości płytki |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Oprogramowanie do przycinania adapterów |
| Deeptoolsv3.5.1 | Instytut Maxa Plancka | https://deeptools.readthedocs.io/en/develop/index.html | Oprogramowanie do wykonywania analizy korelacji współczynników Pearsona, analizy głównych składowych oraz analizy mapy cieplnej/wykresu średniej |
| FastQC Wersja 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Oprogramowanie do sprawdzania jakości pliku fastq |
| Interwencjav0.6.1 | Biologia obliczeniowa i Regulacja genów - grupa Matheliera | https://intervene.readthedocs.io/en/latest/index.html | Oprogramowanie do wykonywania analizy diagramu Venna przy użyciu plików szczytowych |
| MACSv2.2.9.1 | Inicjatywa Chana Zuckerberga | https://github.com/macs3-project/MACS/tree/macs_v2 | Oprogramowanie do wywoływania szczytów |
| MACSv3.0.2 | Inicjatywa Chana Zuckerberga | https://github.com/macs3-project/MACS/tree/master | Oprogramowanie do wywoływania szczytów |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Oprogramowanie do przetwarzania plików sam/bam |
| SEACRv1.3 | Howard Hughes Medial institute | https://github.com/FredHutch/SEACR | Oprogramowanie do wywoływania szczytów |
| Toolkit Release 3.1.1 | NCBI | https://github.com/ncbi/-tools | Oprogramowanie do pobierania SRR z GEO |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | oprogramowanie do wykonywania wysokiej jakości i szybkiego przycinania |
Bibliografia
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
