To badanie przedstawia przestrzenny protokół Trekker–CUT&Tag multiome, łączący bezpośrednie przestrzenne kodowanie sekcji tkanki z analizą wielodostępu pojedynczych komórek. To podejście umożliwia przestrzennie rozdzielone profilowanie pojedynczych komórek ekspresji genów i modyfikacji histonu H3K27ac jednocześnie, oferując mechanizmy wglądu w regulację genów w kontekście mikroanatomii tkanki.
Artykuł metodologiczny
Przestrzennie rozdzielone, zintegrowane profilowaniu wieloomowe z pojedynczymi komórkami transkryptomu i epigenomicznych celów w zamrożonych sekcjach tkankowych
W tym artykule
Podsumowanie
Streszczenie
Technologie przestrzenne multiomiczne w połączeniu z profilowaniem pojedynczych komórek oferują bezprecedensowe możliwości wyjaśnienia molekularnej i komórkowej architektury złożonych tkanek. Połączenie przestrzennego kodowania jąder w pojedynczych krojach kryogenicznych przygotowanych z bloków tkankowych osadzanych w optymalnym medium zamrażającym (OCT) z pojedynczymi pomiarami multiomicznymi w pojedynczej komórce w prosty i wydajny przepływ pracy może ułatwić adnotacje i przestrzennie rozdzieloną analizę molekularną komórek w typach tkanek. To badanie opisuje przestrzenny podejście do rozszczepienia pod celami i tagmentacji (CUT&Tag) multiomowi, które jednocześnie opisuje modyfikację histonu H3K27ac i ekspresję genów na pojedynczej zamrożonej sekcji mózgu. Po przestrzennym kodowaniu, pojedyncze jądra są izolowany i poddany CUT&Tag, połączonemu chwytaniu tagmentowanych DNA, RNA i przestrzennych kodów kreskowych, przygotowaniu biblioteki i sekwencjonowaniu. Przepływ pracy generuje przestrzennie adnotowany profil epigenomowy i transkryptomowy z tych samych jąder, umożliwiając przypisanie informacji multiomicznych do współrzędnych anatomicznych. Integracja informacji epigenomowych z danymi przestrzennymi transkryptomowymi zwiększa wiarygodność identyfikacji typów komórek i ujawnia przestrzennie zorganizowane programy regulacyjne i interakcje międzykomórkowe w nietkniętych tkankach.
Wprowadzenie
Biologia przestrzenna to szybko rozwijająca się dziedzina, która mapuje lokalizację, organizację i oddziaływania cząsteczek, komórek i tkanek w ich naturalnym środowisku1,2,3. W przeciwieństwie do metod bulk lub konwencjonalnych metod jednokomórkowych, które wymagają dysocjacji tkanki i prowadzą do utraty informacji o położeniu, podejścia przestrzenne zachowują współrzędne fizyczne analitów lub komórek/jąder, co umożliwia bezpośrednie badanie wpływu architektury tkanki na tożsamość komórkową, komunikację międzykomórkową i funkcję biologiczną4,5,6,7. Choć transkryptomika przestrzenna i proteomika przestrzenna są obecnie najpowszechniej stosowanymi modalnościami, dziedzina ta szybko ewoluuje w kierunku przestrzennego profilowania multiomicznego3,8,9. Wspólne profilowanie ekspresji genów i stanów epigenomicznych w obrębie tej samej tkanki jest szczególnie wartościowe, ponieważ bezpośrednio łączy wynik transkrypcyjny z mechanizmami regulacyjnymi — takimi jak dostępność chromatyny i modyfikacje histonów — które sterują aktywnością genów i wykazują zmienność w zależności od domen przestrzennych10,11,12. Zatem zintegrowana analiza przestrzennego epigenomu i transkryptomu dostarczy kluczowych informacji na temat tego, w jaki sposób programy regulacyjne kształtują tożsamość komórkową i organizację tkanki.
Opracowano kilka przestrzennych strategii multiomicznych umożliwiających jednoczesne profilowanie epigenomiczne i transkrypcyjne. Metoda deterministycznego kodowania kreskowego w sekwencjonowaniu tkanek (DBiT-seq) wykorzystuje kanały mikroprzepływowe do dostarczania przestrzennych kodów kreskowych bezpośrednio lub pośrednio, poprzez stemplowanie płytkami żelowymi, do skrawków tkanki, co pozwala na przestrzenną adnotację analitów. Podejście to ułatwia przestrzennie rozdzielone współprofilowanie cech epigenomicznych i transkrypcyjnych12,13,14,15. Metoda Slide-tag, komercjalizowana jako platforma Takara Trekker, wprowadza przestrzenne kody kreskowe bezpośrednio do nienaruszonej tkanki przed dysocjacją, co pozwala na przetwarzanie przestrzennie indeksowanych jąder komórkowych przy użyciu standardowych procedur dla pojedynczych komórek i ich obliczeniowe rzutowanie z powrotem na oryginalne współrzędne tkanki16. Z kolei metoda przestrzennych analiz dostępnej chromatyny, linii komórkowych i ekspresji genów z sekwencjonowaniem (SPACE-seq) wykorzystuje strategię target-out, w której epigenetyczne cele z ogonami poly(A) oraz mRNA są wychwytywane przez sekwencję wychwytującą poly-dT w płytkach do transkryptomiki przestrzennej17.
Metoda Cleavage under targets & tagmentation (CUT&Tag) jest potężnym narzędziem do mapowania oddziaływań między DNA a białkami histonowymi lub niehistonowymi z próbek o niezwykle niskiej ilości materiału wyjściowego18. Metoda CUT&Tag opiera się na fragmentacji chromatyny i znakowaniu DNA (tagmentacji) za pośrednictwem transpozazy Tn5, wykorzystując koniugowany z białkiem A kompleks Tn5 kierowany przez przeciwciała do specyficznego cięcia loci i znakowania molekularnego. Podczas gdy konwencjonalny test CUT&Tag obejmuje wiele etapów inkubacji i płukania, w celu zwiększenia wydajności CUT&Tag w późniejszych zastosowaniach multiomiki pojedynczych komórek wykorzystano uproszczony i usprawniony schemat postępowania CUT&Tag19.
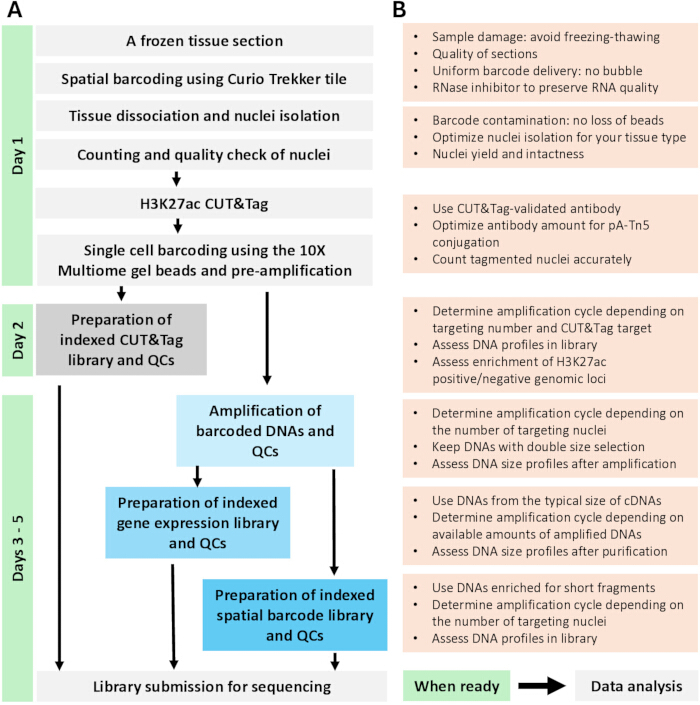
Rycina 1: Przegląd procedury i kontroli jakości w spatial Trekker–CUT&Tag multiome assay.(A) Schematyczny diagram procedury spatial Trekker–CUT&Tag multiome. Przekrój wieńcowy świeżo zamrożonej tkanki mózgu myszy jest montowany na płytce spatial Trekker i poddawany przestrzennemu kodowaniu kreskowemu. Po lizie tkanki jądra są izolowane i oceniane pod kątem wydajności oraz jakości. Około 50 000 jąder jest wykorzystywanych do CUT&Tag H3K27ac, a tagmentowane jądra, po przeliczeniu, są poddawane kodowaniu kreskowemu pojedynczych komórek przy użyciu kulek żelowych 10x Genomics Chromium Multiome. DNA z kodem kreskowym pojedynczych komórek jest wstępnie amplifikowane i dzielone na dwie frakcje. Indeksowana biblioteka CUT&Tag jest generowana bezpośrednio poprzez PCR indeksujący. W przypadku bibliotek ekspresji genów i przestrzennych kodów kreskowych, wstępnie amplifikowane DNA jest dalej amplifikowane i poddawane selekcji wielkością. Fragmenty odpowiadające typowym rozmiarom cDNA są wykorzystywane do przygotowania biblioteki ekspresji genów, natomiast krótsze fragmenty DNA służą do generowania biblioteki przestrzennych kodów kreskowych. Biblioteki są sekwencjonowane i mapowane zgodnie z wytycznymi 10x Genomics i Curio Trekker. Przewidywany harmonogram eksperymentu jest wskazany po lewej stronie. (B) Kluczowe punkty kontroli jakości (QC) i krytyczne uwagi w całej procedurze. QC jąder obejmuje ocenę wydajności, stopnia nienaruszalności, agregacji i zawartości zanieczyszczeń. QC przed sekwencjonowaniem obejmuje ocenę rozkładu wielkości DNA oraz zanieczyszczenia dimerami starterów dla wszystkich bibliotek. Specyficzność biblioteki CUT&Tag jest oceniana za pomocą ilościowego PCR (qPCR), mierząc wzbogacenie docelowych regionów genomowych względem tła. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Niniejsze badanie przedstawia analizę multiomową spatial Trekker CUT&Tag, która umożliwia jednoczesne profilowanie modyfikacji histonowej H3K27ac związanej z aktywnymi elementami cis-regulatorowymi oraz ekspresji genów w świeżo zamrożonych sekcjach tkanek. Protokół ten zawiera szczegółowe procedury dotyczące kodowania przestrzennego (spatial barcoding) metodą Takara Trekker, dysocjacji tkanek i izolacji jąder komórkowych, liczenia jąder i kontroli jakości, profilowania modyfikacji H3K27ac metodą CUT&Tag z niskim wkładem materiału, wychwytu celów molekularnych na kulekach żelowych 10x Genomics single-cell Multiome oraz przygotowania bibliotek. Przepływ pracy zademonstrowano na koronalnym przekroju tkanki mózgu myszy. W przeciwieństwie do standardowego przepływu pracy 10x Genomics Multiome, w którym dostępność chromatyny jest mierzona za pomocą sekwencjonowania chromatyny dostępnej dla transpozazy (ATAC-seq), niniejszy protokół zastępuje fragmenty ATAC fragmentami uzyskanymi z CUT&Tag, co umożliwia bezpośrednią analizę krajobrazów modyfikacji histonów w rozdzielczości pojedynczych komórek. Aby powiązać przestrzenne kody kreskowe Trekker z kodami kreskowymi dla pojedynczych komórek 10x Genomics, przestrzenne kody z ogonem poly(A) oraz transkrypty mRNA są wychwytywane przez sekwencje poly-dT kulek żelowych Multiome, podczas gdy fragmenty DNA z CUT&Tag są wychwytywane przez sekwencje łącznikowe (spacer sequences). Ta strategia podwójnego wychwytu umożliwia jednoczesne odzyskanie informacji epigenomowych, transkrypcyjnych i przestrzennych z tych samych pojedynczych jąder. Z naszej wiedzy jest to pierwszy przestrzenny przepływ pracy multiomowej, który bezpośrednio integruje adnotację przestrzenną barcode-in Trekker z analizą multiomową pojedynczych komórek w celu współprofilowania genomowego rozkładu znaku histonowego oraz transkryptomu. Uzyskane krajobrazy multiomowe o rozdzielczości przestrzennej, integrujące dane o zajętości H3K27ac i ekspresji genów, umożliwiają projekcję profilów pojedynczych komórek z powrotem do ich oryginalnych współrzędnych tkankowych i zapewniają bezpośredni związek między epigenomowymi mechanizmami regulacyjnymi a programami transkrypcyjnymi w odniesieniu do nienaruszonej architektury tkanki.
Protokół
Dorosłe myszy zostały uśmiercone poprzez inhalację CO2 (IACUC #: A48315-15-R24) przed pobraniem tkanek. Mózgowia usunięto in toto po przeprowadzeniu kraniotomii strzałkowej i usunięciu przedzielonej na pół kalwarii. Odczynniki i sprzęt użyte w badaniu są wymienione w Tabeli Materiałów.
1. Montowanie skrawka tkanki na płytce z kodami kreskowymi Trekker w celu przestrzennego kodowania paskowego
- Przed rozpoczęciem przygotuj następujące elementy.
- Poddaj równoważeniu blok tkanki zatopionej w OCT (optimal cutting temperature) w kriotomie przed wykonaniem skrawków. Przygotuj bufory do rozszczepiania UV, dysocjacji tkanki i izolacji jąder.
UWAGA: Optymalna temperatura cięcia może się różnić w zależności od rodzaju tkanki. - W celu izolacji jąder schłodź wirówkę z koszykami wahadłowymi do probówek 1,5 mL do 4 °C. Schłodź na lodzie płytkę 12-dołkową z uszczelką O-ring Trekker.
- Ustaw miernik UV na maksymalny limit prądu (1,2 A) i maksymalną moc.
- Poddaj równoważeniu blok tkanki zatopionej w OCT (optimal cutting temperature) w kriotomie przed wykonaniem skrawków. Przygotuj bufory do rozszczepiania UV, dysocjacji tkanki i izolacji jąder.
- Zanotuj identyfikator płytki kodu kreskowego przestrzennego (np. U0001_001) używanej płytki Trekker.
UWAGA: Każda płytka Trekker zawiera unikalne współrzędne kodów kreskowych. Identyfikator płytki jest niezbędny do pobrania odpowiedniego pliku do mapowania przestrzennych kodów kreskowych danych z sekwencjonowania. - Wykonaj skrawki tkanki. Przecięcia czołowe o grubości 25 µm w przybliżonej pozycji bregma -1 mm wykonano w temperaturze −18 °C (Rysunek 1A).
UWAGA: Grubość może zostać zwiększona do 30 µm w przypadku pracy z tkankami o niskiej komórkowości. - Umieść skrawki (lub obszar zainteresowania) na płytce przestrzennej i rozpuść je, delikatnie przykładając palec do spodu szkiełka przedmiotowego.
OSTROŻNIE: W razie potrzeby zweryfikuj procedury poprzez pomiary kontroli jakości jąder, korzystając z płytki treningowej Trekker. - Za pomocą pęsety oddziel płytkę od przezroczystego kleju i umieść ją w dołku 12-dołkowej płytki do hodowli tkanek na lodzie, na uszczelce O-ring Trekker. Natychmiast nanieś pipetą 30 µL buforu do rozszczepiania UV Trekker na płytkę, upewniając się, że cała tkanka jest pokryta buforem.
- Umieść lampę UV (ustawienie 1,2 A) na płytce bezpośrednio nad dołkiem. Naświetlaj przez 1 min, aby uwolnić kody kreskowe, utrzymując wszystkie elementy na lodzie.
OSTROŻNIE: Podczas pracy z lampą UV należy nosić ochronne okulary UV. - Wyłącz lampę UV i inkubuj płytkę na lodzie przez 7,5 min. Podczas inkubacji wyjmij komorę płuczącą Trekker 10 x 10 i napełnij komory 1 i 2 objętością 400 µL zimnego buforu do płukania jąder Trekker dla próbki na lodzie.
- Ostrożnie podnieś płytkę pęsetą, nie dotykając kulek, i płucz płytkę w komorze 1 przez 5 s. Płucz płytkę w komorze 2 przez 5 s. Ostrożnie umieść płytkę w dołku 12-dołkowej płytki na lodzie. Skrawki tkanki powinny być zabarwione na niebiesko i łatwo widoczne.
2. Dysocjacja tkanki i izolacja jąder
- Nanieś 175 µL buforu Invent Minute A, celując w tkankę. Powtórz tę czynność jeszcze 3 razy, aby uzyskać łącznie 700 µL. Przy każdym dozowaniu celuj w inne części płytki, aby oddzielić całą tkankę od płytki.
UWAGA: Należy unikać zanieczyszczenia kuleczkami, które mogłyby powstać w wyniku zarysowania płytki lub odpadnięcia kuleczek. - Kontynuuj oddzielanie tkanki od płytki, aspirując bufor z boku dołka i dozując go na obszary płytki pokryte tkanką, utrzymując płytkę w lodzie tak długo, jak to możliwe. Powtarzaj czynność, aż na płytce nie pozostanie żadna tkanka. Po usunięciu całej tkanki z płytki, ostrożnie przenieś płytkę pęsetą do pustego dołka.
- Używając pipety P1000, mechanicznie rozbij jądra komórkowe poprzez wielokrotną tryturację w tym samym dołku. Powtarzaj czynność, aż do całkowitego usunięcia widocznych grudek tkanki.
- Ostrożnie przenieś zawiesinę jąder do wkładu filtrującego z probówką zbiorczą z zestawu Invent Minute do izolacji pojedynczych jąder z tkanek/komórek neuronalnych. Inkubuj probówkę z otwartym korkiem w temperaturze –20 °C przez 10 min. Zakorkuj wkład filtrujący i natychmiast odwiruj z prędkością 13 000 x g przez 30 s w chłodzonej mikrowirówce.
- Usuń wkład filtrujący i resuspenduj osad, delikatnie pipetując 10–20 razy. Wirowuj probówkę w schłodzonej wirówce z rotorem kątowym przy 600 x g przez 5 min. Ostrożnie usuń nadsącz i resuspenduj osad w 200 µL buforu Trekker C.
- Do probówki Eppendorf 1,5 mL o niskim wiązaniu dodaj 1 mL zimnego buforu Invent Minute B, a następnie ostrożnie nałóż 200 µL zawiesiny jąder na wierzch buforu Minute B, powoli wypuszczając ciecz po ściance probówki, aby uniknąć wymieszania warstw. Wirowuj probówkę w schłodzonej wirówce z rotorem kątowym przy 500 x g przez 10 min. Ostrożnie usuń mleczną warstwę oraz nadsącz.
- Delikatnie resuspenduj jądra w 24 µL buforu Trekker C i przystąp do pomiarów kontroli jakości wyizolowanych jąder.
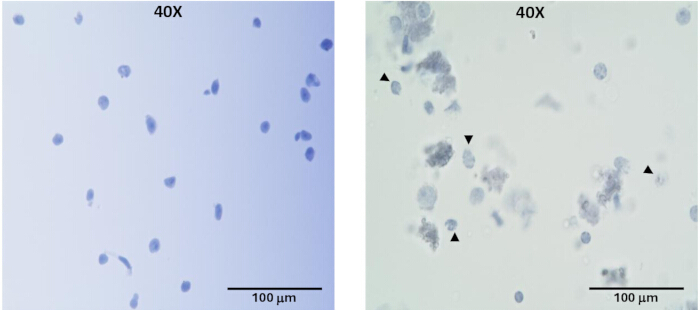
Rycina 2: Ocena kontroli jakości wyizolowanych jąder. Reprezentatywne obrazy w świetle przechodzącym wyizolowanych jąder z tkanki mózgu myszy. Jądra zabarwiono 0,4% błękitem trypanu i obrazowano przy powiększeniu 40x w celu oceny integralności jąder oraz obecności zanieczyszczeń. Preparat jąder pokazany po lewej stronie prezentuje wysokiej jakości, nienaruszone jądra odpowiednie do dalszych analiz, natomiast preparat po prawej stronie ilustruje jądra słabej jakości z częściowo lizowanymi agregatami tkanki. Uszkodzone lub pęknięte jądra zaznaczono wypełnionymi grotami strzałek. Pasek skali wynosi 100 µm. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
3. Liczenie i pomiary kontroli jakości wyizolowanych jąder
- W celu zliczenia jąder przenieś 2 µL zawiesiny jąder do 8 µL buforu Trekker buffer C. Wymieszaj 10 µL rozcieńczonej zawiesiny jąder z 10 µL roztworu barwiącego AO/PI. Policz jądra zgodnie z instrukcjami producenta.
- Aby ocenić jakość wyizolowanych jąder, rozcieńcz 2 µL zawiesiny jąder w 8 µL 4% roztworu błękitu trypanowego. Obejrzyj jądra pod mikroskopem fluorescencyjnym przy powiększeniu 40X, sprawdzając nienaruszoną morfologię błony jądrowej oraz brak zanieczyszczeń pozajądrowych (Rycina 2).
- Niezwłocznie przystąp do analizy single-nucleus CUT&Tag multiome (CUT&Tag dla H3K27ac + ekspresja genów).
UWAGA: Przejdź do kolejnych kroków, jeśli odzyskano co najmniej 30 000 wysokiej jakości jąder.
4. Tagmentacja CUT&Tag w izolowanych jądrach komórkowych
- Przygotować bufor inkubacyjny I do CUT&Tag. Umieścić go w lodzie.
- Przygotować koniugat przeciwciała pierwszorzędowego i enzymu transpozazy aktywowanej przez prowadzenie (TAG).
- Do probówki PCR w lodzie dodać 46,23 µL buforu inkubacyjnego I do CUT&Tag oraz 1,33 µL enzymu TAG. Do probówki dodać zoptymalizowaną ilość przeciwciała pierwszorzędowego. Powoli wymieszać, pipetując 10 razy.
UWAGA: Do reakcji dodano 2,43 µL przeciwciała anty-H3K27ac. Partia przeciwciał została zwalidowana w testach CUT&Tag typu bulk oraz in-situ. Ilość przeciwciała do koniugacji z enzymem TAG należy zoptymalizować za pomocą testu bulk. Optymalne przeciwciało zdefiniowano jako najniższe stężenie, które zapewniło maksymalny stosunek sygnału do szumu, co określono za pomocą qPCR w pozytywnych i negatywnych loci docelowych. - Krótko wirować i umieścić probówkę na rotatorze ustawionym na 18 obr./min. Inkubować w temperaturze pokojowej przez 1 h. Uzyskaną mieszaninę można przygotować wcześniej i przechowywać w lodzie do 5 h.
UWAGA: Inkubację przeciwciała z TAG można przeprowadzić równolegle z izolacją jąder lub przed nią.
- Do probówki PCR w lodzie dodać 46,23 µL buforu inkubacyjnego I do CUT&Tag oraz 1,33 µL enzymu TAG. Do probówki dodać zoptymalizowaną ilość przeciwciała pierwszorzędowego. Powoli wymieszać, pipetując 10 razy.
- Inkubacja izolowanych jąder z koniugatem przeciwciała i enzymu TAG.
- Probówkę (Krok 2.7) z izolowanymi jądrami wirować w schłodzonej wirówce z rotorem kątowym przy 500 x g przez 10 min. Usunąć nadosad bez naruszania osadu, pozostawiając ok. 5 µL nadosadu.
- Dodać 25 µL buforu inkubacyjnego I do CUT&Tag (Krok 4.1) i resuspendować, delikatnie pipetując 10 razy. Przenieść jądra do probówki (Krok 4.2.2) zawierającej koniugat przeciwciała-TAG, używając tej samej końcówki do pipety. Delikatnie wymieszać, pipetując 10 razy, i umieścić probówkę na łagodnym rotatorze.
- Inkubować przez noc w temperaturze 4 ˚C.
- Następnego dnia (Dzień 2) przygotować 1X bufor do jąder CUT&Tag i umieścić w lodzie.
- Tagmentacja CUT&Tag
- Wyjąć probówkę z reakcją (Krok 4.3.3) z rotatora. Dodać 5 µL aktywatora CUT&Tag i przenieść mieszaninę do nowej probówki 1,5 mL. Inkubować przez 1 h w temperaturze 37 ˚ C na ThermoMixerze przy 550 obr./min.
- Wyjąć probówkę, dodać 20 µL buforu gaszącego CUT&Tag i delikatnie wymieszać reakcję, pipetując 10 razy. Wirować probówkę w schłodzonej wirówce z rotorem kątowym przy 500 x g przez 10 min. Usunąć nadosad bez naruszania osadu jąder, pozostawiając ok. 5 µL nadosadu na dnie probówki.
- Dodać 100 µL 1X buforu do jąder CUT&Tag i resuspendować jądra, delikatnie pipetując 10 razy. Wirować probówkę w schłodzonej wirówce z rotorem kątowym przy 500 x g przez 10 min. Usunąć 85 µL nadosadu, pozostawiając ok. 15 µL. Resuspendować jądra, delikatnie i powoli pipetując 10 razy.
- Liczenie tagmentowanych jąder i wyznaczenie liczby docelowej
- Dodać 1 µL zawiesiny tagmentowanych jąder do 9 µL soli fizjologicznej w buforze fosforanowym i wymieszać z 10 µL roztworu barwiącego AO/PI. Policzyć tagmentowane jądra zgodnie z opisem w Kroku 3.1.
- Aby uzyskać pożądaną liczbę wychwyconych jąder, należy użyć 1,6-krotności docelowej liczby jąder do generowania pojedynczych komórek GEM.
- Wirować probówkę w schłodzonej wirówce z rotorem kątowym przy 500 x g przez 10 min i ostrożnie usunąć nadosad, pozostawiając końcową objętość 8 µL.
5. Kodowanie kreskowe pojedynczych jąder poddanych tagmentacji i preamplifikacja DNA z kodami kreskowymi
- Dodaj 7 µL buforu ATAC B do 8 µL tagmentowanych jąder z oczekiwaną liczbą jąder docelowych dla danego eksperymentu.
UWAGA: Więcej szczegółów na temat konfiguracji reakcji i obsługi instrumentu Chromium X znajduje się w protokole „GEM Generation & Barcoding” w instrukcji obsługi Chromium Next GEM Single-Cell Multiome ATAC + Gene Expression Kit (CG000338 Rev G). - Generowanie GEM-ów i kodowanie kreskowe (barcoding) przy użyciu instrumentu Chromium X.
- Dodaj 60 µL master mixu GEM do probówki zawierającej tagmentowane jądra. Delikatnie wymieszaj pipetując i nanieś na rząd 1 chipu Chromium Next GEM J.
- Przygotuj kulek żelowych Single-Cell Multiome i nanieś 50 µL kulek żelowych na rząd 2. Rozdziel 45 µL oleju do partycjonowania do dołków w rzędzie 3.
- Umieść zmontowany chip J z uszczelką w tacy instrumentu Chromium X i uruchom urządzenie.
- Powoli odessać 100 µL GEM-ów z najniższych punktów dołków odzyskiwania w górnym rzędzie 3. Powoli dozuj GEM-y do nowej probówki PCR na lodzie, trzymając końcówki pipety przy ściankach bocznych dołków.
- Inkubuj zebrane GEM-y w termocyklerze (temperatura pokrywy 50˚C) zgodnie z następującym protokołem: jeden cykl w 37 ˚C przez 45 min, jeden cykl w 25 ˚C przez 30 min oraz utrzymanie w 4 ˚C.
- Dodaj 5 µL czynnika wygaszającego (quenching agent) i powoli wymieszaj, pipetując 10 razy.
- Oczyszczanie po inkubacji GEM i puryfikacja DNA
UWAGA: Więcej szczegółów znajduje się w protokole „Post GEM Incubation Cleanup” w instrukcji obsługi Chromium Next GEM Single-Cell Multiome ATAC + Gene Expression Kit (CG000338 Rev G).- Dodaj 125 µL różowego czynnika odzyskiwania do probówki w temperaturze pokojowej i delikatnie odwróć probówkę 10 razy. Krótko wiruj. Powoli usuń i odrzuć 125 µL czynnika odzyskiwania/oleju do partycjonowania (różowego) z dna probówki.
- Dodaj 200 µL mieszaniny oczyszczającej Dynabeads do probówki i wymieszaj, pipetując 10 razy. Inkubuj przez 10 min w temperaturze pokojowej. Umieść probówkę na statywie magnetycznym, aż roztwór stanie się klarowny. Usuń nadsącz.
- Dodaj 300 µL świeżo przygotowanego 80% etanolu do osadu. Inkubuj przez 30 s i usuń nadsącz. Dodaj 200 µL 80% etanolu do osadu, inkubuj przez 30 s i usuń nadsącz. Krótko wiruj probówkę i umieść ją na magnesie. Usuń pozostały nadsącz.
- Zdejmij probówkę z magnesu. Natychmiast dodaj 50,5 µL roztworu elucyjnego I. Wymieszaj pipetując i inkubuj przez 1 min w temperaturze pokojowej. Krótko wiruj i umieść probówkę na magnesie, aż roztwór stanie się klarowny. Przenieś 50 µL klarownego roztworu do nowej probówki.
- Puryfikacja DNA za pomocą kulek paramagnetycznych
- Dodaj 90 µL kulek paramagnetycznych (1,8X) do każdej próbki i dokładnie wymieszaj pipetując. Inkubuj przez 5 min w temperaturze pokojowej. Krótko wiruj i umieść probówkę na magnesie, aż roztwór stanie się klarowny. Usuń nadsącz.
- Dodaj 200 µL 80% etanolu do osadu. Inkubuj przez 30 s. Usuń etanol. Powtórz tę czynność jeszcze raz.
- Krótko wiruj i umieść probówkę na magnesie. Usuń pozostały nadsącz.
- Zdejmij probówkę z magnesu. Dodaj 46,5 µL buforu EB i wymieszaj pipetując. Inkubuj przez 2 min w temperaturze pokojowej. Wiruj i umieść probówkę na magnesie, aż roztwór stanie się klarowny.
- Przenieś 46 µL oczyszczonego DNA do nowej probówki.
- Preamplifikacja kodowanego kreskowo DNA.
- Dodaj 54 µL mieszaniny do preamplifikacji do każdej próbki. Wymieszaj pipetując i krótko wiruj.
- Inkubuj w termocyklerze (temperatura pokrywy 105 °C) zgodnie z następującym protokołem: jeden cykl w 72 °C przez 5 min; jeden cykl w 98 °C przez 3 min; łącznie 7 cykli: 98 °C przez 20 s, 63 °C przez 30 s, 72 °C przez 1 min; jeden cykl w 72 °C przez 1 min oraz utrzymanie w 4 °C. Przechowuj w 4 °C przez noc.
- Następnego dnia (Dzień 3) oczyść preamplifikowane DNA za pomocą kulek paramagnetycznych (1,6X), jak opisano w kroku 5.3.5. Dodaj 80,5 µL buforu EB do probówki i wymieszaj pipetując. Inkubuj przez 2 min w 22 °C (temperatura pokojowa). Krótko wiruj i umieść probówkę na magnesie, aż roztwór stanie się klarowny.
- Przenieś 80 µL preamplifikowanego DNA do nowej probówki. Wykorzystaj 40 µL do generowania biblioteki CUT&Tag. Pozostałe preamplifikowane DNA przechowuj w 4 °C.
UWAGA: 40 µL pozostałego preamplifikowanego DNA zostanie wykorzystane później do bibliotek ekspresji genów i kodowania przestrzennego.
6. Przygotowanie bibliotek dla CUT&Tag, ekspresji genów i kodów kreskowych przestrzennych
- Przygotowanie biblioteki scCUT&Tag
- Przenieść 40 µL przedwzmocnionego DNA do nowej probówki i dodać 60 µL mieszaniny PCR do indeksowania próbek. Wymieszać pipetując i krótko wirować.
- Inkubować w termocyklerze (temperatura pokrywy 105 °C) zgodnie z następującym protokołem: jeden cykl 98 °C przez 45 s; łącznie 12 cykli: 98 °C przez 20 s, 67 °C przez 30 s, 72 °C przez 20 s; jeden cykl 72 °C przez 1 min; utrzymanie w 4 °C).
UWAGA: Optymalna liczba cykli zależy od początkowej liczby jąder oraz profilowanego znacznika histonowego. W eksperymencie dla znacznika H3K27ac zastosowano dwanaście cykli amplifikacji. - Podwójna selekcja rozmiaru i oczyszczanie DNA za pomocą kulek paramagnetycznych (0.6X, 1.55X)
- Dodać 60 µL kulek paramagnetycznych (0.6X) do każdej próbki i dokładnie wymieszać pipetując. Inkubować przez 5 min w temperaturze pokojowej. Krótko wirować i umieścić probówkę na magnesie, aż roztwór stanie się klarowny.
- Przenieść 150 µL nadsączu do nowej probówki. Dodać 95 µL kulek paramagnetycznych (1.55X) do każdej próbki (nadsączu) i wymieszać pipetując. Inkubować przez 5 min w temperaturze pokojowej. Umieścić probówkę na magnesie, aż roztwór stanie się klarowny. Usunąć nadsącz.
- Dodać 300 µL 80% etanolu do osadu. Odczekać 30 s. Usunąć etanol. Powtórzyć tę czynność jeszcze raz. Krótko wirować i umieścić probówkę na magnesie. Usunąć pozostały nadsącz.
- Zdjąć probówkę z magnesu. Dodać do probówki 20,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Wirować i umieścić na magnesie, aż roztwór stanie się klarowny.
- Przenieść 20 µL oczyszczonych i zindeksowanych bibliotek CUT&Tag do nowych probówek.
- Kontrola jakości (QC) biblioteki CUT&Tag
- Analiza rozkładu wielkości DNA w bibliotece
- Wymieszać 1 µL oczyszczonego DNA biblioteki z 1 µL buforu low TE.
- Wymieszać rozcieńczone DNA z buforem roboczym Fragment Analyzer i przeprowadzić analizę na urządzeniu przy użyciu zestawu High-sensitivity HS NGS Fragment Kit (1-6000bp) (Rycina 3A).
- Ocena wzbogacenia pozytywnego dla H3K27ac locusu genomicznego przed sekwencjonowaniem i mapowaniem.
- Wymieszać 1 µL oczyszczonego DNA biblioteki z 4 µL wody wolnej od nukleaz. Użyć 1 µL rozcieńczonego DNA biblioteki do pomiarów qPCR dla trzech locusów genomicznych.
UWAGA: Dla CUT&Tag H3K27ac starter pozytywny zaprojektowano dla locusu Actb-TSS, natomiast startery celujące w T1-TSS oraz locus międzygenowy służyły jako kontrole negatywne20 (Tabela 1). Genomiczne DNA myszy wykorzystano jako kontrolę wejściową (input) w celu normalizacji wydajności PCR (Rycina 3B). - Przygotować łącznie 20 µL mieszaniny reakcyjnej w następujący sposób: 1 µL rozcieńczonego DNA biblioteki, 2 µL mieszaniny starterów 10 µM, 10 µL 2X SYBR Green Master Mix oraz 7 µL wody wolnej od nukleaz.
- Próbkę qPCR w płytce przeprowadzić na systemie CFX Opus Real-Time PCR, stosując odpowiedni program cykliczny dla detekcji SYBR Green.
- Wymieszać 1 µL oczyszczonego DNA biblioteki z 4 µL wody wolnej od nukleaz. Użyć 1 µL rozcieńczonego DNA biblioteki do pomiarów qPCR dla trzech locusów genomicznych.
- Analiza rozkładu wielkości DNA w bibliotece
- Amplifikacja cDNA i DNA kodów kreskowych przestrzennych (spatial barcode).
- Przenieść 35 µL przedwzmocnionego DNA (Krok 5.4.4) do nowej probówki i dodać 65 µL mieszaniny do reakcji amplifikacji cDNA. Wymieszać pipetując i krótko wirować. Starterem używanym do amplifikacji cDNA i DNA kodów kreskowych przestrzennych są Feature cDNA Primers 2.
- Inkubować w termocyklerze (temperatura pokrywy 105 °C) zgodnie z następującym protokołem: jeden cykl 98 °C przez 45 s; łącznie 8 cykli: 98 °C przez 20 s, 63 °C przez 30 s, 72 °C przez 1 min; jeden cykl 72 °C przez 1 min; utrzymanie w 4 °C.
UWAGA: Optymalna liczba cykli musi zostać określona na podstawie typu komórek, zawartości RNA i początkowej liczby jąder. W tym eksperymencie wykonano 8 cykli amplifikacji. - Oczyszczanie amplifikowanego cDNA
- Podwójna selekcja rozmiaru i oczyszczanie DNA za pomocą kulek paramagnetycznych (0.6X, 2.0X) zgodnie z opisem w Kroku 6.1.3. Dodać 60 µL kulek paramagnetycznych (0.6X) do każdej próbki i wymieszać pipetując. Inkubować przez 5 min w temperaturze pokojowej. Umieścić magnes nad roztworem, aż stanie się on klarowny.
- Przenieść i zachować 75 µL nadsączu w nowej probówce, nie naruszając osadu. Przechowywać w temperaturze pokojowej.
OSTROŻNIE: Nie wylewać nadsączu, ponieważ zawiera ono DNA wzbogacone o krótsze fragmenty, które zostaną użyte do wygenerowania biblioteki kodów kreskowych przestrzennych. - Usunąć pozostały nadsącz z osadu. Przemyć 80% etanolem dwa razy, zgodnie z opisem w Kroku 6.1.3.
- Dodać do probówki 40,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Krótko wirować i umieścić na magnesie, aż roztwór stanie się klarowny.
- Przenieść 40 µL amplifikowanego cDNA do nowej probówki. Przechowywać na lodzie w celu przygotowania zindeksowanej biblioteki ekspresji genów.
UWAGA: Ta frakcja wzbogaca DNA o typowy rozmiar cDNA.
- Oczyszczanie amplifikowanego DNA kodów kreskowych przestrzennych
- Dodać 70 µL kulek paramagnetycznych (2.0X) do 75 µL wcześniej zachowanego nadsączu (Krok 6.3.3.2). Wymieszać pipetując i krótko wirować. Inkubować przez 5 min w temperaturze pokojowej. Umieścić probówkę na magnesie, aż roztwór stanie się klarowny. Usunąć nadsącz.
- Przemyć 80% etanolem dwa razy, zgodnie z opisem w Kroku 6.1.3.
- Dodać do probówki 40,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Krótko wirować i umieścić na magnesie, aż roztwór stanie się klarowny.
- Przenieść 40 µL amplifikowanego i oczyszczonego DNA kodów kreskowych przestrzennych do nowej probówki. Przechowywać w −20 °C do późniejszego generowania zindeksowanej biblioteki kodów kreskowych przestrzennych.
- Analiza wielkości cDNA za pomocą Fragment Analyzer. Wymieszać 1 µL amplifikowanego cDNA z 1 µL buforu low TE. Przebadać rozcieńczone DNA za pomocą Fragment Analyzer zgodnie z opisem w Kroku 6.2.1.
- Przygotowanie zindeksowanej biblioteki ekspresji genów
- Przenieść 10 µL amplifikowanego cDNA (Krok 6.3.3.5) do nowej probówki. Dodać 25 µL buforu EB i 15 µL mieszaniny do fragmentacji. Wymieszać pipetując na lodzie. Krótko wirować i przenieść probówkę do schłodzonego termocyklera w 4 °C.
- Inkubować w termocyklerze (temperatura pokrywy 65 °C), uruchamiając następujący protokół: jeden cykl 32 °C przez 5 min; jeden cykl 65 °C przez 30 min; utrzymanie w 4 °C.
- Podwójna selekcja rozmiaru i oczyszczanie DNA za pomocą kulek paramagnetycznych (0.6X, 0.8X) zgodnie z opisem w Kroku 6.1.3. Dodać 50,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Krótko wirować i umieścić na magnesie, aż roztwór stanie się klarowny.
- Przenieść 50 µL próbki do nowej probówki. Dodać 50 µL mieszaniny do ligacji adaptorów i wymieszać pipetując. Krótko wirować. Inkubować w termocyklerze (temperatura pokrywy 30 °C) zgodnie z następującym protokołem: jeden cykl 20 °C przez 15 min i utrzymanie w 4 °C.
- Oczyszczanie DNA za pomocą kulek paramagnetycznych (0.8X) zgodnie z opisem w Kroku 5.3.5. Dodać 30,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Krótko wirować i umieścić na magnesie, aż roztwór stanie się klarowny. Przenieść 30 µL próbki do nowej probówki.
- PCR indeksujący bibliotekę ekspresji genów. Dodać 50 µL mieszaniny amplifikacyjnej oraz dodać 20 µL indywidualnego podzbioru indeksów podwójnych TT set A do każdej próbki.
- Inkubować w termocyklerze (temperatura pokrywy 105 °C) zgodnie z następującym protokołem: jeden cykl 98 °C przez 45 s; łącznie 11 cykli: 98 °C przez 20 s, 54 °C przez 30 s, 72 °C przez 20 s; jeden cykl 72 °C przez 1 min; utrzymanie w 4 °C.
UWAGA: Optymalna liczba cykli musi zostać określona na podstawie typu komórek, zawartości RNA i początkowej liczby jąder. W tym eksperymencie zastosowano łącznie 11 cykli amplifikacji. - Podwójna selekcja rozmiaru i oczyszczanie DNA za pomocą kulek paramagnetycznych (0.6X, 0.8X) zgodnie z opisem w Kroku 6.1.3. Dodać do probówki 35,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Krótko wirować i umieścić na magnesie, aż roztwór stanie się klarowny.
- Przenieść 35 µL oczyszczonej i zindeksowanej biblioteki ekspresji genów do nowej probówki.
- Analiza rozkładu wielkości DNA w bibliotece ekspresji genów. Wymieszać 1 µL DNA biblioteki z 1 µL buforu low TE. Przebadać rozcieńczone DNA zgodnie z opisem w Kroku 6.2.1. (Rycina 3A).
- Przygotowanie zindeksowanej biblioteki kodów kreskowych przestrzennych
- Przygotować łącznie 100 µL mieszaniny PCR do indeksowania próbek w następujący sposób: 50 µL Amp Mix (z zestawu GEM-X Single-Cell 3' Feature Barcode Kit), 25 µL buforu EB, 20 µL startera z Dual Index Plate TT Set A oraz 1 µL oczyszczonego DNA kodów kreskowych przestrzennych (Krok 6.3.4.4) rozcieńczonego w 4 µL buforu EB.
- Inkubować w termocyklerze (temperatura pokrywy 105 °C) zgodnie z następującym protokołem: jeden cykl 98 °C przez 45 s; łącznie 7 cykli: 98 °C przez 20 s, 54 °C przez 30 s, 72 °C przez 20 s; 72 °C przez 1 min; utrzymanie w 4 °C.
- Oczyszczanie DNA za pomocą kulek paramagnetycznych (1.2X) zgodnie z opisem w Kroku 5.3.5. Dodać do probówki 35,5 µL buforu EB i wymieszać pipetując. Inkubować przez 2 min w temperaturze pokojowej. Umieścić probówkę na magnesie, aż roztwór będzie klarowny.
- Przenieść 35 µL oczyszczonego i zindeksowanego DNA biblioteki kodów kreskowych przestrzennych do nowej probówki. Przechowywać w 4 °C do 72 h lub w −20 °C do długotrwałego przechowywania.
- Kontrola rozkładu wielkości DNA w zindeksowanej bibliotece kodów kreskowych przestrzennych. Wymieszać 1 µL oczyszczonego DNA biblioteki z 1 µL buforu low TE. Przebadać rozcieńczone DNA za pomocą Fragment Analyzer zgodnie z opisem w Kroku 6.2.1 (Rycina 3A).
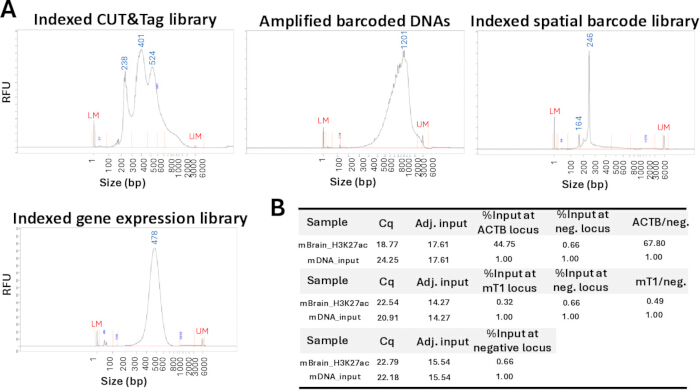
Rycina 3: Ocena kontroli jakości indeksowanych bibliotek. (A) Profile wielkości w amplifikowanych DNA i indeksowanych bibliotekach. DNA analizowano za pomocą analizatora fragmentów (Fragment Analyzer) w celu oceny jakości DNA i rozkładu wielkości. Przedstawiono reprezentatywne profile dla indeksowanej biblioteki CUT&Tag, amplifikowanego DNA wykorzystanego do przygotowania biblioteki ekspresji genów i biblioteki kodów kreskowych przestrzennych (spatial barcode), indeksowanej biblioteki ekspresji genów oraz indeksowanej biblioteki kodów kreskowych przestrzennych. (B) Bibliotekę CUT&Tag analizowano metodą qPCR w celu oceny wzbogacenia pozytywnego dla H3K27ac regionu genomowego (tj. ACTB) w stosunku do sygnału tła negatywnego dla H3K27ac (tj. T1 i locus międzygenowy). Różnica krotności między regionami pozytywnymi a negatywnymi została obliczona jako wzbogacenie (enrichment)21. W tym badaniu za idealne uznaje się wzbogacenie przekraczające 10-krotność20. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
7. Sekwencjonowanie bibliotek
- Przeprowadzić sekwencjonowanie biblioteki kodów kreskowych Trekker spatial z głębokością 5 000 par odczytów na uchwycone jądro.
- Przeprowadzić sekwencjonowanie biblioteki H3K27ac CUT&Tag z głębokością 25 000 par odczytów na uchwycone jądro.
- Przeprowadzić sekwencjonowanie biblioteki ekspresji genów z głębokością co najmniej 20 000 par odczytów na uchwycone jądro.
8. Bioinformatyka i analiza danych
- Przetworzyć odczyty ekspresji genów i CUT&Tag przy użyciu programu Cell Ranger ARC v2.0.2 z parametrami --min-atac-count=100 oraz --min-gex-count=1000. Zintegrować wyniki z Cell Ranger ARC z informacjami o kodach kreskowych Trekker za pomocą potoku Trekker pipeline v1.3.0 z domyślnymi parametrami w celu przypisania pozycji przestrzennych.
- Przeprowadzić kontrolę jakości za pomocą pakietu Signac. Z dalszej analizy usunięto komórki spełniające dowolne z poniższych kryteriów: dla CUT&Tag całkowita liczba fragmentów ≥ 1 000 000 lub ≤ 100 oraz wzbogacenie TSS ≤ 2; dla ekspresji genów całkowita liczba UMI ≥ 100 000 lub ≤ 1 000 oraz całkowita liczba wykrytych genów ≥ 10 284 lub ≤ 200.
- Usunąć dublety przy użyciu scDblFinder dla ekspresji genów oraz AMULET dla CUT&Tag. Jako dublety sklasyfikowano komórki spełniające dowolne z poniższych kryteriów: (1) wynik scDblFinder ≥ 0,6; (2) wynik scDblFinder ≥ 0,3 oraz AMULET ≤ 0,01; oraz (3) komórki w klastrach z wysokim % dubletów.
- Znormalizować dane ekspresji genów za pomocą metody LogNormalize, a dane CUT&Tag za pomocą TF-IDF. Obliczyć osadzenia RNA PCA oraz CUT&Tag LSI, wykorzystując wymiary LSI 2–50 dla modalności chromatyny. Skonstruować ważony graf najbliższych sąsiadów za pomocą funkcji FindMultiModalNeighbors i wygenerować osadzenia UMAP w oparciu o multimodalny graf sąsiadów.
- Adnotować dane Trekker po kontroli jakości za pomocą transferu etykiet Seurat w oparciu o FindTransferAnchors i strategię mapowania projekcji PCA z domyślnymi parametrami. Jako referencję wykorzystano dane scRNA-seq z ABC Atlas (wersja 20230630). Podczas ręcznej kurateli usunięto przewidywania typów komórek niespójne ze znaną anatomią tkanki.
UWAGA: Skrypty do analizy bioinformatycznej są dostępne na GitHubie: https://github.com/Liuy12/Mouse_Brain_Trekker_Multiome_Cuttag
Wyniki
Wykorzystując przekrój wieńcowy (grubość 25 µm, około 70% pokrycia płytki przestrzennej o wymiarach 10 × 10 mm) świeżo zamrożonej tkanki mózgu myszy, opisany tutaj schemat pracy pozwolił na konsekwentne uzyskanie 50 100 wysokiej jakości jąder (SD = 12 200, n = 8), co jest wartością wystarczającą do późniejszego profilowania multiomicznego pojedynczych komórek (Rycina 1). Po przestrzennym kodowaniu kreskowym (spatial barcoding) przekroju tkanki metodą Trekker, jądra zostały wyizolowane poprzez łagodną dysocjację tkanki, a następnie dodatkowo oczyszczone za pomocą zestawu do izolacji pojedynczych jąder Invent. Procedura ta doprowadziła do powstania minimalnej ilości zanieczyszczeń i niskiego poziomu agregacji jąder, co pozwoliło na przygotowanie zawiesin jąder odpowiednich do analiz pojedynczych komórek. Reprezentatywne obrazy wyizolowanych jąder przedstawiono na Rycynie 2.
W przypadku dalszych analiz pojedynczych jąder, w tym profilowania multiomowego CUT&Tag (CUT&Tag + ekspresja genów), zazwyczaj przetwarzano tutaj około 50 000 jąder. Aby zmaksymalizować odzysk jąder, zastosowano uproszczony, zoptymalizowany protokół CUT&Tag dla niskich ilości materiału, wykorzystując bezpośrednie celowanie przeciwciało–pA/Tn5 i tagmentację, co pozwoliło zminimalizować czasy inkubacji oraz liczbę etapów płukania19. Stosując to podejście, odzyskano około 25 000 tagmentowanych jąder, co odpowiada średniej wydajności 48,3% (SD = 6,1, n = 3). Jądra te zostały następnie wykorzystane do kodowania pojedynczych komórek za pomocą koralików żelowych 10x Genomics Chromium Multiome. Do generowania GEM-ów zaplanowano użycie około 15 000 jąder, z oczekiwaniem odzyskania ~10 000 jąder z indeksowaniem przestrzennym po filtrowaniu jakościowym. Na podstawie dekodowania przestrzennych kodów kreskowych Trekker, 81,3% jąder (SD = 9, n = 3) z zestawu danych pojedynczych komórek można było z pewnością przypisać do pozycji przestrzennych w obrębie kafelka.
Przepływ pracy multiomowej Trekker–CUT&Tag w rozdzielczości przestrzennej generuje trzy indeksowane biblioteki: bibliotekę CUT&Tag, bibliotekę ekspresji genów oraz bibliotekę kodów kreskowych przestrzennych (spatial barcode). Wstępnie amplifikowane DNA z kodami kreskowymi podzielono na dwie frakcje, z których każda została wykorzystana do przygotowania biblioteki zgodnie z chemią wychwytu celów na koralikach żelowych. Biblioteki CUT&Tag zostały bezpośrednio amplifikowane z wstępnie amplifikowanego DNA i wykazały rozkłady wielkości fragmentów charakterystyczne dla tagmentacji CUT&Tag, odpowiadające DNA wolnemu od nukleosomów oraz DNA nukleosomalnemu (Rycyna 3A). Biblioteka wykazała wyraźne wzbogacenie locus Actb dodatniego pod kątem H3K27ac w stosunku do loci genomicznych ujemnych pod kątem H3K27ac20,21 (tj. 68-krotna różnica, przekraczająca 10-krotny próg wcześniej ustalony dla analizy sekwencjonowania immunoprecypitacji chromatyny H3K27ac20) (Rycyna 3B). W przypadku bibliotek ekspresji genów i kodów kreskowych przestrzennych, wstępnie amplifikowane DNA najpierw poddano amplifikacji zgodnie z protokołem amplifikacji cDNA 10x Genomics, a następnie rozdzielono na dwie frakcje na podstawie wielkości fragmentów przy użyciu oczyszczania koralikami paramagnetycznymi. Indeksowana biblioteka kodów kreskowych przestrzennych została przygotowana z frakcji wzbogaconej w krótsze fragmenty i wykazała ostry pik przy oczekiwanej wielkości fragmentu. Biblioteki ekspresji genów wykazały charakterystyczny rozkład wielkości skoncentrowany wokół amplifikowanych fragmentów cDNA (Rycyna 3A).
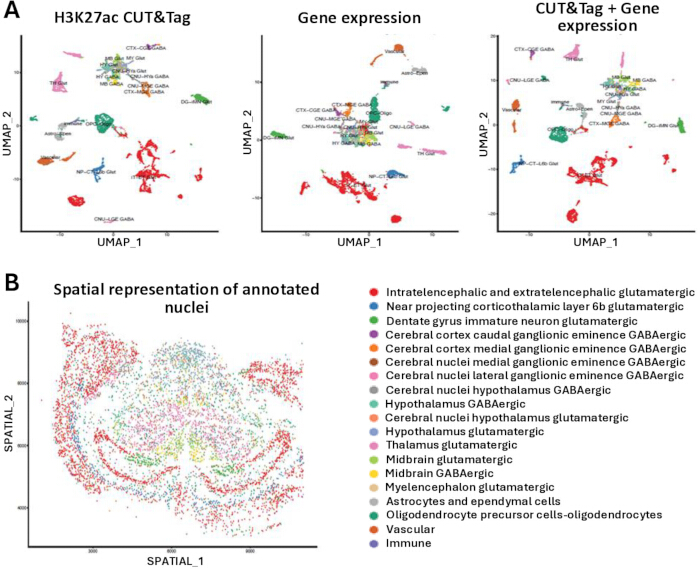
Rysunek 4: Reprezentacja jednokomórkowa i przestrzenna analizy multiomowej spatial Trekker–CUT&Tag w tkance mózgu myszy. (A) Identyfikacja typów komórek za pomocą analizy jednokomórkowej. Wykresy jednorodnej aproksymacji i projekcji rozmaitości (UMAP) przedstawiają adnotowane populacje komórek uzyskane wyłącznie z danych H3K27ac CUT&Tag, wyłącznie z ekspresji genów oraz z zintegrowanego zbioru danych multiomowych (CUT&Tag + ekspresja genów). (B) Reprezentacja przestrzenna danych multiomowych spatial Trekker–CUT&Tag. Jądra ze zintegrowanego zbioru danych multiomowych są przypisywane do współrzędnych przestrzennych przy użyciu kodów kreskowych Trekker, co ujawnia anatomicznie zorganizowane rozmieszczenie typów komórek w przekroju tkanki mózgu myszy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Sekwencjonowanie i mapowanie bibliotek CUT&Tag oraz ekspresji genów przeprowadzono przy użyciu oprogramowania Cell Ranger ARC v2.0.2 zgodnie z wytycznymi firmy 10x Genomics, natomiast biblioteki kodów kreskowych przestrzennych (spatial barcode libraries) przetworzono za pomocą Trekker v1.3.0 zgodnie z zaleceniami firmy Takara Trekker. Do bibliotek CUT&Tag zastosowano sugerowane opcje mapowania dla single-cell ATAC-seq. Wygenerowano zestawy danych dla samych jąder w CUT&Tag, samej ekspresji genów oraz połączony multiome (CUT&Tag + ekspresja genów). Komórki z całkowitą liczbą UMI dla CUT&Tag (≥ 1 000 000 lub ≤ 100) lub ekspresji genów (≥ 100 000 lub ≤ 1000) zostały odfiltrowane przy użyciu pakietu Signac22. Przewidywanie dubletów wykonano za pomocą kombinacji scDblFinder23 dla ekspresji genów oraz AMULET24 dla CUT&Tag. Usunięto komórki spełniające jedno z poniższych kryteriów: 1) scDblFinder.score > 0,6; 2) scDblFinder.score między 0,3 a 0,6 oraz amulet.score < 0,01. Adnotację typów komórek wykonano za pomocą funkcji FindTransferAnchors pakietu Seurat25 w oparciu o dane referencyjne26 z Allen Brain Cell Atlas. Dla biblioteki ekspresji genów w niniejszym badaniu mediana liczby UMI na komórkę wyniosła 15 378, a mediana liczby genów na komórkę wyniosła 4 378. Dla biblioteki CUT&Tag wykryto 11 860 komórek, z medianą 6 631 wysokiej jakości fragmentów na komórkę i wynikiem wzbogacenia TSS wynoszącym 7,66. W przypadku biblioteki kodów kreskowych przestrzennych Trekker, 92,43% jąder przypisano do pozycji przestrzennych, a 51,54% jąder przypisano do pojedynczej lokalizacji przestrzennej. Surowe dane z sekwencjonowania oraz dane przetworzone z analiz wtórnych są dostępne w bazie GEO pod numerem dostępu GSE327406. Końcowy, po kontroli jakości (post-QC), adnotowany obiekt Seurat jest dostępny w Zenodo pod numerem dostępu 19475899. Reprezentatywne rzuty UMAP z adnotacjami typów komórek przedstawiono na Rysunku 4A. Poprzez powiązanie kodów kreskowych pojedynczych komórek z kodami kreskowymi przestrzennymi, poszczególne jądra przypisano z powrotem do ich lokalizacji przestrzennych w tkance w celu wygenerowania mapy przestrzennej (Rysunek 4B). Mapa ta ściśle odpowiada cechom anatomicznym zaobserwowanym w sąsiednich przekrojach i jest zgodna z koronalnym przekrojem mózgu w Allen Brain Atlas27, który stanowi standardowy wzorzec anatomii mózgu myszy. Wspólna analiza przestrzennej ekspresji genów i profili H3K27ac w rozdzielczości pojedynczej komórki umożliwiła identyfikację głównych typów komórek mózgu i ujawniła anatomicznie zorganizowane wzorce rozmieszczenia komórkowego w przekroju tkanki.
Dyskusja
Ten protokół opisuje przestrzenny przepływ pracy Trekker-CUT&Tag multiome, który integruje przestrzenną kodowanie, nisko-wejściowe profilowanie CUT&Tag H3K27ac, jednoczesne przechwytywanie wielu docelowych cząsteczek na żelowych perłach 10x Genomics single-cell multiome oraz przygotowanie biblioteki do sekwencjonowania Illumina. Łącząc indeksowanie przestrzenne z epigenomowymi i transkryptonomicznymi odczytami jednokomórkowymi, to podejście eliminuje fundamentalną ograniczenie konwencjonalnych jednokomórkowych przepływów pracy multiome, które nie mają natywnego kontekstu tkankowego. To badanie z powodzeniem demonstruje wykonalność przestrzennego profilowania multiome CUT&Tag (H3K27ac CUT&Tag + ekspresja genów) i ustanawia podstawę dla przestrzennego współprofilowania ekspresji genów oraz docelowych regulatorów, takich jak znaki histonowe i białka związane z chromatyną.
Rygoryzujący kontrolę jakości na wielu etapach przepływu pracy jest niezbędny dla pomyślnej implementacji tego przepływu pracy (Rysunek 1). Chociaż opisany tutaj proces rozpoczyna się od kroków po przekroju, jakość samego przekroju tkankowego jest krytyczna dla optymalnych wyników. Grubość przekroju powinna być dostosowana w oparciu o typ tkanki i oczekiwaną komórkowość. Podczas dysocjacji tkanki i izolacji jąder maksymalizacja wydajności jąder przy zachowaniu integralności jądra jest kluczowa dla ogólnej wydajności przepływów pracy multiome jednokomórkowych opartych na Trekkerze. Niska wydajność jąder może wynikać z nieoptymalnej dysocjacji tkanki, nieefektywnej izolacji jąder lub niewystarczającej grubości przekroju. Zła integralność jąder może wynikać z nadmiernego mechanicznego uszkodzenia, przedłużającego się czasu przetwarzania lub nadmiernego rozkładania. Izolacja jąder stanowi główny punkt rozwiązywania problemów dla pomyślnej implementacji przepływu pracy multiome jednokomórkowego opartego na Trekkerze. Dlatego zaleca się mocno tkankową optymalizację protokołu izolacji jąder przed rozpoczęciem przepływu pracy multiome jednokomórkowego opartego na Trekkerze. Izolowanych jąder należy oceniać ilościowo i jakościowo. Liczenie jąder za pomocą barwników jądrowych zapewnia estymację wydajności, podczas gdy mikroskopowe badanie umożliwia ocenę integralności błony jądrowej, agregacji oraz obecności niejądrowych zanieczyszczeń. Po przygotowaniu biblioteki wszystkie biblioteki powinny być oceniane pod kątem dystrybucji rozmiarów fragmentów i braku dimerycznych adapterów. W przypadku bibliotek CUT&Tag należy oceniać wzbogacenie docelowych regionów genomu nad tłem za pomocą ilościowej PCR, co zapewnia wczesny wskaźnik specyficzności assayu i ogólnej jakości biblioteki przed sekwencjonowaniem. Kontrolę jakości po sekwencjonowaniu jest równie ważna dla dokładnej interpretacji danych multiome przestrzennych. Takie wskaźniki jak współczynniki mapowania, liczba fragmentów na jądro, wzbogacenie miejsca startu transkrypcji, wyniki fragment-in-peak dla CUT&Tag, złożoność genów i głębokość odczytu na komórkę powinny być oceniane zgodnie z zaleceniami 10x Genomics i Takara Trekker. Wspólna ocena tych wskaźników w obu trybach epigenomowych i transkryptonomicznych umożliwia identyfikację artefaktów technicznych i zapewnia niezawodną integrację informacji przestrzennych, epigenomowych i transkrypcyjnych.
Mimo że wykonalność podejścia opartego na barkodzie Trekker w połączeniu z jednokomórkowym assayem multiome CUT&Tag jest demonstrowana w tym badaniu, opisane podejście ma również ograniczenia. Na przykład metoda jest obecnie ograniczona do świeżo zamrożonej tkanki, a jej wykonalność została zademonstrowana tylko dla profilowania pojedynczej modyfikacji histonowej (H3K27ac) w jednym typie tkanki (mózg myszy) bez replikat biologicznych. Ponadto podejście opiera się na dwóch komercyjnych platformach (Takara Trekker i 10x Genomics Next GEM Chromium Single Cell Multiome). Dalsza ocena na różnych typach tkanek i dodatkowych znakach epigenetycznych będzie konieczna, aby ocenić szersze zastosowanie, wydajność, ogólność i powtarzalność tej technologii.
Podsumowując, przestrzenny protokół Trekker-CUT&Tag multiome przedstawiony tutaj demonstruje zdolność do przestrzennego jednokomórkowego współprofilowania epigenomowych i transkryptonomicznych cech. Łącząc kodowanie przestrzenne z ugruntowanymi jednokomórkowymi chemiami multiome, umożliwia mechaniczne badanie regulacji genów w całym układzie tkankowym i oferuje potężną platformę dla przyszłych zastosowań biologii przestrzennej. Warto zauważyć potencjalne zastosowania, takie jak ocena wpływu różnych bodźców eksperymentalnych i środowiskowych na epigenetyczną kontrolę ekspresji genów w określonych typach komórek – na przykład skutki stymulacji nerwowej mogą być analizowane w określonych typach neuronów w centralnym i obwodowym układzie nerwowym, lub wpływ na sąsiednie komórki przenikających pro- i anty-zapalnych komórek odpornościowych można ujawnić w chorobach zapalnych i rakach.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
To prace została częściowo wspierana przez granty National Institutes of Health R01 DK142826 (T.O.), R01 DK121766 (Y.H.), R01 DK126827 (T.O.), R01 DK131455 (T.O.; MPI), P30 DK084567 (T.O.: Epigenomics and Spatial Biology Core, Mayo Clinic Center for Cell Signaling in Gastroenterology) oraz Mayo Clinic Presidential Strategic Initiative Fund (T.O.). Agencje finansujące nie miały wpływu na projekt badań, analizę danych, ani przygotowanie manuskryptu. Treść jest wyłączną odpowiedzialnością autorów.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 0.4% Trypan Blue | Invitrogen | T10282 | Rozcieńczony z 4% roztworu Trypan Blue (Invitrogen, T10282) |
| 10% Tween 20 | Bio-Rad | 1662404 | |
| 10X Genomics Chromium X instrument | 10X Genomics | 1000331 | RRID:SCR_024537 |
| 12-well plates | Thermo Fisher | 150200 | |
| 1X CUT&Tag Nuclei Buffer | 10x Genomics | Przygotowane z 20X Nuclei buffer | Aby uzyskać łączną objętość 110 μL, wymieszaj 5.5 μL 20X Nuclei Buffer (10X Genomics) + 8.25 μL inhibitora RNAse + 1.1 μL 100 mM DTT + 95.15 μL wody bez nukleazy |
| 20X Nuclei Buffer | 10x Genomics | 2000207 | |
| 4% Trypan Blue solution | Invitrogen | T10282 | |
| 5200 Fragment Analyzer | Advanced Analytical | M5310AA | |
| ABC atlas | open-source | N/A | Opracowanie: Allen Institute for Brain Science (Seattle, WA) RRID:SCR_024440 |
| Activator | Epigenome Technology | CF1006 | |
| Adaptor Ligation Mix | 10X Genomics | Przygotowane z buforu ligacyjnego, enzymu, oligonukleotydów | Aby uzyskać łączną objętość 50 ul mieszanki do ligacji adaptorów, wymieszaj 20 μL buforu ligacyjnego + 10 μL ligazy DNA + 20 μL oligonukleotydów adaptorów |
| Adaptor Oligos | 10X Genomics | 2000094 | |
| Amp Mix | 10X Genomics | 2000047 | |
| Amulet | open-source | N/A | Opracowanie: Ucar Lab (The Jackson Laboratory) RRID: N/A |
| Anti-H3K27ac antibody | EpiCypher | 13-0059 | Partia przeciwciała jest zweryfikowana dla próbek bulkowych i in situ CUT&Tag assay RRID:AB_3712075 |
| ATAC Buffer B | 10X Genomics | PN-2000193 | |
| Buffer EB | Qiagen | 19086 | |
| cDNA Amplification Reaction Mix | 10X Genomics | przygotowane z Pre-Amp Mix i primerów 2 | Aby uzyskać łączną objętość 65 μL mieszanki do amplifikacji cDNA, wymieszaj 50 μL Amp Mix + 15 μL primerów cDNA Feature 2 |
| Cell Ranger Arc v2.0.2 | 10X Genomics | N/A | RRID:SCR_023897 |
| CFX Opus Real-Time PCR System | Bio-Rad | 12011319 | |
| Chromium Next GEM Chip J | 10X Genomics | PN 2000264 | |
| Chromium Next GEM Single Cell Multiome Gel Bead Kit | 10X Genomics | PN-1000231 | |
| Chromium Next GEM Single Cell Multiome GEM Kit | 10X Genomics | PN-1000232 | Zestaw zawiera następujące elementy: Barcoding Reagent Mix, Barcoding Enzyme Mix, Template Switch Oligo, Reducing Agent B, Cleanup Buffer i Quenching Agent |
| Chromium Recovery Agent | 10X Genomics | 220016 | |
| Cleanup Buffer | 10X Genomics | 2000088 | |
| Cryostat | Leica Biosystem | CM1860 | |
| DNA Ligase | 10X Genomics | 220110 | |
| DNA LoBind 1.5 mL tubes | Eppendorf | 22431021 | |
| Dual Index TT Set A | 10X Genomics | PN-3000431 | |
| Dynabeads® MyOne® SILANE to make Dynabeads Cleanup Mix | 10X Genomics | PN-2000048 | Aby uzyskać łączną objętość 200 μL mieszanki do czyszczenia Dynabeads, wymieszaj 182 μL buforu do czyszczenia + 13 μL Dynabeads Myone SILANE + 5 μL Reducing Agent B |
| Elution Solution I | 10X Genomics | Przygotowane z Bufferu EB | Aby uzyskać łączną objętość 100 μL Elution Solution I, wymieszaj 98 μL Bufferu EB + 1 μL 10% Tween 20 + 1 μL Reducing Agent B |
| Feature cDNA Primers 2 | 10X Genomics | 2000097 | |
| Fragmentation Buffer | 10X Genomics | 2000091 | |
| Fragmentation Enzyme | 10X Genomics | 2000090 | |
| Fragmentation Mix | 10X Genomics | Przygotowane z Bufferu do fragmentacji i enzymu | Aby uzyskać łączną objętość 15 μL mieszanki do fragmentacji, wymieszaj 5 μL Bufferu do fragmentacji + 10 μL enzymu do fragmentacji |
| Gasket, 6-pack | 10X Genomics | 370017 | |
| GEM Master Mix | 10X Genomics | PN-1000232 | Z zestawu Chromium Next GEM Single Cell Multiome GEM Kit (PN-1000232). Aby uzyskać łączną objętość 60 μL GEM Mater Mix, wymieszaj 49.5 μL Barcoding Reagent Mix + 1.1 μL Template Switch Oligo + 1.9 μL Reducing Agent B + 7.5 μL Barcoding Enzyme Mix |
| GEM-X Single-Cell 3' Feature Barcode Kit | 10X Genomics | PN 2000047 | |
| High Sensitivity NGS Fragment Analysis Kit | Advanced Analytical | DNF-474 | |
| Incubation Buffer | Epigenome Technology | CF1001 | Aby przygotować łączną objętość 100 μL buforu do inkubacji CUT&Tag I, wymieszaj 90.5 μL buforu do inkubacji (CF1001, Epigenome Technology) z 1.5 μL permeabilizer, 0.5 μL stabilizatora i 7.5 μL inhibitora RNAse |
| Invent Minute buffer A | Invent Biotechnologies, Inc | BN-020 | Z zestawu Minute Single Nucleus Isolation Kit (Cat. BN-020). Aby uzyskać łączną objętość 800 μL bufferu A, wymieszaj 786.4 μL Minute Buffer A + 13.6 μL inhibitora RNAse (Takara Bio) |
| Invent Minute Buffer B | Invent Biotechnologies, Inc | BN-020 | Z zestawu Minute Single Nucleus Isolation Kit (Cat. BN-020) |
Bibliografia
- Ståhl, P. L., et al. Visualization and analysis of gene expression in tissue sections by spatial transcriptomics. Science. 353 (6294), 78-82 (2016).
- Asp, M., et al. Spatial detection of fetal marker genes expressed at low level in adult human heart tissue. Sci Rep. 7 (1), 12941 (2017).
- Larsson, L., Frisén, J., Lundeberg, J. Spatially resolved transcriptomics adds a new dimension to genomics. Nat Methods. 18 (1), 15-18 (2021).
- Rodriques, S. G., et al. Slide-seq: A scalable technology for measuring genome-wide expression at high spatial resolution. Science. 363 (6434), 1463-1467 (2019).
- Moffitt, J. R., et al. Molecular, spatial, and functional single-cell profiling of the hypothalamic preoptic region. Science. 362 (6416), eaau5324 (2018).
- Kleshchevnikov, V., et al. Cell2location maps fine-grained cell types in spatial transcriptomics. Nat Biotechnol. 40 (5), 661-671 (2022).
- Liu, X., et al. Spatial multi-omics: deciphering technological landscape of integration of multi-omics and its applications. J Hematol Oncol. 17 (1), 72 (2024).
- Marx, V. Method of the Year: spatially resolved transcriptomics. Nat Methods. 18 (1), 9-14 (2021).
- Zhu, C., Preissl, S., Ren, B. Single-cell multimodal omics: the power of many. Nat Methods. 17 (1), 11-14 (2020).
- Klemm, S. L., Shipony, Z., Greenleaf, W. J. Chromatin accessibility and the regulatory epigenome. Nat Rev Genet. 20 (4), 207-220 (2019).
- Mimitou, E. P., et al. Scalable, multimodal profiling of chromatin accessibility, gene expression, and protein levels in single cells. Nat Biotechnol. 39 (10), 1246-1258 (2021).
- Deng, Y., et al. Spatial-CUT&Tag: Spatially resolved chromatin modification profiling at the cellular level. Science. 375 (6581), 681-686 (2022).
- Liu, Y., et al. High-Spatial-Resolution Multi-Omics Sequencing via Deterministic Barcoding in Tissue. Cell. 183 (6), 1665-1681.e18 (2020).
- Zhang, D., et al. Spatial epigenome-transcriptome co-profiling of mammalian tissues. Nature. 616 (7955), 113-122 (2023).
- Lee, C. N., Fu, H., Cardilla, A., Zhou, W., Deng, Y. Spatial joint profiling of DNA methylome and transcriptome in tissues. Nature. 646 (8087), 1261-1271 (2025).
- Russell, A. J. C., et al. Slide-tags enable single-nucleus barcoding for multimodal spatial genomics. Nature. 625 (7993), 101-109 (2024).
- Huang, Y. H., et al. Unified molecular approach for spatial epigenome, transcriptome, and cell lineages. Proc Natl Acad Sci U S A. 122 (16), e2424070122 (2025).
- Kaya-Okur, H. S., et al. CUT&Tag for efficient epigenomic profiling of small samples and single cells. Nat Commun. 10 (1), 1930 (2019).
- Xie, Y., et al. Droplet-based single-cell joint profiling of histone modifications and transcriptomes. Nat Struct Mol Biol. 30 (10), 1428-1433 (2023).
- Caride, A., et al. Titration-based normalization of antibody amount improves consistency of ChIP-seq experiments. BMC Genomics. 24 (1), 171 (2023).
- Zhong, J., et al. Enhanced and controlled chromatin extraction from FFPE tissues and the application to ChIP-seq. BMC Genomics. 20 (1), 249 (2019).
- Stuart, T., Srivastava, A., Madad, S., Lareau, C. A., Satija, R. Single-cell chromatin state analysis with Signac. Nat Methods. 18 (11), 1333-1341 (2021).
- Germain, P. L., Lun, A., Garcia Meixide, C., Macnair, W., Robinson, M. D. Doublet identification in single-cell sequencing data using scDblFinder. F1000Res. 10, 979 (2021).
- Thibodeau, A., et al. AMULET: a novel read count-based method for effective multiplet detection from single nucleus ATAC-seq data. Genome Biol. 22 (1), 252 (2021).
- Butler, A., Hoffman, P., Smibert, P., Papalexi, E., Satija, R. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 36 (5), 411-420 (2018).
- Yao, Z., et al. A high-resolution transcriptomic and spatial atlas of cell types in the whole mouse brain. Nature. 624 (7991), 317-332 (2023).
- Wang, Q., et al. The Allen Mouse Brain Common Coordinate Framework: A 3D Reference Atlas. Cell. 181 (4), 936-953.e20 (2020).
Przedruki i uprawnienia
