Niniejsza analiza bibliometricszna wykorzystała CiteSpace, VOSviewer i Scimago Graphica do oceny trendów publikacji, sieci współpracy i nowo powstających punktów gorących w badaniach nad reprogramowaniem metabolicznym limfocytów T w latach 2016–2025.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Analiza bibliometryczna przeprogramowania metabolicznego w limfocytach T ujawnia trendy badań i nowe trendy, 2016-2025
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Limfocyty T są centralnymi regulatorami reakcji odpornościowych, a ostatnie badania wykazały, że procesy metaboliczne wpływają na aktywację, różnicowanie i funkcję efektora limfocytów T w chorobach nowotworowych i autoimmunologicznych. W niniejszym badaniu przeprowadzono analizę bibliometryczną publikacji z dnia 1 stycznia 2016 r. do 31 grudnia 2025 r., pobranej z Web of Science Core Collection. Oprogramowanie CiteSpace zostało użyte do analizy współwystępowania, współcytowania i grupowania referencji i słów kluczowych. VOSviewer został zastosowany do analizy czasopism, autorów, referencji, krajów i instytucji, podczas gdy Scimago Graphica wizualizowało krajowe sieci współpracy, a Excel służył do oceny rocznych trendów publikacji. W sumie włączono 1882 publikacji. Roczna produkcja publikacji zwiększała się systematycznie, przy czym zauważalny wzrost zaobserwowano w 2021 i 2025 roku. Chiny miały największy wkład w liczbę publikacji, podczas gdy Stany Zjednoczone wykazały większy wpływ cytowań. Frontiers in Immunology było najbardziej produktywnym czasopismem, podczas gdy Nature wykazał najwyższy wpływ cytowań. Grupowanie słów kluczowych i analizy cytowań zidentyfikowały ewoluujące punkty gorące badań skoncentrowane na metabolizmie limfocytów T, metabolizmie glukozy i aminokwasów oraz rosnącym zainteresowaniem interakcjami metabolicznymi komórek odpornościowych. Ogólnie ta analiza bibliometryczna pokazuje ciągłą ekspansję badań nad immunometabolizmem limfocytów T i podkreśla pojawiające się kierunki tematyczne, w tym regulację metabolizmu międzykomórkowego i metabolizm lipidów.
Wprowadzenie
Naïwe limfocyty T w znacznym stopniu polegają na mitochondrialnej oksydacyjnej fosforylacji (OXPHOS), aby utrzymać swój stan spoczynkowy i niski metabolizm energetyczny1. Po stymulacji antygenowej, jednak, aktywne limfocyty T przechodzą przemianę metaboliczną w kierunku glikolizy tlenowej, aby wspierać szybkie proliferację i funkcję efektora2. Efektorowe limfocyty T, szczególnie podzbiory cytotoksyczne, polegają na glikolizie, aby sprostać zwiększonym wymaganiom bioenergetycznym i biosyntetycznym związanym z produkcją cytokin i ekspansją komórkową3. Mimo że glikoliza produkuje mniej adenozynotrifosforanu (ATP) na cząsteczkę glukozy niż OXPHOS, jej szybki szybkość metabolizmu wspiera funkcjonalne wymagania aktywowanych komórek odpornościowych4. Nadmierna aktywność glikolityczna może również przyczyniać się do szkodliwych efektów w mikrośrodowisku odpornościowym. Nagromadzenie mleczanu może upośledzić syntezę seryny pochodzącej z glukozy i zmienić wewnątrzkomórkową równowagę redoks, hamując w ten sposób proliferację i funkcję limfocytów T5. Ponadto, podwyższone poziomy mleczanu zakłócają zależne od glikolizy szlaki migracji i zmniejszają ruchliwość limfocytów T CD4⁺ i CD8⁺6,7.
Metabolizm komórkowy dynamicznie przystosowuje się do bodźców środowiskowych i fizjologicznych poprzez proces znany jako przeprogramowanie metaboliczne8,9. Coraz więcej dowodów wskazuje, że przeprogramowanie metaboliczne odgrywa kluczową rolę w regulacji aktywacji, różnicowania i funkcjonalnej elastyczności limfocytów T10,11. Te zmiany metaboliczne są szczególnie istotne w przypadku raka i chorób autoimmunologicznych, gdzie zmiany w mikrośrodowisku odpornościowym wpływają na funkcję limfocytów T i regulację odporności12,13. Mimo że kilka badań bibliometrycznych oceniło immunometabolizm w szerszych kontekstach, w tym immunometabolizm raka i metabolizm odpornościowy związany z chorobami, analizy te koncentrują się głównie na ogólnych interakcjach odpornościowo-metabolicznych, a nie na przeprogramowaniu metabolicznym specyficznym dla limfocytów T14,15. Kompleksowa ocena bibliometryczna poświęcona specjalnie immunometabolizmowi limfocytów T pozostaje ograniczona, szczególnie jeśli chodzi o trendy badawcze, sieci współpracy i ewoluujące tematyczne punkty gorące w tej dziedzinie.
Aby uzupełnić tę lukę, w niniejszym badaniu przeprowadzono analizę bibliometryczną publikacji zaindekszowanych w Web of Science Core Collection (WOScc) od 1 stycznia 2016 do 31 grudnia 2025. Do analizy ilościowej wyników publikacji, wzorców współpracy, relacji współcytowania i ewolucji tematycznej w badaniach nad przeprogramowaniem metabolicznym limfocytów T wykorzystano CiteSpace, VOSviewer oraz Scimago Graphica. W przeciwieństwie do tradycyjnych przeglądów narracyjnych, analiza bibliometryczna zapewnia ustrukturyzowany i oparty na danych przegląd krajobrazu naukowego poprzez analizy cytowań, klastrowania i słów kluczowych. Celem niniejszego badania było systematyczne scharakteryzowanie globalnych trendów badawczych i wschodzących punktów gorących w immunometabolizmie limfocytów T oraz dostarczenie zorganizowanego przeglądu aktualnego krajobrazu wiedzy w tej szybko ewoluującej dziedzinie.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu analizowano wyłącznie dane bibliograficzne pobrane z publicznie dostępnych baz danych, a proces ten nie obejmował udziału ludzi, zwierząt ani identyfikowalnych danych osobowych; w związku z tym nie wymagano zgody komisji etycznej ani świadomej zgody uczestników.
Gromadzenie danych i strategia wyszukiwania
Dane zostały pobrane z bazy WoSCC (https://www.webofscience.com/wos/woscc/) w dniu 27 stycznia 2026 r. Wybrano edycje bazy Science Citation Index Expanded (SCI-EXPANDED) oraz Social Sciences Citation Index w ramach WoSCC. Wyszukiwanie przeprowadzono za pomocą interfejsu Advanced Search. Strategię wyszukiwania zastosowano w polu „Topic (TS)”, a pełne zapytanie oraz uzyskane rekordy przedstawiono w Tabeli 1. Okres wyszukiwania ograniczono do publikacji indeksowanych między 1 stycznia 2016 r. a 31 grudnia 2025 r., korzystając z filtra „Timespan” w WoSCC. Za pomocą filtra „Document Types” do analizy włączono wyłącznie oryginalne artykuły badawcze i artykuły przeglądowe. Język ograniczono do angielskiego; nie stosowano żadnych ograniczeń dotyczących kraju, instytucji ani dziedziny badawczej. Wszystkie rekordy wyeksportowano w formacie tekstowym, wybierając opcję „Full Record and Cited References”. W przypadku, gdy liczba pobranych rekordów przekroczyła 500, dane pobierano w kilku partiach, a następnie scalano je w jeden zestaw danych przed analizą. Po pobraniu wszystkie rekordy zaimportowano do programu CiteSpace w celu wstępnego przetwarzania i analizy bibliometrycznej. Duplikaty zidentyfikowano i usunięto za pomocą wbudowanej funkcji deduplikacji w CiteSpace na podstawie metadanych bibliograficznych, w tym tytułu, autorów, roku publikacji i czasopisma źródłowego. W przypadku wykrycia potencjalnych niespójności lub niepełnych rekordów bibliograficznych przeprowadzono dodatkową weryfikację ręczną, aby zapewnić dokładność i spójność danych przed analizą.
| Zbiór | Wyniki | Zapytanie wyszukiwania |
| #1 | 252,461 | TS=("komórka T*" OR "komórka T-*" OR "limfocyt T*" OR "limfocyt T-*" OR "limfocyt T-*" OR "komórka T CD4+*" OR "komórka T CD8+*" OR "cytotoksyczna komórka T*" OR "regulacyjna komórka T*" OR "Treg*" OR "komórka T pomocnicza*" OR "komórka Th*" OR "naiwna komórka T*" OR "komórka T pamięci*" OR "efektorowa komórka T*") |
| #2 | 13,799 | TS=("przeprogramowanie metaboliczne" OR "przebudowa metaboliczna" OR "reorganizacja metaboliczna") |
| #3 | 1,882 | #1 I #2 |
Tabela 1: Strategia wyszukiwania w bazie Web of Science Core Collection zastosowana do pozyskania danych bibliometrycznych. Tabela przedstawia szczegółową strategię wyszukiwania, kombinacje słów kluczowych, operatory Boole'a oraz końcową liczbę pozyskanych rekordów wykorzystanych do gromadzenia literatury z WoSCC. Wyszukiwanie przeprowadzono w polu „Temat (TS)” w interfejsie zaawansowanego wyszukiwania. Znaki wieloznaczne (*) zostały użyte w celu wyszukiwania wielu końcówek słów i powiązanej terminologii. Końcowy zbiór danych składał się z publikacji indeksowanych między 1 stycznia 2016 r. a 31 grudnia 2025 r., po zastosowaniu filtrów językowych oraz filtrów typu dokumentu.
Podejścia analityczne
Do analizy danych systematycznie wdrożono wielonarzędziowe podejście bibliometryczne. Analizę przeprowadzono w środowisku systemu operacyjnego Windows 10. Do analizy referencji i słów kluczowych wykorzystano program CiteSpace (v.5.7.R2), przetwarzając dane w formacie TXT wyeksportowane z WoSCC. Parametry CiteSpace skonfigurowano w następujący sposób: (1) wycinki czasowe (time slicing) ustawiono od 2016 do 2025 roku z interwałem jednego roku na wycinek; (2) kryteria wyboru skonfigurowano przy użyciu g-index (k = 25); (3) metody przycinania (pruning) obejmowały Pathfinder, Pruning Sliced Networks oraz Pruning the Merged Network w celu uproszczenia struktur sieci przy jednoczesnym zachowaniu kluczowych relacji; (4) analizę klastrowania przeprowadzono za pomocą algorytmu log-likelihood ratio16. Analiza ta pozwoliła na wygenerowanie sieci współcytowań, map klastrowania, wizualizacji osi czasu oraz map detekcji gwałtownych wzrostów (burst detection) dla referencji i słów kluczowych. Na mapach wizualizacji rozmiar węzła reprezentował częstotliwość, grubość połączenia wskazywała siłę współwystępowania, a fioletowe pierścienie oznaczały wysoką centralność pośrednictwa (betweenness centrality). Węzły typu burst odzwierciedlały nagły wzrost częstotliwości cytowań lub występowania słów kluczowych w czasie.
Następnie wyeksportowane pliki zapisano ponownie w kodowaniu UTF-8 przy użyciu Notatnika systemu Windows i zaimportowano do programu VOSviewer (wersja 1.6.20) w celu mapowania bibliometrycznego, obejmującego analizy współautorstwa, współcytowań i współwystępowania w odniesieniu do autorów, czasopism, instytucji i krajów17. Zastosowano metodę pełnego zliczania (full-counting), a normalizację przeprowadzono metodą siły powiązań (association-strength). Minimalne progi występowania ustalono zgodnie z rozmiarem zbioru danych (autorzy ≥ 5 publikacji; słowa kluczowe ≥ 5 wystąpień; instytucje ≥ 3 publikacje). Wizualizacja sieci opierała się na wadze elementów i całkowitej sile powiązań. Do analizy współpracy na poziomie krajów pliki GML wyeksportowane z VOSviewer zaimportowano do programu Scimago Graphica (wersja 1.0.53), w którym węzły reprezentowały kraje. Wizualizację sieci i klastrowanie wygenerowano przy użyciu domyślnego algorytmu rozmieszczenia siłowego (force-directed layout), aby przedstawić relacje przestrzenne i wzorce współpracy między krajami. Do opisowej analizy statystycznej rocznych trendów publikacji oraz podstawowego podsumowania danych wykorzystano program WPS Excel. Wyniki zwizualizowano za pomocą wykresów słupkowych i liniowych.
Uzupełniającą analizę w ujęciu czasowym przeprowadzono przy użyciu tej samej strategii wyszukiwania opisanej powyżej, ograniczając wyszukiwanie do publikacji zaindeksowanych między 1 stycznia 2025 r. a 31 grudnia 2025 r. W ramach tego samego zapytania WoSCC i środowiska analitycznego pobrano niedawne publikacje oraz materiały konferencyjne w celach kontekstowych i opisowych. Procedura ta została przeprowadzona w całości w wbudowanym interfejsie analitycznym WoSCC. Nie utworzono niezależnego zbioru danych, a pobrane informacje nie zostały zintegrowane z głównym bibliometrycznym zbiorem danych ani wykorzystane do analizy ilościowej. Ogólny projekt badania oraz przebieg analizy bibliometrycznej przedstawiono na schemacie blokowym (Rycina 1).
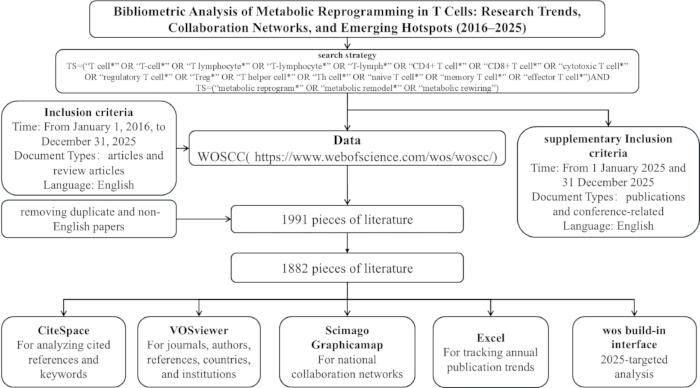
Rysunek 1. Schemat analizy bibliometrycznej badań nad przeprogramowaniem metabolicznym limfocytów T. Schematyczny przegląd projektu badania i procesu analitycznego wykorzystanego w niniejszej analizie bibliometrycznej. Publikacje pobrano z bazy Web of Science Core Collection (WoSCC), stosując zdefiniowane strategie wyszukiwania i kryteria włączenia. Pobrane rekordy wyeksportowano w formacie tekstowym, a następnie poddano wstępnemu przetwarzaniu, obejmującemu usuwanie duplikatów i standaryzację danych bibliograficznych. Analizy bibliometryczne przeprowadzono przy użyciu oprogramowania CiteSpace w celu analizy współcytowań, współwystępowania słów kluczowych, klasteryzacji i wykrywania gwałtownych wzrostów liczby publikacji (burst detection), a także VOSviewer do analizy sieci współpracy pomiędzy autorami, instytucjami, krajami i czasopismami. Do wizualizacji międzynarodowych sieci współpracy wykorzystano Scimago Graphica, natomiast do analizy rocznych trendów publikacyjnych i statystyk opisowych użyto WPS Excel. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Liczba publikacji i trendy czasowe
W celu scharakteryzowania ewolucji czasowej aktywności badawczej w tej dziedzinie przeprowadzono analizę bibliometryczną z wykorzystaniem publikacji indeksowanych w WoSCC. Wstępnie wyszukano łącznie 1 991 rekordów z ostatniej dekady. Po usunięciu duplikatów oraz rekordów nieanglojęzycznych do końcowej analizy włączono 1 882 publikacje, w tym 1 046 oryginalnych artykułów badawczych i 836 artykułów przeglądowych. Roczne trendy publikacji i cytowań od 2016 do 2025 roku...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Nasza analiza bibliometricszna dotycząca przeprogramowania metabolicznego w komórkach T ujawniła utrzymujący się wzrost wydajności badań w czasie. Zauważalny wzrost liczby publikacji i cytowań miał miejsce w 2020 roku, z 40 dodatkowymi publikacjami i 1989 dodatkowymi cytowaniami w porównaniu z 2019 rokiem. Ten wzrost zbiegł się czasowo z kilkoma bardzo cytowanymi publikacjami, w tym Glutamine blockade induces divergent metabolic programs to overcome tumor immune evasion (opublikowana 22 listopada 2019)
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Konflikt interesów:
Autorzy deklarują brak konfliktów interesów związanych z tą pracą.
Wkład autorów:
Zbieranie danych i pozyskiwanie literatury zostało przeprowadzone przez Yi Liu. Przetwarzanie danych i analizy bibliometryczne przeprowadziła Yinping Yang. Wizualizacje oraz przygotowanie rysunków zostały wykonane przez Xinyue Yang i Jinquan Li. Pierwszy szkic manuskryptu został napisany przez Yi Liu i Weihong Li. Wszyscy autorzy przyczynili się do poprawki manuskryptu i zatwierdzili ostateczną wersję przedłożoną do publikacji.
Podziękowania
Autorzy z wdzięcznością przyjmują wsparcie finansowe ze środków Badań Podstawowych dla Centralnych Uniwersytetów (2022-JYB-JBZR-037).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CiteSpace | Drexel University | v.5.7.R2 | SCR_025121 |
| Microsoft Excel | Microsoft Corporation | v.2604 Build 16.0.19929.20136 | SCR_016137 (Microsoft Excel) |
| WPS Excel | Kingsoft Office | v.12.1.0.26375 | |
| Scimago Graphica | Scimago Lab | v.1.0.53 | Niedostępne |
| VOSviewer | Leiden University | v.1.6.20 | SCR_023516 |
| Web of Science Core Collection | Clarivate Analytics | dostęp: 27 stycznia 2026; wersja nie dotyczy | Niedostępne |
| Windows Operating System | Microsoft Corporation | Windows 10 | Niedostępne |
Bibliografia
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
- Wang R, et al. The transcription factor Myc controls metabolic reprogramming upon T-lymphocyte activation. Immunity. 2011;35(6):871-82.
- Shyer JA, et al. Metabolic signaling in T cells. Cell Res. 2020;30(8):649-59.
- Gubser PM, et al. Rapid effector function of memory CD8+ T cells requires an immediate-early glycolytic switch. Nat Immunol. 2013;14(10):1064-72.
- Yuan Q, et al. Enhancing intracellular NADPH bioavailability through improving pentose phosphate pathway flux and its application in biocatalysis asymmetric reduction reaction. J Biosci Bioeng. 2022;134(6):528-33.
- Quinn WJ III, et al. Lactate limits T-cell proliferation via the NAD(H) redox state. Cell Rep. 2020;33(11):108500.
- Pucino V, et al. Lactate buildup at the site of chronic inflammation promotes disease by inducing CD4+ T-cell metabolic rewiring. Cell Metab. 2019;30(6):1055-74.e8.
- O'Neill LAJ, et al. A guide to immunometabolism for immunologists. Nat Rev Immunol. 2016;16(9):553-65.
- Almeida L, et al. Metabolic pathways in T-cell activation and lineage differentiation. Semin Immunol. 2016;28(5):514-24.
- Haas R, et al. Lactate regulates metabolic and pro-inflammatory circuits in control of T-cell migration and effector functions. PLoS Biol. 2015;13(7):e1002202.
- Chang CH, Pearce EL. Emerging concepts of T-cell metabolism as a target of immunotherapy. Nat Immunol. 2016;17(4):364-68.
- Ho PC, et al. Reenergizing T-cell anti-tumor immunity by harnessing immunometabolic checkpoints and machineries. Curr Opin Immunol. 2017;46:38-44.
- Von Meyenn L, et al. Targeting T-cell metabolism in inflammatory skin disease. Front Immunol. 2019;10:2285.
- Zhu H, et al. Trends and hotspots in research related to tumor immune escape: bibliometric analysis and future perspectives. Front Immunol. 2025;16:1604216.
- Zhang B, et al. Mapping research trends in immune-cell metabolic reprogramming in breast cancer: a parallel dual-database bibliometric study. Discov Oncol. 2026;17:724.
- Chen G, et al. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-27.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-71.
- Leone RD, et al. Glutamine blockade induces divergent metabolic programs to overcome tumor immune evasion. Science. 2019;366(6468):1013-21.
- Watson MJ, et al. Metabolic support of tumour-infiltrating regulatory T cells by lactic acid. Nature. 2021;591(7851):645-51.
- Xia L, et al. The cancer metabolic reprogramming and immune response. Mol Cancer. 2021;20(1):28.
- Miao S, et al. tRNA m1A modification regulates cholesterol biosynthesis to promote antitumor immunity of CD8+ T cells. J Exp Med. 2025;222(3):e20240559.
- Angelin A, et al. Foxp3 reprograms T-cell metabolism to function in low-glucose, high-lactate environments. Cell Metab. 2017;25(6):1282-93.e7.
- Huang SC, et al. Metabolic reprogramming mediated by the mTORC2-IRF4 signaling axis is essential for macrophage alternative activation. Immunity. 2016;45(4):817-30.
- Nakaya M, et al. Inflammatory T-cell responses rely on amino acid transporter ASCT2 facilitation of glutamine uptake and mTORC1 kinase activation. Immunity. 2014;40(5):692-705.
- Ma EH, et al. Serine is an essential metabolite for effector T-cell expansion. Cell Metab. 2017;25(2):345-57.
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.