W niniejszym badaniu, poprzez porównanie wyników detekcji 24 hodowli zawiesin bakteryjnych Helicobacter pylori (H. pylori) uzyskanych za pomocą metod detekcji antygenu oraz cyfrowego PCR, przeanalizowano ich korelacje w celu zbadania ich znaczenia w charakterystyce materiałów referencyjnych H. pylori oraz w diagnostycznej ocenie in vitro.
Artykuł badawczy
Korelacja miana antygenu H. pylori z ilościowym oznaczeniem metodą cyfrowej reakcji łańcuchowej polimerazy: ocena analityczna hodowlanych, inaktywowanych izolatów
W tym artykule
Podsumowanie
Streszczenie
Standaryzacja diagnostyki Helicobacter pylori (H. pylori) pozostaje wyzwaniem w przypadku heterogenicznych testów detekcyjnych. Immunochromatografia wykrywa antygeny specyficzne dla H. pylori, ale dostarcza jedynie wyników jakościowych, które są podatne na interferencje ze strony rozpuszczalnych białek bakteryjnych niebędących celem testu poprzez wiązanie niespecyficzne lub inhibicję konkurencyjną. W przeciwieństwie do niej, cyfrowy PCR (dPCR) umożliwia precyzyjną kwantyfikację kopii genomowego DNA, identyfikując zarówno bakterie żywe, jak i nieżywe. W niniejszym badaniu porównano miana punktowe otrzymane metodą immunochromatograficzną (wartości półilościowe obliczone jako odwrotność najwyższego wykrywalnego dwukrotnego rozcieńczenia seryjnego) z liczbą kopii kwasów nukleinowych określoną za pomocą dPCR. Dwadzieścia cztery zawiesiny bakteryjne H. pylori, hodowane przez 72 h w temperaturze 37 °C na agarze Brucella z dodatkiem 5% defibrynowanej krwi owczej w warunkach mikroaerofilnych (85% N2, 10% CO2, 5% O2), poddano równoległemu badaniu antygenowemu oraz pomiarowi dPCR. Do oceny statystycznej zastosowano korelację Pearsona i regresję liniową. Zaobserwowano istotną dodatnią korelację między mianem antygenu a liczbą kopii genomowych (r = 0,536, n = 24, P = 0,007). Jednak niski współczynnik determinacji (R2 = 0,287) wykazał ograniczoną zdolność prognostyczną, ponieważ miano antygenu odpowiadało za zaledwie 29% wariancji mierzonej przez dPCR i nie może stanowić podstawy do wiarygodnej predykcji dla pojedynczej próbki. Rozbieżne profile z wysokim wynikiem dPCR i niskim mianem mogą wynikać z obecności szczątków nieżywych bakterii lub wolnego DNA genomowego. Testy oparte na antygenach i kwasach nukleinowych kwantyfikują analitycznie powiązane, lecz niewymienne substancje. W celu opracowania materiałów referencyjnych i walidacji testów diagnostycznych sugeruje się wieloparametryczną charakterystykę łączącą jednostki tworzące kolonie, miana antygenów i liczbę kopii genomu. Praca ta podkreśla konieczność opracowania specyficznych dla H. pylori konsensusowych wytycznych w celu rozwiązania rozbieżności diagnostycznych.
Wprowadzenie
Helicobacter pylori (H. pylori) to mikroaerofilny, Gram-ujemny pręcik, który powszechnie kolonizuje ludzki przewód pokarmowy, w szczególności antrum żołądka. Jest on główną przyczyną przewlekłego zapalenia żołądka, wrzodów peptycznych oraz raka żołądka1,2. Transmisja H. pylori między ludźmi odbywa się głównie drogą oralno-oralną lub fekalno-oralną; bakteria ta występuje na całym świecie, a wskaźniki zakażeń różnią się w zależności od regionu. W krajach rozwiniętych wskaźnik zakażeń wynosi około 50%, podczas gdy w niektórych krajach rozwijających się może on osiągać nawet 80%3. W 1994 roku Światowa Organizacja Zdrowia (WHO) zaklasyfikowała H. pylori jako kancerogen Grupy 1 w odniesieniu do raka żołądka4. Kluczowe czynniki wirulencji, takie jak CagA (antygen A związany z cytotoksyną) i VacA (cyto-toksyna wakuolizująca A), napędzają przewlekły stan zapalny i uszkodzenia nabłonka, przyczyniając się do mechanizmów patogennych, które uzasadniają klasyfikację bakterii jako kancerogenu Grupy 1. W 2018 roku liczba przypadków nowotworów przypisywanych zakażeniu H. pylori wyniosła 810 000, co przekroczyło łączną liczbę przypadków raka szyjki macicy i wątroby spowodowanych przez wirus papilomaty ludzki (HPV), wirus zapalenia wątroby B (HBV) oraz wirus zapalenia wątroby C (HCV)5. Statystyka ta podkreśla znaczne ryzyko nowotworowe stwarzane przez H. pylori, które w przypadku braku leczenia może prowadzić do raka żołądka z prawdopodobieństwem około 1%–3% według niektórych badań. Wysoka globalna rozpowszechnienie zakażeń H. pylori sprawia, że precyzja w kwantyfikacji – a nie tylko detekcja – jest priorytetem zdrowia publicznego, ponieważ dokładna ocena ładunku bakteryjnego może kierować decyzjami terapeutycznymi i pomagać w unikaniu niepotrzebnych lub niepowodzeń w terapiach eradykacyjnych. Dlatego precyzyjna detekcja i kwantyfikacja H. pylori mają ogromne znaczenie dla badań epidemiologicznych, wyboru planów leczenia oraz oceny skuteczności terapeutycznej.
Biorąc pod uwagę znaczne obciążenie nowotworami przypisywane H. pylori, dokładna detekcja i kwantyfikacja są kluczowe dla nadzoru epidemiologicznego, wyboru metody leczenia oraz monitorowania terapeutycznego. Obecne metody nieinwazyjne obejmują test na obecność antygenu w kale (SAT), test oddechowy z mocznikiem oraz analizy molekularne. Choć cyfrowa PCR (dPCR) oferuje wysoką precyzję i kwantyfikację bezwzględną, jej zastosowanie kliniczne jest ograniczone przez wyższy koszt, złożoność techniczną i wymagania sprzętowe w porównaniu z SAT. Ta rozbieżność sprawia, że konieczne jest zbadanie korelacji między tymi dwiema metodami, w celu poprawy standaryzacji SAT z wykorzystaniem dPCR jako referencji ilościowej.
Cyfrowa PCR (dPCR), rozwijająca się technologia kwantyfikacji absolutnej, umożliwia bezpośrednie wykrycie absolutnej liczby kopii genów docelowych bez konieczności stosowania krzywej wzorcowej. W badaniach nad H. pylori dPCR była wykorzystywana do kwantyfikacji bakterii w błonie śluzowej żołądka, ślinie oraz próbkach kału6,7.
W procesie opracowywania, oceny jakości oraz regulacji odczynników do diagnostyki in vitro, przygotowanie i kalibracja materiałów odniesienia są fundamentalne dla zapewnienia dokładności, porównywalności i identyfikowalności wyników. W przypadku bakteryjnych odczynników do diagnostyki in vitro (takich jak odczynniki do wykrywania antygenów/przeciwciał H. pylori), materiały odniesienia często muszą zawierać szczepy lub próbki kliniczne o ściśle określonych stężeniach lub jednostkach aktywności. Tradycyjną metodą ilościowego oznaczania bakterii jest metoda jednostek tworzących kolonie (CFU/mL), która bezpośrednio odzwierciedla liczbę żywych bakterii z zdolnością do proliferacji i jest często stosowana do wyznaczania wartości wzorców bakteryjnych, oceny czułości odczynników oraz porównywania metodologicznego8. Mimo że CFU jest nadal powszechnie stosowane, wykazuje ono wyraźne ograniczenia w zakresie czasu detekcji, zużycia materiałów oraz kosztów pracy9.
Wraz z szerszym zastosowaniem technologii diagnostyki in vitro, metody molekularne, takie jak dPCR, pozwalają obecnie na ilościowe oznaczanie patogenów z większą dokładnością i czułością. Jednocześnie w praktyce klinicznej coraz częściej stosuje się metody immunologiczne, takie jak miareczkowanie antygenów. Jednak w operacjach praktycznych większość pobranych izolatów klinicznych lub przygotowanych próbek standardowych to próbki inaktywowane lub przechowywane długotrwale, co utrudnia lub uniemożliwia prowadzenie hodowli żywych bakterii oraz liczenie CFU10. Podczas przygotowywania materiałów odniesienia, w celu spełnienia wymogów bezpieczeństwa biologicznego i zapewnienia długoterminowej stabilności materiałów, konieczne jest przeprowadzenie inaktywacji. Metody ilościowe oparte na antygenach lub kwasach nukleinowych stają się zatem niezbędnymi środkami do określania wartości8,11.
Rodzi to praktyczne pytanie dotyczące korelacji i równoważności tych dwóch odrębnych podejść ilościowych: czy przy użyciu detekcji antygenu oraz dPCR do oceny substancji wzorcowych istnieje stabilna i mierzalna zależność między wynikami tych dwóch metod? Wstępne eksperymenty z wykorzystaniem ograniczonego zestawu próbek inaktywowanego H. pylori wykazały spójną dodatnią korelację między intensywnością sygnału w testach immunochromatograficznych a liczbą kopii DNA określoną za pomocą dPCR. Postawiliśmy hipotezę, że w inaktywowanych próbkach bakteryjnych istnieje istotna i spójna dodatnia korelacja między mianem antygenu H. pylori, zmierzonym testami immunochromatograficznymi, a liczbą kopii DNA, określoną za pomocą dPCR. Istnienie takiej korelacji umożliwiłoby przeliczenie jakościowych wyników opartych na antygenie na ilościowe odpowiedniki kwasów nukleinowych. Stanowi to ważną podstawę do oceny wydajności odczynników, ustalania standardów, wyznaczania materiałów referencyjnych oraz interpretacji wyników testów klinicznych w sytuacjach, gdy tradycyjna hodowla nie jest możliwa.
Obecnie badania nad związkiem między wynikami wykrywania antygenu H. pylori a zawartością kwasów nukleinowych są niewystarczające, a brakuje systematycznych danych wspierających prace nad przeglądem, regulacją i standaryzacją. Aby przetestować tę hipotezę, w niniejszym badaniu przeprowadzono równoległe testy 24 kultur zawiesin bakteryjnych H. pylori w celu systematycznej analizy korelacji między mianem antygenu wykrytym metodą koloidalnej immunochromatografii a wynikiem ilościowym dPCR. Na podstawie uzyskanych wyników sformułowano opinie referencyjne dotyczące oceny wydajności odczynników do wykrywania H. pylori oraz przypisywania wartości materiałom wzorcowym.
Protokół
Wszystkie izolaty Helicobacter pylori włączone do niniejszego badania zostały pierwotnie wyizolowane z ludzkich próbek biopsji żołądka oraz próbek kałowych w Piątym Szpitalu Afiliacyjnym Uniwersytetu w Zhengzhou, który dostarczył w pełni przetworzone, zanonimizowane zawiesiny bakteryjne do naszych eksperymentów in vitro. Wszystkie pierwotne procedury (pobieranie próbek klinicznych, izolacja bakterii i początkowa kriokonserwacja) zostały zatwierdzone przez Komitet Etyki Piątego Szpitala Afiliacyjnego Uniwersytetu w Zhengzhou (numer zgody etycznej: KY2026080). Przed pobraniem próbek od wszystkich uczestników uzyskano świadomą zgodę, a wszystkie procedury były ściśle zgodne z Deklaracją Helsińską oraz odpowiednimi krajowymi wytycznymi etycznymi dotyczącymi badań biomedycznych. Wszystkie informacje umożliwiające identyfikację pacjentów zostały trwale usunięte przez szpital źródłowy przed przekazaniem próbek; tożsamość poszczególnych pacjentów nie może zostać wywnioskowana z materiałów eksperymentalnych ani wyników przedstawionych w niniejszym badaniu.
Niniejsze badanie nie wymaga dodatkowej, niezależnej zgody komisji etycznej ani świadomej zgody uczestników. Wszystkie eksperymenty obejmują wyłącznie testy in vitro z wykorzystaniem zanonimizowanych zawiesin bakteryjnych, bez dostępu do oryginalnych próbek ludzkich, dokumentacji klinicznej pacjentów czy prywatnych danych osobowych. Zgodnie z krajowymi przepisami dotyczącymi etyki badań biomedycznych, nieinterwencyjne badania in vitro z wykorzystaniem w pełni zanonimizowanych izolatów drobnoustrojowych spełniają kryteria zwolnienia z wymogów etycznych. Pierwotna zgoda etyczna wydana przez Piąty Szpital Filiacyjny Uniwersytetu w Zhengzhou obejmuje już wszystkie dopuszczalne wtórne zastosowania akademickie tych zanonimizowanych szczepów, co zostało oficjalnie potwierdzone przez instytucjonalną komisję etyki.
Wszystkie H. pylori in vitro eksperymenty przeprowadzono w laboratoriach z aktualnym certyfikatem bezpieczeństwa biologicznego (poziom bezpieczeństwa biologicznego 2, BSL-2, Beijing Dongcheng District Health Commission Laboratory Biosafety Filing [2020] No. 059), zgodnie z instytucjonalnymi standardowymi procedurami operacyjnymi oraz z zachowaniem wszystkich wymagań dotyczących przeglądu i autoryzacji bezpieczeństwa biologicznego. Zatwierdzenie w zakresie bezpieczeństwa biologicznego dla niniejszego badania obejmuje wszystkie procedury z wykorzystaniem inaktywowanego termicznie H. pylori materiał, w tym praca z materiałem, który nie został w pełni inaktywowany (tj. zawierał pozostałe żywe organizmy, co potwierdzono za pomocą PCR żywotności). Przez cały okres trwania badania ściśle przestrzegano standardowych praktyk mikrobiologicznych, wymogów dotyczących środków ochrony indywidualnej (PPE) oraz procedur dekontaminacji odpadów. Wszystkie próbki bakterii zostały odpowiednio inaktywowane przed utylizacją, zgodnie z instytucjonalnymi wytycznymi dotyczącymi gospodarowania odpadami biologicznymi. Szczegółowe informacje na temat wszystkich odczynników, sprzętu oraz oprogramowania wykorzystanego do analizy statystycznej znajdują się w Tabela materiałów.
Szczep i hodowla
UWAGA: H. pylori jest patogenem ludzkim z grupy ryzyka 2. Wszystkie manipulacje z żywymi kulturami (inokulacja, inkubacja i przygotowanie zawiesiny) muszą być przeprowadzane w certyfikowanej komorze bezpieczeństwa biologicznego w laboratoriach poziomu BSL-2, z zastosowaniem fartucha laboratoryjnego, rękawiczek i ochrony oczu.
Inaktywacja termiczna w temperaturze 56 °C przez 25 min drastycznie redukuje, ale nie eliminuje całkowicie żywych organizmów (patrz sekcja 1); częściowo inaktywowane zawiesiny muszą być nadal traktowane zgodnie z warunkami BSL-2. Wszystkie odpady biologiczne i zanieczyszczone materiały eksploatacyjne muszą zostać poddane autoklawowaniu (121 °C, ≥30 min) lub zdezynfekowane zgodnie z instytucjonalnymi procedurami bezpieczeństwa biologicznego przed utylizacją. Praca w standardzie BSL-2 opisana w niniejszym materiale została autoryzowana na podstawie tego samego zgłoszenia dotyczącego bezpieczeństwa biologicznego (Beijing Dongcheng District Health Commission Laboratory Biosafety Filing [2020] No. 059).
The Helicobacter pylori szczepy wykorzystane w niniejszym badaniu obejmowały 24 hodowle zawiesin bakteryjnych, które zostały pierwotnie pozyskane z biopsji żołądka oraz próbek kału pobranych przez Fifth Affiliated Hospital of Zhengzhou University, a następnie przekazane w formie zawiesiny bakteryjnej do kolekcji szczepów In vitro Zakład Diagnostyki Chorób Zakaźnych Narodowego Instytutu Kontroli Leków (NIDC), Pekin, Chiny, a wszystkie prace eksperymentalne w niniejszym badaniu zostały przeprowadzone w NIDC (Pekin, Chiny). Szczepy te zaszczepiono na płytki z podłożem Brucella uzupełnionym 5% odtłuszczonej krwi owczej i inkubowano w warunkach mikroaerofilnych (85% N₂, 10% CO₂, 5% O2₂) w 37 °C przez 72 h. Ten czas inkubacji odpowiada stacjonarnej fazie wzrostu, podczas której ekspresja antygenów każdego szczepu jest stosunkowo stabilna. Następnie zebrano zawiesiny bakteryjne.
Inaktywację termiczną przeprowadzono w cyfrowej łaźni wodnej w temperaturze 56 °C przez 25 min. Zabieg ten wykonano w celu spełnienia wymogów bezpieczeństwa biologicznego oraz zapewnienia długoterminowej stabilności materiałów referencyjnych. Inaktywacja termiczna w 56 °C przez 25 min drastycznie zmniejsza żywotność bakterii, ale nie eliminuje całkowicie wszystkich żywych organizmów, co potwierdzono w późniejszej analizie PCR żywotności, w której zmierzono medianę pozostałej frakcji żywych komórek na poziomie 4,6% (zakres 0,00%–33,00%) w 24 hodowlach zawiesin bakteryjnych (patrz sekcja 6 Wyników oraz Dyskusja). Zgoda w zakresie bezpieczeństwa biologicznego dla niniejszego badania obejmuje pracę z materiałem, który nie został w pełni zinaktywowany (patrz Oświadczenie dotyczące etyki i bezpieczeństwa biologicznego). Potencjalny wpływ inaktywacji termicznej na wykrywanie antygenów uznano za minimalny, ponieważ obróbka termiczna odbywa się poniżej progu denaturacji większości antygenów powierzchniowych H. pylori; może ona jednak wpływać na integralność niektórych termolabilnych antygenów białkowych. W przypadku ilościowego oznaczania DNA inaktywacja termiczna nie powoduje degradacji DNA genomowego i może w rzeczywistości poprawić wydajność ekstrakcji poprzez rozbicie błon komórkowych.
Wykrywanie antygenu
Zebrane 24 zawiesiny bakteryjne rozcieńczono 100-krotnie w PBS w celu przygotowania próbek do wykrywania antygenu. Wstępne 100-krotne rozcieńczenie dostosowuje stężenie antygenu do liniowego zakresu detekcji komercyjnych zestawów i minimalizuje interferencję matrycy, zapewniając tym samym wiarygodne i dokładne wyniki detekcji. Rozcieńczenie pozwala również na oszczędność objętości próbki. Próbki te przetestowano przy użyciu ośmiu zarejestrowanych zestawów do wykrywania antygenu H. pylori (Tabela 1), obejmujących metodę koloidalnego złota, metodę lateksową oraz metodę immunochromatograficzną. W przypadku wyniku dodatniego, rozcieńczoną próbkę poddano rozcieńczeniom seryjnym (1:2, 1:4, 1:8 itd.) i testowano do momentu uzyskania wyniku ujemnego. Najwyższy stopień rozcieńczenia, który pozostał dodatni, odnotowano i zdefiniowano jako „ostateczny dodatni stopień rozcieńczenia antygenu” (np. 1:64). Dwukrotne rozcieńczenia seryjne przygotowano w roztworze soli fosforanowej (PBS, 0,01 M, pH 7,2–7,4). Po naniesieniu próbki każdy pasek inkubowano w temperaturze pokojowej przez 15–20 min przed odczytem; wynik odczytywał wizualnie przeszkolony operator w odniesieniu do linii kontrolnej, a punkt końcowy zapisano jako najwyższe rozcieńczenie wykazujące widoczną linię testową. Ponieważ paski z koloidalnym złotem są odczytywane wizualnie, wartość odcięcia (cut-off) zależy od operatora.
Dla każdej próbki przebadanej przy użyciu wielu komercyjnych zestawów do wykrywania antygenów, miano końcowe zdefiniowano jako medianę mian wszystkich poszczególnych zestawów. Ponieważ osiem zestawów użytych w niniejszym badaniu zostało zaprojektowanych z różnymi antygenami docelowymi i zasadami detekcji, do określenia spójności między zestawami nie wykorzystano współczynnika Kappa Cohena ani CV%, ponieważ wskaźniki te zakładają istnienie wspólnego standardu odniesienia. Zatem zaobserwowana zmienność między zestawami odzwierciedla rzeczywistą heterogeniczność biologiczną i analityczną, a nie błędy pomiarowe. Mediana, jako odporna miara tendencji centralnej, może skutecznie niwelować odchylenia specyficzne dla konkretnych zestawów. Wśród 24 próbek rozstęp w obrębie jednej próbki między najwyższym a najniższym mianem z zestawów wynosił od 2- do 16-krotności (mediana: 4-krotność): w sześciu próbkach różnica między zestawami wynosiła 2-krotność, w czternastu 4-krotność, w trzech 8-krotność, a w jednej 16-krotność. Minimalne, medianowe i maksymalne miana dla każdego zestawu w odniesieniu do każdej próbki wymieniono w Supplementary Table 1.
Ilościowe oznaczanie metodą cyfrowego PCR
Zebranych 24 zawiesin bakteryjnych poddano 500-krotnemu rozcieńczeniu w PBS, a następnie wykorzystano je jako próbki do ilościowego oznaczania metodą dPCR. Ilościowe oznaczenie tych rozcieńczonych próbek zostało przeprowadzone przez cztery laboratoria dPCR (Tabela 2). Analizę dPCR wykonano przy użyciu specyficznych dla danej platformy, zastrzeżonych zestawów starterów i sond celujących w konserwatywne sekwencje genomowe H. pylori. Zestawy do detekcji dPCR użyte w tym badaniu to uniwersalne zestawy odczynników stosowane w przypadku wielu patogenów i wielu celów. Każda platforma niezależnie zaprojektowała i zoptymalizowała specyficzne sekwencje starterów/sond oraz regiony genów docelowych, które stanowią jej podstawową własność intelektualną. Sekwencje te nie zostały ujawnione użytkownikom końcowym. Poinformowano nas jedynie, że specyficznym celem detekcji dla H. pylori jest konserwatywny region genomowy, który został zweryfikowany pod kątem możliwości specyficznej detekcji. Sekwencje genu 23S rRNA 24 szczepów Helicobacter pylori zostały przekazane do bazy NCBI GenBank pod numerem BioProject PRJNA1520048. Sekwencje te zostały przesłane w celu potwierdzenia tożsamości szczepów i nie stanowią celu ilościowego dPCR. Ponieważ projekt starterów/sond, chemia amplifikacji oraz liczenie partycji w oparciu o rozkład Poissona są zastrzeżone dla każdej platformy, etapy te są zależne od platformy i nie mogą zostać odtworzone bez dostępu producenta; w przeciwieństwie do nich, opisane powyżej procedury rozcieńczania próbek, replikacji ekstrakcji i agregacji danych są niezależne od platformy i w pełni określone. Bezwzględna liczba kopii została obliczona przy użyciu algorytmu rozkładu Poissona zaimplementowanego w zastrzeżonym oprogramowaniu analitycznym instrumentu. Specyficzne parametry obliczeniowe i kod źródłowy są własnością producenta i nie zostały ujawnione użytkownikom końcowym. Na koniec, na podstawie rozkładu Poissona i stopnia rozcieńczenia, obliczono bezwzględną liczbę kopii (kopie/mL) genu docelowego w oryginalnym roztworze.
W badaniu uczestniczyły cztery niezależne laboratoria dPCR (Sniper, Jiangsu Bioperfectus Technologies Co., Ltd., Ustar Biotechnologies Ltd. oraz TargetingOne), z których każde wykorzystywało własne zestawy do ekstrakcji oraz odczynniki dPCR zoptymalizowane dla danej platformy aparatury, wszystkie nakierowane na konserwowane sekwencje genomiczne H. pylori. Każda platforma otrzymała nierozcieńczoną zawiesinę bakteryjną i przygotowała próbki zgodnie z własnym protokołem: Ustar wykorzystał nierozcieńczoną zawiesinę bezpośrednio, natomiast Sniper, Jiangsu Bioperfectus Technologies Co., Ltd. oraz TargetingOne rozcieńczyli ją 500-krotnie w PBS przed ekstrakcją. Dla każdego izolatu na każdej platformie wykonano dwie niezależne ekstrakcje kwasów nukleinowych z tej samej 500-krotnie rozcieńczonej zawiesiny bakteryjnej, a każdy ekstrakt przetestowano w trzech powtórzeniach, co dało sześć pomiarów na izolat na platformę (z jednym wyjątkiem w przypadku Ustar, gdzie jedna ekstrakcja dała tylko dwa prawidłowe powtórzenia). Reakcję uznawano za nieważną i wykluczano, jeśli liczba pozytywnych kropel spadła poniżej dolnej granicy wykrywalności instrumentu lub jeśli w kontroli bez matrycy wystąpiła nieswoista amplifikacja; nieważne reakcje powtarzano raz, a trwałe niepowodzenia prowadziły do wykluczenia całej ekstrakcji. Surowe dane specyficzne dla platform przedstawiono w Tabeli uzupełniającej 1.
Agregacja danych przebiegała w ramach dwuetapowej procedury: najpierw wszystkie poprawne pomiary surowe (copies/µL) dla każdej platformy uśredniono i przeliczono na pierwotne stężenie nierozcieńczonej zawiesiny bakteryjnej (copies/mL), stosując specyficzne dla danej platformy wzory przeliczeniowe; następnie cztery stężenia uzyskane z różnych platform dla każdego izolatu uśredniono (średnia arytmetyczna), aby otrzymać końcową, pojedynczą wartość liczby kopii. Taki schemat zapewnia równy wkład każdej platformy, niezależnie od zmienności powtórzeń w obrębie jednej platformy, ograniczając jednocześnie błędy systematyczne właściwe dla poszczególnych instrumentów lub systemów odczynnikowych.
Każdą hodowlę zawiesiny bakteryjnej zmierzono równolegle na czterech platformach dPCR, a dla każdego izolatu obliczono współczynnik zmienności (CV) dla log₁₀-transformowanych liczb kopii między platformami w celu oceny zmienności międzylaboratoryjnej. Odpowiednie wyniki przedstawiono w sekcji Wyniki.
Analiza statystyczna
Miano antygenu H. pylori zdefiniowano jako odwrotność najwyższego czynnika rozcieńczenia próbki, przy którym zaobserwowano wynik dodatni (np. rozcieńczenie 1:64 odpowiada mianu 64). Dla każdego izolatu osiem mian antygenów specyficznych dla zestawu zagregowano za pomocą mediany, a cztery stężenia dPCR specyficzne dla platformy zagregowano za pomocą średniej arytmetycznej, aby uzyskać jedną reprezentatywną wartość na izolat do późniejszej analizy korelacji. Ta strategia redukcji danych jest uzasadniona metodologicznie, ponieważ: (i) osiem zestawów do oznaczania antygenów wykrywa ten sam anality za pomocą porównywalnych zasad immunoanalizy, a mediana stanowi odporny estymator, niewrażliwy na sporadyczne odczyty odstające; (ii) każda z czterech platform dPCR kwantyfikuje konserwatywną loci genomiczną H. pylori, a średnia arytmetyczna szacunków stężenia o rozkładzie log-normalnym daje nieobciążoną tendencję centralną; oraz (iii) taka agregacja jest zgodna z głównym celem badania — oceną zgodności między modalnościami kwantyfikacji opartymi na mianie antygenu a tymi opartymi na DNA na poziomie izolatu — a nie oceną analitycznej wydajności między zestawami lub platformami. Korelację między mianem antygenu a kwantyfikacją dPCR (copies/mL) oceniono najpierw za pomocą analizy korelacji Pearsona. Obie zmienne mają rozkład zbliżony do normalnego po transformacji logarytmicznej (skośność: log10 dPCR = −0.66; log2 miana antygenu = −0.60; skośność reszt regresji = −0.16), co spełnia założenia korelacji Pearsona. Miano antygenu poddano transformacji log2, aby odzwierciedlić linearyzację dwukrotnych rozcieńczeń seryjnych, natomiast wyniki dPCR poddano transformacji log10, co jest również zgodne z formatem raportowania standardu obciążenia bakteryjnego. Następnie, w celu oceny związku liniowego, przeprowadzono analizę korelacji Pearsona i regresję liniową, wykorzystując log2 miana antygenu oraz log10 wyników dPCR. Dla wszystkich analiz zastosowano poziom istotności (α) wynoszący 0.05, przyjmując P < 0.05 za istotne statystycznie. Wszystkie analizy statystyczne przeprowadzono przy użyciu platformy do analizy statystycznej online SPSSPRO.
Wyniki
Porównanie H. pylori titer antygenu i wyniki absolutnej kwantyfikacji metodą dPCR
Spośród 24 hodowanych zawiesin bakteryjnych, tytry antygenu wahały się od 8 do 256, przy wartości średniej wynoszącej 32 (Tabela 1). Wyniki ilościowe dPCR zawierały się w przedziale od 2,67 × 10⁷ kopii/mL do 2,04 × 10⁹ kopii/mL, z medianą log₁₀ = 8.61 (≈4.09 × 10⁸ kopie/mL) (Tabela 2). Zależność wykazywała cechy nieliniowe w danych surowych, sugerując związek potęgowy lub wykładniczy, co uzasadniło kolejne przekształcenia logarytmiczne wartości miana antygenu oraz wyników kwantyfikacji metodą dPCR.
Liniowa zależność między logarytmiczną transformacją miana antygenu a wynikami ilościowymi dPCR
Aby sprawdzić, czy istnieje istotna korelacja między wynikami dwóch metod wykrywania, zastosowano transformację logarytmiczną i przeprowadzono analizę korelacji Pearsona, ponieważ obie zmienne mają rozkład zbliżony do normalnego po transformacji logarytmicznej. Jak pokazano w Rycina 1, po transformacji tyter antygenu (przekształcony log2) i wynik ilościowy bezwzględny dPCR (przekształcony log10) wykazywały istotną umiarkowaną dodatnią korelację liniową (r = 0,536, n = 24, P = 0.007).
Ilościowe modelowanie zależności między mianem antygenu a liczbą kopii w cyfrowej PCR
Aby ilościowo określić zależność między dwiema metodami wykrywania i oszacować możliwość wzajemnego przewidywania wyników, zastosowano analizę regresji liniowej do danych przekształconych logarytmicznie, aby w przyszłości wykorzystać model regresji do przewidywania obciążenia bakteryjnego na podstawie miana antygenu. Analiza ujawnia zależność liniową między logarytmami2 (tytrom antygenu) i logarytm10 (dPCR), dając równanie: log10(dPCR) = 0,1588 × log2(titer) + 7,7988 (R2 = 0,287). Współczynniki regresji (z błędami standardowymi i 95% przedziałami ufności) wynosiły: nachylenie 0,1588 ± 0,053 (95% CI 0,048–0,270) i wyraz wolny 7,7988 ± 0,292 (95% CI 7,193–8,404); błąd standardowy reszt wyniósł 0,318 log10 jednostek, a ogólna regresja była istotna (F(1,22) = 8,84, P = 0,007). Oznacza to, że przy każdym podwojeniu miana antygenu liczba kopii w dPCR wzrasta jedynie 1,441-krotnie (100.1588). Jednakże dla danego miana antygenu przedział predykcyjny 95% wyników dPCR może obejmować niemal dwa rzędy wielkości (na przykład przy mianie 1:32 przedział predykcyjny wynosi około 8,3 × 10⁷ do 1,85 × 10⁹kopii/mL). Oznacza to, że w zastosowaniach praktycznych sam mian antygenu nie może dokładnie przewidzieć liczby kopii kwasu nukleinowego w pojedynczej próbce, jednak użycie tego modelu może dostarczyć szacunku rzędu wielkości przy porównaniach na poziomie grup, choć jego przydatność do przewidywania wyników dla pojedynczych próbek jest ograniczona ze względu na umiarkowaną moc wyjaśniającą (R2 = 0.287).
Zróżnicowanie międzyplatformowe kwantyfikacji metodą dPCR oraz analiza wrażliwości korelacji
Zróżnicowanie międzylaboratoryjne oceniano w skali logarytmicznej10-przekształcono stężenia, aby uwzględnić logarytmicznie normalny rozkład danych ilościowych dotyczących mikroorganizmów. Współczynnik zmienności (CV%) w przypadku czterech platform pochodzących z logarytmu10 stężenia wahały się od 0,9% do 8,3% (mediana 1,8%, średnia 2,5%) wśród 24 izolatów. Jeden odstający wynik (Hp06, CV = 8,3%) wykazał >30-krotna różnica między Sniper (5,93 × 10⁸ kopii/mL) oraz TargetingOne (1,50 × 10⁷ kopii/mL); po wykluczeniu tego izolatu wartości CV zawierały się w przedziale od 0,9% do 6,4%. Aby upewnić się, że ten odstający wynik nie był przyczyną zaobserwowanego antygenu–korelacja dPCR, przeprowadzono analizę wrażliwości wykluczającą Hp06, co dało r = 0,479, R2 = 0,230, oraz P = 0,021 (n = 23) — porównywalne do analizy pierwotnej obejmującej wszystkie 24 izolaty — potwierdzając, że główna korelacja nie zależy od tej izolaty. Ten rozrzut odzwierciedla systematyczne różnice między platformami pod względem wydajności ekstrakcji, wrażliwości odczynników i kalibracji instrumentów, a nie losowy błąd pomiarowy, co uzasadnia uśrednianie wyników między platformami w celu zmniejszenia obciążenia charakterystycznego dla danej platformy.
Definiowanie i klasyfikowanie wyników z wykorzystaniem progów podwójnej metody
Na podstawie powyższych analiz oraz eksploracyjnych, specyficznych dla zbioru danych kryteriów, w niniejszym badaniu przyjęto medianę miana wykrywalności antygenu na poziomie 1:32 jako próg wysokiej wykrywalności antygenu, ze względu na nielosową dystrybucję danych dotyczących miana antygenu, oraz wybrano rzeczywistą medianę logarytmiczną₁₀(dPCR) = 8,61≈4.09 × 10⁸ kopii/mL) jako próg określający wysoką zawartość kwasu nukleinowego. Progi te są eksploracyjnymi, zależnymi od zbioru danych wartościami progowymi wyznaczonymi na podstawie danych pochodzących od izolatów hodowlanych i nie stanowią zwalidowanych kryteriów diagnostyki klinicznej. W związku z tym zastosowanie tych wartości progowych do innych zbiorów próbek lub kontekstów analitycznych wymagałoby ponownego ich wyznaczenia na podstawie odpowiednich danych, a nie bezpośredniego przeniesienia.
Korzystanie z progów eksploracyjnych (titer antygenu ≥ 1:32 tak wysoki, ≤ 1:16 jako niskie; log dPCR₁₀ ≥ 8,61 jako wysokie stężenie kwasu nukleinowego), klasyfikacja czterosektorowa 24 zawiesin bakteryjnych hodowanych (Rycina 2, Tabela 3) jest następująca: 9 próbek (Hp03, Hp04, Hp11, Hp13, Hp18, Hp19, Hp21, Hp22, Hp25) należy do grupy o wysokiej ekspresji antygenu–kategoria o wysokiej zawartości kwasów nukleinowych (37,5%); 3 próbki (Hp09, Hp26, Hp27) sklasyfikowano jako o niskiej zawartości antygenu–wysoki kwas nukleinowy (12,5%); 8 próbek (Hp01, Hp02, Hp05, Hp08, Hp10, Hp14, Hp15, Hp17) wykazuje wysoki antygen–niski poziom kwasów nukleinowych (33,3%); a 4 próbki (Hp06, Hp07, Hp12, Hp20) należą do grupy o niskim stężeniu antygenu–kategoria o niskim stężeniu kwasu nukleinowego (16,7%). Ponieważ 24 izolaty podzielono na sześć grup pod względem miana, przy średnio zaledwie 4 próbkach na grupę, formalne porównania międzygrupowe (np. test Kruskala-Wallisa) charakteryzowałyby się niewystarczającą mocą statystyczną; w związku z tym przedstawiono wyłącznie opisowe podsumowania wyników ilościowych dPCR w poszczególnych grupach miana.
Udział procentowy żywych komórek po inaktywacji cieplnej (PCR oceny żywotności)
Aby wyznaczyć liczbę żywych bakterii pozostających po inaktywacji termicznej, zastosowano system odczynników do PCR oceny żywotności dla wszystkich 24 izolatów. Krótko mówiąc, do każdej zawiesiny po inaktywacji termicznej (200 µL) µL) inkubowano z nieprzenikalnym dla błon odczynnikiem Viability PCR (10 µkońcowa stężenie M) w 37 °C przez 75 min, z równoległym kontrolnym brakiem odczynnika (−VR) przetworzonych w identyczny sposób. Odczynnik został następnie chemicznie zdezaktywowany poprzez dodanie buforu neutralizującego do testu Viability PCR (20 µL, 10×) i inkubowano w temperaturze pokojowej przez 15 min. DNA genomowe wyizolowano z próbek +VR oraz −alikwoty VR i przeprowadzono dPCR na każdym ekstrakcie; frakcję żywotną obliczono jako stosunek +VR do −liczba kopii VR × 100%. Mediana frakcji żywych komórek wyniosła 4,6% (zakres 0,00%)–33,00%; pełne wyniki dla poszczególnych izolatów w Tabela uzupełniająca 2). Procent żywych komórek nie korelował istotnie z tytrem antygenu (r = 0,03, P = 0,90) lub z liczbą kopii dPCR (r = 0,37, P = 0.08).
DOSTĘPNOŚĆ DANYCH:
Sekwencje genów 23S rRNA 24 Helicobacter pylori szczepy zostały zdeponowane w NCBI GenBank pod numerem dostępu BioProject PRJNA1520048. Sekwencje te zostały wykorzystane wyłącznie do potwierdzenia tożsamości szczepów i nie reprezentują celu ilościowego oznaczania metodą dPCR, którym jest konserwatywny region genomowy własny dla producenta, zgodnie z opisem w protokole.
Surowe wartości miana antygenów specyficzne dla ośmiu komercyjnych zestawów immunochromatograficznych z użyciem koloidalnego złota oraz specyficzne dla platformy ilościowe wartości dPCR z czterech urządzeń cyfrowej PCR nie mogą zostać udostępnione w publicznym repozytorium z powodu wrażliwości komercyjnej, umów poufności z producentami oraz ograniczeń regulacyjnych związanych z oznakowaniem CE/zatwierdzeniem przez Narodową Administrację Produktów Medycznych in vitro produkty diagnostyczne
Dodatkowe dane ograniczone mogą być udostępniane poufnie w razie konieczności, zgodnie z obowiązującymi przepisami dotyczącymi poufności i ograniczeń regulacyjnych.
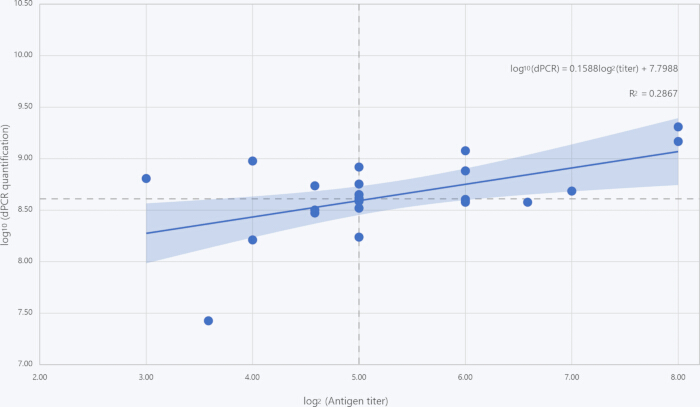
Rycina 1: Korelacja między Helicobacter pylori titer antygenu i ilościowe oznaczanie metodą cyfrowej reakcji łańcuchowej polimerazy (dPCR) Wykres punktowy z linią regresji przedstawia zależność między mianem antygenu a liczbą kopii DNA w 24 hodowlanych zawiesinach bakteryjnych (n = 24). Miana antygenów określono za pomocą testu immunochromatograficznego z użyciem koloru złotego koloidalnego i odczytu wizualnego. Przebadano serie rozcieńczeń każdej próbki, a miano wyrażono jako najwyższy czynnik rozcieńczenia, który daje wynik pozytywny (przedstawiony na osi x jako log)2przetransformowane, bezwymiarowe wartości). Liczbę kopii DNA określono za pomocą dPCR i przedstawiono na osi y jako log10-przetransformowane stężenia (log10 kopii/mL). Każdy punkt reprezentuje indywidualny próbkę zawiesiny bakteryjnej. Nieprzerwiana niebieska linia oznacza dopasowanie regresji liniowej. Przycieniony pas wokół linii regresji przedstawia 95% przedział ufności dopasowanej średniej odpowiedzi. Przerywane linie pionowa i pozioma wskazują eksploracyjne progi klasyfikacyjne (log₂ titer = 5, czyli 1:32; log₁₀ dPCR = 8,61, tj. 4,09 × 10⁸ kopii/mL) wykorzystanych na rysunku 2 i w tabeli 3. Korelację oceniono za pomocą współczynnika korelacji Pearsona, co dało wartość r = 0,536, P = 0,007, R2 = 0,287, co wskazuje na istotną statystycznie pozytywną korelację między obiema metodami. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
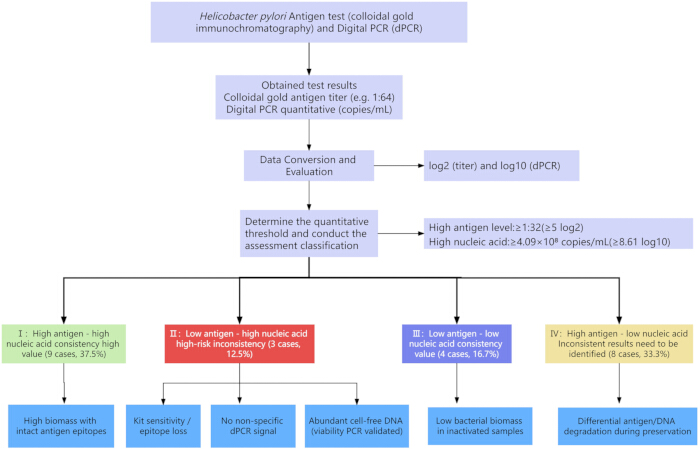
Rycina 2: Ramy analitycznej klasyfikacji dla H. pylori testowanie łączenia wyników testu antygenowego z kwantyfikacją metodą dPCR Na tym rysunku przedstawiono klasyfikację w układzie czterech ćwiartek 24 hodowanych zawiesin bakteryjnych (n = 24) na podstawie zgodności między tytrem antygenu w teście immunochromatograficznym a wynikami ilościowymi dPCR. Wykorzystano eksploracyjne, specyficzne dla zbioru danych progi (titer antygenu ≥ 1:32 tak wysoki, ≤ 1:16 jako niskie; log dPCR₁₀ ≥ 8,61 jako wysokie stężenie kwasu nukleinowego), próbki klasyfikuje się jako: wysokie stężenie antygenu–wysoki poziom kwasu nukleinowego (n = 9, 37,5%), wysoki poziom antygenu–niski poziom kwasu nukleinowego (n = 8, 33,3%), niski poziom antygenu–wysoki kwas nukleinowy (n = 3, 12,5%) i niski antygen–niski poziom kwasów nukleinowych (n = 4, 16,7%). Te progi stanowią eksploracyjne wartości odcięcia wyznaczone na podstawie danych z izolatów hodowlanych i nie reprezentują zwalidowanych kryteriów diagnostyki klinicznej. Ramy klasyfikacyjne obrazują zgodność i niezgodność między metodami wykrywania immunologicznymi a molekularnymi. Kategorie z niezgodnościami mogą odzwierciedlać takie czynniki, jak stabilność antygenów, żywotność bakterii lub zmienność liczby kopii DNA. Ramy te przeznaczone są wyłącznie do celów analitycznego porównania i nie stanowią rekomendacji diagnostycznych ani terapeutycznych w praktyce klinicznej. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
| Nie. | Odczynnik wykrywający | Producent |
| 1 | zestaw do wykrywania antygenu Helicobacter pylori (metoda złota koloidalnego) | Bioneovan Co., Ltd |
| 2 | Zestaw do wykrywania antygenu Helicobacter pylori (HP) w żołądku (metoda złota koloidalnego) | Shanghai Chemtron BIOTECH Co., Ltd |
| 3 | zestaw do wykrywania antygenu Helicobacter pylori (metoda złota koloidalnego) | Jiangsu Mole Bioscience Co., Ltd |
| 4 | zestaw do wykrywania antygenu Helicobacter pylori (metoda złota koloidalnego) | Hangzhou Genesis Biodetecton & Biocontrol Ltd |
| 5 | zestaw do wykrywania antygenu Helicobacter pylori (metoda złota koloidalnego) | JIANGSU COWIN BIOTECH CO., LTD |
| 6 | Odczynnik do wykrywania antygenu Helicobacter pylori (metoda lateksowa) | ABON Biopharm (Hangzhou) Co. Ltd |
| 7 | Odczynnik do wykrywania antygenu Helicobacter pylori (metoda immunochromatograficzna) | GUANGZHOU WONDFO BIOTECH CO., LTD |
| 8 | zestaw do wykrywania antygenu Helicobacter pylori (metoda złota koloidalnego) | Beijing Core Technology Co., Ltd |
Tabela 1: Lista Helicobacter pylori Odczynniki do wykrywania antygenów i ich producenci. Tabela wymienia osiem komercyjnie dostępnych testów immunochromatograficznych do wykrywania H. pylori antygen, które zostały ocenione w tym badaniu. Dla każdego produktu podano numer (zgodnie z oznaczeniem producenta), handlową nazwę odczynnika wykrywającego oraz producenta'przedstawiono nazwy. Wybrano je ze względu na ich szerokie wykorzystanie w diagnostyce klinicznej i testowaniu punktu opieki zdrowotnej. Wszystkie informacje pochodzą od producentów' dołączane ulotki oraz oficjalne strony internetowe (dostęp w marcu 2026 r.). Wymienienie tych odczynników nie oznacza rekomendacji; stanowią one przykład różnorodności dostępnych testów.
| Nie. | Model aparatu | Platformy PCR cyfrowej |
| 1 | DQ24 | Snajper |
| 2 | Bio Rad QX200 Droplet Digital PCR | Jiangsu Bioperfectus Technologies Co., Ltd |
| 3 | DQ24 Pro | Ustar Biotechnologies (Hangzhou) Ltd |
| 4 | System TD-1 Digital PCR | TargetingOne |
Tabela 2: Lista platform cyfrowej PCR (dPCR) i modeli instrumentów. W tej tabeli wymieniono cztery platformy laboratoryjne wyposażone w systemy dPCR wraz z odpowiednimi modelami instrumentów wykorzystywanymi w testowaniu. Platformy te wybrano ze względu na ich różnorodność technologiczną oraz reprezentatywność dla obecnej implementacji technologii dPCR. Wszystkie informacje pochodzą od odpowiednich platform. Wymienienie tych platform nie oznacza rekomendacji; po prostu oddają one zakres istniejących systemów dPCR.
| Typ | Liczba przypadków | Proporcja | Numer próbki |
| Wysoki antygen – wyska kwasów nukleinowych | 9 | 37.5% | Hp03, Hp04, Hp11, Hp13, Hp18, Hp19, Hp21, Hp22, Hp25 |
| Niski antygen – wyski kwas nukleinowy | 3 | 12.5% | Hp09, Hp26, Hp27 |
| Niski poziom antygenu – niski poziom kwasów nukleinowych | 4 | 16.7% | Hp06, Hp07, Hp12, Hp20 |
| Wysoka zawartość antygenu – niska zawartość kwasu nukleinowego | 8 | 33.3% | Hp01, Hp02, Hp05, Hp08, Hp10, Hp14, Hp15, Hp17 |
Tabela 3: Klasyfikacja i proporcje wyników testu antygenowego oraz testu kwasu nukleinowego w niniejszym badaniu. Ta tabela klasyfikuje 24 hodowane zawiesiny bakteryjne według zgodności między tytrem antygenu (określonym za pomocą testu immunochromatograficznego, wyrażonym jako najwyższy czynnik rozcieńczenia dający wynik pozytywny) a wynikami ilościowymi cyfrowej reakcji łańcuchowej polimerazy (dPCR) (wyrażonymi jako log₁₀ kopii/mL). Używając wartości progowej miana antygenu 1:32 (wysokie ≥ 1:32, niski ≤ 1:16) oraz granica ilościowego oznaczania metodą dPCR wynosząca 4,09 × 10⁸ kopie/mL (log₁₀ = 8,61) jako eksploracyjne, specyficzne dla zestawu danych progi, izolaty sklasyfikowano do czterech podgrup: wysoki antygen – wyski kwas nukleinowy, niski antygen–Wysoki poziom kwasów nukleinowych, wysoki poziom antygenu–Niski kwas nukleinowy oraz niski antygen – niski kwas nukleinowy. Wśród 24 próbek 9 zakwalifikowano jako wysoki antygen–Wysoka zawartość kwasów nukleinowych (37,5%; Hp03, Hp04, Hp11, Hp13, Hp18, Hp19, Hp21, Hp22, Hp25), 3 jako niski antygen–Wysoki kwas nukleinowy (12,5%; Hp09, Hp26, Hp27), 8 jako wysoki antygen–Niski poziom kwasów nukleinowych (33,3%; Hp01, Hp02, Hp05, Hp08, Hp10, Hp14, Hp15, Hp17) oraz 4 jako niski antygen–Niski poziom kwasu nukleinowego (16,7%; Hp06, Hp07, Hp12, Hp20). Dla każdej kategorii tabela przedstawia liczbę przypadków (n), udział procentowy w stosunku do całkowitej liczebności próby (%) oraz numery próbek w obrębie poszczególnych kategorii. Klasyfikacja ta ilustruje zgodność i niezgodność między metodami wykrywania immunologicznymi a molekularnymi; kategorie z rozbieżnościami mogą odzwierciedlać takie czynniki, jak stabilność antygenu, żywotność bakterii lub zmienność liczby kopii DNA, co dostarcza wskazówek ułatwiających interpretację wyników badań analitycznych.
Tabela uzupełniająca 1: Zestawiony zestaw danych dotyczący wykrywania antygenu i ilościowego oznaczania metodą dPCR dla 24 Helicobacter pylori izolaty Arkusz 1 (Wykrywanie antygenów): końcowe tytry zestawu na podstawie ośmiu komercyjnych zestawów immunochromatograficznych z koloidowym złotem dla każdego izolatu, wraz z minimalnym, średnim i maksymalnym tytrem na próbkę oraz zakresem wielokrotności wewnątrz próbki. Arkusz 2 (Cyfrowe ilościowe wykrywanie PCR): stężenia dPCR specyficzne dla platformy (kopie/mL) dla każdego izolatu oraz podsumowanie statystyk międzyplatformowych (mediana, minimum, maksimum i CV% logarytmu)₁₀przekształcone stężenia) Arkusz 3 (Analiza korelacji i regresji): poziom odmiany log₂przetransformowane miano antygenów i log₁₀przetransformowane stężenia dPCR, wyniki korelacji Pearsona i regresji liniowej (r, R2, równanie regresji), analiza wrażliwościowa z wykluczeniem odstającego punktu Hp06 oraz szczegółowe statystyki regresji (błędy standardowe, 95% przedziały ufności, błąd standardowy reszt, statystyka F oraz P-wartość). Identyfikatory specyficzne dla zestawu i platformy zostały anonimizowane ze względu na poufność handlową; zestaw danych zawiera wszystkie wartości niezbędne do odtworzenia Rysunku 1–2 i tabela 3.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2: Wyniki PCR oceny żywotności dla 24 Helicobacter pylori izolaty Kopiowanie liczby cząsteczek dPCR dla odczynnika żywotności na pojedynczą izolat–leczony (+VR) i bez odczynnika (−aliquoty VR po inaktywacji termicznej w 56 °C przez 25 min, z obliczoną frakcją żywotną (%) i równoważną ΔCq dla każdego izolatu. Mediana frakcji żywych komórek we wszystkich izolatach wyniosła 4,6% (zakres 0,00%–11,6%).–33.00%).Kliknij tutaj, aby pobrać ten plik.
Dyskusja
W niniejszym badaniu 24 hodowlanych izolatów H. pylori miano antygenu w teście immunochromatograficznym oraz liczba kopii genomu w dPCR wykazały umiarkowaną, lecz istotną dodatnią korelację (r = 0.536, P = 0.007); jednak miano antygenu wyjaśniało jedynie 29% wariancji liczby kopii w dPCR (R2 = 0.287), co oznacza, że oba pomiary są ze sobą powiązane, ale nie są zamienne. Głównym ograniczeniem tego badania jest mała liczebność próby (n = 24), co ogranicza moc statystyczną i wyjaśnia eksploracyjny charakter zastosowanych poniżej progów klasyfikacji.
W niniejszym badaniu ilościowo przeanalizowano miano antygenu w hodowlach H. pylori oraz liczbę kopii kwasów nukleinowych wykrytą za pomocą dPCR, co ujawniło umiarkowaną, lecz istotną korelację między wynikami detekcji tymi dwiema metodami (r = 0,536, P = 0,007). Chociaż na poziomie populacyjnym obserwuje się istotną korelację między obiema metodami, w praktyce klinicznej często spotyka się rozbieżności na poziomie indywidualnym. Wynika to z faktu, że różne cele detekcji odzwierciedlają odmienne cechy biologiczne patogenów. W szczególności testy antygenowe wykrywają białka, które mogą przetrwać po eliminacji bakterii, podczas gdy testy kwasów nukleinowych wykrywają DNA, które może utrzymywać się na niskim poziomie nawet po usunięciu żywych bakterii. Taka niespójność została dobrze udokumentowana w przypadku różnych chorób zakaźnych. Na przykład w diagnostyce klinicznej zakażenia Clostridioides difficile niektórzy nosiciele uzyskują pozytywne wyniki w detekcji genu toksyny, ale negatywne wyniki w detekcji antygenu białka toksyny, co prowadzi do błędnej diagnozy osoby zakażonej i powoduje nadmierne leczenie oraz pojawienie się lekooporności. Dlatego Infectious Diseases Society of America (IDSA)12 w wytycznych wyraźnie rozróżniło znaczenie kliniczne „detekcji toksyny” i „detekcji genu toksyny” dla Clostridioides difficile. Diagnozowanie zakażenia wyłącznie za pomocą testów kwasów nukleinowych jest niewystarczające i zaleca się stosowanie metod umożliwiających bezpośrednie wykrycie aktywnego białka toksyny. Dodatkowo, w przypadku pozaszpitalnego zapalenia płuc po leczeniu antybiotykowym, ładunek bakteryjnego DNA w plwocinach pacjenta gwałtownie spada, podczas gdy antygen w moczu pozostaje pozytywny po wyzdrowieniu i utrzymuje się od kilku tygodni do kilku miesięcy13. Podobne zjawiska obserwuje się również w diagnostyce i leczeniu zakażeń H. pylori. W 2022 roku Mayo Clinic Laboratories oceniło, że u 223 pacjentów w obserwacji po leczeniu antybiotykowym metoda PCR była stosunkowo czuła w wykrywaniu niskopoziomowego resztkowego DNA w próbkach kału. Niektórzy pacjenci, mimo klinicznego wyzdrowienia i negatywnego wyniku testu antygenowego, nadal uzyskiwali pozytywne wyniki PCR przez kilka tygodni14. Wszystko to dodatkowo potwierdza różnice biologiczne między różnymi celami detekcji.
W niniejszym badaniu identyfikacja ilościowej korelacji i równoważności między mianem antygenu H. pylori wykrytym metodą immunochromatograficzną a wartościami kwantyfikacji dPCR oferuje praktyczne wytyczne do charakterystyki materiałów referencyjnych H. pylori oraz do oceny odczynników diagnostycznych in vitro. 1) Wsparcie aktualizacji modelu oceny wydajności produktu: Obecnie ocena w badaniach klinicznych odczynników do wykrywania antygenu H. pylori opiera się na ślepym porównaniu synchronicznym z klinicznymi „złotymi standardami”, takimi jak histologia, hodowla lub test oddechowy z mocznikiem15. Niniejsze badanie sugeruje, aby organy regulacyjne zobowiązały przedsiębiorstwa do dostarczenia w materiałach aplikacyjnych podczas procesu przeglądu odpowiednich danych korelacyjnych między wynikami ich testów a ilościowymi metodami kwasów nukleinowych oraz do jasnego zdefiniowania wydajności ich produktów w „zakresie wyników niezgodnych”, aby bardziej realistycznie odzwierciedlić zdolność wykrywania produktu w złożonych scenariuszach klinicznych i bardziej kompleksowo zdefiniować LOD odczynnika. 2) Dostarcza to nowego podejścia do przypisywania wartości materiałom referencyjnym bakterii: materiały referencyjne do kontroli jakości i kalibracji mogą zostać przekształcone z pojedynczej wartości „CFU” w „wielowymiarowe wartości charakterystyczne”8, które obejmują miano antygenu i liczbę kopii kwasu nukleinowego. Model regresji opracowany w tym badaniu może dostarczyć wstępnej oceny rzędu wielkości zależności między tymi dwiema wartościami, stanowiąc ilościową podstawę do stosowania materiałów referencyjnych oraz do porównań międzylaboratoryjnych.
Zalecamy, aby producenci podawali nie tylko granicę wykrywalności (LOD) w jednostkach analitycznych (np. CFU/mL lub miano antygenu), ale także jej równoważność w kopiach genomowych — określoną za pomocą cyfrowej PCR (dPCR) — tak aby wyniki można było porównywać i ujednolicać pomiędzy laboratoriami i platformami. Takie raportowanie w podwójnych jednostkach jest zgodne z wymaganiami dotyczącymi identyfikowalności metrologicznej normy ISO 175118 oraz z ramami oceny zdolności wykrywania według CLSI EP17-A216.
Potencjalne przyczyny występowania próbek o charakterystyce „niski poziom antygenu – wysoki poziom kwasów nukleinowych” są następujące: 1) Zmienność genetyczna szczepu: Jeśli dojdzie do zastąpienia aminokwasu w epitopie antygenowym lub jeśli białko wydzielnicze zostanie zablokowane podczas transportu i sekrecji, może wystąpić zjawisko „ucieczki” w detekcji antygenu17. 2) Metoda dPCR jest zaprojektowana tak, aby celować w konserwowane sekwencje genów i je amplifikować. Specyficzny gen będący celem dPCR w niniejszym badaniu nie został ujawniony w dokumentacji producenta. Jednak komercyjne zestawy do wykrywania antygenów mogą celować w różne antygeny H. pylori (np. VacA, ureazę, białka flagellarne lub antygeny całokomórkowe), a jakikolwiek brak zgodności między genem docelowym dPCR a antygenem rozpoznawanym przez dany zestaw może objawiać się jako rozbieżność ilościowa w czterech kwadrantach wykresu rozrzutu — wysoki dPCR/niski antygen, niski dPCR/wysoki antygen, zgodność wysoki-wysoki lub zgodność niski-niski — zamiast binarnych rozbieżności dodatni/ujemny18. 3) Ograniczenia metody detekcji: Technologia wykrywania antygenów jest ograniczona przez niezwykle niskie lub niezwykle wysokie stężenia antygenów, co osłabia sygnał z powodu niewystarczającego powinowactwa do przeciwciał lub przesycenia, a także jest wpływana przez matrycę próbki. 4) Asymetria wydajności granicy wykrywalności: Dolna granica wykrywalności (LOD) dPCR może osiągać 10–100 kopii/mL, podczas gdy granica wykrywalności koloidalnej metody immunochromatograficznej dla ureazy wynosi około 104–105 CFU/mL. Gdy liczba bakterii znajduje się na wartości krytycznej, łatwo dochodzi do zjawiska „niskiego poziomu antygenu – wysokiego poziomu kwasów nukleinowych”. 5) Wpływ stanu infekcji na wyniki kliniczne jest znaczący, szczególnie w rozróżnianiu infekcji bakteryjnych od wirusowych. W procesie infekcji liczba kopii genów i poziom ekspresji antygenu nie wykazują stałej zależności. Po skutecznym leczeniu poziom kwasów nukleinowych może gwałtownie spaść, podczas gdy eliminacja antygenu może być opóźniona przez pewien czas19.
Zawiesiny bakteryjne wykorzystane w niniejszym badaniu pochodziły zarówno z próbek biopsji żołądka, jak i próbek kału, co reprezentuje odmienne środowiska matrycy o różnych profilach zakłóceń. Izolaty pochodzące z biopsji żołądka są w znacznym stopniu wolne od inhibitorów PCR związanych z kałem, lecz mogą być narażone na działanie resztkowej pepsyny podczas przetwarzania próbek. Z kolei próbki kału zawierają inhibitory PCR (np. sole żółciowe, złożone polisacharydy, produkty degradacji hemoglobiny), które mogą obniżać wydajność amplifikacji i prowadzić do niedoszacowania ilościowego dPCR, a także proteazy jelitowe, które mogą degradować antygeny docelowe nawet wtedy, gdy bakteryjne DNA pozostaje nienaruszone. Te specyficzne dla matrycy efekty działają niezależnie od opisanych powyżej mechanizmów niedopasowania regionu docelowego i wskazują, że protokoły przygotowania oraz walidacja metody powinny być dostosowane do rodzaju próbki podczas interpretacji rozbieżności ilościowych w badanych próbkach klinicznych.
Aby eksperymentalnie określić stosunek bakterii żywych do nieżyjących po inaktywacji termicznej, przeprowadzono test viability PCR z użyciem systemu odczynników do viability PCR dla wszystkich 24 wyizolowanych kultur. Odczynnik ten działa analogicznie do monoazydy propidyny (PMA): selektywnie przenika do komórek z uszkodzonymi błonami i kowalencyjnie modyfikuje ich DNA genomowe, aby zablokować późniejszą amplifikację. Procent bakterii żywych obliczono według wzoru: Viable % = (liczba kopii DNA/µL po zastosowaniu odczynnika żywotności (VR)) / (liczba kopii DNA/µL bez VR) × 100. Dla wszystkich izolatów mediana frakcji bakterii żyjących po inaktywacji termicznej wyniosła 4,6% (zakres: 0,00%–33,0%), co potwierdza, że zastosowana inaktywacja termiczna w 56 °C przez 25 min drastycznie zmniejsza żywotność bakterii, jednak nie eliminuje całkowicie żywych organizmów. Dane dotyczące żywotności silnie wspierają naszą interpretację, według której rozbieżne profile charakteryzujące się wysokim wynikiem dPCR i niskim mianem antygenu wynikają przede wszystkim z obecności resztkowego wolnego DNA oraz DNA w nieżyjących cząstkach bakterii, a nie z obecności nienaruszonych, żywych H. pylori. Pełne wyniki ilościowego oznaczania żywotności dla wszystkich 24 szczepów zestawiono w Tabeli uzupełniającej 2.
W niniejszym badaniu klasyfikacja czterokwartylowa (oparta na eksploracyjnych progach specyficznych dla zbioru danych) wykazała, że 8 próbek charakteryzowało się wysokim poziomem antygenu i niskim poziomem kwasów nukleinowych, a 4 próbki należały do grupy z niskim poziomem antygenu i niskim poziomem kwasów nukleinowych, obok 9 próbek z kategorii zgodnej wysokim–wysokim oraz 3 z kategorii zgodnej niskim–wysokim. Obecność próbek z wysokim poziomem antygenu i niskim poziomem kwasów nukleinowych (n = 8) sugeruje, że ekspresja antygenu i zawartość kwasów nukleinowych nie zawsze są ze sobą skorelowane, nawet w kulturach czystych. Wszystkie 24 izolaty pobrano w stacjonarnej fazie wzrostu (72 h hodowli; patrz sekcja 1 Protokołu). W fazie stacjonarnej replikacja DNA w dużej mierze ustaje, podczas gdy antygeny strukturalne i metaboliczne utrzymują się lub nawet nadal kumulują; to rozprzężenie fazy wzrostu stanowi prawdopodobną biologiczną podstawę asymetrii między liczną grupą wysokiego poziomu antygenu i niskiego poziomu kwasów nukleinowych (n = 8) a niewielką grupą niskiego poziomu antygenu i wysokiego poziomu kwasów nukleinowych (n = 3), choć samo w sobie nie wyklucza innych mechanizmów, takich jak różnice między szczepami w ekspresji antygenów lub częściowa liza podczas inaktywacji termicznej. Istnienie próbek z niskim poziomem antygenu i wysokim poziomem kwasów nukleinowych (n = 3) potwierdza, że niski miano antygenu nie musi nieuchronnie odpowiadać niskiemu obciążeniu kwasami nukleinowymi, co wykazuje, że testy kwasów nukleinowych uzupełniają testy antygenowe w określonych scenariuszach. Progi te mają charakter eksploracyjny i specyficzny dla zbioru danych i nie reprezentują zwalidowanych kryteriów diagnostyki klinicznej.
Niniejsze badanie jest ograniczone przez małą wielkość próby (n = 24), co sprawia, że moc statystyczna jest niewystarczająca do przeprowadzenia rzetelnej analizy podgrup. Próbki podzielono na sześć grup miana, przy średnio zaledwie 4 próbkach w każdej grupie, w związku z czym formalne porównania międzygrupowe nie posiadają wystarczającej mocy statystycznej, aby wykryć istotne różnice. W związku z tym nie zastosowano testu Kruskala-Wallisa, aby uniknąć prezentowania wyników statystyki indukcyjnej o niewystarczającej mocy. Ponadto wszystkie próbki były izolatami hodowlanymi i nie uwzględniały bardziej złożonych efektów matrycy występujących w próbkach klinicznych, takich jak błona śluzowa żołądka, kał czy ślina.
Oświadczenia
Autorzy nie mają żadnych konfliktów interesów do ujawnienia.
W procesie pisania, redagowania, analizy statystycznej, opracowywania kodu ani przygotowywania rycin do niniejszego manuskryptu nie wykorzystano żadnych narzędzi AI.
WKŁAD AUTORÓW:
Wszyscy autorzy potwierdzili swój wkład w niniejszą pracę. Indywidualne role autorów są wymienione poniżej. Wszyscy autorzy przeczytali i zatwierdzili ostateczną wersję przedłożonego manuskryptu oraz biorą pełną odpowiedzialność za dokładność i rzetelność danych badawczych. Wenwen Sun: Badania, Kuratela danych, Analiza formalna, Metodyka, Pisanie projektu, Pozyskiwanie funduszy; Xiaona Han: Badania, Metodyka; Jin Zhang: Badania, Metodyka; Xinxin Duan: Badania, Metodyka; Tingting Li: Konceptualizacja, Nadzór; Manyu Li: Konceptualizacja, Nadzór, Pisanie – recenzja i redakcja; Haiwei Zhou: Konceptualizacja, Nadzór, Pisanie – recenzja i redakcja.
Podziękowania
Niniejsze badanie jest finansowane przez Youth Development Research Foundation of the National Institutes for Drug Control (NIDC) (Grant nr 2025C5).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 2X dPCR Probe Master Mix Plus (Rox) | Sniper | RT021096A | Odczynnik do ilościowego wykrywania metodą cyfrowego PCR |
| Bacterial Genomic DNA Extraction Kit | Tiangen Biochemical Technology (Beijing) Co., Ltd. | Y2213/DP302-02 | Ekstrakcja kwasów nukleinowych bakterii |
| Bio-Rad QX200 Droplet Digital PCR System | Jiangsu Bioperfectus Technologies Co., Ltd. | QX200 | Ilościowe wykrywanie metodą cyfrowego PCR |
| Digital PCR Integrated Machine | Sniper | DQ24 | Ilościowe wykrywanie metodą cyfrowego PCR |
| Digital PCR Integrated Machine | Ustar Biotechnologies (Hangzhou) Ltd. | DQ24 | Ilościowe wykrywanie metodą cyfrowego PCR |
| Digital Water Bath | Yiheng Scientific Instrument Co., Ltd. | DK-8D | Inaktywacja termiczna zawiesin bakteryjnych w 56 °C |
| Forward primer | Sangon Biotechnology (Shanghai) Co., Ltd. | / | Amplifikacja kwasów nukleinowych w cyfrowym PCR |
| Gastric Helicobacter pylori Antigen Detection Kit (Colloidal Gold Method) | Shanghai Chemtron Biotech Co., Ltd. | B202301020 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori Agar Medium (solid) | Qingdao Haibo Biotechnology Co., Ltd. | HB8647 | Pożywka do hodowli H. pylori |
| Helicobacter pylori antigen detection kit (colloidal gold method) | Bioneovan Co., Ltd. | 202403001 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori antigen detection kit (colloidal gold method) | Jiangsu Mole Bioscience Co., Ltd. | 20240310 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori antigen detection kit (colloidal gold method) | Hangzhou Genesis Biodetection & Biocontrol Ltd. | GG230601021 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori antigen detection kit (colloidal gold method) | Jiangsu Cowin Biotech Co., Ltd. | 28223 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori antigen detection kit (colloidal gold method) | Beijing Core Technology Co., Ltd. | 2415810 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori antigen detection reagent (immunochromatographic method) | Guangzhou Wondfo Biotech Co., Ltd. | W028402001 | Wykrywanie antygenu H. pylori |
| Helicobacter pylori antigen detection reagent (latex method) | ABON Biopharm (Hangzhou) Co., Ltd. | 0000805308 | Wykrywanie antygenu H. pylori |
| Heracell Tri-Gas Incubator | Thermo Fisher Scientific | N/A | Hodowla mikroaerofilowa; skład gazowy: 5% O2, 10% CO2, 85% N2 |
| Microcentrifuge Tubes (1.5 mL / 2 mL) | Axygen Scientific Inc. | MCT-150-C / MCT-200-C | Rozcieńczanie próbek i ekstrakcja kwasów nukleinowych |
| Nucleic acid extraction or purification reagents | Jiangsu Bioperfectus Technologies Co., Ltd. | SDK60105 | Ekstrakcja kwasów nukleinowych bakterii |
| Nucleic acid extraction reagent | TargetingOne | Pathogens TNA-B1 (11019) | Ekstrakcja kwasów nukleinowych bakterii |
| PBS, 1X (pH 7.2-7.4, 0.01 M, cell culture) | Solarbio Science & Technology Co., Ltd. | P1020 | Rozcieńczanie próbek |
| Petri Dishes (90 mm) | Beekman Biotech | N/A | Sterylne szalki do izolacji i pasażowania bakterii |
| Pipette Tips (10 uL / 200 uL / 1000 uL) | Axygen Scientific Inc. | T-300 / T-200-Y / T-1000-B | Sterylne końcówki z filtrem do rozcieńczania próbek i dozowania odczynników |
| Probe | Sangon Biotechnology (Shanghai) Co., Ltd. | / | Amplifikacja kwasów nukleinowych w cyfrowym PCR |
| Reverse primer | Sangon Biotechnology (Shanghai) Co., Ltd. | / | Amplifikacja kwasów nukleinowych w cyfrowym PCR |
| SPSSPRO Online Statistical Analysis Platform | SPSSPRO | Web-based (https://www.spsspro.com/; accessed August 2026) | Analiza statystyczna: korelacja Pearsona, regresja liniowa |
| Sterile Defibrinated Sheep Blood | Solarbio Science & Technology Co., Ltd. | TX0030-100 mL | Suplement do płytek hodowlanych H. pylori |
| TD-1 Digital PCR System | TargetingOne | TD-1 | Ilościowe wykrywanie metodą cyfrowego PCR |
| Viability PCR Reagent System | Promega | A8881 | Ocena żywotności H. pylori inaktywowanych termicznie metodą viability PCR |
| Vortex Mixer | Scientific Industries Inc. | SI-0256 | Homogenizacja zawiesin bakteryjnych |
Bibliografia
- Ndip RN, et al. Helicobacter pylori isolates recovered from gastric biopsies of patients with gastro-duodenal pathologies in Cameroon: current status of antibiogram. Trop Med Int Health. 2008;13(6):848-54.
- Malfertheiner P, et al. Management of Helicobacter pylori infection: the Maastricht VI/Florence consensus report. Gut. 2022;71(9):1724-62.
- Hooi JKY, et al. Global prevalence of Helicobacter pylori infection: systematic review and meta-analysis. Gastroenterology. 2017;153(2):420-9.
- International Agency for Research on Cancer. Schistosomes, liver flukes and Helicobacter pylori. IARC Monogr Eval Carcinog Risks Hum. 1994;61:1-241.
- de Martel C, et al. Global burden of cancer attributable to infections in 2018: a worldwide incidence analysis. Lancet Glob Health. 2020;8(2):e180-90.
- Wang YK, et al. Diagnosis of Helicobacter pylori infection: current options and developments. World J Gastroenterol. 2015;21(40):11221-35.
- Hindson BJ, et al. High-throughput droplet digital PCR system for absolute quantitation of DNA copy number. Anal Chem. 2011;83(22):8604-10.
- International Organization for Standardization. ISO 17511:2020, In vitro diagnostic medical devices—requirements for establishing metrological traceability of values assigned to calibrators, trueness control materials and human samples. International Organization for Standardization; Geneva; 2020.
- Morisset D, et al. Quantitative analysis of food and feed samples with droplet digital PCR. PLoS One. 2013;8(5):e62583.
- World Health Organization. WHO international standard for SARS-CoV-2 RNA, NIBSC code 20/146. World Health Organization; Geneva; 2020.
- Forootan A, et al. Methods to determine limit of detection and limit of quantification in quantitative real-time PCR (qPCR). Biomol Detect Quantif. 2017;12:1-6.
- Johnson S, et al. Clinical practice guideline by the Infectious Diseases Society of America (IDSA) and Society for Healthcare Epidemiology of America (SHEA): 2021 focused update guidelines on management of Clostridioides difficile infection in adults. Clin Infect Dis. 2021;73(5):e1029-44.
- Hyams C, Williams OM, Williams P. Urinary antigen testing for pneumococcal pneumonia: is there evidence to make its use uncommon in clinical practice? ERJ Open Res. 2020;6(1):00223-2019.
- Marrero Rolon R, et al. Erratum for Marrero Rolon et al., “Clinical evaluation of a real-time PCR assay for simultaneous detection of Helicobacter pylori and genotypic markers of clarithromycin resistance directly from stool.” J Clin Microbiol. 2022;60(2):e0245221.
- China Food and Drug Administration. Technical review guidelines for registration of Helicobacter pylori antigen/antibody detection reagents. China Food and Drug Administration; Beijing; 2018.
- Clinical and Laboratory Standards Institute. EP17-A2, Evaluation of detection capability for clinical laboratory measurement procedures; approved guideline. 2nd ed. Clinical and Laboratory Standards Institute; Wayne, PA; 2012.
- Yamaoka Y, Graham DY. Helicobacter pylori virulence and cancer pathogenesis. Future Oncol. 2014;10(8):1487-500.
- Leal YA, et al. Utility of stool sample-based tests for the diagnosis of Helicobacter pylori infection in children. J Pediatr Gastroenterol Nutr. 2011;52(6):718-28.
- Devonshire AS, et al. The use of digital PCR to improve the application of quantitative molecular diagnostic methods for tuberculosis. BMC Infect Dis. 2016;16:366.