W celu rozwiązania problemu fragmentacji tekstów prawnych oraz kwestii śledzenia stronniczości w medycznej sztucznej inteligencji (AI), w niniejszym badaniu skonstruowano graf wiedzy prawnej i zastosowano splot grafowy uwzględniający relacje do wyrównania semantycznego. Zidentyfikowano stronnicze źródła za pomocą wstecznej propagacji gradientu, a uzyskane korzystne wyniki eksperymentalne wspierają stworzenie zgodnej z przepisami aplikacji medycznej AI.
Artykuł badawczy
Konstruowanie prawnych grafów wiedzy i śledzenie stronniczości w medycznej sztucznej inteligencji w oparciu o grafowe sieci neuronowe
W tym artykule
Podsumowanie
Streszczenie
W analizie zgodności prawnej sztucznej inteligencji (AI) w medycynie niniejszy artykuł odnosi się do niejednoznaczności w określaniu odpowiedzialności, wynikającej z fragmentacji semantycznej wieloźródłowych, heterogenicznych tekstów prawnych oraz trudności w śledzeniu błędów algorytmicznych. Przedstawiono metodę konstrukcji grafu wiedzy i wykrywania ścieżek propagacji błędów w oparciu o grafowe sieci neuronowe. Ustrukturyzowano i zakodowano cztery typy węzłów heterogenicznych – klauzule prawne, zachowania medyczne, moduły algorytmiczne oraz strony odpowiedzialne – a następnie skonstruowano graf skierowany w oparciu o cztery rodzaje relacji semantycznych zawartych w przepisach prawa: "naruszenie", "podstawa", "wyzwalacz", i "atrybucja"Następnie wykorzystano grafową sieć konwolucyjną uwzględniającą relacje, połączoną z wagami specyficznymi dla typów krawędzi oraz mechanizmem uwagi, aby przeprowadzić wielowarstwowe wyrównanie cech dla międzymodalnej semantyki prawnej. Następnie zastosowano propagację wsteczną opartą na gradiencie w celu zidentyfikowania krawędzi znacząco przyczyniających się do stronniczości, skonstruowano podgraf propagacji stronniczości i wykorzystano detekcję społeczności do zlokalizowania klastrów węzłów korzenia. Na koniec przepływy decyzji w czasie rzeczywistym zostały odwzorowane na węzły tymczasowe, zgodność zweryfikowano za pomocą podobieństwa osadzeń, a dynamikę wag kluczowych krawędzi monitorowano w celu ostrzegania przed akumulacją stronniczości systemowej. Eksperymenty wykazują, że pod względem dokładności wyrównania semantycznego proponowana metoda osiąga średnią dokładność wyrównania encji na poziomie co najmniej 0,92 oraz średną kompletność zachowania relacji na poziomie co najmniej 0,88 dla różnych gradientów gęstości grafu wiedzy. W odniesieniu do zdolności lokalizacji stronniczości współczynnik odzyskiwania węzłów korzenia osiąga wartość 0,95.±±0,02, a precyzja ścieżki propagacji osiąga 0,93±±0.03. Niniejsze badanie w pewnym stopniu pozwala na głębokie powiązanie logiki prawnej z zachowaniem algorytmicznym, zapewniając wyjaśnialny i weryfikowalny system wspierania zgodności dla godnego zaufania wdrażania sztucznej inteligencji w medycynie.
Wprowadzenie
Głębokie zaangażowanie sztucznej inteligencji (AI) medycznej w diagnostykę i wsparcie leczenia, alokację zasobów oraz ocenę ryzyka powiązało procesy podejmowania przez nią decyzji z założeniem odpowiedzialności prawnej1,2. Normy prawne są silnie ustrukturyzowane, lecz semantycznie rozproszone, natomiast działanie systemów AI może mieć charakter „czarnej skrzynki”, bez semantycznie zgodnego i możliwego do prześledzenia interfejsu łączącego oba te obszary3. W tym kontekście opracowanie wspólnych ram reprezentacji, które obejmą prawne łańcuchy przyczynowo-skutkowe w ramach algorytmicznych sekwencji behawioralnych, stało się niezbędnym elementem umożliwiającym szczegółowe przypisywanie odpowiedzialności oraz dynamiczne zapewnienie zgodności z przepisami4,5. Niniejsze badanie odnosi się nie tylko do testowania systemów technologicznych pod kątem prawnym, ale dotyczy również głębokiego utrzymania sprawiedliwości medycznej, sprawiedliwości algorytmicznej oraz zaufania instytucjonalnego, co nadaje mu ogromne znaczenie teoretyczne i praktyczną pilność.
Podstawowym problemem w dzisiejszej analizie zgodności prawnej systemów AI w medycynie jest brak obliczalnej struktury powiązań między semantyką prawną a zachowaniem algorytmicznym6,7. Dokumenty prawne są dostępne w formie zwykłego tekstu, a relacje między akapitami są przeplatane zależnościami, konfliktami i wyjątkami, co stwarza problemy przy ich dzieleniu na jednostki logiczne, które mogłyby być interpretowane przez maszyny8,9. Ponadto proces podejmowania decyzji przez system AI jest zamknięty w sterowanej danymi „czarnej skrzynce”, przez co żadne z wariantów jego wyników nie może zostać powiązane z konkretnymi naruszeniami obowiązków prawnych lub węzłami przypisania odpowiedzialności10,11. Taki brak powiązań (na przykład błąd danych treningowych, wady projektu modelu lub semantyczna interpretacja norm prawnych) nie może być izolowany eksperymentalnie w celu zidentyfikowania źródła błędu lub doprecyzowania obowiązków prawnych programistów, wdrażających lub użytkowników12,13. Jeszcze bardziej problematyczne jest to, że istniejące procedury zgodności sprawdzają jedynie, czy ostateczny wynik spełnia określoną specyfikację, nie biorąc pod uwagę ścieżki propagacji ani wzmocnienia stronniczości w sieci interakcji na styku „prawo-technologia”14,15. Gdy medyczne AI podlega jednocześnie wielu przepisom prawnym, a system generuje łańcuch błędów z powodu błędnej interpretacji jednego z postanowień, konwencjonalne podejścia nie pozwalają prześledzić, w jaki sposób błąd rozprzestrzenia się na inne powiązane przepisy, a następnie prowadzi do odpowiedzialności prawnej16,17. Dodatkowo brakuje mechanizmu dynamicznej korelacji między przepływem decyzji w czasie rzeczywistym a istniejącym grafem wiedzy prawniczej, co skutkuje opóźnioną oceną zgodności podczas pracy systemu i uniemożliwia proaktywne monitorowanie trendów kumulacji błędów18,19. Problemy te łącznie prowadzą do niepewności w ustalaniu odpowiedzialności, nietrwałości przypisywania winy oraz opóźnionych interwencji regulacyjnych, co znacząco utrudnia wiarygodne wdrażanie wysokoryzykownych systemów AI w ochronie zdrowia oraz stosowanie odpowiedzialności prawnej.
Przede wszystkim tradycyjne badania analizują teksty prawne w formie ustrukturyzowanej i budują bazy wiedzy dla konkretnych dziedzin za pomocą ontologii lub reguł, aby wspierać odpowiadanie na pytania dotyczące zgodności z przepisami lub powiadomienia o ryzyku20,21. Chociaż podejścia te pozwalają na uchwycenie reprezentacji niektórych pojęć prawnych, mają one tendencję do zakładania, że wewnętrzna logika prawa jest spójna i statyczna, co utrudnia radzenie sobie z niespójnościami między jurysdykcjami, wyjątkami lub niejednoznacznymi sformułowaniami>. Kolejne prace wprowadziły technologię przetwarzania języka naturalnego, wykorzystując wstępnie wytrenowane modele językowe do wyodrębniania podmiotów i relacji prawnych, co zwiększyło zakres ekstrakcji wiedzy22,23, jednak wciąż pozostaje to na płytkim poziomie semantycznym, nie tworząc interfejsu mapowania między zachowaniami prawnymi a technicznymi. W zakresie zarządzania stronniczością algorytmiczną badania skupiały się głównie na projektowaniu ograniczeń dotyczących sprawiedliwości24,25, a ich wskaźniki oceny opierają się zazwyczaj na zmiennych demograficznych, co wykazuje brak spójności z zasadami przypisywania odpowiedzialności prawnej. Niektóre badania próbowały kodować reguły prawne jako ograniczenia i implementować je w procesie trenowania modeli26,27, jednak ze względu na sztywność i niską ziarnistość wyrażania reguł, są one trudne do dostosowania do złożonych sytuacji klinicznych. Ogólnie rzecz biorąc, istniejące prace traktują zgodność prawną jako zewnętrzne zadanie weryfikacyjne, a nie jako wewnętrzny, obliczalny atrybut architektury systemu. Skutkuje to równoległym działaniem logiki prawnej i logiki algorytmicznej, co uniemożliwia wspólne wnioskowanie i dynamiczną interwencję w ścieżki propagacji stronniczości.
W ostatnich latach sieci neuronowe na grafach były stopniowo wprowadzane do dziedziny medycznej dzięki ich zdolnościom do jawnego modelowania struktur relacyjnych28,29. Niektóre badania wykorzystują grafy heterogeniczne do integracji orzecznictwa, przepisów prawnych i informacji o stronach, wspierając rekomendacje spraw lub prognozowanie wyroków poprzez osadzanie węzłów30,31, co potwierdza skuteczność struktur grafowych w przechwytywaniu powiązań prawnych. Inne prace traktują komponenty algorytmiczne jako węzły grafu, wykorzystując krawędzie do reprezentowania przepływów danych lub relacji wywołań w celu śledzenia propagacji błędów32,33. Eksploracje te wykazują, że struktury grafowe mogą służyć jako wspólny nośnik elementów prawnych i technologicznych. Jednakże istniejące modele grafowe zazwyczaj obarczone są trzema ograniczeniami: po pierwsze, ograniczają się do jednego typu relacji krawędzi, nie rozróżniając różnic normatywnych, przyczynowych i atrybucyjnych w semantyce prawnej; po drugie, proces agregacji cech ignoruje wagi semantyczne typów krawędzi, co prowadzi do równego traktowania różnych ścieżek logiki prawnej; i po trzecie, brakuje im różniczkowalnego mechanizmu śledzenia propagacji błędów, co uniemożliwia zlokalizowanie krawędzi o wysokim wkładzie i rekonstrukcję ścieżek odpowiedzialności. Niniejszy artykuł konstruuje relacyjną sieć konwolucyjną na grafach, która rozwiązuje problem fuzji heterogeniczności semantycznej poprzez przypisanie dedykowanej macierzy transformacji do każdego typu semantycznej krawędzi prawnej i wprowadzenie mechanizmu uwagi w celu dynamicznej regulacji międzytypowego przepływu informacji. Ponadto, dzięki połączeniu wstecznej propagacji gradientu i ekstrakcji podgrafów, umożliwia ona interpretowalny przejście od oceny zgodności na poziomie makro do śledzenia błędów na poziomie mikro, przełamując barierę tradycyjnych modeli grafowych, które wspierają jedynie wnioskowanie statyczne.
Poza domeną medyczną, ostatnie postępy w metodach opartych na grafach oraz metodach ewolucyjnych wykazały szeroką przydatność w przetwarzaniu ustrukturyzowanej wiedzy. Na przykład Xue i wsp. zaproponowali wielowarstwowe hybrydowe podejście programowania genetycznego do adaptacyjnej konstrukcji cech podobieństwa w dopasowywaniu ontologii, osiągając stabilne wyrównanie w heterogenicznych grafach wiedzy34. Cheng i wsp. przedstawili kompleksowy przegląd zastosowań grafowych sieci splotowych w rekonstrukcji obrazów, systematycznie kategoryzując metody odszumiania, super-rozdzielczości oraz usuwania rozmycia35. Li i wsp. zaprezentowali szczegółowy przegląd ewolucyjnego uczenia głębokiego z perspektywy zautomatyzowanego uczenia maszynowego, obejmujący zasady, algorytmy, zastosowania oraz otwarte wyzwania36. Ma i wsp. opracowali ramowy system rozmytego wyszukiwania architektury sieci neuronowej do rozpoznawania defektów w warunkach niepewności, wykazując skuteczność wyszukiwania ewolucyjnego w obsłudze niejednoznacznych danych37. Badania te podkreślają potencjał integracji reprezentacji o strukturze grafu z optymalizacją ewolucyjną w złożonych zadaniach podejmowania decyzji.
Głównym celem niniejszej pracy jest ustanowienie w pełni interpretowalnego modelu analizy zgodności prawnej sztucznej inteligencji w medycynie, wprowadzając innowacje na trzech poziomach. Na poziomie reprezentacji wiedzy jest to pierwsze podejście modelujące klauzule prawne, praktyki medyczne, moduły algorytmiczne oraz strony odpowiedzialne jako cztery typy heterogenicznych węzłów. W oparciu o praktykę prawną wyekstrahowano cztery rodzaje relacji skierowanych: „naruszenie”, „podstawa”, „wyzwalacz” oraz „atrybucja”, co pozwoliło na skonstruowanie skierowanego grafu wiedzy z prawną logiką przyczynową, stanowiącego ustrukturyzowany fundament semantyczny dla analizy zgodności. W zakresie śledzenia źródeł stronniczości zaproponowano metodę kwantyfikacji wkładu krawędzi opartą na czułości gradientu. Poprzez propagację wsteczną wyznaczono zbiór krawędzi maksymalizujących błąd wyjściowy, a następnie zastosowano algorytm wykrywania społeczności w celu zgrupowania węzłów o wysokim wkładzie, przekształcając „stronniczość czarnej skrzynki” w „białe skrzynki klastrów odpowiedzialności”, co umożliwia atrybucję w oparciu o operacyjny łańcuch dowodowy. Na poziomie monitorowania dynamicznego w czasie rzeczywistym opracowano mechanizm tymczasowego osadzania węzłów decyzji, który mapuje bieżące wyniki AI na przestrzeń grafu wiedzy. Na podstawie porównania bliskości osadzeń skwantyfikowano stopień odchylenia od norm oraz monitorowano zmiany wag kluczowych krawędzi prawno-technicznych, aby sygnalizować akumulację stronniczości systemowej. Paradygmat ten rozwiązuje problemy fragmentacji semantycznej oraz trudności w śledzeniu źródeł, przekształcając zgodność prawną z weryfikacji ex post w zarządzanie ex ante, oferując skalowalną ścieżkę techniczną dla przejrzystości odpowiedzialności w systemach AI wysokiego ryzyka.
Protokół
Konstrukcja grafowej sieci neuronowej dla grafu wiedzy prawnej w obszarze sztucznej inteligencji medycznej
Jak pokazano na Rysunku 1, proponowana struktura składa się z trzech głównych modułów. Warstwa wejściowa integruje dane z wielu źródeł w graf heterogeniczny za pomocą multimodalnego kodowania encji i modelowania krawędzi skierowanych. Warstwa GCN uwzględniająca relacje przeprowadza następnie semantyczne wyrównanie międzymodalne poprzez wagi specyficzne dla typów oraz mechanizm uwagi, generując ujednolicone osadzenia węzłów. Ostatecznie osadzenia te umożliwiają śledzenie błędów systematycznych (poprzez wsteczną propagację gradientu i detekcję społeczności) oraz dynamiczne monitorowanie zgodności (poprzez mapowanie węzłów w czasie rzeczywistym i śledzenie wag krawędzi), a wynik dostarcza organom regulacyjnym interpretowalnych dowodów atrybucji oraz alertów o ryzyku.
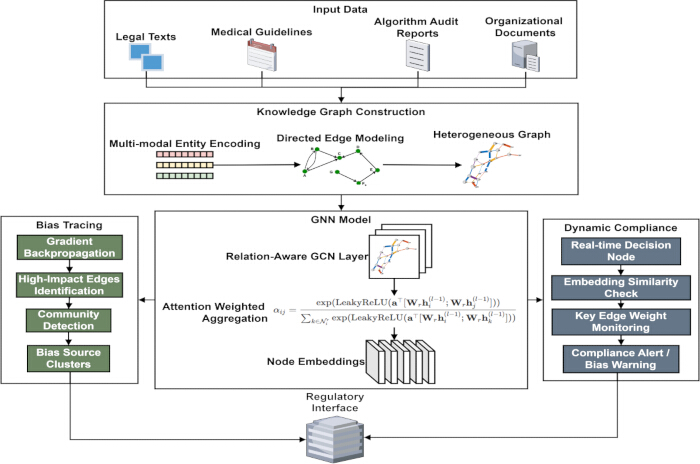
Rysunek 1Architektura grafu wiedzy prawnej i śledzenia stronniczości dla sztucznej inteligencji w medycynie. Ten schemat ilustruje ogólny przebieg pracy proponowanego frameworka. Warstwa wejściowa integruje heterogeniczne dane z wielu źródeł (teksty prawne, wytyczne kliniczne, raporty z audytu algorytmów), które są kodowane do czterech typów encji (klauzule prawne, zachowania medyczne, moduły algorytmu, strony odpowiedzialne) i łączone za pomocą czterech skierowanych relacji prawno-semantycznych (naruszenie, podstawa, wyzwalacz, przypisanie). Warstwa GCN uwzględniająca relacje wykonuje multimodalne dopasowanie semantyczne za pomocą wag specyficznych dla typu oraz mechanizmu uwagi. Moduł śledzenia błędów systematycznych wykorzystuje wsteczną propagację gradientu do identyfikacji krawędzi o wysokim wkładzie, a następnie stosuje detekcję społeczności w celu zlokalizowania klastrów węzłów głównych. Dynamiczny monitor zgodności mapuje decyzje podejmowane w czasie rzeczywistym na węzły tymczasowe, ocenia podobieństwo osadzeń w odniesieniu do klauzul prawnych i śledzi ewolucję wag krawędzi w celu wczesnego ostrzegania. Wyniki obejmują interpretowalne dowody przypisania oraz alerty o ryzyku. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Kodowanie jednostek prawnych i relacji w strukturze grafu heterogenicznego
Z przepisów regulujących kwestie sztucznej inteligencji w medycynie, wytycznych praktyki klinicznej oraz raportów z audytów algorytmów konsekwentnie wyodrębniane są cztery podstawowe encje: klauzule prawne, procedury medyczne, moduły algorytmiczne oraz podmioty odpowiedzialne. Dla każdego rodzaju encji zaproponowano oddzielny model uczenia reprezentacji cech, aby były one semantycznie rozróżnialne. Węzły klauzul prawnych są zorganizowane tak, aby zawierać numer klauzuli prawnej, który służy jako unikalny identyfikator (ID) danej klauzuli. Jednocześnie zdefiniowano wskaźnik ilościowy dotkliwości kary, aby określić poziom odpowiedzialności prawnej związanej z daną klauzulą, i w konsekwencji ustanowiono wektor cech.
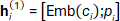 (1)
ci to numer wpisu, Emb(·) oznacza odwzorowanie osadzenia w niskowymiarowej przestrzeni, a [·;·] oznacza operację konkatenacji wektorów. Reprezentacja ta zachowuje zarówno strukturę formalną, jak i surowość kary zawartą w tekście prawnym, wspierając rozumowanie międzyoświadczeniowe.
Węzły zachowań medycznych są zestandaryzowane i zakodowane w oparciu o system klasyfikacji operacji klinicznych, z których wyodrębniono poziom ryzyka rj ∈ {1,2,3} oraz zbiór przypisanych etykiet scenariuszy sj ⊂ S, gdzie S jest pełnym zbiorem zdefiniowanych kategorii scenariuszy. Do przetwarzania zbioru etykiet wykorzystuje się kodowanie multi-hot, które następnie jest łączone z osadzeniem (embeddingiem) poziomu ryzyka w celu utworzenia reprezentacji początkowej:
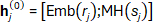 (2)
Strategia ta zapewnia, że różne rodzaje zachowań medycznych mają mierzalne relacje dystansowe w przestrzeni wektorowej, co umożliwia porównania między scenariuszami. Funkcja osadzania tekstu Emb(·) jest zaimplementowana przy użyciu wstępnie wytrenowanego chińskiego modelu języka prawniczego Lawformer (wytrenowanego na wielkoskalowym chińskim korpusie prawnym), przy wymiarze wyjściowym ustalonym na 768.
W oparciu o zależności logiczne i ograniczenia prawne między encjami ustanowiono cztery typy skierowanych relacji semantycznych: „naruszenie”, „podstawa”, „wyzwalacz” oraz „przypisanie”, z których każdy odpowiada innym prawnym wzorcom przyczynowości. Każdej krawędzi eij ⊂ E przypisany jest typ etykiety tij ⊂ T = {violate, base, trigger, attribute} w celu późniejszej transmisji wiadomości dla rozpoznania relacji. Konstrukcja krawędzi ściśle przestrzega mechanizmu dopasowania reguł dziedzinowych: gdy zachowanie medyczne odbiega od wymagań normatywnych, ustanawiana jest krawędź „naruszenia” skierowana od węzła zachowania do odpowiedniego postanowienia prawnego; gdy postanowienie prawne służy jako techniczna podstawa zgodności operacji, ustanawiana jest krawędź „podstawy”; jeśli wynik modułu algorytmu bezpośrednio wyzwala wykonanie określonego zachowania medycznego, łączona jest krawędź „wyzwalacza”; relację przypisania odpowiedzialności ustanawia się na podstawie dokumentów odpowiedzialności organizacji i wniosków z audytu, tworząc krawędź „przypisania” między stroną odpowiedzialną a naruszeniem lub wadą algorytmu.
Po zainicjowaniu wszystkich węzłów tworzony jest graf heterogeniczny (V, E, H0), gdzie V jest zbiorem węzłów, E jest zbiorem krawędzi skierowanych z etykietami typów, a H0 jest początkową macierzą cech. Aby zwiększyć semantyczną zdolność dyskryminacyjną struktury grafu, cechy węzłów są normalizowane:
 (3)
μk i σk to odpowiednio średnia i odchylenie standardowe k-tej cechy węzła w zbiorze treningowym, a ∈ jest małą stałą zapobiegającą dzieleniu przez zero. Normalizacja zapewnia, że heterogeniczne cechy z wielu źródeł uczestniczą w operacjach splotu grafowego w jednolitej skali, co zapobiega efektom dominacji numerycznej zakłócającym uczenie semantyczne. Wynikowy ustrukturyzowany model grafu w pełni oddaje topologię relacyjną czterowymiarowych elementów prawa, zachowania, technologii i odpowiedzialności w medycznym systemie AI, stanowiąc obliczalną podstawę grafową dla późniejszej analizy propagacji stronniczości.
Udoskonalenie wyrównania splotu grafowego dla międzymodalnej semantyki prawnej
Sieć splotowa na grafach uwzględniająca relacje (relation-aware graph convolutional network)38,39, która rozszerza strukturę Relational Graph Convolutional Network (R-GCN), jest wykorzystywana do propagacji cech przez wiele warstw początkowego grafu heterogenicznego. Podczas gdy R-GCN wprowadza macierze transformacji dla każdej relacji w przypadku ogólnych danych relacyjnych, nasze podejście dodatkowo włącza uczenie się mechanizmu uwagi (attention mechanism) w celu dynamicznego ważenia wkładu sąsiadów oraz definiuje cztery specyficzne typy relacji prawno-semantycznych (naruszenie, podstawa, wyzwalacz, atrybucja), dostosowane do analizy zgodności medycznej sztucznej inteligencji. Operacja w każdej warstwie niezależnie parametryzuje proces transformacji w oparciu o typ semantyczny krawędzi. W przypadku dowolnego węzła docelowego, informacje o jego sąsiedztwie są grupowane i agregowane według typów łączących je krawędzi. Każdy typ relacji jest wyposażony w dedykowaną macierz transformacji liniowej, aby zróżnicować cechy przesyłane wzdłuż różnych ścieżek semantyki prawnej40,41. Jeśli krawędź między węzłem klauzuli prawnej a węzłem zachowania medycznego jest typu „podstawa”, to gdy węzeł klauzuli prawnej otrzymuje komunikat z węzła zachowania medycznego, stosuje on odpowiednią macierz wag w celu przestrzennego zmapowania cech sąsiada. W ten sam sposób, gdy węzeł zachowania medycznego wysyła wyjście za pośrednictwem węzła modułu schematu integracji krawędzi „wyzwalacz” do modułu algorytmu, stosowana jest macierz parametrów przypisana do tej relacji, która wykonuje transformację cech. Naśladuje to płynność różnych typów logiki prawnej, realizując/informując różne warstwy logiki w celu zachowania niezależności semantycznej podczas przepływu informacji, bez szumu między-modalnego. Agregację definiuje się następująco:
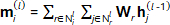 (4)
mi(l) oznacza kompletne informacje zebrane przez węzeł i w warstwie l, Nil to jego zbiór sąsiadów w relacji r, Wr to macierz transformacji liniowej, a hj(l−1) to reprezentacja osadzenia węzła sąsiedniego w poprzedniej warstwie.
W celu dynamicznego dostosowania intensywności wpływu różnych węzłów sąsiednich na aktualizację reprezentacji węzła docelowego, podczas agregacji komunikatów wprowadzono uczący się mechanizm uwagi42,43. Współczynnik uwagi jest generowany w oparciu o dwa czynniki: podobieństwo atrybutów węzła oraz istotność prawną, bez polegania na stałych wagach a priori. W przypadku węzłów dotyczących klauzul prawnych, podczas odbierania cech sąsiednich zachowań medycznych, wynik uwagi jest obliczany na podstawie skwantyfikowanej wartości intensywności kary związanej z tymi zachowaniami; natomiast gdy węzeł modułu algorytmicznego integruje informacje o zachowaniach medycznych, koncentruje się on na sąsiadach o wyższym poziomie ryzyka operacyjnego. Wagę uwagi oblicza się w następujący sposób:
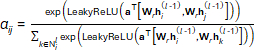 (5)
αij to współczynnik uwagi węzła j względem węzła i, a a to uczenie się wektor uwagi. Model ten umożliwia automatyczną identyfikację ścieżek połączeń o wysokim ryzyku lub wysokich ograniczeniach podczas uczenia end-to-end, przypisując im wyższą uwagę. Końcowe zaktualizowane osadzenie węzła jest określone przez wiadomości ważone i połączenia rezydualne.
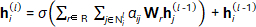 (6)
σ jest funkcją aktywacji, a konstrukcja rezydualna łagodzi problem zanikającego gradientu podczas głębokiej propagacji i gwarantuje stabilność w obecności wielu konfliktów semantycznych. Po L = 3 grafowych warstwach splotowych (każda z wymiarem ukrytym wynoszącym 256 i aktywacją ReLU), osadzenia wszystkich węzłów w sposób płynny włączają międzymodalne informacje kontekstowe i stają się ujednoliconymi reprezentacjami z możliwościami prawnej dyskryminacji semantycznej.
Na Rysunku 2 przedstawiono dwa alternatywne schematy analizy zgodności prawnej dla sztucznej inteligencji (AI) w ochronie zdrowia, których celem jest wizualizacja rodzajów relacji prawnych oraz dróg propagacji stronniczości, wskazując potencjalne źródła błędów w procesie podejmowania decyzji. Rysunek 2A obrazuje wpływ różnych semantycznych relacji prawnych, gdzie cztery typy relacji zostały zakodowane kolorystycznie, a dla każdego typu krawędzie wyróżniono innym kolorem. Grubość krawędzi odpowiada wadze uwagi danej relacji, tj. w jakim stopniu relacja ta wpływa na decyzję AI. Gruba krawędź wskazuje w zasadzie dominującą relację prawną w decyzji, która w tym przypadku w wystarczającym stopniu uzasadniła wynik sprawy. Wielkość węzła jest mierzona jego wkładem w naruszenia: większe węzły oznaczają silniejszy związek między postępowaniem a konkretnymi klauzulami prawnymi, a tym samym wyższe ryzyko potencjalne. Powyższa wizualizacja zapewnia przejrzystą warstwę semantyki prawnej, która umożliwia zidentyfikowanie najsilniejszych i najryzykowniejszych ścieżek prawnych w procesach decyzyjnych AI. Rysunek 2B wskazuje również ścieżki o wysokim wkładzie (w propagację stronniczości), kładąc nacisk na krawędzie o wysokim znaczeniu, które w procesie podejmowania decyzji zostały pogrubione i uzupełnione liniami przerywanymi (np. B1-B3). Podwojenie szerokości tych krawędzi reprezentuje ich znaczenie w rozprzestrzenianiu systemowej stronniczości. To, jakie kombinacje reguł prawnych i zachowań technicznych prowadzą do tego efektu wzmocnienia stronniczości, pokazano na Rysunku 2. Analiza ta nie tylko ujawnia ścieżkę propagacji stronniczości, ale także ułatwia identyfikację jej źródła, na podstawie czego można ustanowić audyt zgodności oraz odpowiedzialność narzędzia AI.
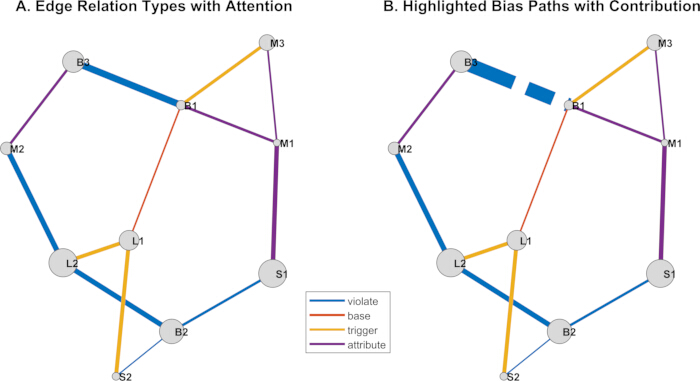
Rycina 2Analiza zgodności z przepisami prawa oraz propagacji uprzedzeń w sztucznej inteligencji w ochronie zdrowia (przykład ilustracyjny). (A) Relacje semantyczne w zakresie prawnym oznaczone kolorami: naruszenie (czerwony), podstawa (niebieski), wyzwalacz (zielony), atrybucja (pomarańczowy). Grubość krawędzi jest proporcjonalna do wagi uwagi, co wskazuje na wpływ każdej relacji na decyzję AI. Rozmiar węzła jest proporcjonalny do jego wkładu w naruszenie, co wyróżnia ryzykowne encje. (B) Podgraf propagacji stronniczości: krawędzie o wysokim wkładzie są pogrubione i przerywane (np. B1‑B3); krawędzie o podwójnej szerokości wskazują na amplifikację stronniczości systemowej. Wizualizacja ta wspomaga identyfikację dominujących ścieżek prawnych, źródeł stronniczości oraz audyt zgodności. Skale pomiarowe i słupki błędów nie mają zastosowania, ponieważ jest to ilustracja schematyczna. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Mechanizm backtrackingu podgrafu dla ścieżki propagacji obciążenia
W niniejszym badaniu „bias” (stronniczość) definiuje się jako systematyczne odchylenie wyniku systemu AI od decyzji oczekiwanej klinicznie i prawnie, mierzone rozbieżnością między przewidzianym przez model wynikiem ryzyka a etykietą zgodności stanowiącą prawdę obiektywną (ground-truth). Sygnał stronniczości jest kwantyfikowany jako strata entropii krzyżowej (cross-entropy loss) między końcowym wynikiem algorytmu a binarnym wskaźnikiem zgodności (1 dla zgodnych, 0 dla niezgodnych), zagregowana dla wszystkich instancji decyzji w partii (batch).
Po przeszkoleniu grafowej sieci neuronowej wykorzystuje się jej różniczkowalność do przeprowadzenia analizy wstecznej propagacji sygnału obciążenia w warstwie wyjściowej. Rozpoczynając od węzła decyzyjnego algorytmu wykrywającego anomalie, oblicza się wielkość gradientu funkcji straty w odniesieniu do każdej krawędzi łączącej, aby ilościowo określić wkład każdej krawędzi w powstawanie obciążenia. Proces ten jest realizowany za pomocą frameworka automatycznego różniczkowania, który cofa się warstwa po warstwie wzdłuż krawędzi skierowanych w strukturze grafu, aby uzyskać siłę wpływu transformacji każdego parametru krawędzi na końcową zmianę wyjściową. Im wyższa wartość bezwzględna gradientu, tym bardziej dominująca jest relacja prawno-techniczna niesiona przez daną krawędź w propagacji obciążenia. Wkład krawędzi definiuje się jako:
 (7)
Lbias to różniczkowalna strata zdefiniowana dla zachowań stronniczych, a wi to wektor wag wejściowych odpowiadający typowi krawędzi. Wartość tego gradientu odzwierciedla stopień udziału konkretnej relacji semantycznej w aktualnym błędzie systematycznym (bias). Po ocenieniu wszystkich krawędzi w ten sposób, wyznaczany jest dynamiczny próg τ w celu odfiltrowania zbioru krawędzi o wysokim wkładzie Ehigh, których wkład przekracza gij > τ, co tworzy początkowy podgraf propagacji błędów Gbias = (Vbias, Ehigh). Konkretnie, τ jest określany jako 85. percentyl absolutnych wartości gradientów dla wszystkich krawędzi w każdej epoce treningowej, co gwarantuje, że do konstrukcji podgrafu zachowanych zostanie tylko 15% najbardziej wpływowych krawędzi. Podgraf ten koncentruje się na kluczowych ścieżkach połączeń, które najprawdopodobniej generują systematyczny błąd, co kompresuje przestrzeń poszukiwań i zwiększa wydajność śledzenia źródła.
W obrębie skonstruowanego podgrafu propagacji obciążeń wykonuje się algorytm detekcji społeczności kierowany klastrowaniem spektralnym, aby zidentyfikować wysoko spójne struktury klastrów węzłów. Proces ten opiera się na faktoryzacji znormalizowanej macierzy Laplace'a podgrafu, mapowaniu osadzeń węzłów do niskowymiarowej przestrzeni spektralnej oraz zastosowaniu w tej przestrzeni strategii klastrowania uwzględniającej gęstość, aby zapewnić grupowanie węzłów różnych typów (takich jak klauzule prawne i moduły algorytmiczne) w tym samym klastrze, gdy są one ściśle powiązane funkcjonalnie. Każda zidentyfikowana społeczność reprezentuje potencjalną pętlę funkcjonalną lub jednostkę agregacji odpowiedzialności. Wyniki podziału na społeczności są kierowane następującymi celami optymalizacji:
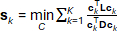 (8)
L=D−A to macierz Laplasjanu podgrafu, A to macierz sąsiedztwa, D to macierz stopni, ck to wektor wskaźnikowy k-tej wspólnoty, a K to ustalona liczba wspólnot. Kryterium to maksymalizuje minimalną różnicę cięcia między wspólnotami, zapewniając silne połączenia wewnętrzne.
Następnie przeprowadzana jest analiza oparta na kompozytach międzywarstwowych dla każdej społeczności. Jeśli społeczność zawiera węzły klauzul prawnych oraz węzły modułów algorytmicznych, zostaje ona oznaczona jako potencjalne źródło stronniczości. Aby przetestować przyczynowość, przeprowadza się test interwencyjny: wszystkie krawędzie w tym obszarze są tymczasowo usuwane z grafu, ponownie wykonuje się ten sam proces podejmowania decyzji i odnotowuje różnice w pomiarach stronniczości. Miara ważności przyczynowej jest zdefiniowana jako:
 (9)
Borig oraz Bmask reprezentują odpowiednio siłę obciążenia modelu oryginalnego oraz obciążenie po maskowaniu. Jeśli miara ważności przyczynowej znajduje się znacznie powyżej predetermined threshold, oznacza to, że klaster węzłów został zidentyfikowany jako wyjaśnialne źródło obciążenia, co będzie wyznaczać późniejszą korekcję zgodności i przypisywanie błędów.
Dynamiczna weryfikacja zgodności z ograniczeniami prawnymi
Instancje decyzji w czasie rzeczywistym, pojawiające się podczas pracy medycznego systemu AI, są wprowadzane jako węzły przejściowe i osadzane w wyuczonej przestrzeni grafu wiedzy. Każdy węzeł generuje początkowy wektor cech poprzez odczytanie swojego kontekstu wejściowego, zachowania wyjściowego oraz stanu algorytmu. Następnie wektor ten jest przekazywany do grafowej sieci neuronowej z zamrożonymi parametrami w celu wykonania jednowarstwowej propagacji w przód, co pozwala uzyskać osadzenie zgodne z grafem wiedzy bez zmiany oryginalnej struktury grafu. W ten sposób umożliwione zostaje porównywanie węzłów przejściowych i węzłów klauzul prawnych we wspólnej przestrzeni semantycznej.
Następnie oblicz podobieństwo cosinusowe między węzłem przejściowym a każdym z węzłów klauzul prawnych:
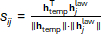 (10)
htemp to osadzenie węzła tymczasowego, a hjlaw to osadzenie węzła j-tego zapisu prawnego. Wartość podobieństwa w praktyce odzwierciedla stopień dopasowania semantycznego między bieżącą decyzją a każdym ograniczeniem prawnym. Dynamiczny próg zgodności θ jest ustalany na podstawie rozkładu podobieństwa historycznych próbek zgodnych, aby dostosować granicę rozstrzygnięcia do różnych scenariuszy zastosowań. Konkretnie, θ = µ - 2σ, gdzie µ i σ to średnia oraz odchylenie standardowe rozkładu podobieństwa cosinusowego obliczonego z zestawu walidacyjnego składającego się z 50 znanych zgodnych instancji decyzji.
Jeśli wynik podobieństwa cosinusowego spadnie poniżej dynamicznego progu zgodności, przyjmuje się, że odpowiedni przepis prawa został naruszony, co uruchamia mechanizm powiadamiania o braku zgodności. Powiadomienie zawiera również numer minimalnie dopasowanego zapisu prawnego, wartość podobieństwa oraz kierunek analizy rozbieżności, co powinno być wystarczające, aby organy regulacyjne mogły podjąć niezwłoczne działania. Podejście to zapewnia interpretowalne odwzorowanie z nieprzejrzystego procesu podejmowania decyzji na przestrzeń semantyki prawnej i ułatwia sprawdzanie zgodności w czasie rzeczywistym.
Podczas ciągłej pracy monitorowany jest trend zmian wag kluczowych krawędzi połączeń technologia-prawo w podgrafie propagacji obciążenia. Szczególna uwaga skupiona jest na krawędziach łączących węzły modułów algorytmicznych z węzłami klauzul prawnych, ponieważ bezpośrednio reprezentują one siłę odpowiedzi zachowania technicznego na konkretne regulacje. Parametry macierzy transformacji dla każdej krawędzi docelowej są rejestrowane podczas wnioskowania, a ich norma jest wyodrębniana jako dynamiczny wskaźnik ewolucji siły korelacji między nimi. Definiując sekwencję siły krawędzi jako:
 (11)
wt reprezentuje normę Frobeniusa macierzy wag odpowiadającej relacji między krawędzią eij w znaczniku czasu t, a Wkl(t) jest macierzą parametrów faktycznie używaną w modelu w tym czasie. Wskaźnik ten odzwierciedla głębokość uczenia modelu lub jego zależność od ograniczenia prawnego.
W sekwencji przeprowadzany jest test monotoniczności z przesuwnym oknem, a ulepszony test znaków służy do określenia, czy zaobserwowano istotny trend wzrostowy. Jeśli przyrosty w N kolejnych krokach czasowych spełniają warunek dominacji dodatniej, przyjmuje się, że krawędź wykazuje zjawisko abnormalnego wzmocnienia. Po dodatkowym połączeniu z historycznymi danymi o wkładzie gradientu, jeśli krawędź została zidentyfikowana jako ścieżka o wysokim wpływie w poprzedniej rundzie analizy śledzenia źródła, uruchamiany jest proces wczesnego ostrzegania o akumulacji błędu systematycznego.
Na koniec generowany jest raport śledzenia źródła, zawierający informacje o węzłach na obu końcach krawędzi docelowej, krzywe zmian wag, statystyki częstotliwości powiązanych decyzji oraz potencjalne rekomendacje atrybucji. Mechanizm ten umożliwia przejście od statycznej oceny zgodności do dynamicznego przewidywania ryzyka, wspierając proaktywną interwencję w przypadku potencjalnych odchyleń instytucjonalnych.
Dane i projekt eksperymentalny
Aby zweryfikować skuteczność proponowanego modelu, w niniejszej pracy skonstruowano wieloźródłowy zbiór danych heterogenicznych, integrujący rzeczywiste regulacje oraz dane symulacyjne, a także zaprojektowano rygorystyczne eksperymenty kontrolne. Źródła danych obejmują krajowe regulacje dotyczące sztucznej inteligencji w medycynie, wytyczne leczenia klinicznego, raporty z audytów algorytmów open-source oraz logi decyzji z symulacji. Po przeprowadzeniu preprocessingu zbudowano referencyjny heterogeniczny graf wiedzy zawierający 285 węzłów (85 klauzul prawnych, 120 zachowań medycznych, 42 moduły algorytmiczne i 38 podmiotów odpowiedzialnych) oraz 1247 krawędzi skierowanych, co przedstawiono na Rysunku 3.
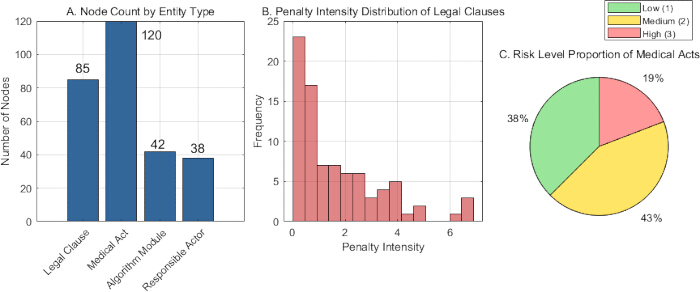
Rysunek 3Rozkład i charakterystyka heterogenicznych typów encji. (A) Wykres słupkowy przedstawiający liczbę węzłów dla każdego typu encji: klauzule prawne (85), zachowania medyczne (120), moduły algorytmu (42), strony odpowiedzialne (38). (B) Histogram intensywności kary dla węzłów klauzul prawnych, podzielony na kategorie: niską (0–0,33), średnią (0,34–0,6) i wysoką (0,67–1,0); oś pionowa przedstawia liczbę wystąpień. (C) Wykres kołowy rozkładu poziomu ryzyka w węzłach zachowań medycznych: niski (19%), średni (43%), wysoki (38%). Wszystkie wartości stanowią liczby bezwzględne lub percentages; nie przedstawiono słupków błędów, ponieważ są to statystyki opisowe zbioru danych. Prosimy o kliknięcie tutaj, aby wyświetlić większą wersję tego rysunku.
Rysunek 3 ilustruje rozkład i charakterystykę węzłów encji w heterogenicznym grafie wiedzy. Rysunek 3A przedstawia rozkład liczby czterech typów węzłów encji, z czego najliczniejsze są węzły „zachowań medycznych” (120), następnie „klauzule prawne” (85), natomiast „moduły algorytmiczne” (42) i „podmioty odpowiedzialne” (38) występują w mniejszej liczbie. Wynika to z faktu, że struktura grafu została zaprojektowana w oparciu o zachowania i reguły. Rysunek 3B przedstawia rozkład intensywności kar dla węzłów reprezentujących pojedynczą klauzulę prawną, gdzie intensywność określa surowość odpowiedzialności prawnej. Dane wskazują, że istnieje stosunkowo niewiele przepisów o wysokiej intensywności kary, a większość z nich mieści się w przedziale od średniej do niskiej intensywności, co jest zgodne z rzeczywistością, w której w realnych systemach prawnych istnieje tylko kilka klauzul dotyczących ciężkich naruszeń. Rysunek 3C ilustruje rozkład poziomu ryzyka w węzłach zachowań medycznych, gdzie zachowania o średnim ryzyku stanowią największy odsetek 43%, a zachowania o niskim ryzyku najmniejszy odsetek 19%, co wskazuje, że scenariusze medyczne są zazwyczaj rutynowe, a operacje wysokiego ryzyka podlegają bardziej rygorystycznym ograniczeniom powiązań w grafie. Statystyki te wspólnie uzasadniają przyjęty w konstrukcji grafu wiedzy schemat kodowania dysambiguacji encji, aby zapewnić wsparcie cech dla późniejszego wyrównania splotowego grafu.
Cały zbiór danych został losowo podzielony na zbiory treningowy (70%), walidacyjny (10%) i testowy (20%), z warstwami dostosowanymi do typu węzła i rozkładu relacji, aby zachować ogólną strukturę grafu w każdym podziale. Ten sam podział stosowano konsekwentnie dla wszystkich metod bazowych, aby zapewnić sprawiedliwe porównanie. Oprócz tego podstawowego podziału, trzy gradienty gęstości grafu wiedzy (rzadki, średni, gęsty) oraz trzy ustawienia złożoności międzyjurysdykcyjnej (pojedyncza, bilateralna, multilateralna) opisane powyżej służą jako niezależne środowiska testowe, które wspólnie oceniają odporność metody w warunkach zmiennej kompletności danych i stopnia nakładania się przepisów. W celu stworzenia etykiet prawdy obiektywnej (ground-truth) do oceny lokalizacji stronniczości przyjęto dwuetapową strategię: (1) adnotacja ekspercka — trzech ekspertów z dziedziny prawa i medycyny niezależnie przeanalizowało logi decyzji i zidentyfikowało węzły przyczyn źródłowych oraz ścieżki propagacji dla każdego zarejestrowanego naruszenia zgodności, a rozbieżności rozstrzygano głosowaniem większościowym; (2) symulowana iniekcja — w celu kontrolowanego testowania sztucznie wprowadzono sygnały stronniczości do 20 losowo wybranych ścieżek decyzji poprzez zaburzenie wag krawędzi w grafie wiedzy, zapewniając, że rzeczywiste węzły źródłowe i dotknięte krawędzie były znane a priori.
Dla wszystkich metod bazowych (TransE, ComplEx, GNN Explainer, KG-BERT oraz Node2Vec) zastosowano tę samą konfigurację treningową (optymalizator Adam, współczynnik uczenia 1 × 10⁻³, wielkość partii 64, 10 epok) oraz te same partycje danych co w naszej metodzie, aby zapewnić rzetelne porównanie. W przypadku TransE i ComplEx wymiar embeddingu ustawiono na 256 z marginesem 1,0; dla KG-BERT wykorzystano wstępnie wytrenowany model BERT-base z wielkością partii 16 i maksymalną długością sekwencji 128; dla GNNExplainer zastosowano 3-warstwową sieć GCN z tym samym wymiarem ukrytym wynoszącym 256; natomiast dla Node2Vec ustawiono długość spaceru na 80, liczbę spacerów na węzeł na 10 oraz wymiar embeddingu na 256.
Aby zapewnić rzetelne porównanie, wszystkie metody bazowe dostosowano do tych samych zadań lokalizacji stronniczości, a mianowicie identyfikacji węzła głównego oraz rekonstrukcji ścieżki propagacji. W przypadku metod TransE, ComplEx i Node2Vec, które nie są z natury wyjaśnialne, obliczono gradient straty stronniczości względem osadzenia każdego węzła i wykorzystano wielkość gradientu jako wskaźnik istotności węzła; węzły główne wybrano poprzez zastosowanie progu dla tych wskaźników, a ścieżki propagacji zrekonstruowano poprzez zachowanie krawędzi o najwyższym wkładzie gradientu. W przypadku GNNExplainer bezpośrednio wykorzystano wbudowane mechanizmy istotności krawędzi i maskowania węzłów w celu uzyskania zarówno węzłów głównych, jak i podgrafów. Dla KG‑BERT, który operuje na tripletach, każdą krawędź grafu przekształcono w tekstowy triplet i wykorzystano wagi uwagi modelu dla encji do wyprowadzenia istotności węzłów, a następnie zastosowano tę samą strategię progowania w celu rekonstrukcji ścieżki. Dzięki tym dostosowaniom każda metoda bazowa generuje zarówno predykcje węzła głównego, jak i predykcje ścieżki propagacji, co umożliwia jednolitą ewaluację wszystkich metod.
Ocena koncentruje się na czterech podstawowych możliwościach: dokładności dopasowania semantycznego, zdolności do lokalizowania błędów poznawczych, efektywności rozliczalności oraz generalizacji w różnych domenach. Przedstawiono w niej również trzy istotne zmienne kontrolne, które odwzorowują złożoność świata rzeczywistego.
1) Gradient gęstości grafu wiedzy: Aby ocenić, jak metoda radzi sobie przy różnych poziomach kompletności informacji, z bazowego grafu pełnego (gęstość D = 1.0) tworzone są dwa podzbiory w oparciu o strategię losowego usuwania krawędzi w następujący sposób:
Graf rzadki (D ~ 0,3): 30% krawędzi zostaje zachowanych w sposób losowy, co symuluje etap wczesnego konstruowania wiedzy z pominięciem znacznej ilości informacji.
Graf o średniej gęstości (D ~ 0.6): 60% krawędzi zostaje zachowanych w sposób losowy, co symuluje typowy scenariusz częściowo znanej struktury wiedzy.
Gęsty graf (D = 1.0): Wykorzystanie wszystkich 1247 krawędzi, co odpowiada optymalnemu scenariuszowi stosunkowo pełnej wiedzy.
2) Sytuacja częstotliwości podejmowania decyzji przez medyczną AI: Ustawiono trzy obciążenia przepływu decyzji sztucznych w celu przetestowania wydajności monitorowania zgodności w czasie rzeczywistym:
Niska częstotliwość 10 Hz: Średnio na sekundę generowanych jest 10 zdarzeń decyzyjnych, co symuluje monitorowanie systemów małoscale'owych lub jednopunktowych.
Częstotliwość średnia 50 Hz: 50 zdarzeń decyzyjnych na sekundę, symulujących obciążenie systemu AI w regionalnych lub średniej wielkości placówkach medycznych.
Wysoka częstotliwość 100 Hz: 10 zdarzeń decyzyjnych na sekundę symuluje scenariusze wysokiego obciążenia współbieżnego dla usług AI wdrażanych w dużym szpitalu lub platformie chmurowej.
3) Gradient złożoności międzyjurysdykcyjnej: Aby przetestować przenaszalność modelowania ograniczeń prawnych, skonstruowano trzy zestawy testowe oparte na stopniu złożoności:
Pojedyncza jurysdykcja: Obejmuje wyłącznie aktualne chińskie prawa i przepisy regulujące sztuczną inteligencję w medycynie.
Jurysdykcja dwustronna: Obejmuje reżimy regulacyjne Chin oraz Unii Europejskiej, przy czym około 15% przepisów jest sprzecznych lub nakładających się na siebie.
Jurysdykcja wielostronna: Opierając się na dwóch poprzednich, dodatkowo integruje zasady prywatności i bezpieczeństwa z amerykańskiej ustawy HIPAA (Health Insurance Portability and Accountability Act), tworząc środowisko testowe, w którym systemy prawne trzech reżimów prawnych przeplatają się, co zwiększa wskaźnik konfliktów przepisów do około 25%.
Do oceny ilościowej wykorzystano następujące kluczowe wskaźniki:
1) Dokładność dopasowania semantycznego: Mierzy zdolność grafu do modelowania relacji między podmiotami prawnymi a technicznymi.
Dokładność dopasowania encji:
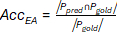 (12)
Ppred to zbiór par dopasowanych encji przewidzianych przez model, a Pgold to zbiór dopasowań wzorcowych (golden alignments) naniesionych przez ekspertów.
Zachowanie integralności relacji:
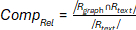 (13)
Rgraph to zrekonstruowany zbiór relacji w grafie, a Rtext to zbiór jawnych relacji wyodrębnionych z oryginalnego tekstu prawnego.
2) Zdolność lokalizacji stronniczości: Ocena skuteczności śledzenia przyczyn źródłowych i ścieżek propagacji stronniczości.
Wskaźnik odzyskiwania węzła korzenia:
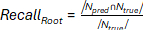 (14)
Npred to zbiór węzłów źródłowych obciążenia zidentyfikowanych przez model, a Ntrue to zbiór prawdziwych węzłów źródłowych oznaczonych przez ekspertów.
Dokładność ścieżki propagacji:
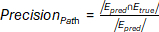 (15)
Epred to zbiór krawędzi w podgrafie propagacji obciążenia wywnioskowanym przez model, a Etrue to rzeczywisty zbiór krawędzi propagacji obciążenia.
3) Efektywność śledzenia odpowiedzialności: Przetestowanie wydajności systemu w scenariuszach monitorowania w czasie rzeczywistym.
Średnie opóźnienie śledzenia:
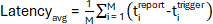 (16)
M oznacza całkowitą liczbę żądań, a titrigger oraz tireport to odpowiednio znaczniki czasu i-tego wyzwalacza stronniczości oraz generowania raportu źródłowego.
Przepustowość systemu:
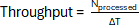 (17)
Nprocessed oznacza liczbę jednoczesnych żądań śledzenia pomyślnie przetworzonych w oknie czasowym ΔT.
4) Zdolność do generalizacji międzydomenowej: weryfikacja przystawalności metody do różnych systemów prawnych.
Zakres jurysdykcyjny:
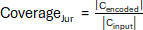 (18)
Cencoded oznacza liczbę różnych klauzul jurysdykcyjnych pomyślnie zakodowanych w grafie, a Cinput oznacza całkowitą liczbę klauzul wejściowych.
Wskaźnik wykrywania konfliktów ograniczeń:
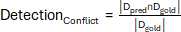 (19)
Dpred to zbiór sprzeczności logicznych w obszarze prawa wykrytych przez model, a Dgold to zbiór wszystkich par sprzeczności adnotowanych przez ekspertów.
Wszystkie eksperymenty przeprowadzono przy użyciu stacji roboczej wyposażonej w procesor wielordzeniowy oraz jednostkę przetwarzania graficznego; pełna specyfikacja sprzętowa została podana w Tabeli Materiałów.
Główne hiperparametry tego podejścia oraz ich wartości wymieniono w Tabeli 1; obejmują one strukturę modelu i konfigurację treningu, a także kluczowe progi, takie jak wymiar osadzenia, liczba warstw splotowych, szybkość uczenia oraz wielkość partii. Wszystkie parametry zostały dostrojone względem zbioru walidacyjnego za pomocą przeszukiwania siatkowego (grid search), wytrenowany model stabilnie zbiegł, a uzyskana wydajność jest optymalna. Niektóre progi zostały ustanowione zgodnie z kryteriami dziedzinowymi, aby spełnić wymogi wysokiej niezawodności w zakresie zgodności medycznej AI.
| Parametr | Wartość | Opis |
| Wymiar zanurzenia | 128 | Rozmiar wymiaru cech dla osadzeń węzłów |
| Liczba warstw splotowych | 3 | Głębokość relacyjnej grafowej sieci splotowej |
| Szybkość uczenia | 0.001 | Wstępna szybkość uczenia dla optymalizatora Adam |
| Wielkość partii | 32 | Liczba podgrafów przetwarzanych w partii |
| Współczynnik rezygnacji | 0.1 | Prawdopodobieństwo dropoutu stosowane do cech węzłów podczas trenowania |
| Liczba głowic uwagi | 8 | Liczba głowic w mechanizmie uwagi wielogłowicowej |
| Współczynnik regularyzacji L2 | 5 × 10⁻⁴ | Współczynnik zaniku wag dla regularyzacji parametrów |
| Próg podobieństwa | 0.75 | Minimalne podobieństwo osadzeń dla walidacji zgodności |
| Próg wkładu gradientu | 0.01 | Próg wyboru krawędzi o wysokim wpływie w konstrukcji podgrafu stronniczości |
| Wielkość okna monitorowania | 10 | Kroki czasowe wykorzystane do śledzenia dynamiki wag krawędzi |
Tabela 1: Główne ustawienia parametrów. Lista kluczowych hiperparametrów użytych w eksperymentach: wymiar osadzenia (256), liczba warstw GCN (3), wymiar ukryty (256), szybkość uczenia (1 × 10⁻³), rozmiar partii (64), wymiar wektora uwagi, próg wkładu krawędzi (85. percentyl wartości gradientów), dynamiczny próg zgodności (µ‑2σ, gdzie µ i σ pochodzą ze zbioru walidacyjnego składającego się z 50 zgodnych instancji), liczba społeczności K (wyznaczona przez grupowanie spektralne) oraz optymalizator (Adam). Wartości te zostały wybrane za pomocą przeszukiwania siatki (grid search) na zbiorze walidacyjnym.
Wyniki
Weryfikacja wydajności śledzenia pochodzenia stronniczości w grafie wiedzy prawnej AI w medycynie
Wydajność splotu grafowego uwzględniającego relacje
Poprzez wytrenowanie grafowej sieci konwolucyjnej uwzględniającej relacje, obliczono podobieństwa osadzeń między klauzulami prawnymi a węzłami zachowań medycznych w różnych warstwach konwolucyjnych, a następnie zarejestrowano efekt dopasowania każdej warstwy. Po drugie, poddano analizie statystycznej wagi uwagi przypisane do czterech semantycznych relacji prawnych po zakończeniu uczenia, aby określić znaczenie każdego typu relacji w agregacji cech. Na koniec przeanalizowano wzorzec zaniku wpływu węzłów sąsiednich wraz ze wzrostem odległości. Poprzez obliczenie wkładu węzłów o różnych odległościach przeskoków w aktualizację cech węzła centralnego, określono siłę propagacji wpływu i oceniono efektywny zasięg mechanizmu przekazywania wiadomości. Cały proces ewaluacji oparto na analizie ilościowej wewnętrznych parametrów i stanów aktywacji modelu, aby zapewnić obiektywizm i powtarzalność wyników.
Rycina 4 przedstawia wydajność grafowych sieci splotowych uwzględniających relacje w międzymodalnym wyrównaniu semantyki prawnej. Rycina 4A obrazuje trend podobieństwa osadzeń węzłów wraz ze wzrostem liczby warstw splotowych, które stopniowo wzrasta od 0,12 w warstwie 1 do 0,68 w warstwie 4. Ta progresywna tendencja wynika z następującego stopniowego współistnienia przestrzeni klauzul prawnych i przestrzeni zachowań medycznych w trakcie wielowarstwowego przekazywania komunikatów. Głębokie warstwy splotowe potrafią nauczyć się złożonych wzorców międzymodalnych powiązań semantycznych. Relacja „naruszenie” otrzymuje największą wagę 0,35 na Rycynie 4B, która pokazuje rozkład wag uwagi dla czterech typów relacji semantyki prawnej. Jest to zgodne z podstawowymi zasadami analizy zgodności prawnej, ponieważ model skupia się na powiązaniach z naruszeniami, aby wspierać rzetelną kontrolę ryzyka. Rycina 4C pokazuje wzorzec akumulacji wpływu węzłów sąsiednich w wielu skokach. Zmierzona siła wpływu rośnie monotonicznie od 0,15 przy 1 skoku do 0,92 przy 8 skokach, co wskazuje, że osadzenie węzła centralnego stopniowo włącza szersze informacje strukturalne z odległych węzłów. Ten nieoczekiwany wzrost w rzeczywistości oddaje pośrednią zależność węzłów centralnych od węzłów odległych. Gdy węzły są rozpatrywane w większej odległości skokowej, mogą one uzyskać bardziej globalne informacje strukturalne z większą ilością szumu i informacji redundantnych. Zatem w praktycznych zastosowaniach konieczne jest wypracowanie kompromisu między rozmiarem pola recepcyjnego a jakością informacji. Cała transformacja danych wykazała, że mechanizm uwzględniający relacje był skuteczny w przetwarzaniu powiązań między heterogenicznymi tekstami prawnymi a zachowaniami technologicznymi oraz że semantyka prawna mogła zostać dokładnie zamodelowana za pomocą zróżnicowanego projektu argumentów.
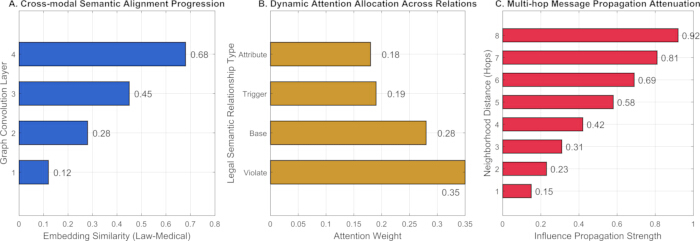
Rycina 4Wydajność wyrównania semantyki międzymodalnej sieci splotowych grafów świadomych relacji.(A) Podobieństwo osadzeń węzłów (podobieństwo cosinusowe) jako funkcja liczby warstw GCN (od 1 do 4), wykazujące rosnącą zbieżność między przestrzeniami zachowań prawnych i medycznych. (BRozkład wag uwagi dla czterech typów relacji (naruszenie, podstawa, wyzwalacz, atrybucja), przy czym najwyższą wagę (0,35) otrzymało naruszenie.C) Siła wpływu węzłów sąsiednich w zależności od odległości w skokach (od 1 do 8), określająca sposób kumulacji strukturalnych informacji wieloskokowych. Wszystkie wartości stanowią średnią z 30 niezależnych uruchomień; słupki błędów (pominięte dla przejrzystości) miały odchylenia standardowe poniżej 0,05 we wszystkich przypadkach, a trendy są monotoniczne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Aby zrozumieć proces optymalizacji parametrów oraz charakterystykę wydajności różnych typów prawnych relacji semantycznych w grafowej sieci konwolucyjnej uwzględniającej relacje, obliczono średnią wartość macierzy wag dla każdego typu relacji uzyskanej poprzez optymalizację parametrów, a następnie potwierdzono zbieżność uczenia parametrów metodą wstecznej propagacji błędów. W celu oceny jakości agregacji cech wykorzystano podobieństwo cosinusowe do zbadania spójności osadzeń węzłów różnych typów. Szybkość zbieżności obliczono na podstawie spadku funkcji straty w każdej rundzie trenowania, co zapewniło stabilność każdego typu relacji podczas uczenia. Stabilność mechanizmu uwagi oceniono poprzez obliczenie odchylenia standardowego wag uwagi na różnych etapach trenowania. Metryki wydajności obliczeniowej znormalizowano na podstawie liczby operacji zmiennoprzecinkowych, aby zapewnić obiektywizm porównania. Wszystkie metryki obliczono 30 razy na tym samym zbiorze testowym z różnymi ziarnami losowości w celu zapewnienia istotności statystycznej. Dla porównań parzystych między naszą metodą a każdą z metod bazowych przeprowadzono testy t-Studenta dla prób zależnych z 29 stopniami swobody.
Rysunek 5 ilustruje efekty optymalizacji parametrów oraz charakterystykę wydajności różnych prawnych relacji semantycznych w relacyjnej grafowej sieci splotowej. Rysunek 5A przedstawia rozkład wartości dedykowanych macierzy wag dla czterech typów relacji, gdzie oś pionowa reprezentuje typ relacji, a oś pozioma reprezentuje wartości wielkości wyuczonych macierzy parametrów. Relacja „violation” osiąga najwyższą wartość 0,78, co wskazuje, że ten typ semantyczny dominuje w modelu i odzwierciedla nacisk analizy zgodności prawnej na identyfikację naruszeń. Rysunek 5B porównuje wyniki jakości agregacji cech dla różnych typów relacji, gdzie oś pionowa reprezentuje typ relacji, a oś pozioma reprezentuje wynik efektu agregacji. Wykazuje on, że relacja „violation” osiąga również najlepsze wyniki w zakresie jakości fuzji cech (0,89). Rysunek 5C przedstawia wydajność szybkości zbieżności różnych relacji, gdzie oś pionowa reprezentuje typ relacji, a oś pozioma reprezentuje tempo redukcji straty w każdej rundzie treningowej. Wartości, w kolejności, dla violation, base, trigger i attribution wynoszą: 0,023, 0,031, 0,028 i 0,035. Wynik ten wskazuje, że relacja „attribution” zbiega wolniej, ale pozostaje stabilna. Rysunek 5D pokazuje wariancję wag uwagi w trzech etapach uczenia. Oś y reprezentuje etap uczenia (wczesny, środkowy i późny), a oś x reprezentuje wariancję wag uwagi od lewej do prawej strony. Odpowiednie wartości to 0,18 (wczesny), 0,12 (środkowy) i 0,08 (późny), co wskazuje, że model stopniowo stabilizuje swoją koncentrację na istotnych relacjach podczas uczenia. Rysunek 5E przedstawia kompromis w zakresie wydajności obliczeniowej dla różnych relacji. Oś y odpowiada typowi relacji, natomiast oś x odpowiada znormalizowanemu czasowi wykonania, który jest definiowany jako wykorzystanie zasobów obliczeniowych do wykonania konkretnego zadania. Wartości wynoszą 0,42 (violation), 0,39 (base), 0,43 (trigger) i 0,38 (attribution). Rozkład między klasami jest zrównoważony, co wskazuje, że mechanizm relacyjny zapewnia dobrą alokację zasobów bez obniżania wydajności.
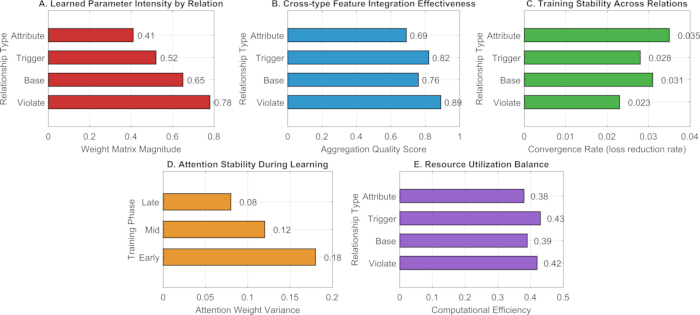
Rycina 5Optymalizacja parametrów splotu i analiza wydajności grafu uwzględniającego relacje. (A) Magnituda (norma Frobeniusa) dedykowanych macierzy wag dla każdego typu relacji. (B) Wynik jakości agregacji cech (spójność podobieństwa cosinusowego) dla każdego typu relacji. (C) Szybkość zbieżności (redukcja funkcji straty na epokę treningową) dla każdego typu relacji. (D) Wariancja wag uwagi wczesnej, środkowej i późnej fazie trenowania, wykazująca stabilizację. (E) Znormalizowany czas wykonania (relatywny koszt obliczeniowy) dla każdego typu relacji. Wszystkie metryki stanowią średnie z 30 uruchomień; słupki błędów reprezentują odchylenie standardowe (wyświetlone tam, gdzie są widoczne). Relacja naruszenia (violation) wykazuje najwyższą wartość oraz jakość agregacji, natomiast relacja przypisania (attribution) zbiega wolniej, lecz pozostaje stabilna. Aby wyświetlić powiększoną wersję tej ryciny, kliknij tutaj.
Dokładność wyrównania semantycznego
Dokładność dopasowania encji oraz integralność zachowania relacji zostały wykorzystane jako główne wskaźniki. W warunkach gradientu gęstości grafu wiedzy (rzadki/średni/gęsty), proponowana metoda została porównana z TransE, ComplEx, GNNExplainer, KG-BERT i Node2Vec. Wszystkie metody uruchomiono 30 razy, a następnie wyliczono średnią i odchylenie standardowe, aby wyeliminować wpływ losowości.
Rysunek 6 przedstawia porównanie wydajności proponowanej metody z kilkoma metodami referencyjnymi przy różnych gęstościach grafu wiedzy pod kątem dwóch kluczowych wskaźników: dokładności dopasowania encji oraz integralności zachowania relacji. Na Rysunkach 6A i 6B oś pozioma reprezentuje poszczególne metody, a oś pionowa kolejno dokładność dopasowania encji oraz integralność zachowania relacji.
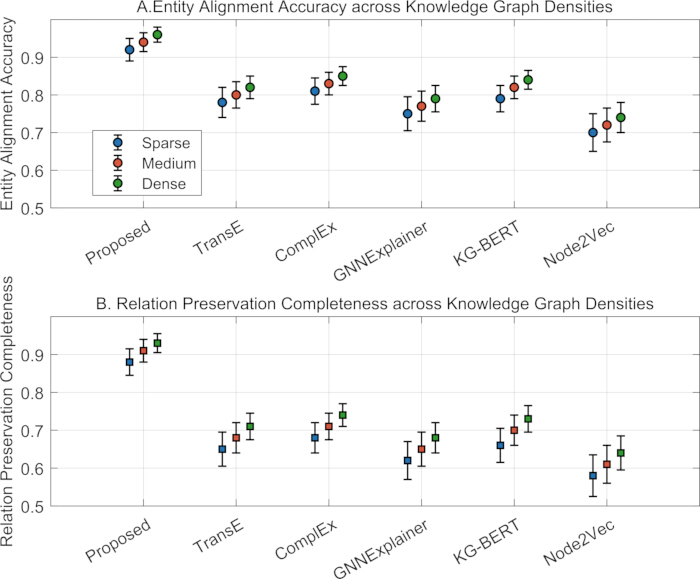
Rycina 6Wydajność dopasowania semantycznego przy różnych gęstościach grafu. (A) dokładność dopasowania encji (równanie 12) oraz (B) zachowanie spójności relacji (Równ. 13), porównując proponowaną metodę z TransE, ComplEx, GNNExplainer, KG‑BERT oraz Node2Vec. Wysokość słupków wskazuje wartości średnie z 30 uruchomień; słupki błędów reprezentują odchylenie standardowe. Proponowana metoda osiąga dokładność na poziomie co najmniej 0,92 oraz spójność co najmniej 0,8 dla wszystkich gęstości, przewyższając wszystkie modele bazowe. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Z perspektywy dokładności wyrównania encji zaproponowana metoda wykazuje doskonałe wyniki w różnych warunkach gęstości, osiągając średnią dokładność wyrównania encji nie mniejszą niż 0,92, co stanowi najwyższy poziom, szczególnie w przypadku grafów gęstych. Wskazuje to, że zbudowana grafowa sieć splotowa uwzględniająca relacje może skutecznie przechwytywać powiązania semantyczne między heterogenicznymi węzłami, zapewniając efektywne wyrównanie cech międzymodalnych dzięki wagom specyficznym dla typu krawędzi oraz mechanizmom uwagi. Przeciwnie, metody tradycyjne, zwłaszcza TransE i Node2Vec, radzą sobie gorzej ze względu na brak jawnego modelowania prawnych relacji semantycznych. Przewaga proponowanego podejścia została potwierdzona również wynikami integralności zachowania relacji, gdzie średnia integralność zachowania relacji nie była mniejsza niż 0,8, co wskazuje, że podejście to potrafi dobrze zrekonstruować jawne relacje w oryginalnym tekście prawnym przy różnych gęstościach grafu. Ta wysoka wydajność wynika ze strukturalnego kodowania grafów heterogenicznych oraz wielowarstwowego schematu przekazywania wiadomości, który kompleksowo przechwytuje złożone relacje między klauzulami prawnymi, zachowaniami medycznymi, modułami algorytmicznymi i podmiotami odpowiedzialnymi. Choć GNNExplainer i KG-BERT wykazują pewne zdolności modelowania relacyjnego, oba są ograniczone w zastosowaniach do semantyki normatywnej w prawie, a ich wydajność ustępuje wydajności zaproponowanej metody.
Porównanie możliwości lokalizacji odchyleń
Ocena lokalizacji błędu (bias localization) jest przeprowadzana za pomocą dwukryterialnych ram weryfikacji kolaboracyjnej, opartych na pełności przywoływania (recall) węzłów przyczyn źródłowych oraz precyzji ścieżek propagacji, co odnosi się do kompletności śledzenia źródła i dokładności ścieżki. Wszystkie metody porównawcze są wykonywane na tej samej strukturze grafu wejściowego, przy użyciu tego samego protokołu wstrzykiwania symulacji błędu i definicji interfejsu ewaluacyjnego, aby zapewnić rzetelność testów. Każdy eksperyment jest powtarzany 30 razy z różnymi ziarnami liczb losowych w celu zminimalizowania fluktuacji losowych. Wyniki przedstawiono jako średnia ±± odchylenie standardowe, a do wyznaczenia wartości p (w odniesieniu do metody opisanej w niniejszej pracy) wykorzystano testy t dla prób zależnych, co gwarantuje poprawność statystyczną i porównywalność wniosków z oceny. Wartości p zostały wyznaczone na podstawie testów t dla prób zależnych z 29 stopniami swobody (na podstawie 30 niezależnych uruchomień). Statystyki t dla porównania naszej metody z każdą z metod bazowych mieszczą się w zakresie od 7,82 do 12,45, co odpowiada raportowanym wartościom p.
Tabela 2 przedstawia wyniki ilościowej oceny zdolności lokalizacji błędu systematycznego (bias) dla różnych metod, z uwzględnieniem dwóch głównych wskaźników wydajności: czułości węzła głównego (root node recall) oraz precyzji ścieżki propagacji. Pod względem czułości węzła głównego zaproponowana metoda jest znacznie lepsza od wszystkich metod bazowych, osiągając najwyższą czułość na poziomie 0.95 ±± 0.02, co jest wynikiem istotnie lepszym niż w przypadku drugiej najlepszej metody GNNExplainer (0.82 ±± 0.03) i znacznie przewyższa pozostałe metody. Przewaga ta wynika z zaproponowanego w niniejszej pracy mechanizmu kwantyfikacji uwzględniającego gradient, który pozwala na precyzyjne śledzenie ścieżki propagacji sygnałów błędu w grafie i skuteczne rozpoznawanie węzłów źródłowych o największym wkładzie. W przeciwieństwie do nich, klasyczne podejścia TransE i Node2Vec, które nie posiadają środków do wychwytywania różnic semantycznych w typach krawędzi i przez to nie są w stanie wyraźnie odróżnić ścieżek propagacji błędu od regularnych relacji, osiągnęły wyniki czułości odpowiednio 0.75 ±± 0.04 i 0.72 ±± 0.05. Mimo zastosowania wstępnie wytrenowanego modelu językowego w KG-BERT, metoda ta jest ograniczona w przepływie informacji w obrębie struktury grafu, osiągając wynik czułości 0.70 ±± 0.04.
| Metoda | Przywołanie węzła głównego | wartość p (czułość węzła korzenia) | Precyzja ścieżki propagacji | wartość p (precyzja ścieżki propagacji) |
| Proponowany | 0.95 ± 0.02 | - | 0.93 ± 0.03 | - |
| TransE | 0.75 ± 0.04 | 1.23 × 10⁻8 | 0.78 ± 0.05 | 2.45 × 10⁻7 |
| ComplEx | 0.78 ± 0.03 | 8.91 × 10⁻9 | 0.81 ± 0.04 | 1.67 × 10⁻8 |
| GNNExplainer | 0.82 ± 0.03 | 3.45 × 10⁻7 | 0.86 ± 0.04 | 9.21 × 10⁻9 |
| KG-BERT | 0.70 ± 0.04 | 5.67 × 10⁻8 | 0.73 ± 0.05 | 4.32 × 10⁻8 |
| Node2Vec | 0.72 ± 0.05 | 7.89 × 10⁻9 | 0.75 ± 0.06 | 1.54 × 10⁻7 |
Tabela 2: Współczynnik odzyskiwania węzła głównego i współczynnik precyzji ścieżki propagacji. Porównanie wydajności lokalizacji obciążenia dla wszystkich metod. Wartości podano jako średnia ±± odchylenie standardowe z 30 niezależnych uruchomień. Przedstawiono odzyskiwanie węzła głównego (Równanie 14) oraz precyzję ścieżki propagacji (Równanie 15). Zaproponowana metoda osiąga najwyższy poziom odzyskiwania (0,95 ±± 0,02) i precyzji (0,93 ±± 0,03), znacząco przewyższając metody bazowe (test t dla prób zależnych, p < 0,01 dla wszystkich porównań).
Metoda ta charakteryzuje się również najwyższą dokładnością ścieżki propagacji z wartością 0,93 ±± 0,03, przewyższając pozostałe metody. Dowodzi to, że zaproponowana procedura backtrackingu podgrafu może skutecznie eliminować szumne krawędzie i identyfikować rzeczywistą ścieżkę propagacji błędów. Analiza wartości p potwierdza istotne różnice w wydajności; wszystkie metody bazowe wykazują niezwykle istotne różnice w stosunku do proponowanej metody (p < 0,01), co zapewnia odporność i skuteczność zaproponowanego podejścia w problemie lokalizacji błędów. Stosunkowo wysoka wydajność modeli ComplEx i GNNExplainer może sugerować znaczenie złożonych struktur relacji oraz wyjaśnialności sieci neuronowych na grafach w wykrywaniu błędów, jednak nie dorównują one rozwiązaniu end-to-end przedstawionemu w niniejszej pracy.
Ocena efektywności śledzenia odpowiedzialności
Ocena dotyczyła odpowiedzi w czasie rzeczywistym systemu śledzenia odpowiedzialności, przyjmując średnie opóźnienie śledzenia oraz przepustowość równoległych zapytań jako dwa kluczowe wskaźniki wydajności. Eksperymenty przeprowadzono przy trzech częstotliwościach podejmowania decyzji przez medyczną AI (niskiej, średniej i wysokiej częstotliwości). W celu zapewnienia sprawiedliwego porównania, wszystkie podejścia zostały zasilone tym samym strumieniem danych wejściowych i poddane pełnej procedurze śledzenia.
Rycina 7 porównuje efektywność śledzenia odpowiedzialności pomiędzy różnymi metodami przy różnych częstotliwościach podejmowania decyzji przez medyczne AI. Wyniki dotyczą metod rozważanych od lewej do prawej: Linie są opisane jako decyzje med-AI o niskiej, średniej i wysokiej częstotliwości.
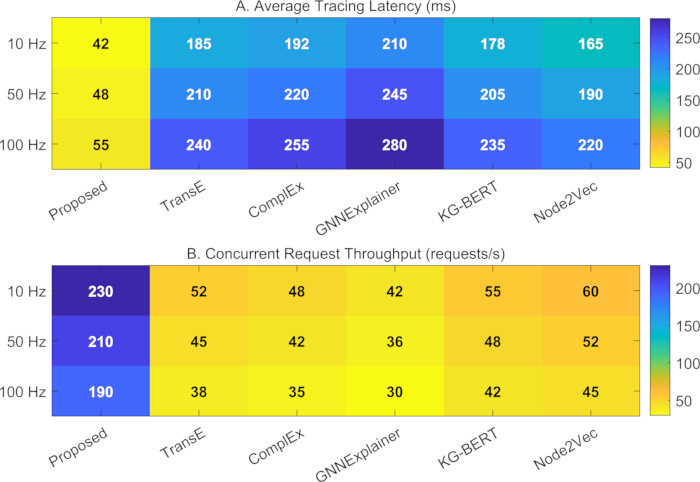
Rysunek 7Średnie opóźnienie śledzenia źródła oraz przepustowość przetwarzania równoległych żądań. (A) Średnie opóźnienie śledzenia (ms) dla każdej metody; (B) Przepustowość (żądań/sekundę) dla poszczególnych metod. Linie łączą wartości średnie z 30 uruchomień; słupki błędów (jeśli są widoczne) reprezentują odchylenie standardowe. Proponowana metoda utrzymuje najniższe opóźnienie (42‑5 ms) i najwyższą przepustowość (190‑230 żąd/s) dla wszystkich częstotliwości, co świadczy o lepszej wydajności w czasie rzeczywistym. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
W przypadku średniego opóźnienia śledzenia, zaproponowana metoda wypada najlepiej we wszystkich warunkach częstotliwości; ponadto wszystkie pozostałe metody wykazują znacznie wyższe opóźnienie niż nasza. We wszystkich metodach opóźnienie śledzenia zazwyczaj rośnie wraz z częstotliwością podejmowania decyzji, jednak w naszym przypadku wzrost ten jest łagodny: 42 milliseconds przy niskiej częstotliwości i 5 milliseconds przy wysokiej częstotliwości. Ta przewaga wynika z faktu, że metoda ta opiera się na relacyjnej sieci splotowej grafów (aware-relational graph convolutional network), która przypisuje różne macierze wag do różnych typów prawnych relacji semantycznych, aby uniknąć kosztów obliczeniowych związanych z udostępnianiem ogólnych parametrów przy wysokiej współbieżności, co występuje w klasycznych podejściach. W przeciwieństwie do nich, metody TransE i ComplEx, oparte na dekompozycji tensorowej, drastycznie tracą na wydajności przy wysokich częstotliwościach. Nie potrafią one efektywnie przetwarzać nieliniowych transformacji długodystansowych interakcji między relacjami prawno-technicznymi, co skutkuje wyższym opóźnieniem. Pod względem czasu przetwarzania par zapytań, metoda opisana w niniejszej pracy również wypada lepiej. W warunkach niskiej częstotliwości jej przepustowość wynosi 230 requests/second, co znacznie przewyższa pozostałe podejścia. Wraz ze wzrostem częstotliwości przepustowość spada, jednak stopień tego spadku jest kontrolowany nawet w scenariuszu wysokiej częstotliwości, gdzie przepustowość wciąż osiąga 190 requests/second. Ta odporność jest przypisana do strategii tymczasowego osadzania węzłów (temporary node embedding) oraz równoległego projektu ścieżki wstecznej propagacji gradientu w tym podejściu, co gwarantuje dokładność śledzenia wsadowego przy jednoczesnym wydajnym przetwarzaniu wsadowym zapytań. Podejścia ogólne, nie będąc specjalnie zoptymalizowanymi, wykazują znaczny spadek wydajności w przypadku jednoczesnych zapytań, przez co nie nadają się do monitorowania w czasie rzeczywistym.
Walidacja zdolności do generalizacji międzydomenowej w zakresie pokrycia ograniczeń prawnych
Procedura ewaluacji jest przeprowadzana pod kątem zdolności międzydomenowych modelowania ograniczeń prawnych, gdzie wskaźnikami ilościowymi są zakres jurysdykcyjny oraz wskaźnik wykrywania konfliktów ograniczeń. Na potrzeby eksperymentu zaprojektowano trzy rodzaje złożoności międzyjurysdykcyjnej: jurysdykcję jednostronną, dwustronną oraz wielostronną. Aby wyeliminować błąd ewaluacji wynikający z różnic architektonicznych, wszystkie konkurencyjne metody powtórzono 30 razy i przedstawiono wyniki średnie, aby zapewnić rzetelne porównanie zdolności do generalizacji.
Jak pokazano w Tabeli 3, podejście to konsekwentnie osiąga lepsze wyniki niż wszystkie metody bazowe w trzech wariantach złożoności jurysdykcji prawnych, a spadek wydajności jest łagodniejszy. Zapewnia ono prawie 89% wskaźnik wykrywania konfliktów przy 94% pokryciu prawnym w scenariuszu pojedynczej jurysdykcji prawnej. Po uogólnieniu na wielostronne jurysdykcje prawne, metoda ta wciąż jest w stanie zapewnić 87% pokrycia przy 81% wskaźniku wykrywania konfliktów. W przeciwieństwie do tego, tradycyjne metody osadzania (np. TransE i Node2Vec) wykazują spadek pokrycia do około 60% w środowiskach wielostronnych, przy zazwyczaj niższych wskaźnikach wykrywania konfliktów, co sugeruje, że nie nadają się one do radzenia sobie z semantyczną heterogenicznością między różnymi jurysdykcjami prawnymi. KG-BERT i GNNExplainer wykazują pewną poprawę dzięki dodatkowym wstępnie wytrenowanym modelom językowym lub modułom interpretacyjnym, jednak nadal cierpią z powodu gwałtownego pogorszenia wydajności w sytuacjach, gdy jurysdykcje prawne nakładają się na siebie.
| Metoda | Ustawienia jurysdykcji | Zakres domeny prawnej | Wskaźnik wykrywania konfliktów ograniczeń |
| Proponowana | Pojedyncza | 0.94 ± 0.02 | 0.89 ± 0.03 |
| Dwustronna | 0.91 ± 0.03 | 0.85 ± 0.04 | |
| Wielostronna | 0.87 ± 0.04 | 0.81 ± 0.05 | |
| TransE | Pojedyncza | 0.76 ± 0.05 | 0.52 ± 0.06 |
| Dwustronna | 0.68 ± 0.06 | 0.45 ± 0.07 | |
| Wielostronna | 0.61 ± 0.07 | 0.38 ± 0.08 | |
| ComplEx | Pojedyncza | 0.79 ± 0.04 | 0.5 ± 0.05 |
| Dwustronna | 0.72 ± 0.05 | 0.48 ± 0.06 | |
| Wielostronna | 0.65 ± 0.06 | 0.41 ± 0.07 | |
| GNNExplainer | Pojedyncza | 0.82 ± 0.04 | 0.61 ± 0.05 |
| Dwustronna | 0.75 ± 0.05 | 0.54 ± 0.06 | |
| Wielostronna | 0.68 ± 0.06 | 0.47 ± 0.07 | |
| KG-BERT | Pojedyncza | 0.80 ± 0.04 | 0.58 ± 0.05 |
| Dwustronna | 0.73 ± 0.05 | 0.51 ± 0.06 | |
| Wielostronna | 0.6 ± 0.06 | 0.4 ± 0.07 | |
| Node2Vec | Pojedyncza | 0.74 ± 0.05 | 0.49 ± 0.06 |
| Dwustronna | 0.6 ± 0.06 | 0.42 ± 0.07 | |
| Wielostronna | 0.59 ± 0.07 | 0.36 ± 0.08 |
Tabela 3: Zakres jurysdykcji i wskaźnik wykrywania konfliktów ograniczeń. Wyniki generalizacji międzydomenowej w ramach pojedynczych, bilateralnych i multilateralnych jurysdykcji prawnych. Zakres jurysdykcji (Równanie 18) oraz wskaźnik wykrywania konfliktów ograniczeń (Równanie 19) przedstawiono jako średnia ±± SD z 30 uruchomień. Proponowana metoda utrzymuje wysoki zakres (≥87%) i wykrywalność (≥81%) nawet w najbardziej złożonym ustawieniu multilateralnym, podczas gdy metody bazowe ulegają znacznemu pogorszeniu.
Rozbieżność ta wynika z całkowicie odmiennych procesów modelowania. Istniejące podejścia do osadzania grafów wiedzy (np. TransE, ComplEx) wykorzystują relacje geometryczne w statycznej przestrzeni wektorowej do modelowania i nigdy nie rozróżniają binarnych semantyk prawnych, takich jak „zakaz” i „dozwolenie”, co uniemożliwia im obsługę niuansów regulacji tego samego aktu medycznego w różnych systemach prawnych. Chociaż KG-BERT potrafi uchwycić kontekst tekstowy, brakuje mu jawnej mocy rozumowania strukturalnego i ma trudności z wnioskowaniem w przypadku zależności normatywnych oraz sprzecznych ograniczeń między klauzulami. Zamiast tego zaproponowany model buduje skierowany graf heterogeniczny poprzez rozszerzenie o cztery typy krawędzi semantyki prawnej („naruszenie”, „podstawa”, „wyzwalacz” i „atrybucja”) oraz integruje splot grafowy świadomy relacji z wsteczną propagacją gradientu. W rezultacie zaproponowany model nie tylko zachowuje przyczynową kierunkowość logiki prawnej, ale także dynamicznie dopasowuje semantycznie równoległe klauzule i wykrywa sprzeczne zasady w wieloźródłowych danych wejściowych z domeny prawnej. Zatem w złożonych scenariuszach częstych konfliktów obowiązków, nakładających się odpowiedzialności lub niepewnych priorytetów stosowania w ramach wielostronnego systemu prawnego, opisana metodologia oferuje sposób na precyzyjną i ustrukturyzowaną identyfikację źródeł sprzeczności oraz przekształcenie ich w wnioskowania międzydomenowe o wysokim stopniu pokrycia i dokładności.
Badanie ablacyjne
Aby wyizolować wkład każdego z głównych komponentów, przeprowadziliśmy badanie ablacyjne poprzez usuwanie lub zastępowanie kluczowych modułów w naszej strukturze w ustawieniu gęstego grafu (D = 1,0). W szczególności porównaliśmy pełny model z trzema wariantami: (1) bez splotu uwzględniającego relacje, w którym wszystkie typy krawędzi współdzielą jedną macierz transformacji; (2) bez mechanizmu uwagi, w którym wkłady sąsiadów są uśredniane jednolicie; oraz (3) bez wstecznego śledzenia gradientu, w którym źródła obciążenia są identyfikowane za pomocą prostej heurystyki stopnia węzła zamiast rekonstrukcji podgrafu opartej na gradiencie.
Tabela 4 przedstawia wyniki analizy ablacyjnej, ujawniając odrębny wkład każdego z komponentów. Usunięcie splotu uwzględniającego relacje (relation-aware convolution) spowodowało najistotniejszy spadek wydajności, przy czym czułość dla korzenia (root recall) spadła z 0,95 do 0,81, a precyzja ścieżki (path precision) z 0,93 do 0,78. Potwierdza to, że modelowanie krawędzi specyficzne dla typu jest kluczowe dla uchwycenia semantycznej różnorodności relacji prawnych, ponieważ stosowanie jednej macierzy transformacji dla wszystkich typów relacji prowadzi do znacznej utraty informacji podczas wyrównywania między modalnościami. Mechanizm uwagi również wnosi zauważalny wkład; jego usunięcie obniża czułość dla korzenia do 0,8, a precyzję ścieżki do 0,85, co wskazuje, że dynamiczne ważenie komunikatów sąsiadów poprawia zdolność modelu do rozróżniania wpływowych ścieżek prawnych, choć jego wpływ jest wtórny względem uwzględniania relacji. Usunięcie wstecznego śledzenia gradientu (gradient backtracking) spowodowało najmniejszy spadek czułości (0,91), ale największy spadek precyzji ścieżki (0,76), co sugeruje, że choć proste heurystyki mogą częściowo identyfikować węzły źródłowe, precyzyjna rekonstrukcja struktury propagacji w dużym stopniu opiera się na analizie wrażliwości bazującej na gradiencie. Ogólnie rzecz biorąc, wszystkie trzy komponenty znacząco przyczyniają się do wydajności lokalizacji stronniczości w ramach systemu, przy czym splot uwzględniający relacje jest najważniejszy, a wsteczne śledzenie gradientu jest niezbędne dla dokładności na poziomie ścieżki.
| Wariant modelu | Pełność przywoływania korzenia (Root Recall) | Precyzja ścieżki (Path Precision) |
| Pełny model | 0.95 ± 0.02 | 0.93 ± 0.03 |
| bez splotu świadomego relacji | 0.81 ± 0.03 | 0.78 ± 0.04 |
| bez mechanizmu uwagi | 0.8 ± 0.02 | 0.85 ± 0.03 |
| bez cofania gradientu | 0.91 ± 0.03 | 0.76 ± 0.05 |
Tabela 4: Wyniki badania ablacyjnego na gęstym grafie (D = 1.0). Efekt usunięcia kluczowych komponentów: (bez splotu uwzględniającego relacje), (bez mechanizmu uwagi) oraz (bez wstecznego śledzenia gradientu). Metryki (root recall i path precision) stanowią średnią ±± SD z 30 uruchomień. Pełny model wykazuje najlepsze wyniki, co potwierdza, że każdy komponent wnosi istotny wkład, przy czym splot uwzględniający relacje jest najbardziej krytyczny.
DOSTĘPNOŚĆ DANYCH:
Strukturalny heterogeniczny zestaw danych grafu wiedzy wygenerowany i przeanalizowany w ramach niniejszego badania, obejmujący wszystkie dane dotyczące węzłów i krawędzi (285 węzłów w obrębie czterech typów encji oraz 1 247 krawędzi skierowanych z czterema dopuszczalnymi relacjami semantycznymi), został zdeponowany w repozytorium Figshare pod adresem DOI: https://doi.org/10.6084/m9.figshare.311764. Dane są publicznie dostępne od daty publikacji niniejszego artykułu. Odpowiadające im pliki zestawu danych zostały również udostępnione jako Supplementary File 1.
Plik uzupełniający 1: Pliki zbiorów danych wykorzystane w niniejszym badaniu.Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Integracja sztucznej inteligencji medycznej z decyzjami klinicznymi rodzi wyzwania prawne w zakresie przypisywania odpowiedzialności, co jest utrudnione przez lukę semantyczną między nieustrukturyzowanymi tekstami prawnymi a algorytmami typu „czarna skrzynka”. Aby ją zniwelować, zaproponowaliśmy oparty na GNN graf wiedzy, który modeluje klauzule prawne, zachowania medyczne, moduły algorytmiczne i strony odpowiedzialne jako węzły heterogeniczne, połączone czterema skierowanymi relacjami prawno-semantycznymi (naruszenie, podstawa, wyzwalacz, przypisanie). Struktura ta zapewnia obliczalny interfejs dla dopasowania międzymodalnego i śledzenia błędów systematycznych.
Nasza metoda osiąga lepsze wyniki we wszystkich mierzonych parametrach. Przy różnej gęstości grafów, dokładność dopasowania encji (≥0.92) oraz zachowanie relacji (≥0.88) przewyższają wyniki TransE, ComplEx oraz KG‑BERT. Lokalizacja obciążenia daje przypominanie pierwiastka (0.95 ±± 0.02) i precyzję ścieżki (0.93 ±± 0.03), co znacząco przewyższa GNNExplainer. Dynamiczny monitoring zapewnia niskie opóźnienia (42–55 ms) i wysoką przepustowość (190–230 req/s), podczas gdy testy międzyjurysdykcyjne wykazują stabilny zakres pokrycia (≥87%) i wykrywanie konfliktów (≥81%). Wyniki te potwierdzają skuteczne łączenie semantyki prawnej i technicznej z interpretowalnym śledzeniem obciążenia.
Naszym sukcesom leżą u podłoża trzy innowacje: (1) typowane krawędzie prawno-semantyczne wychwytują rozróżnienia przyczynowe i normatywne, które często umykają jednolitym osadzeniom20,21; (2) konwolucja świadoma relacji z dedykowanymi macierzami transformacji dla każdego typu relacji zachowuje specyfikę semantyczną, umożliwiając jednocześnie wymianę między typami38,39; oraz (3) oparta na gradientach kwantyfikacja wkładu i klasteryzacja sterowana społecznościami przekształcają globalne obciążenie w lokalną identyfikację źródła, pokonując ograniczenia wyjaśniaczy posthoc32,33. Przenosi to kwestię zgodności z poziomu statycznego sprawdzania reguł na poziom dynamicznego rozumowania świadomego struktury.
Ograniczenia obejmują poleganie na ręcznie definiowanej ekstrakcji relacji oraz trudności z niejednoznacznymi klauzulami. Przyszłe prace będą integrować formalizmy logiki prawnej (np. logikę uchylną26,27) oraz uczenie online w celu dostosowania do zmieniających się regulacji, a także rozszerzą analizę na inne obszary wysokiego ryzyka (autonomiczna jazda, finanse). Informacje zwrotne od użytkownika (user-in-the-loop) pozwolą na dalsze udoskonalenie atrybucji. Kierunki te umocnią wykorzystanie wyjaśnialnej sztucznej inteligencji opartej na grafach jako fundamentu dla godnych zaufania systemów inteligentnych.
Oświadczenia
Rękopis nie był wcześniej publikowany ani nie jest rozpatrywany przez żadne inne czasopismo. Wszyscy autorzy zatwierdzili treść pracy. Autorzy oświadczają, że nie mają żadnych finansowych konfliktów interesów.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| ComplEx | Implementacja open-source (np. OpenKE) | Wersja 1.0 | Podstawowy model osadzania kompleksów do porównania grafów wiedzy |
| GNNExplainer | Implementacja open-source (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Podstawowy model interpretowalności GNN do śledzenia błędów systematycznych |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Procesor centralny do trenowania modeli i wstępnego przetwarzania danych |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Podstawowy model osadzania KG oparty na Transformerach do wyrównania semantycznego |
| Node2Vec | Implementacja open-source (https://github.com/aditya-grover/node2vec) | Wersja 1.0 | Podstawowy model osadzania węzłów oparty na błądzeniu losowym |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | Wysokowydajne GPU przyspieszające trenowanie grafowych sieci neuronowych |
| Ours (Relation-aware GCN) | Własna implementacja w PyTorch | PyTorch 1.12.0 | Zaproponowany framework z transformacjami per-relacja, mechanizmem uwagi i wstecznym śledzeniem gradientu |
| TransE | Implementacja open-source (np. OpenKE) | Wersja 1.0 | Podstawowy model osadzania translacyjnego do porównania grafów wiedzy |
Bibliografia
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.