Niniejsza praca proponuje nowy model, bramkowane liniowe sieci neuronowe z mechanizmem uwagi typu slot (gated-slot linear attention graph neural networks) do rekomendacji opartych na sesjach, który wykorzystuje bramkowaną liniową uwagę w oparciu o dwukrotnie skonstruowany graf sesji. Model ten zwiększa dokładność i efektywność rekomendacji oraz przewyższa rozwiązania stanu wiedzy (SOTA) w trzech publicznych zbiorach danych.
Artykuł badawczy
Liniowe grafowe sieci neuronowe z mechanizmem uwagi typu Gated-Slot dla rekomendacji opartych na sesjach
W tym artykule
Podsumowanie
Streszczenie
Systemy rekomendacji oparte na sesjach (SBR) mają na celu przewidzenie kolejnego elementu, z którym użytkownik prawdopodobnie wejdzie w interakcję, w oparciu o sekwencję zachowań w ramach bieżącej sesji. Niedawne podejścia wykorzystujące mechanizm uwagi Transformer (np. GC-SAN) wykazały lepszą wydajność w porównaniu z metodami tradycyjnymi; obciążają one jednak systemy dużym nakładem obliczeniowym i złożonością przestrzenną ze względu na kwadratowy koszt samo-uwagi. Aby rozwiązać te ograniczenia, zaproponowano nowy model o nazwie GSLA4Rec (grafowe sieci neuronowe z liniową uwagą typu gated-slot dla rekomendacji opartych na sesjach), który integruje liniową uwagę z nauczalnym mechanizmem bramkowania oraz strategią aktualizacji pamięci opartą na slotach, zainspirowaną uwagą typu gated-slot. Konkretnie, GSLA4Rec konstruuje najpierw dwa grafy: graf sesji w celu uchwycenia przejść między elementami wewnątrz sesji oraz globalny graf sąsiedztwa w celu zakodowania sygnałów kolaboratywnych między sesjami, modelując tym samym zarówno lokalne, jak i globalne informacje kontekstowe. Zaproponowane podejście opiera się na mechanizmie liniowej uwagi gated-slot, który (1) wykorzystuje jednostki bramkowania do tłumienia szumu z nieistotnych lub nadmiarowych interakcji w długich sesjach, (2) używa jednostek slotów do dynamicznego przechowywania i aktualizowania kompaktowych reprezentacji sesji, co zmniejsza obciążenie pamięci, oraz (3) zastępuje samo-uwagę uwagą liniową w celu osiągnięcia liniowej złożoności czasowej. Wspólnie komponenty te znacząco zwiększają dokładność predykcyjną modelu i wydajność w przechwytywaniu ewoluujących zainteresowań użytkowników. Obszerne eksperymenty na wielu publicznych zbiorach danych referencyjnych, w tym Diginetica, Tmall i NowPlaying, wykazują, że GSLA4Rec konsekwentnie przewyższa najnowocześniejsze (SOTA) metody SBR pod względem wydajności rekomendacji, co potwierdza skuteczność mechanizmu GSLA.
Wprowadzenie
Wraz z szybkim rozwojem usług online (takich jak e-commerce, platformy krótkich filmów i kanały informacyjne), problem przeładowania informacjami stał się coraz bardziej widoczny i dotkliwy. Systemy rekomendacyjne1,2 zapewniają spersonalizowane i precyzyjne usługi dostarczania informacji poprzez głęboką analizę danych o zachowaniach użytkowników. Jednak w wielu praktycznych zastosowaniach charakteryzujących się anonimowym dostępem, niezalogowanymi użytkownikami, ochroną prywatności oraz krótkim czasem interakcji, tradycyjne metody rekomendacji, takie jak filtrowanie kolaboratywne3 i faktoryzacja macierzy4,5, znacznie ograniczają możliwości zastosowania algorytmów rekomendacyjnych. Aby sprostać tym wyzwaniom, pojawiło się SBR6,7,8,9. SBR koncentruje się na sekwencji danych interakcji w ramach bieżącej sesji użytkownika, aby przewidzieć kolejny potencjalny punkt zainteresowania. Paradygmat ten nie tylko pozwala uniknąć zależności od długoterminowych danych historycznych użytkowników, ale także skutecznie wychwytuje krótkoterminowe, dynamiczne zmiany zainteresowań, wykazując tym samym unikalną wartość aplikacyjną w scenariuszach takich jak e-commerce, krótkie filmy, rekomendacje muzyczne i inne.
Wczesne metody opierały się przede wszystkim na łańcuchach Markowa5,10,11,12 w celu modelowania prawdopodobieństw przejścia między elementami w sekwencjach sesji. Choć metody te potrafiły uchwycić zależności sekwencyjne pierwszego rzędu, charakterystyka złożonych zależności wyższego rzędu oraz nieliniowej dynamiki zainteresowań użytkowników pozostawała ograniczona, co redukowało skuteczność modeli w złożonych scenariuszach. Wraz z rozwojem technologii uczenia głębokiego (Deep Learning)13,14, w systemach SBR zaczęto szeroko stosować metody oparte na sieciach neuronowych. GRU4REC15 jako pierwszy zastosował rekurencyjne sieci neuronowe14 (RNNs) w rekomendacjach opartych na sesjach, skutecznie uchwycając zależności czasowe w sekwencjach; NARM16 dodatkowo zwiększył zdolność do wydobywania kluczowych zainteresowań użytkowników poprzez integrację mechanizmów uwagi z sieciami RNN; STAMP17 wykorzystał wielowarstwowe perceptrony (MLPs) połączone z mechanizmami uwagi, aby skupić się na przechwytywaniu krótkoterminowych zainteresowań użytkowników. Mimo że metody te przyniosły pewien postęp w modelowaniu sekwencji, wciąż napotykały one na trudności, takie jak problemy z obsługą długoterminowych zależności oraz podatność na szum.
W ostatnich latach grafowe sieci neuronowe (GNNs)18,19,20,21 wprowadziły nową perspektywę do zadania SBR. Modele takie jak SR-GNN22 jawnie modelują złożone relacje przejścia poprzez konstruowanie grafu sesji (SG), co pozwala na osiągnięcie znaczących usprawnień w dokładności rekomendacji. Jednak większość istniejących metod opartych na GNN przeprowadza konstrukcję grafu i przekazywanie komunikatów w obrębie pojedynczych sesji, co skutkuje brakiem efeknego wykorzystania globalnych informacji o korelacji elementów. Aby rozwiązać ten problem, GCE-GNN23 integruje semantykę globalną i grafy sesji z mechanizmem self-attention, aby adaptacyjnie określać wagę ważności elementów poprzez konstruowanie globalnego grafu sąsiedztwa (NGG), co pozwala na osiągnięcie znacznej poprawy wydajności. Niemniej jednak istniejące metody oparte na GNN wciąż napotykają dwa główne wąskie gardła: po pierwsze, złożoność mechanizmu self-attention rośnie kwadratowo wraz z długością sesji, co prowadzi do znacznych kosztów obliczeniowych podczas przetwarzania długich sesji; po drugie, tradycyjne GNN nie posiadają zdolności do dynamicznej regulacji ważności elementów podczas agregacji informacji, co utrudnia odróżnienie szumu od krytycznych zachowań, wpływając tym samym na jakość reprezentacji.
Aby rozwiązać te problemy, niniejsza praca proponuje grafową sieć neuronową z liniową uwagą i bramkowanymi slotami do rekomendacji opartych na sesjach (GSLA4Rec): (1) zaprojektowanie mechanizmu bramkowanych slotów, który filtruje szum za pomocą bramkowania i przechowuje kluczowe informacje semantyczne w slotach sesji, co zwiększa odporność modelu i zmniejsza koszty pamięciowe; (2) wprowadzenie mechanizmu liniowej uwagi, który redukuje złożoność obliczeniową z O(N2) do O(N), gdzie N oznacza długość sesji), przy jednoczesnym zachowaniu zdolności do modelowania zależności długodystansowych; (3) przeprowadzenie obszernych eksperymentów na trzech publicznych zbiorach danych referencyjnych (Diginetica, Tmall oraz NowPlaying), które wykazują, że GSLA4Rec znacząco przewyższa istniejące metody SOTA, wykazując szczególnie wyraźne zalety w scenariuszach z długimi sesjami oraz w przypadkach rzadkich danych.
Protokół
Doświadczanie rekomendacji opartych na sesjach
Rekomendację opartą na sesjach można badać z trzech perspektyw: SBR, uczenia kontekstu globalnego oraz GSLA (patrz Tabela materiałów). W badaniu nie uczestniczyli ludzie ani zwierzęta. Wszystkie zbiory danych eksperymentalnych wykorzystane w tej pracy są ogólnodostępne i zostały przesłane jako Plik uzupełniający: GSLA4Rec.zip.
Rekomendacja oparta na sesji
System rekomendacji oparty na sesjach (SBR) był systemem sztucznej inteligencji, który wchodził w interakcje z użytkownikami poprzez wielTOURnowe dialogi w języku naturalnym, aby dynamicznie rozumieć ich preferencje i dostarczać spersonalizowane rekomendacje. SBR ewoluował od metod tradycyjnych do podejść opartych na głębokim uczeniu oraz rozwiązań hybrydowych, a następnie rozwinął się w kierunku rozwiązań opartych na dużych modelach językowych (LLM).
Tradycyjna rekomendacja oparta na sesjach
Tradycyjne SBR było zazwyczaj reprezentowane przez metody oparte na łańcuchach Markowa oraz filtrowanie kolaboratywne. Pierwsze z nich generowało rekomendacje poprzez dekompozycję specyficznych dla użytkownika probabilistycznych macierzy przejścia. Na przykład Guy Shani24 zaproponował metodę rekomendacji opartą na procesie decyzyjnym Markowa, która tworzyła rekomendacje poprzez dekompozycję odpowiadających im macierzy; Wanrong Gu25 poprawił wydajność rekomendacji poprzez zintegrowanie łańcuchów Markowa z odstępami czasu między zakupami. Filtrowanie kolaboratywne generowało rekomendacje poprzez wydobywanie ukrytych relacji sekwencyjnych między sąsiednimi interaktywnymi elementami za pomocą faktoryzacji macierzy. Przykładowo, Sarwar B1 obliczał podobieństwo między elementami na podstawie historycznych zachowań użytkowników (takich jak oceny i kliknięcia), aby rekomendować elementy zgodne z przeszłymi preferencjami użytkowników. Jeśli użytkownik A polubił element a, a element c był bardzo podobny do a, system rekomendował c użytkownikowi A; Rendle S5 zaproponował FPMC, model rekomendacji sekwencyjnych łączący faktoryzację macierzy z łańcuchami Markowa, aby uchwycić ukryte relacje sekwencyjne między sąsiednimi interaktywnymi elementami. Jednakże tradycyjne SBR skupiało się na relacjach sekwencyjnych między sąsiednimi elementami, co utrudniało modelowanie złożonych relacji zależności.
Rekomendacje oparte na sesjach z wykorzystaniem głębokiego uczenia
Rekomendacje oparte na sesjach z wykorzystaniem głębokiego uczenia ewoluowały przez etapy obejmujące splotowe sieci neuronowe (CNNs)26,27,28,29, sieci RNN oraz GNN. SBR oparte na CNN wykorzystywały operacje takie jak splot i pooling do nauki reprezentacji kontekstu każdej sesji, które następnie służyły do dalszych rekomendacji. Caser30 przekształcał L ostatnio odwiedzonych przez użytkownika elementów w wektory d-wymiarowe za pomocą warstwy embeddingu, tworząc macierz embeddingu traktowaną jako „obraz” zmapowany w czasie i przestrzeni latentnej. Następnie wykorzystywano trzy splotowe filtry wzorców sekwencyjnych — na poziomie punktowym, na poziomie unii bez pomijania oraz na poziomie unii z jednokrotnym pominięciem — aby nauczyć się wzorców sekwencyjnych dla lepszej wydajności SBR. Tuan i wsp.31 w sposób jednolity modelowali strumienie kliknięć w sesjach oraz cechy treści za pomocą 3D splotowych jąder w celu utworzenia wspólnych reprezentacji czasoprzestrzennych i treściowych.
RNNy stanowiły klasę architektur sieci neuronowych zaprojektowanych specjalnie do przetwarzania danych sekwencyjnych. Głównym założeniem było uchwycenie zależności czasowych poprzez struktury rekurencyjne, takie jak sieci długiej krótkotrwałej pamięci (LSTM)13 oraz jednostki z bramkowaniem (GRU)32. Były one szeroko stosowane w takich dziedzinach jak przetwarzanie języka naturalnego (NLP)33, rozpoznawanie mowy34, tłumaczenie tekstów35, turystyka36,37, kryminalistyka38, oraz przewidywanie przyszłych trendów39 (np. ruchu drogowego40, giełd papierów wartościowych41,42 oraz meteorologii43). GRU4Rec, zaproponowany przez Hidasi i wsp., był kamieniem milowym w badaniach nad SBR; jako pierwszy wprowadził RNNy do SBR i wykorzystał GRU do uchwycenia sekwencyjnych wzorców zachowań użytkowników w celu uzyskania spersonalizowanych rekomendacji.
Sieci GNN44 wykazały silną zdolność ekspresyjną w modelowaniu złożonych relacji w danych o strukturze grafu, a niektórzy badacze wprowadzili GNN do modelowania złożonych przejść w obrębie lub pomiędzy sesjami. W zależności od różnych architektur modeli GNN, metody oparte na GNN w zadaniu SBR są zazwyczaj klasyfikowane jako bramkowane grafowe sieci neuronowe (GGNNs)45, grafowe sieci konwolucyjne (GCNs)46 oraz grafowe sieci uwagi (GATs)47. SR-GNN był pierwszym modelem, który zastosował GNN w SBR poprzez reprezentowanie sekwencji sesji jako grafów skierowanych i wykorzystanie GGNN do przechwytywania złożonych relacji przejść między elementami w obrębie sesji, w połączeniu z mechanizmami uwagi w celu uzyskania końcowego zanurzenia (embeddingu) sesji, co poprawiło wydajność rekomendacji. Chen L48 zaproponował wielowidokową strukturę GNN, która łączy atrybuty strukturalne i niestrukturalne słowa kluczowe w celu modelowania wielowymiarowych powiązań produktów, zwiększając dokładność SBR. Driss E49 zaprojektował innowacyjny system rekomendacji sesyjnych wykorzystujący kapsułkowe grafowe sieci neuronowe do przechwytywania złożonych cech elementów i zwiększenia dokładności predykcji dla SBR.
Wspomniane techniki głębokiego uczenia rozszerzyły zakres badań nad SBR i skutecznie poprawiły jego wydajność, jednak nadal posiadały one pewne ograniczenia, przejawiające się głównie w następujących kwestiach: 1) w przypadku nowo pojawiających się elementów lub bardzo rzadkich sesji modelom trudno było dokonać dokładnych przewidywań ze względu na brak globalnego kontekstu; 2) nie potrafiły one wykorzystać globalnych wzorców zawartych we wszystkich historycznych sesjach.
Hybrydowy system rekomendacji oparty na sesjach
Hybrydowe systemy rekomendacji oparte na sesjach integrują zalety różnych technik, takich jak filtrowanie kolaboratywne, głębokie uczenie (Deep-Learning) oraz mechanizmy uwagi, w celu poprawy wydajności SBR. Model GC-SAN50 włączył mechanizm self-attention oparty na SR-GNN, aby lepiej uchwycić informacje o interakcjach istotnych elementów w obrębie sesji. FGNN51 dodatkowo agregował informacje z sąsiednich elementów poprzez mechanizm uwagi wielogłowicowej (multi-head attention), aby nauczyć się wielu relacji elementu docelowego. SR-HetGNN52 zaliczany jest do SBR z wykorzystaniem grafów heterogenicznych; poprzez wprowadzenie elementów wielu typów (użytkownik, element, sesja) oraz krawędzi wielorelacyjnych (kliknięcie, zakup, współwystępowanie, powiązanie atrybutów), skonstruowano globalną sieć wiedzy, przełamując ograniczenia pojedynczych sekwencji elementów, co w ostatnich latach stało się ważną metodą modelowania zachowań anonimowych użytkowników oraz powiązań zainteresowań między sesjami. KGSR-SAP53 zbudował graf wiedzy poprzez łączenie elementów krawędziami wielu relacji w celu opisania różnych interakcji użytkownik-element, rozwiązując problem utraty informacji, który występuje, gdy globalny graf zawiera tylko krawędzie jednego typu (interakcja użytkownik-element). Wang ZH54 zaproponował DiffSBR, model rekomendacji sesyjnych oparty na dyfuzji. Generuje on wiarygodne preferencje dotyczące następnego elementu poprzez symulację odszumiania sygnału, co poprawia modelowanie dynamicznych sekwencji kliknięć użytkownika. Qiao ST55 zbudował framework SBR łączący wielowidokowe uczenie intencji oraz dopasowanie do LLM. Pozwala on na wydobywanie ukrytych intencji użytkownika z różnych perspektyw i wykorzystuje modele językowe do wyrównania cech semantycznych, co prowadzi do lepszej wydajności rekomendacji.
Kontekst globalny
Aby przezwyciężyć wadę polegającą na „analizowaniu sesji w izolacji”, badacze zdali sobie sprawę, że informacje globalne mogą zostać wykorzystane do zwiększenia możliwości reprezentacji bieżącej sesji, co pozwala rozwiązać takie problemy jak rzadkość danych, zimny start oraz luka semantyczna w tradycyjnych systemach SBR. Jednocześnie podczas konstruowania kontekstu globalnego konieczna była integracja informacji globalnych w ramach pojedynczej sesji przy jednoczesnym zminimalizowaniu zakłóceń szumem. CSRM56 zoptymalizowano reprezentację na poziomie sesji poprzez integrację informacji kolaboratywnych między bieżącą sesją a sesjami sąsiednimi, wykorzystując koder pamięci zewnętrznej (OME) do wyodrębniania intencji kolaboratywnych z informacji kolaboratywnych. CA-TCN57 zaproponowano model czasowej sieci konwolucyjnej świadomej między-sesyjnie, konstruując grafy globalne i grafy kontekstu sesji, aby symulować wpływ relacji między-sesyjnych na elementy i sesje, podczas gdy czasowa sieć konwolucyjna (TCN) rozszerza pole recepcyjne poprzez konwolucje dylatacyjne, przy czym liczba warstw obejmuje sekwencje o długości wykładniczej (pole recepcyjne = ), rozwiązując problem zanikającego gradientu w sieciach RNN. Chen58 zaproponowano metodę SBR opartą na hipergrafowych sieciach neuronowych (SR-HGNNs), która integruje propagację mieszanego rzędu (niskiego i wysokiego rzędu) oraz mechanizmy uwagi, aby rozwiązać problem nadmiernego wygładzania (over-smoothing) tradycyjnych sieci GNN w krótkich sesjach i rozróżnić znaczenie różnych rzędów propagacji, co pozwala dokładniej uchwycić zależności i uniknąć zakłóceń szumem. GCE-GNN wykorzystywa pary elementów współwystępujących wielorzędowych do konstrukcji nieskierowanego grafu ważonego, obliczając częstotliwości współwystępowania elementów w celu odzwierciedlenia ich ważności w sesji; AGNN-GC59 wykorzystywa między-sesyjne relacje przejść między elementami do konstrukcji globalnego grafu kolaboratywnego, obliczając prawdopodobieństwa przejść między elementami w grafie globalnym, aby odzwierciedlić zmiany zainteresowań w sesji; DA-GCN60 wykorzystuje najkrótszą ścieżkę do aktualizacji macierzy sąsiedztwa w celu konstrukcji dynamicznego grafu ważonego, obliczając globalną częstotliwość współwystępowania oraz odległość ścieżki między elementami. Zainspirowani powyższą literaturą, w niniejszej pracy zaproponowano konstrukcję grafu globalnego za pomocą metody opartej na sąsiedztwie, tj. wykorzystanie współczynnika podobieństwa Jaccarda do wyznaczania podobnych sesji, co pozwoliło nie tylko na wykorzystanie informacji globalnych, ale także na odfiltrowanie szumu (usunięcie nieistotnych elementów), osiągając cel dokładnej konstrukcji kontekstu globalnego i kładąc solidne fundamenty pod późniejszy algorytm SBR.
Liniowa uwaga z bramkowanymi slotami
Tradycyjne transformery61 charakteryzowały się wysoką złożonością czasowo-przestrzenną ze względu na konieczność stosowania operacji uwagi w pełni połączonej dla całej sekwencji, zgodnie z poniższym:
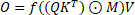 (1)
Gdzie Q, K, V ∈ RN×d były liniowymi przekształceniami elementów wejściowych, M = {Mij = 1 jeśli i ≥ j, w przeciwnym razie −∞ } stanowiła maskę przyczynową zapobiegającą wyciekowi informacji z przyszłości, ⊙ oznaczało mnożenie elementowe, a f oznaczało funkcję aktywacji softmax.
Aby uzyskać liniową uwagę62, najbardziej bezpośrednim pomysłem było usunięcie funkcji aktywacji softmax. Jednak gdyby funkcja aktywacji softmax została usunięta bezpośrednio, liniowa uwaga z pewnością doprowadziłaby do pewnych potencjalnych problemów: utraty potężnej mocy ekspresyjnej sieci neuronowych i niemożności rozwiązywania złożonych problemów świata rzeczywistego.
Liniowa uwaga szczelinowa z kontrolą ograniczonej pamięci
Przy założeniu, że funkcja aktywacji softmax musiała zostać zachowana, K i V zostały skompresowane oddzielnie do K̃, Ṽ ∈ Rm×d. Z perspektywy sieci pamięciowej, K̃ i Ṽ posiadały sloty pamięci, których długość zwiększa się wraz z sekwencją, tzn. liczba slotów m = N. Gdyby m była stała, linearyzacja byłaby oczywiście możliwa. Inspirując się Bounded-memory Control63, każdy token w elementach wejściowych o długości N musiał zostać zapisany konkurencyjnie w m slotach.
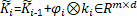 ,
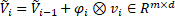 ,
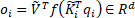 (2)
Gdzie f było funkcją aktywacji softmax, a φi był wektorem sterującym efektywne wejście dla kontrolowania wartości klucza ki w następujący sposób.
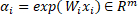 ,
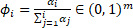 (3)
Tutaj, (φi)j reprezentowało intensywność zapisu itoken do jslot został uzyskany przy użyciu skumulowanej funkcji softmax.
Aby uzyskać wydajne obliczenia liniowe, wzór (2) przekształcono we wzór (4), który obliczał οi na podstawie qi, ki oraz vi (Równanie 4) poprzez {οi|i=1T, qi, ki, vi)|i=1T} i zastosowano dwuetapowe obliczenia sekwencyjne:
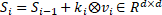 ,
 (4)
W związku z tym można wyprowadzić operacje SLA:
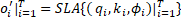 ,
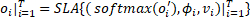 (5)
Gdzie oi′ ∈ ℝm, οi ∈ ℝd. W związku z tym SLA może uzyskać wydajne sprzętowo trenowanie fragmentowe (chunk-wise) w czasie liniowym64.
Liniowa uwaga z bramkowanymi slotami
Liniowa uwaga szczelinowa (slot linear attention) z kontrolą ograniczonej pamięci mogłaby zredukować złożoność obliczeniową i przestrzenną. Jednakże akumulacja informacji mogłaby również wprowadzić szum do interakcji w sesji, dlatego zanik zależny od danych był bardzo ważny dla selektywnego zatrzymywania i zapominania informacji, a ten mechanizm selektywny został ponownie omówiony w niedawnych selektywnych modelach przestrzeni stanów65. GSLA z zależnością od danych można wyrazić jako:
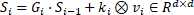 ,
 (6)
W tym przypadku bramki rozpadu zostały sparametryzowane przez postać produktu zewnętrznego Gi = αi ⊗ βi, αi, βi ∈ [0,1]d. W dalszej części GSLA można również zapisać w następującej równoważnej formie, przyjmując zazwyczaj βt = 1 oraz mnożenie macierzy zgodnie z64:
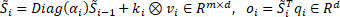 (7)
Gdzie αi i ki oznaczały odpowiednio bramkę zapominania i bramkę wejściową, obie bramki mogły zostać sprzężone jako ki = 1 − αi, w oparciu o literaturę dotyczącą bramkowanych sieci RNN. Było oczywiste, że GSLA można sformułować za pomocą sekwencyjnych obliczeń dwuprzebiegowych, jak pokazano w równaniu (8). Struktura drugiego rzędu umożliwiała blokowe trenowanie równoległe w celu zwiększenia wydajności uczenia, a wprowadzenie operacji softmax w środku struktury drugiego rzędu poprawiło zdolność modelowania pamięci o ograniczonej liczbie slotów.
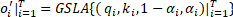 ,
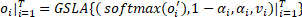 (8)
Transformowanie danych sesyjnych
Definicja problemu
Przyjmijmy, że dana sekwencja sesji to S = {v1s, v2s, ⋯, vns}, gdzie vis oznacza i-ty kliknięty element. Poprzez analizę zachowania użytkownika w zakresie kliknięć w tej sekwencji, system przewidział następny element, którym użytkownik może być zainteresowany vn+1s.
Konstrukcja grafu
Konstrukcja grafu sesji
Dla sesji S = {v1s, v2s, ⋯, vns} skonstruowano skierowany graf Gs = (Vs, εs), gdzie Vs stanowił zbiór elementów danej sesji S, a εs = {eijlocal|vi, vj, vi, vj ∈ Vs} był zbiorem krawędzi danej sesji S. ε(vi-1s, vis) reprezentował następujące po sobie kliknięte elementy w tej sesji. Krawędź eijlocal można było podzielić na cztery typy: ein, eout, ein-out, eself. Ponieważ ten sam element mógł pojawiać się wielokrotnie w sekwencji, obliczono wartość wagową dla każdej krawędzi.
Bieżąca sesja s = [v1, v2, v4, v2, v3] została przekształcona w graf skierowany (SG), jak pokazano na Rysunku 1A.
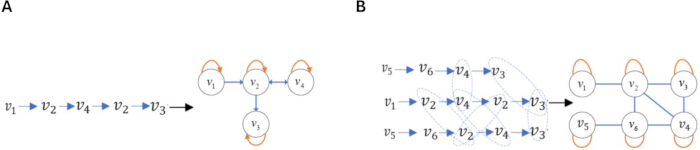
Rysunek 1: Przekształcanie elementów interaktywnych w struktury grafowe. (A) Ilustracja konstrukcji grafu sesji (SG) poprzez przekształcenie sesji w graf. (B) Ilustracja konstrukcji globalnego grafu sąsiedztwa (NGG) poprzez połączenie wielu sesji w jeden graf. Rysunek został wykonany samodzielnie w programie Visio z całkowicie spersonalizowanymi elementami. Nie wykorzystano zewnętrznych zasobów graficznych objętych prawem autorskim, w związku z czym nie było konieczne dodatkowe licencjonowanie praw osób trzecich. Prawa autorskie do rysunku przysługują autorom i będą zgodne z zasadami praw autorskich czasopisma po zaakceptowaniu pracy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Konstrukcja globalnego grafu sąsiedztwa
Na podstawie bieżącej sesji S skonstruowano odpowiadający jej NGG Gg = (Vg, εg), aby wzbogacić uczenie reprezentacji bieżącej sesji w sposób między-sesyjny. Vg stanowił zbiór elementów zawierający wszystkie elementy w Gg, a εg = {eijglobal|vi, vj, vi, vj ∈ Vg} był zbiorem krawędzi Gg. ε(vi-1g, vig) reprezentował bezpośrednio oddziałujące ze sobą elementy vi-1g oraz vig w NGG Gg. Proces ten składał się z dwóch kroków: pozyskania sesji sąsiednich oraz konstrukcji NGG.
Pozyskiwanie sesji sąsiedzkich
W całym zbiorze danych wyszukiwano sesje z maksymalną liczbą elementów współwystępujących z bieżącą sesją. Wybrano top-N sesji z najwyższą liczbą współwystąpień, aby utworzyć zbiór kandydujących sesji sąsiadujących S. Następnie zastosowano współczynnik podobieństwa Jaccarda do obliczenia podobieństwa między bieżącą sesją cu a sesją Sr ∈ S ze zbioru kandydatów S, zgodnie z równaniem (9).
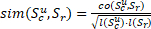 (9)
Tutaj co(Scu, Sr) oznaczało liczbę elementów występujących jednocześnie zarówno w Scu, jak i w Sr, podczas gdy l(Scu) oraz l(Sr) reprezentowały odpowiednio długości Scu i Sr, a Scu i Sr oznaczały aktualną sesję oraz sesję sąsiednią. Sesje o podobieństwie poniżej określonego progu (który mógł zostać ustawiony jako hiperparametr) zostały odfiltrowane, a pozostałe sesje utworzyły zbiór sesji sąsiednich Ns dla aktualnej sesji.
Konstrukcja globalnego grafu sąsiedztwa
Na podstawie zbioru sesji sąsiadujących Ns skonstruowano NGG, co przedstawiono na Rysunku 1B. Podczas konstruowania macierzy sąsiedztwa, jeśli dwa elementy (vi, vj) wchodziły w interakcję, odpowiadający im wpis Aij przyjmował wartość 1, w przeciwnym razie przyjmował wartość 0. Dodatkowo interakcje między elementami traktowano jako nieskierowane i wyposażono w pętle zwrotne, a następnie przeprowadzono normalizację, jak pokazano w Tabeli 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tabela 1: Znormalizowana macierz sąsiedztwa globalnego grafu sąsiadów. Tabela przedstawia znormalizowaną macierz sąsiedztwa opisującą ważone połączenia między węzłami w skonstruowanym globalnym grafie sąsiadów.
Projektowanie algorytmu rekomendacji opartego na sesjach
W tej sekcji szczegółowo omówiono proponowany innowacyjny model GSLA4Rec, który poprawił wydajność SBR poprzez wprowadzenie mechanizmu GSLA w odniesieniu do wspólnej reprezentacji cech SG i NGG.
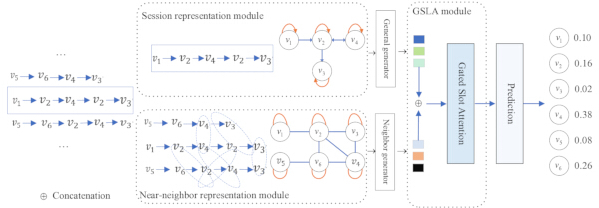
Rysunek 2: Schemat GSLA4Rec. Ten schemat zintegrował uczenie struktury grafu sesji i globalnego grafu sąsiedztwa, odfiltrował szum interakcji za pomocą mechanizmu bramkowania, zrównoważył pamięć i wydajność dzięki mechanizmowi slotów pamięci oraz uchwycił istotność elementów za pomocą mechanizmu liniowej uwagi, aby przewidzieć preferencje kolejnego kliknięcia użytkownika. Rysunek ten został wykonany autorsko w programie Visio z całkowicie spersonalizowanymi elementami. Nie wykorzystano zewnętrznych zasobów graficznych objętych prawem autorskim, w związku z czym nie było potrzeby uzyskania dodatkowych licencji od osób trzecich. Prawa autorskie do rysunku należą do autorów i będą zgodne z zasadami praw autorskich czasopisma po zaakceptowaniu pracy. GSLA4Rec reprezentuje sieci neuronowe na grafach z liniową uwagą i slotami bramkowanymi dla SBR. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
Rysunek 2 przedstawia strukturę GSLA4Rec, która składa się z czterech głównych komponentów: 1) Reprezentacja elementów na poziomie sesji. Wykorzystuje ona model GNNs na SG do nauki embeddingów elementów na poziomie sesji w ramach bieżącej sesji; 2) Reprezentacja elementów na globalnym poziomie sąsiedztwa. Uczy ona globalnych embeddingów elementów we wszystkich sesjach, wykorzystując GRU do rekurencyjnego włączania embeddingów sąsiadów każdego elementu na podstawie NGG; 3) GSLA. Modeluje preferencje użytkowników w bieżącej sesji poprzez agregację wyuczonych reprezentacji elementów zarówno na poziomie sesji, jak i na poziomie globalnym; 4) Warstwa predykcji. Generuje ona przewidywane prawdopodobieństwa dla elementów kandydujących. Cztery powyższe komponenty zostały szczegółowo omówione w dalszej części.
Reprezentacja sesji
W systemach SBR kluczowe było zrozumienie zachowań interakcyjnych użytkowników. W tym celu, w celu reprezentacji sesji, skonstruowano SG oraz NGG, dążąc do kompleksowego zrozumienia zachowań interakcyjnych użytkowników, a tym samym uchwycenia ich bardziej autentycznych intencji.
Reprezentacja elementów na poziomie sesji
Na podstawie SG przedstawionego na Rysunku 1A, do ekstrakcji cech SG zastosowano metodę ważonego dwukierunkowego mechanizmu uwagi grafu (Weighted Bidirectional Graph Attention, WBGAT). Metoda ta wprowadziła wagi krawędzi oraz kierunkowość elementów (sąsiedzi przychodzący i odchodzący) w oparciu o standardowy mechanizm GAT, co pozwoliło na wzmocnienie istotnych krawędzi i uchwycenie zależności dwukierunkowych, eliminując tym samym niedoskonałości tradycyjnego GAT w zakresie asymetrycznych relacji między elementami oraz siły oddziaływań. Proces obliczeniowy przebiegał następująco:
W pierwszej kolejności obliczono wagi normalizacji stopnia wejściowego elementów.
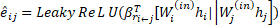 (10)
gdzie eij oznacza wagę cech elementu j względem elementu i pierwszego rzędu w sąsiedztwie,  była relacją między elementem i a elementem j, β* ∈ ℝd były wektorami wag, hi i hj były odpowiednio reprezentacjami elementu i oraz j, Wi(in) ∈ ℝd*d i Wj(in) ∈ ℝd*d były parametrami trenowalnymi, a || reprezentowało operację konkatenacji. Aby odróżnić różne relacje stopnia wejściowego, wytrenowano dwa wektory wag, mianowicie rin oraz rin-self. Jako funkcję aktywacji zastosowano LeakyReLU.
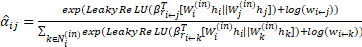 (11)
Aby współczynniki były porównywalne dla różnych elementów, wagi uwagi zostały znormalizowane za pomocą funkcji softmax. Przy założeniu, że Ni(in) stanowi zbiór sąsiadów wchodzących pierwszego rzędu dla elementu i, a  jest wagą sąsiada wchodzącego dla krawędzi skierowanej (i←j) w SG, metoda ta umożliwiła modelowi naukę korelacji cech elementów przy jednoczesnym zachowaniu informacji o immanentnej sile połączeń w strukturze grafu poprzez obliczenie logarytmu wag krawędzi i dodanie ich do oryginalnego wyniku uwagi eij.
Po drugie, obliczenie wag normalizacji stopnia wyjściowego elementów.
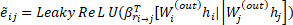 (12)
gdzie ẽij oznacza wagę sąsiada wychodzącego pierwszego rzędu cech elementu j względem elementu i,  była relacją między elementem i a j, a wytrenowano dwa wektory wag, mianowicie rout oraz rout-self.
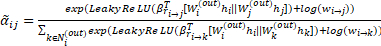 (13)
Gdzie Ni(out) oznacza zbiór sąsiadów wychodzących pierwszego rzędu elementu i, a  reprezentuje wagę sąsiada wychodzącego krawędzi skierowanej (i→j) w SG.
Po trzecie, agregacja informacji. Zaktualizowane osadzenie elementu można uzyskać po obliczeniu sumy ważonej osadzeń pierwszego rzędu stopnia wejściowego i stopnia wyjściowego elementu i.
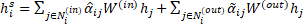 (14)
Gdzie  oraz α̃ij oznaczały odpowiednio wagi stopnia wejściowego i wyjściowego elementu i, a
 oznaczało zaktualizowaną reprezentację elementu i.
Reprezentacja elementów na poziomie globalnym sąsiedztwa
Ostatnie badania zgodnie wskazały, że konstrukcja grafu globalnego może poprawić reprezentację danych, a w konsekwencji zwiększyć wydajność SBR, co pozostaje bezsprzeczne. Jednak globalne wzbogacanie danych może również wprowadzić nieistotne informacje, takie jak szumy. W proponowanym modelu, aby osiągnąć globalną augmentację danych przy jednoczesnym maksymalnym ograniczeniu szumów, skonstruowano globalny graf najbliższych sąsiadów.
Na podstawie NGG przedstawionego na Ryc. 1B oraz znormalizowanej macierzy sąsiedztwa w Tabeli 1, bieżąca sesja oraz jej sesje sąsiednie zostały przekształcone w NGG, a następnie zastosowano metodę GGNNs45 w celu ekstrakcji cech NGG. Proces uczenia wektorów elementów w NGG przedstawiono w równaniu (15).
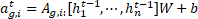
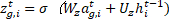
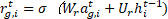
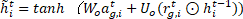
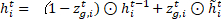 (15)
W ∈ ℝd×2d oznacza wagi sterujące, a zg,i i rg,i reprezentują odpowiednio bramkę aktualizacji (update gate) oraz bramkę resetowania (reset gate). [h1t-1, ⋯, hnt-1] reprezentuje listę wszystkich wektorów elementów w sesji s. σ(x) = 1/(1 + e-x) to logistyczna funkcja sigmoidalna, ⊙ oznacza mnożenie elementowe, a hi ∈ ℝd reprezentuje wektor po aktualizacji bramkowanej. Macierz sąsiedztwa As ∈ ℝn×n wskazuje połączenia między elementami w sąsiednich sesjach, a As,i: ∈ ℝ1×n reprezentuje blok kolumnowy As odpowiadający elementowi vs,i w macierzy sąsiedztwa. Dla bieżącej sesji s = [v1, v2, v4, v2, v3], NGG oraz znormalizowana macierz sąsiedztwa zostały przedstawione odpowiednio na Rysunku 1B i w Tabeli 1.
Reprezentacja przedmiotów
Reprezentację elementu uzyskano poprzez zsumowanie wektora elementu na poziomie sesji oraz globalnego wektora elementu sąsiada, zgodnie z równaniem (16):
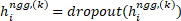
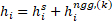 (16)
Gdzie zastosowano dropout w reprezentacjach przedmiotów sąsiednich na poziomie globalnym, aby zapobiec przeuczeniu.
Liniowa uwaga z bramkowanymi slotami
Zastosowana w niniejszej pracy liniowa uwaga z bramkowanymi slotami (GSLA) integruje liniową uwagę z kontrolą ograniczonej pamięci oraz mechanizmem bramkowania zależnym od danych. Z jednej strony dziedziczy ona mechanizm skończonej liczby slotów pamięci z modelu kontrolera opartego na uwadze (ABC), kompresując pary klucz-wartość, które pierwotnie rosły wraz z długością sekwencji, do stałej liczby slotów, przy czym każdy slot jest aktualizowany poprzez zapis konkurencyjny, co rozwiązuje problem złożoności obliczeniowej globalnej uwagi w transformatorach. Z drugiej strony wprowadza precyzyjny mechanizm bramkowania podobny do GLA, w którym dane wejściowe dynamicznie dostosowują współczynnik retencji informacji historycznych za pomocą bramki zapominania αi, co eliminuje problem szumu wynikający z braku mechanizmu zapominania w modelu ABC.
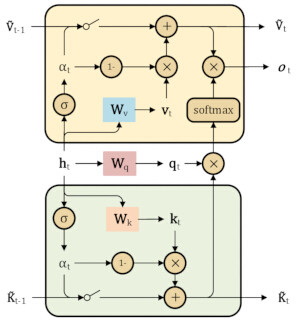
Rysunek 3: Schemat GSLA. Wektor wejściowy został zmapowany odpowiednio na wektor zapytania (query), wektor słów kluczowych (keyword) oraz wektor wartości (value), a następnie przetworzony przez liniową mechanizm uwagi (linear attention) z kontrolą ograniczonej pamięci i zależnym od danych mechanizmem bramkowania, aby uzyskać zaktualizowany wektor zapytania, wektor słów kluczowych, wektor wartości oraz wektor wyjściowy. Rysunek ten został wykonany samodzielnie w programie Visio z wykorzystaniem w pełni dostosowanych elementów. Nie użyto zewnętrznych zasobów graficznych objętych prawem autorskim, w związku z czym nie było konieczne uzyskanie dodatkowych licencji od stron trzecich. Prawa autorskie do rysunku należą do autorów i będą zgodne z zasadami praw autorskich czasopisma po zaakceptowaniu pracy. GSLA oznacza gated-slot linear attention. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Zgodnie z konkretną implementacją przedstawioną na Rysunku 3, wektor wejściowy został oddzielnie zmapowany na wektor zapytania (query), wektor klucza (key) oraz wektor wartości (value)64:
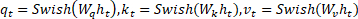 (17)
Gdzie Wq, Wk, Wv ∈ ℝd×d reprezentowały macierze wag transformacji odpowiadające odpowiednio zapytaniu (query), kluczowi (key) i wartości (value), a ht oznaczał wektor osadzenia w t-tym kroku czasowym w sekwencji wejściowej sesji. Funkcję Swish zdefiniowano jako Swish(x) = x · σ(x), będącą funkcją aktywacji z samobramkowaniem, gdzie σ była funkcją Sigmoidalną; funkcja ta wykazała wyższą skuteczność niż tradycyjna funkcja aktywacji ReLU w wielu zadaniach uczenia głębokiego.
GSLA wykorzystywał bramkę zapominania αi oraz bramkę wejściową 1 − αi, zależnie od danych wejściowych, aby dynamicznie aktualizować informacje w i-tym slocie pamięci. Proces przebiegał w następujący sposób64:
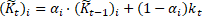 (18)
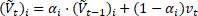 (19)
W tym przypadku K̃t i Ṽt reprezentowały sloty wektorów kluczy i sloty wektorów wartości w kroku czasowym t, podczas gdy K̃t-1 i Ṽt-1 reprezentowały sloty wektorów kluczy i sloty wektorów wartości w kroku czasowym t−1. Brama zapominania αi = σ(Wαht)1/τ, gdzie Wα ∈ ℝd była macierzą wag transformacji, σ była funkcją sigmoidalną, a τ współczynnikiem tłumienia (zazwyczaj ustawianym na 8), służącym do kontrolowania stopnia rozmycia bramy zapominania. Pozwalało to GSLA na płynną regulację tempa zapominania informacji historycznych: im większa wartość αi, tym bardziej GSLA polegało na informacjach historycznych, a im mniejsza wartość αi, tym bardziej GSLA koncentrowało się na bieżącym wejściu.
Kluczowe sloty wektorowe K̃t oraz sloty wektorów wartości Ṽt dla slotów w kroku t zostały zapisane w formie macierzowej, jak pokazano65 w równaniach (20) i (21):
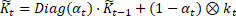 (20)
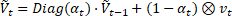 (21)
Następnie wykorzystano GSLA z właściwościami drugiego rzędu (patrz równanie (8)), aby obliczyć wyjście oi |i=1T dla każdego kroku czasowego i ∈ [1, …, T]. Do wyjścia z każdego kroku czasowego zastosowano transformację liniową w celu uzyskania wyniku h̃t. Na koniec obliczono średnią wartość reprezentacji wszystkich elementów w sekwencji sesji, aby wygenerować embedding sesji S̃e z dynamicznymi aktualizacjami pamięci:
 (22)
 (23)
Tutaj ot reprezentuje wyjście z Gated-Slot w kroku czasowym t, a h̃t oznacza wynik zastosowania transformacji liniowej na ot. S̃e oznacza średnią wartość h̃t dla wszystkich kroków czasowych.
Warstwa predykcyjna
Na podstawie uzyskanej reprezentacji sesji S̃e oraz początkowego zanurzenia elementu i, wykonano operację iloczynu skalarnego w celu obliczenia wyniku dla każdego kandydującego elementu hi. Następnie zastosowano funkcję softmax, aby uzyskać prawdopodobieństwa rekomendacji kandydującego elementu i:
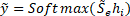 (24)
Tutaj ỹ reprezentowało prawdopodobieństwa rekomendacji elementu kandydującego, hi oznaczało wektor elementu kandydującego, a do trenowania modelu zastosowano funkcję straty entropii krzyżowej.
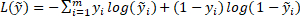 (25)
W tym przypadku y stanowiło reprezentację prawdy obiektywnej (ground truth) zakodowaną metodą one-hot.
Wyniki
Zbiory danych i przetwarzanie wstępne
W eksperymentach, w celu oceny wydajności modelu, wybrano trzy publiczne zbiory danych SBR pochodzące z rzeczywistych danych transakcyjnych w praktycznych scenariuszach zastosowań: Diginetica, wyekstrahowany z konkursu CIKM Cup 2016, zawierający rekordy transakcji i kliknięć użytkowników, Tmall, dotyczący logów użytkowników z platformy Tmall, rejestrujący zachowania przeglądania i zakupów użytkowników, oraz Nowplaying, zawierający rekordy muzyczne dotyczące historii odtwarzania użytkowników na platformach muzycznych. Zbiory danych te są szeroko stosowane w badaniach nad SBR i pozwalają na kompleksową ocenę skuteczności oraz możliwości zastosowania modelu.
Na etapie wstępnego przetwarzania danych zestawy danych zostały zestandaryzowane w celu zapewnienia spójności jakości danych. W szczególności odfiltrowano wszystkie sesje o długości mniejszej niż 2, a elementy pojawiające się rzadziej niż 5 razy zostały usunięte. Ponadto dla każdej sesji S = {v1, v2, ..., vn} wygenerowano wiele podciągów do trenowania i testowania modelu. Podciągi te miały postać: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Po zakończeniu wyżej wspomnianego wstępnego przetwarzania przeprowadzono analizy statystyczne zestawów danych, a szczegółowe informacje przedstawiono w Tabeli 2.
| Zbiór danych | Diginetica | Tmall | Odtwarzane teraz |
| kliknij | 982961 | 818479 | 1367963 |
| trenować | 719470 | 351268 | 825304 |
| test | 60858 | 25898 | 60417 |
| elementy | 43097 | 40728 | 60417 |
| śr. dł. | 5.12 | 6.69 | 7.42 |
Tabela 2: Opis zbiorów danych. Tabela podsumowuje statystyki zbiorów danych Diginetica, Tmall i Nowplaying, w tym liczbę kliknięć, próbek treningowych i testowych, elementów oraz średnią długość sesji.
Warunki eksperymentalne
Konfiguracja parametrów
Aby zapewnić rzetelność eksperymentu, zastosowano metody preprocessingu w celu przetworzenia trzech zbiorów danych, jednocześnie konfigurując parametry modelu GSLA4Rec. Dla zbiorów danych Diginetica i Nowlaying wielkość partii (batch size) ustawiono na 150, a dla zbioru Tmall na 300. Parametry tego modelu zainicjowano za pomocą rozkładu Gaussa ze średnią 0 i odchyleniem standardowym 0,1, a wymiar ustawiono na 100. Jako optymalizator wykorzystano Adam z początkową stopą uczenia wynoszącą 0,001; stopę uczenia mnożono przez 0,1 co 3 epoki. Trening przeprowadzono przez łącznie 30 epok na procesorze GPU NVIDIA TITAN V oraz w środowisku PyTorch 1.11.0 z cu113 (patrz Tabela materiałów) w celu uzyskania najlepszej wartości. Próg filtrowania sesji sąsiednich ustawiono na 0,5, a w eksperymencie zastosowano regularyzację L2. Dla każdego zbioru danych ostatnie 10% danych posortowanych według czasu transakcji wybrano jako zestaw testowy, natomiast pozostałe 10% i 80% wybrano losowo odpowiednio jako zestawy walidacyjne i treningowe. Liczbę slotów pamięci w GSLA ustawiono na wartość z zestawu {0, 1, 2, 3, 4, 5}.
Metryki oceny
W niniejszej pracy przyjęto miary P@N (Precision@N, N = 10/20) oraz MRR@N (Mean Reciprocal Rank@N, N = 10/20). P@N wykorzystano do pomiaru proporcji poprawnych rekomendacji wśród pierwszych N wyników rekomendacji, natomiast MRR@N posłużyło do obliczenia średniej odwrotności rangi poprawnych projektów; wyższa wartość MRR oznacza lepszą wydajność sortowania.
Analiza wydajności
Skuteczność modelu GSLA4Rec została oceniona w odniesieniu do modeli bazowych reprezentujących różne etapy rozwoju technologicznego. W początkowej fazie do SBR stosowano metody uczenia maszynowego; na przykład FPMC5 służył do przewidywania efektów sekwencyjnych w oparciu o łańcuch Markowa. Następnie, wraz z rozwojem sztucznej inteligencji, w SBR szeroko zastosowano uczenie głębokie; przykładowo model GRU4Rec10, oparty na sieciach RNN, modeluje SBR poprzez stosowanie wielu warstw GRU i wykorzystuje specjalistyczne funkcje straty w celu optymalizacji SBR, NARM16 wprowadził AM w celu uchwycenia głównych zainteresowań użytkowników oraz wygenerowania ostatecznej reprezentacji embeddingu dla kolejnego potencjalnego elementu rekomendacji, a STAMP17 wykorzystał wielowarstwowe perceptrony wzmocnione AM do jednoczesnego wychwytywania ogólnych i doraźnych zainteresowań użytkowników. W ostatnich latach w SBR szeroko wykorzystuje się również grafowe sieci neuronowe ze względu na ich potężne możliwości uczenia danych nieeuklidesowych. Na przykład SR-GNN22 jako pierwszy zastosował GNN w SBR, uzyskując złożone relacje przejść między elementami za pomocą GGNN i koncentrując się na doraźnych zainteresowaniach użytkowników w połączeniu z AM, GCE-GNN23 wykorzystał GAT do uzyskania relacji transferu elementów w kontekstach lokalnych i globalnych oraz wygenerował reprezentacje sesji poprzez RPE i soft-AM, natomiast S2-DHCN66 przekształcił dane sesji w hipergraf i graf liniowy, wykorzystując uczenie samosuperwizowane do usprawnienia SBR.
Ostatnio przyjęto kompleksowe podejście w celu poprawy wydajności SBR. Na przykład GC-SAN50 połączył sieci GNN z wielowarstwowymi sieciami samo-uwagi w celu zwiększenia jakości rekomendacji poprzez modelowanie zależności krótkoterminowych i długoterminowych, TASRec67 włączył informacje czasowe poprzez konstruowanie sekwencji dynamicznych migawek grafu w różnych punktach czasowych, CT-GNN68 zastosował sieci GNN z połączonymi informacjami czasowymi, aby nauczyć się dodatkowych informacji o powiązaniach czasowych między elementami, CORE69 zintegrował informacje o współwystępowaniu i informacje czasowe elementów w celu uzyskania końcowej reprezentacji sesji, RESTC70 zaproponował czasoprzestrzenne wzorce interakcji zainspirowane właściwościami jednorodności i wyrównania uczenia kontrastowego, COTRec66,71 zastosował uczenie samosuperwizowane na dwóch widokach grafu sesji oraz wspólne trenowanie w celu rozwiązania problemu rzadkości danych w SBR, a RAIN71 wykorzystał maskowanie krawędzi i rekonstrukcję strukturalną, a także wspólnie wytrenował wskaźnik krawędzi w celu jawnej identyfikacji i eliminacji szumnych krawędzi, co znacząco zwiększyło dokładność i odporność SBR.
| Zbiory danych | Diginetica | Tmall | Obecnie odtwarzane | ||||||||||
| Klasa metody- identyfikacja | Metryki | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Uczenie maszynowe | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| Głębokie uczenie | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| Głębokie uczenie | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| Głębokie uczenie | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| GNN (grafowe sieci neuronowe) | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| GNN (grafowe sieci neuronowe) | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNN (grafowe sieci neuronowe) | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN z mechanizmem uwagi (Att) | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNN z mechanizmem uwagi (Att) | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNN (sieci neuronowe na grafach) + TEM (transmisyjna mikroskopia elektronowa) | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNN+Tem | RDZEŃ | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNN+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNNs+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNNs+ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNN-y+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| SD | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| wartość p | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Twnioskowanie | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
Tabela 3: Porównanie wydajności na trzech zbiorach danych. Tabela porównuje GSLA4Rec z metodami rekomendacji opartymi na uczeniu maszynowym, głębokim uczeniu, sieciach GNN, mechanizmach uwagi, analizie temporalnej oraz innymi metodami na zbiorach danych Diginetica, Tmall i Nowplaying, przy użyciu miar P@10, P@20, MRR@10 i MRR@20. Dla GSLA4Rec podano również wartości SD oraz p.
W celu weryfikacji skuteczności modelu GSLA4Rec oraz wyeliminowania przypadkowości wzrostu wydajności spowodowanej czynnikami losowymi, na zbiorze testowym przeprowadzono wielokrotne eksperymenty grupowe oraz analizy statystyczne. W szczególności zbiór testowy podzielono na grupy po 150 sesji w jednej partii, powtarzając proces 30 razy z wykorzystaniem metody ziarna losowego (random seed). Średnie wyniki i czas zużycia dla wszystkich eksperymentów grupowych obliczono odpowiednio jako wydajność i czas wnioskowania modelu GSLA4Rec. Obliczono odchylenie standardowe (SD) oraz statystyczną istotność testu t dla modelu GSLA4Rec, aby dodatkowo potwierdzić stabilność i pewność wzrostu wydajności tego modelu. W Tabeli 3 przedstawiono wydajność, SD, wartość p oraz Tinference proponowanego modelu rekomendacyjnego GSLA4Rec w porównaniu z modelami bazowymi na trzech zbiorach danych. Liczby podkreślone wskazują na najlepszą metodę bazową, natomiast model o najwyższej wydajności dla każdej z metryk oceny zaznaczono pogrubioną czcionką.
Metody rekomendacyjne oparte na uczeniu maszynowym: W zadaniach SBR tradycyjna metoda FPMC wykazała najgorsze wyniki, głównie dlatego, że modele łańcuchów Markowa nie radziły sobie z uchwyceniem złożonych wzorców przejść między elementami. 2) Metody rekomendacyjne oparte na głębokim uczeniu: Modele takie jak GRU4REC, NARM i STAMP wykorzystywały podejścia do modelowania sekwencji i osiągnęły pewną poprawę wydajności. Wśród nich NARM i STAMP wykazały lepsze wyniki rekomendacji niż GRU4REC, przede wszystkim dlatego, że NARM wprowadził mechanizm uwagi w celu uchwycenia głównych zainteresowań użytkowników. 3) Metody rekomendacyjne oparte na GNN: Zastosowanie GNN w SBR przyniosło znaczną poprawę wydajności. Na przykład SR-GNN, który zapoczątkował konwersję sekwencji sesji na struktury grafowe w celu uchwycenia przestrzennych informacji strukturalnych elementów, przewyższył metody głębokiego uczenia reprezentowane przez STAMP o 0,36–4,64%, wykazując przewagę przestrzenną struktur grafowych w przetwarzaniu danych sekwencyjnych. S2-DHCN zastosował dwukanałową splotową hipergrafową konwolucję do uchwycenia zależności wysokiego rzędu między elementami i połączył ją z samonadzorowanym uczeniem kontrastowym w celu usprawnienia reprezentacji, rozwiązując ograniczenie tradycyjnych GNN polegające na modelowaniu jedynie relacji parzystych i niedoborze informacji; jego wydajność przewyższyła metody głębokiego uczenia reprezentowane przez STAMP o 1,30–7,04%. GCE-GNN, dzięki efektywnej integracji informacji z pojedynczej sesji oraz globalnych informacji sesyjnych, przewyższył metody głębokiego uczenia reprezentowane przez STAMP o 1,46–7,60% i SR-GNN o 0,88–5,85%, co wskazuje, że metody struktury grafowej uwzględniające globalne informacje kontekstowe mogą znacznie zwiększyć wydajność SBR. 4) Metody rekomendacyjne GNN + mechanizm uwagi: TASRec dążył do bardziej precyzyjnego uchwycenia krótkoterminowych i długoterminowych preferencji w sekwencjach zachowań użytkowników poprzez wprowadzenie mechanizmu świadomego czasu; jego wydajność przewyższyła metody głębokiego uczenia o 0,73–5,91% i model SR-GNN o 0,30–2,31%, jednak była niższa od modelu GCE-GNN o 0,59–3,84%. GC-SAN połączył struktury grafowe przekształcone z sekwencji sesji z mechanizmami wielogłowicowej uwagi (multi-head self-attention), aby skutecznie uchwycić lokalne i długoterminowe zależności w obrębie sesji; jego wydajność była porównywalna lub nieco wyższa niż modelu SR-GNN, ale gorsza niż modeli TASRec i GCE-GNN. Sugeruje to, że wprowadzenie mechanizmów uwagi może efektywnie poprawić wydajność SBR, jednak poprawa ta była mniej znacząca niż ta osiągnięta dzięki informacjom globalnym, co potwierdza znaczenie globalnych informacji kontekstowych. 5) Metody rekomendacyjne GNN + kodowanie czasu: CT-GNN był pierwszym modelem łączącym struktury grafowe z kodowaniem czasowym w celu jednoczesnego uchwycenia „struktury przestrzennej” i „dynamiki czasowej”, przewyższając model GC-SAN o 0,55–3,82%. CORE uchwycił długoterminowe preferencje i krótkoterminowe intencje poprzez statyczną analizę częstotliwości współwystępowania elementów z globalnych sesji oraz zaprojektowanie ważenia pozycji czasowej dla bieżących sesji, a następnie połączył te informacje o współwystępowaniu i czasie w celu uzyskania końcowej reprezentacji sesji; jego wydajność przewyższyła model TASRec o 0,25–9,58% i model GC-SAN o 0,67–11,56%, wykazując znaczną poprawę o 3,64–5,74% nad modelem GCE-GNN w zbiorze danych Tmall. RESTC wprowadził model uczenia kontrastowego oparty na przestrzenno-czasowych GNN, aby rozwiązać problemy występujące w tradycyjnych GNN, takie jak skupienie wyłącznie na przestrzennych strukturach grafowych, ignorowanie informacji czasowych i niewystarczająca fuzja przestrzenno-czasowa; jego wydajność przewyższyła model CORE o 0,39–3,31% i model GCE-GNN o 0,28–7,56%, co wskazuje, że zarówno kodowanie czasowe, jak i uczenie kontrastowe skutecznie zwiększają wydajność SBR. RAIN wykorzystał techniki maskowania krawędzi i rekonstrukcji strukturalnej do wspólnego trenowania wskaźnika krawędzi w celu jawnej identyfikacji i eliminacji krawędzi szumiących, osiągając wydajność zbliżoną do modelu RESTC.
Zaproponowany model, GSLA4Rec, zintegrował globalne informacje kontekstowe oraz mechanizm bramkowanej liniowej uwagi z gniazdami (gated-slot linear attention), aby skutecznie przechwytywać informacje kontekstowe użytkowników przy jednoczesnym filtrowaniu szumów i redukcji złożoności obliczeniowej. Wykazał on poprawę wydajności we wszystkich zbiorach danych, przewyższając dwa najlepiej działające modele bazowe — model RESTC o 0,54–2,31% oraz model GCE-GNN o 0,83–10,18%. Było to szczególnie widoczne przy obsłudze zależności sekwencyjnych w scenariuszach długich sesji w SBR (konkretnie poprawy o 10,18% i 4,73% w porównaniu z GCE-GNN oraz o 1,44% i 2,31% w porównaniu z RESTC odpowiednio w zbiorach danych Tmall i Nowplaying). W skrócie, zaproponowany model GSLA4Rec wykorzystał efektywne konstruowanie grafów do przechwytywania kontekstów użytkowników i filtrowania szumów; jego wydajność konsekwentnie przewyższała modele SOTA we wszystkich zbiorach danych.
Analiza wydajności
Jak pokazano w Rysunek 4wyniki eksperymentalne na zbiorze danych Diginetica wykazały, że proponowany model GSLA4Rec osiągnął szybszą prędkość uczenia w porównaniu z modelami bazowymi pod kątem czasu uczenia na epokę; wszystkie eksperymenty przeprowadzono na procesorze GPU NVIDIA TITAN V przy zużyciu pamięci wynoszącym około 9300 MB. Modele oparte na głębokim uczeniu, w tym STAMP, NARM i GRU4Rec, działały wydajnie, lecz wykazały najsłabszą skuteczność; modele TASRec i GC-SAN oparte na sieciach GNN i mechanizmie self-attention poprawiły skuteczność, jednak wiązało się to ze znacznym wydłużeniem czasu obliczeń. Chociaż S2-DHCN oraz CORE oparte na GNN spowodowały niewielki wzrost czasu obliczeń, jednak ogólna wydajność uległa znaczącej poprawie, w szczególności w przypadku zaproponowanego modelu GSLA4Rec, który wykazał istotny wzrost skuteczności. Główną przyczyną był fakt, że model GSLA4Rec poświęcał mniej czasu na konstrukcję grafu niż modele bazowe; ponadto zastosowano w nim dwuetapowy mechanizm bramkowanej uwagi liniowej (gated linear attention) z ustalonymi slotami pamięci. m, co skutkuje liniową złożonością czasową O(Ldm). Konstrukcja ta okazała się znacznie bardziej wydajna niż standardowy mechanizm self-attention O(L2d) przy jednoczesnym zachowaniu wysokiej pojemności pamięci dzięki odczytowi slotów wspieranemu funkcją softmax. Przeprowadzono eksperymenty z testowaniem wydajności na zbiorze testowym w celu synchronizacji czasu wnioskowania statystycznego, co przedstawiono w ostatnim wierszu Tabela 3wykazano przewagę wydajności modelu GSLA4Rec, unikając "fałszywie wysoka dokładność, ale niedostępna" oraż rzeczywiste osiągnięcie kompromisu pomiędzy skutecznością a efektywnością.
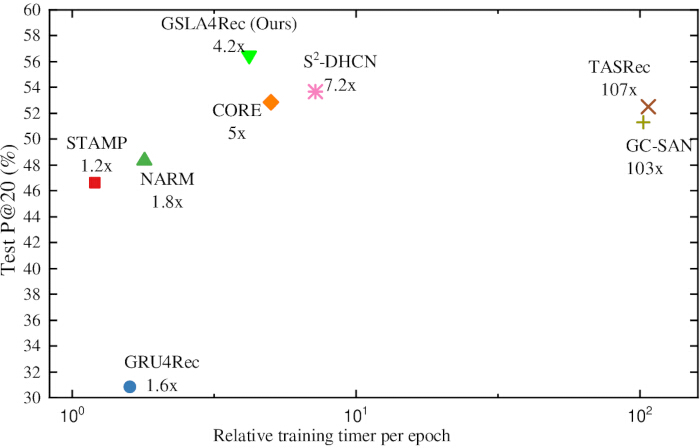
Rycina 4: Wydajność GSLA4Rec w funkcji czasu wykonania na zbiorze Diginetica. Na rycinie przedstawiono czas relatywny trenowania na epokę dla zaproponowanego modelu GSLA4Rec oraz modeli bazowych, uruchomionych na procesorze GPU NVIDIA TITAN V z wykorzystaniem zbioru Diginetica; GSLA4Rec osiągnął wyższą prędkość trenowania niż modele bazowe. Rycina została wykonana samodzielnie w programie OriginPro z użyciem w pełni dostosowanych elementów. Nie wykorzystano zewnętrznych zasobów graficznych objętych prawem autorskim, w związku z czym nie było konieczne uzyskanie dodatkowych licencji od stron trzecich. Prawa autorskie do ryciny należą do autorów i będą zgodne z zasadami praw autorskich czasopisma po zaakceptowaniu pracy. GSLA4Rec oznacza grafowe sieci neuronowe z liniową uwagą typu gated-slot (gated-slot linear attention graph neural networks) dla SBR. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Podsumowując, efektywność zaproponowanego modelu GSLA4Rec z mechanizmem gated-slot attention o złożoności liniowej konsekwentnie przewyższała wyniki SOTA we wszystkich zbiorach danych. W szczególności GSLA4Rec osiągnął znaczące wzrosty wydajności w scenariuszach rekomendacji dla długich sesji w zbiorach danych Tmall i Nowplaying oraz wykazał wyższą zdolność modelowania zależności sekwencyjnych.
Analiza eksperymentów ablacyjnych
Wpływ SG i NGG oraz GSLA
Aby ocenić wpływ SG, NGG, mechanizmu bramkującego, slotów pamięci oraz liniowej uwagi na obecny SBR, przeprowadzono badania ablacyjne na zbiorach danych Diginetica, Tmall i Nowplaying. W wersji GSLA4Rec‑NotSG wykluczono kodowanie cech SG przy zachowaniu kodowania NGG; w GSLA4Rec‑NotNGG odrzucono kodowanie NGG i przeprowadzono ekstrakcję cech wyłącznie na podstawie SG; w GSLA4Rec‑NotGM usunięto jedynie mechanizm bramkujący w obrębie GSLA; w GSLA4Rec‑NotMS wyeliminowano wyłącznie sloty pamięci GSLA, a w GSLA4Rec‑NotLA pominięto tylko moduł liniowej uwagi w GSLA.
| Zbiór danych | Diginetica | Tmall | Odtwarzane teraz | |||
| Pomiary | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Tabela 4: Wyniki eksperymentów ablacyjnych modelu GSLA4Rec. Tabela przedstawia wyniki ablacyjne GSLA4Rec po usunięciu poszczególnych komponentów modelu na zbiorach danych Diginetica, Tmall oraz Nowplaying, oceniane za pomocą wskaźników P@20 oraz MRR@20.
Tabela 4 przedstawia wyniki badania ablacyjnego na różnych zbiorach danych; wszystkie wskaźniki wydajności spadły w porównaniu z pełnym modelem. Spadek wydajności po usunięciu globalnego kodowania grafu sesji dla najbliższych sąsiadów (GSLA4Rec-NotNGG) był silniejszy niż po usunięciu kodowania cech grafu sesji (GSLA4Rec-NotSG). Usunięcie któregokolwiek z podmodułów w GSLA prowadziło do pogorszenia wydajności, przy czym stopień tego pogorszenia układał się w kolejności malejącej dla: uwagi liniowej, slotów pamięci oraz mechanizmu bramkowania. Wynikało to z faktu, że znaczenie każdego elementu w SBR było zdecydowanie różne i istniała potrzeba zastosowania pamięci asocjacyjnej między elementami. Można zatem stwierdzić, że GSLA stanowiło kluczową część modelu opisanego w niniejszej pracy.
Wpływ różnych metod agregacji
Aby ocenić wpływ różnych metod agregacji informacji na wydajność modelu GSLA4Rec, zbadano następujące trzy klasyczne metody agregacji informacji: 1) Average Pooling: wykonanie operacji uśredniania wektorów wygenerowanych przez SG i NGG; 2) Konkatenacja Wektorów: łączenie wektorów wygenerowanych przez SG i NGG; 3) Sumowanie Wektorów: sumowanie wektorów wygenerowanych przez SG i NGG. Wyniki przedstawiono w Tabeli 5. Model GSLA4Rec z zastosowaniem Vec-Sum osiągnął najlepszą wydajność w zbiorach danych Diginetica, Tmall oraz Nowplaying. W przeciwieństwie do tego, Mean-pooling przyniósł słabe wyniki we wszystkich zbiorach danych. Gorsza wydajność agregacji średniej oraz agregacji przez konkatenację może wynikać z przeuczenia spowodowanego nadmierną liczbą parametrów, co obniżyło ogólną wydajność modelu.
| Zbiór danych | Diginetica | Tmall | Nowplaying | |||
| Miary | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Mean-Pooling | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| Vec-Concating | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| Vec-Sum | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
Tabela 5: Wpływ różnych metod agregacji. Tabela porównuje wpływ uśredniania (mean pooling), konkatenacji wektorów i sumowania wektorów na wydajność modelu GSLA4Rec w zbiorach danych Diginetica, Tmall i Nowplaying z wykorzystaniem miar P@20 i MRR@20.
Analiza ustawień hiperparametrów
Wpływ różnych rozmiarów slotów pamięci
Sloty pamięci przechowywały informacje z poprzednich kroków czasowych, co było szczególnie istotne w zadaniach z zależnościami czasowymi. W tej sekcji zbadano wpływ rozmiarów slotów pamięci m = [0, 1, 2, 3, 4, 5] na wydajność SBR. Wyniki eksperymentów, przedstawione w Tabeli 6, wykazały, że przy ustawieniu rozmiaru slotów pamięci m na 3, wskaźniki P@20 oraz MRR@20 osiągnęły optymalne wartości we wszystkich trzech zbiorach danych. Sugeruje to, że umiarkowany rozmiar slotów pamięci skutecznie poprawił dokładność rekomendacji oraz jakość rankingu modelu; mniejsze sloty pamięci mają trudności z zapamiętaniem wystarczającej ilości informacji historycznych i koncentrują się bardziej na krótkoterminowych zainteresowaniach użytkowników, natomiast gdy rozmiar slotów pamięci wzrósł do 4 lub więcej, model przechowuje nadmierną ilość informacji historycznych, co powoduje nadmierne poleganie na zainteresowaniach z przeszłości przy jednoczesnym pomijaniu bardziej krytycznych bieżących informacji wejściowych, co w konsekwencji obniża wydajność rekomendacji.
| Zbiór danych | Diginetica | Tmall | Odtwarzane teraz | |||
| Pomiary | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
Tabela 6: Wpływ różnych rozmiarów slotów pamięci. Tabela przedstawia wydajność modelu GSLA4Rec przy różnych konfiguracjach slotów pamięci (m0–m5) na zbiorach danych Diginetica, Tmall i Nowplaying z wykorzystaniem miar P@20 oraz MRR@20.
Wpływ różnych współczynników dropoutu
Aby zapobiec przeuczeniu, wprowadzono regularyzację dropout. Przed zsumowaniem wektora elementów na poziomie sesji oraz wektora elementów sąsiadów na poziomie globalnym, wyjścia neuronów w wektorze elementów sąsiadów na poziomie globalnym hingg,(k) były losowo pomijane, aby zwiększyć odporność i zdolność generalizacji modelu GSLA4Rec.
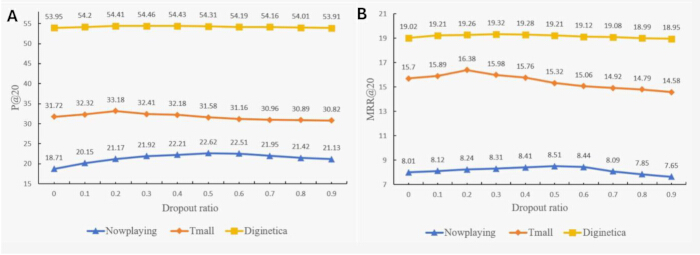
Rysunek 5: Efektywność GSLA4Rec przy różnych współczynnikach dropout. (A) P@20 oraz (B) MRR@20 dla modelu GSLA4Rec przy różnych współczynnikach dropout w zbiorach danych Nowplaying, Tmall i Diginetica. Efektywność początkowo wzrastała, a następnie spadała wraz ze wzrostem współczynnika dropout, co wykazuje odporność i zdolność do generalizacji modelu. GSLA4Rec: sieci neuronowe grafowe z bramkowaną liniową uwagą slotową dla rekomendacji opartych na sesjach (SBR). Rysunek został wykonany samodzielnie w programie OriginPro z w pełni spersonalizowanymi elementami. Nie wykorzystano zewnętrznych zasobów graficznych objętych prawem autorskim, w związku z czym nie wymagano dodatkowych licencji stron trzecich. Prawa autorskie do rysunku należą do autorów i będą zgodne z zasadami prawa autorskiego czasopisma po zaakceptowaniu pracy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Rysunek 5A–B przedstawia wpływ różnych współczynników dropout w równaniu (16) na wydajność modelu. Wyniki eksperymentalne wykazały, że model osiąga słabe wyniki przy niskim współczynniku dropout, jednak wraz ze wzrostem tego współczynnika wydajność modelu stopniowo rosła, aż do osiągnięcia poziomu optymalnego. Konkretnie, optymalny współczynnik dropout wynosił 0.3 dla zbioru danych Diginetica, 0.2 dla zbioru danych Tmall oraz 0.5 dla zbioru danych Nowplaying. Gdy współczynnik dropout przekroczył te wartości optymalne, wydajność modelu zaczęła spadać, przede wszystkim dlatego, że nadmierne pomijanie neuronów uniemożliwiło modelowi efektywną naukę istotnych cech z danych sesyjnych.
Wpływ różnych rozmiarów osadzeń
Aby maksymalnie zminimalizować narzut obliczeniowy przy jednoczesnym zachowaniu optymalnej wydajności modelu, zbadano wpływ różnych wymiarów osadzeń d na działanie modelu GSLA4Rec. Jak pokazano na Rysunku 6A–B, w przypadku trzech publicznych zbiorów danych Diginetica, Tmall i Nowplaying, model GSLA4Rec wykazywał słabe wyniki, gdy wymiar osadzenia d wynosił 10–40; jednak wydajność modelu gwałtownie rosła wraz ze wzrostem wartości d, a wskaźniki wydajności miały tendencję do stabilizacji, gdy wartość d mieściła się w zakresie od 80 do 120. Następnie wydajność faktycznie spadła przy dalszym wzroście d, co prawdopodobnie wynikało z przeuczenia spowodowanego zbyt dużym wymiarem osadzenia. W związku z tym wymiar wektora osadzenia elementu ostatecznie ustalono na 100.
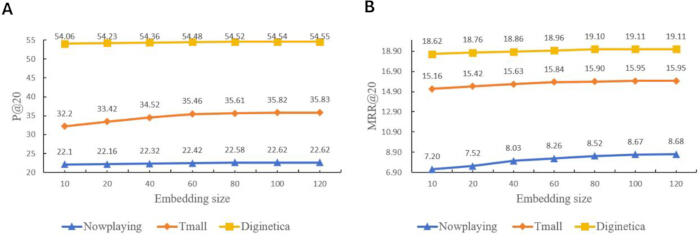
Rysunek 6: Wydajność modelu GSLA4Rec przy różnych rozmiarach embeddingów. (A) P@20 oraz (B) MRR@20 modelu GSLA4Rec przy różnych rozmiarach embeddingów dla zbiorów danych Nowplaying, Tmall i Diginetica. Wydajność modelu stopniowo rosła wraz ze zwiększaniem rozmiaru embeddingów, aż ostatecznie osiągnęła plateau. GSLA4Rec – grafowe sieci neuronowe z liniową uwagą bramkowanych slotów dla rekomendacji opartych na sesjach (SBR). Rysunek został wykonany samodzielnie w programie OriginPro z pełnym dostosowaniem elementów. Nie wykorzystano zewnętrznych zasobów graficznych objętych prawem autorskim, w związku z czym nie wymagano dodatkowych licencji stron trzecich. Prawa autorskie do rysunku należą do autorów i będą zgodne z zasadami praw autorskich czasopisma po zaakceptowaniu pracy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Wpływ różnej długości sesji
Znane było, że długość poszczególnych sesji różni się w trzech rzeczywistych zbiorach danych SBR (Diginetica, Tmall i Nowplaying). Aby zweryfikować odporność modelu GSLA4Rec w porównaniu z modelami bazowymi dla różnych długości sesji, wszystkie sesje w zbiorach Diginetica i Tmall podzielono na trzy grupy: krótką (S), średnią (M) i długą (L), odpowiednio od 1 do 6, od 7 do 12 oraz powyżej 12. Do weryfikacji skuteczności metod, zamiast P@20, zastosowano MRR@20, ponieważ MRR lepiej odzwierciedla jakość rankingową poprawnych wyników. Rycina 7A–B wskazała, że model GSLA4Rec przewyższył model bazowy oparty na sekwencjach NARM, model bazowy oparty na GNN SR-GNN, model bazowy GNN rozszerzony o uczenie kontrastowe S2-DHCN oraz model bazowy czasoprzestrzenny RESTC przy różnych długościach sesji. Jednocześnie zaobserwowano, że skuteczność wszystkich metod spadała wraz ze wzrostem długości sekwencji, ponieważ dalekosiężne przejścia między elementami utrudniały uchwycenie preferencji użytkowników; jednak zaproponowany model GSLA4Rec wykazał najwolniejszy spadek w porównaniu z modelami bazowymi, gdyż mechanizm Gated-slot pozwalał odfiltrować nieistotne elementy. Skuteczność GSLA4Rec w grupach długich zbiorów Diginetica i Tmall przewyższyła odpowiednio model NARM o 6,3 oraz 8,85.
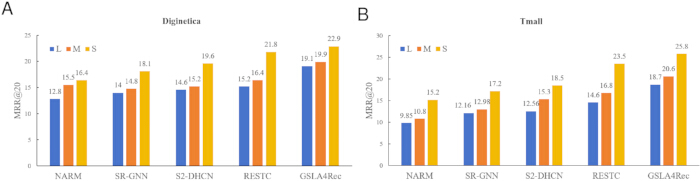
Rysunek 7: Wydajność GSLA4Rec przy różnych długościach sesji. Wydajność GSLA4Rec oraz modeli bazowych w różnych grupach długości sesji dla zbiorów danych (A) Diginetica oraz (B) Tmall, oceniona za pomocą MRR@20. Grupy długości sesji oznaczono jako L, M i S. GSLA4Rec: grafowe sieci neuronowe z liniową uwagą bramkowanych slotów dla rekomendacji opartych na sesjach (SBR). Rysunek został wykonany samodzielnie w programie OriginPro z pełną personalizacją elementów. Nie wykorzystano zewnętrznych zasobów graficznych objętych prawem autorskim; w związku z tym nie było wymaganych dodatkowych licencji autorskich stron trzecich. Prawa autorskie do rysunku należą do autorów i będą zgodne z zasadami praw autorskich czasopisma po przyjęciu pracy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Podsumowanie
Niniejsza praca proponuje globalną sieć uwagi liniowej z bramkowanymi slotami kontekstowymi dla SBR. Dzięki połączeniu SG i NGG oraz wprowadzeniu mechanizmu uwagi liniowej z bramkowanymi slotami, metoda ta pozwala na skupienie się na kluczowych elementach w sekwencji sesji, przechwytywanie zależności krótko- i długoterminowych, skuteczną redukcję szumów oraz zmniejszenie złożoności obliczeniowej. Wyniki eksperymentalne potwierdzają, że metoda ta wykazuje doskonałą dokładność i wydajność rekomendacji na trzech publicznych zbiorach danych, szczególnie wyróżniając się w zadaniach modelowania zależności długoterminowych.
DOSTĘPNOŚĆ DANYCH:
Trzy powszechnie stosowane publiczne zestawy danych (Diginetica, Tmall oraz Nowplaying, których adresy URL znajdują się w Tabeli materiałów), wspierające wyniki niniejszego badania, są otwarcie dostępne w internecie. Jednocześnie trzy szeroko wykorzystywane publiczne zestawy danych oraz kod źródłowy do tej pracy zostały przekazane w ramach Folderu uzupełniającego: GSLA4Rec.zip. Prosimy kliknąć tutaj, aby pobrać ten plik.
Dyskusja
W porównaniu z wartościami odniesienia, model GSLA4Rec osiąga dwukrotną poprawę wydajności i efektywności z trzech głównych powodów. Po pierwsze, zastosowanie mechanizmów bramkowych do NGG zmniejsza rzadkość danych i skutecznie filtruje szumy. Po drugie, mechanizm gniazd pamięciowych równoważy pojemność przechowywania i efektywność za pomocą hiperparametru m dostosowanie. Po trzecie, mechanizm uwagi liniowej oblicza korelacje między elementami na poziomie O(N) złożoność, znacznie niższa niż O(N2)61Model GSLA4Rec nadmiernie polega na użytkownikach' sekwencje interakcji i ignoruje multimodalne właściwości elementów48Tymczasem konstrukcja NGG wykorzystuje ustalony próg Jaccarda bez funkcji dynamicznej adaptacji oraz miejsca pamięciowe m nie może osiągnąć adaptacyjnej regulowalności65.
Model GSLA4Rec, który tworzy SG&NGG i przyjmuje liniową uwagę z bramkowanymi szczelinami, szczególnie nadaje się do rekomendacji sesji anonimowych39 na platformach e-commerce i streamingu online. W przypadku platform e-commerce model ten rekomenduje dopasowane produkty użytkownikom, analizując ich zachowania związane z przeglądaniem, klikaniem lub dodawaniem produktów do koszyka, bez opierania się na atrybutach charakteryzujących użytkownika. Zestawy danych Diginetica i Tmall wykorzystane w niniejszym artykule są zbiorami danych do rekomendacji e-commerce. W przypadku platform streamingu krótkich filmów i muzyki, metoda ta analizuje użytkowników' sekwencje odtwarzania, aby wywnioskować ich ukryte preferencje, aktualizuje streszczenia treści w celu zatrzymania użytkowników oraz wydłuża czas oglądania. Zestaw danych Nowplaying wykorzystany w tym artykule to zbiór danych dotyczący rekomendacji muzyki.
Istnieją alternatywne rozwiązania, które mogą zastąpić architekturę uwagi liniowej z kanałem bramkowanym. Pojawiający się Mamba65 oparty na modelu przestrzeni stanów, jako alternatywa, charakteryzuje się selektywną przestrzenią przechowywania stanów i liniową złożonością obliczeniową, łącząc zrównoważoną liniową złożoność z możliwością dopasowania długich sekwencji oraz połączony z modelem językowym dużym (LLM)55 ramy zwiększania, wyodrębnia użytkowników' niejawne intencje wynikające z oryginalnego dziennika interakcji, osiągając w ten sposób wysoką skuteczność i efektywność rekomendacji. Prace przyszłe mogą optymalizować GSLA4Rec pod wieloma aspektami: budowę dynamicznej NGG w celu zastąpienia stałego filtrowania Jaccarda, implementację zmiennych slotów pamięciowych w celu automatycznego dopasowania sesji o różnej długości oraz włączenie multimodalnych informacji o użytkowniku w celu poprawy dokładności rekomendacji. Dodatkowo, przy użyciu modeli wzbogaconych o LLM55, użytkownicy' celowe intencje można wydobyć z sekwencji interakcji, a dane z rozmów zawierające zakłócenia można filtrować dokładniej72.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych znanych konkurencyjnych interesów finansowych ani osobistych relacji, które mogłyby wpłynąć na pracę opisaną w niniejszym artykule.
Podziękowania
Autor dziękuje recenzentom za wnikliwe uwagi i sugestie przekazane podczas procesu recenzji, a także profesorowi Jiang Nanowi, promotorowi doktoratu, za staranne prowadzenie. Badanie to było częściowo finansowane przez National Science Foundation of China w ramach grantów nr 6217072713 oraz nr 62061019, a także z funduszy na otwarte zagadnienia badawcze w ramach Jiangxi Province unmanned sensing system and artificial intelligence technology Engineering Research w 2025 roku oraz przez Jiangxi Provincial Key Laboratory of Advanced Electronic Materials and Devices (nr 2024SSY03012).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | BRAK | CUDA 11.3 to wersja platformy obliczeń równoległych i modelu programowania wydana przez NVIDIA w 2021 roku, mająca na celu zwiększenie wydajności i elastyczności tworzenia aplikacji przyspieszanych przez GPU. |
| Diginetica | Diginetica | BRAK | Diginetica to oficjalny zestaw danych konkursowych CIKM (International Information Retrieval Conference) Cup z 2016 roku, który został wykorzystany w konkursie algorytmów CIKM do rozwiązania problemu spersonalizowanego wyszukiwania produktów w e-handlu z uwzględnieniem kontekstu wyszukiwania. Obecnie stał się on najważniejszym standardowym zestawem danych referencyjnych dla e-handlu w dziedzinie rekomendacji opartych na sesjach (SBR). |
| Nowplaying | Zenodo | BRAK | Jest to wielkoskalowy zestaw danych dotyczący zachowań słuchania muzyki, skonstruowany na podstawie analizy wpisów z tagiem „# nowplaying” w serwisie Twitter, wykorzystywany przede wszystkim w badaniach nad rekomendacjami konwersacyjnych dla muzyki, rekomendacjami uwzględniającymi kontekst oraz analizą korelacji sentymentu. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | BRAK | OriginPro to komercyjne profesjonalne oprogramowanie do rysowania naukowego i analizy danych opracowane przez OriginLab Corporation, powszechnie używane do tworzenia wykresów o jakości publikacyjnej, statystyki danych, dopasowania krzywych, przetwarzania sygnałów itp. W niniejszym artykule OriginPro został wykorzystany do narysowania wykresów porównawczych eksperymentów, wykresów liniowych oraz wykresów słupkowych. |
| PyTorch 1.11.0 | PyTorch Foundation | BRAK | PyTorch to otwartoźródłowy framework głębokiego uczenia dla uczenia maszynowego i głębokiego uczenia, wydany przez Facebook w 2016 roku. Implementuje on głównie automatyczne różniczkowanie i wprowadza dynamiczne grafy obliczeniowe, aby zwiększyć elastyczność budowania modeli. |
| TITAN V GPU | NVIDIA | BRAK | NVIDIA TITAN V to flagowa karta graficzna wprowadzona przez NVIDIA pod koniec 2017 roku, skierowana głównie do obszarów obliczeń o wysokiej wydajności i sztucznej inteligencji. |
| Tmall | Tmall | BRAK | W ramach konkursu rekomendacji Alibaba Tmall na IJCAI 2015, Alibaba Tianchi publicznie udostępniła zanonimizowane rzeczywiste logi online Tmall. Jest to jeden z trzech standardowych zestawów danych w dziedzinie SBR (Diginetica, Yoocoose, Tmall) i preferowany zestaw ewaluacyjny dla scenariuszy e-handlu w Chinach. |
| visio 2021 | Microsoft | BRAK | Visio to oprogramowanie do rysowania wektorowego opracowane przez Microsoft, używane do tworzenia schematów struktury modelu, schematów blokowych, diagramów ramowych, diagramów topologii sieci w artykułach naukowych oraz generowania rysunków wektorowych do ilustracji w publikacjach |
Bibliografia
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.