Niniejszy schemat postępowania integruje transkryptomikę masową oraz jednokomórkową z wstępnymi badaniami tkanek pacjentów w celu priorytetyzacji MMP1 w owrzodzeniu stopy cukrzycowej. MMP1 wykazało wzorzec ekspresji skoncentrowany na fibroblastach oraz wyższą obfitość w tkankach, co potwierdza związek z przebudową macierzy, pozostawiając jednak nierozstrzygniętą kwestię przyczynowości i użyteczności klinicznej.
Artykuł badawczy
Integracyjna transkryptomika populacyjna i jednokomórkowa z walidacją tkankową priorytetyzuje MMP1 w stopie cukrzycowej
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Komórkowe źródła powtarzalnych zmian transkryptomicznych w owrzodzeniach stopy cukrzycowej (DFU) pozostają nie do końca określone. W niniejszym badaniu zintegrowano analizę różnicowej ekspresji, analizę ważonej sieci koekspresji genów (WGCNA), screening genów związanych z cukrzycową neuropatią obwodową (DPN), eksploracyjny wybór cech metodami uczenia maszynowego, dwa zewnętrzne zbiory danych transkryptomicznych typu bulk, analizę pojedynczych komórek, analizę sieci tradycyjnej medycyny chińskiej (TCM) oraz ilościową reakcję polimerazy w łańcuchu (qPCR) i western blotting w tkankach pacjentów. W zbiorze GSE199939 (10 próbek DFU i 11 próbek kontrolnych) zidentyfikowano 3 691 genów o różnicowej ekspresji, a niebieski moduł WGCNA był silnie powiązany z DFU (r = 0,97, p = 5 × 10-13). Przecięcie genów o różnicowej ekspresji, genów hubowych niebieskiego modułu oraz 1 062 genów związanych z DPN pozwoliło wyłonić 77 kandydatów. Geny CCL7, CHEK1, MKI67, MMP1, MMP13 oraz TRPV2 zostały potwierdzone przez co najmniej dwie metody wyboru cech; całkowita separacja w rekurencyjnej eliminacji cech z wykorzystaniem maszyn wektorów nośnych wzbudziła obawy dotyczące przeuczenia (overfitting) kohorty odkrywczej. MMP1 wykazał największą zmianę ekspresji w kohorcie odkrywczej (log2 fold change = 9,854; skorygowane p = 1,24 × 10⁻²⁹). W połączonej macierzy GSE68183/GSE80178 MMP1 miał skorygowane p wynoszące 0,0159 oraz pole pod krzywą charakterystyki operacyjnej odbiornika (AUC) równe 0,981. W zbiorze GSE134431 ekspresja MMP1 była nominalnie wyższa w DFU niż w skórze stopy cukrzycowej bez owrzodzeń (p = 0,0225; skorygowane p = 0,135; AUC = 0,808). Analiza 69 944 komórek z 24 próbek wykazała najwyższą średnią ekspresję MMP1 w fibroblastach, przy czym wyższa ekspresja na poziomie próbek występowała w fibroblastach, keratynocytach i komórkach śródbłonka w DFU. Badania w tkankach pacjentów wykazały wyższą zawartość mRNA MMP1 w czterech dopasowanych parach (test sparowany dla ΔCq, p = 3,04 × 10⁻⁵) i wyższą zawartość białka w trzech dopasowanych parach (sparowane p = 0,0107). Replikacja statystyczna była niepełna. Wyniki sugerują związek z przebudową macierzy zorientowaną na fibroblasty, przy uwzględnieniu ograniczeń wynikających z użycia danych TPM w analizie odkrywczej opartej na zliczaniu, niepełnych zapisów preprocessingu pojedynczych komórek oraz małych kohort w badaniach tkankowych. Przyczynowość oraz użyteczność kliniczna pozostają nieustalone.
Wprowadzenie
Owrzodzenie stopy cukrzycowej jest poważnym i nawracającym powikłaniem cukrzycy, wynikającym z nałożenia się neuropatii, powtarzalnego obciążenia mechanicznego, choroby tętnic obwodowych, podatności na infekcje oraz upośledzonej regeneracji tkanek. Współczesne szacunki wskazują, że każdego roku problem ten dotyczy milionów ludzi na całym świecie, a proces gojenia jest często przedłużony, wiążąc się ze znacznym ryzykiem nawrotów, hospitalizacji, amputacji kończyn dolnych oraz zgonu1. Dlatego profilaktyka i leczenie zależą nie tylko od miejscowej pielęgnacji rany, ale także od identyfikacji utraty czucia ochronnego, zmniejszenia nacisku na podeszwę, leczenia infekcji i niedokrwienia oraz eliminacji systemowych czynników ryzyka1,2. Neuropatia obwodowa w cukrzycy jest szczególnie istotna, ponieważ postępująca dysfunkcja sensoryczna może ograniczyć świadomość nacisku, urazów i rozpadu tkanek, podczas gdy zaburzenia ruchowe i autonomiczne mogą dodatkowo zmieniać biomechanikę stopy i integralność skóry2,3. Na poziomie tkankowym uszkodzenie neuropatyczne może współistnieć z neurostanem zapalnym, dysfunkcją mikronaczyniową, stresem metabolicznym i wadliwą regeneracją, co tworzy środowisko rany, w którym uszkodzenia utrzymują się mimo standardowej opieki1,3.
Skuteczne gojenie skóry wymaga skoordynowanego stanu zapalnego, reepitelializacji, angiogenezy, aktywacji fibroblastów, odkładania macierzy pozakomórkowej (ECM) oraz następującego po nich przebudowy macierzy. W cukrzycy procesy te mogą stać się zdezorganizowane w czasie: sygnały zapalne mogą pozostać aktywne, migracja keratynocytów może być upośledzona, odpowiedzi śródbłonka mogą być niewystarczające, a fibroblasty mogą wytwarzać lub organizować nieprawidłową macierz. Fibroblasty odgrywają centralną rolę w stromalnej fazie naprawy, ponieważ syntetyzują białka macierzy, regulują architekturę kolagenu, komunikują się z komórkami odpornościowymi i nabłonkowymi oraz przyczyniają się do skurczu rany. Badania z wykorzystaniem fibroblastów z DFU pochodzących od pacjentów wykazały trwałe nieprawidłowości w transkrypcji związanej z ECM i montażu macierzy, co wspiera pogląd, że stan fibroblastów jest istotnym elementem biologii przewlekłych ran4. Metaloproteinazy macierzy (MMP) uczestniczą w tym procesie poprzez rozszczepianie substratów ECM, co umożliwia migrację komórek, wymianę tkanek i ich przebudowę; jednak ich działanie zależy od lokalizacji, czasu, dostępności substratu oraz regulacji przez tkankowe inhibitory metaloproteinaz (TIMP)5. Nierównowaga między proteolizą a zastępowaniem macierzy może zatem współistnieć z upośledzoną naprawą, ale zwiększona ekspresja pojedynczej MMP sama w sobie nie determinuje roli szkodliwej lub korzystnej. Zgłoszono, że metaloproteinaza macierzy 1 (MMP1), kolagenaza śródmiąższowa zdolna do udziału w wymianie kolagenu włóknistego, jest zmieniona w tkance DFU, a wcześniejsze badania kliniczne powiązały profile MMP/TIMP ze stanem rany lub trajektorią gojenia6,7. Obserwacje te uzasadniają dalsze badanie MMP1 w DFU.
Profilowanie transkryptomiczne zapewnia systematyczne podejście do identyfikacji programów molekularnych związanych z DFU, jednak kilka ograniczeń metodologicznych komplikuje interpretację. Zbiory danych z tkanek w skali zbiorczej (bulk-tissue) uśredniają sygnały z keratynocytów, fibroblastów, komórek śródbłonka, komórek odpornościowych i innych przedziałów, co utrudnia określenie, czy dany kandydat odzwierciedla zmienioną ekspresję w obrębie konkretnego typu komórek, zmiany w składzie komórkowym, czy oba te zjawiska. Porównywalność między zbiorami danych może być również ograniczona przez różnice w platformach, strategiach normalizacji, miejscach pobrania próbek tkanek, stopniu ciężkości owrzodzenia, stanie infekcji, stadium choroby oraz tkance referencyjnej. Co istotne, nieowrzodzona skóra stopy pacjenta z cukrzycą stanowi klinicznie istotny porównawczy materiał tkankowy z cukrzycą, ale nie jest ona zamienna ze skórą zdrową. Sekwencjonowanie RNA z pojedynczych komórek (single-cell RNA sequencing) może częściowo rozwiązać problem źródła komórkowego poprzez rozdzielenie heterogenicznych populacji komórek i ich stanów transkrypcyjnych. Wcześniejsze badanie transkryptomiki przestrzennej i pojedynczych komórek w DFU zidentyfikowało odrębne populacje fibroblastów i wykazało, że programy fibroblastów różnią się w zależności od kontekstu rany i stanu gojenia8. Wyniki te wspierają zastosowanie analizy z rozdzielczością do pojedynczych komórek jako uzupełnienia dla zbiorczych danych transkryptomicznych.
Metody selekcji cech mogą pomóc w ustaleniu priorytetów dla kandydatów z wysokowymiarowych danych ekspresyjnych, jednak biomedyczne badania na małych próbach są szczególnie podatne na optymistyczne szacunki i niestabilną selekcję genów. Gdy liczba mierzonych zmiennych znacznie przekracza liczbę próbek biologicznych, może dojść do pozornej idealnej separacji, nawet jeśli uogólnialne informacje predykcyjne są ograniczone. Ponowne wykorzystanie tych samych obserwacji do selekcji cech, strojenia parametrów i oceny wydajności dodatkowo zawyża AUC, co sprawia, że zagnieżdżona walidacja krzyżowa, zablokowane modele i rzeczywiście niezależne kohorty testowe są niezbędne do oceny wydajności predykcyjnej9,10. Kwestie te mają znaczenie w badaniach nad DFU, ponieważ publicznie dostępne kohorty są często małe i heterogeniczne. Bazy danych składników-celów-ziół tradycyjnej medycyny chińskiej zostały dodatkowo wykorzystane wyłącznie do generowania hipotez.
W niniejszym badaniu zintegrowano analizę transkryptomiczną typu bulk, WGCNA, screening genów związanych z DPN, selekcję cech metodami uczenia maszynowego, ocenę na zewnętrznych zbiorach danych, analizę jednokomórkową, analizę sieci TCM oraz walidację na tkankach pacjentów. Geny kandydackie zidentyfikowane w kohorcie odkrywczej oceniono w dodatkowych zbiorach danych transkryptomicznych, a główny kandydat został zlokalizowany w konkretnych typach komórek z wykorzystaniem danych jednokomórkowych. Następnie poziom mRNA i białka MMP1 w tkankach pacjentów zbadano za pomocą qPCR i western blottingu. Powyższy schemat został opracowany w celu zidentyfikowania powtarzalnego kandydata związanego z DFU oraz scharakteryzowania jego kontekstu komórkowego i biologicznego.
Protokół
Projekt badania i źródła danych
Badanie, obejmujące gromadzenie i wykorzystanie próbek tkanek pacjentów do walidacji metodą qPCR i western blot, zostało przeanalizowane i zatwierdzone przez Komisję Etyczną Szpitala Numer Cztery w Wuhan (numer zatwierdzenia KY2024-161-01). Wszystkie procedury z użyciem ludzkich tkanek zostały przeprowadzone zgodnie z zatwierdzonym protokołem i obowiązującymi zasadami etycznymi. Komponent transkryptomiczny badania opierał się na publicznie dostępnych, zanonimizowanych zestawach danych. Od wszystkich uczestników, których próbki tkanek zostały wykorzystane do walidacji eksperymentalnej, uzyskano pisemną świadomą zgodę. Publicznie dostępne zestawy danych transkryptomicznych analizowano w formie zanonimizowanej, a procedury uzyskiwania zgód dla oryginalnych badań, w których dane te wygenerowano, były realizowane przez odpowiednie instytucje.
W niniejszym badaniu zintegrowano transkryptomikę masową, analizę sieci, selekcję cech, analizę pojedynczych komórek, predykcję sieci TCM oraz walidację w tkankach pacjentów. Kohorta odkrywcza obejmowała zbiór danych Gene Expression Omnibus (GEO) GSE199939 (10 próbek DFU i 11 próbek kontrolnych). Zewnętrzna ocena transkryptomiczna obejmowała połączoną macierz GSE68183/GSE80178 (9 próbek DFU i 6 próbek kontrolnych) oraz GSE134431 (13 próbek DFU i 8 próbek skóry stopy cukrzycowej bez owrzodzeń [DFS]). Analiza pojedynczych komórek wykorzystywała wstępnie przetworzony, adnotowany za pomocą SingleR obiekt Seurat pochodzący z GSE165816, obejmujący 69 944 komórek z 24 próbek (14 DFU i 10 kontrolnych). Ocena tkanek obejmowała cztery dopasowane pary pacjentów (DFU–otoczenie rany) do analizy qPCR oraz trzy dopasowane pary do western blottingu, w oparciu o odzyskane zapisy z analiz i potwierdzone przez autorów dopasowanie. Wszystkie materiały i sprzęt wykorzystane w tym badaniu zostały wymienione w Tabeli materiałów.
Konstrukcja zestawu genów powiązanych z DPN
Geny powiązane z DPN pobrano z bazy danych genów National Center for Biotechnology Information (NCBI) za pomocą narzędzia rentrez. Terminy wyszukiwania obejmowały „diabetic peripheral neuropathy”, „diabetic neuropathy”, „diabetic polyneuropathy”, „painful diabetic neuropathy” oraz „diabetic sensorimotor polyneuropathy”, z ograniczeniem do Homo sapiens. Uzyskane identyfikatory przypisano do oficjalnych symboli genów, przekształcono na wielkie litery, oczyszczono i usunięto duplikaty. Geny pochodzące z bazy danych połączono z listą genów DPN opracowaną na podstawie literatury i usunięto duplikaty, co pozwoliło uzyskać 1 062 genów powiązanych z DPN. Pełne frazy wyszukiwania oraz kod do oczyszczania identyfikatorów zawarto w towarzyszących skryptach; obejmują one również neuropatie cukrzycowe, cukrzycę w połączeniu z dystalną symetryczną polineuropatią lub neuropatią obwodową, a także termin MeSH „Diabetic Neuropathies”. Komponent pochodzący z literatury nadal wymaga potwierdzenia pochodzenia na poziomie cytowań.
Wstępne przetwarzanie kohorty odkrywczej i analiza różnicowej ekspresji
Macierz ekspresji GSE199939 została dopasowana do tabeli fenotypów na podstawie identyfikatora próbki. Powielone identyfikatory genów uczyniono unikalnymi. W archiwalnej analizie odkrywczej wartości ekspresji zostały zaokrąglone, a następnie dopasowano model dwumianowy ujemny przy użyciu oprogramowania DESeq2 (wersja 1.48.2), przyjmując grupę jako czynnik projektu oraz kontrast DFU względem kontroli. Geny z brakującymi skorygowanymi wartościami p zostały wykluczone. Wielokrotne testowanie kontrolowano za pomocą procedury Benjamini–Hochberg (BH). W archiwalnej liście genów różnicowo wyrażonych (DEG) zastosowano kryteria: wartość bezwzględna log2 fold change większa niż 1 oraz wartość p skorygowana metodą BH < 0,05. Porównanie z publicznym źródłem GEO potwierdziło, że danymi wejściowymi były wartości TPM, a nie surowe liczby odczytów. Zaokrąglanie TPM nie spełnia wymogu surowych liczb odczytów (raw-count) wymaganych przez DESeq2. Oryginalne szacunki zostały zachowane, jednak poprawność statystyk odkrywczych oraz zależnych od nich wyników WGCNA i selekcji cech pozostaje nieustalona do czasu przeprowadzenia odpowiedniej reanalizy. Porównanie źródeł zostało udokumentowane w archiwum uzupełniającym.
W celu wizualizacji zastosowano transformację stabilizującą wariancję (VST) z pakietu DESeq2 z parametrem blind = FALSE. Analizę głównych składowych (PCA) przeprowadzono na macierzy ekspresji poddanej transformacji VST. Mapa ciepła wykorzystywała wartości z obliczone dla każdego wiersza dla 50 genów o najniższych skorygowanych wartościach p. Implementacja PCA centrowała i skalowała przekształcone wartości dla poszczególnych genów przy użyciu funkcji prcomp z parametrem scale. = TRUE.
Ważona analiza sieci koekspresji genów
W analizie WGCNA zachowano geny z liczbą zliczeń większą niż 5 w co najmniej trzech próbkach GSE199939. Czynniki skali (size factors) oszacowano za pomocą DESeq2, zastosowano transformację VST z parametrem blind = TRUE, a następnie wybrano 5 000 genów o największej wariancji między próbkami. Jakość próbek i genów oceniono za pomocą funkcji goodSamplesGenes, a do oceny jakości na poziomie próbek wykorzystano hierarchiczne grupowanie z metodą średniej (average-linkage hierarchical clustering).
Sieć podpisana została skonstruowana przy użyciu pakietu WGCNA (wersja 1.74). Potencjalne wartości potęg od 1–10 i 12–30 w przyrostach co 2 oceniono za pomocą funkcji pickSoftThreshold; przyjęto docelową wartość dopasowania topologii bezskalowej na poziomie 0,85, a wybraną potęgę miękkiego progowania (soft-thresholding power) ustalono na 18. Moduły zidentyfikowano za pomocą funkcji blockwiseModules, stosując podpisaną macierz sąsiedztwa i podpisaną macierz nakładania topologicznego (signed topological overlap matrix), korelację Pearsona, minimalną wielkość modułu wynoszącą 30, wysokość cięcia do scalania (merge cut height) 0,25, próg ponownego przypisania 1 × 10⁻⁶, pamRespectsDendro = FALSE oraz maksymalną wielkość bloku 10 000.
Eigengeny modułów korelowano z binarną cechą DFU. Moduły nieszare o wartościach |r| > 0,5 oraz p < 0,05 uznano za powiązane z DFU. Dla każdego powiązanego modułu istotność genów (GS) zdefiniowano jako korelację Pearsona między ekspresją genów a statusem DFU, a przynależność do modułu (MM) jako korelację Pearsona między ekspresją genów a odpowiadającym im eigengenem modułu. Geny kluczowe (hub genes) określono jako te, dla których |MM| > 0,8 oraz |GS| > 0,5. Do dalszej analizy wybrano moduł niebieski, który wykazał najsilniejszy pozytywny związek z DFU. Jego geny kluczowe zestawiono z genami różnicowo wyrażonymi (DEGs) oraz zestawem genów związanym z DPN. Zgłoszony próg dla genów kluczowych opiera się zatem na wartościach bezwzględnych zarówno MM, jak i GS, niezależnie od znaku korelacji.
Priorytetyzacja cech w oparciu o uczenie maszynowe
77 genów wspólnych dla zestawów genów DEG, genów hubowych modułu niebieskiego oraz genów związanych z DPN oceniono w zbiorze GSE199939. Duplikaty symboli genów zostały zredukowane poprzez obliczenie ich średniej ekspresji. Matryca genów kandydatów została poddana transformacji log2, gdy wartość maksymalna przekroczyła 50; usunięto cechy o zerowej wariancji, a pozostałe cechy zestandaryzowano. Zastosowano ziarno losowości 123. Wdrożona sekwencja obejmowała przesiewanie kandydatów w całej kohorcie, redukcję duplikatów symboli, warunkową transformację logarytmiczną, filtrowanie cech o zerowej wariancji, centrowanie i skalowanie dla pełnej kohorty oraz specyficzną dla algorytmu selekcję cech. Przesiewanie DEG i WGCNA przeprowadzono na pełnej kohorcie odkrywczej przed walidacją krzyżową na poziomie algorytmu. Opisany schemat postępowania nie ustanawia zatem zagnieżdżonej walidacji wolnej od wycieku danych (leakage), a wewnętrzne wartości AUC nie mogą być używane jako nieobciążone szacunki wydajności predykcyjnej.
Zastosowano trzy procedury selekcji cech. Po pierwsze, dopasowano regresję logistyczną metodą LASSO (least absolute shrinkage and selection operator) przy użyciu pakietu glmnet (wersja 5.0), z rodziną dwumianową (binomial family), alpha = 1, błędem klasyfikacji jako miarą walidacji krzyżowej, bez dodatkowej standaryzacji oraz pięciokrotną walidacją krzyżową ograniczoną przez rozmiar mniejszej klasy. Wybrano cechy przy wartości lambda.1se; lambda.min stosowano tylko w przypadku, gdy lambda.1se nie wybrała żadnego genu. Po drugie, przy użyciu pakietu randomForest (wersja 4.7-1.2) dopasowano las losowy składający się z 1000 drzew; zachowano geny, dla których średni spadek indeksu Giniego był co najmniej tak duży, jak średnia istotność wszystkich genów kandydackich. Po trzecie, zaimplementowano rekurencyjną eliminację cech z wykorzystaniem liniowej maszyny wektorów nośnych (SVM-RFE) za pomocą pakietu e1071 (wersja 1.7-17), szeregując cechy według kwadratu wagi liniowej dla całej kohorty przed oceną sukcesywnie mniejszych podzbiorów cech za pomocą AUC w walidacji krzyżowej z pominięciem jednej próbki (LOOCV). Ranking nie był przeliczany w obrębie każdego folderu treningowego. Dopasowanie liniowego SVM przeprowadzono z parametrami scale = FALSE oraz probability = TRUE, bez jawnej siatki strojenia kosztów. Wybór kary LASSO opierał się na wewnętrznej walidacji krzyżowej bez oddzielnej zewnętrznej pętli oceny, a istotność w lasie losowym obliczono dla całej kohorty.
Żaden gen nie został wybrany przez wszystkie trzy metody; zatem zachowano geny wspierane przez co najmniej dwie metody. SVM-RFE uzyskał wartość AUC wynoszącą 1,00 dla wszystkich ocenianych rozmiarów podzbiorów, wybrano natomiast najmniejszy z równorzędnych podzbiorów. Ponieważ ta całkowita separacja wzbudziła obawy dotyczące przeuczenia (overfitting) i zbyt optymistycznej oceny w małej kohorcie odkrywczej, wartość AUC dla SVM-RFE nie była interpretowana jako szacunek wydajności klinicznej. Żaden zablokowany model wielogenowy nie został przetestowany w kohorcie zewnętrznej; analizy zewnętrzne charakterystyki operacyjnej odbiornika (ROC) oceniały ekspresję poszczególnych genów kandydackich. Analiza skryptu potwierdziła, że przetwarzanie wstępne oraz ranking cech SVM nie były ograniczone do fałdów treningowych. Te same wyniki LOOCV wykorzystano do wyboru rozmiaru podzbioru, bez zastosowania zewnętrznej pętli ewaluacyjnej. W konsekwencji, ten przepływ pracy zawiera wyciek informacji (information leakage) i służy jedynie do eksploracyjnej priorytetyzacji cech.
Analiza wzbogacenia funkcjonalnego
Przeprowadzono analizy nadreprezentacji ontologii genów (GO) oraz Kyoto Encyclopedia of Genes and Genomes (KEGG) dla panelu sześciu genów. Symbole genów przyporządkowano do identyfikatorów Entrez za pomocą org.Hs.eg.db (wersja 3.21.0). Analizę GO wykonano przy użyciu clusterProfiler (wersja 4.16.0) w obrębie ontologii procesu biologicznego, komponentu komórkowego i funkcji molekularnej. Do wzbogacenia KEGG wykorzystano kod organizmu ludzkiego (hsa). Terminy istotne zdefiniowano jako nominalne p < 0,05 oraz p skorygowane metodą BH < 0,05. Ze względu na uwzględnienie tylko sześciu genów, analiza wzbogacenia służyła przede wszystkim do adnotacji funkcjonalnej. Skrypt KEGG wykorzystywał lokalne adnotacje KEGG.db z funkcją enrichKEGG(use_internal_data = TRUE); wersja adnotacji musi zostać udokumentowana. Skrypty GO i KEGG nie zawierały niestandardowego uniwersum, zatem bazy adnotacji zdefiniowały domyślne tła.
Zewnętrzna ocena transkrypcyjna populacyjna
W przypadku scalonej macierzy GSE68183/GSE80178 symbole genów zostały ustandaryzowane, a duplikaty symboli zredukowano poprzez obliczenie średniej ekspresji dla odpowiadających sobie wierszy. Sześć genów kandydackich dopasowano do pliku fenotypów. Ponieważ dostępne pliki nie dokumentowały w pełni procedury wstępnego scalania i korekcji efektu seryjnego (batch correction), zestaw danych ten analizowano w formie dostarczonej i interpretowano z ostrożnością. W konsekwencji, na podstawie dostarczonego zapisu przetwarzania nie można potwierdzić ani usunięcia efektów seryjnych, ani niezależności sygnału grupowego od efektów badania. Macierz ta stanowi eksploracyjne wsparcie międzyzbiorowe, a nie ostateczną replikację.
W przypadku zbioru GSE134431 sześć genów kandydackich wyekstrahowano z macierzy liczby odczytów na kilobazę na milion zmapowanych odczytów (RPKM) i przekształcono jako log2(RPKM + 1). Jako grupę referencyjną przyjęto DFS, a jako grupę porównawczą DFU. DFS oznacza skórę stopy cukrzycowej bez owrzodzeń. Pierwotnie przesłana Rycina 4C przedstawiała surowe wartości RPKM; zaktualizowany panel wykorzystuje wskazaną skalę log2(RPKM + 1). Dwustronne testy Wilcoxona z przybliżeniem normalnym i poprawką na ciągłość oraz automatycznie zorientowane analizy ROC zostały zweryfikowane w obu skalach i dały identyczne wartości p oraz AUC, ponieważ przekształcenie jest ściśle monotoniczne.
W obrębie każdego zbioru danych walidacji masowej różnice w ekspresji między grupami testowano za pomocą dwustronnych testów sum rang Wilcoxona, a w odniesieniu do sześciu genów zastosowano korekcję BH. Krzywe ROC obliczono przy użyciu pakietu pROC (wersja 1.19.0.1), stosując kierunek wybrany automatycznie przez oprogramowanie. Obliczono wartości AUC oraz odpowiadające im 95% przedziały ufności (CIs), aby porównać wzorce dyskryminacyjne w różnych zbiorach danych. Automatyczny wybór kierunku ROC z każdego zbioru danych oceniających może prowadzić do optymistycznej oceny dyskryminacji; te wartości AUC dla pojedynczych genów mają charakter opisowy i nie służą do walidacji wcześniej określonego klinicznego modelu predykcyjnego.
Lokalizacja na poziomie pojedynczych komórek i analiza na poziomie próbek
Analiza pojedynczych komórek została przeprowadzona z wykorzystaniem zapisanego obiektu Seurat biofsci_SingleR_annotated_MMP1_analyzed.rds z zestawu GSE165816, zawierającego 22 889 genów i 69 944 komórki w analizie RNA. Analiza RNA zachowała warstwę nieujemnych liczb całkowitych (non-negative integer counts layer) oraz warstwę danych wygenerowaną za pomocą LogNormalize ze współczynnikiem skalowania 10 000, a następnie transformacją log1p; ta ostatnia nie była TPM. Obiekt zawierał 2 000 genów zmiennych wybranych metodą vst (loess.span = 0.3; 20 przedziałów o równej szerokości), przeskalowaną ekspresję dla wszystkich zachowanych genów (włączone centrowanie i skalowanie; scale.max = 10) oraz 50 głównych składowych obliczonych z cech zmiennych z ziarnem (seed) 42. Zapisana historia poleceń wykorzystywała wymiary Harmony 1–20 do konstrukcji najbliższych sąsiadów oraz przybliżonej i rzutowanej projekcji rozmaitości jednorodnej (UMAP). Ustawienia sąsiadów obejmowały k = 20, Annoy z 50 drzewami i odległością euklidesową oraz próg przycinania wspólnych najbliższych sąsiadów (SNN) wynoszący 1/15. Do klasteryzacji użyto rozdzielczości 0.8, algorytmu 1, n.start = 10, n.iter = 10 oraz random.seed = 0. W UMAP zastosowano implementację uwot, 30 sąsiadów, dwa wymiary wyjściowe, metrykę odległości cosinusowej, min.dist = 0.3, spread = 1, learning.rate = 1 oraz ziarno 42. Obiekt zachował redukcję Harmony, jednak oryginalne progi kontroli jakości, pełne wywołanie RunHarmony wraz z kowariantami partii oraz ustawienia referencyjne i adnotacyjne SingleR dla tego analizowanego obiektu nie mogły zostać odzyskane. Etykiety typów komórek, etykiety grup i identyfikatory próbek były przechowywane odpowiednio w SingleR_label, Group oraz orig.ident. Zachowano dziesięć adnotowanych typów komórek: limfocyty B, limfocyty T CD8+, komórki śródbłonka, komórki nabłonkowe, fibroblasty, hematopoetyczne komórki macierzyste, keratynocyty, makrofagi, monocyty oraz neurony.
MMP1 ekspresja została podsumowana z podziałem na typy komórek. Komórki z znormalizowaną ekspresją MMP1 większą od zera sklasyfikowano jako MMP1-dodatnie. Do analizy na poziomie próbek obliczono średnią znormalizowaną ekspresję dla każdej kombinacji próbka-typ komórki. Próbki DFU oraz kontrolne porównano w obrębie każdego typu komórek za pomocą dwustronnych testów sum rang Wilcoxona, a następnie zastosowano korektę BH dla wszystkich badanych typów komórek. Jednostką wykorzystaną w raportowanych porównaniach był numer dostępu do próbki w bazie GEO, a nie pojedyncza komórka. 24 numery dostępu nie zostały potraktowane jako dowód pochodzenia od 24 niezależnych dawców. Zapisany obiekt nie zawierał zweryfikowanego identyfikatora dawcy, a wielokrotne pobieranie tkanek od tych samych dawców nie zostało uwzględnione w modelu; w związku z tym testy na poziomie próbek interpretuje się jako wstępne. Powyższe podsumowania stanowią średnią znormalizowanej ekspresji w obrębie próbki i typu komórek; nie są one modelami różnicowej ekspresji pseudobulk opartymi na sumowaniu liczby odczytów.
Dziesięć funkcjonalnych zestawów genów oceniono za pomocą funkcji Seurat AddModuleScore. Obliczono korelacje Spearmana między ekspresją MMP1 w poszczególnych komórkach a wynikami modułów, a następnie zastosowano korektę BH. Do eksploracyjnej analizy wysokiej ekspresji MMP1 wybrano trzy typy komórek z najwyższą średnią ekspresją MMP1 spośród typów zawierających co najmniej 50 komórek. Globalny próg określono jako medianę ekspresji wśród komórek MMP1-dodatnich, jeżeli dostępnych było więcej niż 10 komórek dodatnich; w przeciwnym razie skrypt wykorzystał ogólny 75. percentyl. Komórki powyżej tego progu przypisano do grupy MMP1-high, a pozostałe do grupy MMP1-low. Funkcja FindMarkers wykorzystywała test Wilcoxona, logfc.threshold = 0,25 oraz min.pct = 0,1. Geny z nadekspresją przy skorygowanej wartości p < 0,05 poddano analizie wzbogacenia procesów biologicznych GO. Ponieważ grupy zostały zdefiniowane na podstawie ekspresji MMP1, analiza ta posłużyła do opisania szlaków związanych ze stanem MMP1-high. Korelacje dla poszczególnych komórek, ich skorygowane wartości p oraz wzbogacenie w grupie MMP1-high względem MMP1-low mają charakter opisowy, ponieważ nie modelowano zależności wewnątrzpróbkowej. Pojedyncze komórki nie były interpretowane jako niezależne powtórzenia biologiczne.
Przewidywanie zależności składnik-cel-zioło w TCM
Sześć priorytetowych genów dopasowano do kolumny 4 lokalnej tabeli interakcji chemicznych i genów w bazie Comparative Toxicogenomics Database (CTD). W kolumnie 7 ograniczono rekordy do Homo sapiens. Nazwy składników zostały przycięte i znormalizowane do małych liter w celu dopasowania, a następnie usunięto powtarzające się mapowania składnik-cel oraz zioło-składnik. Składniki powiązano z ziołami przy użyciu referencyjnej tabeli zioło-składnik. W procesie wzbogacania bazy danych zastosowano nominalne p < 0,05 oraz skorygowane p < 0,05. Przed podsumowaniem opartym na pokryciu usunięto powtarzające się rekordy zioło-składnik-cel. Do wzbogacania ziół wykorzystano funkcję clusterProfiler::enricher z mapowaniem zioło-składnik jako TERM2GENE, przy parametrach minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 oraz qvalueCutoff = 1 przed zastosowaniem nominalnych i skorygowanych metodą BH progów istotności. Powiązania bazodanowe te mogą opisywać zmiany w ekspresji lub aktywności i nie potwierdzają bezpośredniego wiązania ani jednokierunkowego efektu.
Zioła uszeregowano przy użyciu następującego wyniku pokrycia:
S = 3R + 5L +2T + 3C + 2I + N (1)
W tym przypadku R to liczba rekordów MMP1, L to liczba składników powiązanych z MMP1, T to liczba objętych celów, C to liczba składników rdzeniowych, I to wskaźnik osi macierzy, a N to całkowita liczba składników.
Głównymi składnikami były kwercetyna, luteolina i berberyna. Wskaźnik osi macierzy ustawiono na 1, gdy zioło obejmowało zarówno MMP1, jak i MMP13, a w przeciwnym razie na 0. Wymagano, aby zioła kandydujące zawierały co najmniej jeden wpis powiązany z MMP1 oraz albo co najmniej dwa składniki powiązane z MMP1, albo co najmniej cztery cele i jeden główny składnik. Wynik posłużył do podsumowania zakresu bazy danych i nie był traktowany jako miara skuteczności farmakologicznej. Współczynniki definiują niestandardową, heurystyczną regułę zakresu, która kładzie nacisk na wpisy i składniki powiązane z MMP1, szerszy zakres celów, trzy wyznaczone składniki oraz wspólny zakres MMP1/MMP13. Nie zostały one dopasowane do wyników klinicznych ani zweryfikowane eksperymentalnie, a zastosowanie alternatywnych wag mogłoby zmienić ranking ziół.
Pobieranie tkanek pacjentów oraz wstępna ocena za pomocą qPCR i western blot
Pacjenci z klinicznie zdiagnozowanymi owrzodzeniami stopy cukrzycowej, którzy zostali poddani klinicznie wskazanemu oczyszczeniu rany lub operacji w Szpitalu Wuhan Fourth, kwalifikowali się do badania w przypadku dostępności tkanki stopy oraz uzyskania pisemnej świadomej zgody. Kryteria wykluczenia obejmowały nowotwór w miejscu pobrania próbki, niedcukrzycową przyczynę owrzodzenia lub niewystarczającą ilość bądź jakość tkanki do planowanych analiz. Tkankę DFU oraz tkankę nieowrzodzenia otaczającą ranę pobrano od tego samego pacjenta zgodnie z zatwierdzonym protokołem badania. Ta druga służyła jako dopasowany komparator okołoranowy; nie była to zdrowa skóra osoby bez cukrzycy. Ocena qPCR obejmowała cztery dopasowane pary (cztery próbki DFU i cztery odpowiadające im próbki okołoranowe), a western blotting obejmował trzy dopasowane pary. Dopasowanie zostało potwierdzone przez autorów dla każdego testu; tożsamość międzytestowa nie była wykorzystywana w porównaniach statystycznych. Każdy pacjent stanowił jednostkę biologiczną, a techniczne studzienki PCR były pomiarami powtórzonymi w obrębie jednej próbki. Wstępne analizy te miały na celu ocenę ekspresji MMP1 na poziomie tkankowym i nie były zaprojektowane w celu ustalenia wydajności diagnostycznej, przyczynowości ani uogólnialności wyników w różnych fenotypach DFU.
W celu walidacji qPCR, całkowite RNA wyekstrahowano z próbek tkanek pochodzących od pacjentów przy użyciu odczynnika do ekstrakcji całkowitego RNA zgodnie z instrukcjami producenta. Stężenie i czystość RNA oceniono spektrofotometrycznie; do dalszych analiz wykorzystano próbki o stosunku A260/A280 w zakresie 1,8–2,1. Całkowite RNA (1 µg) poddano odwrotnej transkrypcji przy użyciu zestawu do odwrotnej transkrypcji Moloney murine leukemia virus (M-MLV) w końcowej objętości reakcji 20 µL. Dostępny projekt instrumentu identyfikuje system PCR w czasie rzeczywistym. Ilościowy PCR przeprowadzono z użyciem 2x SYBR Green PCR master mix w reakcji o objętości 20 µL zawierającej 10 µL 2x SYBR Green master mix, po 0,4 µL startera forward oraz reverse, 2 µL komplementarnego DNA (cDNA) oraz 7,2 µL wody wolnej od nukleaz. Program amplifikacji obejmował wstępną denaturację w 95 °C przez 30 s, a następnie 40 cykli: 95 °C przez 5 s i 60 °C przez 30 s. W celu weryfikacji swoistości amplifikacji przeprowadzono analizę krzywej topnienia. Obfitość transkryptu MMP1 mierzono z użyciem β-aktyny (ACTB) jako genu referencyjnego. Sekwencje starterów wymieniono w Tabeli 1. W przypadku skorygowanej analizy parowanej, wartości z pięciu studni technicznych na cel w każdej próbce uśredniono przed obliczeniem ΔCq, a względną ekspresję MMP1 obliczono metodą 2-ΔΔCq , przyjmując grupę nieowrzodziało tkanki okołoranowej jako kalibrator. Odzyskane pary próbek to NC–DFU, NC1–DFU1, NC2–DFU2 oraz NC3–DFU3, potwierdzone przez autorów jako cztery pary dopasowane do pacjentów. Poprzedny wykres qPCR wykorzystywał wartości z pięciu studni technicznych tylko dla NC i DFU; skorygowany wykres przedstawia jedną wartość na poziomie próbki po uśrednieniu studni technicznych dla każdej z czterech par. Wnioskowanie parowane oparto na ΔCq = średnie Cq(MMP1) − średnie Cq(ACTB), a nie na wartościach krotności zmiany (fold-change) na poziomie studni. Zarchiwizowane dane instrumentu różnią się również od zgłoszonej objętości reakcji i programu cykli, a ich zgodność z przedstawionym eksperymentem pozostaje nieustalona.
W celu walidacji metodą western blot (WB), próbki tkanek homogenizowano w lodowatym buforze do radioimmunoprecypitacji uzupełnionym o inhibitory proteaz. Lizaty inkubowano na lodzie przez 30 min, a następnie odwirowano przy 12 000 x g przez 15 min w temperaturze 4 °C. Zebrano nadsącz, a stężenia białek określono za pomocą testu kwasu bicinchonininowego. Równye ilości białka (20 µg na ścieżkę) rozdzielano na żelach gradientowych 4%–20% SDS-PAGE (poliakrylamid z dodecylosiarczanem sodu) i przeniesiono na membrany z polifluorku winylidenu o rozmiarze porów 0,22 µm. Membrany blokowano 5% beztłustym mlekiem w buforze TBS (tris-buffered saline) zawierającym 0,1% Tween-20 przez 1 h w temperaturze pokojowej, a następnie inkubowano przez noc w 4 °C z poliklonalnym przeciwciałem przeciwko MMP1 (1:1 000) oraz poliklonalnym przeciwciałem przeciwko kofilinie (1:6 000). Po trzech przemyciach buforem TBS z 0,1% Tween-20, membrany inkubowano przez 1 h w temperaturze pokojowej z przeciwciałem kozim anty-króliczym przeciwko immunoglobulinie G (IgG) sprzężonym z peroksydazą chrzanową (1:5 000). Prążki białkowe wizualizowano przy użyciu wzmocnionego substratu chemiluminescencyjnego i obrazowano za pomocą systemu obrazowania chemiluminescencyjnego z wykorzystaniem odpowiedniego oprogramowania operacyjnego (wersja 1.2.0), zgodnie z zapisem w metadanych obrazu. Prążki ilościowo określono przy użyciu oprogramowania ImageJ. Kofilinę zastosowano jako kontrolę ładunku, a zawartość białka MMP1 znormalizowano względem kofiliny w celu porównania między grupami.
Analiza statystyczna i oprogramowanie
Wszystkie testy były obustronne, chyba że zaznaczono inaczej. Jako główny próg dla wielokrotnego testowania przyjęto p < 0,05 skorygowane metodą BH. Dokładne liczebności próby różniły się w zależności od zbioru danych, a w przypadku analizy na poziomie pojedynczych komórek — w zależności od obecności danego typu komórek w każdej próbce. Podsumowania ekspresji ciągłej przedstawiono jako poszczególne obserwacje z wykresami pudełkowymi obrazującymi medianę oraz rozstęp międzykwartylowy; wąsy sięgają 1,5-krotności rozstępu międzykwartylowego. W przypadku western blottingu sześć uzyskanych stosunków MMP1 do kofiliny przeanalizowano za pomocą obustronnego sparowanego testu t na trzech parach pacjentów potwierdzonych przez autorów (df = 2; p = 0,0107). W przypadku qPCR pięć wartości Cq dla ACTB oraz pięć dla MMP1 wyciągnięto osobno w obrębie każdego preparatu przed obliczeniem ΔCq. Obustronny sparowany test t porównał wartości ΔCq dla DFU oraz dopasowanych tkanek okołoranowych w czterech parach pacjentów potwierdzonych przez autorów (df = 3; p = 3,04 × 10⁻⁵). Średnie ΔCq tkanek okołoranowych posłużyło jako wspólny kalibrator dla prezentacji ekspresji względnej. Geometryczną średnią krotności zmiany w obrębie pacjenta oraz 95% CI uzyskano poprzez odwrócenie transformacji średniej sparowanej różnicy ΔCq i jej przedziału ufności opartego na teście t. Poszczególne obserwacje biologiczne przedstawiono za pomocą linii łączących dopasowane tkanki; powtórzenia techniczne nie zwiększają biologicznej liczebności próby. Wartości p dla analiz tkanek są nominalne i mają charakter eksploracyjny. Przy trzech lub czterech pacjentach nie można wiarygodnie ocenić normalności różnic sparowanych, a wyniki analiz pozostają wstępne. Analizy bioinformatyczne i generowanie rycin wykonano w programie R 4.5.2 w systemie Windows 11. Wersje głównych pakietów obejmowały DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 oraz ggplot2 4.0.3. Skonsolidowany spis oprogramowania, baz danych i parametrów znajduje się w Supplementary Table 1.
Wyniki
Transkryptomika odkrywcza identyfikuje szeroki program ekspresji związany z DFU
Zbiór GSE199939 posłużył jako kohorta odkrywcza i obejmował 10 próbek z DFU oraz 11 próbek kontrolnych (Rysunek 1A). Analiza głównych składowych ekspresji znormalizowanej metodą VST wykazała wyraźny podział grup; główne składowe 1 i 2 wyjaśniały odpowiednio 34,8% i 15,1% całkowitej wariancji (Rysunek 1B).
Użycie |log2 krotność zmiany > 1 i skorygowane metodą BH p < 0,05; analiza różnicowej ekspresji zidentyfikowała 3691 DEG, w tym 1247 genów o zwiększonej ekspresji w DFU oraz 2444 genów o zmniejszonej ekspresji w DFU (Rycina 1C). 50 najważniejszych DEG utworzyło wzorzec ekspresji o silnej strukturze grupowej (Rycina 1D). spośród sześciu genów wybranych w dalszej kolejności, MMP1 wykazało największą zmianę w kohorcie odkrywczej (log2 zmiana krotności (fold change) = 9,854; skorygowana p = 1.24 × 10⁻²⁹).
Moduł koekspresji związany z DFU pokrywa się z DEG i genami związanymi z DPN
Analizę WGCNA przeprowadzono na 5 000 najbardziej zmiennych genach poddanych transformacji VST. Dla sieci podpisanej wybrano wartość miękkiego progu odcięcia (soft-thresholding power) równą 18, aby zrównoważyć dopasowanie do topologii bezskalowej i łączność (Rysunek 2A). Klasteryzacja hierarchiczna i dynamiczne wykrywanie modułów pozwoliły na zidentyfikowanie wielu modułów koekspresji (Rysunek 2B). Moduł niebieski wykazał najsilniejszą pozytywną korelację z DFU (Pearson r = 0,97, p = 5 × 10-13; Rysunek 2C). Odpowiednie podsumowania kontroli jakości dotyczące klasteryzacji próbek oraz wielkości modułów przedstawiono na Rysunku dodatkowym 1A,B.
W obrębie modułu niebieskiego 689 genów spełniło kryteria węzłów (hubs) |MM| > 0,8 oraz |GS| > 0.5 (Rycina 2D). Przecięcie 3691 DEG, 689 genów węzłowych modułu niebieskiego oraz 1062 genów związanych z DPN pozwoliło na wyłonienie 77 wspólnych genów kandydackich (Rycina 2E). Uproszczony widok sieci hubów modułu niebieskiego oraz statystyki najwyżej sklasyfikowanych hubów przedstawiono w Rycina uzupełniająca 2A, B.
Wielometodowa selekcja cech priorytetyzuje sześć genów, ale wykazuje przeuczenie w kohorcie odkrywczej
Analizę 77 wspólnych genów przeprowadzono przy użyciu metod LASSO, lasów losowych (random forest) oraz SVM-RFE. Metoda LASSO przy wybranej karze pozwoliła wyłonić siedem genów: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67i CHEK1 (Rycina 3A). Filtrowanie metodą lusu losowego (random forest) pozwoliło na zachowanie 41 genów o istotności równej lub wyższej od średniej, w tym pięciu członków końcowego panelu spośród najwyżej sklasyfikowanych cech (Rysunek 3B). Metoda SVM-RFE uzyskała wartość AUC równą 1,00 dla każdego ocenionego zagnieżdżonego podzbioru; zgodnie z regułą rozstrzygania remisów na rzecz najmniejszego rozmiaru, CHEK1 wybrano jako podzbiór jedno genowy (Rycina 3C), co budzi obawy dotyczące przeuczenia modelu oraz zbyt optymistycznej oceny w kohorcie odkrywczej. Odpowiednie wykresy ekspresji, mapa ciepła oraz krzywe ROC dla kohorty odkrywczej przedstawione są w Rycina uzupełniająca 3A–C.
Żaden gen nie został wybrany przez wszystkie trzy metody. Zachowanie genów wspartych przez co najmniej dwie metody pozwoliło wyłonić CCL7, CHEK1, MKI67, MMP1, MMP13 oraz TRPV2 (Rycyna 3D). Adnotacja GO tych sześciu genów wykazała funkcje związane z demontażem macierzy zewnątrzkomórkowej, procesami katabolicznymi i metabolicznymi kolagenu, kondensacją chromosomów oraz funkcjami metaloendopeptydazy (wszystkie p po korekcie BH < 0,05; Rycina 3E). Analiza KEGG zidentyfikowała sygnalizację interleukiny-17 (IL-17) (CCL7/MMP1/MMP13; skorygowane p = 1,81 × 10⁻⁴) oraz sygnalizację relaksyny (MMP1/MMP13; skorygowane p = 0,0175; Rycina 3F). Wyniki wzbogacenia zostały wykorzystane do scharakteryzowania funkcji biologicznych reprezentowanych przez panel sześciu genów.
Ocena międzyzbiorowa wykazuje niejednorodne wsparcie dla MMP1
W połączonej macierzy GSE68183/GSE80178 (9 DFU i 6 kontroli), poziomy CCL7, MMP1 i MMP13 różniły się między grupami po korekcie BH dla sześciu genów (skorygowane p = odpowiednio 0,0168, 0,0159 i 0,0431; Rysunek 4A). CHEK1, MKI67 oraz TRPV2 nie osiągnęły skorygowanego progu istotności (skorygowane p = 0,259, 0,680 i 0,259). Analiza ROC dla pojedynczych genów wykazała wartości AUC wynoszące 0,944 dla CCL7 (95% CI, 0,825–1,000), 0,704 dla CHEK1 (0,403–1,000), 0,574 dla MKI67 (0,243–0,905), 0,981 dla MMP1 (0,930–1,000), 0,870 dla MMP13 (0,686–1,000) oraz 0,722 dla TRPV2 (0,447–0,997; Rysunek 4B). Wartości ROC uznano za wstępne, ponieważ procedura łączenia i korekty efektu serii (batch-correction) nie została w pełni udokumentowana.
W zbiorze GSE134431 (13 próbek DFU i 8 nieowrzodziałych próbek DFS), ekspresja MMP1 była wyższa w DFU niż w DFS w teście Wilcoxona przy nominalnym poziomie istotności (p = 0.0225), choć powiązanie to nie pozostało istotne po korekcie BH (skorygowane p = 0.135; Rycina 4C). Pozostałe pięć genów nie wykazało istotnych różnic między grupami. MMP1 wykazało również najwyższą opisową wartość AUC, wynoszącą 0.808 (95% CI, 0.589–1.000), podczas gdy wartości AUC dla pozostałych kandydatów mieściły się w zakresie od 0.529 do 0.635 (Rycina 4D). Ogólnie rzecz biorąc, MMP1 wykazało najbardziej spójny wzorzec opisowy spośród sześciu kandydatów, jednak replikacja statystyczna była niepełna.
Analiza pojedynczych komórek lokalizuje MMP1 przede wszystkim w fibroblastach
Zestaw danych z pojedynczych komórek zawierał 69 944 komórek z 24 próbek (14 DFU i 10 kontrolnych) i obejmował 10 adnotowanych typów komórek (Rycina 5A). Lokalna wizualizacja cech UMAP MMP1 ekspresja ograniczona do określonych obszarów komórkowych, zamiast jednorodnej ekspresji w całym atlasie (Rysunek 5B). Ogólnie 3799 komórek (5,43%) zostało znormalizowanych MMP1 ekspresja większa od zera. Fibroblasty wykazywały najwyższą średnią znormalizowaną ekspresję (0,181) oraz największą całkowitą MMP1frakcja dodatnia (7,88%; Rysunek 5C).
Na poziomie próbek średnia ekspresja MMP1 była wyższa w próbkach DFU niż w próbkach kontrolnych w keratynocytach, fibroblastach i komórkach śródbłonka. Po korekcie BH dla wszystkich badanych typów komórek, każde z tych porównań miało skorygowaną wartość p wynoszącą 0,0214 (keratynocyty: 9 próbek kontrolnych i 14 próbek DFU; fibroblasty: 10 i 14; komórki śródbłonka: 10 i 14; Rysunek 5D). Odsetek komórek wykazujących pozytywną ekspresję MMP1 wzrósł z 5,86% do 9,29% w fibroblastach, z 0,026% do 6,68% w keratynocytach oraz z 0,29% do 2,67% w komórkach śródbłonka (Rysunek 5E).
Korelacje wyników modułów na poziomie pojedynczych komórek były umiarkowane. Najsilniejszą dodatnią korelację zaobserwowano dla wyniku modułu starzenia/fenotypu wydzielniczego związanego ze starzeniem (SASP) (rho Spearmana = 0,274), a następnie dla przebudowy macierzy zewnątrzkomórkowej (rho = 0,240), ferroptozy (rho = 0,197) oraz aktywacji fibroblastów (rho = 0,170). Rycina 5F). Porównanie MMP1wysoki i MMP1- fibroblasty o niskiej ekspresji wykazywały wzbogacenie w zakresie organizacji macierzy zewnątrzkomórkowej, organizacji struktur zewnątrzkomórkowych, organizacji włókien kolagenowych, przetwarzania glikoprotein oraz terminów związanych z fałdowaniem białek (Rycina 5G). Te opisowe wyniki powiązały MMP1-wysoki stan fibroblastów w odniesieniu do procesów związanych z przebudową macierzy. Dodatkowe analizy UMAP na poziomie grup, podsumowania próbek dla wszystkich typów komórek oraz kontekst wyników funkcjonalnych znajdują się w Rycina uzupełniająca 4A–CPowiązania na poziomie pojedynczych komórek nie były traktowane jako dowody niezależne od dawcy.
Pokrycie sieci priorytetyzuje składniki powiązane z MMP1 oraz zioła kandydackie
Przefiltrowana tabela relacji zioło-składnik-cel zawierała 561 unikalnych rekordów łączących 99 ziół, 14 składników oraz pięć z sześciu potencjalnych celów. Najczęstszym celem był MMP1 z 156 rekordami, a następnie CHEK1 (120), MMP13 (102), MKI67 (100) oraz TRPV2 (83; Rysunek 6A). Wśród składników kwercetyna i luteolina wykazywały najszerszy zakres występowania w ziołach, będąc powiązanymi odpowiednio z 83 i 62 ziołami. Berberyna była powiązana z 10 ziołami; te trzy składniki zostały wykorzystane jako składniki kluczowe w regule priorytetyzacji (Rysunek 6B).
Wskaźnik pokrycia najwyżej sklasyfikował wspólnie Guanhuangbo, Mahuang i Niuxi (wynik = 38 dla każdego; Rysunek 6C). Każdy z nich obejmował wszystkie pięć dostępnych celów i zawierał dwa składniki powiązane z MMP1. Macierz składnik-cel wykazała, że kwercetyna zapewniała najszersze pokrycie w panelu celów, podczas gdy luteolina i berberyna dostarczyły dodatkowej łączności skoncentrowanej wokół MMP1 (Rysunek 6D). Skoncentrowana sieć powiązała wiodące zioła z reprezentatywnymi składnikami oraz pięcioma dostępnymi celami (Rysunek 6E). Wyniki te pozwoliły zidentyfikować kombinacje zioło-składnik-cel o wysokim pokryciu w bazach danych do dalszej oceny. Uzupełniające macierze pokrycia zioło-cel i składnik-rdzeń przedstawiono na Rysunku uzupełniającym 5A,B.
Wstępne testy na sparowanych tkankach wykazują wyższą zawartość mRNA i białka MMP1
Analiza Western blot wykazała wyższą zawartość MMP1 w próbkach z DFU niż w odpowiadających im nieowrzodziałych próbkach z otoczenia rany (Rycyna 7A,B). Dla trzech dopasowanych par średnia różnica (DFU minus otoczenie rany) w stosunku MMP1/kofilin wyniosła 0,3553 (95% CI, 0,1959–0,5147; obustronny sparowany test t, t(2) = 9,592, p = 0,0107). Pomiary sparowane dla każdego pacjenta przedstawiono na Rycynie 7B. Po uśrednieniu pięciu powtórzeń technicznych dla każdego genu w każdej próbce, qPCR wykazała wyższą znormalizowaną zawartość mRNA MMP1 w każdej z czterech próbek z DFU w porównaniu z odpowiadającą im próbką z otoczenia rany (Rycyna 7C). Średnia różnica ΔCq wewnątrz pacjenta (DFU minus otoczenie rany) wyniosła −2,6035 (95% CI, −2,8024 do −2,4046; obustronny sparowany test t, t(3) = −41,663, p = 3,04 × 10⁻⁵), co odpowiada geometrycznej średniej zwiększonej 6,08-krotnie (95% CI, 5,30–6,98). Te obserwacje przy małej próbie mają charakter wstępny i nie potwierdzają efektu funkcjonalnego.
W zbiorach danych z etapu odkryć oraz zewnętrznych zbiorach danych masowych, MMP1 wykazywał najbardziej spójny wzorzec opisowy spośród sześciu priorytetowych genów, choć replikacja statystyczna była niepełna. Podsumowania z analizy pojedynczych komórek wykazały najwyższą średnią ekspresję w fibroblastach, a sparowane pomiary WB od trzech pacjentów oraz sparowane pomiary qPCR od czterech pacjentów wykazały wyższą obfitość MMP1. Obserwacje te wskazują na MMP1 jako kandydata związanego z DFU do dalszych badań. Cały schemat oceny od analizy obliczeniowej do analizy tkankowej został podsumowany na Rysunku uzupełniającym 6.
DOSTĘPNOŚĆ DANYCH:
Publiczne zbiory danych transkryptomicznych są dostępne w bazie NCBI Gene Expression Omnibus pod numerami dostępu GSE199939, GSE68183, GSE80178, GSE134431 oraz GSE165816. Dostępne skrypty do analizy i generowania rycin, przetworzone tabele ekspresji i wyników, ilościowe tabele źródłowe do rycin, tabele wyników statystycznych, oryginalny arkusz roboczy i projekt instrumentu qPCR oraz dostarczone nieprzycięte obrazy western blot znajdują się w Pliku uzupełniającym 1. Archiwum zawiera również wyodrębnione metadane komórek i historię poleceń z odzyskanego obiektu pojedynczych komórek, raporty weryfikacji typów macierzy oraz manifest plików. Plik uzupełniający 1 zawiera historyczne pliki źródłowe oraz folder R2_Updates, w którym znajdują się poprawione tabele źródłowe dla analiz sparowanych, wyniki statystyczne, kod do generowania rycin oraz skorygowany spis parametrów. Pełny przeanalizowany plik Seurat RDS jest wskazany w dokumentacji archiwum, ale nie został dołączony do tego uzupełniającego pliku ZIP. Pełna historia łączenia próbek bulk, oryginalne ustawienia filtrowania i adnotacji pojedynczych komórek oraz szczegóły oryginalnego odejmowania tła z blotów i kwantyfikacji ścieżek nie są w pełni dostępne; ograniczenia te opisano w protokole i dyskusji. Lokalnie odzyskany plik RDS nie został przekazany do publicznego repozytorium.
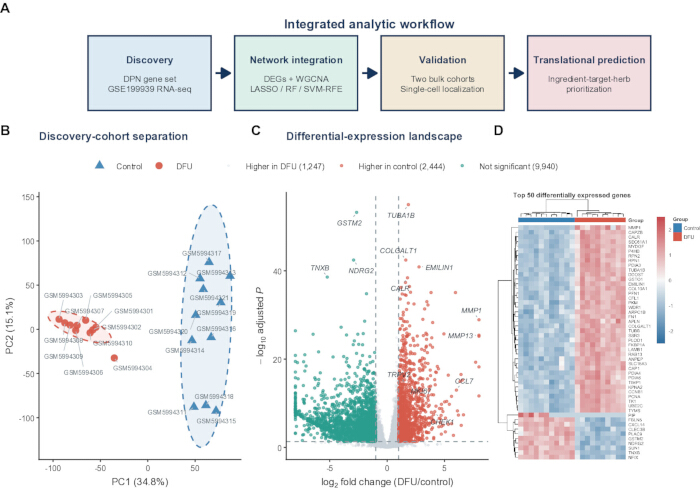
Rysunek 1: Transkryptomika odkrywcza identyfikuje program ekspresji związany z DFU. (A) Przegląd schematu obliczeniowego, obejmujący konstrukcję zestawu genów DPN i analizę odkrywczą GSE199939, integrację sieci i uczenia maszynowego, ocenę w próbkach bulk oraz w pojedynczych komórkach, a także przewidywanie zależności składnik-cel-zioło w TCM. (B) Analiza głównych składowych dla profili ekspresji GSE199939 ze stabilizacją wariancji z 10 próbek DFU i 11 próbek kontrolnych. Elipsy wskazują 90% obszary grup; procenty oznaczają wariancję wyjaśnioną przez każdą składową. (C) Wykres wulkaniczny wyników różnicowej ekspresji DESeq2 dla DFU w stosunku do kontroli. Punkty czerwone i turkusowe oznaczają geny odpowiednio z zwiększoną ekspresją w DFU i kontroli, przy zastosowaniu |log2 fold change| > 1 i skorygowanej wartości p według metody BH < 0,05; punkty szare nie spełniły obu progów. (D) Mapa ciepła wyników z-score dla wierszy dla 50 genów z najniższymi skorygowanymi wartościami p. Kolumny przedstawiają próbki biologiczne, a pasek adnotacji oznacza grupę. DEGs, geny różnicowo eksponowane; DFU, stopa cukrzycowa; DPN, cukrzycowa polineuropatia obwodowa; VST, transformacja stabilizująca wariancję. Końcowa ocena eksperymentalna jest opisana w protokole i na Rysunku 7. qPCR, ilościowa reakcja polimerazy łańcuchowej; TCM, tradycyjna medycyna chińska; RF, lasy losowe; LASSO, operator najmniejszego bezwzględnego kurczenia i selekcji; SVM-RFE, rekurencyjna eliminacja cech z wykorzystaniem maszyny wektorów wspierających. Aby zobaczyć powiększoną wersję tego rysunku, kliknij tutaj.
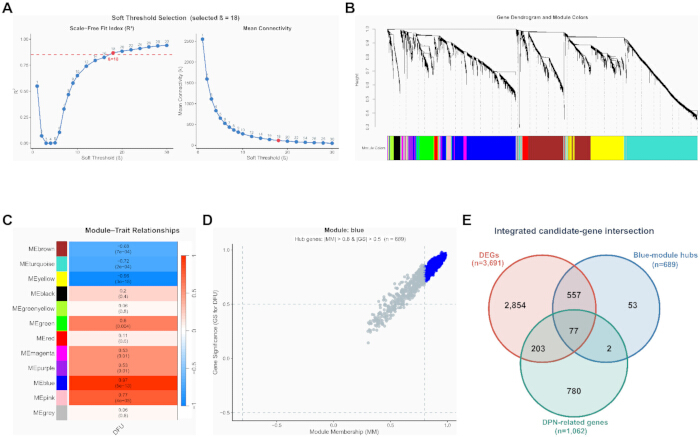
Rysunek 2: WGCNA i wcześniejsza wiedza na temat DPN wskazują na 77 genów kandydackich. (A) Ocena progu miękkiego podpisanej sieci dla 5 000 najbardziej zmiennych genów po transformacji VST. Wybrana potęga wyniosła beta = 18; linia przerywana oznacza docelowe dopasowanie topologii bezskalowej na poziomie 0,85. (B) Dendrogram genów z wiązaniem średnim z dynamicznym przypisaniem kolorów modułów. (C) Korelacje Pearsona między eigengenami modułów a binarną cechą DFU. Każda komórka przedstawia współczynnik korelacji i odpowiadającą mu dwustronną wartość p; kolor wskazuje kierunek i wielkość. (D) Istotność genu (GS) dla DFU w stosunku do przynależności do modułu (MM) w module niebieskim. Niebieskie punkty spełniają warunek |module membership| > 0,8 i |gene significance| > 0,5; n = 689 genów hub. (E) Przecięcie trzech zbiorów: 3 691 DEG, 689 genów hub modułu niebieskiego oraz 1 062 genów związanych z DPN, co dało 77 wspólnych kandydatów. DFU, stopa cukrzycowa; DPN, cukrzycowa polineuropatia obwodowa; GS, istotność genu; MM, przynależność do modułu; WGCNA, ważona analiza sieci współekspresji genów. Kohorta odkrywcza zawierała 21 próbek (10 DFU i 11 kontrolnych). Adnotacja na Rysunku 2D wykorzystuje |MM| > 0,8 i |GS| > 0,5, co odpowiada kryterium wartości bezwzględnej zweryfikowanemu w oryginalnym kodzie selekcji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
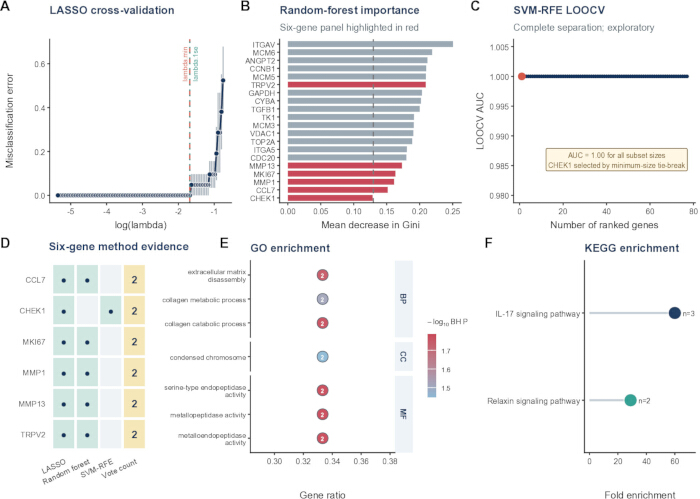
Rysunek 3: Priorytetyzacja cech przy użyciu wielu metod prowadzi do wyłonienia panelu sześciu genów. (A) Krzywa pięciokrotnej walidacji krzyżowej dla binomialnej regresji LASSO. Pionowe linie przerywane oznaczają lambda.min oraz lambda.1se; wybrano cechy niezerowe przy lambda.1se, chyba że ta kara nie wskazała żadnej cechy. (B) Średni spadek indeksu Gini w lasach losowych dla 20 najwyżej ocenionych genów z modelu składającego się z 1 000 drzew. Czerwone słupki identyfikują członków końcowego panelu sześciu genów; linia przerywana oznacza średnią istotność użytą jako próg retencji dla całego zestawu kandydatów. (C) AUC LOOCV dla liniowego SVM-RFE w zagnieżdżonych podzbiorach cech. Wszystkie rozmiary podzbiorów dały AUC = 1.00; CHEK1 został wybrany zgodnie z zasadą najmniejszego rozmiaru w przypadku remisu, co wskazuje na przeuczenie (overfitting) w kohorcie odkrywczej. (D) Macierz wsparcia metod dla CCL7, CHEK1, MKI67, MMP1, MMP13 oraz TRPV2. Kropki oznaczają wybór przez LASSO, lasy losowe lub SVM-RFE; ostatnia kolumna podaje liczbę metod wspierających. (E) Wybrane terminy Gene Ontology wzbogacone wśród sześciu genów. Położenie punktu wskazuje stosunek genów, etykiety punktów wskazują liczbę zmapowanych genów, kolor wskazuje -log10 skorygowanej metodą BH wartości p, a boczny pasek oznacza ontologię. (F) Szlaki KEGG wzbogacone wśród zmapowanych genów. Położenie punktu wskazuje krotność wzbogacenia, etykiety rozmiaru punktów wskazują liczbę zmapowanych genów, a kolor rozróżnia szlaki. Wzbogacenie wymagało nominalnej wartości p < 0.05 oraz skorygowanej metodą BH wartości p < 0.05. AUC, pole pod krzywą charakterystyki operacyjnej odbiornika; BH, Benjamini-Hochberg; BP, proces biologiczny; CC, komponent komórkowy; KEGG, Kyoto Encyclopedia of Genes and Genomes; LOOCV, walidacja krzyżowa z pominięciem jednej próbki; MF, funkcja molekularna; SVM-RFE, rekurencyjna eliminacja cech z wykorzystaniem maszyn wektorów nośnych. LASSO, operator najmniejszego bezwzględnego kurczenia i selekcji. Panele A–D wykorzystują 21 próbek odkrywczych (10 DFU i 11 kontroli). W panelu A słupki błędów oznaczają błąd standardowy błędu walidacji krzyżowej. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
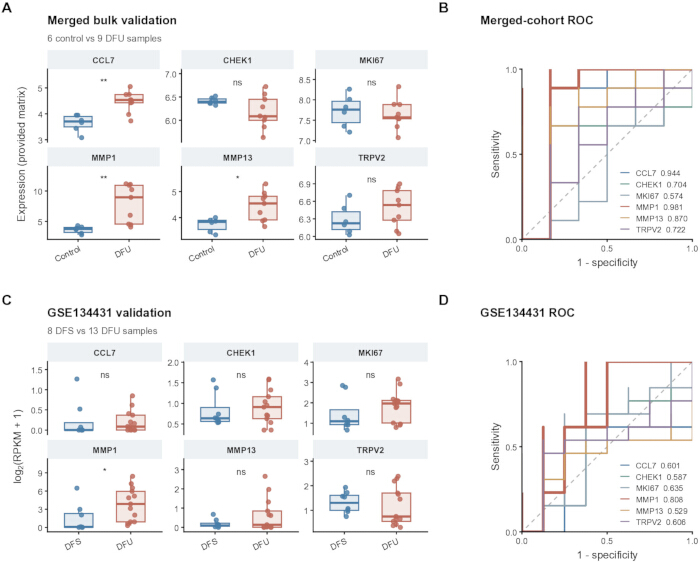
Rycina 4: Międzyzbiorowa ocena bulk-transkryptomiczna panelu sześciu genów. (A) Ekspresja sześciu genów w połączonej macierzy GSE68183/GSE80178 (6 kontroli i 9 próbek DFU). (B) Odpowiadające im krzywe ROC dla pojedynczych genów wraz z wartościami AUC; 95% przedziały ufności podano w tabeli danych źródłowych. Ze względu na niepełną dokumentację procesu łączenia danych i korekty efektu serii (batch correction), wyniki te zinterpretowano jako wstępne. (C) Ekspresja log2(RPKM + 1) w GSE134431 (8 próbek DFS bez owrzodzeń i 13 próbek DFU). (D) Odpowiadające im krzywe ROC i wartości AUC. Na wykresach (A) i (C) pola reprezentują medianę i rozstęp międzykwartylny, wąsy sięgają 1,5-krotności rozstępu międzykwartylnego, a punkty reprezentują próbki biologiczne. Gwiazdki oznaczają istotność nominalną z dwustronnych testów sum rang Wilcoxona (*p < 0.05, **p < 0.01); wartości p skorygowane metodą BH dla sześciu genów podano w tekście i tabeli danych źródłowych. Kierunek ROC został wybrany automatycznie przez pROC. AUC, pole pod krzywą charakterystyki operacyjnej odbiornika; DFS, nieowrzodzona skóra stopy cukrzycowej; DFU, owrzodzenie stopy cukrzycowej; RPKM, liczba odczytów na kilobazę na milion zmapowanych odczytów; ROC, charakterystyka operacyjna odbiornika. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
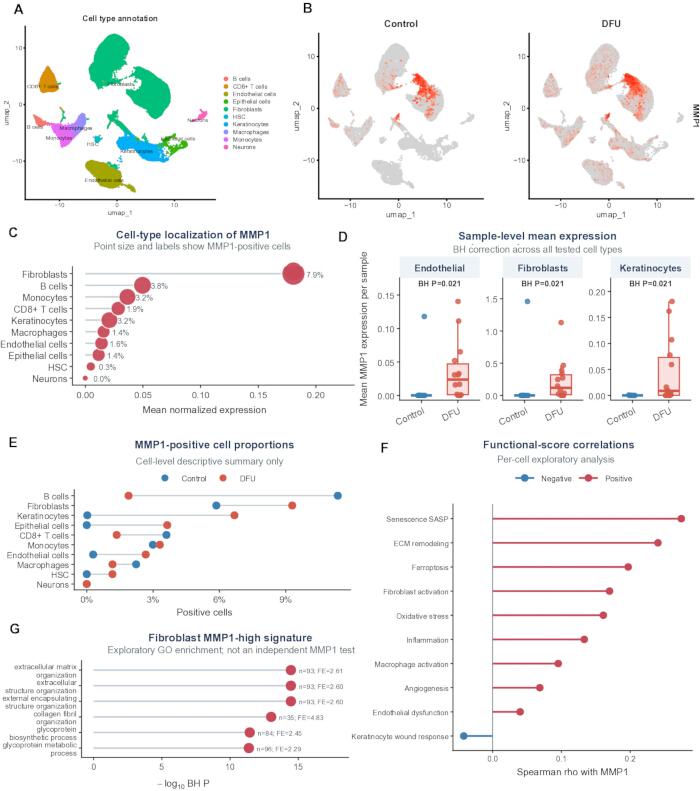
Rysunek 5: Lokalizacja w pojedynczych komórkach wiąże MMP1 z sygnałami fibroblastów i przebudowy macierzy. (A) UMAP z 69 944 komórek z 24 próbek (10 kontrolnych i 14 próbek DFU), pokolorowany według 10 adnotacji typów komórek wyznaczonych przez SingleR. (B) Wykresy cech UMAP pokazujące znormalizowaną ekspresję MMP1 w komórkach kontrolnych i DFU. (C) Podsumowanie typów komórek dla średniej znormalizowanej ekspresji MMP1; rozmiar punktów i etykiety oznaczają całkowitą frakcję komórek MMP1-dodatnich, zdefiniowaną jako ekspresja znormalizowana > 0. (D) Średnia ekspresja MMP1 na poziomie próbek w komórkach śródbłonka, fibroblastach i keratynocytach. Pudełka przedstawiają medianę i rozstęp międzykwartylny; punkty to próbki biologiczne. Dwustronne testy sum rang Wilcoxona zostały uzupełnione korekcją BH dla wszystkich testowanych typów komórek. Dostępna liczba próbek wynosiła 10 kontrolnych i 14 DFU dla komórek śródbłonka i fibroblastów oraz 9 kontrolnych i 14 DFU dla keratynocytów. (E) Frakcje komórek MMP1-dodatnich w zależności od grupy i typu komórek. (F) Korelacje Spearmana na poziomie pojedynczych komórek między ekspresją MMP1 a wynikami modułów funkcjonalnych. (G) Wzbogacenie procesów biologicznych GO wśród genów upregulowanych w fibroblastach z wysoką ekspresją MMP1 w porównaniu do fibroblastów z niską ekspresją MMP1. BH, Benjamini-Hochberg; DFU, stopa cukrzycowa; ECM, macierz zewnątrzkomórkowa; GO, Gene Ontology; HSC, hematopoetyczne komórki macierzyste; UMAP, uniform manifold approximation and projection. Korelacje na poziomie komórkowym oraz wzbogacenie uwarunkowane ekspresją w panelach F i G są opisami eksploracyjnymi, bez potwierdzającego wnioskowania uwzględniającego dawcę. Niezależność na poziomie próbek wymaga weryfikacji identyfikatorów dawców. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
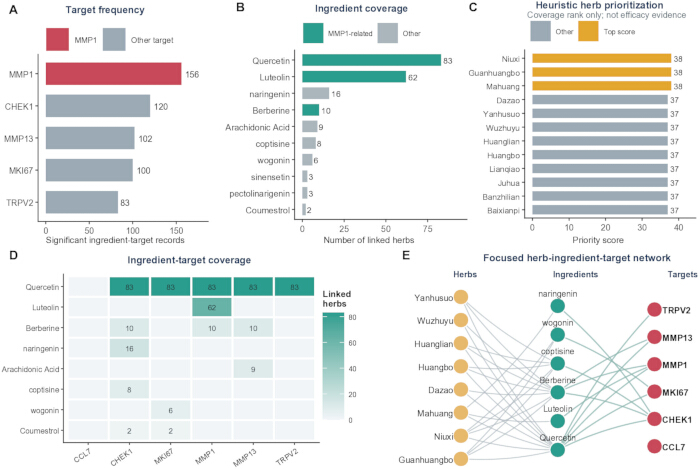
Rysunek 6: Przewidywanie składników-celów-ziół TCM w oparciu o stopień pokrycia, skoncentrowane na MMP1. (A) Liczba przefiltrowanych rekordów z bazy danych dla par zioło-składnik-cel dla każdego dostępnego kandydata na cel. (B) Liczba powiązanych ziół dla najczęstszych składników; kolor morski oznacza składniki powiązane z MMP1. (C) Główne zioła uszeregowane według wyniku pokrycia; złote słupki wskazują trzy najwyższe wspólne wyniki. (D) Macierz składnik-cel dla reprezentatywnych składników o wysokim stopniu pokrycia. Wartości w komórkach wskazują liczbę powiązanych ziół; puste komórki oznaczają brak rekordu w przefiltrowanej tabeli relacji. (E) Skoncentrowana sieć łącząca reprezentatywne, wysoko sklasyfikowane zioła, składniki i kandydatów na cele. Kolor węzła oznacza typ encji; szare krawędzie zioło-składnik oznaczają zawartość, a morskie krawędzie składnik-cel oznaczają powiązania w bazie danych. Przefiltrowana tabela relacji zawierała 561 unikalnych rekordów, 99 ziół, 14 składników i pięć celów z kwalifikującymi się powiązaniami; CCL7 został przedstawiony jako odizolowany szósty węzeł kandydujący. TCM, tradycyjna medycyna chińska. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
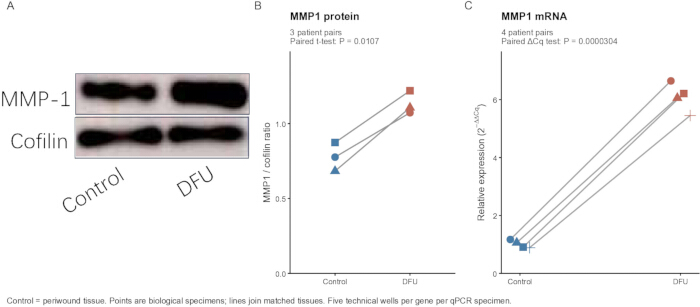
Rysunek 7: Wstępna ocena ekspresji MMP1 w tkankach pacjentów z DFU za pomocą qPCR i western blot. (A) Reprezentatywny western blot przedstawiający zawartość białka MMP1 w nieowrzodziałej tkance okołorannej oraz tkance DFU, z kofiliną jako kontrolą ładunku. (B) Stosunki MMP1 do kofiliny odzyskane z oryginalnego projektu wykresów. Symbole przedstawiają poszczególne pomiary biologiczne z trzech par pacjentów; linie łączą dopasowane próbki z obszaru okołorannego i DFU. Dwustronny test t dla prób zależnych wykazał t(2) = 9,592 i p = 0,0107. (C) Względna zawartość mRNA MMP1 w czterech potwierdzonych przez autorów dopasowanych parach pacjentów: NC–DFU, NC1–DFU1, NC2–DFU2 oraz NC3–DFU3. Średnie z pięciu technicznych dołków ACTB oraz pięciu technicznych dołków MMP1 obliczono oddzielnie dla każdej próbki przed wyznaczeniem ΔCq. Ekspresję względną obliczono metodą 2−ΔΔCq, przyjmując średnie ΔCq dla tkanki okołorannej jako wspólny kalibrator. Każdy symbol reprezentuje jedną próbkę biologiczną; linie łączą dopasowane tkanki. Dwustronny test t dla prób zależnych przeprowadzono na wartościach ΔCq na poziomie próbki (t(3) = −41,663; p = 3,04 × 10⁻⁵), a nie na krotnościach zmian z dołków technicznych. Nie zastosowano gwiazdek istotności. Dołki techniczne nie są powtórzeniami biologicznymi. Kontrola oznacza nieowrzodziałą tkankę okołoranną. Cq, cykl kwantyfikacji. Wartości p dla analizy tkankowej są nominalne i mają charakter eksploracyjny. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
| Gen | Numer dostępu RefSeq | Starter forward 5' do 3' | Starter reverse 5' do 3' |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tabela 1: Sekwencje starterów do ilościowej walidacji PCR dla MMP1. Podano sekwencje oligonukleotydów bezpośrednich i odwrotnych (5′–3′) oraz numery dostępowe transkryptów NCBI RefSeq dla ludzkich genów MMP1 (NM_002421) oraz ACTB (NM_001101.5). ACTB (β-aktyna) służył jako gen referencyjny dla względnej ekspresji MMP1.
Rycina uzupełniająca 1: Podsumowania kontroli jakości WGCNA. (A) Hierarchiczna analiza skupień z zastosowaniem średniego wiązania dla próbek GSE199939 na podstawie 5 000 genów o najwyższej zmienności po stabilizacji wariancji. Etykiety próbek są pokolorowane według grup; przerywana pozioma linia to pomocniczy wskaźnik wysokości dendrogramu dla 95. percentyla, używany do wizualnej oceny wartości odstających. (B) Liczba genów przypisanych do każdego modułu WGCNA. Słupki w kolorze morskim oznaczają osiem modułów innych niż szary, które spełniły kryterium powiązania z DFU; słupki szare oznaczają pozostałe moduły. DFU, stopień cukrzycowy; VST, transformacja stabilizująca wariancję; WGCNA, analiza ważonej sieci koekspresji genów. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 2: Wsparcie dla koekspresji modułu niebieskiego. (A) Uproszczona sieć koekspresji 25 najwyżej sklasyfikowanych genów hubowych modułu niebieskiego. spośród korelacji parzystych z |r| > 0,70, wyświetlona sieć zawiera sumę dwóch najsilniejszych powiązań każdego genu. Wielkość węzła oznacza stopień w tej wyświetlonej, rzedkiej sieci, a wypełnienie węzła oznacza istotność genu dla DFU. (B) Istotność genów i przynależność do modułu niebieskiego dla 15 najwyżej sklasyfikowanych hubów. Podzbiór krawędzi został wybrany w celu zwiększenia czytelności i nie reprezentuje wszystkich kwalifikujących się korelacji. DFU, stopa cukrzycowa; GS, istotność genu; MM, przynależność do modułu. Kliknij tutaj, aby pobrać ten plik.
Rycina dodatkowa 3: Wyświetlenia uczenia maszynowego dla wewnętrznej kohorty odkrywczej. (A) Skalowana ekspresja CCL7, CHEK1, MKI67, MMP1, MMP13 oraz TRPV2 w kohorcie odkrywczej GSE199939. Prostokąty reprezentują medianę i rozstęp międzykwartylny, a punkty reprezentują próbki biologiczne. (B) Mapa ciepła z-score dla wierszy na poziomie próbek dla tych samych sześciu genów. Skrócone etykiety próbek są przypisane do identyfikatorów GEO w kluczu danych źródłowych. (C) Krzywa ROC dopasowanego wielogenowego modelu kohorty odkrywczej. Wartość AUC wynosząca 1.00 została uzyskana poprzez dopasowanie i ocenę modelu na tych samych 21 próbkach, co wskazuje na przeuczenie w kohorcie odkrywczej. AUC, pole powierzchni pod krzywą charakterystyki operacyjnej odbiornika; ROC, charakterystyka operacyjna odbiornika. Kohorta odkrywcza zawierała 21 próbek (10 DFU i 11 kontroli). Prosimy kliknąć tutaj, aby pobrać ten plik.
Rycina uzupełniająca 4: Kontekst ekspresji w pojedynczych komórkach. (A) UMAP 69 944 komórek z podziałem na grupę kontrolną i grupę DFU. (B) Średnia ekspresja MMP1 na poziomie próbek biologicznych dla wszystkich 10 przypisanych typów komórek; punkty reprezentują próbki, a oś X wykorzystuje transformację pierwiastkową w celu wizualizacji. (C) Mapa ciepła wyników modułów funkcjonalnych podsumowanych dla komórek w obrębie każdego przypisanego typu komórek i zestandaryzowanych wewnątrz każdego modułu. DFU, diabetic foot ulcer (stopa cukrzycowa); UMAP, uniform manifold approximation and projection. Prosimy kliknąć tutaj, aby pobrać ten plik.
Rycina dodatkowa 5: Pomocnicze macierze pokrycia TCM. (A) Liczba rekordów zbazy danych dla ziół i celów dla 18 najwyżej sklasyfikowanych ziół z pokryciem powiązanym z MMP1 oraz pięciu potencjalnych celów przedstawionych w przefiltrowanej tabeli relacji. (B) Liczba rekordów w bazie danych łączących te same zioła z głównymi składnikami: kwercetyną, luteoliną i berberyną. Wartości w komórkach oznaczają unikalne rekordy bazy danych po usunięciu duplikatów. TCM, tradycyjna medycyna chińska. Kliknij tutaj, aby pobrać ten plik.
Rysunek uzupełniający 6: Schemat analizy obliczeniowej i oceny tkankowej. Schemat podsumowuje dane wejściowe do analizy odkrywczej, przecięcie DEG/WGCNA, eksploracyjny wybór cech, zewnętrzną ocenę bulk, kontekst jednokomórkowy, rozszerzenie TCM oraz ocenę ekspresji w dopasowanych tkankach. Do qPCR wykorzystano cztery dopasowane pary pacjentów, a do western blotting trzy dopasowane pary pacjentów. Liczba kandydatów oraz zgłoszone wyniki obliczeniowe zostały zachowane z oryginalnej analizy. Ograniczeniami pozostają: dane TPM w przepływie odkrywania opartym na liczbach, niekompletne oryginalne zapisy preprocessingu jednokomórkowego oraz małe kohorty w badaniach tkankowych. Schemat nie sugeruje, że analizy odkrywcze zostały ponownie zwalidowane. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 1: Inwentarz oprogramowania analitycznego, baz danych, parametrów i ograniczeń. Niniejszy arkusz dokumentuje 26 kroków analizy, zawierając opis kroku analitycznego, narzędzia lub bazy danych, zgłoszoną wersję, dane wejściowe, główne parametry, dane wyjściowe oraz brakujące informacje lub ograniczenia. Obejmuje on transkryptomikę odkrywczą, WGCNA, screening genów i wybór cech, analizę wzbogacenia, zewnętrzne analizy bulk i single-cell, analizę sieci TCM oraz raportowanie wyników badań tkankowych. Tabela rejestruje dostępne informacje metodologiczne i sama w sobie nie ustanawia niezależnej powtarzalności. Prosimy kliknąć tutaj, aby pobrać ten plik.
Plik uzupełniający 1: Archiwum danych, kodu analitycznego oraz źródeł postaci i analiz. Archiwum to zawiera dostępne skrypty do analizy i generowania postaci, przetworzone tabele ekspresji i wyników, postaci ilościowe oraz źródłowe dane statystyczne, oryginalny arkusz roboczy i projekt instrumentu qPCR, dostarczone nieprzycięte obrazy western blot, wyekstrahowane metadane i historię poleceń z poziomu pojedynczych komórek, raporty weryfikacji typu macierzy oraz manifest plików. Zachowano pliki historyczne; folder R2_Updates zawiera poprawioną analizę testów sparowanych, zaktualizowane źródła postaci oraz zrewidowany spis parametrów. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Ten zintegrowany schemat postępowania pozwolił na wyłonienie MMP1 jako priorytetowego genu na podstawie transkryptomiki masowej, analizy WGCNA, przesiewu genów związanych z DPN oraz eksploracyjnego wyboru cech, a następnie zbadano jego kontekst komórkowy i ekspresję tkankową. Sześć genów zostało potwierdzonych przez co najmniej dwie metody selekcji, przy czym MMP1 wykazało największą zmianę ekspresji w kohorcie odkrywczej. Dowody zewnętrzne były niejednorodne: MMP1 pozostało istotne w połączonej macierzy GSE68183/GSE80178, podczas gdy jego powiązanie w GSE134431 było nominalne (p = 0,0225) i nie przetrwało korekty BH (skorygowane p = 0,135). Wartość AUC wynosząca 0,808 w GSE134431 ma charakter opisowy, szczególnie że kierunek krzywej ROC został wybrany w obrębie zbioru oceny. W związku z tym określenie „najbardziej spójny” opisuje obserwowany wzorzec wśród sześciu kandydatów i nie oznacza pełnej replikacji statystycznej ani zwalidowanego biomarkera diagnostycznego.
Panel kandydacki został przypisany do procesów wymiany kolagenu, rozpadu ECM, aktywności metaloendopeptydaz oraz sygnalizacji IL-17 i relaksyny. Adnotacje te są zgodne z biologią ran przewlekłych, lecz obejmują jedynie kilka genów. Wcześniejsze badania na ludziach wykazały zmienione profile MMP i inhibitorów w ranach cukrzycowych6, podczas gdy prospektywne badanie DFU powiązało wyższy stosunek MMP1 do tkankowego inhibitora metaloproteinaz 1 (TIMP1) z gojeniem7. Zatem zwiększona ekspresja MMP1 nie musi wskazywać na jednolity szkodliwy efekt; jej znaczenie może zależeć od etapu naprawy, dostępności substratu i równowagi inhibitorów. Obserwacje eksperymentalne dotyczące MMP13, CCL7 i IL-17 dostarczają dodatkowego kontekstu11,12,13,14, jednak nie można założyć, że ich funkcje są równoważne w przypadku ludzkich DFU.
Podsumowania na poziomie pojedynczych komórek wykazały, że najwyższa średnia ekspresja MMP1 występuje w fibroblastach, przy wyższej ekspresji na poziomie próbek w fibroblastach, keratynocytach i komórkach śródbłonkowych z DFU. Wzorzec ten jest zgodny z doniesieniami o zaburzonej organizacji ECM w fibroblastach pochodzących z DFU4, heterogenicznych stanach fibroblastów w badaniach pojedynczych komórek i badaniach przestrzennych8, a także programach fibroblastów gojących związanych z makrofagami15. Jednakże identyfikatory próbek wymagają weryfikacji na poziomie dawcy, a korelacje wyników modułowych na poziomie komórkowym oraz wzbogacenie uwarunkowane ekspresją pozostają opisowe, ponieważ nie modelowano zależności wewnątrz jednego dawcy. Wkład populacji nabłonkowych i śródbłonkowych również przemawia przeciwko wyłącznie autonomicznemu mechanizmowi fibroblastycznemu. Transkryptomika przestrzenna, hybrydyzacja RNA in situ lub immunobarwienie zapewniłyby uzupełniającą lokalizację16.
Wartość metodologiczna polega na połączeniu różnicowej ekspresji, koekspresji, wcześniejszej wiedzy o genach, podsumowań w rozdzielczości pojedynczych komórek oraz niezależnych modalności analiz w celu priorytetyzacji kandydatów. Nie polega ona na dokładności predykcyjnej w kohorcie odkrywczej. Przesiew całe kohorty poprzedzał walidację krzyżową na poziomie algorytmu, a jednolity wynik AUC dla modelu SVM-RFE wynoszący 1,00 budzi obawy dotyczące wycieku danych, przeuczenia i optymistycznej oceny. Panel ten powinien zatem pozostać wynikiem priorytetyzacji cech. Do oceny predykcyjnej niezbędne byłoby pełne zagnieżdżone przetwarzanie wstępne, selekcja i strojenie, a następnie zablokowany test niezależny9,10. Dane wejściowe z etapu odkrywania zostały zweryfikowane jako TPM, mimo zastosowania modelu opartego na zliczeniach; w konsekwencji wynikowe statystyki odkrywania i późniejsza selekcja pozostają niezweryfikowane do czasu przeprowadzenia odpowiedniej reanalizy. Połączona macierz bulk nie posiada pełnej historii przetwarzania wstępnego. Odzyskany obiekt Seurat dostarcza ustawień normalizacji, selekcji cech zmiennych, PCA, sąsiedztwa, klastrowania i UMAP, choć pierwotne filtrowanie, pełne wywołanie Harmony oraz referencję adnotacji udokumentowano w sposób niepełny. Alternatywnymi podejściami do dalszej oceny są: zharmonizowane przetwarzanie ponowne z danych źródłowych, udokumentowana ocena efektu serii oraz analizy pseudobulk z uwzględnieniem dawcy lub analizy modelami mieszanymi.
Analizy tkanek pacjentów dostarczają wstępnych, ortogonalnych dowodów na wyższą obfitość MMP1. Jako komparator wykorzystano nieowrzodziałą tkankę okołoranową od tych samych pacjentów, zatem kontrast odzwierciedla lokalne różnice związane z owrzodzeniem w obrębie tkanki cukrzycowej, a nie porównanie ze zdrową skórą. Pobrane pomiary WB od trzech dopasowanych par pacjentów oraz pomiary qPCR od czterech potwierdzonych przez autorów dopasowanych par zostały przeanalizowane za pomocą testów dla prób zależnych, z wyświetleniem poszczególnych obserwacji biologicznych. W przypadku qPCR średnią z powtórzeń technicznych obliczono dla każdego preparatu, a do wnioskowania wykorzystano ΔCq; powtórzenia techniczne nie zwiększyły liczebności próby biologicznej. Spójny kierunek obserwacji w parach wspiera wstępne porównanie ekspresji, jednak małe kohorty nie pozwalają na ustalenie generalizowalności ani wiarygodną ocenę założeń dotyczących rozkładu. Obfitość w całej tkance (bulk-tissue) nie określa lokalizacji komórkowej białka, aktywności enzymatycznej ani związku przyczynowo-skutkowego z gojeniem. Niezbędne są większe, klinicznie scharakteryzowane kohorty. Inne ograniczenia obejmują niepełne współzmienne kliniczne, odmienne tkanki komparacyjne, niepełnie udokumentowany zestaw genów DPN pochodzący z literatury oraz niepełną dokumentację odejmowania tła z oryginalnych blotów. Tkanki zdrowej, tkanki kontrolnej zdefiniowanej w badaniu oraz nieowrzodziałej skóry stopy cukrzycowej nie należy traktować jako zamiennych.
Sieć TCM stanowi rozszerzenie służące do generowania hipotez. Jej niestandardowe wagi podsumowują zakres pokrycia bazy danych, a nie zaangażowanie celu lub skuteczność, a rankingi mogą ulec zmianie w zależności od zawartości bazy danych i doboru wag. Kwercetyna i berberyna wykazują również zmienną lub ograniczoną ekspozycję systemową17,18. W związku z tym potencjalne składniki i zioła wymagają bezpośrednich badań w zakresie celu, zależności dawka-odpowiedź, farmakokinetyki, toksyczności oraz testów funkcjonalnych. Przyszłe prace powinny łączyć dobrze udokumentowane niezależne kohorty z lokalizacją przestrzenną i zaburzeniem MMP1 w pierwotnych fibroblastach lub wielokomórkowych modelach ran. Niniejsze odkrycia wskazują na MMP1 jako potencjalny kandydat powiązany z DFU w kontekście przebudowy macierzy zorientowanej na fibroblasty, bez ustalania związku przyczynowo-skutkowego lub użyteczności klinicznej.
Oświadczenia
Autorzy oświadczają, że nie występuje konflikt interesów.
Podziękowania
Badania te były wspierane przez Projekt Medycznych Badań Naukowych Miasta Wuhan (Projekt Kierowniczy, Grant nr WX23Z77), zarządzany przez Komisję Zdrowia Miasta Wuhan.
Autorzy dziękują uczestnikom, którzy udostępnili próbki tkanek do niniejszego badania, oraz badaczom, którzy wygenerowali i zdeponowali publicznie dostępne zestawy danych w bazie NCBI Gene Expression Omnibus.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Przezroczyste paski 8 probówek PCR o cienkich ściankach, 0,2 mL | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| Sterylne końcówki do pipet z filtrem, 1000-μL | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| Sterylne probówki do mikrocentryfugi, 1,5 mL, wolne od DNazy/RNazy | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| Sterylne końcówki do pipet z filtrem, 10-μL | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR Mastermix | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| 20× Tris-buffered saline (bufor solny z Trisem) | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| Sterylne końcówki do pipet z filtrem, 200-μL | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| Para starterów qPCR dla ACTB | Solarbio Life Sciences (synteza oligosomów na zamówienie) | Custom | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Szwecja | Amersham Imager 600 | Model odnotowany we wszystkich 22 dostarczonych plikach TIFF; oprogramowanie operacyjne wersja 1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Zestaw do oznaczania białek kwasem biczninkoniniowym (BCA) | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Wersja 4.16.0 |
| Poliklonalne przeciwciało przeciwko kofilinie (królicze anty-kofilina) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Chiny) | 10960-1-AP | Rozcieńczenie WB zastosowane w tej badaniu: 1:6 000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Zasób składnik-cel |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Wersja 1.48.2 |
| Woda wolna od DNazy/RNazy | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / autorzy e1071 | https://cran.r-project.org/package=e1071 | Wersja 1.7-17 |
| Chemiluminescencyjny substrat ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | National Center for Biotechnology Information | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | National Center for Biotechnology Information | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | National Center for Biotechnology Information | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | National Center for Biotechnology Information | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | National Center for Biotechnology Information | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Gene Ontology Consortium | https://geneontology.org/ | GO |
| ggplot2 | twórcy ggplot2 | https://ggplot2.tidyverse.org/ | Wersja 4.0.3 |
| glmnet | CRAN / autorzy glmnet | https://cran.r-project.org/package=glmnet | Wersja 5.0 |
| Tabela referencyjna zioło-składnik | Źródło niepodane w manuskrypcie | Niepodano | Nieudokumentowano: dokładna nazwa bazy danych/pliku, wersja/data oraz publiczny adres URL |
| Kozie przeciwciało anty-królicze IgG (H+L) sprzężone z HRP | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Chiny) | SA00001-2 | Rozcieńczenie WB zastosowane w tej badaniu: 1:5 000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Próbki tkanki z owrzodzeń stopy cukrzycowej ludzi | Wuhan Fourth Hospital, Wuhan, Chiny | N/A | Próbki DFU dopasowane do pacjentów; qPCR n=4 próbek; WB n=3 próbek; zatwierdzony protokół KY2024-161-01 |
| Próbki nieowrzodzonej tkanki okołoranowej ludzi | Wuhan Fourth Hospital, Wuhan, Chiny | N/A | Dopasowany do pacjenta komparator okołoranowy; qPCR n=4 próbek; WB n=3 próbek; zatwierdzony protokół KY2024-161-01 |
| ImageJ | National Institutes of Health | https://imagej.net/ij/ | Wersja nieudokumentowana |
| Kyoto Encyclopedia of Genes and Genomes | KEGG | https://www.genome.jp/kegg/ | Kod organizmu ludzkiego hsa |
| Lista genów DPN opracowana na podstawie literatury | Komponent pochodzący z literatury; tabela źródłowa na poziomie genów nie została w pełni udokumentowana | Niepodano | Pochodzenie na poziomie genów nie zostało w pełni udokumentowane |
| Mikroobjętościowy spektrofotometr UV-Vis | Producent/model niepodany w manuskrypcie | Niepodano | Nieudokumentowano: dokładny producent, model oraz adres URL produktu; zgadane zastosowanie: pomiar stężenia RNA i ocena A260/A280 |
| Poliklonalne przeciwciało przeciwko MMP1 (królicze anty-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Chiny) | 10371-2-AP | Rozcieńczenie WB zastosowane w tej badaniu: 1:1 000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| Para starterów qPCR dla MMP1 | Solarbio Life Sciences (synteza oligosomów na zamówienie) | Custom | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/gene/ | Baza danych genów ludzkich |
| Beztłuszczne mleko w proszku, odczynnik blokujący | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Wersja 3.21.0 |
| Gotowy żel SDS-PAGE, gradient 4%–20% | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / autorzy pROC | https://cran.r-project.org/package=pROC | Wersja 1.19.0.1 |
| Mieszanina inhibitorów proteaz, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| System transferu białek | Producent/model niepodany w manuskrypcie | Niepodano | Nieudokumentowano: dokładny producent, model oraz adres URL produktu; zgadane zastosowanie: transfer na membranę PVDF 0,22-μm |
| Membrana PVDF, 0,22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Wersja 4.5.2 |
| randomForest | CRAN / autorzy randomForest | https://cran.r-project.org/package=randomForest | Wersja 4.7-1.2 |
| Urządzenie do PCR w czasie rzeczywistym | Roche Diagnostics | LightCycler 96 | Wersja oprogramowania niepotwierdzona. Objętość projektu/cykle różnią się od zgłoszonego protokołu; dokładne powiązanie z eksperymentem wymaga weryfikacji. |
| Chłodzona mikrocentryfuga | Producent/model niepodany w manuskrypcie | Niepodano | Nieudokumentowano: dokładny producent, model oraz adres URL produktu; zgadane zastosowanie: 12 000 × g przez 15 min w 4 °C |
| rentrez | CRAN / autorzy rentrez | https://cran.r-project.org/package=rentrez | Wersja 1.2.4 |
| Bufor do lizy RIPA, wysokostężony | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| System elektroforezy SDS-PAGE | Producent/model niepodany w manuskrypcie | Niepodano | Nieudokumentowano: dokładny producent, model oraz adres URL produktu; zgadane zastosowanie: rozdział białek na żelach gradientowych 4%–20% |
| Seurat | Satija Lab / twórcy Seurat | https://satijalab.org/seurat/ | Wersja 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Wersja 2.10.0 |
| Homogenizator tkankowy | Producent/model niepodany w manuskrypcie | Niepodano | Nieudokumentowano: dokładny producent, model oraz adres URL produktu; zgadane zastosowanie: homogenizacja tkanki w lodowatym buforze do lizy |
| Odczynnik TriQuick do ekstrakcji całkowitego RNA | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Ultra-przezroczyste płaskie nakrętki do pasków probówek PCR 0,2 mL | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Uniwersalny zestaw RT-PCR (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / autorzy WGCNA | https://cran.r-project.org/package=WGCNA | Wersja 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Bibliografia
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.