Aqui descrevemos um protocolo para a imunoprecipitação eficiente de cromatina (ChIP) seguido por sequenciamento de DNA do elevado-throughput (ChIP-seq) do tecido adiposo marrom (BAT) isolado de um rato. Este protocolo é apropriado para o mapeamento de modificações do histone e investigando a localização de todo o genoma de proteínas não-histonas de interesse em vivo.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Imunoprecipitação da cromatina do tecido de adiposo marrom murino
Neste artigo
Resumo
Resumo
Processos mais celulares são regulados pela modulação transcriptional de programas específicos de gene. Tal modulação é conseguida através das ações combinadas de uma ampla gama de fatores de transcrição (TFs) e cofactores mediando ativação transcricional ou repressão através de alterações na estrutura da cromatina. Imunoprecipitação da cromatina (ChIP) é uma abordagem útil biologia molecular para mapeamento de modificações do histone e criação de perfil de fatores de transcrição/cofactores ligação ao DNA, assim fornecendo um instantâneo das dinâmicas mudanças nucleares ocorridos durante as diferentes processos biológicos.
Para estudar o Regulamento transcriptional no tecido adiposo, amostras provenientes em vitro culturas de células de imortalizado ou linhas de célula primária muitas vezes são favorecidas em ensaios de ChIP por causa da abundância de material começar e reduziram variabilidade biológica. No entanto, estes modelos representam um instantâneo limitado do estado real da cromatina em organismos vivos. Assim, há uma necessidade crítica para protocolos otimizados executar o ChIP em amostras de tecido adiposo derivadas de modelos animais.
Aqui descrevemos um protocolo para eficiente ChIP-seq de modificações do histone e proteínas não-histonas no tecido adiposo marrom (BAT) isolado de um rato. O protocolo é otimizado para investigar todo o genoma de localização das proteínas de interesse e epigenéticas marcadores no morcego, que é um tecido morfologicamente e fisiologicamente distinto entre os depósitos de gordura.
Introdução
Enquanto o tecido adiposo branco (WAT) é especializado para o armazenamento de energia, o tecido adiposo marrom (BAT) dissipa energia na forma de calor devido a sua habilidade para converter carboidratos e lipídios em energia térmica através de desacoplamento mitocondrial1. Por causa desta função especializada, é necessário para a manutenção da temperatura do corpo em condições fisiológicas e em resposta à exposição fria o depósito de morcego. Enquanto mudanças de expressão do gene durante a diferenciação de morcego e após estresse termogênico têm sido muito estudadas in vivo e in vitro, os mecanismos moleculares subjacentes a essas mudanças têm sido principalmente dissecado em linhas celulares imortalizado e primário pré-adipócitos, com excepção dos vários estudos in vivo2,3,4,5.
Regulamento dos programas de expressão do gene específico através de uma regulação transcricional é conseguido coordenadas mudanças na cromatina estrutura através de transcrição de vários fatores e fatores co ações. Imunoprecipitação da cromatina (ChIP) é uma abordagem valiosa de biologia molecular para investigar o recrutamento desses fatores ao DNA e perfilando as associado mudanças na paisagem da cromatina. Fatores-chave para o sucesso das experiências de ChIP incluem otimizações de reticulação condições e cromatina corte consistência ao longo de diferentes amostras, disponibilidade de matérias-primas adequadas e, principalmente, a qualidade dos anticorpos. Ao executar o ChIP de tecidos, também é importante considerar a heterogeneidade das amostras e otimizar o protocolo para melhorar a eficiência do isolamento de núcleos, com o último sendo um passo particularmente sensível ao trabalhar com tecido adiposo devido a o conteúdo lipídico elevado. Na verdade, técnicas de isolamento molecular de depósitos de todo tecido adiposos são complicadas pela presença de altos níveis de triglicérides, e protocolos devem ser otimizados para aumentar a quantidade de isolamento de cromatina. Finalmente, quando arranjar em sequência do elevado-throughput é realizado após o isolamento do DNA-ChIP, a profundidade de sequenciamento é fundamental para determinar o número de picos que são detectados com confiança.
Aqui, nos referimos às normas de trabalho e orientações gerais para experimentos de ChIP-seq recomendados pelo ENCODE e modENCODE consórcios6 para as melhores práticas, e focamos em uma descrição passo a passo de um protocolo otimizado para ChIP-seq de BAT. O protocolo descrito permite isolamento eficiente da cromatina do tecido adiposo para realizar o sequenciamento de genoma-largo para fatores de ligação a DNA com picos bem definidos, bem como marcas de histona com sinais mais difusos.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
As etapas de manipulação de animais do protocolo foram aprovadas pelo cuidado institucional do Animal e uso Comité (IACUC) da Universidade de Boston.
1. dia 1: Dissecação e preparação de morcego para a imunoprecipitação da cromatina (ChIP)
- Eutanásia em ratos utilizando uma câmara de gás carbônico (CO2) e faz a dissecação imediatamente depois. Pelo de rato de pulverizador com etanol a 70% antes da incisão. Coloque o mouse com as costas virada para cima, em seguida abrir a pele ao longo do pescoço. Localize o taco diretamente sob a pele entre os ombros (interscapulaire; elas aparecem como dois lóbulos, em forma de borboleta, com uma camada fina de gordura branca que precisa ser cuidadosamente removido7).
Nota: Para um 3 meses C57BL/6J rato que se alimenta de uma dieta de comida regular (peso do mouse neste intervalos de idade entre 27 e 30 g), cada lóbulo de morcego é aproximadamente 1 cm de comprimento. O peso total do depósito morcego é aproximadamente 0,15 g em ratos machos e fêmeas. - Use 1 almofada de morcego para 3 ChIPs. Almofadas de morcego múltiplas podem ser processadas simultaneamente até sonication.
- Crosslink cada morcego pad em 10 mL de tampão fosfato salino (PBS) contendo 1% formaldeído durante 15 minutos, girando a 150 rpm, à temperatura ambiente (RT).
- Saciar a reticulação adicionando 2,5 M de glicina a uma concentração final de 125 mM por 5 min, girando a 150 rpm no RT
- Transferir a almofada morcego a 500 µ l de tampão de Lise hipotónica (10 mM HEPES, 1,5 mM de MgCl2, 10 mM KCl, 0.5 mM DTT, 0,2 mM PMSF) e adicionar 2 esferas de aço inoxidável (tamanho: 3,2 mm de diâmetro, consulte Tabela de materiais) para cada pad de morcego. Usar um homogeneizador de grânulo-baseado (consulte Tabela de materiais) para destruir o tecido.
- Começar com 5 minutos na potência máxima. Se necessário, prolongar o tempo até que o tecido é homogeneizado e células únicas são separadas. Transferi as amostras em um novo tubo e centrifugar a 4 ° C a 16.000 x g por 10 min.
- Após a centrifugação, transferir o sobrenadante para um tubo novo e manter o centrifugado no gelo. Centrifugue o sobrenadante a 4 ° C a 16.000 x g durante 10 minutos evitar a perda de células de flutuação. Descartar o sobrenadante final e Resuspenda ambas as pelotas de célula juntos em 300 µ l de tampão de Lise SDS (SDS 1%; EDTA 10 mM; PH Tris-HCl 8, 50mm) com 1 x inibidor da protease (ver Tabela de materiais). Incube no gelo por 10 min.
- Proceda à sonicação os lysates para gerar DNA fragmentos 200-500 pares de bases longas. Depois sonication, remover os resíduos por centrifugação por 10min a 16.000 x g a 4 ° C e verificar o sucesso do sonication através de DNA eletroforese em um gel de agarose 1%. Para um gel de tamanho médio, executado em 120 V; uma boa separação é alcançada após 45 min.
Nota: Otimização de sonication pode ser necessária para atingir o tamanho adequado de fragmentos. Com o sonicador escolhida (ver Tabela de materiais), isto requer 2 vezes em 320 W potência e frequência de 20 KHz para 10 min, usando ciclos de 30 s na/30 s fora. - Diluir a fração sobrenadante 10-fold (volume final é de 3 mL para cada almofada morcego) em tampão de diluição de ChIP (SDS 0,01%; Triton 1,1%; EDTA 1.2 mM; Tris-HCl pH 8, 16,7 mM; NaCl 167 mM) com 1 x inibidor da protease. Reserve 1% desta solução de cromatina (o equivalente a 30 µ l para 3 mL) como a entrada de ChIP. Manter as entradas durante a noite a 4 ° C (até passo 2.4).
Nota: A fração acima irá fornecer a entrada de referência para a quantificação relativa dos immunoprecipitated material em comparação com a quantidade de DNA presente em cada amostra antes da imunoprecipitação. - Adicione o anticorpo de ChIP (consulte Tabela de materiais para os anticorpos utilizados aqui como um exemplo) a 1 mL de solução de cromatina e incubar durante uma noite a 4 ° C, com rotação. Executar paralela imunoprecipitação com correspondente pré-imune IgG, se disponível, ou IgG normal da mesma espécie (ex., regular IgG de coelho, se o anticorpo é produzido em um coelho). Como alternativa, salve 1 mL de solução de cromatina para um controle de não-anticorpo.
Nota: A quantidade ideal de anticorpo deve ser determinada experimentalmente para cada novo anticorpo, se a concentração do anticorpo não é conhecida. Caso contrário, 2 – 5 µ g de anticorpo é uma quantidade razoável de partida para usar. Anticorpos de ChIP-grau de utilização sempre que possível, ou anticorpos que foram validados para a imunoprecipitação.
2. dia 2: Coleção dos complexos imunes
- Adicionar 50 µ l de chorume de 50% de proteína A Agarose aos complexos imunes e incubar durante 1 h a 4 ° C com rotação a 150 rpm.
-
Os grânulos de pelotas por centrifugação por 1 min a 100 x g a 4 ° C. Realize lavagens sequenciais dos grânulos com buffers de aumentar o rigor.
- Primeiro, lave com tampão de lavagem de sal (150 mM NaCl; Tris-HCl pH 8, 20mm; EDTA 2 mM; Triton-X 1%; SDS 0,1%), em seguida, com tampão de lavagem de elevado-sal (500 mM NaCl; Tris-HCl pH 8, 20mm; EDTA 2 mM, Triton-X1%; SDS 0,1%), em seguida, com lavagem LiCl (0,25 M LiCl; Tris-HCl pH 8, 10 mM; EDTA 1 mM; Igepal 1%; deoxicholate 1%) e finalmente com 1 x TE (Tris-HCl pH 8, 10 mM; EDTA).
- Execute todas as lavagens em 0,45 µm colunas filtro centrífugo de PVDF (Tabela de materiais), primeiro transferir os grânulos nas colunas usando 500 µ l de tampão de lavagem de baixo teor de sal. Granule os grânulos nas colunas para 3 min a 2.500 x g. Descartar o escoamento e repetir 1 vez para todos os buffers de lavagem listados na etapa 2.2.1.
- Após concluídas as lavagens, eluir os imunocomplexos adicionando 300 µ l de tampão de eluição 1% SDS, 0.1 M NaHCO3) aos talões peletizada nas colunas. Incube a RT por 30 min em um shaker a 400 rpm. Recolha o eluato por girando para baixo de colunas para 3 min a 2.500 x g em um tubo de fresco.
- Inverta as ligações cruzadas incubando o eluato e insumos coletados na etapa de 1,9 a 65 ° C durante a noite.
3. dia 3: Recuperação de DNA com extração fenol/clorofórmio
- Adicione 300 µ l de fenol: clorofórmio: IAA, 1:1 para o eluato e insumos. Vórtice por 10 s.
- Girar a 4 ° C por 15 min a 21.000 x g. Transferi o sobrenadante para um tubo de fresco. Adicione 3 µ l de glicogênio, 30 µ l de acetato de sódio 3M e 750 µ l de etanol frio de 100%. Vórtice para 10 loja s. a-80 ° C durante 2 h.
- Spin para baixo a 21.000 x g a 4 ° C por 20 min, manter a pelota e descartar o sobrenadante. Pellet de lavagem com 1ml de frio 70% EtOH e spin-down a 21.000 x g a 4 ° C por 5 min. descartar o sobrenadante e secar ao ar livre a pelota.
- Resuspenda o pellet em 70 µ l de água livre de DNAse.
- Prossiga para o passo 4 para testes de ocupação de cromatina em regiões específicas do genoma por reação em cadeia da polimerase quantitativa (qPCR) ou para a etapa 5 para preparar amostras para sequenciamento.
4. análise de ChIP usando qPCR (leitura de Genes de caixa)
- Dilua a entrada de DNA da etapa 3.4 para gerar uma curva de referência padrão. Diluições em série de 1/10, 1/100 e 1/1000 são geralmente suficientes para capturar a escala linear, mas ainda mais diluições podem ser necessárias para amostras mais concentradas.
- Para cada par de primer (aqui, usamos cartilhas direcionamento promotores de NDUFV1 e TOMM20), prepare-se dois conjuntos de reações qPCR: uma usando as amostras diluídas de entrada da etapa 4.1 e um segundo com as amostras de DNA isoladas por imunoprecipitação da etapa 3.4. Realize cada reação em triplicado.
Nota: Reações podem ser configuradas em paralelo para múltiplos genes usando placas de 96 ou 384 poços. - Configurar um volume de reação de 10 μL por poço com 5 μL de mistura de x PCR 2 (Tabela de materiais), 1 μL de primer mix (1 μM primer frente e reverso primer 1 μM) e 4 μL de DNA do ChIP (ou o controle de entrada).
- Brevemente spin para baixo a placa.
- Execute as reações de qPCR em um sistema PCR em tempo real usando o protocolo recomendado pelo fabricante para a deteção de reagente (Tabela de materiais). Aqui nós usamos as seguintes condições: 1) 1s a 95 ° C para 1 ciclo; 2) 1 s a 95 ° C, seguido por 20 s a 60 ° C, durante 45 ciclos; 3) 15 s a 95 ° C seguido de 60 s em 60 ° C, seguido por 15 s a 95 ° C para 1 ciclo.
Nota: Verificar a curva de dissociação: a presença de um pico no jazigo da dissociação térmica sugere um único amplicon é gerada a partir da reação de PCR. Se mais de um pico é visualizado, este é potencialmente indicativa de múltiplos, amplicons específico; Nesse caso, recomendamos o design dos pares alternativos da primeira demão. - Determine a fase linear de amplificação exponencial da reação de PCR para cada cartilha definida pelo cálculo da curva de calibração usando a série de DNA genômico diluído na etapa 4.1. de acordo com o valor de Ct (limiar de ciclo).
- Se o valor de Ct do ADN do ChIP e controle de entrada está dentro do valor de escala linear de Ct, calcule o enriquecimento do ADN do ChIP em relação a entrada, de acordo com o fator de diluição de DNA do ChIP e controle de entrada no passo 4.1.
5. a amplificação do DNA de ChIP para High-throughput sequenciamento (leitura de todo o genoma)
Nota: Esta etapa pode ser terceirizada para uma facilidade do núcleo acadêmico ou comercial sequenciamento companhia quando sequenciamento recursos não estão disponíveis internamente.
- Preparar uma biblioteca de DNA a partir do DNA extraído com uma preparação adequada de biblioteca ChIP kit (veja a Tabela de materiais) seguindo as instruções do fabricante.
- A biblioteca em um sistema de sequenciamento de alto rendimento, usando 50 bp único-extremidade como leitura de sequências (ver Tabela de materiais).
Nota: De acordo com ChIP-seq orientações sugeridas por ENCODE6, recomenda-se um mínimo de 10 milhões de leituras para genomas de mamíferos.
6. análise de dados
- Realize o controle de qualidade em sequenciamento bruto leituras usando FastQC8.
Nota: Métricas de qualidade de sequenciamento comum incluem por qualidade de sequência de base, por conteúdo de sequência de base, por conteúdo de sequência GC, comprimento de sequência e níveis de duplicação de sequência. Geralmente, um índice de qualidade de leitura de Q > 30 em cada posição de base é um indicativo dos resultados do sequenciamento de alta qualidade. A distribuição de conteúdo GC através de todas as leituras mais ou menos deve assemelhar-se uma distribuição normal, com um pico em torno percentagem efectiva de genômica GC conteúda da espécie a. - Remova qualquer contaminação de adaptador de sequenciamento e leituras de baixa qualidade através da leitura aparar utilitário Trimmomatic9.
Nota: Os parâmetros padrão implementado especificam a remoção dos adaptadores dependente de plataforma, remoção das bases de baixa qualidade de esquerda e à direita e o uso de uma janela ampla deslizante 4-base para aparar quando lê a qualidade média por base cai abaixo de um limite especificado. - Alinhe leituras transformadas para o genoma de referência de rato MM1010 com o alinhador Bowtie211 usando parâmetros padrão.
- Filtrar leituras alinhadas por remoção desses com uma qualidade de mapeamento Bowtie2 marcar (MAPQ) de menos de 10 usando Samtools12.
- Determine várias métricas de qualidade pós-alinhamento, tais como porcentagem leituras mapeadas, vertente correlação cruzada, cumulativa Leia cobertura e amostra replicam reprodutibilidade.
Nota: Vários pacotes, incluindo SPP13, ChIPqc14e Deeptools15 estão disponíveis para calcular essas métricas de qualidade. - Realizar análise chamada de pico com um controle de entrada ou amostra de KO apropriada usando o algoritmo (MACS2) de MACS16 com parâmetros padrão.
- Remova qualquer chamados picos que se sobrepõem com conhecidos regiões na lista negra17 da anotação mm10 usando Bedtools18.
Nota: Na lista negra de regiões são áreas no genoma que foram mostradas para ter sinal elevado ou contagens de leitura independente da linha celular ou técnica de sequenciamento. Estas regiões exibem sinais de artefato artificialmente elevados em certas regiões do genoma que podem ser filtradas fora de experimentos de sequenciamento de genoma funcional. Todas as repetições devem ser processadas de forma independente através do encanamento e podem ser usadas para a taxa de descoberta de reprodutibilidade (IDR). IDR é empregado para medir a reprodutibilidade dos resultados entre repetições através do método, conforme descrito por Li, Brown, Huang e Bickel19,20. O método IDR quantitativamente avalia a coerência entre repetições e é recomendado por ENCODE e modENCODE como parte de suas diretrizes de ChIP-seq. - Use picos estatisticamente significativos para várias análises a jusante como gene ontology21,22, enriquecimento ou motivo análise23.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
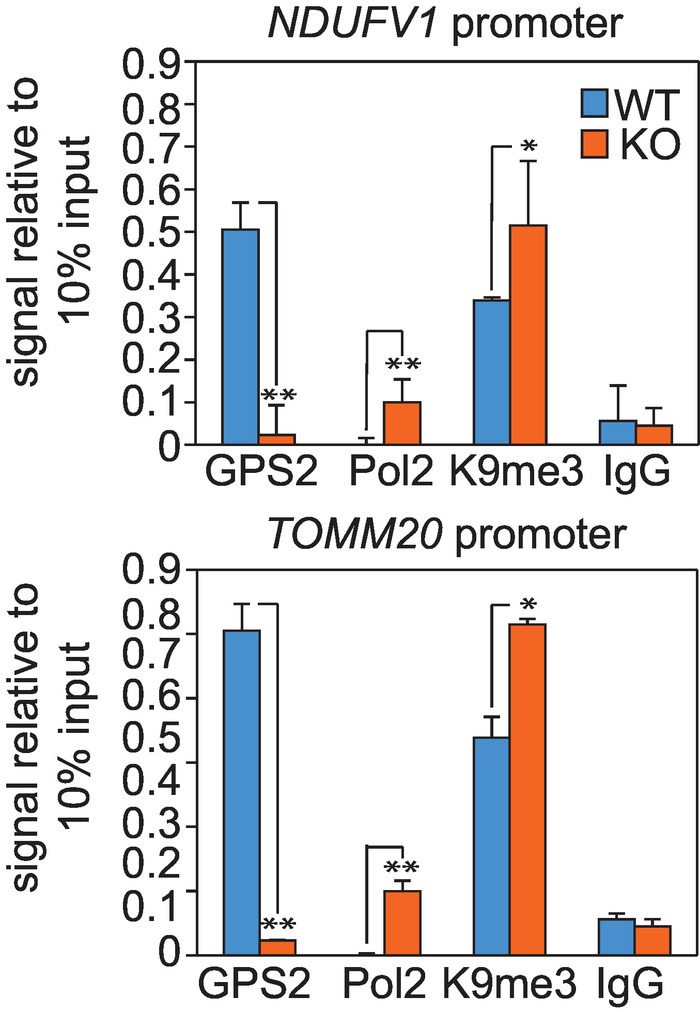
Figura 1: ChIP validação por qPCR. ChIP-qPCR análise de representante GPS2 alvo genes NDUFV1 (à esquerda) e TOMM20 (à direita) no morcego de camundongos WT e GPS2-AKO, mostrando alterações relativas ao nível de metilação de H3K9 e vinculação GPS2 e Pol2. Os gráficos de barras representam a média da amostra de 3 repetições com * p < 0,05 e * * p < 0,01 calculado com ...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
O protocolo descrito aqui representa uma ferramenta valiosa para a realização de ChIP de tecidos murino, especificamente otimizados para marrom de tecido adiposo. Um dos maiores desafios na execução de ChIP de tecido está se recuperando de um número suficiente de células durante a preparação da amostra. Corte o taco usando um liquidificador de homogeneizador de tecidos juntamente com esferas de aço inoxidável em vez de um pilão de vidro canônico significativamente reduz o número de células que perderam devido ao tecido i...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Liquidificador de Tecidos Bullet Blender | Próxima Aventura | BBX24 | |
| 3.2 mm de Diâmetro | Próximo Anúncio | SSB32 | |
| Bioruptor Sonicator | Diagenode | ||
| 1.5 mL Micro Tubo TPX Plástico | Diagenode | C30010010-5 | |
| Inibidor de protease completa | Roche | ||
| Pasta de Agarose Proteína A | Invitrogen | ||
| Anticorpo GPS2 | Em casa | Policlonal de coelho, anticorpo Ct (Cardamone et al., Mol Cell 2018) | |
| Anticorpo Pol2 | Diagenode | C15100055 | |
| anticorpo h3K9me3 | Millipore | 05-1242 | |
| Fast Syber Green Master Mix | Aplicado Biossistema | 4385612 | |
| ViiA7 | Aplicado Biossistema | ||
| TruSeq ChIP Kit de Preparação de Biblioteca | Illumina | IP-202-1012 | |
| HiSeq 2000 | Illumina |
Referências
- Cannon, B., Nedergaard, J. Brown adipose tissue: function and physiological significance. Physiological Reviews. , (2004).
- Cardamone, M. D., et al. Mitochondrial Retrograde Signaling in Mammals Is Mediated by the Transcriptional Cofactor GPS2 via Direct Mitochondria-to-Nucleus Translocation. Molecular Cell. 69, (2018).
- Emmett, M. J., et al. Histone deacetylase 3 prepares brown adipose tissue for acute thermogenic challenge. Nature. , (2017).
- Harms, M. J., et al. PRDM16 binds MED1 and controls chromatin architecture to determine a brown fat transcriptional program. Genes & Development. , (2015).
- Shapira, S. N., et al. EBF2 transcriptionally regulates brown adipogenesis via the histone reader DPF3 and the BAF chromatin remodeling complex. Genes & Development. , (2017).
- Landt, S. G., et al. ChIP-seq guidelines and practices of the ENCODE and modENCODE consortia. Genome Research. 22, 1813-1831 (2012).
- Liisberg Aune, U., Ruiz, L., Kajimura, S. Isolation and Differentiation of Stromal Vascular Cells to Beige/Brite Cells. Journal of Visualized Experiments. , e50191(2013).
- Andrews, S. FastQC: a quality control tool for high throughput sequence data. , Available from: http://www.bioinformatics.babraham.ac.uk/projects/fastqc (2010).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30, 2114-2120 (2014).
- Genome Browser Gateway. , Available from: https://genome.ucsc.edu/cgi-bin/hgGateway?db=mm10 (2018).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. , 357-359 (2012).
- Li, H., et al. The Sequence alignment/map (SAM) format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Kharchenko, P. V., Tolstorukov, M. Y., Park, P. J. Design and analysis of ChIP-seq experiments for DNA-binding proteins. Nature Biotechnology. 26, 1351-1359 (2008).
- Carroll, T. S., Liang, Z., Salama, R., Stark, R., de Santiago, I. Impact of artifact removal on ChIP quality metrics in ChIP-seq and ChIP-exo data. Frontiers in Genetics. 5, 75(2014).
- Ramírez, F., et al. deepTools2: A next Generation Web Server for Deep-Sequencing Data Analysis. Nucleic Acids Research. , (2016).
- Zhang, Y., et al. Model-based Analysis of ChIP-Seq (MACS). Genome Biology. 9, R137(2008).
- ENCODE Project Consortium. An integrated encyclopedia of DNA elements in the human genome. Nature. 489 (7414), 57-74 (2012).
- Quinlan, A. R., Hall, I. M. BEDTools: a flexible suite of utilities for comparing genomic features. Bioinformatics. 26, 841-842 (2010).
- Li, Q., Brown, J. B., Huang, H., Bickel, P. J. Measuring reproducibility of high-throughput experiments. Annals of Applied Statistics. 5 (3), 1752-1779 (2011).
- Irreproducible Discovery Rate (IDR). , Available from: https://github.com/nboley/idr (2018).
- The Gene Ontology Consortium. Expansion of the Gene Ontology Knowledgebase and Resources. Nucleic Acids Research. 45, D331-D338 (2017).
- Ashburner, M., et al. Gene Ontology: tool for the unification of biology. Nature Genetics. 25, 25-29 (2000).
- Boeva, V. Analysis of Genomic Sequence Motifs for Deciphering Transcription Factor Binding and Transcriptional Regulation in Eukaryotic Cells. Frontiers in Genetics. 7, 24(2016).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Reimpressões e permissões
