Este protocolo orienta os iniciantes em bioinformática através de um pipeline introdutório de análise CUT&RUN que permite aos usuários concluir uma análise inicial e validação dos dados de sequenciamento CUT&RUN. A conclusão das etapas de análise descritas aqui, combinadas com a anotação de pico a jusante, permitirá que os usuários obtenham insights mecanicistas sobre a regulação da cromatina.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de método
Análise Introdutória e Validação de Dados de Sequenciação CUT&RUN
Neste artigo
Resumo
Resumo
A técnica CUT&RUN facilita a detecção de interações proteína-DNA em todo o genoma. As aplicações típicas do CUT&RUN incluem alterações de perfil nas modificações da cauda das histonas ou mapeamento da ocupação da cromatina do fator de transcrição. A adoção generalizada do CUT&RUN é impulsionada, em parte, por vantagens técnicas em relação ao ChIP-seq convencional, que incluem requisitos de entrada de células mais baixos, requisitos de profundidade de sequenciamento mais baixos e maior sensibilidade com sinal de fundo reduzido devido à falta de agentes de reticulação que, de outra forma, mascaram os epítopos de anticorpos. A adoção generalizada do CUT&RUN também foi alcançada por meio do compartilhamento generoso de reagentes pelo laboratório Henikoff e do desenvolvimento de kits comerciais para acelerar a adoção para iniciantes. À medida que a adoção técnica do CUT&RUN aumenta, a análise e a validação do sequenciamento CUT&RUN tornam-se gargalos críticos que devem ser superados para permitir a adoção completa por equipes predominantemente de laboratório úmido. A análise CUT&RUN normalmente começa com verificações de controle de qualidade em leituras de sequenciamento bruto para avaliar a profundidade do sequenciamento, a qualidade da leitura e possíveis vieses. As leituras são então alinhadas a uma montagem de sequência do genoma de referência e várias ferramentas de bioinformática são posteriormente empregadas para anotar regiões genômicas de enriquecimento de proteínas, confirmar a interpretabilidade dos dados e tirar conclusões biológicas. Embora vários pipelines de análise in silico tenham sido desenvolvidos para suportar a análise de dados CUT&RUN, sua complexa estrutura de vários módulos e o uso de várias linguagens de programação tornam as plataformas difíceis para iniciantes em bioinformática que podem não ter familiaridade com várias linguagens de programação, mas desejam entender o procedimento de análise CUT&RUN e personalizar seus pipelines de análise. Aqui, fornecemos um protocolo de pipeline de análise CUT&RUN passo a passo de linguagem única, projetado para usuários com qualquer nível de experiência em bioinformática. Este protocolo inclui a conclusão de verificações críticas de qualidade para validar se os dados de sequenciamento são adequados para interpretação biológica. Esperamos que seguir o protocolo introdutório fornecido neste artigo, combinado com a anotação de pico a jusante, permita que os usuários extraiam insights biológicos de seus próprios conjuntos de dados CUT&RUN.
Introdução
A capacidade de medir as interações entre proteínas e DNA genômico é fundamental para entender a biologia da regulação da cromatina. Ensaios eficazes que medem a ocupação da cromatina para uma determinada proteína fornecem pelo menos duas informações importantes: i) localização genômica e ii) abundância de proteínas em uma determinada região genômica. Rastrear as mudanças de recrutamento e localização de uma proteína de interesse na cromatina pode revelar loci alvo direto da proteína e revelar papéis mecanicistas dessa proteína em processos biológicos baseados em cromatina, como regulação da transcrição, reparo do DNA ou replicação do DNA. As técnicas disponíveis hoje para traçar o perfil das interações proteína-DNA estão permitindo que os pesquisadores explorem a regulação com uma resolução sem precedentes. Tais avanços técnicos foram possibilitados pela introdução de novas técnicas de perfil de cromatina que incluem o desenvolvimento de Clivagem sob Alvos e Liberação Usando Nuclease (CUT & RUN) pelo laboratório Henikoff. O CUT&RUN oferece várias vantagens técnicas em relação à imunoprecipitação convencional da cromatina (ChIP) que incluem menores requisitos de entrada de células, menores requisitos de profundidade de sequenciamento e maior sensibilidade com sinal de fundo reduzido devido à falta de agentes de reticulação que, de outra forma, mascaram os epítopos de anticorpos. A adoção desta técnica para estudar a regulação da cromatina requer uma compreensão completa do princípio subjacente à técnica e uma compreensão de como analisar, validar e interpretar os dados do CUT&RUN.
O procedimento CUT&RUN começa com a ligação das células à Concanavalina A conjugada a esferas magnéticas para permitir a manipulação de números baixos de células durante todo o procedimento. As células isoladas são permeabilizadas usando um detergente neutro para facilitar a introdução de um anticorpo que tem como alvo a proteína de interesse. A nuclease microcócica (MNase) é então recrutada para o anticorpo ligado usando uma etiqueta de proteína A ou proteína A / G ligada à enzima. O cálcio é introduzido para iniciar a atividade enzimática. A digestão da MNase resulta em complexos mononucleossômicos de DNA-proteína. O cálcio é subsequentemente quelatado para encerrar a reação de digestão, e fragmentos curtos de DNA da digestão da MNase são liberados dos núcleos e, em seguida, submetidos à purificação do DNA, preparação da biblioteca e sequenciamento de alto rendimento1 (Figura 1).
Abordagens in silico para mapear e quantificar a ocupação de proteínas em todo o genoma foram desenvolvidas em paralelo com as abordagens de laboratório úmido usadas para enriquecer essas interações DNA-proteína. A identificação de regiões de sinais enriquecidos (picos) é uma das etapas mais críticas na análise de bioinformática. Os métodos iniciais de análise ChIP-seq usaram algoritmos como MACS2 e SICER3, que empregaram modelos estatísticos para distinguir locais de ligação proteína-DNA genuínos do ruído de fundo. No entanto, o ruído de fundo mais baixo e a resolução mais alta dos dados CUT & RUN tornam alguns programas de chamada de pico empregados na análise ChIP-seq inadequados para a análise CUT & RUN4. Este desafio destaca a necessidade de novas ferramentas mais adequadas para a análise de dados CUT&RUN. O SEACR4 representa uma dessas ferramentas recentemente desenvolvida para permitir chamadas de pico a partir de dados CUT&RUN, superando as limitações associadas às ferramentas normalmente empregadas para a análise ChIP-seq.
As interpretações biológicas dos dados de sequenciamento CUT&RUN são extraídas das saídas a jusante da chamada de pico no pipeline de análise. Vários programas de anotação funcional podem ser implementados para prever a relevância biológica potencial dos picos chamados a partir dos dados do CUT&RUN. Por exemplo, o projeto Gene Ontology (GO) fornece identificação funcional bem estabelecida de genes de interesse 5,6,7. Várias ferramentas e recursos de software facilitam a análise de GO para revelar genes e conjuntos de genes enriquecidos entre os picos CUT&RUN 8,9,10,11,12,13,14. Além disso, softwares de visualização como o Deeptools15, o visualizador de genômica integrativa (IGV)16 e o UCSC Genome Browser17 permitem a visualização da distribuição de sinais e padrões em regiões de interesse em todo o genoma.
A capacidade de extrair interpretações biológicas dos dados do CUT&RUN depende criticamente da validação da qualidade dos dados. Os componentes críticos a serem validados incluem a avaliação de: i) qualidade do sequenciamento da biblioteca CUT&RUN, ii) similaridade replicada e iii) distribuição de sinal em centros de pico. A conclusão da validação de todos os três componentes é crucial para garantir a confiabilidade das amostras da biblioteca CUT&RUN e dos resultados da análise downstream. Portanto, é essencial estabelecer guias introdutórios de análise CUT&RUN para permitir que iniciantes em bioinformática e pesquisadores de laboratório úmido conduzam essas etapas de validação como parte de seus pipelines de análise CUT&RUN padrão.
Juntamente com o desenvolvimento do experimento CUT&RUN de laboratório úmido, vários pipelines de análise in silico CUT&RUN, como CUT&RUNTools 2.018,19, nf-core/cutandrun20 e CnRAP21, foram desenvolvidos para apoiar a análise de dados CUT&RUN. Essas ferramentas fornecem abordagens poderosas para analisar conjuntos de dados CUT&RUN e CUT&Tag de célula única e em massa. No entanto, a estrutura modular relativamente complexa do programa e a familiaridade necessária com várias linguagens de programação para conduzir esses pipelines de análise podem dificultar a adoção por iniciantes em bioinformática que buscam entender completamente as etapas de análise do CUT&RUN e personalizar seus próprios pipelines. A evasão dessa barreira requer um novo pipeline de análise introdutório do CUT&RUN que é fornecido em scripts simples passo a passo codificados usando uma única linguagem de programação simples.
Neste artigo, descrevemos um protocolo simples de pipeline de análise CUT&RUN de linguagem única que fornece scripts passo a passo suportados com descrições detalhadas para permitir que usuários novos e novatos realizem análises de sequenciamento CUT&RUN. Os programas usados neste pipeline estão disponíveis publicamente pelos grupos de desenvolvedores originais. As principais etapas descritas neste protocolo incluem alinhamento de leitura, chamada de pico, análise funcional e, mais criticamente, etapas de validação para avaliar a qualidade da amostra para determinar a adequação e confiabilidade dos dados para interpretação biológica (Figura 2). Além disso, esse pipeline oferece aos usuários a oportunidade de cruzar os resultados da análise com os conjuntos de dados CUT&RUN disponíveis publicamente. Em última análise, este protocolo de pipeline de análise CUT&RUN serve como um guia introdutório e referência para iniciantes em análise de bioinformática e pesquisadores de laboratório úmido.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
NOTA: As informações para os arquivos fastq CUT&RUN em GSE126612 estão disponíveis na Tabela 1. As informações relacionadas aos aplicativos de software utilizados neste estudo estão listadas na Tabela de Materiais.
1. Baixando o pipeline Easy-Shells_CUTnRUN de sua página do Github
- Abra o terminal do sistema operacional.
NOTA: Se o usuário não tiver certeza de como abrir o terminal no macOS e no Windows, revise esta página da Web (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Para Linux, revise esta página da Web (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Baixe o pipeline de análise compactado do Github digitando wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip no terminal.
- Depois de baixar o arquivo zip, descompacte o arquivo zip baixado digitando unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ no terminal.
- Após a descompactação, exclua o arquivo zip digitando rm ~/Desktop/Easy-Shells_CUTnRUN.zip no terminal e altere o nome da pasta digitando mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN.
- Depois de remover o arquivo compactado, digite chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh no terminal para definir a permissão executável para todos os scripts de shell dentro do diretório de trabalho. A partir de agora, basta digitar o caminho e o nome desses scripts de shell no terminal ou arrastar os scripts para o terminal e entrar para executar esses scripts de shell no terminal.
NOTA: O shell Bash normalmente é pré-instalado na maioria das distribuições Linux. No entanto, as versões recentes do macOS não fornecem mais o shell Bash pré-instalado. Se o sistema não tiver o Bash, instale o shell do Bash primeiro. Visite os links abaixo para obter instruções sobre como instalar o shell Bash no sistema operacional Linux (https://ioflood.com/blog/install-bash-shell-linux/) e macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following:). Esses scripts de shell passo a passo são escritos para criar uma pasta ~/Desktop/GSE126612 para executar a maior parte dessa análise CUT&RUN dentro deste diretório sem qualquer necessidade de modificação. Se o usuário entender como usar esses scripts de shell, os usuários podem revisar e personalizar esses scripts de shell para analisar outros conjuntos de dados do CUT&RUN e modificar as opções de acordo com as necessidades específicas do projeto. Para ler e editar esses scripts de shell, considere usar o Visual Studio Code (https://code.visualstudio.com/) como uma opção para um programa fácil de usar disponível para os principais sistemas operacionais.
2. Instalando os programas necessários para o Easy Shells CUTnRUN
- Entre os scripts de shell com o nome de Script_01_installation_***.sh, descubra o script de shell cujo nome inclui o tipo de sistema operacional do sistema do usuário. Atualmente, o Easy Shells CUTnRUN suporta o script de instalação para sistemas baseados em macOS, Debian/Ubuntu e CentOS/RPM.
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- No terminal, opere o script de shell de instalação digitando ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh ou arraste o arquivo de script de shell para o terminal e digite.
- Leia o arquivo Test_README.md na pasta /path/to/SEACR-1.3/Testfiles. Siga as instruções no arquivo README para esclarecer se o SEACR no sistema do usuário funciona corretamente.
NOTA: É crucial validar a função SEACR com arquivos de teste fornecidos pela página do SEACR no Github para obter resultados de chamada de pico adequados a partir dos dados CUT&RUN. Portanto, siga as instruções do Test_README.md em /path/to/SEACR-1.3/Testfiles imediatamente após a instalação do SEACR. Embora o Easy Shells CUTnRUN forneça scripts de shell de instalação para alguns sistemas operacionais, esses scripts podem não funcionar no sistema de alguns usuários para instalar todos os programas necessários para o Easy Shells CUTnRUN. Se houver algum problema na instalação, revise o site original do programa desinstalado ou solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
3. Fazer o download do conjunto de dados CUT&RUN disponível publicamente do Sequence Read Archive (SRA)
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script irá: (i) Criar uma pasta (~/Desktop/GSE126612/fastq) e baixar uma lista de arquivos SRA escritos em um arquivo de texto (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) dentro da pasta fastq. Como exemplo, o SRR_list.txt inclui os arquivos fastq do subconjunto de GSE126612 amostras CUT&RUN. (ii) Baixe os arquivos fastq brutos dentro da pasta fastq. (iii) Crie uma pasta (~/Desktop/GSE126612/log/fastq) e anote um arquivo de log (download-fastq_log.txt) e um arquivo de informações de amostra baixado (SRR_list_info.txt) dentro desta pasta de log. - Depois de executar o script, verifique o arquivo de log. Se houver alguma mensagem de erro no arquivo de log, corrija o erro e tente a etapa 3.3 novamente. Se houver algum problema para resolver o problema, peça ajuda na página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Para facilitar a prática deste pipeline de análise CUT&RUN, as seguintes amostras disponíveis publicamente são recuperadas do SRA: uma amostra de controle simulado (IgG), três amostras de uma arquitetura de cromatina e proteína do fator de transcrição (CTCF), quatro amostras correspondentes a uma marca de histona 'ativa' (H3K27Ac) e três amostras correspondentes a regiões de iniciação transcricional marcadas por RNA polimerase II (RNAPII-S5P). O sequenciamento foi realizado como extremidade emparelhada, portanto, dois arquivos são pareados por amostra.
4. Verificação de qualidade inicial para os arquivos de sequenciamento brutos
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh no terminal ou arraste o script de shell para o terminal e digite.
NOTA: Este script de shell irá: (i) Executar o programa FastQC para todos os arquivos fastq brutos na pasta ~/Desktop/GSE126612/fastq e salvar os arquivos de relatório de verificação de qualidade na pasta ~/Desktop/GSE126612/fastqc.1st . (ii) Anote um arquivo de log (fastqc.1st.log.SRR-number.txt) por uma execução do FastQC em uma pasta de log (~/Desktop/GSE126612/log/fastqc.1st). - Após a conclusão da execução do script de shell, revise o arquivo de log para esclarecer o sucesso da execução. Se houver alguma mensagem de erro no arquivo de log, corrija o erro e repita a etapa 4.3. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Entre os arquivos de saída, fastqc.html arquivos incluem resultados de verificação de qualidade fáceis de usar. Se houver problemas graves de qualidade, discuta com colegas de bioinformática para determinar a adequação dos dados para análise posterior. Relatórios de controle de qualidade semelhantes são usados para confirmar a qualidade de dados aprimorada após o corte do adaptador. Para usar esse script para outros conjuntos de dados, edite o caminho dos diretórios de trabalho e de saída para atender às necessidades do usuário. Uma diferença notável ao interpretar o QC do CUT&RUN em comparação com as leituras do ChIP-seq é que as leituras duplicadas no CUT&RUN não indicam necessariamente duplicatas de PCR. Isso ocorre porque a MNase recrutada será digerida no mesmo local ou em locais semelhantes dentro dos grupos experimentais.
5. Qualidade e ajuste do adaptador para arquivos de sequenciamento brutos
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh no terminal ou arraste o script Script_04_trimming.sh para o terminal e digite.
NOTA: Este script de shell irá: (i) Executar o programa Trim-Galore para todos os arquivos fastq brutos em ~/Desktop/GSE126612/fastq para executar o ajuste do adaptador e da qualidade. (ii) Crie uma pasta (~/Desktop/GSE126612/trimmed) e salve os arquivos de saída do Trim-Galore dentro da pasta cortada. (iii) Crie uma pasta de log (~/Desktop/GSE126612/log/trim_galore) e anote um arquivo de log trim_galore_log_RSS-number.txt por uma execução do Trim-Galore. - Após a conclusão da execução, revise o arquivo de log com cuidado. Se houver alguma mensagem de erro no arquivo de log, corrija o erro e repita a etapa 5.3. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
- Após a conclusão deste processo, compare os arquivos de saída .html com os arquivos fastqc.html criados em 4.3. Revise o caminho dos diretórios de entrada e saída para executar a etapa de corte para quaisquer arquivos fastq localizados em outro lugar.
6. Baixando o índice bowtie2 para os genomas de referência para amostras de controle reais e de pico
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh no terminal ou arraste o script de shell para o terminal e digite.
NOTA: Este script irá: (i) Baixar índices Bowtie2 para genomas de referência de amostra reais (humano; hg19; usado na publicação original22) e genomas de referência de controle Spike-in (levedura em brotamento; R64-1-1) na pasta bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Anote um arquivo de log (bowtie2-index-log.txt) em um diretório de log (~/Desktop/GSE126612/log/bowtie2-index). - Após a conclusão da execução, verifique o arquivo de log. Se houver alguma mensagem de erro, corrija o erro e repita a etapa 6.3. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Atualmente, os índices Bowtie2 para vários genomas de referência são fornecidos no site Bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Os usuários podem editar Script_05_bowtie2-index.sh para baixar qualquer índice Bowtie2 para atender aos requisitos do usuário. Se o usuário não conseguir localizar o índice Bowtie2 do genoma de referência de interesse, localize os arquivos fasta da sequência do genoma de referência em:- Ensembl ftp (https://ftp.ensembl.org/pub/current_fasta/)
- Página da UCSC (https://hgdownload.soe.ucsc.edu/downloads.html)
- ou outros bancos de dados específicos da espécie.
Depois de localizar os arquivos fasta da sequência do genoma de referência, crie um índice Bowtie2 para o genoma de referência baixado seguindo a seção "O indexador bowtie2-build" (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) do site Bowtie2.
7. Mapeamento de leituras de sequenciamento CUT&RUN aparadas para os genomas de referência
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script de shell irá: (1) Executar o programa bowtie2 para mapear todos os arquivos fastq cortados do adaptador e da qualidade para controle experimental (humano; hg19) e pico (levedura de brotamento; R64-1-1) genomas de referência independentemente. (ii) Execute a função de visualização samtools para compactar os arquivos de pares de leitura mapeados no formato bam. (iii) Crie uma pasta (~/Desktop/GSE126612/bowtie2-mapped) e salve o arquivo de pares de leitura mapeados compactados dentro da pasta bowtie2-mapped. (iv) Crie uma pasta (~/Desktop/GSE126612/log/bowtie2-mapped) e anote o log do processo de mapeamento como bowtie2_log_hg19_SRR-number.txt de arquivo de texto para pares de leitura mapeados no genoma de referência hg19 e bowtie2_log_R64-1-1_SRR-number.txt para pares de leitura mapeados em R64-1-1) para indicar a eficiência do mapeamento dentro da pasta de log de mapeamento bowtie2. - Após a conclusão da execução, verifique o arquivo de log. Se houver alguma mensagem de erro no arquivo de log, corrija o erro e execute o script de shell novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Este script de shell executa bowtie2 com opções para mapear arquivos de sequenciamento de extremidade emparelhada para encontrar pares de leitura mapeados concordantemente com comprimentos de fragmento de 10 bp-700 bp. Descubra as descrições das opções digitando bowtie2 --help no terminal ou visitando o site da gravata borboleta2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner) para entender e alterar as opções conforme necessário. Use este script de shell para mapear quaisquer outros arquivos fastq alterando o formato de caminho e nome dos arquivos fastq e dos índices Bowtie2.
8. Classificando e filtrando os arquivos de pares de leitura mapeados
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando "chsh -s $(which bash)" no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script irá: (i) Executar a função de visualização samtools para todos os arquivos de pares de leitura mapeados compactados na pasta ~/Desktop/GSE126612/bowtie2-mapped para filtrar pares de leitura mapeados em regiões cromossômicas não canônicas, lista negra anotada publicamente e regiões de repetição TA. (ii) Execute a função de classificação samtools para classificar os arquivos bam filtrados por nomes de fragmentos ou coordenadas dentro do mesmo diretório. (iii) Anote um arquivo de log por um arquivo bam de entrada no diretório ~/Desktop/GSE126612/log/filter-sort-bam . - Após a conclusão da execução, revise os arquivos de log com cuidado. Se houver alguma mensagem de erro nos arquivos de log, corrija o erro e tente executar o script de shell novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Os arquivos bam resultantes (saída) classificados por nomes de fragmentos servirão como arquivos de entrada para criar arquivos bedGraph de fragmentos e readcounts brutos. Os arquivos bam classificados por coordenadas servirão como arquivos de entrada para gerar arquivos BEDPE de fragmento. Todos os BED, bedGraph e BEDPE serão usados para chamadas de pico e visualização na análise downstream. Todos os arquivos de leito de anotação para regiões cromossômicas canônicas (chr1~22, chrX, chrY e chrM), regiões de lista negraanotadas publicamente 23 e regiões de repetição TA18 estão localizadas no diretório ~/Desktop/Easy-Shells_CUTnRUN/blacklist . Se necessário, use este diretório para adicionar arquivos de lista negra adicionais. Use este script de shell para executar as mesmas funções para outros arquivos bam de pares de leitura mapeados, alterando o caminho e o nome dos arquivos bam. Digite samtools view --help e samtools sort --help no terminal para obter mais descrições sobre essas funções.
9. Converta pares de leitura mapeados em arquivos bedGraph de fragmento BEDPE, BED e readcounts brutos
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script irá: (i) Executar macs3 filterdup e awk function para converter arquivos bam classificados por coordenadas em arquivos BEDPE de fragmento cujos comprimentos de fragmento são menores que 1kb e salvar os arquivos BEDPE em ~/Desktop/GSE126612/BEDPE. (ii) Crie um diretório de log (~/Desktop/GSE126612/log/bam-to-BEDPE) e anote um arquivo de log por arquivo de fragmentos de leituras mapeadas. (iii) Execute as funções bedtools bamtobed e awk, cut, sort para converter arquivos bam classificados por nomes de fragmentos em arquivos BED de fragmentos cujos comprimentos de fragmento são menores que 1 kb. (iv) Crie uma pasta (~/Desktop/GSE126612/bam-to-bed) e salve os arquivos BED de fragmento dentro da pasta bam-to-bed. (v) Anote um arquivo de log por arquivo BED de fragmentos de leituras mapeadas em um diretório de log (~/Desktop/GSE126612/log/bam-to-bed). (vi) Execute a função bedtools genomecov para gerar arquivos bedGraph readcounts brutos usando os arquivos BED de fragmento em uma pasta (~/Desktop/GSE126612/bedGraph). - Após a conclusão da execução, verifique os arquivos de log com cuidado. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Os arquivos bedGraph de readcounts brutos de saída serão usados como arquivos de entrada para o programa de chamada de pico SEACR com opção de normalização na seção 12 e normalização de contagem de leitura fracionária em escala (SFRC)22 na seção 10. Os arquivos BED de fragmento servirão como arquivos de entrada para leituras mapeadas normalizadas por milhão de Spike-in na normalização de controle negativo (SRPMC)24,25 na seção 10.To capturar fragmentos curtos (>100 bp) apenas para dados CUT&RUN de fatores associados à cromatina, alterar a etapa de filtragem de fragmentos neste script e prosseguir com a etapa de normalização. Para comparar os sinais CUT & RUN entre fragmentos de tamanho curto e regular dentro da mesma amostra, a normalização SFRC pode ser útil para reduzir o efeito potencial de redução da amostragem causado pela captura apenas de fragmentos curtos. Use este script de shell para executar os mesmos processos para outros arquivos bam classificados sequenciados de extremidade emparelhada, alterando o formato de caminho e nome dos arquivos bam e bed.
10. Convertendo arquivos bedGraph readcounts brutos em arquivos bedGraph e bigWig normalizados
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar for-loop com a função awk para criar arquivos bedGraph normalizados SFRC usando arquivos bedGraph readcounts brutos em ~/Desktop/GSE126612/bedGraph. (ii) Execute a função bedGraphToBigWig para criar o formato compactado (.bw) dos arquivos bedGraph normalizados do SFRC em ~/Desktop/GSE126612/bigWig. (iii) Anote um arquivo de log para registrar o fator de normalização usado para o cálculo do SFRC por execução e salve o arquivo de log em ~/Desktop/GSE126612/log/SFRC. - Após a conclusão da execução, verifique os arquivos de log. Se houver alguma mensagem de erro, corrija o erro e execute o script de shell novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: A normalização de contagem de leitura fracionária em escala foi usada na publicação original22 de GSE126612 conjunto de dados CUT&RUN. A fórmula da normalização no compartimento i é a mesma abaixo: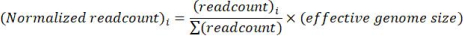
Como esse método de normalização não inclui normalização com controle negativo (por exemplo, amostra de IgG) nem controle de pico, essa abordagem pode não ser ideal para observar a diferença de sinal em todo o genoma entre as amostras. No entanto, como esse método é teoricamente semelhante a outras normalizações baseadas em readcounts totais (por exemplo, Contagem por milhão), seria bom o suficiente observar a diferença de sinal local entre as amostras. - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script irá: (i) Executar for-loop com a função bedtools genomecov para criar arquivos de gráfico de leito normalizados SRPMC em ~/Desktop/GSE126612/bedGraph usando arquivos BED de fragmento em ~/Desktop/GSE126612/bam-to-bed. (ii) Anote um arquivo de log para registrar os fatores de normalização usados para a normalização SRPMC por uma execução em ~/Desktop/GSE126612/log/SRPMC. (iii) Execute a função bedGraphToBigWig para criar o formato compactado (.bw) dos arquivos bedGraph normalizados e salve os arquivos bigWig normalizados na pasta ~/Desktop/GSE126612/bigWig . - Após a conclusão da execução, revise os arquivos de log com cuidado. Se houver alguma mensagem de erro nos arquivos de log, corrija o erro e execute o script de shell novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: A fórmula de normalização SRPMC foi desenvolvida para normalizar as contagens de leitura de amostras reais com controle negativo (amostra de IgG, por exemplo) e controle de pico, combinando o fator de normalização RPM (leituras por milhão de leituras mapeadas), RPS (proporção de leituras por leitura de pico) e razão de sinal relativo para controle24,25. A definição de RPS é a mesma abaixo:
Ao aplicar RPS para amostra real e amostra de controle negativo, a razão de sinal relativo (RS) para controle para amostra real pode ser calculada como abaixo: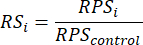
E a definição do fator de normalização RPM (RPM:NF) é a mesma abaixo: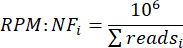
A partir daqui, o fator de normalização SRPMC (SRPMC:NF) saiu combinando o RS e o RPM:NF: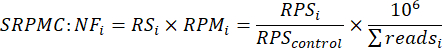
E esta fórmula pode ser simplificada da seguinte forma:
Portanto, o método SRPMC normaliza as leituras pela (1) proporção de leituras de pico entre o controle e a amostra e (2) leituras de controle normalizadas por RPM. Uma vez que esse fator de normalização considera leituras de pico e torna as leituras de controle comparáveis entre as amostras, esse método seria apropriado para observar a diferença em todo o genoma entre as amostras e reduzir o efeito do lote no total de leituras de amostras reais e controles em diferentes experimentos em lote. Esses arquivos bedGraph normalizados se tornarão arquivos de entrada para chamar picos usando o SEACR na seção 11. E esses arquivos bigWig normalizados serão usados na visualização de loci por meio de IGV e na criação de mapa de calor e gráfico médio via Deeptools. É altamente recomendável usar um navegador de genoma para visualizar o padrão de paisagem do conjunto de dados CUT&RUN usando os arquivos bigWig normalizados em regiões genômicas representativas para avaliar a qualidade dos dados. As amostras CUT&RUN que exibem padrões de sinal de fundo ruidosos que se assemelham ao controle de IgG provavelmente são apropriadas para omitir para análises posteriores. Use esses scripts de shell para normalizar outros arquivos de leito de leitura e arquivos bedGraph de readcounts brutos, alterando o caminho e os nomes de arquivo para arquivos de entrada e saída de bedgraph e bedgraph. Edite esses scripts para aplicar outros cálculos de normalização alterando os fatores e a fórmula dentro desse script.
11. Validando a distribuição do tamanho do fragmento
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado em: (i) Execute picard.jar função CollectInsertSizeMetrics usando arquivos bam de pares de leitura mapeados na pasta ~/Desktop/GSE126612/filtered-bam para identificar a distribuição do tamanho da inserção. (ii) Crie uma pasta (~/Desktop/GSE126612/insert-size-distribution) e salve os resultados da análise de distribuição de tamanho de inserção na pasta criada. (iii) Anote um arquivo de log por um arquivo bam de entrada na pasta ~/Desktop/GSE126612/log/insert-size-distribution . - Após a conclusão da execução, verifique os arquivos de log com cuidado. Se houver alguma mensagem de erro nos arquivos de log, corrija o erro e tente executar o script de shell novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Em geral, a análise do tamanho da inserção (Saída) para amostras CUT&RUN mostra picos principais em faixas de tamanho nucleossômico mono (100-300 pb) e di (300-500 pb). Erros/limitações técnicas (como digestão excessiva/insuficiente da MNase durante a preparação da amostra CUT&RUN ou seleção inadequada do tamanho durante a preparação da biblioteca) podem causar o enriquecimento de fragmentos iguais ou maiores que os trinucleossômicos (500-700 pb) e iguais ou menores que os fragmentos subnucleossômicos (<100 pb). Às vezes, a ausência de picos de tamanho mononucleossômico com o enriquecimento dos fragmentos longos (>500 pb) e curtos (<100 pb) pode ser devido às faixas de seleção de tamanho de biblioteca escolhidas no estágio de laboratório úmido ou à baixa profundidade de sequenciamento. Compare a profundidade do sequenciamento ('bases sequenciadas totais' / 'tamanho total do genoma de referência'), a visão geral do cenário genômico usando arquivos bigWig de readcounts normalizados na seção 10 e o padrão de distribuição do tamanho da inserção para esclarecer a qualidade das amostras CUT&RUN processadas. As linhas tracejadas nos histogramas representam a 'fração cumulativa' de leituras com um tamanho de inserção maior ou igual ao valor no eixo x. Essa linha tracejada permite a identificação da distribuição dos tamanhos de inserção no arquivo de leituras mapeadas de entrada. A progressão ao longo do eixo x está associada ao aumento do tamanho da pastilha. A linha tracejada identifica a proporção de pares de leitura mapeados no arquivo bam de entrada que têm um tamanho de inserção pelo menos tão grande quanto o indicado na posição do eixo x de interseção. Portanto, a interpretação começa em 1 à esquerda, indicando que todas as leituras têm um tamanho de inserção maior ou igual ao menor tamanho, e diminui para 0 à medida que o tamanho da inserção aumenta.
12. Picos de chamada usando MACS2, MACS3 e SEACR
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar as funções macs2 callpeak e macs3 callpeak com e sem controle IgG usando arquivos BEDPE de fragmento para chamar picos e salvar os resultados de chamada de pico em diretórios de saída (~/Desktop/GSE126612/MACS2 e ~/Desktop/GSE126612/MACS3). (ii) Anote o log dessas chamadas de pico como arquivo de texto no diretório de log (~/Desktop/GSE126612/log/MACS2 e ~/Desktop/GSE126612/log/MACS3) - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar SEACR_1.3.sh script com e sem controle IgG, com opções rigorosas e relaxadas usando readcounts brutos bedGraph e arquivos bedGraph normalizados para chamar picos. (ii) Crie o diretório de saída (~/Desktop/GSE126612/SEACR-peaks) e salve os resultados da chamada de pico por SEACR. (iii) Anote o registro dessas chamadas de pico como arquivo de texto no diretório de log (~/Desktop/GSE126612/log/SEACR). - Após a conclusão da execução de scripts de shell, verifique os arquivos de log com cuidado. Se houver alguma mensagem de erro nos arquivos de log, corrija o erro primeiro. Alguns programas podem não chamar picos para amostra de controle de IgG com opção de controle de IgG juntos, portanto, omitir a mensagem de erro sobre a amostra de controle de IgG com opção de controle de IgG. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Esses dois scripts de shell executam chamadas de pico para amostras CUT&RUN usando três chamadores de pico (MACS2, MACS3 e SEACR) com várias opções: com/sem opção de controle IgG, usando arquivos bedGraph readcounts brutos com opção de normalização do chamador de pico ou arquivos bedGraph readcounts normalizados sem opção de normalização do chamador de pico e opções de chamada de pico SEACR rigorosas e relaxadas. Como os arquivos de saída de chamada de pico não são suficientes para serem usados diretamente em análises downstream, o Easy Shells CUTnRUN inclui um script para processar esses arquivos de saída de picos chamados para criar novos arquivos de pico que incluem cromossomo, início, fim e nome dos picos. Por meio de abordagens intensivas de chamadas de pico, o Easy Shells CUTnRUN oferece a oportunidade de escolher o programa de chamadas de pico mais adequado para o projeto CUT&RUN de um usuário, comparando os picos chamados em três chamadores de pico. Além disso, este pipeline de análise CUT&RUN também oferece a oportunidade de selecionar as opções de chamada de pico mais adequadas para o projeto CUT&RUN de um usuário. Essas comparações serão feitas por diagrama de Venn, e visualização como mapa de calor e gráfico médio.
13. Criando arquivos de cama de pico chamados
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Execute a função awk usando arquivos de cama na pasta ~/Desktop/GSE126612/SEACR para criar dois tipos de arquivos de cama de pico SEACR ~/Desktop/GSE126612/peak-bed_SEACR pasta. Todos os arquivos de leito de pico incluem o início e o fim de cada pico, e os arquivos de leito de pico focados incluem o início e o leito do compartimento de sinal mais alto dentro de cada pico. (ii) Execute a função awk usando arquivos _peaks.xls nas pastas ~/Desktop/GSE126612/MACS2 e ~/Desktop/GSE126612/MACS3 para criar arquivos de cama de pico inteiros que incluem o início e o fim de cada pico chamado por MACS2 e MACS3 nas pastas ~/Desktop/GSE126612/peak-bed_MACS2 e ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) Execute a função awk usando arquivos _summits.bed nas pastas ~/Desktop/GSE126612/MACS2 e ~/Desktop/GSE126612/MACS3 para criar arquivos de cama de pico focados que incluem o início e o fim do compartimento mais significativo dentro de cada pico. (iv) Os arquivos de log são gravados em formato de arquivo de texto na pasta ~/Desktop/GSE126612/log/peak-bed . - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar a função de interseção de ferramentas de cama usando arquivos de cama de pico que são chamados sem a opção de controle IgG para remover picos sobrepostos aos picos de controle IgG. (ii) Os arquivos de cama de pico filtrados são salvos nas pastas ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 e ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) Um arquivo de log log_filter-peaks.txt é criado na pasta ~/Desktop/GSE126612/log/filter-peaks . - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar as funções cat e sort para concatenar os arquivos de cama de pico inteiros MACS2 e MACS3 das replicações como um arquivo de cama de pico e classificar o arquivo de cama de pico concatenado na pasta ~/Desktop/GSE126612/bed-for-comparison. (ii) Execute a função de mesclagem de bedtools usando os arquivos de leito de pico inteiros concatenados para mesclar picos que se sobrepõem. (iii) Um arquivo de log log_cat-merged-peak-bed_MACS.txt é escrito na pasta de log ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar as funções cat e sort para concatenar os arquivos de leito de pico SEACR inteiros das réplicas como um arquivo de leito de pico e classificar o arquivo de leito de pico concatenado na pasta ~/Desktop/GSE126612/bed-for-comparison. (ii) Execute a função de mesclagem de bedtools usando os arquivos de leito de pico inteiros concatenados para mesclar picos que se sobrepõem. (iii) Um arquivo de log log_cat-merged-peak-bed_SEACR.txt é gravado na pasta de log ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Após a conclusão da execução dos scripts de shell, revise os arquivos de log com cuidado. Se houver alguma mensagem de erro nos arquivos de log, corrija o erro e execute o(s) script(s) novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Todos os arquivos de leito de pico das regiões de pico serão usados como arquivos de entrada da análise do diagrama de Venn para comparar a semelhança entre opções de chamada de pico, métodos de chamada de pico, réplicas e observações de paisagem genômica próximas às regiões de pico. Os arquivos de leito de pico de regiões de pico inteiras mesclados serão usados para análise de componente principal (PC) e análise de correlação de coeficiente de Pearson usando deeptools. Os arquivos de leito de pico focados serão usados para análise de mapa de calor e gráfico médio usando Deeptools.
14. Validação da similaridade entre réplicas usando correlação de Pearson e análise de componentes principais (PC).
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, os usuários poderão ver o seguinte: /path/to/bash (ou uma mensagem semelhante, como /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, pule esta etapa.
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar a função multiBamSummary BED-file usando os arquivos bam de replicações, que foram classificados por coordenadas, e mesclar arquivos de leito de pico inteiros para CTCF, H3K27Ac e RNAPII-S5P para gerar arquivos de matriz para análise de correlação Pearson na pasta Desktop/GSE126612/deeptools_multiBamSummary . (ii) Execute a função plotCorrelation usando os arquivos de matriz para realizar o cálculo do coeficiente de correlação de Pearson e o agrupamento do mapa de calor e salve o resultado na pasta ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Anote um arquivo de log log_plotCorrelation.txt na pasta ~/Desktop/GSE126612/log/correlação . - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar a função multiBamSummary BED-file usando os arquivos bam, que foram classificados por coordenadas, e mesclar arquivos de leito de pico inteiros, que incluem todos os picos CTCF, H3K27ac e RNAPII-S5P, para gerar arquivos de matriz para análise de componentes principais (PCA) na pasta Desktop/GSE126612/deeptools_multiBamSummary . (ii) Execute a função plotPCA usando os arquivos de matriz para executar o PCA e salve o resultado na pasta ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Anote um arquivo de log log_plotPCA.txt na pasta ~/Desktop/GSE126612/log/correlação . - Após a conclusão da execução de scripts de shell, verifique os arquivos de log. Se houver alguma mensagem de erro, corrija o erro e execute os scripts de shell novamente. Se houver algum problema para resolver o problema, solicite assistência usando a página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Em princípio, as réplicas adequadamente preparadas e processadas mostram valores mais altos de coeficiente de correlação de Pearson dentro do mesmo grupo de agrupamento e posicionamento próximo na análise de componentes principais. Qualquer replicação, que mostre um coeficiente de correlação de Pearson mais baixo e longa distância de outras réplicas no gráfico de componentes principais, pode representar um potencial outlier entre as replicações. Este script de shell é aplicável a qualquer formato bam mapeado lê dados. Altere o caminho e o nome do arquivo dos arquivos bigwig para atender aos requisitos específicos do projeto.
15. Validação da similaridade entre replicados, métodos de chamada de pico e opções usando diagrama de Venn
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, pode haver algo como /path/to/bash (por exemplo, /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, considere pular esta etapa
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é escrito para: (i) Executar a função intervenn usando arquivos de leito de pico de toda a região de pico para encontrar sobreposições entre os picos chamados por várias opções (com/sem opção de controle IgG, com/sem normalização e opções de chamada de pico rigorosas/relaxadas para SEACR). (ii) Crie uma pasta (~/Desktop/GSE126612/intervene_methods) e salve os resultados da análise do diagrama de Venn nesta pasta. (iii) Anote um arquivo de log log_intervene_methods.txt na pasta ~/Desktop/GSE126612/log/interven . - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é escrito para: (i) Executar a função intervenn usando arquivos de leito de pico de toda a região de pico para encontrar sobreposições entre os picos das replicações. (ii) Crie uma pasta (~/Desktop/GSE126612/intervene_replicates) e salve os resultados da análise do diagrama de Venn nesta pasta. (iii) Anote um arquivo de log log_intervene_replicates.txt na pasta ~/Desktop/GSE126612/log/interven . - Após a conclusão da execução dos scripts de shell, revise os arquivos de log. Se houver alguma mensagem de erro, corrija o erro e execute os scripts de shell novamente. Se houver algum problema no uso do pipeline de análise Easy Shells CUTnRUN, peça ajuda na página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Esses resultados da análise do diagrama de Venn fornecem informações para escolher as opções de chamada de pico, métodos e réplicas mais apropriados com alta reprodutibilidade para análise downstream. Pode ser preferível escolher as opções e métodos de chamada de pico que mostram os números de pico mais altos com boa sobreposição com outros métodos e opções de chamada de pico.
16. Analisar mapas de calor e gráficos médios para visualizar os picos chamados.
- Abra o terminal e digite echo $SHELL para verificar o shell padrão no terminal ativo. Se o shell Bash for o shell padrão no terminal atual, pode haver algo como /path/to/bash (por exemplo, /bin/bash) no terminal.
- Se o shell padrão não for Bash, defina o shell Bash como shell padrão digitando chsh -s $(which bash) no terminal. Se o terminal usar o shell Bash como padrão, considere pular esta etapa
- Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
NOTA: Este script é gravado para: (i) Executar a função de ponto de referência computeMatrix usando arquivos bigWig normalizados e arquivos de cama de pico focados para criar matrizes de readcounts normalizadas no centro dos picos focados na pasta ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Execute a função plotHeatmap usando a matriz de contagem de leitura normalizada para gerar mapas de calor e gráficos médios que visualizam o padrão de distribuição de contagem de leitura normalizada nos locais de pico focados. (iii) Crie uma pasta (~/Desktop/GSE126612/deeptools_plotHeatmap) e salve os arquivos de saída plotHeatmap dentro desta pasta. (iv) Anote um arquivo de log log_plotHeatmap_focused.txt na pasta ~/Desktop/GSE126612/log/plotHeatmap . - Digite ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh no terminal ou arraste o arquivo de script de shell para o terminal e digite.
Este script é gravado para: (i) Executar a função de ponto de referência computeMatrix usando arquivos bigWig normalizados e arquivos de cama de pico inteiros para criar matrizes de readcounts normalizadas no centro de todos os picos na pasta ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Execute a função plotHeatmap usando a matriz de contagem de leitura normalizada para gerar mapas de calor e gráficos médios que visualizam o padrão de distribuição de contagem de leitura normalizado em todos os locais de pico. (iii) Crie uma pasta (~/Desktop/GSE126612/deeptools_plotHeatmap) e salve os arquivos de saída plotHeatmap dentro desta pasta. (iv) Anote um arquivo de log log_plotHeatmap_whole.txt na pasta ~/Desktop/GSE126612/log/plotHeatmap . - Após a conclusão da execução dos scripts de shell, revise os arquivos de log. Se houver alguma mensagem de erro, corrija o erro e execute os scripts de shell novamente. Se houver algum problema no uso do pipeline de análise Easy Shells CUTnRUN, peça ajuda na página de problemas do GitHub do Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Idealmente, os locais de pico do cume dos picos MACS2 / 3 e os locais de pico focados dos SEACR exibem uma distribuição de sinal nítida e focada no centro dos gráficos. No entanto, se o algoritmo de chamada de pico não funcionar corretamente para dados CUT & RUN, uma distribuição de sinal "ruidosa" menos focada pode aparecer nos gráficos. Portanto, o uso do número de picos chamados e os padrões de distribuição de sinal de pico dos gráficos de saída orientará a determinação da validade de pico para análises CUT & RUN adicionais que incluem anotação de pico a jusante.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
A qualidade e o corte do adaptador retêm leituras com alta qualidade de sequenciamento
As técnicas de sequenciamento de alto rendimento são propensas a gerar erros de sequenciamento, como 'mutações' de sequência nas leituras. Além disso, os dímeros do adaptador de sequenciamento podem ser enriquecidos em conjuntos de dados de sequenciamento devido à remoção inadequada do adaptador durante a preparação da biblioteca. Erros excessivos de sequenciamento, como mutações de leitura, geração de leituras mais...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
A capacidade de mapear a ocupação de proteínas na cromatina é fundamental para a realização de estudos mecanísticos no campo da biologia da cromatina. À medida que os laboratórios adotam novas técnicas de laboratório úmido para traçar o perfil da cromatina, a capacidade de analisar dados de sequenciamento desses experimentos de laboratório úmido torna-se um gargalo comum para cientistas de laboratório úmido. Portanto, descrevemos um protocolo introdutório passo a passo para permitir que ...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores declaram não divulgar.
Agradecimentos
Todas as figuras ilustradas foram criadas com BioRender.com. O CAI reconhece o apoio fornecido por meio de um Prêmio de Investigador em Início de Carreira da Ovarian Cancer Research Alliance, um Forbeck Foundation Accelerator Grant e o Prêmio Nacional de Pesquisa de Detecção Precoce da Minnestoa Ovarian Cancer Alliance.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Software para compactar e converter readcounts bedGraph para bigWig |
| The Quinlan Lab @ U. of Utah | https://bedtools.readthedocs.io/en/latest/index.html | Software para processar arquivos bam/bed/bedGraph | |
| bowtie2 2.5.4 | Universidade | Johns Hopkinshttps://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Software para construir índice de gravata borboleta e realizar alinhamento |
| CollectInsertSizeMetrics (Picard) | Broad institute | https://github.com/broadinstitute/picard | Software para realizar análise de distribuição de tamanho de inserção |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Software para realizar o corte do adaptador |
| Deeptoolsv3.5.1 | Max Planck Institute | https://deeptools.readthedocs.io/en/develop/index.html | Software para realizar análise de correlação de coeficiente de Pearson, análise de componentes principais e análise de mapa de calor/gráfico médio |
| FastQC Versão 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Software para verificar a qualidade do arquivo fastq |
| Interventionv0.6.1 | Biologia Computacional & Regulação gênica - Grupo Mathelier | https://intervene.readthedocs.io/en/latest/index.html | Software para realizar análise de diagrama de Venn usando arquivos de pico |
| MACSv2.2.9.1 | Iniciativa de Chan Zuckerberg | https://github.com/macs3-project/MACS/tree/macs_v2 | Software para chamar picos |
| MACSv3.0.2 | Iniciativa de Chan Zuckerberg | https://github.com/macs3-project/MACS/tree/master | Software para chamar picos |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Software para processar arquivos sam/bam |
| SEACRv1.3 | Howard Hughes Medial institute | https://github.com/FredHutch/SEACR | Software para chamar picos |
| SRA Toolkit Release 3.1.1 | NCBI https://github.com/ncbi/sra-tools Software para baixar SRR do GEO | ||
| Trim_Galore v0.6.10 | de https://github.com/FelixKrueger/TrimGalore | Bioinformática Babraham | para realizar corte de qualidade e atapter |
Referências
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Reimpressões e permissões
