Abordando problemas de fragmentação de textos jurídicos e de rastreamento de vieses em inteligência artificial (IA) médica, este estudo constrói um grafo de conhecimento jurídico e emprega convolução de grafo com foco em relações para alinhamento semântico. Ele identifica fontes de viés por meio de retropropagação baseada em gradiente, com métricas experimentais favoráveis que apoiam uma aplicação de IA médica em conformidade.
Artigo de investigação
Construção de Grafos de Conhecimento Jurídico e Rastreamento de Viés em Inteligência Artificial Médica Baseada em Redes Neurais Gráficas
Neste artigo
Resumo
Resumo
Na análise de conformidade legal em inteligência artificial (IA) médica, este artigo aborda a ambiguidade na determinação de responsabilidade causada pela fragmentação semântica de textos jurídicos heterogêneos de múltiplas fontes e pelas dificuldades em rastrear vieses algorítmicos. Propõe-se um método de construção de grafo de conhecimento e detecção de caminhos de propagação de viés com base em redes neurais em grafo. Quatro tipos de nós heterogêneos — cláusulas legais, comportamentos médicos, módulos de algoritmos e partes responsáveis — são estruturados e codificados, e um grafo direcionado é construído com base em quatro tipos de relações semânticas jurídicas: "violação", "base", "disparo" e "atribuição". Em seguida, utiliza-se uma rede convolucional em grafo com percepção de relações, combinada com pesos específicos por tipo de aresta e um mecanismo de atenção, para alcançar o alinhamento de características em múltiplas camadas para semântica jurídica multimodal. Depois, emprega-se retropropagação baseada em gradiente para identificar arestas que contribuem significativamente para o viés, construir um subgrafo de propagação de viés e utilizar descoberta de comunidades para localizar aglomerados de nós raiz. Por fim, fluxos de decisão em tempo real são mapeados para nós temporários, a conformidade é verificada por meio de similaridade de incorporação, e a dinâmica dos pesos das arestas-chave é monitorada para alertar sobre o acúmulo sistêmico de viés. Os experimentos mostram que, em termos de precisão no alinhamento semântico, o método proposto alcança uma precisão média no alinhamento de entidades de pelo menos 0,92 e uma completude média na preservação de relações de pelo menos 0,88 em diferentes gradientes de densidade do grafo de conhecimento. Em relação à capacidade de localização de viés, a taxa de revocação dos nós raiz atinge 0,95±±0,02 e a precisão do caminho de propagação alcança 0,93±±0,03. Esta pesquisa, até certo ponto, consegue um acoplamento profundo entre lógica jurídica e comportamento algorítmico, fornecendo um sistema de apoio à conformidade explicável e verificável para a implantação confiável de IA médica.
Introdução
A profunda atuação da IA médica no diagnóstico, no suporte ao tratamento, na alocação de recursos e na avaliação de riscos vinculou sua tomada de decisões à suposição de responsabilidade legal1,2. As normas jurídicas são altamente estruturadas, mas semanticamente distribuídas, e o comportamento dos sistemas de IA pode ser uma caixa preta, sem uma interface semanticamente alinhável e rastreável entre os dois3. Nesse contexto, o desenvolvimento de um framework comum de representação que capture cadeias causais jurídicas dentro de sequências comportamentais algorítmicas surgiu como um facilitador necessário para viabilizar a atribuição fina de responsabilidade e a conformidade dinâmica4,5. Este estudo não está relacionado apenas aos testes jurídicos de sistemas tecnológicos, mas também envolve a manutenção profunda da equidade médica, da equidade algorítmica e da confiança institucional, possuindo, portanto, grande significado teórico e urgência prática.
A questão fundamental na análise de conformidade legal de IA médica hoje é a ausência de uma estrutura conectiva computável entre a semântica jurídica e o comportamento algorítmico6,7. Documentos legais estão disponíveis como texto simples, e as relações entre parágrafos estão entrelaçadas com dependências, conflitos e exceções, o que gera problemas ao dividi-los em unidades lógicas que possam ser interpretadas por máquinas8,9. Embora a tomada de decisão do sistema de IA esteja encapsulada em uma caixa preta baseada em dados, nenhuma de suas variações de saída pode ser rastreada até violações específicas de obrigações legais ou nós para atribuição de responsabilidade10,11. Essa desconexão (por exemplo, viés nos dados de treinamento, falhas no design do modelo ou a interpretação semântica de normas jurídicas) não pode ser isolada experimentalmente para identificar a origem do viés ou esclarecer as obrigações legais para desenvolvedores, implantadores ou usuários12,13. Ainda mais problemático, os procedimentos de conformidade existentes apenas verificam se uma saída final atende a uma especificação fixa, sem considerar o caminho de propagação ou a amplificação do viés na rede de interações entre "direito e tecnologia"14,15. Quando a IA médica está sujeita a múltiplas disposições legais simultaneamente, e o sistema produz uma cadeia de erros devido à má interpretação de uma cláusula, as abordagens convencionais não conseguem rastrear como o erro se difunde por outras disposições relacionadas e, em seguida, alcança a responsabilização16,17. Além disso, há uma falta de mecanismo de correlação dinâmica entre o fluxo de decisões em tempo real e o grafo de conhecimento jurídico existente, resultando em avaliação tardia da conformidade durante a operação do sistema, impedindo assim o monitoramento proativo da tendência de acumulação de viés18,19. Esses problemas em conjunto levam à incerteza na determinação de responsabilidade, atribuição frágil e intervenção regulatória tardia, o que inibe significativamente a implantação confiável de sistemas de IA de alto risco na saúde e a aplicação da responsabilização jurídica.
Acima de tudo, estudos tradicionais de pesquisa analisam textos jurídicos em forma estruturada e constroem bases de conhecimento de domínios específicos com ontologias ou regras, a fim de apoiar perguntas e respostas sobre conformidade ou notificação de riscos20,21. Embora essas abordagens possam capturar representações de alguns conceitos jurídicos, elas tendem a pressupor a lógica interna do direito como coerente e estática, dificultando o tratamento de inconsistências entre jurisdições, exceções ou formulações vagas. Trabalhos posteriores introduziram tecnologias de processamento de linguagem natural, utilizando modelos linguísticos pré-treinados para extrair entidades e relações jurídicas, ampliando a abrangência da cobertura na extração de conhecimento22,23, mas ainda permanecem em um nível semântico superficial, falhando em estabelecer uma interface de mapeamento entre comportamentos jurídicos e técnicos. Em termos de governança de viés algorítmico, a pesquisa concentrou-se principalmente no desenho de restrições de equidade24,25, cujos indicadores de avaliação geralmente se baseiam em variáveis demográficas, carecendo de alinhamento com os princípios jurídicos de atribuição. Mesmo alguns estudos tentaram codificar regras jurídicas como restrições e incorporá-las ao treinamento do modelo26,27, mas devido à rigidez e granularidade grosseira da expressão das regras, é difícil adaptá-las a situações clínicas complexas. De modo geral, os trabalhos existentes tratam a conformidade legal como uma tarefa externa de verificação, e não como um atributo computável intrínseco da arquitetura do sistema. Isso faz com que a lógica jurídica e a lógica algorítmica operem em paralelo, sem apoiar o raciocínio conjunto e a intervenção dinâmica nos caminhos de propagação de viés.
Nos últimos anos, as redes neurais gráficas vêm sendo gradualmente introduzidas no campo médico devido à sua capacidade explícita de modelar estruturas relacionais28,29. Alguns estudos utilizam grafos heterogêneos para integrar jurisprudência, dispositivos legais e informações sobre as partes, apoiando recomendações de casos ou previsões de sentenças por meio de incorporações de nós30,31, verificando assim a eficácia das estruturas gráficas na captura de conexões jurídicas. Outros trabalhos abstraem componentes algorítmicos como nós do grafo, utilizando arestas para representar fluxos de dados ou relações de chamada, com o objetivo de rastrear a propagação de erros32,33. Essas explorações demonstram que as estruturas gráficas podem atuar como suporte comum para elementos jurídicos e tecnológicos. No entanto, os modelos gráficos existentes apresentam geralmente três limitações: primeiro, restringem-se a um único tipo de relação de aresta, não conseguindo distinguir entre diferenças normativas, causais e de atribuição na semântica jurídica; segundo, o processo de agregação de características ignora os pesos semânticos dos tipos de aresta, fazendo com que diferentes caminhos lógicos jurídicos sejam tratados de forma igual; e terceiro, carecem de um mecanismo diferenciável para rastreamento da propagação de vieses, impossibilitando a localização de arestas de alta contribuição e a reconstrução de caminhos de responsabilidade. Este artigo propõe uma rede convolucional gráfica sensível a relações, que resolve o problema da fusão de heterogeneidade semântica ao atribuir uma matriz de transformação dedicada a cada tipo de aresta semântica jurídica e introduzir um mecanismo de atenção para ajustar dinamicamente o fluxo de informações entre diferentes tipos. Além disso, combinando retropropagação de gradientes e extração de subgrafos, permite um salto interpretável do julgamento de conformidade em nível macro ao rastreamento de vieses em nível micro, superando o gargalo dos modelos gráficos tradicionais, que apenas suportam raciocínio estático.
Além do domínio médico, avanços recentes em métodos baseados em grafos e evolutivos demonstraram ampla aplicabilidade no processamento de conhecimento estruturado. Por exemplo, Xue et al. propuseram uma abordagem híbrida multilayer de programação genética para construção adaptativa de características de similaridade no alinhamento de ontologias, alcançando um alinhamento robusto entre grafos de conhecimento heterogêneos34. Cheng et al. realizaram uma revisão abrangente das aplicações de redes convolucionais em grafos na restauração de imagens, categorizando sistematicamente métodos para redução de ruído, super-resolução e remoção de desfoque35. Li et al. apresentaram uma análise detalhada sobre aprendizado profundo evolutivo sob a perspectiva da aprendizagem automática automatizada, abrangendo princípios, algoritmos, aplicações e desafios em aberto36. Ma et al. desenvolveram um framework de busca arquitetural neural difusa para reconhecimento de defeitos sob incerteza, demonstrando a eficácia da busca evolutiva no tratamento de dados ambíguos37. Esses estudos destacam o potencial da integração de representações baseadas em grafos e otimização evolutiva para tarefas complexas de tomada de decisão.
O objetivo principal deste artigo é estabelecer um framework interpretável de ponta a ponta para análise de conformidade legal em IA médica, com inovações em três níveis. No nível de representação do conhecimento, é a primeira proposta a modelar cláusulas legais, práticas médicas, módulos de algoritmos e partes responsáveis como quatro tipos de nós heterogêneos. Com base na prática jurídica, extrai quatro tipos de relações direcionadas: "violação", "base", "gatilho" e "atribuição", construindo um grafo de conhecimento direcionado com lógica causal jurídica, fornecendo uma base semântica estruturada para a análise de conformidade. Na rastreabilidade da origem do viés, sugere um método de quantificação da contribuição das arestas baseado na sensibilidade do gradiente. Por meio da retropropagação, identifica o conjunto de arestas que maximiza o viés na saída e, em seguida, aplica um algoritmo de descoberta de comunidades para agrupar nós de alta contribuição, transformando o "viés caixa-preta" em "agrupamentos brancos de responsabilidade", o que permite a atribuição com base em uma cadeia de evidências operacional. No nível de monitoramento dinâmico em tempo real, desenvolve um mecanismo temporário de incorporação de nós de decisão que mapeia as saídas em tempo real da IA no espaço do grafo de conhecimento. Com base na comparação da proximidade das incorporações, quantifica o grau de desvio normativo e monitora a variação do peso daquelas arestas jurídico-técnicas essenciais, a fim de sinalizar o acúmulo de viés sistêmico. Esse paradigma resolve tanto os dilemas de fragmentação semântica quanto de rastreabilidade e transforma a conformidade legal de uma verificação a posteriori em uma governança a priori, oferecendo um caminho técnico escalável para a transparência da responsabilidade em sistemas de IA de alto risco.
Protocolo
Construção de rede neural gráfica para grafo de conhecimento jurídico em inteligência artificial médica
Conforme mostrado na Figura 1, o framework proposto compreende três módulos principais. A camada de entrada integra dados multissource em um grafo heterogêneo por meio da codificação de entidades multimodais e modelagem de arestas direcionadas. Em seguida, a camada GCN com percepção de relações realiza o alinhamento semântico cruzado de modalidades por meio de pesos e atenção específicos a tipos, produzindo incorporações unificadas de nós. Por fim, essas incorporações suportam o rastreamento de vieses (por meio de retropropagação de gradiente e detecção de comunidades) e o monitoramento dinâmico de conformidade (por meio de mapeamento em tempo real de nós e rastreamento de pesos de arestas), com a saída fornecendo evidências de atribuição interpretáveis e alertas de risco para os reguladores.
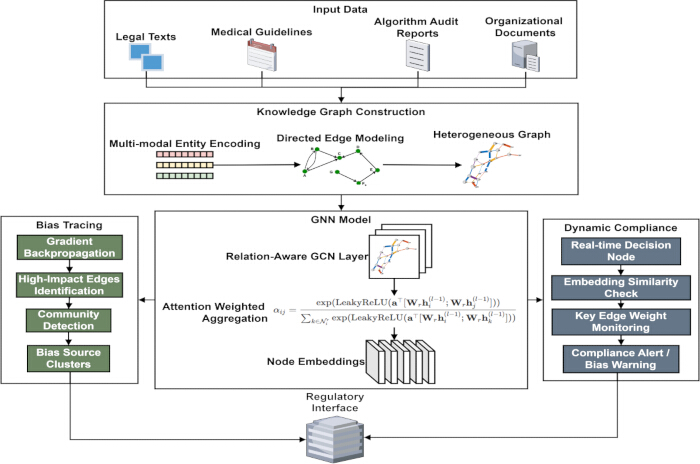
Figura 1: Grafo de conhecimento jurídico e arquitetura de rastreamento de vieses para inteligência artificial médica. Este diagrama ilustra o fluxo de trabalho geral do framework proposto. A camada de entrada integra dados heterogêneos de múltiplas fontes (textos jurídicos, diretrizes clínicas, relatórios de auditoria de algoritmos), que são codificados em quatro tipos de entidade (cláusulas jurídicas, comportamentos médicos, módulos de algoritmo, partes responsáveis) e conectados por quatro relações jurídico-semânticas direcionadas (violação, base, gatilho, atribuição). A camada GCN com percepção de relações realiza o alinhamento semântico multimodal por meio de pesos e atenção específicos a cada tipo. O módulo de rastreamento de vieses utiliza retropropagação de gradiente para identificar arestas de alta contribuição e, em seguida, aplica detecção de comunidades para localizar aglomerados de nós principais. O monitor de conformidade dinâmico mapeia decisões em tempo real para nós temporários, avalia a similaridade dos embeddings em relação às cláusulas jurídicas e rastreia a evolução dos pesos das arestas para alertas precoces. As saídas incluem evidências interpretáveis de atribuição e alertas de risco. Clique aqui para visualizar uma versão maior desta figura.
Codificação estruturada de grafo heterogêneo de entidades jurídicas e relações
Quatro entidades fundamentais são consistentemente derivadas de leis regulatórias de IA médica, diretrizes de prática clínica e relatórios de auditoria de algoritmos: cláusulas legais, procedimentos médicos, módulos de algoritmos e entidades responsáveis. Propõe-se um modelo separado de aprendizado de representação de características para cada tipo de entidade, de modo que sejam semanticamente distinguíveis. Os nós das cláusulas legais são organizados para conter o número da cláusula legal, o qual é usado como um ID (identificador) exclusivo para a cláusula legal. Ao mesmo tempo, define-se um índice de quantificação da gravidade da penalidade para indicar o nível de responsabilidade legal associado à cláusula, e, consequentemente, estabelece-se um vetor de características.
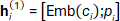 (1)
ci é o número da entrada, Emb(·) representa o mapeamento de incorporação de baixa dimensão e [·;·] representa a operação de concatenação de vetores. Essa representação preserva tanto a estrutura formal quanto a gravidade da punição do texto jurídico, apoiando o raciocínio entre declarações.
Os nós de comportamento médico são padronizados e codificados com base em um sistema de classificação de operações clínicas, extraindo seu nível de risco rj ∈ {1,2,3} e o conjunto de rótulos de cenários aplicáveis sj ⊂ S, onde S é o conjunto completo de categorias de cenários predefinidas. A codificação multi-hot é utilizada para processar o conjunto de rótulos, e ela é concatenada com a incorporação do nível de risco para formar uma representação inicial:
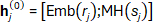 (2)
Essa estratégia garante que diferentes tipos de comportamentos médicos tenham relações de distância mensuráveis no espaço vetorial, permitindo comparações entre cenários distintos. A função de incorporação de texto Emb(·) é implementada utilizando o modelo de linguagem jurídica chinesa pré-treinado Lawformer (pré-treinado em um corpus jurídico chinês de grande escala), com a dimensão de saída fixada em 768.
Com base nas dependências lógicas e nas restrições legais entre entidades, são estabelecidos quatro tipos de relações semânticas direcionadas: "violação", "base", "disparo" e "atribuição", cada um correspondendo a diferentes padrões legais de causalidade. Cada aresta eij ⊂ E recebe um tipo de rótulo tij ⊂ T = {violate, base, trigger, attribute} para a transmissão de mensagens subsequente com percepção das relações. A construção das arestas segue rigorosamente o mecanismo de correspondência de regras do domínio: quando um comportamento médico se desvia dos requisitos normativos, estabelece-se uma aresta de "violação" apontando do nó de comportamento para a cláusula legal relevante; quando a cláusula legal serve como base técnica de conformidade para uma operação, estabelece-se uma aresta de "base"; se a saída do módulo do algoritmo dispara diretamente a execução de um comportamento médico específico, conecta-se uma aresta de "disparo"; a relação de atribuição de responsabilidade é estabelecida com base nos documentos de responsabilidade da organização e nas conclusões de auditoria, criando uma aresta de "atribuição" entre a parte responsável e a violação ou defeito do algoritmo.
Após a inicialização de todos os nós, é formado um grafo heterogêneo (V, E, H0), em que V é o conjunto de nós, E é o conjunto de arestas direcionadas com rótulos de tipo e H0 é a matriz de características inicial. Para aprimorar a capacidade discriminativa semântica da estrutura do grafo, as características dos nós são normalizadas:
 (3)
μk e σk são a média e o desvio padrão da característica do k-ésimo nó no conjunto de treinamento, respectivamente, e ∈ é uma constante pequena para evitar a divisão por zero. A normalização garante que características heterogêneas de múltiplas fontes participem das operações de convolução em grafos em uma escala uniforme, impedindo que efeitos de dominância numérica interfiram na aprendizagem semântica. O modelo de grafo estruturado resultante incorpora plenamente a topologia relacional dos elementos quadridimensionais de lei, comportamento, tecnologia e responsabilidade no sistema de IA médica, fornecendo uma base de grafo computável para a análise subsequente de propagação de viés.
Aprimoramento da alinhamento por convolução de grafos para semântica jurídica multimodal
Uma rede convolucional gráfica com percepção de relações38,39, que estende o framework da Rede Convolucional Gráfica Relacional (R-GCN), é utilizada para propagar características através de múltiplas camadas do grafo heterogêneo inicial. Embora a R-GCN introduza matrizes de transformação por relação para dados relacionais genéricos, nossa abordagem incorpora ainda um mecanismo de atenção treinável para ponderar dinamicamente as contribuições dos vizinhos e define quatro tipos específicos de relações jurídico-semânticas (violação, base, gatilho, atribuição), adaptadas à análise de conformidade em IA médica. A operação de cada camada parametriza independentemente o processo de transformação com base no tipo semântico das arestas. Para qualquer nó alvo, as informações de sua vizinhança são agrupadas e agregadas de acordo com os tipos das arestas que as conectam. Cada tipo de relação é equipado com uma matriz de transformação linear dedicada, a fim de diferenciar as características transmitidas ao longo de diferentes caminhos semânticos jurídicos40,41. Se a aresta entre o nó da cláusula jurídica e o nó do comportamento médico for do tipo "base", quando o nó da cláusula jurídica receber uma mensagem de um nó de comportamento médico, ele aplicará a matriz de pesos correspondente para mapear espacialmente as características do vizinho. Da mesma forma, quando um nó de comportamento médico enviar uma saída por meio do módulo de integração de arestas do tipo "gatilho" a um módulo de algoritmo, a matriz de parâmetros associada a essa relação será acionada e realizará a transformação de características. Isso simula a fluidez de diferentes tipos de lógica jurídica, permitindo ou informando diferentes camadas lógicas manterem a independência semântica durante o fluxo de informações, sem ruído intermodal. A agregação é definida da seguinte forma:
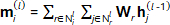 (4)
mi(l) representa a informação abrangente coletada pelo nó i na camada l, Nil é o conjunto de seus vizinhos sob a relação r, Wr é a matriz de transformação linear e hj(l−1) é a representação incorporada do nó vizinho na camada anterior.
Um mecanismo de atenção aprendível é introduzido durante a agregação de mensagens para ajustar dinamicamente a intensidade da influência de diferentes nós vizinhos na atualização da representação do nó alvo42,43. O coeficiente de atenção é gerado com base nos dois fatores: similaridade de atributos dos nós e importância legal, sem depender de pesos prévios fixos. Para nós de cláusulas legais, ao receber características de comportamentos médicos vizinhos, a pontuação de atenção é calculada com base no valor quantificado da intensidade da penalidade associada a esses comportamentos; quando o nó do módulo algorítmico funde informações de comportamentos médicos, ele se concentra nos vizinhos com níveis mais altos de risco operacional. O peso de atenção é calculado da seguinte maneira:
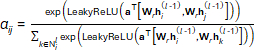 (5)
αij é o coeficiente de atenção do nó j para o nó i, e a é o vetor de atenção treinável. Este modelo permite a identificação automática de caminhos conectados de alto risco ou alta restrição durante o treinamento ponta a ponta, atribuindo-lhes maior atenção. O embedding final do nó atualizado é determinado por mensagens ponderadas e conexões residuais.
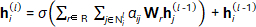 (6)
σ é a função de ativação, e o design residual mitiga o problema de desaparecimento do gradiente na propagação profunda e garante estabilidade na presença de múltiplos conflitos semânticos. Após L = 3 camadas convolucionais em grafos (cada uma com uma dimensão oculta de 256 e ativação ReLU), os embeddings de todos os nós incorporam de forma contínua informações contextuais multimodais e tornam-se representações unificadas com capacidade de discriminação semântica legal.
Dois diagramas alternativos de análise de conformidade legal para a IA na área da saúde são apresentados na Figura 2, com o objetivo de abordar a visualização dos tipos de relações jurídicas e rotas de propagação de vieses, indicando fontes potenciais de viés nessa tomada de decisão. Figura 2A exibe a influência de diversas relações semânticas jurídicas, onde quatro tipos de relações são codificados por cores, e para cada tipo as arestas são diferenciadas por uma cor distinta. A espessura da aresta corresponde ao peso de atenção dessa relação específica, ou seja, o quanto essa relação contribui para a decisão da IA. Uma aresta grossa indica essencialmente uma relação jurídica dominante na decisão, sendo que, neste caso, ela foi suficiente para justificar o resultado do caso. O tamanho do nó é medido pela sua contribuição para violações: nós maiores indicam uma relação mais forte entre a conduta e cláusulas jurídicas específicas, e, portanto, maior risco potencial. A visualização acima fornece uma camada semântica jurídica clara, o que nos permite identificar os caminhos jurídicos mais fortes e mais arriscados na tomada de decisão da IA. Figura 2B também indica caminhos de alta contribuição (para a propagação de vieses), com ênfase nas arestas de alta contribuição, que são destacadas em negrito e acompanhadas por linhas tracejadas (por exemplo, B1-B3) no processo de tomada de decisão. O aumento do dobro da largura dessas arestas representa sua importância na disseminação de vieses sistêmicos. Quais combinações de regras jurídicas e comportamentos técnicos resultam nesse efeito de amplificação do viés é mostrado na Figura 2. Essa análise não apenas revela o caminho da propagação de vieses, mas também facilita a identificação da origem do viés, com base no qual a auditoria de conformidade e a responsabilidade da ferramenta de IA podem ser estabelecidas.
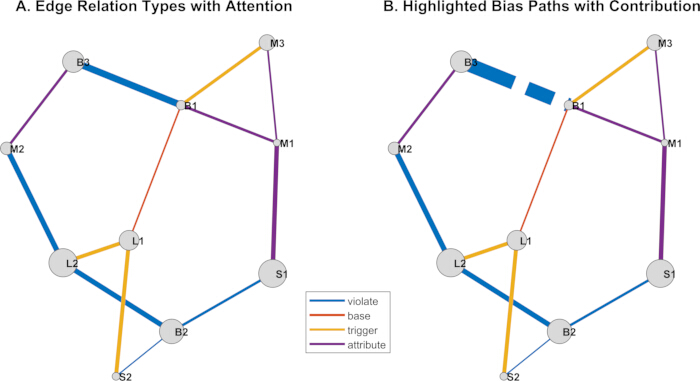
Figura 2: Análise de conformidade legal e propagação de viés em IA para saúde (Exemplo ilustrativo). (A) Relações semânticas legais codificadas por cores: violação (vermelho), base (azul), gatilho (verde), atribuição (laranja). A espessura das arestas é proporcional ao peso de atenção, indicando a influência de cada relação na decisão da IA. O tamanho dos nós é proporcional à sua contribuição para a violação, destacando entidades de risco. (B) Subgrafo de propagação de viés: arestas de alta contribuição estão em negrito e tracejadas (por exemplo, B1‑B3); arestas de largura dupla indicam amplificação de viés sistêmico. Esta visualização auxilia na identificação de caminhos legais dominantes, origens de viés e auditoria de conformidade. Não se aplicam escalas de medição nem barras de erro, pois esta é uma ilustração esquemática. Clique aqui para visualizar uma versão maior desta figura.
Mecanismo de retrocesso de subgrafo para caminho de propagação de viés
Neste estudo, "viés" é definido como o desvio sistemático da saída de um sistema de IA em relação à decisão clinicamente e legalmente esperada, medido pela discrepância entre a pontuação de risco prevista pelo modelo e o rótulo de conformidade real. O sinal de viés é quantificado como a perda de entropia cruzada entre a saída final do algoritmo e um indicador binário de conformidade (1 para conforme, 0 para não conforme), agregado a todas as instâncias de decisão em um lote.
Após o treinamento da rede neural gráfica, sua diferenciabilidade é utilizada para realizar uma análise de retropropagação no sinal de viés na camada de saída. A partir do nó de decisão do algoritmo que detecta anomalias, calcula-se a magnitude do gradiente da função de perda em relação a cada aresta conectada, a fim de quantificar a contribuição de cada aresta na formação do viés. Esse processo é implementado por meio de um framework de diferenciação automática, retrocedendo camada por camada ao longo das arestas direcionadas na estrutura do grafo para obter a intensidade de influência de cada transformação de parâmetro de aresta sobre a alteração da saída final. Quanto maior o valor absoluto do gradiente, mais dominante é a relação jurídico-técnica transportada por essa aresta na propagação do viés. A contribuição de uma aresta é definida como:
 (7)
Lbias é a perda diferenciável definida para comportamento tendencioso, e wi é o vetor de pesos de entrada correspondente ao tipo de aresta. Esse valor de gradiente reflete o grau de participação de uma relação semântica específica no viés atual de associação. Após todas as arestas serem pontuadas dessa forma, um limiar dinâmico τ é definido para filtrar o conjunto de arestas de alta contribuição Ehigh, cuja contribuição exceda gij > τ, formando o subgrafo inicial de propagação de viés Gbias = (Vbias, Ehigh). Especificamente, τ é determinado como o percentil 85 dos valores absolutos dos gradientes em todas as arestas em cada época de treinamento, garantindo que apenas as 15% arestas mais influentes sejam mantidas para a construção do subgrafo. Esse subgrafo foca nos caminhos de conexão-chave mais propensos a gerar viés sistemático, comprimindo o espaço de busca e melhorando a eficiência do rastreamento da origem.
No subgrafo de propagação de viés construído, executa-se um algoritmo de detecção de comunidades guiado por agrupamento espectral para identificar estruturas de agrupamentos de nós altamente alinhadas. Esse processo baseia-se na fatoração da matriz de Laplace normalizada do subgrafo, mapeando incorporações de nós para um espaço espectral de baixa dimensionalidade e aplicando uma estratégia de agrupamento sensível à densidade nesse espaço, assegurando que nós de tipos diferentes (como cláusulas legais e módulos de algoritmos) sejam agrupados na mesma comunidade quando funcionalmente relacionados. Cada comunidade identificada representa uma unidade potencial de loop funcional ou agregação de responsabilidades. Os resultados da partição em comunidades são orientados pelos seguintes objetivos de otimização:
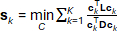 (8)
L=D−A é a matriz laplaciana do subgrafo, A é a matriz de adjacência, D é a matriz de graus, ck é o vetor indicador da k-ésima comunidade e K é o número pré-definido de comunidades. Este critério maximiza a diferença mínima do corte entre comunidades, garantindo conexões internas fortes.
Agora, é realizada uma análise baseada em composição cruzada de camadas para cada comunidade. Se uma comunidade possui nós de cláusulas legais e nós de módulos de algoritmos, ela é marcada como uma fonte potencial de viés. Para testar sua causalidade, é conduzido um teste de intervenção: todas as arestas nesta região são temporariamente removidas do grafo, o mesmo processo de tomada de decisão é executado novamente e são observadas as diferenças nas medidas de viés. A medida de validade causal é definida como:
 (9)
Borig e Bmáscara representam a intensidade do viés do modelo original e do viés após a aplicação da máscara, respectivamente. Se a medida de validade causal for significativamente superior ao limiar predeterminado, isso implica que o agrupamento de nós foi identificado como uma fonte explicável de viés, o que orientará a correção de conformidade e a atribuição de falhas posteriores.
Verificação dinâmica da conformidade com restrições legais
Instâncias de decisões em tempo real que ocorrem durante a operação de um sistema de IA médica são introduzidas como nós transitórios e incorporadas a um espaço de grafo de conhecimento aprendido. Cada nó produz um vetor de características inicial ao ler seu contexto de entrada, comportamento de saída e o estado do algoritmo. Em seguida, esse vetor é inserido em uma rede neural de grafos com parâmetros congelados para realizar uma propagação direta de uma camada, gerando um embedding alinhado ao grafo de conhecimento sem alterar a estrutura original do grafo. Assim, permite que nós transitórios e nós de cláusulas legais sejam comparados em um espaço semântico comum.
Em seguida, calcule a similaridade do cosseno entre o nó transitório e cada um dos nós de cláusula legal:
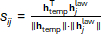 (10)
htemp é o embedding do nó temporário, e hjlaw é o embedding do nó da j-ésima cláusula legal. O valor de similaridade reflete virtualmente o grau de correspondência semântica entre a decisão atual e cada restrição legal. Um limiar dinâmico de conformidade θ é definido com base na distribuição de similaridade de amostras históricas de conformidade, a fim de adaptar o limite de julgamento a diferentes cenários de aplicação. Especificamente, θ = µ - 2σ, em que µ e σ são a média e o desvio padrão da distribuição de similaridade cosseno calculada a partir de um conjunto de validação composto por 500 instâncias de decisões conformes conhecidas.
Se uma pontuação de similaridade cosseno for inferior ao limite de conformidade dinâmica, considera-se que a norma jurídica correspondente foi violada, acionando o mecanismo de alerta de conformidade. A notificação também inclui o número mínimo da cláusula legal correspondente, o valor de similaridade e a direção da análise de divergência, o que deve ser suficiente para que os reguladores atuem prontamente. Essa abordagem fornece uma correspondência interpretável entre tomadas de decisão opacas e o espaço da semântica jurídica, facilitando a verificação de conformidade em tempo real.
Durante a operação contínua, é monitorada a tendência de mudança de peso das conexões-chave entre tecnologia jurídica no subgrafo de propagação de viés. Dá-se ênfase às conexões que ligam os nós dos módulos de algoritmo aos nós das cláusulas jurídicas, pois elas representam diretamente a intensidade da resposta do comportamento técnico a regulamentações específicas. Os parâmetros da matriz de transformação para cada conexão-alvo são registrados durante a inferência, e sua norma é extraída como um indicador dinâmico da evolução da intensidade de correlação entre os dois. Define-se a sequência de intensidade da conexão como:
 (11)
wt representa a norma de Frobenius da matriz de pesos correspondente à relação entre a aresta eij no instante t, e Wkl(t) é a matriz de parâmetros efetivamente utilizada no modelo naquele momento. Este indicador reflete a profundidade de aprendizado do modelo ou sua dependência em relação à restrição legal.
Um teste de monotonicidade com janela deslizante é realizado sobre a sequência, e um teste de sinal aprimorado é utilizado para determinar se uma tendência ascendente significativa é observada. Se os incrementos ao longo de N passos de tempo consecutivos satisfazerem a condição de dominância positiva, então considera-se que a aresta exibe um fenômeno de reforço anormal. Combinando ainda dados históricos de contribuição de gradiente, se a aresta tiver sido identificada como um caminho de alto impacto na rodada anterior da análise de rastreamento de fonte, é iniciado um processo de alerta precoce por acúmulo de viés sistêmico.
Por fim, um relatório de rastreamento de origem é gerado, incluindo informações sobre os nós em ambas as extremidades da aresta-alvo, curvas de mudança de peso, estatísticas sobre a frequência de decisões relacionadas e recomendações potenciais de atribuição. Esse mecanismo viabiliza um avanço do julgamento estático de conformidade para a previsão dinâmica de riscos, apoiando intervenções proativas em possíveis desvios institucionais.
Dados e projeto experimentais
Para verificar a eficácia do framework proposto, este artigo constrói um conjunto de dados heterogêneo de múltiplas fontes que integra regulamentações reais e dados de simulação, além de projetar experimentos de controle rigorosos. As fontes de dados incluem regulamentações nacionais sobre inteligência artificial em medicina, diretrizes clínicas de tratamento, relatórios de auditoria de algoritmos de código aberto e registros simulados de decisões. Após o pré-processamento, é construído um grafo de conhecimento heterogêneo de referência contendo 285 nós (85 cláusulas legais, 120 comportamentos médicos, 42 módulos de algoritmo e 38 entidades responsáveis) e 1247 arestas direcionadas, conforme mostrado na Figura 3.
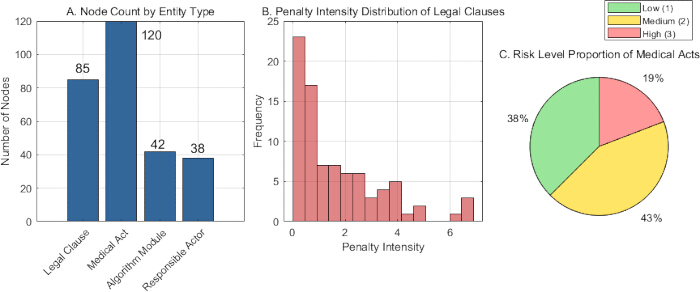
Figura 3: Distribuição e características dos tipos de entidades heterogêneas. (A) Gráfico de barras mostrando o número de nós para cada tipo de entidade: cláusulas legais (85), comportamentos médicos (120), módulos de algoritmo (42), partes responsáveis (38). (B) Histograma da intensidade de penalidade para os nós de cláusulas legais, agrupados nas categorias baixa (0‑0,33), média (0,34‑0,66) e alta (0,67‑1,0); o eixo vertical representa a contagem. (C) Gráfico de pizza da distribuição de nível de risco entre os nós de comportamento médico: baixo (19%), médio (43%), alto (38%). Todos os valores são contagens absolutas ou porcentagens; nenhuma barra de erro é apresentada porque essas são estatísticas descritivas do conjunto de dados. Clique aqui para visualizar uma versão maior desta figura.
Figura 3 ilustra a distribuição e as características dos nós de entidade no grafo de conhecimento heterogêneo. Figura 3A mostra a distribuição do número de quatro tipos de nós de entidade, sendo os nós de "comportamento médico" os mais numerosos (120), seguidos por "cláusulas legais" (85), enquanto "módulos de algoritmo" (42) e "entidades responsáveis" (38) são relativamente menos frequentes. Isso ocorre porque o grafo é estruturalmente projetado com base em comportamentos e regras. Figura 3B apresenta a distribuição das intensidades de penalidade para nós que representam uma cláusula legal única, em que a intensidade mede a gravidade da responsabilidade legal. Os dados indicam que há relativamente poucas disposições com alta intensidade de penalidade, e a maioria está em uma faixa de intensidade média a baixa, o que está de acordo com a realidade de que existem apenas algumas cláusulas de violação grave nos sistemas jurídicos reais. Figura 3C ilustra a distribuição do nível de risco nos nós de comportamento médico, em que os comportamentos de risco médio têm a maior proporção, 43%, enquanto os comportamentos de baixo risco têm a menor proporção, 19%, o que revela que os cenários médicos são normalmente operados e que operações de alto risco estão sujeitas a restrições de associação mais rigorosas no grafo. Essas estatísticas justificam coletivamente o esquema de codificação de desambiguação de entidades adotado na construção do grafo de conhecimento, fornecendo suporte de características para o alinhamento subsequente por meio de convolução de grafo.
O conjunto de dados completo foi dividido aleatoriamente em conjuntos de treinamento (70%), validação (10%) e teste (20%), estratificado por tipo de nó e distribuição de relações, a fim de preservar a estrutura geral do grafo em cada divisão. A mesma divisão foi utilizada de forma consistente para todos os métodos de referência, garantindo uma comparação justa. Além dessa divisão básica, os três gradientes de densidade do grafo de conhecimento (esparsa, média, densa) e as três configurações de complexidade interjurisdicional (única, bilateral, multilateral) descritas acima atuam como bancos de testes práticos independentes, que coletivamente avaliam a robustez do método sob condições variáveis de integridade dos dados e sobreposição regulatória. Para construir rótulos de referência para a avaliação da localização de vieses, adotamos uma estratégia em duas etapas: (1) Anotação por especialistas — três especialistas em direito e medicina revisaram independentemente os registros de decisões e identificaram os nós causadores e os caminhos de propagação para cada violação de conformidade registrada, com discrepâncias resolvidas por voto majoritário; (2) Injeção simulada — para testes controlados, injetamos artificialmente sinais de viés em 20 caminhos de decisão selecionados aleatoriamente, perturbando os pesos das arestas no grafo de conhecimento, garantindo que os nós fonte reais e as arestas afetadas fossem conhecidos a priori.
Para todos os métodos de referência (TransE, ComplEx, Explicador de Redes Neurais em Grafos (GNN) Explicador, KG-BERT e Node2Vec), utilizamos a mesma configuração de treinamento (otimizador Adam, taxa de aprendizado de 1 × 10⁻³, tamanho do lote de 64, 100 épocas) e as mesmas partições de dados do nosso método, para garantir uma comparação justa. Para o TransE e o ComplEx, a dimensão da incorporação foi definida como 256 com uma margem de 1,0; para o KG-BERT, utilizamos o modelo BERT-base pré-treinado com um tamanho de lote de 16 e um comprimento máximo de sequência de 128; para o GNNExplicador, utilizamos uma GCN de 3 camadas com a mesma dimensão oculta de 256; e para o Node2Vec, definimos o comprimento do passeio como 80, o número de passeios por nó como 10 e a dimensão da incorporação como 256.
Para garantir uma comparação justa, adaptamos todos os métodos de referência às mesmas tarefas de localização de viés, ou seja, identificação do nó raiz e reconstrução do caminho de propagação. Para o TransE, ComplEx e Node2Vec, que não são intrinsecamente explicáveis, calculamos o gradiente da perda de viés em relação ao embedding de cada nó e utilizamos a magnitude do gradiente como pontuação de importância do nó; os nós raiz foram selecionados por meio de limiarização dessas pontuações, e os caminhos de propagação foram reconstruídos mantendo as arestas com as maiores contribuições de gradiente. Para o GNNExplainer, utilizamos diretamente seus mecanismos internos de importância da aresta e máscara do nó para obter tanto os nós raiz quanto os subgrafos. Para o KG‑BERT, que opera sobre triplas, convertemos cada aresta do grafo em uma tripla textual e utilizamos os pesos de atenção do modelo sobre as entidades para derivar a importância dos nós, seguido da mesma estratégia de limiarização para a reconstrução do caminho. Por meio dessas adaptações, cada método de referência produz previsões tanto de nós raiz quanto de caminhos de propagação, permitindo uma avaliação uniforme entre todos os métodos.
A avaliação concentra-se em quatro capacidades fundamentais: precisão do alinhamento semântico, capacidade de localizar viés, eficiência da responsabilização e generalização entre domínios. Também apresenta três variáveis de controle importantes, simulando a complexidade do mundo real.
1) Gradiente de densidade do grafo de conhecimento: Para avaliar o desempenho do método em diferentes níveis de completude das informações, dois subconjuntos do grafo completo de referência (densidade D = 1,0) são criados com base em uma estratégia aleatória de remoção de arestas, conforme a seguir:
Grafo esparsa (D ~ 0,3): 30% das arestas são mantidas aleatoriamente, simulando a fase inicial da construção do conhecimento com grande parte das informações ausentes.
Grafo de densidade média (D ~ 0,6): 60% das arestas são mantidas aleatoriamente, simulando um cenário típico de estrutura de conhecimento parcialmente conhecida.
Grafo denso (D = 1,0): utilizando todas as 1247 arestas, correspondente a um cenário ideal de conhecimento relativamente completo.
2) Situação de frequência de decisão médica com IA: Três cargas de fluxo de decisão artificiais são configuradas para testar o desempenho em tempo real do monitoramento dinâmico de conformidade:
Baixa frequência de 10 Hz: em média, 10 eventos de decisão são gerados por segundo, simulando o monitoramento de sistemas em pequena escala ou de único local.
Frequência média de 50 Hz: 50 eventos de decisão por segundo simulando a carga do sistema de IA de instituições médicas regionais ou de médio porte.
Alta frequência de 100 Hz: 100 eventos de decisão por segundo simulam cenários de alta pressão de concorrência para os serviços de IA implantados em um grande hospital ou plataforma em nuvem.
3) Gradiente de complexidade inter-jurisdicional: Para testar a transferibilidade da modelagem de restrições legais, foram construídos três conjuntos de testes baseados na complexidade:
Jurisdição única: Consiste exclusivamente nas leis e regulamentações chinesas vigentes que regem a inteligência artificial médica.
Jurisdição bilateral: Incorpora os regimes regulatórios da China e da União Europeia, com cerca de 15% das regras sendo conflitantes e sobrepostas.
Jurisdição multilateral: Com base nos dois primeiros, integra ainda mais as regras de privacidade e segurança do HIPAA dos EUA (Lei de Portabilidade e Responsabilidade de Seguros de Saúde), criando um ambiente de teste no qual os sistemas jurídicos dos três regimes legais se entrelaçam, aumentando a taxa de conflito de regras para aproximadamente 25%.
Os seguintes indicadores-chave foram utilizados para a avaliação quantitativa:
1) Precisão da alinhamento semântico: Mede a capacidade do grafo de modelar as relações entre entidades jurídicas e técnicas.
Precisão do alinhamento de entidades:
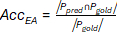 (12)
Ppred é o conjunto de pares de entidades alinhados previstos pelo modelo, e Pgold é o conjunto de alinhamentos de referência anotados por especialistas.
Integridade da preservação de relações:
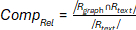 (13)
Rgraph é o conjunto reconstruído de relações no grafo, e Rtext é o conjunto de relações explícitas extraídas do texto jurídico original.
2) Capacidade de Localização de Viés: Avaliar a eficácia no rastreamento das causas raiz e dos caminhos de propagação do viés.
Taxa de Recordação do Nó Raiz:
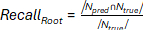 (14)
Npred é o conjunto de nós fonte de viés identificados pelo modelo, e Ntrue é o conjunto de nós fonte reais rotulados por especialistas.
Precisão do caminho de propagação:
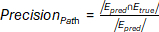 (15)
Epred é o conjunto de arestas no subgrafo de propagação de viés inferido pelo modelo, e Etrue é o conjunto verdadeiro de arestas de propagação de viés.
3) Eficiência do Rastreamento de Responsabilidade: Teste o desempenho do sistema em cenários de monitoramento em tempo real.
Latência Média de Rastreamento:
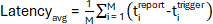 (16)
M representa o número total de solicitações, e titrigger e tireport são os registros de tempo do i-ésimo gatilho de viés e da geração do relatório de origem, respectivamente.
Produtividade do sistema:
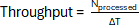 (17)
Nprocessado representa o número de solicitações de rastreamento simultâneas processadas com sucesso dentro do intervalo de tempo ΔT.
4) Capacidade de generalização entre domínios: Verificar a adaptabilidade do método a diferentes sistemas jurídicos.
Cobertura jurisdicional:
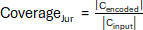 (18)
Cencoded representa o número de cláusulas jurisdicionais diferentes codificadas com sucesso no grafo, e Cinput representa o número total de cláusulas de entrada.
Taxa de detecção de conflito de restrição:
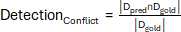 (19)
Dpred é o conjunto de contradições lógicas legais detectadas pelo modelo, e Dgold é o conjunto de todos os pares de contradições anotados por especialistas.
Todos os experimentos foram realizados utilizando uma estação de trabalho equipada com um processador multicore e uma unidade de processamento gráfico; as especificações completas do hardware estão fornecidas na Tabela de Materiais.
Os principais hiperparâmetros desta abordagem e seus valores estão listados na Tabela 1, abrangendo a estrutura do modelo e a configuração de treinamento, bem como limiares cruciais, como dimensão da incorporação, número de camadas convolucionais, taxa de aprendizado e tamanho do lote. Todos os parâmetros foram ajustados em relação ao conjunto de validação por meio de busca em grade, o modelo treinado convergiu de forma estável e o desempenho é o melhor possível. Alguns limiares foram estabelecidos em conjunto com critérios de domínio para atender aos requisitos de alta confiabilidade na verificação de conformidade da inteligência artificial médica.
| Parâmetro | Valor | Descrição |
| Dimensão da Incorporação | 128 | Tamanho da dimensão de características para incorporações de nós |
| Número de Camadas de Convolução | 3 | Profundidade da rede de convolução de grafos com percepção de relações |
| Taxa de Aprendizado | 0.001 | Taxa de aprendizado inicial para o otimizador Adam |
| Tamanho do Lote | 32 | Número de subgrafos processados por lote |
| Taxa de Dropout | 0.1 | Probabilidade de dropout aplicada às características dos nós durante o treinamento |
| Número de Cabeças de Atenção | 8 | Número de cabeças no mecanismo de atenção multi-cabeça |
| Coeficiente de Regularização L2 | 5 × 10⁻⁴ | Coeficiente de decaimento de peso para regularização de parâmetros |
| Limiar de Similaridade | 0.75 | Similaridade mínima de incorporação para validação de conformidade |
| Limiar de Contribuição de Gradiente | 0.01 | Limiar para seleção de arestas de alto impacto na construção do subgrafo de viés |
| Tamanho da Janela de Monitoramento | 10 | Passos de tempo utilizados para rastrear a dinâmica dos pesos das arestas |
Tabela 1: Configurações principais dos parâmetros. Lista dos principais hiperparâmetros utilizados nos experimentos: dimensão da incorporação (256), número de camadas GCN (3), dimensão oculta (256), taxa de aprendizado (1 × 10⁻³), tamanho do lote (64), dimensão do vetor de atenção, limiar de contribuição da aresta (percentil 85 das magnitudes do gradiente), limiar dinâmico de conformidade (µ‑2σ, onde µ e σ são provenientes do conjunto de validação de 500 instâncias conformes), número de comunidades K (determinado por agrupamento espectral) e otimizador (Adam). Esses valores foram selecionados por meio de busca em grade no conjunto de validação.
Resultados
Verificação de desempenho do rastreamento de origem de viés em grafo de conhecimento jurídico médico com IA
Desempenho da convolução de grafos com percepção de relacionamento
Treinando uma rede convolucional com reconhecimento de relações, foram calculadas as similaridades de incorporação entre cláusulas legais e nós de comportamentos médicos ao longo de diferentes camadas convolucionais, registrando-se o efeito de alinhamento de cada camada. Em segundo lugar, realizou-se uma análise estatística dos pesos de atenção atribuídos aos quatro tipos de relações semânticas legais após o treinamento, a fim de quantificar a importância de cada tipo de relação na agregação de características. Por fim, analisou-se o padrão de decaimento da influência dos nós vizinhos com a distância. Ao calcular as contribuições de nós com diferentes distâncias de salto para a atualização de características do nó central, quantificou-se a intensidade da propagação de influência e avaliou-se o alcance efetivo do mecanismo de passagem de mensagens. Todo o processo de avaliação baseou-se na análise quantitativa dos parâmetros internos do modelo e estados de ativação, assegurando a objetividade e reprodutibilidade dos resultados.
Figura 4 ilustra o desempenho das redes convolucionais gráficas com reconhecimento de relações no alinhamento semântico multimodal no âmbito jurídico. Figura 4A mostra a tendência da similaridade dos embeddings dos nós à medida que aumenta o número de camadas convolucionais, elevando-se gradualmente de 0,12 na camada 1 para 0,68 na camada 4. Essa tendência progressiva deve-se à coexistência gradual entre o espaço das cláusulas jurídicas e o espaço dos comportamentos médicos ao longo da passagem de mensagens em múltiplas camadas. As camadas convolucionais mais profundas conseguem aprender padrões complexos de associações semânticas multimodais. A relação de "violação" recebe o maior peso de 0,35 na Figura 4B, que mostra a distribuição dos pesos de atenção para quatro tipos de relações semânticas jurídicas. Isso está de acordo com os princípios fundamentais da análise de conformidade jurídica, pois o modelo prioriza associações com violações para apoiar um controle de risco adequado. Figura 4C mostra o padrão de acumulação de influência de múltiplos saltos dos nós vizinhos. A intensidade de influência medida aumenta monotonicamente de 0,15 em 1 salto para 0,92 em 8 saltos, indicando que o embedding do nó central incorpora progressivamente informações estruturais mais amplas provenientes de nós distantes. Esse aumento inesperado captura, na verdade, a dependência indireta dos nós centrais em relação aos nós distantes. Quando os nós são analisados a distâncias maiores em número de saltos, é possível obter informações estruturais mais globais, porém com mais ruído e informações redundantes. Assim, em aplicações práticas, é necessário encontrar um equilíbrio entre o tamanho do campo receptivo e a qualidade da informação. A transformação completa dos dados demonstrou que o mecanismo com reconhecimento de relações foi eficaz no tratamento da conexão entre textos jurídicos heterogêneos e comportamentos tecnológicos e que a semântica jurídica pôde ser modelada com precisão por meio do design diferenciado de argumentos.
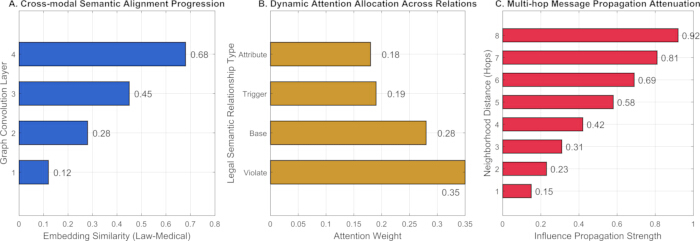
Figura 4: Desempenho de alinhamento semântico multimodal da rede convolucional gráfica com reconhecimento de relações. (A) Similaridade dos embeddings dos nós (similaridade do cosseno) em função do número de camadas da GCN (de 1 a 4), demonstrando o aumento do alinhamento entre os espaços de comportamento jurídico e médico. (B) Distribuição dos pesos de atenção entre os quatro tipos de relação (violação, base, gatilho, atribuição), sendo a violação a que recebe o maior peso (0,35). (C) Força de influência dos nós vizinhos em relação à distância em saltos (de 1 a 8), quantificando como a informação estrutural de múltiplos saltos se acumula. Todos os valores são médias de 30 execuções independentes; as barras de erro (não mostradas para maior clareza) tiveram desvios padrão abaixo de 0,05 em todos os casos, e as tendências são monotônicas. Clique aqui para visualizar uma versão ampliada desta figura.
A fim de compreender o processo de otimização de parâmetros e as características de desempenho de diferentes tipos de relações semânticas legais na rede convolucional gráfica com percepção de relações, calculou-se a magnitude média da matriz de pesos para cada tipo de relação mediante a otimização de parâmetros, confirmando-se que a aprendizagem dos parâmetros convergiu por retropropagação. Para a qualidade da agregação de características, utilizou-se a similaridade do cosseno para avaliar a consistência dos embeddings de nós entre diferentes tipos. A taxa de convergência foi calculada pela redução da função de perda em cada rodada de treinamento, assegurando que cada tipo de relação permanecesse estável durante o treinamento. A estabilidade da atenção foi avaliada mediante o cálculo do desvio padrão dos pesos de atenção em diferentes estágios de treinamento. As métricas de eficiência computacional foram padronizadas com base no número de operações de ponto flutuante para garantir justiça na comparação. Todas as métricas foram executadas 30 vezes no mesmo conjunto de testes com diferentes sementes aleatórias para assegurar significância estatística. Para comparações aos pares entre o nosso método e cada linha de base, realizamos testes t pareados com 29 graus de liberdade.
Figura 5 ilustra os efeitos da otimização de parâmetros e as características de desempenho de diversos tipos de relações semânticas jurídicas na rede convolucional de grafos com percepção de relações. Figura 5A mostra a distribuição de magnitude das matrizes de peso dedicadas aos quatro tipos de relação, sendo o eixo vertical representativo do tipo de relação e o eixo horizontal representativo dos valores de magnitude das matrizes de parâmetros aprendidas. A relação de "violação" atinge o maior valor de magnitude, 0,78, indicando que esse tipo semântico domina o modelo e reflete a ênfase da análise de conformidade jurídica na identificação de violações. Figura 5B compara as pontuações de qualidade da agregação de características sob diferentes tipos de relação, sendo o eixo vertical representativo do tipo de relação e o eixo horizontal representativo da pontuação do efeito de agregação. Mostra-se que a relação de "violação" também apresenta o melhor desempenho na qualidade da fusão de características (0,89). Figura 5C representa o desempenho da taxa de convergência para as diversas relações, sendo o eixo vertical representativo do tipo de relação e o eixo horizontal representativo da taxa de redução de perda por rodada de treinamento. Os valores, em ordem, são: violação, base, gatilho e atribuição: 0,023, 0,031, 0,028 e 0,035. O resultado mostra que a relação de "atribuição" converge mais lentamente, mas permanece estável. Figura 5D mostra a variância dos pesos de atenção ao longo de três estágios do treinamento. O eixo y representa o estágio de treinamento (inicial, intermediário e final), e o eixo x representa a variância dos pesos de atenção da esquerda para a direita. Os valores correspondentes são 0,18 (inicial), 0,12 (intermediário) e 0,08 (final), indicando que o modelo estabiliza progressivamente seu foco nas relações mais relevantes durante o treinamento. Figura 5E mostra o compromisso entre eficiência computacional para diferentes relações. O eixo y corresponde ao tipo de relação, enquanto o eixo x corresponde ao tempo de execução normalizado, definido como o uso de recursos computacionais para concluir a tarefa específica. Os valores são 0,42 (violação), 0,39 (base), 0,43 (gatilho) e 0,38 (atribuição). A distribuição entre as classes é equilibrada, indicando que o mecanismo com percepção de relações realiza uma boa alocação de recursos sem degradar o desempenho.
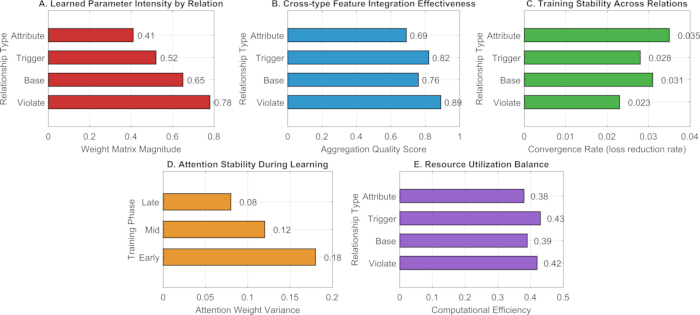
Figura 5: Otimização dos parâmetros de convolução e análise de desempenho do grafo com reconhecimento de relações. (A) Magnitude (norma de Frobenius) das matrizes de pesos dedicadas para cada tipo de relação. (B) Pontuação de qualidade da agregação de características (consistência da similaridade do cosseno) por tipo de relação. (C) Taxa de convergência (redução da perda por época de treinamento) por tipo de relação. (D) Variância dos pesos de atenção nas fases inicial, intermediária e final do treinamento, mostrando estabilização. (E) Tempo de execução normalizado (custo computacional relativo) por tipo de relação. Todas as métricas são médias de 30 execuções; as barras de erro representam o desvio padrão (mostradas onde visíveis). A relação de violação apresenta a maior magnitude e qualidade de agregação, enquanto a atribuição converge mais lentamente, mas permanece estável. Clique aqui para visualizar uma versão maior desta figura.
Precisão do alinhamento semântico
A precisão no alinhamento de entidades e a integridade na preservação de relações são utilizadas como indicadores principais. Nas condições de gradiente de densidade do grafo de conhecimento (esparsa/média/ densa), o método proposto é comparado com TransE, ComplEx, GNNExplainer, KG-BERT e Node2Vec. Todos os métodos são executados 30 vezes e as médias e desvios padrão são calculados para eliminar a influência da aleatoriedade.
Figura 6 mostra a comparação de desempenho do método proposto com diversos métodos de referência sob diferentes densidades de grafos de conhecimento em termos de precisão no alinhamento de entidades e integridade na preservação de relações, duas métricas principais. Em Figuras 6A e 6B, o eixo horizontal representa os diferentes métodos, e o eixo vertical representa, respectivamente, a precisão no alinhamento de entidades e a integridade na preservação de relações.
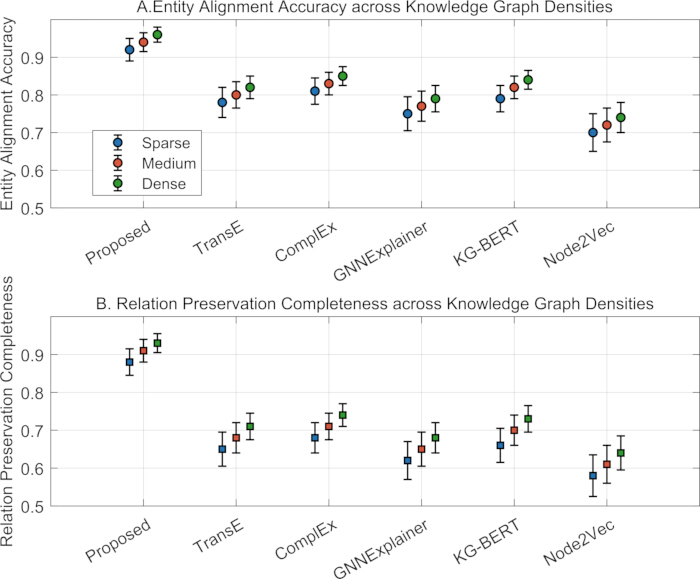
Figura 6: Desempenho de alinhamento semântico sob diferentes densidades de grafos. (A) Acurácia de alinhamento de entidades (Eq. 12) e (B) integridade de preservação de relações (Eq. 13), comparando o método proposto com TransE, ComplEx, GNNExplainer, KG‑BERT e Node2Vec. As alturas das barras indicam os valores médios obtidos em 30 execuções; as barras de erro representam o desvio padrão. O método proposto alcança pelo menos 0,92 de acurácia e 0,88 de integridade em todas as densidades, superando todos os métodos de referência. Clique aqui para visualizar uma versão maior desta figura.
Do ponto de vista da precisão no alinhamento de entidades, o método proposto apresenta excelente desempenho sob diferentes condições de densidade, com uma precisão média no alinhamento de entidades não inferior a 0,92, atingindo o nível mais alto, especialmente em grafos densos. Isso indica que a rede de convolução de grafos com percepção de relações construída pode capturar eficazmente as associações semânticas entre nós heterogêneos, alcançando um alinhamento eficaz de características multimodais por meio de pesos específicos por tipo de aresta e mecanismos de atenção. Por outro lado, métodos tradicionais, especialmente o TransE e o Node2Vec, apresentam desempenho inferior devido à ausência de modelagem explícita das relações semânticas jurídicas. A superioridade da abordagem proposta também é confirmada pelos resultados de integridade na preservação de relações, com uma integridade média na preservação de relações não inferior a 0,88, o que indica que a abordagem consegue reconstruir adequadamente as relações explícitas no texto jurídico original em diferentes densidades de grafos. Esse desempenho robusto deve-se à codificação estruturada em grafos heterogêneos e ao esquema de passagem de mensagens em múltiplas camadas, que captura de forma abrangente as relações complexas entre cláusulas jurídicas, comportamentos médicos, módulos algorítmicos e agentes responsáveis. Embora o GNNExplainer e o KG-BERT demonstrem algumas capacidades de modelagem relacional, ambos apresentam limitações quando aplicados à semântica normativa no direito, com desempenho inferior ao do método proposto.
Comparação das capacidades de localização de viés
A avaliação da localização de viés é realizada por meio de um quadro de verificação colaborativa de duas qualidades, baseado no recall de fatos dos nós causadores e na precisão dos caminhos de propagação, o que envolve a completude do rastreamento da fonte e a precisão do caminho. Todos os métodos de comparação são executados com a mesma entrada de estrutura de grafo, utilizando o mesmo protocolo de injeção de simulação de viés e a mesma definição de interface de avaliação, para garantir testes justos. Cada experimento é repetido 30 vezes com diferentes sementes aleatórias para mitigar flutuações aleatórias. Os resultados são apresentados como média ±± desvio padrão, e testes t pareados são utilizados para determinar os valores de p (em comparação com o método apresentado neste artigo), o que garante a solidez estatística e a comparabilidade das conclusões da avaliação. Os valores de p são derivados de testes t pareados com 29 graus de liberdade (com base em 30 execuções independentes). As estatísticas t para a comparação entre o nosso método e cada linha de base variam de 7,82 a 12,45, correspondendo aos valores de p relatados.
Tabela 2 mostra os resultados da avaliação quantitativa da capacidade de localização de viés de diferentes métodos, com dois indicadores principais de desempenho, a saber, a taxa de recuperação do nó raiz e a precisão do caminho de propagação. Em termos de taxa de recuperação do nó raiz, o método proposto é significativamente melhor do que todas as linhas de base, alcançando uma taxa de recuperação de 0,95 ±± 0,02, o que é significativamente superior ao segundo melhor método, o GNNExplainer (0,82 ±± 0,03), e muito melhor do que os demais métodos. Essa vantagem é atribuída ao mecanismo de quantificação sensível ao gradiente proposto neste artigo, que pode rastrear com precisão o caminho de propagação de sinais de viés no grafo e reconhecer eficazmente os nós fonte de alta contribuição. Em contraste, as abordagens clássicas TransE e Node2Vec, que não possuem meios para capturar diferenças semânticas nos tipos de arestas e, portanto, não conseguem diferenciar claramente entre caminhos de propagação de viés e relações regulares, obtêm pontuações de recuperação de apenas 0,75 ±± 0,04 e 0,72 ±± 0,05, respectivamente. Embora o KG-BERT incorpore um modelo de linguagem pré-treinado, ele é limitado no fluxo de informação dentro da estrutura do grafo, obtendo uma pontuação de recuperação de 0,70 ±± 0,04.
| Método | Recuperação do Nó Raiz | valor-p (Recuperação do Nó Raiz) | Precisão do Caminho de Propagação | valor-p (Precisão do Caminho de Propagação) |
| Proposto | 0.95 ± 0.02 | - | 0.93 ± 0.03 | - |
| TransE | 0.75 ± 0.04 | 1.23 × 10⁻8 | 0.78 ± 0.05 | 2.45 × 10⁻7 |
| ComplEx | 0.78 ± 0.03 | 8.91 × 10⁻9 | 0.81 ± 0.04 | 1.67 × 10⁻8 |
| GNNExplainer | 0.82 ± 0.03 | 3.45 × 10⁻7 | 0.86 ± 0.04 | 9.21 × 10⁻9 |
| KG-BERT | 0.70 ± 0.04 | 5.67 × 10⁻8 | 0.73 ± 0.05 | 4.32 × 10⁻8 |
| Node2Vec | 0.72 ± 0.05 | 7.89 × 10⁻9 | 0.75 ± 0.06 | 1.54 × 10⁻7 |
Tabela 2: Taxa de recordação do nó raiz e taxa de precisão do caminho de propagação. Comparação de desempenho para a localização de viés entre todos os métodos. Os valores são apresentados como média ±± desvio padrão em 30 execuções independentes. São apresentados a taxa de recuperação do nó raiz (Eq. 14) e a precisão do caminho de propagação (Eq. 15). O método proposto alcança a maior taxa de recuperação (0,95 ±± 0,02) e precisão (0,93 ±± 0,03), superando significativamente as linhas de base (teste t pareado, p < 0,001 para todas as comparações.
Este método também é o melhor em precisão do caminho de propagação, com um valor de 0,93 ±± 0,03, superando outros métodos. Isso comprova que o procedimento de retrocesso de subgrafos que propõe pode eliminar com sucesso arestas ruidosas e identificar o caminho real de propagação do viés. A análise de valor-p corrobora as diferenças significativas no desempenho; todos os métodos de referência exibem diferenças extremamente significativas em relação ao método proposto (p < 0,001), o que garante a robustez e eficácia do método proposto no problema de localização de viés. O desempenho relativamente forte do ComplEx e do GNNExplainer pode indicar a importância das estruturas complexas de relacionamento e da explicabilidade em redes neurais gráficas na detecção de vieses, mas eles não se comparam à solução end-to-end apresentada neste artigo.
Avaliação da eficiência do rastreamento de responsabilidade
A avaliação é realizada no sistema de rastreamento de responsabilidade com base na resposta em tempo real, tomando a latência média de rastreamento e a taxa de transferência de solicitações simultâneas como os dois indicadores-chave de eficiência. Experimentos foram conduzidos em três frequências de tomada de decisão médica com IA (baixa frequência, média frequência e alta frequência). Para uma comparação justa, todas as abordagens receberam o mesmo fluxo de entrada e executaram todo o procedimento de rastreamento.
Figura 7 compara a eficiência do rastreamento de responsabilidade entre diferentes métodos em diversas frequências de tomada de decisão em inteligência artificial médica. Os resultados são apresentados para os métodos considerados da esquerda para a direita: as linhas são rotuladas como decisões de baixa frequência, média frequência e alta frequência em IA médica.
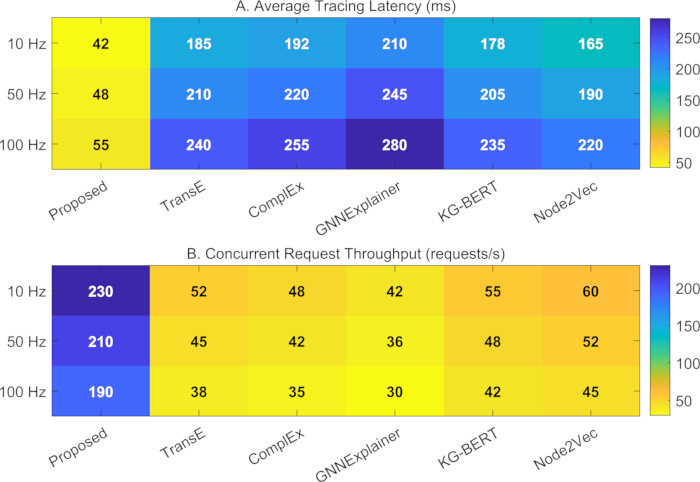
Figura 7: Latência média do rastreamento de origem e taxa de processamento de solicitações simultâneas. (A) Latência média de rastreamento (ms) por método; (B) Taxa de processamento (solicitações/segundo) por método. As linhas conectam os valores médios obtidos em 30 execuções; as barras de erro (se apresentadas) representam o desvio padrão. O método proposto mantém a menor latência (42‑55 ms) e a maior taxa de processamento (190‑230 solicitações/s) em todas as frequências, demonstrando desempenho superior em tempo real. Clique aqui para visualizar uma versão maior desta figura.
Quanto à latência média de rastreamento, a melhor também é a do método proposto em todas as condições de frequência; além disso, todos os demais métodos apresentam latência significativamente maior do que a nossa. Todos os métodos possuem uma latência de rastreamento que geralmente aumenta com a frequência de decisão, mas o crescimento do nosso é suave: 42 milissegundos na frequência baixa e 55 milissegundos na frequência alta. Essa superioridade decorre do fato de que este método é baseado em uma rede convolucional gráfica relacional consciente, que atribui matrizes de pesos diferentes a diferentes tipos de relações semânticas legais, evitando assim a sobrecarga computacional do compartilhamento de parâmetros gerais em alta concorrência, como ocorre nas abordagens clássicas. Em contraste, o TransE e o ComplEx, que são baseados em decomposição tensorial, degradam drasticamente em altas frequências. Eles não conseguem tratar eficientemente a transformação não linear de interações de longo alcance entre relações jurídico-técnicas, resultando em maior latência. Em termos do tempo para pares de solicitações, o método deste artigo também é superior. Na configuração de baixa frequência, sua taxa de transferência é de 230 solicitações/segundo, muito acima das demais abordagens. Com o aumento da frequência, a taxa de transferência diminui, mas a redução é controlável, mesmo em cenários de alta frequência, atingindo ainda 190 solicitações/segundo. Essa robustez é atribuída à estratégia de incorporação temporária de nós e ao design paralelo do caminho de retropropagação do gradiente nesta abordagem, o que garante precisão no rastreamento em lote enquanto processa eficientemente solicitações em lote. Abordagens gerais, por não serem especificamente otimizadas, degradam significativamente seu desempenho ao enfrentar consultas simultâneas, tornando-se, portanto, inadequadas para monitoramento em tempo real.
Validação da capacidade de generalização entre domínios da cobertura de restrições legais
O procedimento de avaliação é realizado sob a perspectiva da capacidade de domínio cruzado da modelagem de restrições legais, em que os dois indicadores de quantificação são a cobertura jurisdicional e a taxa de detecção de conflitos de restrições. Três tipos de complexidade entre jurisdições, a saber, jurisdição única, jurisdição bilateral e jurisdição multilateral, foram projetados para o experimento. A fim de eliminar o viés de avaliação introduzido pela diferença arquitetural, todos os métodos concorrentes são repetidos 30 vezes e os resultados médios são relatados para permitir uma comparação justa da capacidade de generalização.
Conforme mostrado na Tabela 3, esta abordagem alcança consistentemente resultados melhores do que todas as linhas de base em três níveis de complexidade de jurisdição legal, e a degradação é mais suave. Ela fornece uma taxa de detecção de conflitos de quase 89% com cobertura jurídica de 94% em um cenário de única jurisdição legal. Ao ser generalizada para jurisdições legais multilaterais, ainda é capaz de fornecer cobertura de 87% com taxa de detecção de conflitos de 81%. Em contraste, métodos tradicionais de incorporação (por exemplo, TransE e Node2Vec) sofrem uma queda na cobertura para cerca de 60% em ambientes multilaterais, com taxas de detecção de conflitos geralmente mais baixas, o que indica que são inadequados para lidar com a heterogeneidade semântica entre jurisdições legais. No entanto, KG-BERT e GNNExplainer apresentam alguma melhoria com modelos linguísticos pré-treinados adicionais ou módulos de interpretação, mas ainda sofrem com degradação acentuada de desempenho em situações onde as jurisdições legais se sobrepõem.
| Método | Configuração Jurisdicional | Cobertura de Domínio Legal | Taxa de Detecção de Conflitos de Restrição |
| Proposto | Única | 0,94 ± 0,02 | 0,89 ± 0,03 |
| Bilateral | 0,91 ± 0,03 | 0,85 ± 0,04 | |
| Multilateral | 0,87 ± 0,04 | 0,81 ± 0,05 | |
| TransE | Única | 0,76 ± 0,05 | 0,52 ± 0,06 |
| Bilateral | 0,68 ± 0,06 | 0,45 ± 0,07 | |
| Multilateral | 0,61 ± 0,07 | 0,38 ± 0,08 | |
| ComplEx | Única | 0,79 ± 0,04 | 0,55 ± 0,05 |
| Bilateral | 0,72 ± 0,05 | 0,48 ± 0,06 | |
| Multilateral | 0,65 ± 0,06 | 0,41 ± 0,07 | |
| GNNExplainer | Única | 0,82 ± 0,04 | 0,61 ± 0,05 |
| Bilateral | 0,75 ± 0,05 | 0,54 ± 0,06 | |
| Multilateral | 0,68 ± 0,06 | 0,47 ± 0,07 | |
| KG-BERT | Única | 0,80 ± 0,04 | 0,58 ± 0,05 |
| Bilateral | 0,73 ± 0,05 | 0,51 ± 0,06 | |
| Multilateral | 0,66 ± 0,06 | 0,44 ± 0,07 | |
| Node2Vec | Única | 0,74 ± 0,05 | 0,49 ± 0,06 |
| Bilateral | 0,66 ± 0,06 | 0,42 ± 0,07 | |
| Multilateral | 0,59 ± 0,07 | 0,36 ± 0,08 |
Tabela 3: Cobertura jurisdicional e taxa de detecção de conflitos de restrições. Resultados de generalização cruzada entre domínios sob jurisdições legais únicas, bilaterais e multilaterais. A cobertura jurisdicional (Eq. 18) e a taxa de detecção de conflitos de restrições (Eq. 19) são apresentadas como média ±± DP ao longo de 30 execuções. O método proposto mantém alta cobertura (≥87%) e detecção (≥81%) mesmo na configuração multilateral mais complexa, enquanto os métodos de referência apresentam degradação substancial.
Essa discrepância surge dos processos de modelagem subjacentes inteiramente distintos. Abordagens existentes de incorporação de grafos de conhecimento (por exemplo, TransE, ComplEx) aproveitam relações geométricas em um espaço vetorial estático para modelagem e nunca diferenciam semânticas jurídicas binárias, como "proibição" e "permissão", o que as impede de lidar com as regulamentações sutis do mesmo ato médico em diferentes sistemas jurídicos. Embora o KG-BERT possa capturar o contexto textual, ele carece de poder explícito de raciocínio estrutural e tem dificuldade em raciocinar com dependências normativas e restrições conflitantes entre cláusulas. Em vez disso, o modelo proposto constrói um grafo heterogêneo direcionado ao aumentar quatro tipos de arestas semânticas jurídicas ("violação", "base", "disparo" e "atribuição") e integra convolução de grafo sensível às relações com retropropagação de gradiente. Como resultado, o modelo proposto não apenas mantém a direcionalidade causal da lógica jurídica, mas também alinha dinamicamente cláusulas semanticamente paralelas e detecta regras contraditórias em entradas multissource do domínio jurídico. Portanto, em cenários complexos com conflitos frequentes de obrigações, responsabilidades sobrepostas ou prioridades incertas para aplicação dentro de um sistema jurídico multilateral, a metodologia oferece um meio de identificar com precisão as fontes de contradições de forma estruturada e traduzi-las em inferências interdisciplinares com alta cobertura e exatidão.
Estudo de ablação
Para isolar a contribuição de cada componente principal, realizamos um estudo de ablação removendo ou substituindo módulos-chave dentro do nosso framework na configuração de grafo denso (D = 1.0). Especificamente, comparamos o modelo completo com três variantes: (1) sem convolução sensível a relações, em que todos os tipos de arestas compartilham uma única matriz de transformação; (2) sem mecanismo de atenção, em que as contribuições dos vizinhos são uniformemente médias; e (3) sem rastreamento de gradiente, em que as fontes de viés são identificadas usando uma heurística simples baseada no grau do nó, em vez da reconstrução de subgrafos baseada em gradiente.
Tabela 4 apresenta os resultados de ablação, revelando contribuições distintas de cada componente. A remoção da convolução sensível a relações causou a queda mais acentuada no desempenho, com a precisão na raiz diminuindo de 0,95 para 0,81 e a precisão no caminho de 0,93 para 0,78. Isso confirma que a modelagem de arestas específica por tipo é fundamental para capturar a diversidade semântica das relações jurídicas, pois compartilhar uma única matriz de transformação entre todos os tipos de relação resulta em perda substancial de informação durante o alinhamento cruzado de modalidades. O mecanismo de atenção também contribui de forma significativa; sua remoção reduz a precisão na raiz para 0,88 e a precisão no caminho para 0,85, indicando que a ponderação dinâmica das mensagens dos vizinhos melhora a capacidade do modelo de distinguir caminhos jurídicos influentes, embora seu impacto seja secundário em relação à sensibilidade aos tipos de relação. A remoção do rastreamento de gradiente gerou a menor queda na precisão (0,91), mas a maior queda na precisão do caminho (0,76), sugerindo que, embora heurísticas simples possam identificar parcialmente os nós de origem, a reconstrução precisa da estrutura de propagação depende fortemente da análise de sensibilidade baseada em gradiente. No geral, os três componentes contribuem de maneira significativa para o desempenho do framework na localização de vieses, sendo a convolução sensível a relações a mais essencial e o rastreamento de gradiente indispensável para a precisão em nível de caminho.
| Variante do Modelo | Recall da Raiz | Precisão do Caminho |
| Modelo Completo | 0.95 ± 0.02 | 0.93 ± 0.03 |
| sem convolução sensível a relações | 0.81 ± 0.03 | 0.78 ± 0.04 |
| sem mecanismo de atenção | 0.88 ± 0.02 | 0.85 ± 0.03 |
| sem retropropagação do gradiente | 0.91 ± 0.03 | 0.76 ± 0.05 |
Tabela 4: Resultados do estudo de ablação em grafo denso (D = 1.0). Efeito da remoção de componentes principais: (sem convolução com reconhecimento de relações), (sem mecanismo de atenção) e (sem rastreamento de gradiente). As métricas (precisão de raiz e precisão de caminho) são média ±± DP de 30 execuções. O modelo completo apresenta o melhor desempenho, confirmando que cada componente contribui de forma significativa, sendo a convolução com reconhecimento de relações a mais crítica.
DISPONIBILIDADE DE DADOS:
O conjunto de dados do grafo de conhecimento heterogêneo estruturado gerado e analisado durante este estudo, incluindo todos os dados de nós e arestas (285 nós distribuídos em quatro tipos de entidade e 1.247 arestas direcionadas com quatro relações semânticas permitidas), foi depositado no repositório Figshare sob o DOI: https://doi.org/10.6084/m9.figshare.33117644. Os dados estão disponíveis publicamente a partir da data de publicação deste artigo. Os arquivos correspondentes ao conjunto de dados também são fornecidos como Arquivo Suplementar 1.
Arquivo Suplementar 1: Arquivos de conjunto de dados utilizados neste estudo.Clique aqui para baixar este arquivo.
Discussão
A integração da IA médica em decisões clínicas levanta desafios legais na atribuição de responsabilidade, dificultada pela lacuna semântica entre textos jurídicos não estruturados e algoritmos do tipo caixa-preta. Para superar isso, propomos um grafo de conhecimento baseado em GNN que modela cláusulas legais, comportamentos médicos, módulos de algoritmos e partes responsáveis como nós heterogêneos, conectados por meio de quatro relações jurídico-semânticas direcionadas (violação, base, gatilho, atribuição). Essa estrutura fornece uma interface computável para alinhamento cruzado de modalidades e rastreamento de vieses.
Nosso método alcança desempenho superior em todas as métricas. Sob densidades variáveis de grafos, a precisão no alinhamento de entidades (≥0,92) e a preservação de relações (≥0,88) superam TransE, ComplEx e KG‑BERT. A localização de viés apresenta recall da raiz (0,95 ±± 0,02) e precisão do caminho (0,93 ±± 0,03), excedendo significativamente o GNNExplainer. O monitoramento dinâmico mantém baixa latência (42–55 ms) e alta taxa de transferência (190–230 req/s), enquanto testes interjurisdicionais mostram cobertura robusta (≥87%) e detecção de conflitos (≥81%). Esses resultados confirmam a eficaz integração entre semântica jurídica e técnica com rastreamento de viés interpretável.
Três inovações sustentam nosso sucesso: (1) arestas jurídico-semânticas tipificadas capturam distinções causais e normativas frequentemente ignoradas por incorporações uniformes20,21; (2) convolução sensível a relações, com matrizes de transformação dedicadas para cada tipo de relação, preserva a especificidade semântica ao mesmo tempo que permite troca entre tipos38,39; e (3) quantificação baseada em gradientes das contribuições e agrupamento orientado por comunidade transformam viés global em identificação local de fontes, superando as limitações de métodos explicativos pós-hoc32,33. Isso transfere a conformidade de verificação estática de regras para um raciocínio dinâmico e consciente da estrutura.
As limitações incluem a dependência de extração de relações definidas manualmente e dificuldades com cláusulas vagas. Os trabalhos futuros integrarão formalismos de lógica jurídica (por exemplo, lógica derrogável26,27) e aprendizado online para regulamentações em evolução, além de se estender a outros domínios de alto risco (condução autônoma, finanças). O feedback com o usuário no laço aprimorará ainda mais a atribuição. Essas direções consolidarão a IA baseada em grafos e explicável como fundamento para sistemas inteligentes confiáveis.
Divulgações
O manuscrito não foi previamente publicado nem está sendo considerado por qualquer outro periódico. Todos os autores aprovaram o conteúdo do artigo. Os autores declaram que não possuem conflitos de interesses financeiros.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| ComplEx | Implementação de código aberto (por exemplo, OpenKE) | Version 1.0 | Modelo básico de incorporação complexa para comparação de grafos de conhecimento |
| GNNExplainer | Implementação de código aberto (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Modelo básico de interpretabilidade de GNN para rastreamento de viés |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Processador central para treinamento do modelo e pré-processamento de dados |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Modelo básico de incorporação de KG baseado em Transformer para alinhamento semântico |
| Node2Vec | Implementação de código aberto (https://github.com/aditya-grover/node2vec) | Version 1.0 | Modelo básico de incorporação de nós baseado em caminhada aleatória |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | GPU de alto desempenho que acelera o treinamento de redes neurais em grafos |
| Ours (Relation-aware GCN) | Implementação personalizada em PyTorch | PyTorch 1.12.0 | Framework proposto com transformações por relação, atenção e rastreamento de gradiente |
| TransE | Implementação de código aberto (por exemplo, OpenKE) | Version 1.0 | Modelo básico de incorporação translacional para comparação de grafos de conhecimento |
Referências
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.