Este protocolo apresenta a Rede Desacoplada de Três Fluxos (TDE-Net), uma estrutura de reconstrução de imagem a partir de EEG que combina representações complementares de EEG, alinhamento visual em espaço duplo e decodificação por difusão.
Artigo de método
Rede Desemaranhada de Três Fluxos com Fusão Adaptativa de Espaço Duplo para Reconstrução de Imagens Baseada em Eletroencefalografia no THINGS-EEG2
Neste artigo
Resumo
Resumo
A reconstrução de estímulos visuais a partir de eletroencefalografia (EEG) não invasiva exige o mapeamento de respostas neurais breves e ruidosas em representações visuais significativas, apesar da amostragem espacial limitada. As abordagens atuais de EEG para imagem utilizam diversas representações neurais e estratégias gerativas, exigindo fluxos de trabalho reprodutíveis que desacoplem contribuições estruturais e semânticas. Este protocolo apresenta a Rede Tri-Stream Desacoplada (TDE-Net), uma estrutura computacional para reconstrução de imagens baseada em EEG. O protocolo utiliza gravações pré-processadas do conjunto THINGS-EEG2 e organiza as informações de EEG em três fluxos: um ancoradouro de EEG bruto, um fluxo de grafo funcional específico por amostra e um fluxo semântico temporal multi-escala. O fluxo de grafo captura relações no domínio da frequência entre canais de EEG por meio de convolução em grafos e aprendizado contrastivo entre tentativas, enquanto o fluxo semântico extrai características relevantes para a tarefa por meio de ponderação espacial adaptativa e convoluções temporais multi-escala. As características estruturais e semânticas são mapeadas separadamente em espaços latentes de autoencoder variacional (VAE) e de pré-treinamento contrastivo entre linguagem e imagem (CLIP), combinadas utilizando pesos de fusão selecionados por conjunto de desenvolvimento e decodificadas usando o modelo Stable UnCLIP. Em 10 participantes, a TDE-Net alcançou uma precisão média de identificação pareada CLIP de 0,8135, com métricas complementares demonstrando correspondência estrutural e no espaço de características. Análises de ablação e no nível de representação caracterizaram adicionalmente as contribuições de cada fluxo individual. Este protocolo fornece uma estrutura reprodutível para investigar representações de EEG complementares e a reconstrução visual baseada em modelos de difusão.
Introdução
A decodificação da percepção visual é uma área de pesquisa interdisciplinar em interfaces cérebro-computador (BCIs) e neurociência cognitiva. A imagem por ressonância magnética funcional (fMRI) permitiu a reconstrução realista de imagens1,2,3,4, mas seu custo, portabilidade limitada e atraso hemodinâmico restringem algumas aplicações. A eletroencefalografia (EEG) fornece medições temporais em escala de milissegundos com instrumentação comparativamente acessível, mas sua baixa relação sinal-ruído e amostragem espacial limitada dificultam a reconstrução de imagens a partir de EEG.
A complexidade do método deve ser interpretada à luz do compromisso geral entre viés e variância5. Métodos iniciais de decodificação visual utilizavam representações rasas ou lineares, enquanto estudos posteriores introduziram codificadores baseados em convolução compacta, em grafos e em mecanismos de atenção6,7,8,9,10,11. O alinhamento cruzado de modalidades também evoluiu do aprendizado de recursos multimodais12,13 para modelos de difusão latente e grandes codificadores de visão14,15,16. Essas abordagens estabelecem referências úteis, mas suas representações de entrada, alvos latentes e decodificadores diferem, portanto os resultados devem ser interpretados dentro de seus respectivos contextos experimentais.
O objetivo do TDE-Net é fornecer um framework modular para reconstrução de imagem a partir de EEG que separa as representações estruturais e semânticas do EEG, alinha-as com espaços latentes visuais complementares e integra essas previsões para a reconstrução de imagens baseada em difusão. Estudos recentes sobre decodificação de EEG visual introduziram a geração guiada por transformador no EEG-CLIP17, o alinhamento com foco no primeiro plano combinado a redes cerebrais dinâmicas no FSDBN18, o desfoque adaptativo guiado por cognição com alinhamento sob restrição de informação19 e a aprendizagem biomimética bidirecional em múltiplos níveis20. Outros métodos relacionados de reconstrução de imagem a partir de EEG, incluindo o Perceptograma e a difusão guiada com base em incorporações de EEG, fornecem referências adicionais para a predição latente21,22. O TDE-Net difere na sua organização do modelo: ele separa explicitamente uma âncora de EEG bruto, uma representação funcional específica da amostra em forma de grafo e uma representação semântica temporal, realizando em seguida um alinhamento assimétrico aos espaços VAE e CLIP antes da fusão. Essa organização permite que as contribuições estruturais e semânticas sejam examinadas separadamente por meio de análises no espaço latente e no nível da imagem. Em comparação com abordagens de reconstrução EEG-imagem baseadas em única representação ou alinhamento direto, esse design modular oferece caminhos separados para aspectos estruturais e semânticos, preserva uma referência linear do EEG durante a predição latente e permite a avaliação independente da contribuição de cada representação por meio de análises de ablação e do espaço latente.
O TDE-Net foi projetado para experimentos com respostas de EEG pareadas e estímulos visuais, condições suficientes de treinamento e uma janela pós-estímulo curta na qual a reconstrução semântica é o objetivo principal. Sua organização em estágios permite a análise separada da extração de características, alinhamento latente, fusão e decodificação por difusão. Os mapeamentos lineares continuam sendo adequados para conjuntos de dados muito pequenos ou configurações que priorizam a complexidade mínima do modelo, enquanto os decodificadores neurais de ponta a ponta podem ser preferíveis quando estão disponíveis grandes conjuntos de dados específicos para a tarefa e implantação em tempo real.
O presente protocolo avalia a configuração proposta no contexto THINGS-EEG2 de apresentação rápida em série visual (RSVP, na sigla em inglês). As principais contribuições incluem um esquema de representação tripla de EEG composto por uma âncora linear bruta, um fluxo de grafo funcional específico por amostra e um fluxo semântico temporal em múltiplas escalas. Essas representações complementares são mapeadas para espaços latentes VAE e CLIP, e as previsões correspondentes são combinadas antes da decodificação por difusão. A estrutura é avaliada em todos os 10 sujeitos do THINGS-EEG2 utilizando medidas de reconstrução por sujeito, análises de ablação e de janela temporal, e visualizações em nível de representação, com mapas de atenção espacial interpretados como análises de canais do couro cabeludo (topográficas).
Protocolo
O protocolo compreende seis etapas sequenciais: preparação dos ensaios de EEG e latentes de imagens; construção do fluxo estrutural de grafos; treinamento do codificador de EEG semântico; ajuste dos mapeamentos CLIP/VAE; fusão das predições latentes, seguida pela decodificação de imagens; e avaliação dos resultados em nível de imagem e em nível de representação (Figura 1).
1. Prepare os ensaios de EEG e os embeddings de imagens
- Documente a coorte de origem e o protocolo de aquisição.
NOTA: A coorte de origem foi composta por 10 adultos saudáveis (idade média de 28,5 anos, DP 4,0; oito mulheres e dois homens) com visão normal ou corrigida para normal. Os participantes forneceram consentimento escrito informado, receberam compensação financeira e completaram o protocolo original com aprovação do comitê de ética do Departamento de Educação e Psicologia da Freie Universität Berlin, de acordo com a Declaração de Helsinki23.- Utilize o conjunto de dados THINGS-EEG2 de acesso público como recurso para análise secundária.
- Utilize a partição de origem com 1.654 conceitos de treinamento e 200 conceitos de teste não sobrepostos extraídos do THINGS, com as proporções de 27 categorias de nível superior balanceadas entre as partições. Selecione dez imagens com fundo natural para cada conceito de treinamento e uma imagem para cada conceito de teste, resultando em 16.540 condições de treinamento e 200 condições de teste retidas.
NOTA: No presente estudo, a tarefa de detecção de alvo utilizou imagens separadas de Buzz Lightyear como estímulos de captura, que foram excluídas da análise de reconstrução apresentada23. - Siga a cronometragem do protocolo original de apresentação visual em série rápida ao interpretar as épocas.
NOTA: Cada sequência iniciou com um intervalo em branco de 750 ms, seguido por 20 imagens apresentadas centralmente. Cada imagem subtendia 7 graus do ângulo visual, permanecia na tela por 100 ms e tinha uma assincronia de início do estímulo de 200 ms, correspondendo a 5 imagens/s. Um segundo intervalo em branco de 750 ms precedia um período de resposta de até 2 s, durante o qual os participantes primeiro piscavam e depois relatavam se uma imagem-alvo havia aparecido. Um alvo de fixação central em forma de alvo permanecia visível durante toda a sequência23. - Considere a estrutura original das sessões de gravação ao organizar o conjunto de dados. Utilize os dados das quatro sessões de gravação realizadas por cada participante, sendo cada sessão composta por quatro séries de teste e 15 séries de treinamento de aproximadamente 5 min cada. Mantenha quatro repetições para cada condição de treinamento e 80 repetições para cada condição de teste, correspondendo a 82.160 ensaios analisados com imagens não-alvo por participante23.
- Utilize os dados de EEG adquiridos com a configuração original de gravação THINGS-EEG2. Essas gravações foram obtidas a 1.000 Hz usando um EASYCAP de 64 eletrodos dispostos de acordo com o sistema internacional 10-10 e um amplificador BrainVision actiCHamp, com Fz como referência em tempo real e um filtro passa-banda online de 0,1–100 Hz.
- Utilize os dados pré-processados disponibilizados, que foram segmentados de -200 a 800 ms em relação ao início da imagem, corrigidos por linha de base usando o intervalo pré-estímulo, subamostrados para 100 Hz, restringidos a 17 canais parieto-ocipitais, livres de ensaios com alvo e submetidos à normalização multivariada de ruído independentemente em cada sessão de gravação23.
- Prepare tensores de ensaios de EEG
- Carregue os tensores pré-processados do THINGS-EEG2 disponibilizados para os 10 participantes. A partir de cada época de origem, selecione o intervalo pós-estímulo de 0–800 ms e os 17 canais parieto-ocipitais, mantendo a taxa de amostragem de 100 Hz para obter 80 pontos temporais por ensaio. Mantenha a partição de origem com 16.540 condições de imagem de treinamento e 200 condições de teste retidas para cada participante23 (Figura 2).
- Para o pré-treinamento do fluxo de grafos, mantenha as quatro repetições independentes de treinamento para cada condição de imagem e selecione duas repetições para formar um par positivo. Para os fluxos bruto e semântico, faça a média das quatro repetições de treinamento e a média das 80 repetições de teste disponíveis para cada condição.
- Utilize os tensores pré-processados do THINGS-EEG2 produzidos pelo pipeline original MVNN; dentro de cada extrator de características implementado, aplique a padronização Z por arquivo antes do cálculo das características.
NOTA: Esse uso assimétrico de repetições é intencional: ensaios repetidos fornecem pares positivos para o pré-treinamento contrastivo no fluxo de grafos, enquanto os fluxos bruto e semântico utilizam médias por condição para o mapeamento supervisionado. O desenho resultante combina aprendizado de invariância ao nível de repetição no fluxo estrutural com predição latente ao nível de condição nos fluxos bruto e semântico.
- Prepare latentes de imagem emparelhados
- Utilize o codificador de visão CLIP de 1.024 dimensões e o codificador VAE associado ao sd2-community/stable-diffusion-2-1-unclip para extrair alvos de imagem emparelhados. Redimensione as imagens de entrada do VAE para 768 x 768 pixels, armazene o modo posterior do VAE como um vetor de 36.864 dimensões (4 x 96 x 96) e mantenha a ordem das condições de imagem.
- Salve três formas de entrada: tensores com ensaios repetidos para aprendizado contrastivo de grafos, tensores médios de EEG para os fluxos bruto e semântico e latentes de imagem CLIP/VAE emparelhados para mapeamento supervisionado.
- Normalize e armazene em cache as entradas
- Armazene em cache os tensores de EEG pré-processados, as características extraídas de grafos e semânticas e os latentes de imagem emparelhados com ordem fixa de condições.
- Durante o mapeamento ridge, estime os parâmetros de padronização por característica a partir das entradas de treinamento e aplique esses parâmetros às entradas de desenvolvimento e teste.
2. Construa o fluxo estrutural do grafo
- Construa o fluxo de grafos a partir de ensaios de treinamento repetidos e exporte características em nível de nó após o pré-treinamento contrastivo. Utilize a mesma regra de construção de grafos para a extração de características no teste, sem usar latentes das imagens de teste durante o cálculo das características.
- Transforme os ensaios de EEG em entradas de grafos no domínio da frequência
- Transforme cada ensaio com uma transformada rápida de Fourier (FFT) de 80 pontos e mantenha os primeiros 40 bins de frequência não negativa, abrangendo 0 Hz–48,75 Hz na taxa de amostragem de 100 Hz. Utilize o espectro de amplitude logarítmica como uma matriz de características de nó de dimensão 17 x 40, X. Para cada amostra de EEG, calcule C_ij = |corr(X_i, X_j)| entre cada par dos vetores de características dos 17 canais.
- Em cada linha, mantenha a autocorrelação diagonal e as três maiores correlações fora da diagonal (k = 4 entradas mantidas, incluindo a autocorrelação), em seguida, simetrize a matriz mantida para definir a matriz de adjacência funcional ponderada específica para a amostra, A. Aplique normalização simétrica por grau antes da convolução no grafo.
- Utilize esta construção durante o treinamento e o teste; as coordenadas físicas dos eletrodos não são usadas para definir um grafo fixo.
NOTA: Manter a conectividade própria preserva o sinal de cada nó, enquanto limitar as conexões entre canais a três por linha controla a densidade do grafo antes da simetrização. A representação no domínio da frequência fornece uma descrição compacta baseada em amplitude para a construção do grafo, mas não preserva a fase nem todos os detalhes temporais finos dos potenciais relacionados a eventos (ERP) sincronizados; esses aspectos temporais permanecem disponíveis nos fluxos temporais brutos de âncora e semânticos.
- Agregue a topologia dos eletrodos com convolução espectral em grafos
- Aplique uma rede neural convolucional em grafos (GCN) de cinco camadas24 com 80 unidades ocultas por camada, ativações ReLU, dropout de 0,3, normalização simétrica por grau e agrupamento médio de grafos.
- Utilize uma cabeça de projeção de duas camadas com dimensão 80 para o objetivo contrastivo e exporte a representação em nível de nó de dimensão 17 x 80 para fusão estrutural. Aplique convolução espectral na matriz de adjacência dependente da entrada; não introduza um operador de convolução dinâmica separado.
- Treine o fluxo de grafos com aprendizado contrastivo entre ensaios
- Dentro da partição de treinamento, selecione aleatoriamente duas repetições da mesma condição de imagem como um par positivo e trate as representações de outras condições no lote como negativas. Otimize o objetivo contrastivo InfoNCE25 com temperatura τ = 0,5, tamanho de lote 32, Adam com taxa de aprendizado 5 x 10⁻⁴, 20 épocas, annealing cossenoide até eta_min = 10–6 e semente aleatória 42.
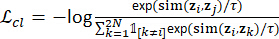 (1)
- Defina a similaridade cosseno no objetivo contrastivo e use a função indicadora para identificar repetições emparelhadas. Mantenha a dimensão da projeção em 80 e aplique a mesma temperatura em ambas as direções da perda contrastiva.
- Dentro da partição de treinamento, selecione aleatoriamente duas repetições da mesma condição de imagem como um par positivo e trate as representações de outras condições no lote como negativas. Otimize o objetivo contrastivo InfoNCE25 com temperatura τ = 0,5, tamanho de lote 32, Adam com taxa de aprendizado 5 x 10⁻⁴, 20 épocas, annealing cossenoide até eta_min = 10–6 e semente aleatória 42.
- Exporte características de nó para fusão precoce
- Congele o codificador de grafos após o pré-treinamento e exporte as características de nó dos 17 canais com 80 dimensões por nó. Concatene essas características com o EEG bruto médio ao longo da dimensão de características para obter a entrada estrutural bruta-mais-grafo para o mapeamento VAE.
- Salve o tensor de características bruto-mais-grafo resultante e utilize-o apenas como entrada estrutural para o ramo de regressão VAE.
3. Treinar o codificador semântico de EEG
- Treine o codificador semântico de EEG nos tensores de EEG médios de 17 canais e 80 pontos.
- Optimize a perda de incorporação cosseno com AdamW (taxa de aprendizado 5 x 10⁻⁴; decaimento de peso 0,01), tamanho de lote 64, 50 épocas, annealing cosseno até eta_min = 10–6, semente aleatória 42 e saída de 1.024 dimensões.
- Aplique filtragem espacial adaptativa orientada por dados
- Aplique uma operação ponderada de produto tensorial canal a canal no tensor de entrada de EEG e expanda a representação para uma profundidade de 9. Trate esta operação como uma camada ponderada de canais orientada por dados, e não como uma implementação do filtro espacial clássico Padrão Espacial Comum (CSP)26.
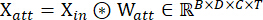 (2)
- Use a operação ponderada de canais aprendida para produzir nove mapas de características e, em seguida, encaminhe-os para o bloco de convolução temporal multi-escala.
- Aplique uma operação ponderada de produto tensorial canal a canal no tensor de entrada de EEG e expanda a representação para uma profundidade de 9. Trate esta operação como uma camada ponderada de canais orientada por dados, e não como uma implementação do filtro espacial clássico Padrão Espacial Comum (CSP)26.
- Modele campos receptivos temporais em múltiplas escalas
- Aplique três convoluções temporais paralelas com tamanhos de kernel de 5, 15 e 31 amostras, utilizando preenchimento de comprimento igual. Concatene as três saídas para obter 24 canais de características temporais e aplique normalização por lote e ativação GELU.
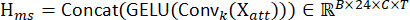 (3)
OBSERVAÇÃO: As convoluções fornecem campos receptivos temporais multi-escala dentro do quadro mais amplo de modelagem convolucional temporal27. - Use os três tamanhos de kernel como filtros temporais multi-escala; interprete suas saídas como representações de sinal aprendidas, e não como atribuições diretas a componentes ERP específicos.
- Aplique três convoluções temporais paralelas com tamanhos de kernel de 5, 15 e 31 amostras, utilizando preenchimento de comprimento igual. Concatene as três saídas para obter 24 canais de características temporais e aplique normalização por lote e ativação GELU.
- Recalibre canais de características relevantes para a tarefa
- Aplique atenção de profundidade com agrupamento médio adaptativo à dimensão temporal e uma convolução com kernel 7 seguida pela normalização Softmax, conforme os princípios de recalibração de canais28. Multiplique os pesos de atenção resultantes elemento a elemento com o tensor de características multi-escala.
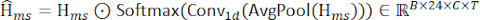 (4)
- Use a saída de atenção como entrada para o bloco de convolução espacial e não interprete os pesos aprendidos como localização neural causal.
- Aplique atenção de profundidade com agrupamento médio adaptativo à dimensão temporal e uma convolução com kernel 7 seguida pela normalização Softmax, conforme os princípios de recalibração de canais28. Multiplique os pesos de atenção resultantes elemento a elemento com o tensor de características multi-escala.
- Exporte o vetor global de características semânticas de EEG
- Aplique uma convolução 1 x 1 seguida por uma convolução depthwise abrangendo os 17 canais dos eletrodos, normalização por lote, ativação GELU, agrupamento médio com fator 2 e dropout p = 0,5. Achate o resultado e projete-o em um vetor de características semânticas de 1.024 dimensões.
- Salve um vetor de características semânticas de 1.024 dimensões para cada amostra média de EEG.
4. Mapear características do EEG para os espaços latentes CLIP e VAE
- Associe cada tensor de características de EEG com o latente da imagem que possui o mesmo índice de condição. Ajuste mapeamentos separados para os alvos CLIP e VAE, e mantenha todas as condições de imagem na partição de treinamento distintas daquelas na partição de teste reservada.
- Ajuste regressão ridge29 com intercepto e no máximo 50.000 iterações. Utilize λCLIP = 1.000 para os mapeamentos de bruto-a-CLIP e semântico-a-CLIP, λVAE = 0 para o ancoramento de bruto-a-VAE e λVAE, struct = 1.000 para o mapeamento de fluxo estrutural-a-VAE. Padronize as entradas dos mapeamentos utilizando as estatísticas da partição de ajuste.
NOTA: O fluxo estrutural é a concatenação das características brutas de EEG e características de grafo; o fluxo semântico contém a saída do codificador semântico sem concatenação de características brutas. - Mapeie características estruturais para o espaço latente do VAE
- Ajuste o mapeamento ridge de fluxo estrutural-a-VAE com λVAE,struct = 1.000 e prediga o latente do VAE com 36.864 dimensões. Este ramo recebe as representações concatenadas de EEG bruto e de grafo; é o único ramo não linear que concatena explicitamente características brutas.
- Mapeie características semânticas para o espaço latente do CLIP
- Ajuste o mapeamento ridge de fluxo semântico-a-CLIP com λCLIP = 1.000 e prediga a representação do CLIP com 1.024 dimensões. A entrada semântica não é concatenada com o EEG bruto.
NOTA: Neste artigo, λ denota regularização ridge e α denota um peso de fusão latente. - Avalie o alinhamento no espaço latente por meio do coeficiente de correlação de Pearson (PCC) por amostra. Utilize condições de desenvolvimento para seleção do peso de fusão e avalie as 200 condições de teste reservadas somente após os mapeamentos e pesos de fusão terem sido fixados.
- Ajuste o mapeamento ridge de fluxo semântico-a-CLIP com λCLIP = 1.000 e prediga a representação do CLIP com 1.024 dimensões. A entrada semântica não é concatenada com o EEG bruto.
5. Fundir previsões latentes e executar a reconstrução por difusão
- Selecione αVAE e αCLIP usando uma divisão de desenvolvimento por condição derivada apenas das 16.540 condições de treinamento. Com a semente aleatória 42, utilize os mesmos índices de ajuste (90%) e índices de desenvolvimento (10%) para os 10 sujeitos; as 200 condições de teste reservadas permanecem fora deste procedimento.
NOTA: As penalidades ridge e o coeficiente de preservação estrutural foram fixados como valores de configuração antes da avaliação final com os dados reservados e não foram ajustados com base nas 200 condições de teste. - Para cada sujeito e cada valor candidato de α em {0,00, 0,05, ..., 1,00}, ajuste o codificador supervisionado por alvo e os mapeamentos ridge no subconjunto de ajuste e calcule a correlação de Pearson latente média por amostra no subconjunto de desenvolvimento.
- Média dos valores de PCC por sujeito com peso igual entre os 10 sujeitos, e selecione os pesos no espaço CLIP e no espaço VAE independentemente pelo valor máximo da média entre sujeitos. Congele ambos os valores antes de refazer o ajuste dos modelos de treinamento finais e avaliar as condições de teste reservadas.
NOTA: Este procedimento selecionou αCLIP = 0,55 e αVAE = 0,65. - Para o espaço VAE, defina a predição fundida como a soma ponderada do ancoramento bruto-para-VAE e da predição VAE do fluxo estrutural:
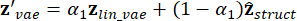 (5)
- Defina αVAE = 0,65, de modo que o ancoramento bruto-para-VAE contribua com 0,65 e a predição do fluxo estrutural contribua com 0,35. Mantenha este valor fixo para todos os sujeitos e condições de teste.
- Para o espaço CLIP, defina a predição fundida como a soma ponderada do ancoramento bruto-para-CLIP e da predição CLIP do fluxo semântico:
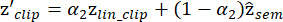 (6)
- Defina αCLIP = 0,55, de modo que o ancoramento bruto-para-CLIP contribua com 0,55 e a predição do fluxo semântico contribua com 0,45. Mantenha este valor fixo para todos os sujeitos e condições de teste.
NOTA: Interprete a operação de fusão como um conjunto ponderado fixo de predições latentes, no sentido geral de combinação de conjuntos30. Não a descreva como uma redução garantida de superajuste ou como uma solução uniformemente ótima em todas as métricas. - Carregue o pipeline fixo de imagem-para-imagem Stable UnCLIP a partir de sd2-community/stable-diffusion-2-1-unclip com pesos da variação fp16. Utilize o embedding CLIP fundido como condição semântica e o latente VAE fundido como inicialização estrutural.
NOTA: O decodificador segue os princípios de difusão com ruído e orientação sem classificador31,32. - Aplique inicialização estrutural com ruído aos latentes de difusão. Redimensione cada predição VAE de 36.864 dimensões para 4 x 96 x 96, seguindo a formulação latente do autoencoder variacional33, e adicione ruído gaussiano após multiplicar o latente estrutural pelo fator estrutural gamma = 0,02. Utilize os passos de tempo de treinamento de difusão T_diff = 1.000 e uma semente de difusão fixa igual a 0 para o procedimento de reconstrução relatado.
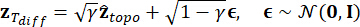 (7)
- Defina o coeficiente de preservação estrutural gamma como 0,02 na inicialização com ruído e mantenha este valor fixo para todas as condições de teste. Transmita o latente resultante ao decodificador sem utilizar informações da imagem real.
- Aplique orientação por atenção cruzada e decodifique o latente da imagem. Concatene o vetor CLIP fundido de 1.024 dimensões com o vetor de condição adicional de 1.024 dimensões usado pelo pipeline, antepor um vetor negativo de condição nula para orientação sem classificador (CFG) e decodifique com escala de orientação 7,5. Utilize o padrão do pipeline de 20 etapas de remoção de ruído e salve uma imagem PNG por condição de teste.
- Salve a imagem reconstruída com o índice original da condição de teste e mantenha o mesmo índice para todos os cálculos subsequentes de métricas.
NOTA: Tabela 1 resume o particionamento de dados, pré-processamento, construção de grafos, treinamento de modelos, mapeamento latente, fusão e configurações de decodificação utilizadas no fluxo de trabalho relatado. A planilha fornecida contém o mesmo resumo de parâmetros em formato legível por máquina.
6. Avaliar a reconstrução e o alinhamento no nível da representação
- Calcule a fidelidade de baixo nível com correlação de pixels (PixCorr) e similaridade estrutural (SSIM). Calcule as acurácias de identificação pareada das camadas 2 e 5 da AlexNet, Inception-v3 e OpenAI CLIP ViT-L/14; calcule as distâncias de correlação do EfficientNet (EffNet) e do SwAV, nas quais valores menores indicam representações de características mais próximas.
- Para a análise do CLIP, forme a matriz de correlação entre as características extraídas de 200 imagens reconstruídas e as 200 imagens reais correspondentes. Para cada reconstrução, compare a correlação com a imagem correta com as correlações com as outras 199 imagens e faça a média das 200 × 199 comparações binárias resultantes para obter a acurácia de identificação pareada do CLIP.
- Para janelas expansivas terminando em 8, 16, ..., 80 pontos temporais, ajuste os mapeamentos de EEG brutos com ridge e calcule a PCC média por amostra entre os latentes previstos e os latentes reais do CLIP e do VAE nas 200 condições de teste do sub-01. Use as previsões do CLIP e do VAE somente com fluxo semântico na janela completa como níveis de referência tracejados.
- Construa matrizes de similaridade representacional (RSMs) a partir das características do CLIP normalizadas por L2, utilizando similaridade cosseno. Ordene ambas as matrizes por agrupamento hierárquico de Ward dos embeddings reais do CLIP, usando distância euclidiana.
- Para a visualização bidimensional, derive cinco clusters k-means a partir dos embeddings reais e aplique uma projeção conjunta de PCA-50 mais t-SNE (t-distributed stochastic neighbor embedding); use o t-SNE apenas para visualização qualitativa.
- Visualize os padrões de EEG branqueados e os pesos do modelo por canal do escalpo com canais rotulados, escalas de cores explícitas e regras reprodutíveis de ordenação. Interprete esses gráficos como análises auxiliares dos sinais medidos no escalpo e dos parâmetros do modelo, não como evidência de localização de fonte cortical, ativação anatômica ou causalidade.
Resultados
O TDE-Net foi avaliado a partir de seis perspectivas complementares: desempenho de reconstrução, resultados visuais representativos, contribuição dos componentes, dependência temporal, estrutura representacional semântica e atenção nos canais do escalpo. A fidelidade de baixo nível foi avaliada usando PixCorr e SSIM, o alinhamento no espaço de características com medidas do AlexNet, Inception-v3, CLIP, EffNet e SwAV, e o desempenho em nível individual com base nos resultados dos 10 sujeitos do THINGS-EEG2. Salvo indicação em contrário, cada figura qualitativa identifica o sujeito correspondente e o subconjunto da condição de teste.
Desempenho da reconstrução e resultados representativos
Como modelo de referência interno, implementamos adicionalmente uma linha de base leve com codificador de EEG baseado em convolução e atenção. Este modelo extrai uma única representação de 1024 dimensões do EEG de cada tentativa e a mapeia independentemente nos espaços latentes do CLIP e do VAE, utilizando o mesmo protocolo de regressão de crista e decodificação por difusão do método proposto. Nas seções seguintes, este modelo é denominado Linha de Base. O codificador é a referência semântica de atenção convolucional no estilo LMDA utilizada na implementação local, com 373.950 parâmetros treináveis e uma saída de 1.024 dimensões.
Tabela 2 compara o TDE-Net com a linha de base interna de convolução com atenção e métodos representativos de reconstrução de imagem baseados em EEG, considerando as métricas relatadas. Para uma avaliação consistente, os métodos foram implementados dentro de um quadro experimental unificado, utilizando a mesma partição THINGS-EEG2, entrada de 17 canais, pré-processamento, condições de teste reservadas e definições de métricas, mantendo ao mesmo tempo suas arquiteturas específicas. No resumo com dez sujeitos, o TDE-Net alcançou valores médios ± DP de 0,2531 ± 0,0138 para PixCorr, 0,3388 ± 0,0025 para SSIM, 0,8777 ± 0,0115 para AlexNet Camada 2, 0,9153 ± 0,0116 para AlexNet Camada 5, 0,7606 ± 0,0213 para Inception-v3, 0,8135 ± 0,0074 para acurácia de identificação por pares CLIP, 0,8285 ± 0,0122 para distância EffNet e 0,5085 ± 0,0101 para distância SwAV. O resumo por sujeito complementa os exemplos qualitativos de um único sujeito.
O valor CLIP indica a precisão de identificação por pares, e não a similaridade cosseno ou uma pontuação genérica de recurso CLIP. Como o fluxo semântico é treinado em direção a um alvo no espaço CLIP, esta medida reflete tanto a reconstrução semântica quanto o alinhamento com o alvo de um ramo. Por isso, é considerado em conjunto com PixCorr, SSIM, AlexNet, Inception-v3, EffNet e SwAV, que caracterizam aspectos complementares da fidelidade de baixo nível e da concordância no espaço de características.
Para caracterizar o desempenho em nível de sujeito, aplicamos o procedimento completo do teste TDE-Net aos sujeitos sub-01 a sub-10, utilizando as mesmas 200 condições de imagem reservadas para cada sujeito. Tabela 3 apresenta as oito medidas de avaliação para cada sujeito, juntamente com a média entre sujeitos e o desvio padrão amostral. A precisão média de identificação por pares CLIP foi de 0,8135 (DP, 0,0074). Os valores médios de PixCorr e SSIM foram de 0,2531 e 0,3388, respectivamente. As precisões médias nas Camadas 2 e 5 da AlexNet foram de 0,8777 e 0,9153, e a precisão média da Inception-v3 foi de 0,7606. As distâncias EffNet e SwAV, nas quais valores menores são melhores, tiveram médias de 0,8285 e 0,5085, respectivamente. A dispersão limitada entre sujeitos nessas medidas indica comportamento quantitativo comparável na reconstrução entre os 10 sujeitos do conjunto THINGS-EEG2.
Figura 3 apresenta reconstruções para os mesmos sete índices de condições excluídos (1, 32, 62, 86, 87, 108 e 175; numeração de arquivos com base zero) em todos os 10 sujeitos. A linha superior mostra os estímulos reais, e as linhas subsequentes mostram as reconstruções correspondentes para sub-01 até sub-10. As reconstruções mantêm categorias semânticas compartilhadas e atributos visuais característicos dos estímulos, enquanto a identidade fina do objeto, forma e textura local variam entre os sujeitos. Este layout fornece uma contrapartida qualitativa aos resultados entre sujeitos resumidos na Tabela 3.
Figura 4 apresenta reconstruções qualitativas para seis condições de teste sub-01 especificadas. As linhas mostram o estímulo real, um comparador Perceptogram gerado pela nossa implementação local21 e a reconstrução do TDE-Net. Os exemplos destacam a preservação das categorias de objetos, formas, cores e atributos de fundo, enquanto detalhes finos de identidade e fundo variam entre os métodos.
Figura suplementar 1 apresenta os grupos com melhor, mediana e pior reconstrução selecionados entre as 200 condições de teste sub-01 em THINGS-EEG223. As condições são classificadas pelo acordo cosseno entre a incorporação CLIP prevista pelo EEG fundido congelado e a incorporação CLIP da imagem de referência correspondente. Os grupos exibidos ilustram a amplitude do acordo semântico observado para este sujeito.
Contribuição dos componentes e comportamento de fusão
Tabela 4 apresenta uma ablação progressiva dos fluxos estrutural e semântico com base em valores médios entre sujeitos obtidos sob o mesmo procedimento de avaliação. O Ancoragem Linear prevê diretamente os latentes CLIP e VAE a partir de dados de EEG pré-processados usando regressão ridge e serve como ponto de partida controlado para o estudo de ablação. Ele segue o princípio linear geral de mapeamento latente utilizado em estudos anteriores de EEG para imagem, incluindo o Perceptogram21, empregando ao mesmo tempo o pré-processamento, regularização, decodificação e configurações de avaliação do presente fluxo de trabalho. Esse desenho permite que o fluxo estrutural, o fluxo semântico e a fusão em espaço duplo sejam examinados em relação a uma referência linear comum.
A partir do Ancoragem Linear, a adição do fluxo estrutural aumentou o SSIM de 0,331 para 0,339 e a acurácia da Camada 5 da AlexNet de 0,913 para 0,932, embora a acurácia da Camada 2 da AlexNet tenha diminuído ligeiramente de 0,889 para 0,886. Adicionar o fluxo semântico em vez disso produziu o maior PixCorr (0,237), mantendo uma alta acurácia da Camada 2 da AlexNet (0,888) e reduzindo as distâncias EffNet e SwAV para 0,865 e 0,531, respectivamente. Quando ambos os fluxos foram incorporados por meio de fusão em espaço duplo, a TDE-Net alcançou as maiores acurácias de identificação pareada da Inception-v3 (0,761) e do CLIP (0,814), juntamente com as menores distâncias EffNet (0,829) e SwAV (0,509). Sua acurácia da Camada 2 da AlexNet (0,878) permaneceu abaixo da do Ancoragem Linear, e seu SSIM (0,339) permaneceu ligeiramente abaixo do da configuração com fluxo estrutural. No geral, os resultados da ablação entre sujeitos mostram que os fluxos estrutural e semântico influenciam diferentes aspectos da reconstrução, enquanto sua fusão fortalece principalmente a identificação semântica e a consistência no espaço de características profundas.
Figura 5 mostra a sensibilidade do conjunto de desenvolvimento em relação aos dois pesos de fusão ao longo da faixa α = 0,00–1,00 em incrementos de 0,05. A curva no espaço CLIP atinge seu máximo em αCLIP = 0,55, enquanto a curva no espaço VAE atinge seu máximo em αVAE = 0,65. Valores semelhantes de PCC foram observados para candidatos vizinhos, enquanto os máximos ocorreram em pesos diferentes para os dois espaços latentes.
Contribuição temporal dos sinais de EEG
Figura 6 mostra a média da PCC latente por condição para janelas de EEG bruto terminando em 8, 16, ..., 80 pontos de tempo no sub-01 (n = 200 condições de teste). As curvas CLIP e VAE aumentam conforme a janela de análise se expande e estabilizam em janelas posteriores. Linhas tracejadas indicam os valores de referência correspondentes somente ao fluxo semântico da janela completa. Esta análise caracteriza a dependência da janela temporal segundo o protocolo de mapeamento relatado.
Alinhamento semântico e análise em nível de representação
Figura 7 compara o PCC latente por amostra para o ancoramento CLIP bruto e a predição CLIP fundida congelada em 200 condições de teste sub-01. As estimativas de densidade kernel gaussiana utilizam a largura de banda de Scott, e linhas tracejadas verticais indicam as médias das amostras. A distribuição fundida apresenta um aumento médio no PCC de aproximadamente 0,013 em relação ao ancoramento bruto. A precisão de identificação por pares no nível de imagem CLIP é relatada separadamente na Tabela 2.
Figura 8 compara matrizes de similaridade cosseno (RSM) para incorporações CLIP de imagens reais e incorporações CLIP previstas por EEG fundidas. Ambas as matrizes compartilham uma faixa comum de dados e uma ordenação Ward derivada das distâncias euclidianas entre os incorporações CLIP reais. O painel residual mostra a RSM prevista menos a RSM real em uma escala simétrica definida pelo residual absoluto máximo, fornecendo uma visualização do acordo representacional.
Figura Suplementar 2 apresenta uma projeção conjunta de 200 embeddings CLIP de referência e 200 previstos por EEG. Cinco rótulos são obtidos por agrupamento k-médias dos embeddings de referência normalizados por L2 (n_init = 50; semente = 7). As características concatenadas de referência e previstas são reduzidas a 50 dimensões por PCA e projetadas conjuntamente por t-SNE com perplexidade 28, distância euclidiana e semente 12. A projeção fornece uma visão qualitativa da organização dos dois conjuntos de representações.
Padrão de EEG e interpretabilidade da atenção espacial
Figura Suplementar 3 agrupa conceitos de teste em Animais, Conceitos relacionados a alimentos/plantas e Outros objetos usando um mapeamento explícito entre conceito e rótulo. Dentro de cada grupo, as linhas são ordenadas por agrupamento de Ward dos embeddings CLIP normalizados e branqueados do padrão-ouro e amostradas uniformemente em até 30 conceitos para melhor legibilidade. O mapa de calor exibe amplitudes do EEG branqueadas, normalizadas e limitadas a uma escala de -1 a 1; os embeddings CLIP são utilizados exclusivamente para determinar a ordenação dentro de cada grupo.
Figura Suplementar 4 exibe uma topografia padrão do couro cabeludo 10–20 dos pesos normalizados absolutos dos canais do fluxo semântico sobre os 17 eletrodos selecionados. O mapa resume os pesos relativos do modelo entre os canais do couro cabeludo medidos e é interpretado como uma visualização dos pesos do modelo em nível de canal.
Este estudo é uma análise computacional secundária do conjunto de dados THINGS-EEG2 com identificação removida. As gravações originais de EEG, matrizes de EEG pré-processadas, metadados e imagens dos estímulos, e arquivos de estado de repouso estão disponíveis por meio do projeto THINGS-EEG2 em https://osf.io/3jk45/ e Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). O software original de aquisição e pré-processamento está disponível em https://github.com/gifale95/eeg_encoding. O acesso e reutilização dos dados de EEG e imagens de estímulos estão sujeitos às licenças e requisitos de atribuição especificados pelos repositórios de origem.
A implementação do TDE-Net, incluindo os scripts de alinhamento, fusão, reconstrução, avaliação e visualização, está disponível em https://github.com/Yuan-ui198/TDE-Net. A versão correspondente a este manuscrito está fixada no commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Nenhum dado novo identificável de participantes foi coletado para o presente estudo.
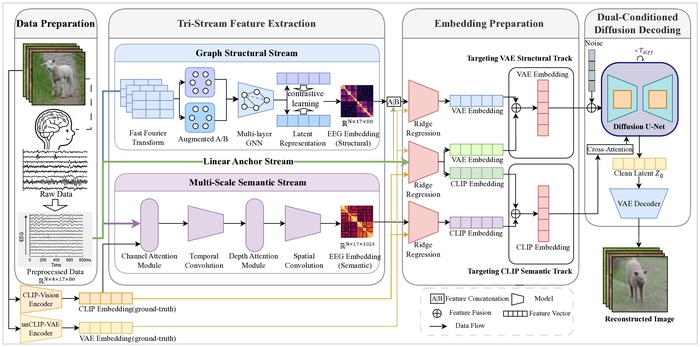
Figura 1: Esquema do TDE-Net. O diagrama mostra o âncora de EEG bruto, o fluxo de grafo funcional específico ao exemplo, o fluxo temporal semântico, o mapeamento em espaços duplos para VAE e CLIP, a fusão ponderada e a decodificação dualmente condicionada do Stable UnCLIP. As dimensões dos tensores são indicadas quando aplicáveis. Clique aqui para visualizar uma versão maior desta figura.
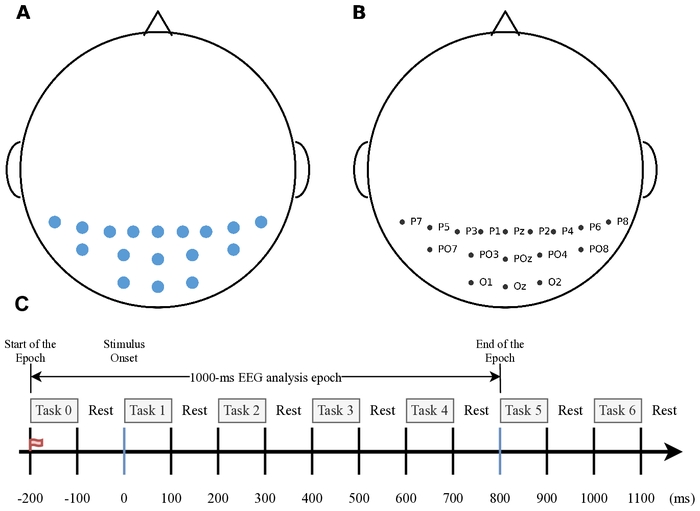
Figura 2: Seleção dos eletrodos de EEG e cronometragem experimental. (A) Distribuição espacial dos 17 eletrodos parieto-occipitais selecionados a partir da aquisição original de 64 canais. (B) Rótulos dos eletrodos: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 e P2. (C) Esquema do cronograma do RSVP e definição da época de EEG. No esquema, “Tarefa” denota um intervalo de apresentação da imagem, enquanto “Descanso” denota o intervalo entre imagens; os blocos numerados de Tarefa indicam intervalos sucessivos de apresentação, e não diferentes condições experimentais. Cada imagem foi apresentada por 100 ms com uma assincronia de início do estímulo de 200 ms. A época de EEG estendeu-se de -200 a 800 ms em relação ao início do estímulo, correspondendo a uma época de análise de EEG de 1000 ms. Clique aqui para visualizar uma versão ampliada desta figura.
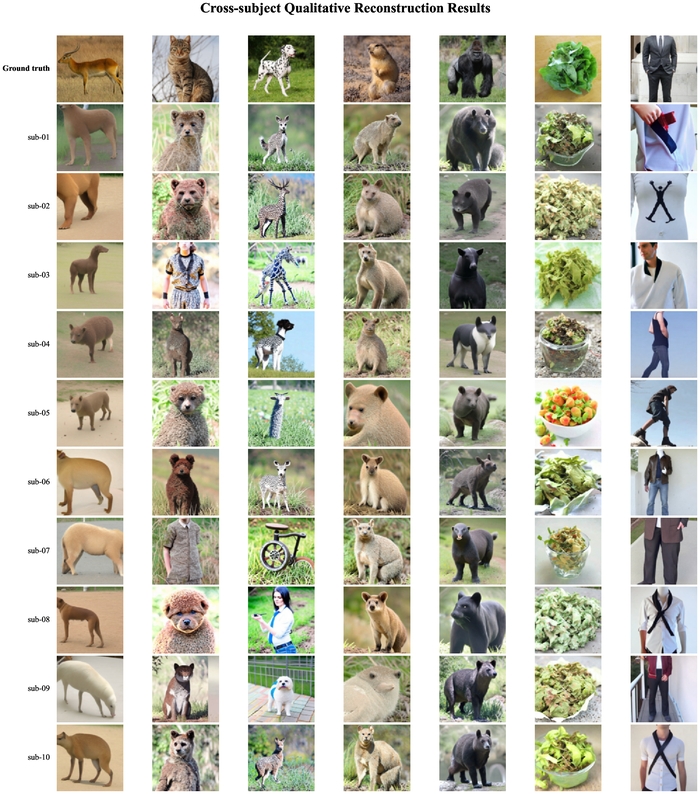
Figura 3: Resultados qualitativos de reconstrução entre sujeitos para sete condições de imagem mantidas. Os mesmos índices de condição com base zero (1, 32, 62, 86, 87, 108 e 175) são usados para sub-01 até sub-10. A linha superior mostra as amostras correspondentes de imagens reais do conjunto de teste THINGS-EEG2, cujas imagens foram extraídas da base de dados de imagens THINGS34, enquanto as linhas restantes mostram as reconstruções do TDE-Net para cada sujeito. A figura ilustra conteúdo semântico comum e variação entre níveis de sujeito; os resultados quantitativos entre sujeitos são relatados na Tabela 3. Clique aqui para visualizar uma versão maior desta figura.
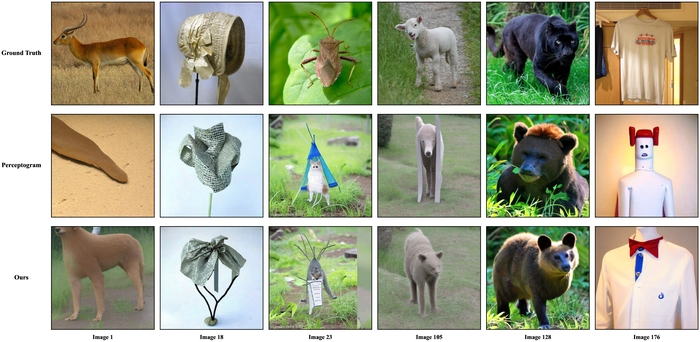
Figura 4: Comparação da reconstrução qualitativa para seis condições de teste sub-01 especificadas. As linhas mostram o estímulo real, uma reconstrução comparadora gerada pela implementação local e a reconstrução do TDE-Net; as colunas correspondem aos índices individuais das condições. As amostras de imagens reais foram extraídas da base de dados de imagens THINGS34. Clique aqui para visualizar uma versão maior desta figura.
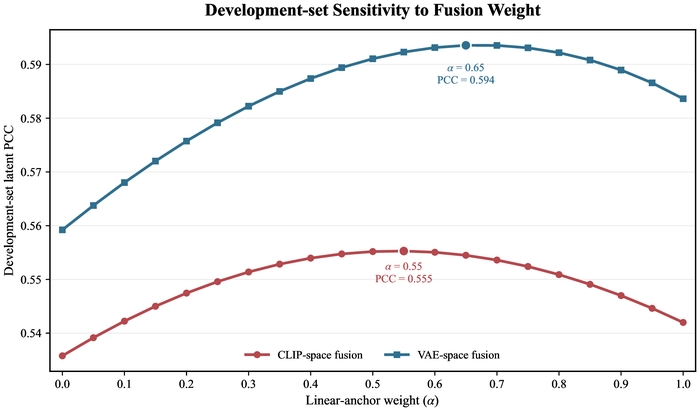
Figura 5: Sensibilidade no conjunto de desenvolvimento dos pesos da fusão latente. O eixo horizontal indica o peso linear do âncora α, o peso do fluxo complementar é 1 - α, e o eixo vertical indica o coeficiente de correlação de Pearson (PCC) latente no conjunto de desenvolvimento. Os valores candidatos variam de 0,00 a 1,00 em incrementos de 0,05. Os pesos nos espaços CLIP e VAE são selecionados independentemente pelo valor médio máximo de PCC por sujeito com pesos iguais entre 10 sujeitos, resultando em αCLIP = 0,55 e αVAE = 0,65. PCC, coeficiente de correlação de Pearson. Clique aqui para visualizar uma versão maior desta figura.
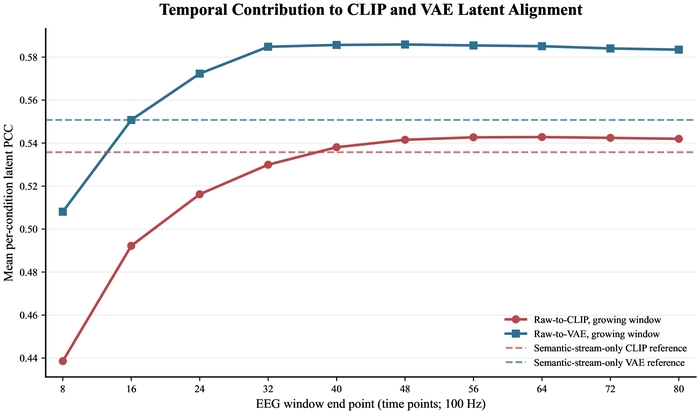
Figura 6: Análise temporal da alinhamento latente no sub-01 (n = 200 condições excluídas). As curvas contínuas mostram a média do coeficiente de correlação de Pearson (PCC) por amostra para as predições no formato bruto-para-CLIP e bruto-para-VAE à medida que a janela de EEG expande de 8 a 80 pontos temporais a 100 Hz. Linhas tracejadas indicam os valores de referência baseados apenas no fluxo semântico para CLIP e VAE com janela completa. PCC, coeficiente de correlação de Pearson. Clique aqui para visualizar uma versão ampliada desta figura.
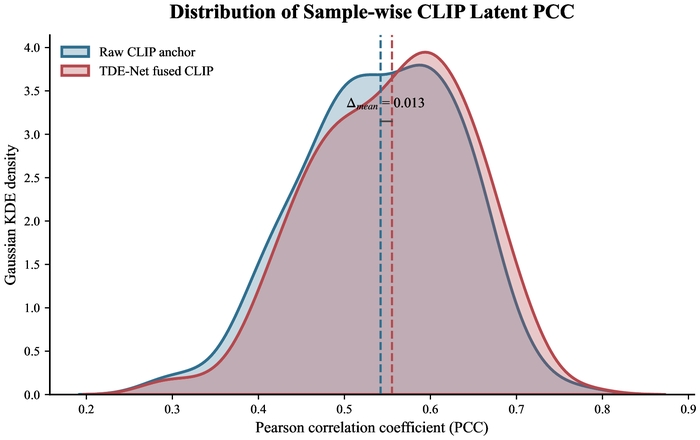
Figura 7: Distribuição do alinhamento latente do CLIP por amostra no sub-01 (n = 200 condições mantidas). As curvas são estimativas de densidade kernel gaussiana com largura de banda de Scott para a âncora CLIP bruta e a predição CLIP com TDE-Net congelado. Linhas tracejadas verticais indicam as médias das amostras, e a anotação mostra a diferença entre elas. PCC, coeficiente de correlação de Pearson; KDE, estimativa de densidade kernel. Clique aqui para visualizar uma versão maior desta figura.
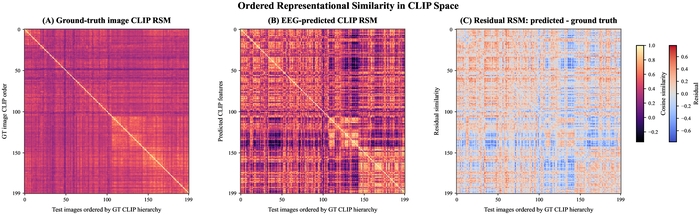
Figura 8: Similaridade representacional ordenada no espaço CLIP para sub-01 (n = 200 condições excluídas). (A) Matriz de similaridade por cosseno (RSM) dos embeddings CLIP de imagens reais normalizados por L2. (B) Matriz de similaridade por cosseno (RSM) dos embeddings CLIP previstos por EEG fundido, exibida com a mesma ordenação e escala de cores do painel A. (C) Matriz de similaridade residual (RSM), calculada como a previsão menos o valor real, exibida em uma escala simétrica definida pelo residual absoluto máximo. A ordenação foi obtida pela distância euclidiana e ligação de Ward dos embeddings CLIP reais. RSM, matriz de similaridade representacional. Clique aqui para visualizar uma versão maior desta figura.
| Componente | Parâmetro | Configuração |
| Dados e pré-processamento | Partição do conjunto de dados | 16.540 condições de treinamento e 200 condições de teste reservadas; divisão 90%/10% para ajuste/desenvolvimento (semente 42) |
| Entrada de EEG | 17 canais parieto-ocipitais; 0-800 ms; 100 Hz; 80 pontos temporais | |
| Representação espectral | FFT de 80 pontos; 40 bins de frequência positiva; espectro de amplitude logarítmica de 0-50 Hz | |
| Fluxo estrutural | Construção do grafo | Correlação de Pearson absoluta específica por amostra; k = 4 vizinhos mais próximos ponderados por nó; simetrização e laços próprios |
| Arquitetura GCN | 5 camadas; 80 unidades ocultas; ReLU; dropout 0,3; normalização por grau simétrico; pooling médio | |
| Objetivo contrastivo | Cabeça de projeção de 80 dimensões; temperatura InfoNCE τ = 0,5 | |
| Treinamento | Adam; taxa de aprendizado 5 × 10⁻⁴; tamanho do lote 32; 20 épocas; recozimento cosseno; taxa de aprendizado mínima 10⁻⁶; semente 42 | |
| Fluxo semântico | Arquitetura | Kernel temporais 5/15/31; profundidade 9; 24 canais de características; dropout 0,5; dimensão de saída 1.024 |
| Treinamento | AdamW; taxa de aprendizado 5 × 10⁻⁴; decaimento de peso 0,01; tamanho do lote 64; 50 épocas; recozimento cosseno; taxa de aprendizado mínima 10⁻⁶; semente 42 | |
| Mapeamento latente | Regressão ridge | Intercepto ajustado; máximo de 50.000 iterações; entradas padronizadas usando estatísticas da partição de ajuste |
| Regularização | Penalidade CLIP λ = 1.000; penalidade VAE bruta λ = 0; penalidade VAE estrutural λ = 1.000 | |
| Dimensões-alvo | CLIP: 1.024; VAE: 36.864 | |
| Fusão e decodificação | Pesos de fusão | Peso âncora CLIP α = 0,55; peso âncora VAE α = 0,65; selecionados nos dados de desenvolvimento e fixados antes dos testes |
| Modelo de difusão | sd2-community/stable-diffusion-2-1-unclip; escala estrutural γ = 0,02; etapas de difusão T = 1.000 | |
| Amostragem | 20 etapas de remoção de ruído; escala de orientação 7,5; semente de difusão 0 |
Tabela 1: Resumo consolidado dos parâmetros para a TDE-Net. A tabela lista a partição dos dados, o pré-processamento, a construção da adjacência funcional, as configurações do grafo e do codificador semântico, as penalidades de mapeamento latente, os pesos de fusão e as configurações de decodificação por difusão utilizadas em todos os experimentos relatados.
| Método | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Referência | 0,141 | 0,321 | 0,823 | 0,878 | 0,704 | 0,739 | 0,898 | 0,564 |
| EEGImageDecode | - | 0,345 | 0,776 | 0,866 | 0,734 | 0,786 | - | 0,582 |
| Perceptograma (unCLIP) | 0,223 | 0,370 | 0,875 | 0,915 | 0,749 | 0,806 | 0,870 | 0,530 |
| TDE-Net (Nosso) | 0,253 ± 0,014 | 0,339 ± 0,003 | 0,878 ± 0,012 | 0,915 ± 0,012 | 0,761 ± 0,021 | 0,814 ± 0,007 | 0,829 ± 0,012 | 0,509 ± 0,010 |
Tabela 2: Resultados quantitativos da reconstrução. Os métodos de comparação, a linha de base com convolução-atenção interna e o TDE-Net foram avaliados dentro de um mesmo framework experimental, utilizando a mesma partição THINGS-EEG2, entrada de 17 canais, pré-processamento, condições de teste reservadas e definições de métricas, mantendo ao mesmo tempo as arquiteturas específicas de cada método. O modelo atual é apresentado como média ± DP ao longo de 10 sujeitos. PixCorr, SSIM, AlexNet Camada 2, AlexNet Camada 5, Inception-v3 e CLIP são medidas em que valores mais altos são melhores; EffNet e SwAV são distâncias de correlação, para as quais valores mais baixos são melhores. A coluna CLIP informa a precisão de identificação por pares utilizando o modelo OpenAI CLIP ViT-L/14.
| Assunto | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0,2260 | 0,3361 | 0,8831 | 0,9203 | 0,7533 | 0,8120 | 0,8567 | 0,5285 |
| sub-02 | 0,2488 | 0,3378 | 0,8699 | 0,9053 | 0,7268 | 0,8074 | 0,8335 | 0,5167 |
| sub-03 | 0,2564 | 0,3397 | 0,8728 | 0,9070 | 0,7658 | 0,8143 | 0,8268 | 0,5096 |
| sub-04 | 0,2420 | 0,3356 | 0,8598 | 0,9034 | 0,7854 | 0,8112 | 0,8255 | 0,5091 |
| sub-05 | 0,2499 | 0,3385 | 0,8760 | 0,8963 | 0,7251 | 0,8016 | 0,8394 | 0,5189 |
| sub-06 | 0,2621 | 0,3395 | 0,8910 | 0,9331 | 0,7818 | 0,8215 | 0,8202 | 0,5009 |
| sub-07 | 0,2489 | 0,3378 | 0,8643 | 0,9185 | 0,7704 | 0,8200 | 0,8222 | 0,5017 |
| sub-08 | 0,2786 | 0,3425 | 0,8951 | 0,9216 | 0,7524 | 0,8245 | 0,8214 | 0,5010 |
| sub-09 | 0,2609 | 0,3370 | 0,8775 | 0,9238 | 0,7662 | 0,8055 | 0,8250 | 0,5009 |
| sub-10 | 0,2571 | 0,3433 | 0,8871 | 0,9240 | 0,7792 | 0,8175 | 0,8140 | 0,4977 |
| Média | 0,2531 | 0,3388 | 0,8777 | 0,9153 | 0,7606 | 0,8135 | 0,8285 | 0,5085 |
| Média ± DP | 0,2531 ± 0,0138 | 0,3388 ± 0,0025 | 0,8777 ± 0,0115 | 0,9153 ± 0,0116 | 0,7606 ± 0,0213 | 0,8135 ± 0,0074 | 0,8285 ± 0,0122 | 0,5085 ± 0,0101 |
| IC 95% | 0,2432-0,2630 | 0,3370-0,3406 | 0,8695-0,8859 | 0,9070-0,9236 | 0,7454-0,7759 | 0,8082-0,8189 | 0,8198-0,8372 | 0,5013-0,5157 |
Tabela 3: Resultados quantitativos entre sujeitos para a TDE-Net. Cada sujeito contribui com 200 condições de teste mantidas. A tabela apresenta as oito métricas para sub-01 até sub-10, seguidas pela média entre sujeitos, desvio padrão amostral e IC de 95%. CLIP denota a precisão de identificação par a par do OpenAI CLIP ViT-L/14; EffNet e SwAV são distâncias de correlação em que valores menores são melhores.
| Método | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Âncora Linear | 0,2157 | 0,3309 | 0,8891 | 0,9128 | 0,7493 | 0,7967 | 0,8683 | 0,5394 |
| Linear + Fluxo Estrutural | 0,2318 | 0,3393 | 0,8861 | 0,9319 | 0,7439 | 0,7996 | 0,8657 | 0,5359 |
| Linear + Fluxo Semântico | 0,2372 | 0,3382 | 0,8879 | 0,9228 | 0,7447 | 0,8026 | 0,8655 | 0,5307 |
| TDE-Net (Nosso) | 0,2531 | 0,3388 | 0,8777 | 0,9153 | 0,7607 | 0,8135 | 0,8285 | 0,5085 |
Tabela 4: Resultados de ablação relatados como médias entre sujeitos sob o procedimento de avaliação descrito na Seção do Protocolo 6. O Linear Anchor é uma referência interna de mapeamento direto de sulcos avaliada localmente; as configurações estrutural, semântica e completa utilizam os mesmos índices de condição e definições de métrica. PixCorr, SSIM, AlexNet Camada 2, AlexNet Camada 5, Inception-v3 e CLIP são medidas em que valores mais altos indicam melhor desempenho; EffNet e SwAV são distâncias de correlação em que valores mais baixos indicam melhor desempenho. Os valores são apresentados com três casas decimais.
Figura Suplementar 1: Casos representativos de reconstrução que abrangem a faixa de concordância CLIP para o sub-01. As 200 condições mantidas são classificadas pela similaridade do cosseno entre as incorporações CLIP previstas pela EEG fundida e as reais; são apresentados seis melhores, seis medianos e seis piores casos. Cada coluna associa uma amostra de imagem real do conjunto de testes THINGS-EEG2 à sua reconstrução pelo TDE-Net. As imagens reais foram extraídas da base de dados de imagens THINGS34. Clique aqui para baixar este arquivo.
Figura Suplementar 2: Visualização conjunta das representações CLIP do padrão-ouro e previstas por EEG no sub-01 (n = 200 condições por representação). (A) Representações CLIP do padrão-ouro. (B) Representações CLIP previstas por EEG. As cores indicam cinco agrupamentos obtidos pelo método k-means aplicado aos embeddings CLIP do padrão-ouro normalizados pela norma L2 (k = 5, n_init = 50, semente = 7). Os agrupamentos são grupos derivados dos dados e não correspondem a categorias semânticas predefinidas. Os embeddings do padrão-ouro e previstos são concatenados, reduzidos a 50 dimensões pela análise de componentes principais (PCA) e projetados conjuntamente por t-SNE (perplexidade = 28, taxa de aprendizado = automática, métrica euclidiana, semente = 12). PCA, análise de componentes principais; t-SNE, incorporação estocástica de vizinhos com distribuição t. Clique aqui para baixar este arquivo.
Figura Suplementar 3: Padrões de EEG agrupados por categoria ampla de conceito de imagem para sub-01. Os conceitos são atribuídos a Animais, Conceitos relacionados a alimentos/plantas ou Outros objetos. Dentro de cada categoria, as linhas seguem a ordenação hierárquica de Ward dos embeddings CLIP da verdade fundamental branqueados e são amostrados uniformemente em até 30 conceitos para melhor legibilidade. As colunas mostram 17 canais de EEG, com 80 pontos de tempo por canal. A escala de cores (-1 a 1) representa a amplitude do EEG branqueado, normalizada e limitada. Clique aqui para baixar este arquivo.
Figura Suplementar 4: Topografia da atenção nos canais do couro cabeludo do fluxo semântico. As cores mostram as magnitudes relativas normalizadas dos parâmetros de ponderação de canais aprendidos nos 17 eletrodos selecionados em uma projeção padrão do couro cabeludo 10–20; os pontos e rótulos dos eletrodos identificam as posições de medição. A escala varia de 0 a 1 e resume a ponderação relativa de canais aprendida pelo modelo. Clique aqui para baixar este arquivo.
Discussão
Este estudo apresenta um fluxo de trabalho computacional modular que separa o pré-processamento de EEG, a aprendizagem de representações estruturais e semânticas, o mapeamento latente CLIP/VAE, a fusão e a decodificação por difusão. Essa organização em etapas permite que as saídas intermediárias sejam examinadas separadamente das imagens geradas e segue a progressão mais ampla desde codificadores compactos de EEG até métodos de reconstrução multimodais e baseados em difusão6,11,12,13,14,15,16,,17,18,19,20,21,22. A análise entre sujeitos relata os valores por sujeito juntamente com a média entre sujeitos e o desvio padrão amostral para a avaliação mantida de dez sujeitos. Juntamente com a ablação passo a passo na Tabela 4, esta análise quantifica os efeitos específicos de cada fluxo e a variação entre sujeitos dentro do pipeline relatado.
Etapas críticas e solução de problemas
Os controles de implementação mais importantes são o isolamento de partições, a normalização consistente, a preservação do índice de condição e os mapeamentos separados do CLIP/VAE. Os pesos de fusão devem ser selecionados com base nas condições de desenvolvimento e fixados antes da reconstrução no teste. Quando o desempenho for inesperadamente baixo, verifique primeiro a ordem e as dimensões do array, depois examine o PCC latente bruto e específico por ramo, os metadados de fusão e as saídas de métricas em nível de imagem. Uma falha no alinhamento latente indica um problema de mapeamento anterior, enquanto imagens variáveis com latentes estáveis podem refletir comportamento estocástico ou dependente do decodificador14,21,22,29.
Alterar a montagem do eletrodo, a taxa de amostragem ou a janela temporal exige mudanças correspondentes na construção do grafo, nas características espectrais e nos kernels temporais. A qualidade da reconstrução deve ser avaliada com medidas complementares de baixo nível e semânticas, pois nenhuma pontuação única captura fidelidade dos pixels, estrutura e concordância em nível de objeto6,11,21,22,23. A medida CLIP utilizada aqui é a precisão de identificação por pares, enquanto Figura 7 e Figura 8 utilizam o PCC em nível latente; essas quantidades não são intercambiáveis.
A organização modular da TDE-Net fornece uma estrutura para examinar se representações complementares de EEG contribuem de maneira distinta para aspectos estruturais e semânticos da reconstrução visual. Esta abordagem pode facilitar a comparação sistemática de representações de características de EEG, alvos latentes e decodificadores generativos, sem depender exclusivamente das imagens reconstruídas finais. Abordagens alternativas incluem mapeamento linear direto de EEG para latente, codificadores de única via baseados em convolução ou atenção, representações baseadas em grafos e estruturas de decodificação neural de ponta a ponta6,7,8,9,10,11,17,18,19,20,21,22. O fluxo de trabalho atual pode ser particularmente útil para pesquisas sobre decodificação da percepção visual, análise de representações neurais e interfaces cérebro-computador não invasivas, nas quais a separação de previsões intermediárias de EEG para latente pode ajudar a caracterizar quais componentes contribuem para o desempenho da reconstrução.
Limitações
As principais limitações são a aquisição fixa de RSVP-EEG THINGS-EEG2, os 17 canais parieto-occipitais selecionados, mapeamentos específicos por sujeito, um único decodificador de difusão e análises qualitativas de interpretabilidade21,22,23. O resumo com 10 sujeitos aborda a variabilidade entre sujeitos dentro do conjunto de dados, mas não estabelece transferência entre conjuntos de dados ou entre paradigmas. As imagens geradas podem conter detalhes plausíveis que não são suportados pela entrada de EEG, e as visualizações de RSM, t-SNE, padrões de EEG e atenção não estabelecem mecanismos neurais causais. A ablação sequencial caracteriza as contribuições do fluxo estrutural, do fluxo semântico e da fusão em espaço duplo sob uma âncora compartilhada de EEG bruto, alvos latentes, decodificador de difusão e protocolo de avaliação.
Próximas direções
Dentro dessas limitações, os resultados apoiam a avaliação de representações complementares de EEG em espaços semânticos e latentes de imagem separados antes da decodificação por difusão. Trabalhos futuros devem testar conjuntos de dados independentes, adaptação por sujeito, estimativas de incerteza, montagens alternativas de canais e decodificadores com controles mais rigorosos sobre detalhes visuais não suportados14,15,16,17,18,19,20,21,22,23. Tais estudos são necessários antes de estender as descobertas atuais a contextos mais amplos de neurociência ou interfaces cérebro-computador.
Conclusão:
A TDE-Net combina uma âncora de EEG bruto com representações estruturais e semânticas de EEG, alinha-as separadamente com os espaços latentes VAE e CLIP e integra as previsões resultantes antes da decodificação por difusão. Em 10 participantes do THINGS-EEG2, as imagens reconstruídas mantiveram correspondência mensurável em nível de pixel, estrutural e semântica com os estímulos visualizados, enquanto a ablação progressiva diferenciou os efeitos do fluxo estrutural, do fluxo semântico e da fusão em espaços duplos. Ao expor características intermediárias de EEG, previsões latentes, saídas de fusão e reconstruções finais, o protocolo fornece um framework reprodutível para investigar a reconstrução visual baseada em EEG e para avaliar sua futura extensão a conjuntos de dados independentes e configurações de aquisição.
Divulgações
Os autores declaram não haver interesses financeiros concorrentes ou relações pessoais que poderiam ter influenciado este trabalho. Os autores declaram que nenhuma ferramenta de IA generativa foi utilizada na elaboração do manuscrito, código, análise de dados ou preparação das figuras.
Agradecimentos
Esta pesquisa foi financiada pela Fundação Nacional de Ciências Naturais da China (número do projeto 62433002) e (número do projeto 62476014), pelo Projeto Nacional de Ciência e Tecnologia de Grande Relevância (número 2021ZD0113703), pelo Projeto Anual de Planejamento da Fundação Municipal de Ciências Sociais de Pequim (número 23GLB014), pelo Projeto de Construção e Apoio a Equipes Inovadoras de Alto Nível das Instituições Municipais de Pequim (número do projeto BPHR20220104) e pelo Programa Beijing Scholars (número do projeto 099).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Acelerar | Hugging Face | 0.30.1 | Gerenciamento de dispositivos em pipelines de difusão; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Codificador de características de imagem usado para alvos semânticos e identificação par a par com CLIP; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Implementação do pipeline Stable UnCLIP; https://github.com/huggingface/diffusers |
| Matplotlib | Equipe de Desenvolvimento do Matplotlib | 3.10.6 | Geração de figuras científicas; https://matplotlib.org/ |
| MNE-Python | Desenvolvedores do MNE | 1.11.0 | Montagem padrão 10-20 e topografia dos canais do couro cabeludo; https://mne.tools/ |
| NumPy | Desenvolvedores do NumPy | 2.3.4 | Arranjos de EEG, incorporações latentes, fusão e agregação de métricas; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | GPU usado para treinamento local do codificador e reconstrução por difusão. |
| Pillow | Fork da Biblioteca Python de Imagens | 11.1.0 | Carregamento, redimensionamento e exportação de imagens; https://python-pillow.org/ |
| Python | Fundação Python Software | 3.12.12 | Ambiente de execução principal; https://www.python.org/ |
| PyTorch | Fundação PyTorch | 2.9.1+cu128 | Treinamento do codificador de EEG e inferência de redes neurais; https://pytorch.org/ |
| scikit-image | Desenvolvedores do scikit-image | 0.25.2 | Utilitários para SSIM e processamento de imagens; https://scikit-image.org/ |
| scikit-learn | Desenvolvedores do scikit-learn | 1.7.2 | Regressão ridge, k-means, PCA e t-SNE; https://scikit-learn.org/ |
| SciPy | Desenvolvedores do SciPy | 1.16.3 | Correlação, distância estatística e agrupamento hierárquico; https://scipy.org/ |
| Seaborn | Desenvolvedores do Seaborn | 0.13.2 | Visualização de densidade com kernel gaussiano; https://seaborn.pydata.org/ |
| Codificador de EEG de fluxo semântico | Autores do TDE-Net; adaptado do LMDA-Net | Commit do repositório c99325d | Representação semântica temporal em múltiplas escalas; a implementação e os metadados do checkpoint são fornecidos no repositório de código. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / Comunidade SD2 | sd2-community/stable-diffusion-2-1-unclip | Decoder de difusão congelado; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Codificador de EEG de fluxo estrutural | Autores do TDE-Net | Commit do repositório c99325d | Representação gráfica auto-supervisionada; os sinais brutos de EEG e as características do grafo são concatenados apenas para o mapeamento estrutural no espaço VAE. |
| Scripts de alinhamento, fusão, avaliação e visualização do TDE-Net | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| Banco de dados THINGS | Hebart et al. | doi:10.1371/journal.pone.0223792 | Fonte de estímulos naturais de objetos; https://things-initiative.org/ |
| Conjunto de dados THINGS-EEG2 | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | EEG de 64 canais de 10 sujeitos; este estudo seleciona 17 canais parieto-occipitais; https://osf.io/anp5v/ |
| timm | Ross Wightman e colaboradores | 1.0.22 | Utilitários de modelos de visão pré-treinados usados na avaliação de características; https://github.com/huggingface/pytorch-image-models |
| torchvision | Fundação PyTorch | 0.24.1+cu128 | Backbones de avaliação AlexNet, Inception-v3 e EfficientNet; https://pytorch.org/vision/ |
| tqdm | Desenvolvedores do tqdm | 4.67.1 | Relatório de progresso para extração de características, reconstrução e avaliação; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Interfaces para componentes de modelos pré-treinados; https://github.com/huggingface/transformers |
Referências
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Reimpressões e permissões
Este artigo foi publicado
Vídeo em breve