Этот протокол помогает новичкам в биоинформатике пройти через вводный конвейер анализа CUT&RUN, который позволяет пользователям завершить первоначальный анализ и проверку данных секвенирования CUT&RUN. Выполнение описанных здесь этапов анализа в сочетании с аннотацией нисходящих пиков позволит пользователям получить механистическое представление о регуляции хроматина.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Вводный анализ и валидация данных секвенирования CUT&RUN
В этой статье
Краткое содержание
Аннотация
Метод CUT&RUN облегчает обнаружение белок-ДНК-взаимодействий по всему геному. Типичные области применения CUT&RUN включают профилирование изменений в модификациях хвоста гистонов или картирование занятости хроматина транскрипционного фактора. Широкое распространение CUT&RUN обусловлено, в частности, техническими преимуществами по сравнению с обычным ChIP-seq, которые включают в себя более низкие требования к входу клеток, более низкие требования к глубине секвенирования и повышенную чувствительность при снижении фонового сигнала из-за отсутствия сшивающих агентов, которые в противном случае маскируют эпитопы антител. Широкое внедрение CUT&RUN также было достигнуто благодаря щедрому обмену реагентами лабораторией Henikoff и разработке коммерческих наборов для ускорения освоения для начинающих. По мере расширения технического внедрения CUT&RUN анализ и валидация секвенирования CUT&RUN становятся критически важными узкими местами, которые необходимо преодолеть, чтобы обеспечить полное внедрение преимущественно мокрыми лабораторными командами. Анализ CUT&RUN обычно начинается с проверки качества необработанных прочтений секвенирования для оценки глубины секвенирования, качества чтения и потенциальных смещений. Затем прочтения выравниваются с эталонной сборкой последовательности генома, а затем используются несколько биоинформационных инструментов для аннотирования областей обогащения генома белками, подтверждения интерпретируемости данных и получения биологических выводов. Несмотря на то, что для поддержки анализа данных CUT&RUN было разработано множество конвейеров анализа in silico , их сложная многомодульная структура и использование нескольких языков программирования делают платформы сложными для новичков в биоинформатике, которые могут не быть знакомы с несколькими языками программирования, но хотят понять процедуру анализа CUT&RUN и настроить свои конвейеры анализа. Здесь мы предоставляем одноязычный протокол пошагового анализа CUT&RUN, предназначенный для пользователей с любым уровнем опыта в области биоинформатики. Этот протокол включает в себя выполнение критических проверок качества для подтверждения того, что данные секвенирования пригодны для биологической интерпретации. Мы ожидаем, что следование вводному протоколу, представленному в этой статье, в сочетании с аннотацией нисходящих пиков позволит пользователям извлекать биологические выводы из своих собственных наборов данных CUT&RUN.
Введение
Возможность измерения взаимодействий между белками и геномной ДНК имеет фундаментальное значение для понимания биологии регуляции хроматина. Эффективные анализы, которые измеряют занятость хроматина для данного белка, дают по крайней мере две ключевые части информации: 1) геномную локализацию и 2) распространенность белка в данной области генома. Отслеживание изменений рекрутмента и локализации белка, представляющего интерес в хроматине, может выявить локусы-мишени белка и выявить механистическую роль этого белка в биологических процессах на основе хроматина, таких как регуляция транскрипции, репарация ДНК или репликация ДНК. Доступные сегодня методы профилирования белково-ДНК-взаимодействий позволяют исследователям изучать регуляцию с беспрецедентным разрешением. Такие технические достижения стали возможными благодаря внедрению новых методов профилирования хроматина, которые включают в себя разработку методов расщепления под мишенями и высвобождения с использованием нуклеазы (CUT&RUN) лабораторией Henikoff. CUT&RUN имеет ряд технических преимуществ по сравнению с обычной иммунопреципитацией хроматина (ChIP), которые включают в себя более низкие требования к входу клеток, более низкие требования к глубине секвенирования и повышенную чувствительность при сниженном фоновом сигнале из-за отсутствия сшивающих агентов, которые в противном случае маскируют эпитопы антител. Использование этого метода для изучения регуляции хроматина требует глубокого понимания принципа, лежащего в основе этого метода, а также понимания того, как анализировать, проверять и интерпретировать данные CUT&RUN.
Процедура CUT&RUN начинается со связывания клеток с конканавалином А, конъюгированным с магнитными шариками, чтобы обеспечить манипуляции с низким количеством клеток на протяжении всей процедуры. Изолированные клетки проникают с помощью мягкого детергента, чтобы облегчить введение антитела, нацеленного на интересующий белок. Затем микрококковая нуклеаза (MNase) рекрутируется в связанное антитело с помощью метки Protein A или Protein A/G, привязанной к ферменту. Кальций вводится для инициирования ферментативной активности. В результате расщепления МНазы образуются мононуклеосомные ДНК-белковые комплексы. Кальций впоследствии хелатируют, чтобы завершить реакцию расщепления, и короткие фрагменты ДНК в результате расщепления MNазы высвобождают из ядер, затем подвергают очистке ДНК, подготовке библиотеки и высокопроизводительному секвенированию1 (рис. 1).
Подходы in silico к картированию и количественной оценке занятости белка в геноме развивались параллельно с лабораторными подходами, используемыми для обогащения этих ДНК-белковых взаимодействий. Идентификация областей обогащенных сигналов (пиков) является одним из наиболее важных этапов биоинформатического анализа. Первоначальные методы анализа ChIP-seq использовали такие алгоритмы, как MACS2 и SICER3, в которых использовались статистические модели для различения истинных сайтов связывания белка и ДНК от фонового шума. Тем не менее, более низкий фоновый шум и более высокое разрешение данных CUT&RUN делают некоторые программы пиковых вызовов, используемые в анализе ChIP-seq, непригодными для анализа CUT&RUN4. Эта проблема подчеркивает потребность в новых инструментах, лучше подходящих для анализа данных CUT&RUN. SEACR4 представляет собой один из таких инструментов, недавно разработанных для обеспечения пиковых вызовов из данных CUT&RUN при одновременном преодолении ограничений, связанных с инструментами, обычно используемыми для анализа ChIP-seq.
Биологические интерпретации данных секвенирования CUT&RUN извлекаются из выходных данных после пикового вызова в конвейере анализа. Для прогнозирования потенциальной биологической значимости вызываемых пиков по данным CUT&RUN может быть реализовано несколько функциональных программ аннотации. Например, проект Gene Ontology (GO) обеспечивает хорошо зарекомендовавшую себя функциональную идентификацию генов, представляющих интерес 5,6,7. Различные программные инструменты и ресурсы облегчают анализ GO для выявления генов и наборов генов, обогащенныхпиками CUT&RUN 8,9,10,11,12,13,14. Кроме того, программное обеспечение для визуализации, такое как Deeptools15, Integrative genomics viewer (IGV)16 и UCSC Genome Browser17, позволяет визуализировать распределение сигналов и закономерности в интересующих областях генома.
Способность извлекать биологические интерпретации из данных CUT&RUN в решающей степени зависит от валидации качества данных. К критически важным компонентам для валидации относятся оценка: i) качества секвенирования библиотеки CUT&RUN, ii) сходства реплик и iii) распределения сигнала в пиковых центрах. Завершение валидации всех трех компонентов имеет решающее значение для обеспечения надежности образцов библиотеки CUT&RUN и результатов последующего анализа. Поэтому важно создать вводные руководства по анализу CUT&RUN, чтобы позволить начинающим биоинформатикам и исследователям мокрых лабораторий проводить такие этапы проверки в рамках своих стандартных аналитических конвейеров CUT&RUN.
Наряду с разработкой эксперимента CUT&RUN в мокрой лаборатории, для поддержки анализа данных CUT&RUN были разработаны различные конвейеры анализа in silico CUT&RUN, такие как CUT&RUNTools2.0 18,19, nf-core/cutandrun20 и CnRAP21. Эти инструменты обеспечивают эффективные подходы к анализу одноклеточных и массовых наборов данных CUT&RUN и CUT&Tag. Тем не менее, относительно сложная модульная структура программы и необходимое знакомство с несколькими языками программирования для проведения этих конвейеров анализа могут препятствовать внедрению биоинформатики новичками, которые стремятся досконально понять этапы анализа CUT&RUN и настроить свои собственные конвейеры. Чтобы обойти этот барьер, требуется новый вводный конвейер анализа CUT&RUN, который предоставляется в виде простых пошаговых скриптов, закодированных с использованием простого единого языка программирования.
В этой статье мы опишем простой одноязычный протокол конвейера анализа CUT&RUN, который предоставляет пошаговые скрипты с подробными описаниями, позволяющими новым и начинающим пользователям проводить анализ секвенирования CUT&RUN. Программы, используемые в этом конвейере, являются общедоступными для исходных групп разработчиков. Основные этапы, описанные в этом протоколе, включают выравнивание чтения, вызов пиков, функциональный анализ и, что наиболее важно, этапы валидации для оценки качества образца для определения пригодности и надежности данных для биологической интерпретации (рис. 2). Кроме того, этот конвейер предоставляет пользователям возможность сопоставлять результаты анализа с общедоступными наборами данных CUT&RUN. В конечном счете, этот протокол конвейера анализа CUT&RUN служит вводным руководством и справочником для начинающих специалистов в области биоинформатического анализа и исследователей в мокрых лабораториях.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
ПРИМЕЧАНИЕ: Информация о файлах CUT&RUN fastq в GSE126612 доступна в Таблице 1. Информация, относящаяся к программным приложениям, использованным в данном исследовании, приведена в Таблице материалов.
1. Загрузка конвейера Easy-Shells_CUTnRUN со страницы на Github
- Откройте терминал из операционной системы.
ПРИМЕЧАНИЕ: Если пользователь не знает, как открыть терминал в macOS и Windows, просмотрите эту веб-страницу (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Для Linux ознакомьтесь с этой веб-страницей (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Загрузите сжатый конвейер анализа с Github, набрав в терминале wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip.
- После загрузки zip-файла распакуйте скачанный zip-файл, набрав в терминале unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/.
- После распаковки удалите zip-файл, набрав rm ~/Desktop/Easy-Shells_CUTnRUN.zip в терминале, и измените имя папки, набрав mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN.
- После удаления заархивированного файла введите в терминале chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh , чтобы установить разрешение на выполнение для всех сценариев оболочки в рабочем каталоге. С этого момента просто введите путь и имя этих сценариев оболочки в терминале или перетащите скрипты в терминал и войдите, чтобы запустить эти сценарии оболочки в терминале.
ПРИМЕЧАНИЕ: Оболочка Bash обычно предустановлена на большинстве дистрибутивов Linux. Однако в последних версиях macOS больше нет предустановленной оболочки Bash. Если в системе нет Bash, сначала установите оболочку Bash. Перейдите по ссылкам ниже, чтобы получить инструкции по установке оболочки Bash в ОС Linux (https://ioflood.com/blog/install-bash-shell-linux/) и macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following:). Эти пошаговые скрипты оболочки написаны для создания одной папки ~/Desktop/GSE126612 для выполнения большей части анализа CUT&RUN в этой директории без каких-либо изменений. Если пользователь понимает, как использовать эти сценарии оболочки, он может пересмотреть и настроить эти сценарии оболочки для анализа других наборов данных CUT&RUN и изменения параметров в соответствии с потребностями конкретного проекта. Для чтения и редактирования этих сценариев оболочки рассмотрите возможность использования Visual studio Code (https://code.visualstudio.com/) в качестве одного из вариантов простой в использовании программы, доступной для основных операционных систем.
2. Установка программ, необходимых для Easy Shells CUTnRUN
- Среди shell-скриптов с именем Script_01_installation_***.sh выясните, имя какого скрипта включает в себя тип операционной системы пользователя. В настоящее время Easy Shells CUTnRUN поддерживает скрипт установки для систем на базе macOS, Debian/Ubuntu и CentOS/RPM.
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- В терминале запустите скрипт оболочки установки, набрав ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh или перетащите файл скрипта оболочки в терминал и введите.
- Чтение файла Test_README.md в папке /path/to/SEACR-1.3/Testfiles. Следуйте инструкциям в файле README, чтобы уточнить, правильно ли работает SEACR в системе пользователя.
ПРИМЕЧАНИЕ: Крайне важно проверить работу функции SEACR с помощью тестовых файлов, предоставленных страницей SEACR на Github, чтобы получить правильные результаты пиковых вызовов из данных CUT&RUN. Поэтому следуйте инструкциям Test_README.md в /path/to/SEACR-1.3/Testfiles сразу после установки SEACR. Несмотря на то, что Easy Shells CUTnRUN предоставляет сценарии установки оболочки для некоторых операционных систем, эти сценарии могут не работать в системах некоторых пользователей для установки всех программ, необходимых для Easy Shells CUTnRUN. Если при установке возникли какие-либо проблемы, просмотрите оригинальный веб-сайт удаленной программы или обратитесь за помощью, используя веб-страницу проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
3. Загрузка общедоступного набора данных CUT&RUN из архива чтения последовательностей (SRA)
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ:Этот скрипт: (i) Создаст одну папку (~/Desktop/GSE126612/fastq) и загрузит список файлов SRA, записанных в текстовом файле (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) в папке fastq. В качестве примера SRR_list.txt включает fastq-файлы подмножества GSE126612 примеров CUT&RUN. (ii) Загрузите необработанные файлы fastq в папку fastq. (iii) Создайте одну папку (~/Desktop/GSE126612/log/fastq) и запишите файл журнала (download-fastq_log.txt) и загруженный файл с образцом информации (SRR_list_info.txt) в эту папку журнала. - После запуска скрипта проверьте файл журнала. Если в файле журнала есть сообщение об ошибке, исправьте ошибку и повторите попытку шага 3.3. Если возникла проблема для решения проблемы, обратитесь за помощью в веб-страницу проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Чтобы облегчить практику работы с этим конвейером анализа CUT&RUN, из SRA извлекаются следующие общедоступные образцы: один образец из имитационного контроля (IgG), три образца белка с архитектурой хроматина и фактором транскрипции (CTCF), четыре образца, соответствующие «активной» метке гистона (H3K27Ac), и три образца, соответствующие областям инициации транскрипции, помеченным РНК-полимеразой II (RNAPII-S5P). Секвенирование выполнялось как pair-end, поэтому для каждого образца объединяются два файла.
4. Первичная проверка качества исходных файлов секвенирования
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh в терминале или перетащите скрипт оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт оболочки: (i) запустит программу FastQC для всех необработанных файлов fastq в папке ~/Desktop/GSE126612/fastq и сохранит файлы отчета о проверке качества в папке ~/Desktop/GSE126612/fastqc.1st . (ii) Запишите файл журнала (fastqc.1st.log.SRR-number.txt) для каждого прогона FastQC в папку журнала (~/Desktop/GSE126612/log/fastqc.1st). - После завершения выполнения сценария оболочки просмотрите файл журнала, чтобы уточнить успешность выполнения. Если в файле журнала есть сообщение об ошибке, исправьте ошибку и повторите шаг 4.3. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Среди выходных файлов fastqc.html файлы содержат удобные для пользователя результаты проверки качества. Если есть серьезные проблемы с качеством, обсудите с коллегами по биоинформатике, чтобы определить пригодность данных для последующего анализа. Аналогичные отчеты о контроле качества используются для подтверждения улучшения качества данных после обрезки адаптера. Чтобы использовать этот скрипт для других наборов данных, отредактируйте путь к рабочему и выходному каталогам в соответствии с потребностями пользователя. Заметное различие при интерпретации контроля качества CUT&RUN по сравнению с чтением ChIP-seq заключается в том, что дубликаты прочтений в CUT&RUN не обязательно указывают на дубликаты ПЦР. Это связано с тем, что рекрутированная MNase будет перевариваться в тех же или похожих местах в экспериментальных группах.
5. Обрезка качества и адаптера для файлов необработанной секвенирования
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh в терминале или перетащите Script_04_trimming.sh скрипт в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт оболочки: (i) Запустит программу Trim-Galore для всех необработанных файлов fastq в ~/Desktop/GSE126612/fastq для выполнения обрезки адаптера и качества. (ii) Создайте одну папку (~/Desktop/GSE126612/trimmed) и сохраните выходные файлы Trim-Galore в обрезанной папке. (iii) Создайте одну папку журнала (~/Desktop/GSE126612/log/trim_galore) и запишите файл журнала trim_galore_log_RSS-number.txt для каждого прогона Trim-Galore. - После завершения прогона внимательно просмотрите файл журнала. Если в файле журнала есть сообщение об ошибке, исправьте ошибку и повторите шаг 5.3. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
- После завершения этого процесса сравните .html выходные файлы с файлами fastqc.html, созданными в версии 4.3. Пересмотрите путь к входным и выходным каталогам, чтобы выполнить этап обрезки для всех файлов fastq, расположенных в другом месте.
6. Загрузка индекса bowtie2 для референсных геномов для фактических и контрольных образцов
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh в терминале или перетащите скрипт оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт будет: (i) загружать индексы Bowtie2 для фактических образцов референсных геномов (человека; hg19; использован в оригинальной публикации22) и контрольных референсных геномов Spike-in (почковающиеся дрожжи; R64-1-1) в папку bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Запишите файл журнала (bowtie2-index-log.txt) в каталог журнала (~/Desktop/GSE126612/log/bowtie2-index). - После завершения прогона проверьте файл журнала. Если есть какое-либо сообщение об ошибке, исправьте ошибку и повторите шаг 6.3. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: В настоящее время индексы Bowtie2 для различных референсных геномов представлены на веб-сайте Bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Пользователи могут редактировать Script_05_bowtie2-index.sh для загрузки любого индекса Bowtie2 в соответствии с требованиями пользователя. Если пользователь не может найти интересующий его индекс Bowtie2 референсного генома, найдите файлы fasta референсной последовательности генома из:- Энсембл ftp (https://ftp.ensembl.org/pub/current_fasta/)
- Веб-страница UCSC (https://hgdownload.soe.ucsc.edu/downloads.html)
- или другие базы данных по конкретным видам.
После поиска файлов fasta референсной последовательности генома создайте индекс Bowtie2 для загруженного референсного генома, следуя разделу «Индексатор bowtie2-build» (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) на веб-сайте Bowtie2.
7. Картирование обрезанных считываний секвенирования CUT&RUN с референсными геномами
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт оболочки: (1) Запустит программу "галстук-бабочка" для сопоставления всех адаптеров и качественных fastq-файлов как с экспериментальными (человек; hg19), так и с контрольными шипами (почковающиеся дрожжи; R64-1-1) референсные геномы независимо. (ii) Запустите функцию просмотра samtools , чтобы сжать сопоставленные файлы прочитанных пар в формат bam. (iii) Создайте одну папку (~/Desktop/GSE126612/bowtie2-mapped) и сохраните сжатый файл сопоставленных read pairs в папке bowtie2-mapped. (iv) Создайте одну папку (~/Desktop/GSE126612/log/bowtie2-mapped) и запишите журнал процесса картирования в виде текстового файла bowtie2_log_hg19_SRR-number.txt для пар чтения, отображенных на референсном геноме hg19, и bowtie2_log_R64-1-1_SRR-number.txt для пар чтения, отображенных на R64-1-1), чтобы указать эффективность картирования в папке bowtie2-mapping log. - После завершения прогона проверьте файл журнала. Если в файле журнала есть сообщение об ошибке, исправьте ошибку и запустите скрипт оболочки еще раз. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Этот скрипт оболочки запускает bowtie2 с опциями для отображения файлов секвенирования парных концов для поиска согласованно отображенных пар чтения с длиной фрагментов 10-700 bp. Откройте для себя описания опций, набрав в терминале bowtie2 --help или посетив веб-сайт bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner), чтобы понять и изменить варианты по мере необходимости. Используйте этот скрипт оболочки для отображения любых других fastq-файлов, изменив путь и формат имен fastq-файлов и индексов Bowtie2.
8. Сортировка и фильтрация сопоставленных файлов прочитанных пар
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, набрав в терминале "chsh -s $(which bash)". Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт выполнит: (i) Запустит функцию просмотра samtools для всех сжатых сопоставленных файлов прочитанных пар в папке ~/Desktop/GSE126612/bowtie2-mapped, чтобы отфильтровать пары чтения, отображенные в неканонических областях хромосом, публично аннотированных черных списках и областях повтора TA. (ii) Выполните функцию сортировки samtools для сортировки отфильтрованных файлов bam по именам фрагментов или координации в пределах одного каталога. (iii) Запишите файл журнала в соответствии с входным файлом bam в каталоге ~/Desktop/GSE126612/log/filter-sort-bam . - После завершения прогона внимательно просмотрите файлы журнала. Если в файлах журнала есть сообщение об ошибке, исправьте ошибку и попробуйте запустить скрипт оболочки еще раз. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Результирующие файлы bam (выходные), отсортированные по именам фрагментов, будут служить входными файлами для создания фрагментов BED и необработанных файлов bedGraph с подсчетом прочтений. Файлы bam, отсортированные по координатам, будут служить входными файлами для создания фрагментных файлов BEDPE. Все BED, bedGraph и BEDPE будут использоваться для пиковых вызовов и визуализации в нисходящем анализе. Все файлы аннотаций для канонических областей хромосом (chr1~22, chrX, chrY и chrM), публично аннотированные областичерного списка 23 и области повторов TA18 расположены в каталоге ~/Desktop/Easy-Shells_CUTnRUN/blacklist . При необходимости используйте эту директорию для добавления дополнительных файлов черного списка. Используйте этот скрипт оболочки для выполнения тех же функций для других сопоставленных пар чтения файлов bam, изменив путь и имя файлов bam. Введите samtools view --help и samtools sort --help в терминале для более подробного описания этих функций.
9. Конвертация сопоставленных пар чтения во фрагменты файлов BEDPE, BED и необработанных счетчиков прочтений bedGraph
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт будет: (i) запускать функции macs3 filterdup и awk для преобразования файлов bam, отсортированных по координатам, во фрагменты файлов BEDPE, длина фрагментов которых меньше 1 кб, и сохранять файлы BEDPE в ~/Desktop/GSE126612/BEDPE. (ii) Создайте каталог журнала (~/Desktop/GSE126612/log/bam-to-BEDPE) и запишите файл журнала для каждого сопоставленного файла прочитанных фрагментов. (iii) Запуск функций bedtools bamtobed и awk, cut, sort для преобразования файлов bam, отсортированных по именам фрагментов, в фрагменты файлов BED, длина фрагментов которых меньше 1 кб. (iv) Создайте одну папку (~/Desktop/GSE126612/bam-to-bed) и сохраните фрагменты файлов BED в папке bam-to-bed. (v) Записывает файл журнала для каждого сопоставленного фрагмента чтения BED файла в каталог журнала (~/Desktop/GSE126612/log/bam-to-bed). (vi) Выполнить функцию bedtools genomecov для генерации необработанных файлов bedGraph с использованием фрагментов файлов BED в одной папке (~/Desktop/GSE126612/bedGraph). - После завершения прогона внимательно проверьте файлы логов. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Выходные необработанные файлы счетчиков чтения bedGraph будут использоваться в качестве входных файлов для программы SEACR peak caller с опцией нормализации в разделе 12 и нормализацией масштабируемого дробного числа прочтений (SFRC)22 в разделе 10. Фрагментные файлы BED будут служить входными файлами для Spike-in normalized Reads Per Million maped reads in the negative Control (SRPMC) нормализации24,25 в разделе 10.To захватывать короткие фрагменты (>100.н.) только для данных CUT&RUN по хроматин-ассоциированным факторам, изменять шаг фильтрации фрагментов в этом скрипте и переходить к этапу нормализации. Для сравнения сигналов CUT&RUN между короткими и обычными фрагментами в одной и той же выборке может быть полезна нормализация SFRC для уменьшения потенциального эффекта понижения дискретизации, вызванного захватом только коротких фрагментов. Используйте этот сценарий оболочки для выполнения тех же процессов для других отсортированных файлов bam с парным концом, изменяя путь и формат имени файлов bam и bed.
10. Конвертация необработанных файлов bedGraph с подсчетом прочтений в нормализованные файлы bedGraph и bigWig
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска цикла for с функцией awk для создания нормализованных файлов bedGraph SFRC с использованием необработанных файлов bedGraph в ~/Desktop/GSE126612/bedGraph. (ii) Выполните функцию bedGraphToBigWig для создания сжатого формата (.bw) нормализованных файлов bedGraph SFRC в ~/Desktop/GSE126612/bigWig. (iii) Запишите один файл журнала для записи коэффициента нормализации, используемого для расчета SFRC за прогон, и сохраните файл журнала в ~/Desktop/GSE126612/log/SFRC. - После завершения прогона проверьте файлы логов. Если есть какое-либо сообщение об ошибке, исправьте ошибку и запустите скрипт оболочки еще раз. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Масштабированная нормализация количества дробных операций чтения была использована в исходной публикации22 набора данных CUT&RUN GSE126612 CUT&RUN. Формула нормализации в ячейке i аналогична приведенной ниже: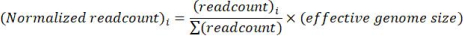
Поскольку этот метод нормализации не включает нормализацию с отрицательным контролем (например, образец IgG) или контролем всплесков, этот подход может быть не идеальным для наблюдения за полногеномной разницей сигналов между образцами. Однако, поскольку этот метод теоретически аналогичен другим нормализациям, основанным на общем количестве прочтений (например, Count Per Million), было бы достаточно наблюдать локальную разницу сигналов между выборками. - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт будет: (i) запускать for-loop с функцией bedtools genomecov для создания нормализованных файлов SRPMC bedgraph в ~/Desktop/GSE126612/bedGraph с использованием фрагментов файлов BED в ~/Desktop/GSE126612/bam-to-bed. (ii) Запишите файл журнала для записи коэффициентов нормализации, используемых для нормализации SRPMC за один прогон в ~/Desktop/GSE126612/log/SRPMC. (iii) Выполните функцию bedGraphToBigWig для создания сжатого формата (.bw) нормализованных файлов bedGraph и сохранения нормализованных файлов bigWig в папку ~/Desktop/GSE126612/bigWig . - После завершения прогона внимательно просмотрите файлы журнала. Если в файлах журнала есть сообщение об ошибке, исправьте ошибку и запустите скрипт оболочки еще раз. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Формула нормализации SRPMC была разработана для нормализации фактического количества прочтений выборки как с отрицательным контролем (например, образец IgG), так и с контролем спайка путем объединения коэффициента нормализации RPM (Reads Per Million Mapped Reads), RPS (Ratio Reads Per Spike-in Read) и относительного отношения сигнала к контролю24,25. Определение RPS такое же, как и ниже:
Применяя RPS как для фактической, так и для отрицательной контрольной выборки, относительное отношение сигнала (RS) к управляющему для фактической выборки можно рассчитать следующим образом: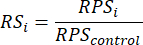
И определение коэффициента нормализации RPM (RPM:NF) такое же, как ниже: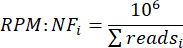
Отсюда был получен коэффициент нормализации SPMC (SRPMC:NF) путем объединения RS и RPM:NF: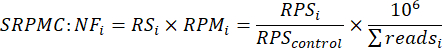
А упростить эту формулу можно следующим образом:
Таким образом, метод SRPMC нормализует чтение на (1) отношение пиковых считываний между контролем и выборкой и (2) нормализованное управление чтением RPM. Поскольку этот нормализующий фактор учитывает всплески прочтений и делает контрольные прочтения сопоставимыми между образцами вместе, этот метод будет целесообразным для наблюдения за различиями между образцами на уровне генома и уменьшения пакетного эффекта при общем количестве прочтений фактических образцов и контрольной группы в различных периодических экспериментах. Эти нормализованные файлы bedGraph станут входными файлами для вызова пиков с использованием SEACR в разделе 11. И эти нормализованные файлы bigWig будут использоваться для визуализации локусов через IGV и создания тепловой карты и усредненного графика через Deeptools. Настоятельно рекомендуется использовать браузер генома для визуализации ландшафтной структуры набора данных CUT&RUN с использованием нормализованных файлов bigWig в репрезентативных областях генома для оценки качества данных. Образцы CUT&RUN, отображающие зашумленные фоновые сигналы, напоминающие контроль IgG, скорее всего, следует опустить для последующих анализов. Используйте эти сценарии оболочки для нормализации других операций чтения файлов bedGraph и необработанных файлов bedGraph, изменяя путь и имена файлов как для входных, так и для выходных файлов bedGraph и bedgraph. Отредактируйте эти скрипты, чтобы применить другие вычисления нормализации, изменив коэффициенты и формулу в этом скрипте.
11. Валидация распределения фрагментов по размерам
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для того, чтобы: (i) запустить функцию CollectInsertSizeMetrics picard.jar использованием сопоставленных пар чтения bam файлов в папке ~/Desktop/GSE126612/filtered-bam для определения распределения размеров вставки. (ii) Создайте одну папку (~/Desktop/GSE126612/insert-size-distribution) и сохраните результаты анализа распределения размеров вставки в созданную папку. (iii) Запишите файл журнала в папку input bam в папке ~/Desktop/GSE126612/log/insert-size-distribution . - После завершения прогона внимательно проверьте файлы логов. Если в файлах журнала есть сообщение об ошибке, исправьте ошибку и попробуйте запустить скрипт оболочки еще раз. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: В целом, анализ размера вставки (Output) для образцов CUT&RUN показывает основные пики в диапазонах размеров моно- (100-300.н.) и di- (300-500.н.). Технические ошибки/ограничения (такие как избыточное/недостаточное переваривание MNазы во время подготовки образцов CUT&RUN или неправильный выбор размера во время подготовки библиотеки) могут привести к обогащению таких же или больших, чем тринуклеосомные (500-700.о.) фрагменты, и таких же или более коротких, чем субнуклеосомные (<100.о.) фрагменты. Иногда отсутствие пиков мононуклеосомных размеров при обогащении длинными (>500.н.) и короткими фрагментами (<100.н.) может быть связано с диапазонами выбора размера библиотеки, выбранными на стадии мокрой лаборатории, или низкой глубиной секвенирования. Сравните глубину секвенирования («общее количество секвенированных оснований» / «общий размер референсного генома»), обзор геномного ландшафта с использованием нормализованных файлов bigWig в разделе 10 и схему распределения размеров вставки вместе, чтобы уточнить качество обработанных образцов CUT&RUN. Пунктирные линии на гистограммах представляют собой «совокупную долю» прочтений с размером вставки, большим или равным значению на оси x. Эта пунктирная линия позволяет определить распределение размеров вставок во входном сопоставленном файле чтения. Последовательность движения по оси x связана с увеличением размера пластины. Пунктирная линия обозначает долю сопоставленных пар чтения во входном файле bam, размер вставки которых по крайней мере такой же большой, как указано в положении пересекающейся оси X. Таким образом, интерпретация начинается с цифры 1 слева, указывая на то, что все операции чтения имеют размер вставки, больше или равный наименьшему размеру, и уменьшается до 0 по мере увеличения размера вставки.
12. Вызов пиковых значений с использованием MACS2, MACS3 и SEACR
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функций macs2 callpeak и macs3 callpeak с контролем IgG и без него, используя фрагменты файлов BEDPE, для вызова пиков и сохранения результатов пиковых вызовов в выходных директориях (~/Desktop/GSE126612/MACS2 и ~/Desktop/GSE126612/MACS3). (ii) Запишите журнал этих пиковых вызовов в виде текстового файла в каталоге журнала (~/Desktop/GSE126612/log/MACS2 и ~/Desktop/GSE126612/log/MACS3) - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот сценарий написан для: (i) Запуска SEACR_1.3.sh скрипта с контролем IgG и без него, со строгими и ослабленными параметрами с использованием необработанных файлов чтения bedGraph и нормализованных файлов bedGraph для вызова пиков. (ii) Создайте выходной каталог (~/Desktop/GSE126612/SEACR-peaks) и сохраните результаты пиковых вызовов с помощью SEACR. (iii) Запишите журнал этих пиковых вызовов в виде текстового файла в каталоге журнала (~/Desktop/GSE126612/log/SEACR). - После завершения запуска shell-скриптов внимательно проверьте файлы логов. Если в файлах журнала есть сообщение об ошибке, сначала исправьте ошибку. Некоторые программы могут не вызывать пики для контрольного образца IgG с опцией контроля IgG вместе, поэтому сообщение об ошибке относительно контрольного образца IgG с опцией контроля IgG может быть опущено. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Эти два сценария оболочки выполняют пиковые вызовы для образцов CUT&RUN с использованием трех пиковых вызовов (MACS2, MACS3 и SEACR) с различными опциями: с/без опции управления IgG, с использованием необработанных прочитанных файлов bedGraph с опцией нормализации пикового вызывающего или нормализованных прочитанных файлов bedGraph без опции нормализации пикового вызывающего абонента, а также строгих и ослабленных опций пикового вызова SEACR. Поскольку выходных файлов вызовов пиков недостаточно для использования непосредственно в нисходящем анализе, Easy Shells CUTnRUN включает один скрипт для обработки этих называемых выходных файлов пиков для создания новых файлов пиков, которые включают хромосому, начало, конец и имя пиков. Благодаря интенсивным подходам к пиковым вызовам, Easy Shells CUTnRUN предоставляет возможность выбрать программу пиковых вызовов, наиболее подходящую для проекта пользователя CUT&RUN, путем сравнения пиковых вызовов по трем пиковым вызовам. Кроме того, этот конвейер анализа CUT&RUN также предоставляет возможность выбрать варианты пиковых вызовов, наиболее подходящие для проекта пользователя CUT&RUN. Эти сравнения будут производиться с помощью диаграммы Венна, а визуализация будет выполнена в виде тепловой карты и усредненного графика.
13. Создание файлов с вызовом пикового ложа
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функции awk с использованием файлов bed в папке ~/Desktop/GSE126612/SEACR для создания двух типов файлов SPACR peak bed ~/Desktop/GSE126612/pic-bed_SEACR . Целые файлы ложа пика включают начало и конец каждого пика, а файлы сфокусированного слоя пика включают начало и ложе самого высокого сигнального столбца в пределах каждого пика. (ii) Запустите функцию awk с использованием файлов _peaks.xls в папках ~/Desktop/GSE126612/MACS2 и ~/Desktop/GSE126612/MACS3 для создания целых файлов ложа пика, которые включают начало и конец каждого пика, вызванного MACS2 и MACS3 в папках ~/Desktop/GSE126612/peak-bed_MACS2 и ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) Запустите функцию awk с использованием файлов _summits.bed в папках ~/Desktop/GSE126612/MACS2 и ~/Desktop/GSE126612/MACS3 для создания сфокусированных файлов порогового слоя, которые включают начало и конец наиболее значимого столбца в пределах каждого пика. (iv) Файлы журнала записываются в текстовом формате в папку ~/Desktop/GSE126612/log/peak-bed . - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуск функции пересечения кроватей с использованием файлов ложа пиков, которые вызываются без опции контроля IgG для удаления пиков, перекрывающихся с контрольными пиками IgG. (ii) Отфильтрованные файлы peak bed сохраняются в папках ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 и ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) Файл журнала log_filter-peaks.txt создается в папке ~/Desktop/GSE126612/log/filter-peaks . - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функций cat и сортировки для объединения полных файлов MACS2 и MACS3 всех пиковых кроватей реплик в один файл пиковой кровати и сортировки объединенного файла в папке ~/Desktop/GSE126612/bed-for-comparison . (ii) Запустите функцию объединения инструментов для кроватей с использованием объединенных файлов целого слоя вершин для объединения вершин, которые перекрывают друг друга. (iii) Файл журнала log_cat-merged-peak-bed_MACS.txt записывается в папку журнала ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для того, чтобы: (i) Запустить функции cat и sort для объединения всех файлов SEACR всех пиковых кроватей репликантов в один файл пиковой кровати и отсортировать объединенный файл пиковой кровати в папке ~/Desktop/GSE126612/bed-for-comparison . (ii) Запустите функцию объединения инструментов для кроватей с использованием объединенных файлов целого слоя вершин для объединения вершин, которые перекрывают друг друга. (iii) Файл журнала log_cat-merged-peak-bed_SEACR.txt записывается в папку журнала ~/Desktop/GSE126612/log/cat-merged-peak-bed. - После завершения запуска сценариев оболочки внимательно просмотрите файлы логов. Если в файлах журнала есть сообщение об ошибке, исправьте ошибку и запустите скрипт(ы) снова. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Файлы ложа пика целых областей пика будут использоваться в качестве входных файлов анализа диаграммы Венна для сравнения сходства между вариантами вызова пиков, методами вызова пиков, репликациями и наблюдениями геномного ландшафта вблизи пиковых областей. Объединенные файлы ложа пиковых областей будут использоваться для анализа главных компонент (ПК) и корреляционного анализа коэффициентов Пирсона с использованием инструментов deeptools. Файлы сфокусированного ложа пика будут использоваться для тепловой карты и анализа графиков средних значений с помощью Deeptools.
14. Проверка сходства между репликациями с помощью корреляции Пирсона и анализа главных компонент (ПК).
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, пользователи могут увидеть следующее: /path/to/bash (или аналогичное сообщение, такое как /bin/bash) в терминале.
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, пропустите этот шаг.
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функции BED-файла multiBamSummary с использованием файлов bam репликатов, которые были отсортированы по координатам, и объединенных целых файлов ложа пика для CTCF, H3K27Ac и RNAPII-S5P для создания матричных файлов для корреляционного анализа Pearson в папке Desktop/GSE126612/deeptools_multiBamSummary . (ii) Запустите функцию plotCorrelation с использованием файлов матрицы для вычисления коэффициента корреляции Пирсона и кластеризации тепловой карты и сохраните результат в папке ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Запишите файл журнала log_plotCorrelation.txt в папку ~/Desktop/GSE126612/log/correlation . - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функции BED-файла multiBamSummary с использованием файлов bam, которые были отсортированы по координатам, и объединенных целых файлов ложа пика, которые включают все пики CTCF, H3K27ac и RNAPII-S5P, для создания матричных файлов для анализа главных компонент (PCA) в папке Desktop/GSE126612/deeptools_multiBamSummary . (ii) Запустите функцию plotPCA с использованием файлов матрицы для выполнения PCA и сохраните результат в папке ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Запишите файл журнала log_plotPCA.txt в папку ~/Desktop/GSE126612/log/correlation . - После завершения выполнения shell-скриптов проверьте файлы логов. Если есть какое-либо сообщение об ошибке, исправьте ошибку и запустите скрипты оболочки снова. Если возникла проблема для ее устранения, обратитесь за помощью с помощью веб-страницы проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
Примечание: В принципе, правильно подготовленные и обработанные реплики показывают более высокие значения коэффициента корреляции Пирсона в одной и той же кластерной группе и близкое позиционирование в анализе главных компонент. Любая реплика, которая показывает более низкий коэффициент корреляции Пирсона и большое расстояние от других реплик на графике главных компонент, может представлять собой потенциальное исключение среди репликатов. Этот скрипт оболочки применим для любого формата bam, сопоставленных с данными чтения. Изменяйте путь и имя файла bigwig в соответствии с требованиями проекта.
15. Проверка сходства между репликациями, методами вызова пиков и опциями с помощью диаграммы Венна
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, то в терминале может быть что-то вроде /path/to/bash (например, /bin/bash).
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, подумайте о том, чтобы пропустить этот шаг
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функции intervention venn с использованием файлов ложа пика всей области пика для поиска перекрытий между пиками, вызываемыми различными вариантами (с/без опции контроля IgG, с/без нормализации и строгими/ослабленными опциями вызова пиков для SEACR). (ii) Создайте одну папку (~/Desktop/GSE126612/intervene_methods) и сохраните результаты анализа диаграммы Венна в этой папке. (iii) Запишите один файл журнала log_intervene_methods.txt в папку ~/Desktop/GSE126612/log/intervention . - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
ПРИМЕЧАНИЕ: Этот скрипт написан для того, чтобы: (i) запустить функцию intervention venn с использованием файлов ложа пика всей области пика для поиска перекрытий между пиками реплик. (ii) Создайте одну папку (~/Desktop/GSE126612/intervene_replicates) и сохраните результаты анализа диаграммы Венна в этой папке. (iii) Запишите один файл журнала log_intervene_replicates.txt в папку ~/Desktop/GSE126612/log/intervention . - После завершения запуска сценариев оболочки просмотрите файлы журнала. Если есть какое-либо сообщение об ошибке, исправьте ошибку и запустите скрипты оболочки снова. Если у вас возникли проблемы с использованием конвейера анализа Easy Shells CUTnRUN, обратитесь за помощью на веб-странице проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: Эти результаты анализа диаграммы Венна дают представление о выборе наиболее подходящих опций, методов и репликаций пиковых вызовов с высокой воспроизводимостью для последующего анализа. Может быть предпочтительнее выбирать опции и методы пикового вызова, которые показывают наибольшие пиковые числа вызовов с хорошим перекрытием с другими методами и опциями пиковых вызовов.
16. Анализ тепловых карт и усредненных графиков для визуализации называемых пиков.
- Откройте терминал и введите echo $SHELL , чтобы проверить оболочку по умолчанию в активном терминале. Если оболочка Bash является оболочкой по умолчанию в текущем терминале, то в терминале может быть что-то вроде /path/to/bash (например, /bin/bash).
- Если оболочка по умолчанию не Bash, установите оболочку Bash в качестве оболочки по умолчанию, введя chsh -s $(which bash) в терминале. Если терминал использует оболочку Bash по умолчанию, подумайте о том, чтобы пропустить этот шаг
- Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh в терминале или перетащите файл скрипта оболочки в терминал и введите.
ПРИМЕЧАНИЕ: Этот скрипт написан для: (i) Запуска функции опорных точек computeMatrix с использованием нормализованных файлов bigWig и файлов сфокусированных пиковых лож для создания нормализованных матриц чтения в центре сфокусированных пиков в папке ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Запустите функцию plotHeatmap с использованием нормализованной матрицы чтений для создания тепловых карт и усредненных графиков, которые визуализируют нормализованную схему распределения счетчиков прочтений в сфокусированных пиковых точках. (iii) Создайте одну папку (~/Desktop/GSE126612/deeptools_plotHeatmap) и сохраните выходные файлы plotHeatmap в этой папке. (iv) Запишите один файл журнала log_plotHeatmap_focused.txt в папку ~/Desktop/GSE126612/log/plotHeatmap . - Введите ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh в терминале или перетащите файл скрипта оболочки в терминал и войдите.
Этот скрипт написан для: (i) Запуска функции опорных точек computeMatrix с использованием нормализованных файлов bigWig и файлов всего ложа пика для создания нормализованных матриц счетчиков чтения в центре всех пиков в папке ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Запустите функцию plotHeatmap с использованием нормализованной матрицы счетчиков прочтений для создания тепловых карт и усредненных графиков, которые визуализируют схему распределения нормализованных чисел чтения во всех местах пиковых нагрузок. (iii) Создайте одну папку (~/Desktop/GSE126612/deeptools_plotHeatmap) и сохраните выходные файлы plotHeatmap в этой папке. (iv) Запишите один файл журнала log_plotHeatmap_whole.txt в папку ~/Desktop/GSE126612/log/plotHeatmap . - После завершения запуска сценариев оболочки просмотрите файлы журнала. Если есть какое-либо сообщение об ошибке, исправьте ошибку и запустите скрипты оболочки снова. Если у вас возникли проблемы с использованием конвейера анализа Easy Shells CUTnRUN, обратитесь за помощью на веб-странице проблем Easy Shells CUTnRUN на github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
ПРИМЕЧАНИЕ: В идеале, пиковые вершины пиков MACS2/3 и сфокусированные пики SEACR демонстрируют резкое и сфокусированное распределение сигнала в центре графиков. Однако, если алгоритм вызова пиков не работает должным образом для данных CUT&RUN, на графиках может появиться менее сфокусированное «зашумленное» распределение сигнала. Таким образом, использование количества вызываемых пиков и шаблонов распределения пикового сигнала на выходных графиках будет определять пиковую достоверность для дальнейшего анализа CUT&RUN, который включает аннотацию нисходящих пиков.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Качество и обрезка адаптера сохраняют прочтения с высоким качеством секвенирования
Методы секвенирования с высокой пропускной способностью склонны к возникновению ошибок секвенирования, таких как «мутации» последовательностей при чтении. Кроме того, димеры адаптера секвенирования могут быть обогащены в наборах данных секвенирования из-за плохого удаления адаптера во время подготовки библиотеки. Чрезмерные ошибки секвенирования, такие как мутации чтения, генерация прочтений короче, чем требуется для пр...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Возможность картирования занятости белка на хроматине имеет основополагающее значение для проведения механистических исследований в области биологии хроматина. По мере того, как лаборатории внедряют новые методы профилирования хроматина, возможность анализировать данные секвенирования из этих лабораторных экспериментов становится распространенным узким местом для ученых, изучающих мокрую лабораторию. Поэтому мы описываем вводный пошаговый протокол, который позволит новичкам в биоинформат...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют о неразглашении информации.
Благодарности
Все иллюстрированные рисунки были созданы с использованием BioRender.com. CAI выражает признательность за поддержку, предоставленную в виде премии Альянса по исследованию рака яичников для исследователей в начале карьеры, гранта Фонда Форбека и Национальной премии за исследования в области раннего выявления рака яичников Миннесотского альянса по раку яичников.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Программное обеспечение для сжатия и преобразования подсчетов чтения bedGraph в bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ the U. of Utah | https://bedtools.readthedocs.io/en/latest/index.html | Программное обеспечение для обработки файлов bam/bed/bedGraph |
| bowtie2 2.5.4 | Университет | Джонса Хопкинсаhttps://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Программное обеспечение для построения индекса галстука-бабочки и выполнения выравнивания |
| CollectInsertSizeMetrics (Picard) | Broad Institute | https://github.com/broadinstitute/picard | Программное обеспечение для анализа распределения размеров вставок |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Программное обеспечение для выполнения обрезки |
| адаптеровDeeptoolsv3.5.1 | Институт Макса Планка | https://deeptools.readthedocs.io/en/develop/index.html | Программное обеспечение для выполнения корреляционного анализа коэффициента Пирсона, анализа главных компонент и анализа тепловой карты/среднего графика |
| FastQC Версия 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Программное обеспечение для проверки качества файла fastq |
| Interventionv0.6.1 | Вычислительная биология и Регуляция генов - Mathelier group | https://intervene.readthedocs.io/en/latest/index.html | Программное обеспечение для выполнения анализа диаграмм Венна с использованием файлов пиков |
| MACSv2.2.9.1 | Инициатива Чана Цукерберга | https://github.com/macs3-project/MACS/tree/macs_v2 | Программное обеспечение для вызова пиков |
| MACSv3.0.2 | Инициатива Чана Цукерберга | https://github.com/macs3-project/MACS/tree/master | Программное обеспечение для вызова пиков |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Программное обеспечение для обработки файлов sam/bam |
| SEACRv1.3 | Howard Hughes Medial Institute | https://github.com/FredHutch/SEACR | Программное обеспечение для вызова пиков |
| SRA Toolkit Release 3.1.1 | NCBI | https://github.com/ncbi/sra-tools | Программное обеспечение для загрузки SRR из GEO |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | программное обеспечение для выполнения качественной и атаптерной обрезки |
Ссылки
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Перепечатки и разрешения
