Для решения проблем фрагментации юридических текстов и отслеживания предвзятости медицинского искусственного интеллекта (И) в данном исследовании создается граф юридических знаний и применяется графовая свертка с учетом отношений для семантического выравнивания. Источники предвзятости выявляются с помощью обратного распространения ошибки на основе градиента; полученные положительные экспериментальные показатели подтверждают возможность создания соответствующего нормативным требованиям приложения медицинского ИИ.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Построение графов правовых знаний и отслеживание предвзятости в медицинском искусственном интеллекте на основе графовых нейронных сетей
В этой статье
Краткое содержание
Аннотация
В данной работе, посвященной анализу соблюдения правовых норм при использовании искусственного интеллекта (ИИ) в медицине, рассматривается проблема неопределенности при определении ответственности, вызванная семантической фрагментацией разнородных многоисточниковых юридических текстов и трудностями в отслеживании алгоритмических предвзятостей. Авторами предложен метод построения графа знаний и обнаружения путей распространения предвзятости на основе графовых нейронных сетей. Структурированы и закодированы четыре типа гетерогенных узлов — правовые нормы, медицинские действия, модули алгоритмов и ответственные стороны, а также построен ориентированный граф на основе четырех типов семантических правовых связей: "нарушение", "основа", "триггер"и "атрибуция"Затем используется графовая сверточная сеть с учетом отношений в сочетании со специфичными для типов ребер весами и механизмом внимания для достижения многослойного выравнивания признаков кросс-модальной юридической семантики. Далее применяется градиентный метод обратного распространения ошибки для выявления ребер, вносящих значительный вклад в смещение, построения подграфа распространения смещения и использования алгоритма обнаружения сообществ для локализации кластеров корневых узлов. В завершение потоки принятия решений в реальном времени отображаются на временные узлы, соответствие проверяется с помощью сходства эмбеддингов, а динамика весов ключевых ребер отслеживается для предупреждения о накоплении системного смещения. Эксперименты показывают, что с точки зрения точности семантического выравнивания предлагаемый метод обеспечивает среднюю точность выравнивания сущностей не менее 0,92 и среднюю полноту сохранения отношений не менее 0,8 при различных градиентах плотности графа знаний. Что касается способности к локализации смещения, полнота охвата корневых узлов достигает 0,95.±±0,02, а точность пути распространения достигает 0,93±±0.03. Данное исследование в определенной степени обеспечивает глубокую взаимосвязь между правовой логикой и алгоритмическим поведением, создавая объяснимую и верифицируемую систему поддержки комплаенса для надежного внедрения искусственного интеллекта в медицине.
Введение
Глубокое внедрение медицинского ИИ в процессы диагностики и поддержки лечения, распределения ресурсов и оценки рисков связало процесс принятия им решений с вопросом юридической ответственности1,2. Правовые нормы строго структурированы, но семантически распределены, в то время как работа систем ИИ может быть представлена по принципу «черного ящика», что создает отсутствие семантически согласованного и отслеживаемого интерфейса между ними3. В этом контексте разработка общей системы представления, которая фиксирует юридические причинно-следственные связи в последовательностях алгоритмического поведения, стала необходимым условием для реализации детального распределения ответственности и динамического соблюдения нормативных требований4,5. Данное исследование относится не только к правовому тестированию технологических систем, но и затрагивает вопросы обеспечения медицинской справедливости, алгоритмической беспристрастности и институционального доверия, что придает ему большое теоретическое значение и практическую актуальность.
Основной проблемой современного анализа соответствия медицинского ИИ правовым нормам является отсутствие вычислимой связующей структуры между правовой семантикой и алгоритмическим поведением6,7. Юридические документы представлены в виде обычного текста, а связи между параграфами переплетены зависимостями, конфликтами и исключениями, что создает трудности при их разделении на логические единицы, которые могли бы интерпретироваться машинами8,9. При этом процесс принятия решений системой ИИ инкапсулирован в основанном на данных «черном ящике», и ни один из вариантов выходных данных не может быть соотнесен с конкретными нарушениями юридических обязательств или узлами распределения ответственности10,1. Подобный разрыв (например, смещение в обучающих данных, недостатки проектирования модели или семантическая интерпретация правовых норм) не может быть выделен экспериментально для определения источника систематической ошибки или уточнения юридических обязанностей разработчиков, лиц, внедряющих систему, или пользователей12,13. Еще более проблематично то, что существующие процедуры комплаенса проверяют лишь соответствие конечного результата фиксированной спецификации, не учитывая путь распространения или усиления смещения в сети взаимодействий «право — технология»14,15. Когда медицинский ИИ одновременно подпадает под действие нескольких правовых положений и система допускает цепочку ошибок из-за неверного толкования одного пункта, традиционные подходы не позволяют проследить, как эта ошибка распространяется через другие связанные положения и приводит к возникновению ответственности16,17. Кроме того, отсутствует механизм динамической корреляции между потоком решений в реальном времени и существующим графом правовых знаний, что приводит к задержке оценки соответствия во время работы системы и, следовательно, препятствует проактивному мониторингу тенденций накопления смещения18,19. В совокупности эти проблемы приводят к неопределенности при определении ответственности, сложности ее атрибуции и запоздалому регуляторному вмешательству, что существенно препятствует надежному внедрению систем ИИ высокого риска в здравоохранении и применению правовой ответственности.
Прежде всего, традиционные исследования изучают юридические тексты в структурированной форме и создают базы знаний по конкретным областям с помощью онтологий или правил для поддержки ответов на вопросы о соответствии нормативным требованиям или уведомлений о рисках20,21. Хотя эти подходы позволяют фиксировать представления некоторых юридических концепций, они, как правило, предполагают, что внутренняя логика права является когерентной и статичной, что затрудняет работу с межюрисдикционными противоречиями, исключениями или расплывчатыми формулировками. В последующих работах была внедрена технология обработки естественного языка с использованием предобученных языковых моделей для извлечения юридических сущностей и отношений, что расширило охват извлечения знаний2,23, однако это все еще остается на поверхностном семантическом уровне, не позволяя создать интерфейс сопоставления между юридическим и техническим поведением. Что касается управления алгоритмической предвзятостью, исследования в основном были сосредоточены на разработке ограничений справедливости24,25, а их показатели оценки обычно основаны на демографических переменных, что не соответствует принципам юридической атрибуции. В некоторых исследованиях предпринимались попытки закодировать юридические правила в виде ограничений и внедрить их в процесс обучения моделей26,27, но из-за жесткости и грубой гранулярности выражения правил их трудно адаптировать к сложным клиническим ситуациям. В целом, в существующих работах соблюдение правовых норм рассматривается как задача внешней верификации, а не как внутренний вычисляемый атрибут архитектуры системы. В результате юридическая логика и алгоритмическая логика функционируют параллельно, что не позволяет осуществлять совместный вывод и динамическое вмешательство в пути распространения предвзятости.
В последние годы графовые нейронные сети постепенно внедряются в медицинскую сферу благодаря их способности к явному моделированию реляционных структур28,29. В некоторых исследованиях используются гетерогенные графы для интеграции судебной практики, законодательных положений и информации о сторонах, что позволяет осуществлять рекомендации по делам или прогнозирование приговоров с помощью вложений узлов30,31, подтверждая тем самым эффективность графовых структур в фиксации правовых связей. В других работах алгоритмические компоненты абстрагируются как узлы графа, а ребра используются для представления потоков данных или отношений вызова с целью отслеживания распространения ошибок32,3. Эти исследования демонстрируют, что графовые структуры могут служить общим носителем как правовых, так и технологических элементов. Однако существующие графовые модели обычно имеют три ограничения: во-первых, они ограничены одним типом ребер, что не позволяет разграничить нормативные, каузальные и атрибутивные различия в правовой семантике; во-вторых, процесс агрегации признаков игнорирует семантические веса типов ребер, в результате чего различные пути правовой логики рассматриваются как равноценные; и в-третьих, в них отсутствует дифференцируемый механизм отслеживания распространения смещения, что делает невозможным определение ребер с наибольшим вкладом и реконструкцию путей ответственности. В данной работе представлена графовая сверточная сеть с учетом отношений, которая решает проблему слияния семантической гетерогенности путем назначения специальной матрицы преобразования для каждого типа семантических правовых ребер и внедрения механизма внимания для динамического регулирования межтипового информационного потока. Кроме того, сочетание обратного распространения градиента и извлечения подграфов обеспечивает интерпретируемый переход от оценки соответствия на макроуровне к отслеживанию смещения на микроуровне, преодолевая ограничения традиционных графовых моделей, поддерживающих только статические рассуждения.
Помимо медицинской области, последние достижения в методах на основе графов и эволюционных методах продемонстрировали широкую применимость для обработки структурированных знаний. Например, Xue et al. предложили многослойный гибридный подход на основе генетического программирования для адаптивного построения признаков сходства при сопоставлении онтологий, чего удалось достичь путем надежного выравнивания гетерогенных графов знаний34. Cheng et al. представили комплексный обзор применения графовых сверточных сетей в восстановлении изображений, систематизировав методы шумоподавления, сверхразрешения и устранения размытия35. Li et al. представили подробный обзор эволюционного глубокого обучения с точки зрения автоматизированного машинного обучения, охватывающий принципы, алгоритмы, области применения и актуальные проблемы36. Ma et al. разработали структуру нечеткого поиска нейронной архитектуры для распознавания дефектов в условиях неопределенности, продемонстрировав эффективность эволюционного поиска при работе с неоднозначными данными37. Эти исследования подчеркивают потенциал интеграции графовых представлений и эволюционной оптимизации для решения сложных задач принятия решений.
Основная цель данной работы заключается в создании сквозной интерпретируемой структуры для анализа соответствия медицинского ИИ правовым нормам, с внедрением инноваций на трех уровнях. На уровне представления знаний впервые предлагается моделирование правовых положений, медицинской практики, модулей алгоритмов и ответственных сторон в виде четырех типов гетерогенных узлов. На основе юридической практики выделяются четыре типа направленных связей: «нарушение», «основание», «триггер» и «приписывание ответственности», что позволяет построить ориентированный граф знаний с правовой причинно-следственной логикой, обеспечивающий структурированный семантический фундамент для анализа комплаенса. Для отслеживания источников предвзятости предлагается метод количественной оценки вклада ребер на основе градиентной чувствительности. С помощью обратного распространения определяется набор ребер, максимизирующий выходное смещение, после чего применяется алгоритм обнаружения сообществ для кластеризации узлов с высоким вкладом, что превращает «предвзятость черного ящика» в «белые кластеры ответственности», делая атрибуцию основанной на операбельной цепочке доказательств. На уровне динамического мониторинга в реальном времени разработан механизм временного встраивания узлов принятия решений, который отображает выходные данные ИИ в реальном времени в пространство графа знаний. На основе сравнения близости эмбеддингов количественно оценивается степень отклонения от нормы и отслеживается изменение веса ключевых правовых и технических ребер для сигнализирования о накоплении системной предвзятости. Данная парадигма решает проблемы семантической фрагментации и прослеживаемости, превращая правовой комплаенс из апостериорной проверки в априорное управление, предлагая масштабируемый технический путь к прозрачности ответственности в системах ИИ с высоким уровнем риска.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Построение графовой нейронной сети для графа знаний в области медицинского ИИ и права
Как показано на Рисунке 1, предлагаемая структура состоит из трех основных модулей. Входной слой объединяет многоисточниковые данные в гетерогенный граф посредством мультимодального кодирования сущностей и моделирования направленных ребер. Затем слой GCN с учетом отношений выполняет кросс-модальное семантическое выравнивание с помощью специфических для типа весов и механизмов внимания, создавая унифицированные эмбеддинги узлов. Наконец, эти эмбеддинги используются для отслеживания смещений (посредством обратного распространения градиента и обнаружения сообществ) и динамического мониторинга соответствия (посредством картирования узлов и отслеживания весов ребер в реальном времени), при этом на выходе формируются интерпретируемые доказательства атрибуции и оповещения о рисках для регуляторов.
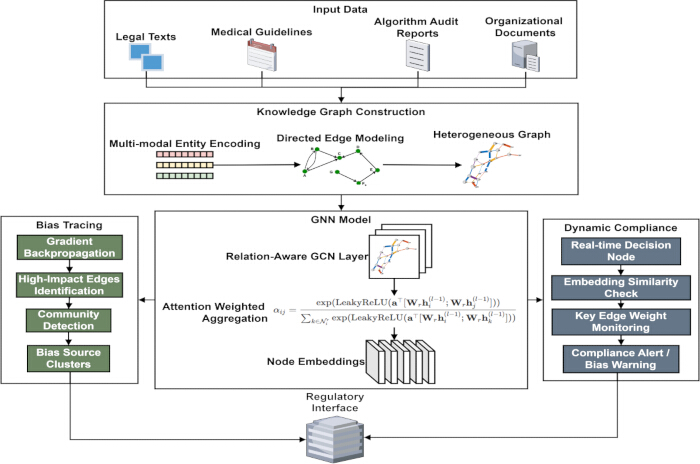
Рисунок 1Архитектура графа юридических знаний и отслеживания предвзятости для медицинского ИИ. На данной схеме представлен общий рабочий процесс предлагаемой структуры. Входной слой объединяет гетерогенные данные из нескольких источников (юридические тексты, клинические рекомендации, отчеты об аудите алгоритмов), которые кодируются в четыре типа сущностей (положения закона, медицинские действия, модули алгоритмов, ответственные стороны) и связываются четырьмя направленными юридически-семантическими отношениями (нарушение, основание, триггер, атрибуция). Слой GCN с учетом отношений осуществляет кросс-модальное семантическое выравнивание с помощью весов и внимания, специфичных для каждого типа. Модуль отслеживания предвзятости использует обратное распространение градиента для выявления ребер с наибольшим вкладом, а затем применяет алгоритм обнаружения сообществ для поиска кластеров корневых узлов. Монитор динамического соответствия сопоставляет решения, принимаемые в реальном времени, с временными узлами, оценивает сходство эмбеддингов с положениями закона и отслеживает изменение весов ребер для раннего оповещения. Результаты включают интерпретируемые доказательства атрибуции и предупреждения о рисках. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Гетерогенное графовое структурированное кодирование юридических лиц и взаимосвязей
Из нормативных актов в области регулирования ИИ в медицине, руководств по клинической практике и отчетов об аудите алгоритмов последовательно выделяются четыре основные сущности: правовые положения, медицинские процедуры, модули алгоритмов и подотчетные субъекты. Для каждого типа сущностей предлагается отдельная модель обучения представлению признаков для обеспечения их семантической различимости. Узлы правовых положений структурированы таким образом, чтобы содержать номер положения, который используется в качестве уникального ID (идентификатора) данного правового положения. Одновременно с этим определяется индекс количественной оценки строгости наказания для указания уровня юридической ответственности, связанной с данным положением, на основании чего формируется вектор признаков.
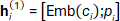 (1)
ci — это порядковый номер записи, Emb(·) обозначает отображение низкоразмерного вложения, а [·;·] представляет операцию конкатенации векторов. Данное представление сохраняет как формальную структуру, так и степень строгости наказания в юридическом тексте, что обеспечивает возможность рассуждений между различными утверждениями.
Узлы медицинского поведения стандартизированы и закодированы на основе системы классификации клинических операций, из которой извлекается уровень риска rj ∈ {1,2,3} и набор применимых меток сценария sj ⊂ S, где S представляет собой полный набор предопределенных категорий сценариев. Для обработки набора меток используется multi-hot кодирование, которое затем объединяется с эмбеддингом уровня риска для формирования начального представления:
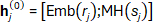 (2)
Данная стратегия гарантирует, что различные типы медицинского поведения имеют измеримые дистанционные соотношения в векторном пространстве, что позволяет проводить сравнения между различными сценариями. Функция вложения текста Emb(·) реализована с использованием предобученной китайской языковой модели для юридической сферы Lawformer (предобученной на крупномасштабном китайском юридическом корпусе), при этом выходная размерность зафиксирована на уровне 768.
На основе логических зависимостей и правовых ограничений между объектами устанавливаются четыре типа направленных семантических связей: «нарушение» (violation), «основание» (basis), «триггер» (trigger) и «атрибуция» (attribution), каждая из которых соответствует определенным моделям правовой причинно-следственной связи. Каждому ребру eij ⊂ E присваивается тип метки tij ⊂ T = {violate, base, trigger, attribute} для последующей передачи сообщений с целью определения взаимосвязей. Построение ребер строго следует механизму сопоставления с правилами предметной области: когда медицинское действие отклоняется от нормативных требований, устанавливается ребро «нарушение», направленное от узла действия к соответствующему пункту закона; когда пункт закона служит техническим основанием для соблюдения правил при выполнении операции, устанавливается ребро «основание»; если результат работы модуля алгоритма напрямую инициирует выполнение конкретного медицинского действия, подключается ребро «триггер»; связь установления ответственности формируется на основе документов об ответственности организации и заключений аудита, создавая ребро «атрибуция» между ответственной стороной и нарушением или дефектом алгоритма.
После инициализации всех узлов формируется гетерогенный граф (V, E, H0), где V — множество узлов, E — множество направленных ребер с метками типов, а H0 — начальная матрица признаков. Для повышения семантической дискриминационной способности структуры графа признаки узлов нормализуются:
 (3)
μk и σk — это среднее значение и стандартное отклонение признака k-го узла на обучающей выборке соответственно, а ∈ — малая константа для предотвращения деления на ноль. Нормализация гарантирует, что многоисточниковые гетерогенные признаки участвуют в операциях графовой свертки в едином масштабе, что предотвращает влияние эффектов численного доминирования на семантическое обучение. Полученная структурированная графовая модель полностью отражает реляционную топологию четырехмерных элементов — права, поведения, технологии и ответственности — в системе медицинского ИИ, обеспечивая вычислительную графовую основу для последующего анализа распространения смещения.
Улучшение выравнивания графовых сверток для кросс-модальной юридической семантики
Графовая сверточная сеть с учетом отношений38,39, расширяющая структуру Relational Graph Convolutional Network (R-GCN), используется для распространения признаков через несколько слоев исходного гетерогенного графа. В то время как R-GCN вводит матрицы преобразования для каждого отношения для общих реляционных данных, наш подход дополнительно включает обучаемый механизм внимания для динамического взвешивания вклада соседних узлов и определяет четыре специфических типа юридико-семантических отношений (нарушение, основание, триггер, атрибуция), адаптированных для анализа соответствия медицинского ИИ нормативным требованиям. Операция в каждом слое независимо параметризует процесс преобразования на основе семантического типа ребер. Для любого целевого узла информация о его окрестности группируется и агрегируется по типам соединяющих ребер. Каждый тип отношения оснащен выделенной матрицей линейного преобразования для дифференциации признаков, передаваемых по различным юридико-семантическим путям40,41. Если ребро между узлом положения закона и узлом медицинского поведения имеет тип «основание», то при получении сообщения от узла медицинского поведения узел положения закона применяет соответствующую весовую матрицу для пространственного отображения признаков соседа. Аналогичным образом, когда узел медицинского поведения отправляет выходной сигнал через модуль схемы интеграции ребер «триггер» в модуль алгоритма, используется матрица параметров triggered, связанная с этим отношением, которая выполняет преобразование признаков. Это имитирует гибкость различных типов юридической логики, реализуя и информируя различные логические уровни для сохранения семантической независимости в процессе информационного потока без кросс-модального шума. Агрегация определяется следующим образом:
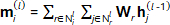 (4)
mi(l) представляет собой совокупную информацию, собранную узлом i в слое l, Nil — его множество соседей согласно отношению r, Wr — матрица линейного преобразования, а hj(l−1) — векторное представление (embedding) соседнего узла в предыдущем слое.
В процессе агрегации сообщений внедрен обучаемый механизм внимания для динамического регулирования интенсивности влияния различных соседних узлов на обновление представления целевого узла42,43. Коэффициент внимания генерируется на основе двух факторов: сходства атрибутов узлов и правовой значимости, без использования фиксированных априорных весов. Для узлов правовых положений при получении признаков соседних медицинских действий оценка внимания рассчитывается на основе количественного значения интенсивности штрафа, связанного с последними; когда узел модуля алгоритма объединяет информацию о медицинских действиях, он фокусируется на соседях с более высокими уровнями операционного риска. Вес внимания рассчитывается следующим образом:
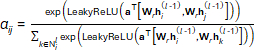 (5)
αij — это коэффициент внимания узла j к узлу i, а a — обучаемый вектор внимания. Данная модель позволяет автоматически идентифицировать связанные пути с высоким риском или сильными ограничениями в процессе сквозного обучения, присваивая им более высокий вес внимания. Итоговое обновленное вложение узла определяется взвешенными сообщениями и остаточными связями.
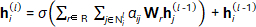 (6)
σ представляет собой функцию активации, а остаточная архитектура (residual design) нивелирует проблему затухания градиента при глубоком распространении и обеспечивает стабильность в условиях множественных семантических конфликтов. После L = 3 графовых сверточных слоев (каждый из которых имеет скрытую размерность 256 и функцию активации ReLU) эмбеддинги всех узлов бесшовно объединяют кросс-модальную контекстную информацию и становятся унифицированными представлениями с возможностью правовой семантической дискриминации.
На рисунке 2 представлены две альтернативные диаграммы анализа соответствия правовым нормам для ИИ в сфере здравоохранения, целью которых является визуализация типов правовых отношений и путей распространения предвзятости, указывающих на потенциальные источники систематических ошибок при принятии решений. На рисунке 2A показано влияние различных правовых семантических связей, где четыре типа связей обозначены разными цветами, и для каждого типа ребра выделены соответствующим цветом. Толщина ребра соответствует весу внимания данной конкретной связи, т.е. тому, какой вклад эта связь вносит в решение ИИ. Толстое ребро фактически указывает на доминирующее правовое отношение в решении, которое в данном случае в достаточной степени обосновало исход дела. Размер узла определяется его вкладом в нарушения: более крупные узлы означают более сильную связь между действиями и конкретными правовыми положениями, и, следовательно, более высокий потенциальный риск. Приведенная визуализация обеспечивает четкий правовой семантический слой, который позволяет нам определить наиболее сильные и рискованные правовые пути в процессе принятия решений ИИ. На рисунке 2B также указаны пути с высоким вкладом (в распространение предвзятости) с акцентом на ребрах с высоким вкладом, которые выделены жирным шрифтом и сопровождаются пунктирными линиями (например, B1-B3) в процессе принятия решений. Удвоение ширины этих ребер представляет их значимость в распространении системной предвзятости. То, какие комбинации правовых норм и технических аспектов поведения приводят к такому эффекту усиления предвзятости, показано на рисунке 2. Данный анализ не только раскрывает путь распространения предвзятости, но и облегчает определение ее источника, на основании чего может быть осуществлен аудит соответствия и установлена ответственность за работу инструмента ИИ.
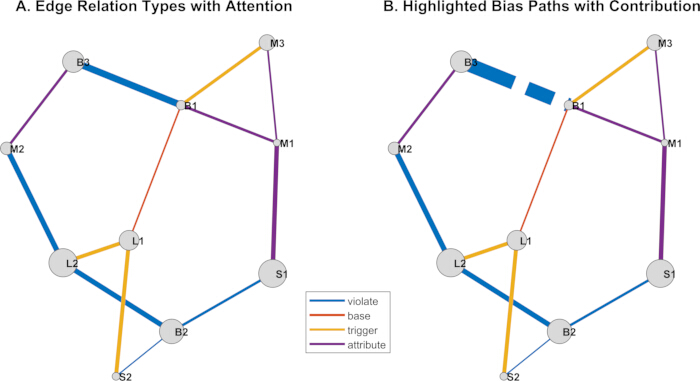
Рисунок 2Анализ соблюдения правовых норм и распространения предвзятости в ИИ для здравоохранения (иллюстративный пример). (A) Юридические семантические связи, обозначенные цветом: нарушение (красный), основание (синий), триггер (зеленый), атрибуция (оранжевый). Толщина ребер пропорциональна весу внимания, что указывает на степень влияния каждой связи на решение ИИ. Размер узла пропорционален его вкладу в нарушение, что позволяет выделить рискованные объекты. (B) Подграф распространения предвзятости: ребра с высоким вкладом выделены жирным шрифтом и пунктиром (например, B1–B3); ребра двойной ширины указывают на усиление системной предвзятости. Данная визуализация способствует выявлению доминирующих правовых путей, источников предвзятости и проведению аудита соответствия. Поскольку данный рисунок является схематической иллюстрацией, шкалы измерений и планки погрешностей не применяются. Пожалуйста, нажмите здесь, чтобы просмотреть эту фигуру в увеличенном размере.
Механизм обратного поиска по подграфу для пути распространения смещения
В данном исследовании под «предвзятостью» (bias) понимается систематическое отклонение выходных данных системы ИИ от клинически и юридически ожидаемого решения, измеряемое разницей между прогнозируемым моделью показателем риска и фактической меткой соответствия (ground-truth compliance label). Сигнал предвзятости количественно определяется как перекрестная энтропия (cross-entropy loss) между конечным выходом алгоритма и бинарным индикатором соответствия (1 — соответствует, 0 — не соответствует), агрегированным по всем случаям принятия решений в пакете.
После обучения графовой нейронной сети ее дифференцируемость используется для проведения анализа обратного распространения сигнала смещения в выходном слое. Начиная с узла принятия решения алгоритмом, который обнаруживает аномалии, вычисляется величина градиента функции потерь по отношению к каждому соединяющему ребру, чтобы количественно оценить вклад каждого ребра в формирование смещения. Этот процесс реализован с помощью фреймворка автоматического дифференцирования, который послойно отслеживает обратные связи вдоль направленных ребер в структуре графа для получения силы влияния трансформации параметров каждого ребра на итоговое изменение выходных данных. Чем выше абсолютное значение градиента, тем более доминирующей является передаваемая этим ребром правотехническая связь в процессе распространения смещения. Вклад ребра определяется следующим образом:
 (7)
Lbias — это дифференцируемая функция потерь, определенная для смещенного поведения, а wi — вектор весов ребер, соответствующий типу ребра. Это значение градиента отражает степень участия конкретной семантической связи в текущем смещении ассоциаций. После того как все ребра будут оценены таким образом, устанавливается динамический порог τ для фильтрации набора ребер с высоким вкладом Ehigh, вклад которых превышает gij > τ, что формирует начальный подграф распространения смещения Gbias = (Vbias, Ehigh). В частности, τ определяется как 85-й процентиль абсолютных значений градиентов по всем ребрам в каждой эпохе обучения, что гарантирует сохранение только 15% наиболее влиятельных ребер для построения подграфа. Данный подграф фокусируется на ключевых путях связей, которые с наибольшей вероятностью вызывают систематическое смещение, тем самым сокращая пространство поиска и повышая эффективность отслеживания источника.
В построенном подграфе распространения смещения выполняется алгоритм обнаружения сообществ с использованием спектральной кластеризации для выявления высоколинейных структур кластеров узлов. Этот процесс основан на факторизации нормированной матрицы Лапласа подграфа, что позволяет отобразить эмбеддинги узлов в низкоразмерное спектральное пространство и применить в нем стратегию кластеризации с учетом плотности; это гарантирует, что узлы разных типов (например, юридические пункты и модули алгоритма) будут сгруппированы в один кластер при наличии тесной функциональной связи. Каждое выявленное сообщество представляет собой потенциальный функциональный цикл или единицу агрегации ответственности. Результаты разделения на сообщества определяются следующими целями оптимизации:
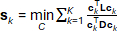 (8)
L=D−A — матрица Лапласа подграфа, A — матрица смежности, D — матрица степеней, ck — индикаторный вектор k-го сообщества, а K — заданное число сообществ. Этот критерий максимизирует минимальную разность разрезов между сообществами, обеспечивая плотные внутренние связи.
Теперь для каждого сообщества проводится анализ на основе композитов разных уровней. Если сообщество содержит узлы правовых положений и узлы модулей алгоритмов, оно помечается как потенциальный источник предвзятости. Для проверки причинно-следственной связи проводится интервенционный тест: все ребра в этой области временно удаляются из графа, процесс принятия решения выполняется повторно, и фиксируются различия в показателях предвзятости. Мера причинно-следственной достоверности определяется следующим образом:
 (9)
Borig и Bmask представляют собой силу смещения исходной модели и силу смещения после маскирования соответственно. Если показатель причинно-следственной значимости существенно превышает заранее определенный порог, это означает, что кластер узлов был идентифицирован как объяснимый источник смещения, что послужит руководством для последующей коррекции соответствия и назначения ошибок.
Динамическая проверка соответствия правовым ограничениям
Случаи принятия решений в режиме реального времени, возникающие в процессе работы медицинской системы ИИ, представляются в виде временных узлов и встраиваются в пространство обученного графа знаний. Каждый узел формирует исходный вектор признаков, считывая входной контекст, выходное поведение и состояние алгоритма. Затем этот вектор подается в графовую нейронную сеть с замороженными параметрами для выполнения однослойного прямого распространения, в результате чего получается эмбеддинг, согласованный с графом знаний, без изменения исходной структуры графа. Таким образом, это позволяет сравнивать временные узлы и узлы с правовыми положениями в едином семантическом пространстве.
Затем вычислите косинусное сходство между переходным узлом и каждым из узлов с юридическими положениями:
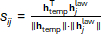 (10)
htemp — это эмбеддинг временного узла, а hjlaw — эмбеддинг узла j-й статьи закона. Значение сходства фактически отражает степень семантического соответствия между текущим решением и каждым правовым ограничением. Динамический порог соответствия θ устанавливается на основе распределения сходства исторических образцов соответствия для адаптации границы принятия решения в различных сценариях применения. В частности, θ = µ - 2σ, где µ и σ — среднее значение и стандартное отклонение распределения косинусного сходства, рассчитанного на валидационном наборе из 50 известных экземпляров соответствующих решений.
Если показатель косинусного сходства опускается ниже динамического порога соответствия, соответствующая правовая норма считается нарушенной, что запускает механизм оповещения о несоблюдении. Уведомление также содержит номер минимально подходящего пункта закона, значение сходства и направление анализа расхождений, что должно быть достаточно для оперативного реагирования регулирующих органов. Такой подход обеспечивает интерпретируемое сопоставление непрозрачного процесса принятия решений с пространством правовой семантики и облегчает проверку соответствия в режиме реального времени.
В процессе непрерывной работы отслеживается тенденция изменения веса ключевых ребер связи между правовыми и технологическими аспектами в подграфе распространения смещения. Особое внимание уделяется ребрам, соединяющим узлы модулей алгоритмов и узлы правовых норм, поскольку они напрямую отражают силу реакции технического поведения на конкретные нормативные требования. Параметры матрицы преобразования для каждого целевого ребра фиксируются во время вывода, а их норма извлекается в качестве динамического показателя эволюции силы корреляции между ними. Определим последовательность силы ребер следующим образом:
 (11)
wt представляет собой норму Фробениуса матрицы весов, соответствующей связи между ребром eij в момент времени t, а Wkl(t) — матрицу параметров, фактически используемую в модели в этот момент. Данный показатель отражает глубину обучения модели или ее зависимость от юридического ограничения.
Для последовательности проводится тест монотонности со скользящим окном, а для определения наличия значимой тенденции к росту используется улучшенный критерий знаков. Если приращения за N последовательных временных шагов удовлетворяют условию преобладания положительных значений, считается, что ребро демонстрирует феномен аномального усиления. При дальнейшем объединении с данными об историческом вкладе градиента, если ребро было идентифицировано как путь с высоким влиянием в предыдущем раунде анализа поиска источника, инициируется процесс раннего предупреждения о системном накоплении смещения.
Наконец, формируется отчет по отслеживанию источника, который включает информацию об узлах на обоих концах целевого ребра, кривые изменения веса, статистику частоты соответствующих решений и возможные рекомендации по атрибуции. Этот механизм обеспечивает переход от статической оценки соответствия к динамическому прогнозированию рисков, поддерживая упреждающее вмешательство при потенциальных отклонениях в организации.
Экспериментальные данные и дизайн
Для проверки эффективности предлагаемой структуры в данной работе создается многоисточниковый гетерогенный набор данных, объединяющий реальные нормативные акты и имитационные данные, а также разрабатываются строгие контрольные эксперименты. Источники данных включают государственные нормативные акты по регулированию медицинского ИИ, клинические рекомендации по лечению, отчеты об аудите алгоритмов из открытых источников и журналы имитационных решений. После предварительной обработки строится эталонный гетерогенный граф знаний, содержащий 285 узлов (85 правовых положений, 120 медицинских действий, 42 модуля алгоритмов и 38 ответственных субъектов) и 1247 направленных ребер, как показано на Рисунке 3.
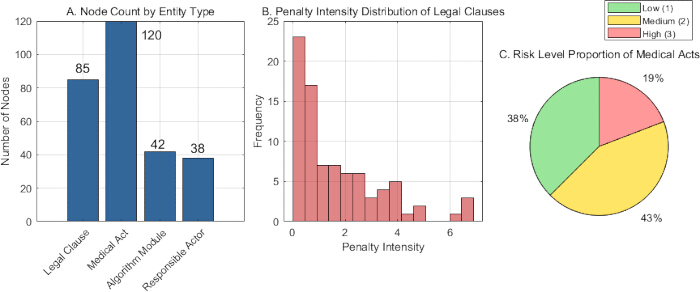
Рисунок 3Распределение и характеристики гетерогенных типов сущностей. (A) Столбчатая диаграмма, показывающая количество узлов для каждого типа сущностей: правовые положения (85), медицинские действия (120), модули алгоритма (42), ответственные стороны (38). (B) Гистограмма интенсивности штрафных санкций для узлов положений договора, разделенная на категории: низкая (0–0,3), средняя (0,34–0,6) и высокая (0,67–1,0); вертикальная ось представляет количество. (C) Круговая диаграмма распределения уровней риска по узлам медицинского поведения: низкий (19%), средний (43%), высокий (38%). Все значения представлены в виде абсолютных величин или процентов; планки погрешностей не указаны, так как данные представляют собой описательную статистику набора данных. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Рисунок 3 иллюстрирует распределение и характеристики узлов сущностей в гетерогенном графе знаний. На Рисунке 3A показано распределение количества четырех типов узлов сущностей, при этом узлы «медицинского поведения» являются наиболее многочисленными (120), за ними следуют «правовые положения» (85), в то время как «алгоритмических модулей» (42) и «ответственных лиц» (38) относительно меньше. Это обусловлено тем, что структура графа разработана на основе действий и правил. На Рисунке 3B представлено распределение интенсивности штрафных санкций для узлов, представляющих отдельное правовое положение, где интенсивность определяет степень строгости юридической ответственности. Данные указывают на то, что положений с высокой интенсивностью штрафов относительно немного, а большинство из них относится к категории средней и низкой интенсивности, что соответствует действительности, согласно которой в реальных правовых системах существует лишь несколько положений о серьезных нарушениях. Рисунок 3C иллюстрирует распределение уровней риска в узлах медицинского поведения, где наибольшую долю составляют действия среднего риска (43%), а наименьшую — действия низкого риска (19%), что показывает, что медицинские сценарии обычно носят стандартный характер, а операции с высоким риском подвергаются более строгим ограничениям связей в графе. Эти статистические данные в совокупности обосновывают схему кодирования разрешения неоднозначности сущностей, принятую при построении графа знаний, для обеспечения поддержки признаков при последующем выравнивании с помощью графовых сверточных сетей.
Весь набор данных был случайным образом разделен на обучающую (70%), валидационную (10%) и тестовую (20%) выборки с использованием стратификации по типу узлов и распределению связей для сохранения общей структуры графа в каждом разделении. Для обеспечения объективности сравнения одни и те же выборки последовательно использовались для всех базовых методов. Помимо этого основного разделения, три градиента плотности графа знаний (низкая, средняя, высокая) и три настройки сложности межюрисдикционного взаимодействия (односторонняя, двусторонняя, многосторонняя), описанные выше, служат независимыми практическими испытательными стендами, которые в совокупности позволяют оценить устойчивость метода в условиях различной полноты данных и степени перекрытия нормативных требований. Для создания эталонных меток для оценки локализации смещения была принята двухэтапная стратегия: (1) экспертная аннотация — три эксперта в области права и медицины независимо изучили журналы принятия решений и определили узлы первопричин и пути распространения для каждого зафиксированного нарушения комплаенса, при этом разногласия разрешались путем голосования большинством; (2) симулированное внесение — для контролируемого тестирования в 20 случайно выбранных путях принятия решений были искусственно введены сигналы смещения путем изменения весов ребер в графе знаний, что позволило заранее знать истинные узлы-источники и затронутые ребра.
Для всех базовых методов (TransE, ComplEx, GNN Explainer, KG-BERT и Node2Vec) мы использовали одинаковую конфигурацию обучения (оптимизатор Adam, скорость обучения 1 × 10⁻³, размер пакета 64, 10 эпох) и те же разделения данных, что и для нашего метода, чтобы обеспечить объективность сравнения. Для TransE и ComplEx размерность эмбеддинга была установлена на уровне 256 с зазором (margin) 1,0; для KG-BERT мы использовали предобученную модель BERT-base с размером пакета 16 и максимальной длиной последовательности 128; для GNNExplainer мы использовали 3-слойную GCN с той же размерностью скрытого слоя 256; а для Node2Vec мы установили длину случайного блуждания 80, количество блужданий на узел 10 и размерность эмбеддинга 256.
Для обеспечения объективного сравнения мы адаптировали все базовые методы под одни и те же задачи локализации смещения, а именно: идентификацию корневого узла и реконструкцию пути распространения. Для моделей TransE, ComplEx и Node2Vec, которые не являются интерпретируемыми по своей природе, мы вычисляли градиент функции потерь смещения по отношению к эмбеддингу каждого узла и использовали величину градиента в качестве показателя значимости узла; корневые узлы выбирались путем применения порога к этим показателям, а пути распространения реконструировались путем сохранения ребер с наибольшим вкладом в градиент. Для GNNExplainer мы напрямую использовали встроенные механизмы значимости ребер и маскирования узлов для получения как корневых узлов, так и подграфов. Для KG‑BERT, который работает с триплетами, каждое ребро графа было преобразовано в текстовый триплет, а веса внимания модели по сущностям использовались для определения значимости узлов с последующим применением той же стратегии пороговой фильтрации для реконструкции путей. Благодаря этим адаптациям каждый базовый метод выдает прогнозы как для корневых узлов, так и для путей распространения, что обеспечивает единообразную оценку всех методов.
Оценка сосредоточена на четырех основных возможностях: точности семантического выравнивания, способности локализовать предвзятость, эффективности подотчетности и обобщении между доменами. Также представлены три важные контрольные переменные, имитирующие сложность реального мира.
1) Градиент плотности графа знаний: для оценки эффективности метода при различных уровнях полноты информации на основе стратегии случайного удаления ребер создаются два подмножества из исходного полного графа (плотность D = 1.0) следующим образом:
Разреженный граф (D ~ 0.3): 30% ребер сохраняются случайным образом, что имитирует стадию раннего построения знаний при значительном отсутствии информации.
Граф средней плотности (D ~ 0.6): 60% ребер сохраняются случайным образом, что имитирует типичный сценарий частично известной структуры знаний.
Плотный граф (D = 1.0): использование всех 1247 ребер, что соответствует наилучшему сценарию при относительно полных знаниях.
2) Ситуация с частотой принятия решений медицинским ИИ: для тестирования производительности динамического мониторинга комплаенса в режиме реального времени установлены три нагрузки искусственного потока принятия решений:
Низкая частота 10 Hz: в среднем генерируется 10 событий принятия решения в секунду, что имитирует мониторинг маломасштабных систем или систем с одним узлом.
Средняя частота 50 Hz: 50 событий принятия решения в секунду, имитирующих нагрузку ИИ-системы региональных или среднемасштабных медицинских учреждений.
Высокая частота 10 Hz: 10 событий принятия решений в секунду имитируют сценарии высокой нагрузки при параллельной обработке запросов для сервисов ИИ, развертываемых в крупном госпитале или облачной платформе.
3) Градиент межюрисдикционной сложности: Для проверки переносимости моделирования правовых ограничений были созданы три тестовых набора, основанных на уровне сложности:
Одна юрисдикция: включает исключительно действующие законы и нормативные акты Китая, регулирующие использование ИИ в медицине.
Двусторонняя юрисдикция: объединяет нормативно-правовые режимы Китая и Европейского союза, при этом около 15% правил являются противоречивыми или дублирующими друг друга.
Многосторонняя юрисдикция: Основываясь на двух предыдущих вариантах, данный подход дополнительно интегрирует правила конфиденциальности и безопасности из закона США HIPAA (Health Insurance Portability and Accountability Act), создавая тестовую среду, в которой правовые системы трех режимов переплетаются, что повышает частоту конфликтов правовых норм примерно до 25%.
Для количественной оценки использовались следующие ключевые показатели:
1) Точность семантического выравнивания: определяет способность графа моделировать взаимосвязи между юридическими и техническими объектами.
Точность выравнивания сущностей:
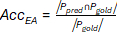 (12)
Ppred — это набор выровненных пар сущностей, предсказанных моделью, а Pgold — набор эталонных выравниваний, аннотированных экспертами.
Целостность сохранения связей:
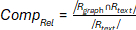 (13)
Rgraph — это реконструированный набор отношений в графе, а Rtext — набор явных отношений, извлеченных из исходного юридического текста.
2) Способность к локализации смещения: оценка эффективности отслеживания первопричин и путей распространения смещения.
Коэффициент полноты восстановления корневого узла:
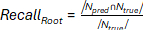 (14)
Npred — это множество узлов-источников смещения, идентифицированных моделью, а Ntrue — множество истинных узлов-источников, размеченных экспертами.
Точность пути распространения:
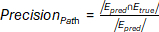 (15)
Epred — это множество ребер в подграфе распространения смещения, выведенном моделью, а Etrue — истинное множество ребер распространения смещения.
3) Эффективность отслеживания подотчетности: Проверьте производительность системы в сценариях мониторинга в режиме реального времени.
Средняя задержка трассировки:
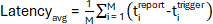 (16)
M представляет собой общее количество запросов, а titrigger и tireport — временные метки i-го триггера предвзятости и генерации исходного отчета соответственно.
Пропускная способность системы:
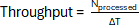 (17)
Nprocessed представляет собой количество одновременных запросов на трассировку, успешно обработанных в течение временного интервала ΔT.
4) Способность к кросс-доменной генерализации: проверка адаптивности метода к различным правовым системам.
Юрисдикционный охват:
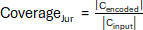 (18)
Cencoded представляет собой количество различных юрисдикционных положений, успешно закодированных в граф, а Cinput представляет собой общее количество входных положений.
Частота обнаружения конфликтов ограничений:
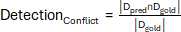 (19)
Dpred — это набор логических противоречий в законодательстве, обнаруженных моделью, а Dgold — набор всех пар противоречий, аннотированных экспертами.
Все эксперименты проводились на рабочей станции, оснащенной многоядерным процессором и графическим процессором; полные технические характеристики оборудования приведены в таблице материалов.
Основные гиперпараметры данного подхода и их значения приведены в Таблице 1; они охватывают структуру модели и конфигурацию обучения, а также критические пороговые значения, такие как размерность эмбеддинга, количество сверточных слоев, скорость обучения и размер пакета. Все параметры были оптимизированы с использованием валидационного набора данных методом перебора по сетке; обученная модель продемонстрировала стабильную сходимость и наилучшую производительность. Некоторые пороговые значения были установлены с учетом отраслевых критериев для обеспечения высокой надежности проверки соответствия медицинского ИИ.
| Параметр | Значение | Описание |
| Размерность эмбеддинга | 128 | Размерность пространства признаков для эмбеддингов узлов |
| Количество сверточных слоев | 3 | Глубина графовой сверточной сети с учетом отношений |
| Скорость обучения | 0.001 | Начальная скорость обучения для оптимизатора Adam |
| Размер партии | 32 | Количество подграфов, обрабатываемых за одну итерацию (батч) |
| Доля выбывших | 0.1 | Вероятность дропаута, применяемая к признакам узлов в процессе обучения |
| Количество голов внимания | 8 | Количество голов в механизме многоголового внимания (multi-head attention) |
| Коэффициент L2-регуляризации | 5 × 10⁻⁴ | Коэффициент затухания весов для регуляризации параметров |
| Порог сходства | 0.75 | Минимальное сходство вложений для проверки соответствия |
| Порог вклада градиента | 0.01 | Порог выбора значимых ребер при построении подграфа смещения |
| Размер окна мониторинга | 10 | Временные шаги, используемые для отслеживания динамики веса ребер |
Таблица 1: Основные параметры настроек. Список ключевых гиперпараметров, использованных в экспериментах: размерность эмбеддинга (256), количество слоев GCN (3), размерность скрытого слоя (256), скорость обучения (1 × 10⁻³), размер пакета (64), размерность вектора внимания, порог вклада ребра (85-й процентиль величин градиента), порог динамического соответствия (µ‑2σ, где µ и σ рассчитаны по валидационному набору из 500 соответствующих экземпляров), количество сообществ K (определено методом спектральной кластеризации) и оптимизатор (Adam). Эти значения были выбраны с помощью поиска по сетке на валидационном наборе.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Проверка эффективности отслеживания происхождения предвзятости в графе знаний по медицинскому праву для ИИ
Эффективность графовой свертки с учетом взаимосвязей
Путем обучения графовой сверточной сети, учитывающей отношения, были рассчитаны сходства эмбеддингов между узлами правовых положений и медицинского поведения на различных сверточных слоях, а также зафиксирован эффект выравнивания каждого слоя. Во-вторых, был проведен статисти...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Интеграция медицинского ИИ в процесс принятия клинических решений создает правовые сложности при определении ответственности, что осложняется семантическим разрывом между неструктурированными юридическими текстами и алгоритмами «черного ящика». Для преодоления этого разрыва мы предложили граф знаний на основе GNN, в котором правовые положения, медицинские действия, модули алгоритмов и ответственные стороны представлены в виде гетерогенных узлов, соединенных четырьмя направленными право-семантическими связями (нарушение, ...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Данная рукопись ранее не публиковалась и не находится на рассмотрении в других журналах. Все авторы утвердили содержание статьи. Авторы заявляют об отсутствии финансового конфликта интересов.
Благодарности
Нет данных
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| ComplEx | Open-source implementation (например, OpenKE) | Версия 1.0 | Базовый метод эмбеддинга комплексов для сравнения графов знаний |
| GNNExplainer | Open-source implementation (https://github.com/RexYing/gnn-explainer) | Коммит 7a3b6a2 (2021) | Базовый метод интерпретируемости GNN для отслеживания смещений |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Центральный процессор для обучения моделей и предварительной обработки данных |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Базовый метод эмбеддинга KG на основе трансформеров для семантического выравнивания |
| Node2Vec | Open-source implementation (https://github.com/aditya-grover/node2vec) | Версия 1.0 | Базовый метод эмбеддинга узлов на основе случайных блужданий |
| NVIDIA Tesla V10 (GPU) | NVIDIA Corporation | 90-2G50-0010-0 | Высокопроизводительный GPU для ускорения обучения графовых нейронных сетей |
| Наш метод (Relation-aware GCN) | Собственная реализация на PyTorch | PyTorch 1.12.0 | Предложенный фреймворк с трансформациями для каждого отношения, механизмом внимания и обратным отслеживанием градиентов |
| TransE | Open-source implementation (например, OpenKE) | Версия 1.0 | Базовый метод трансляционного эмбеддинга для сравнения графов знаний |
Ссылки
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.