В данном протоколе представлена сеть с тремя распутанными потоками (Tri-stream Disentangled Network, TDE-Net) — платформа для реконструкции изображений на основе ЭЭГ, которая сочетает в себе дополняющие друг друга представления ЭЭГ, выравнивание визуальных признаков в двойном пространстве и диффузионное декодирование.
Методическая статья
Трехпотоковая распутанная сеть с адаптивным слиянием в двойном пространстве для реконструкции изображений на основе электроэнцефалографии на наборе данных THINGS-EEG2
В этой статье
Краткое содержание
Аннотация
Реконструкция визуальных стимулов на основе неинвазивной электроэнцефалографии (ЭЭГ) требует сопоставления коротких, зашумленных нейронных ответов со значимыми визуальными представлениями, несмотря на ограниченное пространственное сэмплирование. Существующие подходы к преобразованию ЭЭГ в изображения используют различные нейронные представления и генеративные стратегии, что требует воспроизводимых рабочих процессов, позволяющих разделить структурный и семантический вклады. В данном протоколе представлен Tri-stream Disentangled Network (TDE-Net) — вычислительная платформа для реконструкции изображений на основе ЭЭГ. В протоколе используются предварительно обработанные записи THINGS-EEG2, а информация ЭЭГ организуется в виде опорного сигнала сырых ЭЭГ, потока функционального графа, специфичного для конкретного образца, и многомасштабного временного семантического потока. Поток графа фиксирует взаимосвязи между каналами ЭЭГ в частотной области с помощью графовой свертки и межпробного контрастивного обучения, в то время как семантический поток извлекает релевантные задаче признаки посредством адаптивного пространственного взвешивания и многомасштабных временных сверток. Структурные и семантические признаки по отдельности отображаются в латентные пространства вариационного автокодировщика (VAE) и Contrastive Language-Image Pre-training (CLIP), объединяются с использованием весов слияния, выбранных на основе обучающей выборки, и декодируются с помощью Stable UnCLIP. Для 10 участников TDE-Net обеспечил среднюю точность попарной идентификации CLIP 0,8135, при этом дополнительные метрики продемонстрировали соответствие структурного пространства и пространства признаков. Анализ с использованием абляции и анализ на уровне представлений позволили дополнительно охарактеризовать вклад отдельных потоков. Данный протокол предоставляет воспроизводимую основу для исследования комплементарных представлений ЭЭГ и визуальной реконструкции на основе диффузионных моделей.
Введение
Декодирование зрительного восприятия представляет собой междисциплинарную область исследований в сфере интерфейсов «мозг-компьютер» (ИМК) и когнитивной нейробиологии. Функциональная магнитно-резонансная томография (фМРТ) позволила осуществлять реалистичную реконструкцию изображений1,2,3,4, однако ее стоимость, ограниченная мобильность и гемодинамическая задержка ограничивают некоторые области применения. Электроэнцефалография (ЭЭГ) обеспечивает временные измерения с миллисекундным разрешением при использовании сравнительно доступного оборудования, но низкое соотношение сигнал/шум и ограниченное пространственное сэмплирование затрудняют реконструкцию изображений на основе данных ЭЭГ.
Сложность метода следует интерпретировать с учетом общего компромисса между смещением и дисперсией5. Ранние методы визуального декодирования использовали неглубокие или линейные представления, тогда как в последующих исследованиях были представлены компактные сверточные, графовые и основанные на механизме внимания энкодеры6,7,8,9,10,11. Кросс-модальное выравнивание также эволюционировало от мультимодального обучения признаков12,13 к латентным диффузионным моделям и большим визуальным энкодерам14,15,16. Эти подходы позволяют создать полезные базовые линии, однако их входные представления, латентные цели и декодеры различаются, поэтому результаты следует интерпретировать в рамках соответствующих экспериментальных условий.
Целью TDE-Net является предоставление модульной структуры реконструкции изображений по ЭЭГ, которая разделяет структурные и семантические представления ЭЭГ, выравнивает их с дополнительными визуальными латентными пространствами и интегрирует эти прогнозы для реконструкции изображений на основе диффузии. В недавних исследованиях по декодированию визуальных образов из ЭЭГ была представлена генерация под управлением ЭЭГ на базе трансформеров в EEG-CLIP17, выравнивание с учетом переднего плана с использованием динамических сетей мозга в FSDBN18, адаптивное размытие под когнитивным управлением с выравниванием с ограничением информации19, а также многоуровневое двунаправленное биомиметическое обучение20. Смежные конвейеры преобразования ЭЭГ в изображения, включая Perceptogram и управляемую диффузию на основе эмбеддингов ЭЭГ, служат дополнительными источниками для прогнозирования латентных переменных21,22. TDE-Net отличается организацией модели: она эксплицитно разделяет исходный якорь ЭЭГ, специфичное для образца функциональное графовое представление и временное семантическое представление, после чего выполняет асимметричное выравнивание с пространствами VAE и CLIP перед слиянием. Такая организация позволяет раздельно исследовать структурный и семантический вклады с помощью анализа латентного пространства и анализа на уровне изображений. По сравнению с подходами к преобразованию ЭЭГ в изображения с использованием одного представления или прямого выравнивания, этот модульный дизайн обеспечивает раздельные структурные и семантические пути, сохраняет линейную ссылку на ЭЭГ во время прогнозирования латентных переменных и позволяет независимо оценивать вклад каждого представления с помощью абляции и анализа латентного пространства.
TDE-Net предназначен для экспериментов с парными ответами ЭЭГ и зрительными стимулами, достаточными условиями обучения и коротким окном после предъявления стимула, в котором основной целью является семантическая реконструкция. Его поэтапная организация позволяет отдельно исследовать извлечение признаков, латентное выравнивание, слияние и диффузионное декодирование. Линейные отображения остаются подходящими для очень маленьких наборов данных или условий, в которых приоритетом является минимальная сложность модели, в то время как сквозные нейронные декодеры могут быть предпочтительнее при наличии больших специализированных наборов данных и возможности развертывания в режиме реального времени.
В данном протоколе оценивается предлагаемая конфигурация в условиях быстрого последовательного визуального предъявления (RSVP) набора данных THINGS-EEG2. Основные достижения включают схему трехпоточного представления ЭЭГ, состоящую из необработанного линейного якоря, функционального графового потока для конкретного образца и многомасштабного временного семантического потока. Эти взаимодополняющие представления отображаются в латентные пространства VAE и CLIP, а соответствующие прогнозы объединяются перед диффузионным декодированием. Работа фреймворка оценивается для всех 10 испытуемых THINGS-EEG2 с использованием показателей реконструкции на уровне испытуемых, абляционного анализа и анализа временных окон, а также визуализаций на уровне представлений, где карты пространственного внимания интерпретируются как анализ каналов скальпа (топографический анализ).
Протокол
Протокол состоит из шести последовательных этапов: подготовка проб ЭЭГ и латентных представлений изображений; построение потока структурного графа; обучение семантического энкодера ЭЭГ; подгонка отображений CLIP/VAE; слияние латентных прогнозов с последующим декодированием изображений; и оценка результатов на уровне изображений и на уровне представлений (Рисунок 1).
1. Подготовка проб ЭЭГ и векторных представлений изображений
- Задокументируйте исходную когорту и протокол сбора данных.
ПРИМЕЧАНИЕ: Исходная когорта состояла из 10 здоровых взрослых добровольцев (средний возраст 28,5 лет, SD 4,0; восемь женщин и двое мужчин) с нормальным или скорректированным до нормы зрением. Участники предоставили письменное информированное согласие, получили денежную компенсацию и прошли оригинальный протокол, одобренный комитетом по этике факультета образования и психологии Свободного университета Берлина (Freie Universität Berlin) в соответствии с Хельсинкской декларацией23.- Используйте общедоступный набор данных THINGS-EEG2 в качестве ресурса для вторичного анализа.
- Используйте исходный раздел из 1 654 обучающих концептов и 200 непересекающихся тестовых концептов, выбранных из THINGS, при этом пропорции 27 категорий высокого уровня были сбалансированы между разделами. Выберите десять изображений с естественным фоном для каждого обучающего концепта и одно изображение для каждого тестового концепта, чтобы получить 16 540 условий обучения и 200 отложенных тестовых условий.
ПРИМЕЧАНИЕ: В данной работе в задаче детектирования цели использовались отдельные изображения-ловушки с Баззом Лайтером, которые были исключены из настоящего анализа реконструкции23. - При интерпретации эпох следуйте временным параметрам оригинального протокола быстрого последовательного визуального предъявления (RSVP).
ПРИМЕЧАНИЕ: Каждая последовательность начиналась с пустого интервала продолжительностью 750 ms, после чего следовало 20 центрально представленных изображений. Каждое изображение охватывало 7 градусов угла зрения, оставалось на экране в течение 100 ms с асинхронностью начала стимула 200 ms, что соответствует 5 изображениям/с. Второй пустой интервал 750 ms предшествовал периоду ответа продолжительностью до 2 s, в течение которого участники сначала моргали, а затем сообщали, появилось ли целевое изображение. Центральная мишень фиксации в виде «бычьего глаза» оставалась видимой на протяжении всей последовательности23. - Учитывайте структуру оригинальных сессий записи при организации набора данных. Используйте данные четырех сессий записи, пройденных каждым участником, где каждая сессия состояла из четырех тестовых заходов и 15 обучающих заходов продолжительностью примерно по 5 min каждый. Сохраните четыре повторения для каждого условия обучения и 80 повторений для каждого тестового условия, что соответствует 82 160 проанализированным попыткам с нецелевыми изображениями на одного участника23.
- Используйте данные ЭЭГ, полученные с оригинальной конфигурацией записи THINGS-EEG2. Записи проводились с частотой 1 000 Hz с использованием 64-электродной системы EASYCAP, расположенной согласно международной системе 10-10, и усилителя BrainVision actiCHamp, с электродом Fz в качестве онлайн-референса и онлайн-полосовым фильтром 0,1–100 Hz.
- Используйте выпущенные предобработанные данные, которые были разбиты на эпохи от -200 до 800 ms относительно начала предъявления изображения, подвергнуты коррекции базовой линии по предстимульному интервалу, подвергнуты даунсэмплингу до 100 Hz, ограничены 17 теменно-затылочными каналами, очищены от целевых попыток и подвергнуты многомерной нормализации шума независимо внутри каждой сессии записи23.
- Подготовьте тензоры попыток ЭЭГ
- Загрузите выпущенные предобработанные тензоры THINGS-EEG2 для всех 10 участников. Из каждой исходной эпохи выберите постстимульный интервал 0–800 ms и 17 теменно-затылочных каналов, сохраняя частоту дискретизации 100 Hz, чтобы получить 80 временных точек на попытку. Сохраните исходный раздел из 16 540 условий обучающих изображений и 200 отложенных тестовых условий изображений для каждого участника23 (Рисунок 2).
- Для предварительного обучения графового потока сохраните четыре независимых повторения обучения для каждого условия изображения и выберите два повторения для формирования позитивной пары. Для сырого и семантического потоков вычислите среднее значение четырех повторений обучения и среднее значение 80 доступных тестовых повторений для каждого условия.
- Используйте предобработанные тензоры THINGS-EEG2, созданные оригинальным конвейером MVNN; в каждом реализованном экстракторе признаков применяйте документированное Z-преобразование на уровне файлов перед вычислением признаков.
ПРИМЕЧАНИЕ: Такое асимметричное использование повторений является намеренным: повторные попытки предоставляют позитивные пары для контрастивного предварительного обучения графового потока, в то время как сырой и семантический потоки используют средние значения на уровне условий для контролируемого отображения. Полученная архитектура сочетает обучение инвариантности на уровне повторений в структурном потоке с латентным прогнозированием на уровне условий в сыром и семантическом потоках.
- Подготовьте парные латенты изображений
- Используйте 1024-мерный визуальный энкодер CLIP и VAE-энкодер, связанный с sd2-community/stable-diffusion-2-1-unclip, для извлечения парных целевых изображений. Измените размер входных изображений VAE до 768 x 768 пикселей, сохраните апостериорную моду VAE как вектор размерностью 36 864 (4 x 96 x 96) и сохраните порядок «изображение-условие».
- Сохраните три формы входных данных: тензоры повторных попыток для графового контрастивного обучения, усредненные тензоры ЭЭГ для сырого и семантического потоков, а также парные латенты изображений CLIP/VAE для контролируемого отображения.
- Нормализуйте и кэшируйте входные данные
- Кэшируйте предобработанные тензоры ЭЭГ, извлеченные графовые и семантические признаки, а также парные латенты изображений с фиксированным порядком условий.
- При осуществлении гребневого отображения (ridge mapping) оцените параметры стандартизации по признакам на основе обучающих входных данных и примените эти параметры к проверочным и тестовым входным данным.
2. Построение структурного потока графа
- Сформируйте графовый поток из повторных тренировочных проб и экспортируйте признаки на уровне узлов после контрастивного предварительного обучения. Используйте то же правило построения графа для извлечения признаков тестовой выборки, не используя латентные представления тестовых изображений при вычислении признаков.
- Преобразуйте пробы ЭЭГ в графовые входные данные в частотной области
- Преобразуйте каждую пробу с помощью быстрого преобразования Фурье (FFT) с использованием 80 точек и сохраните первые 40 корзин с неотрицательными частотами в диапазоне 0 Hz–48.75 Hz при частоте дискретизации 100 Hz. Используйте логарифмический амплитудный спектр в качестве матрицы признаков узлов X размером 17 x 40. Для каждого образца ЭЭГ вычислите C_ij = |corr(X_i, X_j)| между каждой парой из 17 векторов признаков каналов.
- В каждой строке сохраните диагональную автокорреляцию и три самые сильные внедиагональные корреляции (всего k = 4 сохраненных элемента, включая автокорреляцию), затем симметризируйте полученную матрицу для определения специфичного для образца взвешенного функционального смежного представления A. Примените симметричную нормализацию по степени перед графовой сверткой.
- Используйте этот метод построения как при обучении, так и при тестировании; физические координаты электродов не используются для определения фиксированного графа.
ПРИМЕЧАНИЕ: Сохранение самосвязей позволяет сохранить сигнал каждого узла, в то время как ограничение межканальных связей до 3 на строку контролирует плотность графа перед симметризацией. Представление в частотной области обеспечивает компактное описание на основе амплитуды для построения графа, но не сохраняет фазу или все детальные временные характеристики вызванных потенциалов (ERP) с фазовой привязкой; эти временные аспекты остаются доступными в исходных якорных и семантических временных потоках.
- Агрегируйте топологию электродов с помощью спектральной графовой свертки
- Примените пятислойную графовую сверточную сеть (GCN)24 с 80 скрытыми юнитами на слой, активациями ReLU, дропаутом 0.3, симметричной нормализацией по степени и усредняющим пулингом графа.
- Используйте 80-мерную двухслойную проекционную голову для контрастивного критерия и экспортируйте представление на уровне узлов размером 17 x 80 для структурного объединения. Применяйте спектральную графовую свертку к матрице смежности, зависящей от входных данных; не вводите отдельный оператор динамической свертки.
- Обучите графовый поток с помощью межпробного контрастивного обучения
- Внутри тренировочного раздела случайным образом выберите две повторности одного и того же условия изображения в качестве положительной пары, а представления других условий в батче рассматривайте как отрицательные. Оптимизируйте контрастивный критерий InfoNCE25 с температурой τ = 0.5, размером батча 32, оптимизатором Adam с коэффициентом обучения 5 x 10⁻⁴, в течение 20 эпох, с косинусным отжигом до eta_min = 10–6 и случайным сидом 42.
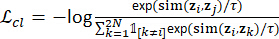 (1)
- Определите косинусное сходство в контрастивном критерии и используйте индикаторную функцию для идентификации парных повторностей. Сохраняйте размерность проекции на уровне 80 и применяйте одну и ту же температуру к обоим направлениям контрастивной функции потерь.
- Внутри тренировочного раздела случайным образом выберите две повторности одного и того же условия изображения в качестве положительной пары, а представления других условий в батче рассматривайте как отрицательные. Оптимизируйте контрастивный критерий InfoNCE25 с температурой τ = 0.5, размером батча 32, оптимизатором Adam с коэффициентом обучения 5 x 10⁻⁴, в течение 20 эпох, с косинусным отжигом до eta_min = 10–6 и случайным сидом 42.
- Экспортируйте графовые признаки на уровне узлов для раннего объединения
- Заморозьте графовый энкодер после предварительного обучения и экспортируйте признаки узлов для 17 каналов с размерностью 80 на узел. Объедините эти признаки с усредненными необработанными данными ЭЭГ вдоль измерения признаков, чтобы получить структурный вход «сырые данные + граф» для отображения VAE.
- Сохраните полученный тензор признаков «сырые данные + граф» и используйте его только в качестве структурного входа для регрессионной ветви VAE.
3. Обучение семантического кодировщика ЭЭГ
- Обучите семантический ЭЭГ-энкодер на усредненных 17-канальных 80-точечных тензорах ЭЭГ.
- Оптимизируйте функцию потерь косинусного вложения с помощью AdamW (скорость обучения 5 x 10⁻⁴; weight decay 0,01), размером пакета 64, в течение 50 эпох, используя косинусное затухание до eta_min = 10–6, случайный seed 42 и 1 024-мерный выход.
- Примените адаптивную пространственную фильтрацию на основе данных
- Примените обучаемую операцию взвешивания каналов на основе тензорного произведения к входному тензору ЭЭГ и расширьте представление до глубины 9. Рассматривайте эту операцию как слой взвешивания каналов на основе данных, а не как реализацию классического пространственного фильтра общего пространственного паттерна (Common Spatial Pattern, CSP)26.
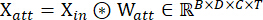 (2)
- Используйте обученную операцию взвешивания каналов для получения девяти карт признаков, затем передайте их в блок многомасштабной временной свертки.
- Примените обучаемую операцию взвешивания каналов на основе тензорного произведения к входному тензору ЭЭГ и расширьте представление до глубины 9. Рассматривайте эту операцию как слой взвешивания каналов на основе данных, а не как реализацию классического пространственного фильтра общего пространственного паттерна (Common Spatial Pattern, CSP)26.
- Смоделируйте временные рецептивные поля на нескольких масштабах
- Примените три параллельные временные свертки с размерами ядер 5, 15 и 31 отсчет с использованием дополнения (padding) той же длины. Объедините три выходных сигнала для получения 24 временных каналов признаков, затем примените пакетную нормализацию и активацию GELU.
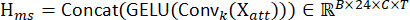 (3)
ПРИМЕЧАНИЕ: Свертки обеспечивают многомасштабные временные рецептивные поля в рамках более широкой архитектуры временного сверточного моделирования27. - Используйте три размера ядер в качестве многомасштабных временных фильтров; интерпретируйте их выход как обученные представления сигнала, а не как прямые соответствия конкретным компонентам вызванных потенциалов (ВП).
- Примените три параллельные временные свертки с размерами ядер 5, 15 и 31 отсчет с использованием дополнения (padding) той же длины. Объедините три выходных сигнала для получения 24 временных каналов признаков, затем примените пакетную нормализацию и активацию GELU.
- Выполните рекалибровку релевантных задаче каналов признаков
- Примените механизм внимания к глубине (depth attention) с адаптивным усредняющим пулингом по временному измерению, свертку с ядром 7 и последующую нормализацию Softmax в соответствии с принципами рекалибровки каналов28. Перемножьте полученные веса внимания поэлементно с тензором многомасштабных признаков.
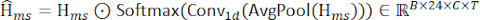 (4)
- Используйте выход механизма внимания в качестве входных данных для блока пространственной свертки; не интерпретируйте обученные веса как причинную нейронную локализацию.
- Примените механизм внимания к глубине (depth attention) с адаптивным усредняющим пулингом по временному измерению, свертку с ядром 7 и последующую нормализацию Softmax в соответствии с принципами рекалибровки каналов28. Перемножьте полученные веса внимания поэлементно с тензором многомасштабных признаков.
- Экспортируйте глобальный семантический признак ЭЭГ
- Примените свертку 1 x 1, затем глубинную свертку (depthwise convolution), охватывающую 17 электродных каналов, пакетную нормализацию, активацию GELU, усредняющий пулинг с коэффициентом 2 и дропаут p = 0,5. Выполните выравнивание (flatten) результата и спроецируйте его в 1 024-мерный семантический вектор признаков.
- Сохраните один 1 024-мерный семантический вектор признаков для каждого усредненного образца ЭЭГ.
4. Сопоставление признаков ЭЭГ с латентными пространствами CLIP и VAE
- Свяжите каждый тензор признаков ЭЭГ с латентным представлением изображения, имеющим тот же индекс условия. Выполните отдельное сопоставление (mapping) для целей CLIP и VAE, при этом все условия изображений в обучающей выборке должны быть непересекающимися с условиями в контрольной тестовой выборке.
- Примените гребневую регрессию29 с перехватом (intercept) и максимальным количеством итераций 50 000. Используйте λCLIP = 1 000 для сопоставлений raw-to-CLIP и semantic-to-CLIP, λVAE = 0 для якоря raw-to-VAE и λVAE, struct = 1 000 для сопоставления structural-stream-to-VAE. Стандартизируйте входные данные сопоставления, используя статистику обучающей выборки.
ПРИМЕЧАНИЕ: Структурный поток (structural stream) представляет собой конкатенацию необработанных данных ЭЭГ и графовых признаков; семантический поток (semantic stream) содержит выход семантического кодировщика без конкатенации с необработанными признаками. - Выполните сопоставление структурных признаков с латентным пространством VAE
- Выполните гребневое сопоставление structural-stream-to-VAE с λVAE,struct = 1 000 и предскажите 36 864-мерный латентный вектор VAE. Эта ветвь принимает конкатенированные необработанные данные ЭЭГ и графовые представления; это единственная нелинейная ветвь, которая явно конкатенирует необработанные признаки.
- Выполните сопоставление семантических признаков с латентным пространством CLIP
- Выполните гребневое сопоставление semantic-stream-to-CLIP с λCLIP = 1 000 и предскажите 1 024-мерное представление CLIP. Семантические входные данные не конкатенируются с необработанными данными ЭЭГ.
ПРИМЕЧАНИЕ: В данной статье λ обозначает регуляризацию гребня, а α обозначает вес слияния латентных пространств. - Оцените выравнивание латентных пространств с помощью пообразного коэффициента корреляции Пирсона (PCC). Используйте условия разработки для выбора весов слияния и оценивайте 200 контрольных тестовых условий только после того, как сопоставления и веса слияния будут зафиксированы.
- Выполните гребневое сопоставление semantic-stream-to-CLIP с λCLIP = 1 000 и предскажите 1 024-мерное представление CLIP. Семантические входные данные не конкатенируются с необработанными данными ЭЭГ.
5. Объединение латентных предсказаний и запуск диффузионной реконструкции
- Выберите αVAE и αCLIP, используя разделение на обучающую и проверочную выборки на уровне условий, полученное только из 16 540 обучающих условий. При случайном числе (seed) 42 используйте одни и те же индексы подмножества для подгонки (90%) и индексы разработки (10%) для всех 10 испытуемых; 200 отложенных тестовых условий остаются вне этой процедуры.
ПРИМЕЧАНИЕ: Штрафы за ридж-регрессию и коэффициент сохранения структуры были установлены в качестве значений конфигурации перед окончательной оценкой на отложенной выборке и не настраивались по 200 тестовым условиям. - Для каждого испытуемого и каждого кандидата α в {0.00, 0.05, ..., 1.00} подберите энкодер с контролем целевой переменной и ридж-отображения на подмножестве для подгонки, а затем рассчитайте средний по образцам коэффициент корреляции Пирсона (PCC) латентных переменных на проверочном подмножестве.
- Вычислите среднее значение PCC на уровне испытуемых с равным весом для 10 испытуемых и независимо выберите веса для пространства CLIP и VAE по максимальному среднему значению между испытуемыми. Зафиксируйте оба значения перед повторной подгонкой итоговых обучающих моделей и оценкой отложенных тестовых условий.
ПРИМЕЧАНИЕ: В результате этой процедуры были выбраны αCLIP = 0.55 и αVAE = 0.65. - Для пространства VAE определите комбинированный прогноз как взвешенную сумму якоря «raw-to-VAE» и прогноза VAE структурного потока:
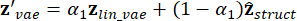 (5)
- Установите αVAE = 0.65, чтобы якорь «raw-to-VAE» вносил вклад 0.65, а прогноз структурного потока — 0.35. Держите это значение фиксированным для каждого испытуемого и тестового условия.
- Для пространства CLIP определите комбинированный прогноз как взвешенную сумму якоря «raw-to-CLIP» и прогноза CLIP семантического потока:
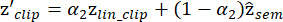 (6)
- Установите αCLIP = 0.55, чтобы якорь «raw-to-CLIP» вносил вклад 0.55, а прогноз семантического потока — 0.45. Держите это значение фиксированным для каждого испытуемого и тестового условия.
ПРИМЕЧАНИЕ: Интерпретируйте операцию комбинирования как фиксированный взвешенный ансамбль латентных прогнозов в общем смысле комбинации ансамблей30. Не описывайте это как гарантированное снижение переобучения или как универсально оптимальное решение по всем метрикам. - Загрузите зафиксированный конвейер Stable UnCLIP «изображение-в-изображение» из sd2-community/stable-diffusion-2-1-unclip с весами вариации fp16. Используйте комбинированное встраивание CLIP в качестве семантического условия и комбинированную латентную переменную VAE в качестве структурной инициализации.
ПРИМЕЧАНИЕ: Декодер работает по принципам диффузионного шумоподавления и классификаторного руководства (CFG)31,32. - Примените зашумленную структурную инициализацию к диффузионным латентным переменным. Измените форму каждого 36 864-мерного прогноза VAE на 4 x 96 x 96 согласно формулировке латентных переменных вариационного автокодировщика33 и добавьте гауссов шум после умножения структурной латентной переменной на структурный масштаб gamma = 0.02. Используйте временные шаги диффузионного обучения T_diff = 1 000 и фиксированное число (seed) диффузии 0 для описанной процедуры реконструкции.
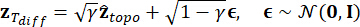 (7)
- Установите коэффициент сохранения структуры gamma на уровне 0.02 при зашумленной инициализации и держите это значение фиксированным для всех тестовых условий. Передайте полученную латентную переменную в декодер, не используя информацию об исходном изображении.
- Примените руководство перекрестного внимания (cross-attention guidance) и декодируйте латентную переменную изображения. Объедините комбинированный 1 024-мерный вектор CLIP с 1 024-мерным расширением условий, используемым конвейером, добавьте в начало нулевой вектор отрицательного условия для классификаторного руководства (CFG) и выполните декодирование с масштабом руководства 7.5. Используйте стандартное значение конвейера в 20 шагов шумоподавления и сохраните по одному изображению в формате PNG для каждого тестового условия.
- Сохраните реконструированное изображение с оригинальным индексом тестового условия и используйте этот же индекс для всех последующих расчетов метрик.
ПРИМЕЧАНИЕ: В Таблице 1 обобщены настройки разделения данных, предобработки, построения графа, обучения модели, латентного отображения, комбинирования и декодирования, использованные в описанном рабочем процессе. В прилагаемом рабочем листе представлена та же сводка параметров в машиночитаемом формате.
6. Оценка реконструкции и выравнивания на уровне представлений
- Вычислите точность воспроизведения на низком уровне с помощью пиксельной корреляции (PixCorr) и структурного сходства (SSIM). Вычислите точность попарной идентификации для второго слоя AlexNet (AlexNet Layer 2), пятого слоя AlexNet (AlexNet Layer 5), Inception-v3 и OpenAI CLIP ViT-L/14; вычислите корреляционные расстояния для EfficientNet (EffNet) и SwAV, где более низкие значения указывают на более близкие представления признаков.
- Для анализа CLIP сформируйте корреляционную матрицу между признаками, извлеченными из 200 реконструированных изображений, и соответствующими 200 эталонными изображениями. Для каждой реконструкции сравните корреляцию с правильным изображением с корреляциями с остальными 199 изображениями; усредните полученные 200 x 199 бинарных сравнений для расчета точности попарной идентификации CLIP.
- Для расширяющихся окон, заканчивающихся на 8, 16, ..., 80 временных точках, подберите ридж-отображения (ridge mappings) для необработанных данных ЭЭГ и рассчитайте средний по выборкам коэффициент корреляции Пирсона (PCC) между предсказанными и эталонными латентными представлениями CLIP и VAE для 200 тестовых условий субъекта sub-01. В качестве пунктирных опорных уровней используйте предсказания CLIP и VAE для полного окна только по семантическому потоку.
- Постройте матрицы репрезентативного сходства (RSM) на основе CLIP-признаков с L2-нормализацией, используя косинусное сходство. Упорядочьте обе матрицы с помощью иерархической кластеризации Уорда эталонных эмбеддингов CLIP с использованием евклидова расстояния.
- Для двумерной визуализации выделите пять k-средних кластеров из эталонных эмбеддингов и примените одну совместную проекцию PCA-50 с последующим t-распределенным стохастическим вложением соседей (t-SNE) к эталонным и предсказанным признакам; используйте t-SNE только для качественной визуализации.
- Визуализируйте отбеленные паттерны ЭЭГ и веса модели для каналов скальпа с обозначением каналов, явными цветовыми шкалами и воспроизводимыми правилами упорядочивания. Интерпретируйте эти графики как вспомогательный анализ измеренных сигналов скальпа и параметров модели, а не как доказательство локализации корковых источников, анатомической активации или причинно-следственной связи.
Результаты
Эффективность TDE-Net оценивалась с шести взаимодополняющих ракурсов: качество реконструкции, репрезентативные визуальные результаты, вклад компонентов, временная зависимость, структура семантического представления и внимание к каналам скальпа. Точность воспроизведения низкого уровня оценивали с помощью PixCorr и SSIM, согласование в пространстве признаков — с помощью метрик AlexNet, Inception-v3, CLIP, EffNet и SwAV, а эффективность на уровне испытуемого — на основе результатов всех 10 испытуемых из набора данных THINGS-EEG2. Если не указано иное, на каждом качественном рисунке указан соответствующий испытуемый и подмножество условий тестирования.
Эффективность реконструкции и репрезентативные результаты
В качестве внутренней эталонной модели мы дополнительно реализовали базовый легковесный сверточно-аттенционный энкодер ЭЭГ. Эта модель извлекает единое 1024-мерное представление ЭЭГ из каждой попытки и независимо отображает его в латентные пространства CLIP и VAE, используя тот же протокол гребневой регрессии и диффузионного декодирования, что и предлагаемый метод. В следующих разделах эта модель обозначается как Baseline. Энкодер представляет собой семантический референс на основе сверточной сети с механизмом внимания в стиле LMDA, использованный в локальной реализации, с 373 950 обучаемыми параметрами и 1 024-мерным выходом.
В таблице 2 приведено сравнение TDE-Net с внутренним базовым методом сверточного внимания (convolutional-attention baseline) и репрезентативными методами реконструкции изображений на основе ЭЭГ по зарегистрированным метрикам. Для обеспечения единообразия оценки методы были реализованы в рамках единой экспериментальной структуры с использованием одного и того же разбиения THINGS-EEG2, 17-канального ввода, одинаковой предобработки, условий контрольного тестирования и определений метрик, при этом были сохранены специфические для каждого метода архитектуры. Согласно сводным данным по десяти испытуемым, TDE-Net достиг значений среднего ± SD: 0.2531 ± 0.0138 для PixCorr, 0.3388 ± 0.0025 для SSIM, 0.8777 ± 0.0115 для AlexNet Layer 2, 0.9153 ± 0.0116 для AlexNet Layer 5, 0.7606 ± 0.0213 для Inception-v3, 0.8135 ± 0.0074 для точности попарной идентификации CLIP, 0.8285 ± 0.0122 для расстояния EffNet и 0.5085 ± 0.0101 для расстояния SwAV. Сводные данные на уровне отдельных испытуемых дополняют качественные примеры для одного субъекта.
Значение CLIP обозначает точность попарной идентификации, а не косинусное сходство или общий показатель признаков CLIP. Поскольку семантический поток обучается с целью достижения таргета в пространстве CLIP, данный показатель отражает как семантическую реконструкцию, так и согласование с таргетом одной из ветвей. Следовательно, он рассматривается совместно с PixCorr, SSIM, AlexNet, Inception-v3, EffNet и SwAV, которые характеризуют взаимодополняющие аспекты низкоуровневой точности и согласованности в пространстве признаков.
Для характеристики показателей на уровне отдельных испытуемых мы применили полную процедуру тестирования TDE-Net к субъектам с sub-01 по sub-10, используя одни и те же 200 отложенных условий изображений для каждого испытуемого. В Таблице 3 представлены все восемь показателей оценки для каждого субъекта, а также среднее значение по всем испытуемым и стандартное отклонение (SD) выборки. Средняя точность попарной идентификации CLIP составила 0,8135 (SD, 0,0074). Средние значения PixCorr и SSIM составили 0,2531 и 0,3388 соответственно. Точность слоев Layer 2 и Layer 5 сети AlexNet в среднем составила 0,8777 и 0,9153, а точность Inception-v3 в среднем составила 0,7606. Средние значения расстояний EffNet и SwAV, где меньшее значение означает лучший результат, составили 0,8285 и 0,5085 соответственно. Ограниченная дисперсия этих показателей на уровне испытуемых указывает на сопоставимое количественное поведение реконструкции у 10 субъектов THINGS-EEG2.
Рисунок 3 представляет реконструкции для тех же семи исключенных индексов условий (1, 32, 62, 86, 87, 108 и 175; нумерация файлов начинается с нуля) для всех 10 испытуемых. Верхний ряд показывает истинные стимулы, а последующие ряды — соответствующие реконструкции для испытуемых с sub-01 по sub-10. Реконструкции сохраняют общие семантические категории и характерные визуальные атрибуты стимулов, в то время как детальная идентификация объектов, форма и локальная текстура варьируются в зависимости от испытуемого. Такая схема представляет собой качественный аналог результатов межсубъектного анализа, обобщенных в Таблице 3.
Рисунок 4 представляет качественные реконструкции для шести заданных тестовых условий sub-01. В строках показаны истинный стимул, компаратор Perceptogram, созданный с помощью нашей локальной реализации21, и реконструкция TDE-Net. Приведенные примеры подчеркивают сохранение категории объекта, его формы, цвета и атрибутов фона, в то время как детальные характеристики идентичности и фона различаются в зависимости от метода.
Дополнительный рисунок 1 демонстрирует группы с наилучшей, медианной и наихудшей реконструкцией, выбранные из 200 тестовых условий sub-01 в THINGS-EEG223. Условия ранжированы по косинусному сходству между замороженным объединенным CLIP-эмбеддингом, предсказанным по ЭЭГ, и соответствующим истинным CLIP-эмбеддингом изображения. Представленные группы иллюстрируют диапазон семантического соответствия, наблюдаемого для данного испытуемого.
Вклад компонентов и особенности слияния
Таблица 4 представляет собой поэтапное исключение (абляцию) структурного и семантического потоков на основе средних значений по всем испытуемым, полученных с использованием той же процедуры оценки. Линейный якорь напрямую предсказывает латентные представления CLIP и VAE из предварительно обработанных данных ЭЭГ с помощью гребневой регрессии и служит контролируемой отправной точкой для исследования абляции. Он следует общему принципу линейного отображения латентных пространств, использованному в предыдущих исследованиях по преобразованию ЭЭГ в изображения, включая Perceptogram21, при этом используются настройки предобработки, регуляризации, декодирования и оценки текущего конвейера. Такая архитектура позволяет изучить структурный поток, семантический поток и слияние в двойном пространстве относительно общего линейного эталона.
Начиная с Linear Anchor, добавление структурного потока увеличило SSIM с 0,331 до 0,339, а точность AlexNet Layer 5 — с 0,913 до 0,932, хотя точность AlexNet Layer 2 немного снизилась с 0,889 до 0,886. Добавление вместо этого семантического потока обеспечило наивысшее значение PixCorr (0,237) при сохранении высокой точности AlexNet Layer 2 (0,888) и сокращении расстояний EffNet и SwAV до 0,865 и 0,531 соответственно. При объединении обоих потоков посредством слияния в двойном пространстве (dual-space fusion), TDE-Net достиг наивысшей точности попарной идентификации Inception-v3 (0,761) и CLIP (0,814), а также наименьших расстояний EffNet (0,829) и SwAV (0,509). Точность AlexNet Layer 2 (0,878) осталась ниже, чем у Linear Anchor, а значение SSIM (0,339) оказалось чуть ниже, чем в конфигурации со структурным потоком. В целом, результаты абляции между субъектами показывают, что структурный и семантический потоки влияют на разные аспекты реконструкции, в то время как их слияние в первую очередь усиливает семантическую идентификацию и согласованность в глубоком пространстве признаков.
Рисунок 5 демонстрирует чувствительность отборочной выборки к двум весам слияния в диапазоне α = 0.00–1.00 с шагом 0.05. Кривая для CLIP-пространства достигает максимума при αCLIP = 0.55, в то время как кривая для VAE-пространства достигает максимума при αVAE = 0.65. Схожие значения PCC наблюдались для соседних кандидатов, при этом максимумы приходились на разные веса для двух латентных пространств.
Временной вклад сигналов ЭЭГ
Рисунок 6 демонстрирует средний латентный PCC для каждого условия для необработанных окон ЭЭГ, заканчивающихся на 8, 16, ..., 80 временных точках у субъекта 01 (n = 200 тестовых условий). Кривые CLIP и VAE растут по мере расширения окна анализа и выходят на плато в более поздних окнах. Пунктирные линии указывают соответствующие эталонные значения только для семантического потока при полном окне. Данный анализ характеризует зависимость от временного окна в рамках описанного протокола отображения.
Семантическое выравнивание и анализ на уровне представлений
Рисунок 7 сравнение пообразцового коэффициента корреляции Пирсона (PCC) латентных представлений CLIP для исходного якоря CLIP и замороженного объединенного прогноза CLIP в 200 тестовых условиях sub-01. Оценки плотности распределения с использованием гауссова ядра рассчитаны по методу Скотта; вертикальные пунктирные линии обозначают средние значения по выборке. Объединенное распределение демонстрирует среднее увеличение PCC примерно на 0,013 по сравнению с исходным якорем. Точность попарной идентификации CLIP на уровне изображений приведена отдельно в Таблица 2.
Рисунок 8 представляет собой сравнение RSM по косинусному сходству для эмбеддингов CLIP истинных изображений и объединенных прогнозируемых эмбеддингов CLIP на основе ЭЭГ. Обе матрицы имеют общий диапазон данных и упорядочивание по методу Уорда, полученное на основе евклидовых расстояний между истинными эмбеддингами CLIP. Панель остатков показывает разность между прогнозируемой RSM и истинной RSM в симметричном масштабе, определенном по максимальному абсолютному остатку, что позволяет визуализировать степень соответствия репрезентаций.
Дополнительная фигура 2 представляет собой совместную проекцию 200 истинных и 200 предсказанных по ЭЭГ эмбеддингов CLIP. Пять меток были получены с помощью кластеризации k-means L2-нормализованных истинных эмбеддингов (n_init = 50; seed = 7). Конкатенированные истинные и предсказанные признаки были сокращены до 50 измерений с помощью PCA и совместно спроецированы методом t-SNE с перплексией 28, евклидовым расстоянием и seed 12. Проекция обеспечивает качественное представление организации двух наборов репрезентаций.
Паттерны ЭЭГ и интерпретируемость пространственного внимания
Дополнительная фигура 3 группирует тестовые концепты по категориям «Животные», «Еда/растения» и «Другие объекты» с использованием явного сопоставления концептов и меток. Внутри каждой группы строки упорядочены по методу кластеризации Уорда на основе отбеленных истинных вложений CLIP и равномерно отобраны (не более 30 концептов) для обеспечения читаемости. Тепловая карта отображает обрезанные, нормализованные отбеленные амплитуды ЭЭГ по шкале от -1 до 1; вложения CLIP используются исключительно для определения порядка внутри групп.
Дополнительный рисунок 4 представляет стандартную топографию скальпа 10–20 для нормализованных абсолютных весов каналов семантического потока по 17 выбранным электродам. Карта обобщает относительные веса модели по измеренным каналам скальпа и интерпретируется как визуализация весов модели на уровне каналов.
Данное исследование представляет собой вторичный вычислительный анализ деидентифицированного набора данных THINGS-EEG2. Исходные записи ЭЭГ, предварительно обработанные массивы ЭЭГ, метаданные и изображения стимулов, а также файлы состояния покоя доступны в рамках проекта THINGS-EEG2 по адресу https://osf.io/3jk45/ и в Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). Программное обеспечение для первичного сбора и предварительной обработки данных доступно по адресу https://github.com/gifale95/eeg_encoding. Доступ и повторное использование данных ЭЭГ и изображений стимулов регулируются лицензиями и требованиями к указанию авторства, определенными в исходных репозиториях.
Реализация TDE-Net, включая скрипты для выравнивания, слияния, реконструкции, оценки и визуализации, доступна по адресу https://github.com/Yuan-ui198/TDE-Net. Версия, соответствующая данной рукописи, зафиксирована в коммите c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Для настоящего исследования новые идентифицируемые данные участников не собирались.
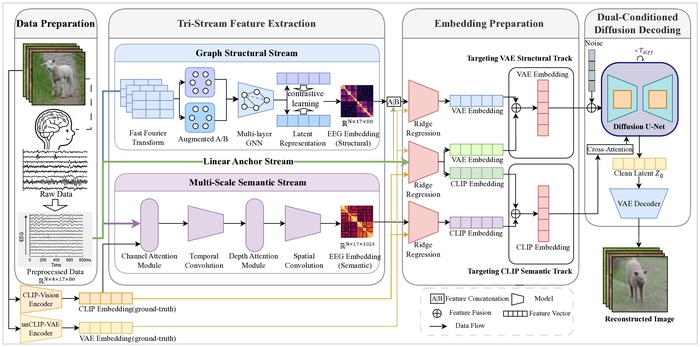
Рисунок 1: Схема TDE-Net. На диаграмме представлены исходный опорный сигнал ЭЭГ, поток функциональных графов для конкретного образца, семантический временной поток, отображение в двух пространствах VAE и CLIP, взвешенное слияние и декодирование Stable UnCLIP с двойным условием. Где применимо, указаны размерности тензоров. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
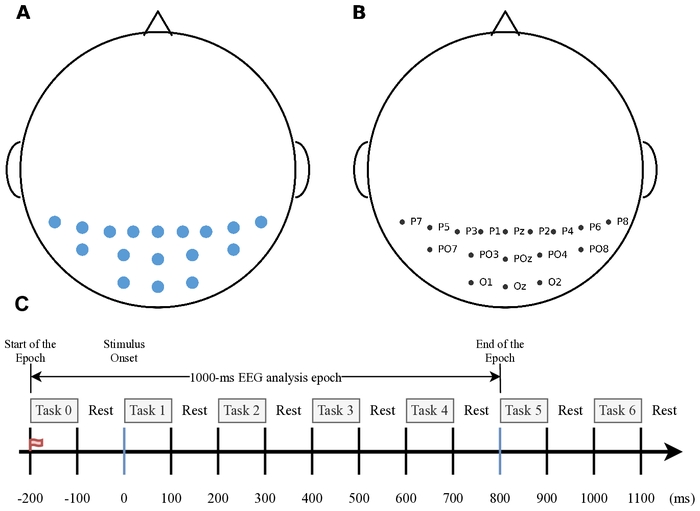
Рисунок 2: Выбор ЭЭГ-электродов и временная схема эксперимента. (A) Пространственное распределение 17 выбранных теменно-затылочных электродов из исходного 64-канального набора данных. (B) Обозначения электродов: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 и P2. (C) Схема временных интервалов RSVP и определения эпохи ЭЭГ. На схеме «Task» (Задание) обозначает интервал предъявления изображения, а «Rest» (Отдых) — интервал между изображениями; пронумерованные блоки Task указывают на последовательные интервалы предъявления, а не на разные экспериментальные условия. Каждое изображение предъявлялось в течение 100 ms с асинхронией начала стимула 200 ms. Эпоха ЭЭГ охватывала период от -200 до 800 ms относительно начала стимула, что соответствует аналитическому окну ЭЭГ длительностью 1000 ms. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
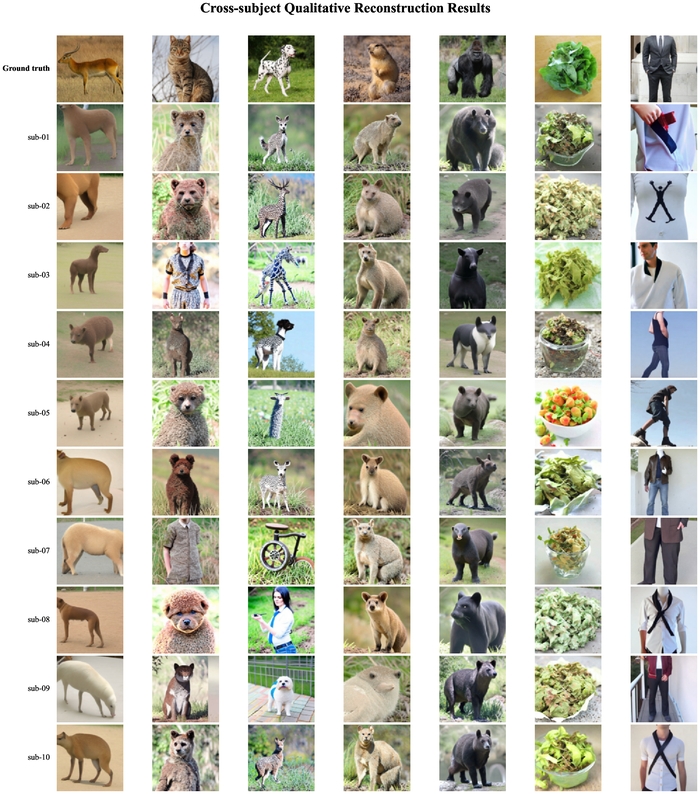
Рисунок 3: Результаты качественной межсубъектной реконструкции для семи исключенных условий изображений. Для субъектов с sub-01 по sub-10 используются одни и те же индексы условий, начинающиеся с нуля (1, 32, 62, 86, 87, 108 и 175). В верхнем ряду показаны соответствующие эталонные образцы изображений из тестового набора THINGS-EEG2, изображения которых были взяты из базы данных изображений THINGS34, тогда как в остальных рядах представлены реконструкции TDE-Net для каждого субъекта. На рисунке показаны общие семантические признаки и вариации на уровне субъектов; количественные результаты межсубъектного анализа представлены в Таблице 3. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в увеличенном виде.
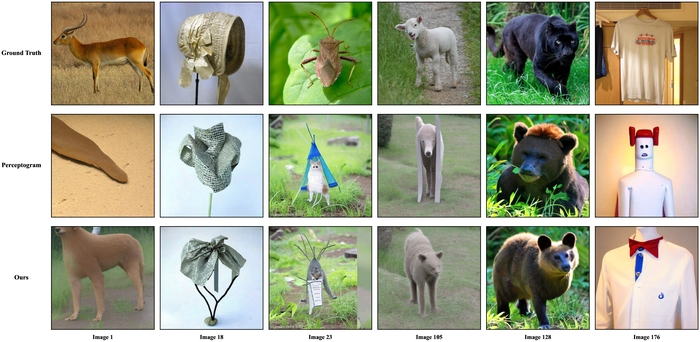
Рисунок 4: Сравнение качественной реконструкции для шести заданных условий тестирования sub-01. Строки демонстрируют истинный стимул, сравнительную реконструкцию, созданную локальной реализацией, и реконструкцию TDE-Net; столбцы соответствуют индексам отдельных условий. Образцы изображений истинного значения были взяты из базы данных изображений THINGS34. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
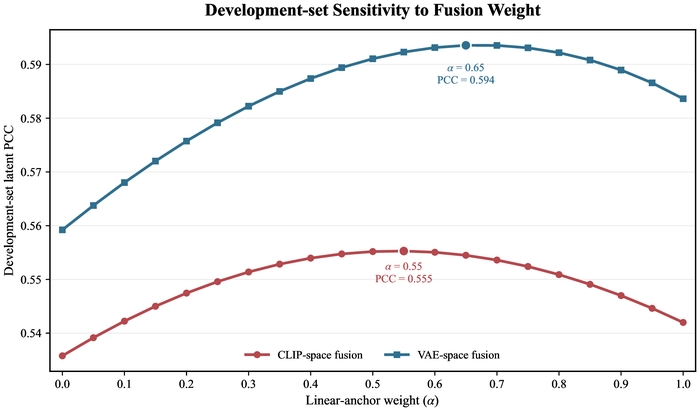
Рисунок 5: Чувствительность весов латентного слияния на обучающей выборке. По горизонтальной оси отложен вес линейного якоря α, вес дополнительного потока составляет 1 - α, по вертикальной оси — значение latent PCC на обучающей выборке. Диапазон возможных значений составляет от 0.00 до 1.00 с шагом 0.05. Веса для пространства CLIP и VAE выбираются независимо по максимальному среднему значению PCC на уровне субъектов с равными весами для 10 субъектов, что дает αCLIP = 0.55 и αVAE = 0.65. PCC — коэффициент корреляции Пирсона. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
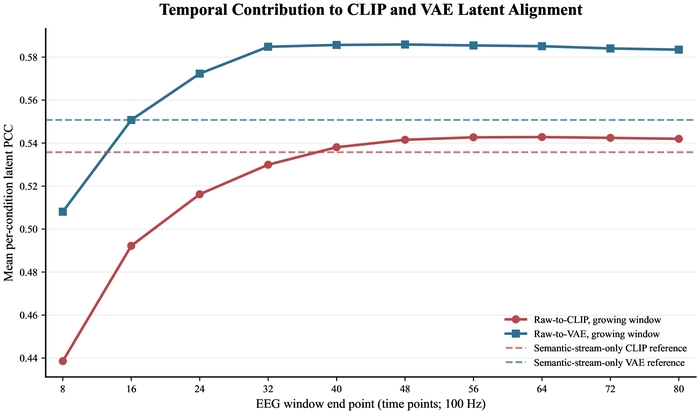
Рисунок 6: Анализ временных окон латентного выравнивания в sub-01 (n = 200 исключенных условий). Сплошные кривые показывают средний по образцам PCC для предсказаний гребневой регрессии raw-to-CLIP и raw-to-VAE при расширении конечной точки окна ЭЭГ от 8 до 80 временных точек при частоте 100 Hz. Пунктирные линии обозначают эталонные значения CLIP и VAE только для семантического потока при полном окне. PCC — коэффициент корреляции Пирсона. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
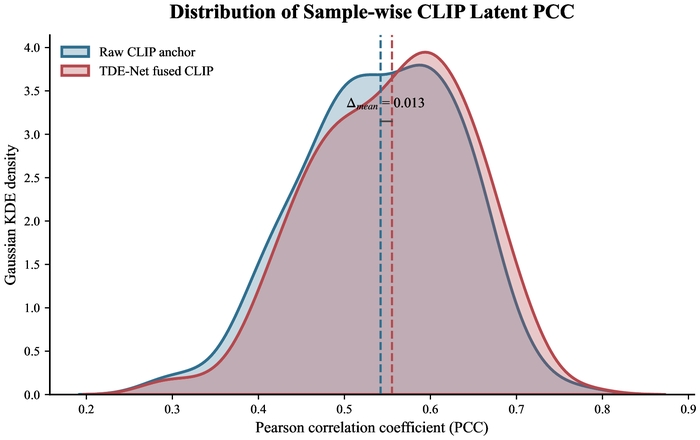
Рисунок 7: Распределение латентного выравнивания CLIP по образцам в подмножестве sub-01 (n = 200 исключенных условий). Кривые представляют собой оценки плотности распределения с использованием гауссова ядра и ширины окна по Скотту для исходного якоря CLIP и замороженного прогноза CLIP, объединенного с помощью TDE-Net-fused. Вертикальные пунктирные линии обозначают средние значения по выборке, а аннотация указывает на разницу между ними. PCC — коэффициент корреляции Пирсона; KDE — ядерная оценка плотности. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
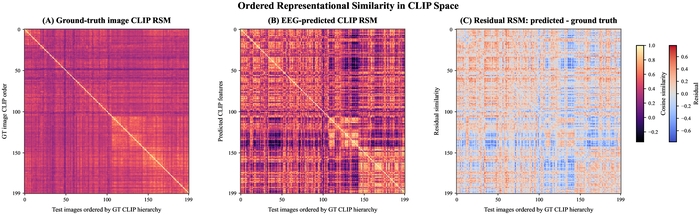
Рисунок 8: Упорядоченное репрезентативное сходство в пространстве CLIP для субъекта sub-01 (n = 200 отложенных условий). (A) RSM косинусного сходства L2-нормированных эмбеддингов CLIP истинных изображений. (B) RSM косинусного сходства объединенных предсказанных по ЭЭГ эмбеддингов CLIP, отображенных с использованием того же порядка и цветовой шкалы, что и на панели A. (C) Остаточная RSM, рассчитанная как разность между предсказанными и истинными значениями, отображенная в симметричном масштабе, определенном максимальным абсолютным остатком. Порядок получен с помощью евклидова расстояния и метода иерархической кластеризации Варда для истинных эмбеддингов CLIP. RSM, матрица репрезентативного сходства. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Компонент | Параметр | Настройка |
| Данные и предобработка | Разбиение набора данных | 16 540 условий для обучения и 200 условий для выделенного теста; разделение на обучающую и проверочную выборки 90%/10% (seed 42) |
| Входные данные ЭЭГ | 17 теменно-затылочных каналов; 0-800 ms; 100 Hz; 80 временных точек | |
| Спектральное представление | БПФ из 80 точек; 40 корзин положительных частот; логарифмический амплитудный спектр 0-50 Hz | |
| Структурный поток | Построение графа | Абсолютная корреляция Пирсона для каждого образца; взвешенные top-k = 4 соседа на узел; симметризация и петли самоперехода |
| Архитектура GCN | 5 слоев; 80 скрытых нейронов; ReLU; dropout 0.3; симметричная нормализация степени; mean pooling | |
| Контрастивная целевая функция | 80-мерная проекционная голова; температура InfoNCE τ = 0.5 | |
| Обучение | Adam; скорость обучения 5 × 10⁻⁴; размер батча 32; 20 эпох; косинусное затухание; минимальная скорость обучения 10⁻⁶; seed 42 | |
| Семантический поток | Архитектура | Временные ядра 5/15/31; глубина 9; 24 канала признаков; dropout 0.5; размерность выхода 1 024 |
| Обучение | AdamW; скорость обучения 5 × 10⁻⁴; затухание весов 0.01; размер батча 64; 50 эпох; косинусное затухание; минимальная скорость обучения 10⁻⁶; seed 42 | |
| Латентное отображение | Ридж-регрессия | Свободный член подогнан; максимальное количество итераций 50 000; входные данные стандартизированы с использованием статистики обучающей выборки |
| Регуляризация | Штраф CLIP λ = 1 000; штраф raw VAE λ = 0; штраф structural VAE λ = 1 000 | |
| Целевые размерности | CLIP: 1 024; VAE: 36 864 | |
| Слияние и декодирование | Веса слияния | Вес якоря CLIP α = 0.55; вес якоря VAE α = 0.65; выбраны на проверочных данных и зафиксированы перед тестированием |
| Диффузионная модель | sd2-community/stable-diffusion-2-1-unclip; структурный масштаб γ = 0.02; временные шаги диффузии T = 1 000 | |
| Сэмплирование | 20 шагов шумоподавления; масштаб guidance 7.5; seed диффузии 0 |
Таблица 1: Сводная характеристика параметров TDE-Net. В таблице приведены данные по разделению выборки, предварительной обработке, построению функциональной матрицы смежности, настройкам графового и семантического кодировщиков, штрафам латентного отображения, весам слияния и параметрам диффузионного декодирования, использованным во всех представленных экспериментах.
| Метод | PixCorr | SSIM (структурное сходство изображений) | AlexNet(2) | AlexNet(5) | Начало | CLIP | EffNet | SwAV |
| Исходный уровень | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| Декодирование изображений по ЭЭГ | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Перцептограмма (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (наша разработка) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
Таблица 2: Результаты количественной реконструкции. Методы сравнения — базовая модель с внутренним сверточным вниманием (Baseline) и TDE-Net — оценивались в рамках единой экспериментальной структуры с использованием одного и того же разбиения THINGS-EEG2, 17-канального ввода, предварительной обработки, отложенных тестовых условий и определений метрик при сохранении специфичных для каждого метода архитектур. Данные текущей модели представлены как среднее ± SD по 10 испытуемым. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 и CLIP являются показателями, для которых более высокие значения свидетельствуют о лучшем результате; EffNet и SwAV представляют собой корреляционные расстояния, для которых более низкие значения являются лучшими. В столбце CLIP указана точность попарной идентификации с использованием модели OpenAI CLIP ViT-L/14.
| Предмет | PixCorr | SSIM (индекс структурного сходства) | AlexNet L2 | AlexNet L5 | Начало (Inception) | CLIP | EffNet | SwAV |
| под-01 | 0.2260 | 0.3361 | 0.8831 | 0.9203 | 0.7533 | 0.8120 | 0.8567 | 0.5285 |
| под-02 | 0.2488 | 0.3378 | 0.8699 | 0.9053 | 0.7268 | 0.8074 | 0.8335 | 0.5167 |
| под-03 | 0.2564 | 0.3397 | 0.8728 | 0.9070 | 0.7658 | 0.8143 | 0.8268 | 0.5096 |
| под-04 | 0.2420 | 0.3356 | 0.8598 | 0.9034 | 0.7854 | 0.8112 | 0.8255 | 0.5091 |
| под-05 | 0.2499 | 0.3385 | 0.8760 | 0.8963 | 0.7251 | 0.8016 | 0.8394 | 0.5189 |
| под-06 | 0.2621 | 0.3395 | 0.8910 | 0.9331 | 0.7818 | 0.8215 | 0.8202 | 0.5009 |
| под-07 | 0.2489 | 0.3378 | 0.8643 | 0.9185 | 0.7704 | 0.8200 | 0.8222 | 0.5017 |
| под-08 | 0.2786 | 0.3425 | 0.8951 | 0.9216 | 0.7524 | 0.8245 | 0.8214 | 0.5010 |
| под-09 | 0.2609 | 0.3370 | 0.8775 | 0.9238 | 0.7662 | 0.8055 | 0.8250 | 0.5009 |
| менее 10 | 0.2571 | 0.3433 | 0.8871 | 0.9240 | 0.7792 | 0.8175 | 0.8140 | 0.4977 |
| Среднее значение | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7606 | 0.8135 | 0.8285 | 0.5085 |
| Среднее значение ± СКО (стандартное отклонение) | 0.2531 ± 0.0138 | 0.3388 ± 0.0025 | 0.8777 ± 0.0115 | 0.9153 ± 0.0116 | 0.7606 ± 0.0213 | 0.8135 ± 0.0074 | 0.8285 ± 0.0122 | 0.5085 ± 0.0101 |
| 95% ДИ | 0.2432-0.2630 | 0.3370-0.3406 | 0.8695-0.8859 | 0.9070-0.9236 | 0.7454-0.7759 | 0.8082-0.8189 | 0.8198-0.8372 | 0.5013-0.5157 |
Таблица 3: Результаты количественного анализа TDE-Net при кросс-субъектном тестировании. Каждый субъект предоставляет 200 отложенных тестовых условий. В таблице приведены восемь показателей для испытуемых с sub-01 по sub-10, а затем среднее значение по всем субъектам, выборочное стандартное отклонение (SD) и 95% доверительный интервал (CI). CLIP обозначает точность попарной идентификации OpenAI CLIP ViT-L/14; EffNet и SwAV представляют собой корреляционные расстояния, где меньшее значение указывает на лучший результат.
| Метод | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Линейный якорь | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Линейный + Struct-Stream | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Линейный + Sem-Stream | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (наш вариант) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Таблица 4: Результаты абляции, представленные в виде средних значений по испытуемым в рамках процедуры оценки, описанной в разделе 6 протокола. Linear Anchor представляет собой локально оцениваемый внутренний прямой опорный ориентир отображения гребней; структурная, семантическая и полная конфигурации используют одни и те же индексы условий и определения метрик. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 и CLIP являются показателями, где более высокие значения означают лучший результат; EffNet и SwAV — это корреляционные расстояния, где более низкие значения означают лучший результат. Значения приведены с точностью до трех знаков после запятой.
Дополнительная фигура 1: Репрезентативные примеры реконструкции, охватывающие диапазон согласованности CLIP для испытуемого sub-01. 200 отложенных условий ранжированы по косинусному сходству между объединенными предсказанными по ЭЭГ и истинными эмбеддингами CLIP; показаны шесть лучших, шесть средних и шесть худших случаев. В каждом столбце истинное изображение из тестового набора THINGS-EEG2 сопоставлено с результатом реконструкции TDE-Net. Истинные изображения были взяты из базы данных изображений THINGS34. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 2: Совместная визуализация истинных и предсказанных по ЭЭГ представлений CLIP для субъекта sub-01 (n = 200 условий на каждое представление). (A) Истинные представления CLIP. (B) Представления CLIP, предсказанные по ЭЭГ. Цвета обозначают пять кластеров k-means, построенных на основе L2-нормированных истинных эмбеддингов CLIP (k = 5, n_init = 50, seed = 7). Кластеры представляют собой группы, определенные на основе данных, и не соответствуют заранее заданным семантическим категориям. Истинные и предсказанные эмбеддинги конкатенированы, сокращены до 50 измерений с помощью PCA и совместно спроецированы методом t-SNE (perplexity = 28, learning rate = auto, евклидова метрика, seed = 12). PCA — анализ главных компонентов; t-SNE — стохастическое вложение соседей с t-распределением. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 3: Паттерны ЭЭГ, сгруппированные по широким категориям концепций изображений для испытуемого sub-01. Концепции распределены по категориям: «Животные», «Еда/Растения» или «Другие объекты». Внутри каждой категории строки расположены в соответствии с иерархической сортировкой Уорда для отбеленных истинных эмбеддингов CLIP; для обеспечения читаемости проведена равномерная выборка (не более 30 концепций). Столбцы представляют 17 каналов ЭЭГ с 80 временными точками на канал. Цветовая шкала (от -1 до 1) отображает ограниченную нормализованную амплитуду отбеленной ЭЭГ. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 4: Топография внимания каналов скальпа в семантическом потоке. Цвета отображают нормализованные относительные величины выученных параметров веса каналов для выбранных 17 электродов в стандартной проекции скальпа по системе 10–20; точки и метки электродов определяют позиции измерений. Шкала варьируется от 0 до 1 и обобщает выученное моделью относительное взвешивание каналов. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
В данном исследовании представлен модульный вычислительный рабочий процесс, в котором разделены предварительная обработка ЭЭГ, обучение структурному и семантическому представлению, латентное картирование CLIP/VAE, слияние и диффузионное декодирование. Такая поэтапная организация позволяет анализировать промежуточные результаты отдельно от сгенерированных изображений и соответствует общей тенденции перехода от компактных энкодеров ЭЭГ к методам кросс-модальной и диффузионной реконструкции6,11,12,13,14,15,16,,17,18,19,20,21,22. Межсубъектный анализ содержит значения для каждого субъекта, а также среднее значение по группе и стандартное отклонение (SD) выборки для отложенной оценки по десяти субъектам. Вместе с поэтапным абляционным анализом, представленным в Таблице 4, этот анализ позволяет количественно оценить эффекты конкретных потоков данных и межсубъектную вариативность в рамках описанного конвейера.
Критические этапы и поиск и устранение неисправностей
Наиболее важными контрольными механизмами реализации являются изоляция разделов, последовательная нормализация, сохранение индекса условий и раздельные отображения CLIP/VAE. Веса слияния должны быть подобраны на условиях разработки и зафиксированы перед тестовой реконструкцией. В случае неожиданно низкой производительности следует сначала проверить порядок и размерность массивов, а затем проанализировать исходные и специфичные для ветви латентные PCC, метаданные слияния и выходные метрики на уровне изображений. Ошибка выравнивания латентных признаков указывает на проблему отображения на предыдущем этапе, в то время как вариативность изображений при стабильных латентных признаках может отражать стохастическое или зависящее от декодера поведение14,21,22,29.
Изменение монтажа электродов, частоты дискретизации или временного окна требует соответствующих корректировок при построении графиков, определении спектральных признаков и временных ядер. Качество реконструкции следует оценивать с помощью дополнительных низкоуровневых и семантических показателей, поскольку ни один отдельный показатель не позволяет в полной мере отразить точность передачи пикселей, структуру и соответствие на уровне объектов6,11,21,22,23. Используемый здесь показатель CLIP представляет собой точность попарной идентификации, в то время как на Рисунке 7 и Рисунке 8> используется коэффициент корреляции Пирсона (PCC) на уровне латентных представлений; эти величины не являются взаимозаменяемыми.
Модульная организация TDE-Net создает основу для изучения того, вносят ли взаимодополняющие представления ЭЭГ различный вклад в структурные и семантические аспекты визуальной реконструкции. Такой подход может способствовать систематическому сравнению представлений признаков ЭЭГ, латентных целей и генеративных декодеров без исключительной опоры на итоговые реконструированные изображения. Альтернативные подходы включают прямое линейное отображение ЭЭГ в латентное пространство, однопоточные сверточные или основанные на механизме внимания энкодеры, графовые представления и сквозные (end-to-end) нейросетевые структуры декодирования6,7,8,9,10,11,17,18,19,20,21,22. Представленный рабочий процесс может быть особенно полезен для исследований в области декодирования зрительного восприятия, анализа нейронных представлений и неинвазивных интерфейсов мозг-компьютер, где разделение промежуточных предсказаний «ЭЭГ-латентное пространство» может помочь определить, какие компоненты влияют на качество реконструкции.
Ограничения
Основные ограничения заключаются в фиксированном сборе данных RSVP с помощью THINGS-EEG2, выборе 17 теменно-затылочных каналов, субъективно-специфическом картировании, использовании одного диффузионного декодера и качественном анализе интерпретируемости21,22,23. Обобщенные данные по 10 субъектам учитывают вариабельность испытуемых внутри одного набора данных, однако они не устанавливают возможность переноса между разными наборами данных или парадигмами. Сгенерированные изображения могут содержать правдоподобные детали, не подтвержденные данными ЭЭГ, а анализ RSM, t-SNE, паттернов ЭЭГ и карт внимания не позволяет установить причинно-следственные нейронные механизмы. Поэтапная абляция характеризует вклад структурного потока, семантического потока и слияния в двойном пространстве при использовании общих исходных данных ЭЭГ, латентных целей, диффузионного декодера и протокола оценки.
Перспективы дальнейших исследований
В рамках данных ограничений полученные результаты подтверждают целесообразность оценки дополнительных представлений ЭЭГ в отдельных семантических и латентных пространствах изображений перед диффузионным декодированием. В будущих работах следует протестировать независимые наборы данных, адаптацию под конкретного субъекта, оценки неопределенности, альтернативные монтажи каналов, а также декодеры с более строгим контролем неподдерживаемых визуальных деталей14,15,16,17,18,19,20,21,22,23. Такие исследования необходимы перед распространением текущих выводов на более широкие области нейронаук или настройки интерфейсов «мозг-компьютер».
Заключение:
TDE-Net объединяет необработанный опорный сигнал ЭЭГ со структурными и семантическими представлениями ЭЭГ, выравнивает их по отдельности с латентными пространствами VAE и CLIP и интегрирует полученные прогнозы перед диффузионным декодированием. У 10 участников набора данных THINGS-EEG2 реконструированные изображения сохранили измеримое соответствие просматриваемым стимулам на уровне пикселей, структуры и семантики, в то время как пошаговый абляционный анализ позволил дифференцировать эффекты структурного потока, семантического потока и слияния в двух пространствах. Демонстрируя промежуточные признаки ЭЭГ, латентные прогнозы, результаты слияния и окончательные реконструкции, данный протокол предоставляет воспроизводимую основу для исследования визуальной реконструкции на основе ЭЭГ и оценки возможности ее дальнейшего применения к независимым наборам данных и условиям сбора данных.
Раскрытие информации
Авторы заявляют об отсутствии конфликтов финансовых интересов или личных отношений, которые могли бы повлиять на данную работу. Авторы заявляют, что при подготовке рукописи, написании кода, анализе данных или создании рисунков инструменты генеративного ИИ не использовались.
Благодарности
Данное исследование было профинансировано Национальным фондом естественных наук Китая (гранты № 62433002 и № 62476014), Национальным проектом по основным наукам и технологиям (№ 2021ZD0113703), ежегодным плановым проектом Пекинского муниципального фонда социальных наук (№ 23GLB014), проектом по созданию и поддержке высокоуровневых инновационных групп в учреждениях города Пекина (грант № BPHR20220104) и программой «Пекинские ученые» (грант № 099).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Accelerate | Hugging Face | 0.30.1 | Управление устройствами конвейера диффузии; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Энкодер признаков изображений, используемый для семантических целей и попарной идентификации CLIP; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Реализация конвейера Stable UnCLIP; https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib Development Team | 3.10.6 | Генерация научных рисунков; https://matplotlib.org/ |
| MNE-Python | MNE Developers | 1.11.0 | Стандартный монтаж 10-20 и топография каналов скальпа; https://mne.tools/ |
| NumPy | NumPy Developers | 2.3.4 | Массивы ЭЭГ, латентные вложения, слияние и агрегация метрик; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | GPU, используемый для локального обучения энкодера и диффузионной реконструкции. |
| Pillow | Python Imaging Library Fork | 11.1.0 | Загрузка, изменение размера и экспорт изображений; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | Основная среда выполнения; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | Обучение энкодера ЭЭГ и логический вывод нейронной сети; https://pytorch.org/ |
| scikit-image | scikit-image Developers | 0.25.2 | SSIM и утилиты обработки изображений; https://scikit-image.org/ |
| scikit-learn | scikit-learn Developers | 1.7.2 | Ридж-регрессия, k-средних, PCA и t-SNE; https://scikit-learn.org/ |
| SciPy | SciPy Developers | 1.16.3 | Корреляция, статистическое расстояние и иерархическая кластеризация; https://scipy.org/ |
| Seaborn | Seaborn Developers | 0.13.2 | Визуализация гауссовой ядерной оценки плотности; https://seaborn.pydata.org/ |
| Семантический энкодер ЭЭГ (Semantic-stream EEG encoder) | TDE-Net authors; adapted from LMDA-Net | Repository commit c99325d | Многомасштабное временное семантическое представление; реализация и метаданные контрольных точек предоставлены в репозитории кода. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 Community | sd2-community/stable-diffusion-2-1-unclip | Замороженный диффузионный декодер; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Структурный энкодер ЭЭГ (Structural-stream EEG encoder) | TDE-Net authors | Repository commit c99325d | Самообучающееся графовое представление; необработанные данные ЭЭГ и признаки графа конкатенируются только для структурного отображения в пространстве VAE. |
| Скрипты выравнивания, слияния, оценки и визуализации TDE-Net | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| База данных THINGS | Hebart et al. | doi:10.1371/journal.pone.0223792 | Источник натуралистических стимулов объектов; https://things-initiative.org/ |
| Набор данных THINGS-EEG2 | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | 64-канальная ЭЭГ от 10 субъектов; в данном исследовании выбрано 17 теменно-затылочных каналов; https://osf.io/anp5v/ |
| timm | Ross Wightman and contributors | 1.0.22 | Утилиты предобученных моделей зрения, используемые при оценке признаков; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | Опорные сети AlexNet, Inception-v3 и EfficientNet для оценки; https://pytorch.org/vision/ |
| tqdm | tqdm Developers | 4.67.1 | Отчет о прогрессе извлечения признаков, реконструкции и оценки; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Интерфейсы для компонентов предобученных моделей; https://github.com/huggingface/transformers |
Ссылки
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Перепечатки и разрешения
Эта статья была опубликована
Видео скоро будет доступно