Bu araştırma, L1-L2-İngilizce ve L1-L2 Portekizce arasında bir karşılaştırma yapmayı, yabancı bir aksanın etkisinin hem metrikleri hem de prozodik-akustik parametreleri ne kadar açıkladığını kontrol etmeyi ve ayrıca bir ses diziliminde hedef sesin seçimini kontrol etmeyi amaçladı.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Yöntem makalesi
Ses dizilişlerinde yabancı aksan ve adli konuşmacı tanımlama: prozodiye dayalı akustik özelliklerin etkisi
Bu makalede
Özet
Özet
Bu araştırma, yabancı aksanlı İngilizce ve yabancı aksanlı Brezilya Portekizcesi'nin hem prozodik-akustik özelliklerini hem de algısal bağıntılarını incelemeyi ve konuşmacıların yabancı ve yerli aksan üretimlerinin dinleyicilerin algısıyla nasıl ilişkili olduğunu kontrol etmeyi amaçlamaktadır. Metodolojide, L2 Brezilya Portekizcesi konuşan bir grup Amerikalı ve L2 İngilizce konuşan bir grup Brezilyalı ile bir konuşma üretim prosedürü ve her iki dil için ses dizilimi gerçekleştirdiğimiz bir konuşma algılama prosedürü gerçekleştirdik. Konuşma üretimi istatistiksel analizi için, dil gruplarının, karşı sınıfın ortak değişken(ler)inin yumuşatma etkisi için kontrol edilen özelliklerin her bir sınıfı (metrik veya prozodik-akustik) üzerindeki etkisini değerlendirmek için Genelleştirilmiş Katkı Modelleri çalıştırdık. Konuşma algısı istatistiksel analizi için, kadroların seslerinin dinleyiciler tarafından değerlendirilen puanlar üzerindeki etkisini değerlendirmek için bir Kruskal-Wallis testi ve bir post-hoc Dunn testi yaptık. Yine de Kosinüs ve Öklid mesafelerine dayalı akustik (ses) benzerlik testleri yaptık. Sonuçlar, dil grupları arasında f0'ın değişkenliği, süresi ve ses kalitesi açısından önemli akustik farklılıklar göstermiştir. Dizilişler için sonuçlar, f0, yoğunluk ve ses kalitesinin prozodik özelliklerinin dinleyicilerin algılanan yargılarıyla ilişkili olduğunu gösterdi.
Giriş
Aksan, hem ana dilde (L1) hem de yabancı dilde (L2) iletişim ve akıcılığın göze çarpan ve dinamik bir yönüdür1. Yabancı aksan, bir hedef dilin L2 fonetik özelliklerini temsil eder ve diğer değişkenlerin yanı sıra konuşmacının L2 deneyimine, konuşma tarzına, giriş kalitesine, anlatımına yanıt olarak (zamanla) değişebilir. Yabancı bir aksan, yabancı bir konuşmacı tarafından üretilen L2 konuşması ile hedef dilin yerel veya referans aksanı arasındaki (skaler) fark derecesi olarak ölçülebilir2,3,4,5.
Bu araştırma, yabancı aksanlı İngilizce ve yabancı aksanlı Brezilya Portekizcesi'nin (BP) hem prozodik-akustik özelliklerini hem de algısal bağıntılarını incelemenin yanı sıra, konuşmacıların yabancı ve yerli aksan üretimlerinin dinleyicilerin algısıyla ne ölçüde ilişkili olduğunu kontrol etmeyi amaçlamaktadır. Adli tıp alanında daha önce yapılan araştırmalar, yabancı aksan tanımlamasında ünlülerin ve ünsüzlerin sağlamlığının, bir bireyin uzun vadeli analizi için istikrarlı olduğunu (The Lo Case6) veya bir konuşmacının yüksek kimlik doğruluğuna atıfta bulunduğunu (The Lindbergh Case7) göstermiştir. Bununla birlikte, süreye, temel frekansa (f0, yani perdenin akustik korelasyonu), yoğunluğa ve ses kalitesine (VQ) dayalı prozodik-akustik özelliklerin keşfi, artan bir ilgi kazanmıştır8,9. Bu nedenle, bu çalışmada prozodik-akustik özellikler seçimi, adli fonetik alanında umut verici bir yolu temsil etmektedir8,10,11,12,13.
Bu araştırma, adli vakalarda bir ses kılık değiştirme biçimi olarak yabancı aksanlara adanmış çalışmalarla desteklenmektedir14,15 ve ayrıca konuşmacı tanıma için ses dizilerinin hazırlanması16,17. Örneğin, konuşma hızı, Almanca, İtalyanca, Japonca ve Brezilya dillerinde İngilizce konuşanların tanımlanmasında önemli bir rol oynamıştır18,19,20,21,22. Konuşma hızının yanı sıra, uzun vadeli spektral ve f0 özellikleri, L2 yetkin konuşmacıları hedef dile aşinalık konusunda zorlar çünkü beyin ve bilişsel temeller hafıza, dikkat ve duyguda bir eksiklik yaşar ve uzun konuşma dönüşleri sırasında konuşmacının fonetik performansına yansır23. Adli tıp alanındaki yabancı aksanlara bakış, kulağa gerçekten yabancı aksan gibi gelen şeyin tanımının, yabancı aksanlı konuşmanın hiç veya aşırı derecede olmamasına değil, dinleyicinin yabancılığına büyük ölçüde bağlı olduğu yönündedir24.
Algısal alanda, 1990'ların ortalarından beri suçluların tanınması için kullanılan yaygın bir adli araç, bir suç mahallindeki bir faili tanımlamak için kullanılan görsel tanımaya benzer olan Voice Lineup'tır (işitsel tanıma)16<,sup class="xref">25. Bir ses dizisinde, şüphelinin sesi, bir kulak tanığı tarafından kimlik tespiti için yaş, cinsiyet, coğrafi konum, lehçe ve kültürel durum gibi sosyolinguistik yönlerden benzer folyo seslerle birlikte sunulur. Bir ses diziliminin başarısı veya başarısızlığı, ses örneklerinin sayısına ve örnek sürelerine bağlı olacaktır25,26. Ayrıca, gerçek dünyadaki örnekler için, ses kalitesinin ses tanımanın doğruluğunu sürekli olarak etkilediği düşünülmektedir. Düşük ses kalitesi, bir voice27'nin benzersiz özelliklerini bozabilir. Ses benzerliği söz konusu olduğunda, f0'a dayalı ince fonetik ayrıntı, ses tanıma sırasında dinleyicinin kafasını karıştırabilir28,29. Bu tür akustik özellikler f0'ın ötesine uzanır ve süre unsurlarını ve yoğunluk ve VQ30'un spektral özelliklerini kapsar. Birden çok prozodik özelliğin bu görünümü, doğru konuşmacı tanımlamasını sağlamak için adli ses karşılaştırması bağlamında çok önemlidir9,14,15,29,31.
Özetle, adli fonetik çalışmaları, son on yılda yabancı aksan tanımlamasına ilişkin bazı farklılıklar göstermiştir. Bir yandan, yabancı bir aksan, bir konuşmacıyı tanımlama sürecini etkilemiyor gibi görünmektedir32,33 (özellikle konuşmacı hedef yabancı aksana aşina değilse34). Öte yandan ters yönde bulgular var12,34,35.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Bu çalışma, bir insan araştırmaları etik kurulundan onay almıştır. Ayrıca, bu çalışmaya katılan tüm katılımcılardan verilerinin kullanılması ve yayınlanması için bilgilendirilmiş onam alınmıştır.
1. Konuşma üretimi
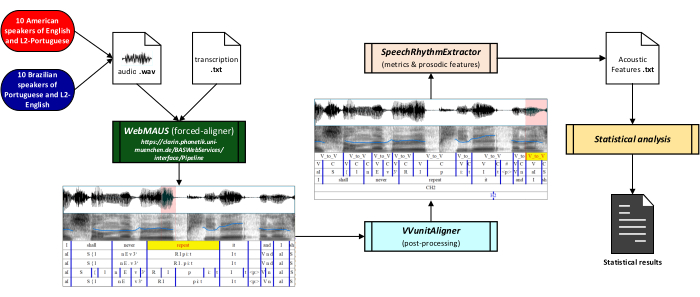
NOT: Hem Grup 1 tarafından üretilen 'L1 İngilizce-L2 BP' hem de Grup 2 tarafından üretilen 'L1 BP-L2 İngilizce' için okuma görevinden konuşma örnekleri topladık; bu gruplar sırasıyla Amerika İngilizcesi (ABD'den) Konuşmacılar (AmE-S) ve Brezilyalı Konuşmacılardır (Bra-S). Konuşma üretimine ilişkin akış şeması için Şekil 1'e bakınız.

Şekil 1: Konuşma üretimine ilişkin şematik akış şeması. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
- Katılımcılar
- Belirleyin katılımcı sayısı, the dil (L1 İngilizce, L2 Brezilya Portekizcesi; L1 Brezilya Portekizcesi, L2 İngilizce), the cinsiyet (dişi veya erkek), the yaş (ortalama, standart sapma), grup özellikleri (profesyoneller veya lisans öğrencileri) ve L2 yeterlilik düzeyi her grup için (ileri veya oldukça ileri aşamada).
NOT: Mevcut araştırma için, hem AmE-S hem de Bra-S grupları L2 yeterliliğine sahip kabul edilmiştir (her iki grup da B2-C1 düzeyinde nitelendirilmiştir)36). Prosedürler yürütüldüğünde, AmE-S grubu Brezilya'da iki yıldır yaşamaktaydı. Bra-S grubu ise prosedürler yürütüldüğünde ABD'de iki yıldan fazla süredir yaşamaktaydı. Her iki grup da yurt dışında yaşadıkları süre boyunca, eğitim ve çalışma amacıyla haftada en az 6 gün, günde yaklaşık 4-5 saat L2 dillerini konuşmuşlardı. - Katılımcıları rahat ve sessiz bir odaya yerleştirin ve her grup için okuma materyallerini sunun.
- Belirleyin katılımcı sayısı, the dil (L1 İngilizce, L2 Brezilya Portekizcesi; L1 Brezilya Portekizcesi, L2 İngilizce), the cinsiyet (dişi veya erkek), the yaş (ortalama, standart sapma), grup özellikleri (profesyoneller veya lisans öğrencileri) ve L2 yeterlilik düzeyi her grup için (ileri veya oldukça ileri aşamada).
- Veri toplama
NOT: Konuşma verileri şu dillerdeki bir okuma görevinden toplanmalıdır: L1-İngilizce ve L2-BP; L1-BP ve L2-İngilizce. Gerekiyorsa katılımcıların metinleri önceden okumasına izin verin.- Kayıt prosedürleri
- Konuşma verilerini, uygun akustik koşullara sahip sessiz bir yerde kaydedin.
- Dijital bir ses kaydedici kullanın (bakınız Materyaller Tablosu)37 ve tek yönlü, elektromanyetik olarak izole edilmiş bir kardioid mikrofon (bakınız Materyaller Tablosu)38.
- Ses verilerini ' içinde kaydedin.wavform.
- Örnekleme hızını 48 kHz ve kuantalama hızını 16 bit olarak ayarlayın.
NOT: 1.2.1.3 ve 1.2.1.4 adımlarında açıklanan ses formatı ile örnekleme ve kuantizasyon hızları yapılandırması, daha sonraki akustik analizlerde kullanılan spektral özelliklerin korunması amacıyla yüksek kaliteyi sağlamak ve gürültüyü azaltmak için uygulanmıştır.
- Kayıt prosedürleri
- Akustik analiz
NOT: Akustik analiz prosedürlerini üç adıma ayırın: zorunlu hizalama (forced-alignment), yeniden hizalama ve akustik özellik çıkarımı.- Linguistik transkripsiyonu (bir '. şeklinde) yazın.Lütfen çevirilecek metni sağlayın.her bir ses dosyası için (.file) dosyası.
- ' çiftini etiketleyinLütfen çevirmemi istediğiniz metni (.txt dosyasının içeriğini) paylaşın. Metni gönderdiğinizde, belirttiğiniz tüm bilimsel ve akademik standartlara uygun olarak çeviriyi gerçekleştireceğim.'/'.wavaynı ada sahip dosyalar (örneğin, 'my_file.wav'/ 'my_file.Lütfen çevrilecek kaynak metni sağlayın. Metni ilettiğinizde, belirttiğiniz akademik standartlara ve JoVE çeviri yönergelerine uygun olarak profesyonelce Türkçeye çevireceğim.').
NOT: Bölüm 1.3.7'de özetlenen prosedürün performansını artırmak için, '.txt/.wav' dosya etiketlerinin ilk üç karakterinin şunları temsil etmesi şiddetle önerilir: Dil, Diyalektveya Aksan, dördüncü ile altıncı karakterler ise şunları belirtir: Cinsiyet (örneğin, EL1FEM için Eİngilizce L1 Female). Yedinci karakterden itibaren, kullanıcı konuşmacı numarasını belirtmelidir (örneğin, 001 (ilk konuşmacı için). Sonuç olarak, ilk '.txt/.wav' çifti EL1FEM001. - Her bir L1-L2 dili için bir klasör oluşturun.
NOT: L1-L2 İngilizce için bir klasör ve L1-L2 BP için bir klasör. - Aynı dildeki tüm dosya çiftlerinin aynı klasörde olduğunu doğrulayın.
- Zorunlu hizalamayı gerçekleştirin.
- Munich Automatic Segmentation (MAUS) zorunlu hizalayıcının web arayüzüne erişin (webMAUS)39 at https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline.
- Her bir çifti sürükleyip bırakın.dalga formu / .Lütfen çevrilecek metni sağlayın. şuradan alınan dosyalar kesikli dikdörtgen içindeki klasöre Dosyalar (veya dikdörtgenin içine tıklayın, Şekil 2A).
- Tıklayın Yükle dosyaları hizalayıcıya yüklemek için kullanılan buton (kırmızı oka bakınız) Şekil 2A).
- Aşağıdaki seçenekleri seçin Hizmet seçenekleri menü (Şekil 2B): G2P-MAUS-PHO2SYL için Boru hattı adı; İngilizce (ABD) (için Dil) eğer L1-L2 İngilizce verileri; İtalyanca (IT) (için Dil) eğer L1-L2 BP verileri.
NOT: webMAUS, BP zorlanmış hizalama (forced alignment) için önceden eğitilmiş akustik modeller sunmadığından, BP verileri için 'İtalyanca'yı seçtik. Fonetik literatürü, İtalyanca fonolojisinin tıpkı BP gibi, bir dereceye kadar karşılaştırılabilir ve simetrik bir yedi ünlü envanterine sahip olduğunu öne sürmektedir.40yanı sıra konsonantal akustik benzerlikler41,42. - 'Çıktı formatı' ve 'Her şeyi tut' için varsayılan seçenekleri bırakın.
- Kontrol edin Çalıştır kullanım koşullarını kabul etmek için seçenek kutusu (yeşil oka bakınız Şekil 2C).
- Tıklayın Web Servisini Çalıştır yüklenen dosyaları hizalayıcıda çalıştırmak için buton.
NOT: Her bir ses dosyası için MAUS zorlamalı hizalayıcı (forced aligner) bir Praat dosyası döndürür TextGrid nesne (1.3.1 adımında açıklanan '.txt' dosyasından çıkarılan dilbilimsel transkripsyona dayalı olarak kelimelerin, fonolojik hecelerin ve fonların anotasyonunu içeren, Praat ile önceden formatlanmış bir '.txt' dosyası). - Tıklayın ZIP Dosyası olarak indir TextGrid dosyalarını sıkıştırılmış bir dosya olarak indirme düğmesi (Şekil 2C).
NOT: Sıkıştırılmış TextGrid dosyalarının, ses dosyalarıyla aynı klasöre indirildiğinden emin olun. - Fonetik analiz yazılımında daha sonra yeniden hizalama yapmak üzere TextGrid dosyalarını çıkarın43.
- Yeniden hizalamayı gerçekleştirin.
- Praat VVUnitAligner betiğine erişin ve indirin44 -dan / -den https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat.
- Aynı dildeki tüm dosya çiftlerinin ve VVUnitAligne'nin onaylandığını belgeleyinr betikler aynı klasördedir.
NOT: L1-L2 İngilizce dosyaları ve VVunitAligner için bir klasör ile L1-L2 BP dosyaları ve VVunitAligner için bir klasör. - Fonetik analiz yazılımını açın.
- Tıklayın Praat | Praat betiğini aç… betiği şuradan çağırmak için nesne penceresi.
- Tıklayın Çalıştır düğmeye bir kez basın.
NOT: ... adlı bir form Fonetik hece hizalama betiğin kullanımına yönelik ayarları içeren pencere ekranda belirecektir (Şekil 3A). - Tıklayın Dil 'İngilizce (ABD),' 'Portekizce (Brezilya),' 'Fransızca (Fransa)' veya 'İspanyolca (İspanya)' dillerinden seçim yapmaya yarayan düğme.
- Tıklayın Yığın segmentasyonu 'Otomatik', 'Zorlanmış (manuel)' veya 'Yok' segmentasyon prosedürlerinden birini seçmek için kullanılan buton.
- Kontrol edin TextGrid dosyalarını kaydedin yeni TextGrid dosyalarını otomatik olarak kaydetme seçeneği.
- Tıklayın Tamam | Çalıştır 1.3.5.7. adımdaki fonetik birimlerin yeniden hizalanması için butonlar.
NOT: VVUnitAligner, her bir ses dosyası için bölüm 1.3.7 için yeni bir TextGrid dosyası oluşturacaktır (Şekil 3B).
- Akustik özelliklerin otomatik ekstraksiyonunu gerçekleştirin.
- SpeechRhythmExtractor betiğine erişin ve indirin45 den Prosodik-akustik özelliklerin otomatik olarak çıkarılması için https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat.
- Yeni bir klasör oluşturun ve SpeechRhythmExtractor'ı tüm dillere ait tüm ses/TextGrid dosyası çiftleriyle birlikte buraya yerleştirin.
- Fonetik analiz yazılımını açın.
- Tıklayın Praat | Praat betiğini aç… betiği ... üzerinden çağırmak için nesne penceresi.
- Tıklayın Çalıştır düğmeye yalnızca bir kez basın.
NOT: Ekranda betik ayarlarını içeren bir form belirecektir. Çıktı '.txt' dosya adı kutucuklarında, dosyaları uygun şekilde yeniden adlandırın veya varsayılan adları bırakın. - Kontrol edin ses kalitesi parametreleri kaydetme seçeneği Çıktı dosyası VQ ses kalitesi için (Şekil 3C).
NOT: Bu ikinci çıktı dosyası (the Çıktı dosyası VQ) 1 arasındaki farkın parametrelerini içerirst ve 2nd harmonikler (H1-H2) ve Cepstral Belirginlik Pik değerleri (CPP)9. - Kontrol edin Dilbilimsel hedef 'Dil', 'Lehçe' veya 'Aksan' etiketlerinden birini seçme seçeneği (Şekil 3C).
- Kontrol edin Birim f0 özelliklerini Hz veya Yarım Ses (Semitones) cinsinden seçme seçeneği (Şekil 3C).
- şunlar için değerleri ayarlayın F0 eşiği, minimum ve maksimum f0 eşikleri (Şekil 3C).
NOT: Araştırmanın özel amaçları veya önceden belirlenmiş spesifik ses özellikleri olmadığı sürece, 1.3.7.9. adımındaki parametrelerin varsayılan değerlerde bırakılması şiddetle önerilir. - Tıklayın Tamam | Çalıştır akustik özelliklerin otomatik çıkarımı için.
NOT: Senaryo KonuşmaRitmiÇıkarıcı sekme ile ayrılmış bir '.txt' dosyası döndürür (Çıktı dosyası/ Çıktı dosyası VQ) konuşmacılardan çıkarılan akustik özellikleri içeren.
- İstatistiksel analiz
- Akustik özellikleri içeren hesap çizelgesini R'ye yükleyin46 ortam (veya tercih edilen herhangi bir istatistik yazılımı/ortamı).
- Genelleştirilmiş Toplamsal Modeller (GAM'ler) non-parametrik istatistiklerini gerçekleştirin.
- R'da GAM'ler uygulayın.
- Aşağıdaki komutları yazın ve basın Giriş.
library(mgcv)
model = gam(the metrik/prozodik-akustik özellik analizinde ~ şunlar Dil + seçilen metrik özelliktarafından = -e/a tarafından Dil) + diğerleri metrik/prozodik-akustik özellikler, veri = the veri çerçevesi)
NOT: Akademik camiadaki fonetikçiler (ve dilbilimciler) arasındaki artan popülaritesi nedeniyle, protokolün test istatistiklerini R programlama dilinde gerçekleştirmeye karar verdik. R, fonetik saha araştırmalarında yaygın olarak kullanılmıştır.471.4.2.2 numaralı adımın bir sözde kod (pseudo-code) içerdiğini unutmayın. Kodu araştırma değişkenlerine göre yazın.

Şekil 2: MAUS zorunlu hizalayıcı kullanılarak yapılan fonetik hizalamadan alınan ekran görüntüsü. (A) Kesikli dikdörtgen, 'my_file.wav'/' my_file.txt' dosyalarını sürükleyip bırakmak veya klasörden bu dosyaları aramak için içerisine tıklamak içindir; yükleme düğmesi kırmızı okla belirtilmiştir. (B) A panelinden yüklenen dosyalar (mavi oka bakınız), kullanılacak işlem hattı, dosya çiftleri için dil, döndürülecek dosya formatı ve tüm dosyaları saklamak için bir 'true/false' düğmesi. (C) Kullanım Şartları onay kutusu (yeşil oka bakınız), Run Web Services düğmesi ve Sonuçlar (indirilecek TextGrid dosyaları). Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Şekil 3: Yeniden hizalama prosedürünün ekran görüntüsü. (A) Yeniden hizalama prosedürü için giriş ayarları formu. (B) Kısmi dalga formu, f0 (mavi) konturlu geniş bant spektrogramı ve altı segmente edilmiş (ve etiketlenmiş) katman: katman 1: bir ünlü başlangıcından bir sonraki ünlü başlangıcına kadar olan birimler (V_to_V); ünlü başlangıcı (V_to_V); katman 2: ünlü (V), ünsüz (C) ve duraksama (#) birimleri; katman 3: V_to_V fonik temsilleri; katman 4: metinden bazı kelimeler; katman 5: metinden bazı konuşma parçaları (CH); katman 6: kadın bir AmE-S tarafından üretilen her konuşma parçasının en yüksek (H) ve en düşük (L) tonlarını içeren tonal katman. (C) Akustik özelliklerin otomatik çıkarımı için giriş ayarları. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
2. Konuşma algısı
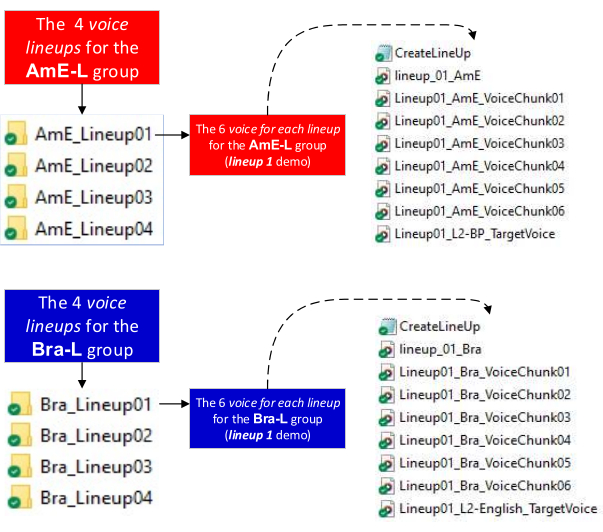
NOT: Amerikalı dinleyicilerle İngilizce dilinde dört ses dizilimi ve Brezilyalı dinleyicilerle BP dilinde dört dizilim gerçekleştirdik. Konuşma algısına ilişkin akış şeması için Şekil 4'e bakınız.
Şekil 4: Konuşma algısı için şematik akış şeması. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
- Katılımcılar
- Konuşma üretimi protokolüne katılan kişilerden farklı katılımcıları her bir grup için seçiniz.
NOT: Protokolün bu bölümü için iki grup katılımcı seçilmiştir: Grup 1The AmAmerikalı Eİngilizce (ABD) Ldinleyiciler (AmE-L) ve Grup 2The Brazilian Ldinleyiciler (Bra-L). Mevcut araştırma için hem AmE-L hem de Bra-L, L2 yeterliliğine sahip olarak kabul edilmiştir (her iki grup da B2-C1 olarak nitelendirilmiştir)36 Prosedürler gerçekleştirildiğinde AmE-L grubu Brezilya'da iki yıldır yaşamaktaydı. Bra-L grubu ise prosedürler gerçekleştirildiğinde ABD'de iki yılı aşkın süredir yaşamaktaydı. Yurt dışında yaşadıkları süre boyunca, her iki grup da eğitim ve çalışma amaçlarıyla L2 konuşmaya devam etmiştir (haftada en az altı gün, günde yaklaşık 4 ila 5 saat). - Belirleyin katılımcı sayısı, the dil (L1 İngilizce, L2 Brezilya Portekizcesi; L1 Brezilya Portekizcesi, L2 İngilizce), cinsiyet (dişi veya erkek), yaş (ortalama, standart sapma), grup özellikleri (profesyoneller veya lisans öğrencileri) ve L2 yeterlilik düzeyi her grup için.
- Konuşma üretimi protokolüne katılan kişilerden farklı katılımcıları her bir grup için seçiniz.
- Ses dizilimleri
NOT: Ses dizilimi prosedürlerini iki farklı adıma ayırın: ses dizilimlerinin hazırlanması ve uygulanması.- İngilizce için dört ve BP için dört ses dizilimi hazırlayın.
- Bölüm 1: Konuşma üretimi kısmındaki konuşmacılardan ses dosyalarını alın.
- Her bir dil faktörüne ait ses dosyalarının ayrı klasörlerde olduğunu doğrulayın.
- L1 İngilizce veya L1 BP dilinde rastgele altı ses parçası seçin.
NOT: Dizilimdeki altı ses şunları temsil etmektedir tek hedef ses ve beş folyo. - 2.2.1.3 adımında yer alan konuşmacılardan birine ait L2 İngilizce veya L2 BP dilindeki bir ses parçasını seçin.
NOT: 2.2.1.4 adımındaki ses parçası şudur: referans ses. Parçalar yaklaşık 20 saniye uzunluğunda olmalıdır.8. - Praat CreateLineup betiğine erişin ve betiği indirin48 -den/dan https://github.com/pabarbosa/prosody-scripts-CreateLineUp
- CreateLineup betiğini çalıştırmadan önce L2 referans sesinin, L1 çeldiricilerin ve L1 hedef sesinin aynı klasörde olduğunu doğrulayın (Şekil 5).
- Fonetik analiz yazılımını açın.
- -den/dan nesne penceresitıklayın Praat | Praat betiğini aç… betiği çağırmak için.
- Tıklayın Çalıştır | Çalıştır.
NOT: Betik, dosyayı şu sırada döndürür: (L2 referans sesi) + (L1 hedef sesi ve rastgele dağıtılmış çeldiriciler)Şekil 5).
- Ses dizilimlerinin çalıştırılması
- Tercih edilen herhangi bir platformda (örneğin, SurveyMonkey) sıralamaları barındırmak için çevrimiçi bir alan oluşturun. Şuraya bakın: Materyaller Tablosu) sesle teşhis işlemlerini uzaktan yürütmek için.
- Çevrimiçi alan bağlantısına erişin.
- CreateLineup betiğinden dönen dosyaları platforma yükleyin.
- Her adımı test etmek için prosedürü katılımcılardan önce uygulayın.
NOT: Bağlantıya önceden erişilmesi ve her şeyin normal çalışıp çalışmadığını kontrol etmek için dizilimlerin çalıştırılması önerilir.
- İngilizce için dört ve BP için dört ses dizilimi hazırlayın.
- İstatistiksel analiz
- Dinleyicilerin değerlendirme puanlarını içeren hesap çizelgesini R ortamına (veya tercih edilen herhangi bir istatistiksel yazılıma/ortama) yükleyin.
- Kruskal-Wallis testini R'da gerçekleştirin.
- Aşağıdaki komutları yazın ve basın Giriş.
model = kruskal.test(kararlar ~ her biri sesle teşhis dizilimi, veri = şunlar veri çerçevesi)
- Post-hoc Dunn testi uygulayın.
- Dunn testini R'da gerçekleştirin.
- Aşağıdaki komutları yazın ve basın Girin.
library(FSA)
model = dunnTest(kararlar her biri sesle teşhis dizilimi, data = data, method = "Bonferroni")
NOT: 2.3.1.2 ve 2.3.2.2 adımlarındaki kodlar yalancı kodlardır (bkz. NOT 1.4.2.2).
- Dinleyicilerin değerlendirme puanlarını içeren hesap çizelgesini R ortamına (veya tercih edilen herhangi bir istatistiksel yazılıma/ortama) yükleyin.
- Akustik benzerlik analizi
- Hedef ile herhangi bir çeldirici arasında anlamlı fark göstermeyen dizilimleri seçin (bkz. adım 2.2.1.3'teki NOT).
- 1.3.1 ile 1.3.7.5 arasındaki adımların ve 1.3.7.8 ile 1.3.7.10 arasındaki adımların prosedürlerini tekrarlayın.
- Python için betiğe erişin ve indirin49, AkustikBenzerlik_kosinüs_ökrid50 den https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
NOT: Betik üç matris (.txt ve .csv formatlarında) döndürür: biri Kosinüs benzerliği içindir51,52, biri Öklid uzaklığı için52,53ve biri Dönüştürülmüş Öklid uzaklık değerleri için, ayrıca hedef ses ile her bir çeldirici arasında ikili bir karşılaştırma için. - Betiğin, dizilim veri kümesiyle aynı klasöre indirildiğinden emin olun.
- Tıklayın Dosyayı açın… betiği çağırmak için düğme.
- Tıklayın Çalıştır | Hata Ayıklama Olmadan Çalıştır butonlar
NOT: İkinci Çalıştırın buton şu şekilde etiketlenebilir Çalıştır veya Hata Ayıklama Olmadan Çalıştır veya Betik Çalıştır. Hepsi aynı komutları yürütür. Bu durum yalnızca kullanılan Python ortamına bağlıdır. - Akustik özelliklere dayalı ses benzerlik testleri gerçekleştirin.
NOT: Kosinüs benzerliği (veya kosinüs uzaklığı), Yapay Zeka'da (AI), özellikle otomatik konuşma tanıma (ASR) sistemlerindeki makine öğrenmesinde uygulanan bir tekniktir. Sıfır ile bir arasında bir benzerlik ölçüsüdür. Bir'e yakın bir kosinüs benzerliği, iki sesin benzer olma olasılığının oldukça yüksek olduğu anlamına gelir. Sıfıra yakın bir kosinüs benzerliği ise seslerin büyük olasılıkla benzer olmadığını ifade eder.52Genellikle Öklid benzerliği olarak adlandırılan Öklid mesafesi; yapay zeka, makine öğrenimi ve otomatik konuşma tanımada (ASR) da yaygın olarak kullanılır. Bu mesafe, Öklid uzayındaki iki nokta arasındaki doğrusal mesafeyi temsil eder.53yani noktalar ne kadar yakınsa (mesafe değerleri ne kadar düşükse), sesler o kadar benzerdir. Her iki tekniğin rapor edilen sonuçlarının daha net anlaşılması için, Öklid mesafesi ham puanlarını sıfırdan (daha az ses benzerliği) bire (daha fazla ses benzerliği) kadar olan değerlere dönüştürdük54.

Şekil 5: Konuşma algısı için dizin kurulumu. Sıralama klasörleri. Her klasör altı L1 sesi, L2 hedef sesi, "CreateLineup" betiği ve (betik çalıştırıldıktan sonra oluşturulan) ses sıralama ses dosyasını içerir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Konuşma üretimi sonuçları
Bu bölümde, istatistiksel olarak anlamlı prosodik-akustik özelliklerin ve ritim metriklerinin performansını tanımladık. Bu prosodik özellikler; süre ile ilişkili olan konuşma, artikülasyon ve duraklama hızları ile ses kalitesi ile ilişkili olan shimmer'dır. Ritim metrikleri ise hece süresinin standart sapması (SD), konsonantın SD'si, vokalik veya konsonantal sürenin SD'si ve hece süresinin varyasyon katsayısıdır (bkz. Ek Tablo S1).
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Mevcut protokol (adli) fonetik alanında bir yenilik sunmaktadır. İki aşamaya ayrılır: biri üretime dayalı (akustik analiz) ve diğeri algıya dayalı (yargı analizi). Üretim analizi aşaması, istatistiklerin yanı sıra Veri hazırlama ve Zorlamalı hizalama, Yeniden Hizalama ve Prozodik-akustik özelliklerin otomatik olarak çıkarılmasını içerir. Bu protokol, veri toplama aşamasını, ağırlıklı olarak manuel segmentasyona dayalı geleneksel protokollerden daha hızlı ve daha verimli bir şekilde veri analizine bağlar.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarların beyan edecekleri herhangi bir çıkar çatışması yoktur.
Teşekkürler
Bu çalışma, Ulusal Bilimsel ve Teknolojik Kalkınma Konseyi - CNPq tarafından desteklenmiştir, ilk yazar için hibe no. 307010/2022-8 ve ikinci yazar için hibe no. 302194/2019-3. Yazarlar, bu araştırmanın katılımcılarına cömert işbirlikleri ve paha biçilmez katkıları için içten teşekkürlerini sunarlar.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| CreateLineup | Kişisel koleksiyon | # | Ses dizilimleri hazırlığı için praat için komut dosyası |
| Dell I3 (katı hal sürücülü - SSD) | Dell | # | Dizüstü bilgisayar |
| Praat | Paul Boersma & David Weenink | # | Fonetik analiz yazılımı |
| Python 3 | Python Yazılım Vakfı | # | Yorumlanmış, üst düzey, genel amaçlı programlama dili |
| R | : İstatistiksel Hesaplama için R Projesi | # | İstatistiksel hesaplama için programlama dili |
| Shure, Beta, SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | Kişisel koleksiyon | # | Praat için komut dosyası, akustik özelliklerin otomatik olarak çıkarılması için |
| SurveyMonkey, SurveyMonkey | Inc. | # | Ücretsiz özelleştirilebilir anketlerin yanı sıra veri analizi, örnek seçimi, önyargısızlaştırma ve veri temsilini içeren bir dizi arka uç programı bir araya getirin. |
| Tascam DR-100 MKII | Tascam | # | Dijital ses kayıt cihazı |
| Münih Otomatik Segmentasyon Sistemi MAUS | Münih Üniversitesi | # | Ses (.wav) ve dilsel bilgi (.txt) dosyalarının zorla hizalayıcı |
| VVUnitAligner | Kişisel koleksiyon | # | Fonetik birimlerin otomatik olarak yeniden hizalanması ve sonradan işlenmesi için praat için komut dosyası |
Kaynaklar
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Yeniden basım ve izinler
Daha fazla makale keşfet
