Geri bildirim, bilgisayar sistemi aracılığıyla iki NLP anlamsal özelliği ve öğretmenin yazılı geri bildirimi şeklinde sunularak öğrencilerin İngilizce yazı akıcılığını ve doğruluğunu artırdı. Sonuçlar birincisi için olumlu sonuçlar gösterdi.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Derin Sinir Ağı ve Öğretmenlerin Yazılı Değerlendirmesi Yoluyla Otomatik Yazı Değerlendirmesinin İngilizce Yazı Performansı Üzerindeki Etkisini Araştırmak
Bu makalede
Özet
Özet
Bilgisayar destekli dil öğrenme teknolojileri, özellikle yapay zeka (YZE) bağlamında, son birkaç yılda dil öğreniminde en büyük ilerlemeleri sağladı. Otomatik yazma değerlendirmesi (bundan sonra AWE) ve otomatik deneme puanlama (AES) gibi çeşitli teknolojiler vardır; bunlar sadece bilgisayar disiplinlerinde değil, aynı zamanda eğitimde de dil öğreniminin temel taşları olarak kabul edilir. Değerlendirme, yalnızca dil öğrenimini geliştirmede oldukça etkili olan ve bu nedenle ayrıntılı veya derinlemesine geri bildirim sağlayamayan AWE teknolojisi kullanılarak bütüncül puanlar şeklinde yapılabilir. Bir dilin iki ana unsuru (yani Dilbilgisi ve Akıcılık) hakkında ayrıntılı yazı geri bildirimi sağlamak için, sinir ağı modellerini içeren bilgisayar destekli bir uygulama sistemi ve iki anlamsal temelli doğal dil işleme (bundan sonra NLP) yöntemi değerlendirilmiştir. Bu amaçla, İngilizce ikinci dil öğrenen (ESL) olan 90 Pakistanlı üniversite öğrencisi rastgele olarak kontrol, eğitmen geri bildirimi ve deneysel gruplara atandı. Bilgisayar destekli değerlendirme bir sinir ağını kapsıyordu. AWE temel modeli ile notlama yapan eğitmenler arasındaki karşılaştırma testinin sonuçları, bu sinir ağlarını kullanan bilgisayar destekli geri bildirim arasında bir korelasyon olduğunu gösterdi. Bu tür sonuçların sonuçları, özellikle dilsel doğruluk ve akıcılığın zorluk oluşturduğu durumlarda, ESL yazım pedagojisinde yatmaktadır.
Giriş
Yazıda geri bildirim, organizasyon, dilbilgisi, akıcılık, içerik ve mekanik gibi dilin çeşitli özelliklerini ele alır ve böylece öğrencilerin ya yeniden yazmalarını ya da yeni bir metin parçasınıoluşturmasını sağlar 1,2,3. Şu anda, İngilizce yazma öğretmenleri, bilgisayar destekli dil öğreniminin (bundan sonra CALL olarak adlandırılır) ve AWE veya AES şeklinde bilgisayar destekli yazım değerlendirmesi ve yazılı denemelerin notlandırılması sayesinde büyük ölçüde faydalanmıştır. Ayrıca, İngilizce yazısının bilgisayar destekli değerlendirmesi, içerik, dilbilgisi, kelime dağarcığı gibi dilsel unsurlar hakkında tanısal geri bildirim sağlar ve öğrencilerin yazılı metnine zamanında, bireysel ve nesnel yanıtlar verir. AWE sistemi ayrıca, öğrencilere yazılı yanıtlar vererek bu yazılı yanıtlar yoluyla edinilen bilgileri içselleştirmelerini veöğrencilerin bilişsel kapasitesini artırmalarını sağlayabiliyor.
Mevcut çalışma, çok stratejili, bilgisayar tabanlı İngilizce yazı öğrenme kavramını ve analitik puanlama sürecini göz önünde bulundurarak çok stratejili, bilgisayar tabanlı İngilizce yazı öğrenme kavramını sundu. Bu, derin öğrenmeyi yazılı geri bildirime entegre ederek ayrıntılı yazılı geri bildirim puanlaması sunan diğer NLP anlamsal tabanlı modelleri de içeriyordu. Önceki AWE teknolojisinin sınırlamalarını ele alıyor; bu teknoloji yalnızca bütüncü, analitik, spesifik puanlamayı vurgulamamaktadır. Sonuç olarak, öğrenciler arasında İngilizce yazma öğrenimini geliştirmek için dil göstergelerinin bir dizi unsuruna ilişkin tam ve alt ve toplam notlarla doğru ve hemen değerlendirme ile daha çok ilgilidir. Dilbilimin çeşitli özellikleri (yani içerik, karmaşıklık, doğruluk, akıcılık) arasında, bu çalışma sadece Pakistan'daki ESL öğrenenlerin akıcılığını ve dilbilgisel yönünü inceleyecektir. Bu amaçla, mevcut çalışma, öğretmenlerin değerlendirmesi eşliğinde sinir ağlarının kullanılmasını içeren NLP teknolojisi stratejisini önermektedir.
Pakistan dil öğrenme bağlamında, Pakistanlı öğrenciler İngilizce yazmayı öğrenmede sorunlarla karşılaşırlar; öğrenciler İngilizceyi zorunlu ders olarak kabul etmelerine rağmen, 1. sınıftan 14. sınıfa kadar devam ederler. İşte burada yanlış dersler ve dilbilgisini açıklamak için eski yöntemlerin kullanılması gibi birçok faktör ortaya çıkar. Üniversite düzeyinde, öğretmenlerin ders vermesi gereken öğrenci sayısı oldukça yüksektir; çünkü öğrencilerin çeşitli kolej ve okulları içeren çeşitli geçmişleri vardır. Bu durum, öğretmenlerin öğrencilerin yazı hatalarını düzeltmek için çok zaman harcamasına neden olur ve bu da iş yükünü çok artırır. Öte yandan, öğrenciler öğretmenlerin yazılı geri bildirimlerini hafife aldı ve hataları fark edip düzeltmek için çabagöstermedi.
Bir çalışmaya göre, akıcılık çoğunlukla öğrencilerin hata yapmaktan korktuğu için akıcı yazmaya engel olmasından kaynaklanıyor ve bu nedenle öğrenciler düşüncelerle ilgilenmekten daha sık hata yapmaktan kaçınmayı tercih ediyorlar. Urduca dilinin İngilizce yazıya ara sıra müdahalesi ve diğer bağlamsal faktörler de vardır. Ayrıca, Urduca ulusal dil olarak kabul edilir. Bu bağlamsal faktörlerin bir sonucu olarak, öğretmenler her öğrenci yazılı çıktı üretirken veya yazılı makaleleri düzenlediğinde kesin, zamanında ve tutarlı geri bildirim sağlamakta zorlanır. Yazı değerlendirmesi teorisi göz önünde bulundurulduğunda, bu çalışma, geleneksel öğretmen değerlendirmesinin karşılaştırılması sırasında otomatik makine yazısı geri bildirim stratejisi kullanan ve bütünsel puanlama yerine analitik puanlama uygulayarak öğrencilerin iki önemli dilsel boyut (yani dilbilgisi ve akıcılık) hakkında anında geri bildirim almasını sağlayacak çalışmayı takip edecektir.
Farklı endüstriyel AWE ve AES ürünleri ortaya çıkmıştır; bunlar arasında Pigai.org, Bingo English, My Access, E-rater, I-write, Criterion vb. bulunur. AES/AWE, gelişiminin erken aşamasında esas olarak Bayes teoremi10, doğrusal regresyon11 gibi geleneksel makine öğrenimi sistemi ile karakterize edilir. Şu anda, derin öğrenmenin geniş kapsamlı gelişimi, özellikle sinir ağı teknolojisi, tekrarlayan sinir ağları veya RNN12, uzun kısa sürelibellek 13, Konvolüsyon Sinir Ağları (CNN)14, BERTyaklaşımı 15 gibi geri bildirim yazma alanına da dikkat çekici şekilde fayda sağlamıştır. AWE ayrıca NLP16'nın başında kullanılan ön eğitim stratejilerinden faydalar elde etti. Birçok çalışma, öğrenme amacıyla düşmanca örnekler oluşturma, çoklu görev17 ile öğrenme, Kendi Denetim18 ile öğrenme ve GrafikAlgoritmaları 19 gibi sinir ağlarına odaklanan çeşitli çözümleri dikkate almıştır. Bazıları, geri bildirim yazmak için eğitim verisinin eksikliği sorununu ele almak için farklı tekniklerönermiştir 20. Ayrıca, birçok sinir ağı modeline katkıda bulunan puanlamamodelleri de vardır 21.
Dilbilgisel hata düzeltmesi (bundan sonra GEC), NLP görevlerinin bağımsız bir yoludur ve bileşim hatalarını otomatik olarak tespit edip düzeltme kapasitesine sahiptir. GEC'nin görev içeriği, AWE yönleriyle birbiriyle ilişkilidir. AWE görevleri, çoğu doğru biçimde vurgulanması gereken dilbilgisi hatalarının teşhisini dikkate aldığı düşünülür. Ancak AWE çalışmaları GEC'ye daha az dikkat gösterdi ve sadece birkaç araştırma erken GEC modelini AWE teknolojisine entegre etti. Başlangıçta, GEC üzerine yapılan araştırmalar çoğunluklaN-gramı seçer (22), dilmodeli 23 (BERT24 dahil isle) dilbilgisi hatalarını tespit etmek ve düzeltmek için kullanılır. Ancak, yukarıdaki çözümler düzensizlik ve bileşen eksikliği gibi sorunları tamamen çözemedi. Kodlayıcı-dekoder 25'in mimarisi, diğer modellerin daha önce çözemediği sorunları ele alarak GEC'de aynı başarıyı elde etti. Gelişmiş GEC mimarilerinin, Transformer tabanlı yaklaşımlar da dahil olmak üzere sorunları çözmek için birden fazla modelkullandığını belirtmek önemlidir 26.
Farklı çalışmalar, makale yazma değerlendirme konusunda AES'nin insan puanlarına kıyasla verimliliğinidoğruladı 27,28. 29 numaralı bir çalışma, otomatik değerlendirmenin öğrenenlerin İngilizce akıcılığı üzerindeki etkisini gösterdi. Bulgular, otomatik değerlendirmenin İngilizce yazı akıcılığı üzerinde olumlu etkisi olduğunu gösterdi. Buna karşılık, bazı diğerçalışmalar 30AES'in insan derecelerine kıyasla yüksek hata tespit oranını göz ardı etmektedir. Son çalışmalar, dil eğitiminde yazı değerlendirmesinde yapay zeka destekli araçların artan etkinliğini vurgulamaktadır. Bu tür bir çalışma31, Çinli üniversite öğrencilerinin öğrenme bağlamında otomatik notlama ile eğitmenin geri bildirimleri arasında bir karşılaştırma yaptı.
Yapay zeka tabanlı araçların akademik yazıdaki devrim niteliğindeki rolü, son literatürde aktif olarak bildirilmiştir. Yapay zeka destekli yazma araçlarının geleneksel EFL yazma eğitimine ek olarak uygulanmasına ilişkin araştırmalar, teknolojinin başarılı uygulanmasında eşit fırsatların ve proaktif öğretmen desteğinin en önemli öneminivurgulamaktadır 32. AWE'yi inceleyen çalışmalar, örneğin Pigai, bilgisayarların desteği altında verilen geri bildirim ile İngilizce yazma, revizyon ve yeni yazı parçalarının geliştirilmesi arasındaki güçlü korelasyonugösterdi 33. Başka bir çalışma, İngilizce yazma eğitimini olumlu etkileyen ve çeşitli dilbilimsel özelliklere odaklanan derin öğrenmenin daha yüksek seviyeleri hakkında geri bildirim alan varyasyonel otomatik kodlayıcıların (VAE) faydalarınıvurgulamıştır 34. Başka bir araştırma ise, sinir AWE sistemlerinin, derin öğrenmeyi kullanarak anında değerlendirme sağlayan NLP tabanlı GEC ile etkiliolacağını öne sürdü.
Çok ajanlı sistemlerin geliştirilmesi, yazıya yardımcı olan teknolojilerin geliştirilmesinde önemli bir adımdır. Çok ajanlı bir akademik yazı geliştirme asistanı olan bir örnek olarak, derin öğrenmeye dayalı AcademyCraft, yazma ve detaylı geri bildirim verme yeteneklerini göstermiştir; böylece karmaşık analitik şemalar üzerinde yapay zeka tabanlı EFL/ESL yazım desteğinikolaylaştırır 36. Aslında, teknoloji tabanlı dil öğrenme çalışmaları, derin öğrenme, otomatik değerlendirme ve anlamsal geri bildirim gibi çeşitli ortaya çıkan kalıpları da ortaya koymuş; performans analizi, yazı doğruluğunda kademeli ve tutarlı bir artış ile öğrencikatılımını göstermiştir 37.
Transformer-LSTM modelleri, İngilizce yazıya otomatik derecelendirme ve geri bildirim yapma konusunda belirli bir eğilim göstermiştir. Bu tür hibrit mimariler, transformatörlerin bağlamsal anlayışını ve LSTM sistemlerinin ardışık işlemesini karşılıklı olarak birleştirerek, dilbilgisi ve tutarlılık derecelendirmesinde daha iyi bir doğruluk göstererek daha nüanslı geri bildirimüretimi sağladı38. EFL öğretmenlerinin yapay zeka yazma araçlarındaki algısı, içerik organizasyonu ve yazım kalitesinde ölçülebilir iyileşmeler tutarlı bir şekilde rapor eder ve teknolojik entegrasyonun faydasını tetiklemede pedagojik yardımın kritik rolüneodaklanır. Eğitmenlerin geri bildirimi ile bilgisayar destekli geri bildirim arasında karşılaştırma yapan çalışmalar daha azdır; bu da İngilizce İngilizce yazı süreçlerini akıcılık ve dilbilgisi açısından inceleyen derin öğrenme modelleri ima edilmektedir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Çalışmada kullanılan tüm yazılım ve araçlar Materyaller Tablosu'nda listelenmiştir.
Derecelendirme kriterleri
Bu çalışmada kabul edilen değerlendirme sınıflandırması, İngilizce yazının yabancı dil olarak kapsamlı değerlendirilmesi için tüm gereklilikleri içeren akıcılık ve doğruluk olmak üzere iki ana alanı ele almaktadır. Bu boyutlar, yazı kalitesinin temel noktalarını ölçmek için tasarlanmıştır; bu noktalar etkili iletişim ve dil yeterliliğinde beceri gösterisine yardımcı olur. Akıcılık modülü, fikirlerin akıcılığını ve kelimelerin ile cümle yapısının ne kadar iyi kullanıldığını ölçerek yazıda doğallık, ifade edilebilirlik ve tutarlılığı ölçer. Doğruluk modülü, kesin dilbilgisel doğruluğu, mekanik kusursuzluğu ve standart İngilizce kurallarına uyumu hedefler ve varsayımsal olarak dilin hatalılığını birkaç düzeyde ölçüp sayar. ( bkz. Tablo 1)
Görev tanımı
İngilizce öğrenen öğrencilerin otomatik yazma değerlendirme koşullarını takip eden bu çalışma, EG bilgisayar destekli İngilizce yazı değerlendirme sisteminin yeni bir modelini önermektedir. Önceki çalışmalarla karşılaştırıldığında, otomatik yazı değerlendirme sistemlerinin kapsamı nedeniyle sınırlandırılan bu sistem, kullanıcıların dilsel analiz, modifikasyon kapsamı ve veri işleme temelinde sistem çapında geri bildirim analizi seviyesine olanak tanıyan yenilikçi derin öğrenme tekniklerinin tanıtılması yoluyla bu sınırlamaların çözülmesine yardımcı olacaktır. Bir kompozisyonun en önemli iki göstergesi olan akıcılık (eserin ne kadar doğal, tutarlı ve ifade dolu olduğu) veya doğruluk (metnin ne kadar doğru yazılmış, dilbilgisi, mekanik ve dil hatalarıyla dolu) üzerine, sinir ağlarının ayrı bileşenleriyle birlikte çift model sistemi çeşitli değerlendirmeler yapmak zorundadır. Ayrıca, çeşitli dilsel düzeylerde hataları tespit eder, düzeltme önlemleri önerir ve kullanıcıların öğrencilerin dil öğrenimini metodik bir şekilde geliştirmelerini sağlamak için bir liste şeklinde geri bildirim sunar. Bilgisayar destekli otomatik değerlendirme sisteminin hesaplanma sürecini tanımlamak için, (1)–(4) formüllerinde aşağıdaki matematiksel modeli öneriyoruz ( bkz. Tablo 2).
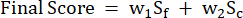 (1)
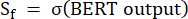 (2)
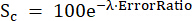 (3)
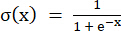 (4)
burada: Final Score = bileşik yazı değerlendirme puanı; w1 = akıcılık puanına verilen ağırlık; w2 = doğruluk puanına verilen ağırlık; Sf = BERT tabanlı akıcılık puanı ([0, 1] olarak normalleştirilmiştir); Sc = üstel çöküş doğruluk puanı; λ = bozulma sabiti kontrol hata cezası; σ(x) = lojistik sigmoid aktivasyon fonksiyonu; ErrorRatio = metindeki hataların toplam tokenlara oranı. Akıcılık puanları, lojistik sigmoid fonksiyonu σ(x) tarafından [0, 1] olarak normalleştirilirken, üstel azalma fonksiyonu doğruluğun puanlanmasında kullanılır ve hata sıklığına uygun bir ceza uygulanır.
Sistem mimarisi ve tasarımı
Sistem mimarisi, girdi denemelerinin analizinin paralel değerlendirme yolları aracılığıyla paralel olarak gerçekleştirildiği paralel işleme mimarisine sahip iki modelli bir sistem kullanır. Akıcılık ve Doğruluk modülleri ise karşılıklı puanları verir ve nihai bileşik puan, iki alt puanın ağırlıklı ortalamasıdır. Doğruluk modülü, puanlamanın yanı sıra hata algılama ve düzeltme konusunda da bir öneri sunar (bkz. Şekil 1).
Akıcılık modülü
Yazma akıcılığı, bir dilin doğru kelime seçimi, cümle yapısı çeşitliliği, sözdizimi karmaşıklığı, tutarlılık vb. açısından kullanılan nitelik veya alışkanlık olarak tanımlanabilir.4. Akıcılık değerlendirme modelleri, fikirlerin skekeme veya garip olmadan aktarıldığını yakalar; bu da yerel iletişim eğilimlerine benzer bir şekilde ses verir. Geleneksel akıcılık ölçümü ölçeklere dayanır ve bu da değerlendiriciler arası güvenilirlik endişelerini vurgular. Önerilen sistem, derin durumsal anlayışla anlamsal tutarlılığı ve dilsel doğallığı otomatik olarak teşvik etmek için BERT tabanlı sinir ağı içerdiği için bu dezavantajı aşmaktadır. Bu mimari karar, akıcılık ölçümünde gerekli olan bağlamsal ilişkilerin ve anlamsal kalıpların tanımlanmasında etkili olduğu bulunan BERT'in güçlü yönleri dikkate alınarak alınmıştır. Giriş dizileri, sisteme beslenir ve uzun menzilli bağımlılıklar ile bağlamsal ilişkileri belirlemek için çoklu başlı öz-dikkatle 12 transformatör katmanından geçirilir ( bkz. Şekil 2).
Dikkat mekanizması şu şekilde olurdu:
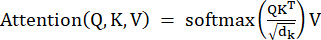 (5)
Q, K ve V sırasıyla sorgu, anahtar ve değeri temsil eden matrisler olsun, d ve k ise anahtar vektörlerin boyutları olsun. CLS token gömü, tüm giriş dizisinin genel anlamsal tutarlılığını kaydeden özetlidir.
Akıcılık puanının hesaplanması şu şekildedir:
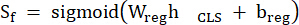 (6)
Burada hCLS BERT [CLS] token gömülmesi, Wreg ise b reg regresyon başının parametreleri ve σ çıktıyı [0, 1] olarak normalize eden sigmoid aktivasyon fonksiyonudur.
Doğruluk modülü
Doğruluk değerlendirmesi, dilbilgisel doğruluğu, mekanik kesinlik ve standart İngilizce geleneklerine uyum üzerine odaklanır. Bu boyut, yazının teknik yönlerini kapsar; sözdizim, morfoloji, noktalama işaretleri ve yazım doğruluğu dahil. Doğruluk bileşeni sadece dilsel hataların sayısını değerlendirmekle kalmaz, aynı zamanda metnin genel kalitesi üzerindeki etkisini de inceler. Anlamsal tutarlılık ve doğal akışı vurgulayan akıcılık değerlendirmesinin aksine, doğruluk değerlendirme modülü hassas hata tanımlaması ve sistematik düzeltme gerektirir. Modül, farklı hata türlerini ayırt eder, şiddetini değerlendirir ve öğrenme gelişimini desteklemek için hedefli düzeltmeler sağlar. Doğruluk kaybı, dilbilgisel hata tespit ve düzeltme için ince ayarlanmış FLAN-T5 modelini kullanır. Bu seçim, sistemin sadece hata bulmakla kalmayıp, aynı zamanda bir sistem içinde ilgili düzeltmeleri de yapmasını sağlayan T5'in metinden metne dönüştürülebilirliğiyle şekillenir. Sistem, kodlayıcı-kodlayıcı biçimidir ve metin bu dönüşüm biçiminde beslenir: ( bkz. Şekil 3)
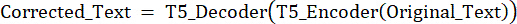 (7)
Kodlayıcı öğesi, yalnızca dilbilgisel eğilimleri değil, aynı zamanda potansiyel başarısızlık alanlarını da yakalayan bağlama duyarlı temsiller üretir:
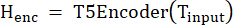 (8)
Yanlış tanımlanan hatalara uygun dilbilgisi varyasyonları üreterek çözümleyici düzeltilmiş dizileri oluşturur:
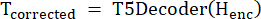 (9)
Bu tür iki yönlü işleme, sistemin hataların bağlamlarının farkında olmasını ve bağlamların nasıl düzeltilmesi gerektiğini bilmesini sağlar; böylece ipuçları anlamsal olarak tutarlıdır ancak dilbilgisindeki herhangi bir düzeltmeye odaklanır.
Hata ve puanlama algoritmasının nicelendirilmesi
Doğruluk puanı, metin içindeki konuma ve anlama müdahaleye dayalı dilsel hatalar ve ciddiyet dikkate alınarak orijinal yazıyı doğru yazı versiyonuyla karşılaştırdı. Bu yöntem, hata türleri arasındaki ayrımı metnin metnin anlaşılması üzerindeki etkiyle karşılaştırır. Hata sıklığı ile metnin kalitesi arasındaki ilişki, notlandırma sisteminde logaritmik bir şekilde vurgulanmıştır. Orijinal metin ile düzeltilmiş metnin token karşılaştırmasında temel bir adım, dizi hizasının bitli tekniğine dayanan iki dereceli karşılaştırmadır. İkinci aşama, bazı bilinen dilsel taksonomilere dayanarak hata türlerinin tanımlanması ve sınıflandırılmasını içerir; bu hatalar dilbilgisel hataları (özne-fiil uyumu, zaman tutarlılığı ve sözdizimi yapısı güvenilirliği), mekanik (büyük harf, noktalama ve yazım) ve kullanım (kelime seçimi, deyimli ifade ve kayıt uygunluğu) hatalarını ayırt eder. Üçüncü aşama, metnin toplam uzunluğuna göre hata oranının hesaplanmasıdır. Dördüncü adım, hata oranlarını doğrudan yorumlanabilir doğruluk puanlarına dönüştüren üstel azalma puanlama algoritmasını kullanır; böylece hata sıklığı ile metin kalitesi arasındaki toplama ve doğrusal olmayan bağımlılığı yaklaşık olarak taklit eder.
Hata niceleme sürecinin matematiksel işlenmesi, kurulan hata oranının hesaplanmasıyla başlar; bu da normalize hata kurulum oranı sağlar ve farklı uzunluktaki metinlerin adil bir karşılaştırmasını sağlar:
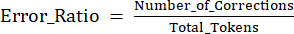 (10)
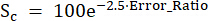 (11)
İnsan uzman görüşleriyle tamamen doğrulanarak ampirik temelde 2.5 kalibrasyon parametresi belirlenmiştir; böylece puanlama fonksiyonu hata sıklığı arttıkça metin kalitesinin azalmasına ilişkin insan anlayışıyla uyumlu sonuçlar sunabilir. Bu parametre değerini bu şekilde ayarlamak, düşük hata oranına sahip (Error_Ratio < 0.1) herhangi bir metnin standart İngilizce kurallarına yakından uyduğu için yüksek doğruluk puanına sahip olmasını sağlar; orta hata oranına sahip (0.1 < Error_Ratio ≤ 0.3) herhangi bir metin, bazı dilsel sorunların doğrudan felaket olmadığını gösteren orta doğruluk puanına sahiptir. ve yüksek hata oranına sahip (0.3 Error_Ratio > metinler, anlama olasılığını önemli ölçüde etkileyen kritik dilsel endişeler nedeniyle düşük doğruluk puanı almıştır.
Doğruluk değerlendirmesi için doğruluk puanlama algoritması, T5 tabanlı sistem tarafından tespit edilen ve düzeltilen tüm hataları nihai hata oranının hesaplanışında ceza maddeleri olarak sistematik olarak dikkate alır. Dilbilgisi hataları için kullanılan ceza kredisi mekanizması, hata oranı büyümesinin yüksek değerlere doğru üstel azalmasıyla temsil edilir; bu da metnin kalitesinin çok düşük olduğu anlamına gelir ve hata oranı 0'a eşit olduğunda 100'e yükselir, yani kesinlikle hiç hata tespit edilmez. İngilizce standart geleneklerinin mükemmel bir kullanımıdır. Böyle bir matematiksel ilişki, doğruluk kodunun dil yeterlilik seviyelerinin tüm yelpazesinde önemli bir ayrım sunmasını ve gerçek kazanımları gösteren küçük ardışık ilerlemelere yanıt vermesini sağlar.
Veri setleri: eğitim ve değerlendirme korpusu
Yeterli kalite ve kapsama sahip eğitim verileri, çift model sistemin performansı için çok önemlidir. Mevcut çalışma, farklı yazım görevleri kullanılarak oluşturulan modeli geliştirmek ve değerlendirmek için iyi tasarlanmış öğrenci metinlerinden oluşan bir veri seti kullandı. Örneklem, ortalama yaşı 19 olan 45 erkek ve 45 kadın Pakistanlı üniversite öğrencisinden oluşuyordu; onlar zorunlu olarak 'Fonksiyonel İngilizce' derslerini okudular. Her öğrenci, ön sınav, müdahale denemeleri ve sınav sonrası etkinlikler dahil olmak üzere sekiz hafta boyunca sekiz deneme yazdı. Öğrencilere her yazma görevi için 400–450 kelime üretme izni verildi. Veri setlerinin istatistikleri aşağıdaki özellikleri sağlar:
70.500 kelime
Ortalama cümle uzunluğu: 15.7 kelime (SD = 3.2)
Kelime dağarcığı aralığı (Tip-Token Oranı): 0.64 (SD 0.08) Dilbilgisel hata yoğunluğu: 100 kelimede 2.3 (SD = 1.1)
Seçilen verilerin gerekçelenmesi ve veri kalitesi güvencesi
Seçilen veri seti, otomatik yazı değerlendirmesi üzerine araştırma çalışmalarının zenginliğini ve alakasını sağlayan birkaç önemli faktörle yönlendirildi. Başlangıçta, Ekonomi öğrenci nüfusu doğası gereği seçildi; bu, Pakistan yükseköğretimindeki EFL öğrencilerine benzer şekilde, gerçek dünya durumlarını yansıtan daha özgün yazı örneklerinin sunulmasını mümkün kılmıştır. İkinci olarak, maksimum ve minimum potansiyel kelime aralığı olan 400–450 kelimenin belirlenmesi, pilot çalışmalar verileriyle bu aralığın dil açısından yeterince karmaşık olduğu ve aynı zamanda tutarlı insan değerlendirmeleri açısından yönetilebilir boyutta kaldığı ortaya çıktı. Her bir kompozisyon, üç eğitimli İngilizce öğretmeni tarafından (dereceleyiciler arası güvenilirlik κ = 0.847, akıcılık boyutu ve 0.823, doğruluk boyutu) tarafından standartlaştırılmış 10 puanlık akıcılık ve doğruluk derecelendirme ölçeklerinde değerlendirildi. İnsan değerlendiricilerin eğitimi titizdi ve IELTS ile TOEFL yazı değerlendirmeleriyle ilgili geliştirilmiş puanlama rubriklerine dayanıyordu. Veriler, insan tarafından notlandırılmış bir veri setinden oluşur ve bu veri seti insan tarafından notlandırılmış veriler üzerinde eğitilmek üzere modellerin eğitilmesi ve doğrulamasında kullanılabilir.
Veri ön işleme ve doğrulama prosedürleri
Veri seti sistematik olarak önceden işlendi ve metin normalizasyonu, metnin BERT WordPiece tokenizer'ı ile tokenize edilmesi ve kalite doğrulama kontrollerinin yapılmasını içeriyordu. Eksik çalışmalar gönderen ve intihal edilmiş metin üretenler veri bütünlüğünü belirlemek için dahil edilmedi. Son veriler, yetkinlik seviyeleri ve görev türleri arasında dengelenmiş olmak için eğitim (%70), doğrulama (%15, n = 41) ve test setleri (%15, n = 40) olarak rastgele olarak ayrıldı. Profesyonel olarak düzenlenmiş akademik metinler, gazete makaleleri ve yayımlanmış makaleler içeren büyük bir referans korpusunun dilsel analizi, yaklaşık 50 milyon kelime oluşturur. Bu korpus, akıcılık testlerini yapmak için gereken dil kalıplarını sağlar ve hata tespit prosedürlerinde standart kullanımla karşılaştırarak yardımcı olur. Referans korpusunda, ön işlem ve indeksleme öncesi adımlar tokenizasyon, konuşma parçası etiketleme, sözdizimi ayrıştırma ve gerçek zamanlı değerlendirme sırasında verimli erişimi kolaylaştırmak için anlamsal etiketlemedir.
Akıcılık modeli eğitim stratejisi
Veriyi akıcılığa ulaşmak için eğitmek için ardışık bir optimizasyon sistemi önerilir. Eğitim, uyarlanabilir öğrenme hızı planlaması, aşamalı grup büyüklüğü ve eğitim ilerledikçe aşırı uyum oluşmasını önleyen gelişmiş düzenleme yöntemleri gibi son teknoloji özellikleri kullandı; böylece modelin dil akıcılığına işaret eden dilsel kalıpları belirlemedeki etkinliğini korudu. Öğrenme hızı, doğrusal bir azalma takvimi ile 5 × 10⁻⁴ olup, yakınsamanın stabil kalmasını ve optimal parametre değerleri etrafında sallanmamasını sağlamak için yapılandırılmıştır. Bu öğrenme hızı, [1 x 10⁻⁶, 1 x 10⁻⁴] içinde ızgara aramasıyla seçilir ve 5 x 10⁻⁵ , yakınsama hızı ile kararlılık arasındaki en uygun ödündür. Gerçek eğitim sadece 3 dönemle sınırlı olacak; bu yapılandırma, doğrulama kaybı takibi ile ampirik faydalar temelinde optimize edilmiş, böylece öğrenmeyi etkili kılacak yeterli parametre güncellemeleri engellemeden aşırı uyum sağlanmasını önlemiştir. Bozulmayı önlemek için mekanizmaların erken durdurulması, 2 dönem sabırla ve minimum 0.001 delta ile gerçekleştirilmiştir.
Optimizasyon, AdamW optimizatörü tarafından gerçekleştirilir ve β₁ = 0.9 (momentum, birinci moment tahminlerinin üstel olarak düşüşünü kontrol eder), β₂ = 0.999 (ikinci moment tahmini, ikinci moment tahminlerinin üstel olarak azalmasını kontrol eder) ve ε = 1 × 10⁻8 (sayısal kararlılık terimi) gibi basitleştirilmiş seçimler yapılır. Ağırlık kaybı düzenlemesi (λ = 0.01), parametre büyüklüklerinin aşırı büyümesini engeller; bu değer aralık genelinde doğrulama performans analiziyle seçilir [0.001, 0.1]. Karmaşık izleme, eğitim boyunca çeşitli metrikleri izleyerek modelin en iyi performansını garanti eder ve aşırı uyumdan kaçınır. İzleme çerçevesine dahil olanlar şunlardır:
Kayıp takibi: Eğitim ve doğrulama kaybı her dönemde takip edilir ve erken durma, doğrulama kaybı ardışık 2 dönemde iyileşmediğinde otomatik olarak gerçekleşir.
Performans metrikleri: Doğrulama verileri, her 100 eğitim adımında tahmin edilen ve gerçek puanlar arasındaki Pearson korelasyon katsayılarının hesaplanmasında kullanılır.
Gradient algılama: Gradyent normları, kaybolan ve patlayan gradyanları tespit etmek için izlenir ve 1.0 gradyan normunda gradyan kırpımı uygulanır.
Öğrenme hızı zamanlaması: Doğrulama tabanlı öğrenme oranı azalması (faktör = 0.5) 1'den fazla dönem platosu tespit edilirse.
Düzenleme ile İlgili: Sistematik ablasyon ile okuldan ayrılma oranları (BERT'ler için 0,1, regresyon başı için 0,3) bulundu. Eğitim sürecinde aşırı uyumu önlemeye dayalı birkaç düzenleme yöntemi kullanılır: (1) ağdaki katman türü için optimize edilmiş ayrılma oranlarıyla kesilme düzenlemesi, (2) yukarıda açıklandığı gibi ağırlık kaybı, (3) doğrulama performansına göre erken durma ve (4) eğitim örneklerinin yüzde 15'ini geri çeviri yöntemleriyle abartmaya dayalı veri artırılması. En iyi performans gösteren modelin kontrol noktaları her dönemden sonra kaydedildi ve en yüksek puan alan modeller doğrulama korelasyon puanlarına göre seçildi. Akıcılık değerlendirme bölümünde kullanılan kayıp fonksiyonu, sürekli akıcılık puanlarını tahmin etme regresyon görevinin ana hedef fonksiyonu olan Ortalama Kare Hata (MSE)'dir. Kayıp formülasyonu matematiksel olarak şu şekilde verilir:
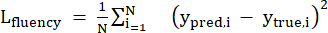 (12)
N, toplam eğitim örneklem büyüklüğüdür, y_pred, i i-ci örneklemin tahmin edilen akıcılık puanıdır ve y_true, i ise insan uzman değerlendiricilerinin verdiği karşılık gelen temel gerçeklik puanıdır. Bu kayıp, tahmin-gerçek hataları ikinci derecede caydırmak için çok faydalıdır; böylece daha büyük hatalar daha büyük bir ceza getirir ve aynı zamanda türevlenebilirdir. Öğrenme hızı zamanlama mekanizması iki aşamalı bir süreçle oldukça gelişmiştir ve doğrusal bir ısınma aşamasıyla başlar, ardından optimal yakınsamaya sahip özellikler oluşturmak için sistematik bir bozulma süreci gelir. Bu, öğrenme hızının sıfırdan başladığı ve kademeli olarak maksimum hıza dönüştüğü ısınma aşamasında yapılır; ardından model parametreleri eğitim veri setine göre optimize edilir. Isınma aşamasının matematiksel ifadesi şudur:
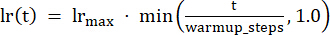 (13)
Isınma aşamasından sonra, öğrenme hızı optimal parametre değerlerinin aşılmasını önlemek için sistematik bir doğrusal şekilde azalır ve sabit yakınsamaya yol açar. Matematiksel olarak, bozulma evresi şöyledir:
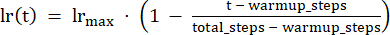 (14)
Burada t mevcut eğitim adımıdır, lr max ısınma sırasında elde edilen maksimum öğrenme hızıdır, warmup ısınma aşamasına atanan adım sayısıdır ve total tüm dönemler boyunca toplam eğitim adım sayısıdır. Bahsedilen zamanlama prosedürü, modelin alt seviyelerde agresif öğrenmesini ve yakınsama seviyelerinde istikrarı sağlar.
Doğruluk modeli eğitim stratejisi
Doğruluk modeli, mevcut tüm dilbilgisi bilgisinden ihtiyaç duyulan şekilde kullanılmak için önceden eğitilmiş FLAN-T5 modelini kullanan transfer öğrenme stratejisine dayanıyordu. Bu, genel dil anlayışını ve ESL öğrenenlerin yaptığı hatalarla ilgili özel bilgileri incelemek amacıyla yapılmıştı. Kullanılan transfer öğrenme yöntemi, temel model olarak pszemraj/flan-t5-large-gramar-synthesis kontrol noktasını kullanır ve doğruluk açısından birkaç kayda değer avantaja sahiptir. Model zaten eğitilmiş ve çeşitli metin alanlarında eğitilmiş yüksek bir dil anlama kapasitesine sahip olduğundan, birçok yazım stiline ve yazım konusuna uyum sağlayacaktır. Özellikle, ikinci dil yazısında karşılaşılan birden fazla dilbilgisi hatasını kapsayan büyük düzeltme veri setlerinde dilbilgisine özgü ince ayar yapılmıştır. Ayrıca, kontrol noktası, farklı hata türlerine (örneğin, morfolojik hatalar, sözdizimi ve anlamsal hatalar) karşı test edilen güçlü hata tespit sistemlerini içerir ve çalışmanın doğuştan gelen düzeltme test parametreleriyle mükemmel bir karşılaştırma standardı oluşturur.
Alan uyarlama süreci, önceden eğitilmiş modelin dil anlayışının genel yeteneklerini değiştirmeyen, ancak yazma değerlendirme görevi çözümünün özel özelliklerini tanıtan sistematik parametre değişikliklerini yansıtır. Bu uyum sürecinin matematiksel türetimi şöyledir:
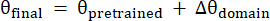 (15)
Burada θönceden eğitilmiş , genel dil anlayışı ve dilbilgisi bilgisini kodlayan önceden eğitilmiş modelin parametrelerini temsil ederken, Δθalanı hedef yazım değerlendirme görevinden öğrenilen özel parametre güncellemelerini temsil eder. Alana özgü güncellemeler, hedef veri seti üzerinde gradyan tabanlı optimizasyonla hesaplanır; bu da modelin EFL yazımda yaygın olan hata türlerine karşı göreve özgü duyarlılık geliştirmesini sağlar ve daha geniş dilsel yeteneklerini bozmaz.
Karşılaştırma deneyleri
EG'nin işlevselliğini kanıtlamak için, Pearson korelasyon katsayısı ölçümün temel değeri olarak önerilmiştir; bu değer otomatik puanlar ile insanların uzmanlığı arasındaki doğrusal bağlantıyı belirler. Korelasyon katsayısı şu formülle bulunur:
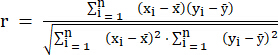 (16)
Burada xi otomatik puanları, insan puanlarını temsil eder ve  ve
 ve ilgili ortalamalardır. Korelasyon katsayısı −1 ile 1 arasında değişir; değerler 1'e yakın olup, otomatik ve insan değerlendirmesi arasında güçlü bir pozitif ilişki olduğunu gösterir.
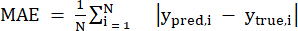 (17)
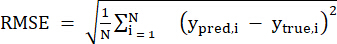 (18)
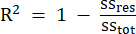 (19)
Temel model karşılaştırmaları
Büyük Mühendisliğin performansını değerlendirmek ve mevcut yöntemlere karşı üstünlüğünü göstermek için, yerleşik AWE ve geleneksel tek metrik yaklaşımlarla derinlemesine karşılaştırmalar yapılır. Bu temel karşılaştırmalar, EG mimarisinin ek değerini doğrulamak ve akıcılık ile doğruluk değerlendirmesinin entegrasyonunun, bireysel boyutlara izole odaklanan yaklaşımlara kıyasla ölçülebilir iyileştirmeler sağladığını göstermek için gereklidir. Temel modellerin seçimi, yazının nasıl değerlendirilmesi gerektiğine dair farklı bir yönelimi yansıtan dört AWE kategorisini kapsar. İlki, akıcılığı değerlendirmek için tek bir BERT tabanlı modele sahiptir. Bu modeller, akıcılık ve tutarlılık metin desenlerini değerlendirmek için transformator mimarileri kullanır. İkinci kategori, geleneksel dilbilimsel metodolojilere yerleşmiş olup, dilbilgisel hata tespiti için kural tabanlı sistemlere odaklanır. Bu nedenle, odak doğruluk üzerinde kaldı ve yazı kalitesiyle ilgili diğer yönler, örneğin uyum ve içerik göz ardı edildi. Üçüncü kategori ise, genel kalite puanları elde etmek için değişken cümle uzunluğu, sözcük çeşitlendirmesi ve sözdizimi karmaşıklığı gibi dilsel karmaşıklık göstergelerini içeren özellik tabanlı AWE sistemleridir. Dördüncü sistem, çeşitli yüzeysel dilsel özellikleri birleştirerek hibrit sistemleri dikkate alır; genellikle topluluk yöntemleri veya ağırlıklı ortalamalar kullanılır. Bu modeller, EG sinir mimarilerinin ulaştığı entegre sofistike seviyesine ulaşamaz. Temel model performansı üç ana boyutla değerlendirilir. İlki, sistem tarafından oluşturulan notların eğitimli insan uzmanlarının (İngilizce eğitmenler) dereceleriyle uyumunu standartlaştırılmış rubrikler kullanarak ölçür. İkincisi ise genellenebilirliği belirler; farklı konulara ve karmaşıklığa sahip üç makalede performansın tutarlı kalıp kalmadığını belirler. Üçüncü boyut, tahmini güvenilirliğe dayanır; ortalama mutlak hata, kök ortalama kare hatası ve güven aralığı analizi gibi istatistiksel araçlarla puanlama doğruluğunu ve kararlılığını değerlendirir. Bu boyutlar topluca, karşılaştırma için sağlam bir çerçeve oluşturur ve EG sistemlerinin üstünlüğünü, özellikle geleneksel yaklaşımlara göre daha fazla hassasiyet ve istikrar sağlama üstünlüğünü vurgular.
Deneysel ve kontrol grupları
Bu çalışma, iki sağlam sınıfta işlevsel bir İngilizce dersi okuyan 90 lisans Ekonomisi öğrencisini içeriyordu. Veriler, yazı doğruluğu ve akıcılıktaki ilerlemeyi izlemek için üç kez alındı: ön test, müdahale ve test sonrası. Bu insan konu çalışması, Pakistan'ın Lahor Kampüsü ISLAMABAD'daki COMSATS Üniversitesi Bölüm Danışma Kurulu tarafından onaylandı. Katılımcılar iki duruma maruz kaldı: geleneksel insan geri bildirimi ve bilgisayar destekli geri bildirim. Kontrol grubu, eğitimli bir İngilizce eğitmeninden geleneksel yazılı geri bildirim alan 45 öğrenciden oluşuyordu. Katılımcılar, öğrencilerin makaleleri hakkında bütünsel notlar, hataların belirlenmesi ve bir eğitmenin çalışmayı nasıl geliştirebileceğine dair yorumlar şeklinde öneriler şeklinde yazılı geri bildirim aldılar. Deneysel grup ise, sınıfta aynı şekilde eğitilen 45 öğrenciden oluşuyordu, ancak öğrencilerin yazımları, hem akıcılık hem de doğruluk açısından yaklaşık 30 saniye içinde tanı bilgisi sağlayan hızlı otomatik geri bildirimle desteklendi.
Bu çalışma, 8 hafta süren bir süre boyunca gerçekleştirildi; burada öğrencilere müdahale edilmeden önce test katılımcılarının ilk yazı performansını belirlemek için ön test (1. hafta) yapıldı. Deneysel grupta NLP anlamsal belirteçleriyle bilgisayar tabanlı geri bildirim ve kontrol grubundaki öğretmenlerin değerlendirmesi katılımcılara altı hafta boyunca verildi. Sonuç olarak, test sonrası (8. haftada) öncesi ve sonrası doğruluk ve akıcılık ölçümleri arasındaki farkı anlamak için gerçekleştirildi. Karşılaştırılabilirlikte benzer sonuçlar elde etmek için, katılımcılardan her değerlendirme döneminde benzer görevleri yazılı olarak üstlenmeleri istendi; böylece yazıdaki görev zorluğu ve içeriğin aşinalığı gibi olası kafa karıştırıcı değişkenleri en aza indirildi. Yazı önerilerinin zorluk seviyesine uygun olmasını sağlamak ve içerik geçerliliğini belirlemek için, yazım önerileri uyumlu şekilde seçilmiştir. Makale konuları, katılımcıların uzun süre benzer bir görevi yapmak zorunda kalmasını önlemek için öğrencilerin çeşitli içerik alanlarını kapsayacağı temelinde seçildi.
Ön sınav aşamasında, katılımcılardan 400–450 kelimelik bir makale yazmaları ve akademik ile kariyer hedefleri hakkında yazmaları istendi. Bu betimleyici ödev, kişisel deneyime ve gelecekteki projeksiyonlara dayanıyordu; bu da yazıyı organize etme, net örnekler sunma ve kişisel hedefler ile motivasyonun mantıklı bir ifadesi sunma ihtiyacını ima ediyordu. Müdahale yazma görevi, günlük yaşam rutini, hobiler, seyahat, üniversitedeki ilk gün, unutulmaz günler ve en yakın arkadaş anları gibi farklı konulara dayanıyordu. Sınav sonrası soru, 'Teknolojinin iletişim üzerindeki etkisi' konusuna bağlıydı ve gereken makale uzunluğu 400–450 kelime idi.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
İstatistiksel yaklaşımın geçerliliği ve güvenilirliği
Sistem, EG'nin yazı gelişimi üzerindeki etkilerine dair kapsamlı kanıtlar sunan çeşitli tamamlayıcı istatistiksel yöntemlerle test edilmiştir. Bu, eğitim müdahalelerinin karmaşık istatistiksel analizlere tabi olduğunu kabul eden çok yönlü bir analitik yöntemdir ve bunun sadece grupların karşılaştırmalarıyla sınırlı kalmayacağını, değişim desenlerinin, etkilerin büyüklüğünün ve çeşitli ölçüm...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Deneysel sonuçlar birkaç önemli başarıyı göstermektedir. İlk olarak, çift model sistem, insan uzman yargılarıyla güçlü bir korelasyon sağladı (r = 0.923), tek model yaklaşımları ve çağdaş AWE sistemlerini önemli ölçüde geride bıraktı. İkinci olarak, kontrollü müdahale çalışması, ESL öğrencilerinin yazı performansında önemli iyileşmeler ortaya koymuştur; büyük etki boyutları (d = 1.28) yakın literatürde bildirilenlerin üzerinde olmuştur. Üçüncü olarak, sistem birden fazla değerlendirme öl...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Tüm yazarlar arasında çıkar çatışması yoktur.
Teşekkürler
Öğrencilerden veri toplamaya yardımcı olan COMSATS Üniversitesi İslamabad, Lahor kampüsü ve İngilizce fakültesinin desteğini takdir ediyoruz.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| YAZILIM / ARAŞTIRMADA KULLANILAN KÜTÜPHANELER | |||
| Derin Öğrenme Çerçevesi | PyTorch | 1.13.1 | Sinir ağı uygulaması için derin öğrenme çerçevesi |
| Ön Eğitilmiş Modeller | Transformers (Sarılma Yüz) | 4.21.3 | Ön eğitilmiş model yükleme, BERT ve T5 model uygulamaları |
| Dil Modeli | BERT (Transformers'dan Çift Yönlü Kodlayıcı Temsilleri) | bert-taban-kılıfsız | Akıcılık değerlendirmesi, anlamsal tutarlılık değerlendirmesi, bağlamsal anlayış |
| Dil Modeli | FLAN-T5 (İnce Ayarlanmış Dil Net T5) | pszemraj/flan-t5-large-gramar-synthesis | Dilbilgisel hata düzeltme, metinden metne dönüşüm, hata tespiti |
| Sayısal Hesaplama | NumPy | 1.23.5 | Sayısal hesaplamalar, matematiksel fonksiyonlar için dizi işlemleri |
| Veri Analizi | Pandalar | 1.5.2 | Veri işleme, istatistiksel analiz ve ön işleme |
| Makine Öğrenimi | Scikit-learn | 1.1.3 | İstatistiksel metrik hesaplama, korelasyon analizi, değerlendirme metrikleri |
| Görselleştirme | Matplotlib | 3.6.2 | Veri görselleştirmesi, eğitim ilerleme grafikleri, performans grafikleri |
| Görselleştirme | Seaborn | 0.12.1 | İstatistiksel veri görselleştirmesi, korelasyon ısı haritaları |
| NLP Araç Seti | NLTK (Doğal Dil Araç Seti) | 3.7 | Metin ön işleme, tokenizasyon, dilsel analiz |
| NLP İşleme | SpaCy | 3.4.4 | İleri NLP ön işleme, POS etiketleme, sözdizimi analizi |
| Tokenizasyon | Tokenizer'lar | 0.13.2 | BERT WordPiece ve T5 tokenizasyonu için hızlı tokenizasyon |
| İSTATISTIK VE ANALIZ YAZILIMI | |||
| İstatistiksel Yazılım | SPSS İstatistiksel Yazılımı | Sürüm 26.0 | İstatistiksel analiz, bağımsız örneklemler t-testleri, ANOVA, korelasyon analizi |
| Eğitim Veri Seti | Kaggle ASAP Veri Seti | 2012 versiyonu | Eğitim korpusu referansı (AWE modellerinin %90'ı bu veri setini kullanır) |
| PYTHON OPTIMIZASYON VE EĞITIM KÜTÜPHANELERI | |||
| Optimizer | torch.optim.AdamW | PyTorch 1.13.1 | Ağırlık azalması düzenlemesi ile model optimizasyonu (λ=0.01), β 1=0.9, β 2=0.999, ε=1× 10⁻⁸ |
| Kayıp / Aktivasyon | torch.nn.functional | PyTorch 1.13.1 | Sigmoid aktivasyon, kayıp fonksiyonları, kesilme düzenlenmesi |
| Veri Yükleme | torch.utils.data.DataLoader | PyTorch 1.13.1 | Progressive batch boyutlandırma (4&nadir; 16), veri yükleme ve toplu çalışma |
| Tokenizasyon | Transformers. AutoTokenizer | Transformers 4.21.3 | BERT WordPiece tokenizasyonu, metin ön işleme |
| Model Yükleme | Transformers. AutoModel | Transformers 4.21.3 | BERT ve T5 mimarileri için önceden eğitilmiş model yüklemesi |
| Gradient Kontrolü | torch.nn.utils.clip_grad_norm_ | PyTorch 1.13.1 | Eğim kesimi (eşik: 1.0) eğitim stabilitesi için |
| LR Programlama | torch.optim.lr_scheduler | PyTorch 1.13.1 | Doğrusal azalma ve ısınma ile öğrenme hızı zamanlaması |
| Metrikler | sklearn.metrics | Scikit-learn 1.1.3 | Pearson korelasyonu, MAE, RMSE hesaplaması değerlendirme için |
| PYTHON SINIR AĞI UYGULAMASI | |||
| Baz Sınıf | torch.nn.Modül | PyTorch 1.13.1 | Özel sinir ağı mimarileri için temel sınıf (Akıcılık & Doğruluk modülleri) |
| Doğrusal Katmanlar | torch.nn.Lineer | PyTorch 1.13.1 | Doğrusal regresyon başlığı uygulaması (768&nadirr; 512→ 256→ 128→ 1 nöron var) |
| Düzenleme | torch.nn.Dropout | PyTorch 1.13.1 | Dropout düzenlemesi (BERT için 0.1, regresyon başı için 0.3) |
| Aktivasyon | torch.nn.functional.sigmoid | PyTorch 1.13.1 | Akıcılık skoru normalizasyonu için Sigmoid aktivasyonu [0,1] |
| Aktivasyon | torch.nn.functional.relu | PyTorch 1.13.1 | Doğrusal olmayan dönüşümler için regresyon katmanlarında ReLU aktivasyonu |
| Transformatör | Transformers. BertModel | Transformers 4.21.3 | Akıcılık değerlendirmesi için çoklu başlı öz-dikkatli 12 transformatör katmanı |
| Seq2Seq | Transformers. T5For ConditionalGeneration | Transformers 4.21.3 | Dilbilgisi hata düzeltmesi için kodlayıcı-kodlayıcı mimarisi |
| Kayıp Fonksiyonu | torch.nn.MSELoss | PyTorch 1.13.1 | Akıcılık regresyon eğitimi için Ortalama Kare Hata kaybı fonksiyonu |
| PYTHON DEĞERLENDIRME VE METRIK KÜTÜPHANELERI | |||
| Korelasyon | scipy.stats.pearsonr | SciPy 1.9.3 | Model-insan anlaşması için Pearson korelasyon katsayısı |
| Hata Metriği | sklearn.metrics.mean_absolute_error | Scikit-learn 1.1.3 | Tahmin doğruluğu için Ortalama Mutlak Hata (MAE) hesaplaması |
| Hata Metriği | sklearn.metrics.mean_squared_error | Scikit-learn 1.1.3 | Hata büyüklüğü değerlendirmesi için Kök Ortalama Kare Hatası (RMSE) |
| İstatistiksel Test | scipy.stats.ttest_ind | SciPy 1.9.3 | Bağımsız örnekler istatistiksel anlamlılık testi için t-testi |
| Korelasyon Matrisi | numpy.corrcoef | NumPy 1.23.5 | Derecelendiriciler arası güvenilirlik için korelasyon matrisi hesaplaması |
| Veri Korelasyonu | Pandalar. DataFrame.corr | Pandas 1.5.2 | Veri korelasyon analizi ve istatistiksel raporlama |
| Görselleştirme | matplotlib.pyplot | Matplotlib 3.6.2 | Performans görselleştirmesi, korelasyon grafikleri, eğitim ilerleme grafikleri |
| Isı haritası | seaborn.heatmap | Seaborn 0.12.1 | Korelasyon matrisi görselleştirmesi ve istatistiksel veri sunumu |
| PYTHON METIN IŞLEME VE NLP KÜTÜPHANELERI | |||
| Metin İşleme | re (Düzenli İfadeler) | Python 3.9+ dahili | Metin deseni eşleştirme, veri temizliği ve ön işleme |
| Yapılandırma İşleme | JSON | Python 3.9+ dahili | Yapılandırma dosyası işleme, model parametre depolama |
| Serileştirme | turşu | Python 3.9+ dahili | Model serileştirme ve kontrol noktası kaydetme/yükleme |
| İlerleme Takibi | tqdm | 4.64.1 | Eğitim döngüleri ve veri işleme için ilerleme çubukları |
| Kütük Kesim | Kayıt | Python 3.9+ dahili | Eğitim ilerleme kaydı, hata takibi ve hata ayıklama |
| Tekrarlanabilirlik | rastgele | Python 3.9+ dahili | Tekrarlanabilir deneyler için rastgele tohum ayarı |
| Dosya Sistemi | os | Python 3.9+ dahili | Dosya sistemi işlemleri, model yolu yönetimi |
| CLI Ayrıştırma | argparse | Python 3.9+ dahili | Eğitim yapılandırmaları için komut satırı argüman ayrıştırma |
| TİCARET AWE / AES PLATFORMLARI (Referanslı) | |||
| Ticari Platform | Pigai.org | Ticari AWE platformu | Çin İngilizcesi İngilizce yazma değerlendirmesi, otomatik geri bildirim sistemleri |
| Ticari Platform | Bingo İngilizce | Ticari AWE sistemi | İngilizce dil öğrenme desteği, yazma becerisi gelişimi |
| Eğitim Platformu | Erişimim | Eğitim yazarlığı platformu | Öğrenci yazı değerlendirmesi ve geri bildirim sunumu |
| Puanlama Motoru | E-derecelendirme | ETS otomatik puanlama motoru | Standart sınav denemesi puanlama, bütünsel değerlendirme |
| Değerlendirme Aracı | I-yazıyorum | Yazı değerlendirme aracı | Akademik yazı değerlendirmesi ve tanısal geri bildirim |
| Uygulama Hizmeti | Kriter | ETS yazma uygulama hizmeti | Yazma becerisi geliştirme ve otomatik geri bildirim |
| Yapay Zeka Dil Modeli | ChatGPT | OpenAI dil modeli | YZ destekli yazım geri bildirimi ve değerlendirme (literatürde referans verilmiştir) |
| DERİN ÖĞRENME MİMARİZELERI (Literatürde Referans Gösterilmiştir) | |||
| Mimari | Tekrarlayan Sinir Ağları (RNN) | Cai, 2019 | Ardışık metin işleme — Geri bildirim sistemleri yazma ve otomatik değerlendirme |
| Mimari | Uzun Kısa Süreli Hafıza (LSTM) | Jin ve ark., 2018 | Uzun menzilli bağımlılık modellemesi & mdash; Otomatik Deneme Puanlama ve Dizi Analizi |
| Mimari | Konvolüsyon Sinir Ağları (CNN) | Dong ve ark., 2017 | Yerel desen tanıma & mdash; Metin sınıflandırması ve puanlama için özellik çıkarımı |
| Mimari | Transformer-LSTM Hibrit | Xuan, 2025 | Birleşik bağlamsal ve ardışık işleme — Otomatik puanlama ve geri besleme üretimi |
| Mimari | Varyasyonel Otomatik Kodlayıcılar (VAE) | Kumar ve ark., 2024 | Üretken modelleme & mdash; Gelişmiş yazma becerisi gelişimi ve kişiselleştirilmiş geri bildirim |
| Mimari | Çok Ajanlı Sistemler | Thompson ve ark., 2024 | İşbirlikçi yapay zeka işleme ve çalışma; gelişmiş yazma desteği (AcademiCraft platformu) |
| Mekanizma | Dikkat Mekanizmaları | Dong ve ark., 2017 | Kendine dikkat ve çoklu kafa ilgisi ve mdash; geliştirilmiş AES performansı ve bağlamsal anlayış |
| MÜZEKLİ MAKINE ÖĞRENİŞİ TEKNİKLERİ (Referanslı) | |||
| İstatistiksel Yöntem | Bayes Teoremi | Rudner & Liang, 2002 | Geleneksel ML yaklaşımı — erken AES/AWE geliştirme ve olasılıksal puanlama |
| İstatistiksel Yöntem | Doğrusal Regresyon | Phandi ve ark., 2015 | İstatistiksel modelleme & mdash; Özellik Tabanlı Yazım Değerlendirmesi ve Puan Tahmini |
| Öğrenme Yöntemi | Sıralama Tercihi Öğrenimi | Chen & O, 2013 | Sıralama tabanlı metodoloji & mdash; Karşılaştırmalı makale puanlama ve tercih modelleme |
| Dil Modeli | N-gram modelleri | Xie ve ark., 2015 | İstatistiksel dil modellemesi & mdash; Dilbilgisel Hata Düzeltme ve Desen Tanıma |
| Mimari | Kodlayıcı-Kodlayıcı Mimarisi | Ge ve ark., 2018 | Dizi-diziye modelleme & mdash; Dilbilgisel Hata Düzeltme ve Metin Dönüşümü |
| DEĞERLENDIRME STANDARTLARI VE ÇERÇEVELERI | |||
| Değerlendirme Standardı | IELTS Yazı Değerlendirmesi | Puan değerlendirme rubrik uyarlaması | Akıcılık ve doğruluk için standart değerlendirme kriterleri |
| Değerlendirme Standardı | TOEFL Yazı Değerlendirmesi | Akademik yazım standartları | Yeterlilik değerlendirmesi ve standartlaştırılmış puanlama |
| İstatistiksel Ölçüt | Cohen'in d Etkisi Boyutu | 0.2=küçük, 0.5=orta, 0.8=büyük | Müdahale etkinliği için pratik önem değerlendirmesi |
| Güvenilirlik Ölçümü | Dereceler arası Güvenilirlik (κ) | Akılık: 0.847 / Doğruluk: 0.823 | Kappa katsayısı & dash; İnsan Değerlendirici Tutarlılığı ve Anlaşma Doğrulaması |
Kaynaklar
- Bitchener, J. Evidence in support of written corrective feedback. J Second Lang Writ. 17 (2), 102-118 (2008).
- Nusrat, A., Ashraf, F., Narcy-Combes, M. F. Effect of direct and indirect teacher feedback on accuracy of English writing: A quasi-experimental study among Pakistani undergraduate students. 3L Lang Linguist Lit. 25 (4), 84-98 (2019).
- Nusrat, A., Khan, S., Kashif, F., Fawad, R. Effect of teachers’ asynchronous e-feedback and synchronous oral feedback on English language learners’ writing accuracy. Front Educ. 7, 783684 (2022).
- Chen, B., Bao, L., Zhang, R., Zhang, J., Liu, F., Wang, S., et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: A writing feedback perspective. J Educ Comput Res. 61 (8), 60-102 (2024).
- Li, J., Link, S., Hegelheimer, V. Rethinking the role of automated writing evaluation (AWE) feedback in ESL writing instruction. J Second Lang Writ. 27, 1-18 (2015).
- Ellis, R. Explicit form-focused instruction and second language acquisition. The handbook of educational linguistics. , 437-455 (2008).
- Shamim, F. Trends, issues and challenges in English language education in Pakistan. Asia Pac J Educ. 28 (3), 235-249 (2008).
- Haider, G. An insight into difficulties faced by Pakistani student writers: Implications for teaching of writing. J Educ Soc Res. 2 (3), 17-27 (2012).
- Nawaz, M., Hussain, S. A., Bughio, F. A. Exploring the preferred corrective feedback and practiced corrective feedback among Pakistani ESL secondary school students and teachers in writing class: Matches and mismatches. Int J Lang Lit Transl. 6 (1), 31-45 (2023).
- Rudner, L. M., Liang, T. Automated essay scoring using Bayes theorem. J Technol Learn Assess. 1 (2), 1-22 (2002).
- Phandi, P., Chai, K. M. A., Ng, H. T. Flexible domain adaptation for automated essay scoring using correlated linear regression. , 431-439 (2015).
- Cai, C. Automatic essay scoring with recurrent neural network. , 1-7 (2019).
- Jin, C., He, B., Hui, K., Sun, L. TDNN: A two-stage deep neural network for prompt-independent automated essay scoring. 1, 1088-1097 (2018).
- Dong, F., Zhang, Y., Yang, J. Attention-based recurrent convolutional neural network for automatic essay scoring. CoNLL. , 153-162 (2017).
- Sharma, A., Kabra, A., Kapoor, R. Feature enhanced capsule networks for robust automatic essay scoring. , 365-380 (2021).
- Mim, F. S., Inoue, N., Reisert, P., Ouchi, H., Inui, K. Corruption is not all bad: Incorporating discourse structure into pre-training via corruption for essay scoring. IEEE ACM Trans Audio Speech Lang Process. 29, 2202-2215 (2021).
- Cummins, R., Rei, M. Neural multi-task learning in automated assessment. arXiv. , 1-9 (2018).
- Cao, Y., Jin, H., Wan, X., Yu, Z. Domain-adaptive neural automated essay scoring. , 1011-1020 (2020).
- Jiang, Z., Liu, M., Yin, Y., Yu, H., Cheng, Z., Gu, Q., et al. Learning from graph propagation via ordinal distillation for one-shot automated essay scoring. , 2347-2356 (2021).
- Li, X., Chen, M., Nie, J. Y. SEDNN: Shared and enhanced deep neural network model for cross-prompt automated essay scoring. Knowl Based Syst. 210, 106491 (2020).
- Beseiso, M., Alzubi, O. A., Rashaideh, H. A novel automated essay scoring approach for reliable higher educational assessments. J Comput High Educ. 33 (3), 727-746 (2021).
- Xie, W., Huang, P., Zhang, X., Hong, K., Huang, Q., Chen, B., et al. Chinese spelling check system based on an n-gram model. , 128-136 (2015).
- Brockett, C., Dolan, W. B., Gamon, M. Correcting ESL errors using phrasal SMT techniques. , 249 (2006).
- Zhang, S., Huang, H., Liu, J., Li, H. Spelling error correction with soft-masked BERT. , 882-890 (2020).
- Ge, T., Wei, F., Zhou, M. Reaching human-level performance in automatic grammatical error correction: An empirical study. arXiv. , 1-15 (2018).
- Zhao, W., Wang, L., Shen, K., Jia, R., Liu, J. Improving grammatical error correction via pre-training a copy-augmented architecture with unlabeled data. 1, 156-165 (2019).
- Shermis, M. D., Koch, C. M., Page, E. B., Keith, T. Z., Harrington, S. Trait ratings for automated essay grading. Educ Psychol Meas. 62 (1), 5-18 (2002).
- Mizumoto, A., Shintani, N., Sasaki, M., Teng, M. F. Testing the viability of ChatGPT as a companion in L2 writing accuracy assessment. Res Methods Appl Linguist. 3 (2), 100116 (2024).
- Ajabshir, Z. F., Ebadi, S. The effects of automatic writing evaluation and teacher-focused feedback on CALF measures and overall quality of L2 writing across different genres. Asian Pac J Second Foreign Lang Educ. 8 (1), 26 (2023).
- Almusharraf, N., Alotaibi, H. An error-analysis study from an EFL writing context: Human and automated essay scoring approaches. Tech Knowl Learn. 28 (3), 1015-1031 (2023).
- Chen, H., Pan, J. Computer or human: A comparative study of automated evaluation scoring and instructors' feedback on Chinese college students' English writing. Asian Pac J Second Foreign Lang Educ. 7 (1), 34 (2022).
- Liu, X., Zhang, Y., Chen, L. The transformative impact of AI-powered tools on academic writing: Perspectives of EFL university students. Lang Learn Technol. 28 (2), 78-95 (2024).
- Zhang, Q., Li, F. From process to product: Writing engagement and performance of EFL learners under computer-generated feedback instruction. System. 115, 102998 (2023).
- Kumar, S., Patel, R., Williams, T. Automated deep learning approaches in variational autoencoders (VAEs) for enhancing English writing skills. J Educ Technol Res. 45 (3), 234-251 (2024).
- Martinez, A., Rodriguez, P., Thompson, K. Neural automated writing evaluation with corrective feedback. Comput Linguist. 50 (1), 123-145 (2024).
- Thompson, J., Anderson, C., Davis, R. AcademiCraft: Transforming writing assistance for English for academic purposes with multi-agent system innovations. Artif Intell Educ. 12 (4), 445-462 (2024).
- Rodriguez, M., Kim, S., Brown, D. Technology-enhanced language learning in English language education: Performance analysis, core publications, and emerging trends. Appl Linguist Rev. 15 (2), 201-225 (2024).
- Xuan, Y. Transformer-LSTM models for automatic scoring and feedback in English writing assessment. IEEE Access. 13, 82084-82096 (2025).
- Anderson, R., Smith, K., Johnson, M. The impact of AI writing tools on the content and organization of students' writing: EFL teachers' perspective. Comput Educ. 195, 104712 (2023).
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.