Bu çalışma, iki farklı veri setinde duygu tanıma doğruluğunu artırmak için transformer kodlayıcılarından, ayrıklaştırılmış duygu temsillerinden ve görsel eşleme ile grafik tabanlı çapraz modlu dikkat mekanizmasından yararlanan, uçtan uca çok modlu bir duygu analizi çerçevesi önermektedir.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Akıllı Etkileşim Tasarımı için Multimodal Duygu Özelliklerinin Görsel Haritalandırılması
Bu makalede
Özet
Özet
Makinelerin insan etkileyiş durumlarını anlamasını, yorumlamasını ve bunlara tepki vermesini sağlayan çok modlu duygu özelliklerinin görsel eşlemesi, akıllı arayüz tasarımı için kritik öneme sahiptir. Bununla birlikte, mevcut çok modlu duygu tespit algoritmaları temel olarak öngörücü performansa odaklanmakta; yorumlanabilirlik, etkileşim farkındalığı veya özellik düzeyindeki çapraz mod etkileşimleri hakkında çok az bilgi sunmaktadır. Bu çalışma; etkileşim odaklı görselleştirme, yorumlanabilir temsil öğrenimi ve duygu öngörüsünü birleştiren çok modlu duygu yönlerinin görsel eşlemesi için bir çerçeve sunmuştur. Manuel olarak oluşturulmuş özellikler kullanılmadan; metinsel, işitsel ve görsel modalitelerden üst düzey duygu gömmelerini çıkarmak için transformer tabanlı kodlayıcılar kullanılmıştır. Dayanıklılığı artırmak amacıyla, ayrıştırılmış temsil öğrenimi tekniği kullanılarak duyguya özgü ve modaliteye özgü bilgiler birbirinden ayrılmıştır. Ayrıca, modaliteler arasındaki ince duygusal ilişkileri simüle etmek için adaptif dikkat ağırlıklandırmasını kullanan grafik tabanlı bir çapraz mod dikkat ağı oluşturulmuştur. Şeffaflığı artırmak amacıyla zamansal duygu yörüngelerini, çapraz mod dikkat dağılımlarını ve gizli duygu gömmelerini betimlemek için çok görünümlü bir görsel eşleme modülü oluşturulmuştur. Önerilen çerçeveyi değerlendirmek için Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) veri seti ve Chinese Multimodal Sentiment Analysis Dataset (CH-SIMS) kullanılmıştır. Deneysel sonuçlara göre, önerilen çerçeve; doğruluk, F1-skoru, korelasyon ve ortalama mutlak hata açısından temsilci temel tekniklerden tutarlı bir şekilde daha iyi performans gösterirken, gelişmiş özellik düzeyinde yorumlanabilirlik ve etkileşim farkındalıklı görselleştirme sağlamıştır. Ek olarak, görsel eşleme modülü; çok modlu duygu temsillerinin, çapraz mod etkileşimlerinin ve zamansal duygu dinamiklerinin kalitatif yorumlanmasını kolaylaştırarak etkileşim farkındalıklı görselleştirme ve analizi desteklemiştir.
Giriş
İnsan duygularını doğru şekilde tanımlama ve anlama yeteneği, insanlar ve makineler arasındaki etkileşimi geliştirmek için kritik hale gelmiştir. Duygu analizi, insan-bilgisayar etkileşimini geliştirmenin yanı sıra; ön tanı tıbbi teşhis1, sınıf içi davranış analizi2, hasta psikolojik takibi3, araçlarda yorgunluk tespiti4 ve akıllı ev ortamlarında akıllı yönetim5 dahil olmak üzere birçok alanı devrimcileştirme potansiyeline sahiptir. Duygusal hesaplama ve derin öğrenmedeki6 son gelişmeler, insan duygularının karmaşıklığını yakalayabilen gerçek zamanlı sistemler oluşturmaya olan ilgiyi artırmıştır.
Güncel yöntemlerin çoğu öncelikle metinsel, grafiksel veya işitsel işaretler gibi tek modlu verilere dayanmaktadır7,8,9. Bu yaklaşımlar, iğneleme veya bağlama özgü nüanslar gibi incelikli sinyalleri tespit etmede defalarca başarısız olmuştur. Araştırmalar, bu kısıtlamaların üstesinden gelmek için birden fazla kaynaktan gelen tamamlayıcı verileri birleştiren çok modlu duygu değerlendirmesine yönelmiştir10,11,12. Birden fazla modun birleştirilmesinin avantajları; erken füzyon-uzun kısa süreli bellek (EF-LSTM)13, hafif ve FM derin sinir ağları (LF-DNN)14, tensör füzyon ağları (TFN) ve düşük dereceli çok modlu füzyon yaklaşımları gibi temel modellerle gösterilmiştir. Ancak, bu yaklaşımların çoğu çevrimdışı özellik üretimine dayanmakta olup dinamik, gerçek dünya durumları için uygun değildir.
Duygusal durumları kapsamak adına, çok modlu duygu tanımlama araştırmaları ve uygulamaları son on yıl içinde artış göstermiştir15. Günümüzde araştırmaların en zorlu ve önemli alanlarından biri, çeşitli veri kaynakları kullanılarak duygusal durumların sürekli izlenmesidir16. Çok modluluk fikri, bu denli çeşitli bir bilgi sisteminin ortaya çıkışıyla oldukça doğal bir şekilde gelişmiş ve duygusal hesaplama, insan-bilgisayar etkileşimi (HCI), öğrenme, video oyunları, tüketici hizmetleri, tıbbi bakım, kullanıcı deneyimi (UX) değerlendirmesi vb. gibi alanlarda duyguların uygulanmasında birçok ilerlemeye yol açmıştır. Ancak, duygu tanıma tekniklerini UX değerlendirmesinde uygulamak her zaman bu kadar basit olmamıştır.
Tek modlu yöntemler yerine çok modlu tanımaya odaklanmanın temel nedenlerinden biri, tek bir bilgi kaynağına güvenmenin beraberinde getirdiği doğal dezavantajlardır. Tek modlu duygu tespit sistemleri, eksik veya belirsiz veriler nedeniyle daha düşük doğruluk oranlarından muzdarip olabilirken; MER şemaları, birden fazla veri kaynağını entegre ederek daha güvenilir bir yapı sunmakta ve dışavurumcu durumların daha kapsamlı ve derinlemesine bir şekilde anlaşılmasını sağlamaktadır17. Örneğin, özellikle jestlerin karmaşık veya belirsiz olduğu durumlarda, sadece yüz dili duyguları kesin olarak sınıflandırmak için yeterli olmayabilir. Öte yandan, yüz ifadelerinin dil veya fiziksel ipuçları gibi diğer iletişim biçimleriyle birleştirilmesi, duygu tanıma doğruluğunu artırabilir.
Duygu tanıma üzerine birçok farklı modalite üzerinde kapsamlı araştırmalar yapılmıştır. İlk çalışmalar; grafik, akustik veya metin tabanlı girdiler gibi farklı modalitelerden ayırt edici özelliklerin belirlenmesine odaklanmıştır. Çeşitli modalitelerin entegrasyonunun, daha güvenilir ve hassas bir duygu tespitine olanak tanıyan dengeli duygusal bilgiler sağlayabildiği giderek daha belirgin hale gelmektedir. Bu bölüm; temel yaklaşımlara, bunların eksikliklerine ve yöntemimizin gerekçelerine odaklanarak, tek modaliteli ve multimodal duygu analizindeki temel gelişmeleri incelemektedir.
Duygu tanıma üzerine yapılan ilk çalışmalar öncelikle tek bir modaliteye odaklanmıştır. Görsel alanda, çığır açan araştırmalar prototipik yüz hareketlerinin kategorizasyonuna yol açmıştır20. Sonraki ilerlemeler, görsel hareket21 ve gizli Markov modelleri22 gibi zamansal dinamikleri yakalamaya yönelik teknikleri içerirken; yüz tepkileri, Yüz Eylem Kodlama Sistemi (FACS)23 kullanılarak eylem birimlerine ayrılmıştır. LSTM'ler ve evrişimli sinir ağları (CNN'ler), anlamlı özellikleri doğrudan ham ses sinyallerinden çıkarmak için başarıyla kullanılmıştır; ses tabanlı duygu tanımlama metodolojileri, geleneksel sinyal işlemeden derin öğrenmeye doğru evrilmiştir24. Metin tabanlı duygu analizinde bağlamsal duygu sinyallerinin çıkarımı, dikkat mekanizmalarını içeren tekrarlayan sinir ağları (RNN'ler) ve daha yakın zamanda transformer tabanlı modeller ile büyük ölçüde geliştirilmiştir. Başarılarına rağmen, tek modlu teknikler, diğer modlarda bulunan tamamlayıcı bilgilerden yoksun oldukları için insanların deneyimlediği karmaşıklıkları doğru bir şekilde temsil etme konusunda doğuştan yetersizdir.
Konuşma tabanlı duygu belirleme alanında, daha uzun vadeli çevresel verileri toplamak amacıyla 2021 yılında DialogXL model25 gibi bazı dikkat mekanizması tabanlı modeller önerilmiştir. Kim ve ark.26, ERC doğruluğunu artırmak için 2021 yılında EmoBERTa modelini tanıtmıştır. Bu model, konuşmalardaki konuşmacıların özelliklerini ve birbirleriyle olan etkileşimlerini geliştirmek için konuşmacı verilerini kullanmaktadır. 2022 yılında Li ve ark.27, CoG-BART yöntemini sunmuştur. Bu yapı, modelin ilgili verileri yorumlama yeteneğini geliştirmek için denetimli karşıtlaştırmalı öğrenme kullanmaktadır. Denetimli öğrenmenin önemli miktarda etiketlenmiş veri gerektirdiği belirtilmelidir.
Bu tür çalışmaların tipik bir örneği, modaliteler arası genelleştirmeyi geliştirmek için özellik etkileşim belirteçleri ve kontrastif hizalama kullanan Çok Modlu Etkileşim Duyarlı Temsil (MIAR) çerçevesidir28. MIAR, modalite hizalamasını iyileştirir ve birden fazla veri setinde güçlü bir performans sergiler; ancak, görsel eşleme konusuna değinmeden temel olarak öngörü doğruluğuna odaklanır. Benzer şekilde, Çapraz Dikkatli Sesli-Görsel Füzyon modeli29, valans ve uyarılma öngörüleri için ince taneli sesli-görsel etkileşimleri etkili bir şekilde yakalar, fakat iki modalite ile sınırlıdır ve görselleştirme yeteneklerinden yoksundur. LSTM ağlarına ve otokodlayıcı füzyonuna dayalı zamansal modelleme yaklaşımları, duyguların zamansal dinamiklerini başarıyla yakalasa da modalite etkileşimleri ve öğrenilen duygusal temsiller hakkında sınırlı bilgi sağlar. Daha yakın zamanda, Transformer tabanlı Çok Modlu Füzyon Ağı (TMFN)30 gibi Transformer tabanlı yöntemler, gelişmiş çok modlu füzyon ve kontrastif öğrenme yoluyla CMU-MOSI ve CMU-MOSEI üzerinde güçlü performans göstermiştir. Buna rağmen, bu yaklaşımlar temel olarak performans odaklı kalmaya devam etmekte olup açıklanabilirlik, özellik düzeyinde yorumlama ve etkileşim odaklı görselleştirme için sınırlı destek sunmaktadır.
Metinsel, akustik ve görsel verilerin entegrasyonunu geliştirmek amacıyla çeşitli çok modlu duygu tanıma teknikleri önerilmiştir. EF-LSTM ve LF-DNN gibi erken füzyon teknikleri, karmaşık modlar arası etkileşimleri yakalayamasalar da duygu ve his analizi için çok modlu bilgilerin kullanılmasının avantajlarını ortaya koymuşlardır. TFN, CMU-MOSI ve CMU-MOSEI gibi kıyaslama veri kümeleri üzerindeki performansı artırıp modlar arası etkileşimlerin açık modellemesini sunmuş olsa da, sınırlı yorumlanabilirliği ve yüksek hesaplama karmaşıklığı kullanışlılığını kısıtlamıştır. Modalite hizalamayı ve dinamik özellik füzyonunu iyileştirmek için MIAR, çapraz dikkatli füzyon modelleri, TMFN ve adaptif çok modlu transformerlar gibi daha modern teknikler, transformer topolojileri ve dikkat mekanizmaları kullanmışlardır. Bu yöntemler, doğruluk, F1-skoru ve ortalama mutlak hata gibi yaygın değerlendirme metriklerinde rekabetçi sonuçlar elde etmelerine rağmen, öncelikle öngörücü performansa odaklanmış; özellik düzeyindeki duygusal temsiller ve modlar arası bağımlılıklar hakkında çok az bilgi sunmuşlardır. Ayrıca, gizli duygu gömmelerini, dikkat dağılımlarını ve zamansal duygu dinamiklerini ortaya çıkarabilen görselleştirme teknikleri geliştiren veya modlar arası etkileşimlerin grafik tabanlı modellemesini entegre eden çalışma sayısı oldukça azdır. Önerilen yaklaşım; bu eksiklikleri gidermek ve çok modlu duygu tanıma performansını artırmak için çok görünümlü görsel eşleme, grafik tabanlı çapraz modal dikkat füzyonu ve ayrıştırılmış temsil öğrenimini bünyesinde barındırmaktadır.
Benzer şekilde, Adaptif Çok Modlu Transformer32, gürültülü veya eksik modallik bilgilerini adaptif olarak azaltmak ve böylece duygu sınıflandırma performansını artırmak için değişim tabanlı füzyon önermektedir. Bu yaklaşım, modal bilgi dağılımındaki tutarsızlıkları etkili bir şekilde giderebilse de, tasarımı duygu analiziye özeldir ve öğrenilen duygusal temsiller hakkında sınırlı bilgi sunar. Bir diğer önemli katkı ise, gerçek zamanlı çok modlu duygu tanıma için CNN'leri, multiplikatif LSTM'leri ve transformer tabanlı dikkat mekanizmasını entegre eden Çok Modlu Füzyon Modeli'dir33. Model; video, ses ve metin modaliteleri üzerinde tam füzyon gerçekleştirmekte ve güçlü bir tanıma performansı sergilemektedir. Bununla birlikte, diğer mevcut modeller gibi, öncelikle öngörücü doğruluğa odaklanmakta olup görselleştirme ve etkileşim odaklı yorumlanabilirlik için açık özelliklerden yoksundur.
Sonuç olarak, güncel durumdaki son teknoloji çok modlu duygu tanıma yaklaşımları, modlar arası etkileşimleri yakalamada ve tahmin doğruluğunu artırmada önemli başarılar elde etmiş olsa da, bunların çoğu tanıma odaklı görevlere yoğunlaşmıştır. Özellik düzeyinde yorumlanabilirlik, duygusal temsillerin görüntü alanında görselleştirilmesi ve akıllı etkileşim tasarımı için önerilen çerçevenin entegre edilmesi alanları çok az ilgi görmüştür. Önerilen çerçeve, bu zorluklar göz önünde bulundurularak sunulmuştur.
Çok modlu duygu tanımadaki kayda değer ilerlemelere rağmen28,29, mevcut yöntemlerin çoğu, öğrenilen duygusal temsillerin ve modlar arası etkileşimlerin yorumlanabilirliğini çok az sunarak öncelikle öngörücü performansı artırmaya odaklanmaktadır. Metinsel, akustik ve görsel modlar arasındaki karmaşık etkileşimlerin, özellikle modalite farklılıkları ve bilgi eksiklikleri meydana geldiğinde, mevcut füzyon stratejileri tarafından modellenmesi sıklıkla zordur 28,31. Transformer tabanlı tasarımlar ve dikkat mekanizmaları temsil öğrenimini geliştirmiş olsa da, duyguya özgü ve modaliteye özgü bilgilerin açıkça ayrıştırılmamış olması nedeniyle şeffaflıkları ve yorumlanabilirlikleri genellikle azalmaktadır31,32,33. Ek olarak, intermodal etkileşimlerin graf tabanlı modellenmesini araştıran veya zamansal duygu dinamiklerini, dikkat dağılımlarını ve duygu gömmelerini ortaya çıkarabilen görselleştirme çerçeveleri oluşturan çalışma sayısı oldukça azdır. Bu dezavantajlar, etkileşim odaklı görsel eşlemeyi güçlü bir çapraz modal öğrenimle birleştiren, akıllı insan-makine etkileşimi için yorumlanabilir bir çok modlu çerçevenin gerekliliğini ortaya koymaktadır.
Bu çalışma, akıllı arayüz tasarımında çok modlu duygu yönlerinin görsel haritalaması için yorumlanabilir bir çerçeve sunmaktadır. Sistem, manuel olarak oluşturulmuş özelliklere ihtiyaç duymadan; metin, ses ve görsel modalitelerden üst düzey duygusal temsiller çıkarmak için uçtan uca derin öğrenme kullanır. Modlar arası duygusal etkileşimler, duyguya özgü ve modaliteye özgü bilgileri ayıran, böylece ayrıştırılmış temsil öğrenimini sağlayan, yorumlanabilirliği ve dayanıklılığı artıran grafik tabanlı bir dikkat füzyon mekanizması kullanılarak modellenir. Ek olarak, zamansal duygu dinamiklerini, modlar arası dikkat modellerini ve duygu gömmelerini göstermek için çok görünümlü bir görselleştirme modülü oluşturulmuştur. Önerilen çerçevenin akıllı insan-makine etkileşim sistemlerindeki etkinliği ve uygunluğu, kıyaslama çok modlu duygu tanıma veri kümeleri üzerinde yapılan doğrulamalarla değerlendirilmiştir.
Bu çalışma, mevcut çok modlu duygu tanımlama sistemlerindeki kısıtlı yorumlanabilirliği ve çapraz modlu etkileşimlerin yetersiz modellenmesini aşmak için, geleneksel tahmin odaklı yaklaşımların ötesine geçen, çok modlu duygu yönlerinin görsel haritalaması için benzersiz bir çerçeve sunmaktadır. Önerilen yaklaşım; transformer tabanlı çok modlu temsil öğrenimini, ayrıştırılmış duygu farkındalıklı öznitelik modellemesini, graf tabanlı çapraz modlu dikkat füzyonunu ve etkileşim odaklı görselleştirmeyi tek bir mimari içinde birleştirir. Çerçeve, temel olarak sınıflandırma performansına odaklanan mevcut yaklaşımların aksine, yorumlanabilirliği, sağlamlığı ve çapraz modlu tutarlılığı artırmak için duyguya özgü ve modaliteye özgü temsilleri net bir şekilde ayırır. Ek olarak, metinsel, işitsel ve görsel modaliteler arasındaki ince taneli duygusal karşılıklı bağımlılığı yakalayarak modlar arası etkileşimlerin adaptif modellenmesini sağlamak için graf tabanlı bir dikkat mekanizması sunulmuştur. Modelin karar verme sürecine dair sezgisel içgörüler sunan zamansal duygu yörüngelerini, çapraz modlu dikkat modellerini ve gizli duygu gömmelerini ortaya çıkararak şeffaflığı artırmak amacıyla çok görünümlü bir görsel haritalama modülü oluşturulmuştur. Çok modlu duygusal dinamiklerin geliştirilmiş görselleştirme ve yorumlanabilirliğini sağlamasının yanı sıra, CH-SIMS ve CMU-MOSEI kıyaslama veri setleri üzerindeki deneysel değerlendirmeler; doğruluk, F1-skoru, ortalama mutlak hata ve korelasyon açısından rekabetçi bir performans göstermiştir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Önerilen çalışma, çok modlu duygu özelliklerinin görsel haritalaması için yorumlanabilir bir çerçeve sunarak akıllı etkileşim tasarımını geliştirmeyi amaçlamaktadır. Bu çalışmada, kamuya açık olan CH-SIMS ve CMU-MOSEI veri tabanları kullanılmıştır. Her iki veri kümesi de resmi kaynaklarından edinilmiş ve sırasıyla yaratıcıları tarafından belirlenen kullanım kılavuzlarına, araştırma standartlarına ve lisans koşullarına uygun şekilde kullanılmıştır. Veri kümelerinin metin, ses ve video verilerini içeren çok modlu içeriği, veri kümesi sağlayıcıları tarafından yetkili katılımcı izinleri ve veri toplama protokolleri doğrultusunda ilk olarak toplanmış ve etiketlenmiştir. Bu çalışmada doğrudan insan etkileşimi, yeni katılımcıların alınması veya kişisel olarak tanımlanabilir bilgilerin toplanması yapılmamıştır. Tüm analizler, kamuya açık araştırma veri kümeleri kullanılarak gerçekleştirilmiştir. Sonuç olarak, ikincil veri analizimizin ek etik onay veya Kurumsal İnceleme Kurulu (IRB) incelemesi gerektirmemiştir. Çalışma, kamuya açık veri kümelerinin kullanımı, etik araştırma prosedürleri ve ilgili veri kullanım politikalarına ilişkin uygun kurumsal normlara uygun olarak yürütülmüştür.
Duygu tanımlamalarını, duyguya veya biçime özgü özellikler kullanarak farklı biçimler arasında öğrenmek ve anlayışı artırmak amacıyla bir grafik tabanlı çapraz-biçim dikkat mekanizması kullanıldı. Gerçek zamanlı duyguya duyarlı etkileşimli tasarımı geliştirmek için çoklu görünüm görsel eşleme bileşeni kullanılır ve duyu tanıma için verimliliği tahmin edilir. Bulgular, önerilen yöntemin gerçek dünyada duyguya duyarlı akıllı kullanıcı arayüzleri için hem yorumlanabilirliği hem de verimliliği artırdığını göstermektedir. Şekil 1, önerilen çalışmanın mimari iş akışını göstermektedir. Şekil 1, akıllı etkileşim sistemleri bağlamında çokbiçimli duygu özelliklerinin öğrenilmesi için önerilen görsel eşleme çerçevesinin tam iş akışını göstermektedir. İş akışı, sırasıyla dil, prosodi ve yüz ifadeleri biçimlerinden tamamlayıcı duygusal bilgileri yakalayan metin, ses ve video olmak üzere üç senkronize giriş biçimiyle başlar. Her bir biçim, ham giriş verilerinin yüksek düzeyli temsillerini elde etmek için biçime özgü bir transformatör kodlayıcı tarafından işlenir. Daha sonra temsiller, öğrenilen duygularda heterojen veri kaynakları arasında tutarlılığı sağlamak için duyguya özgü gömülülerin biçime özgü özelliklerden ayrıştırıldığı ayrıştırılmış temsil öğrenimi modülüne verilir. Her bir biçimden elde edilen duyguya özgü gömülüler daha sonra etkileşim bağlamına göre her bir biçime dinamik önem ağırlıkları atayan ve biçimler arası duygusal bağımlılıkları modelleyen grafik tabanlı çapraz-biçim dikkat ağı tarafından birleştirilir. Son olarak, çerçeve hem duygu sınıflandırma çıktıları hem de etkileşim içgörülerini sağlar ve böylece şeffaf duyguya duyarlı karar verme ile uyarlamalı akıllı etkileşim tasarımını kolaylaştırır.
Çok modlu veri edinimi
CH-SIMS ve CMU-MOSEI veri kümeleri, senkronize video, ses ve metin gibi çok modlu bilgileri toplamış iki mevcut kamuya açık çok modlu veri kümesidir. CH-SIMS veri kümesi, filmlerden, televizyon dizilerinden ve eğlence programlarından alınan çok sayıda video parçasından elde edilen 2.281 video parçasını içeren Çinlilerin çok modlu incelemelerini kapsar. Bu video parçalarına karşılık gelen ses ve metin eklenmesi, çok modlu verileri kullanarak duyguların çok modlu analizine yönelik araştırmaları daha ilgi çekici ve uygulanabilir hale getirir. Ancak, görüş, duygu ve duyguların incelenmesi için en büyük çok modlu veri kümelerinden biri, çeşitli konularda 1.000'den fazla konuşmacı tarafından söylenen 23.000'den fazla video klibinden toplanan CMU-MOSEI veri kümesidir. Veri kümesi, sınıf dağılımını koruyarak rastgele eğitim (%70), doğrulama (%15) ve test (%15) alt kümelerine bölünmüştür.
Metin transkripsiyonları, ses sinyalleri ve video kareleri elde edilir ve ince taneli bir zaman düzeyinde eşleşecek şekilde zaman damgası ile hizalanır. Kare düzeyinde entegrasyon, önerilen temsil öğrenimi ve grafa dayalı füzyon mekanizmalarının, görsel ifadelerden, ses tonlarından ve dilsel içerikten ortaya çıkan duygusal içeriği birlikte modellemesini ve yararlanmasını sağlar. Etkili çok modlu duygusal dinamiklerin çıkarımı, bu tür çok modlu edinim tekniği ile mümkün hale gelir ve bu durum, akıllı etkileşim tasarımı ile anlaşılır görsel haritalama için temel bir öneme sahiptir.
Tablo 1, önerilen yöntemde kullanılan çok modlu duygu veri kümelerinin temel yapılarını sunmaktadır. Konuşulan kelimeler, ses tonlamaları ve yüz ifadeleri gibi daha geniş bir yelpazede ilgili duyguları elde etmek amacıyla CH-SIMS ve CMU-MOSEI, bu veri kümelerinden video, ses ve metin modlarını bir araya getirmiştir. Ayrıca, CH-SIMS'te sınırlı sayıda veri örneği mevcuttur ve bu durum, Çin'de modalite etkileşimlerinin ve duygu değişimlerinin kapsamlı bir şekilde incelenmesine olanak tanır. Diğer taraftan, CMU-MOSEI veri kümesi, çeşitli dillerde, konularda ve eklenmiş duygu seviyelerinde büyük miktarda veri içermesi nedeniyle, bu çalışmada ele alınan temsil öğrenimi ve ilgili görselleştirme algoritmalarının dayanıklılığını değerlendirmede daha önemli bir rol oynar. Ayrıca, önceki çalışmalara kıyasla, modelleri test ederken bilgi seçimiyle ilgili zorlukları azaltır.
Çok modlu ön işleme ve senkronizasyon
CH-SIMS ve CMU-MOSEI veri kümelerinden alınan zaman damgası ek açıklamaları, metinsel, işitsel ve görsel modları senkronize etmek ve tutarlı çok modlu temsil öğrenmesini sağlamak için kullanıldı. Her bir söylem, temel analiz birimi olarak işlev gördü ve aynı zaman aralığı içinde eşleşen ses ve video bölümlerine bağlandı. Hizalama, söylem düzeyinde gerçekleştirildi. Transkript, her bir söylemin başlangıç ve bitiş zaman damgalarına göre bölümlere ayrıldı. Aynı zaman aralığı içinde yer alan video kareleri ve ses sinyalleri çıkarılarak transkript-ses-görsel karşılığı oluşturuldu. Ses bölümleri, akustik temsiller üretmek için Wav2Vec 2.0 kullanılarak işlendi; video bölümünden alınan görsel kareler ise önceden belirlenmiş bir oranda örneklenerek Görüşüm Dönüştürücüsü (ViT) ile kodlandı. RoBERTa kodlayıcısı, söylem transkriptlerinden metinsel gömme vektörleri oluşturmak için kullanıldı. Üç modülün farklı uzunluklarda özellik dizileri üretmesi nedeniyle, tüm modül özelliklerinin tek bir söylem sınırına hizalanmasıyla zamansal senkronizasyon sağlandı. Farklı uzunluktaki dizileri normalleştirmek için sabit uzunluklu bir biçim kullanıldı. Daha uzun diziler, izin verilen maksimum dizi uzunluğuna kısaltıldı; daha kısa diziler ise sıfır doldurma (zero-padding) uygulanarak uzatıldı. Eğitim sırasında, doldurulan öğeleri geçerli özellik konumlarından ayırmak için dikkat maskeleri kullanıldı. Modül-özgü gömme vektörleri, birleştirme işleminden önce farklı modüller arası dizi uzunluklarını aşmak amacıyla ortak bir gizli uzaya izdüşümü yapıldı. Bu, boyutsal tutarlılığı garanti etti ve graf tabanlı dikkat mekanizmasının etkili çapraz modlu etkileşim öğrenmesini sağlamasını mümkün kıldı. Bozuk dosyaları, eksik ek açıklamaları veya eksik modül bilgileri olan örnekler, veri kalitesini ve senkronizasyon bütünlüğünü korumak amacıyla çalışmalardan çıkarıldı.
Dönüştürücü tabanlı özellik çıkarımı
Çoklu veri modlarını hizaladıktan ve gerekli ön işleme adımlarından sonra, bir uçtan uca yaklaşım ile görme, ses ve metin gibi çoklu modlardan bilgiyi kullanarak yüksek düzeyde duygu farkında özellik gösterimlerini öğrenmek için derin öğrenme yöntemi kullanılır. Ham çoklu modlu verilerden içsel olarak ayırt edici özellik gösterimlerini öğrenmek amacıyla bir transformatör kodlayıcı kullanılarak önerilen yöntem, özellik mühendisliği ihtiyacını ortadan kaldırır. Önerilen yaklaşımda kullanılan veri kümeleri arasında tutarlılığı kolaylaştırmak amacıyla her bir modalite için sabit boyutlu bir yerleştirme öğrenilir. Örneğin, görüntü, ses ve metin modalitelerini içeren her bir bireysel modalite için 768 boyutlu özellik yerleştirmeleri öğrenilir ve çeşitli boyutlardaki verilerde yüksek düzeyli özellikleri öğrenmek amacıyla önerilen CH-SIMS veri kümesi ve CMU-MOSEI veri kümesi boyunca kullanılan, özellikle bir özellik çıkarımı yaklaşımı boyunca kullanılan birleşik bir özellik uzayı oluşturur.
Görsel modül: Duygu duyarlı kare yerleştirmeleri için vizyon dönüştürücü
Duyguya özgü mekansal temsiller elde etmek amacıyla video karelerinden görsel bilgiyi çıkarmak için bir Görüş Dönüştürücü (ViT-Base) modeli kullanıldı. Özellikleri çıkarmadan önce, her video parçasının kareleri (224 × 224) piksele ölçeklendirildi ve düzenli zaman aralıklarında örneklemeye alındı. 16 × 16 piksel boyutunda bir yama kullanılarak, ViT-Base mimarisi, 12 adet dönüşüm kodlayıcı katmanı tarafından işlenen bir dizi görsel belirteç üretir. Alınan kare düzeyindeki temsiller, görsel temel yapı olarak önceden eğitilmiş bir ViT modeli kullanılarak 768 boyutlu bir gömme uzayına yansıtıldı. Kare düzeyindeki gömmeler, her parça için nihai görsel temsili oluşturmak amacıyla ortalama havuzlama ile birleştirildi. Eğitim sırasında, genelleştirme yeteneğini artırmak için görüntü normalizasyonu ve rastgele kırpma ile yatay çevirme gibi yaygın artırma yöntemleri kullanıldı. Daha sonra, bu görsel gömmeleri metin ve işitsel temsillerle birleştirmek için önerilen çok modlu birleştirme çerçevesi kullanıldı.
Duygudaki zamansal dinamikleri korumak için CH-SIMS ve CMU-MOSEI veri kümelerinden alınan video örnekleri görsel modalite için eşit aralıklarla örneklenecektir. Her bir video karesi, 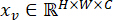 , N tane sabit boyutlu bölüme ayrılabilir; ardından bu bölümler düzleştirilir ve boyutu
 olan gizli bir yerleştirme uzayına ters çevrilerek aktarılır. Pozisyonel yerleştirmelerin ve öğrenilebilir bir gruplama tokenının eklenmesiyle bir seri oluşturulur:
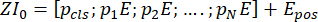 (1)
burada  konum kodlamasını ve
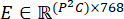 yama yerleştirme matrisini temsil eder.
Gömülü yama dizisini işlemek için, ileri beslemeli ağlar ve çok başlı kendine dikkat mekanizmalarından oluşan katmanlı dönüştürücü kodlayıcı katmanları kullanılır. l katmanındaki dönüşüm şu şekilde tanımlanır:
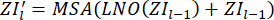 (2)
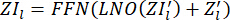 (3)
Duygu bilgili görsel özellik vektörünü elde etmek için sınıf belirteciyle eşdeğer olan çıkış, özellik vektörü olarak çıkarılır  . Veri kümeleri arasında dil ve içerik farklılıklarına rağmen tutarlı görsel duygu temsillerini ele almak için her video parçasının çerçeve düzeyindeki gömülüm vektörleri, yüz ifadelerini ve duyguların gelişimini yakalamak amacıyla birleştirilir.
Wav2Vec 2.0 kullanan ses modalitesi ile prozodi ve anlamsal akustik gömülüler Bağlamsal konuşma gömülülerinin oluşturulmasında önceden eğitilmiş bir Wav2Vec 2.0 kodlayıcısı akustik temel olarak kullanıldı. Her bir ifade için sabit uzunlukta bir akustik özellik vektörü, ortalama havuzlama kullanılarak gizli temsillerin çıktısının birleştirilmesiyle elde edildi. Wav2Vec 2.0 modeli, bağlamsal ve duyguyle ilgili konuşma özelliklerini yakalayabilmek için ses sinyallerinden akustik temsilleri çıkarmak amacıyla kullanıldı. Özellik çıkarımından önce ses kayıtları normalleştirildi ve 16 kHz'e yeniden örneklendi. Metinsel ve görsel modaliteler arasında senkronizasyonu sağlamak için her bir söylem düzeyindeki ses parçası, veri kümesi ek açıklamaları tarafından sağlanan zaman damgası sınırları kullanılarak ayrıldı. Göreve özgü uyumun geliştirilmesini sağlamak için önceden eğitilmiş akustik kodlayıcı model eğitimi sırasında uyarlandı ve böylece elde edilen temsillerin konuşma sinyallerinin duygusal yönlerini daha doğru bir şekilde yansıtmaları sağlandı. Daha sonra nihai ses gömülülerini kullanarak grafik tabanlı çapraz modal dikkat birleştirme ve ayrıştırılmış temsil öğrenimi gerçekleştirildi.
Ses modalitesinde, CH-SIMS ve CMU-MOSEI veri kümelerindeki başlangıç ses bilgisinden elde edilen konuşma sinyallerini modellemek ve duygu ile ilgili ses özelliklerini doğrudan ayıklamak için Wav2Vec-2.0 kullanılır. Her giriş konuşma sinyali  için bir evrişimli özellik kodlaması mevcuttur:
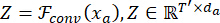 (4)
Z, melodi, ton ve enerji gibi düşük düzeyli prosodik özellikleri temsil eder. Uzun menzilli zamana dayalı bağımlılıkları temsil eden bir transformatör tabanlı bağlam ağı, yukarıda belirtilen yapılar için faydalıdır:
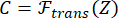 (5)
Duyguyu ifade etmek için temel olan prozodik ve anlamsal ses verileri, bu bağlamsal ses temsillerine dahil edilir. Belirli uzunlukta bir ses gömülü ifadesi, zamansal havuzlama işlemi uygulanarak oluşturulur:
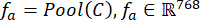 (6)
Tasarım, MFCC'ler gibi akustik özellikleri kullanmaktan kaçınır ve yalnızca dalgalar biçimlerinden temsiller çıkararak CMU-MOSEI'den İngilizce konuşma verilerini ve CH-SIMS'ten Çince konuşma verilerini kullanarak dayanıklılık sağlar.
Bağlamsal duygu yerleştirmeleri için RoBERTa kullanarak metin modu
Metin modu için, derin çift yönlü dönüşüm (transformer) modeli RoBERTa, iki veri kümesinden alınan konuşma transkriptlerine uygulanarak bağlamsal anlamsal ve duygusal anlam elde edilmiştir. Transkript verilerinden bağlamsal anlamsal ve duygusal bilgiyi yakalayabilmek için RoBERTa tabanlı dönüşüm kodlayıcıları kullanılmıştır. İngilizce dilindeki CMU-MOSEI veri kümesi için önceden eğitilmiş bir RoBERTa modeli kullanılırken, Çince CH-SIMS veri kümesi için dilin özel dilbilgisel özelliklerini daha iyi yansıtabilmek amacıyla bir Çince RoBERTa varyantı tercih edilmiştir. Metin ön işleme, her dil için uygun RoBERTa ayrıştırıcısını kullanarak tokenleştirme ve metin normalleştirme işlemlerini içermiştir. Toplu işlemde tutarlılığı sağlamak amacıyla, giriş dizileri token yerleştirme biçimine dönüştürülmüş ve önceden belirlenmiş sabit maksimum dizi uzunluğuna göre ya sıfırla doldurulmuş ya da kısaltılmıştır. RoBERTa giriş formatına uygun olarak, özel sınıflandırma ve ayırıcı token'ları eklenmiştir. Dönüşüm kodlayıcısı tarafından üretilen bağlamsallaştırılmış token temsilleri, son [CLS]-eşdeğer tümce temsili kullanılarak birleştirilerek sabit uzunlukta bir metin yerleştirmesi elde edilmiştir. Öğrenilen temsilleri duygu tanıma görevine uyarlamak amacıyla, önceden eğitilmiş RoBERTa kodlayıcıları çok modlu eğitim ile iyileştirilmiştir. Ardından, önerilen çok modlu birleştirme çerçevesi kullanılarak metin yerleştirmeleri ses ve görsel özelliklerle birleştirilmiştir.
Her bir tokenleştirilmiş giriş için token yerleştirme vektörleri ve konumsal kodlamalar birleştirilebilir, 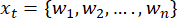 , derin çift yönlü dönüşüm tekniği olarak bilinen giriş temsili oluşturmak için.
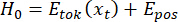 (7)
Bu form, kelimeler arasındaki bağlam bağımlılıklarını keşfetmek için özyönelimi kullanan L transformatörünün katmanları aracılığıyla temsil edilir:
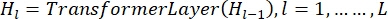 (8)
Bağlamsal duygu yerleştirmesi, sınıflandırma belirtecinin son gizli durumu kullanılarak elde edilir:
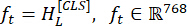 (9)
Duygu ile ilgili dilbilimsel özelliklere örnek olarak duygu kutupluluğu, yoğun duygular ve ilişkili çıkarımlar bu yerleştirme yöntemiyle temsil edilecektir. RoBERTa, dil bağımından bağımsız modellemeyi kolaylaştırır. Bu, sistemin hem CMU-MOSEI veri kümesinden alınan İngilizce metinler hem de CH-SIMS veri kümesinden alınan Çince metinler için aynı yerleştirme boyutunu kullanmasına olanak tanır.
Önerilen derin özellik temsili öğrenme adımı tarafından, her biri görsel fv, ses fa ve metinsel ft modları için 768 boyutunda olan üç moda özel özellik vektörü çıkarılır. Akıllı etkileşim tasarımında, bu öğrenilen temsiller, özellik düzeyinde görsel eşleme, grafik tabanlı çapraz modal füzyon ve ayrıştırılmış temsil öğrenmesi için temel oluşturan birleşik bir çoklu modal özellik uzayı oluşturur.
Ayrıştırılmış temsil öğrenimi
Derin bir özellik gösterimini öğrendikten sonra, görsel, işitsel ve metin modlarından gelen çok modlu özellik vektörlerinin ek işleme tabi tutulması, duygulara dair kesintili bir tanımlama sağlayabilir. Eğer önceki adımda kullanılan işitsel, görsel ve metin modlarına özgü özellik gömmeleri sırasıyla fv, fa ve ft ile temsil ediliyorsa ve  ve
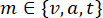 ise, bu adımın amacı, her bir modale ait önceki anlamsal yapıları dikkate alarak duygusal betimlemeleri içeren iki ayrı gizli temsile tüm modallik özelliklerini ayrıştırmaktır.
Bu, her bir modalite özelliğini, fm , iki paralel projeksiyon ağına besleyerek gerçekleştirilir: bir duygu kodlayıcısı  ve bir modalite kodlayıcısı
 , bu iki kodlama üretilir.
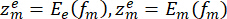 (10)
Burada  duyguya bağlı gizli özelliği temsil eder ve
 ise bir modaliteye özgü gizli özelliği gösterir. Bu, ses, görüntü ve metin gibi çoklu girişler arasında duygu-özgü gömme vektörlerinin tekrar tekrar bir uzay aracılığıyla iletişim kurmasına olanak tanırken, her modaliteyle ilişkili özgün yapısal verilerin korunmasını sağlar.
Etkili bir ayrıştırma, bağımsızlık kısıtlamalarıyla yeniden yapılarak sağlanır. Orijinal modalite özelliğinin yeniden yapılandırması şu şekilde verilir:
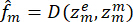 (11)
burada  bir kod çözücü ağıdır. Yapının yeniden oluşturulması kaybı aşağıdaki verileri korur:
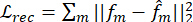 (12)
Ayrıca, duygu ile modaya özgü betimlemeler arasındaki diklik veya ilişkisizlik, genellikle bilgi çakışmasını sınırlar:
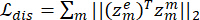 (13)
Bu hedeflere ulaşılarak, modelin güvenilir, anlaşılır ve farklı modalite değişkenliğine karşı dirençli duygu temsilleri öğrenmesi mümkün olabilir. Özellikle akıllı etkileşim tasarımı için sonraki grafik tabanlı çapraz modalite birleştirme ve görsel haritalama özellikleri, yorumlanabilir ve yapılandırılmış duygu temsillerine büyük ölçüde bağlıdır.
Modallar arasında duygu tutarlılığı
Duygu tutarlılığının eklenmesi, modaliteler arasındaki füzyonun etkinliğini açıkça artırır. Bunun nedeni, modaliteye özgü duygu yerleştirmeleri gizli bir alanı paylaştığından, birleştirme stratejilerinin iki gösterim arasında büyük boşlukları hesaba katması gerekmemesidir. İki duygunun birleşik gösterimi şu şekilde tanımlanır  . Duyguya özgü gösterimler tutarlı olduğunda, ağırlıklı füzyon daha kararlı olacaktır çünkü farklı modalitelerden gelen sinyaller arasındaki değişiklikler artık sonucu etkilemeyecektir.
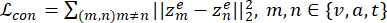 (14)
Duygusal bilgide anlamsal uyumun sağlanmasıyla bu hedef, farklı modlar arasında tutarsızlıkları en aza indirir ve duyguyu ifade etmek için kullanılan modaliteden bağımsız olarak duyguyu algılamanın tutarlı kalmasını sağlar. Sonuç olarak, konuşma sinyallerinden, yüz ifadelerinden ve dilsel içerikten elde edilen duygusal ipuçlarını projekte ederek tutarlı ve duygusal bir temsil alanı oluşturulur.
Çapraz modlu birleşim üzerindeki etki
Duygu tutarlılığı modlar arası sunulduğunda çapraz modalite birleştirme daha etkili hale gelir. Duyguya özgü gömülü ifadeler ortak bir gizli uzayda hizalandığı için, birleştirme mekanizmaları artık modlar arası önemli temsiller arası boşlukları kapatmak zorunda değildir. Birleştirilmiş duygu temsili şu şekilde tanımlanır:
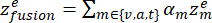 (15)
αm'nin, m modalitesine verilen dikkat ağırlığını temsil ettiği yerde. Duyguya özgü temsiller tutarlı olduğunda, ağırlıklı birleştirme daha kararlı ve anlaşılır hâle gelir çünkü birleştirme sonucu çelişkili modalite sinyalleri yerine tamamlayıcı duygusal kanıtlar gösterir.
Matematiksel olarak, farklı duyguya özgü temsil türleri arasındaki  varyansı, ’ye göre azaltmak şuna eşdeğerdir:
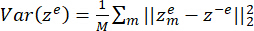 (16)
burada  ortalama duygu ifadesini temsil eder. Azaltılmış varyans, giriş modellerinin duygusal gürültü yerine duygusal önemi dikkate alınarak ağırlıklandırılmasına neden olur ve böylece ağın yakınsamasının iyileştirilmesini ve daha doğru dikkat değerlendirmesini sağlar.
Ayrıştırılmış duygu görselleştirmelerinin nihai öğrenme hedefi, parçalanma, yeniden yapılandırma ve duygu birliğini birleştirmektir:
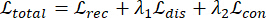 (17)
bu iki hiperparametre, λ1 ve λ2, çapraz-modal duygu güvenilirliği ile ayrışma arasındaki ilişkiyi kontrol eder. Önerilen model, daha sonra grafik tabanlı birleştirme ve akıllı arayüz tasarımında özellik düzeyinde temsili sağlamaya yönelik sağlam bir temel sunmaya odaklanarak, modaliteye bağımsız, yorumlanabilir ve birleştirilebilir duygusal temsiller elde eder.
Çizge tabanlı çoklu veri kaynağı arası dikkat birleşimi
Modallar arasındaki ayrıntılı duygusal ilişkileri simüle etmek için modlara dayalı bir çapraz-modal dikkat ağı kullanıldı. Modallar arasında bilgi akışını kolaylaştırmak amacıyla, her bir modalet-özgü gömme (metin, ses ve görsel) bir graf düğümü olarak temsil edilen tamamen bağlı çoklu modal bir graf oluşturuldu. Graf komşuluk matrisini oluşturmak için modalet ilişkileri kullanıldı ve bu matris daha sonra öğrenilebilir bir dikkat yöntemiyle geliştirildi. Birkaç dikkat kafasının çıktılarının birleştirilip projeksiyonuyla ortak bir gizli uzay oluşturuldu. Birleştirilmiş düğüm temsilleri, dikkat ağırlıklı havuzlama kullanılarak toplandığında, birleşik çoklu modal duygu temsili üretildi. Daha sonra bu birleştirilmiş temsil, etkileşim-farkında analiz ve duygu tanıma için tahmin ve görselleştirme modüllerine iletildi. Graf-birleştirme modülünün gizli temsil boyutu 256'dı ve sekizer dikkat kafasına sahip iki graf dikkat katmanı bulunuyordu. Yakındaki modalların göreceli önemini belirlemek için bağlı düğümler arasındaki dikkat katsayıları hesaplandı ve softmax fonksiyonu kullanılarak standartlaştırıldı. Her graf-dikkat katmanının ardından, eğitim kararlılığını artırmak ve aşırı öğrenmeyi azaltmak amacıyla katman normalizasyonu, artan bağlantılar ve %0,2 bırakma oranı uygulandı. Birkaç dikkat kafasının çıktılarının ortak bir gizli uzaya birleştirilip projeksiyonunun ardından, düğüm temsilleri dikkat ağırlıklı havuzlama kullanılarak tek bir çoklu modal duygu gömmesine birleştirildi. Bundan sonra, birleştirilmiş temsil çoklu görünüm görsel eşleme ve duygu tahmini için kullanıldı.
Çok başlı grafik dikkati kullanılarak çeşitli çapraz-modal etkileşimler yakalandı. Her düğüm için bağlı düğümler arasındaki dikkat katsayılarını normalleştirmek amacıyla softmax fonksiyonu kullanıldı. Eğitim stabilitesini artırmak ve aşırı uydurmayı önlemek için, grafik birleştirme modülündeki yığılmış grafik-dikkat katmanlarının ardından artan bağlantılar, katman normalizasyonu ve dropout düzenlemesi uygulandı.
Şimdi, terimler bireysel olarak, görsel, ses ve metin modaliteleri tarafından toplanan belirli duygulara karşılık gelen temsilleri ifade etsin; her bileşen, paylaşılan gizli uzay  içinde yer alsın. Modallik düğümleri için modeller, graf
 için bir gösterim kullanır; koleksiyonun düğümleri
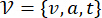 , üç modallik düğümünün kendisine karşılık gelir ve farklı modallik temsilleri arasında paylaşılan duygusal bağımlılıklar açıkça güçlendirilir.
Grafiğin her düğümüne duygu-özgü bir özellik vektörü atandıktan sonra elimizde şunlar vardır:
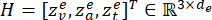 (18)
Geleneksel birleştirme yöntemlerinin önceden belirlenmiş veya sabit birleştirme ağırlıkları kullanmasının aksine, önerilen yöntem kanallar arası ve duygusal durumlar arası önemlerine ve aralarındaki bağımlılıklara göre uyarlanabilir kenar ağırlıklarını öğrenir.
Çapraz modlu birleştirme için bir Grafik Dikkat Ağı (GAT) kullanılır. Her bir i düğümü ve komşu düğümleri, yani j düğümü için bir dikkat katsayısı hesaplanır:
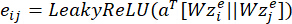 (19)
j modundan i modalitesine geçişin duygusal etkisi, normalize edilmiş ağırlıklar αij ile ölçülür.
Ardından, her modalite düğümünün birleştirilmiş görünümü, komşularının ağırlıklı bir gruplandırması olarak hesaplanır:
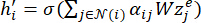 (20)
burada aktivasyon fonksiyonu  doğrusal olmayandır. Sonuç olarak, her düğümün güncellenmiş özellikleri, küresel birleştirilmiş duygu temsili elde etmek için birleştirilir:
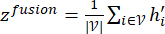 (21)
Çeşitli modlardan tamamlayıcı bilgileri yakalarken karmaşık iç modlar arası ilişkileri koruduğu için yorumlanabilir duygu modellemesi ve ardından gelen görsel haritalama için yararlı bir tekniktir.
Algoritma 1 (Ek Dosya 1), grafik tabanlı çapraz modlu birleştirmeyi gerçekleştirmek için genel şemayı sağlar. Başlangıçta, görsel, ses ve metin modları ile ilişkili duygu-özel özelliklere bağlı bir grafik oluşturulur. Daha sonra, duygusal bağımlılık kombinasyonunu temsil eden her bir grafik düğüm çifti için dikkat skorları hesaplanır. Bu dikkat skorları, her modülün belirli duygusal bağlama göreli katkısını göstermek üzere normalize edilir ve böylece dikkat ağırlıklarının öğrenilmesi sağlanır. Genel duygu yerleştirme, son aşamada grafik düğümleriyle ilişkili özellikleri birleştirerek üretilir. Bu anlamda, belirli duygularla ilişkili çok modlu özellikleri genel olarak birleştiren algoritma, uyarlanabilirlik, yorumlanabilirlik ve bağlamsal zekâ açısından umut vericidir.
Şekil 2, çok modlu duygu birleşimine yönelik önerilen çapraz-modal dikkat ağıının yapısını ve işleyişini göstermektedir. Metin, işitsel ve video modları için bağımsız olarak elde edilen duygu-özgü gömülüler, başlangıçta dilsel, ses ve yüz ifadesi bilgilerinin belirli bir duygusal bağlam için nispi önemini öğrenecek şekilde modül düzeyinde dikkat mekanizmalarından geçirilir. Modlara ait dikkatle ağırlıklandırılmış temsiller daha sonra, dikkat matrisinin modlar arası bağımlılıkları ve etkileşim güçlerini yansıttığı birleşik bir duygu gömülü hâline getirilerek birleştirilir. Ağı tarafından öğrenilen dikkat matrisi, modların katkılarını dinamik olarak düzenler ve böylece gürültülü ve daha az bilgilendirici olanlarsa dikkate alınmaksızın en güçlü eğitim modalitesine odaklanılmasını sağlar. Birleştirilmiş duygu temsili, nötr, kucaklaşma ve endişe gibi duygusal durumların doğru duygu tanımasına ve ayrıntılı analizine olanak tanır.
Görsel haritalama modülü
Görsel haritalama bölümü sayesinde, duygusal durumun birleşik temsili, grafik temel alınarak çapraz modlu birleştirme sürecinden sonra anlaşılabilir ve kolayca tüketilebilir bir görsel biçime dönüştürülebilir.
Gizli duygusal temsilleri anlamayı kolaylaştırmak için, öğrenilen çok modlu duygu yerleştirmelerini görselleştirmek amacıyla boyut indirgeme teknikleri kullanıldı. Temel Bileşen Analizi (PCA) kullanılarak özellik boyutu azaltılırken varyansın büyük kısmı korundu ve yerleştirmeler, t-dağılımlı Stokastik Komşu Gömme (t-SNE) yöntemiyle görüntülemek üzere iki boyutlu bir uzaya projelendirildi. t-SNE için perplexity değeri 30, öğrenme oranı 200 ve optimizasyon yinelemesi sayısı 1.000 olarak belirlendi. Elde edilen projeksiyonlar kullanılarak duygu özelinde kümeler ve modallikler arası ilişkiler görselleştirildi. Graf tabanlı dikkat ağı tarafından elde edilen normalize edilmiş çok modlu dikkat ağırlıkları, dikkat ısı haritaları oluşturmak için kullanıldı. Bu ısı haritaları, duygu tahmini sırasında metin, ses ve görsel modalliklerinin nispi katkılarını göstermektedir. Öğrenilen dikkat katsayıları, çok modlu etkileşim grafiklerini oluşturmak üzere kenar ağırlıkları olarak kullanıldı ve bu sayede birleştirme çerçevesi içinde modallikler arası ilişkiler ve bilgi akışı görsel olarak incelenebildi. Zamansal duygusal dinamikleri incelemek amacıyla ardışık söz öbeklerindeki gizli duygu yerleştirmelerinin gelişimi izlenerek duygu izleme grafikleri oluşturuldu. Bu izlemeler, duygusal durumların ve modallik katkılarının zaman içinde nasıl değiştiğini ortaya koymaktadır. Tüm görselleştirmeler, Matplotlib ve Scikit-learn gibi Python kütüphaneleri kullanılarak oluşturuldu. Yorumlanabilirliği değerlendirmek, küme oluşumunu, modallik katkılarını ve zamansal duygu dinamiklerini incelemek amacıyla yerleştirme görselleştirmeleri, etkileşim grafikleri ve dikkat ısı haritalarına nitel analizler uygulandı.
Değişken 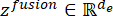 , grafik dikkat ağı işlevi tarafından duygusal durumun birleştirilmiş temsilini ifade etsin. Duygusal durum grafiklerinin çıktı düzeyindeki görselleştirilmesinin aksine, modülün ana hedefi duygusal durum temsillerini ve dikkat mekanizmasının ilgili ağırlıklarını anlaşılabilir bir görsel forma dönüştürmektir.
αji öğrendikten sonra, her modalitenin katkısını görsel olarak incelemek için bir dikkat ısı haritası oluşturulur. Daha sonra gelen dikkat ağırlıkları toplanarak her modalite için bileşik bir öneme puanı belirlenir:
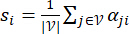 (22)
burada si , I. modalitenin göreli duygusal katkısını temsil eder. Dikkat ısı haritası oluşturmak için elde edilen değerler normalize edilir ve kullanıcıların çeşitli zaman adımlarında veya etkileşimli durumlarda öne çıkan modaliteyi kolayca belirleyebilmesini sağlayan bir renk haritasına aktarılır. Çeşitli görsel, işitsel veya metinsel giriş modaliteleri aracılığıyla bu tür bir arayüz, kullanıcının sistemin dikkat mekanizmasının nasıl çalıştığını anlamasına yardımcı olur.
Öğrenilen grafik, insan duygularının çapraz-modalite bağımlılığını temsil etmek için özellikle "ağırlıklı etkileşim grafiği" olarak modellenmiştir. Modalite kendisi, grafikteki her bir düğümle temsil edilir ve insan duygularıyla ilgili etkileşimlerin gücü, onları birbirine bağlayan kenarlardaki αji şeklindeki ağırlıklarla temsil edilir. Yukarıdaki ağırlıklı grafik, insan duygusal etkileşimlerinin yoğunluğunu göstermektedir. i ve j'nin tanımı şöyledir:
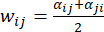 (23)
Bu ağırlıklar sayesinde grafik görselleştirmesindeki çizgi kalınlığı veya saydamlık düzeyi uygun şekilde gösterilir. Bu durum, modalitelerin nasıl etkileşime girdiğini anlamayı kolaylaştırır. Tasarımcılar, çok modlu etkileşim grafiklerinin yardımıyla birleştirme süreci boyunca duygusal göstergelerin nasıl etkileşime girdiğini daha iyi anlayabilir.
Zamansal duyguların gelişimini göstermek amacıyla çeşitli zaman adımlarındaki birleştirilmiş duygu yerleştirme vektörleri  , boyut azaltma algoritmaları olan PCA veya t-SNE gibi yöntemler kullanılarak daha düşük boyutlu bir uzaya indirgenir:
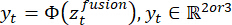 (24)
burada projeksiyon fonksiyonu  ile temsil edilir. Etkileşimlerde duygu geçişlerini, şiddetlerini ve kararlılığını gösteren 2B/3B duygu yörüngelerinin ortaya çıkışı, duygusal durumların zaman içindeki gelişiminin sezgisel bir gösterimi olarak yorumlanabilir. Bu yönler, akıllı etkileşim, karar verme ve gerçek zamanlı izleme için kullanılabilir.
Geleneksel duygu sistemlerinin yalnızca belirli sınıflara veya puanlara eşleme yapmasının aksine, bu sistem, insan duygularının içinde nasıl oluştuğunu göstermeye odaklanır. Ağırlıklandırma faktörleri, modeller arası etkileşimler ve bunlara karşılık gelen yollar dahil olmak üzere ara özelliklerin görselleştirmelerini sunarak karar verme sürecini ortaya koyar. Bu, kullanıcının her bir faktörün—görsel, sesli veya dilsel—insan duygusuna verdiği yanıtı üretirken üzerinde nasıl bir etkisi olduğunu anlamasını sağlar.
Duyguları görsel temsiller aracılığıyla anlaşılır formlara dönüştürmek, derin öğrenme yöntemleriyle duygu analizi ile bunların akıllı arayüz tasarımına entegrasyonu arasındaki boşluğu kapatmaya yardımcı olabilir. Her iki yaklaşımdan toplanan veriler daha sonra daha kesin kullanıcı arayüzleri oluşturmak için kullanılabilir. Bu nedenle, önerilen yaklaşım etkileşim tasarımcılarına daha hassas kullanıcı arayüzleri geliştirmeleri için önemli bilgiler sağlayabilir. Başka bir deyişle, duygu anlayışı etkileşim tasarımının çok aktif bir parçası haline gelir. Duygu anlayışı etkileşim tasarımına aktif olarak dahil edildiğinde ancak bu şekilde doğruluk artabilir.
Görsel haritalama modülü, birbiriyle bağlantılı ancak farklı birkaç şekilde açıklanabilirliği mümkün kılar: Özellik düzeyinde açıklanabilirlik, DNN tarafından oluşturulan duyguların temel temsillerini ortaya çıkarır ve duygularla ilgili her bir özelliğin tanımlanmasında kullanılan anlamsal yapıyı anlamamızı sağlar; modalite düzeyinde açıklanabilirlik, görsel, ses veya metin modalitelerinin duyguları ifade etme kararlarına nasıl katkıda bulunduğunu açıklamak için etkileşim grafiklerinden ve görsel dikkat ısı haritalarından veri kullanır; son olarak, duygu yerleştirme işleminden elde edilen yörüngeler, her bir görsel ve metin modalitesinin dinamik bir etkileşim perspektifinden zaman içinde nasıl değiştiğini anlamamızı sağlar. Lütfen Algoritma 2'ye bakınız (Ek Dosya 1).
Birleştirilmiş çok modlu duygusal özellikler, önerilen görsel eşleme Algoritma 2 kullanılarak akıllı etkileşim tasarımı için görsel olarak anlamlı temsillere dönüştürülür. Graf tabanlı çok modlu dikkat ağırlıkları, her zaman adımında giriş görsel, ses ve metin unsurları arasındaki farklılıkları nicelendirmek için kullanılır. Bu farklılıklar, duyguları etkileyen ana kaynakları ısı haritası görsel öğeleri kullanarak vurgulamak için görsel temsillere eşlenir. Giriş unsurları arasındaki etkileşimi anlamak ve çok modlu giriş unsurları tarafından oluşturulan duygusal gelişimi iletmek için daha sonra ikili etkileşim güçleri hesaplanarak çok modlu etkileşim ağırlıkları oluşturulur. Aynı zamanda, zaman içinde toplanan birleştirilmiş duygusal unsurlar düşük boyutlu bir uzaya eşlenerek sürekli bir duygusal unsur gelişimi üretilir ve böylece duygusal gelişime bir bakış açısı oluşturulur.
Duygu tahmini ve etkileşim geribildirimi
olarak temsil edilen birleştirilmiş duygu gösterimi, etkileşim geri bildirimi ve duygu tahmini için bir fonksiyon olarak kullanılır. Ayrıca, duygu tahmini, sürekli duygu yoğunluğu tanıma için bir regresyon görevi ve ayrık duygu tanıma için bir sınıflandırma görevinden oluşan çoklu görevli bir model olarak tanımlanır. Ayrık duygu tanıma için aşağıdaki softmax tabanlı sınıflandırma modeli kullanılır:
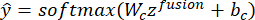 (25)
burada  beklenen duygu sınıfı olasılıklarını temsil eder ve Wc ile bc öğrenilebilir kısıtlamalardır. Sınıflandırma amacını iyileştirmek için çapraz entropi kaybı kullanılır:
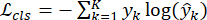 (26)
burada yk gerçek etiket, K ise duygu sınıflarının sayısıdır. Duygu yoğunluğunu paralel olarak tahmin etmek için bir regresyon dalı kullanılır ve valans ve uyarılma da dahil olmak üzere çeşitli sürekli duygusal özelliklerin tahmini yapılır. Buna aşağıdaki tanımı verin:
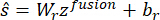 (27)
beklenen duygu yoğunluğu skoru  ile gösterilir. Regresyon görevini iyileştirmek için ortalama kare hata kaybı kullanılır:
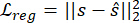 (28)
Genel olarak, iki görev tahmin amaçlı birlikte kullanılır:
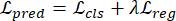 (29)
burada regresyon ve sınıflandırma amaçları λ ile dengelenir. Bu tür etkileşim-bilinçli geri bildirimi etkinleştirmek için tanımlanan duygusal duruma göre görselleştirme modülünün dinamik olarak değiştirilmesini önerir. Belirli bir t zamanındaki etkileşim bağlamı ct ile temsil edilir. Görselleştirme modülünün yanıtı şu şekilde verilir:
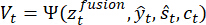 (30)
görselleştirme adaptasyon fonksiyonu  ile temsil edilir. Bu, sistem tahminlerine dayalı olarak modivite ısı haritalarını, etkileşim grafiklerini ve duygusal yörüngeleri gerçek zamanlı olarak ayarlamayı mümkün kılar. Bu durum, sistemin duygusal durum tahmininde iyi performans göstermesinin yanı sıra geri bildirim için önemli ölçüde destek sağladığını gösterir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Bu çalışma, önerilen çok modlu duygu özellikleri için görsel eşleme çerçevesini, CH-SIMS ve CMU-MOSEI olmak üzere iki kıyaslama veri seti kullanarak hem etkileşim duyarlı yorumlanabilirlik hem de öngörücü performans açısından doğrulamaktadır. Deneysel sonuçlara göre, önerilen yaklaşım; korelasyon, doğruluk, F1-skoru ve ortalama mutlak hata (MAE) dahil olmak üzere çeşitli metriklerde, mevcut çok modlu duygu tanıma tekniklerinden tutarlı bir şekilde daha iyi performans göstermektedir. Ayrıştırılmış duygu temsili, grafik ta...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Deneysel bulgular, CH-SIMS ve CMU-MOSEI veri kümeleri genelinde, multimodal duygu özellikleri için önerilen görsel eşleme çerçevesinin, mevcut multimodal duygu tanıma tekniklerinden daha üstün performans gösterdiğini kanıtlamaktadır. EF-LSTM ve TFN gibi erken ve geç füzyon modelleriyle karşılaştırıldığında, önerilen teknik daha yüksek doğruluk ve F1 Skorları elde ederek, çeşitli duygusal bilgilerin işlenmesindeki dayanıklılığını ortaya koymuştur. Yöntemdeki bu iyileşme, modaliteye özgü gürültüyü bastıran ve görsel, işits...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarların herhangi bir çıkar çatışması yoktur.
Teşekkürler
Yazarlar, Universiti Sains Malaysia, Penang, Malezya'daki Konut, Bina ve Planlama Okulu ile Changsha University of Science & Technology, Changsha, Çin'deki Tasarım Sanatları Okulu tarafından sağlanan destek için teşekkürlerini sunarlar. Yazarlar ayrıca, bu çalışma boyunca sağladıkları akademik ve araştırma destekleri için Xiamen Academy of Arts and Design, Fuzhou University, Xiamen, Çin'e şükranlarını sunarlar.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Adam | PyTorch Optimizer Kütüphanesi | https://pytorch-optimizers.readthedocs.io/en/latest/ (Öğrenme Oranı = 1 × 10⁻⁴) | Model eğitimi sırasında parametre optimizasyonu |
| CH-SIMS | Orijinal Veri Seti Deposu | En Son Kamuye Açık Sürüm | Çince çok modlu duygu/emosyon analizi için kıyaslama veri seti |
| CMU-MOSEI | CMU Multimodal SDK Deposu | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (En Son Kamuye Açık Sürüm) | Çok modlu duygu ve emosyon tanıma için kıyaslama veri seti |
| Ayrıştırılmış Emosyon Kodlayıcı | Özel Uygulama | https://pytorch-geometric.readthedocs.io/en/latest/(Çift Kodlayıcı Mimarisi) | Emosyon-özgü ve modalite-özgü gizli temsil்களின் ayrıştırılması |
| Graf Dikkat Ağı (GAT) | PyTorch Geometric | Çok başlı GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | Modallar arası emosyonel ilişkilerin modellenmesi ve adaptif özellik füzyonu |
| Graf Tabanlı Modallar Arası Dikkat Katmanı | Özel Uygulama | Çok Başlı Dikkat Füzyonu | Modaliteler arasında ince taneli emosyonel bağımlılıkların öğrenilmesi |
| Matplotlib | Matplotlib Projesi | 3.7+ | Grafiklerin ve görsel analizlerin oluşturulması |
| NetworkX | NetworkX Projesi | 3.0+ | Modallar arası etkileşim graflarının oluşturulması ve görselleştirilmesi |
| NVIDIA GPU | NVIDIA Corporation | CUDA destekli GPU | Transformer ve graf sinir ağı eğitiminin hızlandırılması |
| Temel Bileşenler Analizi (PCA) | Scikit-learn | sklearn.decomposition.PCA | Yüksek boyutlu emosyon gömmelerinin başlangıç indirgemesi |
| Python | Python Software Foundation | 3.8+ | Çok modlu emosyon analizi çerçevesini uygulamak için kullanılan temel programlama dili |
| PyTorch | PyTorch Foundation | 2.0+ | Derin sinir ağlarının geliştirilmesi, eğitimi ve optimizasyonu |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, 768-boyutlu gömmeler) | Bağlamsal dilbilimsel ve anlamsal emosyon temsillerinin çıkarılması |
| Seaborn | Seaborn Projesi | 0.12+ | Dikkat ısı haritalarının ve istatistiksel görselleştirmelerin oluşturulması |
| t-dağılımlı Stokastik Komşuluk Gömme (t-SNE) | Scikit-learn | scikit-learn.org (Perplexity = 30, İterasyon = 1000) | Gizli emosyon kümelerinin ve yörüngelerinin görselleştirilmesi |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS veya sonrası | Deneysel yürütme ortamı |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, 768-boyutlu gömmeler | Video karelerinden emosyon duyarlı görsel temsillerin çıkarılması |
| Wav2Vec 2.0 | Meta AI Research | Temel Model, 768-boyutlu gömmeler | Bağlamsal akustik ve konuşma emosyon özelliklerinin çıkarılması |
Kaynaklar
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.