Önerilen MSCNN-LSTM çerçevesi, spor videolarında aksiyon tanıma için çok ölçekli uzamsal öznitelik çıkarımını zamansal dizi modelleme ile entegre ederek, ince taneli uzamsal öznitelikleri ve zamansal hareket kalıplarını yakalarken standart spor aksiyon veri kümelerinde rekabetçi bir sınıflandırma performansı sergilemektedir.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Uzun Kısa Süreli Bellek (LSTM) Tabanlı Zamansal Modellemeye Sahip Çok Ölçekli Evrişimli Ağlar Kullanılarak Spor Videolarında Eylem Tanıma
Bu makalede
Özet
Özet
Spor videolarında eylem tanıma; karmaşık hareket dinamikleri, kapanmalar (oklüzyon) ve yüksek sınıf içi değişkenlik nedeniyle zorlayıcı olmaya devam etmektedir. CNN-BiLSTM ve transfer öğrenme tabanlı modeller dahil olmak üzere mevcut derin öğrenme yaklaşımları, insan aktivitesi tanımada etkinlik göstermiş olsa da, hızlı ve çeşitli hareketlerin olduğu spor senaryolarında performansları sınırlı kalabilmektedir. Mevcut birçok yöntem, hem ince taneli hem de kaba hareket özelliklerini aynı anda etkili bir şekilde yakalayamayan tek ölçekli evrişimli filtrelere dayanmaktadır. Bu kısıtlamayı gidermek amacıyla bu çalışma, spor videolarında eylem tanıma için Uzun Kısa Süreli Bellek (LSTM) ağı ile entegre edilmiş bir Çok Ölçekli Evrişimli Sinir Ağı (MSCNN) önermektedir. MSCNN, paralel evrişimli çekirdekler aracılığıyla birden fazla alıcı alanda uzamsal temsiller çıkararak hem ayrıntılı hem de bağlamsal hareket özelliklerinin öğrenilmesini sağlar. Bu özellikler, ardından ardışık kareler arasındaki zamansal bağımlılıkları ve hareket sürekliliğini yakalamak için LSTM tarafından işlenir. Deneysel değerlendirme UCF11, UCF Sports ve JHMDB karşılaştırma veri setleri üzerinde gerçekleştirilmiştir. Önerilen MSCNN-LSTM modeli, sırasıyla %98,3, %95,4 ve %81,7'lik sınıflandırma doğruluklarına ulaşarak bu çalışmada değerlendirilen karşılaştırmalı yaklaşımlardan daha yüksek performans göstermiştir. Bir ablasyon çalışması, çok ölçekli özellik çıkarımının ve zamansal modellemenin genel performansa olan katkısını daha ayrıntılı olarak ortaya koymuştur. Bu bulgular, önerilen çerçevenin spor videolarında eylem tanıma için uzamsal ve zamansal bilgileri birleştirme potansiyelini kanıtlamaktadır.
Giriş
İnsan aktivite tanıma; akıllı gözetleme, anomali tespiti, eylem tabanlı görsel-işitsel geri çağırma ve sağlık hizmetlerinde hasta izleme dahil olmak üzere çeşitli gerçek dünya alanlarında kapsamlı uygulama alanlarına sahiptir1,2. Özellikle gözetleme sistemlerinden ve sosyal medya platformlarından gelen video akışlarındaki eylem tanıma, anomali tespiti ve olay anlamlandırma açısından önemli bir potansiyele sahiptir3. Video analizinde insan eylemleri; eller ve bacaklar gibi farklı vücut bölümlerinin gözlemlenmesi yoluyla tanımlanır. Statik görüntülerin aksine, tek bir kare genellikle bir eylemi temsil etmek için yetersizdir4. Örneğin, futbol ve ip atlama aktivitelerinin başlangıç pozları tek bir karede benzer görünebilir. Bu eylemler arasındaki farklar, insan vücudunun hareket kalıplarını ve çevresiyle etkileşimlerini yakalayan bir dizi kare boyunca gözlemlendiklerinde belirginleşir5,6,7. Okunabilirliği artırmak ve terminolojide tutarlılığı sağlamak amacıyla, bu makale boyunca kullanılan kısaltmalar Tablo 1'de özetlenmiştir.
| Kısaltma | Tam Form |
| Yapay Zeka | Yapay Zeka |
| AUC (Eğri Altındaki Alan) | Eğri Altında Kalan Alan |
| Çift Yönlü Uzun Kısa Süreli Bellek (BiLSTM) | Çift Yönlü Uzun Kısa Süreli Bellek |
| Evrişimli Sinir Ağları | Evrişimli Sinir Ağı |
| CUDA | Hesaplama Birleşik Cihaz Mimarisi |
| F1-skoru | Kesinlik ve Duyarlılığın Harmonik Ortalaması |
| Grafik İşleme Birimi | Grafik İşlem Birimi |
| HAR | İnsan Aktivite Tanıma |
| JHMDB | Ortak İnsan Hareket Veri Tabanı |
| Uzun Kısa Süreli Bellek (LSTM) | Uzun Kısa Süreli Bellek |
| mAP-T | Zamansal Ortalama Ortalama Keskinlik |
| Mikrokristalin Selüloz | Matthews Korelasyon Katsayısı |
| MSCNN | Çok Ölçekli Evrişimli Sinir Ağı |
| ROC (Alıcı İşletme Karakteristiği) | Alıcı İşletim Karakteristiği |
| TSI | Zamansal Stabilite İndeksi |
| UCF | Central Florida Üniversitesi |
| VRAM | Video Rastgele Erişimli Bellek |
Tablo 1: Makalede kullanılan kısaltmalar listesi. Çalışma boyunca kullanılan yaygın kısaltmalar ve akronimler ile bunların karşılık geldiği tam formlar.
Hızlı ve doğru spor videosu sınıflandırması; spor analitiği, olay tespiti, içeriğe dayalı geri çağırma ve öneri sistemleri11,12,13 dahil olmak üzere çok çeşitli uygulamalar için önemlidir8,9,10. Sporla ilgili video içeriğinin hızla artmasıyla birlikte, önceki analitik çerçevelerin sınırlamaları giderek daha belirgin hale gelmiştir14. Sonuç olarak, spor aktivitelerinin karmaşıklığını ve dinamik doğasını ele alabilen sağlam yaklaşımlara yönelik artan bir talep vardır. Geleneksel spor videosu sınıflandırma yöntemleri, spor videolarındaki hareket modellerini ve aktiviteleri karakterize etmek için büyük ölçüde optik akış ve Yönlendirilmiş Gradyan Histogramı (HOG) gibi el yapımı tanımlayıcılara dayanmıştır15.
Statik görüntü sınıflandırmada dikkat çekici başarılar elde eden ConvNet'ler, video analizine de uygulanmıştır. Ancak, videolar dinamik uzay-zamansal bilgiler içerdiği için eylem tanıma daha zorlayıcı olmaya devam etmektedir. Güncel derin öğrenme tabanlı yaklaşımlar genel olarak üç gruba ayrılabilir: iki akışlı ağlar16, 3D evrişimli ağlar ve hesaplama açısından verimli mimariler. Optik akıştan zamansal bilgi öğrenmek için iki akışlı ağlar ek bir ConvNet17,18 kullansa da bu yaklaşım hesaplama açısından maliyetlidir. C3D, I3D ve R3D gibi 3D evrişimli mimariler zamansal bilgileri doğrudan modelleyebilse de parametre sayısını önemli ölçüde artırarak optimizasyonu daha zor hale getirirler. Hesaplama açısından verimli yöntemler ise ayrıştırılmış 3D işlemleri araştırarak model karmaşıklığını azaltmaya çalışır.
Ayrıca, CNN'ler yerel uzamsal özellikleri çıkarabildiği ve LSTM'ler zamansal bağlam bilgilerini yakalayabildiği için, hibrit modeller sensör girişlerinden uzamsal-zamansal hareket paternlerini etkili bir şekilde öğrenebilir. CNN ve tekrarlayan sinir ağı mimarilerini birleştiren güncel çalışmalar teşvik edici sonuçlar vermiştir18,19,20. Ancak, LSTM'ler dizi işleme sırasında bilgileri sıkıştırdığı için, özellik çıkarımı sırasında oluşan gürültüler tanıma performansını etkileyebilir. Bu sorunu gidermek için çeşitli çalışmalara dikkat mekanizmaları eklenmiştir21,22. Dikkat mekanizmaları, modelin tanıma göreviyle en ilgili özelliklere odaklanmasını sağlayarak sınıflandırma performansını artırır.
CNN tabanlı özellik çıkarımı ile birleştirilmiş derin çift yönlü LSTM modelleri, insan aktivite tanıma konusunda gelecek vaat eden sonuçlar elde etmiş olsa da, bu çerçevelerin spor videosu aksiyon tanımasına genişletilmesinde bazı zorluklar devam etmektedir. İlk olarak, mevcut CNN-LSTM mimarileri genellikle tek ölçekli konvolüsyonel özellik çıkarımı kullanmaktadır; bu durum, spor sahnelerindeki oyuncu ve nesne hareketlerinin eş zamanlı gerçekleşmesi gibi, birden fazla mekansal ve zamansal çözünürlükte meydana gelen aksiyonları yakalama yeteneklerini sınırlayabilir. 3D CNN'ler23 ve iki akışlı CNN'ler dahil olmak üzere çok ölçekli konvolüsyonel ağlar, farklı ölçeklerdeki mekansal ve hareket ipuçlarını yakalamanın önemini ortaya koymuştur, ancak bu kavram LSTM tabanlı hibrit sistemlerde daha az araştırılmıştır. İkinci olarak, önceki çoğu CNN-BiLSTM modeli24 öncelikle kısa vadeli zamansal bağımlılıklara odaklanırken, takım sporlarında yaygın olan uzun vadeli hareket sürekliliği ve nesneler arası etkileşimler yeterince temsil edilmeyebilir. MobileNetV2 ve ResNet gibi transfer öğrenme tabanlı birçok yaklaşım, statik kare özelliklerine dayanmakta ve zamansal dikkat mekanizmalarını veya adaptif çok ölçekli özellik füzyonunu tam olarak kullanmamaktadır25. Ayrıca, mevcut modellerin çoğu temel olarak UCF11 ve JHMDB gibi kıyaslama veri kümeleri üzerinde değerlendirilmiştir. SoccerNet ve FineGym gibi karmaşık kamera hareketlerini ve aktivite kalıplarını yakalayan daha güncel spora özgü veri kümeleri ise yeterince araştırılmamıştır. Bu sınırlamalar, spor videosu aksiyon tanımasında hem ince taneli mekansal temsilleri hem de uzun vadeli zamansal bağımlılıkları daha iyi yakalayabilmek için LSTM veya BiLSTM ağları gibi zamansal bellek modülleriyle entegre edilmiş çok ölçekli bir konvolüsyonel özellik çıkarımı çerçevesine duyulan ihtiyacı vurgulamaktadır.
Ek olarak, CNN'ler yerel uzamsal özellikleri çıkarabilirken, LSTM'ler zamansal bağlamı modelleyebilir. Bu nedenle, hibrit CNN-RNN mimarileri insan aktivite tanıma konusunda gelecek vaat eden performanslar sergilemiştir26,27. Yakın tarihli çalışmalar, insan aktivite tanımayı iyileştirmek için tamamlayıcı öğrenme stratejilerini dahil ederek geleneksel CNN–LSTM çerçevelerini genişletmiştir. Örneğin, görevle ilgili özellikleri vurgulamak ve daha az bilgilendirici temsilleri baskılamak, böylece tanıma performansını artırmak için dikkat mekanizmaları tanıtılmıştır28. Diğer yaklaşımlar, öğrenme verimliliğini ve özellik temsilini geliştirerek eylem tanıma ve zamansal segmentasyon görevlerini ortaklaşa optimize etmek için çok görevli öğrenmeyi benimsemiştir29. Bu ilerlemelere rağmen, ince taneli uzamsal ve zamansal özellikler her zaman etkili bir şekilde yakalanamadığı için, mevcut yöntemler görsel olarak benzer eylemleri ayırt etme konusunda hâlâ sınırlı bir yeteneğe sahip olabilir. Tablo 2, mevcut yaklaşımların güçlü yönlerini ve sınırlamalarını özetlemektedir30.
| Referans / Yıl | Kullanılan Yöntem | Veri kümesi(leri) | Performans Metrikleri | Temel Güçlü Yönler | Kısıtlamalar |
| Hassan ve ark. (2024)1 | KFDI (Anahtar Kare Dinamik Görüntü) | UCF11 | Doğruluk: %85,3 | Verimli anahtar kare seçimi ve geliştirilmiş dinamik görüntü temsili. | Kare seçim hatalarına karşı duyarlıdır; sınırlı zamansal modellemeye sahiptir. |
| Zhou ve ark. (2023)24 | Genişletilmiş CNN + BiLSTM + Artık Blok | UCF11, UCF Sporları | Doğruluk: UCF11: %89 ve UCF Spor: %92,2 | Mekansal ve zamansal öğrenmeyi entegre eder; çok ölçekli bilgileri yakalar. | Hesaplama açısından yoğun; küçük veri setlerinde aşırı öğrenme (overfitting) riski. |
| Ullah ve ark. (2025)34 | Yerel-Küresel Öznitelik + QSVM | UCF11 | Doğruluk: %82,6 | Sağlam bir tanıma için el yapımı ve derin özellikleri birleştirir. | Manuel ayar gerektirir; ölçeklenebilirliği sınırlıdır. |
| Shin ve ark. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101 ve JHMDB | Doğruluk: UCF11: %97,73; UCF50: %98,81; UCF101: %98,46; JHMDB: %83,38 | Uzun menzilli mekansal ve zamansal bağımlılıkları yakalar. | Yüksek hesaplama maliyeti ve veri gereksinimleri. |
| Su ve ark. (2024)23 | 3 Boyutlu Evrişimli Sinir Ağları (3D-CNN) | UCF11 | Doğruluk: %85,1 | Uçtan uca spatiotemporal öznitelik öğrenimi. | Yüksek bellek ve GPU gereksinimleri. |
| Karuppannan ve ark. (2024)35 | Derin Oto Kodlayıcı + CNN | UCF11 | Doğruluk: %96,2 | Kompakt öznitelik temsilleri öğrenir. | Sınırlı uzun vadeli zamansal modelleme. |
| Sahoo ve ark. (2020)36 | HAR-Derinlik | KTH, UCF sporları, JHMDB, UCF101 ve HMDB51 | Doğruluk: KTH: %97,67; UCF Sports: %95,00; JHMDB: %73,13; UCF101: %92,97; HMDB51: %69,74 | Etkin derinlik tabanlı zamansal öğrenme. | Doğru derinlik tahmini ve kapsamlı ön işleme gerektirir. |
Tablo 2: Spor videosu aksiyon tanıma için mevcut derin öğrenme yöntemlerinin karşılaştırılması. Önerilen MSCNN-LSTM çerçevesi tarafından ele alınan araştırma boşluklarını vurgulayan; veri setleri, metodolojik özellikler, avantajlar ve sınırlamalar dahil olmak üzere temsilci derin öğrenme yaklaşımlarının özeti.
Duygusal olarak ifadeleyici yüz animasyonları oluşturmak için bir Yüz Gürültü Giderici Model (Facial Denoiser Model - FDM) ile Yerelden Küreselle Latent Difüzyon Modelini (Local-to-global Latent Diffusion Model - LG-LDM) birleştiren, ses senkronizasyonu ile yönlendirilen bir yüz animasyon çerçevesi önerilmiştir. Detaylı üç boyutlu yüz geometrisini ve ince ifade varyasyonlarını yeniden oluşturmak için Duygu Merkezli Vektör Kuantize Varyasyonel Otokodlayıcı (Emotion-centric Vector Quantized Variational Autoencoder - EVQ-VAE) kullanılmıştır31. Ayrıca, tıkanıklık olan koşullar altında hedef segmentasyonu, yerelleştirme, tıkanıklık çıkarımı ve çoklu hedef kavrama pozu tahmini gerçekleştirmek için binoküler stereo görme kullanan, tıkanıklık farkındalıklı bir robotik kavrama çerçevesi geliştirilmiştir32. Ek olarak, ızgara projeksiyonu ve adaptif kutu bölme kullanan, nokta bulutlarından zemin çıkarımı için iki aşamalı bir çerçeve tanıtılmıştır; burada, ızgara tabanlı özellik analizi yoluyla yapılan kaba çıkarımın ardından zemin-engel sınırlarını iyileştirmek için yükselti ve eğrilik olasılıkları kullanılmıştır33.
Derin öğrenme tabanlı hareket tanımadaki önemli ilerlemelere rağmen, mevcut yöntemler; hızlı hareketler, kamera hareketleri ve birden fazla oyuncu arasındaki etkileşimler dahil olmak üzere spor videolarının yüksek değişkenliği ve karmaşıklığını yönetmekte hâlâ zorluk çekmektedir. Geleneksel CNN veya LSTM tabanlı modellerin çoğu tek bir uzamsal ölçekte çalışır ve bu nedenle hem yerel hem de küresel hareket modellerini etkili bir şekilde yakalamakta zorlanabilir. Ayrıca, uzun süreli dizilerde veya örtüşen hareketlerde zamansal tutarlılığın sürdürülmesi zorlu olmaya devam etmektedir. Transfer öğrenme yöntemleri özellik çıkarımını geliştirmiş olsa da, bu yöntemlerin spora özgü veri setlerine adaptasyonu nispeten yeterince araştırılmamıştır.
Bu çalışma, hem ince taneli mekansal özellikleri hem de uzun süreli zamansal bağımlılıkları yakalamak amacıyla çok ölçekli mekansal özellik çıkarımını LSTM tabanlı zamansal modelleme ile entegre ederek, spor videolarında aksiyon tanıma için bir Çok Ölçekli Evrişimli Sinir Ağı–Uzun Kısa Süreli Bellek (MSCNN-LSTM) çerçevesi geliştirmeyi ve değerlendirmeyi amaçlamaktadır. Önerilen çerçeve, zorlayıcı koşullar altında karmaşık spor aksiyonlarının temsilini iyileştirmek için tamamlayıcı evrişimli çekirdekler ve çok seviyeli özellik füzyonunu kullanmaktadır. Çerçevenin performansı; doğruluk, kesinlik, geri çağırma, F1-skoru, zaman üzerinden ortalama Ortalama Hassasiyet (mAP-T), Zamansal Kararlılık İndeksi (TSI), Cohen's kappa katsayısı (κ), Matthews Korelasyon Katsayısı (MCC) ve ROC Eğrisi Altındaki Alan (AUC) kullanılarak UCF11, UCF Sports ve JHMDB kıyaslama veri kümeleri üzerinde değerlendirilmiştir. Deneysel sonuçlar, bu çalışmada değerlendirilen yöntemlerle karşılaştırıldığında rekabetçi bir performans sergilemiş; çerçevenin spor analitiği, sporcu performans izleme, otomatik olay tespiti ve spor videolarını anlama konusundaki potansiyelini ortaya koymuştur.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Bu çalışma, bir Çok Ölçekli Evrişimli Sinir Ağı (MSCNN) ile Uzun Kısa Süreli Bellek (LSTM) ağını entegre eden, spor videolarındaki eylem tanıma için iki aşamalı bir derin öğrenme çerçevesi kullanmıştır. Model geliştirme ve değerlendirme için UCF11, UCF Sports ve JHMDB adlı halka açık kıyaslama veri setleri kullanılmıştır. İnsan katılımcılardan yeni veri toplanmamış, kişisel olarak tanımlanabilir hiçbir bilgiye erişilmemiş veya bu bilgiler işlenmemiştir. Çalışma, halka açık anonimleştirilmiş veri setlerinin ikincil analizini içerdiğinden ve doğrudan insan katılımı gerektirmediğinden, kurumsal etik onay ve bilgilendirilmiş onam alınmasına gerek duyulmamıştır.
İş akışı, kare örnekleme ve zamansal normalizasyonun ardından MSCNN modülü kullanılarak özellik çıkarımından oluşmuştur. Çıkarılan özellikler daha sonra zamansal modelleme için bir LSTM ağı kullanılarak işlenmiş ve ardından çok sınıflı bir sınıflandırma katmanına aktarılmıştır. Son olarak model, seçilen kıyaslama veri setleri kullanılarak eğitilmiş ve değerlendirilmiştir. Şekil 1 önerilen çerçevenin genel mimarisini göstermektedir.
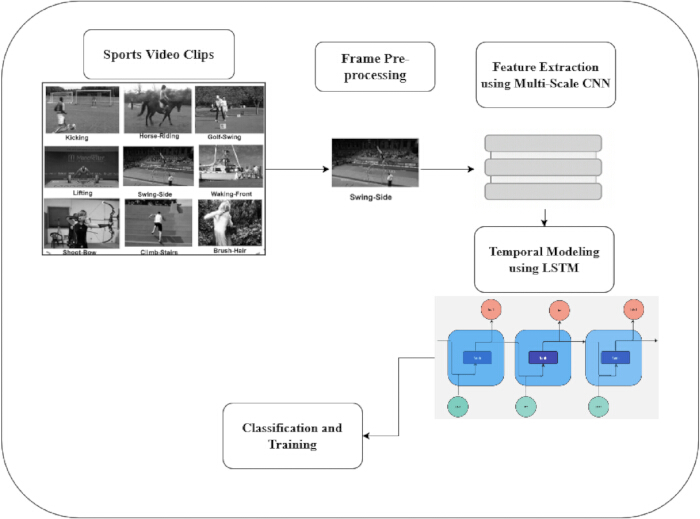
Şekil 1: Spor videosu aksiyon tanıma için önerilen MSCNN-LSTM çerçevesi. Video ön işleme, çok ölçekli uzamsal özellik çıkarımı, zamansal dizi öğrenimi ve aksiyon sınıflandırmasını gösteren genel iş akışı. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Şekil 1, hibrit MSCNN-LSTM mimarisine dayalı olarak önerilen spor videosu eylem tanıma çerçevesinin iş akışını göstermektedir. Süreç, futbol vuruşu, binicilik ve golf vuruşu gibi çeşitli atletik eylemler içeren spor video klipleriyle başlar. Ham videolar, ön işleme aşamasında tekil karelere ayrılmış; burada kareler kırpılmış, standardize edilmiş ve model girişi için hazırlanmıştır. Ön işlemeden geçen kareler daha sonra özellik çıkarımı için MSCNN modülüne beslenmiştir. Çok ölçekli evrişimli mimari, farklı alıcı alanlardaki uzamsal özellikleri yakalayarak spor videosu karelerinden hem yerel hem de bağlamsal bilgilerin çıkarılmasını sağlar. Çıkarılan özellik vektörleri daha sonra, zamansal bağımlılıkları ve ardışık kareler boyunca hareketin evrimini modellemek üzere LSTM ağı tarafından işlenmiştir. Son olarak, sınıflandırma ve eğitim modülü, her bir video klibi için eylem kategorisini tahmin etmek amacıyla öğrenilen uzay-zamansal temsilleri kullanmıştır. Önerilen çerçeve, UCF11 (YouTube Actions), UCF Sports ve JHMDB kıyaslama veri kümeleri kullanılarak yapılan veri toplama ve ön işlemeyle başlayan dört ardışık adımdan oluşmaktadır. Her bir spor videosu, çevresel varyasyonlara karşı dayanıklılığı artırmak amacıyla yeniden boyutlandırılan, normalize edilen ve döndürme, çevirme ve kırpma yoluyla zenginleştirilen bir dizi kareye dönüştürülmüştür. Ön işlemeden geçen kareler daha sonra, 3 × 3, 5 × 5 ve 7 × 7 çekirdeklere sahip paralel evrişimli dalların tamamlayıcı yerel ve bağlamsal uzamsal özellikleri çıkardığı önerilen Çok Ölçekli Evrişimli Sinir Ağı (MSCNN) tarafından işlenmiştir. Bu çok ölçekli özellikler, kompakt özellik temsilleri oluşturmak için toplu normalizasyon (batch normalization) ve maksimum havuzlama (max pooling) kullanılarak birleştirilmiş ve rafine edilmiştir. Ortaya çıkan kare düzeyindeki özellikler, ardışık kareler arasındaki zamansal bağımlılıkları modellemek için daha sonra bir Uzun Kısa Süreli Bellek (LSTM) ağına aktarılmıştır. Nihai LSTM çıktıları düzleştirilmiş ve ReLU aktivasyonuna sahip tam bağlantılı katmanlardan geçirildikten sonra, eylem kategorisini tahmin etmek için bir Softmax sınıflandırıcıya iletilmiştir. Ağ, aşırı öğrenmeyi azaltmak için çapraz entropi kayıp fonksiyonu ve dropout düzenlemesi ile Adam optimize edici kullanılarak eğitilmiştir. Model performansı son olarak UCF11, UCF Sports ve JHMDB kıyaslama veri kümeleri üzerinde doğruluk, kesinlik, geri çağırma ve F1-skoru kullanılarak değerlendirilmiştir.
1. Veri toplama ve ön işleme
Bu çalışmada, spor ve insan hareketleri için halka açık üç kıyaslama veri seti kullanılmıştır. Bu veri setleri; değişen kamera hareketleri, bakış açıları ve arka plan karmaşıklığına sahip gerçek dünya spor görüntülerini içermektedir. Spesifik olarak çalışma, yaklaşık 25 kişiden kaydedilen 1.168 YouTube videosundan toplanan ve her hareket için birden fazla örnek içeren 11 hareket kategorisine sahip UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) veri setini kullanmıştır. Joint-Annotated Human Motion Database (JHMDB)34,35 21 hareket sınıfı ve 928 adet açıklama eklenmiş video içermektedir. UCF Sports veri seti ise yayın kaynaklarından alınan 720 × 480 piksel çözünürlüğe sahip 10 hareket sınıfı ve 150 video dizisinden oluşmaktadır (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Kolektif olarak bu veri setleri, hem bireysel hem de takım sporlarını kapsamakta olup, önerilen MSCNN-LSTM eylem tanıma çerçevesini değerlendirmek için zamansal süre ve görsel ölçek bakımından çeşitlilik sağlamaktadır. Veri kalitesi tarama sürecinin bir parçası olarak UCF11, UCF Sports ve JHMDB veri setleri; bozuk videolar, yinelenen dosyalar ve eksik açıklamalı klipler açısından incelenmiştir. Bu dışlama kriterlerini karşılayan herhangi bir örnek belirlenmemiştir; bu nedenle, mevcut tüm videolar sonraki analizler için saklanmıştır. Veri setleri daha sonra, tutarlı bir rastgele bölme stratejisi kullanılarak eğitim (%70), doğrulama (%15) ve test (%15) alt kümelerine ayrılmıştır. Şekil 2, eğitim ve değerlendirme için kullanılan temsili görüntüleri sunmaktadır.
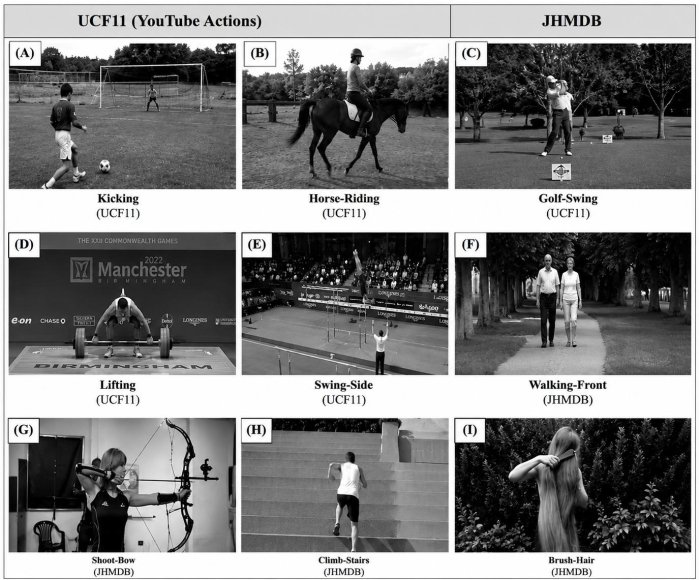
Şekil 2: Karşılaştırmalı spor hareket tanıma veri setlerinden temsili kareler. Paneller (A–D) UCF11 (YouTube Actions) veri setinden, paneller (E–H) UCF Sports veri setinden ve paneller (I–L) JHMDB veri setinden örnekler göstermektedir. Kareler; hareket sınıfları, bakış açıları, arka planlar, aydınlatma koşulları ve hareket karmaşıklığındaki varyasyonları örneklendirmektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Önerilen eylem tanıma modeli, Tablo 3'te özetlendiği üzere UCF11, UCF Sports ve JHMDB kıyaslama veri kümeleri üzerinde değerlendirilmiştir. Bu veri kümeleri, çeşitli hareket modellerini ve zorlayıcı çevresel koşulları temsil etmektedir. UCF11 (YouTube Actions) veri kümesi, farklı aydınlatma, bakış açısı ve arka plan koşulları altında elde edilmiş 11 sınıftan spor eylemlerini içermektedir. UCF Sports veri kümesi, gerçekçi hareket dizilerini içeren, profesyonel yayınlardan alınmış 150 saha sporu videosundan oluşmaktadır. JHMDB veri kümesi, 21 ince taneli eylem kategorisi için ayrıntılı insan hareketi açıklamaları sunmakta ve uzaysal-zamansal eylem tanıma için bir kıyaslama veri kümesi görevi görmektedir. Bu veri kümeleri birlikte, spor ve insan eylemi senaryolarında model performansını değerlendirmek için kullanılmıştır. Ağ, Adam optimize edici kullanılarak 32'lik bir grup boyutu, 0,001'lik başlangıç öğrenme hızı ve bir çapraz entropi kayıp fonksiyonu ile 100 epok boyunca eğitilmiştir. Nihai değerlendirme için en düşük doğrulama kaybına sahip model seçilmiştir. Tüm deneylerde 42'lik sabit bir rastgele tohum kullanılmıştır. Yakınsamayı iyileştirmek için erken durdurma ve platoda öğrenme hızı azaltma uygulanmış; LSTM eğitimi sırasında patlayan gradyanları önlemek için 5,0 eşiğiyle gradyan kırpma kullanılmıştır. Önerilen MSCNN-LSTM modeli yaklaşık 15 milyon eğitilebilir parametre içermektedir. Uygulama için kullanılan donanım ve yazılım yapılandırması Tablo 4'te özetlenmiştir. Sınıf dağılımları yeterince dengeli olduğundan, herhangi bir ek sınıf ağırlıklandırma veya yeniden örnekleme prosedürü uygulanmamıştır. Karşılaştırma modelleri, orijinal çalışmalarında rapor edilen hiperparametreler kullanılarak uygulanmış ve eğitim ayarları mümkün olduğunca uyumlu hale getirilmiştir. Performans değerleri, farklı rastgele başlatmalarla yapılan beş bağımsız çalışmanın ortalaması ± standart sapması olarak rapor edilmiştir. Önerilen model ile karşılaştırma modelleri arasındaki farklar, p < 0,05 anlamlılık eşiğinde eşleştirilmiş t-testleri kullanılarak değerlendirilmiştir.
| Veri Kümesi | Sınıf Sayısı | Video Sayısı | Çözünürlük (px) | Lütfen çevrilecek kaynak metni sağlayın. | Açıklama |
| UCF11 (YouTube İşlemleri) | 11 | 1168 | Değişken (≈ 320×240) | Central Florida Üniversitesi | Sporlardan 11 insan eylemini içerir (örn. basketbol şutu, dalış, golf vuruşu, futbolla sektirme). Videolar, aydınlatma, bakış açısı ve arka plan açısından yüksek varyasyona sahip olacak şekilde YouTube'dan toplanmıştır. |
| UCF Sporları | 10 | 150 | 720×480 | UCF Spor Aksiyonu Veri Seti | Gerçek televizyon yayını görüntülerinden (BBC, ESPN) kaydedilmiş olan dalış, binicilik, golf vuruşu, koşu ve halter gibi spor aktivitelerini içerir. |
| JHMDB | 21 | 928 | 320×240 | Max Planck Akıllı Sistemler Enstitüsü | Hareket ve poz analizi için eklem açıklama notları içeren; yakalama, zıplama, saç tarama, şut çekme ve koşma gibi günlük ve sportif aktiviteleri kapsar. |
Tablo 3: Eğitim ve değerlendirme için kullanılan kıyaslama veri setlerinin özellikleri. Aksiyon sınıfı sayısı, video örnekleri, veri seti özellikleri ve model eğitimi, doğrulama ve test süreçlerindeki rolleri dahil olmak üzere UCF11, UCF Sports ve JHMDB veri setlerinin genel görünümü.
| Kullanılan Parametreler | Açıklama |
| Programlama Dili | Python 3.8.18 [4] |
| Derin Öğrenme Çerçevesi | TensorFlow 2.15.0 [1] |
| GPU Hızlandırıcı | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU (Merkezi İşlem Birimi) | Intel Core i9 @ 3,5 GHz × 16 Çekirdek |
| İşletim Sistemi | Windows 11 |
| Bellek (RAM) | 64 GB DDR4 |
| Optimize Edici | Adam (öğrenme oranı = 0,001) |
| Yığın Boyutu | 32 |
| Epok Sayısı | 100 |
| Aktivasyon Fonksiyonları | ReLU (CNN katmanları), Softmax (çıkış katmanı) |
| Terk Oranı | 0.5 |
Tablo 4: Önerilen MSCNN-LSTM modelinin simülasyon ortamı ve hiperparametre konfigürasyonu. Donanım özellikleri, yazılım ortamı, optimize edici ayarları, öğrenme oranı, grup boyutu, epok sayısı, giriş boyutları ve model eğitimi ile değerlendirmesi sırasında kullanılan diğer hiperparametreler.
2. Ön işlem
Eğitimden önce, her bir ham video zaman sıralı kare dizilerine dönüştürülmüş; ardından normalize edilmiş, zamansal olarak örneklenmiş ve artırılmıştır. Her bir giriş videosu V önce bir kareler dizisine dönüştürülmüş ve 4B bir tensör olarak temsil edilmiştir V ∈ RT×H×W×C, burada T kare sayısıdır, H × W i kare dizinini belirtir ve C renk kanallarının sayısını ifade eder (RGB için 3). Ön işleme hattı; kare çıkarma, mekansal yeniden boyutlandırma ve ardından sabit bir çözünürlüğe merkezden veya rastgele kırpma işlemlerinden oluşmuştur (H′, W′), piksel başına yoğunluk normalizasyonu ve özellik çıkarımı öncesinde rastgele çevirme, ölçeklendirme ve renk titremesini içeren isteğe bağlı veri artırımı gerçekleştirilmiştir. Somut olarak yoğunluk normalizasyonu, Denklem (1)'de olduğu gibi standart skor normalizasyonu şeklinde uygulanmıştır.
 (1)
burada μ, σ eğitim seti üzerinden hesaplanan kanal ortalamaları ve standart sapmalarıdır veya Denklem (2)'deki gibi min–max ölçeklendirmesi şeklinde uygulanır.
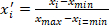 (2)
Normalizasyondan sonra, her kare F̃t ∈ RH′×W′×C′ olarak ve sonuçlanan video tensörü V′ ∈ RT×H′×W′×C olarak temsil edilmiştir. Çok ölçekli evrişimli ön uçta, farklı çekirdek boyutlarına sahip birkaç 2-B (veya erken uzay-zamansal evrişimler için 3-B) evrişim uygulanarak birden fazla alıcı alan uzaysal özellik haritası elde edilmiştir; ardından her kare veya kısa video klip için zamansal bir özellik temsili oluşturulmuş ve LSTM modülüne aktarılmıştır. Orijinal makale, zamansal modelleme için önce MobileNetV2 ve ardından Deep BiLSTM uygulamaktadır; yukarıdaki aynı ön işleme hattı, çok ölçekli evrişim + LSTM değişimi ile tam uyumludur.
3. Örnekleme ve zamansal normalizasyon
Video uzunlukları T veri setleri arasında ve kendi içinde farklılık gösterdiğinden, çok ölçekli konvolüsyon + LSTM'e kareler veya kısa kesitler cinsinden sabit bir N giriş uzunluğu sağlamak için kareleri tekdüze örnekliyoruz veya zamansal olarak yeniden örnekliyoruz. Tekdüze kare indisleri Denklem (3)'te olduğu gibi hesaplanabilir,
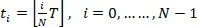 (3)
böylece, örneklenen kare dizisi Vs = {F̃t0, …, F̃tN−1} şeklindedir. Daha hassas bir zamansal sadakat gerektiğinde, doğrusal zamansal interpolasyon uygularız: Denk. (4)'te hesaplandığı gibi herhangi bir yeniden örneklenmiş kesirli zaman τ ∈ [0, T−1] için.
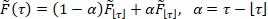 (4)
böylece yeniden örneklenen Vs dizisi tam olarak N kareye sahip olur ve pürüzsüz hareketi korur. Alternatif olarak, kısa ardışık kliplerle örnekleme (adım aralığı s olan zamansal pencere uzunluğu w), her bir klibin Cj ∈ RT×H′×W′×C ve j = 0, …, ⌊(T − w)/s⌋ olduğu bir klip tensörleri kümesi üretir. Ağ içindeki zamansal normalizasyon için, birden fazla ölçekte basit bir zamansal havuzlama etkilidir: çok ölçekli evrişimler tarafından üretilen bir zamansal özellik dizisi X = {x1, …, xN} verildiğinde, Denklem (5)'te olduğu gibi havuzlanmış özellikler uygulanır.
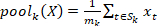 (5)
burada Sk, k ölçeği için zamansal destek (örneğin, Sk örtüşmeyen bloklar veya genişletilmiş indeksler olabilir) ve mk = |Sk|'dir.
Öznitelik çıkarımı öncesinde, tüm videolar 224 × 224 piksel boyutuna ölçeklenmiş ve saniyede 25 kare hızında örneklenmiştir. Her deneyde 32 karelik sabit bir dizi uzunluğu kullanılmıştır. Veri artırma teknikleri arasında rastgele kırpma (ölçek = 0.8–1.0), rastgele döndürme (±15°), rastgele yatay çevirme (olasılık = 0.5) ve parlaklık modifikasyonu (±20%) yer almıştır. Piksel değerlerini standartlaştırmak için ImageNet ortalama değerleri [0.485, 0.456, 0.406] ve standart sapmaları [0.229, 0.224, 0.225] kullanılmıştır. Her video dizisi için zamansal örneklemede tekdüze kare seçimi uygulanmıştır. Daha uzun videolar, tutarlı bir dizi uzunluğunu korumak için tekdüze şekilde kırpılmış veya örneklenmiş, 32 kareden daha az olan videolar ise sıfır ile doldurulmuştur. Eğitim ve değerlendirme boyunca bu ayarlar sabit olarak kullanılmıştır.
4. MSCNN kullanılarak öznitelik çıkarımı
Spor videolarındaki aksiyonların uzamsal temsilini geliştirmek için Çok Ölçekli Konvolüsyonel Sinir Ağı (MSCNN) kullanılmıştır. Tek bir çekirdek boyutuna dayanan geleneksel konvolüsyonel sinir ağları, özellikleri birden fazla uzamsal ölçekte yakalama konusunda sınırlı kapasiteye sahip olabilir. Bazı spor aksiyonları benzer görsel özellikler sergilediği için, tek ölçekli bir konvolüsyonel mimarinin hem yerel hem de küresel özellikleri aynı anda yakalaması zor olabilir. Bu sınırlamayı gidermek için, önerilen çerçeve, çok ölçekli özellik çıkarımı ve özellik füzyonu gerçekleştirmek üzere farklı boyutlardaki konvolüsyonel çekirdekleri kullanmaktadır.
Önerilen ağ mimarisinde, kanallar arası bilgileri düzenlemek ve giriş özellik haritalarının boyutunu azaltmak için 1 × 1 konvolüsyon çekirdekleri kullanılmıştır. Ayrıca bu katmanlar, ek özellik dönüşümleri ve doğrusal olmayan temsiller getirerek ağın ifade kapasitesini artırmaktadır. Farklı boyutlardaki konvolüsyon çekirdekleri, çoklu ölçeklerde uzamsal bilgilerin çıkarılmasını sağlar. Eğitim stabilitesini artırmak için ağırlıklı çok ölçekli özellik füzyonunu takiben sıralı normalizasyon gerçekleştirilir. Derin ağ eğitimindeki gradyan kaybolması ve gradyan patlaması sorunlarını hafifletmek amacıyla, önerilen mimari rezidüel bağlantılar ve LSTM tabanlı zamansal modelleme kullanmaktadır.
Çok ölçekli tasarım, ağın farklı uzamsal çözünürlüklerdeki özellikleri yakalama yeteneğini artırır ve özellik temsil kapasitesini geliştirir. Ayrıca, geleneksel N × N konvolüsyon çekirdeği, N × 1 ve 1 × N konvolüsyon işlemlerine ayrıştırılmıştır. MSCNN modülünde kullanılan N × 1 ve 1 × N konvolüsyonları, tekil video karelerinden tamamlayıcı yönsel ve çok ölçekli uzamsal özellikler yakalamak için tasarlanmıştır. Bu konvolüsyonel işlemler, farklı alıcı alan ölçeklerindeki kalıpları çıkararak uzamsal özellik temsilini güçlendirir. Ardından, ardışık kareler arasındaki zamansal ilişkiler, eylem tanıma için uzun süreli zamansal bağımlılıkları öğrenmek amacıyla MSCNN tarafından çıkarılan özellik dizisini işleyen LSTM modülü tarafından modellenir.
Her bir spor videosu V = {F1, F2, …, FT} toplam T kareye ayrıştırılır. Örneğin oyuncu pozu, hareket bulanıklığı, top yörüngesi gibi mekansal varyasyonları kodlamak için; 3 × 3, 5 × 5 ve 7 × 7 çekirdek boyutlarına karşılık gelen s ∈ {1, 2, 3} üç farklı ölçekte evrişimsel dallar çalışır. Her bir dal, Denklem (6)'da olduğu gibi özellik haritalarını çıkarır:
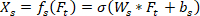 (6)
Ws ve bs sırasıyla s ölçeğindeki konvolüsyonel ağırlıklar ve sapmalar, σ ise ReLU aktivasyonudur. Çok ölçekli füzyon katmanı, özellikleri Denklem (7)'de olduğu gibi toplar:
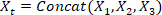 (7)
Bu birleştirilmiş öznitelik tensörü, hem ince taneli hareket ipuçlarını hem de grup etkinlikleri gibi geniş alanlı bağlamsal bilgileri gömer. Şekil 3 yalnızca MSCNN öznitelik çıkarma modülünü göstermektedir. Zamansal modelleme ve sınıflandırma için kullanılan LSTM katmanı (256 gizli birim), yoğun katman (128 nöron) ve dropout katmanı (0,5), Şekil 4'te ayrı olarak sunulmuştur.
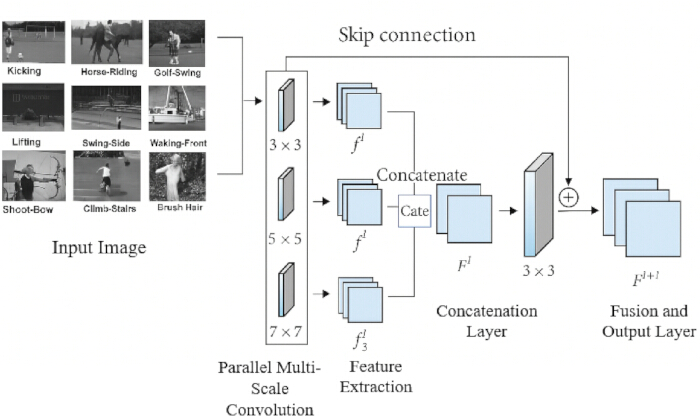
Şekil 3: Önerilen Çok Ölçekli Konvolüsyonel Sinir Ağı (MSCNN) özellik çıkarım modülü. 3 × 3, 5 × 5 ve 7 × 7 çekirdek boyutlarına sahip üç paralel konvolüsyonel dal, birbirini tamamlayan çok ölçekli uzamsal özellikleri çıkarır ve bu özellikler LSTM ağı ile zamansal modelleme yapılmadan önce birleştirilir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
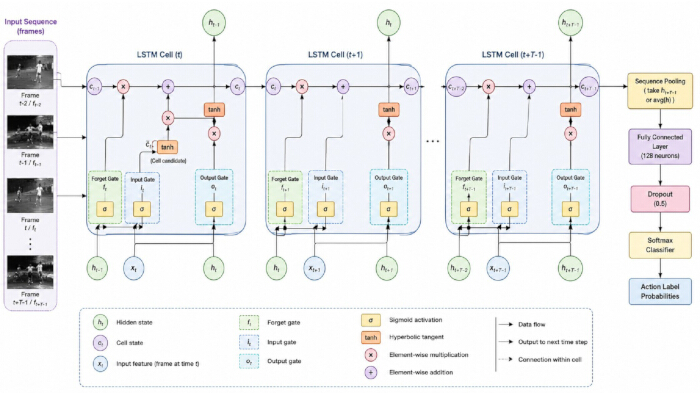
Şekil 4: Spor videolarında eylem tanıma için önerilen LSTM mimarisi. LSTM modülü, ardışık video kareleri boyunca giriş, unutma ve çıkış kapısı işlemleri aracılığıyla zamansal bağımlılıkları modeller. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
Şekil 3 spor videolarında eylem tanıma için önerilen Çok Ölçekli Evrişimli Sinir Ağı (MSCNN) özellik çıkarma modülünü göstermektedir. Giriş video kareleri; tamamlayıcı ince ve kaba taneli uzamsal özellikleri yakalamak amacıyla, her biri 64 filtre içeren 3 × 3, 5 × 5 ve 7 × 7 çekirdek boyutlarına sahip üç evrişimli dal boyunca paralel olarak işlenmiştir. Çıktılar; Batch Normalization, ReLU aktivasyonu ve 2 × 2 maksimum havuzlama kullanılarak rafine edilmiş, ardından birleştirilmiş ve 128 filtreli 1 × 1'lik bir evrişimle füzyonlanmıştır. Bir rezidüel atlama bağlantısı, düşük seviyeli uzamsal bilgileri korumuş ve gradyan akışını iyileştirmiştir. Füzyonlanmış özellik haritaları düzleştirilmiş ve zamansal modelleme için 256 gizli birimli bir LSTM katmanına; ardından 128 nöronlu tam bağlantılı bir katmana, ReLU aktivasyonuna ve Softmax katmanı kullanılarak yapılan nihai sınıflandırmadan önce 0,5'lik bir dropout oranına aktarılmıştır. Çok ölçekli özellik haritaları (f1Lütfen çevirmemi istediğiniz metni sağlayın., f2Lütfen çevirilecek metni sağlayın.ve f3Lütfen çevirmemi istediğiniz metni paylaşın.) birleştirilerek füzyon temsili oluşturulmuştur (FLütfen çevrilmesini istediğiniz metni sağlayın.), ardından sonraki katman için çıktı özellik haritasını oluşturmak amacıyla 3 × 3'lük bir konvolüsyon ile daha da geliştirilmiştir. Bu hiyerarşik mimari, birden fazla alıcı alanda tamamlayıcı uzamsal özelliklerin öğrenilmesini sağlayarak spor aksiyonu tanıma performansını artırmıştır.
5. LSTM kullanılarak zamansal modelleme
Video kenarları boyunca zamana dayalı evrimi modellemek için, dinamik bağımlılıkları ve hareket sürekliliğini yakalamak amacıyla birleştirilmiş özellik dizisi LSTM sistemine sağlanmıştır. Her bir giriş videosu için, önce kare başına çok ölçekli CNN özellikleri çıkarılmıştır. Video kareleri I1, …, IT olsun. Her bir t karesi ve her bir s ölçeği için, çok ölçekli evrişimli kodlayıcı bir ft(s) ∈ Rd özellik vektörü üretir. Daha sonra, Denklem (8)'de olduğu gibi projeksiyon + birleştirme veya ağırlıklı toplam yoluyla ölçekler tek bir kare tanımlayıcıda birleştirilir:
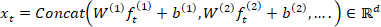 (8)
Ardından, zamansal dinamikleri modellemek için {xt}tT=1 dizisini bir LSTM'ye besleyin. Standart LSTM notasyonunda, t zamanındaki kapılar ve durumlar Denklem (9) ila (13)'te yer almaktadır:
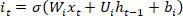 (9)
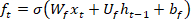 (10)
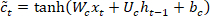 (11)
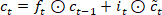 (12)
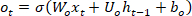 (13)
Burada σ sigmoid aktivasyonunu, ⊙ ise eleman bazlı çarpımı temsil eder.) Çift yönlü LSTM mimarileri hem geçmiş hem de gelecek zamansal bağlamı yakalamak için kullanılabilse de, önerilen çerçeve, ardışık video kareleri arasındaki zamansal bağımlılıkları modellemek için standart bir LSTM kullanmaktadır. Bu tasarım seçimi, bu çalışmada sunulan MSCNN-LSTM mimarisi ile tutarlıdır. Klip işlendikten sonra, bir klip temsili elde edilmiştir (örneğin, son gizli durum veya zamansal havuzlama): z = Poolt(vt).
Şekil 4, spor aksiyonu tanıma için önerilen LSTM mimarisinin iş akışını göstermektedir. Ağ, bir dizi video karesi veya CNN ile çıkarılmış özellikleri almış ve bunları ardışık zaman adımları (t−2, t−1 ve t) boyunca işlemiştir. Her bir LSTM hücresi, ağ üzerindeki bilgi akışını düzenleyen bir giriş kapısı, bir unutma kapısı ve bir çıkış kapısından oluşmuştur. Giriş kapısı yeni bilgileri hücre durumuna dahil etmiş, unutma kapısı ilgisiz zamansal bilgileri atmış ve çıkış kapısı bir sonraki zaman adımına aktarılan gizli durumu oluşturmuştur. Hücre durumu uzun vadeli zamansal bağımlılıkları korurken, gizli durum kısa vadeli zamansal bilgileri yakalamıştır. Ardışık işlemenin ardından, LSTM çıktıları zamansal bir özellik temsili oluşturmak için havuzlanmış ve bu temsil, ilgili spor aksiyonunu tahmin etmek üzere tam bağlantılı bir katmana ve bir Softmax sınıflandırıcısına aktarılmıştır. Ağ; 32'lik bir grup boyutu, 0,001 başlangıç öğrenme oranı ve bir çapraz entropi kayıp fonksiyonu ile Adam optimize edici kullanılarak 100 epok boyunca eğitilmiştir. Final değerlendirmesi için en düşük doğrulama kaybına sahip model seçilmiştir. Tekrarlanabilirliği sağlamak adına tüm deneyler 42 sabit rastgele tohum (random seed) kullanılarak yürütülmüştür. Yakınsamayı iyileştirmek için erken durdurma ve platoda öğrenme oranını düşürme yöntemleri uygulanmış ve LSTM eğitimi sırasında gradyan patlamasını önlemek için 5,0 eşik değerli gradyan kırpma işlemi gerçekleştirilmiştir. Önerilen MSCNN-LSTM modeli yaklaşık 15 milyon eğitilebilir parametre içermiştir.
Final sınıf skorları ve olasılıklar, Denk. (14)'te olduğu gibi bir doğrusal katman + softmax kullanır:
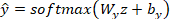 (14)
Eq. (15)'te olduğu gibi, etiketli klipler üzerindeki çapraz entropi kaybını minimize ederek eğitin:
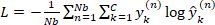 (15)
burada Nb grup boyutunu, C sınıf sayısını ve y(n) one-hot gerçek değerini temsil eder. Düzenleme ( xt/LSTM çıktıları üzerinde dropout, ağırlık azalımı) uygulanmıştır. Uzun spor sekansları için kararlılığı artırmak amacıyla gradyan kırpma uygulanır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Önerilen MSCNN-LSTM modeli; çeşitli spor eylemleri, bakış açıları ve hareket örüntülerini içeren UCF11 (YouTube Actions), UCF Sports ve JHMDB veri setleri üzerinde eğitilmiş ve değerlendirilmiştir. Sınıf dağılımları yeterince dengeli olduğu için ek bir sınıf ağırlıklandırma veya yeniden örnekleme prosedürü uygulanmamıştır. Karşılaştırma modelleri, orijinal çalışmalarında bildirilen hiperparametreler kullanılarak uygulanmış ve eğitim ayarları mümkün olan yerlerde uyumlu hale getirilmiştir. Sonuçlar, farklı rastgele başlat...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Önerilen MSCNN-LSTM çerçevesi; UCF11, UCF Sports ve JHMDB kıyaslama veri kümelerinde değerlendirilen yaklaşımlardan tutarlı bir şekilde daha iyi performans göstermiştir. Dilated CNN–BiLSTM, Vision Transformer mimarileri ve 3D CNN'lere dayanan önceki yöntemler, etkili uzaysal-zamansal özellik öğrenimi sergilemiş ancak yüksek hesaplama karmaşıklığı, önemli eğitim gereksinimleri veya ince taneli hareket modellerinin yetersiz temsili nedeniyle sınırlı kalmış olabilirler23,...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarlar herhangi bir çıkar çatışması beyan etmemektedir.
Teşekkürler
Bu araştırma, Malezya Ulusal Üniversitesi, Bilgi Bilimi ve Teknoloji Fakültesi, Yapay Zeka Teknoloji Merkezi'nde (CAIT) yürütülmüştür. Yazarlar, sağlanan kurumsal destek ve araştırma olanakları için teşekkürlerini sunarlar. Bu çalışma, herhangi bir kamu, ticari veya kâr amacı gütmeyen finansman kuruluşundan özel bir destek almamıştır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Derin öğrenme model eğitimi ve çıkarımı için kullanılır |
| Intel Core i9 İşlemci | Intel Corporation | 16 Çekirdekli, 3,5 GHz | Veri ön işleme ve hesaplama için kullanılır |
| Sistem Belleği | Genel | 64 GB DDR4 RAM | Yüksek ölçekli video işlemeyi destekler |
| Python Programlama Dili | Python Software Foundation | Sürüm 3.8.18 | Uygulama için kullanılan temel programlama dili |
| TensorFlow | Sürüm 2.15 | Model geliştirme için kullanılan derin öğrenme çerçevesi | |
| İşletim Sistemi | Microsoft Corporation | Windows 11 | Model geliştirme ve deneyleme |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | Model eğitimi için GPU hızlandırma |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Derin sinir ağı hızlandırma kütüphanesi |
| OpenCV | Açık Kaynak | Sürüm 4.8.1 | Video karesi çıkarma ve ön işleme |
| NumPy | Açık Kaynak | Sürüm 1.24.4 | Sayısal hesaplama ve dizi işleme |
| Scikit-learn | Açık Kaynak | Sürüm 1.3.2 | Performans değerlendirmesi ve istatistiksel analiz |
| Matplotlib | Açık Kaynak | Sürüm 3.7.5 | Deneysel sonuçların görselleştirilmesi |
| UCF11 Veri Kümesi | Central Florida Üniversitesi | Kamuya Açık Veri Seti | Spor aksiyonu tanıma kıyaslama veri seti |
| UCF Spor Veri Seti | Central Florida Üniversitesi | Kamuya Açık Veri Seti | Spor aksiyon tanıma karşılaştırmalı veri seti |
| JHMDB Veri Seti | Max Planck Bilişim Enstitüsü | Kamuya Açık Veri Seti | İnsan hareketi ve eylem tanıma karşılaştırma veri seti |
Kaynaklar
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.