Bu protokol, klinik karar destek mekanizması için FHIR tabanlı klinik verileri, Erişimle Artırılmış Üretim (Retrieval-Augmented Generation) ve çok etmenli büyük dil modelleri ile entegre eden birlikte çalışabilir bir web platformunun uygulanmasını açıklamaktadır. İş akışı; tekrarlanabilir dağıtımı, standartlaştırılmış veri entegrasyonunu ve yapay zeka (AI) destekli tıbbi veri analizinin değerlendirilmesini sağlar.
Araştırma makalesi
Tıbbi Veri Analizi için Büyük Dil Modellerine Dayalı Birlikte Çalışabilir Web Platformu: Klinik Karar Destek için Bir Protokol
Bu makalede
Özet
Özet
Klinik karar verme süreçleri, genellikle parçalı elektronik sağlık kayıtları ve heterojen sağlık bilgi sistemleri arasındaki sınırlı birlikte çalışabilirlik nedeniyle engellenmektedir. Bu makale, tıbbi veri analizini ve klinik karar desteğini desteklemek amacıyla, Fast Healthcare Interoperability Resources (FHIR) standardı aracılığıyla klinik verileri entegre eden, beraberinde Retrieval-Augmented Generation (RAG), Büyük Dil Modelleri (LLMs) ve çok ajanlı bir klinik akıl yürütme çerçevesi kullanan birlikte çalışabilir bir web platformunun uygulanması için adım adım bir protokol sunmaktadır. Protokol; hesaplama ortamı yapılandırması, klinik veri seti ön işleme, FHIR tabanlı veri entegrasyonu, vektör veritabanı oluşturma, geri çağırma yapılandırması, istem mühendisliği, çok ajanlı orkestrasyon ve sistem değerlendirmesi dahil olmak üzere tüm iş akışını açıklamaktadır. Temsili sonuçlar, platformun heterojen veri kaynakları genelinde anlamsal birlikte çalışabilirliği artırırken, klinik olarak ilgili ve bağlamsal olarak tutarlı yanıtlar üretme yeteneğini kanıtlamaktadır. Sistem performansı; BLEU, ROUGE, BERTScore ve kosinüs benzerliği dahil olmak üzere tamamlayıcı nicel ve anlamsal metrikler kullanılarak değerlendirilmiştir. Önerilen metodolojik iş akışının tekrarlanabilirliğini değerlendirmek için, kamuya açık, tamamen anonimleştirilmiş kıyaslama sağlık veri setleri kullanılarak nitel bir değerlendirme yapılmıştır. Önerilen mimari, bağlamsal akıl yürütmeyi geliştirmek, halüsinasyonları azaltmak ve tekrarlanabilir yapay zeka destekli klinik iş akışlarını desteklemek için standartlaştırılmış sağlık birlikte çalışabilirliğini geri çağırma ile güçlendirilmiş dil modelleriyle birleştirmektedir. Bu protokol; klinik karar desteği, tıbbi veri analizi ve gelecekteki translasyonel araştırmalar için birlikte çalışabilir, gizlilik duyarlı ve akıllı sağlık sistemleri uygulamak isteyen araştırmacılar ve geliştiriciler için ölçeklenebilir ve tekrarlanabilir bir çerçeve sunmaktadır.
Giriş
Sağlık bilgileri rutin olarak hastanelerde, tanı merkezlerinde, laboratuvarlarda ve polikliniklerde oluşturulmakta ve genellikle heterojen bilgi sistemleri arasında dağılmış halde kalmaktadır. Bu parçalanmışlık, birlikte çalışabilirliği sınırlamakta ve kapsamlı hasta kayıtlarına zamanında erişimi kısıtlayarak klinik bakım, veri entegrasyonu ve sağlık yönetimi için kalıcı zorluklar oluşturmaktadır1,2,3,4.
Bu parçalanmanın sonuçları, özellikle hasta bilgilerine zamanında erişime dayanan klinik iş akışlarında belirgin hale gelmektedir. Sağlık hizmeti profesyonelleri eksiksiz ve entegre tıbbi kayıtlara ulaşamadıklarında, klinik değerlendirme zorlaşmakta; bu durum, özellikle acil durumlarda eksik karar verme riskini artırmakta ve bakım hizmetinin verimliliğini düşürmektedir5,6.
Yapay Zeka'daki (YZ), özellikle de Büyük Dil Modellerindeki (LLM'ler) son gelişmeler, sağlık uygulamaları için mevcut olan hesaplamalı yaklaşımların kapsamını genişletmiştir. Bu modeller; tanısal destek, klinik triyaj ve karar destek gibi görevlerde araştırılmıştır. Örneğin, Jahan ve ark.5 LLM'lerin biyomedikal görevlerdeki kullanımını değerlendirmiş, Taylor ve ark.7 ise dijital ruh sağlığı taraması için ince ayarlanmış modelleri araştırmış ve uzmanlaşmış klinik ortamlarda teşvik edici sonuçlar bildirmiştir.
LLM'lerin uygulamaları daha uzmanlaşmış klinik alanlara da genişlemiştir. Song ve ark. 49 bunların pnökoniyoz tanısındaki kullanımını araştırmış, Chien ve ark.8 ise bu modelleri kayıt dışı bakım verenler arasındaki iş yükü modellerini analiz etmek için uygulamıştır. Oftalmolojide Xue ve ark.9 glokom tanısı için bir soru-cevap sistemi önermiş, Tan ve ark.3 ve Wu ve ark.10 ise LLM'lerin hibrit tanı sistemlerinde ve geleneksel Çin tıbbı konsültasyonlarında kullanımını bildirmiştir.
LLM'lerin kullanımı doğrudan klinik uygulamalarla sınırlı değildir. Zhang ve ark.11 bunların ruh sağlığı senaryolarında duygu tanıma üzerindeki uygulamalarını araştırmış, Sarzaeim ve ark.12 ise halk sağlığıyla ilgili analizlere de katkıda bulunabilecek akıllı polislik sistemlerini incelemiştir. Bu çalışmalar, LLM tabanlı yaklaşımların sağlıkla ilgili farklı alanlardaki geniş uygulanabilirliğini örneklemektedir.
LLM'ler sağlık hizmetleri uygulamaları için olasılıkları genişletmiş olsa da, bunların klinik ortamlara entegrasyonu hala önemli teknik, organizasyonel ve düzenleyici zorluklarla ilişkilidir. Pratik uygulama; uygun hesaplama altyapısı, etkili veri yönetişimi ve Genel Veri Koruma Yönetmeliği (GDPR) ile Brezilya Genel Veri Koruma Yasası (LGPD) gibi düzenleyici çerçevelere uyum gerektirir. Bu çerçeveler, yapay zeka destekli sağlık sistemlerindeki gizlilik, güvenilirlik ve algoritmik yanlılık ile ilgili sorunları ele alırken, hassas sağlık bilgilerinin güvenli ve etik bir şekilde işlenmesine yönelik gereklilikleri belirler13,14 .
Elektronik Sağlık Kayıtları (EHR'ler), tıbbi görüntüleme sistemleri ve Nesnelerin İnterneti (IoT) cihazları dahil olmak üzere heterojen sağlık veri kaynakları arasındaki birlikte çalışabilirlik, yapay zeka destekli sağlık çözümlerinin yaygınlaştırılması önünde önemli bir teknik zorluk olmaya devam etmektedir. Bu bağlamda, HL7 FHIR gibi standartlaştırılmış birlikte çalışabilirlik çerçeveleri, anlamsal tutarlılığı korurken ve ölçeklenebilir entegrasyonu desteklerken farklı sistemler arasında klinik bilgilerin değişimi için yapılandırılmış bir mekanizma sağlar.
Bu çalışma, heterojen klinik ortamlarda tıbbi veri analizini desteklemek amacıyla Büyük Dil Modellerini sağlık hizmetleri birlikte çalışabilirlik standartlarıyla entegre eden, birlikte çalışabilir bir web platformu sunmaktadır. Önerilen mimari; Brezilya Genel Veri Koruma Kanunu (LGPD) dahil olmak üzere geçerli veri koruma gereklilikleriyle uyumu korurken, bağlam duyarlı yapay zeka destekli analiz sağlamak için HL7 FHIR tabanlı veri entegrasyonunu, Geri Getirme ile Güçlendirilmiş Üretim (RAG) ve çok ajanlı bir işlem çerçevesi ile birleştirmektedir.
Bu protokol, yerleşik sağlık bilişimi birlikte çalışabilirlik standartlarını kullanarak heterojen klinik verilerin entegrasyonuna yönelik birlikte çalışabilir bir mimariyi tanımlamaktadır. Ayrıca, büyük ve küçük dil modellerine (LLM'ler ve SLM'ler) dayalı çok ajanlı bir işleme hattının uygulanmasını ve önerilen platformun davranışını değerlendirmek için nicel metrikler ile nitel analizleri birleştiren bir değerlendirme çerçevesini detaylandırmaktadır.
Protokol
Bu çalışma, insan katılımcıların dahil edilmesini, tanımlanabilir hasta kayıtlarına erişimi veya hayvanlar üzerinde deneyleri kapsamamaktadır. Protokol, metodolojik doğrulama için yalnızca kamuya açık ve tamamen anonimleştirilmiş veri setleri kullanılarak geliştirilmiş ve değerlendirilmiştir. Herhangi bir kişisel sağlık bilgisine erişilmemiş veya işlem yapılmamıştır. Bu nedenle, Kurumsal İnceleme Kurulu (IRB) veya Araştırma Etik Kurulu onayı gerekmemiştir. Protokol, klinik verileri içeren gelecekteki uygulamaları desteklemek amacıyla, Brezilya Genel Veri Koruma Yasası (LGPD) dahil olmak üzere geçerli veri koruma ilkelerine uygun olarak geliştirilmiştir.
Veri seti seçimi ve ön işleme
Önerilen protokol; metodolojik doğrulama için yapılandırılmış Elektronik Sağlık Kayıtları (EHR'ler), klinik soru-cevap verileri ve tıbbi görüntüleme veri kümelerini içeren, kamuya açık ve tamamen anonimleştirilmiş klinik veri kümeleri kullanılarak değerlendirilmiştir. Platforma entegrasyon öncesinde veri kümeleri; veri normalizasyonu, tutarsız veya eksik kayıtların kaldırılması, HL7 FHIR kaynaklarına eşleme, metin temizleme, erişim parçalarına (retrieval chunks) bölme ve vektör indeksleme için gömme (embedding) üretimi dahil olmak üzere standartlaştırılmış ön işleme prosedürlerinden geçirilmiştir. Bu ön işleme adımları, heterojen veri kaynakları arasında anlamsal tutarlılık sağlayarak birlikte çalışabilirliği kolaylaştırmış ve geçerli veri gizliliği ilkelerine uyumu korurken önerilen iş akışının tekrarlanabilirliğini mümkün kılmıştır.
Veri setleri, yapay zeka ve dijital sağlık araştırmalarında yaygın olarak kullanılan, halka açık kıyaslama (benchmark) depolarından elde edilmiştir. Bu setler; yapılandırılmış Elektronik Sağlık Kayıtları (ESK), yapılandırılmamış klinik anlatılar, klinik soru-cevap görevleri ve tıbbi görüntüleme meta verileri dahil olmak üzere heterojen klinik bilgileri temsil etmek üzere seçilmiştir. Protokol, belirli bir klinik kohortu değerlendirmek yerine, farklı sağlık hizmetleri veri setlerine uyarlanabilenle yeniden üretilebilir bir uygulama iş akışını göstermeye odaklanmaktadır. Bu kıyaslama veri setlerinin çeşitliliği; birlikte çalışabilirlik hattının, Geri Getirme ile Artırılmış Üretimin (RAG) ve çok ajanlı akıl yürütme çerçevesinin birden fazla klinik veri modalitesi genelinde doğrulanmasını sağlamaktadır.
Deneysel ortam konfigürasyonu
Deneysel ortam, birlikte çalışabilen platformu kontrollü ve tekrarlanabilir koşullar altında değerlendirmek üzere yapılandırılmıştır. Mimari; tıbbi veri analizi için tek bir işlem hattında organize edilmiş veri alım modülleri, birlikte çalışabilirlik katmanları, büyük dil modelleri (LLM'ler) ve değerlendirme bileşenlerinden oluşmaktadır. Şekil 1, klinik veri alımından tanısal çıktıların üretilmesine kadar olan tüm iş akışını göstermektedir.
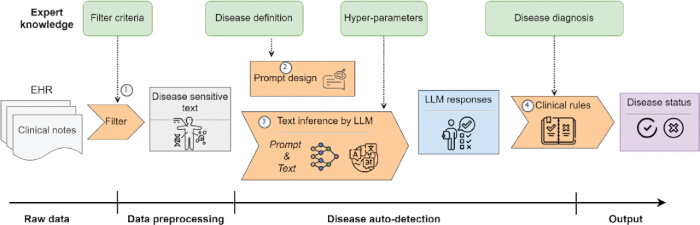
Şekil 1Ham klinik verilerden hastalık durumu çıktısına kadar olan işlem hattını gösteren genel sistem iş akışı. Süreç, Elektronik Sağlık Kayıtlarının (ESK) alınmasıyla başlar ve ardından hastalık duyarlı bilgileri çıkarmak için veri filtreleme ve ön işleme adımları izler. Yapılandırılmış bir istem tasarım aşaması; uzman bilgisini, hastalık tanımlarını ve hiperparametreleri entegre ederek Büyük Dil Modeli (LLM) ile etkili etkileşim kurulmasını sağlar. LLM, bağlama duyarlı yanıtlar üretmek için metin çıkarımı gerçekleştirir ve bu yanıtlar daha sonra nihai hastalık durumunu belirlemek amacıyla klinik kurallar aracılığıyla değerlendirilir. İş akışı, klinik karar verme sürecini desteklemek için veri ön işlemenin, bilgi güdümlü istemlemenin ve yapay zeka tabanlı çıkarımın entegrasyonunu vurgulamaktadır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Sağlık hizmetleri birlikte çalışabilirlik mimarisi
Arka uç altyapısı, platform bileşenleri arasındaki iletişimi desteklemek için RESTful API'lere dayalı modüler bir mimari benimsemiştir (Şekil 2). Bu mimari, yapılandırılmış Elektronik Sağlık Kayıtları (ESK'ler), hekim notları ve tıbbi görüntüleme sistemlerinden türetilen meta veriler dahil olmak üzere heterojen klinik bilgileri kapsar. Bu veriler birden fazla kaynaktan ve formattan geldiği için, birlikte çalışabilirlik, özellikle Fast Healthcare Interoperability Resources (FHIR) çerçevesi15,16,17 aracılığıyla standartlaştırılmış veri modelleriyle sağlanmıştır..FHIR'ın benimsenmesi, dağıtık sağlık hizmetleri ortamlarında ölçeklenebilirlik ve esnekliği korurken yapılandırılmış bilgi alışverişini destekler. Sağlık kurumlarında yaygın olarak kullanılmaya devam eden eski klinik sistemlerle entegrasyonu kolaylaştırmak için HL7 tabanlı iletişim mekanizmaları da dahil edilmiştir16,17.
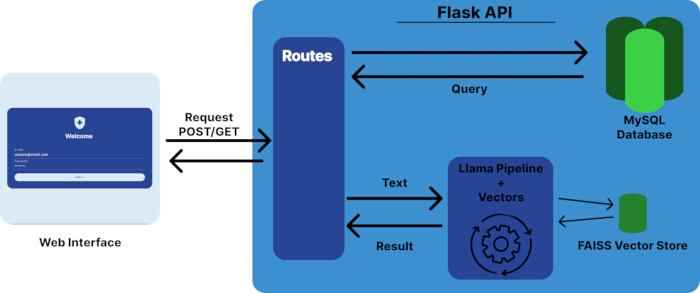
Şekil 2Önerilen birlikte çalışabilir platformun sistem mimarisiWeb arayüzü, HTTP POST/GET isteklerini kullanan bir Flask API aracılığıyla arka uç ile iletişim kurar. API; yönlendirme, sorgu işleme ve hem yapılandırılmış hem de yapılandırılmamış veri kaynaklarıyla etkileşimi yönetir. Yapılandırılmış klinik veriler bir MySQL veritabanında saklanırken, FAISS tabanlı bir vektör deposu geri çağırma işlemleri için benzerlik aramasını destekler. LLaMA tabanlı işlem hattı, metinsel girdileri işler ve vektör temsillerini kullanarak yanıtlar üretir; böylece Geri Çağırma ile Güçlendirilmiş Üretim (RAG) sağlanır. Bu mimari; web servislerinin, veritabanı yönetiminin, vektör geri çağırmanın ve büyük dil modeli çıkarımının birleşik bir sistemdeki entegrasyonunu vurgulamaktadır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Çoklu ajan iş akışı yapılandırması
Çok ajanlı mimari, iş akışının farklı aşamalarından sorumlu uzmanlaşmış fonksiyonel ajanlar şeklinde organize edilmiştir. Bir ön işleme ajanı veri normalizasyonu ve FHIR eşlemesini gerçekleştirir; bunu, vektör veri tabanı içinde anlamsal aramadan sorumlu olan bir getirme ajanı takip eder. Bir akıl yürütme ajanı, yanıtlar oluşturmak için getirilen bağlamı LLM ile entegre ederken, bir doğrulama ajanı ise nihai yanıt döndürülmeden önce çıktı tutarlılığını ve biçimlendirmeyi kontrol eder. Ajan koordinasyonu, her bir ajanın çıktısının bir sonraki aşama için girdi olarak hizmet ettiği, tekrarlanabilir ve modüler bir uygulamayı sağlayan ardışık bir orkestrasyon stratejisini izler.
Klinik veri entegrasyonu
Veri entegrasyon katmanı, birden fazla klinik kaynaktan gelen bilgileri toplar ve bunları sonraki işlemler için hazırlar. Ön işleme süreci, heterojen veri setleri arasındaki semantik tutarlılığı artırmak amacıyla veri normalizasyonunu, tokene ayırmayı ve varlık hizalamayı içerir. Klinik bilgiler yapı ve kalite bakımından farklılık gösterdiğinden, bu işlemler gürültüyü azaltmaya ve yapay zeka modelleriyle etkileşimi kolaylaştırmaya yardımcı olur. Şekil 3'te15,16,17 gösterildiği gibi, farklı veri formatlarını uyumlu hale getirmek ve işlem hattıyla uyumluluğu sürdürmek için yapılandırılmış eşleme stratejileri de uygulanmıştır.
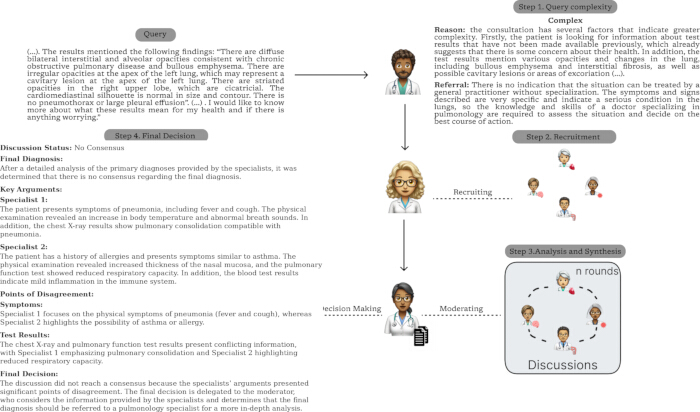
Şekil 3Çok ajanlı klinik akıl yürütme sürecinin ayrıntılı örneğiŞekil, klinik bir sorgunun karmaşıklık değerlendirmesi, uzman seçimi, ortaklaşa tartışma ve nihai karar verme dahil olmak üzere birden fazla aşama üzerinden nasıl analiz edildiğini göstermektedir. Bu süreç, sistemin sorgu karmaşıklığına bağlı olarak akıl yürütme stratejilerini dinamik bir şekilde uyarlama yeteneğini ortaya koyarak, klinik karar destek senaryolarında hem verimliliği hem de tanısal doğruluğu artırmaktadır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Geri Getirme ile Güçlendirilmiş Üretim (Retrieval-Augmented Generation) hattını yapılandırın
Bilgi erişimini, büyük dil modellerinin üretici yetenekleriyle birleştirerek bağlama duyarlı analiz sağlamak amacıyla Geri Getirme ile Artırılmış Üretim (Retrieval-Augmented Generation - RAG) yöntemi entegre edilmiştir. Kullanıcı sorguları, gömme modelleri kullanılarak vektör temsillerine dönüştürülür ve en ilgili bağlamsal pasajları geri getirmek için anlamsal benzerlik araması kullanılarak vektör veritabanı ile eşleştirilir. Geri getirilen belgeler, LLM tarafından çıkarım yapılmadan önce orijinal sorgu ile birleştirilir. Bu strateji, yanıt üretimi sırasında bağlamsal bilgi sağlanmasına yardımcı olur ve sağlık hizmetleri de dâhil olmak üzere bilgi yoğunluklu uygulamalarda, gerçeklerle daha tutarlı sonuçlarla ve azaltılmış halüsinasyonlarla ilişkilendirilmiştir18,19. Şekil 1 ve Şekil 3, genel geri getirme iş akışını ve ilgili muhakeme sürecini göstermektedir.
Her kullanıcı isteği için, nihai istem, orijinal sorgunun vektör veritabanından getirilen en ilgili bağlamsal pasajlarla birleştirilmesiyle dinamik olarak oluşturulur. Getirilen bilgiler, çıkarım öncesinde bağlamsal kanıt olarak eklenir; böylece dil modelinin, anlamsal tutarlılığı koruyarak ve desteklenmeyen üretimleri azaltarak, getirilen sağlık hizmetleri bilgisine dayalı yanıtlar oluşturması sağlanır.
Prompt mühendisliği ve çoklu ajan akıl yürütme
Protokol, yanıt üretimi sırasında bağlamsal yorumlamayı geliştirmek için yapılandırılmış istem stratejileri içermektedir. Bu istem teknikleri, gelişmiş çıkarım mekanizmalarıyla birlikte, karmaşık klinik senaryolarda akıl yürütme sürecine rehberlik etmeye yardımcı olur ve literatürde bildirilen güncel gelişmelerle20 uyumludur.
Mimari; veri doğrulama, bağlam filtreleme, klinik akıl yürütme desteği ve çıktı doğrulama dahil olmak üzere, işlem hattı içinde farklı işlevleri yerine getiren özelleşmiş modüllerden oluşan çok ajanlı bir çerçeveyi içerir. Modüler organizasyon, görevlerin ardışık veya paralel olarak yürütülmesine olanak tanıyarak farklı işlem gereksinimleri için esneklik sağlar (Şekil 4). Bu faaliyetlerin birden fazla ajana dağıtılması, tek bir dil modeline olan bağımlılığı azaltır ve daha sağlam bir işlem iş akışını destekler. Bu mimari strateji, dağıtık yapay zeka ve akıllı sistem tasarımındaki son gelişmelerle uyumludur21,2.
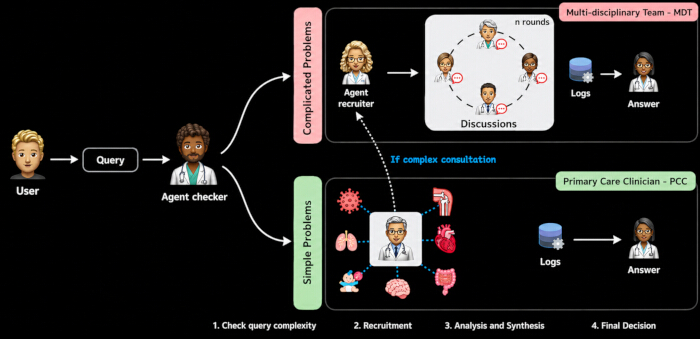
Şekil 4Klinik akıl yürütme için çok ajanlı karar verme çerçevesiSüreç, sorgu karmaşıklığını değerlendirmekten sorumlu bir ajan denetleyici tarafından değerlendirilen bir kullanıcı sorgusuyla başlar. Karmaşık vakalarda sistem, nihai bir karar üretmeden önce problemi analiz etmek ve bilgiyi sentezlemek için yinelemeli tartışma turlarına giren, uzmanlaşmış ajanlardan oluşan çok disiplinli bir ekip (MDT) dinamik olarak görevlendirir. Daha basit vakalarda ise sorgu, daha hızlı yanıt oluşturulmasını sağlayan bir birinci basamak sağlık hizmeti klinisyeni (PCC) ajanı tarafından yönetilir. Bu adaptif mimari, verimlilik ve analitik derinlik arasında denge kurarak sağlık uygulamalarında karar kalitesini ve sistem ölçeklenebilirliğini artır. Lütfen bu şeklin daha büyük bir versiyonunu görüntülemek için buraya tıklayın.
Performans değerlendirmesi
Sistem performansı, üretilen çıktıların hem dilsel kalitesini hem de anlamsal tutarlılığını yakalayan tamamlayıcı metrikler kullanılarak değerlendirilmiştir. Sentaktik benzerliği n-gram örtüşmesine dayanarak ölçmek için BLEU uygulanırken23, ROUGE özellikle özetleme ve bilgi çıkarımı görevlerinde geri çağırma (recall) ve içerik kapsamını değerlendirmiştir24. Anlamsal benzerlik, üretilen ve referans metinleri karşılaştırmak için transformer tabanlı modellerden türetilen bağlamsal gömülmeleri (embeddings) kullanan BERTScore ile değerlendirilmiştir25. Ek analizlere, sırasıyla model güvenini ve anlamsal tutarlılığı incelemek için perplexity ve kosinüs benzerliği dahil edilmiştir26,27.
Seçilen değerlendirme metrikleri, sözcüksel ve anlamsal analizleri birleştirerek sistem performansı hakkında tamamlayıcı bakış açıları sunmaktadır. Bu kombinasyon, bağlamsal yorumlamanın sözcüksel benzerlik kadar önemli olduğu sağlık hizmetleri uygulamalarında özellikle geçerlidir. Platform, hem bulut tabanlı hem de yerel dağıtımı destekleyen kontrollü bir hesaplama ortamında değerlendirilmiştir. Hassas klinik bilgilerin işlenmesi sırasında veri gizliliği gereksinimlerini desteklemek ve dış hizmetlere olan bağımlılığı azaltmak amacıyla, LLM'lerin yerel olarak çalıştırılması bir seçenek olarak eklenmiştir. Bu dağıtım stratejisi, veri koruma çerçeveleriyle uyumludur ve farklı operasyonel ortamlara adapte edilebilir4.
Sonuçlar
Sistem performansı, üretilen çıktıların hem dilsel doğruluğunu hem de anlamsal tutarlılığını incelemek için nitel analizle birlikte tamamlayıcı nicel metrikler kullanılarak değerlendirilmiştir. Bu değerlendirme stratejisi, sağlıkla ilgili dil üretme görevlerinde model davranışının daha kapsamlı bir karakterizasyonunu sağlamak amacıyla sözcük düzeyindeki ve anlamsal ölçümleri birleştirir.
Tablo 1, BLEU, ROUGE ve BERTScore ile elde edilen nicel sonuçları sunmaktadır. Bu metrikler, sözcüksel benzerlik, bilgi kapsamı ve anlamsal uyum dahil olmak üzere üretilen metnin birbirini tamamlayan yönlerini değerlendirdikleri için seçilmiştir ve doğal dil işleme araştırmalarında yaygın olarak kullanılmaktadırlar.
| Değerlendirme | İstem | Pearson | Kök Ortalama Kare Hata (RMSE) | MAE | İsabet Oranı |
| Mixtral | Kısa | 0.098 | 1.779 | 1.346 | 6/28 |
| sıfır-atış | 0.174 | 1.618 | 1.293 | 15/28 | |
| az örnekle öğrenme | 0.475 | 1.673 | 1.367 | 9/28 | |
| LLaMA 3 | kısa | 0.485 | 1.617 | 1.314 | 11/28 |
| sıfır-atış | 0.479 | 1.614 | 1.314 | 10/28 | |
| birkaç örnekle öğrenme | 0.425 | 1.652 | 1.339 | 13/28 | |
| LLaMA 3.1 | kısa | 0.349 | 1.621 | 1.318 | 06/28 |
| sıfır-atış | 0.68 | 1.614 | 1.307 | 12/28 | |
| az örneklemli | 0.408 | 1.243 | 0.886 | 11/28 |
Tablo 1: Önerilen sistemin kantitatif değerlendirme metrikleri.
Üretilen çıktılar ve referans metinler arasındaki n-gram örtüşmesine dayalı sözdizimsel benzerliği nicelleştirmek için BLEU kullanılmıştır23. Aslen makine çevirisi için geliştirilmiş olan bu yöntem, metinler arasındaki yapısal uygunluğu yakaladığı için çok çeşitli metin üretme görevlerine de uygulanmıştır. Mevcut değerlendirmede, BLEU skorları üretilen yanıtların referans çıktılarla tutarlı sözdizimsel özellikler sergilediğini göstermektedir.
Üretilen metinlerdeki ilgili bilgilerin kapsamına odaklanarak, geri çağırma odaklı benzerliği değerlendirmek için ROUGE kullanılmıştır24. Sağlık uygulamalarında, klinik olarak ilgili bilgilerin korunması genellikle aynı sözcüklerin tekrarlanmasından daha önemli olduğu için bu metrik özellikle yararlıdır. Tablo 2'de belirtildiği üzere, ROUGE skorları, üretilen yanıtların değerlendirilen vakalar genelinde ilgili klinik içeriği koruduğunu göstermektedir.
| Hakem | İstem | ICC1 | ICC2 | ICC3 | ICC1k | ICC2k | ICC3K |
| Mixtral | kısa | 0.136 | 0.164 | 0.182 | 0.32 | 0.37 | 0.4 |
| sıfır-örneklemeli (zero-shot) | 0.28 | 0.353 | 0.507 | 0.539 | 0.621 | 0.755 | |
| az-örneklemeli (few-shot) | 0.24 | 0.323 | 0.52 | 0.463 | 0.58 | 0.76 | |
| LLaMA3 | kısa | 0.234 | 0.31 | 0.532 | 0.479 | 0.597 | 0.73 |
| sıfır-örneklemeli (zero-shot) | 0.24 | 0.34 | 0.51 | 0.492 | 0.607 | 0.786 | |
| az-örneklemeli (few-shot) | 0.218 | 0.321 | 0.531 | 0.456 | 0.587 | 0.72 | |
| LLaMA3.1 | kısa | 0.521 | 0.525 | 0.537 | 0.76 | 0.768 | 0.77 |
| sıfır-örneklemeli (zero-shot) | 0.246 | 0.343 | 0.56 | 0.495 | 0.61 | 0.792 | |
| az-örneklemeli (few-shot) | 0.59 | 0.597 | 0.589 | 0.817 | 0.816 | 0.81 |
Tablo 2: Değerlendiriciler arası uyum metrikleri (ICC).
Transformer tabanlı modellerden türetilen bağlamsal gömmeler kullanarak anlamsal benzerliği değerlendirmek için BERTScore dahil edilmiştir25. BLEU ve ROUGE'dan farklı olarak bu metrik, metinleri sözcüksel örtüşme yerine bağlamsal anlamlarına göre karşılaştırır ve bu da onu klinik dil üretimini değerlendirmek için uygun hale getirir. Bu çalışmada elde edilen BERTScore değerleri, üretilen yanıtlar ile ilgili referans metinler arasında yüksek düzeyde anlamsal uyum olduğunu göstermektedir.
Ek analizler, birincil değerlendirme metriklerini tamamlamak amacıyla perplexity ve kosinüs benzerliğini içermiştir. Üretilen çıktıların öngörülebilirliğini tahmin etmek için hesaplanan perplexity değerinde, düşük değerler metin üretimi sırasında daha düşük belirsizliğe işaret etmektedir26. Üretilen ve referans metinlerden elde edilen gömme (embedding) vektörleri arasındaki uyumu nicelendirmek için kullanılan kosinüs benzerliği, anlamsal tutarlılığa dair ek bir ölçüt sağlamıştır27.
Hep birlikte ele alındığında, değerlendirme metrikleri üretilen yanıtların sözdizimsel, anlamsal ve bağlamsal özelliklerine ilişkin tamamlayıcı bilgiler sağlamaktadır. Şekil 5, değerlendirme sonuçlarının incelenen metrikler genelindeki dağılımını özetleyerek, test edilen koşullar altında sistem performansına dair genel bir görünüm sunmaktadır.
Değerlendirme sonuçları, harici bilgi kaynaklarına erişim gerektiren uygulamalarda Veri Geri Getirme ile Güçlendirilmiş Üretim'in (Retrieval-Augmented Generation - RAG) beklenen davranışıyla tutarlıdır. Geri getirilen belgelerin yanıt oluşturma sürecine dahil edilmesi sayesinde mimari, bilgi yoğunluklu senaryolarda klinik olarak ilgili yanıtları destekleyen ek bağlamsal bilgiler sağlamaktadır18,19. Yapılandırılmış istem (prompting) stratejileri, güncel çalışmalarda bildirilen yaklaşımlarla tutarlı olarak, akıl yürütme sürecine ve bağlamsal yorumlamaya rehberlik eden tamamlayıcı mekanizmalar olarak dahil edilmiştir20.
Nitel analiz, üretilen çıktıların yorumlanabilirliği ve klinik uygunluğu incelenerek nicel değerlendirmeyi tamamlamıştır. Farklı klinik sorgu türleri için sistem yanıtlarının temsilci örnekleri Şekil 3'te gösterilmiştir. Bu örnekler, platformun daha karmaşık klinik bilgileri içeren vakalar da dahil olmak üzere, değerlendirilen senaryolar boyunca bağlamsal olarak tutarlı yanıtlar nasıl oluşturduğunu göstermektedir.
Çok ajanlı mimari, işlem görevlerini iş akışı içindeki tamamlayıcı işlevlerden sorumlu uzmanlaşmış modüllere dağıtır. Bu organizasyon, tek bir dil modeline olan bağımlılığı azaltır ve literatürde bildirilen güncel çok ajanlı yaklaşımlarla tutarlı olarak, bilgi işlemenin ve çıktı doğrulamanın birden fazla aşamasına olanak tanır21,2. Şekil 5, bu çalışmada ele alınan farklı istemleme stratejileri ve dil modelleri ile elde edilen değerlendirme sonuçlarının dağılımını özetlemektedir.
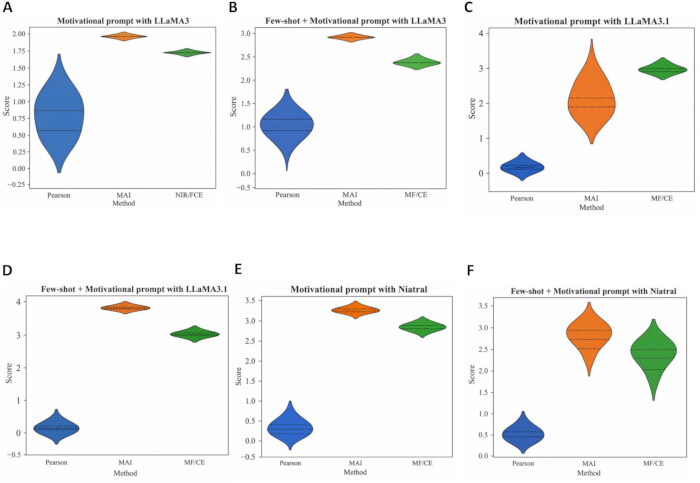
Şekil 5Önerilen sistemin farklı istemleme stratejileri ve dil modelleri üzerindeki performans dağılımı. (A–FKeman grafikleri; LLaMA3, LLaMA3.1 ve Mixtral modelleri kullanılarak kısa, sıfır örnekli (zero-shot) ve az örnekli (few-shot) istemleme yaklaşımları için yanıt kalitesindeki varyasyonları göstermektedir. Sonuçlar, istem tasarımının çıktı tutarlılığı ve performansı üzerindeki etkisini vurgulayarak, yapılandırılmış istemleme stratejilerinin klinik görevlerde daha stabil ve doğru yanıtlar üretme eğiliminde olduğunu kanıtlamaktadır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Değerlendirme sonuçları, büyük dil modellerinin performansını değerlendirmek için sözcüksel ve anlamsal metriklerin birleştirilmesini savunan güncel çalışmalarla4,12 tutarlıdır. Özellikle, anlamsal yorumlamanın sözcüksel eşleşmenin ötesine geçtiği sağlık hizmetleriyle ilgili dil üretiminde, bağlamsal benzerliği yakalamak için gömme tabanlı (embedding-based) metrikler giderek daha önemli hale gelmiştir28,29.
Genel olarak değerlendirme, önerilen platformun birlikte çalışabilirlik standartlarını, Geri Çağırma ile Güçlendirilmiş Üretimi (RAG) ve çok ajanlı işlemeyi sağlık veri analizi için birleştirilmiş bir çerçevede entegre ettiğini göstermektedir. Bu çalışmada sunulan nicel ve nitel sonuçlar, önerilen iş akışının değerlendirilen deneysel koşullar altındaki fizibilitesini desteklemekte ve gerçek dünya klinik ortamlarındaki gelecekteki doğrulamalar için bir temel oluşturmaktadır.
VERİ KULLANILABİLİRLİĞİ
Bu çalışmada kullanılan veri setleri kamuya açıktır. Göğüs röntgeni veri seti, https://openi.nlm.nih.gov/ adresinde bulunan indiana_reports.csv ve indiana_projections.csv dosyalarını da kapsayacak şekilde, Indiana University Chest X-ray Collection'dan (Open-i, U.S. National Library of Medicine) elde edilmiştir. MedQA kıyaslama veri seti, resmi deposu aracılığıyla kamuya açıktır. Bu çalışmada tescilli veya hasta kimliğini belirleyebilecek klinik veriler kullanılmamıştır. Tekrarlanabilirliği desteklemek amacıyla tüm ön işleme prosedürleri Protokol bölümünde açıklanmıştır.
Tartışma
Bu çalışmada sunulan değerlendirme, halka açık ve tamamen anonimleştirilmiş referans sağlık veri kümeleri kullanılarak gerçekleştirilen metodolojik bir doğrulamayı temsil etmektedir. Bu çalışmanın amacı klinik etkinliğin ötesinde, tekrarlanabilir bir uygulama protokolü göstermek olduğundan, sağlık profesyonellerini veya hasta alımını içeren prospektif bir klinik doğrulama yürütülmemiştir.
Bu çalışmanın bulguları, sağlık hizmetleri birlikte çalışabilirlik standartlarının büyük dil modelleriyle birleştirilmesinin, heterojen klinik bilgilerin entegrasyonu için pratik bir çerçeve sunduğunu göstermektedir. Önerilen mimari; FHIR ve HL7 dahil olmak üzere yapılandırılmış veri değişim mekanizmalarını, dijital sağlık sistemlerindeki güncel gelişmelerle uyumlu, birleşik bir iş akışında yapay zeka tabanlı dil işleme ile bir araya getirmektedir15,16,17.
Önerilen iş akışının önemli bir yönü, çoklu ajan mimarisi içinde Geri Getirme ile Güçlendirilmiş Üretim'in (Retrieval-Augmented Generation - RAG) entegrasyonudur. Bu konfigürasyonda, geri getirilen belgeler yanıt üretimi sırasında ek bağlamsal bilgiler sağlayarak bilgi yoğunluklu klinik görevleri destekler. Bu mimari tasarım, geri getirme tabanlı mekanizmaları, büyük dil modeli uygulamalarında bağlamsal temellendirmeyi ve yanıt güvenilirliğini artırmaya yönelik bir strateji olarak tanımlayan güncel çalışmalarla uyumludur18,19.
Yanıt oluşturma sırasında bağlamsal yorumlamayı desteklemek amacıyla, önerilen iş akışına yapılandırılmış istemleme stratejileri dahil edilmiştir. Önceki çalışmalar, istem mühendisliği ve yapılandırılmış akıl yürütme tekniklerinin, büyük dil modellerinin karmaşık karar verme görevlerindeki performansını artırabileceğini bildirmiştir20. Bu protokolde benimsenen yaklaşım, bu gelişmelerle uyumludur ve klinik dil işleme için yapılandırılmış bir çerçeve sunmaktadır.
Değerlendirme perspektifinden bakıldığında, tamamlayıcı metriklerin kullanımı, sistem performansının farklı boyutlarının incelenmesine olanak tanımıştır. BLEU ve ROUGE sentaktik benzerlik ve içerik kapsamı hakkında bilgi sağlarken23,24, BERTScore gibi gömme tabanlı metrikler, yalnızca sözcüksel örtüşme ile yansıtılamayabilecek anlamsal ilişkileri yakalamaktadır25. Bu çok boyutlu değerlendirme stratejisi, sağlık hizmetleri uygulamalarında büyük dil modellerini değerlendirirken sözcüksel ve anlamsal ölçümlerin birleştirilmesini öneren güncel kıyaslama çalışmalarıyla uyumludur4,12.
Önerilen iş akışı, birlikte çalışabilir yapay zeka tabanlı klinik karar destek sistemlerinin uygulanması için tekrarlanabilir bir metodolojik çerçeve sunmaktadır. Bu çalışma, farklı yapay zeka mimarilerini kıyaslamak yerine, tekrarlanabilirliği ve gelecekteki adaptasyonu kolaylaştırmak amacıyla tüm uygulama iş akışını, sistem mimarisini, birlikte çalışabilirlik mekanizmalarını ve değerlendirme metodolojisini belgelendirmeye odaklanmaktadır. Geleneksel LLM'leri, RAG devre dışı bırakılmış konfigürasyonları, ince ayar yapılmış modelleri veya geleneksel makine öğrenimi yaklaşımlarını içeren karşılaştırmalı analizler, bu metodolojik katkının kapsamı dışındadır ve gelecekteki araştırmalar için önemli bir yönü temsil etmektedir.
Önerilen çerçevenin gelecekte gerçek dünya klinik ortamlarına aktarılması, sağlık uzmanlarıyla ek doğrulamaların yapılmasının yanı sıra geçerli düzenleyici ve etik gerekliliklere uyumu gerektirecektir. Kullanım amacına bağlı olarak, bu sistemler Tıbbi Cihaz Olarak Yazılım (SaMD) düzenlemelerine tabi olabilir ve ABD Gıda ve İlaç İdaresi (FDA) ile Avrupa Tıbbi Cihaz Yönetmeliği (MDR) dahil olmak üzere düzenleyici makamlar tarafından belirlenen gerekliliklere uygun olmalıdır. Ayrıca, sağlık kurumlarında güvenli ve sorumlu bir dağıtımı desteklemek için güçlü veri yönetişimi, siber güvenlik, şeffaflık ve klinik güvenlik uygulamaları temel öneme sahip olacaktır.
Nitel analiz, temsilci klinik senaryolar genelinde oluşturulan yanıtların özelliklerini örneklendirerek nicel değerlendirmeyi tamamlamıştır. Sunulan örnekler, platformun değerlendirilen koşullar altında bağlamsal olarak tutarlı yanıtlar üretebildiğini göstermekte ve nicel metriklerin ötesinde yanıtların yorumlanabilirliği hakkında ek bilgi sağlamaktadır. Benzer gözlemler, büyük dil modellerini tanısal destek ve hasta etkileşimi dahil olmak üzere klinik uygulamalara uygulayan çalışmalarda da bildirilmiştir28,29,30,31.
Önerilen mimari; veri doğrulama, bağlamsal filtreleme, klinik akıl yürütme desteği ve çıktı doğrulama dahil olmak üzere tamamlayıcı işlevlerden sorumlu özelleşmiş modüllere işlem görevlerini dağıtmaktadır. Bu modüler organizasyon, tek bir dil modeline olan bağımlılığı azaltmakta ve iş akışı içerisinde bilgi işlemenin ardışık aşamalarına olanak tanımaktadır. Benzer mimari stratejiler, dağıtık yapay zeka sistemleri ve karmaşık karar verme ortamları için tasarlanmış çok etmenli çerçeveler üzerine yapılan güncel çalışmalarda tanımlanmıştır21,22.
Önerilen protokolün tekrarlanabilirliğini ve uygulamasını kolaylaştırabilecek birkaç uygulama hususu bulunmaktadır. Klinik bilgilerin HL7 FHIR standardına tutarlı bir şekilde eşlenmesi, veri işleme hattı boyunca semantik birlikte çalışabilirliğin korunmasına yardımcı olur. Benzer şekilde, belge ön işleme, parçalama stratejileri, gömme (embedding) üretimi ve vektör indeksleme, Veri Geri Çağırma ile Zenginleştirilmiş Üretim (Retrieval-Augmented Generation) iş akışının davranışını etkiler; bu nedenle hedef uygulamanın özelliklerine göre yapılandırılmalı ve doğrulanmalıdır. Yanıt üretimi sırasında bağlamsal temellendirmeyi iyileştirmek için istem mühendisliği (prompt engineering) ve çoklu ajan orkestrasyonu, alana özgü bilgiler ve uzman geri bildirimleri kullanılarak yinelemeli olarak geliştirilebilir. Bu uygulama yöntemleri, güvenilir yapay zeka ve geri çağırma ile zenginleştirilmiş dil modellerindeki güncel gelişmelerle uyumludur18,19,20.
Bu çalışmanın bazı kısıtlılıkları kabul edilmelidir. Değerlendirme, tamamlayıcı nicel ve nitel metrikleri birleştirmiş olsa da, bu ölçümler klinik akıl yürütmenin tüm yönlerini tam olarak yansıtmayabilir. Bu gözlem, sağlık uygulamaları için alana özgü değerlendirme çerçeveleri öneren önceki çalışmalarla tutarlıdır12. Ayrıca platform, gerçek dünyadaki klinik ortamların değişkenliğini ve karmaşıklığını tam olarak temsil etmeyebilecek, halka açık ve anonimleştirilmiş kıyaslama veri setleri kullanılarak kontrollü koşullar altında değerlendirilmiştir.
Önerilen platform, yerleşik sağlık hizmetleri birlikte çalışabilirlik standartlarına uygun olarak geliştirilmiştir. HL7 ve FHIR'ın benimsenmesi, heterojen sağlık bilgi sistemleri arasında yapılandırılmış veri değişimini destekleyerek birden fazla kaynaktan gelen klinik bilgilerin entegrasyonu için standartlaştırılmış bir çerçeve sağlar. Bu mimari yaklaşım, dağıtık sağlık hizmetleri ortamları için birlikte çalışabilir yapay zeka sistemleri geliştirme yönündeki güncel çalışmalarla uyumludur15,16,17.
Önerilen iş akışının başarılı bir şekilde uygulanması, birkaç kritik metodolojik adıma bağlıdır. İlk olarak, heterojen sağlık sistemleri arasında semantik birlikte çalışabilirliği korumak için klinik veriler tutarlı bir şekilde standartlaştırılmış HL7 FHIR kaynaklarıyla eşleştirilmelidir15,17. İkinci olarak; normalizasyon, parçalama stratejisi ve gömme (embedding) oluşturmayı içeren belge ön işleme aşamaları dikkatle yapılandırılmalıdır, çünkü bu aşamalar Geri Çağırma ile Güçlendirilmiş Üretim (Retrieval-Augmented Generation - RAG) hattı içindeki geri çağırma kalitesini doğrudan etkiler19,32,33. Üçüncü olarak, indekslenmiş belgeler ile geri çağırma sonuçları arasındaki tutarlılığı sağlamak için bilgi tabanı her güncellendiğinde vektör veri tabanı yeniden oluşturulmalıdır. Son olarak, bağlamsal doğruluğu artırmak, halüsinasyonları en aza indirmek ve yapay zeka destekli klinik karar destek iş akışlarının yeniden üretilebilirliğini geliştirmek için istem mühendisliği (prompt engineering) ve çoklu ajan orkestrasyonu, temsili klinik senaryolar kullanılarak yinelemeli olarak doğrulanmalıdır4,3,20,31.
Sorun giderme perspektifinden bakıldığında, yaygın uygulama zorlukları arasında eksik FHIR kaynak eşlemesi, belge indeksleme veya vektör veri tabanı yapılandırmasıyla ilişkili azalmış erişim performansı ve yetersiz bağlamsal bilgi veya suboptimal istem mühendisliği tarafından etkilenen yanıtlar yer almaktadır. Bu sorunlar; birlikte çalışabilirlik kaynaklarının doğrulanması, erişim parametrelerinin optimizasyonu, bilgi tabanındaki değişikliklerden sonra vektör veri tabanının periyodik olarak güncellenmesi veya yeniden oluşturulması ve tamamlayıcı sözcükbilimsel ve anlamsal metrikler kullanılarak sürekli değerlendirme yapılması yoluyla çözülebilir. Bu uygulamalar, tutarlı sistem davranışını destekler ve yapay zeka destekli klinik karar destek iş akışlarının konuşlandırılmasını ve bakımını kolaylaştırır4,12,25,23..
Pratik bir perspektiften bakıldığında, büyük dil modellerinin sağlık hizmetleri ortamlarında konuşlandırılması, hesaplama kaynaklarının ve altyapı gereksinimlerinin değerlendirilmesini gerektirir. Önerilen mimari hem bulut tabanlı hem de yerel yürütmeyi desteklese de, özellikle kaynakların kısıtlı olduğu ortamlarda, konuşlandırma ölçeğine ve mevcut hesaplama kaynaklarına bağlı olarak ek optimizasyon stratejileri gerekli olabilir4.
Gelecekteki araştırmalar, platformu gerçek dünya klinik veri setleri ve rutin sağlık hizmetleri iş akışlarıyla değerlendirerek önerilen iş akışını genişletebilir. Ek incelemeler, model yorumlanabilirliğini artırmak ve klinik karar destek sürecinde şeffaflığı desteklemek için alana özgü ince ayar stratejilerini ve açıklanabilir yapay zeka yöntemlerinin entegrasyonunu da araştırabilir. Bu yönelimler, platformun pratik sağlık hizmetleri ortamlarında daha kapsamlı bir şekilde değerlendirilmesine katkıda bulunabilir.
Genel olarak bu çalışma, sağlık hizmetleri birlikte çalışabilirlik standartlarını, Geri Getirme ile Artırılmış Üretimi (RAG) ve çok ajanlı dil modeli mimarilerini birleşik bir klinik veri işleme iş akışı içinde entegre etmek için yeniden üretilebilir bir çerçeve sunmaktadır. Önerilen protokol, yapay zeka destekli tıbbi veri analiz sistemlerinin uygulanması ve değerlendirilmesi için yapılandırılmış bir yaklaşım sağlamakta olup, birlikte çalışabilir klinik karar destek sistemlerindeki gelecekteki geliştirmeler için bir referans görevi görebilir.
Açıklamalar
Yazarlar, bu makalede rapor edilen çalışmayı etkileyebilecek herhangi bir rakip finansal çıkar veya kişisel ilişki beyan etmemektedir. Üretken yapay zeka (AI) araçları; yalnızca dil düzenleme, dil bilgisi düzeltme ve makale okunabilirliğindeki iyileştirmelere yardımcı olmak amacıyla kullanılmıştır. Tüm bilimsel içerik, çalışma tasarımı, metodoloji, veri analizi, sonuçların yorumlanması ve editöryal kararlar, makale içeriğinin tüm sorumluluğunu üstlenen yazarlar tarafından geliştirilmiş, doğrulanmış ve onaylanmıştır.
Teşekkürler
Yazarlar, bu çalışmanın geliştirilmesini destekleyen araştırma ortamını ve teknik tartışmaları sağladığı için Ceará Federal Üniversitesi (UFC), Gömülü ve Dağıtık Sistemler Laboratuvarı'na (LESC) teşekkür ederler. Yazarlar ayrıca, bu çalışma boyunca kullanılan açık kaynaklı yazılımların, birlikte çalışabilirlik standartlarının ve kamuya açık veri setlerinin geliştiricilerine ve yöneticilerine şükranlarını sunarlar.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Retrieval-Augmented Generation (RAG) hattında benzerlik araması için kullanılan vektör veritabanı. |
| FHIR Standard | HL7 International | Release 4 (R4) | Yapılandırılmış klinik veri değişimi için benimsenen sağlık hizmetleri birlikte çalışabilirlik standardı. |
| Flask | Pallets Projects | Version 3.0.3 | RESTful backend API'yi uygulamak için kullanılan Python web çerçevesi. |
| HL7 Standard | HL7 International | Version 2.x | Hastane bilgi sistemleri ile birlikte çalışabilirlik için kullanılan eski mesajlaşma protokolü. |
| HTTP REST API | Custom Implementation | N/A | Frontend, backend, veritabanı ve yapay zeka servisleri arasındaki RESTful iletişim katmanı. |
| LangChain | LangChain Inc. | Version 0.3.x | LLM'leri, istem mühendisliğini ve Retrieval-Augmented Generation iş akışlarını entegre etmek için kullanılan çerçeve. |
| LangGraph | LangChain Inc. | Version 0.2.x | Çok ajanlı klinik akıl yürütme iş akışını yönetmek için kullanılan çerçeve. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Klinik akıl yürütme ve doğal dil üretimi için kullanılan Büyük Dil Modeli. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Yapılandırılmış klinik verileri saklamak için kullanılan ilişkisel veritabanı. |
| Ollama | Ollama Inc. | Version 0.9.x | Hasta gizliliğini korurken Büyük Dil Modellerini çalıştırmak için kullanılan yerel çıkarım motoru. |
| Python | Python Software Foundation | Version 3.11 | Platformun tamamını uygulamak için kullanılan programlama dili. |
| PyTorch | Linux Foundation | Version 2.4 | Büyük Dil Modeli çıkarımı için kullanılan derin öğrenme çerçevesi. |
| Retrieval-Augmented Generation (RAG) Pipeline | Custom Implementation | N/A | Bağlam duyarlı yanıt üretimi için semantik geri çağırmayı LLM çıkarımıyla birleştiren yapay zeka çerçevesi. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Semantik doküman geri çağırma için yoğun vektör temsilleri oluşturmak amacıyla kullanılan gömme modeli. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | Geliştirme ve deneysel değerlendirme için kullanılan işletim sistemi. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Yazılım uygulaması ve hata ayıklama için kullanılan entegre geliştirme ortamı. |
Kaynaklar
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.