Bu çalışma, kronik obstrüktif akciğer hastalığında (KOAH) potansiyelle tanısal biyobelirteçleri ve düzenleyici ağları belirlemek için transkriptomik, makine öğrenimi ve immün infiltrasyon analizini entegre eden, tekrarlanabilir bir biyoinformatik boru hattı sunmaktadır.
Araştırma makalesi
Tanısal Bir Biyobelirteç Olarak UPP1: KOAH'ta İntegratif Biyoenformatik ve İmmün İnfiltrasyon Analizlerinden Elde Edilen Bulgular
* These authors contributed equally
Bu makalede
Özet
Özet
KOAH, kalıcı hava akımı kısıtlaması ve kronik inflamasyon ile karakterize progresif bir solunum yolu hastalığıdır, ancak N4-asetilsitidin (ac4C) RNA modifikasyonunun patogenezindeki rolü büyük ölçüde keşfedilmemiş durumdadır. Bu çalışma, yayınlanmış bir veri tabanından ac4C ile ilişkili genleri (ac4C-RG'ler) sistematik olarak taramayı ve KOAH'taki düzenleyici ağlarını araştırmayı, böylece herhangi bir spesifik gen ile ac4C modifikasyonu arasında doğrudan bir düzenleyici ilişki varsaymadan ilerideki mekanistik çalışmalar için potansiyel biyobelirteçler belirlemeyi amaçlamıştır. Transkriptomik profillerdenle diferansiyel olarak ekspresyon gösteren genler (DEG'ler) tanımlanmış ve temel ko-ekspresyon modüllerini ortaya çıkarmak için ağırlıklı gen ko-ekspresyon ağ analizi (WGCNA) uygulanmıştır. DEG'ler, anlamlı modüller ve ac4C-RG'ler arasında çapraz analiz gerçekleştirilmiştir. Anahtar genler LASSO regresyonu, XGBoost ve rastgele orman algoritmaları kullanılarak taranmış, ardından lojistik regresyona dayalı tanısal model oluşturulmuştur. Model performansı, alıcı işletim karakteristiği (ROC) eğrisi analizi, %95 güven aralıklarıyla eğri altındaki alan (AUC), kalibrasyon eğrisi değerlendirmesi ve karar eğrisi analizi (DCA) ile değerlendirilmiştir. Toplam 160 örtüşen gen tanımlanmış ve altı hub gen (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B ve B4GALT2) üç makine öğrenimi algoritmasının tamamı tarafından tutarlı bir şekilde seçilmiştir. Tanısal model; eğitim, dahili test ve harici doğrulama setlerinde sırasıyla 0,766, 0,759 ve 0,723'lük AUC değerleri ile iyi bir ayırt edici performans göstermiştir. Düzenleyici ağ analizi, potansiyel ceRNA eksenleri ve transkripsiyon faktörü etkileşimleri önermiş; immün infiltrasyon profillemesi ise anahtar genler ile birden fazla immün hücre alt kümesi arasında anlamlı korelasyonlar ortaya koymuştur. İlaç-gen etkileşim analizi ve moleküler kenetlenme, fluorouracil, capecitabine ve 5-benzylacyclouridine'in UPP1 ile öngörülen uygun bağlanma afiniteleri sergileyebileceğini göstermiştir. Sonuç olarak, PTRF, PRKCDBP, UPP1, TOR3A, FAM168B ve B4GALT2, KOAH'ta potansiyel ac4C ile ilişkili biyobelirteçler olarak tanımlanmış, bunların immün ve metabolik düzenlemede rol oynamış olabileceği belirlenmiş ve gelecekteki fonksiyonel araştırmalar ile terapötik keşifler için bir temel oluşturulmuştur.
Giriş
KOAH, alveoler ve havayolu yapılarındaki anormalliklerden kaynaklanan progresif hava akımı kısıtlaması ile karakterize, kronik ve heterojen bir solunum yolu hastalığıdır1,2. Proteaz-antiproteaz dengesizliği, oksidatif stres, kronik inflamasyon ve hücresel senesans, KOAH'ın temel patofizyolojik mekanizmalarını oluşturarak akciğer dokusunun yapısal yıkımına ve fonksiyonel bozulmasına yol açar3,4. Ayrıca KOAH; uzun süreli sigara kullanımı, çevresel kirlilik, mesleki maruziyet, solunum yolu enfeksiyonları ve genetik yatkınlık dahil olmak üzere çok sayıda risk faktöründen etkilenmektedir5,6. KOAH, küresel ekonomi üzerinde önemli bir yük oluşturmuştur. 2020'den 2050'ye kadar yıllık olarak küresel GSYİH'nın %0,111'ini oluşturacağı öngörülmektedir7. Bronkodilatörler, inhale kortikosteroidler, pulmoner rehabilitasyon ve uzun süreli oksijen tedavisi gibi güncel terapötik stratejiler semptomları hafifletebilse de, hastalığın ilerlemesini durdurmak hala zorlayıcıdır. Belirgin klinik heterojenlik nedeniyle, hasta sonuçları geniş farklılıklar göstermektedir8. Bu nedenle, KOAH yönetimini geliştirmek ve hasta sağkalımını artırmak için yeni tanısal biyobelirteçlere ve prognostik göstergelere acil ihtiyaç vardır.
RNA modifikasyonu, gen ekspresyonunu düzenlemek için RNA yapısını ve işlevini değiştirebilen RNA moleküllerinin kimyasal değişimini ifade eder9,10. Yaygın RNA modifikasyonları arasında N6-metiladenozin (m6A), psödouridin (Ψ), 5-metilsitozin (m5C) ve ac4C yer alır11. ac4C modifikasyonu, mRNA stabilitesinin korunmasında ve mRNA translasyonunun teşvik edilmesinde kritik bir rol oynar12,13. NAT10, ac4C modifikasyonunu katalizleyen bilinen tek ökaryotik enzimdir ve aktivitesi bu modifikasyonun oluşumu için esastır14. Çalışmalar; oksidatif stres, hücresel senesans, inflamasyon ve ac4C modifikasyonu arasında güçlü bir korelasyon olduğunu göstermiştir. Örneğin, inflamatuar bağırsak hastalığı (IBD) olan bireylerden alınan kolon dokularındaki CD4+ T lenfositleri, belirgin şekilde yükselmiş NAT10 seviyeleri sergilemektedir15. NAT10, CCL2 ve CXCL1 kemokinlerinin ac4C asetilasyonunu artırarak makrofaj ve nötrofil infiltrasyonunu teşvik eder ve inflamatuar hasarı şiddetlendirir16. Oksidatif stres altında ac4C seviyelerindeki belirgin artışla kanıtlandığı üzere, oksidatif strese verilen hücresel yanıt ac4C modifikasyonunu içerebilir. Ek olarak NAT10, TGFB1 mRNA'sını ac4C modifikasyonu aracılığıyla stabilize ederek PM2.5-indükli pulmoner fibrozisi teşvik eder ve böylece epitel-mezenşimal geçişi tetikler17. Ancak, ac4C modifikasyonunun KOAH'taki rolü büyük ölçüde araştırılmamıştır ve bu durum, söz konusu alanda daha fazla araştırmaya olan ihtiyacı vurgulamaktadır.
Bu çalışmada, KOAH hastaları ve kontroller arasındaki DEG'leri belirlemek için GEO veri tabanı kullanılmıştır. Ardından, multiomik verilerden derlenen yayınlanmış bir ac4C-RG listesi18, örtüşen adayları belirlemek amacıyla DEG'lerle entegre edilmiştir. ac4C modifikasyonunun KOAH'ın temel süreçleri olan inflamasyon ve oksidatif stresi etkilediği bilindiğinden, ac4C düzenleyici ağıyla ilişkili genlerin KOAH'ta düzensiz çalışabileceği hipotezi kurulmuştur. Ancak, örtüşen genler NAT10'un doğrudan substratları veya doğrudan ac4C tarafından düzenlenen genler olarak değil, ac4C ile ilişkili ağla bağlantılı adaylar olarak değerlendirilmiştir. Anahtar genler, birden fazla makine öğrenimi algoritması kullanılarak taranmış, ardından bir tanı modelinin kurulumu ve doğrulanması gerçekleştirilmiştir. Sonrasında, KOAH patogenezinde rol oynayan ilgili yolaklar belirlenmiş ve potansiyel hedef ilaçlar tahmin edilmiştir. Son olarak, anahtar genlerin ekspresyon seviyelerini doğrulamak için RT-qPCR analizleri yapılmış; böylece KOAH patofizyolojisine dair ön bilgiler edinilmiş ve terapötik araştırmalar için potansiyel yollar sunulmuştur.
Protokol
Kurumsal inceleme kurulu beyanı
Bu çalışma Helsinki Deklarasyonu'na uygun olarak yürütülmüştür. Protokol, Shenzhen Luohu Geleneksel Çin Tıbbı Hastanesi Etik Kurulu tarafından onaylanmış (onay no. 2024-LHQZYYYXLL-KY-039) ve kayıt öncesinde tüm katılımcılardan yazılı bilgilendirilmiş onam alınmıştır. Bu protokolde kullanılan araştırma araçlarının ve malzemelerinin ayrıntıları Malzemeler Tablosunda sunulmuştur.
Veri kaynağı ve işleme
KOAH ile ilişkili gen ekspresyon veri setleri Gene Expression Omnibus (GEO) üzerinden elde edilmiştir. Transkriptom veri seti olarak GSE54837 veri seti, doğrulama seti olarak ise GSE112811 veri seti kullanılmıştır (Tablo 1). ac4C-RG'ler literatürden derlenmiştir18. KOAH ve kontrol grupları arasındaki diferansiyel olarak eksprese edilen genler (DEG'ler), limma R paketi kullanılarak belirlenmiştir. |log2FC| > 0 ve p < 0,05 olması durumunda DEG'ler istatistiksel olarak anlamlı kabul edilmiştir. Gen ekspresyon değişikliklerinin genel dağılımını görselleştirmek için yanardağ (volcano) grafikleri oluşturulmuştur.
WGCNA'nın Oluşturulması
KOAH ile ilişkili modülleri belirlemek amacıyla, R kullanılarak GSE54837 veri seti üzerinde WGCNA gerçekleştirilmiştir. Ağ yapımından önce, ortalama bağlama yöntemi ve Öklid mesafe metriği ile hclust fonksiyonu kullanılarak yapılan hiyerarşik kümeleme analizi yoluyla aykırı örnekler tespit edilmiş ve çıkarılmıştır. Optimal yumuşak eşikleme gücü (β ölçeksiz topoloji uyum indeksi R'yi elde etmek için (= 10) seçilmiştir2 ölçeksiz topoloji ve ortalama bağlantısallığı dengeleyen ≥ 0,85 değeri kullanılmıştır. Bir komşuluk matrisi oluşturulmuş ve topolojik örtüşme matrisine (TOM) dönüştürülmüştür. Gen modülleri, dinamik ağ kesme algoritması (deepSplit = 2, minClusterSize = 50) kullanılarak tanımlanmıştır. Eigengene korelasyonlarına sahip modüller > 0,75 değeri, ardından mergeCloseModules fonksiyonu kullanılarak birleştirilmiştir. Daha sonra, sonraki analizler için KOAH ile ilişkili modülleri belirlemek amacıyla modül özgenleri, Pearson korelasyon katsayıları kullanılarak klinik özelliklerle (KOAH durumu, yaş, cinsiyet ve sigara içme durumu) korele edilmiştir.
Örtüşen genlerin taranması, zenginleştirme analizi ve PPI ağ analizi
DEG'ler, MEsalmon modül genleri ve ac4C-RG'ler arasındaki örtüşen genleri belirlemek için ggvenn R paketi kullanılarak bir Venn diyagramı oluşturulmuştur. Örtüşen genlerin fonksiyonel zenginleştirme analizi, clusterProfiler R paketi ile Gene Ontology (GO) ve Kyoto Encyclopedia of Genes and Genomes (KEGG) veri tabanları kullanılarak gerçekleştirilmiştir. Örtüşen genler arasındaki protein düzeyindeki etkileşimleri analiz etmek için protein-protein etkileşim (PPI) bilgileri STRING veri tabanından (https://string-db.org/) elde edilmiştir. Elde edilen PPI ağını görselleştirmek için Cytoscape yazılımı kullanılmıştır.
Makine öğrenimi aracılığıyla anahtar genlerin belirlenmesi
Üç makine öğrenimi tekniği uygulanmıştır: en küçük mutlak büzülme ve seçme operatörü (LASSO) regresyonu, ekstremi gradyan artırma (XGBoost) ve rastgele orman (RF). LASSO regresyonu, optimal ceza parametresi λ'yi belirlemek için 10 katlı çapraz doğrulama ile glmnet paketi kullanılarak gerçekleştirilmiştir. type.measure parametresi "deviance" ve family parametresi "binomial" olarak ayarlanmıştır. Optimal λ, çapraz doğrulanmış sapmayı minimize eden λmin kriteri kullanılarak seçilmiş ve sonuçta 17 gen elde edilmiştir. XGBoost, xgboost paketi kullanılarak şu hiperparametrelerle uygulanmıştır: nrounds = 100, max_depth = 6, eta = 0.3, subsample = 0.8, colsample_bytree = 0.8 ve eval_metric = "logloss". Özellik önemi gain metriği ile sıralanmış ve en iyi 30 gen seçilmiştir. Rastgele orman, randomForest paketi kullanılarak ntree = 200 ile uygulanmıştır. Özellik önemi, Gini'deki ortalama azalma ile sıralanmış ve en iyi 30 gen seçilmiştir. Sonraki analizler için anahtar genleri belirlemek amacıyla, üç makine öğrenimi yöntemiyle seçilen genlerin kesişimi alınmıştır.
Risk tahmini için lojistik regresyon modelinin oluşturulması ve değerlendirilmesi
GSE54837 veri seti, rastgele olarak bir eğitim seti (%70) ve bir test seti (%30) şeklinde ikiye ayrılmıştır. Temel genlerin ekspresyon seviyeleri girdi özellikleri olarak kullanılarak, MASS paketindeki glm fonksiyonu ile eğitim seti üzerinde bir lojistik regresyon modeli oluşturulmuştur. Model performansı, pROC paketi ile oluşturulan ROC eğrileri kullanılarak değerlendirilmiştir. AUC için %95 güven aralıkları, 2.000 bootstrap tekrarı ile hesaplanmıştır. Model kalibrasyonu, 1.000 bootstrap yeniden örneklemesiyle (rms paketi) oluşturulan kalibrasyon eğrileri kullanılarak değerlendirilmiştir. Bir dizi eşik olasılığı boyunca net klinik faydayı değerlendirmek için dca paketi kullanılarak DCA gerçekleştirilmiştir. Bireyselleştirilmiş risk tahminini kolaylaştırmak amacıyla, rms paketindeki nomogram fonksiyonu kullanılarak bir nomogram oluşturulmuştur.
Regresyon denklemi şuydu:
logit(P) = 0.5823 + 0.6010 × UPP1 - 0.6563 × PTRF + 0.3853 × B4GALT2 - 0.3972 × FAM168B + 0.1848 × PRKCDBP - 0.4787 × TOR3A. (1)
Burada P, KOAH'ın öngörülen olasılığını temsil eder ve her bir katsayı, ilgili gen ekspresyon değerinin KOAH log oranlarına (log odds) olan katkısını temsil eder.
Ekspresyon analizi, GeneMANIA ağı ve moleküler düzenleyici ağ
GSE54837 veri setindeki KOAH ve kontrol grupları arasındaki gen ekspresyon seviyeleri, Wilcoxon sıra toplamı testi kullanılarak karşılaştırıldı. Ekspresyon seviyelerinin dağılımını görselleştirmek için, medyan, çeyrekler arası aralık (IQR) ve bireysel veri noktalarının üzerine eklendiği kutu grafikleri ggplot2 paketi kullanılarak oluşturuldu. Gen ağlarını kurmak ve fonksiyonel etkileşimleri tahmin etmek için GeneMANIA kullanıldı. Arama, varsayılan parametrelerle gerçekleştirildi: tür = Homo sapiens, maksimum ilgili gen sayısı = 20. Ortaya çıkan ağ indirildi ve görselleştirildi; kenar renkleri etkileşim türlerini belirtmektedir. Transkripsiyon sonrası düzenleyici mekanizmaları incelemek için rekabetçi endojen RNA (ceRNA) ağı kuruldu. Altı ana geni hedefleyen miRNA'lar, iki bağımsız veri tabanı kullanılarak tahmin edildi: DIANA-microT (skor ≥ 0,8) ve miRanda (skor ≥ 140, enerji ≤ −20 kcal/mol). Her iki veri tabanı tarafından tanımlanan miRNA'ların kesişimi, miRNA-mRNA çiftlerini oluşturmak için kullanıldı. Ardından, bu miRNA'ları hedefleyen lncRNA'lar StarBase veri tabanı kullanılarak tahmin edildi. Bir lncRNA-miRNA-mRNA düzenleyici ağı kuruldu ve Cytoscape kullanılarak görselleştirildi. Transkripsiyonel düzenleyici ilişkiler, ChIP-X Enrichment Analysis Version 3 (ChEA3) kullanılarak tahmin edildi. TF tahmini yapılan her bir ana gen için, en yüksek zenginleştirme skoruna sahip ilk 10 transkripsiyon faktörü seçildi. Cytoscape'de bir TF-hedef düzenleyici ağı kuruldu.
Gen seti zenginleştirme analizi ve immün hücre infiltrasyon değerlendirmesi
Her bir ana genin biyolojik fonksiyonlarını incelemek için clusterProfiler paketi kullanılarak gen seti zenginleştirme analizi (GSEA) gerçekleştirilmiştir. Her bir ana gen için örnekler, medyan değere göre yüksek ve düşük ekspresyon gruplarına ayrılmıştır. İki grup arasındaki diferansiyel ekspresyon analizi limma kullanılarak yapılmış ve elde edilen gen listesi, işaretli log₂ kat değişimine (fold-change) göre sıralanmıştır. GSEA, GO biyolojik süreç terimleri için gseGO fonksiyonu ve KEGG yolakları için gseKEGG fonksiyonu kullanılarak şu parametrelerle yürütülmüştür: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0.05 ve nPerm = 1.000. 28 immün hücre tipinin göreceli bolluğu, GSVA paketinde yer alan tek örnek gen seti zenginleştirme analizi (ssGSEA) kullanılarak tahmin edilmiştir. 28 immün hücre tipi için marker genleri içeren küratörlü bir gen seti imza matrisi, önceki literatürden19 elde edilmiştir. Her bir örnek için gsva fonksiyonu; method = "ssgsea", ssgsea.norm = TRUE ve kcdf = "Gaussian" parametreleri ile uygulanmıştır. ssGSEA zenginleştirme skorları ile altı ana genin ekspresyon seviyeleri arasındaki Spearman korelasyon katsayıları cor.test fonksiyonu kullanılarak hesaplanmıştır. p değerleri, Benjamini-Hochberg yöntemi kullanılarak çoklu testler için düzeltilmiştir. Korelasyon matrisi, pheatmap paketi kullanılarak bir ısı haritası (heatmap) şeklinde görselleştirilmiştir.
İlaç tahmini, moleküler kenetleme ve hastalık ilişkisi analizi
Temel genleri hedefleyen potansiyel terapötik bileşikler DrugBank veri tabanı kullanılarak belirlendi. Tahmin edilen ilaç-gen etkileşimlerini görselleştirmek için Cytoscape programında bir “temel gen hedefli ilaç” etkileşim ağı oluşturuldu. Bağlanma afinitelerini değerlendirmek için CB-Dock2 platformu kullanılarak moleküler kenetleme gerçekleştirildi. İnsan UPP1 proteininin 3D yapısı Protein Veri Bankası'ndan (PDB ID: 7B8T) alındı. İlaç moleküler yapıları (SMILES formatında) PubChem'den elde edildi. Kenetleme işlemi AutoDock Vina motoru kullanılarak gerçekleştirildi ve çıktılar bağlanma serbest enerjisine (ΔG, kcal/mol cinsinden) göre sıralandı. Kenetleme kompleksleri PyMOL kullanılarak görselleştirildi. Temel genler ile çevresel maruziyetlerle ilişkili insan hastalıkları arasındaki ilişkiler Karşılaştırmalı Toksikogenomik Veri Tabanı (CTD) kullanılarak incelendi. Her gen için ayrı ayrı sorgulama yapıldı ve en güçlü ilişkili ilk on hastalık çıkarılarak radar grafikleri ile görselleştirildi.
RT-qPCR protokolü
Sekiz KOAH hastası ve sekiz sağlıklı kontrolden periferik venöz kan örnekleri Shenzhen Luohu Geleneksel Çin Tıbbı Hastanesi'nde toplanmıştır. KOAH, post-bronkodilatör FEV1/FVC < 0,70 olarak tanımlanan Global Initiative for Chronic Obstructive Lung Disease (GOLD) kriterlerine göre teşhis edilmiştir. Kontrol grubu, solunum yolu hastalığı öyküsü olmayan ve pulmoner fonksiyon testleri normal (tahmin edilen FEV1% ≥ %80 ve FEV1/FVC ≥ 0,70) olan, yaş ve cinsiyetten eşleştirilmiş sağlıklı gönüllülerden oluşmuştur. Hastaların temel bilgileri Tablo 2'de gösterilmektedir. Toplam RNA, bir kan RNA ekstraksiyon kiti kullanılarak KOAH kan örneklerinden ekstrakte edilmiştir. cDNA sentezi için, 500 ng toplam RNA, genetik DNA uzaklaştırma özellikli bir cDNA sentez kiti kullanılarak sağlanan protokole uygun şekilde ters yazıma uğratılmıştır. Elde edilen cDNA, 150 ng/μL olacak şekilde seyreltilmiştir.
RT-qPCR, bir gerçek zamanlı PCR sisteminde SYBR Green bazlı bir qPCR master mix kullanılarak gerçekleştirildi. Her 10 μL'lik reaksiyon; 5 μL 2x SYBR Green master mix, 0.5 μL'lik ileri ve geri primerler (10 μM), 1 μL seyreltilmiş cDNA (15 ng/μL) ve 3 μL nükleaz içermeyen su içeriyordu. Döngü koşulları; 5 dk boyunca 95 °C'de başlangıç denatürasyonunu, ardından 10 s 95 °C ve 30 s 60 °C şeklinde 40 döngüyü ve amplifikasyon özgünlüğünü doğrulamak için 60 °C'den 95 °C'ye kadar yapılan final erime eğrisi analizini içeriyordu. Tüm reaksiyonlar teknik olarak üç tekrar şeklinde gerçekleştirildi. İç referans gen olarak β-actin kullanıldı. Her bir hedef gen için primer verimliliği, standart eğri dilüsyon serileri kullanılarak doğrulandı ve %90 ile %110 arasında değişti. Gen ekspresyon seviyeleri β-actin'e göre normalize edildi ve göreceli ekspresyon 2-ΔΔCt yöntemi kullanılarak hesaplandı. KOAH ve kontrol grupları arasındaki istatistiksel karşılaştırmalar Mann-Whitney U testi kullanılarak gerçekleştirildi.
İstatistiksel analiz
Ağ görselleştirmeleri Cytoscape kullanılarak oluşturulmuş ve istatistiksel analizler R yazılımı ile gerçekleştirilmiştir. Aksi belirtilmedikçe, normal dağılım göstermeyen veriler için Mann-Whitney U testi, iki grubun karşılaştırılması için normal dağılım gösteren verilerde ise Student t-testi kullanılmıştır. p < 0.05 değeri istatistiksel olarak anlamlı kabul edilmiştir.
Sonuçlar
Örtüşen genlerin belirlenmesi, zenginleştirme analizi ve PPI ağı oluşturulması
GSE54837 veri setinden, 1.675'i yukarıye düzenlenmiş (upregulated) ve 1.696'sı aşağıye düzenlenmiş (downregulated) olmak üzere toplam 3.371 DEG belirlenmiştir. En anlamlı yukarı ve aşağı düzenlenme gösteren ilk 10 gen Şekil 1A'da gösterilmiştir. GSE54837 verilerinin hiyerarşik kümelemesi gerçekleştirilmiş (Ek Şekil 1A) ve ölçekten bağımsız ağ topolojisini sağlamak için 10 değerinde bir yumuşak eşikleme gücü uygulanmıştır (Şekil 1B). Gen eş-ifade modülleri, minimum modül boyutu 50 gen olacak şekilde dinamik ağaç kesme yöntemi kullanılarak oluşturulmuş ve her bir modüle ayrı bir renk atanmıştır (Ek Şekil 1B). Özgen (eigengene) korelasyonları > 0,75 olan modüller daha sonra birleştirilmiş (Ek Şekil 1C, Şekil 1C) ve sonuç olarak 14 farklı modül elde edilmiştir. Modül özgenleri ile klinik özellikler arasındaki Pearson korelasyon analizine dayanarak, MEsalmon modülü (5.226 gen içerir), KOAH ile en anlamlı pozitif korelasyonu göstermiştir (r = 0,35, p = 7 x 10⁻8, Şekil 1D). Venn analizi; 3.371 DEG, 5.226 MEsalmon modül geni ve 2.118 ac4C-RG arasında örtüşen 160 gen belirlemiştir (Şekil 1E). Bu 160 genin fonksiyonel zenginleştirme analizi, anlamlı GO terimlerinin tek zincirli RNA bağlanması, mRNA metabolik süreçlerinin düzenlenmesi ve RIG-I sinyal yolu olduğunu göstermiştir (Şekil 1F). Ayrıca KEGG analizi, bu genlerin temel olarak Fc gama R aracılı fagositoz, mRNA gözetim yolu ve fokal adezyon süreçlerinde zenginleştiğini ortaya koymuştur (Şekil 1G). Örtüşen genlerin PPI ağı 118 düğüm ve 196 kenar içermektedir (Şekil 1H).
KOAH'ta altı ana genin tanımlanması
160 örtüşen aday arasından potansiyel kilit genleri daha ayrıntılı belirlemek için üç makine öğrenimi algoritması uygulandı. İlk olarak LASSO regresyonu uygulandı ve optimal ceza parametresini (λ) ≈ 0,091 belirlemek için çapraz doğrulama kullanıldı (Şekil 2A). Katsayı profili grafiği, optimal λ değerinde 17 genin korunduğunu gösterdi (Şekil 2B). XGBoost analizi, en yüksek kazanca sahip ilk 30 geni belirledi ve bunlar arasında PTRF, WBP11 ve LDOC1L yüksek öngörücü değer sergiledi (Şekil 2C). RF algoritması da benzer şekilde, ilk 30 geni Gini önem skorlarına göre sıraladı ve PTRF, RFX5 ile PRKCDBP en öngörücü olanlar arasında yer aldı (Şekil 2D). Üç yöntemle seçilen genlerin kesişim analizi sonucunda altı kilit örtüşen gen belirlendi: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B ve B4GALT2 (Şekil 2E).
Tanısal model oluşturma ve temel genlerin ekspresyon analizi
GSE54837 veri setinin %70'i eğitim seti olarak kullanılarak, altı temel geni içeren bir lojistik regresyon modeli oluşturuldu. ROC eğrisi analizi, eğitim, iç test ve dış doğrulama setleri için sırasıyla 0,766 ( %95 GA: 0,691–0,8417), 0,759 ( %95 GA: 0,6368–0,8817) ve 0,723 ( %95 GA: 0,6085–0,8596) AUC değerleri ile orta düzeyde tanısal performans olduğunu göstermiştir (Şekil 3A–C). Kalibrasyon analizi yüksek güvenilirliği doğrulamış ve DCA, hem eğitim (Şekil 3D–E) hem de doğrulama setlerinde (Şekil 3F–G) geniş bir eşik olasılık aralığında net bir klinik fayda olduğunu göstermiştir. Her bir genin katkısını görselleştirmek ve bireyselleştirilmiş risk tahminini kolaylaştırmak için bir nomogram oluşturulmuştur (Şekil 3H). Ekspresyon analizi, COPD örneklerinde B4GALT2, PRKCDBP ve UPP1 genlerinin anlamlı düzeyde yukarı regüle olduğunu, FAM168B, PTRF ve TOR3A genlerinin ise aşağı regüle olduğunu ortaya koymuştur (Şekil 3I).
KOAH'taki ana genlerin düzenleyici ağı ve fonksiyonel analizi
Tanımlanan hub genlerle en ilişkili ilk 20 geni içeren fonksiyonel bir etkileşim ağı, GeneMANIA analizi kullanılarak oluşturulmuştur (Şekil 4A). Bağlantıların çoğunluğunu fiziksel etkileşimler oluşturmuş, bunları ko-ekspresyon korelasyonları ve ortak protein domainleri izlemiştir. Fonksiyonel anotasyon; nükleobaz içeren küçük molekül katabolik süreç, nükleozid katabolik süreç ve plazma membranı salı (raft) gibi süreçlerde anlamlı bir zenginleşme olduğunu göstermiştir. Transkripsiyon sonrası düzenleme, DIANA-microT ve miRanda veri tabanlarından elde edilen miRNA tahminleri kesiştirilerek araştırılmış ve sekiz örtüşen miRNA tanımlanmıştır (Şekil 4B). Ardından bir lncRNA-miRNA-mRNA düzenleyici ekseni oluşturulmuştur. Sankey diyagramına göre, tanımlanan miRNA'lardan her ikisi de FAM168B düzenlemesi ile ilişkili olan iki tanesinin yedi lncRNA tarafından hedeflendiği öngörülmüş; kalan beş hub gen için böyle bir düzenleyici etkileşim tanımlanmamıştır (Şekil 4C). Transkripsiyonel düzenleme, B4GALT2, UPP1, FAM168B ve TOR3A için yukarı akış transkripsiyon faktörlerini (TF'ler) öngören ChEA3 platformu kullanılarak daha detaylı incelenmiştir. Bir TF-hedef düzenleyici ağı oluşturmak için her gen için en üstteki on TF seçilmiştir (Şekil 4D). Altı temel genin biyolojik fonksiyonlarını araştırmak için GSEA uygulanmıştır. UPP1; diyasilgliserol metabolik süreç ve purin nükleozid trifosfat biyosentetik süreç gibi biyolojik süreçlerin yanı sıra proteozom ve sitokrom P450 tarafından ksenobiyotiklerin metabolizması dahil olan yolaklarda anlamlı şekilde zenginleşmiştir (Şekil 4E–F). Kalan beş temel gen için zenginleşme sonuçları Ek Şekil 2A–J'de sunulmuştur.
KOAH'ta UPP1'in immün infiltrasyonu ve ilaç hedeflerinin öngörülmesi
Kontrol ve KOAH gruplarında 28 immün hücre tipinin immün infiltrasyon seviyeleri ssGSEA algoritması kullanılarak değerlendirilmiştir. KOAH hastalarında bellek B hücreleri, myeloid kaynaklı baskılayıcı hücreler ve aktive dendritik hücreler anlamlı derecede daha yüksek zenginleşme skorları göstermiştir. Buna karşılık, tip 1 T yardımcı hücreleri, aktive B hücreleri ve immatür B hücreleri anlamlı derecede daha düşük zenginleşme skorları sergilemiştir (Şekil 5A). ssGSEA'nın, immün hücre oranlarının doğrudan ölçümlerinden ziyade transkriptomik verilere dayalı göreceli immün hücre zenginleşme tahminleri sağladığı belirtilmelidir. Korelasyon analizi, altı ana genin immün hücre alt kümeleriyle farklı ilişki örüntüleri sergilediğini ortaya koymuştur. Spesifik olarak UPP1, PRKCDBP ve B4GALT2; bellek B hücreleri, aktive dendritik hücreler ve myeloid kaynaklı baskılayıcı hücrelerin infiltrasyon seviyeleriyle pozitif korelasyon göstermiş (Spearman ρ > 0.4, p < 0.05), PTRF, TOR3A ve FAM168B ise tip 1 T yardımcı hücreleri ve aktive B hücreleri ile negatif korelasyonlar sergilemiştir (Spearman ρ < −0.3, p < 0.05). Tam korelasyon matrisi ısı haritasında sunulmuştur (Şekil 5B). İlaç tahmin analizi, altı aday gen arasından sadece UPP1'in küçük moleküllerle öngörülen etkileşimlere sahip olduğunu belirlemiştir. Veritabanından fluorouracil, capecitabine ve 5-benzylacyclouridine dahil olmak üzere üç bileşik, potansiyel UPP1-etkileşimli bileşikler olarak tanımlanmıştır (Şekil 5C). Bu bileşikler öncelikle onkolojide veya deneysel ortamlarda kullanılmaktadır ve KOAH ile olan ilgileri daha fazla araştırma gerektirmektedir. Bağlanma serbest enerjisi hesaplamaları, 5-benzylacyclouridine'in en güçlü bağlanma afinitesini sergilediğini ve nispeten daha yüksek bir öngörülen bağlanma afinitesine sahip olduğunu ortaya koymuştur (Tablo 3). Her üç bileşik için yapılan moleküler docking görselleştirmeleri, deneysel doğrulamadan ziyade hesaplamalı docking tahminleriyle uyumlu olarak, UPP1 ile uygun öngörülen bağlanma konformasyonları olduğunu göstermiştir (Şekil 5D–F). Ayrıca, CTD analizi, altı ana genin tamamının; prenatal maruziyetin gecikmiş etkileri, kilo kaybı, hepatomegali ve inflamasyon dahil olmak üzere çeşitli hastalık fenotipleriyle güçlü bir şekilde ilişkili olduğunu göstermiştir (Şekil 5G–L).
Klinik örneklerde temel tanısal genlerin RT-qPCR validasyonu
Kilit genlerin ekspresyon seviyelerini doğrulamak için sekiz KOAH hastası ve sekiz kontrol deneğinden kan örnekleri toplanmış olup, sınırlı örneklem boyutu nedeniyle bu analiz ön bir doğrulama olarak değerlendirilmiştir. Şekil 6A–F'de gösterildiği üzere, biyoinformatik analizlerde gözlemlenen eğilimlerle tutarlı olarak, KOAH örneklerinde PTRF, TOR3A ve FAM168B anlamlı düzeyde downregüle olurken, PRKCDBP ve UPP1 anlamlı düzeyde upregüle olmuştur. Buna karşın, iki grup arasında B4GALT2 ekspresyonu için anlamlı bir fark gözlemlenmemiştir. Bu tutarsızlık, sınırlı örneklem boyutuna veya veri setleri ile klinik örnekler arasındaki örnek türü farklılıklarına bağlanabilir.
VERİ KULLANILABİLİRLİK BEYANI:
Tüm RNA dizileme verileri Gene Expression Omnibus veri tabanından (GEO, https://www.ncbi.nlm.nih.gov) elde edilmiş olup, eğitim seti olarak GSE54837 ve doğrulama seti olarak GSE112811 seçilmiştir. Bu analizde kullanılan kodlar https://doi.org/10.5281/zenodo.21771476 adresinden temin edilebilir.
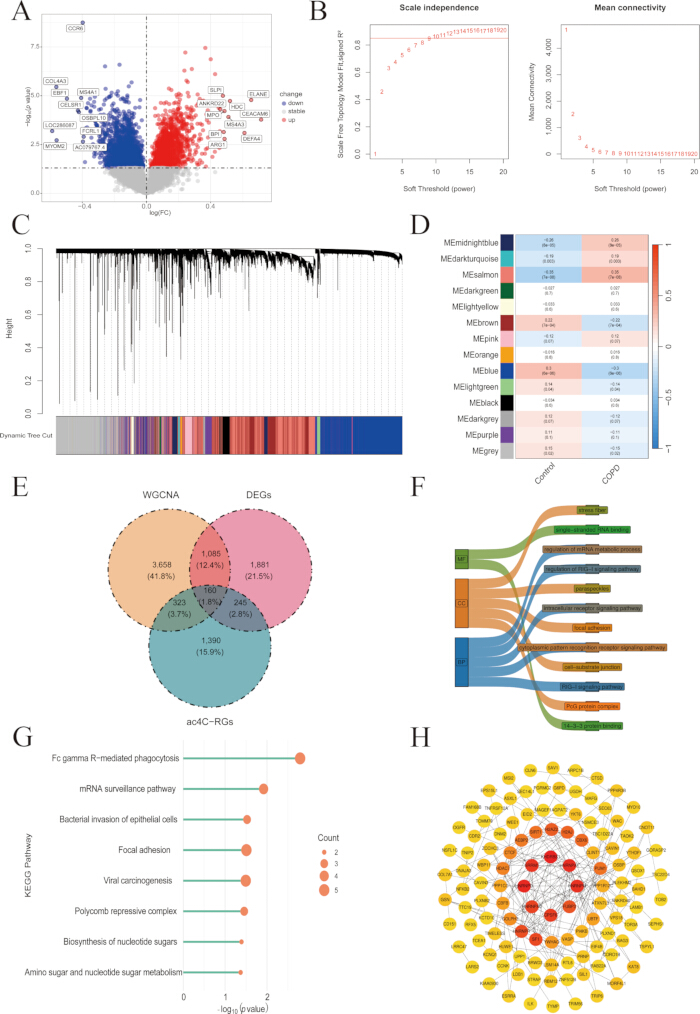
Şekil 1: Örtüşen genlerin belirlenmesi, zenginleştirme analizi ve PPI ağı oluşturma. (A) GSE54837 veri setindeki DEG'lerin volcano grafiği. (B) Yumuşak eşik taraması. (C) Modül kümeleme dendrogramı (birleştirme sonrası). (D) Modüller ve özellikler arasındaki korelasyonun ısı haritası. (E) Örtüşen genlerin belirlenmesi için Venn diyagramı. (F) MF, CC ve BP'deki kesişim genlerinin temel zenginleştirme sonuçlarını gösteren GO zenginleştirme analizinin Mulberry diyagramı. (G) KEGG sinyal yolu zenginleştirme analizinin lollipop diyagramı, balon boyutu zenginleştirilmiş gen sayısını temsil eder. (H) Örtüşen genlerin PPI ağı; düğümler proteinleri, kenarlar ise protein-protein etkileşimlerini temsil eder. Kısaltmalar: DEGs = diferansiyel olarak eksprese edilen genler; PPI = protein-protein etkileşimi; GO = Gen Ontolojisi; MF = moleküler fonksiyon; CC = hücresel bileşen; BP = biyolojik süreç; KEGG = Kyoto Gen ve Genom Ansiklopedisi; ac4C-RGs = N4-asetilsitidin ile ilişkili genler. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
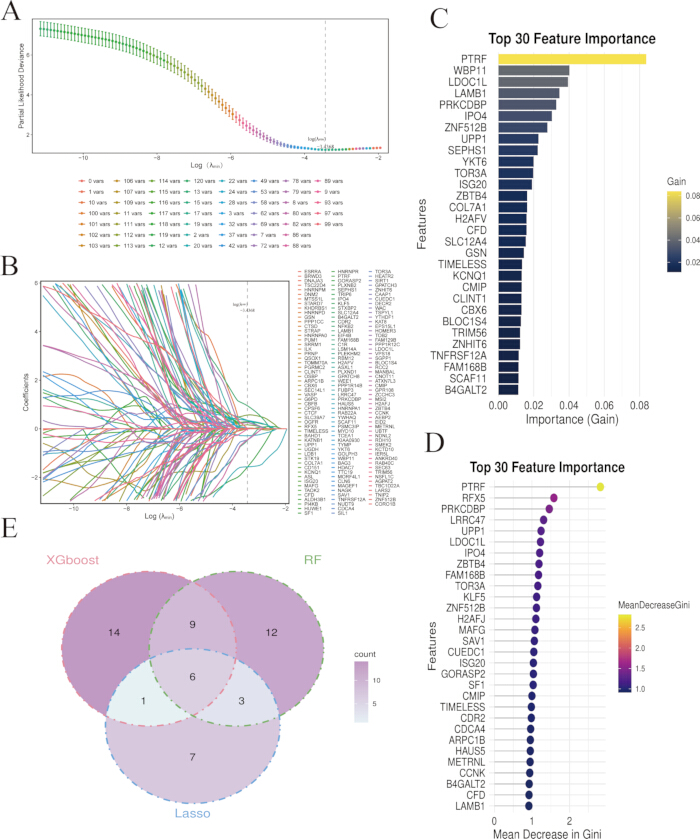
Şekil 2: KOAH'taki altı temel genin tanımlanması. (A) LASSO çapraz doğrulama eğrisi. (B) LASSO regresyon katsayısı yol diyagramı. λ arttıkça, önemsiz genlerin katsayıları 0'a yakınsar. (C) XGBoost özellik önem sıralaması. x-ekseni kazanç değerini, y-ekseni gen adını ve renk derinliği önemi temsil eder. (D) RF özellik önem sıralaması. x-ekseni Gini'deki ortalama azalmayı temsil eder. (E) Üç algoritmanın çapraz analiziyle elde edilen örtüşen genlerin Venn diyagramı. Kısaltmalar: LASSO = least absolute shrinkage and selection operator; XGBoost = extreme gradient boosting; RF = random forest. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
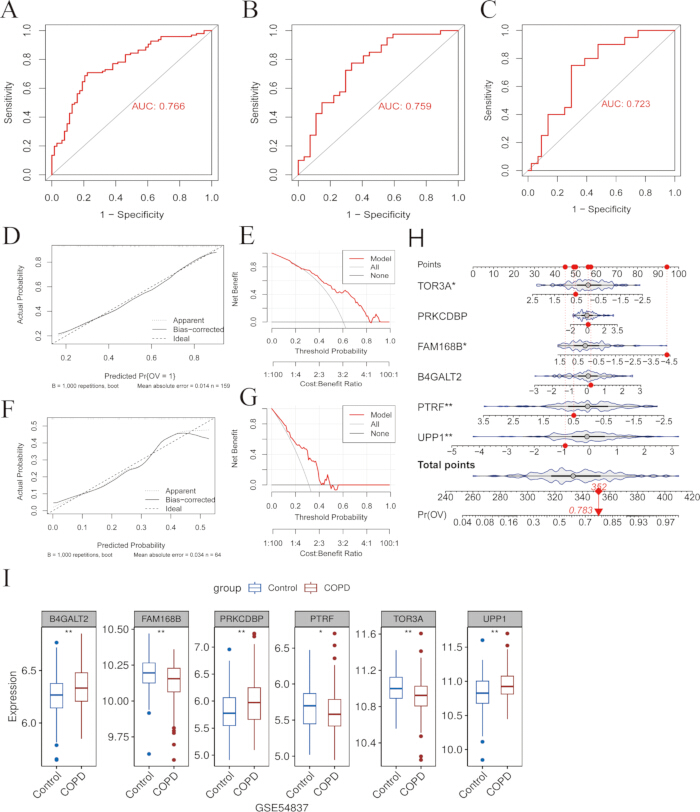
Şekil 3: Bir tanı modelinin oluşturulması ve anahtar genlerin ekspresyon analizi. (A) Eğitim setinin ROC eğrisi. (B) Dahili test setinin ROC eğrisi. (C) Harici doğrulama setinin ROC eğrisi. (D) Eğitim setinin kalibrasyon eğrisi. (E) Eğitim setinin DCA analizi. (F) Harici doğrulama setinin kalibrasyon eğrisi. (G) Harici doğrulama setinin DCA analizi. (H) Altı anahtar genin nomogramı. Bireysel COPD riskinin öngörülmesi için her gene karşılık gelen bir puan atanır. (I) GSE54837 veri setindeki COPD ve kontrol örneklerinde altı anahtar genin ekspresyon analizi. Kısaltmalar: ROC = alıcı işletim karakteristiği; AUC = eğri altında kalan alan; DCA = karar eğrisi analizi; COPD = kronik obstrüktif akciğer hastalığı. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
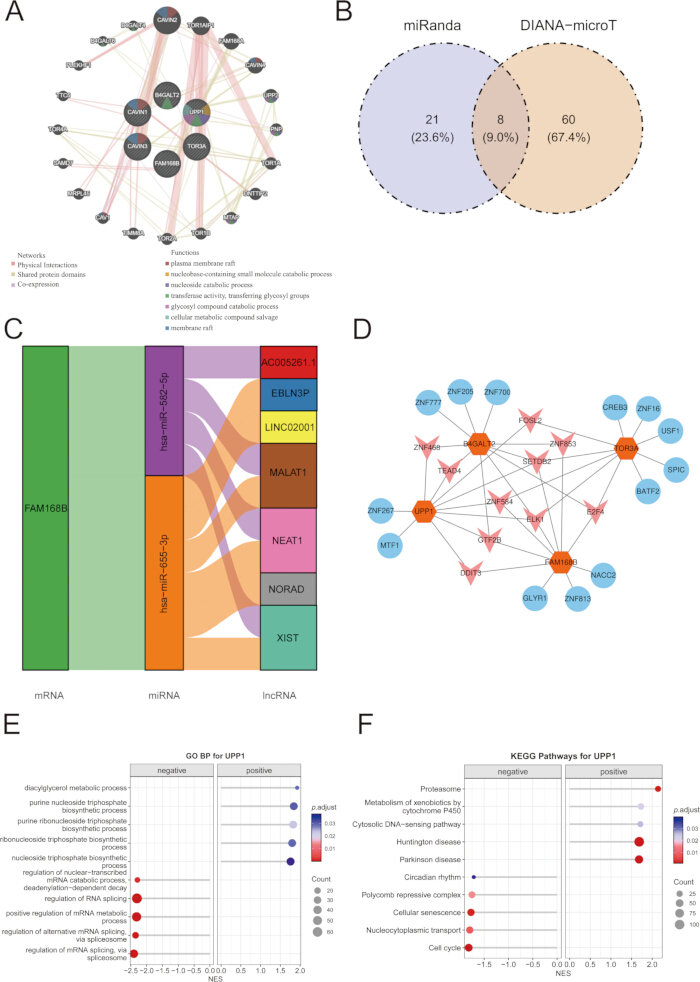
Şekil 4: KOAH'taki ana genlerin düzenleyici ağı ve fonksiyonel önemi. (A) 6 ana genin GeneMANIA analiz sonuçları. Çizgilerin rengi genler arasındaki korelasyonu, düğümlerin rengi ise farklı fonksiyonel kategorileri göstermektedir. (B) DIANA-microT ve miRanda veri tabanlarının çapraz analizine ait Venn diyagramı. (C) ceRNA düzenleyici ağının Mulberry diyagramı. (D) Potansiyel transkripsiyon faktörü düzenleyici ağı. Mavi düğümler transkripsiyon faktörlerini, turuncu düğümler ise hedef genleri temsil etmektedir. (E) UPP1'in GO'yu içeren tek gen GSEA zenginleştirme analizi. (F) UPP1'in KEGG'i içeren tek gen GSEA zenginleştirme analizi. Kısaltmalar: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
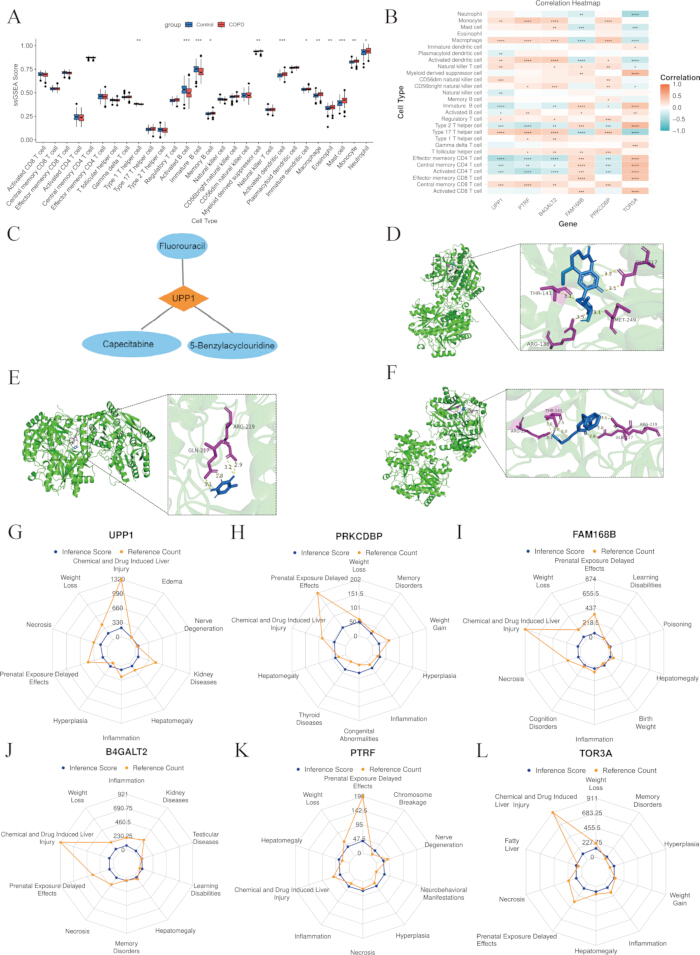
Şekil 5: KOAH'ta temel genlerin immün infiltrasyonu ve ilaç hedeflerinin öngörülmesi. (A) Gruplar arasındaki immün hücre bolluğu farkları. (B) İmmün hücreler ile temel genler arasındaki korelasyonun ısı haritası. (C) Temel genler ve öngörülen ilaçlar arasındaki etkileşim ağı. (D) Fluorouracil'in UPP1 ile moleküler kenetlenmesi. (E) Capecitabine'in UPP1 ile moleküler kenetlenmesi. (F) 5-benzylacyclouridine'in UPP1 ile moleküler kenetlenmesi. Her bir bileşik için sol taraftaki görüntü genel kenetlenme konformasyonunu, sağ taraftaki görüntü ise yerel bağlanma etkileşimlerini göstermektedir. (G) B4GALT2'nin CTD analizi. (H) FAM168B'nin CTD analizi. (I) PRKCDBP'nin CTD analizi. (J) PTRF'nin CTD analizi. (K) TOR3A'nın CTD analizi. (L) UPP1'in CTD analizi. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
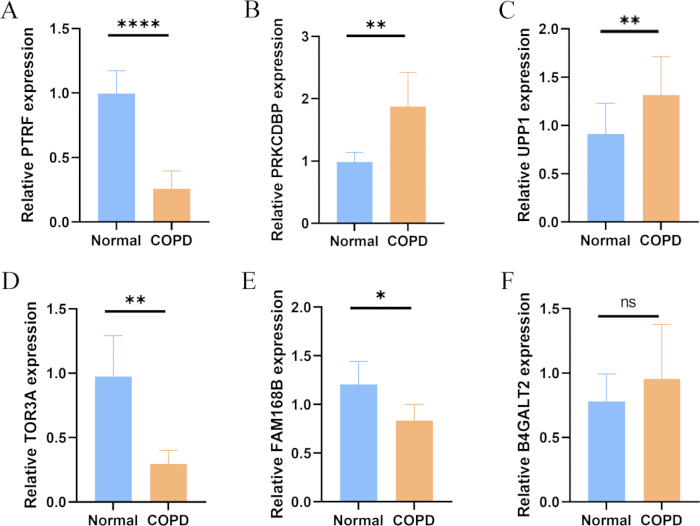
Şekil 6: KOAH ve kontrol örneklerinde temel gen ekspresyonunun RT-qPCR doğrulaması. (A) PTRF'nin bağıl ekspresyonu. (B) PRKCDBP'nin bağıl ekspresyonu. (C) UPP1'in bağıl ekspresyonu. (D) TOR3A'nın bağıl ekspresyonu. (E) FAM168B'nin bağıl ekspresyonu. (F) B4GALT2'nin bağıl ekspresyonu. ns = anlamlı değil, p > 0.05; * p < 0.05; ** p < 0.01; *** p < 0.001; **** p < 0.0001. Kısaltma: RT-qPCR = ters transkripsiyon kantitatif polimeraz zincir reaksiyonu. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
Ek Şekil 1: GSE54837 veri seti örnekleri ve gen modülü kümelemesi. (A) GSE54837 veri setinin örnek kümeleme diyagramı. (B) Birleştirme öncesi modül kümeleme dendrogramı. Belirgin modülleri tanımlamak için genler dinamik ağaç kesme yöntemi kullanılarak gruplandırılmıştır. (C) Modül özgenlerinin hiyerarşik kümeleme dendrogramı. Benzer ifade modellerine sahip modüller, özgen benzerliklerine göre kümelenmiştir.Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Şekil 2: GSEA zenginleştirme analizi. (A) PRKCDBP'nin GO analizi. (B) PRKCDBP'nin KEGG analizi. (C) PTRF'nin GO analizi. (D) PTRF'nin KEGG analizi. (E) TOR3A'nın GO analizi. (F) TOR3A'nın KEGG analizi. (G) FAM168B'nin GO analizi. (H) FAM168B'nin KEGG analizi. (I) B4GALT2'nin GO analizi. (J) B4GALT2'nin KEGG analizi. Kısaltmalar: GO = Gen Ontolojisi; KEGG = Kyoto Gen ve Genom Ansiklopedisi.Lütfen bu dosyayı indirmek için buraya tıklayın.
| Veri Seti | Kontroller | Hastalar | Sekanslama platformu |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tablo 1: Çalışmada kullanılan gen ekspresyon veri setleri. Model geliştirme/dahili test ve harici doğrulama için sırasıyla kullanılan GSE54837 ve GSE112811 veri setlerinin özellikleri.
| Hasta | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Cinsiyet (K/E) | M | M | M | F | M | M | M | M |
| Yaş (yıl) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Sigara içme durumu | Evet | Evet | Sigarayı bırakma (2 yıl) | Hayır | Evet | Evet | Evet | Sigarayı bırakma (5 yıl) |
| Paket-yıl | günlük 20 / 30 yıl | günlük 15 / 35 yıl | günlük 20 / 50 yıl | günlük 20 /40 yıl | günlük 30 / 40 yıl | günlük 15 / 40 yıl | günlük 20 / 30 yıl | |
| KOAH grubu | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tablo 2: Çalışma katılımcılarının temel özellikleri. RT-qPCR validasyonuna dahil edilen KOAH hastalarının ve sağlıklı kontrollerin temel demografik ve klinik özellikleri.
| Moleküler ad | Gen | Skor(kcal/mol) |
| 5-Benzilasiklouridin | UPP1 | -9.6 |
| Kapecitabin | UPP1 | -6.1 |
| Florourasil | UPP1 | -5.5 |
Tablo 3: UPP1 ve aday bileşikler için moleküler kenetlenme sonuçları.
UPP1'in fluorouracil, capecitabine ve 5-benzylacyclouridine ile etkileşimine ilişkin, bağlanma afinitelerini de içeren öngörülen moleküler kenetlenme sonuçları.
Tartışma
Ağırlıklı olarak haberci RNA (mRNA) ve taşıyıcı RNA'da (tRNA) görülen korunmuş RNA modifikasyonu ac4C, mRNA stabilitesini ve translasyon verimliliğini artırır20. NAT10, ac4C modifikasyonuna aracılık eden bilinen tek RNA asetiltransferazdır21. Çalışmalar, KOAH hastalarının akciğer epitel hücrelerinde NAT10'un yukarı yönlü düzenlendiğini göstermiştir. NAT10'un nakavt edilmesi mitokondriyal fonksiyonu ve transkriptomik yanıtları bozar22. Entegre multiomik analizine dayalı olarak, bu çalışma KOAH ile yakından ilişkili altı temel gen tanımlamış ve orta düzeyde tanısal performans gösteren ve daha fazla araştırma için potansiyel değer taşıyan bir tanı modeli geliştirmiştir. İleri analizler, bu genlerin transkripsiyonel düzenlemedeki, ceRNA ağlarındaki ve immün mikroçevredeki kilit rollerini ortaya koymuştur. Ek olarak, potansiyel hedefli ilaçlar tahmin edilerek KOAH patogenezine dair içgörüler sağlanmış ve kişiselleştirilmiş hassas tedavi stratejilerinin geliştirilmesi kolaylaştırılmıştır. WGCNA ve diferansiyel ekspresyon analizi kullanarak, hem KOAH'ta diferansiyel eksprese olan hem de daha önce yayınlanmış bir ac4C ilişkili gen listesinde yer alan genleri tanımladık. Bu genlerin, NAT10 veya ac4C asetilasyonu ile kanıtlanmış mekanistik bağlantıları nedeniyle değil, ac4C düzenleyici ağıyla olan ilişkileri temel alınarak seçildiklerinin ve toplam 160 aday gen elde edildiğinin belirtilmesi önemlidir. Makine öğrenimi algoritmaları aracılığıyla altı temel gen (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B ve B4GALT2) tanımlanmıştır. Bunlar arasında PTRF, IL-33-ZBP1 aracılı makrofaj nekroptozunu düzenleyerek ev tozu akarı (HDM)-indükli havayolu inflamasyonunda kritik bir rol oynar; bu da KOAH gibi kronik inflamatuar akciğer durumlarında yer alabileceğini göstermektedir23. Lai ve ark.24, ekzojen üridin uygulamasına makrofajlarda Nrf2/SLC7A11/GPX4 yolu üzerinden ferroptozu inhibe ettiğini ve böylece sepsisin neden olduğu akut akciğer hasarını hafiflettiğini kanıtlamıştır. Üridin metabolizmasında kilit bir enzim olan UPP1'in yukarı yönlü düzenlenmesi akut akciğer hasarı modellerinden alınan akciğer dokusunda gözlemlenmiş olsa da, tam rolü —ve bu yukarı yönlü düzenlemenin koruyucu bir yanıtı mı yoksa doku hasarının bir sonucu mu olduğu— henüz tam olarak açıklığa kavuşturulmamıştır. Bununla birlikte, bu bulgu, UPP1'in KOAH gibi inflamatuar akciğer hastalıklarının patofizyolojik süreçleriyle potansiyel bir ilişkisi olabileceğini göstermekte ve daha fazla araştırılmasını gerektirmektedir. Geriye kalan dört temel gen, akciğerle ilgili bozukluklarda daha az araştırılmıştır ancak diğer hastalıklardaki işlevlerine ve mevcut bulgularımıza dayanarak, KOAH patogenezine katkıda bulunabilecekleri potansiyel yollar hakkında hipotezler kurmaktayız.
Altı ana gene dayanarak bir KOAH tanı modeli oluşturduk ve modelin iyi öngörü performansını doğruladık. Ekspresyon analizi, KOAH'ta UPP1, B4GALT2 ve PRKCDBP'nin anlamlı şekilde yukarı regüle olduğunu, FAM168B, PTRF ve TOR3A'nın ise belirgin şekilde aşağı regüle olduğunu göstermiştir. B4GALT2 veri seti analizinde yukarı regüle olarak tanımlanmış olsa da, RT-qPCR doğrulamasında anlamlı bir fark gözlemlenmemiştir. Bu tutarsızlık, sınırlı örneklem boyutuna, kohort heterojenliğine ve kamuya açık veri setleri ile klinik kan örnekleri arasındaki örnek kaynak farklılıklarına bağlanabilir. Gen seti zenginleştirme analizi, bu ana genlerin RNA ekleme ve mRNA işlemenin yanı sıra hücre döngüsü ve nikotin bağımlılığı gibi yolaklarda anlamlı şekilde zenginleştiğini ortaya koymuştur. Geri dönüşümsüz hücre döngüsü durması, hücresel yaşlanmanın temel mekanizması olarak kabul edilmektedir ve bu durum KOAH'ın patofizyolojisine önemli ölçüde katkıda bulunabilir25,26. Daha ileri analizler, DNA hasarının tetiklediği yaşlanma ilişkili sekretuar fenotipin (SASP), kronik inflamasyonu sürdürerek ve akciğer doku hasarını artırarak KOAH'ın kalıcı ilerleyişini teşvik edebileceğini göstermiştir27. Önceki bir çalışma da nikotin bağımlılığı ve KOAH'ın altında yatan genetik bağlantıları incelemiştir28. Sigara içmek KOAH için birincil risk faktörü olsa da, sigara içenlerin sadece küçük bir kısmı hastalığı geliştirmektedir; bu durum, hem KOAH hem de nikotin bağımlılığında genetik faktörlerin önemli bir rol oynadığını göstermektedir. Liu ve ark.29, RNA-bağlayıcı proteinlerin (RBP'ler) KOAH ve pulmoner hipertansiyondaki (PH) rollerini özetleyerek, mRNA ekleme ve transkripsiyon sonrası gen ekspresyonu regülasyonu aracılığıyla pulmoner vasküler yeniden şekillenme ve inflamatuar yanıtlardaki yerlerini vurgulamış, böylece biyobelirteçler ve terapötik hedefler olarak potansiyellerine dikkat çekmişlerdir. Özetle, bu çalışmada tanımlanan ana genler ve ilişkili yolaklar, yalnızca KOAH patogenezi hakkındaki anlayışımızı derinleştirmekle kalmamakta, aynı zamanda gelecekteki tanısal biyobelirteçlerin ve hedefe yönelik terapötik stratejilerin geliştirilmesi için sağlam bir temel sunmaktadır.
ceRNA ağı; lncRNA'lar, circRNA'lar ve mRNA'lar dahil olmak üzere çeşitli RNA türlerini içerir ve bunlar ortak miRNA'lara rekabetçi bir şekilde bağlanarak karşılıklı düzenleyici ilişkiler kurar ve gen ekspresyonunu etkiler30. Bu karmaşık ağ, çok sayıda fizyolojik ve patolojik süreçte yer alır; gen düzenleme mekanizmalarının ve kanser ile kronik inflamatuar bozukluklar gibi hastalıkların patogenezinin aydınlatılmasına katkıda bulunur. Örneğin, Wang ve ark. 11 lncRNA, beş miRNA ve 16 mRNA'dan oluşan bir ceRNA koekspresyon ağı kurmuşlardır ve bu ağdaki çekirdek alt ağın, KOAH'taki bağışıklık hücresi oranlarındaki ve akciğer fonksiyonlarındaki değişikliklerle ilişkili olduğu görülmüştür31. Benzer şekilde, Zhang ve ark.32 erkek sigara içicilerin periferik kan mononükleer hücrelerine dayalı bir circRNA-miRNA-mRNA ceRNA ağı geliştirerek, disregüle circRNA'ları ve KOAH ile ilgili temel yolakları tanımlamışlardır. Koekspresyon ağı analizimiz, temel genlerin öncelikle fiziksel etkileşimler, koekspresyon ve ortak protein domainleri aracılığıyla fonksiyonel bağlantılar kurduğunu ve birden fazla metabolizma ile ilgili yolakta önemli ölçüde zenginleştiğini ortaya koymuştur. Bu bulgulara dayanarak, daha sonra bir transkripsiyon faktörü (TF)-hedef düzenleme ağı ve bir miRNA-lncRNA-mRNA düzenleyici ekseni oluşturduk. Bu sonuçlar, temel genlerin KOAH'ta lncRNA'lar, transkripsiyon faktörleri ve miRNA'ları içeren çok seviyeli mekanizmalar aracılığıyla kooperatif bir şekilde düzenlenebileceğini göstermektedir.
İmmün infiltrasyon, dokularda veya kanda immün hücrelerin dağılımını ve aktivitesini belirterek immün durumu yansıtır. Buna dayanarak, hesaplamalı tarama kullanılarak potansiyel aday ilaçlar tahmin edilmiş ve ardından hedef proteinlerle olan bağlanma afinitesini ve stabilitesini değerlendirmek için moleküler kenetleme simülasyonları gerçekleştirilmiştir. Bu analizler birlikte, yeni terapötik ajanların tanımlanmasını kolaylaştırır ve hastalık mekanizmaları hakkında daha derin içgörüler sağlar. Bu çalışmada, altı temel genin çoğu immün hücre infiltrasyonu ile pozitif korelasyon gösterdiği saptanmıştır. İlaç tahmini; UPP1 ile fluorouracil, capecitabine ve 5-benzylacyclouridine arasındaki potansiyel etkileşimleri belirlemiş olup, moleküler kenetleme ile daha sonra doğrulandığı üzere, sonuncusu en güçlü bağlanma afinitesini sergilemiştir. Özellikle fluorouracil ve capecitabine temel olarak antitümör ajanlar olarak kullanılmaktadır ve bu çalışmada, KOAH için doğrulanmış terapötik seçeneklerden ziyade, veri tabanı tarafından tahmin edilen UPP1 ile etkileşime giren bileşikler olarak tanımlanmışlardır. Önceki çalışmalar, fluorouracilin lokal uygulamasının ağır havayolu obstrüksiyonu vakalarında havayolu açıklığını iyileştirebileceğini bildirmiştir33. Ancak diğer kanıtlar, fluorouracil ve capecitabine'in, özellikle mevcut akciğer rahatsızlığı olan hastalarda pulmoner toksisiteye yol açabileceğini göstermektedir34. Bu nedenle, bunların KOAH ile potansiyel ilişkileri daha fazla deneysel ve güvenlik doğrulaması gerektirmektedir. Ayrıca, CTD analizi altı temel genin tamamının çok sayıda patolojik süreçle ilişkili olduğunu göstermiştir. Topluca; immün infiltrasyon, ilaç tahmini ve moleküler kenetlemenin entegre analizi, KOAH'ın hassas tedavisi için yeni moleküler hedefler ve teorik bir temel sunarak ilgili ilaçların geliştirilmesini ve klinik çevirisini teşvik etmektedir.
Bununla birlikte, bazı sınırlamaların kabul edilmesi gerekmektedir. Çalışma, nispeten sınırlı örnek kaynaklarına sahip halka açık veri setlerine dayanmıştır; bu durum grup etkilerine (batch effects) ve potansiyel model aşırı öğrenmesine (overfitting) yol açabilir. RT-qPCR doğrulaması küçük bir kohortta gerçekleştirilmiş olup, B4GALT2 ekspresyonunda gözlenen tutarsızlık, olası kohort heterojenliğine işaret etmektedir. Ek olarak, immün infiltrasyon ve ilaç tahmin analizleri hesaplamalı nitelikte olup daha fazla deneysel doğrulama gerektirmektedir. Ayrıca, bir keşif aşaması biyoinformatik araştırması olarak, diagnostik modelimiz temel olarak %95 güven aralıklarıyla birlikte AUC değerleri kullanılarak değerlendirilmiştir. Halka açık veri setlerinin retrospektif doğası ve sınırlı örnek boyutları nedeniyle hassasiyet, özgüllük, öngördürücü değerler ve ayrıntılı kalibrasyon istatistikleri gibi kapsamlı performans metrikleri tam olarak değerlendirilmemiştir. Bu nedenle, modelimiz bir kavram kanıtlama (proof-of-concept) aracı olarak görülmeli ve klinik faydası daha büyük prospektif kohortlarda yeniden doğrulanmalıdır.
Bütünleştirici biyoinformatik ve makine öğrenimi analizleri aracılığıyla, bu çalışma KOAH ile anlamlı düzeyde ilişkili altı temel gen belirlemiştir. Birden fazla kohortta güvenilir öngörücü performans sergileyen, sağlam bir tanı modeli oluşturulmuştur. Fonksiyonel analizler, bu genlerin transkripsiyonel ve post-transkripsiyonel düzenleme, immün hücre infiltrasyonu ile nikotin bağımlılığı ve hücre döngüsü ile ilgili yolakları içeren kritik düzenleyici ağlara katıldığını ortaya koymuştur. İlaç öngörüsü ve moleküler kenetlenme analizleri, birkaç aday bileşiğin güçlü bağlanma afiniteleri sergilemesiyle UPP1'in gelecek vadeden bir terapötik hedef olduğunu vurgulamıştır. Genel olarak, bu bulgular KOAH patofizyolojisine dair anlayışımızı geliştirmekte ve gelecekteki terapötik geliştirmeler ile hassas tıp stratejileri için değerli moleküler hedefler sunmaktadır.
Açıklamalar
Yazarlar herhangi bir çıkar çatışması beyan etmemektedir. Çalışmaya katılan tüm deneklerden bilgilendirilmiş onam alınmıştır.
Teşekkürler
Bu çalışma için gerekli olan klinik imkanları ve idari desteği sağladıkları için Shenzhen Luohu Geleneksel Çin Tıbbı Hastanesi'ne teşekkür ederiz. Son olarak, bu araştırmaya katılan tüm hastalara ve sağlıklı gönüllülere minnettarız; onların katkıları bu çalışma için vazgeçilmezdi. Bu çalışma, Shenzhen Tıp Sanming Projesi (No. SZZYSM202401018), Luohu Bölgesi Öncelikli Uzmanlık Fonları (No. LX202402021) ve Luohu Bölgesi Öncelikli Uzmanlık Fonları (No. LX202302064) tarafından desteklenmiştir.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| β-aktin primerleri | Tsingke | Lütfen çevirmemi istediğiniz kaynak metni sağlayın. Metni gönderdiğinizde, belirttiğiniz tüm profesyonel çeviri standartlarına ve akademik kriterlere uygun olarak çeviriyi gerçekleştireceğim. | İleri: 5’-CATGTACGTTGCTATCCAGGC-3’ Tersine Çevirme: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| B4GALT2 primerleri | Tsingke | Metin sağlanmadı. Lütfen çevrilmesini istediğiniz İngilizce kaynağı giriniz. | İleri: 5’-GGGCAGACTGCTGATCGAG-3’ Tersine Çevirme: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Çevrim içi | Moleküler kenetleme |
| clusterProfiler | Bioconductor | v4.14.6 | Zenginleştirme analizi |
| Cytoscape | Cytoscape Konsorsiyumu | v3.8.3 | Ağ görselleştirme |
| DrugBank | Alberta Üniversitesi | Çevrimiçi | İlaç öngörüsü |
| FAM168B primerleri | Tsingke | Lütfen çevirmemi istediğiniz kaynak metni sağlayın. | İleri: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Tersine Çevirme: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | LASSO regresyonu |
| GSVA (Gen Set Varyasyon Analizi) | Bioconductor | v1.52.3 | ssGSEA analizi |
| Hifair III 1. Zincir cDNA Sentez Supermixi | YEASEN | 11141ES | cDNA sentezi |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | qPCR amplifikasyonu |
| limma | Bioconductor | v3.54.0 | Diferansiyel ekspresyon |
| LightCycler 480 II Sistemi | Roche | LightCycler 480 II | Gerçek zamanlı PCR |
| PTRF primerleri | Tsingke | Girdi sağlanmadı. Lütfen çevrilmesini istediğiniz metni iletin. | İleri: 5’-GGGCCGTAGACCAGATCCA-3’ Tersine Çevirme: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| PRKCDBP primerleri | Tsingke | Metin sağlanmadı. Lütfen çevrilmesini istediğiniz kaynak metni giriniz. | İleri: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Tersine Çevirme: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| R yazılımı | R Vakfı | v4.4.2 | İstatistiksel hesaplama |
| rastgeleOrman | CRAN | v4.7 | Rastgele Orman |
| RNA izolatörü MolPure Blood RNA Kit | YEASEN | 19241ES50 | RNA ekstraksiyonu |
| STRING veri tabanı | EMBL | Çevrim içi | PPI ağı |
| TOR3A primerleri | Tsingke | Lütfen çevirmek istediğiniz metni sağlayın. | İleri: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Tersine Çevirme: 5’-CCCGTCCCGATACAGGTTC-3’ |
| UPP1 primerleri | Tsingke | Lütfen çevrilecek metni sağlayın. | İleri: 5’-CTGTCAGTCATGGTATGGGCA-3’ Tersine Çevirme: 5’-GAGCACCGGGCATAGTACA-3’ |
| Ağırlıklı Gen Ko-ifade Ağ Analizi (WGCNA) | CRAN | v1.72 | Eş-ekspresyon ağı |
| XGBoost | CRAN | v1.7 | XGBoost algoritması |
Kaynaklar
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.