Bu protokol, biyobelirteç keşfi ve moleküler alt tipleme amacıyla dilate kardiyomiyopatide yaşlanma ve mitokondri ile ilişkili genleri tanımlamak için çok boyutlu transkriptomik verileri makine öğrenmesi ile entegre etmektedir.
Araştırma makalesi
Dilate Kardiyomiyopatide Yaşlanma ve Mitokondri ile İlişkili Hub Genlerin Belirlenmesi
Bu makalede
Özet
Özet
Dilate kardiyomiyopati (DKM), sol ventrikül dilatasyonu ve sistolik disfonksiyon ile karakterize olup mitokondriyal disfonksiyon ve immün-inflamatuar aktivasyon ile ilişkilidir. Ancak, DKM'deki yaşlanmaya bağlı moleküler imzalar ve mitokondriyal düzenleyici yollar henüz tam olarak anlaşılamamıştır. Bu çalışma, Gene Expression Omnibus veri tabanından altı dökme transkriptomik veri seti ve bir tek hücreli RNA dizileme veri setini analiz etmiştir. Veri normalizasyonu, grup düzeltmesi (batch correction) ve hücre tipi anotasyonunun ardından; diferansiyel ekspresyon analizi, ağırlıklı gen ko-ekspresyon ağı analizi ve protein-protein etkileşim ağı oluşturma yöntemleri kullanılarak yaşlanma ve mitokondri ile ilgili aday genler belirlenmiştir. Çekirdek genler; en küçük mutlak küçültme ve seçim operatörü regresyonu (LASSO), rastgele orman (random forest) ve destek vektör makinesi-rekürsif özellik eleme (SVM-RFE) yöntemleri ile daha fazla taranmıştır. DKM'deki kardiyak immün mikroçevreyi karakterize etmek için immün hücre infiltrasyonu, hücre-hücre iletişimi ve moleküler alt tip analizleri gerçekleştirilmiştir. Toplam 66 yaşlanma ile ilgili gen ve 16 mitokondri ile ilgili genin DKM ile ilişkili olduğu ve temel olarak hipoksiyle indüklenen faktör-1 sinyalizasyonu, oksidatif fosforilasyon ve nitrik oksit sentaz ile ilgili yolaklarda zenginleştiği görülmüştür. Makine öğrenimi ve tek hücreli RNA dizileme analizleri SERPINE1, TGFB2, CYBB ve TLR2'yi çekirdek genler olarak tanımlamıştır. CYBB ve TLR2 monositlerde ve makrofajlarda yüksek düzeyde eksprese edilirken, SERPINE1 ve TGFB2 ağırlıklı olarak stromal hücrelerde eksprese edilmiştir. İmmün manzara analizi, DKM örneklerinde artmış pro-inflamatuar makrofaj aktivasyonu ve değişmiş hücre-hücre iletişimi olduğunu göstermiştir. Çekirdek gen ekspresyonuna dayanarak, DKM örnekleri sırasıyla vasküler endotelyal büyüme faktörü sinyalizasyonu ve primer safra asidi biyosentezi ile ilişkili iki moleküler alt tipe ayrılmıştır. Bu protokol, DKM'de aday biyobelirteçlerin ve moleküler alt tiplerin belirlenmesi için entegre bir çerçeve sunmaktadır.
Giriş
Dilate kardiyomiyopati (DKM), sol ventrikül dilatasyonu ve bozulmuş sistolik fonksiyon ile karakterize miyokardiyal bir bozukluktur. Dünya çapında kalp yetmezliğinin en yaygın üçüncü nedeni ve kalp transplantasyonu için başlıca endikasyondur1. Popülasyon tabanlı çalışmalar, yaklaşık her 250 yetişkinden 1'inde görülen bir prevalans tahmin etmekte olup, erkeklerde daha yüksek bir prevalans görülmektedir ve vakaların önemli bir kısmı monogenik varyantlara bağlanmaktadır2. Bu bulgular, hem genetik yatkınlığın hem de çevresel faktörlerin DKM'nin başlangıcına ve ilerlemesine katkıda bulunduğunu göstermektedir.
DCM patogenezi; enflamatuar aktivasyon, oksidatif stres, kardiyomiyosit apoptozu ve düzensiz profibrotik sinyalizasyon dahil olmak üzere birbirleriyle bağlantılı süreçleri içerir. Tümör nekroz faktörü-α promotör varyantları dahil olmak üzere enflamatuar genetik polimorfizmler, viral DCM yatkınlığı ile ilişkilendirilmiştir3. Artmış oksidatif stres, insan DCM alt tiplerinde kardiyomiyosit ölümü ve sol ventrikül disfonksiyonu ile de ilişkilendirilmiştir4. Ayrıca, Wnt/β-catenin ve kalsinürin/aktive edilmiş T hücreleri nükleer faktörü sinyalizasyonunun aberrant aktivasyonu, miyokardiyal hipertrofiyi ve interstisyel fibrozu teşvik ederek hastalık progresyonuna katkıda bulunur5,6. Kardiyomiyositlerin yüksek enerji gereksinimleri olduğu için mitokondriyal disfonksiyon, DCM'nin bir diğer önemli bileşenidir. Mitokondriyal biyogenez, kalsiyum homeostazı, mitofaji ve mitokondriyal DNA bütünlüğünün bozulması, oksidatif fosforilasyonu engelleyebilir ve progresif kardiyak disfonksiyona katkıda bulunabilir7,8,9,10.
Bu mekanistik bulgulara rağmen, önemli bilgi eksiklikleri devam etmektedir. Özellikle, DCM başlangıcı ve ilerlemesi sırasında mitokondriyal yapısal yeniden şekillenme ile biyoenerjetik disfonksiyon arasındaki zamansal ve nedensel ilişkiler henüz tam olarak tanımlanmamıştır11. Çeşitli terapötik stratejiler araştırılmıştır. Kök hücre tedavisi; parakrin, sitoprotektif ve immünomodülatör etkiler aracılığıyla rejeneratif potansiyel göstermiştir, ancak hücre kaynaklarının, iletim yollarının ve transplantasyon sonrası sağkalımın optimizasyonu hala gereklidir12. Adeno-ilişkili virüs tabanlı iletim ve kümelenmiş düzenli aralıklı kısa palindromik tekrarlar tabanlı genom düzenleme dahil olmak üzere gen tedavisi yaklaşımları da potansiyel hassas tedavi stratejileri sunmaktadır. Ancak, kardiyak tropizm, vektör immünojenisitesi ve uzun süreli güvenlikle ilgili kısıtlamalar henüz çözülememiştir13.
Gene Expression Omnibus (GEO) gibi depolardaki halka açık transkriptomik veri setleri, DCM'de biyobelirteç keşfi için yaygın olarak kullanılmaktadır. Bu kaynaklar, çok merkezli klinik kohortlara erişim sağlar, maliyet etkin ve tekrarlanabilir araştırmaları destekler ve veri setleri arası entegrasyon yoluyla istatistiksel gücü artırabilir14. Transkriptomik profilleme ayrıca genom çapında aday gen taramasına, moleküler alt tiplendirmeye ve yolak düzeyinde analize olanak tanır15. Ancak halka açık veri setlerinin; teknik grup etkileri (batch effects), klinik ve etiyolojik heterojenlik, nedensel çıkarım için sınırlı kapasite ve eksik boylamsal veya prognostik bilgiler gibi doğal sınırlamaları vardır16. Bu nedenle, halka açık transkriptomik veri setlerinden elde edilen bulgular, hipotez oluşturma ve aday biyobelirteç önceliklendirmesi için en uygundur ve bağımsız kohortlar ile deneysel modellerde doğrulanması gerekir.
DCM üzerine yapılan birçok biyoinformatik çalışma öncelikle, yanlış pozitif bulgular üretebilen ve gen ko-ekspresyon ağlarını veya kalp dokusundaki hücresel heterojeniteyi tam olarak tanımlamayan diferansiyel ekspresyon analizine dayanmaktadır. Bu kısıtlamaları gidermek için mevcut çalışmada, tamamlayıcı yöntemleri birleştiren entegre bir analitik strateji uygulanmıştır. Bulk transkriptomik analiz, vaka-kontrol karşılaştırmaları için uygun olan doku düzeyinde ekspresyon profilleri sağlar. Ağırlıklı gen ko-ekspresyon ağı analizi (WGCNA), fenotipik özelliklerle ilişkili gen modüllerini tanımlar ve tekil diferansiyel ekspresyon gösteren genler yerine, fonksiyonel olarak ilişkili gen setlerinin önceliklendirilmesine olanak tanır. Protein-protein etkileşim (PPI) ağı analizi, ağ topolojisine dayanarak yüksek bağlantılı genleri belirler. Entegre veri setleri genelinde aday biyobelirteçleri tanımlamak için üç makine öğrenimi algoritması —en küçük mutlak büzülme ve seçim operatörü regresyonu, rastgele orman ve destek vektör makinesi-rekürsif özellik eleme— kullanılmıştır¹⁷. Ardından, hücre tipine özgü ekspresyon paternlerini ve hücreler arası iletişim ağlarını incelemek için tek hücre RNA dizileme (scRNA-seq) kullanılmıştır18.
Mitokondriyal disfonksiyon ve yaşlanmaya bağlı moleküler değişikliklerin her biri DCM kapsamında incelenmiş olsa da, bunların hastalıkla ilişkili transkripsiyonel değişikliklerle olan ortak ilişkileri henüz yeterince araştırılmamıştır. Mevcut çalışma, DCM'de yaşlanma ve mitokondri ile ilişkili hub genleri belirlemek, kardiyak immün mikroçevreyi karakterize etmek ve tanımlanan genlere dayalı moleküler alt tipleri incelemek için birden fazla bulk transkriptomik ve scRNA-seq veri setini entegre etmiştir. Bu entegre yaklaşım, aday biyobelirteçleri önceliklendirmek ve sonraki mekanistik ve doğrulama çalışmalarına temel oluşturmak için kullanılmıştır.
Protokol
Tüm hayvan prosedürleri, Henan Çin Tıp Üniversitesi İkinci Bağlı Hastanesi Laboratuvar Hayvanları Etik Komitesi tarafından gözden geçirilmiş ve onaylanmıştır (Onay No. HNSZYYYJS2023011150). Tüm prosedürler, Laboratuvar Hayvanı Refahının Etik İncelemesi Kılavuzları (GB/T 35892-2018) ve Değiştirme, Azaltma ve İyileştirme (3R) ilkeleriyle uyumlu olarak yürütülmüştür. Bu çalışmada kullanılan reaktifler, veri tabanları, yazılımlar ve ekipmanlar Materyaller Tablosunda listelenmiştir.
1. Veri kaynakları ve deneysel materyaller
Spontan dilatasyonel kardiyomiyopati (DCM) fenotipine sahip ve 25 ± 2 g vücut ağırlığındaki erkek SPF-grade CTNTR141W transgenik fareler model grup olarak kullanılmıştır. Vücut ağırlığı 25 ± 2 g olan, yaşa uygun erkek SPF-grade C57BL/6J fareler ise kontrol grubu olarak kullanılmıştır. Her grup 12 fare içermektedir. Tüm hayvanlar, geçerli laboratuvar hayvanı üretim lisansına sahip kurumlardan temin edilmiş ve 22 ± 2 °C sıcaklık, %40–60 bağıl nem ve 12 saatlik ışık/karanlık döngüsü altında, sterilize edilmiş gıda ve suya serbest erişimi olan SPF-grade bariyer ortamında barındırılmıştır. 1 haftalık alışma sürecinin ardından, tüm fareler kardiyak fonksiyon değerlendirmesi ve örnek toplama öncesinde 4 hafta daha aynı koşullarda tutulmuştur. Deney başlangıcında tüm fareler 6–8 haftalık yaşındaydı. Fareler derin anestezi altına alınmış ve servikal dislokasyon yöntemiyle ötanize edilmiştir.
DCM hastalarının sol ventrikül miyokard dokusuna ait yedi adet halka açık transkriptomik veri seti, Gene Expression Omnibus (GEO)19 veri tabanından alınmıştır. Bu veri setleri, altı bulk transkriptomik veri seti ve bir tek hücreli RNA dizileme (scRNA-seq) veri seti olan GSE145154'ü içermekteydi. Analize hem CD45-pozitif hem de CD45-negatif fraksiyonlar dahil edilmiştir. Kümeleme öncesinde hem CD45-pozitif hem de CD45-negatif hücre fraksiyonları birleştirilmiştir. Harmony entegrasyonu için ana batch değişkeni olarak örnek kimliği kullanılmıştır. GSE145154'ten normal sol ventrikül ve DCM sol ventrikül örnekleri, özellikle GSM4307515, GSM4307516, GSM4307520 ve GSM4307521 dahil edilmiştir. Bu çalışmada kullanılan veri setleri GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 ve GSE141910'dur. DCM dışındaki tüm örnekler hariç tutulmuş, yalnızca kontrol örnekleri (Kontrol grubu) ve DCM örnekleri (DCM grubu) tutulmuştur. Kalite kontrol sonrası herhangi bir örnek çıkarılmamıştır. Dahil edilen GEO veri setlerinin örnek bilgileri şu şekilde özetlenmiştir: GSE5406 102 örnek (16 kontrol ve 86 DCM örneği); GSE42955 17 örnek (5 kontrol ve 12 DCM örneği); GSE57338 231 örnek (136 kontrol ve 95 DCM örneği); GSE79962 20 örnek (11 kontrol ve 9 DCM örneği); GSE116250 51 örnek (14 kontrol ve 37 DCM örneği) ve GSE141910 322 örnek (161 kontrol ve 161 DCM örneği) içermekteydi.
2. Toplu transkriptom veri ön işleme
Altı toplu veri seti için ham ekspresyon matrisleri ve klinik anotasyon dosyaları, GEOquery paketi20 kullanılarak indirildi. Affymetrix mikroarray veri setleri için ham CEL dosyaları, RNA-seq veri setleri için ise ham sayım matrisleri alındı. Mikroarray verileri için arka plan düzeltmesi, kantil normalizasyonu ve ekspresyon hesaplamaları, affy paketinde21 uygulanan robust multi-array average algoritması kullanılarak gerçekleştirildi.
RNA-seq sayım verileri, edgeR paketi22 kullanılarak M-değerlerinin kırpılmış ortalaması yöntemiyle normalize edilmiş ve log₂-dönüştürülmüş milyon başına sayım değerlerine dönüştürülmüştür. Prob tanımlayıcıları, platforma özgü anotasyon dosyaları kullanılarak resmi gen sembollerine dönüştürülmüştür. Birden fazla prob aynı gene eşlendiğinde, ortalama ekspresyon değeri hesaplanmıştır.
Veri setleri arasındaki teknik grup etkileri (batch effects), sva paketindeki23 ComBat algoritması kullanılarak giderilmiştir. Veri seti kaynağı ve tespit platformu grup faktörleri olarak belirlenmiştir. Grup etkisinin giderilme etkinliğini değerlendirmek için grup düzeltmesi öncesinde ve sonrasında temel bileşen analizi gerçekleştirilmiştir.
3. Tek hücreli transkriptom verilerinin ön işlemesi ve hücre anotasyonu
GSE145154'ten elde edilen gen ekspresyon matrisi, Seurat versiyon 524 kullanılarak bir Seurat nesnesi oluşturmak amacıyla Seurat'a aktarıldı. Düşük kaliteli hücreler şu eşik değerleri kullanılarak dışlandı: hücre başına 200–6.000 saptanan gen, 500'den fazla toplam benzersiz moleküler tanımlayıcı (UMI) sayısı ve %25'in altında mitokondriyal gen yüzdesi. Bu kalite kontrol eşiklerinin dışında kalan hücreler, düşük kaliteli veya yırtılmış hücreler olarak değerlendirilerek dışlandı. Düşük kaliteli hücreleri yalnızca yukarıda açıklanan kalite kontrol eşiklerini kullanarak eledik.
Log normalizasyonu, 10.000 ölçek faktörü ile NormalizeData fonksiyonu kullanılarak gerçekleştirilmiştir. En yüksek değişkenliğe sahip ilk 3.000 gen, vst yöntemiyle FindVariableFeatures fonksiyonu kullanılarak seçilmiştir. Veriler ScaleData ile ölçeklendirilmiş, ardından lineer boyut indirgeme için temel bileşen analizi uygulanmıştır.
Batch etkileri, örnek kimliğinin gruplandırma değişkeni olarak belirlendiği RunHarmony fonksiyonu aracılığıyla Harmony algoritması25 kullanılarak düzeltildi. Hücreleri kümelemek için FindNeighbors ve FindClusters fonksiyonları kullanılarak ilk 15 temel bileşenten yararlanıldı. Kümeleme, 0,15 çözünürlükte Leiden algoritması kullanılarak gerçekleştirildi. Doğrusal olmayan boyut indirgeme ve görselleştirme, uniform manifold approximation and projection kullanılarak yapıldı.
Hücre tipleri, SingleR paketini26 kullanan otomatik açıklamanın yanı sıra kanonik marker genler kullanılarak tanımlandı. Marker genler şunlardı: B hücreleri için IGKC, MS4A1 ve CD79A; kardiyomiyositler için TNNI3, MYL2 ve ACTC1; endotel hücreleri için VWF, PECAM1 ve EGFL7; makrofajlar için C1QC, C1QB ve C1QA; monositler için S100A8, S100A9 ve G0S2; doğal öldürücü hücreler için NKG7, GNLY ve CCL5; düz kas hücreleri için MYL9, TAGLN ve ACTA2; stromal hücreler için FBLN1, LUM ve DCN; ve T hücreleri için CD3E, CD3G ve CD3D.
4. Diferansiyel ekspresyon analizi ve gen seti zenginleştirme skorlaması
DCM ve sağlıklı kontrol grupları arasındaki gen ekspresyonunu karşılaştırmak için limma paketi27 kullanılarak bir lineer model oluşturulmuştur. P değeri < 0.05 olan ve mutlak kat değişim değeri (fold change) 1,5'ten büyük olan (bu değer 0,58'den büyük bir mutlak log₂ kat değişimine karşılık gelir) genler, anlamlı şekilde diferansiyel eksprese olmuş olarak tanımlanmıştır.
Her bir örnekteki yaşlanma ile ilişkili ve mitokondri ile ilişkili gen setleri için zenginleştirme skorlarını hesaplamak amacıyla tek örnekli gen seti zenginleştirme analizi gerçekleştirildi28. DCM ve sağlıklı kontrol grupları arasındaki zenginleştirme skorlarındaki farklar, P değerinin < 0,05 olduğu durumlar istatistiksel olarak anlamlı kabul edilerek Wilcoxon sıra toplamı testi kullanılarak değerlendirildi.
Tek hücre düzeyinde, yaşlanma ile ilişkili ve mitokondriyal modül skorları Seurat'taki AddModuleScore fonksiyonu kullanılarak hesaplanmıştır. Gruplar arasındaki modül skorlarındaki farklılıklar Wilcoxon rank-sum testi ile değerlendirilmiştir.
Yaşlanma ile ilişkili gen imzaları CellAge veri tabanından (https://genomics.senescence.info/cells/) ve mitokondri ile ilişkili gen setleri GeneCards'tan (https://www.genecards.org/) alınmıştır. Skorlama için kullanılan eksiksiz gen listeleri Ek Dosya 1'de sunulmuştur.
5. Ağırlıklı gen ko-ekspresyon ağının oluşturulması
Ağ oluşturulması için bulk transkriptomik verilerde en yüksek ekspresyon varyansına sahip ilk 5000 protein kodlayan gen tutuldu. Birden fazla yumuşak eşikleme gücü (soft-thresholding power) altında ölçeksiz topoloji uyum indeksini hesaplamak için pickSoftThreshold fonksiyonu uygulandı. Optimal eşik, R2 değeri 0,9'un üzerinde olan ölçeksiz bir ağ sağlayan minimum güç olarak belirlendi. Buna göre, sonraki ağ analizi için β = 5 yumuşak eşikleme gücü benimsendi.
Minimum modül boyutu 30 olarak belirlenen blockwiseModules fonksiyonu kullanılarak imzalı ağırlıklı bir ko-ekspresyon ağı oluşturuldu. Her bir modül özgeni (eigengene) ile yaşlanma ile ilişkili veya mitokondriyal zenginleştirme skoru arasında Pearson korelasyon katsayıları hesaplandı. Mutlak korelasyon katsayısı 0,4'ten büyük ve P < 0,001 olan modüller, anlamlı şekilde ilişkili modüller olarak değerlendirildi.
Anlamlı şekilde ilişkili modüllerdeki genler, DCM ile ilişkili yaşlanma aday genlerini ve DCM ile ilişkili mitokondri aday genlerini belirlemek amacıyla farklı şekilde eksprese edilen genlerle kesiştirilmiştir.
6. Fonksiyonel zenginleştirme analizi
Gen Ontolojisi (GO) ve Kyoto Gen ve Genom Ansiklopedisi (KEGG) yolak analizlerini içeren fonksiyonel zenginleştirme analizleri, clusterProfiler paketi kullanılarak29 aday genler üzerinde gerçekleştirilmiştir. GO zenginleştirmesi üç standart kategoriyi kapsamıştır: biyolojik süreç, hücresel bileşen ve moleküler fonksiyon.
Tüm analizler, insan türü anotasyonu, P-değerinin düzeltilmesi için yanlış keşif oranı (FDR) ve 0,05'lik bir q-değeri eşiği ile gerçekleştirilmiştir. Gen setleri 10–500 gen boyut aralığıyla sınırlandırılmış ve FDR değeri olan terimler < 0,05 değeri istatistiksel olarak anlamlı olarak tanımlandı. Son olarak, GO zenginleştirme sonuçları görselleştirildi yoluyla gruplandırılmış sütun grafikler kullanılırken, KEGG zenginleştirme sonuçları kabarcık grafikleriyle gösterilmiştir.
7. PPI ağının oluşturulması ve hub gen taraması
Aday genler, organizma Homo sapiens ve etkileşim güven eşiği 0,7'den büyük kombine skor olarak ayarlanarak STRING versiyon 11.5 veri tabanına30 gönderildi. Bağlantısız düğümler gizlendi ve etkileşim verileri sekme ile ayrılmış değerler formatında dışa aktarıldı.
Etkileşim verileri, görselleştirme için Cytoscape versiyon 3.9.1'e aktarıldı31. Düğüm topolojik skorları, CytoHubba eklentisi32 kullanılarak üç algoritma (Derece, maksimum komşuluk bileşeni ve maksimum klik merkeziliği) ile hesaplandı.
Ağ içerisindeki temel fonksiyonel modüller, şu varsayılan parametreler kullanılarak MCODE eklentisiyle33 belirlendi: derece eşiği, 2; k-core, 2; düğüm puanı eşiği, 0.2 ve maksimum derinlik, 100. Üç topolojik algoritmanın tamamı tarafından ilk 10 arasında sıralanan genler, nihai protein-protein etkileşim merkez genlerini belirlemek amacıyla MCODE temel alt ağıyla kesiştirildi.
8. Makine öğrenimi tabanlı çekirdek gen seçimi ve tanısal model oluşturma
Tekrarlanabilirliği ve dengeli temsili sağlamak amacıyla, entegre toplu transkriptomik veri seti, sabit bir rastgele tohum (seed = 123456) kullanılarak 7:3 oranında eğitim ve doğrulama setlerine rastgele ayrılmıştır. Bu ayrım, her iki setteki sınıf oranlarını tutarlı tutmak için hastalık grubuna (DCM ile kontrol) göre tabakalı olarak yapılmıştır. Ayrım işleminden önce, farklı veri seti kaynaklarından gelen grup etkileri sva paketi kullanılarak düzeltilmiş ve entegre edilen örnekler rastgele tahsis sırasında birleşik bir kohort olarak ele alınmıştır.
Aday genleri taramak için üç makine öğrenimi algoritması uygulandı. İlk olarak, glmnet paketindeki cv.glmnet fonksiyonu aracılığıyla LASSO lojistik regresyonu gerçekleştirildi34. Değerlendirme metriği olarak AUC'nin benimsendiği 5 katlı çapraz doğrulama (cross-validation) ikili sınıflandırma modeli oluşturuldu. lambda.min değerinde sıfır olmayan katsayılara sahip genler, aday genler olarak ayrıldı.
İkinci olarak, randomForest paketi35 kullanılarak 500 karar ağacından oluşan bir rastgele orman (random forest) sınıflandırma modeli oluşturulmuştur. Her bölünme için örneklenen değişken sayısı, toplam özellik sayısının karekökü olarak ayarlanmıştır. Gen önemi Gini katsayısına göre nicelleştirilmiş ve en yüksek önem puanına sahip ilk 10 gen seçilmiştir.
Üçüncü olarak, caret paketindeki36 rfe fonksiyonu kullanılarak SVM-RFE analizi gerçekleştirildi. Özellik sayıları 1–10 aralığında belirlendi ve model eğitimi için 5-katlı çapraz doğrulama yöntemi benimsendi. Nihayetinde, optimal çapraz doğrulama doğruluğuna sahip gen alt kümesi seçildi.
Üç algoritmanın tamamı tarafından tanımlanan genler, DCM'deki nihai temel yaşlanma ve mitokondri ile ilgili genler olarak tanımlandı. Ardından 10 sınıflandırma algoritması kullanılarak tanısal modeller oluşturuldu: karar ağacı, gradyan artırma makinesi, artırılmış genelleştirilmiş doğrusal model, k-en yakın komşu, lojistik regresyon, sinir ağı, kısmi en küçük kareler, rastgele orman, destek vektör makinesi ve ekstrem gradyan artırma.
Alıcı işletim karakteristik eğrileri pROC paketi kullanılarak oluşturuldu37. Eğitim ve doğrulama setlerindeki tanısal performansı değerlendirmek için eğri altındaki alan, doğruluk, duyarlılık ve özgünlük hesaplandı.
Her bir çekirdek genin model tahminlerine katkısını hesaplamak için SHapley Additive exPlanations analizi gerçekleştirilmiştir38. Özet grafikler ve örnek bazlı şelale grafikleri oluşturulmuştur. Validasyon setinde eğri altında kalan alan değerleri 0,8'den büyük olan nihai bir tanısal modelin, iyi tanısal performansa sahip olduğu kabul edilmiştir.
9. Hücre-hücre etkileşimi çıkarımı
Kardiyak mikroçevredeki hücre-hücre iletişim ağları CellChat paketi kullanılarak çıkarılmıştır39. CellChatDB.human veritabanı kullanılarak bir CellChat nesnesi oluşturulmuştur. Diferansiyel eksprese edilen ligandlar ve reseptörler identifyOverExpressedGenes kullanılarak tanımlanmış ve anlamlı etkileşim çiftleri identifyOverExpressedInteractions kullanılarak filtrelenmiştir.
Hücre tipleri arasındaki iletişim olasılıkları computeCommunProb kullanılarak hesaplanmıştır. Global hücre tipi düzeyindeki iletişim ağı aggregateNet ile birleştirilmiştir. Her bir hücre tipi çifti arasındaki etkileşim sayısı ve iletişim gücü nicelendirilmiş; ısı haritaları ve sütun grafikleri kullanılarak görselleştirilmiştir.
10. İmmün hücre infiltrasyon kantifikasyonu
Her bir bulk örnek için, tek örnek gen seti zenginleştirme analizi28 ve bir immün hücre imza gen seti40 kullanılarak 28 immün hücre tipine ait zenginleştirme skorları hesaplanmıştır. DCM ve sağlıklı kontrol grupları arasındaki immün hücre zenginleştirme skorlarını karşılaştırmak için Wilcoxon sıra toplamı testi kullanılmıştır. P < 0,05 istatistiksel olarak anlamlı kabul edilmiştir.
Temel gen ekspresyon seviyeleri ile immün hücre zenginleştirme skorları arasındaki ilişkiyi değerlendirmek için Pearson korelasyon analizi gerçekleştirilmiştir. P < 0,05 olan tüm korelasyonlar istatistiksel olarak anlamlı kabul edilmiştir.
11. Moleküler alt tiplendirme için konsensüs kümeleme
Çekirdek gen ekspresyon profilleri kullanılarak DCM örneklerinin gözetimsiz konsensüs kümelemesi gerçekleştirildi aracılığıyla ConsensusClusterPlus paketi41Kümeleme parametreleri; maksimum küme sayısı 6, 1000 yeniden örnekleme iterasyonu ve 0,8 yeniden örnekleme oranı olarak belirlenmiştir. Kümeleme için Öklid uzaklığı ile medoidler etrafında bölümlendirme yöntemi benimsenmiş ve tekrarlanabilirliği sağlamak için sabit bir rastgele tohum kullanılmıştır.
Optimal alt tip sayısı, delta alan grafiği ve konsensüs küme kararlılık skorlarına göre belirlenmiş ve sonuç olarak K = 2 olarak tanımlanmıştır. İki moleküler alt tipin belirgin ayrımını doğrulamak için ayrıca temel bileşen analizi gerçekleştirilmiştir.
Örnekle özgü KEGG yolak zenginleştirme skorlarını hesaplamak için gen seti varyasyon analizi42 uygulanmıştır. Alt tipler arasındaki diferansiyel yolak aktivasyonunu tespit etmek için limma paketi27 kullanılmış ve 0.05'ten küçük P değeri istatistiksel olarak anlamlı olarak tanımlanmıştır.
12. Kardiyak fonksiyonların ekokardiyografik değerlendirmesi
Fareler anestezi altına alındı aracılığıyla %1 sodyum pentobarbital (30 mg/kg) intraperitonal olarak enjekte edildi ve termostatik bir ameliyat masasında sırtüstü pozisyonda sabitlendi. Göğüs kıllarının temizlenmesinin ardından, prekordial bölgeye ultrason iletim jeli eşit şekilde uygulandı.
Küçük hayvan ultrason sistemi kullanılarak, sol ventrikül papiller kasları düzeyinde iki boyutlu rehberli M-mod ekokardiyografi gerçekleştirilmiştir. Sol ventrikül end-diyastolik çapı, end-sistolik çapı, ejeksiyon fraksiyonu ve fraksiyonal kısalma değerlerini ölçmek için birbirini takip eden üç stabil kalp döngüsü kaydedilmiştir. Tüm ekokardiyografik değerlendirmeler, profesyonel bir ultrasonograf tarafından körleme yöntemiyle yürütülmüştür.
Ekokardiyografik inceleme için her gruptan rastgele üç fare seçilmiş ve toplamda bu 6 hayvan, daha sonra miyokard dokusu toplama ve ELISA ölçümü için sakrifiye edilmiştir. Geriye kalan deney hayvanlarına ek paralel laboratuvar analizleri uygulanmış olup, bu hayvanlara ait veriler mevcut çalışmaya dahil edilmemiştir.
13. Miyokard dokusu toplama, protein ekstraksiyonu ve enzimle bağlantılı immünosorbent deneyi
Ekokardiyografik değerlendirmenin ardından fareler derin anestezi altında ötanize edilmiştir. Kalp dokuları hızla toplanmıştır. aracılığıyla median torakotomi yapıldı ve sol ventrikül miyokardı buz üzerinde diseke edildi. İzole edilen dokular, kalıntıya dair intrakardiyak kanı uzaklaştırmak için buz soğukluğundaki fosfat tamponlu salin ile iyice durulandı. Fazla sıvı steril filtre kağıdıyla kurutulduktan sonra, örnekler derhal sıvı azot içerisinde şok donduruldu ve −80 °C tekrarlanan dondurma-çözme döngülerinden kesinlikle kaçınılarak, sonraki protein ekstraksiyonu için.
Dondurulmuş miyokard dokuları tartıldı ve buz üzerinde yaklaşık 1 mm3 boyutunda parçalara bölündü. Dokular, 10 mg doku başına 100 µL tampon şeklinde standardize edilmiş bir oranda, proteaz ve fosfataz inhibitörleri içeren buz gibi soğuk RIPA liz tamponunda liz edildi. Örnekler, buz üzerinde mekanik olarak tamamen homojenize edildi ve tam hücre lizini sağlamak için 30 dk inkübe edildi.
Lizatlar 4 °C'de 15 dk boyunca 12,000 × g hızında santrifüjlendi. Elde edilen süpernatantlar enzim içermeyen tüplere toplandı ve toplam protein konsantrasyonu, üretici protokolleri izlenerek bir bisinkoninik asit protein analiz kiti kullanılarak belirlendi. Tüm örnekler, lizis tamponu ile aynı protein konsantrasyonuna normalize edildi.
Miyokard lizatlarında dört hub genin protein ekspresyon seviyeleri, ilgili enzim bağlantılı immünosorbent assay (ELISA) kitleri kullanılarak ölçülmüştür. Seri dilüsyonla hazırlanan standartlar ve normalize edilmiş doku lizatları, önceden kaplanmış mikroplakalara duble olarak (kuyu başına 100 µL) eklenmiştir. Plakalar oda sıcaklığında 2 sa boyunca inkübe edilmiş ve kit ile birlikte sağlanan yıkama tamponu ile iyice yıkanmıştır.
Her kuyucuğa enzimle konjuge edilmiş antikor eklenmiş ve oda sıcaklığında 1 h boyunca inkübe edilmiş, ardından kapsamlı bir yıkama işlemi uygulanmıştır. Daha sonra substrat kromojen çözeltisi eklenmiş ve plaklar oda sıcaklığında, karanlıkta 20 min boyunca inkübe edilmiştir. Renk reaksiyonu durdurma çözeltisi ile sonlandırılmış ve absorbans değerleri, tam dalga boyuna sahip bir mikroplaka okuyucu kullanılarak 450 nm'de (referans dalga boyu: 570 nm) ölçülmüştür.
14. İstatistiksel analiz
Tüm istatistiksel analizler ve veri görselleştirmeleri R versiyon 4.2.3 kullanılarak gerçekleştirilmiştir. Her bir hedef genin (TGFB2, SERPINE1, CYBB, TLR2) ELISA konsantrasyon ölçümleri için, öncelikle Kontrol ve DCM gruplarındaki verilerin normalliğini değerlendirmek amacıyla Shapiro-Wilk testi uygulanmıştır. Ardından, iki grup arasındaki varyansların homojenliğini değerlendirmek için F-testi kullanılmıştır. Gruplar arası karşılaştırma yöntemi, varyans homojenlik testi sonuçlarına göre belirlenmiştir: varyanslar homojen ise (P ≥ 0.05), gruplar arasındaki ortalama değerleri karşılaştırmak için eşleştirilmemiş Student’s t-testi uygulanmış; varyanslar heterojen ise (P < 0.05), analiz için düzeltilmiş Welch’s t-testi kullanılmıştır. Tüm testler çift yönlü yapılmış ve istatistiksel anlamlılık eşiği P < 0.05 olarak belirlenmiştir. Veriler, üzerine dağıtılmış bireysel veri noktaları eklenmiş kutu grafikleri (boxplot) şeklinde görselleştirilmiştir. Tüm testlerin P değerleri ve uygulanan t-testi türü her grafikte ayrıntılı olarak belirtilmiştir.
Sonuçlar
Veri ön işleme ve diferansiyel ekspresyon analizi
Altı bulk transkriptomik veri setinin tamamı, alt analizlerden önce standart ön işleme ve grup etkisi (batch-effect) düzeltmesine tabi tutulmuştur. Mikroarray verileri robust multi-array average algoritması kullanılarak normalize edilirken, RNA-seq sayım verileri trimmed mean of M-values yöntemi kullanılarak normalize edilmiştir. Veri seti kaynağı ve tespit platformu ile ilişkili teknik grup etkilerini gidermek için ComBat algoritması uygulanmıştır. Temel bileşenler analizi, örneklerin düzeltme öncesinde veri seti kaynağına göre kümelendiğini, düzeltme sonrasında ise grup bazlı belirgin bir ayrışma olmaksızın daha homojen bir şekilde dağıldığını göstermiştir.
Dilate kardiyomiyopati (DCM) ve sağlıklı kontrol (HC) grupları arasındakile diferansiyel ekspresyon analizi limma paketi kullanılarak gerçekleştirilmiştir. En belirgin şekilde diferansiyel ekspresyon gösteren 20 genin ısı haritası, iki grup arasındaki ekspresyon profillerinin ayrıldığını göstermiştir (Şekil 1A). P değeri < 0,05 ve |log₂ fold change| > 0,58 eşik değerleri kullanılarak toplam 1.473 diferansiyel eksprese gen tanımlanmıştır. Bunların 819 geni DCM miyokard örneklerinde yukarı regüle, 654 geni ise aşağı regüle olmuştur (Şekil 1B).
Ardından, her bir örnekteki yaşlanma ile ilgili ve mitokondri ile ilgili gen setleri için zenginleştirme skorlarını hesaplamak amacıyla tek örneklik gen seti zenginleştirme analizi kullanıldı. Her iki skor da DCM ve HC grupları arasında anlamlı farklılık gösterdi (Şekil 1C).
Ağırlıklı gen ortak ifade ağ analizi
Yaşlanma ile ilişkili ve mitokondriyal zenginleştirme skorlarıyla ilişkili gen modüllerini belirlemek için ağırlıklı gen ortak ifade ağ analizi gerçekleştirildi. Ağın oluşturulması için toplu veri setindeki en yüksek ekspresyon varyansına sahip 5.000 protein kodlayan gen kullanıldı. β = 5 yumuşak eşikleme gücünde, ölçeksiz topoloji uyum indeksi R2 = 0,9 değerini aşarak ölçeksiz ağ kriterini karşıladı (Şekil 1D).
Hiyerarşik kümeleme ve modül birleştirme sonucunda üç gen modülü belirlenmiştir. Her üç modül de yaşlanma ile ilişkili skorla anlamlı düzeyde korelasyon göstermiştir. Turkuaz modül, yaşlanma ile ilişkili skorla en güçlü korelasyonu sergilemiştir (r = 0.69, P < 0.001). Mitokondriyal skor için ise mavi ve gri modüller anlamlı düzeyde korelasyon göstermiş olup, en güçlü ilişki mavi modülde görülmüştür (r = 0.56, P < 0.001; Şekil 1E). Bu nedenle, yaşlanma ile ilişkili gen taraması için turkuaz modül, mitokondri ile ilişkili gen taraması için ise mavi modül seçilmiştir.
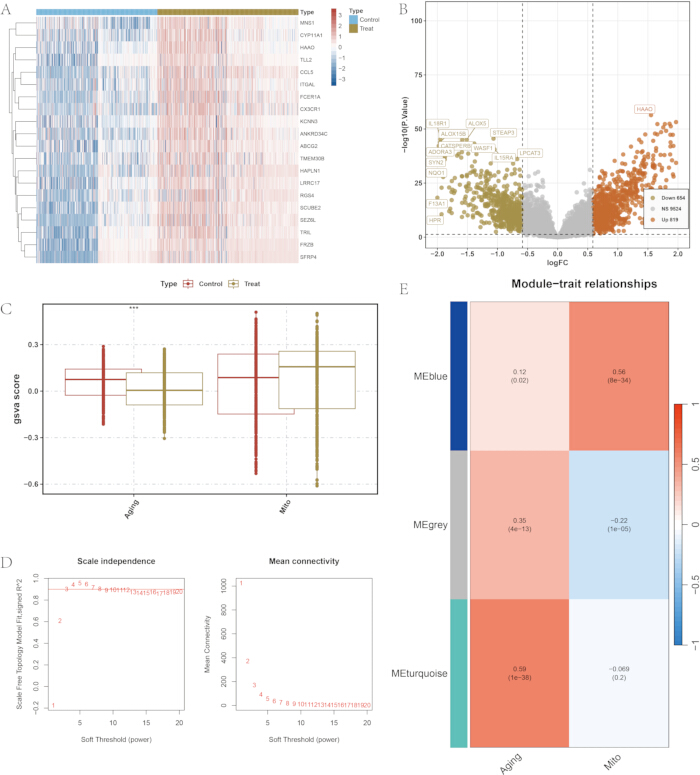
Şekil 1: Diferansiyel ekspresyon analizi ve ağırlıklı gen ko-ekspresyon ağının oluşturulması. (A) Dilate kardiyomiyopati (DCM) ve sağlıklı kontrol (HC) grupları arasında en anlamlı şekilde diferansiyel ekspresyon gösteren 20 genin ısı haritası. (B) Tüm diferansiyel eksprese edilen genlerin yanardağ grafiği. Kırmızı upregüle olan genleri, yeşil downregüle olan genleri ve gri anlamlı olmayan genleri belirtir. Eşik değerler P value < 0.05 ve |log₂ fold change| > 0.58 olarak belirlenmiştir. (C) Yaşlanma ile ilişkili ve mitokondri ile ilişkili gen setleri için tek örneklemli gen seti zenginleştirme analizi skorlarının kutu grafikleri. (D) Ağırlıklı gen ko-ekspresyon ağı analizi için yumuşak eşik seçimi; farklı yumuşak eşikleme kuvvetleri boyunca ölçekten bağımsız topoloji uyum indeksi ve ortalama bağlantısallığı göstermektedir. (E) Modül özgenleri ile yaşlanma ile ilişkili ve mitokondriyal skorlar arasındaki korelasyonların ısı haritası. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Yaşlanma ve mitokondri ile ilişkili aday genlerin tanımlanması
Aday genler; diferansiyel olarak ifade edilen genlerin, seçilen ağırlıklı gen ko-ekspresyon ağ analizi modüllerindeki genlerin ve ilgili referans gen setlerinin kesiştirilmesiyle tanımlanmıştır. Bu analiz, 66 DCM ile ilişkili yaşlanma aday geni (Şekil 2A) ve 16 DCM ile ilişkili mitokondri aday geni (Şekil 2B) belirlemiştir.
Gen Ontolojisi zenginleştirme analizi, yaşlanma ile ilişkili aday genlerin, nitrik oksit sentaz biyosentezi ve kolajen içeren hücre dışı matris organizasyonu dahil olmak üzere biyolojik süreçlerde zenginleştiğini göstermiştir (Şekil 2C). Mitokondri ile ilişkili aday genler ise mitokondri iç membranı ve solunum zinciri kompleksi dahil olmak üzere, mitokondriyal enerji metabolizması ile ilişkili terimlerde zenginleşmiştir (Şekil 2D).
Kyoto Encyclopedia of Genes and Genomes analizi, yaşlanma ile ilişkili aday genlerin hipoksiyle indüklenebilir faktör-1, fosfoinositid 3-kinaz-protein kinaz B ve ileri glikasyon son ürünü-ileri glikasyon son ürünü reseptörü sinyal yolaklarında zenginleştiğini göstermiştir (Şekil 2E). Mitokondri ile ilişkili aday genlerin, oksidatif fosforilasyonu içeren yolaklarda zenginleştiği görülmüştür (Şekil 2F).
DCM ve HC grupları arasındaki yaşlanmayla ilgili 66 aday genin diferansiyel ekspresyon modelleri, bir ekspresyon ısı haritası kullanılarak görselleştirilmiştir (Şekil 2G). Mitokondriyle ilgili 16 aday genin ekspresyon modelleri ise kutu grafikleri kullanılarak görselleştirilmiştir (Şekil 2H).
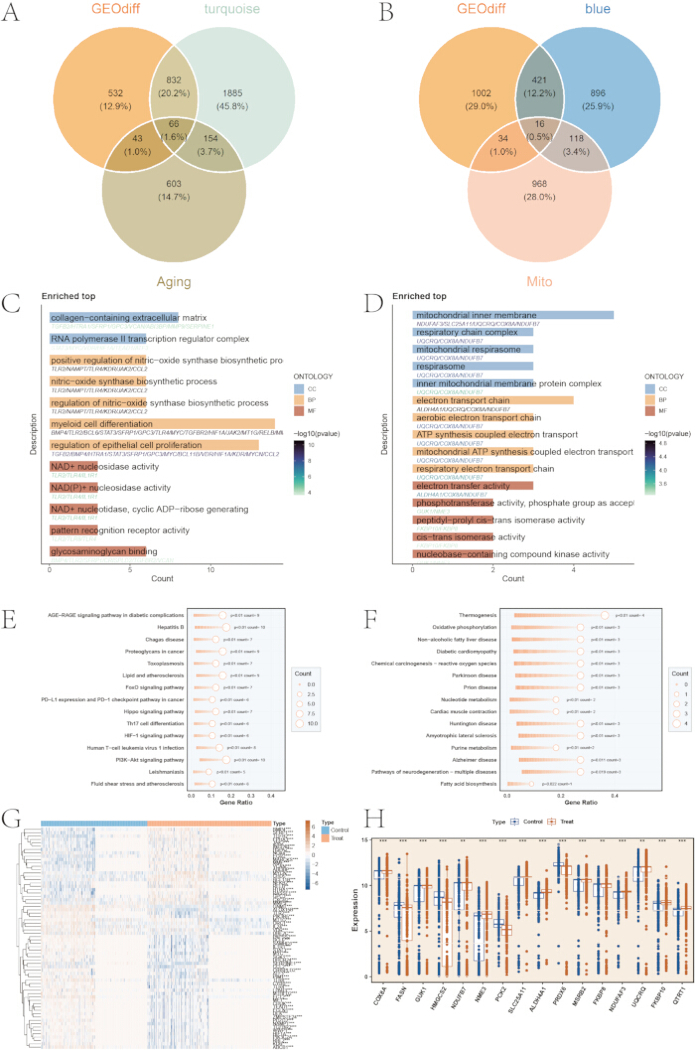
Şekil 2: Aday genlerin taranması ve fonksiyonel zenginleştirme. (A) Diferansiyel eksprese olan genlerin, ağırlıklı gen ko-ekspresyon ağ analizi modül genlerinin ve yaşlanma ile ilişkili referans gen setinin kesişimini gösteren Venn diyagramı. (B) Diferansiyel eksprese olan genlerin, ağırlıklı gen ko-ekspresyon ağ analizi modül genlerinin ve mitokondri ile ilişkili referans gen setinin kesişimini gösteren Venn diyagramı. (C) Yaşlanma ile ilişkili aday genlerin Gen Ontolojisi zenginleştirme analizi. (D) Mitokondri ile ilişkili aday genlerin Gen Ontolojisi zenginleştirme analizi. (E) Yaşlanma ile ilişkili aday genlerin Kyoto Encyclopedia of Genes and Genomes yolak zenginleştirme analizi. (F) Mitokondri ile ilişkili aday genlerin Kyoto Encyclopedia of Genes and Genomes yolak zenginleştirme analizi. (G) DCM ve HC gruplarındaki 66 yaşlanma ile ilişkili aday genin ekspresyon ısı haritası. (H) DCM ve HC gruplarındaki 16 mitokondri ile ilişkili aday genin ekspresyon kutu grafikleri. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Tek hücreli RNA dizileme veri setinin hücre tipi anotasyonu
Tek hücre çözünürlüğünde doğrulama için GSE145154 tek hücreli RNA dizileme veri seti kullanıldı. Kalite kontrol filtrelemesi, log normalizasyonu ve Harmony grup düzeltmesinin ardından, farklı örneklerden gelen hücreler, görünür bir örnekle ilişkili ayrışma olmaksızın tek düzen manifold yaklaşımı ve projeksiyon (UMAP) uzayına dağıtıldı. İlk 15 temel bileşen ve 0,15 kümeleme çözünürlüğü kullanılarak hücreler 9 kümeye ayrıldı (Şekil 3A).
Kanonik belirteç genler ve SingleR kullanılarak yapılan otomatik anotasyon; makrofajlar, doğal katil hücreler, T hücreleri, B hücreleri, endotel hücreler, düz kas hücreleri, monositler, stromal hücreler ve kardiyomiyositlerden oluşan 9 ana hücre tipini belirlemiştir (Şekil 3B). Hücre tipine özgü belirteç genlerin ekspresyon modelleri bu anotasyonları desteklemiştir (Şekil 3C).
Her bir hücre için AddModuleScore fonksiyonu kullanılarak mitokondriyal modül skorları hesaplanmış olup, genişlemiş kardiyomiyopati ve sağlıklı kontrol grupları arasında anlamlı farklılıklar göstermiştir (P < 2.22 × 10⁻16; Şekil 3D). Yaşlanma ile ilişkili modül skorları da iki grup arasında anlamlı şekilde farklılık göstermiştir (P < 2.22 × 10⁻16; Şekil 3E). Mitokondriyal skorların uniform manifold approximation and projection (UMAP) uzayına yansıtılması, yüksek skorların temel olarak kardiyomiyositlerde gözlemlendiğini göstermiştir (Şekil 3F). Buna karşılık, yüksek yaşlanma ile ilişkili skorlar ağırlıklı olarak makrofajlarda gözlemlenmiştir (Şekil 3G).
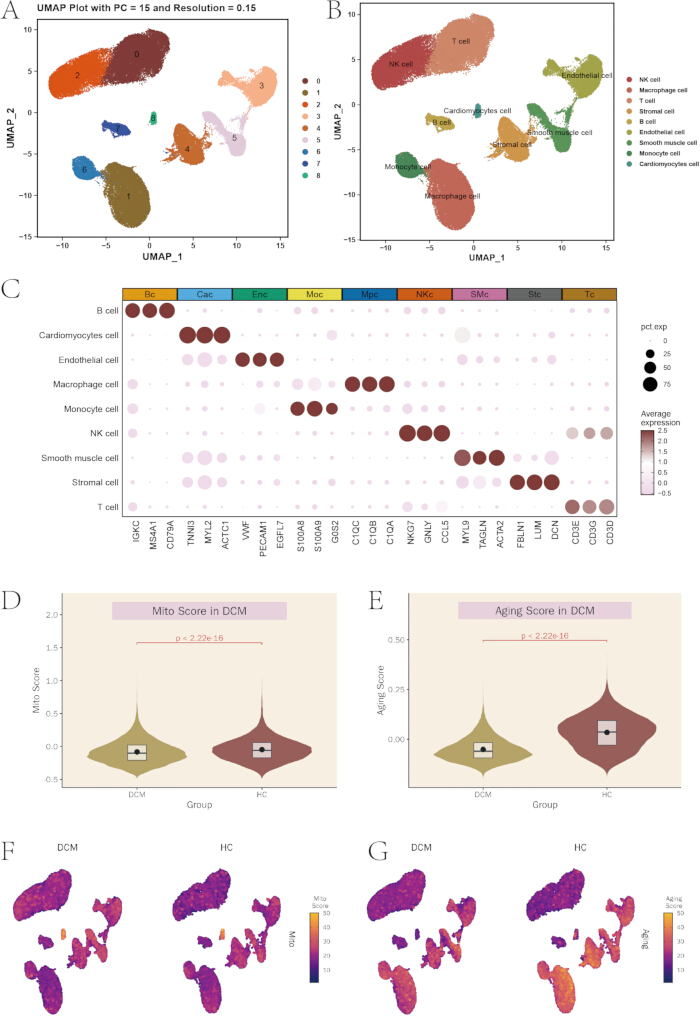
Şekil 3: Tek hücre transkriptom anotasyonu ve modül skor analizi. (A) İlk 15 temel bileşen ve 0,15 kümeleme çözünürlüğü kullanılarak oluşturulan hücre kümelerinin tek düzlem yakınsama ve projeksiyon (UMAP) grafiği. (B) Anote edilmiş hücre tiplerinin tek düzlem yakınsama ve projeksiyon (UMAP) grafiği. (C) Hücre tipleri genelinde kanonik marker genlerin ekspresyonunu gösteren balon grafiği. (D) DCM ve HC gruplarında mitokondriyal modül skorlarının keman grafiği. (E) DCM ve HC gruplarında yaşlanma ile ilişkili modül skorlarının keman grafiği. (F) Hücreler genelinde mitokondriyal modül skorlarının dağılımını gösteren tek düzlem yakınsama ve projeksiyon (UMAP) grafiği. (G) Hücreler genelinde yaşlanma ile ilişkili modül skorlarının dağılımını gösteren tek düzlem yakınsama ve projeksiyon (UMAP) grafiği. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Protein-protein etkileşim ağı oluşturma
Yaşlanma ile ilişkili 66 ve mitokondri ile ilişkili 16 aday genden oluşan birleşik set, birleşik skor > 0.7 yüksek güven eşiği kullanılarak bir protein-protein etkileşim ağı oluşturmak amacıyla STRING versiyon 11.5 veri tabanına yüklendi. Ağ, görselleştirme ve topolojik analiz için Cytoscape'e aktarıldı (Şekil 4A).
Yüksek derecede bağlantılı düğümleri ve çekirdek alt ağları belirlemek için derece, maksimal klik merkeziliği, maksimum komşuluk bileşeni ve MCODE analizleri kullanılmıştır. Bu yöntemlerle tanımlanan alt ağlar Şekil 4B–E'de gösterilmiştir.
Derece, maksimal klik merkeziliği ve maksimum komşuluk bileşeni ile sıralanan ilk 10 gen, MCODE çekirdek alt ağıyla kesiştirildi. Bu analiz sonucunda şu 10 aday gen belirlendi: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 ve CXCR2.
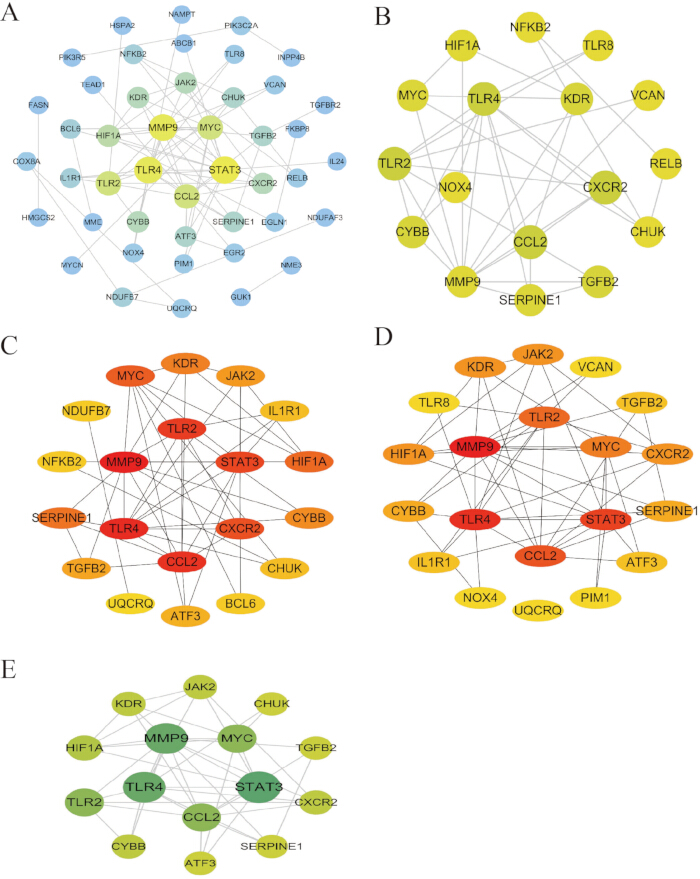
Şekil 4: Protein-protein etkileşim ağı oluşturma ve hub gen taraması.
(A) Aday genlerin genel protein-protein etkileşim ağı. (B) MCODE kullanılarak belirlenen çekirdek alt ağ. (C) Maksimal klik merkeziliği kullanılarak belirlenen çekirdek alt ağ. (D) Maksimum komşuluk bileşeni kullanılarak belirlenen çekirdek alt ağ. (E) Derece (Degree) kullanılarak belirlenen çekirdek alt ağ. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Hub genlerin makine öğrenmesi tabanlı taraması
10 protein-protein etkileşim adayından hub genleri taramak için üç makine öğrenmesi algoritması —en küçük mutlak küçültme ve seçim operatörü lojistik regresyonu, rastgele orman ve destek vektör makinesi-özyinelemeli özellik eleme— uygulanmıştır. Tüm analizler, sabit bir rastgele tohum (set.seed(12345)) ve 5 katlı çapraz doğrulama kullanılarak gerçekleştirilmiştir. LASSO modelinde, optimal lambda (lambda.min) değerinde sıfır olmayan katsayılara sahip genler aday olarak tutulmuştur (Şekil 5A).
Destek vektör makinesi-özyinelemeli öznitelik eleme modelinde, 10 öznitelik dahil edildiğinde 0,859 ile en yüksek çapraz doğrulama doğruluğuna (Şekil 5B) ve buna karşılık gelen 0,141'lik minimum hata oranına (Şekil 5C) ulaşılmıştır. 500 karar ağacına sahip rastgele orman modeli, torba dışı (out-of-bag) hata oranının kararlı yakınsamasını göstermiştir (Şekil 5D). Gini katsayısına dayalı gen önem sıralamasında TGFB2, TLR2, SERPINE1 ve CYBB en yüksek sıradaki genler arasında yer almıştır (Şekil 5E). Her üç algoritma tarafından seçilen genlerin kesişimi, dört nihai merkez (hub) gen sağlamıştır: CYBB, SERPINE1, TGFB2 ve TLR2 (Şekil 5F).
Her bir hub genin model öngörülerine olan katkısını değerlendirmek için SHapley Additive exPlanations analizi gerçekleştirilmiştir. TGFB2, 0,249 ile en yüksek ortalama mutlak SHapley Additive exPlanations değerine sahipken, bunu sırasıyla 0,103 ile SERPINE1, 0,083 ile CYBB ve 0,078 ile TLR2 izlemiştir (Şekil 6A). Özet grafik, örnekler genelinde gen katkılarının dağılımını ve yönünü göstermiştir (Şekil 6B). Bağımlılık grafikleri, bireysel gen değerleri ile model katkıları arasındaki ilişkiyi örneklendirmiş (Şekil 6C), örnek başına şelale grafikleri ise her bir genin bireysel öngörülere katkısını göstermiştir (Şekil 6D).
Dört merkez genine dayalı tanısal sınıflandırma modelleri, ardından 10 sınıflandırma algoritması kullanılarak oluşturulmuştur. Eğitim setinde, çoğu algoritma 0.85'in üzerinde eğri altı alan değerlerine ulaşmıştır (Şekil 6E). Dahili doğrulama setinde ise çoğu algoritma 0.78'in üzerinde eğri altı alan değerleri elde etmiştir (Şekil 6F).
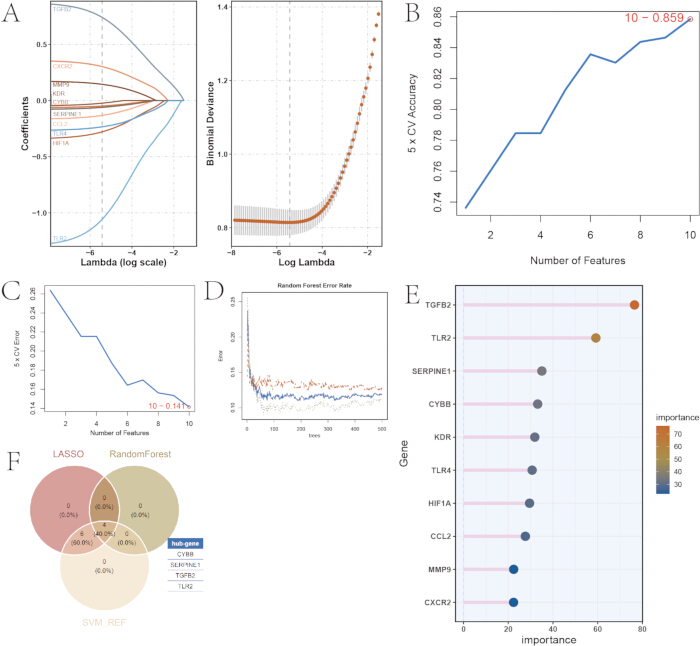
Şekil 5: Hub genlerin makine öğrenimi tabanlı taraması. (A) En küçük mutlak daraltma ve seçme operatörü (LASSO) regresyon katsayısı yörüngesi ve optimal lambda seçimi. (B) Destek vektör makinesi-özyinelemeli özellik eleme modeli için çapraz doğrulama doğruluk eğrisi. (C) Destek vektör makinesi-özyinelemeli özellik eleme modeli için çapraz doğrulama hata eğrisi. (D) Rastgele orman modeli için torba dışı (out-of-bag) hata oranı eğrisi. (E) Rastgele orman modelinde Gini katsayısına dayalı gen önem sıralaması. (F) Üç makine öğrenimi algoritması tarafından belirlenen hub genleri gösteren Venn diyagramı. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
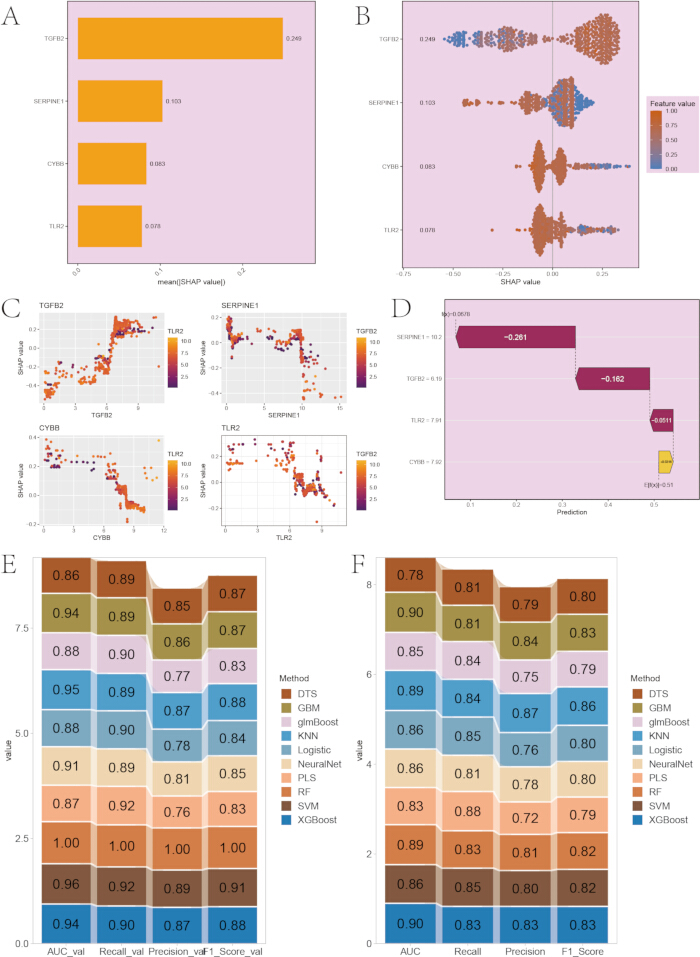
Şekil 6: Tanısal model değerlendirmesi ve SHapley Additive exPlanations analizi. (A) Dört hub gen için ortalama mutlak SHapley Additive exPlanations değerleri. (B) Gen katkılarının dağılımını ve yönünü gösteren SHapley Additive exPlanations özet grafiği. (C) Her bir hub gen için SHapley Additive exPlanations bağımlılık grafikleri. (D) Temsili bir örnek için SHapley Additive exPlanations şelale grafiği. (E) Eğitim setindeki 10 sınıflandırma algoritmasının tanısal performans ısı haritası. (F) Doğrulama setindeki 10 sınıflandırma algoritmasının tanısal performans ısı haritası. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Tek hücre doğrulaması ve hücre-hücre iletişimi analizi
Dört hub genin ekspresyon modelleri tek hücre düzeyinde değerlendirildi. Hücre tipi dağılım analizi, CYBB ve TLR2'nin monositlerde ve makrofajlarda yüksek düzeyde eksprese olduğunu, SERPINE1 ve TGFB2'nin ise ağırlıklı olarak stromal hücrelerde eksprese olduğunu göstermiştir (Şekil 7A).
Keman grafikleri, CYBB ekspresyonunun dilatasyon tipi kardiyomiyopati ve sağlıklı kontrol grupları arasında anlamlı şekilde farklılık gösterdiğini ortaya koymuştur (Şekil 7B). SERPINE1 (Şekil 7C), TGFB2 (Şekil 7D) ve TLR2 (Şekil 7E) de gruplar arasında anlamlı düzeyde farklılık göstermiştir. Her dört genin de, her bir karşılaştırma için P < 0.0001 olmak üzere, sağlıklı kontrollere kıyasla dilatasyon tipi kardiyomiyopati grubunda anlamlı şekilde artmış olduğu görülmüştür.
Kardiyak mikroçevredeki hücre-hücre iletişim ağları, CellChat ve bir ligand-reseptör veri tabanı kullanılarak çıkarılmıştır. Hücre-hücre etkileşimlerinin sayısı ve genel gücü, dilate kardiyomiyopati ve kontrol grupları arasında farklılık göstermiştir (Şekil 7F). Hücre tipleri arasındaki diferansiyel iletişim gücü de gözlemlenmiştir (Şekil 7G). Monositler, makrofajlar, kardiyomiyositler ve stromal hücreler, iletişim ağının ana katılımcılarıdır.
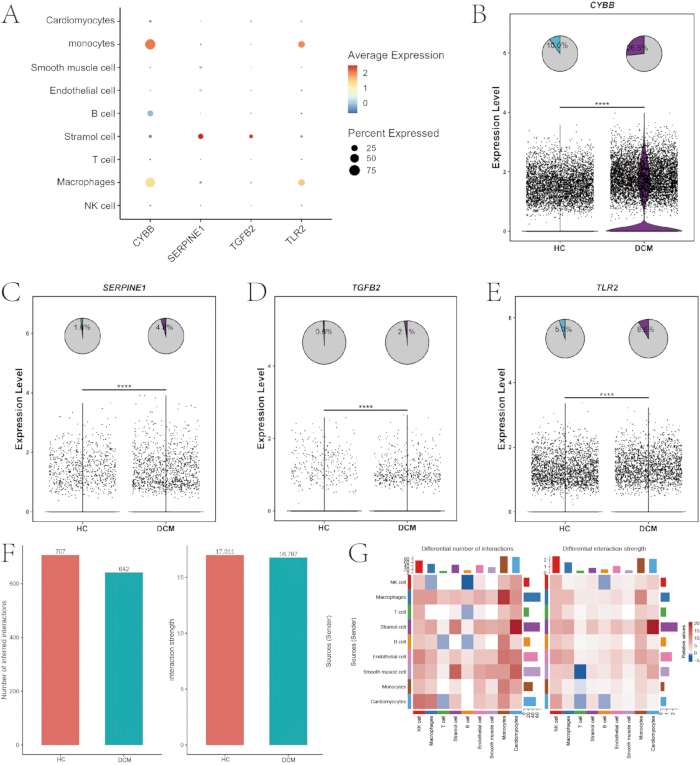
Şekil 7: Hub genlerin tek hücre doğrulaması ve hücre-hücre iletişimi analizi. (A) Dört hub genin farklı hücre tiplerindeki ekspresyonunu gösteren balon grafiği. (B) DCM ve HC gruplarında CYBB ekspresyonunun keman grafiği. (C) DCM ve HC gruplarında SERPINE1 ekspresyonunun keman grafiği. (D) DCM ve HC gruplarında TGFB2 ekspresyonunun keman grafiği. (E) DCM ve HC gruplarında TLR2 ekspresyonunun keman grafiği. (F) Hücre-hücre etkileşimlerinin sayısını ve genel gücünü gösteren sütun grafiği. (G) Gruplar arasındaki hücre-hücre iletişimi gücündeki farklılıkları gösteren ısı haritası. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
İmmün hücre infiltrasyon analizi
Tek örnek gen seti zenginleştirme analizi kullanılarak her bir bulk örnek için 28 immün hücre alt kümesine ait zenginleştirme skorları hesaplanmıştır. Çoğu immün hücre tipinin bolluğu, dilate kardiyomiyopati ve sağlıklı kontrol grupları arasında anlamlı düzeyde farklılık göstermiştir (Şekil 8A).
Ardından, hub gen ekspresyonu ile immün hücre zenginleştirme skorları arasındaki ilişkiyi değerlendirmek için Pearson korelasyon analizi gerçekleştirildi. CYBB ekspresyonu, birden fazla immün hücre tipinin bolluğu ile anlamlı düzeyde korelasyon gösterdi (Şekil 8B). Benzer korelasyonlar SERPINE1 (Şekil 8C), TGFB2 (Şekil 8D) ve TLR2 (Şekil 8E) için de gözlemlendi. CYBB, SERPINE1 ve TLR2; monositler ve makrofajlar dahil olmak üzere birçok doğuştan gelen immün hücre popülasyonu ile pozitif korelasyon gösterdi.
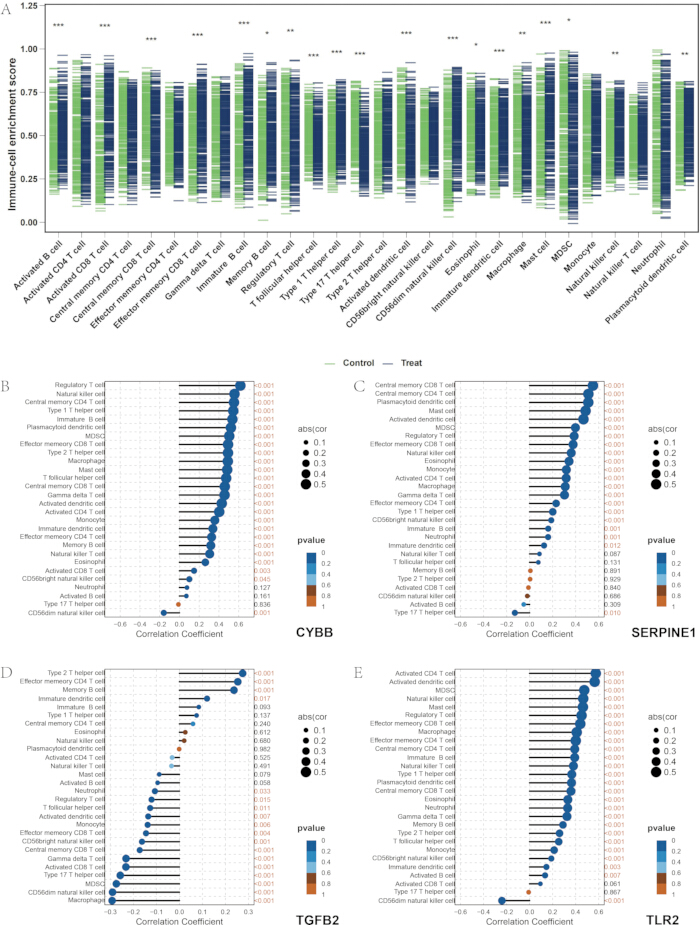
Şekil 8: Bağışıklık hücresi infiltrasyonu ve korelasyon analizi. (A) DCM ve HC gruplarında 28 bağışıklık hücresi tipi için zenginleştirme skorlarının kutu grafikleri. (B) CYBB ekspresyonu ile bağışıklık hücresi bolluğu arasındaki korelasyonları gösteren lollipop grafiği. (C) SERPINE1 ekspresyonu ile bağışıklık hücresi bolluğu arasındaki korelasyonları gösteren lollipop grafiği. (D) TGFB2 ekspresyonu ile bağışıklık hücresi bolluğu arasındaki korelasyonları gösteren lollipop grafiği. (E) TLR2 ekspresyonu ile bağışıklık hücresi bolluğu arasındaki korelasyonları gösteren lollipop grafiği. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Dilate kardiyomiyopatinin moleküler alt tiplendirmesi
Dört hub genin ekspresyon profillerine dayanarak, dilate kardiyomiyopati örnekleri üzerinde gözetimsiz konsensüs kümeleme yapılmıştır. Konsensüs kümeleme matrisi, K = 2 değerinde ayrımı desteklemiştir (Şekil 9A). Delta alan grafiği, örnekleri C1 ve C2 olmak üzere iki moleküler alt tipe ayıran K = 2 değerinin optimal küme sayısı olduğunu daha fazla desteklemiştir (Şekil 9B).
CYBB, SERPINE1 ve TLR2 ekspresyon seviyeleri iki alt tip arasında anlamlı şekilde farklılık göstermiştir (Şekil 9C). Birden fazla immün hücre alt kümesinin bolluğu da alt tipler arasında farklılık göstermiştir (Şekil 9D). Gen seti varyasyon analizi, C1 alt tipinde vasküler endotelyal büyüme faktörü sinyal yolunun göreceli aktivasyonunu gösterirken, primer safra asidi biyosentezi ve glikosfingolipid biyosentezi C2 alt tipinde zenginleşmiştir (Şekil 9E). Temel bileşen analizi, iki alt tipe atanan örnekler arasında ayrışma olduğunu göstermiştir (Şekil 9F).
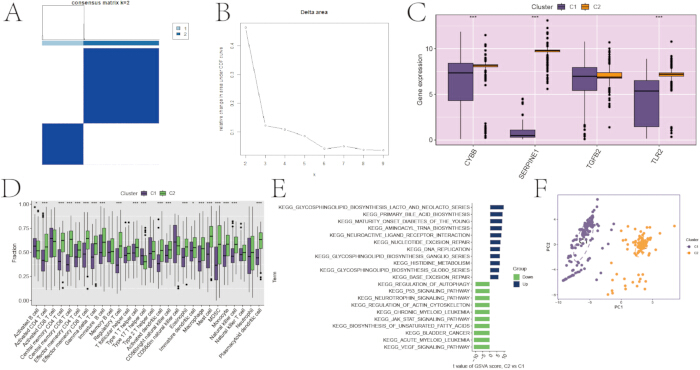
Şekil 9: Dilate kardiyomiyopatinin moleküler alt tiplendirmesi için konsensüs kümeleme. (A) K = 2 için konsensüs kümeleme matrisi. (B) Optimal küme sayısını belirlemek için kullanılan delta alan grafiği. (C) İki moleküler alt tipte hub gen ekspresyonunun kutu grafikleri. (D) İki moleküler alt tipte immün hücre bolluğunun kutu grafikleri. (E) İki moleküler alt tip arasında farklı şekilde zenginleşmiş Kyoto Encyclopedia of Genes and Genomes yolaklarının ısı haritası. (F) İki moleküler alt tip arasındaki ayrımı gösteren temel bileşenler analizi grafiği. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
In vivo dilate kardiyomiyopati fare modelinde validasyon
Spontan dilate kardiyomiyopati fenotipine sahip CTNTR141W transgenik fareler, ... için kullanılmıştır. in vivo doğrulama. Yaşla eşleştirilmiş wild-type C57BL/6J kontrol fareleri ile karşılaştırıldığında, transgenik farelerde sol ventrikül son diyastolik çapında anlamlı bir artış ve sol ventrikül ejeksiyon fraksiyonunda azalma gözlenmiştir; bu durum ventriküler dilatasyon ve sistolik disfonksiyon ile uyumludur (Şekil 10A).
Toplam protein sol ventriküler miyokard dokusundan ekstrakte edildi ve bisinkoninik asit tabanlı toplam protein normalizasyonunun ardından, dört merkez gen tarafından kodlanan proteinlerin konsantrasyonları enzimle bağlantılı immunosorbent analiz (ELISA) ile ölçüldü. Tüm analizler çift örneklem (duplicate) olarak gerçekleştirildi. Standart eğrilerin korelasyon katsayıları (R2) ≥ 0,99 idi ve çift örneklem kuyucukları arasındaki varyasyon katsayıları %10'un altındaydı. Kontrol ve DCM grupları arasındaki istatistiksel anlamlılık, F-testi ile değerlendirilen varyansların eşitliğine bağlı olarak Student t-testi veya Welch t-testi kullanılarak değerlendirildi (normallik Shapiro-Wilk testi ile doğrulandı). Dilate kardiyomiyopati (DCM) farelerinde, kontrol grubuna kıyasla her dört merkez gene karşılık gelen miyokard protein seviyeleri anlamlı derecede artmıştı (Şekil 10B). ELISA doğrulaması için her gruba 3 biyolojik tekrarlanan örnek (münferit fareler) dahil edildi. ELISA doğrulaması için grup başına üç bağımsız biyolojik tekrarlanan örnek dahil edildi. Bu bulgular öncül olarak değerlendirilmeli ve daha geniş bir kohortta doğrulanmalıdır.
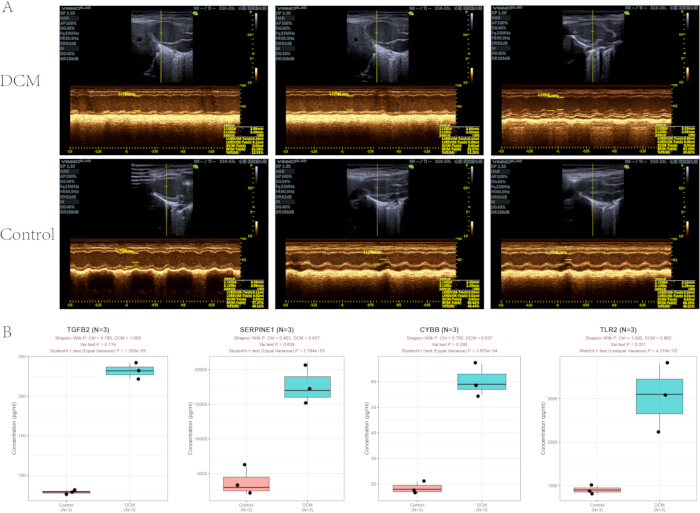
Şekil 10: CTNTR141W transgenik dilate kardiyomiyopati fare modelinde in vivo doğrulama. (A) CTNTR141W transgenik DCM farelerinin ve yabani tip kontrol farelerinin temsilci M-modu ekokardiyografik görüntüleri. (B) Fare sol ventrikül miyokard dokularındaki dört merkez gen kaynaklı proteinin ELISA ile kantifikasyonu. Kutu ve bıyık grafikleri, Kontrol ve DCM grupları için protein konsantrasyonlarını göstermektedir (grup başına n = 3 biyolojik tekrar). Her bir kutu grafiği için: kutu içindeki düz yatay çizgi medyan değeri; kutunun üst ve alt sınırları 75. ve 25. yüzdelikleri (çeyrekler arası aralık, IQR) temsil eder; üst ve alt bıyıklar, 1.5 × IQR içindeki maksimum ve minimum aykırı olmayan veri noktalarına kadar uzanır; tekil siyah noktalar, tekil hayvanlardan elde edilen bağımsız biyolojik tekrarları karşılar. y-ekseni mutlak protein konsantrasyonunu belirtir: TGFB2 ve CYBB için pg/mL, TLR2 ve SERPINE1 için ng/mL. İki grup arasındaki istatistiksel karşılaştırmalar, normalite Shapiro-Wilk testi ile doğrulanarak ve varyans homojenliği F-testi ile değerlendirilerek, Student t-testi (eşit varyans) veya Welch t-testi (eşit olmayan varyans) kullanılarak gerçekleştirilmiştir. Sınırlama beyanı: n = 3 tekrardan elde edilen ELISA sonuçları öncül keşif bulgularıdır ve gelecekte genişletilmiş örneklem boyutu ile doğrulama yapılması gerekmektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Veri Erişilebilirliği:
Bu çalışmada analiz edilen altı toplu transkriptomik veri seti ve bir tek hücre RNA dizileme veri seti, Gene Expression Omnibus veri tabanında GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 ve GSE145154 erişim numaraları altında kamuya açık olarak sunulmaktadır. Tek hücre analizi, GSE145154'ten alınan GSM4307515, GSM4307516, GSM4307520 ve GSM4307521 örneklerini içermektedir. Bu çalışma sırasında oluşturulan veya analiz edilen diğer tüm veriler ve hesaplama kodları, yayınlanan bu makalede ve ek bilgi dosyalarında yer almaktadır. Özellikle, Ek Dosya 1; tam yaşlanma ve mitokondri ile ilişkili gen listelerini, 28 hücreli immün imzayı, özel analiz betiklerini, normalize edilmiş transkriptomik veri matrislerini, ELISA analizleri için kaynak verileri ve tüm makale şekillerinin temelini oluşturan ham kaynak verileri içermektedir.
Ek Dosya 1: Yaşlanma ve Mitokondri ile İlişkili Gen Setleri, İmmün İmzalar, Analiz Betikleri, Normalize Edilmiş Transkriptomik Veriler ve Şekil Kaynak Verileri. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Entegre çok katmanlı iş akışı; bulk transkriptomik meta-analiz, ağırlıklı gen ko-ekspresyon ağı oluşturma, topluluk makine öğrenimi, tek hücre transkriptomik doğrulaması ve in vivo hayvan modeli doğrulamasını birleştirmiştir. Yaşlanma ve mitokondri ile ilişkili dört hub gen olan CYBB, SERPINE1, TGFB2 ve TLR2, dilate kardiyomiyopati (DCM) için aday tanısal biyobelirteçler olarak tanımlanmıştır. Mikroarray ve RNA-dizileme platformları dahil olmak üzere, Gene Expression Omnibus deposundan alınan altı bağımsız sol ventrikül transkriptomik veri setinin entegrasyonu, tek veri seti yanlılığını azaltmış ve analizin istatistiksel temelini güçlendirmiştir43,44,45. Önceden tanımlanmış yaşlanma ilişkili ve mitokondriyal gen setleri ile birleştirilen ağırlıklı gen ko-ekspresyon ağı analizi, yalnızca diferansiyel ekspresyon analizine güvenmek yerine, özelliklerle ilişkili fonksiyonel modüllerin tanımlanmasını sağlamıştır46. Topluluk makine öğrenimi, bireysel özellik seçim yöntemleriyle ilişkili algoritmaya özgü yanlılığı azaltırken47,48, SHapley Additive exPlanations analizi her bir hub genin model tahminlerine olan katkısını nicelleştirmiştir49. Bulk miyokard transkriptomları, tek hücre transkriptomları ve transgenik bir fare modeli üzerinden yapılan doğrulamalar, seçilen genlerin hücresel dağılımını ve miyokard protein seviyelerini daha ayrıntılı şekilde karakterize etmiştir50.
Kalıntı veri setine özgü varyasyonlar, diferansiyel ekspresyon analizini ve modül-özellik ilişkilerini etkileyebileceği için batch düzeltmesi entegre analizde kritik bir adımdı. Bu nedenle, veri seti kaynağı ve deteksiyon platformu ComBat modeline batch faktörleri olarak dahil edildi. Temel bileşen analizi grafiklerindeki kalıntı veri setine bağımlı kümelenme, düzeltmenin tamamlanmadığını ve potansiyel sistematik yanlılığı gösterirdi44. Yumuşak eşikleme gücü (soft-thresholding power) ayrıca ağırlıklı gen ko-ekspresyon ağı oluşturma için önemliydi. R2 > 0.9 değerinde bir ölçeksiz topoloji uyum indeksi üreten minimum değer seçilerek β = 5 elde edildi. Daha düşük bir değer parçalı veya fonksiyonel olarak bilgilendirici olmayan modüller üretebilirken, daha yüksek bir değer gen bağlantılarını zayıflatabilir ve modül-özellik korelasyon analizinin istatistiksel gücünü azaltabilir46. Kardiyomyositler yüksek metabolik aktiviteye sahip olduğundan, tek hücre kalite kontrol eşikleri kalp dokusuna uyarlandı. Kardiyomyositleri korurken yırtılmış ve düşük kaliteli hücreleri temizlemek için, mitokondriyal gen yüzdesi kesme noktasının %25'in altında olduğu ve saptanan gen aralığının 200–6,000 olduğu katı bir filtreleme stratejisi uygulandı50. Tekrarlanan makine öğrenimi analizleri arasındaki varyasyonu azaltmak için veri seti bölme, model eğitimi ve çapraz doğrulama işlemlerinde set.seed(12345) şeklinde belirlenmiş sabit bir rastgele tohum (random seed) kullanıldı47.
Genotip onayı, standardize barındırma koşulları ve tutarlı ekokardiyografik ölçümler, hayvan deneylerinde fenotipik stabilitenin korunması için önemliydi. CTNTR141W transgenik fareler, belirtilen alıştırma ve besleme döneminden sonra sol ventrikül dilatasyonu ve sistolik disfonksiyon geliştirirler.51Gruplandırma öncesinde, transgenik olmayan hayvanları dışlamak ve fenotipin yanlış sınıflandırılmasını önlemek için genotip doğrulaması yapılması gereklidir. Ekokardiyografik ölçümler, sol ventrikül papiller kasları seviyesinde tutarlı bir şekilde alınmalı ve ölçümler birbirini izleyen üç stabil kardiyak döngü boyunca ortalama olarak hesaplanmalıdır. Görüntüleme pozisyonundaki farklılıklar veya anestezi derinliği, sol ventrikül ejeksiyon fraksiyonu ölçümlerindeki değişkenliği artırabilir.51Enzim bağlı immünosorbent assay kalitesi, standart eğri korelasyon katsayıları (R) kullanılarak değerlendirilmiştir.2 ≥ 0,99 ve varyasyon katsayıları < Yinelenen kuyucuklar arasında %10. Standart eğri lineeritesinin düşük olması veya tutarsız yinelenen ölçümler, protein konsantrasyon tahminlerine sistematik hata girebilir.
İş akışının uygulanması sırasında çeşitli analitik sorunlar ortaya çıkabilir. ComBat düzeltmesi sonrası devam eden grup (batch) ayrımı; grup değişkenleri ile klinik faktörler arasındaki doğrusal bağımlılığı, düşük ekspresyonlu genlerin yetersiz filtrelenmesini veya modellenmemiş teknik varyasyonu yansıtıyor olabilir. Mevcut olduğunda, yaş ve cinsiyet gibi klinik kovaryatlar korumalı değişkenler olarak eklenebilir ve gürültüyü azaltmak için örneklerin %70'inden fazlasında sıfır ekspresyona sahip genler çıkarılabilir44. Artık ayrım devam ettiğinde, removeBatchEffect ile ek düzeltme düşünülebilir. Beklenmedik derecede yüksek veya düşük sayıda diferansiyel eksprese gen saptanması; örnek heterojenliğinin, normalizasyonun, aykırı değerlerin ve eşik değer seçiminin değerlendirilmesini gerektirebilir27. Düşük modül-özellik korelasyonları; varyans eşiğinin, yumuşak eşikleme gücünün (soft-thresholding power) ve uç özellik değerlerinin yeniden değerlendirilmesiyle ele alınabilir. En değişken 5.000 genden 7.500 gene genişleme veya tek örnekle gen seti zenginleştirme analizinin gen seti varyasyon analizi ile değiştirilmesi modül tespitini iyileştirebilir46. Protein-protein etkileşim ağındaki aşırı sayıda izole düğüm, STRING güven eşiğinin ayarlanmasını veya aday gen setinin genişletilmesini gerektirebilir30. Düşük makine öğrenimi performansı; eğitim ve doğrulama setleri arasındaki dağılım farklarını, özellik redundansını veya grup dengesizliğini yansıtıyor olabilir. Tabakalı örnekleme, redundant özelliklerin azaltılması veya azınlık sınıfın aşırı örneklenmesi (oversampling) bu etkileri azaltabilir47. Belirsiz tek hücre kümelemesi; Harmony düzeltmesinin, temel bileşen seçiminin ve marker gen anotasyonunun yeniden değerlendirilmesini gerektirebilir50.
Bazı kısıtlamalar dikkate alınmalıdır. Transkriptomik veri setleri kamuya açık depolardan retrospektif olarak elde edilmiştir ve orijinal çalışma tasarımları ile klinik karıştırıcı faktörler kontrol edilememiştir. Veri setleri genelinde klinik açıklamalar eksiktir ve çoğu veri setinde etiyoloji, ilaç geçmişi, hasta yaşı ve uzun vadeli sonuçlar hakkında ayrıntılı bilgi bulunmamaktadır. Bu kısıtlamalar, seçilen genler ile prognoz, tedavi yanıtı veya kronolojik yaşlanma arasındaki ilişkilerin değerlendirilmesini engellemiştir52. Batch düzeltmesine rağmen kalıntı teknik varyasyonlar mevcut olabilir. Analiz temel olarak haberci RNA ekspresyonuna dayanmıştır ve entegre epigenomik, proteomik veya metabolomik verileri içermemiştir. Sonuç olarak, protein aktivitesi, translasyon sonrası regülasyon ve üst mekanizmalar belirlenememiştir. Sadece bir tek hücreli veri seti dahil edilmiş olup, bu durum DCM etiyolojileri genelindeki hücresel heterojenliğin değerlendirilmesini sınırlamaktadır50. CTNTR141W transjenik modeli temel olarak bir kardiyak troponin T mutasyonu ile ilişkili kalıtsal DCM'yi temsil etmektedir ve hastalığın idiyopatik, viral veya iskemik formlarını yeniden üretmeyebilir51. Fareler ve insanlar arasındaki tür farklılıkları da doğrudan klinik çeviriyi sınırlamaktadır. Protein düzeyindeki doğrulama farelerden alınan miyokard dokusu ile sınırlandırılmış; büyük klinik kohortlar ve yerleşik biyobelirteçlerle karşılaştırmalar yapılmamıştır. Dört merkez gen (hub gene) DCM'ye özgü değildir ve diğer kardiyovasküler veya enflamatuar durumlarda da değişmiş olabilir. Ek olarak, aday seçimi önceden tanımlanmış yaşlanma ile ilgili ve mitokondriyal gen setlerine dayandırılmıştır. Bu hipotez odaklı strateji, seçilen referans setlerinin dışındaki genleri hariç tutabilirken, üç makine öğrenimi algoritması arasındaki kesişim, yalnızca tek bir yöntemle tanımlanan genleri atlayabilir48.
Analitik çerçeve, DCM'de gelecekteki moleküler alt tiplendirme, biyobelirteç validasyonu ve multi-omik çalışmalara destek sağlayabilir. Dört genli panel, tanısal veya alt tiplendirme aracı olarak değerlendirilmeden önce bağımsız periferik kan veya miyokard kohortlarında değerlendirilebilir. C1 ve C2 alt tipleri farklı immün ve metabolik yolak profilleri göstermiş olup, alt tipe özgü biyolojik özelliklerin sonraki validasyonları için bir temel oluşturmuştur15. Seçilen genler ayrıca moleküler kenetlenme, hücresel ve fonksiyonel çalışmalarda da incelenebilir. TLR2 ve CYBB enflamatuar sinyalleşme ve reaktif oksijen türleri üretimi ile ilişkiliyken, TGFB2 ve SERPINE1 fibrozis ve kardiyak yeniden şekillenme ile ilişkilidir53. Proteomik, metabolomik, epigenomik, genom çapında ilişkilendirme ve Mendel randomizasyon verileriyle entegrasyon, düzenleyici ilişkilerin ve potansiyel nedensel ilişkilerin değerlendirilmesine yardımcı olabilir54. İş akışı, hastalığa özgü veri setleri ve referans gen setleri değiştirilerek hipertrofik kardiyomiyopati, iskemik kardiyomiyopati ve kalp yetersizliğinin transkriptomik çalışmalarına da uyarlanabilir45. Gelecekte, transpozaz erişilebilir kromatin dizileme ve spatial transkriptomik için tek hücreli analizlerin dahil edilmesi, hücresel düzenleme ve spatial ekspresyon hakkında ek bilgiler sağlayabilir. Makrofajlarda yaşlanma ile ilgili imzaların ve kardiyomiyositlerde mitokondriyal imzaların gözlemlenen zenginleşmesi, kardiyak hastalıklardaki enflamatuar ve mitokondriyal süreçlerle ilgili önceki raporlarla tutarlıdır55,56,57.
Bu çalışmanın kabul edilmesi gereken birkaç kısıtlılığı bulunmaktadır. Özellikle, protein nicelendirmesi için kullanılan ticari ELISA kitleri, hedef proteinlerin serum örneklerinde saptanması için resmi olarak valide edilmiştir. Mevcut çalışmada, saptama matrisi olarak serum yerine miyokardiyal doku lizatları kullanılmıştır. Deneysel verilerin güvenilirliğini ve karşılaştırılabilirliğini sağlamak amacıyla analiz boyunca tutarlı örnek ön işlem ve deneysel işlem prosedürleri titizlikle uygulanmış olsa da, bu ELISA kitlerinin miyokardiyal doku lizatı örnekleri için resmi üretici validasyonunun eksikliği, protein nicel sonuçlarında potansiyel olarak küçük sapmalara yol açabilir. Bu nedenle, seruma özgü ELISA kitlerinin miyokardiyal doku lizatlarına uygulanması, bu çalışmanın metodolojik bir kısıtlılığını oluşturmaktadır.
Açıklamalar
Yazar, herhangi bir çıkar çatışması beyan etmemektedir.
Teşekkürler
Gene Expression Omnibus veri tabanı aracılığıyla sağlanan ve halka açık olan veriler için teşekkür ederiz. Ayrıca, makale hakkındaki yapıcı görüşleri için hakemlere ve editörlere teşekkürler sunulur. Bu çalışma, "Yiqi Huoxue Formülünün KLF2-Nrf2 Aracılı İnflamatuar Regülasyon yoluyla Aterosklerotik Vasküler Remodelasyonu Hafifletme Mekanizması" başlıklı İl Düzeyi Bilimsel Araştırma Projesi (Hibe No. 2021JDZX2026) tarafından desteklenmiştir.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Aquasonic Clear Ultrasound Gel | Parker Laboratories, Inc. | Mar-34 | Küçük hayvan ekokardiyografik görüntülemesi için kullanılır. |
| BCA Protein Assay Kit | Thermo Fisher Scientific | 23227 | 562 nm'de tespit; aralık, 20–2.000 µg/mL; fare kalp lizatlarının toplam protein kantifikasyonu için kullanılır. |
| CellAge veri tabanı | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | Yaşlanma ile ilişkili gen imzalarının kaynağı. |
| CytoHubba, Cytoscape eklentisi | Cytoscape App Store | Version 0.1 | Protein-protein etkileşim ağlarında düğüm topolojisi skorlaması için kullanılır. |
| Cytoscape | Cytoscape Consortium | Version 3.9.1 | Protein-protein etkileşim ağlarının görselleştirilmesi için kullanılır. |
| Tam dalga boylu mikroplaka okuyucu | Thermo Fisher Scientific | Multiskan FC | ELISA analizlerinde absorbansı ölçmek için kullanılır. |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | Transkriptomik veri setlerini elde etmek için kullanılan genel depo. |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | Mitokondri ile ilişkili gen setlerinin kaynağı. |
| Halt Protease ve Phosphatase Inhibitor Cocktail, 100×, EDTA-free | Thermo Fisher Scientific | 78441 | 4 °C'de saklanır; kullanımdan hemen önce RIPA tamponuna 10 µL/mL oranında eklenir. |
| Sıvı azot | Yerel laboratuvar gaz tedarikçisi | Uygulanamaz | Miyokard dokusunun şok dondurulması için kullanılır. |
| Erkek SPF düzeyinde C57BL/6J fareler, 6–8 haftalık, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Uygulanamaz | Hayvan Üretim Lisansı No. SCXK (Jing) 2021-0006; normal kontroller olarak kullanılır. |
| Erkek SPF düzeyinde CTNTR141W transgenik DCM fareler, 6–8 haftalık, 25 ± 2 g | Institute of Laboratory Animal Science, Chinese Academy of Medical Sciences | Uygulanamaz | Hayvan Üretim Lisansı No. SCXK (Jing) 2021-0065; spontan DCM modeli olarak kullanılır. |
| MCODE, Cytoscape eklentisi | Cytoscape App Store | Version 2.0.2 | Protein-protein etkileşim ağlarındaki temel fonksiyonel alt ağları tanımlamak için kullanılır. |
| Mouse CYBB ELISA Kit | Biogradetech | A-QEK09250-96wells | Bu çalışmada fare miyokard dokusu lizatlarındaki CYBB'yi ölçmek için kullanılmıştır. |
| Mouse PAI-1 ELISA Kit | EK-BIO | ML30970 | Bu çalışmada fare miyokard dokusu lizatlarındaki SERPINE1 tarafından kodlanan protein olan PAI-1'i ölçmek için kullanılmıştır. |
| Mouse TGF-β2 ELISA Kit | ElaBoX | SEKM-0036 | Bu çalışmada fare miyokard dokusu lizatlarındaki TGF-β2'yi ölçmek için kullanılmıştır. |
| Mouse TLR-2 ELISA Kit | Solarbio | SEKM-0163 | Bu çalışmada fare miyokard dokusu lizatlarındaki TLR-2'yi ölçmek için kullanılmıştır. |
| Fosfat tamponlu salyanda, pH 7.4, kalsiyum ve magnezyumsuz | Biological Industries | 02-024-1ACS | Steril 1× çözelti; 4 °C'de saklanır; doku yıkama ve dilüsyon için kullanılır. |
| R paketi: caret | CRAN | Version 6.0-94 | Destek vektör makinesi-rekürsif özellik eleme işlemi için kullanılır. |
| R paketi: CellChat | CellChat geliştiricileri | Version 1.6.1 | Tek hücreli RNA sekanslama verilerinden hücre-hücre iletişimi çıkarımı için kullanılır. |
| R paketi: clusterProfiler | Bioconductor | Version 4.8.3 | Fonksiyonel zenginleştirme analizi için kullanılır. |
| R paketi: ConsensusClusterPlus | Bioconductor | Version 1.64.0 | Denetimsiz konsensüs kümeleme için kullanılır. |
| R paketi: edgeR | Bioconductor | Version 3.42.4 | M-değerlerinin kırpılmış ortalaması yöntemi ile RNA sekanslama verilerinin normalizasyonu için kullanılır. |
| R paketi: GEOquery | Bioconductor | Version 2.68.0 | Gene Expression Omnibus'tan veri indirmek için kullanılır. |
| R paketi: glmnet | CRAN | Version 4.1-8 | En küçük mutlak büzülme ve seçim operatörü lojistik regresyonu için kullanılır. |
| R paketi: limma | Bioconductor | Version 3.56.2 | Diferansiyel ekspresyon analizi ve istatistiksel modelleme için kullanılır. |
| R paketi: pROC | CRAN | Version 1.18.5 | ROC eğrisi analizi için kullanılır. |
| R paketi: randomForest | CRAN | Version 4.7-1.2 | Rastgele orman makine öğrenmesi için kullanılır. |
| R paketi: Seurat | CRAN | Version 5.0.1 | Tek hücreli RNA sekanslama veri analizi için kullanılır. |
| R paketi: SingleR | Bioconductor | Version 2.2.0 | Otomatik hücre tipi anotasyonu için kullanılır. |
| R paketi: sva | Bioconductor | Version 3.48.0 | ComBat grup etkisiy düzeltmesi için kullanılır. |
| Soğutmalı santrifüj | Sigma-Aldrich | SIGMA 3-K | Miyokard dokusu lizatlarının santrifügasyonu için kullanılır. |
| RIPA Liziz ve Ekstraksiyon Tamponu | Thermo Fisher Scientific | 89900 | Kullanıma hazır 1× çözelti; 4 °C'de saklanır; kullanımdan önce proteaz ve fosfataz inhibitörleri ile desteklenir. |
| Küçük hayvan ultrasonik görüntüleme sistemi | VINNO Technology Co., Ltd. | VINN06LAB | Kardiyak fonksiyonun ekokardiyografik değerlendirmesi için kullanılır. |
| Sodyum pentobarbital | Sinopharm Chemical Reagent Co. | 20040428 | Steril salyanda %1'lik çözelti, 10 mg/mL olarak hazırlanır; 30 mg/kg dozunda intraperitonal anestezi için kullanılır. |
| STRING veri tabanı | STRING Consortium | Version 11.5 | Protein-protein etkileşim ağı oluşturma için kullanılır. |
| TGrinder H24 Doku Homojenizörü | TIANGEN | OSE-TH-01 | Fare miyokard dokusunu RIPA tamponunda 6.0 m/s hızda, 2–3 döngü boyunca 30–60 s boyunca homojenize etmek için kullanılır. |
| Termostatik hayvan platformu/küçük hayvanlar için ısıtmalı ameliyat masası | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Ekokardiyografi sırasında fareleri 37 °C'de tutmak için kullanılır; çalışma aralığı, oda sıcaklığından 50 °C'ye kadardır. |
Kaynaklar
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740