Bu protokol, anonimleştirilmiş lisans öğrencilerinin iyi oluş anket verilerinin ham dışa aktarımdan yanıt taramasına, ölçek puanlamasından güvenilirlik kontrolüne, regresyon tanılarına, şekil-kaynak doğrulamasına ve görselleştirmeye hazır analitik çıktılara kadar olan süreçlerini kapsayan yapılandırılmış ve denetlenebilir bir iş akışını göstermektedir.
Yöntem makalesi
Lisans Öğrencilerinin İyi Oluş Anket Verilerinin Taranması, Puanlanması ve Görselleştirilmesi İçin Yapılandırılmış Bir İş Akışı
Bu makalede
Özet
Özet
Anket tabanlı çalışmalar, öğrenci refahını incelemek için yaygın olarak kullanılmaktadır, ancak ham yanıtlardan analiz edilebilir değişkenlere, istatistiksel tablolara ve görsel çıktılara giden prosedürel yol genellikle yetersiz belgelenmektedir. Bu protokol, birden fazla Likert tipi ölçek bölümüyle toplanan anonimleştirilmiş lisans öğrencisi refah anketi verilerinin işlenmesi için yapılandırılmış ve denetlenebilir bir iş akışını göstermektedir. İş akışı; etik onay, onam belgeleri, anket yapılandırması ve ham veri dışa aktarımı ile başlar; ardından yanıt taraması, mükerrer yanıt incelemesi, eksik veri yönetimi, madde kodlama, ters puanlama, güvenilirlik değerlendirmesi, betimsel analiz, korelasyon analizi, karşılaştırmalı grup karşılaştırması, regresyon modelleme, tanısal kontroller ve görselleştirme kaynağı hazırlama aşamalarıyla devam eder. Örnek anket; Depression Anxiety Stress Scales-21, Tuckman Procrastination Scale, Psychological Sense of School Membership Scale, üst düzey düşünme ölçüm literatürü ve subjektif refah ölçeği belgelerinden yararlanan, kaynakları belgelenmiş ve çalışmaya uyarlanmış ölçek bölümleri kullanmaktadır. Madde düzeyindeki yanıtların nasıl izlenebilir analitik çıktılara dönüştürülebileceğini göstermek için örnek ölçek düzeyindeki değişkenler olarak negatif duygu, akademik erteleme, okul aidiyeti, üst düzey düşünme ve subjektif refah kullanılmıştır. Temsili çıktılar arasında bir tarama akış tablosu, demografik özet, betimsel ve aralık doğrulama istatistikleri, iç tutarlılık tahminleri, bir korelasyon matrisi, karşılaştırmalı karşılaştırma sonuçları, regresyon katsayıları, artık ve etki tanıları ile şekil kaynak dosyaları yer almaktadır. Protokol; önceden belirlenmiş karar kuralları, bağlantılı bir ölçek haritası, analiz öncesi tarama günlüğü, ters puanlama doğrulaması ve şekiller için sayısal kaynak doğrulamasını vurgulamaktadır. Yeni bir psikometrik ölçek önermek, bir ölçüm modelini doğrulamak veya nedensel ilişkiler kurmak yerine bu yöntem; anket tabanlı lisans öğrencisi refah verilerini taraması, puanlaması, analiz etmesi ve görselleştirmesi gereken araştırmacılar için pratik ve denetlenebilir bir prosedür sunmaktadır. İş akışı; ölçek haritası, etik onay, puanlama kuralları, yanıt tarama eşikleri ve görselleştirme kaynak dosyaları analizden önce tanımlandığında, benzer anket tabanlı çalışmalara uyarlanabilir.
Giriş
Sübjektif iyi oluş, öğrencilerin yaşamlarını, duygusal deneyimlerini, sosyal ilişkilerini ve öğrenme ortamlarındaki günlük işlevselliklerini nasıl değerlendirdiklerini yansıttığı için öğrenci araştırmalarında önemli bir sonuçtur. Yükseköğretimde öğrenci iyi oluşu, yalnızca yaşam doyumu veya psikolojik sıkıntı ile sınırlı kalmayıp çok boyutludur1. Bu nedenle, araştırmacıların aynı analitik çerçeve içinde duygusal, davranışsal, sosyal, bilişsel ve iyi oluşla ilgili deneyimleri incelemeleri gerektiğinde anket verileri yararlı olmaya devam etmektedir.
Anket verilerinin değeri, yalnızca seçilen yapılara değil, aynı zamanda ham yanıtların analitik değişkenlere nasıl dönüştürüldüğüne de bağlıdır. Birçok çalışma, ham kayıtları nihai tablo ve şekillere bağlayan ara kararları göstermeden ölçek puanlarını, korelasyon matrislerini, grup karşılaştırmalarını veya regresyon modellerini raporlamaktadır. Eksik yanıtlar tutarsız şekilde ele alınabilir, ters puanlanan maddeler yanlış kodlanabilir, mükerrer gönderimler veri setinde kalabilir ve dikkatsiz yanıtlar geçerli gözlemler olarak kabul edilebilir. Bu nedenle, eksik veri kararları görünmez bir post hoc adım olarak görülmek yerine planlanmalı, belgelenmeli ve raporlanmalıdır2. Çevrimiçi anket verileri ayrıca açık yanıt kalite kuralları gerektirir; çünkü hızlı yanıtlama, aynı seçeneği işaretleme (straight-lining), tutarsız cevaplar ve diğer düşük çaba kalıpları betimsel istatistikleri, güvenirlik tahminlerini ve gözlemlenen ilişkileri saptırabilir3.
Bu protokolün yeniliği, ham anket dışa aktarımı ile nihai istatistiksel ve görsel çıktılar arasında kurulan bağlantılı denetim izinde yatmaktadır. Spesifik olarak iş akışı; tamamlanmış bir ölçek haritası, analiz öncesi tarama günlüğü, ters puanlama kontrol noktası, puanlama doğrulama günlüğü, şekiller için sayısal kaynak doğrulaması ve her tabloyu veya şekli kaynak dosyasına bağlayan bir denetim izi ekler. Bu durum, yöntemi standart anket temizleme, ölçek puanlama, güvenirlik testi veya görselleştirme uygulamalarından ayırmaktadır. Protokol, sadece anket verilerinin temizlendiğini ve analiz edildiğini belirtmek yerine; hangi dosyanın kilitlendiğini, hangi dosyanın tarandığını, hangi kuralların uygulandığını, hangi ölçek puanlarının oluşturulduğunu ve her bir görsel çıktıyı oluşturmak için hangi doğrulanmış sayısal tablonun kullanıldığını açıkça tanımlar.
İş akışı; negatif duygu, akademik erteleme, okula aidiyet, üst düzey düşünme ve subjektif iyi oluş olmak üzere beş ölçek düzeyinde değişken içeren anonimleştirilmiş üniversite öğrencisi anket verileriyle gösterilmiştir. Bu yapılar; tek bir yapılandırılmış ve denetlenebilir iş akışı içerisinde duygusal, davranışsal, okul bağlamlı, bilişsel ve sonuç odaklı örnekler sunmak amacıyla seçilmiştir. Akademik erteleme, üniversite öğrencileri arasında depresyon, anksiyete ve stresle ilişkili sonuçlar da dahil olmak üzere daha sonraki ruh sağlığı güçlükleriyle ilişkilendirilmiştir4. Okula aidiyet ve subjektif iyi oluş da öğrenci popülasyonlarında birbiriyle yakından bağlantılıdır; bu durum, aidiyet ve iyi oluşla ilgili ölçümlerin aynı anket işleme çerçevesine dahil edilmesini desteklemektedir5. Ancak bu protokolde, söz konusu yapılar nedensel bir psikolojik model oluşturmaktan ziyade iş akışını göstermek için kullanılmıştır.
Protokolün temel bir özelliği, veri işleme kararlarının esasa yönelik yorumlamadan ayrılmasıdır. Ölçek haritası analizden önce hazırlanır, yanıt kalitesi kriterleri ölçek puanlamasından önce belirlenir, ters puanlama doğrulaması istatistiksel testlerden önce tamamlanır ve şekiller ancak sayısal kaynak tabloları kontrol edildikten sonra oluşturulur. Bu sıralama önemlidir çünkü Likert tipi yanıt ölçekleri; madde ifadeleri, yanıt çıpaları, puanlama yönü ve istatistiksel işlem arasında dikkatli bir uyum gerektirir6. Protokol ayrıca model karmaşıklığını, şeffaf ön işleme ve puanlama doğrulamasının arkasına önceliklendirir. Öngörülü veya çok değişkenli modeller öğrenci araştırmalarında yararlı olabilir7 ve grafiksel özetler, doğrulanmış sayısal matrislere bağlı kaldıkları sürece yorumlamayı geliştirebilir8; ancak her ikisi de girdi değişkenlerinin şeffaf bir şekilde hazırlanmasına bağlıdır. Bu nedenle iş akışı; korelasyon analizini, karşılaştırmalı grup kıyaslamasını, regresyon modellemesini, tanısal kontrolü ve görselleştirmeyi zorunlu esasa yönelik iddialardan ziyade örnek modüller olarak kullanır.
Bu protokol, anonimleştirilmiş öğrenci iyi oluş verileri için pratik bir anket işleme iş akışına ihtiyaç duyan araştırmacılara yöneliktir. Madde düzeyindeki anket yanıtlarının çevrimiçi bir platformdan dışa aktarıldığı, Likert tipi maddelerden ölçek düzeyinde değişkenlerin hesaplanması gerektiği ve amacın şeffaf betimsel, korelasyonel, grup karşılaştırmalı, regresyon, tanısal ve görselleştirmeye hazır çıktılar üretmek olduğu durumlar için uygundur. Nedensel ilişkiler kurmak, yeni ölçekleri geçerli kılmak, doğrulayıcı faktör analizinin yerini almak, ölçüm değişmezliği testlerinin yerini almak veya madde tepki veya gizil değişken modellemesinin yerine geçmek için tasarlanmamıştır. Katkısı prosedüreldir: anket kayıtlarından raporlanan tablo ve şekillere giden yolu görünür, tekrarlanabilir ve denetlenebilir kılar. Bu odak noktası; çevrimiçi anket veri kalitesi9, regresyon ve etki kontrolü10 ile denetlenebilir anket tabanlı analiz iş akışlarına11 ilişkin güncel endişelerle tutarlıdır.
Protokol
İnsan katılımcıların yer aldığı bu çalışma, Guizhou Açık Üniversitesi Havacılık Koleji Etik Kurulu tarafından incelenmiş ve onaylanmıştır (Onay No. GZOU-EDU-2024-015). Kurul, çalışmanın anonim ve gönüllü anket prosedürleri kullandığı ve katılımcılar için minimum riskin ötesinde bir risk oluşturmadığı için etik muafiyet kriterlerini karşıladığına karar vermiştir. Tüm katılımcılar, anketi doldurmadan önce elektronik ortamda bilgilendirilmiş onam vermişlerdir ve herhangi bir yaptırımla karşılaşmaksızın istedikleri zaman cevaplamayı bırakabilmişlerdir. Bazı maddeler olumsuz duygular, stres, yalnızlık, çaresizlik, memnuniyetsizlik veya bunlarla ilgili refah deneyimlerine değindiği için, onam sayfası ve final anket sayfası, rahatsızlık yaşayan katılımcılar için araştırmacının ve kurumun iletişim bilgilerini sağlamıştır. Bu protokolde kullanılan veri seti; tarama, puanlama, analiz ve görselleştirme öncesinde anonim hale getirilmiştir. Anketin tamamı Ek Dosya 1 olarak sunulmuştur.
1. Anketi, etik materyalleri ve iş akışı belgelerini hazırlayın
- Anket programlamadan önce uygun popülasyonu, çalışma ortamını, anket yapılarını ve planlanan analitik çıktıları tanımlayın.
- Hedef popülasyonu, katılım kanalını, anket içeriğini, tahmini tamamlama süresini, anonimlik korumasını, veri depolama yöntemini, çekilme prosedürünü, katılımcı destek bilgilerini ve planlanan analizleri kapsayan bir etik başvuru hazırlayın.
- Veri toplama işlemi başlamadan önce etik onay veya muafiyet belgesini, onam metnini, katılım çağrı metnini, anket versiyonunu, katılımcı destek bilgilerini ve planlanan iş akışını proje klasöründe saklayın.
- Hedef popülasyonu; en az 18 yaşında, şu anda yükseköğrenime kayıtlı, anketi anlayabilen ve bilgilendirilmiş onam verebilen tam zamanlı lisans öğrencileri olarak tanımlayın.
- Katılım süreci öncesinde dışlama kriterlerini belirleyin. Onamı reddeden, hedef popülasyon tanımına uymayan, mükerrer yanıtlar gönderen, eksik veri eşiğini aşan veya Adım 1.4'te açıklanan birleşik geçersiz yanıt kriterlerini karşılayan katılımcıları dışlayın.
- Bilgilendirilmiş onam beyanını anketin başına yerleştirin. Çalışmanın amacını, katılımın gönüllülük esasına dayandığını, yaklaşık 12 dk olan tamamlama süresini, anonimlik korumasını, çekilme hakkını, veri kullanım planını, araştırmacı iletişim bilgilerini ve destek iletişim bilgilerini belirtin.
- Öğrenci numaraları, T.C. kimlik numaraları, cep telefonu numaraları, kişisel e-posta adresleri, yurt adresleri veya diğer kişisel tanımlayıcılar dahil olmak üzere doğrudan tanımlanabilir bilgiler toplamayın.
- Anketi şu sırayla düzenleyin: bilgilendirilmiş onam, demografik bilgiler, negatif duygu maddeleri, akademik erteleme maddeleri, okul aidiyeti maddeleri, üst düzey düşünme maddeleri ve subjektif iyi oluş maddeleri.
- Anket programlamadan önce kaynak ölçüm araçlarını seçin. Bu protokolde negatif duygu 21 maddelik Depresyon Anksiyete Stres Ölçekleri-21, akademik erteleme 16 maddelik Tuckman Erteleme Ölçeği, okul aidiyeti 18 maddelik Psikolojik Okul Üyeliği Duygusu Ölçeği, üst düzey düşünme yayınlanmış üst düzey düşünme ölçüm literatüründen uyarlanan 20 maddelik bir üst düzey düşünme madde seti ve subjektif iyi oluş üniversite öğrencisi araştırmaları için geliştirilmiş 20 maddelik bir subjektif iyi oluş ölçeği kullanılarak değerlendirilmiştir12,13,14,15,16.
- Anket programlamadan önce kilitli bir ölçek haritası hazırlayın. Yapı adını, orijinal ölçek adını, orijinal atıfı, dil versiyonunu, izin veya yetkilendirme durumunu, çeviri veya uyarlama prosedürünü, madde kodunu, madde ifadesini, yanıt aralığını, yanıt seçeneklerini, puanlama yönünü, ters puanlanan madde durumunu, nihai ölçek düzeyindeki değişkeni ve puanlama kuralını ekleyin.
- Bir madde setini yalnızca kaynak araç, atıf, geçerlilik kanıtı ve uyarlama veya çeviri durumu belgelendiğinde valide edilmiş bir ölçek olarak tanımlayın. Yazar tarafından geliştirilen veya çalışmaya özgü olan tüm madde setlerini Tablo 1 ve Ek Dosya 1'de belirtin.
- Veri toplama işlemi başlamadan önce ölçüm çerçevesini sabitleyin. Çevrilmiş veya uyarlanmış araçlar için, katılımcı alımı başlamadan önce çeviri, inceleme, uzlaşma ve pilot kontrol işlemlerini tamamlayın.
- Kilitli anket dosyasını, ölçek haritasını, ham veri dışa aktarım kontrol listesini, tarama günlüğünü, puanlama doğrulama günlüğünü, analiz günlüğünü, şekil-kaynak tablo şablonunu ve analiz sözdizimi veya betik dosyasını içeren bir iş akışı denetim paketi hazırlayın.
- Tüm iş akışı çıktıları için versiyonlanmış dosya adları kullanın.
- Her denetim dosyası için gerekli sütunları tanımlayın.
- Tarama günlüğü; kayıt ID'sini, tarama kriterini, işaret durumunu, dışlama durumunu, dışlama nedenini, karar tarihini ve incelemeci baş harflerini içerir.
- Ölçek haritası; yapı adını, ölçek kaynağını, madde kodunu, madde ifadesini, yanıt aralığını, yanıt seçeneklerini, ters puanlama durumunu, nihai değişken adını, puanlama kuralını ve izin veya uyarlama durumunu içerir.
- Puanlama doğrulama günlüğü; madde kodunu, orijinal değer aralığını, yeniden kodlanmış değer aralığını, ters puanlama formülünü, aralık kontrol sonucunu, uyumsuzluk durumunu, yapılan düzeltmeyi ve düzeltme tarihini içerir.
- Şekil-kaynak tablosu; şekil numarasını, panel numarasını, kaynak tabloyu, çizilen değişkenleri, gösterilen istatistiği, örneklem büyüklüğünü ve doğrulama durumunu içerir.
- Anket programlamadan önce analitik iş akışını tanımlayın: anket uygulaması, ham veri dışa aktarımı, yanıt taraması, ölçek puanlama, güvenirlik değerlendirmesi, betimsel analiz, korelasyon analizi, yüksek-düşük grup karşılaştırması, regresyon modellemesi, tanısal kontroller ve görselleştirme hazırlığı17.
- Protokolü, yazılım menü yollarından ziyade kararlar, operasyonlar ve doğrulama çıktıları etrafında yapılandırın.
- Kurumsal ve dergi politikalarının izin verdiği durumlarda; anket dosyası, ölçek haritası, tarama günlüğü şablonu, puanlama günlüğü şablonu, analiz sözdizimi veya betik dosyası ve şekil-kaynak tabloları dahil olmak üzere iş akışı kaynaklarını sağlayın.
NOT: Şekil 1 anket hazırlama sürecinden ham veri dışa aktarımı, yanıt taraması, ölçek puanlama, istatistiksel analiz, tanısal kontroller ve görselleştirme çıktısına kadar olan yolu göstermektedir. Tablo 1 her bir yapı için kaynak aracı, madde sayısını, yanıt aralığını, puanlama çerçevesini, ters puanlama kuralını, izin veya uyarlama durumunu ve nihai ölçek düzeyindeki değişkeni raporlamaktadır.
2. Anketi yapılandırın ve dağıtın
- Anket platformunun onam onay mekanizmasını, zorunlu maddeleri, mükerrer gönderim incelemesini, zaman damgası yakalamayı ve yanıt süresi kaydını desteklediğini doğrulayın.
- Materyaller Tablosunda listelenen çevrimiçi anket platformunu kullanarak anketi oluşturun. Anketi, kesinleştirilmiş ölçek haritasına göre programlayın.
- Anket bağlantısını paylaşmadan önce, programlanan anketi kesinleştirilmiş ölçek haritasıyla madde madde karşılaştırın. Herhangi bir düzeltmeyi çalışma günlüğüne kaydedin.
- Bilgilendirilmiş onam maddesini ilk zorunlu madde olarak ayarlayın. Bir katılımcı “Katılmayı kabul etmiyorum” seçeneğini seçtiğinde anketi otomatik olarak durdurun.
- Demografik ve psikolojik ölçek bölümlerini Adım 1.8'de belirlenen sıraya göre programlayın. Ölçek haritasıyla eşleşen madde kodlarını kullanın.
- Psikolojik ölçek maddelerini, yalnızca etik onay veya muafiyet tarafından izin verildiğinde ve katılımcılar herhangi bir yaptırıma maruz kalmadan çekilebildiklerinde zorunlu olarak ayarlayın. Zorunlu yanıtlara izin verilmiyorsa, veri toplama öncesinde eksik veri kuralını kaydedin.
- Her ölçek bölümünden önce yanıt çıpalarını görüntüleyin ve çıpaları her ölçek içinde tutarlı tutun18.
- Anket platformu bu işlevi sağlıyorsa, tekrarlanan gönderimleri devre dışı bırakın. Mükerrer yanıt incelemesi için gereken anonim cihaz, tarayıcı, platform veya gönderim tanımlayıcılarını saklayın.
- Gönderim zamanının ve tamamlama süresinin otomatik olarak kaydedilmesini etkinleştirin.
- Anket açılış süresini 7 takvim günü olarak ayarlayın veya etik kurul tarafından onaylanan toplama penceresini kullanın.
- Anket bağlantısını onaylanmış kurumsal alım kanalı aracılığıyla gönderin. Tüm katılımcılara aynı yazılı talimatları sağlayın.
- Önceden belirlenen toplama penceresi sona erdikten sonra anketi kapatın.
NOT: Alım metnini, anket bağlantısını, açılış ve kapanış tarihlerini, platform ayarlarını, onam metnini, anketin final versiyonunu ve platform dışa aktarma ayarlarını çalışma günlüğünde saklayın.
3. Ham verileri dışa aktarma ve güvenli hale getirme
- Veri toplama penceresi kapandıktan hemen sonra tamamlanan anket yanıtlarını bir hesap tablosu dosyası olarak dışa aktarın.
- Dışa aktarılan ilk dosyayı kilitli ham veri seti olarak kaydedin. Bu dosyayı düzenlemeyin.
- Tarama, puanlama ve analiz için bir çalışma kopyası oluşturun. Dosyayı tarih, versiyon numarası ve proje tanımlayıcısı ile adlandırın.
- Dışa aktarılan dosyanın katılımcı başına bir satır ve her bir demografik değişken, anket maddesi, zaman damgası değişkeni, platform değişkeni veya türetilmiş platform alanı için bir sütun içerdiğini doğrulayın.
- Kilitli ham veri setini, çalışma kopyasını, ölçek haritasını, anket dosyasını, çalışma günlüğünü, tarama günlüğünü, puanlama doğrulama günlüğünü, analiz günlüğünü, şekil-kaynak tablolarını ve sözdizimi veya betik dosyasını şifre korumalı bir proje klasöründe saklayın.
- Veri setinin doğrudan tanımlanabilir bilgi içermediğini kontrol edin. Analizden önce çalışma kopyasındaki beklenmedik tüm tanımlayıcı alanları kaldırın ve alan adını, kaldırma nedenini, kaldırma tarihini ve sorumlu incelemeciyi çalışma günlüğüne kaydedin.
- Katılımcı düzeyindeki verileri paylaşmadan veya yayınlamadan önce dolaylı tanımlanabilirliği kontrol edin. Cinsiyet, yaş, sınıf düzeyi, kurum kategorisi ve akademik bölüm kategorisi kombinasyonları ile oluşturulan küçük demografik hücreleri gözden geçirin. Bir hücre beşten az katılımcı içeriyorsa, kategorileri birleştirin, hücreyi gizleyin veya yalnızca toplulaştırılmış veriler sağlayın.
- Katılımcı düzeyindeki verilerin mevcut olup olmadığı, etik veya gizlilik gereksinimleri nedeniyle kısıtlanıp kısıtlanmadığı veya toplulaştırılmış bir iş akışı veri seti ile değiştirilip değiştirilmediği dahil olmak üzere veri kullanılabilirlik durumunu çalışma günlüğüne kaydedin.
- Veri temizleme işleminden önce bir tarama günlüğü oluşturun. Ham örneklem boyutunu, tarama kriterini, işaretlenen kayıt sayısını, kaldırılan kayıt sayısını, tutulan kayıt sayısını, hariç tutma nedenini, karar tarihini ve incelemeci baş harflerini kaydedin.
- İstatistiksel analizden önce bir analiz izleme dosyası oluşturun. Yazılım adını, yazılım versiyonunu, işletim sistemini, dosya adlarını, veri versiyonunu, betik veya sözdizimi versiyonunu ve her bir analiz çalışmasının tarihini kaydedin.
NOT: Kilitli ham veri setini yalnızca doğrulama için kullanın. Tüm tarama, puanlama ve analiz işlemlerini çalışma kopyasını kullanarak gerçekleştirin.
4. Yanıtları tarama ve analitik veri setini oluşturma
- Herhangi bir ölçek düzeyi puanı hesaplamadan önce, önceden belirlenmiş dışlama ve kalite kontrol kurallarını uygulayın.
- Tarama kurallarını çalışma kopyasına şu sırayla uygulayın: onam durumu, uygunluk, mükerrer başvurular, eksik veriler, yanıt süresi, düz çizgi şeklinde yanıtlama, aralık dışı değerler ve birleşik yanıt kalitesi göstergeleri.
- Her tarama işleminden sonra; işaretlenen, çıkarılan ve tutulan kayıt sayısını tarama günlüğüne kaydedin. Çalışma dosyasının önceki sürümlerinin üzerine yazmayın.
- Bilgilendirilmiş onam maddesinin "Hayır" olarak işaretlendiği veya cevapsız bırakıldığı tüm kayıtları kaldırın.
- Adım 1.4'te tanımlanan dahil etme kriterlerini karşılamayan tüm kayıtları çıkarın.
- Anonim yanıt tanımlayıcıları, gönderim zamanı, platformun mükerrer gönderim işaretleri ve tekrarlanan yanıt örüntüleri kullanılarak mükerrer gönderimler için tarama yapın.
- Tekrarlanan girişler tespit edildiğinde, daha sonraki bir eksiksiz yanıtın tutulmasını destekleyen belgelenmiş bir neden olmadıkça, ilk eksiksiz gönderim muhafaza edilir.
- Ölçek puanlarını hesaplamadan önce tüm yanıt kalitesi kurallarını düzeltin. Tablo 2 iş akışında kullanılan dışlama eşiklerini, işaretleme eşiklerini, gerekçeleri, literatür desteğini ve hassasiyet analizi planını özetler.
- Eksik veriler açısından tarama yapın. Tüm ölçek maddelerinin %20'sinden fazlası eksik olduğunda ilgili katılımcıyı çıkarın. İzole bir eksik maddeyi, ancak o ölçeğin en az %80'i tamamlanmışsa, yalnızca aynı ölçek için katılımcının ortalama puanı ile değiştirin. Değişken herhangi bir analizde kullanılmadığı sürece demografik değişkenler için atama yapmayın.
- Ölçek maddelerinin %20'sinden fazlası eksik olduğu için hariç tutulan katılımcı sayısını ve ölçek içi ortalama imputasyon yöntemi uygulanan katılımcı sayısını kaydedin. Mevcut veri setinde, ölçek maddelerinin %20'sinden fazlası eksik olduğu için 4 katılımcı hariç tutulmuş ve 37 münferit eksik madde için 21 katılımcıya ölçek içi ortalama imputasyon uygulanmıştır.
- Yanıt süresini tarayın. 180 saniyenin altında tamamlanan yanıtları işaretleyin. Bu değeri otomatik bir hariç tutma kuralından ziyade, hızlanma (speeding) bayrağı olarak değerlendirin.
- Düz hat yanıtları için tarama yapın. Likert ölçekli maddelerin %90'ından fazlası için aynı seçenek seçildiğinde yanıtı işaretleyin. Bu değeri otomatik bir hariç tutma kuralı yerine bir yanıt örüntüsü bayrağı olarak değerlendirin.
- Mükerrer gönderim kanıtları, imkansız zaman damgaları, farklı gönderimler arasında tekrarlanan yanıt dizgileri veya platform meta verileri ile anket içeriği arasındaki çelişkiler dahil olmak üzere, düşük çaba göstergesini işaret eden ek unsurları tarayın.
- İşaretlenmiş bir yanıtı, yalnızca aşırı derecede kısa tamamlama süresiyle birleşen düz çizgide yanıtlama, mükerrer gönderim kanıtı veya imkansız platform meta verileri gibi, en az iki kalite kontrol göstergesi geçersiz yanıtlamaya işaret ettiğinde kaldırın.19.
- Tutuldukları durumlarda bile, işaretlenmiş tüm kayıtları kaydedin. Mevcut veri setinde, 19 yanıt tamamlama süresi nedeniyle işaretlenmiştir. < 180 s, 8 yanıt şunlar için işaretlendi: >%90 düz çizgi yanıtı verilmiş olup, iki veya daha fazla yanıt kalitesi göstergesini karşıladıkları için 13 kayıt hariç tutulmuştur.
- Aralık dışı değerler için tarama yapın. Negatif duygu maddelerinin 1–4, akademik erteleme, okul aidiyeti ve üst düzey düşünme maddelerinin 1–5 ve subjektif iyi oluş maddelerinin 1–6 aralığında olduğunu doğrulayın.
- Bir değeri yalnızca orijinal dışa aktarımda belirgin bir biçimlendirme hatası olduğunda düzeltin. Geçerli psikolojik puanları, olağandışı derecede yüksek veya düşük göründükleri için değiştirmeyin.
- Sunulan anketleri, onam ve uygunluk dışı kalma durumlarını, mükerrer kayıt dışı kalmaları, eksik veri nedeniyle dışarıda bırakılanları, yanıt kalitesi bayraklarını, birleştirilmiş kalite kontrol dışı kalmaları, münferit madde atamalarını, korunan analitik vakaları ve nihai analitik örneklem büyüklüğünü raporlayan bir tarama akış tablosu oluşturun.
- Kilitli tarama günlüğünü kullanarak tarama akış tablosunu tamamlayın ve tarama kararlarına ait dışa aktarılmış bir denetim kaydını saklayın. Mevcut veri setinde tarama akışı şu şekildeydi: gönderilen anketler, n = 448; onam veya uygunluk dışı bırakmalar, n = 6; mükerrer gönderimler çıkarılmıştır, n = 5; şu nedenlerle hariç tutulan kayıtlar: >ölçek maddelerinin %20'sinin eksik olması, n = 4; iki veya daha fazla yanıt kalitesi göstergesi nedeniyle hariç tutulan kayıtlar, n = 13; nihai analitik veri seti, n = 420.
- Tutulan kayıtları analitik veri seti olarak kaydedin. Yeni ve versiyonlanmış bir dosya adı kullanın ve tarama günlüğünü analitik veri seti ile birlikte saklayın.
NOT: Belgelenmiş bir yanıt kalitesi sorunu mevcut olmadığı sürece geçerli ekstrem puanları muhafaza edin.
5. Psikolojik ölçekleri puanlayın
- Madde düzeyindeki yanıtları, yalnızca yanıt taraması tamamlandıktan ve analitik veri seti kaydedildikten sonra ölçek düzeyindeki değişkenlere dönüştürün.
- Tüm Likert tipi maddeleri, kilitli anketteki yanıt çıpalarına ve ölçek haritasındaki puanlama kurallarına göre kodlayın.
- Orijinal madde değişkenlerini değiştirmeden saklayın. Yeniden kodlanan veya ters puanlanan maddeler için ayrı türetilmiş değişkenler oluşturun.
- Her bir ölçeği, kilitli ölçek haritasına ve ilgili kaynak araca veya puanlama kılavuzuna göre puanlayın.
- Sübjektif iyi oluş puanını hesaplamadan önce belirlenen sübjektif iyi oluş maddelerini ters puanlayın. 1–6 yanıt ölçeği için, her bir ters maddeyi 7 eksi orijinal puan olarak hesaplayın ve türetilmiş değişken adının sonuna _R ekleyin.
- Sübjektif iyi oluşu hesaplarken orijinal değişkenleri değil, ters puanlanmış değişkenleri kullanın.
- Her bir ölçek düzeyindeki puanı, dahil edilen maddelerinin ortalaması olarak hesaplayın: negatif duygu, akademik erteleme, okul aidiyeti, üst düzey düşünme ve sübjektif iyi oluş.
- Nihai ölçek düzeyindeki değişkenleri Negative emotion, Academic procrastination, School belongingness, Higher-order thinking ve Subjective well-being olarak adlandırın.
- Her bir ölçek düzeyi değişkeninin minimum ve maksimum değerini, teorik yanıt aralığına göre doğrulayın. Herhangi bir puan beklenen aralığın dışındaysa kodlamayı, ters puanlamayı ve kayıp veri yönetimini yeniden kontrol edin.
- Çıkarımsal analizden önce her bir ölçeğin yönünü ölçek haritasına göre doğrulayın. Yüksek puanlar, yapısal kavramın amaçlanan yönünü yansıtmalıdır.
- Analizden önce bir ters puanlama denetimi gerçekleştirin. Rastgele seçilmiş bir kayıt alt kümesi için veya mümkün olduğunda tüm ters puanlanmış maddeler için ters puanlanan maddeleri yeniden hesaplayın ve denetim sonucunu puanlama doğrulama günlüğüne kaydedin.
- Bir puanlama hatası tespit edilirse, türetilmiş değişkeni düzeltin, etkilenen ölçek puanını yeniden oluşturun, puanlama doğrulama günlüğünü güncelleyin ve düzeltilmiş analitik veri setine dayanarak tüm alt analizleri ve şekil-kaynak tablolarını yeniden çalıştırın.
NOT: Ters puanlama ve aralık doğrulamasını; korelasyon analizi, grup karşılaştırması, regresyon modellemesi veya görselleştirme öncesinde zorunlu kontrol noktaları olarak değerlendirin.
6. İç tutarlılığı ve betimleyici özellikleri değerlendirin
- Kilitli ölçek haritasında tanımlanan madde değişkenlerini kullanarak her bir ölçek için iç tutarlılığı, düzeltilmiş madde-toplam korelasyonlarını ve betimsel istatistikleri hesaplayın.
- Her bir ölçek için Cronbach alfa değerini, madde sayısını, geçerli örneklem büyüklüğünü, düzeltilmiş madde-toplam korelasyonlarını ve madde çıkarıldığında alfa değerlerini kaydedin.
- Bu iş akışı için minimum kabul edilebilir güvenirlik eşiği olarak 0,70 Cronbach alfa değerini kullanın. Herhangi bir maddeyi çıkarmadan önce, madde ifadesini, puanlama yönünü, ters puanlamayı, yapı uyumunu ve kaynak araç belgelerini20 kontrol edin.
- Analiz ortamı desteklediğinde, tamamlayıcı bir güvenirlik tahmini olarak McDonald omega değerini hesaplayın. İki tahmin farklı güvenirlik yorumlarına yol açtığında, omegayı Cronbach alfa ile birlikte raporlayın.
- Çıkarmayı düşünmeden önce, negatif veya çok düşük düzeltilmiş madde-toplam korelasyonuna sahip tüm maddeleri inceleyin. Bunu öncelikle olası bir kodlama, ters puanlama veya yapı uyumu sorunu olarak değerlendirin.
- Sadece Cronbach alfayı artırmak için bir maddeyi çıkarmayın. Madde çıkarma işlemi; puanlama kılavuzu, madde ifadesi, düzeltilmiş madde-toplam korelasyonu, kavramsal uyum ve belgelenmiş puanlama doğrulaması ile gerekçelendirilmelidir.
- Ortalama, standart sapma, minimum, maksimum, çarpıklık ve basıklık dahil olmak üzere beş ölçek düzeyindeki tüm değişkenler için betimsel istatistikleri hesaplayın.
- Her bir ölçek için minimum ve maksimum olası puanlardaki katılımcı oranını kaydederek taban veya tavan etkisini kontrol edin.
- Güvenirlik tahminlerini, madde-toplam tanılarını, betimsel istatistikleri ve tüm puanlama kararlarını analiz günlüğüne kaydedin.
NOT: Cronbach alfa, tam bir psikometrik doğrulama prosedürü olarak değil, bir güvenirlik kontrol noktası olarak kullanılır. Resmi ölçüm değerlendirmesi gerektiğinde, bu iş akışını McDonald omega, doğrulayıcı faktör analizi, ölçüm değişmezliği testi, madde tepki modellemesi veya diğer gizil değişken yöntemleri ile tamamlayın.
7. Korelasyon analizi gerçekleştirin
- Doğrulanmış beş ölçek düzeyi değişkenini kullanın: negatif duygu, akademik erteleme, okul aidiyeti, üst düzey düşünme ve öznel iyi oluş.
- Pearson korelasyonlarını hesaplamadan önce, her bir ölçek düzeyi değişken çifti için dağılımları ve iki değişkenli saçılım grafiklerini inceleyin.
- Değişkenlerin yaklaşık olarak sürekli skor varyasyonu, şiddetli çarpıklık, doğrusal olmayan ilişkiler veya etkili uç değer örüntüleri gösterip göstermediğini değerlendirin.
- Betimsel ilişki analizi için varsayımlar kabul edilebilir olduğunda, tüm ölçek düzeyi değişken çiftleri için Pearson korelasyon katsayılarını ve çift kuyruklu p-değerlerini hesaplayın.
- Her bir değişken çifti için korelasyon katsayısını, p-değerini, örneklem büyüklüğünü ve ilişkinin yönünü kaydedin.
- Korelasyon katsayılarını virgülden sonra üç basamak olacak şekilde raporlayın.
- Her bir katsayının yönünü ölçek haritası ile karşılaştırın. Eğer bir katsayı amaçlanan yapı yönüyle çelişiyorsa, madde puanlamasını yeniden kontrol edin.
- Doğrulanmış korelasyon matrisini, Temsili Sonuçlar bölümündeki korelasyon ısı haritası için sayısal kaynak tablo olarak kaydedin.
- Dağılımlar belirgin şekilde çarpık olduğunda, sıralı ölçek hassasiyeti gerektiğinde veya saçılım grafikleri monoton ancak doğrusal olmayan ilişkilere işaret ettiğinde, analizi Spearman korelasyonu kullanarak tekrarlayın ve ilişkilerin yönünü ve göreceli büyüklüğünü karşılaştırın.
- Pearson ve Spearman sonuçlarının aynı temel yoruma yol açıp açmadığını kaydedin.
NOT: Korelasyon analizini hem betimsel bir ilişki kontrolü hem de bir puanlama yönü denetimi olarak kullanın.
8. Yüksek ve düşük subjektif iyi oluş gruplarının oluşturulması
- Temizlenmiş ve puanlanmış analitik veri setini kullanın. Grup oluşturma işlemi için ham dışa aktarılan verilere geri dönmeyin.
- Regresyon modellemesi için birincil çıktı olarak sürekli subjektif iyi oluş puanını kullanın. Yüksek-düşük gruplandırmasını yalnızca karşılaştırmalı profil analizi için kullanın.
- Katılımcıları subjektif iyi oluş puanlarına göre en yüksekten en düşüğe doğru sıralayın.
- Yüksek ve düşük subjektif iyi oluş gruplarını tanımlamak için önceden belirlenmiş %27'lik uç grup kuralını uygulayın. Bu eşik değerin gerekçesini Tablo 2'de ve analiz günlüğünde belgeleyin.
- En üstteki %27'lik dilimdeki katılımcıları yüksek subjektif iyi oluş grubuna, en alttaki %27'lik dilimdeki katılımcıları ise düşük subjektif iyi oluş grubuna atayın.
- Ortadaki %46'lık dilimi tanımlayıcı istatistikler, korelasyon analizi, cinsiyet karşılaştırması ve regresyon modellemesi için tam analitik veri setinde tutun, ancak bu vakaları yüksek-düşük karşılaştırmasının dışında bırakın.
- Subjektif iyi oluş grubu adında bir gruplandırma değişkeni oluşturun. Üst grubu Yüksek, alt grubu Düşük ve geri kalan katılımcıları Orta olarak kodlayın.
- Yüksek ve düşük grupların hedeflenen sayıda vaka içerdiğini doğrulayın. %27 sınırında eşit puanlar oluşursa, önceden belirlenmiş eşitlik giderme kuralını uygulayın ve kararı analiz günlüğüne kaydedin.
- Eşit puanlar veya küçük örneklem boyutu nedeniyle %27 sınırının istikrarsız grup üyeliği oluşturduğu durumlarda bir duyarlılık kontrolü gerçekleştirin. Tertil gruplandırma gibi önceden belirlenmiş alternatif bir kural kullanın ve yorumlamanın değişip değişmediğini raporlayın.
NOT: Yüksek-düşük gruplandırması tanımlayıcı bir karşılaştırma prosedürüdür. Birincil regresyon modelindeki sürekli subjektif iyi oluş puanının yerini almamalıdır.
9. Yüksek ve düşük sübjektif iyi oluş gruplarını karşılaştırın
- Analitik veri setini, sübjektif iyi oluş gruplandırma değişkeninde yalnızca Yüksek veya Düşük olarak kodlanan katılımcıları tutacak şekilde filtreleyin.
- Yüksek ve düşük grupları negatif duygu, akademik erteleme, okul aidiyeti ve üst düzey düşünme açısından karşılaştırın.
- Grup karşılaştırmasından önce, her bir değişken için gruba özgü dağılımları, örneklem boyutlarını ve varyans eşitliğini inceleyin.
- Dağılım ve varyans varsayımları kabul edilebilir olduğunda bağımsız örneklemler t-testi kullanın. Varyans eşitliği varsayımı desteklenmediğinde Welch t-testi kullanın.
- Grup ortalamalarını, standart sapmaları, ortalama farklarını, t-değerlerini, serbestlik derecelerini, p-değerlerini ve %95 güven aralıklarını kaydedin.
- Her bir grup farkı için Cohen’s d değerini hesaplayın ve etki büyüklüğünü p-değeri ile birlikte yorumlayın.
- Her bir grup farkının yönünün, yapı tanımlarıyla ve korelasyon matrisiyle tutarlı olup olmadığını inceleyin.
- Doğrulanmış grup karşılaştırma tablosunu, herhangi bir grup karşılaştırma görselleştirmesi için sayısal kaynak olarak kaydedin.
- Bu analizi, uç sübjektif iyi oluş profilleri arasındaki bir karşıtlık olarak raporlayın.
NOT: Yüksek-düşük karşılaştırmasını nedensel bir kanıt olarak yorumlamayın.
10. Cinsiyet farklılıklarını inceleyin
- Yüksek-düşük grup filtresini kaldırın ve tam analitik veri setine geri dönün.
- Cinsiyeti nedensel bir maruziyetten ziyade betimleyici bir gruplandırma değişkeni olarak kullanın.
- Kadın ve erkek katılımcıları negatif duygu, akademik erteleme, okul aidiyeti, üst düzey düşünme ve subjektif iyi oluş değişkenleri açısından karşılaştırın.
- Karşılaştırmadan önce gruba özgü örneklem büyüklüklerini, eksik verileri, dağılımları ve varyans eşitliğini inceleyin.
- Varsayımlar uygun olduğunda bağımsız örneklemler t-testi kullanın. Varyans eşitliği varsayımı desteklenmediğinde Welch t-testi kullanın.
- Grup ortalamalarını, standart sapmaları, ortalama farklarını, t-değerlerini, serbestlik derecelerini, p-değerlerini, %95 güven aralıklarını ve Cohen’s d değerlerini kaydedin.
- Cinsiyet farklılıklarını betimleyici olarak yorumlayın ve etki büyüklüklerini p-değerleri ile birlikte raporlayın.
- Cinsiyet karşılaştırma sonuçlarını post hoc dışlamayı, ölçek modifikasyonunu veya nedensel yorumlamayı gerekçelendirmek için kullanmayın.
NOT: Cinsiyet karşılaştırmaları, bu kesitsel anket iş akışı dahilinde betimleyici alt grup kontrolleri olarak eklenmiştir.
11. Regresyon modelini tahmin edin
- Bağımlı değişken olarak sübjektif iyi oluşu kullanın.
- Negatif duygu, akademik erteleme, okula aidiyet ve üst düzey düşünmeyi eş zamanlı ölçek düzeyinde yordayıcılar olarak kullanın21.
- Ölçek puanlaması sırasında oluşturulan sürekli ölçek düzeyindeki değişkenleri kullanın. Sürekli sübjektif iyi oluş puanını yüksek-düşük gruplandırma değişkeni ile değiştirmeyin.
- Birincil modeli eş zamanlı girişli çoklu doğrusal regresyon kullanarak kurun.
- Standartlaştırılmamış katsayıları, standartlaştırılmış katsayıları, standart hataları, t-değerlerini, p-değerlerini, %95 güven aralıklarını, R2, düzeltilmiş R2, tolerans ve varyans şişirme faktörünü kaydedin.
- Şiddetli çoklu doğrusal bağlantının yokluğu için eşik değer olarak 5,00'in altındaki varyans şişirme faktörü değerlerini kullanın.
- Yordayıcılar ile sübjektif iyi oluş arasındaki ilişkilerin yaklaşık olarak doğrusal olup olmadığını değerlendirmek için iki değişkenli saçılım grafiklerini, kısmi regresyon grafiklerini veya bileşen-artık grafiklerini inceleyin.
- Durbin-Watson istatistiğini kullanarak artıkların bağımsızlığını değerlendirin.
- Örneklem boyutu için uygun olduğunda, bir artık Q-Q grafiği ve resmi bir normallik testi kullanarak artıkların normalliğini değerlendirin.
- Standartlaştırılmış artıkların standartlaştırılmış tahmin edilen değerlere karşı grafiğini kullanarak homoskedastisiteyi değerlendirin.
- Tanısal kontrol için standartlaştırılmış artıklar, standartlaştırılmış tahmin edilen değerler, kaldıraç değerleri ve Cook uzaklığını kaydedin.
- Dört psikolojik yordayıcı ile örneklem açıklamasında bildirilen cinsiyet, yaş, sınıf düzeyi, kurum kategorisi ve akademik bölüm kategorisi dahil olmak üzere demografik değişkenlerin mevcut ve yeterli şekilde dağıldığı durumlarda, bunları içeren ek bir düzeltilmiş model tahmin edin.
- Birincil modeli ek düzeltilmiş model ile karşılaştırın. Dört psikolojik yordayıcının yönünün, büyüklüğünün ve istatistiksel yorumunun demografik düzeltme sonrası sabit kalıp kalmadığını kaydedin.
- Birincil modelden elde edilen doğrulanmış standartlaştırılmış katsayıları ve %95 güven aralıklarını, Temsili Sonuçlar bölümündeki katsayı grafiği için sayısal kaynak tablo olarak kaydedin22.
NOT: Regresyon katsayılarını nedensel etkiler olarak değil, koşullu ilişkiler olarak yorumlayın. Demografik olarak düzeltilmiş model, mevcut arka plan değişkenleri hesaba katıldıktan sonra iş akışı sonuçlarının sabit kalıp kalmadığını değerlendirmek için bir duyarlılık analizinde kullanılır.
12. Regresyon modelinin tanısını koyun
- Uydurulmuş regresyon modelinden elde edilen standartlaştırılmış artıkların incelenmesi. Mutlak standartlaştırılmış artık değeri 3,00'den büyük olan vakalar işaretlenir.
- Etkili gözlemler için kaldıraç değerleri ve Cook uzaklığının incelenmesi.
- Analitik örneklem büyüklüğünün n olduğu durumda, Cook uzaklığı 4/n'den büyük olan gözlemler potansiyel etkili vakalar olarak işaretlenir. 1,00'den büyük Cook uzaklığı, tek tarama sınırı olmaktan ziyade ciddi etki referans eşiği olarak kabul edilir.
- Doğrusalsızlık, eşitsiz varyans ve olağandışı kümelenme açısından artık-tahmin grafiğinin incelenmesi.
- Artık Q-Q grafiğinin ve artık normallik testi sonucunun incelenmesi. Normallik değerlendirmesinin, tanımlayıcı ilişki analizi için doğrusal model kullanımını destekleyip desteklemediği kaydedilir.
- Durbin-Watson istatistiğinin kaydedilmesi ve artık bağımsızlığının kabul edilebilir olup olmadığının belirlenmesi.
- İşaretlenen tüm vakaların tarama günlüğü, puanlama doğrulama günlüğü ve uygunluk kriterlerine göre gözden geçirilmesi.
- İşaretlenen vakalar, geçerli gözlemleri temsil ettikleri ve veri giriş hatalarını, puanlama hatalarını, mükerrer gönderimleri, uygunluk ihlallerini veya belgelenmiş yanıt kalitesi sorunlarını yansıtmadıkları sürece veri setinde tutulur.
- İşaretlenmiş bir vaka, ancak denetim izi belgelenmiş bir prosedürel, uygunluk, kodlama, puanlama veya veri giriş hatası tespit ettiğinde düzeltilir veya kaldırılır.
- Herhangi bir belgelenmiş düzeltmeden sonra regresyon modelinin yeniden çalıştırılması; katsayıların, güven aralıklarının, R2 değerinin, düzeltilmiş R2 değerinin ve tanısal çıktıların orijinal modelle karşılaştırılması.
- Cook uzaklığı 4/n'den büyük olan vakalar hariç tutularak modelin yeniden uydurulmasıyla bir etki duyarlılık kontrolü yapılması. Esas yorumlamanın değişip değişmediğinin raporlanması.
- Standartlaştırılmış artıklarla işaretlenen vaka sayısı, Cook uzaklığı 4/n'den büyük olduğu için işaretlenen vaka sayısı, maksimum Cook uzaklığı, Durbin-Watson istatistiği ve artık normallik ile doğrusallık kontrollerinden çıkan sonuç dahil olmak üzere nihai tanısal kararın analiz günlüğüne kaydedilmesi.
NOT: Sadece model uyumunu artırmak amacıyla etkili vakalar kaldırılmamalıdır. Kaldırma veya düzeltme işlemi, belgelenmiş bir denetim izi nedenine dayanmalıdır.
Sonuçlar
Yanıt taraması sonrası oluşturulan analitik veri seti
Yanıt tarama iş akışı, sunulan 448 anketten 420 anonimleştirilmiş öğrenci kaydından oluşan bir analitik veri seti oluşturmuştur. Tarama günlüğü her bir karar noktasını kaydetmiştir. Onam veya uygunluk gereksinimleri karşılanmadığı için altı kayıt çıkarılmış, beş mükerrer gönderim kaldırılmış, ölçek maddelerinin %20'den fazlasının eksik olması nedeniyle dört kayıt hariç tutulmuş ve iki veya daha fazla yanıt kalitesi göstergesini karşıladıkları için 13 kayıt dışlanmıştır. On dokuz yanıt <180 s tamamlama süresi nedeniyle, sekiz yanıt >'>%90 düz çizgi yanıtlaması nedeniyle işaretlenmiş ve 21 katılımcı için 37 izole eksik maddeye ölçek içi ortalama ataması yapılmıştır. Nihai analitik veri seti doğrudan tanımlanabilir katılımcı bilgisi içermemekte, tutulan hiçbir vaka eksik veri dışlama eşiğini aşmamakta ve tutulan tüm madde yanıtları önceden tanımlanmış yanıt aralıklarında yer almaktadır. Tarama akışı Tablo 3'te özetlenmiştir.
Elde tutulan örneklem, analitik veri setinin sırasıyla %65,5'ini ve %34,5'ini oluşturan 275 kadın ve 145 erkek katılımcıdan oluşmuştur. Ortalama yaş 20,1 ± 1,2 yıldı. Katılımcılar dört lisans yılı düzeyine dağılmış olup; 1. Yıl ile 4. Yıl arası sırasıyla örneklemin %27,1, %27,4, %25,5 ve %20,0'sini oluşturmuştur. Veri seti ayrıca üç kurumsal kategori ve beş akademik ana dal kategorisi içermiştir. Kategori incelemesi sonrası, yayınlanan hiçbir demografik hücre beşten az katılımcı içermemiştir. Analitik veri setinin demografik özellikleri Tablo 4'te özetlenmiştir.
Ölçek oluşturma, aralık doğrulama ve suboptimal iş akışı örnekleri
Madde kodlaması ve ters puanlama işlemlerinin ardından beş ölçek düzeyinde değişken hesaplanmıştır: negatif duygu, akademik erteleme, okul aidiyeti, üst düzey düşünme ve subjektif iyi oluş. Her bir puan, teorik yanıt aralığı içerisinde kalmıştır. Negatif duygu puanları 1-4 ölçeğinde 1.048 ile 3.143 arasında değişmiştir. Akademik erteleme, okul aidiyeti ve üst düzey düşünme puanları, ilgili 1–5 ölçeklerinde sırasıyla 1.312 ile 4.250, 2.333 ile 4.444 ve 2.350 ile 4.850 arasında değişmiştir. Subjektif iyi oluş puanları ise 1–6 ölçeğinde 2.000 ile 5.300 arasında değişmiştir. Ters puanlama doğrulaması, türetilen ters puanlanmış değişkenler ile nihai analitik veri setindeki sabit puanlama kuralı arasında herhangi bir tutarsızlık saptamamıştır. Bu kontroller; madde kodlamasının, ters puanlamanın, eksik madde yönetiminin ve puan toplama işlemlerinin tespit edilebilir aralık hataları olmaksızın tamamlandığını onaylamıştır.
İş akışı ayrıca, hataların veya şüpheli çıktıların nihai analizden önce nasıl tespit edildiğini gösteren optimal olmayan denetim örnekleri de oluşturmuştur. Bir denetim yürütmesi sırasında, puanlama doğrulama günlüğü; orijinal değeri, beklenen "ters puan = 7-orijinal puan" formülünü, türetilmiş değeri ve nihai ölçek aralığını karşılaştırdığı için yanlış türetilmiş bir subjektif iyi oluş ters puanlanmış değeri tespit edilmiştir. Türetilmiş değişken düzeltilmiş, subjektif iyi oluş puanı yeniden oluşturulmuş ve tüm alt süreçlardaki betimsel, korelasyon, karşılaştırma, regresyon, tanısal ve şekil-kaynak çıktıları yeniden çalıştırılmıştır. Bir başka ara çalışma dosyasında, aralık doğrulama sırasında aralık dışı bir madde değeri belirlenmiş ve bunun kilitli ham dışa aktarımdan ziyade hesap tablosu işlemlemesinden kaynaklandığı saptanmıştır. Çalışma kopyası, herhangi bir geçerli uç yanıtı değiştirmeden düzeltilmiş ve belgelenmiştir. Bir maddenin aynı ölçekteki diğer maddelere göre daha düşük bir düzeltilmiş madde-toplam korelasyonu göstermesi durumunda bir güvenilirlik uyarısı da gözden geçirilmiştir; maddenin ifade biçimi, puan yönü ve yapı hizalaması doğru olduğu için madde tutulmuştur. Bir şeklin, doğrulanmış sayısal kaynak tablosuyla eşleşmediği durumlarda bir taslak görselleştirme uyumsuzluğu belirlenmiştir; şekil, doğrulanmış tablodan yeniden oluşturulmuş ve şekil-kaynak kaydı güncellenmiştir. Bu örnekler, iş akışının yalnızca başarılı çıktılar üretmekle kalmayıp aynı zamanda denetim izi aracılığıyla kodlama hatalarını, aralık sorunlarını, güvenilirlik uyarılarını, şekil-kaynak uyumsuzluklarını ve yanıt kalitesi endişelerini de tespit ettiğini göstermektedir.
Betimleyici özellikler ve iç tutarlılık
Beş ölçek seviyesindeki değişken kullanılabilir varyasyon göstermiştir. Ortalama negatif duygu puanı 2,099 ± 0,391 ve ortalama akademik erteleme puanı 2,639 ± 0,484 olarak belirlenmiştir. Okul aidiyeti ve üst düzey düşünme, sırasıyla 3,343 ± 0,390 ve 3,627 ± 0,418 ile orta-yüksek ortalama değerler göstermiştir. Ortalama subjektif iyi oluş puanı 3,784 ± 0,543'tür. Hiçbir ölçekte belirgin bir taban veya tavan etkisi gözlenmemiş ve her ölçek için teorik minimum veya maksimum değerdeki katılımcı oranı %2,0'nin altında kalmıştır.
Beş ölçeğin tamamı için iç tutarlılık kabul edilebilir düzeydeydi. Cronbach alfa değerleri 0,834 ile 0,899 arasında değişerek önceden belirlenen 0,70 eşiğini aşmıştır. En yüksek iç tutarlılık 0,899 Cronbach alfa değeri ile negatif duygularda, bunu 0,895 ile subjektif iyi oluş takip etmiştir. McDonald omega değerleri 0,842 ile 0,906 arasında değişmiş ve omega tahminleri güvenilirlik yorumunu değiştirmemiştir. Düzeltilmiş madde-toplam korelasyon incelemesi, çıkarılması gereken herhangi bir madde tespit etmemiştir. Betimsel istatistikler ve güvenilirlik tahminleri Tablo 5'te sunulmuştur.
Ölçek düzeyi değişkenler arasındaki korelasyon yapısı
Korelasyon matrisi, bir betimsel ilişki ölçüsü ve puanlama yönü kontrolü olarak kullanılmıştır. Pearson korelasyonları hesaplanmadan önce, ölçek dağılımları ve iki değişkenli saçılım grafikleri incelenmiştir. Hiçbir değişkende ciddi çarpıklık veya basıklık gözlenmemiş ve hiçbir iki değişkenli grafikte, betimsel Pearson korelasyon analizini geçersiz kılacak güçlü bir doğrusal olmayan örüntüye rastlanmamıştır. Öznel iyi oluş; negatif duygu (r = -0,496) ve akademik erteleme (r = -0,294) ile negatif yönde; okul aidiyeti (r = 0,481) ve üst düzey düşünme (r = 0,386) ile pozitif yönde korelasyon göstermiştir. Kalan ilişkiler de aynı puanlama mantığını izlemiştir: negatif duygu, akademik erteleme (r = 0,270) ile pozitif yönde; okul aidiyeti (r = -0,346) ve üst düzey düşünme (r =-0,205) ile negatif yönde ilişkilidir; akademik erteleme, okul aidiyeti (r = -0,222) ve üst düzey düşünme (r = -0,134) ile negatif yönde ilişkilidir ve okul aidiyeti, üst düzey düşünme (r = 0,310) ile pozitif yönde ilişkilidir. Eksiksiz Pearson korelasyon matrisi Tablo 6'da sunulmuştur.
Spearman duyarlılık kontrolü, tüm değişken çiftleri için aynı yönlü yorum sonucunu vermiştir. Öznel iyi oluş ile dört yordayıcı arasındaki Spearman korelasyonları; negatif duygu için ρ = -0,502, akademik erteleme için ρ = -0,301, okul aidiyeti için ρ = 0,477 ve üst düzey düşünme için ρ = 0,392 olarak bulunmuştur. Doğrulanmış Pearson matrisi, görselleştirme için sayısal kaynak tablo olarak kullanılmıştır. Şekil 2A, beş ölçek düzeyindeki değişkenin tamamını kapsayan korelasyon ısı haritasını sunmaktadır. Şekil 2B, öznel iyi oluş ile olan dört korelasyonu göstermektedir.
Yüksek ve düşük subjektif iyi oluş grupları kullanılarak yapılan karşılaştırmalı gösterim
%27 gruplandırma kuralı, gerçek dünyadaki iyi oluş profillerinin esaslı bir sınıflandırmasından ziyade, karşılaştırmalı bir iş akışı gösterimi olarak kullanılmıştır. Bu kural, eşit büyüklükte iki grup oluşturmuştur: yüksek subjektif iyi oluş grubunda 113 katılımcı ve düşük subjektif iyi oluş grubunda 113 katılımcı. Ortadaki 194 katılımcı tam analitik veri setinde tutulmuş ancak bu karşılaştırmalı analizden hariç edilmiştir. Hiçbir sınır bağı grup atamasını değiştirmemiştir.
Bu modül, iş akışının önceden belirlenmiş bir gruplandırma değişkeni oluşturabildiğini, analitik veri setini filtreleyebildiğini, gruba özel tanımlayıcı istatistikleri hesaplayabildiğini, varsayımlara uygun grup karşılaştırmaları yapabildiğini ve görselleştirme için doğrulanmış bir kaynak tablo dışa aktarabildiğini göstermiştir. Yüksek subjektif iyi oluş grubu, düşük subjektif iyi oluş grubuna göre daha düşük negatif duygu (1.864 ± 0.358'e karşı 2.335 ± 0.343; ortalama fark = -0.472) ve daha düşük akademik erteleme (2.455 ± 0.476'ya karşı 2.801 ± 0.483; ortalama fark = -0.346) sergilemiştir. Okula aidiyet ve üst düzey düşünme, yüksek subjektif iyi oluş grubunda sırasıyla 0.454 ve 0.351 ortalama farklarla daha yüksek bulunmuştur. Dört karşılaştırmanın tamamı anlamlıdır (p < 0.001); Cohen’s d değerleri negatif duygu için -1.346, akademik erteleme için -0.722, okula aidiyet için 1.279 ve üst düzey düşünme için 0.860 olarak gerçekleşmiştir. Varyansların eşitliği varsayımı desteklenmediğinde Welch’s t-testi kullanılmış; aksi takdirde standart bağımsız örneklemler t-testi tercih edilmiştir. Gruplar sonuç değişkeninden oluşturulup daha sonra ilişkili değişkenler üzerinden karşılaştırıldığı için, bu çıktılar seçilen yordayıcıların gerçek dünyadaki öğrenci iyi oluş profillerini tanımladığına dair bir kanıt olarak yorumlanmamalıdır. Yüksek-düşük grup karşılaştırması Tablo 7'de özetlenmiştir.
Cinsiyete göre tanımlayıcı karşılaştırma
Cinsiyet, tanımlayıcı bir gruplandırma değişkeni olarak incelenmiştir. Kadın katılımcılar, erkek katılımcılara göre biraz daha yüksek bir ortalama negatif duygu puanı göstermiştir (2.129 ± 0.380'e karşı 2.042 ± 0.407). Bu fark istatistiksel olarak anlamlıdır ancak büyüklüğü küçüktür (p = 0.033; Cohen’s d = 0.224). Akademik erteleme, okul aidiyeti, üst düzey düşünme ve subjektif iyi oluşta cinsiyete dayalı anlamlı farklar görülmemiştir. Subjektif iyi oluş ortalamaları kadın ve erkek katılımcılar arasında neredeyse aynıdır (3.781 ± 0.521'e karşı 3.789 ± 0.583; p = 0.887; Cohen’s d = -0.015). Welch t-testi duyarlılık kontrolleri, cinsiyet karşılaştırma sonuçlarının yorumunu değiştirmemiştir. Cinsiyet farkı sonuçları Tablo 8'de sunulmuştur.
Model oluşturma ve tanısal kontrol örneği olarak regresyon modeli
Çoklu doğrusal regresyon modeli; puanlanmış anket verilerinden bir model oluşturma, tanı koyma ve doğrulama örneği olarak kullanılmıştır. Bağımlı değişken olarak subjektif iyi oluş girilmiş; negatif duygu, akademik erteleme, okul aidiyeti ve üst düzey düşünme ise ölçek düzeyindeki tahmin ediciler olarak eş zamanlı olarak girilmiştir. Bu modülün amacı; katsayı çıkarımı, çoklu doğrusal bağlantı kontrolleri, artık tanıları, etki değerlendirmesi, demografik olarak düzeltilmiş hassasiyet analizi ile şekil ve kaynak hazırlığını göstermektir.
Model, subjektif iyi oluştaki varyansın orta düzeyde bir kısmını açıklamıştır (R2 = 0.411 ve düzeltilmiş R2 = 0.406). Negatif duygu, en büyük negatif standardize edilmiş katsayıyı göstermiştir (B = -0.450, standardize edilmiş β = -0.324). Akademik erteleme de negatif bir katsayı sergilemiştir (B = -0.130, standardize edilmiş β = -0.116). Okula aidiyet ve üst düzey düşünme, sırasıyla β = 0.275 ve β = 0.218 şeklinde pozitif standardize edilmiş katsayılar göstermiştir. Uygun hale getirilen modelde dört öngörücünün tamamı istatistiksel olarak anlamlıdır: negatif duygu, okula aidiyet ve üst düzey düşünme p < 0.001; akademik erteleme ise p = 0.004 düzeyindedir. Tüm varyans şişirme faktörü değerleri 1.24'ün altında olduğu için çoklu doğrusal bağlantı (multikolinearite) görülmemiştir. Bu regresyon çıktıları, öğrenci iyi oluşunun kesin bir psikolojik açıklaması değil, temsilci model kontrol çıktılarıdır. Tablo 9 tam regresyon çıktısını sunmaktadır.
Dört psikolojik öngörücüye cinsiyet, yaş, sınıf düzeyi, kurum kategorisi ve akademik bölüm kategorisi eklenerek tamamlayıcı bir demografik düzeltmeli model tahmin edilmiştir. Düzeltilmiş model, R2 = 0,427 ve düzeltilmiş R2 = 0,414 ile benzer bir varyans oranını açıklamıştır. Dört psikolojik öngörücünün yönü ve istatistiksel yorumu, demografik düzeltmeden sonra değişmeden kalmıştır. Demografik düzeltmeli duyarlılık modeli Tablo 10'da özetlenmiştir. Şekil 3A, dört öngörücü için standardize edilmiş katsayıları ve %95 güven aralıklarını göstermektedir. Şekil 3B ise standardize edilmiş öngörü değerleri, standardize edilmiş artıklar ve Cook uzaklığına dayalı tanısal gösterimi sunmaktadır.
Regresyon tanıları ve modelin korunması
Regresyon tanıları, uydurulan modelin tek bir etkili kayıt tarafından yönlendirildiğini göstermemiştir. İki değişkenli ve kısmi regresyon grafikleri güçlü bir doğrusal olmama durumu sergilememiştir. Artık-tahmin grafiği ciddi bir heteroskedastisite veya olağan dışı kümelenme göstermemiştir. Durbin-Watson istatistiği 1.93 olarak bulunmuş ve kabul edilebilir artık bağımsızlığını desteklemiştir. Artık Q-Q grafiği, normallikten ciddi bir sapma göstermemiştir. Resmi artık normallik testi istatistiksel olarak anlamlıydı, W = 0.992, p = 0.031, ancak Q-Q grafiği ve örneklem boyutu, tanımlayıcı ilişki analizi için doğrusal modelin korunmasını desteklemiştir.
İki kaydın mutlak standartlaştırılmış artık değerleri 3,00'den büyüktü. Hiçbir kaydın Cook uzaklığı 1,00'den büyük değildi. n = 420 ve 4/n = 0,0095 olduğu durumda, Cook uzaklığı >4/n şeklindeki daha hassas eşik kullanılarak 17 kayıt potansiyel olarak etkili olarak işaretlendi. En büyük Cook uzaklığı 0,037 idi. İşaretlenen artık ve etki vakaları; tarama günlüğü, puanlama doğrulama günlüğü ve uygunluk kriterlerine göre incelendi. Hiçbirinde veri giriş hataları, yanlış puanlama, mükerrer yanıtlar, uygunluk hataları veya belgelenmiş yanıt kalitesi sorunlarına dair bir kanıt görülmedi; bu nedenle, bu vakalar final modelde tutuldu. Cook uzaklığı >4/n olan vakalar hariç tutularak yapılan bir etki hassasiyet kontrolü, birincil modelle aynı iş akışı yorumunu verdi. Standartlaştırılmış katsayılardaki maksimum mutlak değişim 0,026 idi ve düzeltilmiş R2 değeri 0,406'dan 0,405'e değişti. Tanısal ve hassasiyet sonuçları Tablo 11'de özetlenmiştir.
Analitik boru hattı dahili doğrulaması
İş akışı, temizlenmiş ve puanlanmış analitik veri setinden başlayarak aynı puanlama kuralları, karar eşikleri ve analiz izleme dosyası kullanılarak tekrarlandı. Dahili tutarlılık analizi, tanımlayıcı istatistikler, korelasyon analizi, yüksek-düşük grup karşılaştırmaları, cinsiyet karşılaştırmaları, regresyon modellemesi, tanısal kontroller ve görselleştirme kaynağı hazırlığı işlemleri tekrarlanmıştır. Tekrarlanan çıktılar; orijinal tanımlayıcı istatistikler, korelasyon matrisi, grup karşılaştırma değerleri, regresyon katsayıları, tanısal çıktılar ve görselleştirme kaynak dosyaları ile eşleşmiştir. Bu durum, analitik boru hattının aynı kilitli analitik veri setine uygulandığında hesaplama kararlılığını doğrulamıştır. Bu kontrol, bağımsız bir analistin kilitli ham dışa aktarımdan başlayarak tüm iş akışını uygulaması ve aynı belgelenmiş çıktılara ulaşmasını gerektiren bağımsız prosedürel tekrarlanabilirlik teşkil etmemektedir.
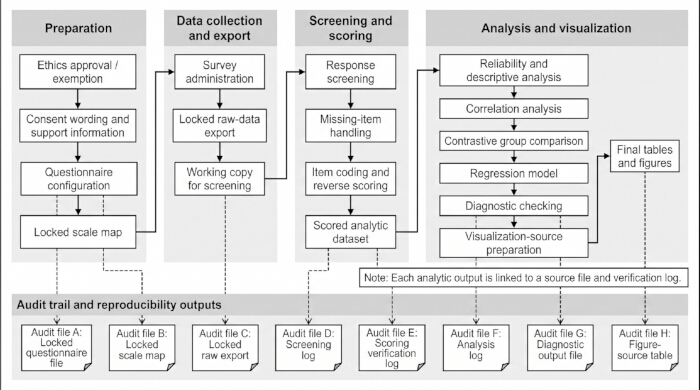
Şekil 1: Ankete dayalı öznel iyi oluş veri işleme iş akışı. Şema; etik hazırlıklar, anket yapılandırması, anket uygulaması, ham veri dışa aktarımı, ölçek haritası, tarama günlüğü, puanlanmış analitik veri seti, doğrulanmış analiz tabloları, regresyon tanıları, şekil kaynak dosyaları ve görselleştirme çıktılarını içeren protokol sırasını ve temel denetim çıktılarını göstermektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
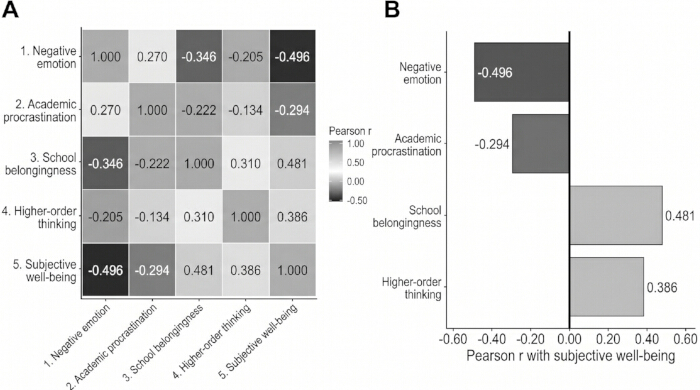
Şekil 2: Ölçek düzeyindeki değişkenler arasındaki korelasyon yapısı. (A) Tablo 6'daki doğrulanmış korelasyon matrisinden oluşturulan Pearson korelasyon ısı haritası. (B) Aynı doğrulanmış kaynak tablodan oluşturulan, subjektif iyi oluş merkezli korelasyon profili. Beş ölçek düzeyi değişkeninin tamamı gösterilmektedir: negatif duygu, akademik erteleme, okula aidiyet, üst düzey düşünme ve subjektif iyi oluş. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
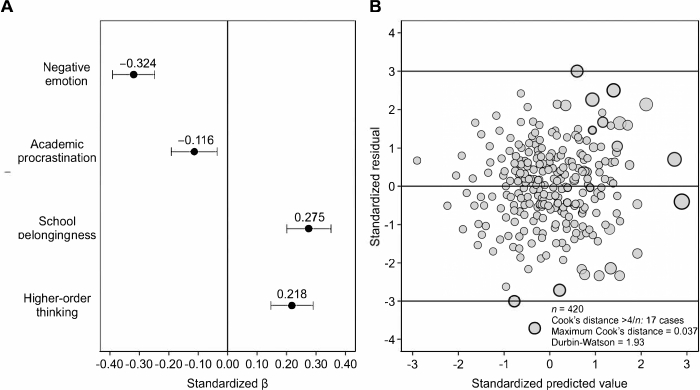
Şekil 3: Regresyon katsayısı ve tanısal görselleştirme. (A) Tablo 9'daki birincil regresyon çıktısından oluşturulan standartlaştırılmış regresyon katsayıları ve %95 güven aralıkları. (B) Tablo 11'de özetlenen standartlaştırılmış tahmin edilen değerler, standartlaştırılmış artıklar ve Cook uzaklığı değerlerinden oluşturulan regresyon tanılama ekranı. Daha büyük Cook uzaklığı değerleri, uyumlu model üzerinde daha fazla potansiyel etkiye sahip gözlemleri gösterir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Tablo 1: Anket yapısı ve ölçek puanlama çerçevesi. Bu tablo; yapı adı, kaynak araç, kaynak atıf, adaptasyon veya dokümantasyon durumu, madde numarası, yanıt aralığı, puan yönü, ters puanlama gereksinimi, puanlama yöntemi, nihai ölçek düzeyi değişkeni ve protokol rolü dahil olmak üzere ölçüm çerçevesini özetlemektedir. Bu Tabloyu indirmek için lütfen buraya tıklayın.
Tablo 2: Yanıt tarama ve analitik karar kriterleri. Bu tablo; onam taraması, uygunluk taraması, mükerrer yanıt incelemesi, eksik veri yönetimi, yanıt süresi işaretlemesi, düz çizgi yanıt tespiti, geçerli yanıt aralıkları, güvenilirlik değerlendirmesi, yüksek-düşük grup sınıflandırması, regresyon tanıları ve hassasiyet kontrolleri için önceden belirlenmiş kriterleri listelemektedir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 3: Gönderilen anketlerden nihai analitik veri setine kadar olan tarama akışı. Bu tablo; her bir tarama adımındaki gönderilen anket sayısını, işaretlenen kayıtları, çıkarılan kayıtları, elde tutulan kayıtları ve doğrulama kaynaklarını rapor etmektedir. Tamamlama süresi ve düz çizgi yanıt verme durumu, otomatik dışlama kriterlerinden ziyade yanıt kalitesi işaretçileri olarak değerlendirilmiştir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 4: Analitik veri setinin demografik özellikleri.Bu tablo; cinsiyet, yaş, lisans sınıfı, kurum kategorisi ve akademik bölüm kategorisi dahil olmak üzere, yanıt taramasından sonra saklanan anonimleştirilmiş öğrenci kayıtlarını özetlemektedir. Demografik hücreler, raporlanmadan önce dolaylı tanımlanabilirlik riski açısından incelenmiştir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 5: Beş ölçek düzeyindeki değişkenin betimsel istatistikleri, aralık doğrulaması ve iç tutarlılığı. Bu tablo; negatif duygu, akademik erteleme, okula aidiyet, üst düzey düşünme ve sübjektif iyi oluş için madde sayısını, teorik aralığı, gözlemlenen aralığı, ortalamayı, standart sapmayı, Cronbach alfa değerini, McDonald omega değerini ve taban/tavan konsantrasyonunu rapor etmektedir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 6: Ölçek düzeyindeki değişkenlerin Pearson korelasyon matrisi. Bu tablo; negatif duygu, akademik erteleme, okula aidiyet, üst düzey düşünme ve öznel iyi oluş arasındaki Pearson korelasyon katsayılarını sunmaktadır. Matris, betimsel bir ilişki çıktısı ve puanlama yönü doğrulama adımı olarak kullanılmıştır. Bu tabloyu indirmek için lütfen buraya tıklayınız.
Tablo 7: Yüksek ve düşük öznel iyi oluş grupları arasındaki karşılaştırmalı analiz. Bu tablo, öznel iyi oluş puanlarının en üst %27'lik ve en alt %27'lik dilimindeki katılımcıların negatif duygu, akademik erteleme, okul aidiyeti ve üst düzey düşünme becerilerini karşılaştırmaktadır. Bu karşılaştırma, iyi oluş profillerinin esaslı bir sınıflandırmasından ziyade, gruplandırma ve karşılaştırma iş akışını göstermektedir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 8: Cinsiyete göre tanımlayıcı karşılaştırma. Bu tablo; negatif duygu, akademik erteleme, okula aidiyet, üst düzey düşünme ve öznel iyi oluşun cinsiyete göre tanımlayıcı karşılaştırmalarını sunmaktadır. Cinsiyet, tanımlayıcı bir gruplandırma değişkeni olarak ele alınmıştır. Bu Tabloyu indirmek için lütfen buraya tıklayın.
Tablo 9: Öznel iyi oluşu öngören birincil çoklu doğrusal regresyon modeli. Bu tablo, öznel iyi oluşun bağımlı değişken olduğu; negatif duygu, akademik erteleme, okul aidiyeti ve üst düzey düşünmenin ise ölçek düzeyinde öngördücüler olarak aynı anda modele dahil edildiği birincil regresyon modelini sunmaktadır. Standart hata, güven aralığı ve varyans şişirme faktörü değerleri dahil edilmiştir. Bu tabloyu indirmek için lütfen buraya tıklayınız.
Tablo 10: Sübjektif iyi oluşu tahmin eden demografik olarak ayarlanmış regresyon duyarlılık modeli. Bu tablo; cinsiyet, yaş, lisans yılı, kurum kategorisi ve akademik bölüm kategorisine göre ayarlama yapıldıktan sonraki dört psikolojik öngörücüyü raporlamaktadır. Kategorik demografik değişkenler, kukla kodlama (dummy coding) kullanılarak girilmiştir. Standart hata, güven aralığı ve varyans şişirme faktörü değerleri dahil edilmiştir. Bu Tabloyu indirmek için lütfen buraya tıklayın.
Tablo 11: Regresyon tanıları ve etki duyarlılık kontrolleri. Bu tablo; standartlaştırılmış artıklar, Cook uzaklığı > 1,00, Cook uzaklığı > 4/n, maksimum Cook uzaklığı, Durbin-Watson istatistiği, artık Q-Q grafiği, artık normallik testi, tahmin edilen değere karşı artık grafiği, doğrusallık kontrolü ve etki duyarlılık analizi dahil olmak üzere artık, etki ve model tanı çıktılarını özetlemektedir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Ek Dosya 1: Anket yapısı, ölçek kaynağı ve puanlama dokümantasyonu. Bu ek dosya; anket uygulama sırasını, bilgilendirilmiş onam metnini, demografik değişkenleri, kaynak araç dokümantasyonunu, madde kodlarını, yanıt seçeneklerini, adaptasyon ve dokümantasyon durumu bilgilerini, puanlama yönünü, ters puanlama kurallarını, nihai ölçek düzeyi değişken oluşturumunu, eksik madde yönetimi kurallarını, yanıt kalitesi bağlantı alanlarını, aralık doğrulama kurallarını ve beş anket yapısı için referans bağlantılarını sunmaktadır. Bu dosya, iş akışındaki ölçek programlamasının, puanlamanın ve doğrulamanın belgelenmesi için anket/kod kitabı eki olarak işlev görmektedir. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Bu protokol, anket tabanlı iyi oluş çalışmalarında yaygın olan ancak genellikle yetersiz raporlanan bir süreci standartlaştırmaktadır: ham yanıt kayıtlarından taranmış verilere, puanlanmış ölçek değişkenlerine, istatistiksel çıktılara ve görselleştirmeye hazır dosyalara geçiş süreci. Bu çalışmanın katkısı, yeni bir subjektif iyi oluş teorisi geliştirmek veya nedensel bir model önermek değildir. Bunun yerine bu iş akışı; anket yapılandırması, yanıt tarama, ölçek puanlama, güvenirlik kontrolü, betimsel analiz, ilişki analizi, regresyon tanıları ve şekil-kaynak doğrulaması için denetlenebilir bir yol sunar. Bu ayrım önemlidir çünkü anket tabanlı araştırmalarda denetlenebilirlik; hangi kayıtların tutulacağı, eksik maddelerin nasıl ele alınacağı, ters puanlanan maddelerin nasıl işleneceği ve sayısal kaynak tablolarının görsel çıktılara nasıl bağlanacağı dahil olmak üzere, genellikle istatistiksel yorumlama başlamadan önce verilen prosedürel kararlara bağlıdır. Bu kararların açıkça belirtilmesi, ölçek tabanlı araştırmalardaki tartışmalı ölçüm uygulamalarını azaltır23 ve daha şeffaf bir araştırma kültürünü destekler24.
Protokolün temel bir özelliği, yalnızca sözel açıklamalar yerine somut denetim kalıntılarının (artifact) kullanılmasıdır. Revize edilen iş akışı, her bir yapıyı kaynak aracına, madde aralığına, yanıt çapalarına, puanlama yönüne, ters puanlama kuralına, nihai ölçek düzeyindeki değişkene ve adaptasyon veya dokümantasyon durum bilgilerine bağlar. Denetim izi; kilitli anket dosyasını, kilitli ölçek haritasını, kilitli ham veri dışa aktarımını, tarama günlüğünü, puanlama doğrulama günlüğünü, analiz günlüğünü, tanısal çıktı dosyasını ve şekil-kaynak tablosunu içerir. Bu dosyalar; anketin hangi versiyonunun uygulandığını, hangi kayıtların hariç tutulduğunu veya saklandığını, puanların nasıl oluşturulduğunu ve her bir şekli oluşturmak için hangi doğrulanmış tablonun kullanıldığını netleştirir. Katılımcı düzeyindeki verilerin kamuyla paylaşılamadığı durumlarda, aynı değişken yapısına sahip sentetik bir veri seti ile tamamlanmış tarama/puanlama günlükleri, okuyucuların tanımlanabilir veya dolaylı olarak tanımlanabilir kayıtlara erişmeden hesaplama iş akışını test etmelerine olanak tanıyabilir. Bu kalıntı tabanlı yapı, yeniden kullanılabilir araştırma çıktılarının net bir menşei, yapı ve erişim koşulları gerektirdiğini belirten FAIR prensibi ile uyumludur25.
Temsili sonuçlar, öğrenci refahının psikolojik belirleyicilerine ilişkin esaslı kanıtlardan ziyade iş akışı çıktıları olarak yorumlanmalıdır. Yüksek-düşük subjektif refah karşılaştırması, önceden belirlenmiş bir gruplandırma kuralının nasıl uygulanabileceğini, kontrol edilebileceğini ve raporlanabileceğini göstermek için eklenmiştir; gerçek dünyadaki refah profillerinin bir sınıflandırması olarak yorumlanmamalıdır. Benzer şekilde, regresyon modeli, puanlanmış anket verilerinin nasıl modellenebileceğini, çoklu doğrusallık açısından nasıl kontrol edilebileceğini, artık ve etki tanıları ile nasıl değerlendirilebileceğini ve doğrulanmış bir şekil-kaynak tablosuna nasıl bağlanabileceğini göstermektedir. Bu model; negatif duygu, akademik erteleme, okula aidiyet veya üst düzey düşünmenin subjektif refahı nedensel olarak belirlediğini kanıtlamaz. Tüm ana değişkenler tek bir zaman noktasında aynı öz rapor anket yoluyla toplandığından, ortak yöntem yanlılığı, yanıt stili etkileri ve paylaşılan ölçüm bağlamı dışlanamaz26.
Bu iş akışı ayrıca tam psikometrik doğrulamayı ikame etmez. Cronbach’ın alfa, McDonald’ın omega, gözlemlenen aralık kontrolleri, madde-toplam incelemesi ve ters puanlama doğrulaması, denetlenebilir bir puanlama iş akışı için yararlı kalite kontrol adımlarıdır; ancak bunlar faktöryel geçerliliği, ölçüm değişmezliğini, madde yanıt özelliklerini veya gruplar arası karşılaştırılabilirliği belirlemez. Anketi temel teori testleri için kullanan çalışmalar, doğrulayıcı faktör analizi, ilgili demografik veya kurumsal gruplar arasında ölçüm değişmezliği testi ve uygun olduğunda ek geçerlilik kontrolleri gerçekleştirmelidir27. Bu nedenle, mevcut protokol, dahil edilen yapılar için eksiksiz bir doğrulama çalışması olarak değil, denetlenebilir bir veri işleme ve raporlama çerçevesi olarak anlaşılmalıdır.
İş akışı, dışsal bir doğrulama yapılmaksızın, tek bir zaman noktasında toplanan kendi bildirimine dayalı anket verileri kullanılarak, bir lisans öğrencisinden oluşan bir örneklem üzerinde gösterilmiştir. Bu yöntemin diğer popülasyonlara, disiplinlere, kurumlara, dillere ve kültürel ortamlara taşınabilir olduğu varsayılmamalıdır. İş akışı başka bir bağlamda yeniden kullanılırsa, ölçek haritası mekanik olarak kopyalanmak yerine yeniden oluşturulmalıdır. Araştırmacılar; maddelerin kaynağını, çeviri veya adaptasyon durumunu, iyi olma maddelerinin kültürel ve bağlamsal bağımlılığını, yanıt ölçeklerini, ters puanlama kurallarını, puan yorumlamasını ve yerel etik gereklilikleri gözden geçirmelidir. Çeviri ve adaptasyon prosedürleri, kayıt dışı sözcük değişiklikleri yerine açık bir belgelendirme gerektirir28 ve eğitimsel ile psikolojik test puanlarının yorumlanması, hedeflenen kullanım ve popülasyona yönelik kanıtlara bağlı kalmalıdır29.
Uygulamada bu protokol, anket tabanlı esenlik araştırmalarında veri işleme ve raporlama için denetlenebilir bir çerçeve olarak oldukça kullanışlıdır. Araştırmacıların; temizleme, puanlama, tanılama ve görselleştirme konusundaki kararlarını, yorumlama aşaması başlamadan önce görünür kılmalarına yardımcı olur. Gelecekteki uygulamalar, bu iş akışını bağımsız örneklemler, farklı kurumsal ortamlar, boylamsal tasarımlar ve bağımsız olarak tekrarlayan analist ekipleri üzerinde test etmelidir. Dış doğrulama, önceden kaydedilmiş karar kuralları, paylaşılan sentetik veri setleri, tamamlanmış örnek tarama/puanlama günlükleri ve bağımsız analist tekrarları, iş akışının taşınabilirliğini ve güvenilirliğini daha da güçlendirecektir.
Açıklamalar
Yazarların beyan edecekleri herhangi bir çıkar çatışması bulunmamaktadır.
Teşekkürler
Yazarlar, veri toplama sürecindeki destekleri için anket çalışmasına katılan üniversite öğrencilerine teşekkür ederler. Yazarlar ayrıca, anketlerin dağıtımı, verilerin düzenlenmesi, sonuçların doğrulanması ve tablo ile şekillerin hazırlanmasındaki yardımları için ilgili eğitmenlere ve araştırma görevlilerine teşekkür ederler. Bu çalışma için herhangi bir özel finansman alınmamıştır.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| broom R paketi | CRAN | R paketi | Regresyon çıktılarını yapılandırılmış katsayı ve model özet tablolarına dönüştürmek için kullanıldı. |
| car R paketi | CRAN | R paketi | Varyans şişirme faktörü doğrulaması ve regresyon tanı desteği için kullanıldı. |
| Depresyon Kaygı Stres Ölçekleri-21 kaynak dokümantasyonu | Psychology Foundation of Australia | Lovibond and Lovibond, 1995 | Negatif duygu bölümü için kaynak dokümantasyon. İş akışında, güncel negatif duygusal durum değerlendirmesiyle uyumlu, çalışmaya uyarlanmış ifadeler kullanıldı. |
| dplyr R paketi | CRAN | R paketi | Veri filtreleme, yeniden kodlama, gruplandırma, tarama akış özetleri ve analitik tablo hazırlama için kullanıldı. |
| ggplot2 R paketi | CRAN | R paketi | Korelasyon ısı haritası, subjektif iyi oluş korelasyon grafiği, regresyon katsayısı grafiği ve tanısal görünümler oluşturmak için kullanıldı. |
| Üst düzey düşünme ölçümü kaynak dokümantasyonu | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Üst düzey düşünme bölümü için kaynak dokümantasyon. İş akışında; analitik, değerlendirici, yansıtıcı, bütünleştirici ve kanıta dayalı düşünmeyle uyumlu, çalışmaya uyarlanmış bir madde seti kullanıldı. |
| IBM SPSS Statistics | IBM Corp. | Version 29.0.2.0 | Betimsel istatistikler, Cronbach’s alfa, Pearson korelasyonu, bağımsız örneklemler ve Welch’s t-testleri, çoklu doğrusal regresyon, Durbin-Watson istatistiği, standardize edilmiş artıklar, kaldıraç değerleri, Cook’s uzaklığı ve varyans şişirme faktörleri için kullanıldı. |
| psych R paketi | CRAN | R paketi | Psikometrik özetler, Cronbach’s alfa doğrulaması ve McDonald’s omega için kullanıldı. |
| Psikolojik Okul Aidiyet Hissiyatı Ölçeği kaynak dokümantasyonu | Wiley | Psychol Sch. 1993;30(1):79-90 | Okul aidiyeti bölümü için kaynak dokümantasyon. İş akışında; okul ortamında algılanan kabul, bağlantı, destek ve aidiyetle uyumlu, çalışmaya uyarlanmış ifadeler kullanıldı. |
| R istatistik ortamı | R Foundation for Statistical Computing | Version 4.4.2 | İkincil analitik doğrulama, McDonald’s omega, Spearman duyarlılık kontrolleri, regresyon çıktısı hazırlama, tanısal çıktı hazırlama ve görselleştirme kaynağı hazırlama için kullanıldı. |
| readxl R paketi | CRAN | R paketi | Elektronik tablo anket dışa aktarımlarını R doğrulama iş akışına aktarmak için kullanıldı. |
| Çin Vatandaşları için Subjektif İyi Oluş Ölçeği kaynak dokümantasyonu | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Subjektif iyi oluş bölümü için kaynak dokümantasyon. İş akışında; yaşam doyumu, anlam, destek, ilerleme, memnuniyetsizlik, çaresizlik ve stresle ilişkili iyi oluş deneyimleriyle uyumlu, çalışmaya uyarlanmış ifadeler ve ters puanlanan maddeler kullanıldı. |
| Ek Dosya 1: Anket yapısı ve ölçek dokümantasyonu | Yazarlar | Supplementary File 1 | Uygulanan anket yapısını, yapı sırasını, ölçek kaynağını, madde kodlarını, yanıt seçeneklerini, puanlama yönünü, ters puanlama kurallarını, ölçek düzeyinde puan oluşturma ve dokümantasyon durumu bilgilerini sağlar. |
| Tuckman Erteleme Ölçeği kaynak dokümantasyonu | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Akademik erteleme bölümü için kaynak dokümantasyon. İş akışında; akademik geciktirme ve görev erteleme davranışı ile uyumlu, çalışmaya uyarlanmış ifadeler kullanıldı. |
| Wenjuanxing çevrimiçi anket platformu | Changsha Ranxing Information Technology Co., Ltd. | Web tabanlı platform | Elektronik onam, anket programlama, madde yanıtlarının toplanması, zaman damgası yakalama, tamamlama süresinin kaydedilmesi, mükerrer gönderim incelemesi ve ham yanıtların dışa aktarılması için kullanıldı. |
Kaynaklar
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.