Bu makale, sendika faaliyetlerinin zamanlamasındaki sık kaynak çatışmaları ve yanıt gecikmelerine odaklanarak, Transformer ve PPO pekiştirmeli öğrenmeyi entegre eden dinamik bir çizelgeleme optimizasyon algoritmasını incelemektedir.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Transformer ve Takviyeli Öğrenmeyi Entegre Ederek Sendika Faaliyetleri İçin Dinamik Çizelgeleme ve Kaynak Optimizasyonu Algoritması
Bu makalede
Özet
Özet
Sendika faaliyetlerinin yönetiminde, sık kaynak tahsis çatışmaları ve geciken planlama yanıtları nedeniyle ortaya çıkan düşük organizasyonel verimlilik sorununu çözmek için bu çalışma, Transformer ve PPO'yu (Proximal Policy Optimization) entegre eden dinamik bir planlama algoritması önermektedir. Spesifik uygulamada, öncelikle faaliyet, personel ve kaynak durumlarını tensör girdilerine dönüştürerek çok boyutlu kısıt entegrasyonu sağlayan birleşik bir planlama senaryosu modelleme yapısı tasarlanmıştır. Ardından, geçmiş faaliyet taleplerinin ve kaynak durumlarının zaman serilerini kodlamak, çok boyutlu uzaysal-zamansal özellikleri çıkarmak ve çatışma riskleri algısını artırmak için Transformer çok kafalı dikkat (multi-head attention) mekanizması kullanılmıştır. Sonrasında, kodlama sonuçlarına ve PPO strateji ağına dayanarak, stratejinin karmaşık ortamlara adaptasyonunu artırmak amacıyla mevcut durumdan planlama eylemleri üretilmiştir. Son olarak, budama güncellemesi ve avantaj fonksiyonu düzeltme mekanizması aracılığıyla, iterasyon sırasında stratejinin kararlılığı ve iyileştirilmiş planlama performansı garanti altına alınmıştır. Deneyler, görev yoğunluğu 1000 olduğunda, planlama algoritmasının ortalama karar süresinin 0,72s ve ortalama yanıt gecikmesinin 1,59s olduğunu göstermiş; bu da yüksek yanıt hızı ve karar verme verimliliğine işaret etmiştir. Yedi faaliyet türü ve karmaşıklık düzeyinde, kaynak çatışma oranı 0,05–0,12; ortalama kaynak kullanım oranı 0,75–0,86 ve planlama kararlılık indeksi 0,8–0,91 olarak belirlenmiş, böylece sık kaynak tahsis çatışmaları etkili bir şekilde azaltılmış ve yüksek planlama kararlılığı sağlanmıştır. Yüksek eşzamanlılık koşulları altında, kaynak denge indeksi ve strateji transfer dayanıklılığı indeksi sırasıyla 0,88 ve 0,85 olarak gerçekleşmiş olup, bu durum görev eşzamanlılık yüklerine karşı iyi bir adaptasyon yeteneği olduğunu göstermektedir.
Giriş
Sendika faaliyetleri, sistemin verimli dinamik yanıt yeteneklerine sahip olmasını gerektiren, çok sayıda görev ve kaynağın karmaşık planlamasını içerir1,2. Faaliyet gereksinimleri sıklıkla değişmekte, personel ve mekan kaynaklarının dağılımı ise karmaşık seyretmektedir; bu durum kolaylıkla planlama çatışmalarına ve kaynak israfına yol açabilmektedir3,4. Faaliyet geçmişinin ve gerçek zamanlı kaynak durumunun doğru bir şekilde kaydedilmesinin yanı sıra, potansiyel çatışmaları tanımlama ve bunlara yanıt verme yeteneğinin geliştirilmesi, organizasyonel işletme verimliliğini artırmanın anahtarıdır5,6. Gelişmiş zaman serisi modelleme teknolojisi ve pekiştirmeli öğrenme algoritmalarının entegrasyonu, karmaşık planlama ortamlarında derinlemesine bir anlayış ve akıllı optimizasyon sağlayarak kaynak kullanımının maksimize edilmesine, planlama yanıtının hızlandırılmasına ve sendika faaliyetleri yönetiminin akıllı yükseltilmesine yardımcı olabilir.
Buna rağmen, pratikteki mevcut çizelgeleme yaklaşımları büyük oranda kural tabanlı ve statiktir; sık gerçekleşen görev değişikliklerine ve kaynak dalgalanmalarına uyum sağlayamazlar, bu da genellikle uzamış yanıt sürelerine ve ciddi kaynak çakışmalarına yol açar. Sendika faaliyetlerinin çizelgelenmesinde görev türleri oldukça çeşitlidir; kaynak kullanımı yüksek derecede kısıtlıdır ve sıkça değişir; faaliyetler arasındaki bağımlılıklar ve kaynaklar arasındaki rekabet karmaşık bir çizelgeleme haritası oluşturur7,8. Uygulamada, faaliyet programı personel ve mekanlar gibi kaynakların mevcut zaman pencereleriyle verimli bir şekilde eşleştirilemez9,10 ve genellikle çakışmalar meydana gelerek organizasyonel operasyonların genel tutarlılığını zayıflatır11,12. Çizelgeleme sistemi tek bir optimizasyon hedefiyle değil, aksine kaynak çakışmalarını minimize etmek, yanıt hızını maksimize etmek, çizelgeleme stratejisi stabilitesi ve görev tamamlama oranı gibi çok boyutlu göstergeler arasındaki bir dengeyle karşı karşıyadır13,14; bu durum tipik çok amaçlı optimizasyon özellikleri sergiler. Ek olarak, sendika faaliyetleri belirgin aşamalara ve döngülere sahiptir ve çizelgeleme stratejileri, farklı görev aşamalarındaki değişken kaynak-talep yapılarına dinamik olarak uyum sağlamalıdır. Bir kez oluşturulan statik planlar, yüksek frekanslı değişikliklerin olduğu yürütme ortamını destekleyemez15,16. Mevcut çizelgeleme mantığı, geçmiş görev davranışlarının ve kaynak durumu değişiklik kalıplarının derinlemesine keşfinden yoksundur. Gelecek için doğru tahminler ve strateji çıkarımları sağlayamaz17,18. Sistemin çizelgeleme stratejisi, ani görevlere ve kaynaklardaki geçici değişikliklere yavaş tepki vererek operasyonun genel sürdürülebilirliğini etkiler19,20. Öngörülebilirlik, esneklik ve stabiliteye sahip bir çizelgeleme sistemi kurmak, pratik uygulamalarda temel bir teknik gereksinim haline gelmiştir. Bu durum, modelin yüksek boyutlu bilgi algısına, dizi belleğine ve strateji göçü yeteneklerine sahip olmasını; çok görevli bir ortamda sağlam karar verme ve kaynak dengesini korumasını gerektirir ve böylece sendika faaliyeti çizelgelemesinin akıllı ve optimal koordinasyonunu mümkün kılar.
Birçok çalışma, dinamik çizelgeleme problemine yönelik çeşitli çözümler önermiştir. Bunlar arasında, derin öğrenme ve pekiştirmeli öğrenmenin kombinasyonu, güçlü bir adaptasyon ve optimizasyon kapasitesi göstermiştir. Bazı araştırmacılar, zaman serisi verilerini modellemek için LSTM (Uzun Kısa Süreli Bellek)21,22 kullanmış ve çizelgeleme davranışını optimize etmek için pekiştirmeli öğrenme stratejilerini birleştirerek belirli sonuçlar elde etmişlerdir. Bir diğer araştırma türü ise, çizelgeleme kararlarının basitliğini ve verimliliğini vurgulayan, net kuralların olduğu senaryolar için uygun olan açgözlü algoritma tabanlı bir sezgisel yöntem kullanmaktadır23,24. Diğer çalışmalar, derin Q-ağının (DQN) çizelgelemedeki uygulamasını incelemiş ve değer fonksiyonu yaklaşımı yoluyla iyileştirilmiş stratejiler elde etmişlerdir25,26. Ancak bu yöntemler, karmaşık ve değişken birleşik etkinlik senaryolarıyla karşılaşıldığında, uzun vadeli bağımlılıkların yetersiz yakalanması, kararsız strateji güncellemeleri ve büyük yanıt gecikmeleri gibi sorunlar yaşamakta, bu da yüksek yoğunluklu ve çeşitli görevlerin çizelgeleme ihtiyaçlarını karşılamayı zorlaştırmaktadır. Bu nedenle, verimli özellik çıkarımı ve kararlı strateji güncelleme yeteneklerine sahip bir çizelgeleme algoritmasının nasıl oluşturulacağı, güncel araştırmalarda aşılması gereken bir darboğaz haline gelmiştir.
Çok alanlı çizelgeleme araştırmalarında Transformer mimarisi, uzun vadeli zamansal bağımlılıkları etkili bir şekilde yakalayan çok kafalı öz-dikkat mekanizması sayesinde çeşitli zaman serisi tahmini ve çizelgeleme optimizasyon görevlerine uygulanmıştır27,28. Pekiştirmeli öğrenmedeki PPO algoritması ile birleştirildiğinde, amaç fonksiyonunun kırpılmasıyla strateji kararlı ve verimli bir şekilde güncellenmekte olup bu yaklaşım, robot kontrolü ve akıllı imalat gibi alanlarda iyi performans göstermiştir29,30,31. Bazı çalışmalar, karmaşık kaynak çizelgelemesi için Transformer'ı pekiştirmeli öğrenme ile entegre etmeye çalışmıştır32. Ancak, sendika faaliyetlerinin dinamik çizelgelemesinde, çeşitli faaliyet türlerinin ve karmaşık kaynak kısıtlarının kombinasyonunu ele alan az sayıda çalışma bulunmaktadır. Bazı çalışmalar, kaynaklar ve görevler arasındaki ilişkiyi modellemek için grafik sinir ağlarını kullanmış ve böylece çatışma tanımlama doğruluğunu artırmıştır33,34. Bazı bilim insanları, modelin verimliliğini ve performansını artırmak için uç bilişime dayalı kaynak çizelgelemeyi optimize etmiştir35,36. Buna rağmen, bu yöntemler zamansal bağlam için hala sınırlı modelleme yeteneklerine sahiptir. Buna dayanarak bu makale, sendika faaliyetlerinin değişken ve karmaşık çizelgeleme ihtiyaçlarıyla başa çıkabilmek için, çatışma risklerine karşı yüksek bir algı ve çizelgeleme stratejilerinin kararlı bir güncellemesini sağlamak amacıyla, geçmiş faaliyet ve kaynak durum dizilerini kodlamak için bir Transformer'ın PPO politika ağı ile birlikte kullanılmasını önermektedir.
Daha güncel çalışmalar, bulut bilişimde enerji verimliliği için VM konsolidasyonu37, hücresel ağlarda kimlik doğrulama algoritmaları38, sürdürülebilir bulut bilişim için canlı göç ile geliştirilmiş VM konsolidasyonu39, bekleme tahmini ve evrimsel algoritmalar kullanılarak trafik optimizasyonu40 ve geliştirilmiş optimizasyon ile bütünlük korumasına sahip blockchain tabanlı bulut depolama41 gibi farklı perspektiflerden kaynak planlama optimizasyonunu incelemiştir. Bu çalışmalar kaynak tahsisi ve optimizasyon algoritmaları hakkında değerli bilgiler sunsa da, öncelikle bulut altyapısını, telekomünikasyonu veya depolama sistemlerini hedeflemekte olup sendika faaliyetleri yönetiminin doğasında bulunan çok tipli etkinlik kısıtlamalarını, dinamik personel-mekan kaynak çatışmalarını ve gerçek zamanlı planlama gereksinimlerini özel olarak ele almamaktadır. Bu ayrım, sendika faaliyetlerinin organizasyonel bağlamına uygun olarak tasarlanmış özel bir planlama çerçevesine olan ihtiyacı daha da vurgulamaktadır.
Sendika faaliyetleri için mevcut çizelgeleme yöntemleri, genellikle uzun vadeli uzamsal-zamansal bağımlılıkları yakalamakta ve dinamik değişiklikler karşısında politika stabilitesini korumakta yetersiz kalmakta, bu da yavaş yanıt sürelerine ve yüksek kaynak çatışmalarına yol açmaktadır. Bu araştırma boşluklarını gidermek amacıyla bu çalışma, Transformer çok kafalı dikkat mekanizmasının çatışma tahmini için geçmiş dizileri etkili bir şekilde kodlayabildiği ve kırpılmış bir amaç fonksiyonuna sahip Yakın Politika Optimizasyonu'nun (PPO) stabil ve adaptif politika güncellemeleri sağladığı prensibine dayalı bir çizelgeleme optimizasyon modeli önermektedir. Spesifik olarak, çatışma öngörüsünü artırmak için temel uzamsal-zamansal özellikleri çıkaran faaliyet ve kaynak durum dizilerini kodlamak üzere Transformer uygulanmış ve verimli çizelgeleme eylemi üretimi ile stabil güncellemeler için PPO ile kombine edilmiştir. Faaliyetleri, personeli ve mekanları eşlemek için birleşik bir kısıtlama matrisi tasarlanarak karmaşık bağımlılıkların tanınması geliştirilmiştir. Bu çalışmanın temel yenilikleri şunları içermektedir: (1) zamansal kodlama ve pekiştirmeli öğrenmenin özellikle sendika faaliyeti çizelgelemesi için entegrasyonu; (2) risk algısına öncelik veren çatışma duyarlı bir dikkat mekanizması ve (3) yüksek eşzamanlılık altında strateji sağlamlığını garanti altına almak için avantaj fonksiyonu düzeltmeli bir budama güncellemesi. Çeşitli görev yoğunlukları ve karmaşıklıkları altında yürütülen kapsamlı deneyler; modelin yanıt hızı, kaynak kullanımı ve stabilite açısından mevcut yöntemlere karşı üstünlüğünü doğrulamakta ve sendika faaliyeti yönetimi için pratik ve ölçeklenebilir akıllı bir çizelgeleme çözümü sunmaktadır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Şekil 1, zaman serisi modellemesi ve pekiştirmeli öğrenmeyi entegre eden bir sendika faaliyet çizelgeleme sisteminin yapısını göstermektedir. Giriş katmanı; faaliyet çizelgelerini, kaynak kullanılabilirliğini ve personel zaman penceresi bilgilerini entegre eder ve kısıt grafiği modülü aracılığıyla çok boyutlu bir görev ve kaynak çakışma ilişkisi matrisi oluşturur. Transformer, faaliyet ve kaynak durumlarının geçmiş dizisi üzerinde çok kafalı dikkat kodlaması gerçekleştirerek zamansal bağımlılıklara sahip gizli durumlar üretir. Politika modülü, eylem dağılımları ve durum tahmini oluşturmak için kodlama sonuçlarını kullanır ve eylemler örnekledikten sonra çizelgeleme kararlarını yürütür. Yürütme sonuçları ortama geri beslenerek kaynak durumunu günceller ve anlık ödüller oluşturur. Bunun temelinde, optimizasyon modülü bir kırpma hedef fonksiyonu oluşturur, avantaj fonksiyonunu değerlendirir ve politika kaymasını sınırlamak ve çizelgeleme davranışlarının kararlı güncellenmesini sağlamak için değer ağının tahminini düzeltir. Modüller arasında, kaynak çakışmalarına karşı yüksek hassasiyette bir algı ve dinamik ortamlarda adaptif strateji güncellemeleri gerçekleştirmek için kapalı bir veri döngüsü oluşturulur; böylece çok görevli ve yüksek kısıtlı senaryolarda sendika faaliyet çizelgeleme sisteminin akıllı yanıt verme kapasitesi ve kaynak tahsis verimliliği artırılır.
Sendika faaliyet planlamasının senaryo modellemesi
Planlama sistemindeki tüm faaliyet talepleri, zaman adımlarına dayalı ayrık planlama dizileri şeklinde düzenlenir. Her faaliyet; net başlangıç ve bitiş zamanları, kaynak kategorileri, aşamalar ve öncelik seviyeleri ile tanımlanır. Saha kullanım durumu, yatay eksenin standartlaştırılmış zaman birimini ve dikey eksenin mekansal kaynak numarasını temsil ettiği iki boyutlu bir zaman dilimi matrisi olarak modellenir. Kaynak durumu, mevcut ve dolu olarak işaretlenerek statik bir yapıya sahip başlangıç kaynak dağılım haritası oluşturulur. Personel planlama bilgileri, her biri personelin görev-boşta durumunu ve departman numarasını kaydeden sürekli bir zaman penceresi vektörü oluşturmak için zaman-kimlik boyutunda genişletilir. Tüm giriş bilgileri, burada ayrık zaman adımını, kaynak varlıklarının sayısını ve ilgili kaynak kullanım öznitelik kodunu (dolu olup olmadığı, faaliyet numarası, kullanım önceliği vb.) temsil eden üç boyutlu bir tensör yapısında entegre edilir. Bu yapı, planlama sisteminin herhangi bir zamandaki kaynak konfigürasyonunu okumasına olanak tanıyarak farklı kaynak durum türlerinin birleşik bir temsilini sağlar.
Görev bilgileri modele bağlandıktan sonra, görev yoğunluk vektörü etkinlik önceliğine ve kaynak kullanım süresine göre belirlenir. Çatışmaya neden olabilecek görev kombinasyonları, zaman penceresi örtüşme tespit yöntemi aracılığıyla işaretlenir. Çatışma kombinasyonları düğüm kümelerine dönüştürülür ve örtük bağımlılıkları açıkça temsil etmek için paylaşılan kaynak türleri ile sürelerine dayalı kenar kümeleri oluşturulur. Nihai olarak oluşturulan görev grafiği; zaman dizisi, kaynak örtüşmesi veya kısıt çatışması hakkında sınır bilgilerini içererek, sonraki çatışma tespiti ve çizelgeleme stratejisi oluşturma işlemleri için yapısal bir temel sağlar. Bu yapı, görev çizelgelemenin dinamik doğasını ve kaynak durumundaki sürekli değişiklikleri korur ve çizelgeleme kısıtlarındaki değişikliklerin gerçek zamanlı olarak algılanmasını destekler.
Çakışma tespiti, tensör yapısındaki zaman ve kaynak boyutlarının seyrek örtüşen bölgelerini değerlendirme için başlangıç koşulları olarak kullanır. Çizelgeleme hedefleri örtüşen görev çiftleri için statik ilişki kodlama işlemini uygular. V aktif düğümler kümesini, E kaynak çakışmalarına dayalı olarak oluşturulan kenarları ve C kenarlar için çakışma ağırlığı kodlama matrisini temsil eden bir G=(V,E,C) graf yapısı oluşturur. Çakışma ağırlığı fonksiyonu aşağıdaki formda tanımlanmıştır:
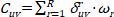 (1)
Bunların arasında, Cuv aktiviteler arasındaki çakışma ağırlığıdır u ve v; u, v aktivite indeksleridir; R toplam kaynak türü sayısıdır; δuvr ∈ {0,1}, faaliyetlerin zaman pencerelerinin olup olmadığını belirtir u ve v kaynakta çakışma Lütfen çevrilecek metni sağlayın.; ωr kaynağın çatışma hassasiyeti ağırlığı mıdır Lütfen çevirmek istediğiniz metni paylaşın. Metni aldığımda, belirttiğiniz tüm bilimsel ve akademik kriterlere uygun olarak profesyonelce Türkçeye çevireceğim.Bu fonksiyon, çatışma şiddetlerinin ağırlıklı toplamını gerçekleştirerek kaynak çatışmalarının çizelgeleme sonuçları üzerindeki önem farklarını hesaba katarken, aynı zamanda çatışma gücü dağılımının ölçülebilir bir ifadesini korur.
Yukarıdaki çatışma grafiği yapısı, seyrek matris gösterimi aracılığıyla bir kısıt sınır matrisine dönüştürülür. Matristeki her bir öge, kaynak çatışmasının derecesini içerir. Görevlerin paralel olarak zamanlanıp zamanlanamayacağını belirlemek için matris, çizelgeleme karar sürecine gömülürken, eylem-kalkanlama mantığı politika ağında yer alır. Periyodik aktivite kümelenmeleri ve yüksek yoğunluklu görev patlamalarıyla başa çıkabilmek için, görev durumundaki değişiklikleri izleyen ve kaynaklar serbest bırakıldıkça veya eklendikçe matris içeriğini gerçek zamanlı olarak güncelleyen dinamik bir güncelleme mekanizması uygulanarak, görev evrimi boyunca çizelgeleme sınırının sürekliliği ve tutarlılığı sağlanır.
Bu çakışma grafiği yapısının uygulanması, çizelgeleme sisteminin potansiyel kaynak darboğazlarını ve görev örtüşme modellerini görsel olarak modellemesine olanak tanıyarak, karar ağının karmaşık kısıtlama senaryolarına yönelik ayrıştırma analizinin verimliliğini artırmaktadır. Çizelgeleme davranışı artık kural tabanlı mantıksal eşleşmeye dayanmamaktadır. Bunun yerine, kısıtlama uzayındaki optimal yolu arayarak, yerel kaynak çakışmalarının küresel görev haritasıyla dinamik olarak dengelenme kabiliyetini geliştirmektedir. Sistem, kaynakların dalgalandığı ve görevlerin sıklıkla eklendiği veya çıkarıldığı bir ortamda çizelgeleme kararlılığını ve görev tutarlılığını koruyabilmektedir.
Şekil 2, görev çakışma ağırlığı ilişkisine dayalı bir ağ yapı diyagramını göstermektedir. Şekildeki her bir düğüm, planlanacak bir görevi temsil eder ve düğümler arasındaki çizgiler kaynak kullanım çakışmalarını belirtir. Kenar kalınlığı, çakışmanın ağırlığını yansıtır. Çakışma ne kadar ciddi olursa, çizgi o kadar kalın olur. Ağırlık hesaplaması, kaynak örtüşmesini bütünleştirir ve çeşitli kaynakların çakışma hassasiyetini birleştirerek görevler arasında bileşik bir çakışma yoğunluğu oluşturur. Grafik yapısı, bazı görevlerin yoğun bağlı alanlar oluşturduğunu ortaya koyarak kaynak kullanımı için önemli bir rekabet olduğunu göstermektedir. Bu tür yerel çakışma kümelenmesi fenomeni, planlama sürecindeki kaynak darboğazlarının ve görev gecikmelerinin temel kaynağıdır ve planlama algoritması buna göre öncelik düzenleme hedefleri belirleyebilir. Düğüm düzenlemesi, yüksek çakışmalı görevleri otomatik olarak kümelemek için kuvvet yönlendirmeli bir yerleşim stratejisi kullanır; bu da planlama sisteminin kilit görev gruplarını tanımlamasına ve strateji dağılımını optimize etmesine olanak tanıyarak genel planlama tutarlılığını ve kaynak koordinasyonunu artırır.
Geçmiş durum dizisi kodlaması
Oluşturulan çatışma grafiği ve kısıtlama matrisine dayanarak, bir sonraki adım, bu kısıtlamaların altında yatan zamansal modellerin sonraki karar verme süreçleri için çıkarılabilmesi amacıyla etkinliklerin ve kaynak durumlarının geçmiş dizilerini kodlamaktır. Çizelgeleme senaryosundaki temel bilgiler; etkinlik talepleri, kaynak durum değişiklikleri ve görev geri bildirim kayıtlarından oluşur. Bu bilgiler; olay zaman noktaları, kaynak kullanım tanımlayıcıları ve etkinlik yürütme durumu gibi özniteliklere karşılık gelen çok sayıda heterojen zaman serisini oluşturur. İşleme yapısını standart hale getirmek için her giriş türü eşit uzunlukta bir vektör dizisi olarak kodlanır ve zaman senkronizasyonu altında durum hizalamasını sağlamak için ortak bir zaman indeksi oluşturulur. Her andaki giriş birimi, üç özellik vektörü setinin birleşiminden oluşur: etkinlik özellik vektörü görevin türünü, önceliğini ve aşama numarasını temsil eder; kaynak özellik vektörü mevcut kaynak doluluğunu, kalan kapasiteyi ve mevcut pencere konumunu kaydeder; geri bildirim özellik vektörü ise görevin bir önceki anda sorunsuz yürütülüp yürütülmediğini ve bir kaynak çatışması veya gecikme olayının meydana gelip gelmediğini tanımlar.
Standartlaştırılmış bir gömme matrisi X ∈ ℝT×d elde etmek için tüm özellikler doğrusal olarak dönüştürülür ve aynı boyutlu uzaya eşlenir; burada T zaman adımlarının sayısını, d ise birleştirilmiş gömme boyutunu temsil eder. Zamansal yapıyı korumak için, giriş matrisi konum kodlama matrisi P ile eleman eleman toplanarak konum farkındalığına sahip giriş oluşturulur:
Z = X + P (2)
Z, sonraki dikkat mekanizmasının girdisi olarak hizmet eden nihai girdi dizisidir. Konum kodlama tasarımı, gelecekteki bilgi sızıntısını önlemek ve kodlama sırasında nedensel kısıtlamaların kesin olarak karşılanmasını sağlamak için sabit bir sinüs ve kosinüs fonksiyonu şablonu kullanır. Yukarıdaki yapı, modelin görev özelliklerini, kaynak durumunu ve zaman konumunu aynı anda algılamasını sağlar. Tam bir durum bellek temeline sahiptir ve sonraki dikkat mekanizması için yüksek çözünürlüklü, birleşik bir yapı sunar.
Dikkat modülü, birden fazla zaman adımı arasındaki potansiyel ilişkileri yakalamak için giriş dizisini işler. Diziyi ayrı ayrı işlemek için birden fazla dikkat başlığı grubu kullanılır ve bu sayede modelin farklı durum evrim yollarına olan duyarlılığı artırılır. Her bir dikkat başlığı, giriş dizisinden bir sorgu matrisi Q, bir anahtar matrisi K ve bir değer matrisi V oluşturur, ağırlık dağılım matrisini hesaplar ve ağırlıklandırılmış bir temsil üretir. Tek başlı dikkat mekanizmasının çıktısı şöyledir:
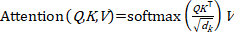 (3)
dk kafa başına düşen özellik boyutlarının sayısıdır. Bu formülde, QK⊤ momentler arasındaki benzerliği temsil eder, √dk sayısal kararlılık için kullanılır ve softmax fonksiyonu ağırlık normalizasyonunu sağlar. Farklı dikkat başlıkları zaman adımlarının farklı kombinasyonlarına odaklanır ve yakaladıkları dinamik bağımlılıklar da çeşitlilik gösterir; bu durum, görev çatışmalarının öncülleri, kaynak tüketim modelleri ve anormal geri bildirim eğilimleri gibi örtük kuralların ortaya çıkarılmasına yardımcı olur.
Tüm dikkat başlığı çıktıları uç uca eklenir ve zamanlama stratejisi oluşturma ağına durum girişi olarak hizmet eden birleşik bir kodlama dizisi üretmek için doğrusal bir dönüşüm katmanından geçirilir. Bu dizi; görev davranış yörüngesini, kaynak değişim özelliklerini ve önceki yürütme sapmalarının mevcut zamanlama penceresindeki etkisini gömer; böylece zamanlama davranışındaki yüksek tarihsel bağımlılık ve seyrek özellik ifadesi sorunlarını etkili bir şekilde çözer. Derin ağın eğitim stabilitesini ve ifade tutma yeteneklerini artırmak için kodlama çıktı katmanına artık bağlantı ve katman normalizasyon modülleri dahil edilmiştir.
Çıktı gizli durum dizisi, yalnızca zaman evrimsel bilgiyi korumakla kalmaz, aynı zamanda ani görevlerden veya geçici kaynak uyumsuzluklarından kaynaklanan değişikliklere yanıt vererek güçlü bir adaptasyon yeteneği sergiler. Bu yapısal tasarım, açık kural tanımlamalarından kaçınır, dinamik çizelgeleme ortamlarının yapılandırılmış modellemesini sağlar ve sonraki politika modüllerinin çok hedefli koşullar altında küresel tutarlılık ve yerel adaptasyonla çizelgeleme çözümleri üretmesini destekler.
Dinamik çizelgeleme stratejisi oluşturma
Hem zamansal bağımlılıkları hem de kaynak çatışması bilgilerini içeren kodlanmış gizli durum dizileri, ardından mevcut ortama uyum sağlayan çizelgeleme eylemleri oluşturmak için politika ağına beslenir. Kodlama modülü tarafından çıktı olarak verilen gizli durum dizisi, çizelgeleme stratejisi ağına girdi olarak kullanılır. Her andaki durum vektörü kümesi; görev özelliklerinin evrimini, kaynak kullanım eğilimlerini ve geçmiş geri bildirim yörüngelerini kapsayan güncel ortam gözlem ifadesini oluşturur. Durum temsil boyutu ve zaman penceresi uzunluğu sabittir ve durum değişikliklerinin sürekliliği bir kayan-güncelleme mekanizması aracılığıyla yakalanır. Durum vektörü politika ağına gönderilmeden önce, girdinin yüksek boyutlu uzayda kararlı bir sayısal dağılım sürdürmesini sağlamak için normalize edilir ve özellik olarak yeniden düzenlenir; böylece gradyan patlaması ve yakınsama dalgalanmaları azaltılmış olur.
Politika ağı yapısı, bir kolun eylem dağılımını oluşturduğu ve diğerinin durum-değer fonksiyonu tahminini çıktı olarak verdiği çift kollu bir çıktı modülü kullanır. Eylem alanı, tüm zamanlanabilir görevleri ve tahsis edilebilir kaynakları kapsar. Aday tarama mekanizması, sınırlı ve yasal bir eylem kümesi oluşturmak için geçersiz veya gereksiz işlem kombinasyonlarını filtreler. Politika kolu, at zaman adımındaki zamanlama eylemini ve st mevcut durum girişini temsil eden bir olasılık dağılımı π(at|st) üretir. Gerçek zamanlama için dağılımdan eylemler seçmek amacıyla standartlaştırılmış bir Gaussian örnekleme veya softmax örnekleme stratejisi kullanılır. Diğer çıktı ise, verilen durumdaki uzun vadeli ödül beklentisini temsil eden ve politika değerlendirmesi ile güncellemesi için kullanılan durum-değer fonksiyonu tahminidir.
Politika ağında, gizli katman, doğrusal olmayan ifade gücünü artırmak ve ağ yakınsamasını hızlandırmak için aktivasyon fonksiyonlarını ve grup normalizasyonunu uygular. Karar verme sürecinde; farklı görevlerin yürütme önceliği, kaynak zamanlama maliyeti ve geçmiş performansı dikkat faktörleri olarak değerlendirilir ve adaptif olarak ayarlanabilir bir politika-çıktı çerçevesi oluşturmak için belirli bir ağırlık matrisi aracılığıyla eylem seçme mekanizmasına uygulanır. Bu tasarım, sabit kurallara güvenmekten kaçınarak stratejinin ani çatışmaları ve yapısal darboğazları yönetme esnekliğini artırır.
Çizelgeleme stratejisi, gerçek eylem dizisini oluşturmak için rastgele bir örnekleme mekanizması kullanır. Her çizelgeleme döngüsünde, mevcut eylem dağılımından yürütülebilir bir eylem örneklenir; kaynak durumu ve görev düğüm işareti güncellenir. Eylem yürütüldükten sonra sistem, bu çizelgeleme turunun genel hedef üzerindeki etkisini ölçmek için kaynak değişiklikleri ve görev ilerleme sonuçlarına dayalı anlık geri bildirim ödülünü hesaplar. Ödül tasarımı; görev tamamlanma oranı, kaynak kullanım verimliliği ve çatışma bastırma derecesi dahil olmak üzere çok boyutlu unsurları göz önünde bulundurur. Kapsamlı göstergeler aracılığıyla strateji güncelleme modülüne geri bildirim sağlar.
Tüm çizelgeleme süreci bir Markov karar zinciri oluşturur ve durum-eylem-ödül dizisini kaydetmek için (st, at, rt, st+1) şeklinde gösterilen ampirik yörünge örnekleme yöntemini kullanır. Strateji optimizasyonu, avantaj tahmininin aşağıdaki formda tanımlandığı avantaj fonksiyonunun oluşturulmasına dayanır:
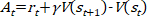 (4)
At avantaj değerini, rt mevcut anlık ödülü, γ ödül indirim faktörünü, V(st) ve V(st+1) ise sırasıyla mevcut ve sonraki durumlardaki durum değer fonksiyonu çıktılarını temsil eder. Avantaj fonksiyonu, mevcut eylemin stratejinin ortalama performansına göre üstünlük derecesini yansıtır. Bu fonksiyon, sonraki strateji iyileştirmelerine rehberlik etmek için kullanılır. Eğer At > 0 ise, bu durum mevcut eylemin ortalama beklentiden daha iyi olduğu anlamına gelir ve seçilme olasılığı artırılmalıdır; aksi takdirde, seçim eğilimi azaltılmalıdır.
Strateji güncelleme sürecinde, aşırı güncelleme genliklerinden kaynaklanan strateji salınımlarını önlemek için, yeni ve eski stratejiler arasındaki değişim aralığını sınırlamak amacıyla bir hedef dağılım kırpma mekanizması uygulanır; böylece ağ çıktısının sürekliliği ve kararlılığı korunur. Aksiyon dağılımı ile geri bildirim ödülü arasında sıkı bir bağ kurulur, bu da stratejinin karmaşık kısıtlamalardaki değişikliklere anında yanıt vermesini sağlar. Bu mekanizma, görevlerin sık değiştiği veya kaynakların aniden uyuşmadığı durumlarda karar verme kararlılığını ve rasyonel kaynak çizelgelemeyi koruyarak; mükerrer tahsis, kaynak sıkışıklığı veya görev kuyruğu birikmesi gibi sorunların etkin bir şekilde önlenmesini sağlar. Çizelgeleme sistemi, farklı görev yoğunluklarında ve kaynak eksikliklerinde daha iyi bir çalışma durumunu koruyabilir ve güçlü adaptif yetenekler sergiler.
Strateji iterasyonu ve kararlı güncelleme mekanizması
Oluşturulan çizelgeleme stratejilerinin kararlı kalmasını sağlamak ve tekrarlanan eğitim turlarında performans kaybı yaşanmasını önlemek için bu alt bölümde, kırpma ve avantaj düzeltmeli iteratif bir güncelleme mekanizması sunulmuştur. Eski ve yeni stratejiler arasındaki kesme güncelleme aralığı belirlenmiş olup, strateji güncelleme sürecinde çizelgeleme şokunu önlemek amacıyla strateji kaymasını sınırlamak için kırpma hedef fonksiyonu kullanılmıştır. Uzun vadeli çizelgelemenin doğruluğunu artırmak için değerleme ağı, avantaj fonksiyonu ile kombinasyon halinde düzeltilmiştir.
Politika ağının eylem çıktısının olasılık dağılımı, sürekli çizelgeleme iterasyonları sırasında şiddetli dalgalanmalara meyillidir; bu durum kararsız davranışlara veya düzensiz kaynak tahsisine yol açabilir. Politika kaymasının neden olduğu çizelgeleme şokunu azaltmak için, yeni ve eski politikalar arasındaki değişim aralığını kontrol etmek amacıyla kırpılmış bir güncelleme aralığı tasarlanmış ve amaç fonksiyonunu geliştirmek için bir kısıtlama terimi oluşturulmuştur. Geçmiş politika olasılığı örnekleme turunda kaydedilir ve oran terimi mevcut politika olasılığı ile oluşturulur. Politika güncelleme hedefi şu şekilde belirlenir:
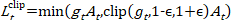 (5)
Burada, gt = πθ(at|st)/πθold(at|st) yeni ve eski politikalar arasındaki olasılık oranını; ε ise politika güncelleme aralığını sınırlayan kırpma eşiğini ifade eder. Oran sınırı aştığında, stratejinin uç örneklerden aşırı gradyanlar üretmesini önlemek ve ağ parametresi ayarlamasının önceden belirlenmiş aralıkta kalmasını sağlamak için bunun yerine kırpma değeri kullanılır. Bu yapı, her çizelgeleme turu için çıktı stratejisindeki değişim aralığını dinamik olarak kısıtlayarak, yoğun görev dağılımları altında strateji çıktısının pürüzsüzlüğünü ve tutarlılığını korur ve çizelgeleme davranışının titreme oranını önemli ölçüde azaltır.
Politika amaç fonksiyonu, eylem dağılımının çeşitliliğini artırmak ve erken yakınsamayı önlemek amacıyla güncelleme işlemi sırasında düzenlileştirme ve entropi ödül terimleri ile genişletilmiştir. Her bir politika güncelleme turu, yuvarlanan eğitim (rolling training) için birden fazla deneyim yörüngesi örneği grubu (batch) kullanarak durum uzayındaki kapsama genişliğini korur. Çıktı eylem dizisinin olasılık dağılımı güncelleme öncesi ve sonrası karşılaştırıldığında, dağılımın sapma oranı hesaplanır ve sert bir eşik değeri ile politikanın kabul edilebilir bozulma aralığı filtrelenir. Bu mekanizma, döngüler arası aktarılan çizelgeleme politikaları için sınır kontrolü sağlayarak, kaynak durumundaki radikal değişikliklerden kaynaklanan aşırı öğrenmeyi (overfitting) engeller.
Strateji güncellemeleri, değer fonksiyonu tarafından sağlanan durum değerlendirmesine dayanır. Durum-değer tahminindeki sapmalar, avantaj fonksiyonunun doğruluğunu doğrudan etkileyebilir ve böylece strateji yinelemesinin yönünü değiştirebilir. Değerleme doğruluğunu artırmak için çok zaman serili bir geri izleme mekanizması oluşturulmuştur ve gelecekteki ödüllerin indirgenmiş kümülatif değeri, mevcut durum değerini düzeltmek için kullanılır. Geri izleme ödülü, aşağıdaki şekilde tanımlanan Genel Avantaj Tahmini (GAE) yapısını benimser:
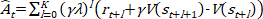 (6)
Ât düzeltilmiş avantaj değeridir; λ geri izleme denge katsayısıdır; rt+l (t+l). adımın anlık ödülünü temsil eder; V(st+l) değerleme ağı tarafından çıktı olarak verilen durum değeridir. Bu yapı, gelecek kaynak çatışmaları, pik yükler ve görev birikmeleri için stratejinin yanıt tahminlerindeki sapmaları düzeltmek amacıyla kısa vadeli anlık geri bildirimi ve uzun vadeli durum beklentilerini entegre eder. λ geri izleme derinliğini kontrol eder ve ani olaylara karşı değerleme ağının yanıtının dayanıklılığını artırmak için kaynak dinamiklerinin şiddetli dalgalandığı dönemlerde otomatik olarak ayarlanır.
Avantaj fonksiyonuna gömülmüş olan çok ölçekli zamana bağlı yapı, değerleme ağının uzun vadeli kaynak eğilimlerini modellemesine olanak tanır. Politika çıktı sapmasını tespit etmede, ağın değerleme hatasına aşırı tepki verip vermediğini değerlendirmek için politika davranış tutarlılık indeksi kullanılır. Geri besleme-fark kalıntı terimleri politika güncelleme davranışını izler; eğitim hedefi ve değer fonksiyonunun ağırlık güncelleme genliği dinamik olarak düzeltilir. Değer ağının ve politika ağının birlikte optimize edilmesi, yüksek frekanslı zamanlamanın kaynak çatışması durumunu yanlış değerlendirmesini önlerken, değer tahmininin görev tamamlama hedefinden sapmamasını sağlar.
Bu kararlı politika güncelleme mekanizması, yüksek boyutlu dinamik bir görev ortamında politika davranışı güncellemelerinin kontrol edilebilirliğini ve tutarlılığını etkili bir şekilde koruyabilir; görev kapsama verimliliğini ve kaynak kullanım esnekliğini artırarak sürekli iteratif bir akıllı çizelgeleme yapısı oluşturur. Çizelgeleme davranışı, uzun vadeli evrimde yerel optimuma düşmeyi önler ve görev modellerindeki değişikliklere ve kaynak döngülerindeki dalgalanmalara karşı genel adaptasyonu güçlendirir.
Şekil 3A, farklı kırpma eşiği koşulları altında hedef fonksiyon değerinin eğitim iterasyon sayısının bir fonksiyonu olarak eğilimini göstermektedir. Yatay eksen eğitim iterasyon sayısını, dikey eksen ise kırpılmış hedef fonksiyonun sayısal değerini temsil eder. ε değeri, farklı politika kayması kontrol gücü derecelerini temsil edecek şekilde 0,1, 0,2 ve 0,3 olarak ayarlanmıştır. Daha küçük bir ε değerine karşılık gelen eğri daha az dalgalanma göstermekte ve hedef fonksiyon kararlı kalmaktadır. ε = 0,1 olduğunda, genel hedef fonksiyon değeri 0,8 ile 1 arasında olup strateji güncellemesinin kademeli ve kararlı olduğunu göstermektedir. Ancak, daha büyük bir ε değeri belirgin dalgalanmalara yol açmaktadır. ε = 0,3 olduğunda, genel hedef fonksiyon değeri 0,65 ile 0,95 arasındadır ve hedef fonksiyon eğrisi daha büyük bir osilasyon genliği sergileyerek strateji güncelleme sürecindeki şiddetli sapma riskini yansıtmaktadır. Eşik ne kadar küçükse strateji o kadar kararlı olmakta, bu da yüksek kısıtlamalı çizelgeleme ortamları için uygun hale gelmektedir. Şekil 3B, farklı geri izleme denge katsayıları altında genelleştirilmiş avantaj tahminindeki değişimleri göstermektedir. Gelecekteki ödüllerin geri izleme derinliğini kontrol etmek için λ sırasıyla 0,8, 0,9 ve 1,0 olarak ayarlanmıştır. Eğri, λ ne kadar yüksekse GAE dalgalanmasının o kadar az olduğunu, uzun vadeli eğilimin daha pürüzsüz olduğunu ve birden fazla adımdan sonraki çizelgeleme davranışının potansiyel etkisini daha doğru yakaladığını göstermektedir. λ değeri 0,8 olan eğri belirgin periyodik dalgalanmalar sergilemekte, bu da anlık ödüllere karşı daha hassas olduğunu ve kısa vadeli, ani görevlere daha uygun olduğunu göstermektedir. Buna karşılık, 1,0'lık bir λ değeri daha çok uzun vadeli eğilim modellemesine odaklanmakta ve periyodik görev senaryoları için uygunluk göstermektedir.
Hesaplama karmaşıklığı ve ölçeklenebilirlik analizi
Önerilen Transformer-PPO çerçevesinin hesaplama karmaşıklığı iki ana bileşen tarafından belirlenir: Transformer kodlayıcı ve PPO politika optimizasyonu.
L katmanlı, H dikkat başlığına, d gömme boyutuna ve T giriş dizisi uzunluğuna (geçmiş zaman penceresi) sahip Transformer kodlayıcı için, ileri geçiş başına zaman karmaşıklığı O(L·T2·d + L·T·d2) şeklindedir; burada T2 terimi öz-dikkat mekanizmasından kaynaklanmaktadır. Uygulamada, L = 3, H = 4, d = 128 ve T 100 zaman adımı olarak sabitlenmiş olup, bu durum yönetilebilir bir hesaplama yükü ile sonuçlanmıştır. Daha uzun geçmiş penceresi durumlarında, kuadratik T2 terimi baskın faktör haline gelir; ancak pratikte, sendika faaliyet planlaması genellikle sonlu geçmiş ufukları (örneğin, bir çeyrek veya bir yıllık kayan pencereler) içerir ve doğruluk ile verimliliği dengelemek için zaman adımı çözünürlüğü ayarlanabilir.
PPO bileşeni için, politika ağı ve değer ağı, çıkarım karmaşıklığı O(d·m) olan hafif MLP'lerdir (gizli katman başına 256 ve 128 nöron); burada m, gizli birimlerin sayısıdır ve Transformer kodlayıcı ile karşılaştırıldığında ihmal edilebilir düzeydedir. Eğitim sırasındaki politika güncellemesi, B grup boyutu ve E güncelleme epok sayısı olmak üzere, O(B·E·d2) karmaşıklığa sahip çoklu epoklardan oluşan mini-batch gradyan güncellemelerini içerir.
Ölçeklenebilirlik açısından çerçeve üç avantajlı özellik sergilemektedir. Birincisi, dikkat mekanizması zaman adımları boyunca paralelleştirilebilir, bu da verimli GPU hızlandırmasına olanak tanır. İkincisi, kısıt matrisi sabit parametreler olarak gömülmek yerine her çizelgeleme adımı için dinamik olarak oluşturulduğundan, model boyutu aktivite veya kaynak sayısından bağımsızdır. Bu durum, eğitilmiş aynı modelin yeniden eğitime gerek kalmadan farklı ölçeklerdeki birliklerde konuşlandırılmasını sağlar. Üçüncüsü, aşırı büyük ölçekli senaryolar için, bir ödünleşim olarak geçmiş pencere uzunluğu T ve gömme boyutu d azaltılabilir veya O(T2) karmaşıklığını O(T log T) veya O(T) seviyesine indirmek için seyrek dikkat varyantı benimsenebilir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Deneysel veriler
Bu makalede sunulan Transformer-PPO dinamik çizelgeleme algoritmasının performansını kapsamlı bir şekilde değerlendirmek için deneyde, büyük bir işletme sendikasının son üç yıla ait faaliyet yönetim verileri kıyaslama veri seti olarak kullanılmıştır. Bu veri seti; toplantılar, eğitimler ve eğlence etkinlikleri dahil olmak üzere çeşitli türlerde 5.000'den fazla faaliyet kaydı ile mekanlar, ekipmanlar ve personel gibi çoklu kaynaklar için çizelgeleme bilgilerini içermektedir. Her kayıt...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Deneysel sonuçlar, önerilen Transformer-PPO algoritmasının tüm değerlendirme metriklerinde temel yöntemlerden (LSTM-PPO, açgözlü arama ve DQN) tutarlı bir şekilde daha yüksek performans gösterdiğini kanıtlamaktadır. Bu üstün performans iki temel faktöre bağlanabilir. İlk olarak, Transformer'ın çok başlı öz-dikkat mekanizması, aktivite ve kaynak durum dizilerindeki uzun vadeli zamansal bağımlılıkları etkili bir şekilde yakalayarak potansiyel çatışmaların proaktif olarak tanımlanmasını sağlar. Modelin kaynak çekişmesini me...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarlar, herhangi bir finansal çıkar çatışması olmadığını beyan ederler.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Temel programlama dili |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Derin öğrenme çerçevesi (Transformer/PPO uygulaması) |
| NumPy 1.23 | NumPy Geliştiricileri | # NumPy 1.23.0 Yayın Notları NumPy'nin 1.23.0 sürümü, yeni özellikler, performans iyileştirmeleri ve çeşitli hata düzeltmeleri sunmaktadır. ## Yeni Özellikler ### Genel * `numpy.typing` modülüne yeni tip belirteçleri eklendi. * `numpy.promote_types` fonksiyonu, belirli durumlar için güncellendi. ### Matris İşlemleri * `numpy.matrix` sınıfı için bazı yöntemler optimize edildi. ## İyileştirmeler * Dizi indeksleme operasyonlarının hızı artırıldı. * Bellek yönetimi ve tahsisi konusunda optimizasyonlar yapıldı. * `numpy.linalg` modülündeki belirli fonksiyonların çalışma süresi kısaltıldı. ## Değişiklikler ve Kaldırılan Özellikler * Artık desteklenmeyen bazı eski fonksiyonlar kaldırıldı. * Bazı parametrelerin varsayılan değerleri, tutarlılığı artırmak adına güncellendi. ## Hata Düzeltmeleri * Çeşitli modüllerde karşılaşılanle ilgili kritik hatalar giderildi. * Sınır durumlarındaki (edge cases) hesaplama hataları düzeltildi. * Tip dönüşümleri sırasında meydana gelen bellek sızıntıları giderildi. ## Bağımlılıklar * Minimum Python sürümü gereksinimleri güncellendi. * Sürümle uyumlu kütüphanelerin güncel versiyonları tanımlandı. | Sayısal hesaplama kütüphanesi |
| Matplotlib 3.5 | Matplotlib Geliştirme Ekibi | # Matplotlib'i Yükleme Matplotlib'i yüklemek için en kolay yol, `pip` paket yöneticisini kullanmaktır. ## Pip ile Yükleme `pip` üzerinden yükleme yapmak için aşağıdaki komutu kullanın: ```bash pip install matplotlib ``` ## Anaconda ile Yükleme Anaconda veya Miniconda kullanıyorsanız, Matplotlib'i `conda` aracılığıyla yükleyebilirsiniz: ```bash conda install matplotlib ``` ## Kaynak Koddan Yükleme Kendi sisteminize uygun şekilde kaynak koddan yüklemek isterseniz, öncelikle gerekli bağımlılıkların yüklü olduğundan emin olun. Ardından, kaynak kodu indirip şu adımları takip edin: 1. Kaynak kodun bulunduğu dizine gidin. 2. Yükleme işlemini başlatmak için şu komutu çalıştırın: ```bash python setup.py install ``` ## Bağımlılıklar Matplotlib'in düzgün çalışabilmesi için aşağıdaki kütüphanelerin yüklü olması gerekir: - NumPy - KiTeX (isteğe bağlı, bazı yazı tipleri için) - Pillow (görüntü işleme için) - PyOpenGL (isteğe bağlı, 3D grafikler için) ## Yükleme Doğrulaması Yüklemenin başarılı olduğunu doğrulamak için Python terminaline şu komutları girin: ```python import matplotlib print(matplotlib.__version__) ``` Sürüm numarası ekranda görünüyorsa, Matplotlib başarıyla yüklenmiş demektir. | Sonuçların görselleştirilmesi |
| Sendika faaliyet planlama veri seti | İş birliği yapılan bir kurumun dahili veri tabanı (anonimleştirilmiştir) | Gizlilik sözleşmesi nedeniyle kamuya açık değildir; araştırmacılar erişim için sorumlu yazarla iletişime geçebilirler | Büyük bir işletme sendikasından üç yıla yayılan 5.000'den fazla etkinlik kaydı (toplantılar, eğitimler, eğlenceler) |
| NVIDIA A100 GPU | |||
| PyTorch |
Kaynaklar
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.