Bu çalışma; Alzheimer hastalığını, frontotemporal demansı ve sağlıklı kontrolleri ayırt etmek için elektroensefalografi biyobelirteçlerini incelemektedir. Kök ortalama kare, güç spektral yoğunluğu ve entropi özelliklerini kullanan Rastgele Orman modelleri, açıklanabilir yapay zeka ve etki büyüklüğü analizi kullanılarak yorumlanmıştır. Düşük etkili entropi özelliklerinin çıkarılması, sınıflandırma performansını artırarak %94 test doğruluğuna ulaşılmasını sağlamıştır.
Araştırma makalesi
Makine Öğrenimi Tabanlı Demans Sınıflandırması için Çok Alanlı Elektroensefalografi Biyobelirteç Füzyonu
Bu makalede
Özet
Özet
Elektroensefalografi (EEG), nörodejeneratif durumlarda beyin aktivitesini karakterize etmek için noninvaziv bir yaklaşım olarak araştırılmıştır. Bu çalışma, çok alanlı EEG biyobelirteçlerinin Alzheimer hastalığını (AD), frontotemporal demansı (FTD) ve sağlıklı kontrolleri (HC) ayırt edip edemeyeceğini değerlendirmiştir. Kamuya açık veri seti; 36 AD, 23 FTD ve 29 sağlıklı kontrol olmak üzere toplam 88 katılımcıdan alınan, dinlenme durumunda ve gözler kapalıyken kaydedilmiş EEG kayıtlarını içermektedir. Makine öğrenmesi sınıflandırması için çok alanlı EEG biyobelirteçleri ve demografik özellikler çıkarılmıştır. EEG kaynaklı özellikler arasında karekök ortalama (RMS), güç spektral yoğunluğu (PSD) ve entropi ölçümleri yer almıştır. Birleştirilmiş özellik seti kullanılarak bir Random Forest sınıflandırıcısı eğitilmiş ve açıklanabilir yapay zeka kullanılarak yorumlanmıştır. Özellik katkılarını değerlendirmek için özellik kararlılığı ve Cohen’s d etki büyüklüğü analizleri yapılmış, ardından bir ablasyon analizi gerçekleştirilmiştir. Entropi tabanlı özelliklerin sınıflandırmaya en düşük katkıyı sağladığı görülmüştür. Tam çok alanlı model %96 eğitim doğruluğuna ve %92 test doğruluğuna ulaşmıştır. Entropi özelliklerinin kaldırılmasından sonra test doğruluğu %94'e yükselmiştir. Bu sonuçlar, seçilen çok alanlı EEG ve demografik özelliklerin Random Forest çerçevesindeki sınıflandırma performansını tanımlamaktadır.
Giriş
Alzheimer hastalığı (AH), bilişsel ve motor fonksiyonlardaki bozulma ile ilişkili ilerleyici bir nörolojik durumdur. Prevalansı yaşla birlikte önemli ölçüde artar ve demans, yaşlı yetişkinler arasında morbidite ve mortalitenin temel nedenlerinden biridir1,2,3,4,5. Tanı ve hastalık sınıflandırması zor olmaya devam ettiği için, beyin sinyallerinin analizi, demans ile ilişkili nörofizyolojik değişiklikleri karakterize etmenin bir yolu olarak araştırılmıştır.
Elektroensefalografi (EEG), beynin elektriksel aktivitesini kaydetmek için kullanılan noninvaziv bir yöntemdir ve Alzheimer hastalığı ile diğer nörolojik bozukluklarda araştırılmıştır6,7,8,9,10,11. EEG sinyalleri, nöronal aktivite tarafından oluşturulan elektriksel potansiyelleri yansıtır ve kafa derisinin birden fazla noktasından noninvaziv olarak kaydedilir12,13,14. Beyin aktivitesi yaygın olarak delta, theta, alfa, beta ve gama frekans bantları kullanılarak karakterize edilir15. Alzheimer hastalığı; EEG yavaşlaması, azalmış sinyal karmaşıklığı ve değişmiş senkronizasyon ile ilişkilendirilmiştir16. Spektral analizler, AD'li bireylerde sağlıklı kontrollere kıyasla artmış delta ve theta aktivitesinin yanı sıra azalmış alfa ve beta aktivitesi rapor etmiştir17,18,19. Önceki EEG sınıflandırma çalışmaları, AD'nin sağlıklı kontrollerden (HC) ve frontotemporal demansın (FTD) HC'den ayırt edilmesinde yüksek performans bildirmiştir. Buna karşılık, AD ve FTD arasındaki ayrım genellikle daha zorlayıcı olmuştur10,11.
Makine öğrenimi yöntemleri, nörolojik hastalıklarla ilişkili EEG sinyallerindeki örüntüleri belirlemek için kullanılmıştır20,21. Bu nedenle özellik çıkarımı, EEG tabanlı sınıflandırmanın önemli bir bileşenidir. Önceki çalışmalar; spektral, temporal, karmaşıklık ve fonksiyonel bağlantı özelliklerini makine öğrenimi modelleriyle kombinasyon halinde incelemiştir3,15,22,23. Spektral özellikler, özellikle AD'de rapor edilen azalmış alfa aktivitesi ve artmış teta aktivitesi dahil olmak üzere beyin aktivitesindeki frekansa bağlı değişimleri nicelleştirdikleri için oldukça önemlidir23,24,25,26.
Birkaç EEG tabanlı çalışma; özelliklerin, sınıflandırıcıların ve doğrulama stratejilerinin farklı kombinasyonlarını değerlendirmiştir. Bağlantı tabanlı analizler AD, FTD ve HC'yi ayırt etmek için kullanılmış olup, bildirilen sınıflandırma performansı yapılan karşılaştırmaya ve özellik seçme prosedürüne bağlı olarak değişkenlik göstermiştir27. Fourier tabanlı özellikler de AD, hafif bilişsel bozukluk (MCI) ve sağlıklı kontrolleri ayırt etmek için değerlendirilmiş olsa da, sınırlı ön işleme ve doğrulama stratejisiyle ilişkili olası aşırı uyum (overfitting) gibi kısıtlılıklar bildirilmiştir28. Doğrusal olmayan EEG karmaşıklık ölçümleri, AD sınıflandırması için ayırt edici potansiyel göstermiş ve bazıları yüksek doğruluk, duyarlılık ve özgüllüğe ulaşmış olsa da, bunların MCI ve hastalık evresi ayrımındaki uygulanabilirliği sınırlı kalmaya devam etmektedir21.
Zaman-frekans EEG temsillerine dayalı derin öğrenme yöntemleri, AD, MCI ve HC'nin çok sınıflı sınıflandırması için de araştırılmıştır29. Yüksek sınıflandırma performansı bildirilmiş olsa da, sınırlamalar arasında küçük veya seçilmiş kohortlar, sınıf dengesizliği, heterojen hastalık şiddeti, harici doğrulamanın eksikliği ve azalmış model yorumlanabilirliği yer almaktadır29. Doğrulama stratejisi de önemli bir metodolojik husustur. Katılımcıdan bağımsız yaklaşımlar, aynı katılımcıdan alınan epoch'ların hem eğitim hem de test setlerinde yer aldığı durumlarda, geleneksel epoch düzeyindeki çapraz doğrulamanın performansı olduğundan yüksek gösterebileceğini kanıtlamıştır30. Bu sınırlama, özellikle farklı doğrulama şemaları kullanan çalışmalar arasındaki sınıflandırma sonuçlarını karşılaştırırken önem taşımaktadır.
Karmaşıklık ve bağlantısallık ölçümleri, destek vektör makinesi sınıflandırıcıları kullanılarak da değerlendirilmiş; faz tabanlı bağlantısallık ve çok ölçekli entropi farklı düzeylerde ayırt edici performans sergilemiştir31,32. Fourier ve dalgacık türevli özelliklerin kullanıldığı diğer çalışmalar; AD, MCI ve HC karşılaştırmalarında değişken performanslar bildirmiş, çok sınıflı sınıflandırmanın genel olarak ikili sınıflandırmadan daha zor olduğu görülmüştür14. Entropi ve senkronite tabanlı yaklaşımlar ek olarak AD ve kontrol grupları arasında ayrım yapabildiğini göstermiştir, ancak kontrol popülasyonunun özellikleri gözlemlenen etki boyutunu etkileyebilir2.
Bu çalışma, EEG frekans bantlarından elde edilen karekök ortalama kare (RMS), güç spektral yoğunluğu (PSD) ve entropi ölçümlerinden oluşan çok alanlı bir öznitelik setini ve demografik bir değişken olarak yaşı değerlendirmektedir. RMS, her bir frekans bandındaki sinyal genliğini temsil ederken; PSD, frekans alanı gücünü temsil eder. Entropi, sinyal karmaşıklığının bir ölçüsü olarak dahil edilmiştir. Bu öznitelikler, EEG aktivitesinin tamamlayıcı tanımlamalarını sağlar ve bir Random Forest sınıflandırıcısı kullanılarak değerlendirilir. Çalışma ayrıca, elde edilen özniteliklerin göreceli katkısını belirlemek için öznitelik önemini, öznitelik stabilitesini, açıklanabilir yapay zekayı ve etki büyüklüğü analizini incelemektedir. Bu çalışma; spektral, zamansal ve karmaşıklık tabanlı ölçümler dahil olmak üzere çok alanlı EEG özniteliklerinin, makine öğrenimi kullanarak Alzheimer hastalığını (AD), frontotemporal demansı (FTD) ve sağlıklı kontrolleri (HC) ayırt etmedeki etkinliğini araştırmaktadır. Ayrıca, güç spektral yoğunluğu (PSD), karekök ortalama kare (RMS) ve entropi ölçümleri kullanıldığında, hangi EEG frekans bandı özniteliklerinin sınıflandırmaya en güçlü katkıyı sağladığını incelemektedir. Buna ek olarak çalışma, PSD ve RMS dahil güç tabanlı özniteliklerin katkılarını, entropi tabanlı özniteliklerin katkılarıyla karşılaştırmakta ve yaşın sınıflandırma modeline olan katkısını değerlendirmektedir.
Protokol
EEG ön işleme, öznitelik çıkarımı ve sınıflandırma iş akışının şematik bir genel görünümü Şekil 1'de gösterilmiştir. Çalışmada kullanılan materyaller ve yazılımlar Materyaller Tablosunda listelenmiştir.
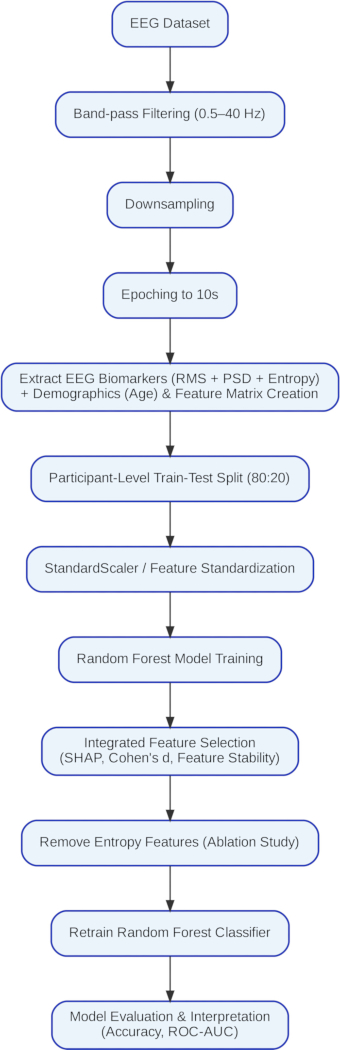
Şekil 1: EEG ön işleme, özellik çıkarımı ve sınıflandırma boru hattının iş akışı. EEG veri doğrulaması, bant geçiren filtreleme ve yeniden referanslama, karekök ortalama (RMS), güç spektral yoğunluğu (PSD) ve entropi özelliklerinin çıkarılması, yaş bilgisinin eklenmesi, eğitim-test ayırımı, Random Forest model geliştirme, özellik stabilitesi analizi, SHAP analizi, Cohen’s d etki büyüklüğü analizi, entegre özellik seçimi, entropi özelliği ablasyonu, modelin yeniden eğitilmesi ve performans değerlendirmesini içeren çalışma iş akışının şematik genel görünümü. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
1. Veri edinimi
Kamuya açık dinlenme durumu EEG veri seti, OpenNeuro deposundan (veri seti ds004504, sürüm 1.0.9) elde edilmiştir33. Katılımcı etiketleri ve demografik bilgiler doğrulanmıştır. Veri seti; 36 Alzheimer hastalığı (AD) olan katılımcı, 23 frontotemporal demans (FTD) olan katılımcı ve 29 sağlıklı kontrol (HC) olmak üzere toplam 88 katılımcıdan oluşmaktadır.
2. EEG kaydı içe aktarma
Her katılımcı için EEG kaydı MNE-Python kütüphanesi kullanılarak yüklendi. Her EEG dosyasının erişilebilir olduğu, başarıyla içe aktarılabildiği ve geçerli bir katılımcı tanımlayıcısı içerdiği doğrulandı. Dosyaları eksik veya bozuk olan kayıtlar çalışma dışı bırakıldı. Bu aşamada 500 Hz olan orijinal EEG örnekleme frekansı korundu. Hesaplama yükünü azaltmak amacıyla, bu çalışma için klinik olarak ilgili tüm EEG bilgileri korunarak sinyallerin örnekleme hızı düşürüldü.
3. Bant geçiren filtreleme
Sürekli EEG kayıtları, 0.5 Hz alt kesim frekansına ve 40 Hz üst kesim frekansına sahip dördüncü dereceden bir bant geçiren filtre kullanılarak filtrelenmiştir.
4. Ortak ortalama referanslama ve epoklama
Filtrelenmiş EEG kayıtlarına ortak ortalama referanslama (CAR) uygulandı. Her zaman örneğinde, mevcut tüm EEG kanalları genelindeki ortalama sinyal hesaplandı ve her bir kanaldan çıkarıldı. Referanslanmış EEG sinyalleri sonraki analizler için saklandı. Her bir referanslanmış EEG kaydı, MNE-Python'daki make_fixed_length_epochs() fonksiyonu kullanılarak sabit uzunluktaki epoklara bölündü. 0 s örtüşmeli 10 s'lik bir epok süresi kullanıldı.
5. Epok doğrulaması
Her katılımcı için yalnızca tamamlanmış 10s epoklar tutuldu. Bir kaydın sonunda kalan 10 s'den kısa olan tüm EEG segmentleri atıldı. Tutulan her epok, daha sonra öznitelik çıkarımı için bireysel bir örnek olarak kullanıldı.
6. Özellik hazırlama
Kaynak veri setinde Mini-Mental Durum Muayenesi (MMSE) verileri mevcut olsa da, bunlar mevcut analizden hariç tutulmuştur. Çıkartılan EEG özellikleri, participants.csv meta veri dosyasından elde edilen yaş ve tanı etiketleri dahil katılımcı demografik bilgileriyle birleştirilmiştir. Katılımcı tanımlayıcısı ortak anahtar olarak kullanılmış ve yalnızca hem EEG özellik kayıtları hem de karşılık gelen demografik bilgileri olan katılımcılar tutulmuştur.
Çok alanlı özellik matrisi; beş kök ortalama kare (RMS) özelliğini (delta_rms, theta_rms, alpha_rms, beta_rms ve gamma_rms), beş güç spektral yoğunluğu (PSD) özelliğini (delta_psd, theta_psd, alpha_psd, beta_psd ve gamma_psd) ve beş entropi özelliğini (delta_entropy, theta_entropy, alpha_entropy, beta_entropy ve gamma_entropy) içermekteydi. Yaş, tamamlayıcı bir demografik değişken olarak eklenmiştir. Yaş dağılımları tanı grupları arasında farklılık gösterebileceğinden, demografik karıştırıcı etkiler tamamen dışlanamamıştır. AD, HC veya FTD olarak tanımlanan tanı grubu, hedef etiket olarak atanmıştır.
7. Veri ön işleme ve eğitim-test bölümleme
Ön işleme sırasında, ilgilenilen EEG frekans bilgileri korunurken hesaplama gereksinimlerini azaltmak için kayıtlar 500 Hz'den 250 Hz'e düşürülmüştür.
Veri seti, gruplandırılmış bölme stratejisi kullanılarak denek düzeyinde eğitim (%80) ve test (%20) alt kümelerine ayrılmıştır. Denek düzeyindeki tahminler, daha sonra her bir katılımcıya ait tahmin edilen epoklar üzerinden çoğunluk oylamasıyla elde edilmiştir. Birincil değerlendirmede, aynı katılımcıya ait epokların her iki alt kümede birden yer almasını önlemek için denek düzeyinde gruplandırılmış eğitim-test bölmesi kullanılmıştır. Denek düzeyindeki tahminler, her bir katılımcıya ait tahmin edilen epoklar üzerinden çoğunluk oylamasıyla elde edilmiştir. Veri seti eksik değerler açısından incelenmiş ve eksik gözlemler uygun şekilde kaldırılmış veya atanmıştır. Tanı etiketleri kodlanmıştır. Eğitim verileri üzerinde bir StandardScaler eğitilmiş ve ardından hem eğitim hem de test veri setlerine uygulanmıştır.
8. Rastgele orman modelinin geliştirilmesi
80 ağaç, 10 maksimum ağaç derinliği, maksimum dört özellik, yaprak başına minimum beş örnek ve 42 rastgele durum (random state) kullanılarak bir Rastgele Orman (Random Forest) sınıflandırıcısı başlatıldı. Sınıflandırıcı, standardize edilmiş eğitim veri seti kullanılarak eğitildi.
9. Model değerlendirmesi
Hem eğitim hem de test veri setleri için sınıf etiketleri tahmin edildi. Bir hata matrisi oluşturuldu ve sınıflandırma raporu ile birlikte doğruluk, kesinlik, duyarlılık ve F1-skoru hesaplandı. Eğitim ve test doğrulukları kaydedildi.
Katılımcı bazlı değerlendirme için, belirli bir katılımcıya ait tüm epokların yalnızca eğitim veya test alt kümesine atandığından emin olun. Random Forest sınıflandırıcı, birincil analizdekiyle aynı hiperparametreler kullanılarak eğitilmiştir.
10. Çapraz doğrulama
Ek bir model değerlendirme prosedürü olarak, shuffle = True ve random_state = 30 kullanılarak beş katlı tabakalı çapraz doğrulama gerçekleştirilmiştir. Beş kat arasındaki ortalama doğruluk ve standart sapma hesaplanmıştır. Bu analiz, birincil denek düzeyindeki ayrılmış veri seti (holdout) değerlendirmesinden ayrı olarak ele alınmıştır.
11. Özellik kararlılık analizi
Özellik kararlılığı, 0'dan 9'a kadar rastgele tohumlar kullanılarak Rastgele Orman (Random Forest) eğitimi 10 kez tekrarlanarak değerlendirilmiştir. Her çalışma için test doğruluğu ve özellik önem skorları kaydedilmiştir. Her bir öngörücü için özellik önem skorunun ortalaması ve standart sapması 10 çalışma boyunca hesaplanmış ve öngörücüler kararlılıklarına göre sıralanmıştır. Bu analiz, birincil denek düzeyindeki değerlendirmenin yerini almaktan ziyade, özellik sıralamalarının tutarlılığını değerlendirmek için kullanılmıştır.
12. Açıklanabilir yapay zeka analizi
Eğitilmiş Random Forest modeline SHAP TreeExplainer uygulandı. Her bir özelliğin model tahminlerine olan katkısını tahmin etmek için SHAP değerleri hesaplandı. Her özellik için ortalama mutlak SHAP değeri hesaplandı ve özellikler SHAP katkılarına göre sıralandı. Tutarlı şekilde düşük SHAP değerlerine sahip özellikler belirlendi ve özellik stabilitesi ile Cohen’s d analizlerinin sonuçlarıyla karşılaştırıldı. Sürekli olarak düşük katkı gösteren özellikler, sonraki ablasyon ve model yeniden eğitimi işlemleri için seçildi.
13. İstatistiksel etki büyüklüğü analizi
AD için her bir EEG biyobelirteci için Cohen’s d hesaplanmıştır karşı SC, AD karşısında FTD ve FTD karşı HC karşılaştırmaları. Etki büyüklükleri; küçük etki için 0,20, orta etki için 0,50 ve büyük etki için 0,80 eşik değerleri kullanılarak yorumlanmıştır.
14. Entegre özellik seçimi
Random Forest özellik önemi analizi, SHAP analizi ve Cohen’s d analizi sonuçları karşılaştırıldı. Tutarlı bir şekilde düşük özellik önemi, düşük SHAP katkısı ve küçük etki boyutları sergileyen öngördürücüler, çıkarılacak adaylar olarak belirlendi.
15. Özellik ablasyonu
Entropi özellikleri keşifsel bir ablasyon analizinde değerlendirilmiş ve RMS, PSD ve yaş içeren indirgenmiş bir özellik matrisi oluşturulmuştur. Random Forest sınıflandırıcısı aynı hiperparametreler kullanılarak yeniden eğitilmiştir. Model eğitimi, test etme, çapraz doğrulama ve alıcı işletim karakteristik (ROC) analizi, indirgenmiş özellik seti kullanılarak tekrarlanmıştır.
16. ROC analizi
Sınıf olasılıkları, optimize edilmiş Random Forest sınıflandırıcısından elde edilmiştir. Çok sınıflı ROC eğrileri, bir-karşı-dinlenme stratejisi. Sınıfa özgü eğri altı alan (AUC) değerleri ve ortalama AUC hesaplandı.
17. Performans karşılaştırması
Tam öznitelik modelinin performansı, entropi-öznitelik ablasyonu sonrası elde edilen indirgenmiş öznitelik modelinin performansıyla karşılaştırılmıştır.
Sonuçlar
Random Forest modeli %96 eğitim doğruluğu ve %92 test doğruluğu elde etmiştir. Makro-ortalama F1-skoru %92, ağırlıklı-ortalama F1-skoru ise yine %92 olarak belirlenmiş olup bu durum üç sınıf arasında karşılaştırılabilir bir performansa işaret etmektedir. Sınıflandırma performansı Alzheimer hastalığı (AD) sınıfı için en yüksek seviyedeyken, Tablo 1'de sunulduğu üzere frontotemporal demans (FTD) sınıfı nispeten daha düşük bir performans göstermiştir.
Sınıflandırma eşikleri genelindeki sınıf ayrımını değerlendirmek için Alıcı İşletim Karakteristiği (ROC) analizi kullanılmıştır. Şekil 2'de gösterildiği gibi, ROC eğrisinin altında kalan alan (AUC) her üç sınıf için de 0,98'i aşmış olup; bu durum AD, FTD ve sağlıklı kontrol (HC) grupları arasında yüksek ayrıştırılabilirlik olduğunu göstermektedir.
Random Forest sınıflandırma modeline öznitelik katkılarını değerlendirmek için TreeExplainer kullanılarak SHAP analizi gerçekleştirilmiştir. Şekil 3'teki özet çubuk grafiği; güç spektral yoğunluğu (PSD), karekök ortalama kare (RMS), entropi ve demografik özelliklerin göreceli katkısını göstermiştir. Mutlak SHAP değerleri daha yüksek olan öznitelikler model tahminlerine daha güçlü katkı sağlarken, entropi ile ilgili öznitelikler karşılaştırmalı olarak düşük katkılar göstermiştir.
Özellik kararlılığı analizi, belirtilen rastgele tohumlar boyunca Random Forest eğitiminin tekrarlanmasıyla gerçekleştirilmiştir. Her çalışma için test doğruluğu ve özellik önem skorları kaydedilmiş, özellik öneminin ortalaması ve standart sapması hesaplanmıştır. Model bu analizde, 0,17% standart sapma ile 95% ortalama sınıflandırma doğruluğu elde etmiştir. Bu tekrarlı çalışmalar temel olarak özellik sıralamalarının tutarlılığını değerlendirmek için kullanılmış ve birincil denek düzeyindeki ayırma (holdout) değerlendirmesinden ayrı olarak ele alınmıştır. Tablo 2'de gösterildiği gibi, özellik kararlılığı analizinde yaş yüksek bir sıralama almıştır. theta_psd ve theta_rms özellikleri de yüksek sıralama alırken; alpha_psd, alpha_rms, beta_psd ve beta_rms orta düzeyde özellik önemi göstermiştir.
Tablo 3'te sunulduğu üzere, grup farklarının büyüklüğünü değerlendirmek için Cohen’s d hesaplanmıştır. Alfa bandı atenüasyonu (alpha_rms, d = 0.97; alpha_psd, d = 0.87) ve artmış teta aktivitesi (theta_rms, d = 0.72), AD'li katılımcılar ve sağlıklı kontroller arasında bildirilen en büyük farkları göstermiştir. Bu bulgular, demans EEG çalışmalarında bildirilen kortikal yavaşlama ile tutarlıdır34. Entropi tabanlı özellikler karşılaştırmalı olarak daha küçük etki büyüklükleri göstermiştir. AD ve FTD arasındaki karşılaştırmalar ağırlıklı olarak küçükten orta düzeyde etki büyüklükleri üretmiştir.
Alfa bandı özellikleri, AD-karşı-HC ve FTD-karşı-HC karşılaştırmaları için büyük etki büyüklükleri göstermiştir. AD karşı HC için bildirilen etki büyüklükleri, alpha_psd için −0.87 ve alpha_rms için −0.97 olmuştur. FTD karşı HC için alfa bandı sönümlenmesi −0.73 idi. theta_psd özelliği, AD karşı HC için 0.61'lik bir etki büyüklüğü gösterirken, theta_rms 0.72'lik bir etki büyüklüğü göstermiştir. AD karşı FTD için daha küçük farklar gözlemlenmiştir.
Beta bandı özellikleri ağırlıklı olarak küçükten orta ölçeğe grup etki büyüklükleri göstermiştir. Beta_psd etki büyüklükleri AD versus HC için −0.35 ve AD versus FTD için −0.41 iken, beta_rms çoğunlukla küçük etkiler göstermiştir. Gamma bandı özellikleri bazı karşılaştırmalar için orta düzeyde etkiler göstermiştir. Gamma_psd etki büyüklüğü FTD versus HC için 0.47 ve AD versus HC için 0.20 iken, gamma_rms FTD versus HC için 0.50'lik bir etki büyüklüğü göstermiştir.
Delta PSD ve RMS, AD versus HC (sırasıyla 0,29 ve 0,34) ve FTD versus HC (sırasıyla 0,25 ve 0,25) için küçük pozitif etki büyüklükleri göstermiştir. AD versus FTD için etki büyüklükleri sıfıra yakın bulunmuştur. Delta entropisi, üç karşılaştırmanın tamamında küçük etki büyüklükleri göstermiştir (0,08, 0,20 ve −0,11).
Öznitelik kararlılığı, SHAP ve etki büyüklüğü analizleri, entropi özniteliklerinin katkılarının karşılaştırmalı olarak düşük olduğunu göstermiştir. Sonuç olarak, entropi öznitelikleri hariç tutularak ve RMS, PSD ile yaş değerleri korunarak bir ablasyon analizi gerçekleştirilmiştir. Öznitelik ablasyonunun ardından, Rastgele Orman (Random Forest) modeli %96 eğitim doğruluğu ve %94 test doğruluğu elde etmiştir. Bu sonuç, değerlendirilen öznitelik seçimi çerçevesi içinde keşifsel bir karşılaştırma olarak yorumlanmıştır. AD, HC ve FTD sınıfları için kesinlik, duyarlılık, F1-skoru ve destek değerleri Tablo 4'te sunulmuştur.
Entropi özelliği ablasyonu öncesindeki ve sonrasındaki performans Tablo 5'te karşılaştırılmıştır. Entropi kaldırıldıktan sonra test doğruluğu %92'den %94'e yükselmiştir. Sınıf bazlı değişiklikler Tablo 6'da sunulmuştur. FTD için kesinlik %4, F1-skoru ise %2 oranında artmıştır. HC grubu için duyarlılık %4 artarken, kesinlik %2 azalmıştır. Özellik ablasyonu sonrası makro-ortalama ve ağırlıklı-ortalama performans ölçümleri yaklaşık %1–2 oranında artmıştır.
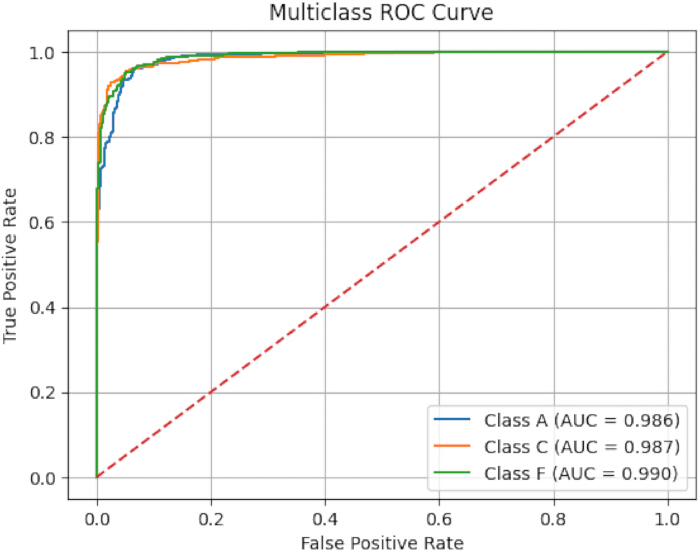
Şekil 2Alzheimer hastalığı, frontotemporal demans ve sağlıklı kontroller için alıcı işletim karakteristik eğrileri. Tekli-yaklaşımla oluşturulan çok sınıflı alıcı işletim karakteristik (ROC) eğrilerikarşıAlzheimer hastalığı (A sınıfı), frontotemporal demans (F sınıfı) ve sağlıklı kontroller (C sınıfı) için dinlenme stratejisi. Her bir sınıf için eğri altındaki alan (AUC) hesaplanmıştır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
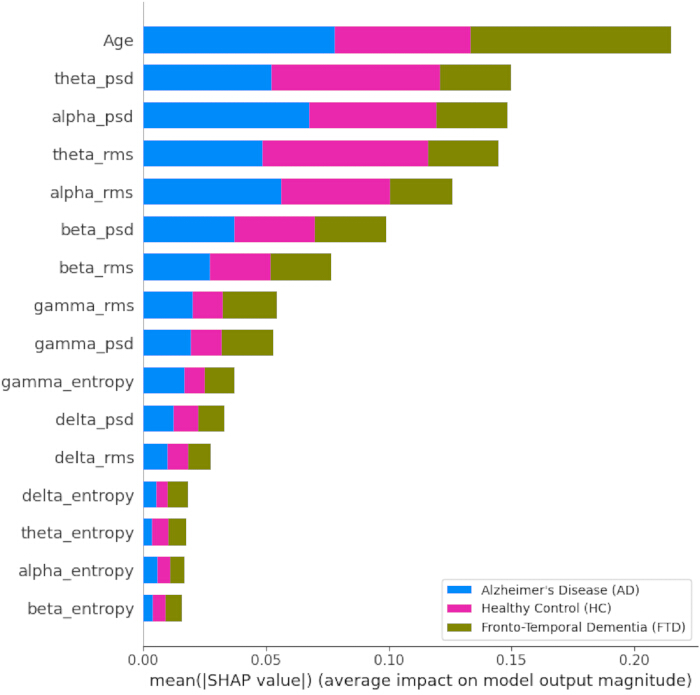
Şekil 3: Eğitilmiş Random Forest modelinin SHAP özet analizi. EEG türevli ve demografik özelliklerin Random Forest sınıflandırma modeline göreceli katkısını gösteren özet çubuk grafiği. Kök ortalama kare (RMS), güç spektral yoğunluğu (PSD), entropi ve yaş özelliklerinin katkılarını sıralamak için ortalama mutlak SHAP değerleri kullanılmıştır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
| Hassasiyet | Geri çağırma | F1-Skoru | Destek | |
| Alzheimer hastalığı | 0.92 | 0.95 | 0.94 | 579 |
| Kontrol | 0.93 | 0.92 | 0.93 | 480 |
| Frontotemporal Demans | 0.93 | 0.87 | 0.9 | 314 |
| Makro ortalama | 0.93 | 0.92 | 0.92 | 1373 |
| Ağırlıklı ortalama | 0.93 | 0.92 | 0.92 | 1373 |
Tablo 1: Test verileri üzerindeki sınıflandırma raporu. Test veri setindeki Alzheimer hastalığı, sağlıklı kontrol ve frontotemporal demans sınıfları için kesinlik (precision), duyarlılık (recall), F1-skoru ve destek (support) değerleri ile birlikte makro-ortalama ve ağırlıklı-ortalama performans ölçümleri.
| Özellik | Ortalama | Standart Sapma |
| Yaş | 0.1966 | 0.0017 |
| teta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alfa_psd | 0.0824 | 0.0022 |
| alfa_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropi | 0.0326 | 0.0008 |
| alfa_entropi | 0.0325 | 0.0006 |
| beta_entropi | 0.0283 | 0.0009 |
| theta_entropisi | 0.0258 | 0.0004 |
| delta_entropi | 0.0255 | 0.0005 |
Tablo 2: Random Forest modelinin özellik-stabilite sıralaması. 0 – 9 arasındaki rastgele tohumlar kullanılarak tekrarlanan Random Forest eğitiminden elde edilen ortalama özellik-önem değerleri ve bunlara karşılık gelen değişkenlik. Özellikler, çalışmalar boyunca sergiledikleri stabiliteye göre sıralanmıştır.
| Özellik | AD karşı HC | AD karşı Frontotemporal Demans | FTD karşısında HC |
| Delta PSD | 0.293 | -0.069 | 0.253 |
| Theta PSD | 0.612 | 0.23 | 0.355 |
| Alfa PSD | -0.869 | -0.219 | -0.64 |
| Beta PSD | -0.352 | -0.408 | 0.201 |
| Gamma PSD | 0.201 | -0.326 | 0.468 |
| Delta Entropi | 0.081 | 0.199 | -0.111 |
| Theta Entropisi | 0.208 | 0.033 | 0.163 |
| Alfa Entropi | -0.061 | 0.071 | -0.137 |
| Beta Entropisi | -0.37 | -0.042 | -0.332 |
| Gamma Entropisi | -0.338 | 0.047 | -0.391 |
| Delta RMS | 0.342 | 0.041 | 0.251 |
| Theta RMS | 0.718 | 0.354 | 0.318 |
| Alfa RMS | -0.977 | -0.205 | -0.73 |
| Beta RMS | -0.494 | -0.365 | 0.015 |
| Gamma RMS | 0.187 | -0.33 | 0.5 |
Tablo 3: Tanı grupları arasında Cohen’s d etki büyüklüğü karşılaştırması. Alzheimer hastalığı karşı sağlıklı kontrol, Alzheimer hastalığı karşı frontotemporal demans ve frontotemporal demans karşı sağlıklı kontrol karşılaştırmaları için EEG biyobelirteçlerine ait Cohen’s d değerleri.
| Hassasiyet | Geri Çağırma | F1-Skoru | Destek | |
| Alzheimer hastalığı | 0.94 | 0.95 | 0.94 | 579 |
| Kontrol | 0.91 | 0.96 | 0.94 | 480 |
| Frontotemporal Demans | 0.97 | 0.89 | 0.92 | 314 |
| Makro ortalama | 0.94 | 0.93 | 0.93 | 1373 |
| Ağırlıklı ort. | 0.94 | 0.94 | 0.94 | 1373 |
Tablo 4: Özellik ablasyonu sonrası sınıflandırma raporu. Entropi özelliklerinin kaldırılması ve Random Forest modelinin yeniden eğitilmesinin ardından Alzheimer hastalığı, sağlıklı kontrol ve frontotemporal demans sınıfları için kesinlik, duyarlılık, F1-skoru ve destek değerleri.
| Metrik | Ablasyon Öncesi | Ablasyon Sonrası | Değişim |
| Eğitim Doğruluğu | 0.96 | 0.96 | %0 değişim |
| Test Doğruluğu | 0.92 | 0.94 | +%2 iyileşme |
| Makro Hassasiyet | 0.93 | 0.94 | +%1 iyileşme |
| Makro Hatırlama | 0.92 | 0.93 | +%1 iyileşme |
| Makro F1-Skoru | 0.92 | 0.93 | +%1 iyileşme |
| Ağırlıklı Kesinlik | 0.93 | 0.94 | +%1 iyileşme |
| Ağırlıklı Duyarlılık | 0.92 | 0.94 | %2 iyileşme |
| Ağırlıklı F1-Skoru | 0.92 | 0.94 | +%2 iyileşme |
Tablo 5: Özellik ablasyonu öncesi ve sonrası performans karşılaştırması. Tüm çok alanlı özellik seti ile entropi özelliklerinin kaldırılmasıyla elde edilen azaltılmış özellik setine ait model performans metriklerinin karşılaştırması.
VERİLERİN ERİŞİLEBİLİRLİĞİ:
Model geliştirme ve analiz için kullanılan işlenmiş CSV veri seti Ek Dosya 1 olarak sunulmuştur. Ön işleme kodu https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing adresindeki bir Python notebook'ta, model oluşturma ve analiz kodları ise https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing adresinde mevcuttur. İşlenmiş CSV veri seti, sağlanan ön işleme kodu kullanılarak yeniden oluşturulabilir
| Sınıf | Metrik | Öncesi | Sonra | Değiştirme |
| Alzheimer hastalığı | Hassasiyet | 0.92 | 0.94 | 0.02 |
| Geri çağırma | 0.95 | 0.95 | Değişiklik yok | |
| F1-skoru | 0.94 | 0.94 | Değişiklik yok | |
| Kontrol | Hassasiyet | 0.93 | 0.91 | −2% |
| Geri çağırma | 0.92 | 0.96 | 0.04 | |
| F1-skoru | 0.93 | 0.94 | 0.01 | |
| Frontotemporal Demans | Kesinlik | 0.93 | 0.97 | 0.04 |
| Geri çağırma | 0.87 | 0.89 | 0.02 | |
| F1 skoru | 0.9 | 0.92 | 0.02 |
Tablo 6: Özellik ablasyonu öncesi ve sonrası sınıfa göre performans değişimleri. Entropi özelliklerinin kaldırılmasının ardından Alzheimer hastalığı, sağlıklı kontrol ve frontotemporal demans sınıfları için kesinlik, duyarlılık ve F1 skorundaki değişimler.
Ek Dosya 1: Model geliştirme ve analiz için kullanılan işlenmiş epok düzeyindeki EEG özellik veri seti. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Güç spektral yoğunluğu (PSD), karekök ortalama kare (RMS) ve entropi ölçümleri dahil olmak üzere çok alanlı özellikler kullanılarak elektroensefalografi (EEG) örneklerini Alzheimer hastalığı (AD), frontotemporal demans (FTD) ve sağlıklı kontrol (HC) gruplarına ayırmak için Random Forest sınıflandırıcısı kullanılmıştır. Yaş, tamamlayıcı bir demografik değişken olarak dahil edilmiştir. Yaş dağılımları tanı grupları arasında farklılık gösterebileceği için demografik karıştırıcı etkiler tamamen dışlanamamıştır ve bu nedenle bildirilen performans, demografik ve elektrofizyolojik bilgilerin birleşik katkısını yansıtmaktadır. Analiz, çok alanlı EEG özelliklerinin AD, FTD ve HC gruplarını ayırt etme yeteneğini incelemiş ve delta, theta, alfa, beta ve gama bant özelliklerinin sınıflandırmaya katkısını değerlendirmiştir35. Özellik kararlılığı ve etki büyüklüğü analizleri, PSD ve RMS dahil güç tabanlı özelliklerin, entropi tabanlı özelliklerden daha güçlü katkı sağladığını göstermiştir. Elde edilen EEG biyobelirteçleri ayrıca ritimlerin yavaşlaması ve azalan alfa aktivitesi ile ilişkili örüntüleri de yansıtmıştır.
Önceki çalışmalar; farklı makine öğrenimi yaklaşımlarını kullanarak entropi, PSD ve RMS tabanlı EEG özelliklerini değerlendirmiştir2,14,27,28,36,37. Entropi, EEG kompleksitesini ve düzensizliğini karakterize etmek için kullanılırken, PSD spektral özellikleri nicelleştirmek için kullanılmıştır2,14,27,28,36. RMS de bir frekans bandı özelliği olarak değerlendirilmiştir37. Aynı temel veri setini kullanan önceki bir çalışma, "bir deneyi dışarıda bırakma" (leave-one-subject-out) doğrulaması ile PSD tabanlı ikili sınıflandırma uygulamıştır33. Mevcut analiz ise bunun yerine; alfa, beta, gamma, theta ve delta bantları genelinde RMS, entropi ve PSD'yi çok sınıflı bir sınıflandırma çerçevesinde birleştirmiştir. Aynı veri seti üzerinde, "bir deneyi dışarıda bırakma" ikili sınıflandırma stratejisi kullanılarak hafifletilmiş bir EEG transformer değerlendirilmiştir. Aynı veri seti üzerinde "bir deneyi dışarıda bırakma" ikili sınıflandırma stratejisiyle değerlendirilen hafifletilmiş bir EEG transformer, %83,28'lik bir doğruluk oranı bildirmiştir. Mevcut sonuçlarla yapılacak doğrudan sayısal karşılaştırmalar, sınıflandırma görevi ve doğrulama prosedürleri farklı olduğu için dikkatle yorumlanmalıdır38.
AD'yi HC'den ve FTD'yi HC'den ayırt etmede en büyük etki büyüklüklerini alfa bandı özellikleri göstermiş olup, artmış teta aktivitesi de AD'nin HC'den ayırt edilmesine katkıda bulunmuştur. Beta bandı özellikleri gruplar arasında daha küçük etkiler göstermiş, entropi tabanlı özellikler ise karşılaştırmalı olarak sınırlı ayırt edici yararlılık sergilemiştir. Gama bandı özellikleri, FTD versus HC dahil olmak üzere bazı karşılaştırmalar için orta düzeyde etkiler göstermiştir. Önceki çalışmalar, AD ve ilgili tanısal karşılaştırmalarda daha düşük alfa gücü ve değişmiş teta aktivitesi rapor etmiştir23,25,39. Entropi ayrıca nörodejeneratif hastalıklarda potansiyel olarak bilgilendirici bir biyobelirteç olarak tanımlanmış36, bu da katkısının veri setine, özellik tanımına ve analitik yaklaşıma göre değişebileceğini göstermiştir.
Destek vektör makineleri, önceki EEG sınıflandırma çalışmalarında sıkça kullanılmıştır3,21,24,37. Mevcut analizde kullanılan Rastgele Orman sınıflandırıcısı, özellik önem tahminleri sağlamış ve bu çalışmada kullanılan yapılandırılmış özellik setine uygulanabilmiştir40,41. Entropi özelliği ablasyonu sonrası sırasıyla %96 ve %94 eğitim ve test doğruluğu elde edilmiştir. Entropi özelliklerinin çıkarılması, model performansının artmasıyla ilişkilendirilmiş; bu durum stabilite, SHAP ve etki büyüklüğü analizlerinde bu özellikler için gözlemlenen daha düşük göreceli katkıyı desteklemiştir. Derin öğrenme ve transformer tabanlı yaklaşımlar da EEG sınıflandırmasına uygulanmıştır, ancak bu tür yaklaşımlar genellikle daha büyük veri setleri gerektirir ve daha yüksek boyutlu veya ardışık temsiller için tasarlanmıştır27,39,42,43,44,45.
EEG sinyalleri gürültülüdür ve durağan değildir; topluluk tabanlı ağaç modelleri, yapılandırılmış özellik temsilleri analiz edilirken dayanıklılık sağlayabilir. Mevcut çalışmada RMS, PSD, entropi ve yaş, Random Forest modeline tamamlayıcı girdiler olarak değerlendirilmiştir. RMS frekans bantları içindeki sinyal genliğini, PSD spektral gücü ve entropi ise sinyal karmaşıklığını temsil etmiştir. Bulgular, değerlendirilen çerçeve dahilinde PSD ve RMS'nin sınıflandırmaya entropiden daha güçlü katkıda bulunduğunu göstermiştir. Yaş da modele katkı sağlamıştır, ancak dahil edilmesi demografik karıştırıcı değişken olasılığını beraberinde getirmiştir. Gelecekteki araştırmalar, genellenebilirliği ve sınıflandırma performansını daha ayrıntılı değerlendirmek için daha büyük veri setlerinde ek demografik değişkenleri ve alternatif makine öğrenimi veya derin öğrenme yaklaşımlarını değerlendirebilir.
Açıklamalar
Bu çalışmada bildirilen çalışmayı etkileyebilecek herhangi bir finansal çıkar çatışması, kişisel ilişki, finansal ilişki veya başka bir faaliyet beyan edilmemiştir.
Teşekkürler
Bu çalışmada kullanılan halka açık EEG veri seti ve veri setini araştırma amaçlı erişilebilir kılan araştırmacıların katkıları kabul edilmektedir. Kamu, ticari veya kâr amacı gütmeyen finansman kuruluşlarından herhangi bir özel destek alınmamıştır.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Analiz defterlerini çalıştırmak için kullanılan bulut tabanlı hesaplama ortamı | |
| MNE-Python | MNE-Python project | 1.12.1 | EEG ön işleme, referanslama, filtreleme ve epok segmentasyonu için kullanılır |
| NumPy | NumPy project | (2.0.2) | Sayısal ve dizi tabanlı hesaplamalar için kullanılır |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | AD, FTD ve HC kayıtlarını içeren, halka açık dinlenme durumu EEG veri seti |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Veri işleme ve model geliştirme için kullanılan programlama ortamı |
| scikit-learn | scikit-learn project | 1.6.1 | Ön işleme, gruplandırılmış veri bölme, Random Forest sınıflandırması ve performans değerlendirmesi için kullanılır |
| SciPy | SciPy project | (1.16.3) | Sinyal işleme ve istatistiksel hesaplamalar için kullanılır |
| SHAP | SHAP project | 0.52.0 | TreeExplainer ile açıklanabilir yapay zeka analizi için kullanılır |
Kaynaklar
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379