Bu protokol, tıbbi görüntü segmentasyonu için çok görüşlü Vision Mamba U-Shaped Network çerçevesinin nasıl oluşturulacağını, eğitileceğini ve değerlendirileceğini açıklar; böylece standart veri seti hazırlama, model uygulaması ve performans değerlendirmesi yoluyla cilt lezyonları ve karın organlarının tekrarlanabilir segmentasyonunu mümkün kılar.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Yöntem makalesi
Çok görüşlü Görüş Mamba U-Şekilli Ağ Çerçevesi Tıbbi Görüntü Segmentasyonu İçin
Bu makalede
Özet
Özet
Tıbbi görüntü segmentasyonu, küresel bağlamı, yerel sınırları ve çok ölçekli anatomik yapıları doğru şekilde yakalayan ve farklı uygulamalarda tekrarlanabilir kalan hesaplamalı yöntemler gerektirir. Bu makale, iki boyutlu tıbbi görüntü segmentasyonu için Multi-view Vision Mamba U-Shaped Network çerçevesinin oluşturulması, eğitilmesi ve değerlendirilmesi için bir protokol sunmaktadır. Protokol, kamuya açık veri seti edinimi, görüntü ve maske ön işleme, ağ oluşturma, model eğitimi, kontrol noktası seçimi ve nicel ve niteliksel performans değerlendirmesini içeren tekrarlanabilir bir iş akışı sağlar. Çerçeve, tamamlayıcı mekânsal, kontur, ölçek ve sınır bilgilerini yakalamak için çoklu görünüm özellik taramasını içerir ve segmentasyon sırasında özellik entegrasyonunu iyileştirmek için U şeklinde kodlayıcı-kodlayıcı mimarisi içinde çok aşamalı özellik birleşimi uygular. Protokol, halka açık cilt lezyonu ve karın organı segmentasyon veri setleri kullanılarak gösterilmiştir. Tarif edilen uygulama iş akışı kapsamında, çerçeve standart değerlendirme metrikleri kullanarak rekabetçi segmentasyon performansı elde eder. Bu protokolde sunulan prosedürleri takip ederek, araştırmacular model uygulamasını yeniden üretebilir, tanımlanmış deneysel ayarlarla ağı eğitebilir, segmentasyon performansını değerlendirebilir ve tekrarlanabilir derin öğrenme tabanlı analiz gerektiren ilgili tıbbi görüntü segmentasyon görevlerine iş akışını uyarlayabilir.
Giriş
Tıbbi görüntü segmentasyonu, bilgisayar görme ve tıbbi görüntü analizi alanlarındatemel bir görevdir 1,2,3. Bu, bir görüntünün daha fazla analiz ve işleme için birden fazla bölgeye veya nesneye bölünmesini içerir. Bu teknoloji, klinisyenlerin patolojik bölgeleri tanımlama ve lokalize etmelerine yardımcı olmasıyla tıbbi görüntülemede özellikle önemlidir; böylece tanı doğruluğunu ve tedavi planlamasını iyileştirir. Manyetik rezonans görüntüleme (MRI), bilgisayarlı tomografi (BT) ve pozitron emisyon tomografisi (PET) gibi tıbbi görüntüleme teknolojilerinin ilerlemesiyle birlikte, doğru tıbbi görüntü segmentasyon tekniklerine olan talep artmaya devam etmiştir. Tıbbi görüntü segmentasyonu için mevcut yöntemler genel olarak üç ana yaklaşıma ayrılabilir: konvolüsyon sinir ağı (CNN) tabanlı yöntemler4, Transformer tabanlıyöntemler 5 ve durum-uzay modeli (SSM) tabanlıyöntemler 6,7. CNN tabanlı yöntemler genellikle tıbbi görüntü segmentasyonu için U şeklinde ağ mimarileri kullanır. Bu kategoride en yaygın kullanılan mimari, biyomedikal görüntü segmentasyonu için U şeklinde kodlayıcı–kodlayıcı mimarisinin etkinliğini gösteren U-Net8'dir. U-Net3+, UNet++9'dan yoğun atlama bağlantılarını tam ölçekli atlama bağlantılarıyla birleştirerek çok ölçekli özellik toplamayı geliştirir. Ancak, CNN tabanlı yöntemlerin uzun vadeli bağımlılıkları yakalama yeteneği sınırlıdır ve bu nedenle uzun vadeli bağlamsal bilgiyi etkili şekilde modellemeyebilir.
Transformator tabanlı yöntemler, paralel hesaplamayı mümkün kılan ve ilgi alanlarına farklı dikkat ağırlıkları atayan öz-dikkat mekanizması aracılığıyla uzun menzilli bağımlılıkları etkili şekilde yakalar. UNETR++10 , parametre sayısını ve hesaplama maliyetini azaltmak için Verimli Eşleştirilmiş Dikkat (EPA) modülünü tanıtır. nnFormer11 , aralı yapraklı konvolüsyon ve öz-dikkat işlemlerini birleştirir ve üç boyutlu (3D) tıbbi görüntü segmentasyonunda hacimsel temsilleri öğrenmek için yerel-küresel hacim tabanlı öz-dikkat mekanizması sunar. H2Former12 , dikkat mekanizmalarını kodlayıcıda CNN tabanlı özellik çıkarımı ile birleştiren verimli hiyerarşik hibrit bir Vizyon Dönüştürücüsü önerir. Ancak, Transformer tabanlı yöntemler, dizi uzunluğu arttıkça kuadratik hesaplama karmaşıklığı sergiler ve bu da hesaplama maliyetinin önemli ölçüde artmasına yol açar. Şekil 1 , MVM-UNet'in motivasyonunu göstermekte ve önerilen çoklu görüş tarama stratejisini mevcut SSM tabanlı segmentasyon çerçeveleriyle karşılaştırmaktadır.
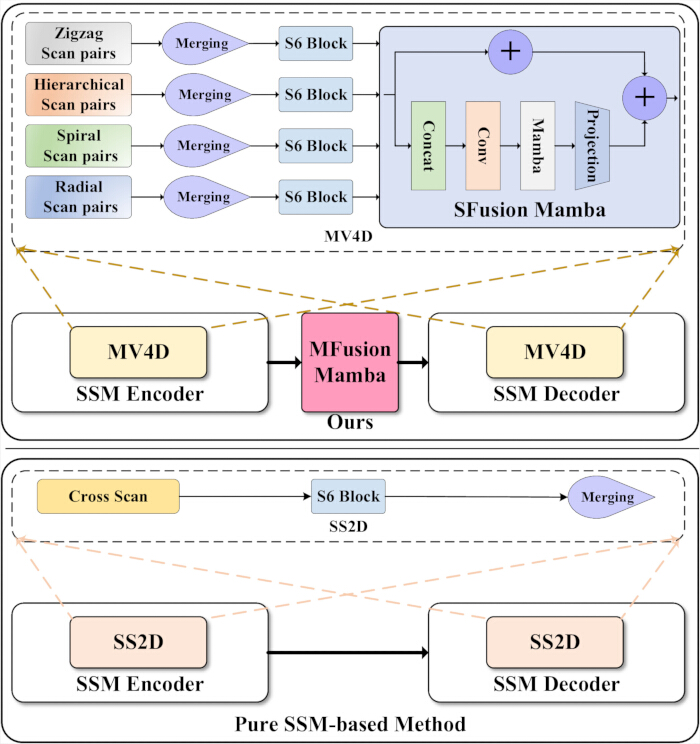
Şekil 1. MVM-UNet'in mevcut saf durum uzayı modeli (SSM) tabanlı segmentasyon mimarileriyle karşılaştırılması. Geleneksel saf durum alanı modeli (SSM) tabanlı segmentasyon çerçevesi ile önerilen Multi-View Mamba U-Net (MVM-UNet) mimarisi arasında karşılaştırma. Üst panel, Multi-View 4-Yönlü (MV4D) modülünün, Spatial Fusion Mamba (SFusion Mamba) tarafından entegre edilen zigzag, hiyerarşik, spiral ve radyal tarama çiftleri kullanarak tamamlayıcı özellikleri çıkardığı MVM-UNet'i gösterirken, Multi-Stage Fusion Mamba (MFusion Mamba) çok ölçekli kodlayıcı özelliklerini çözmeden önce birleştirir. Alt panel, çapraz taramalı Selective Scan 2-Boyutlu (SS2D) modüller kullanılarak temsil eden saf SSM tabanlı bir mimariyi gösterir. Şekil, geleneksel SSM tabanlı segmentasyon ağları ile önerilen MVM-UNet arasındaki mimari farklılıkları vurgulamaktadır. Bu figürün daha büyük bir versiyonunu görmek için lütfen buraya tıklayın.
SSM tabanlı yöntemler, Transformers'ın küresel modelleme yeteneğini doğrusal hesaplama karmaşıklığı ile birleştirir. Mamba mimarisi, seçmeli durum uzayı modeli (Selective-SSM) kullanarak giriş bilgisini seçici olarak işler; böylece model, girdiye göre parametrelerini dinamik olarak ayarlayabilir, alakasız bilgileri filtrelerek ve bilgilendirici özellikleri vurgular. Vim13 ve VMamba14 , Mamba mimarisini bilgisayar görüşü görevleri için uyarlar. U-Mamba15 , tıbbi görüntü segmentasyonunda SSM'lerin uygulamasını incelemek için hibrit CNN–SSM mimarisi kullanırken, Mamba-UNet16 tıbbi görüntü segmentasyonu için tamamen SSM tabanlı kodlayıcı-kodlayıcı mimarisi benimser. Bu yöntemler, önemli ölçüde daha az parametre kullanarak rekabetçi performans sağlar. Ancak mevcut SSM/Mamba tabanlı yöntemler, temel olarak basit görüntü yamaları ve SS2D tarama stratejileri kullanarak görüntü özelliklerini çıkarır ve bu da tıbbi görüntü segmentasyonu için çeşitli sınırlamalar sunar. Birincisi, SS2D ve yama tabanlı teknikler öncelikle genel bilgisayar görme görevleri için tasarlanmıştır. Yerel Mamba17 ve Motion Mamba18 , farklı tarama stratejilerinin farklı görsel bilgi türlerini yakaladığı için SS2D tarama stratejisinin tüm görsel görevler için yetersiz olduğunu öne sürmüştür. İkinci olarak, SS2D tarama stratejisi nispeten basittir ve yalnızca yatay ve dikey tarama yönlerine dayanır. Sonuç olarak, karmaşık mekansal ilişkileri ve ince yapısal detayları yeterince yakalayamayabilir. Tıbbi görüntü segmentasyonu, hem küresel mekansal bağlamın hem de kesin yerel anatomik özelliklerin eşzamanlı modellenmesini gerektirir. Ayrıca, mevcut SSM/Mamba tabanlı yöntemler, kodlayıcı ile çözücü arasında sınırlı özellik birleşimi sağlar. UNet++ ve FATNet gibi mimariler, gelişmiş özellik birleşmesiyle segmentasyon doğruluğunu artırır ve tıbbi görüntü segmentasyonu için etkili özellik entegrasyonunun önemini vurgular.
Bu sınırlamaları gidermek için, bu makale MVM-UNet olarak adlandırılan yeni bir Mamba tabanlı tıbbi görüntü segmentasyon çerçevesi önermektedir. Şekil 1'de gösterildiği gibi, önerilen Çok Görüşlü Dört Yönlü (MV4D) modülü, MVM-UNet'in temel özellik çıkarma bileşeni olarak hizmet verir ve dört farklı tarama stratejisinden gelen bilgilerin entegre edilmesiyle tıbbi görüntü segmentasyonu için özel olarak tasarlanmıştır. Her tarama stratejisi, tamamlayıcı görüntü özelliklerini çıkarır ve giriş görüntüsünün farklı bir görünümünü temsil eder. Zikzak tarama19 , her satırın veya sütunun sonunda geçiş yönünü değiştirerek yerel ve küresel mekânsal bilgiyi dengeler. Buna karşılık, spiral ve radyal taramaşemaları 20 , merkezden dışa veya çevreden içe doğru uzanarak kapsamlı kapsama sağlar. Hiyerarşik tarama18 , hem yerel hem de küresel özellikleri birden fazla ölçekte yakalar. Her tarama stratejisinin dayanıklılığını artırmak için, tarama çiftleri S6 Bloğuna girilmeden önce birleştirilir. Scan-view Fusion Mamba (SFusion Mamba) modülü, dört tarama modalitesinden çıkarılan özellikleri daha sonra entegre eder. Çok ölçekli kodlayıcı özelliklerini etkili bir şekilde kullanmak için, bu makale ayrıca çok ölçekli bir Mamba füzyon modülü (MFusion Mamba) önermektedir; bu modül, her kodlayıcı aşamasından çıkan çıktıları biriktirip birleştirir ve ardından füzülmüş özellikleri çözücüye aktarır. MVM-UNet, ISIC 2017, ISIC 2018 ve Synapse veri setleri üzerinde değerlendirildi. Deneysel sonuçlar, MVM-UNet'in ISIC 2017, ISIC 2018 ve Synapse veri setlerinde rekabetçi segmentasyon performansı elde ettiğini göstermektedir.
Temsilci segmentasyon mimarileri tıbbi görüntü segmentasyonunu daha da geliştirmiştir. U-Net, hücre sayma, tespit ve morfometri21 gibi biyomedikal görüntü analiz görevlerinde de başarıyla uygulanmıştır. CA-Net 22 gibi dikkat artırılmış CNN mimarileri, kapsamlı dikkat mekanizmaları aracılığıyla özellik temsilini iyileştirir. TransUNet 23, Pyramid Medical Transformer24, Swin U-Net25, TransAttUNet26 ve TransCUNet27 gibi temsil Transformer tabanlı segmentasyon çerçeveleri, tıbbi görüntü segmentasyonu için dikkat temelli küresel özellik modellemesinin etkinliğini daha da göstermektedir.
MVM-UNet'in tasarımı, mevcut SSM/Mamba tabanlı segmentasyon yöntemlerinin iki sınırlaması nedeniyle motive edilmiştir. İlk olarak, günümüzdeki birçok Vision Mamba modeli, düzensiz lezyon sınırları, küçük hedef bölgeler ve çok ölçekli anatomik yapılar içeren tıbbi görüntüler için yetersiz olabilecek basit iki boyutlu tarama stratejilerine dayanır. İkinci olarak, geleneksel U şeklindeki kodlayıcı-kodlayıcı mimarileri, özellikleri öncelikle karşılık gelen atlama bağlantıları üzerinden aktarır ve dekodlama sırasında çok aşamalı kodlayıcı bilgisinin doğrudan kullanımını sınırlar. Bu nedenle, MVM-UNet çok görüşlü mekânsal modellemeyi geliştirmek için MV4D ve çok aşamalı kodlayıcı özelliklerini açıkça birleştirmek için MFusion Mamba'yı tanıtır. Bu tasarım, Mamba tabanlı uzun menzilli modellemeyi tıbbi görüntü segmentasyonunun özel gereksinimlerine uyarlamayı amaçlamaktadır.
MVM-UNet genel kodlayıcı–kodlayıcı paradigması ve Mamba tabanlı dizi modelleme üzerine inşa edilmiş olsa da, yeniliği, bu bileşenlerin tıbbi görüntü segmentasyonu için nasıl uyarlanıp entegre edildiğinde yatmaktadır. Standart bir Mamba bloğunu U-şeklindeki ağ omurgasına entegre etmek yerine, önerilen çerçeve, mekânsal modelleme sürecini birden fazla görev odaklı tarama çifti dalıyla yeniden tasarlar, taramaya özgü temsilleri entegre etmek için SFusion Mamba'yı tanıtır, MVV Bloğunu kalıntı ve projeksiyon yolları ile güçlendirir ve kodlayıcı ile çözücü arasına MFusion Mamba'yı ekleyerek çok aşamalı kodlayıcı özelliklerini dekodlamadan önce birleştirir. Bu mimari düzeydeki tasarım, tıbbi görüntülerde sıkça gözlemlenen düzensiz sınırları, küçük hedef bölgeleri ve çok ölçekli anatomik yapıları ele almayı amaçlar.
Bu protokol, iki boyutlu tıbbi görüntülerde uzun süreli bağlamsal bilginin, düzensiz nesne sınırlarının ve çok ölçekli anatomik yapıların eşzamanlı modellenmesini gerektiren segmentasyon görevleri için en uygundur. CNN tabanlı segmentasyon yöntemleriyle karşılaştırıldığında, Mamba tabanlı kodlayıcı–kodlayıcı tasarımı, tıbbi görüntü segmentasyon araştırmacılarına aşina olan U şeklindeki iş akışını korurken etkili bir bağlam modelleme mekanizması sunar. Transformer tabanlı yöntemlerle karşılaştırıldığında, önerilen çerçeve doğrudan kuadratik öz-dikkat kullanımından kaçınmakta ve nispeten verimli bir dizi modelleme mekanizması kullanarak küresel bağlamsal modelleme arayan araştırmacılar için tasarlanmıştır. Buna göre, bu protokol cilt lezyonu segmentasyonu, karın organı segmentasyonu ve küresel yapısal bilgilerin ve yerel sınır detaylarının önemli olduğu benzer iki boyutlu tıbbi görüntü segmentasyon görevleri için uygundur.
Bu protokolün ayrıca kullanımdan önce dikkate alınması gereken sınırlamaları vardır. Hafif bir CNN'in zaten yeterli performans sağladığı nispeten basit segmentasyon görevleri için gerekli olmayabilir. Ayrıca, mimari uyarlama olmadan tam üç boyutlu hacimsel segmentasyon için doğrudan tasarlanmamıştır. Çok sınırlı açıklamalı verilere, sınırlı grafik işlem birimi (GPU) kaynaklarına veya oldukça yorumlanabilir klasik modellere ihtiyaç duyan araştırmacılar da protokolü uygulamadan önce bu kısıtlamaları göz önünde bulundurmalıdır. Genel olarak, bu yöntem, uzun vadeli bağlam modellemesi, yerel sınır temsili ve çok aşamalı özellik birleşimini dengeleyen Mamba tabanlı U şeklinde segmentasyon çerçevesini yeniden üretip değerlendirmek isteyen araştırmacılar için tasarlanmıştır.
Başlıca katkılar şunlardır:
1. Bu makale, MVM-UNet olarak adlandırılan yeni bir Mamba tabanlı tıbbi görüntü segmentasyon çerçevesini sunmaktadır. Mevcut SS2D tabanlı veya standart Mamba bloklarını doğrudan dahil eden yaklaşımların aksine, MVM-UNet zikzak, hiyerarşik, spiral ve radyal tarama dahil olmak üzere dört tamamlayıcı tarama çifti görünümünden tıbbi görüntü özelliklerini modellemek için MV4D'yi tanıtır.
2. Bu makale, taramaya özgü temsilleri entegre etmek ve özellik dönüşümünü geliştirmek için SFusion Mamba ve MVV Bloğunu tasarlamaktadır. SFusion Mamba, farklı tarama çift dallarından çıkarılan özellikleri birleştirirken, MVV Bloğu içindeki kalıntı ve Yukarı-Aşağı Projeksiyon dalları, özellik temsillerini stabilize eden ve zenginleştiren tamamlayıcı özellik yolları sağlar.
3. Bu makale, MFusion Mamba'yı kodlayıcı ile çözücü arasında ara çok aşamalı bir füzyon modülü olarak tanıtmaktadır. Geleneksel atlama bağlantılarının aksine, özellikle karşılık gelen aşama özelliklerini aktarırken, MFusion Mamba çok aşamalı kodlayıcı özelliklerini kabaca ve ince füzyon yoluyla açıkça birleştirir ve kod çözme için zenginleştirilmiş bilgi sağlar.
4. Kapsamlı deneysel sonuçlar, önerilen MVM-UNet'in ISIC 2017 ve ISIC 2018 veri setlerinde rekabetçi segmentasyon performansı ve Synapse çoklu organ segmentasyon veri setinde güçlü performans sağladığını göstermektedir. Ayrıca, kapsamlı ablasyon çalışmaları MVM-UNet'teki her bileşenin katkısını doğrular.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Bu çalışma, ISIC 2017, ISIC 2018 ve Synapse dahil olmak üzere yalnızca kamuya açık ve kimliği yok edilmiş tıbbi görüntü veri setlerini kullanmıştır. Bu çalışmada yeni insan katılımcılar, hayvan denek veya tanımlanabilir özel tıbbi kayıtlar toplanmadı. Bu çalışmada kullanılan ISIC 2017 veri seti, resmi Uluslararası Cilt Görüntüleme İşbirliyi meydan okuma veri deposundan (https://challenge.isic-archive.com/data/#2017) elde edilen ISIC 2017 Challenge cilt lezyonu segmentasyon veri setidir. Bu çalışmada kullanılan veri seti versiyonu, resmi eğitim, doğrulama ve test bölümlerini içeren ISIC 2017 lezyon segmentasyon görevine karşılık gelmektedir. Veri seti 15 Mart 2024'te indirildi. Bu çalışmada kullanılan ISIC 2018 veri seti, resmi Uluslararası Cilt Görüntüleme İşbirliği meydan okuma veri deposundan (https://challenge.isic-archive.com/data/#2018) elde edilen ISIC 2018 Challenge Görev 1 lezyon sınır segmentasyon veri setidir. Bu çalışmada kullanılan veri seti versiyonu, ISIC 2018 Görev 1: Lezyon Sınır Segmentasyonu'na karşılık gelmektedir. Veri seti 8 Temmuz 2024'te indirildi.
Bu çalışmada kullanılan Synapse veri seti, Synapse deposundan accession identifor syn3193805 (https://www.synapse.org/Synapse:syn3193805) altında elde edilen Multi-Atlas Etiketleme Beyond the Cranial Vault abdominal CT veri setidir. Bu çalışmada kullanılan veri seti, yaygın olarak kullanılan 30 vakalı abdominal BT çoklu organ segmentasyon veri setine karşılık gelir. İndirilen arşiv Abdomen/RawData.zip idi ve accession syn3193805 altında mevcut. İndirme sırasında depo tarafından ayrı bir sürüm numarası, yayın etiketi veya tarihli bir etiket sağlanmamıştır. Önceki çalışmalarda benimsenen standart bölünme taktiklerinde, 18 vaka eğitim için, 12 vaka ise test için kullanıldı. Veri paylaşımı, TransUNet23 tarafından kullanılan vaka listesini takip etti. Özellikle eğitim davaları case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 ve case0037 idi; test vakaları ise case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 ve case0035 idi. Veri seti 9 Temmuz 2024'te indirildi. Bu çalışma yalnızca kamuya açık olan, kimliği yok veri setlerini kullandığı ve yeni insan-denek verileri veya tanımlanabilir özel bilgilerin toplanmasını içermediği için, bu protokolde tanımlanan hesaplamalı deneyler için kurumsal inceleme kurulu onayı gerekmemiştir. Resmi yazılı kurumsal muafiyet kararı alınmadı. Yerel kurumsal politika gereği gerekliyse, araştırmacılar kamuya açık veri setlerinin ikincil analizlerini yapmadan önce kurumsal muafiyet belirlemesi almalıdır. Bu çalışma için kurumsal etik muafiyet referans numarası veya resmi muafiyet belgeleri mevcut değildi.
1. Veri setlerinin hazırlanması
- ISIC 2017 cilt lezyonu segmentasyon veri setini resmi Uluslararası Cilt Görüntüleme İşbirliği deposundan indirin. Resmi eğitim, doğrulama ve test bölümlerini kullanın. Veri setinin 2.000 eğitim görsesi, 150 doğrulama görüntüsü ve 600 test görsesi içerdiğini doğrulayın.
- ISIC 2018 cilt lezyonu segmentasyon veri setini resmi Uluslararası Cilt Görüntüleme İşbirliği deposundan indirin. Resmi eğitim, doğrulama ve test bölümlerini kullanın. Segmentasyon veri setinin 2.594 eğitim görüntüsü, 100 doğrulama görüntüsü ve 1.000 test görsesi içerdiğini doğrulayın.
- Synapse çoklu organ segmentasyon veri setini indirin. Eğitim için 18 vaka (2.212 eksenel dilim) ve test için 12 vaka (1.567 eksenel dilim) olan standart bölünmeyi kullanın. Ayrı bir doğrulama seti eklemeyin.
- 12 test vakasını yalnızca nihai değerlendirme için ayırın. Test vakalarını model eğitimi, hiperparametre ayarlaması veya model seçimi için kullanmayın. Segmentasyon görevi sekiz karın organını içerir: aorta, safra kesesi, dalak, sol böbrek, sağ böbrek, karaciğer, pankreas ve mide.
- Aşağıdaki Synapse veri seti bölünmesini kullanın. 18 eğitim vakası ise case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 ve case0037 idi. 12 test vakası ise case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 ve case0035 idi.
- Her veri setini ayrı görsel ve maske klasörlerine düzenleyin. Her görüntünün aynı küçük harf tanımlayıcısına sahip bir segmentasyon maskesi olduğundan emin olun.
- Her cilt lezyonu maskesini ikili bir ön plan-arka plan segmentasyon haritasına dönüştürün. Synapse veri seti için orijinal çok sınıflı organ etiketlerini koruyun.
- ISIC 2017 ve ISIC 2018 veri setleri için, ikili maske dönüşümünden sonra arka plan piksellerine 0, lezyon (ön plan) piksellerine ise 1 etiket değeri atayın. Orijinal maske değerleri 0'dan büyük olan pikseller ön plan olarak kabul edilir ve 1'e dönüştürülürken, orijinal maske değerleri 0'a olan pikseller arka plan olarak kabul edilir ve 0 olarak korunur. Synapse veri seti için, orijinal tam sayı etiket değerlerini koruyun; 0 arka plan sınıfını, 1–8 ise sekiz ön plan organ sınıfını temsil eder.
- ISIC 2017 ve ISIC 2018 görüntülerini ve maskelerini orijinal en-boy oranını korumadan 256 × 256 piksele yeniden boyutlandırmak. Kırpma veya dolgu uygulamayın.
- Her Synapse CT dilimini ve karşılık gelen etiket eşlemesini 224 × 224 piksel olarak yeniden boyutlandırın. RGB görüntüler için bilinezik enterpolasyon, CT dilimleri için üçüncü dereceden spline interpolasyonu ve segmentasyon maskeleri için en yakın komşu interpolasyonu kullanın.
- Python'da görüntüleri boyutlandırmak.
- ISIC 2017 ve ISIC 2018 veri setleri için, utils.py'de uygulanan özel myResize dönüşümünü kullanın; bu dönüşüm torchvision.transforms.functional.resize çağrısı ile hem görüntü hem de maske tensorlarını 256 × 256 piksele boyutlandırır. Bu dönüşümde açık bir interpolasyon modu veya anti-aliasing argümanı belirtmeyin.
- Synapse veri seti için datasets/dataset.py içinde scipy.ndimage.zoom kullanın. CT görüntü dilimlerini üçüncü dereceden spline interpolasyonu (düzen = 3) kullanarak 224 × 224 piksele boyutlandırılır ve en yakın komşu enterpolasyonu ile etiket haritalarını yeniden boyutlandırır (sıra = 0). Yeniden boyutlandırma sırasında ayrı bir anti-aliasing işlemi veya anti_aliasing=True ayarı uygulamayın.
- Tenzor dönüşümünden önce her ISIC RGB görüntünü veri setine özgü ortalama ve standart sapma (SD) kullanarak Denklem 1 kullanılarak aşağıdaki şekilde normalleştirin:
 (1)
Daha sonra normalize edilmiş görüntüyü minimum–maksimum normalizasyon kullanarak 0–255 aralığına yeniden ölçeklendirin.- ISIC 2017 eğitim seti için μ = 159.922 ve σ = 28.871, ISIC 2017 doğrulama ve test setleri için ise μ = 148.429 ve σ = 25.748 kullanın. ISIC 2018 eğitim seti için μ = 157.561 ve σ = 26.706, ISIC 2018 doğrulama ve test setleri için ise μ = 149.034 ve σ = 32.022 kullanın.
- Her normalize edilmiş görüntüyü 256 × 256 × şekilli bir tensöre dönüştürün. Her ikili maske, 256 × 256 × şekilli bir tensöre dönüştürün.
- Veri setine özgü ortalama ve standart sapma normalizasyonundan sonra her görüntü için bağımsız olarak min–max normalizasyonu gerçekleştirilin. Özellikle, her görsemden veri setine özgü ortalamayı çıkarıp karşılık gelen standart sapmaya bölür.
- Normalize edilmiş görüntüden minimum ve maksimum yoğunluk değerlerini hesaplayın ve bu görüntü başına minimum ve maksimum değerleri kullanarak görüntüyü 0–255 aralığına yeniden ölçeklendirin. Bu mini–maksimum ölçeklendirme adımı için veri seti genelindeki minimum ve maksimum değerleri kullanmayın.
- Her Synapse CT dilimi iki boyutlu gri tonlu bir görüntü olarak hazırlanır. Her CT dilimi float32'ye dönüştürün ve tekli bir kanal boyutu ekleyerek 1 × 224 × 224 şeklinde bir giriş tensoru elde edinin.
- Her Synapse etiket haritasını 224 × 224 şekline sahip tek kanallı bir tamsayı maskesi olarak koruyun. Veri yükleyicide ek veri seti seviyesinde ortalama-SD normalizasyonu uygulamayın.
- Dilimleri eğitmek için .npz formatında sağlanan önceden işlenmiş Synapse dosyalarını, hacimleri test etmek için ise .npy.h5 formatını kullanın. Eğitim sırasında her .npz dosyasından ve test sırasında doğrudan .npy.h5 dosyasından görüntü ve etiket dizilerini yükleyin. Serbest bırakılan veri yükleyicide ek yoğunluk kırpma, CT pencereleme, veri seti düzeyinde normalizasyon veya ham hacim yeniden örnekleme uygulaması uygulanmamalıdır.
- Model eğitimi sırasında, yüklenmiş her iki boyutlu dilimi float32'ye dönüştürün, scipy.ndimage.zoom kullanarak hedef mekansal boyutuna dönüştürün; görüntü dilimleri için sıra = 3, etiket haritaları için sıra = 0 ile ve ardından yeniden boyutlandırılmış dizileri tek kanal boyutuna sahip tensorlara dönüştürün.
- Veri artırma sadece eğitim setine uygulanır. ISIC 2017 ve ISIC 2018 için, 0° ile 360° arasında örneklenen açı ile rastgele yatay çevirme (p = 0.5), rastgele dikey çevirme (p = 0.5) uygulanır.
- Her görüntü-maske çiftine aynı geometrik dönüşümü uygulayın. Doğrulama ve test sırasında yalnızca yeniden boyutlandırma, normalizasyon ve tensör dönüşümü uygulanır.
- Synapse veri seti için, eğitim sırasında rastgele dönüş ve rastgele çevirme uygulanır. Her görüntü-etiket çiftini k × 90° rastgele döndürün; burada k {0,1,2,3} ∈, görüntü-etiket çiftini bir uzamsal eksen boyunca rastgele çevirin veya görüntü-etiket çiftini −20°'den 20°'ye örneklenmiş bir açı ile rastgele döndürün.
- Test sırasında stokastik artırma uygulamayın.
- RandomGenerator dönüşümünde uygulanan karşılıklı dışlayıcı dallar kullanılarak Synapse veri setine veri artırımı uygulanır.
- Her eğitim örneği için, önce random.random() koşulu 0.5 > değerlendirin. Bu koşul sağlanırsa, rastgele 90° dönüş (k = 0, 1, 2 veya 3) ve ardından bir mekânsal eksen boyunca rastgele bir dönüşten oluşan random_rot_flip uygulanır.
- Birinci dal seçilmezse, ikinci bir koşul olan random.random() > 0.5 değerlendirin. Bu koşul sağlanırsa, −20° ile 20° arasında rastgele seçilmiş bir dönme açısı kullanarak random_rotate uygulanır. Hiçbir koşul karşılanmazsa, örnekle stokastik artırma uygulanmaz.
- Aynı dönüşümü hem giriş görüntüsüne hem de ilgili etiket haritasına uygulayın.
- Veri seti yükleme, ön işleme ve eğitim öncesinde rastgele tohumu ayarlayın. Ana karşılaştırma deneyleri için rastgele tohum 1, 52 ve 100 kullanın, ablasyon çalışmaları için ise başka belirtilmedikçe tohum 100 kullanın.
- Veri yükleyicisini oluşturmadan önce Python, NumPy, PyTorch CPU, PyTorch CUDA ve cuDNN rastgele üreteçlerini başlatın. Tüm tohum çalışmalarında veri seti bölümlerini, ön işleme prosedürlerini, artırma ayarlarını, normalizasyon parametrelerini, boyutlandırma stratejisini ve değerlendirme ön işlemesini değiştirmeden tutun.
- Ana süreçte veri yükleme yapmak için hem ISIC hem de Synapse deneyleri için num_workers = 0 ayarlanır. Veri setini oluşturmadan ve DataLoader oluşturmadan önce, Python, NumPy, PyTorch CPU, PyTorch CUDA ve cuDNN rastgele sayı üreteçlerini tohumlamak için set_seed fonksiyonuyla küresel rastgele tohumu başlatın. Yayınlanan uygulamada kullanılmadığı için ayrı bir worker_init_fn veya DataLoader'a özgü rastgele üretici tanımlamayın.
2. MVM-UNet mimarisinin inşası
- Önerilen Çok görüşlü Görüş Mamba UNet'i (MVM-UNet) U şeklinde kodlayıcı-çözücü mimarisi kullanarak inşa edin.
- Giriş görüntü boyutunu H × W × 3 olarak ayarlayın. Giriş görüntüsünü patch gömme katmanından geçirin.
- Patch gömüleme katmanını, çekirdek boyutu 4 × 4, adımı 4, üç giriş kanalı ve 96 çıkış kanalı ile 2D bir konvolüsyon kullanarak uygulayın.
- Giriş özellik haritasını H/4 × W/4 mekansal çözünürlüğüne dönüştürün ve C = 96 çıkış kanalı ile değiştirilin.
- Dört kodlayıcı aşaması ve dört kodlayıcı aşaması oluşturun. Her kodlayıcı aşamasından sonra mekansal çözünürlüğü yarıya düşürüp kanal boyutunu iki katına çıkar.
- Simetrik kodlayıcı-kodlayıcı konfigürasyonu kullanın. Hem kodlayıcıda hem de kodlayıcıda MVV Blok sayısını {2, 2, 2, 2} olarak ayarlayın.
- Her kodlayıcı aşamasına iki MVV Bloğu, her kodlayıcı aşamasına ise iki MVV Bloğu yerleştirin.
- Her kodlayıcı ve kodlayıcı aşamasına bir MVV Bloğu ekleyin. Her MVV Bloğu içinde temel özellik çıkarma modülü olarak MV4D modülünü kullanın.
- MFusion Mamba modülünü kodlayıcı ile çözücü arasına yerleştirin. Bu modülü çok aşamalı kodlayıcı özelliklerini çözmeden önce birleştirmek için kullanın.
- Genel MVM-UNet iş akışını yapılandırın. Encoder boyunca özellik çıkarımı için MV4D kullanın.
- Kodlayıcı çıkışlarını atlama bağlantıları olarak kalın. Kodlayıcı çıktılarını ilgili kodlayıcı aşamalarına iletin.
- Kodlayıcı özelliklerini çözmeden önce MFusion Mamba'ya geçirin. Birleştirilmiş temsilin dekoder üzerinden kademeli olarak yukarı örneklenmesi ve segmentasyon başlığı kullanılarak nihai segmentasyon haritasını oluşturulması.
- I ∈ R B×H×W×3 giriş görüntüsünü patch gömüleme katmanından geçirerek burada, C = 96 elde edilir
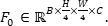 .
- Kodlayıcı özellik haritaları oluşturuldu: E1 ∈R B×H/4×W/4×C, E2 ∈ RB×H/8×W/8×2C, E3 ∈ RB×H/16×W/16×4C, ve E4 ∈ RB×H/32×W/32×8C. Her kodlayıcı aşamasında MV4D içeren MVV Blokları kullanın.
- İlgili atlama bağlantısı için tüm kodlayıcı özelliklerini koruyun. Tüm kodlayıcı özelliklerini çoklu aşamalı özelliklerin birleşmesi için MFusion Mamba'ya aktarın.
- MFusion Mamba içinde kaba ve ince füzyon öncesi kodlayıcı özelliklerini ortak bir özellik alanına hizalamak. Füzelenmiş temsilini kod çözücüye verin.
- Dekoder temsilini aşamalı olarak yukarı örnekleyin. Dekoder özelliklerini H/16 × W/16 E 2, H/8 × W/8 ve H/4 × W/4 ile E1 ile birleştirin.
- Son kod çözücü özelliğini orijinal görüntü çözünürlüğüne örnekleyin. Tahmin haritasını
 RB×H×W×K ∈ oluşturun. Burada, ikili lezyon segmentasyonu için K = 1 ve Sinaps çok organlı segmentasyonu için K = 8.
- Genel ağ mimarisi için Şekil 2'ye ve her aşama için işlemler, ana parametreler ve çıktı özellik boyutları dahil olmak üzere tam katman-katman mimari spesifikasyonu için Ek Tablo 1'e bakınız
- Kodlayıcı–kodlayıcı geçiş katmanları
- Downsample kodlayıcı özellikleri patch-birleştirme geçiş katmanları kullanır. Her geçiş için, 2 × 2 komşuluktan dört uzamsal olarak iç içe girmiş özellik grubu örneklerini alıp kanal boyutu boyunca birleştirin, Katman Normalizasyonu (LayerNorm) uygulanır ve ortaya çıkan 4C boyutlu özelliği önyargısız doğrusal katman kullanarak 2C kanallarına projeksiyon edin. Bu işlem, kanal boyutunu iki katına çıkarırken mekansal çözünürlüğü 2 kat azaltır.
- Upsample dekoder özellikleri yama-genişletici geçiş katmanları kullanır. Önyargısız doğrusal bir projeksiyon uygulayın, genişletilmiş özellikleri mekânsal olarak yeniden düzenleyerek çözünürlüğü 2 kat artırın ve mekânsal genişlemeden sonra LayerNorm uygulayın. Bu işlemi tekrarlayarak H/32 × W/32'den H/16'ya × W/16, H/8 × W/8 ve H/4 × W/4'e kadar olan özellikler haritalarını kademeli olarak yeniden inşa edin.
- MFusion Mamba modülündeki kodlayıcı özelliklerini, bilinear interpolasyon (align_corners = Yanlış) kullanarak hedef mekansal çözünürlüğe göre boyutlandırarak ve ardından özellik birleşiminden önce öğrenilebilir doğrusal kanal projeksiyonu uygulayarak hizalamak.
- Segmentasyon başlığı
- Son kod çözücü özellik haritasını H/4 × W/4'ten orijinal görüntü çözünürlüğüne (H × W) son patch-genişleme katmanı kullanarak yukarı örnekleyin. Doğrusal projeksiyon uygulayın, 4 genişleme faktörü ile mekânsal yeniden düzenleme yapın ve LayerNorm uygulayın.
- Yeniden oluşturulan özellik haritasını, tensörü kanal öncelikli formata dönüştürdükten sonra 1'e ×1 konvolüsyonuyla K çıkış kanalına projeksiyon yapın.
- Değerlendirme sırasında ikili lezyon segmentasyonu için sigmoid aktivasyon fonksiyonu veya softmax aktivasyonu uygulayarak ardından Synapse multiorgan segmentasyonu için argmax uygulanarak nihai tahmini oluşturun. Segmentasyon başının içinde aktivasyon fonksiyonu uygulama.
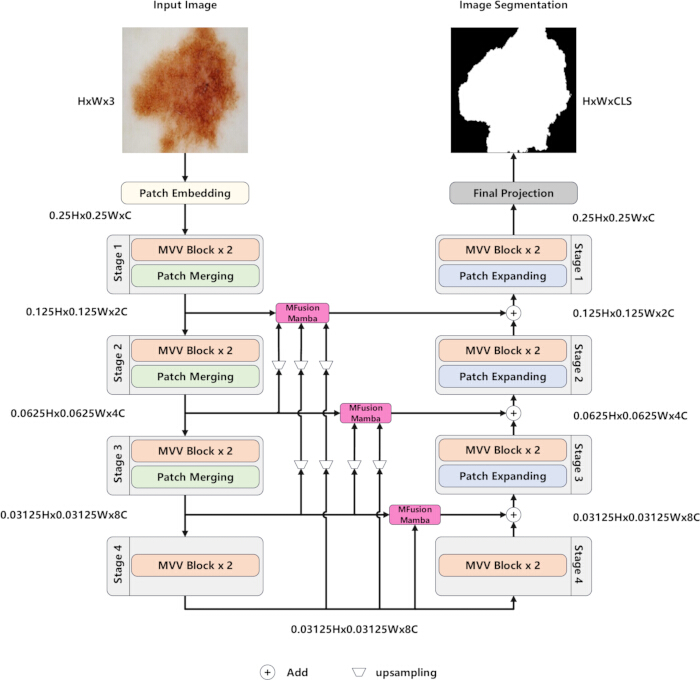
Şekil 2. Multi-View Mamba U-Net'in (MVM-UNet) genel mimarisi. Önerilen Multi-View Mamba U-Net (MVM-UNet) mimarisinin genel görünümü. Giriş görüntüsü, patch gömmelerine dönüştürülür ve patch-birleştirme işlemleriyle ayrılmış Multi-View Vision (MVV) Bloklarından oluşan dört kodlayıcı aşamasından geçer. Kodlayıcı özellikleri, Çok aşamalı Birleşme Mamba (MFusion Mamba) ile toplanır ve atlama bağlantıları aracılığıyla kodlayıcıya iletilir. Kodlayıcı, yama genişletme işlemleriyle mekânsal çözünürlüğü kademeli olarak geri kazanır ve projeksiyon katmanı boyunca nihai segmentasyon haritasını oluşturur. Bu figürün daha büyük bir versiyonunu görmek için lütfen buraya tıklayın.
3. MV4D modülünün inşası
- MVV Bloğunda temel özellik çıkarma birimi olarak MV4D modülünü kullanın. Giriş özellik yamalarını dört tarama çifti dalına besleyin. Mekânsal düzleştirme, tarama çifti indeks oluşturma, dizi toplama, S6/Mamba işleme, ters mekansal yeniden sıralama, tarama çifti birleşimi, SFusion Mamba füzyon, projeksiyon ve çıktı yeniden şekillendirme gibi tam sözde kod için Algoritma 1, Ek Dosya 1'e bakınız.
- modeller/mvmunet/core.py'de uygulanan tam zigzag, hiyerarşik, spiral ve radyal tarama-indeks oluşturma prosedürlerini kullanın. Her tarama stratejisi için, ileri tarama sırasını ve onun ters sırasını tek bir çift yönlü tarama çifti olarak kullanın.
- Zikzak tarama çiftini oluştur. Her satır veya sütunun sonunda görüntü özelliklerini dönüşümlü yönlerde gezdirin. Bu tarama desenini yerel ve küresel mekânsal bilgiyi dengelemek için kullanın.
- Hiyerarşik tarama çiftini oluşturun. Özellikleri birden fazla mekansal ölçekte yakalayın. Bu tarama desenini hem yerel hem de küresel temsillerin çıkarımını güçlendirmek için kullanın.
- Spiral tarama çiftini oluşturun. Görüntü özelliklerini merkezden sınıra doğru veya sınırdan merkeze doğru tara. Bu tarama desenini küresel kontur bilgisinin çıkarımını artırmak için kullanın.
- Radyal tarama çiftini oluşturun. Görüntü özelliklerini birden fazla radyal yön boyunca tara. Bu tarama desenini yerel sınır ve kenar detaylarının çıkarımını geliştirmek için kullanın.
- Her tarama çiftini birleştirin ve birleştirilen diziyi S6 bloğuna aktarın. Eşleştirilmiş tasarımı kullanarak her tarama stratejisinin dayanıklılığını artırırken hesaplama verimliliğini koruyabilirsiniz.
- Her tarama çiftinin çıkış dizisini bir S6 bloğuna besleyin. Zigzag, hiyerarşik, spiral ve radyal tarama görünümlerine karşılık gelen dört özellik temsili elde edin.
- Çıkarılan dört özellik temsili SFusion Mamba modülü kullanılarak birleştirin. İki paralel füzyon yolu kullanın. İlk yolda, dört özelliği eleman bazında ekleme yoluyla entegre edin.
- İkinci SFusion Mamba yolunda, dört özelliği birleştirin. Birleştirilmiş temsili Conv1d ve Mamba ile işleyin. Kanal boyutunu, S6 blok çıkış boyutuna uyacak bir projeksiyon katmanı kullanarak küçültün.
- Model boyutu olarak özellik boyutu C kullanılarak S6/Mamba bloğunu yapılandırın. Her birleşmiş tarama çifti özelliğini füzyondan önce kanal boyutu C'ye eşlemek için bir projeksiyon katmanı kullanın.
- SFusion Mamba'da, ilk yolda eleman bazında toplama işlemi yapılabilir. Conv1d, Mamba ve doğrusal projeksiyondan önceki ikinci yolda dört tarama görünümü özelliğini birleştirin. Adımda belirtildiği gibi normalizasyon, doğrusal projeksiyon, derinlik açısından ayrılabilir konvolüsyon ve MV4D etrafındaki aktivasyon işlemlerini kullanın.
- MV4D modülünün nihai çıktısını elde etmek için iki füzyon yolunun çıktılarını ekleyin.
- Yalnızca yatay ve dikey tarama yönleri kullanmak yerine dört tamamlayıcı tarama çifti dalı oluşturun. Sürekli mekansal geçişi vurgulamak için zikzak tarama, çok ölçekli temsili güçlendirmek için hiyerarşik tarama, merkezden sınıra kontur bilgisini yakalamak için spiral tarama ve sınır odaklı yerel detay çıkarımı artırmak için radyal tarama kullanın.
- Her tarama çiftini bağımsız olarak işleyin. Ortaya çıkan özellikleri SFusion Mamba ile birleştirin. Her işlenen diziyi füzyon öncesi orijinal mekansal sırasına geri eşle.
- Bir giriş özellik haritası X ∈ RB×H×W×C, onu Xdizili olarak düzleştirin ∈ RB×L×C, burada L = H × W.
- Her tarama çifti dalının tarama indekslerine göre düzleştirilmiş diziyi yeniden düzenleyin. Her yeniden sıralanmış diziyi S6 bloğunu kullanarak işleyin. İşlenen diziyi orijinal mekansal sıraya geri döndürün.
- Dört tarama görünümü özelliğini ekleme yolu ve SFusion Mamba yolu üzerinden birleştirerek nihai MV4D çıktısını elde edin. MV4D mimarisi için Şekil 3'e ve tam tensör seviyesinde uygulama iş akışı için Algoritma 1, Ek Dosya 1'e bakınız.
- Models/mvmunet/core.py içindeki tam yazılım uygulamasını kullanın. Bu dosya, tarama indeks üreteçleri PairwiseScanMamba, SequenceS6, SFusion Mamba ve MV4D wrapper modülünü içerir.
- Çok görüşlü tarama indeksleri oluşturun
- Tarama indekslerini models/mvmunet/core.py içinde yayınlanan uygulamayı takip ederek oluşturun. H × W boyutlu bir giriş özellik haritası için, her piksel konumunu tek boyutlu bir indekse düzleştirin: index = r × W + c, burada are ve c sırasıyla satır ve sütun koordinatlarını gösterir.
- Zigzag taramayı sabit r + c ile görüntü çapagonlarını geçerek oluşturun. Her çapraz için geçerli piksel indekslerini toplayın ve her çift numaralı çaprazın sırasını tersine çevirerek geçiş yönünü dönüşümlü yapın.
- Hiyerarşik taramayı görüntüyü dört dörtre ayırarak oluşturun. Alt bölge yüksekliği veya genişliği 2 pikselden büyük olmayana kadar üst sol, üst-sağ, alt-sol ve alt-sağ dörtlükleri sırayla ziyaret edin ve ardından kalan pikselleri satır-majör sırayla gezin.
- Dış görüntü sınırını üst sıra boyunca soldan sağa, sağ sütun boyunca aşağıya, alt sıra boyunca sağdan sola ve sol sütun boyunca yukarı doğru ilerleyerek spiral taramayı oluşturun; sınırı görüntü merkezine doğru kademeli olarak küçültün.
- Radyal taramayı, her pikseli görüntü merkezinden kare mesafesine göre ve ardından atan2 fonksiyonu kullanılarak hesaplanan kutup açısına göre sıralayarak oluşturun.
- Her tarama stratejisi için karşılık gelen ileri tarama sırasını tersine çevirerek ters tarama oluşturun. Öndeki ve geri tarama dizilerini birleştirerek her tarama stratejisi için bir tarama çifti oluşturun ve ardından çiftleri MV4D modülüne aktarın.
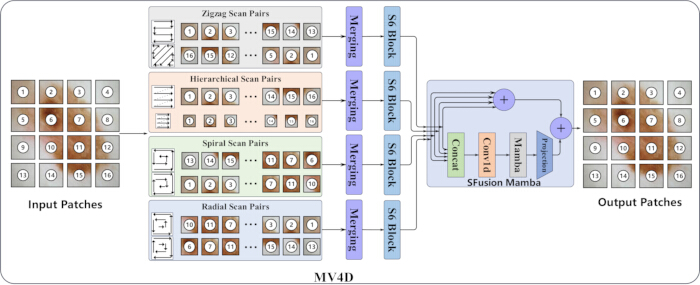
Şekil 3. Multi-View 4-Yönlü (MV4D) modülünün mimarisi. Multi-View 4-Yönlü (MV4D) özellik çıkarma modülünün yapısı. Giriş yamaları, zigzag, hiyerarşik, spiral ve radyal tarama dahil olmak üzere dört tamamlayıcı tarama-çift dalı aracılığıyla işlenir. Dört daldan çıkarılan özellikler birleştirilir, durum-uzay blokları kullanılarak işlenir ve Spatial Fusion Mamba (SFusion Mamba) tarafından entegre edilerek çıktı özellik temsili oluşturulur. Bu figürün daha büyük bir versiyonunu görmek için lütfen buraya tıklayın.
4. MVV Bloğunun İnşası
- MVV Bloğunu bir ana dal ve iki yardımcı şube kullanarak inşa edin. Şekil 4'te gösterilen genel yapıyı kullanın.
- Ana daldaki giriş özelliğine katman normalizasyonu uygulanır. Normalleştirilmiş özelliği doğrusal bir katmana besleyin. Dönüştürülmüş özelliği derinlik açısından ayrılabilir konvolüsiyona aktarın.
- Dönüştürülmüş özelliği derinlik açısından ayrılabilir konvolüsyon kullanarak işleyin. GELU aktivasyon fonksiyonunu uygula. Etkinleştirilen özelliği MV4D modülüne besleyin.
- İlk yardımcı dalı kimlik kalıntısı bağlantısı olarak inşa edin. Giriş özelliğini doğrudan nihai çıkışa bağlayın. Bu dalı orijinal temsilini korumak ve eğitimi stabilize etmek için kullanın.
- İkinci yardımcı kolu bir projeksiyon aşağı-yukarı dal olarak inşa etmek. Giriş özelliğini aşağı projeksiyon katmanı kullanarak sıkıştırın. Özellik boyutunu yukarı projeksiyon katmanı kullanarak geri kazandırın.
- Ana dalın ve her iki yardımcı dalın çıkışlarını birleştirin. Son MVV Blok çıkışını elde edin. Tam mimari için Şekil 4'e bakınız.
- Ana dalın gizli boyutunu giriş kanalı boyutu Cs'ye eşit olarak ayarlayın. Ana doğrusal projeksiyondan önce LayerNorm(Cs) uygulayın ve boyutları Cs→Cs olan doğrusal bir katman kullanın. Derinlik açısından ayrılabilir bir konvolüsyon kullanın; 3×3 derinlik bazında konvolüsyon ile dolgu 1, gruplar = Cs ve önyargı yok, ardından 1×1 nokta başına konvolüsyon ile yanlışlıksız bir konvolüsyon uygulanır.
- Derinlik açısından ayrılabilir konvolüsyondan sonra GELU aktivasyon fonksiyonunu uygulayın. Etkinleştirilmiş özelliği MV4D'ye besin ve Cs→Cs boyutlarında bir çıkış lineer projeksiyonu uygulayın. Projection down-up dalını LayerNorm(Cs) ile yapılandırın; projeksiyon oranı 4, aşağı projeksiyon Cs→Cs/4, GELU aktivasyonu ve yukarı projeksiyon Cs/4→Cs.
- Kimlik dalını, projeksiyon aşağı-yukarı dalı ve drop-path işlenmiş ana dalı eleman bazında toplama ile birleştirerek nihai MVV Blok çıktısını elde edin.
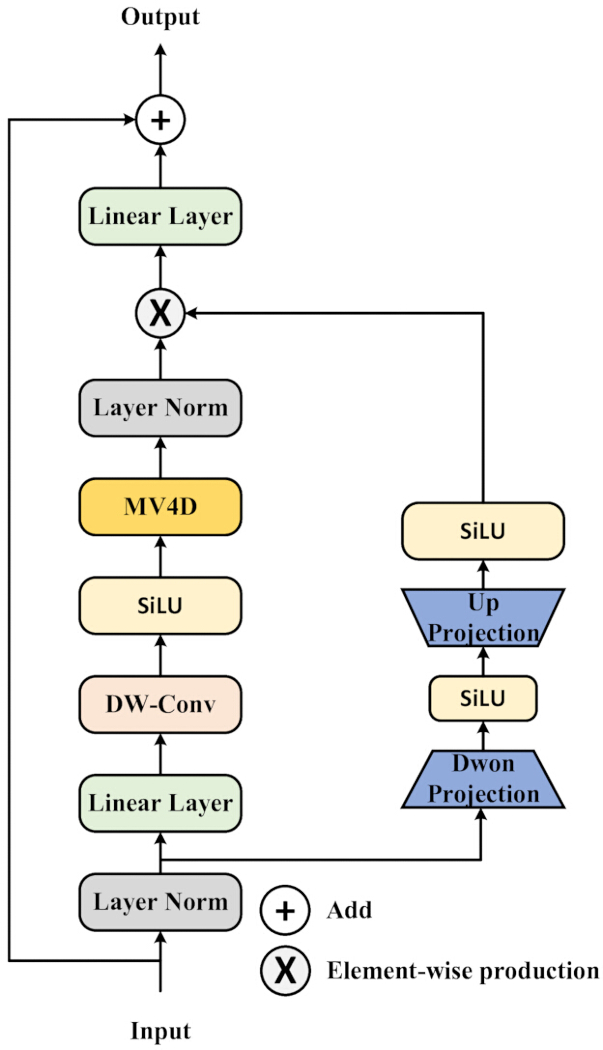
Şekil 4. Çok Görüşlü Görüş (MVV) Bloğunun Mimarisi. Çok Görüşlü Görüş (MVV) Bloğunun Yapısı. Blok, Multi-View 4-Yönlü (MV4D) modülünü içeren ana özellik çıkarma dalından oluşur; derinlik olarak konvolüsyon, normalizasyon ve doğrusal projeksiyon katmanları içerir. Yardımcı yukarı-aşağı projeksiyon dalı, çıkış özellik temsili oluşturmak için kalıntı eklemeden önce elemanlar bazında çarpma yoluyla kapılı özellik modülasyonu sağlar. Bu figürün daha büyük bir versiyonunu görmek için lütfen buraya tıklayın.
5. MFusion Mamba'nın İnşası
- Tüm kodlayıcı aşamalarından özellik haritalarını toplayın. Kodlayıcı özelliklerini, gerektiğinde boyutlandırarak veya yansıtarak birleşik bir temsil alanına hizalayın. Tam tensör seviyesinde uygulama iş akışı için Algoritma 2, Ek Dosya 1'e bakınız.
- Gerektiğinde kodlayıcı özelliklerini hedef mekansal çözünürlüğe göre boyutlandırın. Farklı kanal boyutlarına sahip proje özellikleri aynı kanal boyutuna girer. Çok aşamalı füzyon öncesi tüm kodlayıcı özelliklerini hizalayın.
- Hizalanmış kodlayıcı özelliklerini Kaba, Birleşme bileşenine besleyin. Hadamard ürünü kullanarak kaba füzyon gerçekleştirin. Kabaca birleşmiş temsil oluşturun.
- Kaba, füzyon temsili ince füzyon bileşenine beslenir. İki paralel ince füzyon yolu inşa edin. Her iki yolu bağımsız olarak işleyin.
- İlk ince füzyon yolunu doğrusal bir katman kullanarak işleyin. İkinci İnce Füzyon yolunu yukarı projeksiyon, Conv1d, Mamba ve aşağı projeksiyon kullanarak işleyin. Aşağıya projeksiyondan sonra özellik boyutunu geri getirin.
- İki İnce Füzyon yolunun çıktılarını Hadamard ürünü kullanarak birleştirin. Son doğrusal katmanı uygulayın. MFusion Mamba çıktısını elde edin.
- MFusion Mamba çıkışını çözücüye besleyin. Birleştirilmiş çok aşamalı temsil, kodlayıcı-kodlayıcı atlama özellikleri ile birlikte çözülür. Son segmentasyon haritasını oluşturun.
- Farklı aşamalardan kodlayıcı özelliklerini, kaba füzyondan önce birleşik bir özellik alanına hizalamak. Hizalanmış özellik temsillerini kaba ve ince füzyon aşamaları kullanarak işleyin. MFusion Mamba mimarisi için Şekil 5'e ve tam tensör seviyesinde uygulama iş akışı için Ek Algoritma 2'ye bakınız.
- MFusion Mamba'nın uygulama parametrelerini aşağıdaki gibi kullanın. Her kodlayıcı özelliği Ei için, kanal boyutunu Ci'den Ct'ye yansıtın. Projeksiyon özelliklerini hedef mekansal boyuta göre align_corners=Yanlış olarak bilineşer enterpolasyon kullanarak yeniden boyutlandırın.
- Hizalanmış kodlayıcı özellikleri arasında Kaba Füzyon gerçekleştirmek için Hadamard ürününü uygulayın. İlk İnce Füzyon yolunu C t → C t boyutlarında doğrusal bir katman kullanarak yapılandırın. İkinci İnce Füzyon yolunu yukarı projeksiyonlu Ct → 2Ct, Conv1d, model boyutu 2Ct, bir tarama yönü, durum boyutu 16 ve aşağı projeksiyon 2Ct → Ct ile yapılandırın.
- İnce Füzyon yollarının çıkışlarını Hadamard ürünü kullanarak birleştirin. Ct'den C t'ye boyutlu nihai doğrusal bir projeksiyon uygulayın. Birleşmiş çok aşamalı temsilini çözücüye besleyin.
- MFusion Mamba kullanarak çok aşamalı kodlayıcı özellikleri sigortalamak
- Tüm dört kodlayıcı aşamasından (E1, E2, E3 veE 4) kodlayıcı özelliklerini toplayın ve bunları MFusion Mamba modülüne giriş olarak kullanın. Dekoder füzyonu için yalnızca karşılık gelen aşama kodlayıcı özelliğini seçmeyin.
- Tüm kodlayıcı özelliklerini, mevcut dekoder aşaması için gereken mekânsal çözünürlüğe hizalayın. Kodlayıcı özelliklerini hedef çözünürlüğe göre yeniden boyutlandırın ve özellik birleşmeden önce gerekli kanal boyutuna yansıtın.
- Her kod çözücü aşaması için özellik hizalama prosedürünü tekrarlayın. Kodlayıcı H/16 × W/16, H/8 × W/8 ve H/4 × W/4 koordinatlarında çalıştığında, E1, E2, E3 ve E4'ü uygun hedef özellik alanına yeniden boyutlandırılıp projeksiyon yapın.
- MFusion Mamba modülünün Kabaca Füzyon ve İnce Füzyon işlemleriyle hizalanmış çok aşamalı kodlayıcı özelliklerini birleştirin ve birleşen temsil, ilgili ölçekte dekoder özellikleriyle birleştirin.
- Models/mvmunet/core.py'de yayınlanan uygulamaya göre özellik projeksiyonu, yeniden boyutlandırma ve füzyon işlemlerini gerçekleştirin.
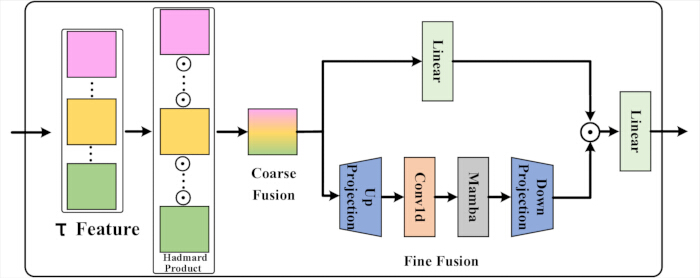
Şekil 5. Çok aşamalı Fusion Mamba (MFusion Mamba) modülünün mimarisi. Çok aşamalı Füzyon Mamba (MFusion Mamba) modülünün yapısı. Çok ölçekli kodlayıcı özellikleri önce kaba füzyon ile birleştirilir ve ardından doğrusal projeksiyon, tek boyutlu konvolüsyon (Conv1d), bir Mamba bloğu ve özellik projeksiyon katmanlarından oluşan İnce Füzyon modülü aracılığıyla geliştirilir; bu modül çözücü tarafından kullanılan birleşmiş özellik temsili oluşturulur. Bu figürün daha büyük bir versiyonunu görmek için lütfen buraya tıklayın.
6. Model eğitimi
- MVM-UNet'i Ubuntu 22.04.1 üzerinde Linux çekirdeği 6.8.0 sürümüyle eğitin. 13. nesil Intel Core i9-13900K CPU ve NVIDIA A800 GPU ile donatılmış bir iş istasyonu kullanın. Eğitim ve değerlendirme boyunca aynı donanım konfigürasyonunu kullanın.
- Modeli PyTorch 2.0.1 ile CUDA 11.8 kullanarak uygulayın ve eğitin. Eğitimden önce tüm gerekli yazılım bağımlılıklarını kurun.
- AdamW optimizer'ini 3 × 10⁻⁵, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁸ ve ağırlık kaybı 0.01 olan AdamW optimizatorunu kullanın. Parti büyüklüğünü 32 olarak ayarlayın, aksi belirtilmedikçe.
- Her modeli 300 dönem boyunca eğitin. ηmin = 1 × 10⁻⁵ olan bir kosinüs tavlama öğrenme hızı takvimi kullanın. Giriş görüntü boyutunu ISIC 2017 ve ISIC 2018 için 256 × 256, Synapse için ise 224 × 224 olarak ayarlayın.
- Ana karşılaştırma deneyleri için üç bağımsız rastgele tohum (1, 52 ve 100) kullanın. Her tohum için tam eğitim ve değerlendirme prosedürünü tekrarlayın. Nihai nicel sonuçları üç koşu boyunca ortalama ± SD olarak bildirin.
- Tüm ablasyon çalışmaları için aksi belirtilmedikçe sabit rastgele 100 tohum kullanın. Tüm ablasyon deneylerinde veri seti bölümlerini, ön işlem stratejisini, ağ mimarisini, optimize edicisini, öğrenme hızını, parti büyüklüğünü ve eğitim dönemi sayısını değiştirmeden tutun.
- ISIC 2017 ve ISIC 2018'de ikili lezyon segmentasyonu için BCE-Dice kaybını kullanın. BCE ve zar kaybı ağırlıklarını 1.0'a ayarlayın. Synapse için CE-Dice kaybını kullanın ve hem çapraz entropi hem de zar kaybı ağırlıklarını 1.0'a ayarlayın.
- ISIC 2017 ve ISIC 2018 eğitim görüntülerini Adım 1'de tanımlanan ön işleme prosedürünü kullanarak yeniden boyutlandırın, normalize edin ve artırın. Adım 1'de açıklandığı gibi Synapse eğitim görgelerine yeniden boyutlandırma, rastgele dönüş ve rastgele çevirme uygulayın. Tüm antrenman çalışmalarında aynı ön işleme ayarlarını kullanın.
- Veri setine özgü doğrulama protokolüne göre model kontrol noktalarını seçin. ISIC 2017 ve ISIC 2018 için en iyi doğrulama performansına sahip kontrol noktasını kaydedin ve her 30 dönemde bir doğrulama yapın. Synapse'ı 300 dönem boyunca doğrulama seti olmadan eğitin ve test için son eğitim kontrol noktasını kullanın.
- ISIC 2017 ve ISIC 2018 modellerinde sadece resmi doğrulama setini kullanın. Synapse test setini eğitim, hiperparametre ayarlama veya kontrol noktası seçimi için kullanmayın. Tüm test verilerini yalnızca nihai değerlendirme için ayırın.
- Tekrarlanabilirlik için aşağıdaki eğitim parametrelerini kullanın. Tüm veri setleri için toplu boyutu 32'ye ayarlayın. AdamW'yi 3 × 10⁻⁵, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁸ ve ağırlık kaybı 1 × 10⁻² ile kullanın.
- ISIC 2017 ve ISIC 2018 için kosinüs tavlama öğrenme hızı zamanlayıcısını Tmax = 50 ve ηmin = 1×10⁻⁵ olarak yapılandırın. Zamanlayıcıyı Tmax = 100 ve ηmin = 1×10⁻⁵ olarak Synapse için yapılandırın. Tüm tekrarlanan deneyler için zamanlayıcı konfigürasyonunu değiştirmeden tutun.
- Tüm modelleri tam hassasiyetli FP32 aritmetiği ile eğitin. Otomatik karma hassasiyetli eğitimi devre dışı bırakın. Optimizasyon sırasında gradyan krampası uygulamayın.
- Tüm karşılaştırma deneylerinde, ablasyon çalışmalarında ve tekrarlanabilirlik çalışmalarında hassasiyet ayarlarını, gradyan güncelleme stratejisini, optimizator yapılandırmasını, öğrenme hızı takvimini ve rastgele tohum protokolünü değiştirmeden tutun.
- En iyi model kontrol noktasını seçin
- ISIC 2017 ve ISIC 2018 veri setleri için her eğitim döneminden sonra doğrulama setinde modeli değerlendirin.
- Her doğrulama partisi için İkili Çapraz Entropi (BCE)-Zar kaybını hesaplayın ve tüm doğrulama seti boyunca ortalama doğrulama kaybını hesaplayın.
- Ortalama doğrulama kaybı daha önce kaydedilen minimum doğrulama kaybından daha düşük olduğunda mevcut modeli en iyi kontrol noktası olarak saklayın.
- Doğrulama sırasında sadece performans izleme için Union (mIoU), zar benzerlik katsayısı (DSC), doğruluk (Acc), özgüllük (Spe) ve hassasiyet (Sen) üzerinden ortalama kesişim kaydı yapın. Bu metrikleri kontrol noktası seçimi kriteri olarak kullanmayın.
7. Model değerlendirmesi
- Her veri seti için resmi test seti kullanılarak eğitilen modeli değerlendirin. Test setini yalnızca nihai performans değerlendirmesi için kullanın.
- ISIC 2017 ve ISIC 2018 için mIoU, DSC, Acc, Sen ve Spe hesaplanın. Tüm hesaplamalar için piksel düzeyinde gerçek pozitifler (TP), yanlış pozitifler (FP), gerçek negatifler (TN) ve yanlış negatifler (FN) kullanın.
- ISIC 2017 ve ISIC 2018 için model çıktısına sigmoid aktivasyon fonksiyonu uygulan. Olasılık haritasını 0.5 eşik kullanarak ikili segmentasyon maskesine dönüştürün. Değerlendirme metriklerini Denklemler 2–6 kullanarak hesaplayın:
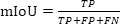 (2)
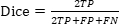 (3)
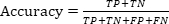 (4)
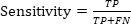 (5)
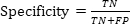 (6)
- Synapse için, model çıktısına softmax aktivasyon fonksiyonunu uygulayın. Her piksel veya voxel, argmax işlemini kullanarak en yüksek olasılıklı sınıfa atayın. Her ön plan organı için DSC ve 95. perdelik Hausdorff mesafesini (HD95) hesaplayın ve tüm test vakalarında ortalama değerleri raporlayın.
- MVM-UNet'i temsil eden CNN tabanlı, Transformer tabanlı ve durum-uzay modeli (SSM) tabanlı segmentasyon yöntemleriyle karşılaştırın. Tüm yöntemler için aynı veri seti bölümlerini, ön işleme prosedürlerini, giriş çözünürlüklerini ve değerlendirme metriklerini kullanın.
- ISIC 2017 ve ISIC 2018 için resmi eğitim, doğrulama ve test bölümlerini kullanın. Synapse için standart 18 eğitim vakası ve 12 test vakası bölünmesini kullanın. Giriş çözünürlüğünü ISIC veri setleri ve Synapse için ayarlayın.
- Mevcut olan zaman resmi uygulamalarıyla temel yöntemleri yeniden üretin. Rapor, tekrarlanan çalışmalarda ortalama ± SD olarak sonuçları yeniden yayımladı. Orijinal olarak yayımlanan literatür verilerini koruyun ve ilgili tablo notlarında ayırt edin.
- Aksi belirtilmedikçe sabit rastgele 100 tohum kullanarak ablasyon çalışmaları yapın. Tüm ablasyon deneylerinde veri seti bölümlerini, ön işleme prosedürü, giriş çözümlemesi, optimize edici, öğrenme hızı takvimi, parti büyüklüğü, epoch sayısı, kayıp fonksiyonu ve değerlendirme metriklerini değiştirmeden tutun.
- MV4D, SFusion Mamba, MVV Bloğundaki Yukarı-Aşağı Projeksiyon dalı, MFusion Mamba, giriş görüntü boyutu, kopma değeri ve kodlayıcı-kodlayıcı katmanı yapılandırmasının katkılarını değerlendirin. Her ablasyon deneyinde yalnızca hedef bileşeni veya parametreyi değiştirin.
- ISIC 2017 ve ISIC 2018 için eşleştirilmiş görüntü sonuçları ve Synapse için eşleştirilmiş vaka sonuçları kullanılarak Wilcoxon imzalı sıralama testini gerçekleştirin. İstatistiksel anlamlılığı belirtmek için 0.05'ten küçük bir p-değeri düşünün.
- Tüm yöntemler için aynı donanım ortamı ve giriş çözünürlüğü kullanılarak hesaplama verimliliğini değerlendirin. Dönem başına eğitim süresini, görüntü başına çıkarım süresini, eğitim sırasında GPU belleğinin zirve kullanımını, model parametrelerinin sayısını ve kayan nokta işlemlerini (FLOP'lar) ölçün. Tek bir ileri pas kullanarak FLOP'ları hesaplayın.
- Model değerlendirmesi tamamlandıktan sonra yalnızca test setinden temsil niteliksel örnekler seçin. Orijinal görüntü, gerçek gerçek maskesi ve tahmin edilen maske, tüm yöntemlerde aynı test vakalarını kullanarak karşılaştırın. Küçük hedefler, düzensiz sınırlar, belirsiz sınırlar ve temsil çok organlı yapıları içeren temsilci örnekleri seçin.
- Değerlendirme metriklerini hesaplayın ve istatistiksel analiz yapın
- ISIC 2017 ve ISIC 2018 veri setleri için segmentasyon metriklerini Python ile NumPy ve sklearn.metrics.confusion_matrix kullanarak hesaplayın. Tahmin edilen olasılık haritasını 0.5'e eşik olarak belirleyin, piksel düzeyinde TP, FP, TN ve FN'yi alın ve bu değerlerden mIoU, DSC, Acc, Sen ve Spe'yi hesaplayın.
- Synapse veri seti için DSC ve HD95'i sırasıyla medpy.metric.binary.dc ve medpy.metric.binary.hd95 kullanarak hesaplayın. Değerlendirme metriklerini hesaplamadan önce model çıktısına softmax ve ardından argmax uygulayın.
- Tek bir ileri geçişle thop.profile kullanarak FLOP sayısını ve eğitilebilir parametreleri hesaplayın.
- Wilcoxon imzalı sıralama testini scipy.stats.wilcoxon kullanarak Python'da gerçekleştirin. ISIC 2017 ve ISIC 2018 veri setleri için eşleştirilmiş görüntü başına metrik değerleri ve Synapse veri seti için çiftleştirilmiş vaka başına metrik değerler kullanın.
8. Kayıp fonksiyonu tanımı
- Çok sınıflı segmentasyon için standart Çapraz Entropi (CE) kaybını, ikili segmentasyon için ise standart BCE kaybını kullanın. Segmentasyon için standart Zar kaybı formülasyonunu kullanın. 7–11 denklemleri bu protokolde kullanılan kayıp fonksiyonlarını tanımlar.
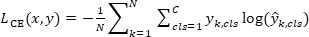 (7)
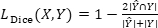 (8)
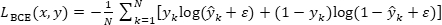 (9)
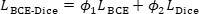 (10)
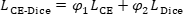 (11)
- ISIC 2017 ve ISIC 2018 için BCE ve zar kaybı ağırlıklarını 1.0 olarak ayarlayın;
 böylece 1 = 1.0 ve 2 = 1.0. Synapse için CE ve zar kaybetme ağırlıklarını 1.0 olarak ayarlayın, örneğin 1 = 1.0 ve φ 2 = 1.0 gibi φ.
- Kayıp fonksiyonlarını utils.py'de uygulayın. nn kullanın. BCE terimi ve nn için BCELoss. CE dönemi için CrossEntropyLoss (CrossEntropyLoss) için geçerlidir. İkili Zar kaybı, tahmin edilen maske ve zemin-doğruluk maskesini düzleştirerek, her örnek için zar kaybını hesaplayarak ve parti boyunca kaybın ortalamasını hesaplayın. Çok sınıflı zar kaybını, hedef etiket haritasını tek sıcak formata dönüştürerek, model çıktısına softmax uygulayarak, her sınıf için zar kaybını hesaplayarak ve tüm sınıflar arasında kaybı ortalamayı hesaplayarak hesaplayın.
- İkili zar kaybı için yumuşatma sabitini 1 olarak, çok sınıflı zar kaybı için ise 1×10⁻⁵ olarak ayarlayın. BCE-Zar kaybını, wb = 1 ve wd = 1 ile BceDiceLoss sınıfını kullanarak uygulayın. CE-Zar kaybını CeDiceLoss sınıfı kullanarak loss_weight = [1, 1] ile uygulayın. Tüm veri setleri, rastgele tohumlar ve deneyler için yumuşatma sabitlerini, azaltma stratejisini ve yazılım uygulamasını değiştirmeden tutun.
- Kayıp azaltma yapılandırılması
- Instantiate nn. BCELoss() ve nn. CrossEntropyLoss() ile birlikte indirgeme argümanını açıkça belirtmeden CrossEntropyLoss() ile karşılaşır.
- Her iki kayıp fonksiyonu için varsayılan PyTorch kayıp azaltma ayarını (azaltma = "ortalama") kullanın. İnredasyon = "toplam" veya azaltılmamış kayıp çıktısı kullanmayın.
9. Tekrarlanabilirlik ayarları ve uygulama
- Yayınlanan uygulamayı https://github.com/LIXUEGUANG002/MVM-UNet'dan indirin. Depo, Materyaller Tablosu'nda listelenen yazılım paketleri, veri setleri, donanım özellikleri ve hesaplama kaynaklarıyla birlikte kullanın.
- Depoyu klonlayın ve git clone https://github.com/LIXUEGUANG002/MVM-UNet.git çalıştırarak proje dizinine girin, ardından cd MVM-Unet ile devam edin.
- ISIC 2017 veya ISIC 2018 deneyini, veri seti adı, veri seti yolu, giriş boyutu, parti büyüklüğü, epoch sayısı, kayıp fonksiyonu, optimizator, öğrenme hızı zamanlayıcısı ve rastgele tohumu configs/config_setting.py'de ayarlayarak yapılandırın. Eğitim betisini depo kökünden python train.py kullanarak çalıştırın.
- Synapse deneyini, configs/config_setting_synapse.py'de veri seti adı, eğitim veri yolu, test hacmi yolu, liste dizini, giriş boyutu, sınıf sayısı, toplu büyüklüğü, epoch sayısı, kayıp fonksiyonu, optimizator, öğrenme hızı zamanlayıcısı ve rastgele tohum ayarları ile yapılandırmak/. Eğitim betesini depo kökünden python train_synapse.py kullanarak çalıştırın.
- Yalnızca çıkarma değerlendirmesini gerçekleştirmek için only_test_and_save_figs = Doğru, best_ckpt_path eğitilmiş kontrol noktasına ve img_save_path ilgili yapılandırma dosyasındaki çıktı dizinine ayarlayın. ISIC 2017 veya ISIC 2018 için python train.py çalıştırın, tahmin sonuçları ve niteliksel rakamlar oluşturmak için Synapse için python train_synapse.py çalıştırın.
- Yayınlanan kaynak kodu sürümünü kullanın
- Yayınlanan GitHub deposunu klonlayın ve veri setlerini, eğitim betiklerini ve değerlendirme ayarlarını yapılandırmadan önce master dalda commit ee891b42c2f2f1d4463adc5e103e üzerinde inceleyin.
- Bu taahhüdü kullanarak bu çalışmada bildirilen deneyleri tekrar edin. El yazması revizyonu sırasında depo için etiketlenmiş bir sürüm mevcut değildi.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Beklenen sonuçlar ve yorumlama
Bu protokol doğru uygulandığında, eğitilmiş MVM-UNet modelinin çoğu değerlendirme metrikinde farklı rastgele tohumlar arasında sadece küçük farklılıklarla tekrarlanan çalışmalar arasında istikrarlı segmentasyon performansı üretmesi beklenmektedir. ISIC 2017 ve ISIC 2018 için başarılı sonuçlar, yüksek DSC, mIoU, Acc, Sen ve Spe değerleri ile yer-gerçeklik lezyon sınırlarını yakından takip eden öngörülen lezyon maskeleriyle yansıtılır (
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Bu protokol, Mamba tabanlı tıbbi görüntü segmentasyon çerçevesi olan MVM-UNet'i tanımlar. Yöntem, mevcut segmentasyon modellerinin iki sınırlamasını ele almak için tasarlandı. Birincisi, geleneksel CNN tabanlı yöntemler, karmaşık tıbbi görüntülerde uzun vadeli bağımlılıkları ve hiyerarşik bağlamsal bilgileri modelleme konusunda sınırlı bir yetkiyesahiptir 43. İkinci olarak, Transformer tabanlı yöntemler küresel bağlamı modelleyebilir ancak genellikle daha yüksek h...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarlar, rekabet eden finansal çıkarları olmadığını belirtirler.
Teşekkürler
Bu araştırma dış bir fon almadı.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 with Linux kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB local storage. | Training, validation, testing, ablation, and inference-only experiments için hesaplama platformu. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB bellek). | GPU hızlandırmalı model eğitimi ve çıkarımı. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13. Nesil Intel Core i9-13900K CPU. | Veri yükleme, ön işleme ve deney yürütme için ana işlemci. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB sistem RAM | Veri seti yükleme, ön işleme ve eğitim için bellek. |
| Hardware - Storage | Institutional computing platform / local workstation | 2 TB NVMe katı hal sürücüsü. | Veri setleri, kontrol noktaları, günlükler ve oluşturulan tahmin şekilleri için depolama. |
| Software environment - Operating system | Canonical Ltd. | Önerilen: Ubuntu 22.04.1 LTS | Hesaplama ortamı için işletim sistemi. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Ortam adı: mvmunet | Bağımlılıkları yüklemek ve izole etmek için kullanılan Python ortamı. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Uygulama ve deney yürütme için kullanılan programlama dili. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | PyTorch ve Mamba ile ilgili paketler tarafından gerektirilen GPU hesaplama arka ucu. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | PyTorch aracılığıyla kullanılan GPU hızlandırmalı derin öğrenme ilkelileri. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Model eğitimi, kayıp hesaplaması, optimizasyon ve çıkarım için derin öğrenme çerçevesi. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Ön işleme ve artırma sırasında kullanılan görüntü dönüştürme yardımcı programları. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Önerilen PyTorch ortamı ile birlikte yüklenir. |
| Python package - timm | timm developers | timm == 0.4.12 | Depolama ortamı talimatlarında listelenen model bileşeni veya yardımcı program bağımlılığı. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | GPU hızlandırmalı dizi modelleme bileşenleri tarafından kullanılan bağımlılık. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Mamba uygulaması tarafından gerektirilen verimli nedensel evrişim bağımlılığı. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Mamba/S6 ile ilgili bileşenler için kullanılan durum-uzay dizi modelleme paketi. |
| Python package - NumPy | NumPy developers | NumPy sürümü 1.24.3. | Sayısal hesaplama ve dizi işlemleri. |
| Python package - SciPy | SciPy developers | SciPy sürümü 1.10.1. | Bilimsel hesaplama; scipy.ndimage.zoom, utils.py'de içe aktarılır. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK sürümü 2.2.1. | utils.py'de içe aktarılan tıbbi görüntü giriş/çıkışı ve ön işleme yardımcı programı. |
| Python package - MedPy | MedPy developers | MedPy sürümü 0.4.0. | utils.py'de içe aktarılan tıbbi görüntü metrik hesaplama paketi. |
| Python package - scikit-image | scikit-image developers | scikit-image sürümü 0.21.0. | README'de listelenen görüntü işleme bağımlılığı. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn sürümü 1.3.2. | README'de listelenen makine öğrenimi yardımcı programı paketi. |
| Python package - matplotlib | Matplotlib developers | Matplotlib sürümü 3.7.2. | Niteliksel görselleştirme şekillerini kaydetmek için kullanılır. |
| Python package - h5py | h5py developers | h5py sürümü 3.9.0. | Synapse test hacimleri için HDF5 dosya desteği. |
| Python package - thop | THOP developers | THOP sürümü 0.1.1.post2209072238. | FLOP'lar ve parametreyle ilgili hesaplama maliyeti hesaplanırken kullanılır. |
| Python package - packaging | Python Packaging Authority | packaging sürümü 23.1. | README'de listelenen bağımlılık. |
| Python package - pytest | pytest developers | pytest sürümü 7.4.0. | README'de listelenen bağımlılık. |
| Python package - chardet | chardet developers | chardet sürümü 5.2.0. | README'de listelenen bağımlılık. |
| Python package - yacs | YACS developers | yacs sürümü 0.1.8. | README'de listelenen yapılandırma yardımcı programı bağımlılığı. |
| Python package - termcolor | termcolor developers | termcolor sürümü 2.3.0. | README'de listelenen oturum açma/terminal yardımcı programı bağımlılığı. |
| Python package - submitit | submitit developers | submitit sürümü 1.4.5. | README'de listelenen deney/iş yardımcı programı bağımlılığı. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX sürümü 2.6.2.2. | README'de listelenen eğitim günlüğü görselleştirme yardımcı programı. |
| Python package - ml-collections | ml_collections developers | ml-collections sürümü 0.1.1. | configs/config_setting_synapse.py tarafından içe aktarılır. |
| Dataset |
Kaynaklar
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.