Bu çalışma, iddia düzeyinde doğrulama ve adaptif istatistiksel eşikleme yoluyla büyük dil modellerindeki halüsinasyonları azaltmaya yönelik hafif bir çerçeve sunmaktadır. Desteklenmeyen iddiaları Doğal Dil Çıkarımı kullanarak seçici bir şekilde düzelten bu yaklaşım, düşük yanıt gecikmesini ve pratik dağıtım verimliliğini korurken olgusal doğruluğu artırmaktadır.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Büyük Dil Modellerinde Düşük Gecikmeli Halüsinasyon Azaltma için İstatistiksel Karar Modelleme ile Adaptif NLI Güdümlü İddia Doğrulama
Bu makalede
Özet
Özet
Büyük Dil Modelleri (LLM'ler), gerçekle bağdaşmayan ancak dilsel olarak akıcı çıktılar üretme şeklinde tanımlanan ve halüsinasyon olarak adlandırılan kritik bir eğilim sergilemektedir; bu durum, hassasiyet gerektiren uygulamalarda ciddi riskler oluşturur. Geri çağırma ile desteklenmiş üretim (retrieval-augmented generation) ve öz-tutarlılık örneklemesi (self-consistency sampling) dahil olmak üzere mevcut azaltma stratejileri, ya önemli düzeyde çıkarım gecikmesine yol açmakta ya da harici bilgi altyapısına bağımlı kalmaktadır ve bu da gerçek zamanlı dağıtımlardaki uygulanabilirliklerini sınırlamaktadır. Bu makale, LLM yanıtlarını atomik olgusal iddialara ayıran ve çıkarılan her bir iddiayı, izole bir olgusal hatırlama istemi aracılığıyla ayrı olarak üretilen bir referansa karşı bağımsız olarak doğrulayan hafif, iki aşamalı bir iddia doğrulama çerçevesi önermektedir. Üretici ve doğrulayıcı aynı temel dil modelini paylaşsa da, yanıt üretimini olgusal hatırlamadan ayırmak, Doğal Dil Çıkarımı (NLI) kullanarak doğrudan yanıt koşullandırmasını azaltmakta ve doğrulama sırasında onaylama yanlılığını hafifletmektedir; ayrıca yalnızca çelişen iddiaları seçerek düzeltmek için NLI güven puanı dağılımı üzerinden τ = µ + kσ olarak tanımlanan adaptif bir istatistiksel eşik uygulamaktadır. Sabit karar sınırlarına dayanan önceki NLI tabanlı yöntemlerin aksine, önerilen çerçeve doğrulama eşiğini her yanıtın güven dağılımına göre dinamik olarak uyarlamakta ve model yeniden eğitimine ihtiyaç duymadan değerlendirilen kıyaslamalarda tutarlı bir performans sergilemektedir. TruthfulQA ve FEVER üzerinde değerlendirilen çerçeve, TruthfulQA'daki halüsinasyon oranını %28'den %9'a indirerek %67,9 oranında bağıl bir azalma sağlamış, temel LLM'e kıyasla yalnızca 160 ms ek gecikme oluşturmuş ve halüsinasyon tespit doğruluğunda SelfCheckGPT ile FActScore'u geride bırakmıştır. Bu sonuçlar, çerçevenin değerlendirilen kıyaslamalarda olgusal güvenilirlik ile yanıt gecikmesi arasında uygun bir denge sağlayabileceğini göstermektedir; ancak farklı alanlar ve dağıtım ortamlarında daha fazla doğrulama yapılması gerekmektedir.
Giriş
Büyük Dil Modelleri (LLM'ler), metin oluşturma, soru yanıtlama, özetleme ve karmaşık akıl yürütme dahil olmak üzere geniş bir doğal dil görevleri yelpazesinde dikkat çekici yetenekler sergileyerek modern yapay zeka sistemlerinin temel bileşenleri olarak ortaya çıkmışlardır1. Akıcı ve bağlamsal olarak tutarlı yanıtlar üretme yetenekleri; klinik karar desteği, hukuki analiz, yazılım mühendisliği ve eğitim teknolojileri gibi yüksek etkili alanlarda benimsenmelerini hızlandırmıştır2. Ancak, bu ortamlardaki güvenilirliklerini sarsan kritik ve kalıcı bir sınırlama mevcuttur: modellerin dilsel olarak akıcı ancak olgusal olarak yanlış, desteklenmeyen veya tamamen uydurma yanıtlar ürettiği halüsinasyon durumu 3. Ampirik çalışmalar, göreve ve modele bağlı olarak %15'ten %40'ın üzerine kadar değişen halüsinasyon oranları bildirmekte olup, GPT-4 gibi en güncel sistemler bile alana özgü değerlendirmeler altında ölçülebilir olgusal tutarsızlıklar sergilemektedir2,3. Bu sınırlama, hatalı çıktıların yanlış bilgilendirmeye, yanlış teşhise veya kusurlu karar verme süreçlerine yol açabileceği hassas uygulamalarda ciddi riskler oluşturmaktadır4. Halüsinasyonlar temel olarak dil modellemenin olasılıksal doğasından kaynaklanmaktadır; LLM'ler, doğrulanmış olgusal bilgileri geri çağırarak veya bunlar üzerinden akıl yürüterek değil, girdi dizilerinin istatistiksel olarak olası devamlarını tahmin ederek token'lar üretirler5. Bunun bir sonucu olarak, üretilen çıktılar kulağa makul gelen ancak yanlış iddialar içerebilir, desteklenmeyen önermeler sunabilir veya anlamsal olarak ilişkili ancak olgusal olarak farklı kavramları birbirine karıştırabilir6.
Mevcut azaltma stratejileri, her biri belirgin sınırlamalara sahip birkaç paradigma aracılığıyla bu sorunu ele almaktadır. Geri Getirme ile Artırılmış Üretim (RAG), yanıtları dışarıdan getirilen belgelere dayandırarak halüsinasyonları azaltır; ancak önemli bir gecikme yükü getirir, bakımı yapılan bilgi tabanlarına erişim gerektirir ve uzmanlaşmış veya düşük kaynaklı alanlardaki geri getirme hatalarına karşı savunmasız kalmaya devam eder7,8,9.
Yanıt oluşturucu ve referans oluşturucu, aynı temel GPT-3.5 Turbo modeli kullanılarak örneklendirilmiş olsa da, farklı istemleme hedefleri ve yürütme bağlamları altında çalışırlar. Yanıt oluşturucu, kullanıcı sorgusuna kısıtlanmamış bir cevap üretirken; referans oluşturucu, daha önce üretilmiş yanıta erişimi olmaksızın izole bir olgusal hatırlama görevi gerçekleştirir. Bu ayrım, doğrudan yanıt koşullandırma etkilerini azaltır ve iddia doğrulama sırasında onaylama yanlılığını sınırlar. Bu nedenle çerçeve, üretilen referansı istatistiksel olarak bağımsız değil, prosedürel olarak bağımsız kabul eder.
Güncel araştırmalar ayrıca, harici geri çağırma veya tekrarlanan doğrulamalara dayanmadan, metin üretimindeki halüsinasyonları azaltmak için hafif ağırlıklı kod çözme stratejilerini de incelemiştir. Temsili yaklaşımlardan biri olan Katmanları Karşılaştırarak Kod Çözme (DoLA), kod çözme sırasında ara ve final transformer katmanlarından gelen temsilleri karşılaştırarak gerçekliği artırır. Üretim sonrası doğrulama çerçevelerinin aksine, bu yöntemler doğrudan token üretimi sırasında müdahale eder ve bu nedenle dil üretim sürecinin farklı bir aşamasını optimize eder. Bu tamamlayıcı stratejiler, halüsinasyon azaltmanın ya kod çözme sırasında ya da üretim sonrası doğrulama yoluyla gerçekleştirilebileceğini göstermekte olup, her yaklaşım hesaplama maliyeti, uygulama karmaşıklığı ve gerçeklik güvenilirliği açısından farklı ödünleşimler sunmaktadır.
Öz-tutarlılık yöntemleri, birden fazla yanıt örneği alarak ve en sık tekrarlanan veya tutarlı çıktıyı seçerek olgusal güvenilirliği artırır; ancak hesaplama maliyetleri örnek sayısıyla doğrusal olarak artar, bu da onları gecikmeye duyarlı dağıtımlar için uygunsuz kılar8. Öz-geribildirim döngüleri aracılığıyla çıktıları defalarca gözden geçiren yinelemeli iyileştirme yaklaşımları, hata oranlarını kademeli olarak azaltır ancak her ek geçişle birlikte çıkarım süresini önemli ölçüde uzatır9. NLI tabanlı doğrulama yöntemleri, üretilen iddialar ile referans metinler arasındaki anlamsal gerektirmeyi değerlendirerek daha hedef odaklı bir alternatif sunar; fakat mevcut uygulamalar, farklı güven dağılımlarına, alanlara veya model davranışlarına uyum sağlayamayan sabit karar eşiklerine dayanmaktadır10,11. Toplu olarak değerlendirildiğinde, bu yaklaşımlar ya kabul edilemez bir hesaplama yükü getirir, ya harici altyapılara bağımlıdır ya da genel dağıtım için gereken uyumluluğa sahip değildir. Bu halüsinasyon doğrulama yaklaşımlarının temel özelliklerinin bir karşılaştırması Ek Tablo 1'de sunulmuştur.
Bu makale, düşük yanıt gecikmesini korurken LLM çıktılarındaki halüsinasyonları azaltmak için tasarlanmış, hafif ve iki aşamalı bir iddia doğrulama çerçevesi önermektedir. İlk aşamada, LLM bir başlangıç yanıtı oluşturur ve bu yanıt daha sonra atomik olgusal iddialara ayrıştırılır. İkinci aşamada, her bir iddia, orijinal oluşturulan yanıta erişim sağlamayan bağımsız bir muhakeme geçişiyle üretilen ayrı bir olgusal referansa karşı Doğal Dil Çıkarımı (NLI) kullanılarak doğrulanır ve istatistiksel olarak türetilmiş bir güven eşiği, iddia düzeyindeki kabul etme veya düzeltme kararını yönetir. Bu çalışmanın temel katkıları şunlardır: (1) Yanıt oluşturmayı olgusal doğrulamadan ayıran, harici veri getirme veya tam yanıtın yeniden oluşturulmasına gerek kalmadan her bir atomik iddianın bağımsız ve hedefli değerlendirilmesine olanak tanıyan iki aşamalı bir iddia düzeyinde doğrulama hattı; (2) NLI güven puanlarının dağılımına dayalı, sabit karar kurallarına güvenmek yerine kabul ve düzeltme sınırlarını dinamik olarak belirleyen ve farklı güven dağılımlarında sağlamlığı artıran adaptif bir istatistiksel eşikleme mekanizması (τ = µ + kσ); (3) Yeniden oluşturmayı yalnızca çelişkili olarak sınıflandırılan iddialarla sınırlayan ve tam yanıt yeniden örnekleme veya yinelemeli iyileştirme yaklaşımlarına kıyasla hesaplama yükünü önemli ölçüde azaltan seçici bir düzeltme stratejisi; (4) Halüsinasyon odaklı bir benchmark üzerinde yapılan ampirik değerlendirme, önerilen çerçevenin yanıt gecikmesini pratik uygulama sınırları içinde tutarken halüsinasyon oranlarını %28'den %9'a düşürdüğünü göstermektedir.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Bu çalışma insan katılımcı, hayvan, biyolojik örnek veya hasta verisi içermemiştir. Bu nedenle, kurumsal etik onay ve bilgilendirilmiş onam gerekmemiştir.
Çalışma tasarımına genel bakış
Büyük dil modeli (LLM) çıktılarının olgusal güvenilirliğini artırmak için iki aşamalı bir doğrulama çerçevesi uygulanmıştır. Prosedür; yanıt oluşturma, iddia çıkarma, İzole Referans Oluşturma, Doğal Dil Çıkarımı (NLI) tabanlı doğrulama, adaptif istatistiksel karar verme, seçici düzeltme ve nihai yanıt birleştirme aşamalarından oluşmuştur. Çerçeve, TruthfulQA ve FEVER karşılaştırma veri kümeleri kullanılarak değerlendirilmiştir.
Genel iş akışı
Kullanıcı Sorgusu → İlk Yanıt Oluşturma → İddia Çıkarımı → Bağımsız Referans Oluşturma → NLI Doğrulaması → İstatistiki Eşik Hesaplaması → İddia Düzeltme → Nihai Doğrulanmış Yanıt. Adaptif iddia doğrulama çerçevesinin genel iş akışı Şekil 1'de gösterilmiştir.
Veri seti hazırlama
817 olgu odaklı soru içeren TruthfulQA veri seti12 indirilmiş ve değerlendirme için hazırlanmıştır. FEVER veri seti13, Desteklenen, Çürütülen veya Yetersiz Bilgi olarak etiketlenmiş 185.445 açıklama içerir; değerlendirmede, açıklama, kanıt ve temel gerçek etiket alanlarını içeren etiketli geliştirme verileri kullanılmıştır. Her bir açıklama, kendisine sağlanan kanıtlara göre değerlendirilirken, orijinal FEVER etiketi doğrulama için referans sonuç olarak tutulmuştur. Olgu doğrulama açıklama-kanıt çiftlerini içeren FEVER veri seti temin edilmiş ve ön işlemeden geçirilmiştir. Giriş soruları ve açıklamalar standartlaştırılmış bir metin formatına dönüştürülmüştür. Deneyler öncesinde yinelenen girişler ve eksik örnekler çıkarılmıştır. TruthfulQA, doğrulama ve test alt kümelerine ayrılmıştır. TruthfulQA örneklerinin yaklaşık %20'si (164 soru) eşik ayarı için kullanılırken, kalan 653 soru performans değerlendirmesi için ayrılmıştır. FEVER için, kıyaslama tarafından sağlanan açıklamalar doğrudan doğrulama birimleri olarak kullanılmış ve TruthfulQA'ya uygulanan yanıt oluşturma ve açıklama çıkarma işlemine tabi tutulmamıştır. Çerçevenin geliştirilmesi ve değerlendirilmesi için kullanılan kıyaslama veri setlerinin özellikleri Tablo 1'de özetlenmiştir.
İlk yanıt oluşturma
Her bir sorgu, temel dil modeline gönderilmiştir. Yanıtlar, 0,7 sıcaklık (temperature) ve 0,9 top-p değeri ile nucleus örnekleme kullanılarak oluşturulmuştur. Maksimum çıktı uzunluğu 256 token ile sınırlandırılmıştır. Oluşturulan yanıtlar, herhangi bir son işlem veya manuel düzenleme yapılmadan saklanmıştır. Üretilen metin doğrudan iddia çıkarma aşamasına aktarılmıştır.
İddia çıkarımı
Üretilen her yanıt, bağımsız olarak doğrulanabilir olgusal ifadelere ayrıştırılmıştır. Atomik iddiaları belirlemek için yapılandırılmış bir ayrıştırma istemi kullanılmıştır. Bileşik ifadeler, minimal olgusal birimlere bölünmüştür. Öznel görüşler, üslup ifadeleri ve konuşma dolgu kelimeleri çıkarılmıştır. Çıkarılan her bir iddia, bağımsız bir doğrulama birimi olarak kaydedilmiştir.
Örnek:
Orijinal yanıt:
"Marie Curie, radyoaktivite üzerine öncü araştırmalar yürüten Polonya doğumlu bir fizikçi ve kimyagerdi."
Çıkarılan iddialar: (1) Marie Curie Polonya doğumluydu; (2) Marie Curie bir fizikçi ve kimyagerdi; (3) Marie Curie radyoaktivite üzerine araştırmalar yaptı.
İzole referans konstrüksiyonu:
Çıkarılan her iddia için bağımsız bir olgusal referans oluşturulmuştur. Doğrulayıcı model, yalnızca orijinal kullanıcı sorgusunu almıştır. Onaylama yanlılığını önlemek için orijinal oluşturulmuş yanıta erişim kısıtlanmıştır. Özlü ve kanıta dayalı yanıtları teşvik etmek için olgusal geri çağırma istemi kullanılmıştır. Oluşturulan referanslar, sonraki doğrulama işlemleri için saklanmıştır.
Doğal dil çıkarım doğrulaması
Her bir iddia-referans çifti, önceden eğitilmiş bir NLI modeline sunuldu. NLI modeli ilişkiyi şunlardan biri olarak sınıflandırdı: Gerektirme (Entailment), Nötr (Neutral) veya Çelişki (Contradiction). Üç sınıf için de güven olasılıkları kaydedildi. İşaretli bir doğrulama puanı atandı: Gerektirme için pozitif değer, nötr için sıfır veya çelişki için negatif bir değer. Tüm doğrulama puanları, eşik hesaplaması için toplandı.
Adaptif istatistiksel eşik hesaplaması
NLI modelinin ürettiği doğrulama güveni, farklı sorguların farklı sayıda iddia, semantik karmaşıklık düzeyi ve güven dağılımları oluşturması nedeniyle yanıtlar arasında önemli ölçüde farklılık gösterir. Sabit bir küresel eşik, tüm yanıtların benzer bir güven profili izlediğini varsayar ki bu durum pratikte nadiren gözlemlenir. Bu değişkenliği gidermek için önerilen çerçeve, her bir yanıt için karar sınırını, o yanıtın doğrulama skorlarının ortalamasını ve standart sapmasını kullanarak bireysel olarak tahmin eder. Ortalama, yanıtın genel güven düzeyini yansıtırken, standart sapma çıkarılan iddialar arasındaki güven değerlerinin dağılımını yakalar. Bu adaptif formülasyon, kabul kriterinin tüm girdiler için tek bir eşiğe dayanmak yerine yanıta özgü belirsizliğe göre ayarlanmasına olanak tanır.
Tüm imzalı doğrulama skorlarının ortalaması (µ) ve standart sapması (σ) hesaplanmıştır.
Adaptif karar eşiği şu şekilde hesaplanmıştır:

burada τ adaptif eşiği, µ ortalama doğrulama puanını, σ standart sapmayı ve k hassasiyet parametresini temsil eder.
Hassasiyet parametresi 0,7 olarak belirlenmiştir. Skoru +τ'ye eşit veya daha büyük olan ve Gerektirim (Entailment) olarak sınıflandırılan iddialar kabul edilmiştir. Skoru −τ'ye eşit veya daha küçük olan ve Çelişki (Contradiction) olarak sınıflandırılan iddialar düzeltme için işaretlenmiştir. Skoru (−τ, +τ) aralığında olan iddialar ise nötr olarak tutulmuştur.
Seçici istem düzeltme
Bir iddia, yalnızca NLI modeli iddia-referans çiftini Çelişki (Contradiction) olarak sınıflandırdığında ve ilgili işaretli doğrulama puanı si ≤ -τ adaptif eşik kriterini karşıladığında düzeltme için iletildi. Böylece, düzeltme kararı NLI sınıf etiketi ve yanıta özgü istatistiksel eşik tarafından ortaklaşa belirlendi. si ≥ τ değerine sahip ve Gerektirme (Entailment) olarak sınıflandırılan iddialar kabul edilirken, -τ < si < τ aralığında kalan iddialar nötr olarak değerlendirildi ve düzeltme yapılmadan korundu. Bu birleşik kriter, düzeltmenin yalnızca hem anlamsal çelişki hem de yeterince güçlü negatif doğrulama kanıtı sergileyen iddialara uygulanmasını sağladı.
Yanıt rekonstrüksiyonu
Kabul edilen ve düzeltilen iddialar orijinal sıralarına göre düzenlendi. Okunabilirliği korumak için cümle sınırları yeniden oluşturuldu. Gerektiğinde küçük dilbilgisi düzenlemeleri yapıldı. Birleştirilen çıktı, nihai doğrulanmış yanıt olarak kaydedildi.
Performans değerlendirmesi
Çatı dört metrik kullanılarak değerlendirildi: (1) Doğruluk: Doğrulama sonrası gerçek anlamda doğru kalan yanıtların oranı; (2) F1 Skoru: Halüsinasyon tespit hassasiyeti ve geri çağırma oranının harmonik ortalaması; (3) Yanıt Gecikmesi: Sorgu gönderiminden doğrulanmış yanıt oluşturulmasına kadar geçen toplam işlem süresi; (4) Halüsinasyon Oranı
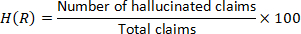
Gecikme süresi, tekrarlanan ölçümler üzerinden ortalama yürütme süresi olarak raporlanmıştır. Her bir çalıştırma için tekil gecikme değerleri saklanmadığından, standart sapmalar ve güven aralıkları hesaplanmamıştır.
Benchmark'a özgü doğruluk değerlendirmesi
TruthfulQA için, nihai doğrulanmış yanıt, kıyaslama ölçütünün insan tarafından onaylanmış yanıt referansları ve yanlış yanıt listeleriyle karşılaştırılmıştır. Bir yanıt, olgusal iddiaları kabul edilen yanıt bilgileriyle tutarlı olduğunda ve belirlenen yanlış yanıt kalıplarına karşılık gelen içerikler barındırmadığında doğru olarak sayılmıştır. FEVER için, nihai çıktıda yer alan her bir iddia, ilgili kanıtı ve orijinal FEVER anotasyonu ile değerlendirilmiştir; Desteklenen (Supported) iddialar olgusal olarak doğrulanmış kabul edilirken, Çürütülen (Refuted) iddialar yanlış olarak sayılmıştır. Yetersiz Bilgi (Not Enough Information) durumları, pozitif olgusal kanıt olarak değerlendirilmek yerine belirsiz olarak bırakılmıştır. Ortaya çıkan iddia düzeyindeki kararlar, raporlanan Doğruluk ve Halüsinasyon Oranı'nı hesaplamak için her bir kıyaslama ölçütü genelinde birleştirilmiştir.
Deneysel ortam
Çerçeve, Python 3.9 kullanılarak uygulanmıştır. Veri işleme işlemleri, sayısal ve tablo analiz kütüphaneleri kullanılarak gerçekleştirilmiştir. NLI modeli, ek bir ince ayar yapılmaksızın çıkarım modunda çalıştırılmıştır. Deneyler; Intel Core i5 işlemci, 16 GB RAM ve 64 bit işletim sistemine sahip bir iş istasyonunda yürütülmüştür. Tüm değerlendirmeler, düşük gecikmeli çalışma sağlamak amacıyla tek geçişli çıkarım ayarı kullanılarak yapılmıştır. Tüm deneyler, veri setleri ve temel yöntemler arasında tutarlı bir değerlendirme sağlamak için özdeş donanım ve yazılım konfigürasyonları kullanılarak gerçekleştirilmiştir.
Beklenen sonuç
Protokol, potansiyel olarak desteklenmeyen iddiaları belirleyerek ve güçlü bir şekilde çelişen iddiaları düzeltme için seçici olarak ileterek iddia düzeyinde doğrulama kararları oluşturmak üzere tasarlanmıştır. Beklenen çıktı, deneysel değerlendirme sırasında gözlemlenen performansa bağlı olarak, gerçeklik tutarsızlıkları azaltılmış ve ek işlem yükü sınırlandırılmış doğrulanmış bir yanıttır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
İlk yanıt oluşturma
Temel dil modeli, her iki kıyaslama veri setindeki sorular için akıcı ve bağlamsal olarak ilgili yanıtlar üretmiştir. Ancak, ayrıntılı bir inceleme, çeşitli yanıtlarda desteklenmeyen ve olgusal olarak yanlış ifadeler olduğunu ortaya çıkarmıştır. TruthfulQA veri setinde temel sistem %28'lik bir halüsinasyon oranı sergilerken, FEVER veri setinde %26'lık bir halüsinasyon oranı gözlemlenmiştir. Bu bulgular, yalnızca doğrudan dil üretiminin yüksek olgusal güveni...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Önerilen çerçeve, tekrarlı örnekleme ve harici veri getirmeden kaçınırken olgusal doğrulama performansını artırmıştır. TruthfulQA üzerinde, halüsinasyon oranı temel LLM için %28'den tam çerçeve ile %9'a düşerken, doğruluk 0,72'den 0,87'ye yükselmiştir. FEVER üzerinde ise halüsinasyon oranı %26'dan %10'a düşmüş, doğruluk ise 0,74'ten 0,89'a çıkmıştır. Bu karşılaştırmalar, farklı uygulama koşullarında evrensel bir üstünlüğün kanıtı olarak değil, bu çalışmada kullanılan deneysel ayarlar ve uygulamalar kapsamında yorumlanmal...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarların beyan edilecek herhangi bir çıkar çatışması yoktur.
Teşekkürler
Yazarlar, bu araştırmayı yürütmek için gerekli olan akademik ortamı ve hesaplama kaynaklarını sağladığı için kurumlarına içten teşekkürlerini sunarlar. Yazarlar ayrıca, önerilen çerçevenin kapsamlı bir şekilde değerlendirilmesine olanak tanıyan, bu çalışmada kullanılan halka açık karşılaştırma veri setlerinin geliştiricilerine ve yöneticilerine teşekkür ederler. Yapıcı geri bildirimleriyle bu çalışmanın kalitesinin ve netliğinin artırılmasına yardımcı olan meslektaşlara ve hakemlere şükranlarını sunarlar. Yazarlar ayrıca, deneylerin gerçekleştirilmesini, veri analizini ve sonuçların görselleştirilmesini kolaylaştıran yazılım kütüphanelerini ve araçlarını sağlayan açık kaynaklı araştırma topluluğuna teşekkür ederler. Topluluğun süregelen çabaları, doğal dil işleme ve güvenilir yapay zeka alanındaki araştırmaları önemli ölçüde ilerletmiştir. Yazarlar, bu araştırma için herhangi bir dış finansal destek veya fon alınmadığını beyan ederler.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| FEVER kıyaslama veri seti | FEVER Shared Task (Thorne et al.) | https://fever.ai/dataset/fever.html | Değerlendirme için kullanılan, iddia-kanıt çiftlerinden oluşan halka açık gerçeklik doğrulama veri seti |
| GPT-3.5 Turbo (büyük dil modeli B10+2:12:12 | OpenAI | Model ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | OpenAI API aracılığıyla erişilen, hem yanıt oluşturucu hem de bağımsız referans oluşturucu olarak kullanılmıştır |
| NumPy | NumPy Geliştiricileri (açık kaynak) | https://numpy.org/ | NLI doğrulama skorlarının ortalaması ve standart sapması dahil olmak üzere istatistiksel hesaplamalar için kullanılan sayısal hesaplama kütüphanesi |
| Openai (Python API istemci kütüphanesi) | OpenAI | https://github.com/openai/openai-python | GPT-3.5 Turbo'ya istemler göndermek ve tamamlamaları almak için kullanılan Python istemci kütüphanesi |
| pandas | pandas Geliştirme Ekibi (açık kaynak) | https://pandas.pydata.org/ | Veri seti ön işleme ve sonuçların yönetimi için kullanılan tablo tabanlı veri analiz kütüphanesi |
| Önceden eğitilmiş Doğal Dil Çıkarımı (NLI) sınıflandırma modeli | Hugging Face model merkezi (Microsoft'un DeBERTa-v3-large mimarisi üzerine kurulu model) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Her bir iddia-referans çiftini gerektirim, nötr veya çelişki olarak sınıflandırmak için, ince ayar yapılmadan çıkarım modunda kullanılmıştır |
| Python | Python Yazılım Vakfı | Sürüm 3.9; https://www.python.org/downloads/release/python-390/ | Doğrulama çerçevesini uygulamak için kullanılan temel programlama dili |
| SciPy | SciPy Geliştiricileri (açık kaynak) | https://scipy.org/ | Deneysel sonuçların istatistiksel analizini desteklemek için kullanılan bilimsel hesaplama kütüphanesi |
| Transformers (Hugging Face Transformers kütüphanesi) | Hugging Face | https://github.com/huggingface/transformers | Önceden eğitilmiş NLI modelini yüklemek ve çalıştırmak için kullanılan Python kütüphanesi |
| TruthfulQA kıyaslama veri seti | Orijinal olarak Lin, Hilton ve Evans tarafından yayınlanmıştır | https://github.com/sylinrl/TruthfulQA | Eşik ayarı ve değerlendirme için kullanılan, 817 olgu odaklı sorudan oluşan halka açık kıyaslama seti |
| İş istasyonu bilgisayarı | Yazımda belirtilmemiştir (lütfen üreticiyi/modeli onaylayın) | Intel Core i5 işlemci; 16 GB RAM; 64-bit işletim sistemi | Tüm deneyleri aynı konfigürasyonlar altında yürütmek için kullanılan donanım |
| Not: Yukarıda listelenen tüm URL'ler bu tablonun tarihi itibarıyla kontrol edilmiş ve aktif olduğu onaylanmıştır. |
Kaynaklar
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Yeniden basım ve izinler
Bu makale yayımlandı
Video yakında