Bu çalışma, çift yapılı bir oturum grafiğine dayalı kapılı-yuva doğrusal dikkat mekanizmasını benimseyen, oturum tabanlı öneriler için kapılı-yuva doğrusal dikkatli grafik sinir ağları adlı yeni bir model önermektedir. Model, öneri doğruluğunu ve verimliliğini artırmakta ve üç genel veri kümesinde SOTA performansını geride bırakmaktadır.
Araştırma makalesi
Oturum Tabanlı Tavsiye İçin Kapılı-Yuvalı Doğrusal Dikkatli Grafik Sinir Ağları
Bu makalede
Özet
Özet
Oturum Tabanlı Tavsiye (SBR) sistemleri, mevcut oturumdaki davranış dizisine dayanarak kullanıcının etkileşime girme olasılığının en yüksek olduğu bir sonraki öğeyi tahmin etmeyi amaçlar. Transformer dikkat mekanizmasını kullanan güncel yaklaşımlar (örneğin, GC-SAN), geleneksel yöntemlere göre üstün performans göstermiştir; ancak, öz-dikkat mekanizmasının (self-attention) karesel maliyeti nedeniyle yoğun hesaplama yükü ve alan karmaşıklığından muzdariptirler. Bu kısıtlamaları gidermek için, lineer dikkati öğrenilebilir bir kapılama mekanizması ve kapılı-yuva (gated-slot) dikkatten esinlenen yuva tabanlı bir bellek güncelleme stratejisiyle entegre eden GSLA4Rec (oturum tabanlı tavsiyeler için kapılı-yuva lineer dikkatli grafik sinir ağları) adlı yeni bir model önerilmiştir. Spesifik olarak GSLA4Rec, öncelikle iki grafik oluşturur: oturum içi öğe geçişlerini yakalamak için oturum grafiği ve oturumlar arası iş birlikçi sinyalleri kodlamak için komşu küresel grafik; böylece hem yerel hem de küresel bağlam bilgileri modellenir. Önerilen yaklaşımın merkezinde yer alan kapılı-yuva lineer dikkat mekanizması; (1) uzun oturumlardaki ilgisiz veya gereksiz etkileşimlerden kaynaklanan gürültüyü bastırmak için kapılama birimleri kullanır, (2) bellek yükünü azaltmak için kompakt oturum temsillerini dinamik olarak depolamak ve güncellemek amacıyla yuva birimlerinden yararlanır ve (3) lineer zaman karmaşıklığına ulaşmak için öz-dikkat yerine lineer dikkati getirir. Bu bileşenler birlikte, modelin tahmin doğruluğunu ve gelişen kullanıcı ilgi alanlarını yakalama verimliliğini önemli ölçüde artırır. Diginetica, Tmall ve NowPlaying dahil olmak üzere birden fazla halka açık karşılaştırma veri seti üzerinde yapılan kapsamlı deneyler, GSLA4Rec'in tavsiye performansında SOTA SBR yöntemlerini tutarlı bir şekilde geride bıraktığını göstermektedir ve bu durum GSLA mekanizmasının etkinliğini doğrulamaktadır.
Giriş
Çevrimiçi hizmetlerin (e-ticaret, kısa video platformları ve haber akışları gibi) hızlı gelişimiyle birlikte, bilgi aşırı yüklemesi sorunu giderek daha belirgin ve ciddi hale gelmiştir. Tavsiye sistemleri1,2, kullanıcıların davranış verilerini derinlemesine analiz ederek kişiselleştirilmiş ve kesin bilgi sunum hizmetleri sağlar. Ancak, anonim erişim, oturum açmamış kullanıcılar, gizlilik koruması ve kısa etkileşim süreleri ile karakterize edilen birçok pratik uygulamada, işbirlikçi filtreleme3 ve matris ayrıştırma4,5 gibi geleneksel tavsiye yöntemleri, tavsiye algoritmalarının uygulanabilirliğini büyük ölçüde kısıtlamaktadır. Bu zorlukların üstesinden gelmek için SBR6,7,8,9 ortaya çıkmıştır. SBR, bir sonraki potansiyel ilgi noktasını tahmin etmek için kullanıcıların mevcut oturumundaki etkileşim dizisi verilerine odaklanır. Bu paradigma, yalnızca uzun vadeli kullanıcı geçmişi verilerine olan bağımlılığı ortadan kaldırmakla kalmaz, aynı zamanda kısa vadeli dinamik ilgi değişikliklerinile keskin bir şekilde yakalayarak e-ticaret, kısa videolar, müzik tavsiyesi ve benzeri senaryolarda benzersiz bir uygulama değeri sunar.
Erken dönem yöntemler, oturum dizilerindeki öğeler arasındaki geçiş olasılıklarını modellemek için öncelikle Markov Zincirlerine5,10,11,12 dayanıyordu. Bu yöntemler birinci derece dizi bağımlılıklarını yakalayabilse de, karmaşık yüksek dereceli bağımlılıkların ve kullanıcı ilgi alanlarının doğrusal olmayan dinamiklerinin karakterizasyonu sınırlı kalmış, bu da model etkinliğini karmaşık senaryolarda kısıtlamıştır. Derin Öğrenme teknolojisinin gelişimiyle birlikte13,14, sinir ağı tabanlı yöntemler SBR'de yaygın olarak uygulanmaya başlanmıştır. GRU4REC15, dizilerdeki zamansal bağımlılıkları etkili bir şekilde yakalayarak, tekrarlayan sinir ağlarını14 (RNN'ler) oturum tabanlı önerilere uygulayan ilk yöntem olmuştur; NARM16, dikkat mekanizmalarını RNN'lerle entegre ederek çekirdek kullanıcıların ilgi alanlarını madenleme yeteneğini daha da geliştirmiştir; STAMP17, kısa vadeli kullanıcı ilgi alanlarını yakalamaya odaklanmak için dikkat mekanizmalarıyla birleştirilmiş çok katmanlı algılayıcılar (MLP'ler) kullanmıştır. Bu yöntemler dizi modellemede belirli bir ilerleme kaydetmiş olsa da, uzun vadeli bağımlılıkları yönetmede zorluk ve gürültüye karşı hassasiyet gibi sorunlarla karşı karşıya kalmaya devam etmiştir.
Son yıllarda, Graf Sinir Ağları (GNN'ler)18,19,20,21 SBR görevine yeni bir bakış açısı getirmiştir. SR-GNN22 gibi modeller, oturum grafiği (SG) oluşturarak karmaşık geçiş ilişkilerini açıkça modeller ve öneri doğruluğunda önemli iyileştirmeler sağlar. Ancak, mevcut GNN tabanlı yöntemlerin çoğu, graf oluşturma ve mesaj iletim işlemlerini bireysel oturumlar içinde gerçekleştirerek küresel ürün korelasyon bilgilerinden etkili bir şekilde yararlanmamaktadır. Bu sorunu çözmek için GCE-GNN23, komşu küresel graf (NGG) oluşturarak ürün önemini adaptif bir şekilde ağırlıklandırmak için küresel semantiği ve oturum grafiklerini bir öz-dikkat (self-attention) mekanizmasıyla entegre ederek performansında önemli artışlar sağlamıştır. Buna rağmen, mevcut GNN tabanlı yöntemler hala iki temel darboğazla karşı karşıyadır: Birincisi, öz-dikkat mekanizmasının karmaşıklığı oturum uzunluğuyla karesel olarak artmakta ve uzun oturumlar işlenirken önemli bir hesaplama yüküne yol açmaktadır; ikincisi, geleneksel GNN'lerin bilgi toplama sırasında ürün önemini dinamik olarak düzenleme yeteneği eksiktir; bu durum, gürültü ile kritik davranışları ayırt etmeyi zorlaştırarak temsil kalitesini etkilemektedir.
Bu zorlukların üstesinden gelmek için bu makale, oturum tabanlı öneriler için kapılı-yuva doğrusal dikkat graf neural ağı (GSLA4Rec) önermektedir: (1) Gating yoluyla gürültüyü filtreleyen ve temel anlamsal bilgileri oturum yuvalarında saklayarak modelin sağlamlığını artıran ve depolama maliyetini azaltan bir kapılı-yuva mekanizması tasarlamak; (2) Uzun mesafeli bağımlılıkları modelleme yeteneğini korurken, hesaplama karmaşıklığını O(N2)'den O(N)'ye (burada N oturum uzunluğudur) düşüren doğrusal dikkat mekanizmasını tanıtmak; (3) Üç halka açık kıyaslama veri seti (Diginetica, Tmall ve NowPlaying) üzerinde kapsamlı deneyler yürütmek; bu deneyler GSLA4Rec'in mevcut SOTA yöntemlerinden önemli ölçüde daha iyi performans gösterdiğini, özellikle uzun oturum ve seyrek senaryolarda belirgin avantajlar sağladığını göstermektedir.
Protokol
Oturum temelli öneri deneyimi
Oturum temelli öneri, SBR, küresel bağlam öğrenimi ve GSLA olmak üzere üç açıdan incelenebilir (bkz. Malzemeler Tablosu). Bu çalışmada insan katılımcı veya hayvan kullanılmadı. Çalışmada kullanılan tüm deneysel veri kümeleri kamuya açıktır ve Ek Dosya: GSLA4Rec.zip olarak sunulmuştur.
Oturum temelli öneri
Oturum temelli öneri (SBR), kullanıcıların tercihlerini dinamik olarak anlayarak kişiselleştirilmiş öneriler sunmak üzere çok aşamalı doğal dil diyalogları aracılığıyla kullanıcılarla etkileşime giren bir yapay zekâ sistemiydi. SBR, geleneksel yöntemlerden derin öğrenmeye dayalı ve hibrit yaklaşımlara doğru gelişti ve daha sonra Büyük Dil Modeli (LLM) tabanlı çözümlere doğru ilerledi.
Geleneksel oturum tabanlı öneri
Geleneksel SBR genellikle Markov Zinciri tabanlı yöntemler ve İşbirlikçi Filtreleme ile temsil edilirdi. İlki, kullanıcıya özgü olasılıksal geçiş matrislerini çözerek öneriler üretirdi. Örneğin, Guy Shani24 ilgili matrisleri çözerek öneriler üreten bir Markov Karar Süreci tabanlı öneri yöntemi önerdi; Wanrong Gu25 Markov Zincirlerini satın alma zaman aralıklarıyla birleştirerek öneri performansını artırdı. İkincisi, matris çarpanlara ayırma yöntemiyle komşu etkileşimli öğeler arasındaki gizli sıralı ilişkileri çıkararak öneriler üretirdi. Örneğin, Sarwar B1 kullanıcıların geçmiş davranışlarına (puan ve tıklamalar gibi) dayanarak öğe-öğe benzerliğini hesaplayarak kullanıcıların geçmiş tercihleriyle uyumlu öğeleri önerdi. Eğer A kullanıcısı a öğesini beğendi ve c öğesi a'ya çok benziyorsa, sistem A'ya c'yi önerir; Rendle S5 komşu etkileşimli öğeler arasındaki gizli sıralı ilişkileri yakalamak için matris çarpanlara ayırma ile Markov Zincirlerini birleştiren FPMC adlı bir dizi öneri modeli önerdi. Ancak bu geleneksel SBR, komşu öğeler arasındaki sıralı ilişkilere odaklanarak karmaşık bağımlılık ilişkilerini modellemeyi zorlaştırıyordu.
Oturuma dayalı derin öğrenme önerisi
Derin öğrenme temelli oturum bazlı öneri sistemleri, Evrişimli Sinir Ağları (CNN'ler)26,27,28,29, YİYA'lar ve GİYA'lar içeren aşamalardan geçerek gelişmiştir. CNN tabanlı OBS, her oturum bağlamının temsillerini öğrenmek için evrişim ve havuzlama gibi işlemleri kullanan ve daha sonra önerilerde kullanılan bir yapıya sahiptir. Caser30, bir kullanıcının etkileşime geçtiği en son L öğeyi bir yerleştirme katmanı aracılığıyla d-boyutlu vektörlere dönüştürerek, zaman ve gizli uzayda eşlenmiş bir "görüntü" olarak ele alınan bir yerleştirme matrisi oluşturur. Ardından, nokta düzeyinde, atlamasız birleşim düzeyinde ve bir kez atlamalı birleşim düzeyinde olmak üzere üç farklı dizisel örüntü evrişim filtresi kullanarak OBS performansını artırmayı hedefler. Tuan ve ark.31, oturum tıklama akışlarını ve içerik özelliklerini 3B evrişim çekirdekleriyle birleştirerek uzamsal-zamansal-içerik birleşik temsilleri oluşturur.
Yinelenen sinir ağları (RNN'ler), sıralı verileri işlemek için özel olarak tasarlanmış bir sinir ağı mimarisi sınıfıydı. Temel fikir, uzun kısa vadeli bellek ağları (LSTM)13 ve kapılı yinelenen birimler (GRU'lar)32 gibi yinelenen yapılar aracılığıyla zamansal bağımlılıkları yakalayarak, doğal dil işleme (NLP)33, konuşma tanıma34, metin çevirisi35, seyahat36,37, suç38, ve gelecekteki trend tahmini39 (örneğin, trafik40, borsa piyasaları41,42 ve meteoroloji43) gibi alanlarda yaygın olarak kullanılmaktı. Hidasi ve arkadaşları tarafından önerilen GRU4Rec, SBR araştırmalarında bir dönüm noktası olmuş ve kişiselleştirilmiş önerileri gerçekleştirmek için kullanıcıların sıralı davranışsal desenlerini GRU aracılığıyla yakalayarak SBR'ye ilk kez RNN'leri tanıtmıştı.
GNN'ler44, grafik yapıdaki veriler içindeki karmaşık ilişkilerin modellenmesinde güçlü ifade gücü göstermiştir ve bazı araştırmacılar, oturumlar içindeki veya oturumlar arasındaki karmaşık geçişleri modellemek için GNN'leri tanıtmıştır. Farklı GNN model mimarilerine bağlı olarak, SBR için GNN tabanlı yöntemler genellikle kapılı grafik sinir ağları (GGNN'ler)45, grafik evrişim ağları (GCN'ler)46 ve grafik dikkat ağları (GAT'ler)47 olarak kategorize edilmiştir. SR-GNN, oturum dizilerini yönlendirilmiş grafikler olarak temsil ederek ve oturumlar içindeki karmaşık öğe geçiş ilişkilerini yakalamak için GGNN'leri kullanarak, dikkat mekanizmalarıyla birlikte son oturum gömülmesini elde ederek ve böylece öneri performansını artırarak, GNN'leri SBR'ye uygulayan ilk çalışmaydı. Chen L48, yapısal öznitelikler ve yapısal olmayan anahtar kelimeleri birleştirerek çok boyutlu ürün ilişkilerini modelleyen çoklu görünüm GNN çerçevesini önererek SBR'nin doğruluğunu artırmıştır. Driss E49, SBR için tahmin doğruluğunu artırmak amacıyla karmaşık öğe özelliklerini yakalamak üzere kapsül grafik sinir ağlarını kullanan yenilikçi bir oturum öneri sistemi tasarlamıştır.
Yukarıda bahsedilen derin öğrenme teknikleri, SBR'nin araştırma kapsamını zenginleştirmiş ve performansı etkili bir şekilde artırmıştır, ancak hâlâ şu şekilde ortaya çıkan bazı sınırlamalara sahiptir: 1) Yeni ortaya çıkan ögeler veya çok seyrek oturumlar için modellerin küresel bağlam eksikliği nedeniyle doğru tahminler yapması zordur; 2) Tüm geçmiş oturumlarda yer alan küresel kalıplardan yararlanamazlar.
Karma oturum tabanlı öneri
Hibrit oturum temelli öneri, işbirliğine dayalı filtreleme, Derin Öğrenme ve dikkat mekanizmaları gibi farklı tekniklerin güçlü yönlerini birleştirerek SBR performansını artırmıştır. GC-SAN50, SR-GNN tabanlı bir kendi kendine dikkat mekanizması entegre ederek oturum içindeki önemli ögelerin etkileşim bilgisini daha iyi yakalamıştır. FGNN51, hedef ögenin birden fazla ilişkisini öğrenmek için çoklu başlı dikkat mekanizması aracılığıyla komşu ögelerden bilgiyi daha da birleştirmiştir. SR-HetGNN52, heterojen grafiklerle oturum temelli öneriye aittir; çoklu tip ögeleri (kullanıcı, öge, oturum) ve çoklu ilişkisel kenarları (tık, satın alma, birlikte oluşum, öznitelik ilişkisi) tanıtarak küresel bir bilgi ağı oluşturmuş, tek tip öge dizilerinin sınırlamasını aşmıştır ve son yıllarda anonim kullanıcı davranışlarını modelleme ile çapraz oturum ilgi ilişkilerini temsil etmede önemli bir yöntemdir. KGSR-SAP53, kullanıcı-öge etkileşimlerinin çeşitli yönlerini tanımlamak için çoklu ilişkili kenarlarla ögeleri birleştirerek bir bilgi grafiği oluşturmuştur ve küresel grafiğin yalnızca tek tip kenar (kullanıcı-öge etkileşimi) içermesinden kaynaklanan bilgi kaybı sorununu çözmüştür. Wang ZH54, DiffSBR adlı, gürültüyü gidermeyi simüle ederek güvenilir bir sonraki öge tercihleri üreten ve dinamik kullanıcı tıklama dizilerinin modellenmesini artıran, difüzyon temelli bir oturum önerisi modeli önermiştir. Qiao ST55, çoklu görünüm niyet öğrenimi ile LLM hizalamasını birleştiren bir SBR çerçevesi oluşturmuştur. Farklı açılardan kullanıcıların örtük niyetlerini ortaya çıkarmış ve dil modellerini kullanarak anlamsal özellikleri hizalayarak önerme performansını daha iyi artırmıştır.
Küresel bağlam
"Oturumların izole bir şekilde incelenmesi" dezavantajını aşmak için araştırmacılar, geleneksel SBR'deki veri seyrekliği, soğuk başlangıç ve anlamsal boşluk gibi problemleri çözmek amacıyla mevcut oturumun temsil yeteneğini artırmak için küresel bilginin kullanılabileceğini fark ettiler. Aynı zamanda, küresel bağlam oluştururken, küresel bilgiyi tek bir oturuma entegre ederken gürültü etkileşimini en aza indirmek gerekiyordu. CSRM56, mevcut oturum ile komşu oturumlar arasındaki işbirlikçi bilgiyi entegre ederek oturum düzeyindeki temsili optimize etti ve dış bellek kodlayıcısı (OME) kullanarak işbirlikçi niyeti işbirlikçi bilgiden çıkardı. CA-TCN57, oturumlar arası farkındalık sağlayan bir zamansal evrişimli sinir ağı (TCN) modeli önerdi ve öğeler ve oturumlar üzerindeki oturumlar arası etkileri simüle etmek için küresel grafikler ile oturum bağlam grafikleri oluşturdu; ayrıca TCN, dilatasyonlu evrişimler aracılığıyla alıcı alanı genişletir ve katman sayısı üstel uzunlukta dizileri kapsar (alıcı alan = ), RNN'lerdeki gradyan kaybolma problemini çözer. Chen58, hipergraf sinir ağlarına dayalı (SR-HGNN'ler) bir SBR yöntemi önerdi; bu yöntem, karışık-dereceli (düşük ve yüksek dereceli) yayılım ile dikkat mekanizmalarını entegre ederek kısa oturumlarda geleneksel GNN'lerin aşırı yumuşama problemini çözer ve farklı yayılım derecelerinin önemini ayırt eder; böylece bağımlılıkları daha doğru yakalar ve gürültü etkileşiminden kaçınır. GCE-GNN, çoklu dereceli birlikte meydana gelen öğe çiftlerini kullanarak yönsüz ağırlıklı bir grafik oluşturdu ve oturum içindeki öğelerin önemini yansıtmak için öğe birliktelik frekanslarını saydı; AGNN-GC59, oturumlar arası öğe geçiş ilişkilerini kullanarak küresel işbirlikçi bir grafik oluşturdu ve küresel grafikte öğe geçiş olasılıklarını hesaplayarak oturum içindeki ilgi değişimlerini yansıttı; DA-GCN60, komşuluk matrisini güncellemek için en kısa yolu kullandı ve dinamik ağırlıklı bir grafik oluşturdu, küresel grafikteki birliktelik frekansını ve öğeler arasındaki yol mesafesini hesapladı. Yukarıdaki literatürden esinlenerek, bu makale, komşu temelli bir yöntemle küresel grafik oluşturmayı önerdi; yani Jaccard benzerlik katsayısını kullanarak benzer oturumları hesaplamak, hem küresel bilgiyi kullanmayı hem de gürültüyü filtrelemeyi (ilgisiz öğeleri süzmek) sağlar ve böylece küresel bağlamın doğru bir şekilde oluşturulmasını sağlar ve sonraki SBR algoritması için sağlam bir temel oluşturur.
Gated-slot doğrusal dikkat
Geleneksel dönüşüm modelleri61, aşağıdaki şekilde, tüm dizi boyunca tam bağlantılı dikkat işlemlerinin gerekli olması nedeniyle yüksek doku-zamansal karmaşıklık oluşturdu:
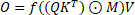 (1)
Q, K, V ∈ RN×d giriş öğelerinin doğrusal dönüşümleri olmak üzere, M = {Mij = 1 eğer i ≥ j, aksi halde −∞ } gelecekteki bilgilerin sızmasını engellemek için kullanılan nedensel maskeydi, ⊙ eleman bazında çarpımı gösterir ve f aktivasyon fonksiyonu olan softmax'ı gösterir.
Doğrusal dikkat elde etmek için62, en doğrudan fikir, aktivasyon fonksiyonu softmax'i kaldırmaktı. Ancak, aktivasyon fonksiyonu softmax doğrudan kaldırılırsa, doğrusal dikkat kesinlikle bazı potansiyel sorunlara yol açar: Sinir ağlarının güçlü ifade gücünü kaybetmek ve karmaşık gerçek dünya problemlerini çözemez hâle gelmek.
Sınırlı bellek kontrolüne sahip yuva doğrusal dikkat
Softmax aktivasyon fonksiyonunun korunması gerekiyorsa, K ve V, K̃, Ṽ ∈ Rm×d olarak ayrı ayrı sıkıştırıldı. Bellek ağı açısından, K̃ ve Ṽ dizilim uzunluğuyla artan bellek yuvalarına sahipti, yani yuva sayısı m = N'dir. Eğer m sabitse, doğrusallaştırma açıkça mümkündür. Bounded-memory Control63 ilham alınarak, uzunluğu N olan giriş öğelerindeki her bir token, m yuvaya rekabetçi olarak yazılması gerekiyordu.
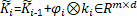 ,
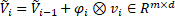 ,
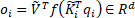 (2)
f'nin aktivasyon fonksiyonu softmax ve φi'nin aşağıdaki gibi anahtar değer ki'yi kontrol etmek için etkili girişi kontrol eden vektör olduğu yer.
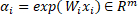 ,
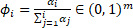 (3)
Burada, inci belirtecin jnci yuva için yazım yoğunluğunu temsil eden (φi)j, kümülatif softmax fonksiyonu kullanılarak elde edilmiştir.
Etkili doğrusal hesaplama elde etmek için formül (2), οi'yi qi, ki ve vi değerlerinden (Denklem 4) {οi|i=1T, qi, ki, vi)|i=1T} kullanarak hesaplayan formül (4) şeklinde yeniden yazıldı ve iki aşamalı ardışık hesaplama benimsendi:
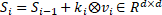 ,
 (4)
Bu nedenle SLA operasyonları türetilebilir:
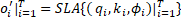 ,
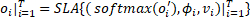 (5)
Burada oi′ ∈ ℝm, οi ∈ ℝd. Bu nedenle, SLA donanım açısından verimli doğrusal zamanlı parça bazında eğitimi edinebilir64.
Gölgeli-yuva doğrusal dikkat
Sınırlı bellek kontrollü slot doğrusal dikkat, hesaplama ve mekânsal karmaşıklığı azaltabilir. Ancak bilgi birikimi, oturum etkileşimi içine gürültülü bilgiyi de getirebilir; bu nedenle bilginin seçmeli olarak saklanması ve unutulması için veriye bağımlı azalma çok önemlidir ve bu seçmeli mekanizma, yakın zamanda seçmeli durum-uzay modellerinde yeniden ele alınmıştır65. Veriye bağımlı GSLA şu şekilde ifade edilebilir:
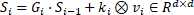 ,
 (6)
Burada bozunum kapıları, Gi = αi ⊗ βi, αi, βi ∈ [0,1]d şeklinde bir dış çarpım formu ile parametrize edildi. Aşağıda izlenecek adımlarda, GSLA tipik olarak βt = 1 ve matris çarpımı kullanılarak aşağıdaki eşdeğer biçimde de yazılabilir64:
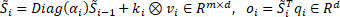 (7)
αi ve ki sırasıyla unutma kapısı ve giriş kapısını gösterdiğinde, bu iki kapı, kapılı RNN'ler üzerine yapılan literatürden esinlenerek ki = 1 − αi şeklinde birleştirilebilir. GSLA'nın, Denklem (8)'de gösterildiği gibi iki aşamalı ardışık hesaplama ile formüle edilebileceği açıkça görülmektedir. İkinci-düzey yapı, eğitim verimliliğini artırmak için blok paralel eğitimi destekler ve ikinci-düzey yapıya ortada softmax işlemi eklenmesi, sonlu yuva belleğinin modellenme kabiliyetini artırır.
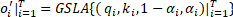 ,
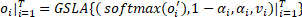 (8)
Oturum verilerinin dönüştürülmesi
Sorun tanımı
S = {v1s, v2s, ⋯, vns} şeklinde verilen oturum dizisini ele alalım; burada vis, i. tıklanan öğeyi göstermektedir. Bu dizideki kullanıcının tıklama davranışını analiz ederek sistem, kullanıcının ilgi duyabileceği bir sonraki öğeyi vn+1s tahmin eder.
Graf yapısı
Oturum grafiğinin oluşturulması
S = {v1s, v2s, ⋯, vns} oturumu için, Vs verilen S oturumunun madde kümesi ve εs = {eijlocal|vi, vj, vi, vj ∈ Vs} verilen S oturumunun kenar kümesi olmak üzere, yönlendirilmiş bir graf Gs = (Vs, εs) oluşturuldu. ε(vi-1s, vis) bu oturumda ardışık tıklanan maddeleri temsil etti. eijlocal kenarı dört türe ayrılabilir: ein, eout, ein-out, eself. Aynı madde dizide tekrar edebildiği için her kenarın ağırlık değeri hesaplandı.
Mevcut oturum s = [v1, v2, v4, v2, v3], Şekil 1A'da gösterildiği gibi bir SG'ye dönüştürüldü.
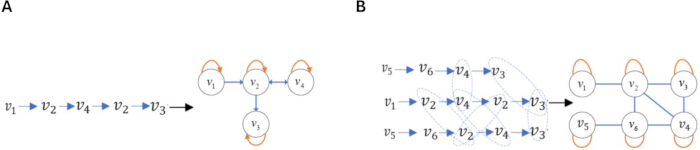
Şekil 1: Etkileşimli ögelerin graf yapılarına dönüştürülmesi. (A) Bir oturumu bir grafa dönüştürerek oturum grafiği (SG) oluşturmanın gösterimi. (B) Birçok oturumu bir araya getirerek komşu küresel grafiğin (NGG) oluşturulmasının gösterimi. Bu şekil, tamamen özgün öğelerle Visio aracılığıyla kendimiz çizilmiştir. Telif hakkı olan harici grafik kaynaklar kullanılmadığından, ek üçüncü taraf telif hakkı lisanslamasına gerek yoktur. Şeklin telif hakkı yazarlara aittir ve kabul edilme durumunda derginin telif hakkı kurallarına uygun olacaktır. Lütfen bu şeklin daha büyük halini görmek için buraya tıklayınız.
Komşu küresel grafik yapısının oluşturulması
Mevcut oturuma göre S, mevcut oturumun temsil öğrenmesini oturumlar arası bir şekilde zenginleştirmek için ilgili NGG Gg = (Vg, εg) oluşturuldu. Vg, Gg içindeki tüm ögeleri içeren öge kümesiydi ve εg = {eijglobal|vi, vj, vi, vj ∈ Vg} Gg grafiğinin kenar kümesiydi. ε(vi-1g, vig), NGG Gg içinde doğrudan etkileşen vi-1g ve vig ögelerini temsil ediyordu. Bu süreç, komşu oturum elde etme ve NGG inşası olmak üzere iki adımdan oluşuyordu.
Komşu oturumunun edinilmesi
Tüm veri kümesi boyunca, mevcut oturumla birlikte en fazla sayıda eşzamanlı öğe içeren oturumlar arandı. En yüksek eş oluşum sayılarına sahip en iyi N oturum, aday komşu oturum kümesi S'yi oluşturmak için seçildi. Daha sonra, mevcut oturum cu ile aday kümesi S'deki bir oturum Sr ∈ S arasındaki benzerlik, Şekil (9)'da gösterildiği gibi Jaccard benzerlik katsayısı kullanılarak hesaplandı.
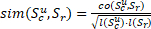 (9)
Scu ve Sr içinde aynı anda bulunan ögelerin sayısını gösteren co(Scu, Sr), Scu ve Sr'nin uzunluklarını sırasıyla temsil eden l(Scu) ve l(Sr) ile birlikte verilmiştir ve Scu ve Sr sırasıyla mevcut oturumu ve komşu bir oturumu belirtir. Belirli bir eşik değerinin altında benzerlik gösteren oturumlar süzülerek çıkarılır ve kalan oturumlar mevcut oturum için komşu oturum kümesi Ns'yi oluşturur.
Komşu küresel grafik yapısının oluşturulması
Ns komşu oturum kümesine dayanarak, NGG oluşturuldu, bu işlem Şekil 1B'de gösterilmiştir. Komşuluk matrisi oluşturulurken, iki öğe (vi, vj) arasında bir etkileşim varsa, ilgili giriş Aij 1 olarak ayarlandı, aksi takdirde 0 olarak ayarlandı. Ayrıca, öğeler arasındaki etkileşimler yönsüz olarak işlendi ve kendine döngülerle donatıldı, ardından Tablo 1'de gösterildiği gibi normalleştirmeye tabi tutuldu.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tablo 1: Komşu küresel grafiğin normalize edilmiş komşuluk matrisi. Tablo, oluşturulan komşu küresel grafikteki düğümler arasındaki ağırlıklı bağlantıları tanımlayan normalize edilmiş komşuluk matrisini sunmaktadır.
Oturuma dayalı öneri algoritması tasarımı
Bu bölüm, SG ve NGG'nin birleşik özellik gösterimine GSLA mekanizmasını ekleyerek SBR performansını artıran GSLA4Rec adlı önerilen yenilikçi modeli ayrıntılarıyla açıklamaktadır.
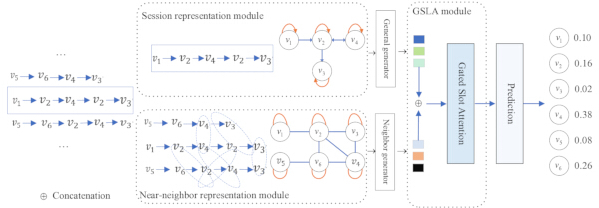
Şekil 2: GSLA4Rec çerçevesi. Bu çerçeve, oturum grafiğini ve komşu küresel grafik yapısını öğrenmeyi birleştirdi, bir geçit mekanizması ile etkileşim gürültüsünü süzdü, bellek yuvaları mekanizması ile depolama ve verimliliği dengeledi ve kullanıcının bir sonraki tıklama tercihini tahmin etmek için doğrusal dikkat mekanizması ile öğe ilgiliğini yakaladı. Bu şekil, tamamen özelleştirilmiş öğelerle Visio aracılığıyla yazarlar tarafından çizilmiştir. Telif hakkı korumalı harici grafik kaynakları kullanılmadı; bu nedenle ek üçüncü taraf telif hakkı lisansına gerek duyulmadı. Şeklin telif hakkı yazarlara aittir ve kabul edilme durumunda derginin telif hakkı kurallarına uygun olacaktır. GSLA4Rec, SBR için geçitli yuvalı doğrusal dikkat grafik sinir ağlarını temsil eder. Lütfen bu şeklin daha büyük halini görmek için buraya tıklayınız.
Şekil 2, oturum düzeyinde öğe temsili, komşu küresel düzeyde öğe temsili, GSLA ve tahmin katmanı olmak üzere dört ana bileşenden oluşan GSLA4Rec'in çerçevesini göstermektedir: 1) Oturum düzeyinde öğe temsili. Mevcut oturum içindeki öğe katıştırmalarını öğrenmek için oturum grafiği (SG) üzerinde bir GNN modeli kullanır; 2) Komşu küresel düzeyde öğe temsili. Her öğenin komşu katıştırmalarını oturumlar boyunca özyinelemeli olarak birleştirmek için NGG tabanlı bir GRU kullanarak küresel düzeyde öğe katıştırmalarını öğrenir; 3) GSLA. Oturum düzeyi ve küresel düzeyde öğrenilen öğe temsillerini birleştirerek mevcut oturumdaki kullanıcı tercihlerini modeller; 4) Tahmin katmanı. Aday öğeler üzerinde tahmin edilen olasılıkları çıktılar. Bu dört bileşen aşağıda ayrıntılı olarak sunulmuştur.
Oturum temsili
SBR'de, kullanıcıların etkileşim davranışlarını anlamak çok önemlidir. Bu amaçla, oturum temsili öğrenmesi için bir SG ve bir NGG oluşturulmuş, kullanıcıların etkileşim davranışlarını kapsamlı bir şekilde anlayarak kullanıcıların daha gerçek niyetini yakalamayı hedeflemiştir.
Oturum düzeyinde öğe gösterimi
Şekil 1A'daki SG'ye dayanarak, SG'nin özelliklerini ayıklamak için Ağırlıklı İkili Yönlü Grafik Dikkati (WBGAT) yöntemi kullanıldı. Bu yöntem, standart GAT mekanizmasına dayanarak kenar ağırlıklarını ve öğe yönlülüğünü (İç komşu ve Dış komşu) tanıttı, önemli kenarların güçlendirilmesi etkisini sağladı ve ikili yönlü bağımlılıkları yakalayarak, geleneksel GAT'nin asimetrik öğe ilişkileri ve etkileşim gücü konusundaki eksikliklerini giderdi. Hesaplama süreci şu şekildeydi:
İlk olarak, madde içe-derece normalizasyon ağırlıklarının hesaplanması.
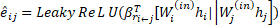 (10)
burada eij, j öğesinin özelliklerinin i öğesine göre birinci dereceden iç komşu ağırlığını gösterir,  , i öğesi ile j öğesi arasındaki ilişkiyi ifade eder, β* ∈ ℝd ağırlık vektörleriydi, hi ve hj sırasıyla i ve j öğelerinin temsilleriydi, Wi(in) ∈ ℝd*d ve Wj(in) ∈ ℝd*d eğitilebilir parametrelerdi, || birleştirme işlemini temsil eder. Farklı iç derece ilişkilerini ayırt etmek için rin ve rin-self olmak üzere iki ağırlık vektörü eğitildi. Aktivasyon fonksiyonu olarak LeakyReLU kullanıldı.
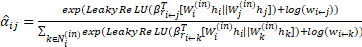 (11)
Farklı ögeler arasında katsayıları karşılaştırılabilir hale getirmek için dikkat ağırlıkları softmax fonksiyonu aracılığıyla normalize edildi. Burada Ni(in), i ögesinin birinci derece iç komşu kümesiyken,  , SG'deki yönlendirilmiş kenar (i←j) için iç komşu ağırlığıdır; bu yöntem, kenar ağırlıklarının logaritmasını alarak orijinal dikkat skoru eij'ye ekleyerek modelin öge özelliklerinin korelasyonlarını öğrenmesini ve grafik yapısının doğuştan gelen bağlantı gücünü korurken aynı zamanda bilgiyi korumasını sağladı.
İkinci olarak, madde dış derece normalizasyon ağırlıklarının hesaplanması.
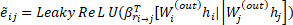 (12)
burada ẽij, j öğesinin özelliklerinin i öğesine göre birinci dereceden dış komşu ağırlığını gösterir,  i ve j öğeleri arasındaki ilişkiyi ifade eder, iki ağırlık vektörü olan rout ve rout-self eğitilmiştir.
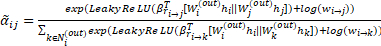 (13)
Ni(out), i öğesinin birinci dereceden dış komşu kümesiyken,  , SG'deki yönlü kenar (i→j) üzerindeki dış komşu ağırlığıdır.
Üçüncüsü, bilgi birleştirme. Öğenin güncellenmiş gömülmesi, i öğesinin birinci derece içeri ve dışarı gömülmesi ağırlıklandırıldıktan ve toplandıktan sonra elde edilebilir.
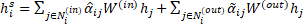 (14)
 ve α̃ij sırasıyla i öğesinin giriş derecesi ve çıkış derecesi ağırlıklarını gösterirken,
 i öğesinin güncellenmiş temsilini belirtti.
Komşu genel düzeydeki öğe gösterimi
Yakın zamanda yapılan araştırmalar, küresel bir grafik oluşturmanın veri temsilini artırarak SBR performansını iyileştirebileceği konusunda tutarlı bir şekilde hemfikir oldu; bu, şüphesiz bir gerçektir. Ancak küresel verilerin artırılması, gürültü gibi ilgisiz bilgilerin de eklenmesine neden olabilir. Önerilen modelde, küresel veri artırma işlemini mümkün olduğu kadar gürültüyü en aza indirerek gerçekleştirmek amacıyla yakınsak komşu küresel grafik oluşturuldu.
Şekil 1B'deki NGG'ye ve Tablo 1'deki normalize edilmiş komşuluk matrisine dayanarak, mevcut oturum ve komşu oturumlar bir NGG'ye dönüştürüldü ve NGG'nin özelliklerini çıkarmak için GGNNs45 yöntemi uygulandı. NGG'deki öğe vektörlerinin öğrenme süreci Denklem (15)'te gösterilmiştir.
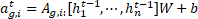
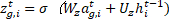
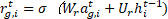
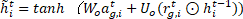
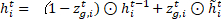 (15)
W ∈ ℝd×2d kontrol ağırlıkları olarak belirtildi, zg,i ve rg,i sırasıyla güncelleme kapısını ve sıfırlama kapısını temsil eder. [h1t-1, ⋯, hnt-1] oturumda yer alan tüm öğe vektörlerinin listesini temsil eder s. σ(x) = 1/(1 + e-x) lojistik sigmoid fonksiyonuydu, ⊙ eleman elemana çarpımı belirtir ve hi ∈ ℝd gated güncelleme sonrası vektörü temsil etti. Komşuluk matrisi As ∈ ℝn×n komşu oturumlardaki öğeler arasında bağlantı olduğunu gösterdi ve As,i: ∈ ℝ1×n bir sütun bloğunu temsil etti As öğesine karşılık gelen vs,i komşuluk matrisinde. Geçerli oturum için s = [v1, v2, v4, v2, v3], NGG ve normalize edilmiş komşuluk matrisi gösterildi. Şekil 1B ve Tablo 1sırasıyla.
Öğe temsili
Öğe gösterimi, oturum düzeyindeki öğe vektörü ile komşu küresel düzeydeki öğe vektörlerinin toplanmasıyla elde edildi ve Denklem (16)'da gösterildiği gibidir:
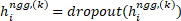
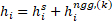 (16)
Aşırı uydurmayı azaltmak için genel düzeyde komşu öğe temsilleri üzerinde dropout kullanıldı.
Kapılı-yuvar dizi dikkati
Bu makalede sunulan sınırlı-bellekli yuva doğrusal dikkat (GSLA), doğrusal dikkati sınırlı bellek kontrolüyle ve veriye bağımlı bir geçit mekanizmasıyla birleştirmiştir. Bir yandan, dizi uzunluğuyla birlikte büyüyen anahtar-değer çiftlerini sabit sayıda yuvaya sıkıştıran dikkat temelli denetleyici (ABC) modelinin sınırlı bellek yuvası mekanizmasını devralmış; her yuva rekabetçi yazma yoluyla güncellenerek transformatörün küresel dikkatinin hesaplama karmaşıklığı sorununa çözüm sunmuştur. Diğer yandan, GLA'ya benzer ince ayarlı bir geçit mekanizması sunmuştur; bu mekanizmada giriş verisi, bir unutma geçidi αi aracılığıyla tarihsel bilginin korunma oranını dinamik olarak ayarlayarak ABC'de unutma mekanizmasının olmamasından kaynaklanan gürültü sorununu çözmüştür.
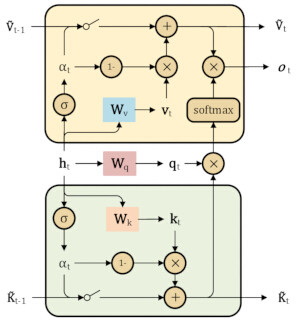
Şekil 3: GSLA'nın şematik diyagramı. Giriş vektörü sırasıyla sorgu vektörüne, anahtar vektörüne ve değer vektörüne dönüştürüldü ve ardından sınırlı bellek kontrollü doğrusal dikkat ve veriye bağımlı bir kapı mekanizması ile işlenerek güncellenmiş sorgu vektörü, anahtar vektörü, değer vektörü ve çıktı vektörü elde edildi. Bu şekil, Visio kullanılarak tamamen özelleştirilmiş öğelerle kendimizce çizilmiştir. Telif hakkı olan harici grafik kaynaklar kullanılmadığından ek üçüncü taraf telif hakkı lisanslamasına gerek yoktur. Şeklin telif hakkı yazarlara aittir ve kabul edilme durumunda derginin telif hakkı kurallarına uygun olacaktır. GSLA, kapı kontrollü yuvalı doğrusal dikkati temsil eder. Bu şeklin daha büyük halini görmek için lütfen buraya tıklayınız.
Şekil 3'te özel olarak uygulandığı gibi, giriş vektörü sorgu vektörüne, anahtar vektörüne ve değer vektörüne ayrı ayrı eşlendi64:
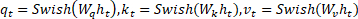 (17)
Burada Wq, Wk, Wv ∈ ℝd×d, sırasıyla sorgu, anahtar ve değer için ilgili dönüşüm ağırlık matrislerini temsil eder ve ht, oturum girdi dizisinde t. zaman adımındaki gömülü vektörü gösterir. Swish fonksiyonu Swish(x) = x · σ(x) olarak tanımlanmıştır ve burada σ Sigmoid fonksiyonudur; bu fonksiyon, geleneksel ReLU aktivasyon fonksiyonuna göre çok sayıda Derin Öğrenme görevinde daha iyi performans göstermiştir.
GSLA, i’inci bellek yuvasındaki bilgiyi dinamik olarak güncellemek için giriş verisine bağlı olarak bir unutma kapısı αi ve bir giriş kapısı 1 − αi kullandı. Süreç şu şekildeydi64:
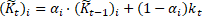 (18)
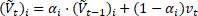 (19)
K̃t ve Ṽt, t zaman adımındaki anahtar vektör yuvalarını ve değer vektör yuvalarını temsil ederken; K̃t-1 ve Ṽt-1, t−1 zaman adımındaki anahtar vektör yuvalarını ve değer vektör yuvalarını temsil eder. Unutma kapısı αi = σ(Wαht)1/τ olup, burada Wα ∈ ℝd dönüşüm ağırlık matrisi, σ Sigmoid fonksiyonu ve τ (genellikle 8 olarak ayarlanır) unutma kapısının yumuşaklığını kontrol etmek için kullanılan sönümleme katsayısıdır. Bu, GSLA'nın geçmiş bilgilerin unutulma oranını düzgün bir şekilde ayarlamasına olanak tanır: αi ne kadar büyükse GSLA geçmiş bilgilere o kadar çok güvenir, αi ne kadar küçükse GSLA o kadar çok mevcut girdiye odaklanır.
tnci adımdaki anahtar vektör yuvaları K̃t ve değer vektör yuvaları Ṽt, Denklem (20) ve (21)'de gösterildiği gibi matris formunda ifade edilmiştir65:
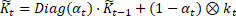 (20)
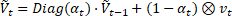 (21)
Daha sonra, ikinci dereceden özelliklere sahip GSLA (Denklem (8)'e bakınız) her zaman adımı i ∈ [1, …, T] için çıkış oi |i=1T hesaplamak amacıyla kullanıldı. Her zaman adımının çıktısına, sonucu h̃t elde etmek için doğrusal bir dönüşüm uygulandı. Son olarak, oturum dizisindeki tüm öğelerin temsillerinin ortalama değeri, dinamik bellek güncellemeleriyle oturum gömülmesi S̃e oluşturmak amacıyla hesaplandı:
 (22)
 (23)
Burada, ot Gated-Slot'un zaman adımı çıktısını temsil etti t, h̃t doğrusal dönüşümün uygulanması sonucunu gösterir ot. S̃e ortalama değeri olarak gösterilmiştir h̃t tüm zaman adımlarında
Tahmin katmanı
Elde edilen oturum gösterimi S̃e ve i öğesinin başlangıç gömülmesine dayanarak, her aday öğe hi için puan hesaplamak amacıyla bir nokta çarpım işlemi gerçekleştirildi. Daha sonra, aday öğe i'nin öneri olasılıklarını elde etmek için softmax fonksiyonu kullanıldı:
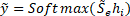 (24)
Burada, ỹ aday ögenin öneri olasılıklarını, hi aday ögenin vektörünü gösterdi ve model eğitimi için çapraz entropi kayıp fonksiyonu kullanıldı.
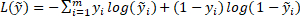 (25)
Burada, y gerçek etiketin bir-sıcak kodlanmış temsilidir.
Sonuçlar
Veri setleri ve ön işleme
Deneylerde, model performansını değerlendirmek için pratik uygulama senaryolarındaki gerçek işlem verilerinden türetilen üç halka açık SBR veri seti seçilmiştir: CIKM Cup 2016 yarışmasından alınan ve kullanıcıların işlem ve tıklama kayıtlarını içeren Diginetica, Tmall platformundaki kullanıcı günlüklerine dayanan ve kullanıcıların göz atma ve satın alma davranışlarını kaydeden Tmall ve kullanıcıların müzik platformlarındaki çalma geçmişine dair müzik kayıtlarını içeren Nowplaying. Bu veri setleri SBR araştırmalarında yaygın olarak kullanılmaktadır ve modelin etkinliği ile uygulanabilirliğini kapsamlı bir şekilde değerlendirmeye olanak sağlamaktadır.
Veri ön işleme aşamasında, veri kalitesinde tutarlılık sağlamak amacıyla veri setleri standartlaştırılmıştır. Spesifik olarak, uzunluğu 2'den kısa olan tüm oturumlar filtrelenmiş ve 5 kereden az görünen ögeler çıkarılmıştır. Ayrıca, her bir oturum için S = {v1, v2, ..., vn}, model eğitimi ve testi için birden fazla alt dizi oluşturulmuştur. Bu alt diziler şu biçimdedir: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Söz konusu ön işleme işlemleri tamamlandıktan sonra, veri setleri üzerinde istatistiksel analizler yapılmış ve ayrıntılı bilgiler şurada sunulmuştur: Tablo 2.
| Veri Kümesi | Diginetica | Tmall | Nowplaying |
| tıklama | 982961 | 818479 | 1367963 |
| eğitim | 719470 | 351268 | 825304 |
| test | 60858 | 25898 | 60417 |
| öğeler | 43097 | 40728 | 60417 |
| ort. uzunluk | 5.12 | 6.69 | 7.42 |
Tablo 2: Veri seti açıklaması. Tablo; tıklama sayıları, eğitim ve test örnekleri, öğeler ve ortalama oturum uzunluğu dahil olmak üzere Diginetica, Tmall ve Nowplaying veri setlerinin istatistiklerini özetlemektedir.
Deneysel ayarlar
Parametre kurulumu
Deneyin adaletini sağlamak için, GSLA4Rec modelinin parametreleri önceden belirlenirken, üç veri kümesini işlemek amacıyla ön işleme yöntemleri benimsenmiştir. Diginetica ve Nowlaying veri kümeleri için batch size 150, Tmall veri kümesi için ise 300 olarak ayarlanmıştır. Bu modelin parametreleri, ortalaması 0 ve standart sapması 0.1 olan Gauss dağılımı kullanılarak başlatılmış ve boyut 100 olarak belirlenmiştir; optimize edici olarak başlangıç öğrenme hızı 0.001 olan Adam kullanılmış, öğrenme hızı her 3 epoch'ta bir 0.1 ile çarpılmış ve eğitim, en iyi değerin alınması için NVIDIA TITAN V GPU ve cu113 ile PyTorch 1.11.0 (bkz. Table of Materials) kullanılarak toplam 30 epoch boyunca gerçekleştirilmiştir; komşu oturumları filtreleme eşiği 0.5 olarak ayarlanmış ve deneyde L2 düzenlileştirmesi uygulanmıştır. Her veri kümesi için, işlem zamanına göre sıralanan verilerin son %10'u test seti olarak seçilmiş, geri kalan %10 ve %80'lik kısımlar ise sırasıyla doğrulama ve eğitim setleri olarak rastgele seçilmiştir. GSLA'daki bellek yuvası sayısı {0, 1, 2, 3, 4, 5} kümesinden bir değer olarak ayarlanmıştır.
Değerlendirme metrikleri
Bu çalışmada P@N (Hassasiyet@N, N = 10/20) ve MRR@N (Ortalama Karşılıklı Sıra@N, N = 10/20) kullanılmıştır. P@N, ilk N öneri sonucu arasındaki doğru önerilerin oranını ölçmek için kullanılmış; MRR@N ise doğru projelerin ortalama karşılıklı sıralamasını hesaplamak için kullanılmıştır; MRR değeri ne kadar yüksekse, sıralama performansı o kadar iyidir.
Performans analizi
GSLA4Rec modelinin etkinliği, teknolojik gelişimin farklı aşamalarını temsil eden temel modellerle (baseline) karşılaştırılarak değerlendirilmiştir. İlk aşamalarda, SBR için makine öğrenmesi yöntemleri kullanılmış; örneğin, Markov zincirine dayalı sıralı etkileri tahmin etmek için FPMC5 kullanılmıştır. Daha sonra, yapay zekanın gelişimiyle birlikte derin öğrenme yöntemleri SBR için yaygın olarak uygulanmıştır; örneğin, GRU4Rec10le SBR'yi birden fazla GRU katmanını üst üste yığarak modelleyen RNN'lere dayanmış ve SBR'yi optimize etmek için özel kayıp fonksiyonları tasarlanmıştır; NARM16, kullanıcıların ana ilgilerini yakalamak için AM'yi tanıtmış ve bir sonraki olası öneri öğesinin nihai gömme (embedding) temsilini oluşturmuştur; STAMP17 ise kullanıcıların genel ilgilerini ve anlık ilgilerini eş zamanlı olarak yakalamak için AM ile geliştirilmiş çok katmanlı algılayıcılar (MLP) kullanmıştır. Son yıllarda, güçlü Öklid dışı veri öğrenme yetenekleri nedeniyle grafik sinir ağları (GNN) da SBR'de yaygın olarak kullanılmaya başlanmıştır. Örneğin, SR-GNN22, GNN'leri SBR'ye ilk kez uygulamış, GGNN'ler aracılığıyla karmaşık öğe geçiş ilişkileri elde etmiş ve AM ile birlikte kullanıcıların anlık ilgilerine odaklanmıştır; GCE-GNN23, yerel ve küresel bağlamlarda öğe aktarım ilişkilerini elde etmek için GAT'leri kullanmış ve RPE ile soft-AM aracılığıyla oturum temsilcileri oluşturmuştur; S2-DHCN66 ise oturum verilerini hipergrafiğe ve çizgi grafiğine dönüştürerek SBR'yi geliştirmek için öz-denetimli öğrenmeden yararlanmıştır.
Son zamanlarda, SBR performansını artırmak için kapsamlı bir yaklaşım benimsenmiştir. Örneğin, GC-SAN50 kısa ve uzun vadeli bağımlılıkları modelleyerek tavsiye performansını geliştirmek için GNN'leri çok katmanlı öz-dikkat ağları ile birleştirmiş, TASRec67 farklı zaman damgalarında dinamik grafik anlık görüntüleri dizisi oluşturarak zamansal bilgileri dahil etmiş, CT-GNN68 öğeler arasındaki ek zamansal ilişki bilgilerini öğrenmek için birleştirilmiş zamansal bilgilere sahip GNN'leri benimsemiş, CORE69 nihai oturum temsili elde etmek için öğelerin birlikte görülme bilgilerini ve zamansal bilgilerini kaynaştırmış, RESTC70 kontrastif öğrenmenin tekdüzeliği ve hizalama özelliklerinden esinlenen uzay-zamansal etkileşim modelleri önermiş, COTRec66,71 SBR'nin veri seyrekliğini çözmek için iki oturum grafik görünümü üzerinde denetimsiz öğrenme ve ortak eğitim benimsemiş, RAIN71 kenar maskeleme ve yapısal yeniden yapılandırmadan yararlanmış ve gürültülü kenarları açıkça belirlemek ve ortadan kaldırmak için ortaklaşa bir kenar göstergesi eğitmiş; bu da SBR'nin doğruluğunu ve sağlamlığını önemli ölçüde artırmıştır.
| Veri Kümeleri | Diginetica | Tmall | Nowplaying | ||||||||||
| Yöntem sınıf- landırması | Metrikler | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Makine Öğrenmesi | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| Derin Öğrenme | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| Derin Öğrenme | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| Derin Öğrenme | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| GNN'ler | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| GNN'ler | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNN'ler | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN'ler+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNN'ler+Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNN'ler+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNN'ler+Tem | CORE | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNN'ler+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNN'ler+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNN'ler+ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNN'ler+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| SD | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| p-değeri | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Tçıkarım | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
Tablo 3: Üç veri kümesi üzerinden performans karşılaştırması. Tablo; GSLA4Rec'i makine öğrenimi, derin öğrenme, GNN tabanlı, dikkat tabanlı, zamansal ve diğer öneri yöntemleriyle Diginetica, Tmall ve Nowplaying veri kümeleri üzerinde P@10, P@20, MRR@10 ve MRR@20 kullanarak karşılaştırmaktadır. GSLA4Rec için SD ve p-değerleri de raporlanmıştır.
GSLA4Rec modelinin performansını doğrulamak ve rastgele faktörlerin neden olduğu performans artışındaki rastgeleliği ortadan kaldırmak amacıyla, test seti üzerinde çoklu gruplandırma deneyleri ve istatistiksel analizler gerçekleştirilmiştir. Spesifik olarak, test seti her bir grup için 150 oturum olacak şekilde bölünmüş ve rastgele tohum (random seed) yöntemi kullanılarak 30 kez tekrarlanmıştır. Tüm gruplandırılmış deneylerin ortalama sonuçları ve zaman tüketimleri, sırasıyla GSLA4Rec modelinin performansı ve çıkarım süresi olarak hesaplanmıştır. GSLA4Rec modelinin performans artışının stabilitesini ve kesinliğini daha fazla doğrulamak için standart sapma (SD) ve istatistiksel anlamlılık t-testi hesaplanmıştır. Tablo 3, önerilen tavsiye modeli olan GSLA4Rec'in performansı, SD, p-değeri ve Tinference değerlerini üç veri setindeki temel modellerle (baselines) karşılaştırmalı olarak sunmaktadır. Altı çizili sayılar en iyi temel yöntemi belirtmekte, her bir değerlendirme metriğine karşılık gelen en iyi performans gösteren model ise kalın siyahla işaretlenmiştir.
Makine öğrenimi tabanlı öneri yöntemleri: SBR görevlerinde, geleneksel FPMC yöntemi, temel olarak Markov zinciri modellerinin öğeler arasındaki karmaşık geçiş kalıplarını yakalayamaması nedeniyle en kötü performansı sergilemiştir. 2) Derin öğrenim tabanlı öneri yöntemleri: GRU4REC, NARM ve STAMP gibi modeller dizi modelleme yaklaşımları benimsemiş ve belirli performans iyileştirmeleri sağlamıştır. Bunlar arasında NARM ve STAMP, temel olarak NARM'ın kullanıcıların ana ilgi alanlarını yakalamak için bir dikkat mekanizması (attention mechanism) getirmesi nedeniyle GRU4REC'ten daha iyi öneri sonuçları göstermiştir. 3) GNN tabanlı öneri yöntemleri: GNN'lerin SBR'de benimsenmesi belirgin performans artışları getirmiştir. Örneğin, öğe uzamsal yapısal bilgilerini yakalamak için oturum dizilerinin graf yapılarına dönüştürülmesine öncülük eden SR-GNN, STAMP ile temsil edilen Derin Öğrenim yöntemlerini %0,36–4,64'lük bir artışla geride bırakarak, ardışık verilerin işlenmesinde graf yapılarının uzamsal avantajını kanıtlamıştır. S2-DHCN, öğeler arasındaki yüksek dereceli bağımlılıkları yakalamak için çift kanallı hipergraf konvolüsyonu benimsemiş ve temsilleri geliştirmek için öz-denetimli karşıtlı öğrenmeyi (self-supervised contrastive learning) eşleştirmiştir; geleneksel GNN'lerin yalnızca ikili ilişkileri modellemedeki kısıtlılığını ve yetersiz bilgi sorununu ele alan bu yöntemin performansı, STAMP ile temsil edilen Derin Öğrenim yöntemlerini %1,30–7,04 oranında geçmiştir. GCE-GNN, tek oturum ve küresel oturum bilgilerini etkili bir şekilde entegre ederek, STAMP ile temsil edilen Derin Öğrenim yöntemlerini %1,46–7,60 ve SR-GNN'i %0,88–5,85 oranında geride bırakmış, bu da küresel bağlamsal bilgileri içeren graf yapı yöntemlerinin SBR performansını önemli ölçüde artırabileceğini göstermiştir. 4) GNN + dikkat mekanizması tabanlı öneri yöntemleri: TASRec, zaman farkındalıklı bir mekanizma getirerek kullanıcı davranış dizilerindeki kısa ve uzun vadeli tercihleri daha kesin bir şekilde yakalamayı amaçlamıştır; performansı Derin Öğrenim yöntemlerini %0,73–5,91 ve SR-GNN modelini %0,30–2,31 oranında aşmış, ancak GCE-GNN modelinin %0,59–3,84 gerisinde kalmıştır. GC-SAN, oturum dizilerinden dönüştürülen graf yapılarını çok kafalı öz-dikkat (multi-head self-attention) mekanizmalarıyla birleştirerek oturumlar içindeki yerel ve uzun vadeli bağımlılıkları başarıyla yakalamıştır; performansı SR-GNN modeliyle benzer veya biraz daha güçlü olsa da hem TASRec hem de GCE-GNN modellerinden daha düşük kalmıştır. Bu durum, dikkat mekanizmalarının getirilmesinin SBR performansını etkili bir şekilde artırabileceğini, ancak bu iyileştirmenin küresel bilgilerle sağlanan iyileştirmeden daha az belirgin olduğunu göstererek küresel bağlamsal bilginin önemini yeniden teyit etmiştir. 5) GNN + zaman kodlama tabanlı öneri yöntemleri: CT-GNN, "uzamsal yapı" ve "zamansal dinamikleri" eş zamanlı olarak yakalamak için graf yapılarını zamansal kodlama ile birleştiren ilk yöntem olmuş ve GC-SAN modelini %0,55–3,82 oranında geride bırakmıştır. CORE, sırasıyla küresel oturumlardaki öğe ortak görünüm frekanslarını istatistiksel olarak analiz ederek uzun vadeli tercihleri ve mevcut oturumlar için zamansal konum ağırlıklandırması tasarlayarak kısa vadeli niyetleri yakalamış; nihai oturum temsilini elde etmek için bu ortak görünüm ve zamansal bilgileri birleştirmiştir; performansı TASRec modelini %0,25–9,58 ve GC-SAN modelini %0,67–11,56 oranında aşmış ve Tmall veri setinde GCE-GNN modeline göre %3,64–5,74'lük önemli bir iyileşme göstermiştir. RESTC, geleneksel GNN'lerdeki yalnızca uzamsal graf yapılarına odaklanma, zamansal bilgilerin göz ardı edilmesi ve yetersiz uzamsal-zamansal füzyon gibi sorunları gidermek için uzamsal-zamansal GNN'lere dayalı bir karşıtlı öğrenme modeli sunmuştur; performansı CORE modelini %0,39–3,31 ve GCE-GNN modelini %0,28–7,56 oranında geçerek hem zamansal kodlamanın hem de karşıtlı öğrenmenin SBR performansını etkili bir şekilde artırdığını göstermiştir. RAIN, gürültülü kenarları açıkça belirlemek ve ortadan kaldırmak için bir kenar göstergesini ortaklaşa eğitmek amacıyla kenar maskeleme ve yapısal yeniden yapılandırma tekniklerini kullanarak RESTC modeline yakın bir performans elde etmiştir.
Önerilen model olan GSLA4Rec, gürültüyü filtrelerken ve hesaplama karmaşıklığını azaltırken kullanıcıların bağlamsal bilgilerini etkili bir şekilde yakalamak için küresel bağlamsal bilgileri ve kapılı yuva doğrusal dikkat (gated-slot linear attention) mekanizmasını entegre etmiştir. Tüm veri kümelerinde performans artışları sergileyerek en iyi performans gösteren iki temel modeli geride bırakmıştır; RESTC modelini %0,54–2,31 ve GCE-GNN modelini %0,83–10,18 oranında aşmıştır. Bu durum, SBR'deki uzun oturum senaryolarında ardışık bağımlılıkların yönetilmesinde özellikle belirgindi (özellikle Tmall ve Nowplaying veri kümelerinde GCE-GNN'e kıyasla sırasıyla %10,18 ve %4,73; RESTC'ye kıyasla ise %1,44 ve %2,31'lik iyileşmeler gözlemlenmiştir). Kısaca, önerilen GSLA4Rec modeli, kullanıcı bağlamlarını yakalamak ve gürültüyü filtrelemek için verimli grafik oluşturmayı dahil etmiştir; performansı tüm veri kümelerinde tutarlı bir şekilde SOTA'yı geride bırakmıştır.
Verimliliğin analiz edilmesi
Şekil 4'te gösterildiği gibi, Diginetica veri kümesi üzerindeki deneysel sonuçlar, önerilen GSLA4Rec'in, tüm deneylerin bir NVIDIA TITAN V GPU üzerinde çalıştırıldığı ve yaklaşık 9300MB bellek tüketildiği durumda, epok başına eğitim süresi açısından temel modellerden daha hızlı bir eğitim hızı elde ettiğini göstermiştir. STAMP, NARM ve GRU4Rec dahil olmak üzere derin öğrenme tabanlı modeller verimli çalışmış ancak en zayıf performansı sergilemişlerdir; GNN'ler ve Öz-Dikkat mekanizmasına dayalı olan TASRec ve GC-SAN modelleri performansı artırmış, ancak önemli ölçüde zaman alıcı olmuşlardır. GNN tabanlı S2-DHCN ve CORE modelleri hesaplama süresinde hafif bir artışa neden olsa da, genel performansta belirgin bir iyileşme sağlanmış, özellikle önerilen GSLA4Rec modeli performansta ciddi bir artış göstermiştir. Bunun temel nedeni, GSLA4Rec modelinin grafik oluşturma aşamasında temel modellere göre daha az zaman harcaması ve ayrıca, sabit bellek slotları m ile iki geçişli kapılı doğrusal dikkat mekanizması kullanarak doğrusal zaman karmaşıklığı O(Ldm) elde etmesidir. Bu tasarım, softmax ile güçlendirilmiş slot okuma yoluyla güçlü bellek kapasitesini korurken, standart öz-dikkat O(L2d) mekanizmasından önemli ölçüde daha verimli olmuştur. İstatistiksel çıkarım süresini senkronize etmek için test kümesi üzerinde gerçekleştirilen performans testi deneyleri, Tablo 3'ün son satırında gösterildiği üzere, GSLA4Rec modelinin verimlilik avantajını kanıtlamış; "yalancı yüksek doğruluk ancak kullanılamazlık" durumundan kaçınarak etkililik ve verimlilik arasında gerçek bir denge sağlamıştır.
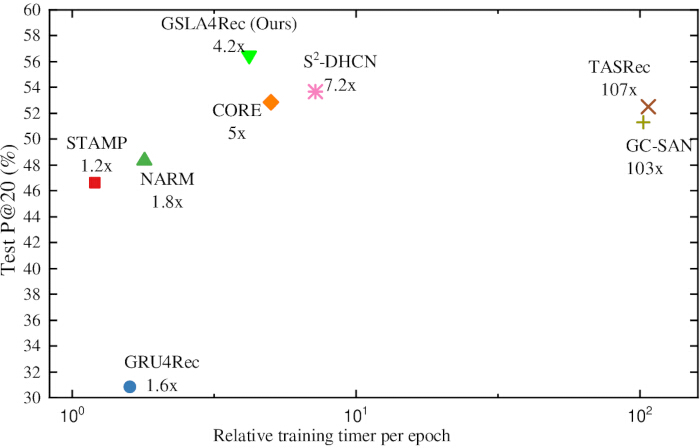
Şekil 4: Diginetica veri setinde GSLA4Rec'in çalışma süresi boyunca performansı. Şekil, önerilen GSLA4Rec ve temel modellerin Diginetica kullanılarak epoch başına göreceli eğitim süresi için NVIDIA TITAN V GPU üzerinde çalıştırıldığını ve GSLA4Rec'in temel modellerden daha hızlı eğitim hızına ulaştığını göstermiştir. Bu şekil, tamamen özelleştirilmiş öğelerle OriginPro aracılığıyla çizilmiştir. Telif hakkı içeren herhangi bir harici grafik kaynağı kullanılmamıştır, bu nedenle ek bir üçüncü taraf telif hakkı lisansına ihtiyaç duyulmamıştır. Şeklin telif hakkı yazarlara aittir ve kabul edildiğinde derginin telif hakkı kurallarına uygun olacaktır. GSLA4Rec, SBR için gated-slot lineer dikkatli grafik sinir ağlarını temsil eder. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Özetle, doğrusal karmaşıklığa sahip gated-slot dikkat mekanizması içeren önerilen GSLA4Rec modelinin verimliliği, tüm veri kümelerinde tutarlı bir şekilde SOTA performansını aşmıştır. Özellikle GSLA4Rec, Tmall ve Nowplaying veri kümeleri üzerindeki uzun oturumlu öneri senaryolarında önemli performans kazanımları elde etmiş ve üstün ardışık bağımlılık modelleme yeteneği göstermiştir.
Ablasyon deneylerinin analizi
SG, NGG ve GSLA'nın Etkisi
SG, NGG, kapılama mekanizması, bellek yuvaları ve doğrusal dikkatin mevcut SBR üzerindeki etkisini değerlendirmek için Diginetica, Tmall ve Nowplaying veri setleri üzerinde ablasyon çalışmaları gerçekleştirilmiştir. GSLA4Rec‑NotSG, NGG kodlamasını korurken SG özellik kodlamasını hariç tutmuş; GSLA4Rec‑NotNGG, NGG kodlamasını dışlamış ve özellik çıkarımını yalnızca SG'ye dayalı olarak gerçekleştirmiş; GSLA4Rec‑NotGM, GSLA içindeki yalnızca kapılama mekanizmasını kaldırmış; GSLA4Rec‑NotMS, GSLA'nın sadece bellek yuvalarını elemiş ve GSLA4Rec‑NotLA, GSLA'daki yalnızca doğrusal dikkat modülünü atlamıştır.
| Veri Seti | Diginetica | Tmall | Şu an oynatılıyor | |||
| Ölçümler | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Tablo 4: GSLA4Rec ablasyon deneylerinin performansı. Tablo; Diginetica, Tmall ve Nowplaying veri kümeleri üzerinde, bireysel model bileşenleri kaldırıldıktan sonra GSLA4Rec'in ablasyon performansını P@20 ve MRR@20 kullanılarak değerlendirerek rapor etmektedir.
Tablo 4, farklı veri kümeleri üzerinde gerçekleştirilen ablasyon çalışmasının sonuçlarını göstermiştir; tüm performans metrikleri tam modele kıyasla azalmıştır. Yakın komşu küresel oturum grafiği kodlaması kaldırıldığında (GSLA4Rec-NotNGG) meydana gelen performans düşüşü, oturum grafiği özellik kodlaması kaldırıldığında (GSLA4Rec-NotSG) meydana gelenden daha güçlüydü. GSLA içindeki herhangi bir alt modülün silinmesi performans kaybına yol açmış olup, bu performans kaybı yüksekten düşüğe doğru sırasıyla lineer dikkat, bellek slotları ve kapılama mekanizması şeklinde sıralanmıştır. Bunun nedeni, SBR'deki her bir öğenin öneminin kesinlikle farklı olması ve öğeler arasında çağrışımlı belleğe ihtiyaç duyulmasıdır. GSLA'nın bu makalenin modelinin kilit bir parçası olduğu görülmüştür.
Farklı agregasyon yöntemlerinin etkisi
Farklı bilgi toplama yöntemlerinin GSLA4Rec modelinin performansı üzerindeki etkisini değerlendirmek için şu üç klasik bilgi toplama yöntemi incelenmiştir: 1) Ortalama Havuzlama (Average Pooling): SG ve NGG tarafından oluşturulan vektörler üzerinde ortalama havuzlama işlemi gerçekleştirme; 2) Vektör Birleştirme (Vector Concatenation): SG ve NGG tarafından oluşturulan vektörlerin uç uca eklenmesi; 3) Vektör Toplama (Vector Summation): SG ve NGG tarafından oluşturulan vektörlerin toplanması. Sonuçlar Tablo 5'te gösterilmiştir. Vec-Sum ile kullanılan GSLA4Rec; Diginetica, Tmall ve Nowplaying veri setlerinde en iyi performansı göstermiştir. Buna karşılık, Mean-pooling tüm veri setlerinde düşük sonuçlar vermiştir. Ortalama toplamanın ve birleştirme toplamanın yetersiz performansı, aşırı parametrelerin neden olduğu ve genel model performansını düşüren aşırı uyumdan (overfitting) kaynaklanmış olabilir.
| Veri Seti | Diginetica | Tmall | Şu an oynatılıyor | |||
| Ölçümler | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Ortalama Havuzlama | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| Vektör Birleştirme | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| Vec-Sum | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
Tablo 5: Farklı toplama yöntemlerinin etkileri. Tablo; mean pooling, vektör birleştirme ve vektör toplama yöntemlerinin, Diginetica, Tmall ve Nowplaying veri setleri genelindeki GSLA4Rec performansı üzerindeki etkilerini P@20 ve MRR@20 kullanarak karşılaştırmaktadır.
Hiper-parametre ayarlarının analizi
Farklı bellek yuvası boyutlarının etkileri
Bellek yuvaları, özellikle zamansal bağımlılıkları olan görevler için kritik önem taşıyan, önceki zaman adımlarından gelen bilgileri depolamıştır. Bu bölüm, bellek yuvası boyutlarının m = [0, 1, 2, 3, 4, 5] SBR performansı üzerindeki etkisini incelemiştir. Tablo 6'da gösterilen deneysel sonuçlar, bellek yuvası boyutları m 3 olarak ayarlandığında, üç veri kümesi genelinde P@20 ve MRR@20 metriklerinin optimal performans sergilediğini göstermiştir. Bu durum, orta düzeydeki bellek yuvası boyutlarının modelin tavsiye doğruluğunu ve sıralama kalitesini etkili bir şekilde artırdığını; daha küçük bellek yuvalarının yeterli geçmiş bilgiyi hafızada tutmakta zorlanarak daha çok kullanıcıların kısa vadeli ilgi alanlarına odaklandığını, bellek yuvası boyutları 4 veya daha fazlasına çıktığında ise modelin aşırı miktarda geçmiş bilgi depolayarak güncel ve daha kritik giriş bilgilerini ihmal edip geçmiş ilgi alanlarına aşırı bağımlı hale geldiğini ve böylece tavsiye performansının düştüğünü ortaya koymuştur.
| Veri Seti | Diginetica | Tmall | Şu an oynatılıyor | |||
| Ölçümler | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
Tablo 6: Farklı bellek yuvası boyutlarının etkileri. Tablo, Diginetica, Tmall ve Nowplaying veri kümelerinde P@20 ve MRR@20 kullanılarak farklı bellek yuvası konfigürasyonlarına (m0–m5) sahip GSLA4Rec performansını rapor etmektedir.
Farklı dropout oranlarının etkileri
Aşırı öğrenmeyi (overfitting) önlemek için dropout düzenlemesi getirilmiştir. GSLA4Rec modelinin sağlamlığını ve genelleme yeteneğini artırmak amacıyla, oturum düzeyindeki öge vektörü ile komşu küresel düzeydeki öge vektörü toplanmadan önce, komşu küresel düzeydeki öge vektörü hingg,(k) içindeki nöron çıktıları rastgele olarak düşürülmüştür.
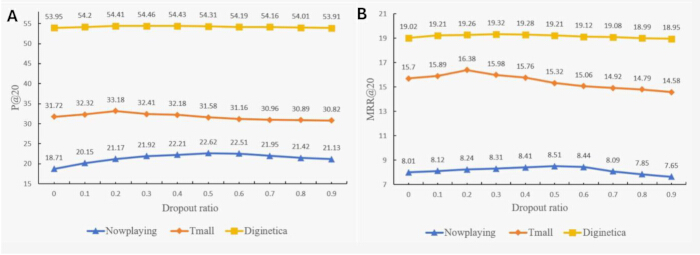
Şekil 5: Farklı dropout oranları altında GSLA4Rec performansı. (A) Nowplaying, Tmall ve Diginetica veri kümelerinde farklı dropout oranları altında GSLA4Rec'in P@20 ve (B) MRR@20 değerleri. Dropout oranı arttıkça performans başlangıçta artmış ve ardından azalmıştır; bu durum modelin dayanıklılığını ve genelleme yeteneğini göstermektedir. GSLA4Rec, oturum tabanlı öneri (SBR) için kapılı-yuva doğrusal dikkatli grafik sinir ağları (gated-slot linear attention graph neural networks). Bu şekil, tamamen özelleştirilmiş öğelerle OriginPro kullanılarak tarafımızca çizilmiştir. Telif hakkıyla korunan herhangi bir harici grafik kaynağı kullanılmamıştır; bu nedenle ek bir üçüncü taraf telif hakkı lisansına gerek duyulmamıştır. Şeklin telif hakkı yazarlara aittir ve kabul sonrası derginin telif hakkı kurallarına uygun olacaktır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Şekil 5A–B, Denklem (16)'daki farklı dropout oranlarının model performansı üzerindeki etkisini göstermiştir. Deneysel sonuçlar, dropout oranı düşük olduğunda modelin zayıf performans sergilediğini; ancak dropout oranı arttıkça, model performansının optimal bir seviyeye ulaşana kadar kademeli olarak iyileştiğini göstermiştir. Spesifik olarak, optimal dropout oranı Diginetica veri setinde 0.3, Tmall veri setinde 0.2 ve Nowplaying veri setinde 0.5 olarak belirlenmiştir. Dropout oranı bu optimal değerleri aştığında, temel olarak aşırı nöron dropout'unun modelin oturum verilerinden önemli özellikleri etkili bir şekilde öğrenmesini engellemesi nedeniyle model performansı düşmeye başlamıştır.
Farklı gömme boyutlarının etkileri
Optimal model performansını korurken hesaplama yükünü mümkün olduğunca en aza indirmek için, farklı gömme boyutlarının d GSLA4Rec modelinin performansı üzerindeki etkisi incelenmiştir. Şekil 6A–B'de gösterildiği gibi, Diginetica, Tmall ve Nowplaying adlı üç halka açık veri setinde, gömme boyutu d 10–40 olduğunda GSLA4Rec modeli düşük performans göstermiştir; ancak d değeri arttıkça modelin performansı hızla yükselmiş, d değeri 80 ile 120 aralığında olduğunda performans metrikleri stabilize olma eğilimi göstermiştir; ardından, muhtemelen büyük gömme boyutunun neden olduğu aşırı öğrenme (overfitting) nedeniyle, d sürekli arttıkça performans aslında düşüş göstermiştir. Bu nedenle, öğe gömme vektörünün boyutu nihai olarak 100 olarak belirlenmiştir.
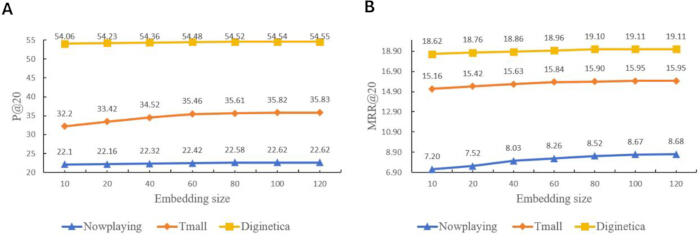
Şekil 6: Farklı gömme boyutları altında GSLA4Rec performansı. Nowplaying, Tmall ve Diginetica veri kümelerinde farklı gömme boyutları altında GSLA4Rec'in (A) P@20 ve (B) MRR@20 değerleri. Model performansı, artan gömme boyutuyla kademeli olarak artmış ve nihayetinde bir platoya ulaşmıştır. GSLA4Rec, oturum tabanlı öneri (SBR) için kapılı-yuvalı doğrusal dikkat graf neural ağlarıdır. Bu şekil, tamamen özelleştirilmiş öğelerle OriginPro kullanılarak tarafımızca çizilmiştir. Telif hakkıyla korunan harici grafik kaynakları kullanılmamıştır; bu nedenle ek üçüncü taraf telif hakkı lisansına ihtiyaç duyulmamıştır. Şekil telif hakkı yazarlara aittir ve kabul sonrası derginin telif hakkı kurallarına uygun olacaktır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Farklı seans sürelerinin etkileri
Üç gerçek dünya SBR veri setinde (Diginetica, Tmall ve Nowplaying) her bir oturumun uzunluğunun değişken olduğu iyi bilinmektedir. GSLA4Rec modelinin farklı oturum uzunluklarında temel modellerle karşılaştırıldığında gösterdiği sağlamlığı doğrulamak için, Diginetica ve Tmall'daki tüm oturumlar sırasıyla 1 ila 6, 7 ila 12 ve 12'den büyük olacak şekilde kısa grup (S), orta grup (M) ve uzun grup (L) olmak üzere üç gruba ayrılmıştır. MRR'nin doğru sonuçların sıralama kalitesini daha iyi yansıtabilmesi nedeniyle, yöntemlerin performansını doğrulamak için P@20 yerine MRR@20 benimsenmiştir. Şekil 7A–B, GSLA4Rec modelinin farklı oturum uzunluklarında sekans tabanlı temel model NARM, GNN tabanlı temel model SR-GNN, karşıtlaştırmalı öğrenme ile zenginleştirilmiş GNN tabanlı temel model S2-DHCN ve uzay-zamansal temel model RESTC'den daha iyi performans gösterdiğini belirtmiştir. Aynı zamanda, uzun menzilli ürün geçişlerinin kullanıcı tercihlerini yakalamayı zorlaştırması nedeniyle, tüm yöntemlerin performansının sekans uzunluğu arttıkça azaldığı gözlemlenmiştir; ancak Gated-slot mekanizması ilgisiz ürünleri filtreleyebildiği için, önerilen GSLA4Rec modelinin temel modellere kıyasla en düşük düşüş hızına sahip olduğu görülmüştür; GSLA4Rec'in performansı, Diginetica ve Tmall'ın uzun gruplarında NARM modelini sırasıyla 6,3 ve 8,85 oranında geride bırakmıştır.
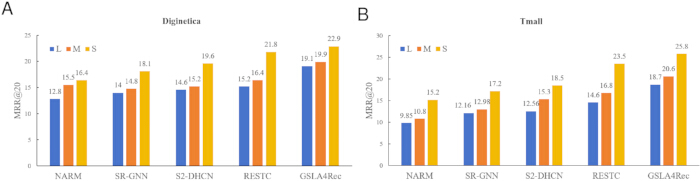
Şekil 7: Farklı oturum uzunlukları altında GSLA4Rec performansı. (A) Diginetica ve (B) Tmall veri setlerinde, farklı oturum uzunluğu grupları altında GSLA4Rec ve temel modellerin MRR@20 kullanılarak değerlendirilmiş performansları. Oturum uzunluğu grupları L, M ve S olarak belirtilmiştir. GSLA4Rec, oturum tabanlı öneri (SBR) için kapılı-yuva doğrusal dikkatli grafik sinir ağlarıdır. Bu şekil, tamamen özelleştirilmiş öğelerle OriginPro kullanılarak bizzat çizilmiştir. Telif hakkıyla korunan herhangi bir harici grafik kaynağı kullanılmamıştır; bu nedenle, ek bir üçüncü taraf telif hakkı lisansına gerek duyulmamıştır. Şeklin telif hakkı yazarlara aittir ve kabul edildiğinde derginin telif hakkı kurallarına uygun olacaktır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Sonuç
Bu makale, SBR için küresel bağlam kapılı-yuva doğrusal dikkat ağı önermektedir. SG ve NGG'yi birleştirip kapılı-yuva doğrusal dikkat mekanizmasını tanıtarak, bu yöntem oturum dizisindeki kilit öğelere odaklanılmasını, uzun ve kısa vadeli bağımlılıkların yakalanmasını, gürültünün etkili bir şekilde azaltılmasını ve hesaplama karmaşıklığının düşürülmesini sağlar. Deneysel sonuçlar, bu yöntemin üç kamuya açık veri kümesinde mükemmel öneri doğruluğu ve verimliliği sergilediğini, özellikle uzun vadeli bağımlılık modelleme görevlerinde üstün performans gösterdiğini doğrulamaktadır.
VERİERİLEBİLİRLİK:
Bu çalışmanın bulgularını destekleyen üç yaygın halka açık veri kümesi (Diginetica, Tmall ve Nowplaying; URL'ler Materyaller Tablosu'nda bulunabilir) internet üzerinden açıkça erişilebilirdir. Aynı zamanda, yaygın olarak kullanılan üç halka açık veri kümesi ve bu çalışmanın kaynak kodu Ek Klasör: GSLA4Rec.zip olarak sunulmuştur. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Temel değerlere kıyasla GSLA4Rec modeli, performans ve verimlilik açısından üç temel nedenden dolayı ikili iyileştirmeler elde eder. Birincisi, NGG'ye geçit mekanizmaları uygulanarak veri seyrekliği azaltılır ve gürültü etkili bir şekilde süzülür. İkincisi, bellek yuvaları mekanizması, hiperparametre aracılığıyla depolama kapasitesi ile verimlilik arasında denge kurar. m ayarlaması. Üçüncüsü, doğrusal dikkat mekanizması öğe korelasyonlarını bir O(N) karmaşıklık, çok daha düşük olan O(N2)61GSLA4Rec modeli kullanıcılarına aşırı bağımlıdır' etkileşim dizileri ve öğelerin çok modlu özelliklerini görmezden gelir48Bu arada, NGG yapısı dinamik ayarlama işlevi olmadan sabit bir Jaccard eşiğini kullanır ve bellek yuvaları m uyarlamalı ayarlanabilirliği sağlayamaz65.
GSLA4Rec modeli, SG'yi oluşturur&NGG ve özellikle anonim oturum önerileri için uygun olan gated-slot doğrusal dikkat mekanizmasını benimser39 e-ticaret ve çevrimiçi akış platformları arasında. E-ticaret platformlarında bu model, kullanıcıların karakteristik özelliklerine dayanmadan, onların ürün sayfalarında gezinme, tıklama veya sepete ekleme davranışlarını izleyerek kullanıcılarla eşleşen ürünleri önerir. Bu makalede kullanılan Diginetica ve Tmall veri kümeleri, e-ticaret öneri veri kümeleridir. Kısa video ve müzik akış platformları için bu yöntem, kullanıcıların' oynatma sıralarını analiz ederek örtük tercihlerini çıkarsar, kullanıcıları elde tutmak için içerik özetlerini günceller ve izleme süresini uzatır. Bu makalede kullanılan Nowplaying veri kümesi, müzik önerme veri kümesidir.
Gated slot doğrusal dikkat mimarisini değiştirebilecek alternatif çözümler mevcuttur. Ortaya çıkan Mamba65 alternatif olarak temel alınan durum uzayı modeli, seçmeli durum depolama alanı ve doğrusal hesaplama karmaşıklığı özelliklerine sahiptir ve doğrusal karmaşıklık ile uzun dizi uyum yeteneği arasında denge kurar; ayrıca büyük dil modeli (LLM) ile birleştirilir55 geliştirme çerçevesi, kullanıcıların çıkarır' orijinal etkileşim günlüğünden örtük niyeti çıkararak iyi bir öneri performansı ve verimlilik elde edilir. Gelecekteki çalışmalar, GSLA4Rec modelini birden fazla açıdan optimize edebilir: sabit Jaccard filtrelemesinin yerini alacak dinamik NGG oluşturulması, farklı uzunluktaki oturumlara otomatik olarak uyum sağlayacak değişken bellek birimlerinin uygulanması ve öneri doğruluğunu artırmak için kullanıcıya ait çok modlu bilgilerin entegre edilmesi. Ayrıca, LLM ile güçlendirilmiş modellerin yardımıyla55, kullanıcılar' örtük niyetler etkileşim dizilerinden çıkarılabilir ve gürültülü konuşma verileri daha doğru bir şekilde süzülebilir72.
Açıklamalar
Yazarlar, bu makalede rapor edilen çalışmayı etkileyebilecek bilinen herhangi bir rakip finansal çıkarın veya kişisel ilişkinin olmadığını beyan ederler.
Teşekkürler
Yazar, inceleme sürecindeki düşünceli geri bildirimleri ve önerileri için hakemlere ve dikkatli rehberliği için doktora danışmanım Profesör Jiang Nan'a teşekkür eder. Bu çalışma kısmen 6217072713 ve 62061019 numaralı hibelerle Çin Ulusal Bilim Vakfı tarafından, kısmen 2025 yılı Jiangxi Eyaleti insansız algılama sistemi ve yapay zeka teknolojisi Mühendislik Araştırmaları açık araştırma konuları tarafından ve kısmen Jiangxi Eyaleti Gelişmiş Elektronik Malzemeler ve Cihazlar Anahtar Laboratuvarı (No.2024SSY03012) tarafından desteklenmiştir.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | YOK | CUDA 11.3, GPU hızlandırmalı uygulamaların performansını ve geliştirme esnekliğini artırmayı amaçlayan, NVIDIA tarafından 2021 yılında yayınlanan bir paralel hesaplama platformu ve programlama modeli sürümüdür. |
| Diginetica | Diginetica | YOK | Diginetica, e-ticarette arama bağlamlı kişiselleştirilmiş ürün getirme problemini çözmek için CIKM algoritma yarışmasında kullanılan 2016 CIKM (Uluslararası Bilgi Erişimi Konferansı) Kupası'nın resmi yarışma veri setidir. Günümüzde Oturum Tabanlı Öneri (SBR) alanındaki en yaygın standart e-ticaret kıyaslama veri seti haline gelmiştir. |
| Nowplaying | Zenodo | YOK | "# nowplaying" etiketli tweet madenciliğine dayalı olarak oluşturulmuş, temel olarak müzik konuşma önerisi, bağlam duyarlı öneri ve duygu korelasyon analizi araştırmaları için kullanılan büyük ölçekli bir müzik dinleme davranışı veri setidir. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | YOK | OriginPro, OriginLab Corporation tarafından geliştirilen, yaygın olarak yayın düzeyinde grafikler çizmek, veri istatistikleri çıkarmak, eğri uydurma ve sinyal işleme gibi işlemler için kullanılan ticari profesyonel bir bilimsel çizim ve veri analiz yazılımıdır. Bu makalede deneysel karşılaştırma grafikleri, çizgi grafikleri ve sütun grafikleri çizmek için OriginPro kullanılmıştır. |
| PyTorch 1.11.0 | PyTorch Foundation | YOK | PyTorch, Facebook tarafından 2016 yılında yayınlanan, makine öğrenimi ve derin öğrenme için açık kaynaklı bir derin öğrenme çerçevesidir. Temel olarak otomatik türevlemeyi uygular ve model oluşturmayı daha esnek hale getirmek için dinamik hesaplama grafiklerini tanıtır. |
| TITAN V GPU | NVIDIA | YOK | NVIDIA TITAN V, NVIDIA tarafından 2017 sonunda piyasaya sürülen ve esas olarak yüksek performanslı hesaplama ve yapay zeka alanlarına hitap eden amiral gemisi bir grafik kartıdır. |
| Tmall | Tmall | YOK | IJCAI 2015 Alibaba Tmall Öneri Yarışması'ndan, Alibaba Tianchi tarafından duyarsızlaştırılmış gerçek Tmall çevrimiçi kayıtları kamuya açıklanmıştır. SBR alanındaki üç standart veri setinden (Diginetica, Yoocoose, Tmall) biridir ve Çince e-ticaret senaryoları için tercih edilen değerlendirme setidir. |
| visio 2021 | Microsoft | YOK | Visio, Microsoft tarafından geliştirilen, bilimsel araştırma makalelerinde model yapı diyagramları, akış şemaları, çerçeve diyagramları ve ağ topolojisi diyagramları çizmek ve makale illüstrasyonları için vektör diyagramları oluşturmak amacıyla kullanılan bir vektör çizim yazılımıdır |
Kaynaklar
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.