Bu protokol; doğru tahmin, şeffaf karar verme ve kişiselleştirilmiş diyabet yönetimi için federasyon öğrenme, çok modlu transformatörler, difüzyon tabanlı artırma, graf tabanlı kişiselleştirilmiş ilaç önerisi ve açıklanabilir yapay zeka aracılığıyla gizliliğe saygı duyan çok modlu bir diyabet zekası çerçevesi olan FedMediFormer-XAI'yi önermektedir.
Yöntem makalesi
FedMediFormer-XAI: Diyabet için Difüzyon Artırımı ve Graf Tabanlı İlaç Önerisi ile Federatif Multimodal Transformer'lar
Bu makalede
Özet
Özet
Diyabet yönetimi; parçalı sağlık verileri, gizlilik endişeleri, yetersiz açıklanabilirlik ve kişiselleştirilmiş terapötik rehberliğin eksikliği gibi bir dizi engel ile karşı karşıyadır. Bu araştırma çalışması; diyabet zekası için federatif öğrenme, multimodal transformer'lar, difüzyon tabanlı veri artırımı, ilaç önerisi için Graf Sinir Ağları (GNN'ler) ve Açıklanabilir Yapay Zeka'yı (XAI) içeren birleşik ve uygun bir çerçeve olan FedMediFormer-XAI'yi tanıtmaktadır. Sistem; klinik kayıtlar, popülasyon sağlığı göstergeleri, sürekli glikoz izleme verileri, retinal fundus görüntüleri, giyilebilir sensör ölçümleri ve farmakolojik bilgiler gibi çeşitli sağlık veri türlerini kullanmaktadır. Sentetik örnekler oluşturmak ve sınıf dengesizliğini gidermek için difüzyon modelleri kullanılırken, çok farklı veri kaynakları arasındaki ilişkileri öğrenmek için multimodal transformer mimarileri uygulanmaktadır. Federatif öğrenme, ham hasta verilerini paylaşmadan, gizliliği koruyan bir yöntemle modellerin iş birliğine dayalı eğitimini sağlar. GNN bileşeni, kişiselleştirilmiş ilaç önerileri için hasta-ilaç ve ilaç-ilaç etkileşimlerini yakalar. SHapley Additive exPlanations (SHAP), dikkat görselleştirme, Entegre Gradyanlar ve karşıolgusal akıl yürütme gibi açıklanabilirlik yöntemleri, tahmin ve öneri sonuçlarının şeffaf yorumlarını sunar. Temsili uygulamada, önerilen çerçeve %94,2 doğruluk, %93,1 kesinlik, %92,8 duyarlılık, %92,9 F1-skoru, 0,88 Matthews Korelasyon Katsayısı (MCC) ve 0,96 Alıcı İşletim Karakteristiği Eğrisi Altındaki Alan (AUC-ROC) elde etmiştir. Graf tabanlı öneri modülü kesinlik = 0,89, duyarlılık = 0,84 ve Normalize Edilmiş İndirgenmiş Kümülatif Kazanç (NDCG) = 0,91 değerlerine ulaşmıştır. Protokol; multimodal transformer'lar, federatif öğrenme, difüzyon tabanlı artırım, graf tabanlı öneri ve açıklanabilir yapay zeka kullanarak heterojen sağlık verilerinin entegrasyonu için yapılandırılmış bir yaklaşım sunmaktadır. Rapor edilen hesaplama sonuçları, çerçevenin diyabet tahmini ve kişiselleştirilmiş ilaç önerisi potansiyelini kanıtlarken, federatif tasarım merkeziyetsiz veri yönetimini desteklemektedir. Klinik faydayı, genellenebilirliği ve gerçek dünya uygulanabilirliğini belirlemek için prospektif çok merkezli bir klinik değerlendirme gereklidir.
Giriş
Diabetes mellitus, insanlığı etkileyen en önemli kronik metabolik hastalıklar arasında yer almakta ve uzun vadeli etkileri ile hasta tedavi maliyetlerinin yüksekliği nedeniyle, giderek artan yaygınlığıyla ciddi bir halk sağlığı sorunu teşkil etmektedir1,2. Bir rapora göre, dünya genelinde şu anda diyabetle yaşayan 537 milyondan fazla yetişkin bulunmaktadır ve bu rakamın önümüzdeki birkaç on yıl içinde önemli ölçüde artması beklenmektedir3. Yüksek kan şekeri seviyeleri kontrol altına alınmazsa, kişi koroner kalp hastalığı4, böbrek hasarı5, sinir hasarı6, görme kaybı7 ve beyin felci8 gibi en ağır komplikasyonlardan muzdarip olacaktır. Bu nedenle, hastalığın en erken evrede teşhis edilmesi, hastanın durumunun düzenli olarak izlenmesi ve gelişmiş tıbbi yaklaşımlar aracılığıyla hastaya eğitim verilmesi, hastaların daha sağlıklı yaşamlar sürmelerine yardımcı olmak ve böylece devletin sağlık sistemi giderlerini azaltmak için gerekli adımlardır9,10.
Günümüzde, elektronik sağlık kayıtlarının (EHR'ler), giyilebilir cihazların, sürekli glukoz izleme (CGM) sistemlerinin, retinal görüntüleme teknolojilerinin ve mobil sağlık uygulamalarının kullanımı hızla yaygınlaşmakta ve analiz edilebilen büyük hacimli heterojen sağlık verileri üretilmektedir11. Bu çeşitli veri toplama araçları; insan vücudu, vücudun bir hastalığın farklı evrelerindeki fonksiyon görme yeteneği, hastanın farklı tedavi türlerine nasıl yanıt verdiği ve gerçek hayattaki davranışları hakkında çeşitli bilgiler sağlayabilir12. Yapay zekanın (AI), oldukça karmaşık verileri işlemek, diyabeti öngörmek, hastalığı izlemek ve doktorlara klinik kararlarda yardımcı olmak için en iyi çözüm olduğu kanıtlanmıştır13. Ayrıca; rastgele ormanlar, destek vektör makineleri ve gradyan artırma yöntemleri dahil olmak üzere makine öğrenimi algoritmaları, diyabet riskinin değerlendirilmesinde mükemmel sonuçlar vermiştir14. Daha yakın zamanlarda, derin öğrenme mimarileri otomatik öznitelik çıkarımına olanak tanımış ve çeşitli sağlık uygulamalarında öngörücü performansı artırmıştır15.
Çok modlu öğrenme yöntemleri kullanılarak; yapılandırılmış klinik kayıtlar, fizyolojik ölçümler, retinal görüntüler ve davranışsal göstergeler tek bir öngörücü çerçevede birleştirilmiş ve böylece diyabet istihbaratı büyük ölçüde geliştirilmiştir16. Çok modlu modeller, birden fazla bilgi kaynağını kullanarak, her bir modülle ayrı ayrı incelendiğinde görünmeyen paternleri tanımlayabilmektedir17. Transformer tabanlı modeller, son zamanlarda çeşitli sağlık hizmetleri verilerinden uzun menzilli bağımlılıkları ve bağlamsal ilişkileri oldukça etkili bir şekilde öğrenmiştir18. Bununla birlikte, dengesiz sınıflar, eksik veriler, veri heterojenliği ve sınırlı genellenebilirlik gibi sorunlar, çok modlu yapay zeka sistemlerinin klinik ortamlarda yaygın olarak kullanımını hâlâ engellemektedir19.
Bu gelişmelere rağmen, mevcut birçok diyabet zekâ sistemi hâlâ, farklı kurumlardan gelen hasta verilerinin tek bir depoda toplanmasını doğal olarak gerektiren merkezi öğrenme çerçevelerine dayanmaktadır20. Bu tür yöntemler; hasta gizliliği, veri gözetimi, siber güvenlik ve düzenleyici uyumluluk konularında halihazırda tartışmalara yol açmaktadır21. Aslında, yasal ve etik mülahazalar nedeniyle, sağlık hizmeti sağlayıcıları hassas hasta verilerini paylaşma kapasiteleri konusunda sıklıkla kısıtlanmaktadır22. Bu bağlamda, gerçek hasta verilerini paylaşmadan ortaklaşa bir modelin eğitilmesine olanak tanıyan federatif öğrenme, uygulanabilir bir çözüm haline gelmektedir23. Federatif öğrenme, merkeziyetsiz optimizasyon ve güvenli parametre toplama yoluyla, coğrafi olarak dağıtılmış veri setlerinden gelen bilgileri kullanarak gizliliği korunan sağlık analizlerini mümkün kılar24. Buna rağmen, iletişim yükü, istemci heterojenliği ve yakınsama stabilitesi, federatif sağlık hizmetleri senaryolarında hâlâ temel sorunlar teşkil etmektedir25.
Halihazırda kullanılan diyabet zeka sistemlerinin bir diğer dezavantajı ise şeffaflık eksikliği ve kişiselleştirilmiş tedavi desteğinin yetersizliğidir. Birçok derin öğrenme modeli "kara kutu" gibi çalışmaktadır; bu durum, tahminlerin ve önerilerin arkasındaki mantığı anlamak isteyen klinisyenler için bir sorun teşkil etmektedir26. SHAP, Entegre Gradyanlar, dikkat görselleştirmesi ve karşı olgusal akıl yürütme gibi açıklanabilir yapay zeka (XAI) yöntemlerinin, model şeffaflığını ve klinisyen güvenini artırmada büyük bir potansiyele sahip olduğu kanıtlanmaktadır27. Buna ek olarak, graf sinir ağları (GNN'ler), hasta-ilaç ve ilaç-ilaç etkileşimlerini yakalamak için en gelişmiş araçlar haline gelmiş; bu da kişiselleştirilmiş ilaç önerileri ve ilaç güvenliği değerlendirmeleri ile sonuçlanmıştır28. Yeni difüzyon modelleri de gerçekçi sentetik sağlık verileri oluşturma ve sınıf dengesizliği sorununu çözme konusunda çözümler sunmuştur29.
Transformerlar, federatif öğrenme, difüzyon tabanlı sentetik veri üretimi, grafik sinir ağları ve açıklanabilir yapay zeka, sağlık uygulamalarında gelecek vadeden sonuçlar sergilemiş olsa da, bunların tek bir tekrarlanabilir diyabet zekası çerçevesinde entegrasyonu hala sınırlıdır. Mevcut yaklaşımlar genellikle bu bileşenleri birbirinden bağımsız olarak ele almakta; kişiselleştirilmiş tedavi önerisi sunmayan gizliliği koruyan öğrenmeye, merkeziyetsiz eğitim içermeyen multimodal tahmine veya grafik tabanlı klinik karar desteği olmayan açıklanabilirliğe odaklanmaktadır. Difüzyon modelleri sınıf dengelemesini destekleyebilse ve transformer mimarileri heterojen sağlık modaliteleri arasındaki ilişkileri öğrenebilse de, bu tamamlayıcı teknolojileri entegre eden standart protokoller hala kısıtlıdır. Bu nedenle, bu çalışma; multimodal tahmin, difüzyon tabanlı artırma, federatif optimizasyon, grafik tabanlı kişiselleştirilmiş ilaç önerisi ve açıklanabilir yapay zekayı tekrarlanabilir bir iş akışında birleştiren ve gelecekteki klinik doğrulama ve uygulamalar için bir temel oluşturan birleştirilmiş bir metodolojik protokol sunmaktadır.
Hasta düzeyinde multimodal veri setlerinin mevcut olduğunu varsayan çalışmaların aksine, bu protokol, doğrudan hasta eşleştirmesi yapmadan heterojen kamuya açık veri setlerini entegre eder. Her bir veri kaynağı için bağımsız modaliteye özgü modeller eğitilir ve latent özellik gömmeleri çapraz modalite dikkat mekanizması aracılığıyla birleştirilir. Bu tasarım, farklı sağlık kuruluşlarının veri depoları genelinde multimodal bilgi entegrasyonuna olanak tanırken metodolojik titizliği de korur.
Önerilen protokol, öncelikle metodolojik geliştirme ve heterojen veri kaynaklarının farklı depolarda veya kurumlarda bulunduğu ve doğrudan veri merkezileştirmenin kısıtlı olduğu dağıtık sağlık yapay zeka ortamları için tasarlanmıştır. Mevcut uygulamada, modaliteye özel veri setleri bağımsızdır ve hasta bazlı eşleştirme yapılmamıştır; bu nedenle, multimodal entegrasyon doğrudan hasta düzeyindeki karşılıklılık yerine öğrenilmiş temsil düzeyinde gerçekleştirilir. Pratik uygulama; uygun şekilde birbirine bağlanmış multimodal hasta verileri, katılımcı merkezler arasında tutarlı ön işleme ve sonuç tanımlamaları, uygun hesaplama altyapısı ile yürürlükteki etik, gizlilik ve düzenleyici gerekliliklere uyum gerektirecektir.
Bu makale; tahmin, öneri ve açıklanabilirlik özelliklerini tek bir çatıda toplayarak gizliliğe önem veren diyabet zekasını mümkün kılan federatif çok modlu transformer çerçevesi FedMediFormer-XAI'yi tanıtmaktadır. Bu çerçeve; sınıf dengesizliğini gidermek için difüzyon tabanlı veri artırımı, diyabet tahmini için çok modlu transformer öğrenimi, iş birlikçi model geliştirme için federatif öğrenme, graf sinir ağı tabanlı kişiselleştirilmiş ilaç önerisi ve klinik kararları şeffaf bir şekilde desteklemek için açıklanabilir yapay zeka yöntemlerini entegre etmektedir. Önerilen FedMediFormer-XAI çerçevesinin genel mimarisi ve iş akışı Şekil 1'de gösterilmiştir.
Önerilen FedMediFormer-XAI çerçevesinin temel katkıları şu şekilde özetlenmiştir: (1) Diyabet zekası için; federatif öğrenme, multimodal transformerlar, difüzyon tabanlı veri artırma, graf sinir ağı tabanlı kişiselleştirilmiş ilaç önerisi ve açıklanabilir yapay zekayı tek bir tekrarlanabilir iş akışında entegre eden birleşik bir protokol sunulmuştur. (2) Ham hasta verilerini paylaşmadan, simüle edilmiş dağıtık sağlık hizmeti istemcileri arasında iş birlikçi model eğitimini mümkün kılmak için gizliliği koruyan bir federatif öğrenme stratejisi geliştirilmiştir. (3) Yapılandırılmış klinik kayıtlar, sürekli glikoz izleme verileri, retinal fundus görüntüleri ve popülasyon sağlığı göstergelerinden tamamlayıcı temsillerin ortaklaşa öğrenilmesi için bir multimodal transformer mimarisi tanıtılmıştır. (4) Orijinal eğitim verilerinin istatistiksel özelliklerini korurken sınıf dengesizliğini azaltmak ve model sağlamlığını artırmak için difüzyon tabanlı sentetik veri üretimi dahil edilmiştir. (5) Kişiselleştirilmiş ilaç önerisi ve etkileşim duyarlı tedavi sıralaması için hasta-ilaç ve ilaç-ilaç ilişkilerini modellemek amacıyla GraphSAGE tabanlı heterojen bir graf öğrenme modülü kullanılmıştır. (6) Model şeffaflığını artırmak ve yorumlanabilir tahmin ile öneri çıktıları sağlamak için SHapley Additive exPlanations (SHAP), Integrated Gradients, dikkat görselleştirme ve karşıolgusal açıklamalar dahil olmak üzere birden fazla açıklanabilir yapay zeka tekniği entegre edilmiştir. (7) Tahmin değerlendirmesi, federatif öğrenme değerlendirmesi, öneri değerlendirmesi, açıklanabilirlik analizi, klinisyen merkezli değerlendirme, harici doğrulama ve tekrarlanabilirlik değerlendirmesini içeren kapsamlı bir doğrulama protokolü sağlanmıştır.
Protokol
Bu çalışmada kullanılan tüm veri setleri, halka açık depolardan elde edilmiş olup kimliksizleştirilmiş hasta bilgileri içermektedir. Bunlar arasında Pima Indians Diabetes Veri Seti, CDC Diyabet Sağlık Göstergeleri Veri Seti, OhioT1DM Veri Seti, APTOS 2019 Körlük Tespiti Veri Seti, İlaç İnceleme Veri Seti ve İlaç-İlaç Etkileşimi Veri Seti yer almaktadır. Çalışma kapsamında doğrudan hasta alımı, müdahale, numune toplama veya tanımlanabilir kişisel sağlık bilgilerine erişim söz konusu olmamıştır. Çalışma, metodolojik geliştirme ve doğrulama amacıyla halka açık, anonimleştirilmiş veri setlerinin ikincil analizi ile sınırlandırılmış ve bu tür verilerin kullanımına ilişkin kurumsal gerekliliklere uygun olarak yürütülmüştür. Bu protokolde açıklanan insan odaklı değerlendirme, gelecekteki uygulama için amaçlanmış olup mevcut çalışmada gerçekleştirilmemiştir. Bu değerlendirmeyi yürütecek araştırmacıların, Kurumsal Etik Kuruldan uygun onayı almaları, tüm katılımcılardan yazılı bilgilendirilmiş onam almaları ve geçerli kurumsal gerekliliklere, veri kullanım sözleşmelerine ve ulusal düzenlemelere uymaları gerekmektedir.
1. Hesaplama ortamını yapılandırın
- Birincil programlama ortamı olarak Python 3.11 kurulumunu yapın. Derin öğrenme model geliştirme ve eğitimi için PyTorch 2.3 ve TensorFlow 2.15 kurulumlarını yapın. Transformer tabanlı mimarileri uygulamak için Transformers kütüphanesini (v4.45) kurun.
- Graf sinir ağı oluşturma ve eğitimini desteklemek için PyTorch Geometric (v2.5) kurulumunu yapın. Açıklanabilirlik ve özellik atama analizleri gerçekleştirmek için SHAP (v0.47) ve Captum (v0.8) kurulumlarını yapın.
- Sayısal hesaplama, veri ön işleme ve makine öğrenimi araçları için NumPy, Pandas ve Scikit-learn kurulumlarını yapın. Görüntü işleme ve görselleştirme görevleri için OpenCV ve Matplotlib kurulumlarını yapın. İlaç etkileşim grafları oluşturmak ve analiz etmek için NetworkX kurulumunu yapın.
- Donanım hızlandırmalı hesaplamayı etkinleştirmek için CUDA Toolkit ve uyumlu NVIDIA GPU sürücülerini kurun. En az 32 GB sistem belleğine sahip bir NVIDIA RTX 4090 GPU yapılandırın. Sonuçların tekrarlanabilirliğini sağlamak için eğitim, doğrulama ve test aşamalarında rastgele tohumu (random seed) 42 olarak ayarlayın. Kullanılan yazılım kütüphanelerinin kurulumlarını ve uyumluluklarını kontrol edin. Analiz için kullanılan yazılım versiyonlarını, donanım özelliklerini ve model konfigürasyon parametrelerini kaydedin.
2. Veri setlerini hazırlama ve ön işleme
- Gerekli klinik, fizyolojik, görüntüleme ve farmakolojik veri setlerini indirin, modaliteye özel depolarda düzenleyin ve bütünlüklerini doğrulayın. Tablo 1 ve 2'de belirtilen veri seti özelliklerini, tahmin hedeflerini ve entegrasyon seviyelerini onaylayın. İş akışı Şekil 2'de gösterilmiştir.
- Yinelenen, geçersiz veya tutarsız kayıtlar ile temel değişkenleri eksik olan kayıtları kaldırın. Uygulanabilir her veri setini; hastadan bağımsız eğitim (%70), doğrulama (%15) ve test (%15) alt kümelerine ayırın. Medyan imputasyon, Min-Max ölçeklendirme ve kategorik kodlamayı yalnızca eğitim alt kümesini kullanarak uyarlayın ve uyarlanan dönüşümleri doğrulama ile test alt kümelerine aynen uygulayın. Sentetik veri üretimini yalnızca eğitim alt kümesi üzerinde gerçekleştirin. Bölümleme ve sızıntı önleme işlemlerini Ek Tablo 1'e uygun olarak doğrulayın.
- Glikoz, gıda alımı, insülin dozu, fiziksel aktivite ve uyku verilerini içe aktarın. Zaman damgalarını standartlaştırın, olayları düzenli aralıklara hizalayın, kaydedilmemiş glikoz değerlerini doğrusal olarak interpole edin, sürekli kayıtları sabit uzunlukta pencerelere bölün ve zamansal transformer girişlerini oluşturmak için z-skoru normalizasyonu uygulayın.
- Retinal fundus görüntülerini yükleyin; bozuk veya okunamaz dosyaları, yinelenenleri, etiketleri eksik olan görüntüleri ve ciddi artefaktlar içeren veya retinal alan görünürlüğü yetersiz olan görüntüleri kaldırın.
- Tutulan görüntüleri 224 × 224 piksel boyutuna yeniden boyutlandırın, piksel yoğunluklarını [0, 1] aralığına normalize edin ve kontrast sınırlı adaptif histogram eşitleme (CLAHE) uygulayın.
- Eğitim görüntülerini; ±15° dahilinde rastgele döndürme, 0.5 olasılıkla yatay çevirme, 0.9–1.1× aralığında rastgele yakınlaştırma ve ±20% dahilinde parlaklık ayarı kullanarak artırın. Doğrulama veya test görüntülerine stokastik artırma uygulamayın. İşlenen görüntüleri Vision Transformer eğitimi için saklayın.
- Modaliteye özel temsilleri, Tablo 2'de özetlenen veri seti entegrasyon stratejisine göre birleştirin. Ortak hasta tanımlayıcılarının mevcut olmadığı durumlarda, bağımsız depolar arasında doğrudan hasta düzeyinde eşleştirme yapmayın.
- Hasta tanımlayıcıları depolar arasında paylaşılmadığı için her halka açık veri setini bağımsız, modaliteye özel bir veri seti olarak saklayın.
- Modaliteye özel özellik çıkarıcılarını ilgili veri setlerini kullanarak bağımsız olarak eğitin: (a) Klinik kayıtlar → TabTransformer kodlayıcı; (b) Popülasyon sağlığı göstergeleri → TabTransformer kodlayıcı; (c) Sürekli glikoz izleme → Zamansal Transformer; (d) Retinal fundus görüntüleri → Vision Transformer; (e) Farmakolojik veriler → GraphSAGE modülü
- Latent özellik gömmelerini (embeddings) her modaliteden bağımsız olarak çıkarın. Ham hasta kayıtlarını birleştirmek yerine, yalnızca öğrenilmiş latent gömmeleri önerilen çapraz modal dikkat füzyon modülü aracılığıyla birleştirin.
- Bağımsız halka açık veri setleri arasında hiçbir yapay hasta eşleştirmesi yapılmadığından emin olun. Ön işleme, artırma ve model geliştirme süreçleri boyunca her veri seti için bağımsız eğitim, doğrulama ve test bölümlerini koruyun.
- Birleştirilmiş multimodal özellik temsillerini; sonraki tahmin, federatif öğrenme, açıklanabilirlik ve kişiselleştirilmiş ilaç önerisi işlemleri için saklayın (Şekil 2).
3. Difüzyon tabanlı veri artırımı gerçekleştirin
- TabDDPM kullanarak yapılandırılmış tabular klinik ve popülasyon sağlığı veri setlerine difüzyon tabanlı artırma uygulayın. Bilgi sızıntısını önlemek için sentetik örnekleri yalnızca ön işlenmiş eğitim bölümünden oluşturun. Modeli şuna göre yapılandırın Ek Tablo 2.
- Adam optimize ediciyi (öğrenme oranı = 1) kullanarak TabDDPM'yi maksimum 500 epok boyunca eğitin. × 10⁻4; grup boyutu = 256). Doğrulama kaybı 20 ardışık epok boyunca en az 0,001 oranında iyileşmezse erken durdurma uygulayın. Yetersiz temsil edilen sınıflar için sentetik örnekler oluşturun.
- Sentetik veri kalitesini; Kolmogorov-Smirnov (KS) istatistikleri, Jensen-Shannon ıraksaması, Wasserstein uzaklığı, öznitelik bazlı korelasyon analizi ve alt süreç sınıflandırma performansı kullanılarak değerlendirin. Orijinal ve sentetik öznitelik dağılımlarını; histogram örtüşmesi, çekirdek yoğunluk kestirimi ve ikili korelasyon katsayılarını kullanarak karşılaştırın.
- Sadece sınıf bazlı öznitelik dağılımları orijinal eğitim verileriyle tutarlı kaldığında sentetik örnekleri kabul edin (KS testi, p > 0,05; Jensen-Shannon ıraksaklığı < 0,10) arasında olmalı ve gerçekçi olmayan klinik değerler içermemelidir. Kabul edilen örnekleri, sınıf dengeli bir veri seti oluşturmak için orijinal eğitim veri setiyle birleştirin. Artırma iş akışı şurada gösterilmiştir: Şekil 3.
- Diyabet tahmin modelini orijinal ve artırılmış eğitim veri setlerini kullanarak yeniden eğitip sentetik verileri doğrulayın. Model genellemesindeki ve dağılımsal yanlılıktaki değişimleri değerlendirmek için Doğruluk (Accuracy), F1-skoru, MCC ve AUC-ROC değerlerini karşılaştırın.
4. Çok modlu transformer modelini geliştirin
Yapılandırılmış klinik veriler, CGM sekansları ve retinal fundus görüntüleri için modaliteye özgü kodlayıcılara sahip multimodal transformeri, şurada gösterildiği gibi yapılandırın Şekil 4. Diyabet tahmini ve grafik tabanlı kişiselleştirilmiş ilaç önerisi için sonuç temsillerini çapraz modal dikkat (cross-modal attention) kullanarak entegre edin.
- Klinik Kodlayıcıyı Geliştirin
- TabTransformer kodlayıcı mimarisini başlatın. Normalize edilmiş klinik değişkenleri ve popülasyon sağlığı göstergelerini girdi olarak verin. Transformer dikkat mekanizmalarını kullanarak bağlamsal özellik temsilleri oluşturun.
- TabTransformer kodlayıcısını 32 yapılandırılmış klinik girdi değişkeni, 128 gömme boyutu, dört transformer katmanı, sekiz dikkat başlığı, 512 ileri besleme boyutu, 0.20 dropout oranı ve Gaussian Error Linear Unit (GELU) aktivasyonu ile konfigüre edin.
- Hasta öznitelikleri arasındaki ilişkileri yakalayan gizli klinik gömmeleri öğrenin. Elde edilen klinik gömmelerini multimodal entegrasyon için saklayın.
- Sürekli Glikoz İzleme Kodlayıcısını Geliştirin
- Temporal transformer kodlayıcıyı başlatın. Sürekli glikoz izleme dizilerini ve fizyolojik ölçümleri sisteme aktarın. Zamansal bağımlılıkları kodlamak için öz-dikkat (self-attention) mekanizmalarını kullanın.
- Temporal transformer'ı 96 zaman adımlı bir dizi uzunluğu, 15 min örnekleme aralığı, 128 gömme boyutu, dört transformer katmanı, sekiz dikkat başlığı, sinüzoidal konum kodlaması ve 0.20 dropout oranı ile konfigüre edin.
- Hastanın glikoz dinamiklerini yansıtan ardışık gömmeler üretin. Zamansal gömmeleri bir sonraki füzyon işlemi için hazır tutun.
- Vision Transformer Kodlayıcısını Geliştirin
- Vision Transformer mimarisini başlatın. Ön işlemeden geçmiş retinal fundus görüntülerini girdi olarak verin. Görüntüleri sabit boyutlu yamalara (patch) bölün.
- Vision Transformer'ı 224 × 224 piksel giriş görüntü çözünürlüğü, 16 × 16 piksel yama boyutu, 768 gömme boyutu, 12 transformer bloğu, 12 dikkat başlığı ve 0.10 dropout oranı ile konfigüre edin.
- Yama düzeyinde özellik temsilleri oluşturun. Retinal patolojileri ve hastalıkla ilişkili biyobelirteçleri belirten görsel özellikleri elde edin. Görüntü gömmelerini multimodal füzyon için saklayın.
- Çapraz Modal Füzyon Gerçekleştirin
- Klinik, CGM ve Vision Transformer kodlayıcılarından gizli temsilleri çıkarın ve her birini, bağımsız doğrusal projeksiyonların ardından Katman Normalizasyonu (Layer Normalization) kullanarak ortak bir 256 boyutlu gizli uzaya yansıtın.
- Yansıtılan modalite tokenlarını birleştirin, öğrenilebilir modalite tipi gömmeleri ekleyin ve klinik, CGM ve retinal temsiller arasında bilgi alışverişini sağlamak için çok başlı çapraz modal dikkati (multi-head cross-modal attention) uygulayın. Dikkat bloğunu sekiz başlık, 256 boyutlu bir model uzayı, 1.024 boyutlu bir ileri besleme katmanı, GELU aktivasyonu, 0.10 dropout, artık bağlantılar (residual connections) ve Katman Normalizasyonu ile konfigüre edin.
- Her bir modaliteye özgü token grubunu ortalama havuzlama (mean-pooling) işleminden geçirin ve sonuç temsillerini birleştirin. Birleştirilmiş 768 boyutlu vektörü 512 boyutlu birleşik bir multimodal temsile yansıtın; dikkat ağırlıklarını ve füzyonlanmış temsilleri sonraki açıklanabilirlik ve ablasyon analizleri için saklayın.
- Birleşik temsili diyabet tahmini ve GraphSAGE tabanlı ilaç öneri modüllerine iletin. Bağımsız veri setleri arasında yapay hasta düzeyinde eşleştirme yapmadan, füzyon boyunca orijinal modaliteye özgü eğitim, doğrulama ve test bölümlerini koruyun.
- Multimodal transformer'ı Ek Tablo 3'te özetlenen model parametrelerine göre konfigüre edin.
5. Federatif öğrenmeyi yapılandırın
- Hasta düzeyinde veri paylaşımı yapmaksızın, coğrafi olarak dağıtılmış sağlık kurumları arasında iş birlikli model eğitimine olanak sağlamak için federatif öğrenme çerçevesini yapılandırın. Her bir katılımcı kurumda, yerel olarak mevcut verileri kullanarak yerel model optimizasyonu gerçekleştirin. Merkezi toplama sunucusuyla yalnızca korumalı model parametrelerini paylaşın. Multimodal modellerin iş birlikli geliştirilmesini sağlarken hasta gizliliğini koruyun.
- Multimodal veri setlerini ayırın ve verilerini paylaşmadan iş birliği yapan farklı sağlık kurumları senaryosunu taklit etmek için bu veri setlerini birden fazla federatif istemciye dağıtın.
- Federasyon öğrenme ağını; 10 katılımcı hastane istemcisi, bir merkezi toplama sunucusu, iletişim turu başına beş yerel epok, 100 iletişim turu, %80 istemci katılım oranı, her iletişim turunda rastgele istemci seçimi ve tur başına minimum sekiz katılımcı istemci olacak şekilde yapılandırın.
- Verilerin yerel ve gizli kalmasını sağlamak amacıyla, her bir istemciye belirli bir kuruma ait bir veri seti verin. Multimodal eğitim verilerini, Dirichlet tabanlı, bağımsız ve özdeş dağılmayan (non-IID) bir strateji kullanarak 10 simüle edilmiş hastane istemcisi arasında paylaştırın. heterojen sınıf dağılımları, demografik kompozisyonlar ve istemci veri seti boyutları oluşturmak için.
- Tekrar üretilebilirliği sağlamak için sabit bir rastgele tohum (random seed) kullanın. Ortaya çıkan istemci düzeyindeki dağılımları doğrulayın ve bu bölümleri federatif eğitim boyunca koruyun. Doğrulama ve test veri kümelerini, istemci bölümlerinden bağımsız tutun.
- Her bir yerel istemciyi, merkezi toplama sunucusundan alınan küresel model parametreleri ile başlatın. Yerel multimodal transformeri, istemcinin yerel eğitim verilerini kullanarak beş epok boyunca eğitin. Yerel modeli, 1 öğrenme oranıyla AdamW optimize ediciyi kullanarak optimize edin. × 10⁻4.
- Yerel eğitimin tamamlanmasının ardından yerel model parametre güncellemelerini hesaplayın. Yerel model parametrelerini, merkezi toplama sunucusuna iletmeden önce korumaya alın. Korunan yerel model parametrelerini, küresel toplama işlemi için merkezi toplama sunucusuna iletin.
- Katılımcı tüm hastane istemcilerinden korumalı model parametrelerini alın. Alınan model güncellemelerinin bütünlüğünü toplama işleminden önce doğrulayın. Yerel model ağırlıklarını Federe Ortalama (FedAvg) algoritmasını kullanarak toplayın. Global multimodal transformeri, toplanmış model parametrelerini kullanarak güncelleyin.
- Güncellenmiş global model parametrelerini katılımcı hastane istemcilerine yeniden dağıtın. Yerel eğitim ve global agregasyon prosedürlerini, 100 iletişim turu tamamlanana veya önceden tanımlanmış yakınsama kriteri karşılanana kadar tekrarlayın.
- İletilen model parametrelerini, belirtilen güvenli toplama mekanizması ve AES-256 şifreleme kullanarak koruyun. Katılımcı istemcileri dijital sertifikalar aracılığıyla kimliklendirin.
- Transport Layer Security (TLS) 1.3 kullanarak şifreli iletişim kanalları oluşturun. Her iletişim turunun tamamlanmasının ardından yalnızca agrege edilmiş global model parametrelerini tutun.
- Ham veri ifşası, yetkisiz paylaşım, üyelik çıkarımı ve model tersine çevirme değerlendirmeleri kullanılarak gizlilik ve güvenlik değerlendirmesi yapın. Üyelik çıkarımı için, saldırı AUC-ROC değerini rastgele referans değeriyle (0,50) karşılaştırın; tersine çevirme işlemini, retinal görüntüler için yapısal benzerlik indeksi ölçümü (SSIM) ve tepe sinyal-gürültü oranı (PSNR), sayısal özellikler için ise normalize edilmiş yeniden yapılandırma hatası kullanarak değerlendirin.
- Sunucunun, birleştirilmemiş bireysel istemci güncellemelerine erişemediğini doğrulayarak güvenli toplama işlemini teyit edin. AES-256/TLS 1.3 korumasını doğrulayın ve şifrelenmemiş model güncelleme iletimlerinin gerçekleşmediğinden emin olun.
- Uygun olan durumlarda federasyonel ve merkezi yapılandırmalar arasındaki gizlilik metriklerini karşılaştırın ve şunlarda belirtilen metrikleri raporlayın Ek Tablo 4.
- Yerel transformer eğitiminin hesaplama karmaşıklığını O(N şeklinde tahmin edin × L × d2), burada N örnek sayısını, L transformer katmanlarının sayısını ve d gömme boyutunu temsil etmektedir.
- Federasyonel toplamanın hesaplama karmaşıklığını O(K olarak tahmin edin × P) iletişim turu başına; burada K katılan istemci sayısını ve P eğitilebilir model parametrelerinin sayısını temsil eder.
- Her bir iletişim turu sırasında, yalnızca korumalı model parametrelerini katılımcı istemciler ve merkezi toplama sunucusu arasında paylaşın. İletişim yükünü; model boyutu, katılımcı istemci sayısı ve iletişim turu sayısına göre hesaplayın.
- Parametre değişim yükünü, karşılık gelen multimodal sağlık veri setlerinin aktarma tahmini maliyetiyle karşılaştırın. Federasyon öğrenme çerçevesini, şurada özetlenen parametrelere göre yapılandırın: Ek Tablo 4. Federasyon öğrenimi iş akışı ve parametre toplama süreci şurada gösterilmektedir: Şekil 5.
6. Kişiselleştirilmiş ilaç öneri modülünü oluşturun
- Farmakolojik, ilaç, hasta tedavisi ve ilaç etkileşim verilerini hesaplama ortamına aktarın. Hasta, ilaç, hastalık, laboratuvar testi ve klinik risk faktörü düğümlerini içeren heterojen bir sağlık hizmetleri grafiği oluşturun.
- Hasta-hastalık, hasta-ilaç, hastalık-ilaç, ilaç-ilaç etkileşimi ve hasta-laboratuvar ilişkilerini graf kenarları olarak tanımlayın. Model eğitiminden önce grafik yapısını doğrulayın; yinelenen, geçersiz veya bağlantısız ilişkileri kaldırın.
- Hasta düğümlerini yaş, cinsiyet, vücut kitle indeksi (BMI), HbA1c, kan glukozu, kan basıncı ve diyabet süresi kullanarak temsil edin. İlaç düğümlerini ilaç sınıfı, etki mekanizması, dozaj, uygulama sıklığı ve bilinen advers etkiler kullanarak temsil edin.
- Hastalık düğümlerini hastalık şiddeti, hastalık evresi ve ilişkili komplikasyonlar kullanarak temsil edin. GraphSAGE eğitiminden önce kategorik öznitelikleri kodlayın ve sürekli düğüm özelliklerini normalize edin.
- Ön işlenmiş düğüm özelliklerini kullanarak düğüm gömmelerini (node embeddings) başlatın. Komşuluk toplama sırasında her hedef düğüm için 25'e kadar komşu düğüm örnekleyin. Komşu düğüm temsillerini ortalama toplama (mean aggregation) kullanarak birleştirin. Hedef düğüm gömmelerini, toplanmış komşuluk temsillerini kullanarak güncelleyin.
- Her GraphSAGE katmanından sonra düzeltilmiş doğrusal birim (ReLU) aktivasyon fonksiyonunu uygulayın. Ortaya çıkan düğüm gömmelerini normalize edin. Komşuluk toplama prosedürünü üç GraphSAGE katmanı boyunca tekrarlayın.
- GraphSAGE modelini 256 gizli boyut, 128 gömme boyutu, üç GraphSAGE katmanı, 25 komşu örnekleme boyutu, 0.30 dropout oranı, 1 × 10⁻4 öğrenme hızı, 512 grup boyutu (batch size) ve maksimum 100 eğitim epoku ile yapılandırın. Modeli Adam optimize edici kullanarak optimize edin.
- Eğitilmiş GraphSAGE modelinden hastaya özgü gömme değerini hesaplayın. Aday ilaçlar için gömmeleri hesaplayın. Hasta temsili ile aday ilaç temsilleri arasındaki uygunluk puanlarını hesaplayın. Aday ilaçları, tahmin edilen uygunluk puanlarına göre sıralayın.
- Mevcut ilaç-ilaç etkileşim bilgilerini kullanarak kontrendike veya potansiyel olarak güvensiz ilaçları belirleyin ve kaldırın. En yüksek puana sahip uygun beş ilacı, kişiselleştirilmiş İlk-5 önerisi olarak döndürün.
- Öneri modelini Bayesian Kişiselleştirilmiş Sıralama (BPR) kaybı kullanarak eğitin. Klinik olarak uygun ilaçlara, daha az uygun aday ilaçlardan daha yüksek puanlar atamak için sıralama hedefini optimize edin.
- Her ilaç önerisine katkıda bulunan etkili komşu düğümleri ve klinik olarak ilgili grafik ilişkilerini belirleyin. Öneriye katkıda bulunan hasta, hastalık, laboratuvar ve ilaçla ilgili özellikler için öznitelik atama puanlarını hesaplayın.
- Her kişiselleştirilmiş ilaç önerisine katkıda bulunan ilişkileri gösteren görsel grafik tabanlı açıklamalar oluşturun. GraphSAGE öneri modelini Ek Tablo 5'te özetlenen parametrelere göre yapılandırın. Grafik tabanlı kişiselleştirilmiş ilaç öneri iş akışı Şekil 6'da gösterilmiştir.
7. Açıklanabilirlik değerlendirmesini gerçekleştirin
- SHAP analizini gerçekleştirin
- Eğitilmiş multimodal transformeri ve ayrılmış test veri setini hesaplama ortamına yükleyin.
- Eğitilmiş tahmin modelini ve, diyabet sonuç sınıfına göre tabakalı rastgele örnekleme kullanılarak yalnızca eğitim veri setinden seçilen 100 eğitim örneğinden oluşan bir arka plan örneğini kullanarak SHAP açıklayıcısını başlatın. Arka plan örneğinde, tüm eğitim bölümünün yaklaşık sınıf dağılımını koruyun ve tekrarlanabilir örnek seçimini sağlamak için 42 sabit rastgele tohumu (seed) kullanın. Seçilen test örnekleri için SHAP değerlerini hesaplayın.
- Mutlak SHAP değerlerinden küresel özellik önemini hesaplayın, küresel ve yerel SHAP görselleştirmeleri oluşturun ve hesaplanan değerleri sonraki nicel ve istatistiksel analizler için saklayın.
- Entegre gradyanlar analizini gerçekleştirin
- Ayrılmış test veri setinden temsilci, doğru sınıflandırılmış ve yanlış sınıflandırılmış örnekler seçin. Entegre Gradyanları hesaplamadan önce modaliteye özgü temel girişleri tanımlayın. Normalleştirilmiş klinik ve CGM sayısal özellikleri için, sıfır normalleştirilmiş özellik katkısını temsil eden bir sıfır temel çizgisi (zero baseline) kullanın ve normalleştirilmiş retinal-görüntü girişi için sıfır değerli bir temel görüntü kullanın.
- Temel çizgi ile orijinal giriş arasında 100 interpolasyon adımı kullanarak Entegre Gradyan atama skorlarını hesaplayın. Özellikler ve modaliteler arasında karşılaştırma yapabilmek için sonuçtaki atama skorlarını normalleştirin. Bireysel model tahminlerine katkıda bulunan etkili klinik, zamansal ve görüntüleme özelliklerini belirlemek için atama görselleştirmeleri oluşturun.
- Dikkat görselleştirmesini gerçekleştirin
- Temsili test örnekleri için eğitilmiş transformer katmanlarından dikkat matrislerini çıkarın. Karşılık gelen dikkat başları (attention heads) genelinde ortalama dikkat ağırlıklarını hesaplayın. Klinik, zamansal ve retinal görüntüleme temsilleri arasındaki çapraz modalite etkileşimlerini görselleştirmek için dikkat ısı haritaları oluşturun. Tahmin sırasında yüksek dikkat ağırlıkları alan baskın klinik, zamansal ve retinal özellikleri belirleyin.
- Rastgele seçilen ayrılmış bir test örneği için eğitilmiş multimodal transformerdan dikkat ağırlıklarını çıkarın ve karşılık gelen klinik-özellik, CGM zamansal, retinal uzamsal ve çapraz modalite dikkat dağılımlarını görselleştirin.
- Karşıolgusal açıklamalar oluşturun
- Ayrılmış test veri setinden temsilci hasta kayıtları seçin. Karşıolgusal örnekler oluşturmadan önce, değiştirilebilir hasta özellikleri için klinik olarak izin verilen aralıkları ve kısıtlamaları tanımlayın. Sürekli özellikleri gözlemlenen eğitim verisi aralığıyla ve kategorik özellikleri eğitim verilerinde gözlemlenen geçerli kategorilerle sınırlandırın. Yaş ve cinsiyet dahil olmak üzere değiştirilemez demografik özellikleri değiştirmeyin.
- Önceden tanımlanmış klinik ve özellik alanı kısıtlamalarını koruyarak, yalnızca izin verilen değiştirilebilir özellikleri minimum düzeyde modifiye ederek karşıolgusal örnekler oluşturun. Gözlemlenen eğitim verisi aralığının dışındaki değerleri, geçersiz kategorik durumları veya değiştirilemez özelliklerdeki modifikasyonları içeren karşıolgusalları reddedin. Tahmin edilen sonucu değiştirmek için gereken klinik olarak makul en küçük özellik modifikasyonlarını belirleyin.
- Modifiye edilen özellikleri, orijinal değerleri, karşıolgusal değerleri ve model tahminlerindeki karşılık gelen değişiklikleri raporlayın. Açıklanabilirlik değerlendirme iş akışı Şekil 7'de gösterilmiş olup, temsili dikkat görselleştirme ve karşıolgusal açıklama çıktıları Ek Şekil 1'de sunulmuştur.
- Açıklama kalitesini değerlendirin
- Oluşturulan açıklamalar ile tahmin modelinin davranışı arasındaki uyumu nicelleştirmek için sadakati (fidelity) hesaplayın. Küçük giriş pertürbasyonları altında tekrar tekrar açıklamalar oluşturup sonuçtaki atama modellerini karşılaştırarak kararlılığı (stability) hesaplayın. Klinik olarak benzer test örnekleri için oluşturulan açıklamaları karşılaştırarak tutarlılığı değerlendirin.
- Her bir açıklamaya önemli ölçüde katkıda bulunan özelliklerin sayısını veya oranını belirleyerek seyrekliği (sparsity) hesaplayın. Atanan özelliklerin karşılık gelen model çıktısını yeterince açıklayıp açıklamadığını belirlemek için tamlığı değerlendirin. Giriş özelliklerinin kontrollü pertürbasyonlarını takiben atama skorlarındaki değişiklikleri ölçerek hassasiyeti değerlendirin.
- Özellik atamaları ile model tahminlerindeki gözlemlenen değişiklikler arasındaki uyumsuzluğu nicelleştirmek için sadakatsizliği (infidelity) hesaplayın. Sonraki istatistiksel analizler için tüm nicel açıklanabilirlik metriklerini kaydedin.
- Prospektif klinisyen doğrulamasını gerçekleştirin
- Gelecekteki prospektif klinik doğrulama için, klinik uzmanları işe almadan önce ilgili Kurumsal Etik Kuruldan onay alın. Etik onay alındıktan sonra; altı endokrinolog, üç diyabet uzmanı ve üç klinik farmakologdan oluşan 12 klinisyen belirleyin ve değerlendirmeye başlamadan önce tüm katılımcılardan bilgilendirilmiş onam alın.
- Klinisyen değerlendirmesi için temsilci model tahminlerini ve bunlara karşılık gelen açıklamaları rastgele seçin. Seçilen açıklamaları, standart bir değerlendirme formatı kullanarak her bir katılımcı klinisyene bağımsız olarak sunun.
- Her klinisyenden, açıklamanın yararlılığını, klinik ilgisini, yorumlanabilirliğini ve güvenilirliğini beşli Likert ölçeği kullanarak değerlendirmesini isteyin. Anonimleştirilmiş klinisyen puanlarını kaydedin ve Adım 7.7'de belirtildiği şekilde değerlendiriciler arası uyumu ve karşılık gelen istatistiksel ölçümleri hesaplayın.
- İstatistiksel analiz gerçekleştirin
- İstatistiksel karşılaştırma testini seçmeden önce nicel değerlendirme puanlarının dağılımını değerlendirin. Uygun şekilde, normal dağılımlı eşleştirilmiş ölçümler için eşleştirilmiş t-testi veya normal dağılımlı olmayan eşleştirilmiş ölçümler için Wilcoxon işaretli sıralama testini uygulayın.
- Katılımcı klinisyenler arasındaki değerlendirici uyumunu nicelleştirmek için Fleiss' kappa değerini hesaplayın. Temel açıklanabilirlik ve klinisyen değerlendirme metrikleri için %95 güven aralıklarını hesaplayın. İstatistiksel anlamlılık eşiğini p < 0.05 olarak belirleyin.
- Hesaplanan test istatistiklerini, güven aralıklarını ve p-değerlerini karşılık gelen değerlendirme sonuçlarıyla birlikte raporlayın. Açıklanabilirlik metriklerini Ek Tablo 6'da özetlenen kriterlere göre değerlendirin ve raporlayın.
8. Model performansını değerlendirin
- FedMediFormer-XAI'ı; doğruluk, kesinlik, duyarlılık, F1-skoru, MCC ve AUC-ROC kullanarak Lojistik Regresyon, Random Forest, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer ve merkezi çok modlu transformer ile karşılaştırın.
- Önerilen çerçeveyle tutarlı bir karşılaştırma sağlamak için her bir temel değerlendirmeyi aynı önceden tanımlanmış eğitim, doğrulama ve test stratejisini kullanarak gerçekleştirin.
- Model değerlendirmesini bağımsız deneysel çalışmalar boyunca tekrarlayın ve her çalışmada elde edilen performans metriklerini kaydedin. Doğruluk, Kesinlik, Duyarlılık, F1-skoru, MCC ve AUC-ROC için ortalama, standart sapma (SD) ve %95 güven aralığını (CI) hesaplayın. Performans sonuçlarını ortalama ± SD ve ilgili %95 CI ile birlikte raporlayın.
- FedMediFormer-XAI ile her bir temel model arasındaki eşleştirilmiş performans farklarının normalliğini değerlendirin. Normal dağılan eşleştirilmiş ölçümlere eşleştirilmiş t-testini, normal dağılmayan eşleştirilmiş ölçümlere ise Wilcoxon işaretli sıra testini uygulayın. İstatistiksel anlamlılık eşiğini p < 0.05 olarak belirleyin.
- Gözlemlenen performans farklarının istatistiksel anlamlılığını ve belirsizliğini nicelleştirmek için ilgili test istatistiklerini, p-değerlerini ve %95 güven aralıklarını raporlayın.
- Modeller nihai olarak yakınsayana kadar tüm iletişim turlarının sayısını belirleyin. Federatif eğitim sırasında küresel modelin performansını izleyin. Yakınsamanın iletişim turları boyunca zamanla nasıl değiştiğini inceleyin.
- Parametre agregasyonunun ne kadar iyi çalıştığını kontrol edin. Desantralize öğrenmenin kestirim performansını nasıl etkilediğini inceleyin. Federatif öğrenme ile merkezi öğrenme sonuçları arasında bir karşılaştırma yapın.
- İletişim turları boyunca federatif yakınsamayı değerlendirin ve federatif ile merkezi kestirim performanslarını karşılaştırın. İlaç önerilerini Precision@5, Recall@5 ve NDCG@5 kullanarak değerlendirin.
- İlgili hasta için pozitif hasta-ilaç etkileşimleri olarak gözlemlenmeyen ilaçları, uygun aday ilaç havuzundan seçerek negatif örnekler-ilaç örnekleri oluşturun. Tüm bilinen pozitif etkileşimleri ve tüm kontrendike ilaçları negatif örnekleme havuzundan çıkarın. Öneri eğitimi için 1:1 oranında sabit bir negatif-pozitif örnekleme oranı koruyun ve tekrarlanabilir negatif örnek seçimi için 42 değerinde sabit bir rastgele tohum (seed) kullanın.
- Her hasta için ilgili öğe kümesini yalnızca ayrılmış değerlendirme verilerinden oluşturun. Hasta u için ilgili öğe kümesi Ru'yu, ayrılmış gerçek değer kayıtlarında pozitif hasta-ilaç kriterlerini karşılayan ilaçlar kümesi olarak tanımlayın. Ru'yu oluşturmak için model tahminlerini kullanmayın. Sıralamadan önce kontrendike ilaçları aday öneri kümesinden çıkarın.
- Her değerlendirme hastası için en yüksek sıralamaya sahip beş uygun ilacı belirleyin. Precision@5'i, önerilen beş ilacın hastanın ilgili öğe kümesi Ru'ya ait olanların oranı olarak hesaplayın. Recall@5'i, hastanın ilgili ilaçlarının beş öneri arasında geri getirilenlerin oranı olarak hesaplayın. Önerilen ilaçların derecelendirilmiş ilgisini kullanarak, klinik olarak uygun ilaçlara daha yüksek ilgi ve ilgisiz ilaçlara sıfır ilgi atayarak NDCG@5'i hesaplayın. Metrikleri tüm değerlendirme hastaları genelinde toplayın ve ortalama Precision@5, Recall@5 ve NDCG@5 değerlerini raporlayın.
- Model değerlendirmesinden önce öneri gerçek değerini (ground truth) oluşturun ve ayrılmış hasta-ilaç etkileşimlerini öneri eğitim verilerinden ayrı tutun. GraphSAGE eğitimi, negatif örnekleme veya aday sıralaması sırasında test seti ilaç etkileşimlerini, test seti etiketlerini veya gelecekteki tedavi bilgilerini kullanmayın.
- Açıklamaların model davranışıyla ne kadar iyi eşleştiğini kontrol etmek için Sadakati (Fidelity) ölçün. Birden fazla inceleme yoluyla açıklamanın kararlılığını değerlendirin. Anlaşılabilirliği (Comprehensibility), doktor odaklı kriterlere göre yargılayın.
- Açıklamaların farklı veri türleri genelinde ne kadar tutarlı olduğunu araştırın. Üretilen açıklamaların klinik değerini doğrulayın. Çalışma boyunca kullanılan değerlendirme metrikleri Ek Tablo 7'de özetlenmiştir.
9. Prospektif klinisyen validasyonunu gerçekleştirin
- Adım 7.6–7.8'de açıklanan katılımcı toplama, değerlendirme, veri toplama ve istatistiksel analiz prosedürlerini izleyerek, uygun etik onay ve bilgilendirilmiş onam alındıktan sonra prospektif klinisyen doğrulaması gerçekleştirin. Katılımcı kompozisyonu, değerlendirme kriterleri, karşılaştırma koşulları ve planlanan istatistiksel analizleri içeren prospektif klinisyen doğrulama deseni, Ek Tablo 8'de özetlenmiştir.
10. Validasyon ve tekrarlanabilirlik değerlendirmesini gerçekleştirin
- Aynı veri seti bölümlerini, ön işleme prosedürlerini, eğitim ayarlarını ve değerlendirme kriterlerini koruyarak, tam FedMediFormer-XAI çerçevesinden bireysel bileşenleri sistematik olarak çıkarıp ablasyon çalışmaları yürütün. Tam modeli ve difüzyon artırımı, federasyon öğrenmesi, GraphSAGE tabanlı ilaç önerisi ve multimodal füzyon olmayan konfigürasyonları değerlendirin.
- Ablasyon konfigürasyonlarını; Doğruluk, Keskinlik, Duyarlılık, F1-skoru, MCC ve AUC-ROC kullanarak tam FedMediFormer-XAI çerçevesi ile karşılaştırın. Her bir çerçeve bileşeninin katkısını belirlemek için her bir performans metriğindeki değişimi nicel olarak belirleyin. Genellenebilirliği değerlendirmek amacıyla doğrulama sonuçlarını dahili test sonuçlarıyla karşılaştırın. Gözlemlenen performans farklarının güvenilirliğini belirlemek için istatistiksel anlamlılık testi gerçekleştirin.
- Uyumlu girdi değişkenleri ve sonuç tanımlarına sahip bağımsız bir dış veri seti mevcut olduğunda, çerçevenin genellenebilirliğini değerlendirin. Dahili test veri seti için kullanılan ön işleme ve değerlendirme prosedürlerini uygulayın ve elde edilen performans metriklerini dahili test sonuçlarıyla karşılaştırın.
- Tekrarlanan deneysel çalışmalar genelinde istatistiksel anlamlılık analizi gerçekleştirin. İstatistiksel testlerden önce, eşleştirilmiş performans farklarının normalliğini değerlendirin. Normal dağılım gösteren eşleştirilmiş ölçümler için eşleştirilmiş t-testini, normal dağılım göstermeyen eşleştirilmiş ölçümler için ise Wilcoxon işaretli sıralar testini uygulayın. İstatistiksel anlamlılık eşiğini p olarak belirleyin. < 0.05.
- Doğruluk (Accuracy), Kesinlik (Precision), Duyarlılık (Recall), F1-skoru, MCC ve AUC-ROC için ortalamayı ve %95 güven aralığını hesaplayın. Temel model karşılaştırmaları için ilgili test istatistiklerini, p-değerlerini ve güven aralıklarını raporlayın. Raporlanan deneylerin tekrarlanabilmesi için gerekli olan tüm model parametrelerini, ön işleme prosedürlerini, eğitim konfigürasyonlarını ve değerlendirme protokollerini belgeleyin.
- Raporlanan deneylerde kullanılan kaynak kodu, yapılandırma dosyaları, değerlendirme betikleri ve eğitilmiş model spesifikasyonlarını muhafaza edin. Model eğitimine, deneysel ayarlara, rastgele tohumlara (random seeds) ve değerlendirme sonuçlarına ilişkin ayrıntılı kayıtlar tutun.
- Mevcut tekrarlanabilirlik materyallerinin eksiksizliğini ve tutarlılığını doğrulayın. Belgelenen yöntem ve materyallerin, deneysel iş akışının bağımsız olarak tekrarlanması için yeterli bilgi sağladığından emin olun.
- Çalışmada kullanılan tekrarlanabilirlik kaynaklarını ve doğrulama prosedürlerini özetleyin Ek Tablo 9Ana çerçeve bileşenlerinin katkısını değerlendirmek için kullanılan ablasyon çalışması prosedürünü ve değerlendirme kriterlerini belgeleyin.
Sonuçlar
Öngörücü performans analizi
FedMediFormer-XAI, değerlendirilen tek modlu ve geleneksel temel modellerle karşılaştırıldığında geliştirilmiş bir öngörücü performans sergilemiştir. Difüzyon tabanlı veri artırma, azınlık sınıf temsilini iyileştirmiş ve bunun sonucunda ortaya çıkan öngörücü performans Tablo 3'te özetlenmiştir. Tekrarlanan çalıştırma değerlendirmesi, değerlendirilen modeller genelinde istikrarlı bir öngörücü performans olduğunu göstermiştir. FedMediFormer-XAI; %94,20 ± 0,34 (%95 CI: 93,78–94,62) doğruluk, %93,10 ± 0,30 (%95 CI: 92,73–93,47) kesinlik, %92,80 ± 0,28 (%95 CI: 92,45–93,15) duyarlılık ve %92,90 ± 0,28 (%95 CI: 92,55–93,25) F1-skoru ile en yüksek genel performansı elde etmiştir. Model, 0,88 ± 0,02 (%95 CI: 0,86–0,90) MCC ve 0,96 ± 0,01 (%95 CI: 0,95–0,97) AUC-ROC değerlerine ulaşmıştır. Merkezi çok modlu transformatör bir sonraki en iyi genel performansı sunarken, tek modlu ve geleneksel makine öğrenimi modelleri karşılaştırmalı olarak daha düşük öngörücü performans göstermiştir. Bu sonuçlar, federatif optimizasyonla birleştirilmiş çok modlu temsil öğreniminin, geliştirilmiş ve daha istikrarlı bir diyabet sınıflandırma performansı sağladığını göstermektedir.
Ablasyon çalışması
Difüzyon artırımının, federasyon öğreniminin, GraphSAGE tabanlı ilaç önerisinin ve multimodal füzyonun katkısını değerlendirmek için bileşen bazlı ablasyon kullanılmıştır. Eksiksiz FedMediFormer-XAI çerçevesi, beş bağımsız çalıştırma genelinde %94,20 ± 0,34 doğruluk, %93,10 ± 0,30 kesinlik, %92,80 ± 0,28 duyarlılık, %92,90 ± 0,28 F1-skoru, 0,88 ± 0,02 MCC ve 0,96 ± 0,01 AUC-ROC değerleri elde etmiştir. Difüzyon artırımının çıkarılması, doğruluğu %91,80 ± 0,42'ye düşürerek 2,40 yüzdelik puanlık bir azalmaya yol açarken; F1-skoru ve AUC-ROC sırasıyla %90,30 ± 0,38 ve 0,94 ± 0,01'e gerilemiştir. Bu azalma, difüzyon tabanlı artırımın azınlık sınıf temsiline ve öngörücü sağlamlığa olan katkısını göstermektedir.
Federatif öğrenmenin çıkarılması %93,10 ± 0,37'lik bir doğruluk oranı ile sonuçlanmış olup, bu durum tam çerçeveye kıyasla 1,10 yüzdelik puanlık bir azalmayı temsil etmektedir. Hassasiyet, geri çağırma, F1-skoru, MCC ve AUC-ROC değerleri de sırasıyla %92,20 ± 0,34, %91,80 ± 0,32, %92,00 ± 0,33, 0,86 ± 0,02 ve 0,95 ± 0,01'e düşmüştür. Bu karşılaştırma, federatif konfigürasyonun öngörücü performans üzerindeki katkısını ortaya koymaktadır.
GraphSAGE tabanlı kişiselleştirilmiş ilaç öneri bileşeninin çıkarılması, diyabet tahmin performansında karşılaştırmalı olarak küçük bir değişikliğe yol açmış; doğruluk %93,80 ± 0,35'e ve F1-skoru %92,60 ± 0,30'a düşmüştür. Karşılık gelen MCC ve AUC-ROC değerleri sırasıyla 0,87 ± 0,02 ve 0,96 ± 0,01 olmuştur. Bu sonuç, GraphSAGE'in doğrudan diyabet sınıflandırma performansını belirlemekten ziyade, öncelikle kişiselleştirilmiş ilaç önerisine katkıda bulunduğunu göstermektedir.
En büyük azalma, multimodal füzyon kaldırıldığında gözlemlenmiştir. Doğruluk %87,60 ± 0,55'e düşerek 6,60 yüzdelik puanlık bir azalma göstermiştir; kesinlik, duyarlılık, F1-skoru, MCC ve AUC-ROC ise sırasıyla %86,80 ± 0,51, %85,90 ± 0,54, %86,30 ± 0,52, 0,76 ± 0,03 ve 0,91 ± 0,01'e gerilemiştir. Bu bulgu, klinik, CGM ve retinal modalitelerden gelen tamamlayıcı bilgilerin birlikte modellenmesinin önemini ortaya koymaktadır.
Federasyon öğrenme analizi
Federasyon öğrenme çerçevesi, ham hasta verilerinin merkezsiz yönetimini sürdürürken dağıtık istemciler arasında iş birlikli model eğitimine olanak sağlamıştır. Eğitim sırasında, her istemcinin yerel modeli ayrı ayrı optimize edilmiş ve Federasyon Ortalama yöntemiyle birleştirilmiştir. 100 iletişim turunun ardından global model yakınsamış ve öngörücü performansı merkezileştirilmiş öğrenme ile tutarlı kalmıştır. Federasyon öğrenme çerçevesi, heterojen istemci veri dağılımlarına rağmen iletişim turları boyunca kararlı bir yakınsama göstermiştir. Korumalı parametre değişimi, merkezsiz veri yönetimini korurken; global model, merkezileştirilmiş temel modele kıyasla rekabetçi bir öngörücü performans sürdürmüştür. Tablo 4 merkezileştirilmiş ve federasyon uygulamalarını karşılaştırmaktadır. Federasyon öğrenme, iletişim yükü nedeniyle ek eğitim süresi gerektirmiş, ancak merkezileştirilmiş öğrenme ile kıyaslanabilir bir öngörücü performans sergilemiştir.
Veri Seti Düzeyinde Performans Analizi
Farklı sağlık hizmetleri modaliteleri arasındaki genellenebilirliği değerlendirmek için, her bir veri setindeki performansı ayrı ayrı inceledik. Multimodal FedMediFormer-XAI modeli, değerlendirilen veri setleri genelinde güçlü ve genellikle rekabetçi bir performans sergilemiştir. Model; Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM ve APTOS 2019 veri setlerinde sırasıyla %91,8, %93,1, %92,4 ve %94,2 doğruluk oranlarına ulaşmıştır. APTOS 2019 veri seti, multimodal modele göre biraz daha yüksek doğruluk (%94,7) ve kesinlik (%93,9) değerleri elde etmiş olsa da, önerilen multimodal yaklaşım tüm veri setleri genelinde rekabetçi performansını korumuş ve en yüksek veri seti düzeyindeki AUC-ROC değeriyle kıyaslanabilir şekilde 0,96'lık bir AUC-ROC elde etmiştir. Veri seti düzeyindeki genel sonuçlar Tablo 5'te sunulmuştur. Tekil veri setleri için, tek başına kullanıldığında retina görüntü analizi en iyi performansı sergilerken, multimodal füzyon en stabil ve dengeli tahminleri sağlamıştır.
Kişiselleştirilmiş ilaç öneri analizi
Graf sinir ağı tabanlı öneri bileşeni, ilaç etkinliği bilgileri ve ilaç etkileşim verileri kullanılarak değerlendirilmiş; aday ilaçlar, öğrenilen hasta-ilaç uygunluk skorlarına göre sıralanmış ve öneri oluşturma sırasında kontrendike kombinasyonlar hariç tutulmuştur. Heterojen graf formatının kullanımı ve hasta-ilaç ile ilaç-ilaç etkileşimlerinin modellenmesi kapsamlı bir şekilde gerçekleştirilmiş, böylece kişiselleştirilmiş ilaç seçimleri ve güvenlik değerlendirmesi desteklenmiştir. GraphSAGE öneri modeli; hastalar, hastalıklar, laboratuvar bulguları ve ilaçlar arasındaki karmaşık ilişkileri etkili bir şekilde yakalamıştır. Kişiselleştirilmiş öneriler, graf komşuluk analizi ve özellik atama yoluyla klinik olarak anlamlı açıklamaları korurken yüksek sıralama performansı göstermiştir.
Tablo 6'ya göre, kişiselleştirilmiş ilaç öneri modülü Precision@5, Recall@5 ve NDCG@5 kullanılarak değerlendirilmiştir. Bu metrikler, GraphSAGE tabanlı öneri modülü tarafından üretilen ilk beş kişiselleştirilmiş ilaç önerisinin ilgililik düzeyini ve sıralama kalitesini nicelendirir. Öneri sistemi; precision = 0,89, recall = 0,84 ve NDCG = 0,91 değerleri ile güçlü bir sıralama performansı sergilemiştir.
Açıklanabilirlik analizi
Çerçeve, multimodal tahminlerin yorumlanmasını desteklemek için SHAP, Integrated Gradients, dikkat görselleştirmesi ve karşıolgusal açıklamaları içermektedir. Öznitelik düzeyindeki katkıları nicelleştirmek için SHAP, tahminleri girdi özniteliklerine atamak için Integrated Gradients, modaliteler arası model odağını incelemek için dikkat görselleştirmesi ve alternatif tahminlerle ilişkili öznitelik değişikliklerini belirlemek için karşıolgusal açıklamalar kullanılmıştır. Şekil 8, eğitilmiş FedMediFormer-XAI modelinden üretilen temsili bir model kaynaklı SHAP özet grafiğini sunarken, Şekil 9 eğitilmiş transformerdan çıkarılan temsili dikkat görselleştirmelerini sunmaktadır. Bu şekiller, önerilen mimarinin şematik çizimleri değil, model değerlendirmesinden elde edilen çıktıları temsil etmektedir.
Şekil 8'de, özellik öneminin toplu düzeydeki sıralamaları sunulmuştur. Daha yüksek mutlak SHAP değerlerine sahip özellikler, model tahminleri üzerinde daha büyük bir etkiye sahip olmuş ve mevcut klinik bilgilerle de iyi bir şekilde örtüşmüştür.
Şekil 9, rastgele seçilmiş bir dışarıda tutulan test örneği için eğitilmiş FedMediFormer-XAI modelinden doğrudan elde edilen temsili dikkat görselleştirmelerini sunmaktadır. Görselleştirmeler klinik özellik dikkati, CGM zamansal dikkati, retinal uzamsal dikkat ve üç modalite arasındaki çapraz modalite dikkatini içermektedir. Dikkat görselleştirmesi, modelin birden fazla modalite boyunca öğrendiği dikkat tahsisini daha detaylı bir şekilde göstermiştir. Seçilen örnek, klinik özellikler arasında HbA1c, diyabet süresi ve yaşa nispeten daha yakın bir dikkat göstermiş, CGM dikkat haritası ise belirgin glukoz değişkenliğine sahip birkaç dönemi vurgulamıştır. Retinal dikkat haritası, model temsiline katkıda bulunan spesifik görüntü bölgelerini tanımlamış ve çapraz modalite dikkat matrisi hem modalite içi hem de çapraz modalite dikkat modellerini ortaya koymuştur. Şekil 9'da gösterildiği gibi, modelden türetilen temsili dikkat haritaları, dışarıda tutulan bir test örneğindeki seçili zamansal glukoz modellerini, etkili klinik değişkenleri ve tanısal olarak ilgili retinal görüntü bölgelerini vurgulamaktadır.
İnsan merkezli değerlendirme sonuçları
Klinisyen güvenini, yorumlanabilirliği, kullanılabilirliği, klinik yararlılığı ve açıklama uygunluğunu yalnızca tahmin ve tahmin artı açıklama koşulları altında değerlendirmek için prospektif bir insan merkezli değerlendirme protokolü tasarlanmıştır. Önerilen değerlendirme; Kurumsal Etik Kurul'dan uygun onayın alınması ve bilgilendirilmiş onamla birlikte endokrinologlar, diyabet uzmanları ve klinik farmakologların katılımıyla gerçekleştirilecektir. Bu değerlendirme gelecekteki prospektif uygulama için tasarlandığından, mevcut protokolde klinisyen düzeyindeki sonuç puanları raporlanmamıştır.
Tablo 7, önerilen prospektif klinisyen değerlendirme tasarımını ve açıklamaların klinisyen güveni, yorumlanabilirlik ve algılanan fayda üzerindeki etkilerini değerlendirmek için önceden tanımlanmış kriterleri özetlemektedir. Prospektif değerlendirme, model tahminlerine dair klinisyen değerlendirmelerini, önceden tanımlanmış Likert ölçeği kriterleri kullanarak açıklamalı ve açıklamasız şekilde karşılaştıracaktır. Önerilen prospektif insan merkezli açıklanabilirlik değerlendirme çerçevesi Şekil 10'da sunulmuştur.
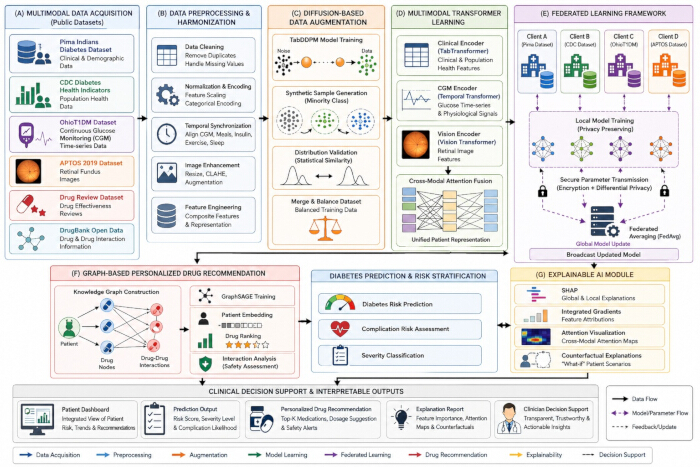
Şekil 1: Genel FedMediFormer-XAI çerçeve mimarisi. Multimodal veri edinimi ve ön işleme, difüzyon tabanlı artırma, modaliteye özgü transformer öğrenimi, federatif model eğitimi, GraphSAGE tabanlı kişiselleştirilmiş ilaç önerisi ve açıklanabilirlik analizini gösteren FedMediFormer-XAI çerçevesinin şematik genel görünümü. Çerçeve; diyabet tahmini, kişiselleştirilmiş ilaç önerileri ve yorumlanabilir model çıktıları üretir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
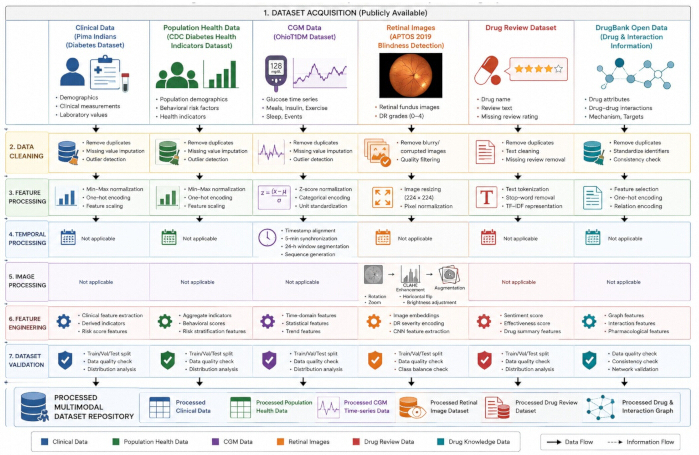
Şekil 2: Multimodal veri seti edinimi ve ön işleme hattı. FedMediFormer-XAI'de kullanılan multimodal veri setlerinin edinimi ve ön işlemesine yönelik şematik iş akışı. Klinik ve popülasyon sağlığı verileri, CGM kayıtları, retinal görüntüler ve farmakolojik bilgiler; aşağı akış analizleri için modele hazır temsilere dönüştürülmeden önce modaliteye özgü kalite kontrolü, ön işleme, normalizasyon, kodlama ve artırma işlemlerinden geçer. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
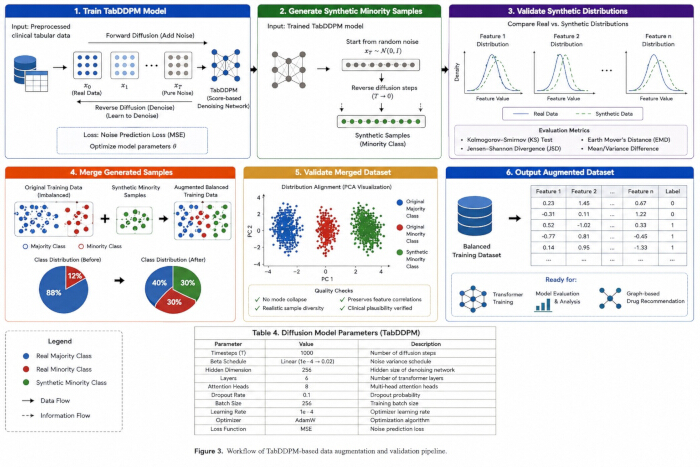
Şekil 3: Difüzyon tabanlı veri artırma iş akışı. TabDDPM kullanılarak yapılandırılmış tablo biçimindeki eğitim verilerinin difüzyon tabanlı artırımı için şematik iş akışı. Üretilen örnekler, sınıf dengesini iyileştirmek amacıyla orijinal eğitim verileriyle entegre edilmeden önce kalite ve dağılım benzerliği değerlendirmelerine tabi tutulur. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
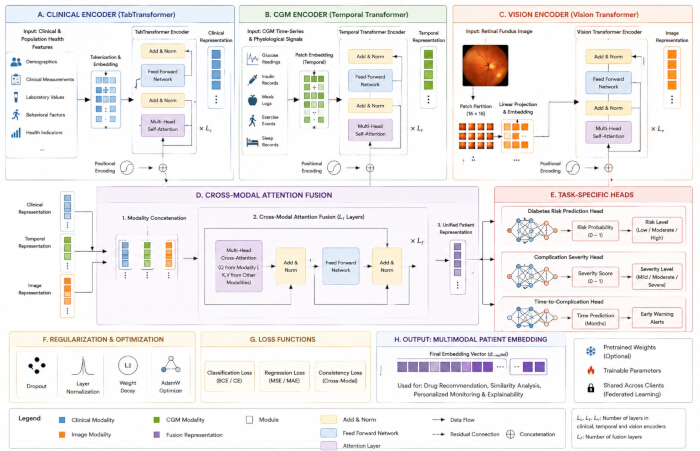
Şekil 4: Önerilen multimodal transformer çerçevesinin mimarisi. (A) klinik veriler için bir TabTransformer kodlayıcı, (B) CGM verileri için bir zamansal transformer kodlayıcı ve (C) retinal görüntüler için bir Vision Transformer kodlayıcıdan oluşan şematik mimari. (D) Modaliteye özgü temsiller, birleşik bir multimodal temsil oluşturmak için çapraz modal dikkat (cross-modal attention) aracılığıyla entegre edilir. (E) Göreve özgü tahmin başlıkları model çıktılarını üretir. (F) Düzenleme ve optimizasyon bileşenleri model eğitimini destekler ve (G) sınıflandırma, regresyon ve çapraz modal tutarlılık kayıpları optimizasyon sürecine rehberlik eder. Ortaya çıkan multimodal temsil; alt akış tahmin, öneri ve açıklanabilirlik görevlerini destekler. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
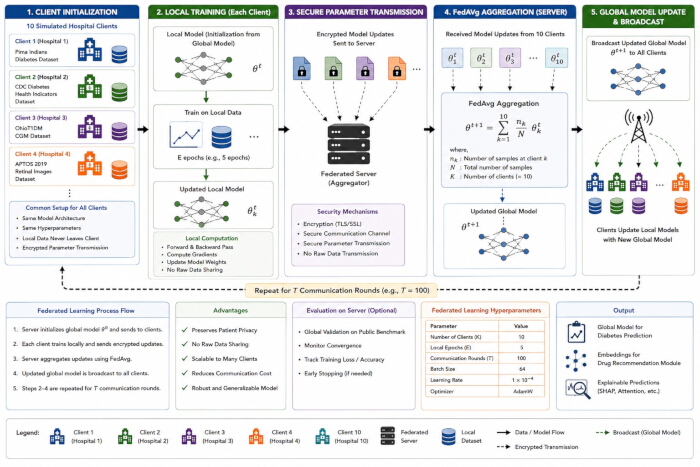
Şekil 5: Federatif öğrenme iletişim çerçevesi. Dağıtık hastane istemcileri arasında gerçekleştirilen federatif eğitim için şematik iş akışı. Yerel multimodal modeller istemciye özgü veriler kullanılarak eğitilir ve korumalı model güncellemeleri Federated Averaging işlemi için merkezi bir sunucuya iletilir. Birleştirilen global model, sonraki iletişim turları için istemciler arasında yeniden dağıtılır. Çerçeve ayrıca güvenli parametre değişimini ve gizlilik, iletişim ve hesaplama gereksinimlerinin değerlendirilmesini göstermektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
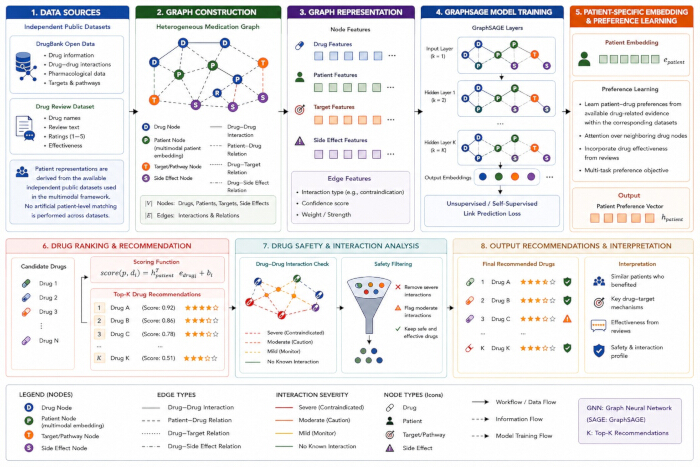
Şekil 6: Graf tabanlı kişiselleştirilmiş ilaç öneri iş akışı. GraphSAGE tabanlı kişiselleştirilmiş ilaç önerisi için şematik iş akışı. Farmakolojik ve hasta temsil verileri, ilgili sağlık kuruluşlarını ve ilişkileri içeren heterojen bir graf şeklinde düzenlenir. GraphSAGE, hasta ve ilaç temsillerini öğrenerek hasta-ilaç uygunluk skorlarının hesaplanması ve aday ilaçların sıralanması için kullanılır. Final Top-K önerilerinin oluşturulmasından önce kontrendike veya güvenli olmayan ilaç kombinasyonları filtrelenir; graf tabanlı bilgiler ise önerilerin yorumlanmasını destekler. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
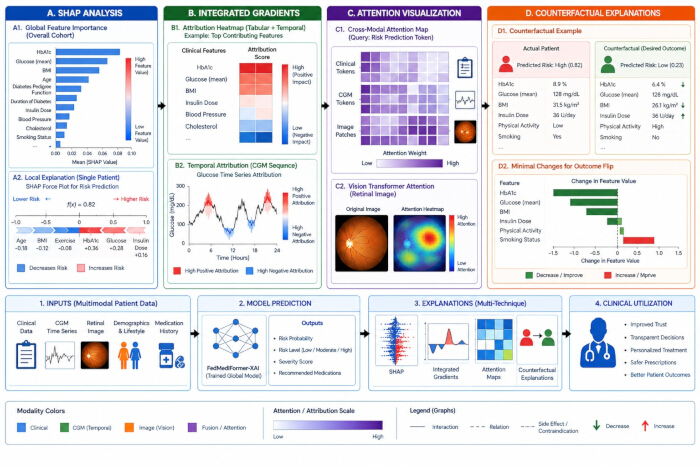
Şekil 7: Açıklanabilirlik değerlendirme çerçevesi. Açıklanabilirlik iş akışının şematik genel görünümü. (A) SHAP analizi küresel ve yerel özellik katkılarını değerlendirir; (B) Integrated Gradients atıf tabanlı açıklamalar sunar; (C) dikkat görselleştirmesi etkili özellikleri ve modalite etkileşimlerini tanımlar; ve (D) karşıolgusal analiz, değişen tahminlerle ilişkili özellik değişikliklerini belirler. Ortaya çıkan açıklama çıktıları, model tahminlerinin yorumlanmasını ve kişiselleştirilmiş önerileri destekler. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
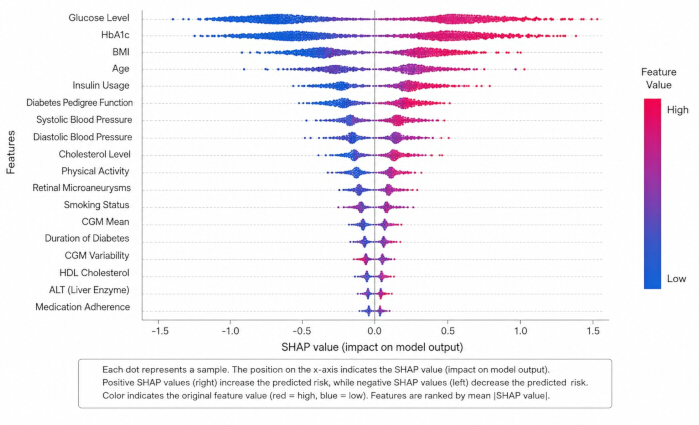
Şekil 8: Eğitilmiş FedMediFormer-XAI modeli tarafından oluşturulan, modele dayalı temsilci bir SHAP özellik önem analizi. SHAP özet grafiği, değerlendirilen örnekler genelindeki SHAP değerlerinin dağılımını göstermektedir ve özellikler, ortalama mutlak SHAP katkılarına göre sıralanmıştır. Pozitif SHAP değerleri, daha yüksek öngörülen diyabet riskine yönelik katkıları belirtirken, negatif değerler daha düşük öngörülen riske yönelik katkıları belirtir. Renkler ilgili özellik değerini temsil eder; daha yüksek özellik değerleri kırmızı ile, daha düşük değerler ise mavi ile gösterilmiştir. Grafik, şematik bir çizimden ziyade modele dayalı gerçek bir açıklanabilirlik çıktısını temsil etmektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
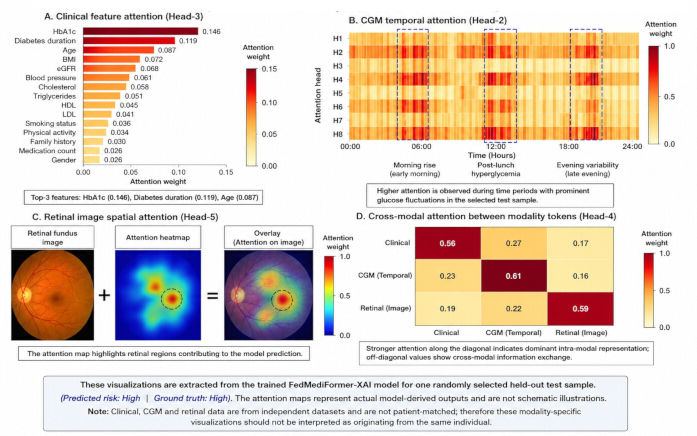
Şekil 9: Rastgele seçilmiş bir tutulan test örneği için eğitilmiş FedMediFormer-XAI modeli tarafından üretilen temsili dikkat çıktıları. (A) Multimodal transformer'ın bir dikkat başlığından elde edilen ve klinik özelliklere atanan göreceli dikkat ağırlıklarını gösteren klinik özellik dikkati. (B) CGM dizisi boyunca, modelin daha yüksek dikkat gösterdiği zaman dilimlerini gösteren zamansal dikkat. (C) Orijinal görüntüyü, dikkat ısı haritasını ve dikkat katmanını içeren retinal fundus görüntüsü için mekansal dikkat. (D) Klinik, CGM ve retinal modalite belirteçleri arasındaki, modalite içi ve modallar arası bilgi ağırlıklandırmasını gösteren çapraz modalite dikkati. Görüntülenen görselleştirmeler, eğitilmiş model tarafından üretilen model türevli çıktılardır. Dikkat ağırlıkları seçilen test örneği için gösterilmiştir ve klinik nedenselliğin bağımsız ölçümleri olarak değil, model dikkat örüntüleri olarak yorumlanmalıdır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
| Veri Seti | Veri Tipi | Numuneler/Kayıtlar | Özellikler/İçerik | Amaç | Genel Erişilebilirlik |
| Pima Yerlileri Diyabet Veri Seti | Klinik Tablo | 768 hasta | 8 klinik değişken | Diyabet risk öngörüsü | Kamuya Açık |
| CDC Diyabet Sağlık Göstergeleri | Popülasyon Sağlığı | 253.680 kayıt | Demografik özellikler, yaşam tarzı, sağlık göstergeleri | Popülasyon risk analizi | Genel |
| OhioT1DM Veri Seti | CGM Zaman Serisi | 12 denek | Glikoz, insülin, öğünler, egzersiz, uyku | Temporal diyabet modellemesi | Kamuya Açık |
| APTOS 2019 Körlük Tespiti | Retinal Görüntüler | 3.662 görüntü | Şiddet etiketli fundus fotoğrafları | Diyabetik retinopati analizi | Kamu |
| İlaç Değerlendirme Veri Seti | Farmakolojik | 215.063 inceleme | İlaç etkinliği, puanlamalar, incelemeler | İlaç önerisi | Kamuya Açık |
| DrugBank Açık Verileri | İlaç Bilgi Grafiği | Binlerce ilaç | İlaç-ilaç etkileşimleri, hedefler, yolaklar | Graf oluşturma | Kamu/Akademik Erişim |
Tablo 1: Veri seti özellikleri. Bu çalışmada kullanılan halka açık veri setlerinin; veri seti türü, örneklem büyüklüğü, veri modalitesi, özellik içeriği, amaçlanan kullanım ve erişilebilirlik bilgilerini içeren özeti.
| Veri Seti | Modalite | Tahmin Hedefi | Füzyon Seviyesi |
| Pima Kızılderilileri Diyabeti | Klinik | Diyabet sınıflandırması | Öznitelik gömme |
| CDC Diyabet Sağlık Göstergeleri | Popülasyon sağlığı | Diyabet risk tahmini | Öznitelik gömme |
| OhioT1DM | Sürekli glikoz izleme | Glikoz trend tahmini | Öznitelik gömme |
| APTOS 2019 | Retinal fundus görüntüleri | Diyabetik retinopati analizi | Öznitelik gömme |
| İlaç İncelemesi + DrugBank | Farmakolojik | İlaç önerisi | Graf gömme |
Tablo 2: Multimodal veri seti entegrasyon stratejisi. Veri modalitesi, tahmin hedefi ve modaliteye özgü temsillerin entegre edildiği düzeyi içeren, multimodal diyabet zekası için kullanılan veri setlerinin özeti. Klinik, popülasyon sağlığı, sürekli glikoz izleme ve retinal görüntü verileri özellik gömmeleri (feature embeddings) olarak temsil edilirken, farmakolojik bilgiler kişiselleştirilmiş ilaç önerisi için grafik gömmeleri (graph embeddings) aracılığıyla entegre edilmiştir.
| Model | Doğruluk, Ortalama ± SD (%95 GA) | Hassasiyet, Ortalama ± SS (%95 GA) | Duyarlılık, Ortalama ± SS (%95 GA) | F1-skoru, Ortalama ± SD (%95 GA) | MCC, Ortalama ± SS (%95 GA) | AUC-ROC, Ortalama ± SS (%95 GA) |
| Rastgele Orman | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| Zamansal Transformer | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| Merkezi Çok Modlu Transformer | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
Tablo 3: Diyabet tahmin performansı. Doğruluk, kesinlik, duyarlılık, F1-skoru, MCC ve AUC-ROC metrikleri kullanılarak FedMediFormer-XAI ile temel makine öğrenimi ve derin öğrenim modellerinin karşılaştırmalı tahmin performansı.
| Metrik | Merkezi Öğrenme | Federatif Öğrenme |
| Doğruluk (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| Gizliliğin Korunması | Hayır | Evet |
| Ham Veri Paylaşımı Gereklidir | Lütfen çevirmemi istediğiniz metni gönderiniz. | Hayır |
| İletişim Turları | Lütfen çevrilmesini istediğiniz metni sağlayın. | 100 |
| Eğitim Süresi (saat) | 4.8 | 5.6 |
| Mevzuata Uygunluk | Orta düzeyde | Yüksek |
Tablo 4: Federatif ve merkezi öğrenme performansı. Merkezi ve federatif öğrenme uygulamalarının öngörücü performans, ham veri paylaşım gereksinimleri, iletişim turları ve eğitim süresi açısından karşılaştırılması.
| Veri Kümesi | Doğruluk (%) | Kesinlik (%) | Duyarlılık (%) | AUC-ROC |
| Pima Indians Diabetes Dataset | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC Diabetes Health Indicators | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM Dataset | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 Blindness Detection | 94.7 | 93.9 | 93.5 | 0.96 |
| Multimodal Fusion (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tablo 5: Veri seti düzeyindeki sonuçlar. Bireysel veri setleri ve multimodal füzyon ayarları genelindeki performans analizi. Sonuçlar, farklı veri modalitelerinin genel öngörücü performansa olan katkısını göstermektedir.
| Metrik | Değer |
| Hassasiyet@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| İlaç Etkileşimi Tespit Doğruluğu | 0.95 |
| Öneri Kapsamı | 0.88 |
| Ortalama Karşılıklı Sıra Derecesi (MRR) | 0.86 |
| Güvenlik Uyumluluk Puanı | 0.94 |
Tablo 6: Kişiselleştirilmiş ilaç öneri performansı. Sıralama metrikleri, etkileşim tespit doğruluğu, öneri kapsamı ve ilaç güvenliği değerlendirmesi kullanılarak grafik tabanlı kişiselleştirilmiş ilaç önerisinin değerlendirilmesi.
| Değerlendirme kriteri | Önerilen değerlendirme tasarımı |
| Klinisyen güveni | Beşli Likert ölçekli değerlendirme |
| Yorumlanabilirlik | Beşli Likert ölçekli değerlendirme |
| Klinik uygunluk | Beşli Likert ölçekli değerlendirme |
| Açıklama faydalılığı | Beşli Likert ölçekli değerlendirme |
| Algılanan yararlılık | Beşli Likert ölçekli değerlendirme |
| Değerlendiriciler arası uyum | Prospektif değerlendirme sonrası hesaplanacak Fleiss' kappa |
| İstatistiksel karşılaştırma | Veri toplama sonrası uygun görülen eşleştirilmiş istatistiksel test |
| Katılımcılar | Etik onay ve bilgilendirilmiş onama şartıyla 12 klinisyen |
| Değerlendirme durumu | Prospektif/gelecekteki değerlendirme |
Tablo 7: Önerilen insan merkezli değerlendirme kriterleri. FedMediFormer-XAI açıklamalarının yararlılığını, klinik ilgisini, yorumlanabilirliğini, güvenilirliğini ve kullanılabilirliğini değerlendirmek için önerilen, prospektif klinisyen merkezli değerlendirme çerçevesi. Değerlendirme; standartlaştırılmış beş puanlı Likert ölçeği değerlendirmesini, Fleiss' kappa kullanılarak yapılan değerlendirmeciler arası uyumu, yalnızca tahmin ve tahmin artı açıklama koşullarının istatistiksel karşılaştırmasını ve %95 güven aralıklarını içerir. Klinisyen değerlendirmesi, yalnızca ilgili Kurumsal Etik Kurul onayı ve bilgilendirilmiş onam alındıktan sonra gerçekleştirilmelidir.
Ek Tablo 1: Veri seti doğrulama stratejisi. Tekrarlanabilirliği ve güvenilir model değerlendirmesini sağlamak amacıyla veri seti bölümlendirme, doğrulama prosedürleri, sınıf dengeleme stratejileri ve kalite kontrol önlemleri uygulanmıştır. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 2: Difüzyon model parametreleri. Eğitim parametreleri, optimizasyon ayarları, latent boyutlar, gürültü planlama stratejisi ve sentetik örnek oluşturma spesifikasyonlarını içeren TabDDPM difüzyon modeli için konfigürasyon ayarları. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 3: Çok modlu transformer yapılandırması. Klinik, zamansal ve görüntü kodlayıcıları; gömme ve füzyon boyutları, dikkat başları, optimize edici, öğrenme oranı, grup boyutu, eğitim epokları, erken durdurma kriteri ve birleşik eğitim kaybı dahil olmak üzere çok modlu transformer mimarisinin yapılandırması. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 4: Federatif öğrenme yapılandırması. Katılımcı hastane sayısı, iletişim turları, yerel eğitim dönemleri, istemci katılım oranı, toplama algoritması, optimize edici, öğrenme hızı, şifreleme yöntemi, iletişim protokolü ve ham veri paylaşım politikası dahil olmak üzere gizliliği koruyan federatif eğitim için kullanılan parametreler. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 5: GraphSAGE yapılandırması. Graf türü, gizli ve gömme boyutları, graf katman sayısı, komşuluk örnekleme boyutu, optimize edici, öğrenme hızı, yığın boyutu, eğitim epokları, Bayesyen Kişiselleştirilmiş Sıralama kaybı ve en iyi ilaç önerileri sayısı dahil olmak üzere, heterojen GraphSAGE tabanlı kişiselleştirilmiş ilaç öneri modülünün yapılandırması. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Tablo 6: Açıklanabilirlik değerlendirme metrikleri. FedMediFormer-XAI çerçevesinin açıklanabilirliğini değerlendirmek için kullanılan nicel ve insan merkezli metrikler. Metrikler; açıklama sadakati, kararlılığı, tutarlılığı, seyrekliği, tamamlayıcılığı, hassasiyeti, sadakatsizliği, değerlendiriciler arası uyumu ve klinisyen tarafından algılanan açıklama kalitesini değerlendirir. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 7: Değerlendirme metrikleri. Çerçeve performansını, sağlamlığını, sıralama kalitesini ve yorumlanabilirliğini değerlendirmek için öngörücü, federatif öğrenme, öneri ve açıklanabilirlik metrikleri kullanılmıştır. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 8: İnsan merkezli değerlendirme tasarımı. Katılımcı grupları, değerlendirme koşulları, değerlendirme kriterleri ve istatistiksel analiz prosedürlerini içeren klinisyen merkezli değerlendirme çalışmasının tasarımı. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo 9: Tekrarlanabilirlik varlıkları. Önerilen FedMediFormer-XAI çerçevesinin tekrarlanabilirliğini desteklemek için gerekli olan veri kümelerinin, uygulama spesifikasyonlarının, yapılandırma dosyalarının, değerlendirme prosedürlerinin, dokümantasyonun ve deneysel kayıtların özeti. Bu dosyayı indirmek için lütfen buraya tıklayınız.
Tartışma
Temel bulguların yorumlanması
Temsili sonuçlar; çok modlu transformer öğrenimi, federatif öğrenme, difüzyon tabanlı artırma, grafik sinir ağı tabanlı ilaç önerisi ve açıklanabilir yapay zekanın tek bir birleşik diyabet zekası çerçevesinde birleştirilmesinin mümkün olduğunu göstermektedir. Klinik kayıtlar, popülasyon sağlığı göstergeleri, sürekli glikoz izleme verileri, retinal fundus görüntüleri ve farmakolojik bilgileri entegre eden önerilen FedMediFormer-XAI çerçevesi, yorumlanabilir ve merkeziyetsiz model geliştirmeyi desteklerken güçlü bir öngörü performansı sergilemiştir. Çok modlu öğrenme yöntemi, farklı sağlık hizmeti modalitelerinden bilgilendirici özellikler çıkararak daha iyi diyabet öngörüsü ve kişiselleştirilmiş tedavi önerileri sağlanmasına olanak tanımıştır.
Federated öğrenmenin faydaları
Önerilen çerçevenin temel katkılarından biri, merkeziyetsiz işbirlikçi model oluşturmayı mümkün kılmak için federated öğrenmenin entegrasyonudur. Federated öğrenme, birden fazla kurumun ham hasta verilerini doğrudan paylaşmadan model eğitimine katılmasına izin vererek geleneksel merkezi öğrenme yöntemlerinden ayrılır. Temel bulgular, federated öğrenmenin merkeziyetsiz veri yönetimini desteklerken merkezi öğrenme ile kıyaslanabilir bir öngörücü doğruluk sağladığını göstermiştir. Bu özellik, veri paylaşımının kurumsal politikalar ve gizlilik gereksinimleri nedeniyle sınırlı olduğu sağlık hizmetleri senaryolarında özellikle önemlidir.
Açıklanabilirlik analizi
Açıklanabilirlik değerlendirmesi; SHAP analizinin, Entegre Gradyanların, dikkat görselleştirmesinin ve karşı olgusal açıklamaların tamamının, modelin davranışı hakkında klinik olarak anlamlı öngörüler sağlayabildiğini ortaya koymuştur. Küresel ve yerel açıklamalar, klinik perspektiften en önemli öngördürücüler (yani glukoz ölçümleri, vücut kitle indeksi, yaş, insülin uygulama modelleri ve retinal anomaliler) konusunda büyük ölçüde hemfikirdir. Dikkat görselleştirmeleri ayrıca, transformer mimarisinin klinik olarak ilgili zamansal ve görüntüleme özelliklerine odaklandığını göstermiştir. Bu yaklaşımlar, model tahminlerinin ve özellik katkılarının tamamlayıcı yorumlarını sunarak şeffaflığı artırmaktadır.
Kişiselleştirilmiş ilaç öneri analizi
Hasta-ilaç ve ilaç-ilaç ilişkilerini modellemenin yanı sıra kişiselleştirilmiş ilaç önerileri sunan GNN tabanlı bir öneri modeli öneriyoruz. Aslında, heterojen grafik topolojisi hem tedavi etkinliği kalıplarının kavranmasını hem de ilaç güvenliğinin dikkate alınmasını kolaylaştırmıştır. Bu çalışmada elde edilen mükemmel ilaç öneri sonuçları, grafik tabanlı öğrenme yöntemlerinin, hastalık öngörüsünün ötesine geçerek kişiselleştirilmiş bir terapötik destek iskeletine doğru diyabet zeka sistemleri geliştirme kapasitesini göstermektedir.
İnsan merkezli değerlendirme
Çerçeve, açıklanabilirliğin klinisyen güveni, yorumlanabilirlik, kullanılabilirlik ve algılanan klinik fayda üzerindeki etkilerini değerlendirmek için ileriye dönük bir insan merkezli değerlendirme protokolü içermektedir. Önerilen değerlendirme, standartlaştırılmış değerlendirme kriterlerini kullanarak yalnızca tahmine dayalı durumlar ile tahmin artı açıklama durumlarını karşılaştıracaktır. Kurumsal Etik Kurul'dan uygun onayın alınması ve bilgilendirilmiş onamın ardından bu değerlendirmenin gelecekteki uygulaması, klinisyen kabulü ve oluşturulan açıklamaların pratik faydası hakkında ampirik kanıtlar sağlayacaktır.
Başarılı ve tekrarlanabilir uygulama için kritik adımlar
Önerilen protokolün birkaç aşaması, tekrarlanabilirliği sağlamak için özel dikkat gerektirmektedir. Veri seti ön işleme ve bölümlendirme işlemleri, hasta düzeyinde ayrımı korumalı ve veri sızıntısını önlemelidir; aynı zamanda federasyon öğrenimi sırasında belirtilen non-IID istemci dağılımları korunmalıdır. Çapraz modalite füzyonu; tanımlanan gizli boyutları, dikkat konfigürasyonunu, modalite tipi gömmelerini, normalizasyonu ve final projeksiyonunu korumalıdır. Difüzyon tabanlı artırım, tutarlı ön işleme ve eğitim parametreleri kullanmalı; GraphSAGE tabanlı öneri ise tutarlı hasta-ilaç temsillerini, etkileşim taramasını, ilgili öğelerin tanımlarını ve Top-K sıralama kriterlerini korumalıdır. Açıklanabilirlik analizi; sabit SHAP arka plan örneklerini, Entegre Gradyan (Integrated Gradients) temel çizgilerini, dikkat çıkarma prosedürlerini ve klinik olarak kabul edilebilir karşıolgusal kısıtlamaları kullanmalıdır. Uygulama bağımlı varyasyonları en aza indirmek için yazılım sürümleri, rastgele tohumlar, model konfigürasyonları, veri seti bölümleri ve değerlendirme parametreleri belgelenmelidir.
Kısıtlamalar
Bu çalışmanın bulguları yorumlanırken birkaç kısıtlama göz önünde bulundurulmalıdır. İlk olarak, çerçeve, gerçek dünyadaki sağlık hizmeti popülasyonlarının ve klinik ortamların çeşitliliğini tam olarak temsil etmeyebilecek, kamuya açık veri setleri kullanılarak geliştirilmiş ve değerlendirilmiştir. İkinci olarak, federatif öğrenme simüle edilmiş hastane istemcileri kullanılarak değerlendirilmiş olsa da, bağımsız sağlık kurumlarını kapsayan geniş ölçekli bir doğrulama gerçekleştirilmemiştir. Üçüncü olarak, federatif öğrenme, kaynakların kısıtlı olduğu ortamlarda ölçeklenebilirliği etkileyebilecek ek iletişim ve hesaplama yükü getirmektedir. Son olarak, bu çalışmada kullanılan açıklanabilirlik teknikleri öncelikle post hoc yorumlama yöntemleridir ve karmaşık modelin davranışını tam olarak yakalayamayabilir.
Önerilen insan odaklı doğrulama protokolü; endokrinologlar, diyabet uzmanları ve klinik farmakologlardan oluşan 12 klinik uzmanın yer aldığı başlangıç paneli göz önünde bulundurmaktadır. Bu örneklem büyüklüğü, kesin klinik doğrulamadan ziyade kullanılabilirlik ve yorumlanabilirliğin ön değerlendirmesi için amaçlanmıştır. Nispeten küçük olan uzman paneli, istatistiksel gücü ve genellenebilirliği sınırlayabilir. Bu nedenle, gelecekteki prospektif çalışmalar, farklı klinik ortamları ve uzmanlık alanlarını temsil eden daha geniş, çok merkezli klinisyen kohortlarını kapsamalıdır.
Önerilen çerçevenin temel bir kısıtlaması, klinik, CGM, retinal görüntüleme ve ilaçla ilgili modalitelerin, hastaya özel eşleşmiş multimodal kayıtlar yerine bağımsız kamuya açık veri kümelerinden türetilmiş olmasıdır. Sonuç olarak, çapraz-modal füzyon bileşeni, aynı hastalardan alınan eşzamanlı multimodal ölçümlerden türetilen bir kanıttan ziyade, tamamlayıcı modalite temsillerini entegre etmek için bir metodolojik çerçeve olarak yorumlanmalıdır. Kaynak veri kümeleri arasındaki popülasyon özellikleri, edinme protokolleri, özellik dağılımları ve hastalık tanımları açısından farklılıklar, dağılımsal tutarsızlıklara yol açabilir ve öğrenilen çapraz-modal ilişkilerin gerçek hasta düzeyindeki ilişkileri temsil etme düzeyini sınırlayabilir. Protokol, bağımsız veri kümeleri arasında yapay hasta düzeyi eşleştirmeden açıkça kaçınmış olsa da, bu tasarım hasta spesifik multimodal etkileşimlerin doğrudan değerlendirilmesini sınırlar ve klinik genelleştirilebilirliği etkileyebilir. Bu nedenle, rapor edilen multimodal performans, prospektif olarak toplanmış ve hasta düzeyinde eşleştirilmiş bir multimodal kohort üzerindeki doğrulamaya eşdeğer olarak yorumlanmamalıdır. Gelecekteki çalışmalar, aynı hastalardan alınan senkronize klinik, CGM, retinal ve tedavi bilgilerini içeren, bağımsız olarak toplanmış daha büyük veri kümeleri kullanarak çerçeveyi doğrulamalıdır.
Sorun giderme ve protokol modifikasyonları
Önerilen protokolün uygulanmasını etkileyebilecek çeşitli pratik hususlar bulunmaktadır. Azınlık sınıfların yetersiz temsil edildiği durumlarda, sınıf dengesizliği öngörü performansını düşürebilir; bu zorluk, difüzyon tabanlı artırma ve yeniden örnekleme stratejileriyle hafifletilebilir. Eksik değerler ve tutarsız veri formatları model stabilitesini etkileyebilir ve titiz ön işleme prosedürleri ile ele alınmalıdır. İstemci veri setleri önemli ölçüde heterojenlik gösterdiğinde, federatif öğrenme yakınsaması istikrarsız hale gelebilir; yerel eğitim epoklarının, öğrenme oranlarının ve toplama sıklıklarının ayarlanması stabiliteyi artırabilir. Özellikle büyük multimodal veri setleri ve transformer mimarileri işlenirken, donanım kısıtlamaları eğitim verimliliğini etkileyebilir. Bu gibi durumlarda, yeniden üretilebilirliği korurken parti boyutunu veya model karmaşıklığını azaltmak, hesaplama fizibilitesini artırabilir.
Gelecekteki yönelimler
Gelecekteki araştırmalar, kişiselleştirilmiş hastalık simülasyonu ve tedavi planlaması için dijital ikiz teknolojilerinin entegrasyonuna odaklanabilir. Büyük ölçekli multimodal sağlık veri kümeleri üzerinde eğitilen temel modeller, temsil öğrenimini ve model genellemesini daha da geliştirebilir. Nedensel açıklanabilirlik teknikleri, korelasyon tabanlı açıklamaların ötesinde, hastalık mekanizmaları ve tedavi etkileri hakkında daha derin içgörüler sağlayabilir. Ek olarak, pekiştirmeli öğrenme yaklaşımları, adaptif tedavi optimizasyonunu ve dinamik ilaç öneri stratejilerini destekleyebilir. Bu ilerlemeler, diyabet zekâ sistemlerinin klinik faydasını ve kişiselleştirme yeteneklerini daha da artırabilir. Ayrıca, yapay zekâ tarafından üretilen tahminler ve ilaç önerileri, profesyonel klinik değerlendirmenin yerini alan araçlar değil, karar destek araçları olarak değerlendirilmelidir. Sağlık hizmetleri yapay zekâ sistemlerinin sorumlu ve etik bir şekilde konuşlandırılması için uygun insan denetimi temel gereksinim olmaya devam etmektedir.
Sonuç
FedMediFormer-XAI; diyabet zekası için multimodal öğrenmeyi, federatif eğitimi, kişiselleştirilmiş ilaç önerisini ve açıklanabilirliği entegre eden yeniden üretilebilir bir çerçeve sunmaktadır. Temsili sonuçlar, önerilen iş akışının uygulanabilirliğini desteklerken; klinik uygulama öncesinde hastaya özel eşleştirilmiş multimodal veri setleri, daha geniş klinik ortamlar ve prospektif klinisyen değerlendirmeleri kullanılarak daha fazla doğrulama yapılması gerekmektedir.
Açıklamalar
Yazarlar, bu çalışmada rapor edilen işi etkileyebilecek herhangi bir rakip finansal çıkar, çıkar çatışması veya kişisel ilişkiye sahip olmadıklarını beyan ederler. Yapay zeka araçları, bu makalenin hazırlanması sırasında yalnızca dilin iyileştirilmesi, taslağın düzenlenmesi, biçimlendirme ve editörlük işlemlerine yardımcı olmak amacıyla kullanılmıştır. Tüm bilimsel içerik, çalışma tasarımı, metodoloji, veri analizi, sonuçların yorumlanması ve çıkarımlar yazarlar tarafından geliştirilmiş, doğrulanmış ve onaylanmıştır. Yazarlar, bu taslakta sunulan çalışmanın doğruluğu, bütünlüğü ve özgünlüğü konusunda tüm sorumluluğu üstlenmektedir.
Teşekkürler
Yazarlar, bu çalışmada kullanılan halka açık veri setlerinin ve açık kaynaklı yazılım kaynaklarının geliştiricilerine ve yöneticilerine teşekkür ederler.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| AES Şifreleme | NIST | AES-256 | Durağan veri / federasyon öğreniminde korumalı model parametre şifrelemesi |
| APTOS 2019 Körlük Tespit Veri Seti | Kaggle/APTOS | 2019 Yayını | Retinal fundus görüntü veri seti; halka açık ve kimliksizleştirilmiş; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Versiyon 0.8 | Model yorumlanabilirliği ve atıf analizi |
| CUDA Toolkit | NVIDIA | Versiyon 12.2 | GPU hızlandırmalı hesaplama |
| Diyabet Sağlık Göstergeleri Veri Seti (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015 Yayını | Popülasyon sağlık göstergeleri; halka açık ve kimliksizleştirilmiş; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diyabetik Retinopati Tespit Veri Seti | Kaggle | Genel Yayın | Retinal görüntü veri seti; halka açık ve kimliksizleştirilmiş; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Dijital sertifikalar | – | – | Federasyon öğreniminde istemci kimlik doğrulaması |
| İlaç Etkileşimi Veri Seti | Kaggle | Genel Yayın | İlaç-ilaç etkileşimi grafik verileri; halka açık ve kimliksizleştirilmiş; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| İlaç İnceleme Veri Seti | UCI Machine Learning Repository | Veri Seti 462 | İlaç etkinliği ve inceleme veri seti; halka açık ve kimliksizleştirilmiş; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Versiyon 3.9 | Görselleştirme |
| MTS Diyabet Veri Seti | Kaggle | Genel Yayın | Giyilebilir sensör / diyabet tahmini veri seti; halka açık ve kimliksizleştirilmiş; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Versiyon 3.3 | İlaç etkileşimi grafik oluşturma ve analizi |
| NumPy | NumPy Developers | Versiyon 1.26 | Sayısal hesaplama |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Model eğitimi ve çıkarımı; en az 32 GB sistem belleği |
| OhioT1DM Veri Seti | Ohio University | Genel Yayın | Sürekli glikoz izleme veri seti; halka açık ve kimliksizleştirilmiş; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Versiyon 4.10 | Görüntü işleme |
| Pandas | PyData | Versiyon 2.2 | Veri işleme ve ön işleme |
| Pima Indianları Diyabet Veri Seti | UCI Machine Learning Repository | Veri Seti 34 | Klinik diyabet tahmini veri seti; halka açık ve kimliksizleştirilmiş; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Versiyon 3.11 | Birincil programlama ortamı |
| PyTorch | Meta AI | Versiyon 2.3 | Derin öğrenme model geliştirme ve eğitimi |
| PyTorch Geometric | PyG Team | Versiyon 2.5 | Grafik sinir ağı oluşturma ve eğitimi |
| Scikit-learn | Scikit-learn Developers | Versiyon 1.5 | Makine öğrenimi araçları ve değerlendirme |
| Güvenli toplama mekanizması | – | – | Federasyon öğreniminde yerel model parametrelerinin korumalı toplama işlemi |
| SHAP | SHAP Developers | Versiyon 0.47 | Açıklanabilir yapay zeka ve öznitelik atıf analizi |
| TensorFlow | Versiyon 2.15 | Derin öğrenme model geliştirme ve eğitimi | |
| Transformers | Hugging Face | Versiyon 4.45 | Transformer tabanlı mimari uygulaması |
| Taşıma Katmanı Güvenliği | IETF | TLS 1.3 | Federasyon parametre değişimi için şifreli iletişim kanalı |
| İş İstasyonu | Genel | – | Hesaplama ortamı; en az 32 GB sistem belleği |
Kaynaklar
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.