Bu çalışma, uzman ve refakatçi rol çerçevelemesinin farklı tıbbi görev bağlamlarında güvenle nasıl ilişkili olduğunu incelemek için bir senaryo deneyi ve elektroensefalogramları entegre etmektedir.
Yöntem makalesi
Tıbbi Yapay Zekada Rol Çerçeveleme ve Güven: Bir Senaryo Deneyi ve EEG'den Kanıtlar
Bu makalede
Özet
Özet
Çevrimiçi tıbbi yapay zeka, arka uç analitik araçlarından hasta odaklı hizmet arayüzlerine evrilmiş, bu da kalibre edilmiş güveni giderek daha önemli bir tasarım ve yönetişim sorunu haline getirmiştir. Rol uygunluğu teorisinden yola çıkan bu çalışma, uzman ve refakatçi rol çerçevelendirmesinin farklı tıbbi görev bağlamlarında güvenle nasıl ilişkili olduğunu incelemiştir. Çalışma 1, 2 (rol: uzman vs. refakatçi) × 2 (görev: hastalık konsültasyonu vs. sağlık konsültasyonu) senaryolu bir deney (N = 300) kullanmıştır. Uzman çerçevelendirme algılanan profesyonelliği artırırken, refakatçi çerçevelendirme sosyal varlığı artırmıştır; her iki algı, eş zamanlı olarak girildiğinde genel güvenle bağımsız olarak ilişkili bulunmuştur. Profesyonellik üzerinden gerçekleşen dolaylı ilişki görev bağlamı tarafından koşullandırılmış, ancak doğrudan bir bootstrap karşılaştırması, genel güven için iki modere edilmiş aracılık indeksinin farklı olduğunu göstermemiştir. Ölçüm tanıları, algılanan profesyonellik ile bilişsel güven ve sosyal varlık ile duygusal güven arasında önemli bir örtüşme olduğunu göstermiş ve bu durum dikkatli bir yorumlama gerektirmiştir. Çalışma 2, 39 eşli gözlemde EEG kullanarak uzman ve refakatçi çerçeveli ifadeleri karşılaştırmıştır. Uzman çerçevelendirmeye daha yüksek frontal-orta hat theta ERS ve daha az negatif baz çizgisine göre düzeltilmiş FCz-F6 theta ΔPLV eşlik ederken, koşul düzeyindeki davranışlar güven oranında, yanıt süresinde veya eksik yanıt oranında güvenilir bir fark göstermemiştir. Bu EEG bulguları, koşullu dolaylı modelin nöral doğrulanmasından ziyade keşifsel süreç düzeyi korelatlarıdır. Genel olarak, rol ipuçlarının birbirini dışlamayan yetkinlik odaklı ve ilişki odaklı değerlendirmeleri şekillendirdiği görülmektedir. Rol tasarımı, güveni sadece maksimize etmek yerine; yetkinlik sınırları, belirsizliğin iletilmesi, risk tabanlı uyarılar ve uygun yönlendirmeler aracılığıyla kalibre edilmiş güvenilirliği desteklemelidir.
Giriş
Tıbbi yapay zeka, artık görüntü tanıma, patoloji analizi ve ilaç keşfi gibi arka uç uygulamalarının yanı sıra hastaya yönelik hizmet arayüzlerini de kapsamaktadır. Sektör analizleri, sağlık hizmetleri yapay zeka pazarının 2033 yılına kadar büyümesinin devam edeceğini öngörmektedir1. Büyük dil modelleri, tıbbi yapay zeka sistemlerinin sağlık sorularını yanıtlamasına, test sonuçlarını yorumlamasına, bilgileri özetlemesine ve doğal dilde öneriler sunmasına olanak tanır2. Bu değişim, kullanıcının teknolojiyle olan ilişkisini dönüştürmektedir. Arka uçtaki analitik bir araç klinisyenler ve kurumlar tarafından değerlendirilirken, hastaya yönelik bir arayüzün rolünü, kanıtlarını, belirsizliklerini ve sınırlarını kullanıcılara iletmesi gerekir. Tıbbi yapay zeka; bir tanı asistanı, bir aile hekimi arayüzü veya bir sağlık yönetimi arkadaşı şeklinde karşımıza çıkabilir ve bunların her biri, kullanıcıların sistemin hizmet kimliğini nasıl anladığını şekillendirebilir. Bu sistemler hastalık konsültasyonlarına ve günlük sağlık yönetimine giderek daha fazla dahil oldukça, güven, teknolojiye yönelik bir tutum olmanın ötesine geçer. Güven; kullanıcıların bilgi paylaşıp paylaşmayacağını, önerileri güvenilir bulup bulmayacağını, sistemle etkileşime girip girmeyeceğini ve sağlık rehberliğine göre hareket edip etmeyeceğini etkiler. Bu nedenle güven, dijital sağlık platformları için merkezi bir tasarım ve yönetişim konusudur.
Tıbbi yapay zekanın kullanıcılar tarafından güvenilir ve kabul edilebilir görülüp görülmeyeceğini yalnızca teknik kapasite belirlemez. Sağlık hizmetleri konuşmalı ajanlarına ilişkin incelemeler, uygulamanın etkileşim kalitesine, klinik uygunluğa, şeffaflığa ve yaygınlaştırma koşullarına bağlı olduğunu göstermektedir3. Tıbbi yapay zeka için güvenilir kanıtlara yönelik güncel çalışmalar da benzer şekilde, iddialar amaçlanan kullanıma uygun kanıtlarla desteklenmediği sürece model performansının yetersiz olduğunu savunmaktadır4. Şeffaflık esastır; çünkü hastalar, güvenilirliği yalnızca akıcı bir dilden çıkarımlamak yerine, kapasite sınırlarını, belirsizliği ve bir önerinin temelini tanımlayabilmelidir5. Bilgi sistemleri araştırmaları da benzer şekilde, yapay zeka destekli tanının benimsenmesini; yorumlanabilirlik, gizlilik koruması ve arayüz ipuçlarının kabulü ortaklaşa şekillendirdiği bir güven yapılandırma problemi olarak çerçeveler6. Bu hususlar, dil modeli arayüzleri için önemlidir. Akıcılık, bir cevabın anlaşılmasını kolaylaştırabilir ancak sistemin klinik bilgiye sahip olup olmadığı, önerisinin kullanıcının durumuna uygun olup olmadığı ve ne zaman yetkin bir klinisyene başvurulmasının gerekli olduğu sorularını cevapsız bırakabilir. Asıl soru, tıbbi yapay zekanın bir cevap üretip üretemeyeceği değil, kullanıcıların bu cevabı uygun bir güven düzeyi ile değerlendirip değerlendiremeyeceğidir.
Tıbbi yapay zekaya duyulan güven, görev bağlamına karşı hassastır. Tıbbi yapay zekaya karşı direnç üzerine yapılan araştırmalar, kullanıcıların yüksek riskli kararlarda algoritmik önerileri reddedebileceğini, çünkü bir algoritmanın kendilerinin benzersizliğini hesaba katamayacağına inandıklarını göstermektedir7. Direnç evrensel değildir. Algoritma takdiri üzerine yapılan araştırmalar, görevler objektif ve kurallar daha net olduğunda insanların algoritmik yargıyı tercih edebileceğini belirtmektedir8. Çevrimiçi sağlık danışmanlığında, yapay zeka tarafından üretilen tavsiyelerdeki kişiselleştirme ve özen, güveni ve benimsemeyi etkilemektedir9. Geleneksel, dijital ve yapay zeka tabanlı konsültasyonları karşılaştıran ayrık seçim araştırmaları da benzer şekilde, tercihler ve güven beklentilerinin formatlar arasında farklılık gösterdiğini ortaya koymaktadır10. İnsan-yapay zeka ekip çalışması, güvenin insan uzmanlığından yapay zeka destekli bir hizmet düzenine aktarılması yoluyla direnci azaltabilir11. Bu nedenle, tıbbi yapay zekaya duyulan güven; algılanan risk, görev gereksinimleri, iletişim tarzı ve sistem değerlendirmesinin etkileşimi yoluyla gelişir. Hastalık danışmanlığı; belirsizliği, olası kayıpları, tanısal sonuçları ve hata maliyetlerini belirgin hale getirir. Sağlık danışmanlığı ise daha çok diyet, egzersiz, uyku, tedaviye uyum ve önleyici yönetim ile ilgilidir ve burada sürdürülebilir etkileşim ile ilişkisel erişilebilirlik daha fazla ağırlık taşıyabilir. Sonuç olarak, bir kullanıcı uzun vadeli sağlık yönetimi yerine olası bir hastalıkla ilgili yardım aradığında, aynı arayüz ipucu farklı şekilde yorumlanabilir.
Rol çerçeveleme, bu beklentilerin iletilebileceği bir arayüz özelliğidir. Tıbbi yapay zeka; profesyonel otoriteyi, yapılandırılmış akıl yürütmeyi, klinik sınırları ve yetkinlik kanıtlarını vurgulayan bir uzman olarak veya empatiyi, güven vermeyi, sosyal desteği ve sürekliliği vurgulayan bir refakatçi olarak çerçevelenebilir. Bu ayrım, sosyal algının iki boyutu olan yetkinlik ve sıcaklık ile ilişkilidir, ancak sadece yetkin bir sistem ile sıcak bir sistem arasında yapılan bir seçim değildir12. İletişim tarzı ve fail çerçevelemesi, konuşmalı ajanların değerlendirmelerini etkiler13. Mobil tıbbi uygulamalarda, sosyal ipuçları ve gizlilik endişeleri, güveni ve davranışsal niyeti ortaklaşa etkiler14. Sağlık hizmetlerindeki konuşmalı ajanlarda antropomorfik ipuçları; sosyal varlığı, güveni ve kabulü artırabilir, ancak aynı zamanda sistem yeteneklerini aşan beklentiler de yaratabilir15. İnsan-yapay zeka ekipleri üzerine yapılan araştırmalar, sıcaklık ve yetkinliğin farklı alıcılık biçimlerini öngördüğünü göstermektedir16. Yüksek riskli görevlerde güven; ekip rolü, görev bağlamı ve performans ihlali arasındaki uyuma bağlıdır17. Bir sohbet robotunun sosyal rolü ile performansı arasındaki tutarlılık da güven inşasını ve onarımını etkiler18. Bu nedenle, uzman ve refakatçi ipuçları, yalnızca konuşma tonunu değiştirmekle kalmayıp farklı değerlendirme standartlarını belirgin hale getirir.
İki boşluk kalmıştır. İlk olarak, yetkinlik ve ilişki odaklı ipuçlarının ilgisinin tıbbi görev talepleriyle nasıl değiştiği araştırmalarla açıklanmamıştır. Yapay zekaya duyulan insan güvenine ilişkin incelemeler bağlam bağımlılığını vurgulamakta ancak uzman ve refakatçi ipuçlarının hastalık ve sağlık konsültasyonları genelinde nasıl işlediğini netleştirmemektedir19. İkinci olarak, tıbbi yapay zekaya güven üzerine yapılan çalışmalar öz-bildirimlere dayanmakta ve rol çerçeveli değerlendirme ile ilişkili işleme süreçleri hakkında sınırlı kanıt sunmaktadır. Gizlilik, şeffaflık, hesap verebilirlik ve yanlılık da ön uç rol ipuçlarının yorumlanmasını kısıtlamaktadır20,21. Bu boşlukları gidermek için bu çalışma, değerlendirmeyi rol ipuçları ile bağlamla belirgin talepler arasındaki uyum yoluyla açıklayan rol uygunluğu teorisinden yararlanmaktadır22. Çalışma 1; rol çerçevelemesini, görev bağlamını ve algılanan profesyonellik ile sosyal varlık yoluyla paralel dolaylı ilişkileri incelemek için randomize bir 2 (rol: uzman vs. refakatçi) x 2 (görev: hastalık konsültasyonu vs. sağlık konsültasyonu) senaryo deneyi (N = 300) kullanmaktadır. Çalışma 2, uzman ve refakatçi çerçeveli ifadelere yanıt olarak theta bandı aktivitesini karşılaştırmak için ayrı bir denek içi EEG deneyi (N = 39) kullanmaktadır. Çalışma 1 davranışsal ilişkileri ve bağlamsal moderasyonu değerlendirirken; Çalışma 2, koşullu dolaylı modelin nöral bir doğrulaması yerine keşifsel bir süreç düzeyinde karşılaştırma sunmaktadır.
Teorik çerçeve ve hipotez geliştirme
Tıbbi yapay zekada rol çerçevelendirme
Tıbbi yapay zeka; hastalık riski, tedavi önerileri, sorumluluk ve etik sınırlar gibi risklerin yüksek olduğu ortamlarda faaliyet göstermektedir23. Bu nedenle, ön uç dilinin yetkinlik, kanıt ve sorumluluk sınırlarını kullanıcılar için daha veya daha az belirgin hale getirebilmesi sebebiyle rol çerçevelemesi önem taşımaktadır. Şeffaflık araştırmaları da benzer şekilde, tıbbi yapay zeka sistemlerinin yetkinlik sınırlarını ve kanıt temellerini iletmesi gerektiğini vurgulamaktadır5. Uzman tarzındaki yanıtlar; resmi terminoloji, yapılandırılmış akıl yürütme, sınır beyanları ve eylem önerileri aracılığıyla yetkinlik aktarırken, refakatçi tarzındaki yanıtlar; empati, güven verme ve iş birlikçi bir dil aracılığıyla ilişkisel destek aktarmaktadır. Bu ipuçları yalnızca arayüz süslemesi değildir: kullanıcıların bir sistemi değerlendirirken uyguladıkları standartları şekillendirirler24,25. Antropomorfizm sosyal tepkileri tetikleyebilir ancak gerçekçi olmayan beklentiler yaratabilir ve sorumluluk sınırlarını bulanıklaştırabilir26,27. İnsan-yapay zeka ekipleri ve sohbet botları üzerine yapılan araştırmalar; sıcaklığın, yetkinliğin, rol-bağlam uyumunun ve sosyal rol ile performans arasındaki tutarlılığın kabulü ve güveni etkilediğini göstermektedir16,17,18. Bu çalışmada rol uyumu, bir yapay zeka yanıtı tarafından iletilen ipuçları ile konsültasyon görevinde belirgin olan değerlendirme talepleri arasındaki hizalanmayı ifade etmektedir22.
Çift yollu güven: Algılanan profesyonellik ve sosyal varlık
Rol uyumu, ayrı bir öznel yapı olarak ölçülmek yerine, gözlemlenen rol-görev etkileşiminden çıkarılmıştır. Bu nedenle yorumlama, deneysel etkileşime bağlıdır ve katılımcıların bilinçli olarak bir rol uygunluğu hissettiklerini bildirdikleri anlamına gelmez. Güven; yetkinlik ve güvenilirliğe ilişkin bilişsel yargıları ve ilişkisel güvenlik ile rahatlığa ilişkin duygusal yargıları içerir28,29,30. Tıbbi yapay zeka kullanımında kullanıcılar, hem sistemin bir sağlık kararını destekleyip destekleyemeyeceğini hem de sistemle etkileşimin yeterince güvenli ve erişilebilir hissettirip hissettirmediğini değerlendirir. Uzman çerçevelemesi, yetkinlik odaklı değerlendirmeyi daha belirgin hale getirmelidir. Klinik karar destek araştırmalarından elde edilen kanıtlar, sistem akıl yürütmesine ilişkin açıklamaların ve bilgilerin güveni ve itimatı etkilediğini göstermektedir31. Çevrimiçi sağlık konsültasyonlarında, kişiselleştirme ve özen de güven ve kabul ile ilişkilendirilmektedir9. Algılanan profesyonellik, güvenle ilgili yetkinlik odaklı bir değerlendirmeyi kapsamaktadır25. Benzer şekilde, çevrimiçi sağlık konsültasyonları üzerine yapılan araştırmalar, kaynak güvenilirliğini kullanıcıların sağlık önerilerini kabul etmesiyle ilgili olarak tanımlamaktadır32. Bu nedenle, mevcut çalışma, uzman çerçevelemesinin daha yüksek algılanan profesyonellik ile ilişkili olup olmadığını test etmektedir.
H1: Arkadaş rolleri, uzman tarzı tıbbi yapay zekalara kıyasla daha düşük algılanan profesyonellik düzeyi oluşturur.
Refakatçi çerçevelemesi, ilişkisel değerlendirmeyi daha belirgin hale getirmelidir. Sosyal mevcudiyet, sistemin insan olduğuna dair bir inançtan ziyade, aracılı etkileşimin algılanan kişilerarası kalitesini ifade eder33. Bu durum, çevrimiçi hizmetlerde ve sağlık odaklı konuşmalı ajanlarda etkileşim kalitesi, güven ve kabul edilebilirlik ile ilişkilendirilmektedir15,34.
Sosyal mevcudiyet, kendini açmanın psikolojik maliyetini azaltabilir ve çevrim içi konsültasyon sırasında bilgi alışverişini destekleyebilir32. Bu nedenle, mevcut çalışma, refakatçi çerçevelemesinin daha yüksek sosyal mevcudiyet ile ilişkili olup olmadığını test etmektedir.
H2: Uzman rolleri, arkadaş tarzı Tıbbi Yapay Zekalara kıyasla daha düşük sosyal mevcudiyet oluşturur.
Algılanan profesyonellik ve sosyal mevcudiyet, güven ile paralel ve birbirini dışlamayan ilişkilendirmeler olarak ele alınmaktadır. Kritik öneme sahip otomasyon sistemlerine doğru şekilde güvenilmesi, yalnızca güvenin maksimize edilmesine değil; sistem yetkinliklerine, sınırlarına ve görev gereksinimlerine bağlıdır35.
H3: Algılanan profesyonellik ve sosyal mevcudiyet, eş zamanlı olarak modellendiklerinde güveni pozitif yönde yordamaktadır.
Görev bağlamının düzenleyici etkisi
Aynı rol ipuçları, farklı tıbbi görevler arasında farklı psikolojik ağırlıklar taşıyabilir. Görev-teknoloji uyumu, rol ipuçlarının görev gereksinimleriyle örtüşüp örtüşmediğini incelemek için bağlamsal bir gerekçe sunar36. Hastalık konsültasyonu; daha yüksek belirsizlik, kayıp riski ve hata maliyetleri içerdiğinden, profesyonellik, doğruluk ve net sınırları özellikle belirgin hale getirir7,37. Bu nedenle uzman ipuçları, bu taleplerle refakatçi ipuçlarından daha yakından uyumlu olmalıdır. Sağlık danışmanlığı ise uzun vadeli sağlık yönetimi, davranışsal süreklilik ve etkileşimin devamlılığına odaklanır. Yapay zeka tabanlı klinik karar destek sistemleri ve sağlık sohbet ajanları üzerine yapılan incelemeler; bağlamsal bilgilerin, uygulanabilirliğin, etkileşimin ve uygulama koşullarının önemini vurgulamaktadır3,38,39.
Bu çalışma, algılanan profesyonellik açısından uzman-refakatçi farkının, sağlık danışmanlığına kıyasla hastalık danışmanlığında daha fazla olacağını öngörmektedir. Sosyal mevcudiyet üzerindeki anlamlı olmayan bir etkileşimi, değişmezliğin kanıtı olarak değerlendirmemektedir. Hipotez şu şekilde önerilmiştir:
H4: Görev bağlamı, uzman rollerinin algılanan profesyonellik üzerindeki etkisini önemli ölçüde modüle eder. Bu etki, hastalık konsültasyonunda sağlık konsültasyonuna göre daha güçlüdür.
Protokol
Araştırma özeti
Çalışma, Helsinki Deklarasyonu'na uygun olarak yürütülmüş ve hem çevrimiçi senaryo deneyini hem de EEG deneyini kapsayan Huaqiao Üniversitesi Etik Kurulu (M2025021) tarafından onaylanmıştır. Tüm katılımcılar bilgilendirilmiş onam vermiş ve çalışma tamamlandığında telafi ödemesi almıştır.
Bu makale birbirini tamamlayan iki çalışma içermektedir (bkz. Şekil 1). Çalışma 1; rol çerçeveleme ve görev bağlamı etkilerini tahmin eden, ölçüm yapısını değerlendiren ve algılanan profesyonellik ile sosyal mevcudiyet üzerinden paralel koşullu dolaylı ilişkileri test eden randomize 2 × 2 senaryo deneyidir. Çalışma 2; uzman ve arkadaş çerçeveli ifadeler altında theta bandı aktivitesini karşılaştıran ve keşifsel süreç düzeyinde bir karşılaştırma olarak yorumlanan, denek içi bir EEG deneyidir. Çalışmalar farklı düzeylerde davranışsal ve nöral kanıtlar sunmaktadır; bunlar tek bir ilerleyici mekanizma olarak ele alınmamıştır.
Çalışma 1: Senaryo deneyi
Katılımcılar ve tasarım
Çalışma 1'de, rol çerçeveleme (uzman ile arkadaş) ve görev bağlamı (hastalık konsültasyonu ile sağlık konsültasyonu) değişkenlerini içeren dengeli 2 × 2 gruplar arası bir desen kullanılmıştır. Orijinal G*Power hesaplaması, orta düzeyde bir omnibus ANOVA etkisi (f = 0.25), α = .05 ve güç = .80 varsaymış ve minimum 128 katılımcı gerektiğini göstermiştir40. Bu hesaplama koşullu dolaylı etkilere göre uyarlanmadığı için, moderatörlü aracılığa dair bir güç kanıtı olarak değil, orijinal örneklem alım temeli olarak raporlanmıştır. N = 300 ve dört dengeli hücre ile yapılan bir duyarlılık analizi, α = .05 düzeyinde f = 0.162 (kısmi η2 = .026) değerindeki bir etkileşimi saptamak için %80 güce işaret etmiştir.
Ek olarak, 300 vakalık SPSS anket veri setini kullanarak modere edilmiş aracılık indeksleri için post hoc simülasyon tabanlı bir güç analizi gerçekleştirdik. Simülasyon, ampirik artıkların yeniden örneklenmesi yoluyla, uyarlanmış paralel aracılı modelden 1.000 dengeli 2 × 2 örneklem oluşturmuştur; simüle edilen her veri setinde 500 vakalık yeniden örneklenmiş yüzdelik bootstrap güven aralıkları kullanılmıştır. Güven aralığının sıfırı dışarıda bırakma olasılığı tahmini profesyonellik indeksi için .698, sosyal varlık indeksi için .157 ve iki indeks arasındaki doğrudan fark için .279 olarak bulunmuştur. Bu analiz; gözlemlenen katsayılara, artık dağılımlarına ve model spesifikasyonuna bağlıdır ve a priori bir örneklem büyüklüğü gerekçelendirmesi değildir. Eksiksiz post hoc simülasyon tabanlı güç analizi Ek Tablo S1'de sunulmuştur.
Üç yüz katılımcı Credamo aracılığıyla seçilmiş ve rastgele dört koşula atanmıştır (her hücre için n = 75). Örneklem 109 erkek (%36,3) ve 191 kadından (%63,7) oluşmuştur; katılımcıların %43,7'si 21-30 yaş, %41,3'ü 31-40 yaş aralığında olup %69,7'si lisans derecesine sahiptir. Gerekli tüm anket maddeleri tamamlanmıştır. Özel bir dikkat kontrol maddesi veya önceden kaydedilmiş tamamlama süresi dışlama kriteri kullanılmamış ve hiçbir katılımcı hariç tutulmamıştır. Medyan tamamlama süresi 268 s (aralık = 67-1.894 s) olarak belirlenmiştir. Tamamlama süresinin beşinci yüzdelik diliminin altındaki yanıtların hariç tutulduğu bir post hoc sağlamlık analizi (<125 s; kalan n = 285), olağandışı derecede hızlı yanıt vermeye karşı hassasiyeti değerlendirmiştir. Detaylı manipülasyon kontrol istatistikleri ve tamamlama süresi hassasiyet analizleri Ek Tablo S2'de raporlanmıştır.
Deneysel uyaranlar ve prosedür
Uyaran materyalleri, bir görev senaryosu tanıtımı ve bir yapay zeka doktor diyalog yanıtından oluşarak toplam dört tam deneysel set meydana getirmiştir. Hastalık konsültasyonu senaryosu, katılımcılardan tekrarlayan gece göğüs sıkışması ve çarpıntı yaşadıklarını ve acil hastane bakımının gerekip gerekmediği konusundaki endişelerini hayal etmelerini istemiştir. Sağlık konsültasyonu senaryosu ise katılımcılardan genel olarak sağlıklı olduklarını ve kişiselleştirilmiş bir diyet ve egzersiz planı aradıklarını hayal etmelerini istemiştir. Her görev kategorisi bir senaryo ile temsil edilmiştir; bu nedenle sonuçlar, tüm hastalık ve sağlık konsültasyonlarına genellenmek yerine bu iki senaryo ile sınırlandırılmıştır.
Kullanılan dört anket ekran görüntüsünün tamamında aynı simge kullanılmış ve sistem adı olan Medical AI (DiagnosPro) görüntülenmiştir; böylece görüntülenen kimlik tüm koşullar boyunca sabit tutulmuştur. Uzman çerçeveli yanıtlar; yapılandırılmış analiz, risk veya kanıt ifadeleri, yönlendirici dil ve açık eylem önerileri kullanmıştır. Refakatçi çerçeveli yanıtlar ise empati, güven verme, iş birlikçi ifadeler ve esnek öneriler kullanmıştır. Bu nedenle manipülasyon, role uygun iletişim ve bilgi ipuçlarından oluşan bir paketi temsil etmiştir; rol çerçevelemesini belirlilikten, uygulanabilirlikten, kesinlikten, tıbbi detaydan veya duygusal destekten izole etmemiştir. Paylaşılan DiagnosPro ismi de tüm koşullarda bir uzman ipucu vermiş olabilir. Uyaranların tam seti Ek Dosya 1'de sunulmuştur.
Katılımcılar önce bilgilendirilmiş onam formunu okumuş ve ardından rastgele dört deneysel koşuldan birine atanmıştır. Senaryoyu ve diyalog uyarımını okuduktan sonra, yanıtlarına dayalı olarak anketi doldurmuşlardır. Anket, manipülasyon kontrolleri ile başlamış, ardından algılanan profesyonellik, sosyal mevcudiyet, güven ve demografik ölçümlerle devam etmiştir. Prosedür yaklaşık 15 dk sürmüştür.
Kullanılan tüm ölçekler, 1'in kesinlikle katılmıyorum ve 7'nin kesinlikle katılıyorum anlamına geldiği 7'li Likert puanlamasıyla değerlendirilmiştir. Algılanan profesyonellik üç madde ile ölçülmüştür: ‘Bu tıbbi yapay zeka tıbbi tavsiye verme yeteneğine sahip’, ‘Bu tıbbi yapay zeka çok profesyonel görünüyor’ ve ‘Bu tıbbi yapay zeka tıp alanında bir uzmandır’ (α = .883)41. Sosyal mevcudiyet üç madde ile ölçülmüştür: ‘Bu tıbbi yapay zeka ile etkileşimde insani bir dokunuş hissettim’, ‘Bu tıbbi yapay zeka ile etkileşim bana yakınlık hissettirdi’ ve ‘Bu tıbbi yapay zeka etkileşim sırasında cana yakın göründü’ (α = .932)42. Bilişsel güven üç maddeden oluşmuştur: ‘Tavsiye vermek için gerekli becerilere sahip olduğu için bu tıbbi yapay zekaya güvenebilirim’, ‘Bu tıbbi yapay zeka tarafından verilen tavsiyelerin doğruluğuna güveniyorum’ ve ‘Bu tıbbi yapay zeka, sağlık sorunumu çözmek için yeterli kapasiteye sahip’ (α = .837). Duygusal güven üç maddeden oluşmuştur: ‘Bu tıbbi yapay zeka bana sıcaklık ve ilgi hissettiriyor’, ‘Bu tıbbi yapay zekaya güvenmek beni güvende hissettiriyor çünkü sağlığımla ilgilendiği görülüyor’ ve ‘Bu tıbbi yapay zekanın bana kasıtlı olarak zararlı herhangi bir şey yapmayacağına inanıyorum’ (α = .700). Genel güven, altı güven maddesinin tamamının ortalaması olarak hesaplanmıştır (α = .784). Bu ölçümler, birbirini dışlayan yapılar yerine yetkinlik odaklı, kişilerarası, bilişsel güven, duygusal güven ve genel güven sonuçları olarak analiz edilmiştir.
Analiz dört aşamada gerçekleştirilmiştir. İlk olarak, doğrulayıcı faktör analizi ile önerilen dört faktörlü model, iki faktörlü ve tek faktörlü alternatiflerle karşılaştırılmıştır; bileşik güvenirlik, ortalama açıklanan varyans, gizil korelasyonlar ve heterotrait-monotrait oranları incelenmiştir. İkinci olarak, algılanan profesyonellik, sosyal mevcudiyet, bilişsel güven, duyuşsal güven ve genel güven için ana ve etkileşim etkileri; hücre ortalamaları, güven aralıkları ve kısmi η2 ile birlikte tam 2 x 2 faktöriyel modellerle tahmin edilmiştir. Tahmin edilen marjinal ortalamalar ve %95 güven aralıkları Şekil 2'de gösterilmiştir. Üçüncü olarak, PROCESS 4.2 beta Model 7 kullanılarak, 5.000 yüzdelik-bootstrap örneği ile43 algılanan profesyonellik ve sosyal mevcudiyet eş zamanlı olarak paralel aracı değişkenler şeklinde modele dahil edilmiştir. Rol çerçevelemesi 1 = uzman ve 2 = arkadaş; görev bağlamı ise 1 = hastalık konsültasyonu ve 2 = sağlık konsültasyonu olarak kodlanmıştır. Ortak-yeniden örnekleme bootstrap yöntemi, moderasyonlu aracılığın iki indeksi ile doğrudan karşılaştırılmıştır. Dördüncü olarak, bilişsel ve duyuşsal güven keşfedici sonuçlar olarak ayrı ayrı analiz edilmiştir. Aracı değişkenler ve sonuçlar eş zamanlı olarak ölçüldüğü için, tahminler nedensel psikolojik mekanizmalardan ziyade aracılığa uygun dolaylı ilişkiler olarak yorumlanmıştır.
Çalışma 2: EEG deneyi
Katılımcılar
Çalışma 2'ye 40 katılımcı dahil edilmiştir. En az bir deneysel koşulda artefaktlarla kirlenmiş denemelerin %30'ü aşması nedeniyle bir katılımcı hariç tutulmuş ve final EEG analizlerinde 39 katılımcı kalmıştır. Bu kriter, değerlendirmeye alınan her katılımcının her koşuldaki denemelerin en az %70'ine katkıda bulunmasını sağlamıştır. Tüm katılımcılar yazılı bilgilendirilmiş onam vermiş ve deney sonunda ödeme almıştır. Demografik bilgiler, değerlendirmeye alınan tüm EEG kayıtlarıyla eşleştirilemediği için final EEG örneği için özetlenmemiştir.
Deneysel uyaranlar ve prosedür
Deney, standart bir EEG laboratuvarında, uyaranların E-Prime 2.1 ile sunulduğu denek içi bir desen kullanılarak gerçekleştirilmiştir. Katılımcılardan, tıbbi bir yapay zeka sistemiyle etkileşim kurduklarını hayal etmeleri ve her bir tıbbi konsültasyon senaryosu için sisteme olan güvenlerini değerlendirmeleri istenmiştir. Deneyde, uzman tipi ve refakatçi tipi varyantlar dahil olmak üzere, tıbbi yapay zeka sisteminin algılanan rolü manipüle edilmiştir.
Toplam 40 adet Çince cümle uyaranı oluşturulmuştur. Uzman tipi koşul 'Tıbbi YZ uzmanı' ile başlayan 20 uyaran içerirken, refakatçi tipi koşul 'Tıbbi YZ refakatçisi' ile başlayan 20 paralel uyaran içermiştir. Tıbbi senaryolar; tıbbi öykü sorma, muayene raporlarını analiz etme, kalp atış hızı verilerini değerlendirme, genetik testleri yorumlama, hastalık riskini belirleme ve tedavi planları önerme gibi profesyonel tanısal işlevlerin yanı sıra, fiziksel durumla ilgili endişe gösterme, uyku kalitesini sorma, anksiyete giderme, sağlık verilerini kaydetme, tedaviye uyumu teşvik etme ve günlük sağlık ipuçları sağlama gibi destekleyici sağlık yönetimi işlevlerini de kapsamıştır. Bu nedenle koşullar, anlamsal içerik ve karmaşıklık açısından da farklılık göstermiştir; bağımsız bir uyaran eşleştirmesi veya ön test uygulanmamıştır.
Resmi deneyden önce katılımcılar kısa bir uygulama bloğu tamamladılar. Her deneme 500 ms'lik bir fiksasyon artı ile başladı, bunu 300–500 ms'lik değişken bir boşluk aralığı ve 1.600 ms boyunca sunulan bir Tıbbi Yapay Zeka ifadesi izledi. Ardından katılımcılar, güveni belirtmek için F tuşuna veya güvensizliği belirtmek için J tuşuna basarak kendi hızlarında ikili bir güven değerlendirmesi yaptılar (bkz. Şekil 3). Uzman ve yardımcı çerçeveli ifadeler randomize edilmiş sırayla sunuldu. E-Prime görev kayıtları, her görev kaydı başına 80 resmi deneme olduğunu gösterdi: 40 uzman ve 40 yardımcı denemesi; her rol için 20 benzersiz ifadenin her biri iki kez sunulmuştur.
Davranışsal görev verileri
Davranışsal görev verileri, final EEG örneklemindeki 39 katılımcıdan 38'si için kullanılabilirdi; bir katılımcının E-Prime görev kaydı kullanılamaz durumdaydı. Bu nedenle, davranışsal analizlerde N = 38 kullanılmıştır. Ayrıntılı davranışsal sonuçlar ve örneklem dökümü Ek Tablo S3'te sunulmuştur. Güven, F tuşu yanıtı olarak kodlanmış; J tuşu yanıtları ise güvensizliği belirtmiştir. Boş yanıtlar veya 0 ms olarak kaydedilen yanıt süreleri eksik veri olarak kodlanmıştır. Güven oranı, yanıtlanan denemeler üzerinden hesaplanmış ve yanıt süresi, yanıtlanan denemeler üzerinden özetlenmiştir. Analiz için mevcut olan nöral veriler, koşul bazında toplanmış ölçümleri içermekteydi ancak deneme düzeyinde EEG indeksleri veya her davranış kaydını kendi EEG kaydına bağlayan doğrulanmış bir tanımlayıcı bulunmamaktaydı; bu nedenle, EEG ve güven yargılarının deneme düzeyinde karma modeli tahmin edilmemiştir.
EEG kaydı ve analizi
Elektrot-cilt empedansını 5 kOhm altında tutmak için Quik-Gel iletken elektrolit jel kullanılmıştır. FCz cihazın varsayılan çevrimiçi referansı olarak belirlenmiş ve örnekleme hızı 1.000 Hz olarak ayarlanmıştır. Bilateral mastoidlerin ortalamasının çevrimdışı referanslanması, CURRY'nin yerleşik yeniden referanslama fonksiyonu ile gerçekleştirilmiştir; FCz korunmuş ve yeni referansa göre otomatik olarak yeniden yapılandırılmış olup herhangi bir özel yeniden yapılandırma komutu veya betiği kullanılmamıştır. Sonraki çevrimdışı işlemler, MATLAB R2020b üzerinde EEGLAB44 ve ICLabel45 kullanılarak yapılmıştır. Veriler 500 Hz'e alt örneklenmiş ve 0.1 ile 40 Hz arasında bant geçiren filtrelemeden geçirilmiştir. Hatalı kanallar ve ciddi şekilde kontamine olmuş veri segmentleri görsel inceleme yoluyla belirlenmiş ve çıkarılmıştır; herhangi bir otomatik interpolasyon veya otomatik segment reddetme eşiği uygulanmamıştır. Ardından varsayılan EEGLAB runica uygulaması (Infomax ICA) kullanılmış ve ICLabel bir artefakt sınıfına (örneğin göz, kas, kardiyak, hat gürültüsü veya kanal gürültüsü aktivitesi) en az .70 olasılık atadığında ilgili bileşenler çıkarılmıştır. Her iki koşuldan herhangi birinde %30'tan fazla artefakt kontamine denemesi olan katılımcılar hariç tutularak, her koşulda en az %70 deneme korunması sağlanmıştır. Epoklar −1.000 ile 1.996 ms arasını kapsamıştır. Fonksiyonel bağlantısallık analizi için ön işlemesi yapılmış veriler ayrıca 250 Hz'e alt örneklenmiş ve faz senkronizasyonu kestirimi öncesinde P7, P8, F7 ve F8 dahil olmak üzere periferik elektrotlar hariç tutulmuştur.
Frontal-orta hat kafa derisi bölgelerinde kaydedilen teta aktivitesi, bilişsel kontrol gereksinimleri tarafından tetiklenen hesaplamalarla ilişkilendirilmiştir46. Medyal ve lateral frontal elektrot bölgeleri arasındaki teta bandı faz senkronizasyonu da kontrolle ilgili işleme süreçleri sırasındaki koordinasyon ile ilişkilendirilmiştir47. Özellikle, çatışma veya hata tespitini takiben FCz ve F6 gibi bölgeler arasında artmış teta bandı faz senkronizasyonu gözlemlenmiştir48. Bu kafa derisi ölçümleri bilişsel kontrole özgü olmadığından, burada tek bir bilişsel mekanizmanın doğrudan çıktıları yerine yakınsayan süreç göstergeleri olarak ele alınmışlardır.
İlk olarak, uyaran sonrası 800–1,000 ms penceresi içinde, 4–8 Hz bandında frontal-orta hat teta olayla ilişkili senkronizasyonu (ERS) nicelleştirilmiştir. ERS, −500 ila −200 ms uyaran öncesi bazal çizgiye göre hesaplanan bağıl güç değişimi kullanılarak zaman-frekans analizi ile hesaplanmıştır. Pozitif değerler güç artışını (senkronizasyon), negatif değerler ise güç baskılanmasını (desenkronizasyon) göstermektedir. İkinci olarak, ön işlemeden geçmiş veriler 250 Hz'e daha fazla alt örnekleme yapıldıktan ve P7, P8, F7 ve F8 dahil olmak üzere periferik elektrotlar hariç tutulduktan sonra fonksiyonel bağlantısallık tahmin edilmiştir. FCz ve F6 arasındaki teta bandı faz kilitleme değeri hesaplanmadan önce kısa süreli Fourier dönüşümü (STFT) uygulanmıştır. Bazal çizgiyle düzeltilmiş PLV değişimi (ΔPLV), −600 ila −200 ms uyaran öncesi bazal çizgiye göre hesaplanmıştır. Ham PLV 0 ile 1 arasında sınırlıdır; bu nedenle, negatif ΔPLV değerleri negatif faz kilitlemeden ziyade bazal çizgiye göre bir azalmayı ifade eder. Bu saç derisi ölçümleri, kontrolle ilgili işleme ve prefrontal koordinasyonla ilişkili keşifsel paternler olarak yorumlanmaktadır; belirli bir bilişsel süreci veya nöral kaynağı doğrudan tanımlamazlar.
Sonuçlar
Çalışma 1: Senaryo-deney sonuçları
Ölçüm modeli. Dört faktörlü model, iki faktörlü ve tek faktörlü alternatiflerden daha iyi uyum göstermiş olsa da mutlak uyum karışık düzeydeydi: χ2(48) = 223.93, p < .001; CFI = .935; TLI = .911; RMSEA = .111; SRMR = .140. Standartlaştırılmış yükler .382 ile .937 arasında değişti. Bileşik güvenirlik değerleri algılanan profesyonellik için .886, sosyal varlık için .932, bilişsel güven için .840 ve duygusal güven için .709 olarak gerçekleşti; karşılık gelen AVE değerleri ise .722, .821, .636 ve .474 idi. Ayırt edici geçerlilik sınırlıydı: HTMT değerleri algılanan profesyonellik ile bilişsel güven arasında .935 ve sosyal varlık ile duygusal güven arasında .926 olarak belirlendi. Bu nedenle, koşullu süreç bulguları ihtiyatla yorumlanmış ve boyuta özgü güven analizleri keşfedici düzeyde tutulmuştur (Tablo 1).
Manipülasyon kontrolleri. Uzman-çerçeveleme katılımcıları (n = 150, M = 5.57, SD = 1.18), Tıbbi YZ'yi refakatçi-çerçeveleme katılımcılarına (n = 150, M = 3.21, SD = 1.76) kıyasla daha uzman benzeri olarak değerlendirmiştir. Varyanslar farklı olduğu için (F = 47.42, p < .001), Welch testi kullanılmıştır; t(259.90) = 13.63, p < .001, ortalama fark = 2.36, 95% CI [2.02, 2.70]. Hastalık-durumu katılımcıları (n = 150, M = 2.51, SD = 1.53), sağlık-durumu katılımcılarına (n = 150, M = 5.98, SD = 1.22) göre daha düşük önleyici sağlık oryantasyonu puanları vermiştir; F = 10.96, p = .001; Welch’s t(284.11) = −21.70, p < .001, ortalama fark = −3.47, 95% CI [−3.79, −3.16]. Varyanslar eşit olmadığında Welch serbestlik dereceleri N − 2'ye eşit değildir; tüm analizlerde N = 300 kullanılmıştır.
Deneysel koşullara göre tanımlayıcı istatistikler. Uzman çerçevelemesinde, hastalık ve sağlık danışmanlığı sırasıyla 5,69 (SD = 0,83) ve 5,85 (SD = 0,63) algılanan profesyonellik ortalamaları; 4,28 (SD = 1,54) ve 4,25 (SD = 1,64) sosyal mevcudiyet ortalamaları; 5,45 (SD = 0,86) ve 5,28 (SD = 0,87) genel güven ortalamaları üretmiştir. Refakatçi çerçevelemesinde, hastalık ve sağlık için karşılık gelen ortalamalar algılanan profesyonellik için 4,52 (SD = 1,47) ve 5,25 (SD = 0,94); sosyal mevcudiyet için 5,68 (SD = 1,07) ve 5,93 (SD = 0,74); genel güven için ise 5,30 (SD = 1,02) ve 5,61 (SD = 0,64) olarak gerçekleşmiştir. Tablo 2, koşula özgü tüm güven aralıklarını ve eksiksiz faktöriyel testleri raporlamaktadır.
Tam faktöriyel sonuçlar. Algılanan profesyonellik, bir rol çerçeveleme ana etkisi, F(1, 296) = 56.92, p < .001, kısmi η2 = .161, bir görev bağlamı ana etkisi, F(1, 296) = 14.37, p < .001, kısmi η2 = .046 ve bir rol × görev etkileşimi, F(1, 296) = 5.89, p = .016, kısmi η2 = .020 göstermiştir. Sosyal varlık, bir rol çerçeveleme ana etkisi, F(1, 296) = 105.57, p < .001, kısmi η2 = .263 göstermiş; ancak ne görev ana etkisi, F(1, 296) = 0.59, p = .442, ne de etkileşim, F(1, 296) = 0.84, p = .359 anlamlı bulunmuştur. Bu son sonuç, moderasyonun tespit edilmediğini göstermektedir; ancak görevler arası eşdeğerliği kanıtlamaz. Bilişsel güven için rol × görev etkileşimi anlamlıdır, F(1, 296) = 5.60, p = .019, kısmi η2 = .019; buna karşılık etkileşim, duygusal güven için anlamlı değildir, F(1, 296) = 3.48, p = .063, kısmi η2 = .012. Genel güven, rol çerçeveleme ana etkisi, F(1, 296) = 0.81, p = .369 veya görev ana etkisi, F(1, 296) = 0.55, p = .459 göstermemiş; ancak rol × görev etkileşimi anlamlı bulunmuştur, F(1, 296) = 5.78, p = .017, kısmi η2 = .019. Hastalık konsültasyonunda, genel güven refakatçi ve uzman çerçevelemesi arasında farklılık göstermemiştir, ortalama fark = −0.15, SE = 0.14, t(296) = −1.06, p = .288, 95% CI [−0.42, 0.13]. Sağlık konsültasyonunda ise genel güven, refakatçi çerçevelemesi altında daha yüksektir, ortalama fark = 0.33, SE = 0.14, t(296) = 2.34, p = .020, 95% CI [0.05, 0.60].
Paralel koşullu dolaylı ilişkiler. Algılanan profesyonellik ve sosyal mevcudiyet aynı anda girildiğinde, her ikisinin de genel güven ile pozitif ilişkili olduğu görülmüştür: sırasıyla b = 0.4872, SE = 0.0258, p < .001, 95% CI [0.4294, 0.5460] ve b = 0.3293, SE = 0.0208, p < .001, 95% CI [0.2762, 0.3829]. Doğrudan rol-çerçeveleme ilişkisi anlamlı değildi, b = 0.0119, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361]. Profesyonellik dolaylı ilişkileri hastalık konsültasyonunda −0.5695, 95% bootstrap CI [−0.7687, −0.3851] ve sağlık konsültasyonunda −0.2923, 95% bootstrap CI [−0.4288, −0.1634] olarak bulunmuştur. Sosyal mevcudiyet dolaylı ilişkileri hastalık konsültasyonunda 0.4625, 95% bootstrap CI [0.3165, 0.6091] ve sağlık konsültasyonunda 0.5532, 95% bootstrap CI [0.3855, 0.7383] değerindeydi (Tablo 3). Algılanan profesyonellik üzerinden moderatörlü aracılık indeksi 0.2772, 95% bootstrap CI [0.0594, 0.5035] iken, sosyal mevcudiyet üzerinden olan indeks 0.0907, 95% bootstrap CI [−0.0984, 0.3008] idi. İndeksler arasındaki doğrudan bootstrap karşılaştırması anlamlı değildi, fark = 0.1864, 95% bootstrap CI [−0.0856, 0.4447]. Bu nedenle sonuçlar, profesyonellik ile olan dolaylı ilişkinin bağlamsal moderasyonunu desteklemekte, ancak iki ilişkinin istatistiksel olarak farklı bağlamsal moderasyonlarını ortaya koymamaktadır.
Keşifsel güven boyutu analizleri. Bilişsel güven için, profesyonellik ve sosyal mevcudiyet moderatörlü-aracılık indeksleri arasındaki karşıtlık pozitifti, fark = 0.3707, %95 bootstrap CI [0.0493, 0.6996]. Duyuşsal güven için ilgili karşıtlık desteklenmedi, fark = 0.0022, %95 bootstrap CI [−0.3421, 0.3127]. Her iki aracı değişken, her iki güven boyutuyla da pozitif ilişkilerini korudu ve bu durum özel etkilerden ziyade çapraz yollara işaret etti. Yüksek HTMT değerleri göz önüne alındığında, bu sonuçlar bilişsel ve duyuşsal mekanizmaların kesin bir ayrımı olarak yorumlanmamalıdır.
Post hoc modere edilmiş-aracılık gücü. Uyarlanmış model ve artık-yeniden örnekleme varsayımları altında, yüzdelik-bootstrap güven aralığının sıfırı dışlama tahmini olasılığı profesyonellik indeksi için .698, sosyal mevcudiyet indeksi için .157 ve bunların doğrudan farkı için .279 idi (1.000 simülasyon; simülasyon başına 500 bootstrap yeniden örneği). Bu gözlemlenen-tasarım tahminleri, desteklenen profesyonellik indeksinin ve anlamlı olmayan doğrudan karşılaştırmanın neden farklı bağlamsal moderasyonun kesin kanıtı olarak yorumlanmaması gerektiğini açıklamaktadır.
Tamamlama süresi sağlamlığı. 125 s altındaki 15 yanıt hariç tutulduğunda, 285 vaka kalmıştır. Genel-güven etkileşimi anlamlı kalmıştır, p = .029; profesyonellik indeksi desteklenmeye devam etmiştir, %95 bootstrap GA [0.0242, 0.4827]; ve düzenlenmiş-aracılık indeksleri arasındaki karşıtlık anlamsız kalmıştır, %95 bootstrap GA [−0.1027, 0.4506]. Temel sonuçlar, en hızlı %5'lik yanıt grubuna bağlı değildir.
Çalışma 2: EEG sonuçları
Frontal-midline theta ERS. Nihai analitik örneklemde (N = 39), 4–8 Hz, 800–1,000 ms penceresindeki theta ERS, uzman çerçevelemede (M = 0.2948, SD = 0.8218), refakatçi çerçevelemeye (M = −0.0422, SD = 1.2155) göre daha yüksekti; ortalama fark = 0.3369, 95% CI [0.0125, 0.6614], t(38) = 2.10, p = .042, Cohen’s dz = 0.337, kısmi η2 = .104. Rapor edilen iki eşleştirilmiş EEG sonucu için Holmle düzeltilmiş p-değeri .042 idi. Bu fark, söz konusu görev penceresinde farklılaşmış theta-bandı işlemesine işaret etmektedir; tek başına theta ERS spesifik bir psikolojik süreci tanımlamaz.
FCz-F6 baz çizgisi düzeltmeli theta PLV değişimi (ΔPLV). Nihai analitik örneklemde (N = 39), theta ΔPLV değeri uzman çerçevelemesinde (M = −0.0111, SD = 0.0546), refakatçi çerçevelemesine (M = −0.0350, SD = 0.0473) kıyasla daha az negatifti; ortalama fark = 0.0239, 95% CI [0.0058, 0.0420], t(38) = 2.68, p = .011, Cohen’s dz = 0.429, partial η2 = .159. Raporlanan iki eşleştirilmiş EEG sonucu genelindeki Holm-düzeltmeli p değeri .022 idi. Bu örüntü, uzman çerçevelemesi altında baz çizgisine göre theta faz tutarlılığındaki daha küçük bir azalmayı temsil etmektedir; tek başına daha güçlü bir prefrontal kontrolü veya spesifik bir bilişsel mekanizmayı kanıtlamaz (bkz. Şekil 4 ve Tablo 4).
Davranışsal görev sonuçları. Analiz edilen 38 görev kaydında, güven-yanıt oranı uzman çerçevelemesinde %83,1 (SD = 15,8%) ve refakatçi çerçevelemesinde %82,4 (SD = 17,5%) olarak belirlenmiştir; ortalama fark = 0,7 yüzde puanı, 95% CI [−0.9, 2.4], t(37) = 0.91, p = .371, dz = 0.147. Ortalama yanıt süreleri sırasıyla 828.7 ms (SD = 204.6) ve 826.1 ms (SD = 208.9) olarak gerçekleşmiştir; ortalama fark = 2.5 ms, 95% CI [−14.0, 19.1], t(37) = 0.31, p = .758, dz = 0.050. Eksik yanıt oranları sırasıyla %6,3 (SD = 7,4%) ve %5,2 (SD = 6,3%) olarak bulunmuştur; ortalama fark = 1,1 yüzde puanı, 95% CI [−1.0, 3.1], t(37) = 1.05, p = .302, dz = 0.170.
Veri Kullanılabilirliği Beyanı:
Kimliksizdirilmiş Çalışma 1 anket verileri, ön işlemesi yapılmış EEG dosyaları ve Çalışma 2'yi destekleyen toplu EEG çıktı dosyaları, Open Science Framework (OSF) üzerinde https://doi.org/10.17605/OSF.IO/JKSP7 adresinden kamuya açık olarak erişilebilirdir. Ek materyaller; eksiksiz deneysel uyaranları (Ek Dosya 1), manipülasyon kontrollerini, ek davranışsal analizleri, post hoc güç analizlerini ve destekleyici metodolojik bilgileri içermektedir.
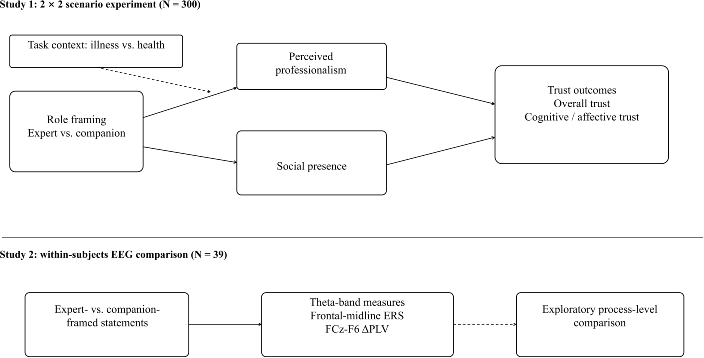
Şekil 1Araştırma çerçevesi. Çalışma 1; rol çerçevelemesini, görev bağlamını ve algılanan profesyonellik ile sosyal mevcudiyet aracılığıyla paralel dolaylı ilişkileri inceleyen 2 × 2 senaryolu bir deneydir (N = 300). Çalışma 2 ise uzman ve refakatçi olarak çerçevelenen ifadelerin keşifsel bir elektroensefalogram karşılaştırmasını sunar (N = 39); bu çalışma koşullu dolaylı modeli doğrudan test etmemektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
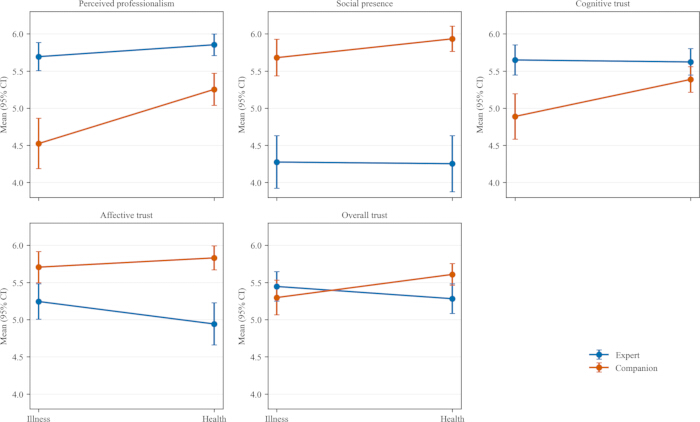
Şekil 2. Algılanan profesyonellik, sosyal mevcudiyet, bilişsel güven, duygusal güven ve genel güven için rol-çerçeveleme × görev-bağlam grafikleri. Noktalar hücre ortalamalarını ve hata çubukları %95 güven aralıklarını göstermektedir (hücre başına n = 75). Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
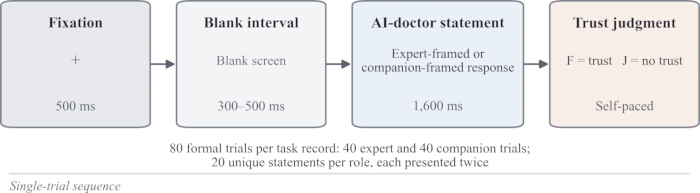
Şekil 3. Çalışma 2'deki tek deneme sekansı. Her deneme 500 ms fiksasyon, 300–500 ms arası değişken bir boş aralık, 1.600 ms'lik uzman veya refakatçi çerçeveli bir yapay zeka doktor beyanı ve katılımcı hızında gerçekleştirilen ikili bir güven değerlendirmesinden oluşmuştur. E-Prime görev kayıtları, görev kaydı başına 80 resmi deneme olduğunu, her rol çerçeveleme koşulu için 40 deneme yapıldığını ve her koşulda 20 benzersiz beyanın her birinin iki kez sunulduğunu göstermiştir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
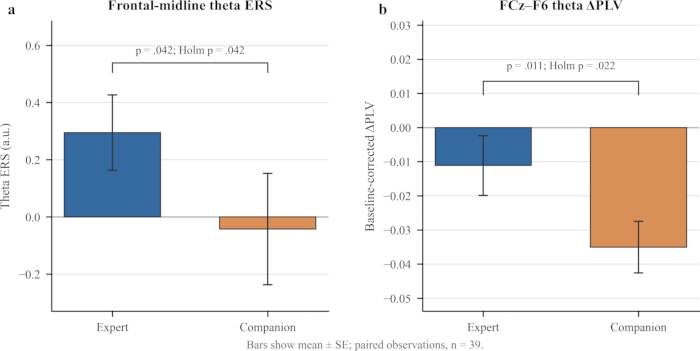
Şekil 4. Tıbbi Yapay Zeka rol çerçevelemesinin frontal-midline theta ERS ve FCz-F6 theta delta PLV üzerindeki etkileri. (A) Frontal-midline theta olayla ilişkili senkronizasyon. (B) Baz çizgisiyle düzeltilmiş FCz-F6 theta faz kilitleme değeri değişimi (ΔPLV); negatif değerler stimülasyon öncesi baz çizgisine göre bir azalmayı ifade eder. Sütunlar n = 39 için ortalama ± SE değerlerini göstermektedir. Eşleştirilmiş t testleri theta ERS için p = .042 ve ΔPLV için p = .011 değerleri vermiştir; raporlanan bu iki sonuç için Holm-düzeltmeli p değerleri sırasıyla .042 ve .022'dir. Kısaltmalar: Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Tablo 1: Çalışma 1 için ölçüm modeli tanıları.Tablo; algılanan profesyonellik, sosyal varlık, bilişsel güven ve duygusal güven için standartlaştırılmış yüklemeleri, Cronbach’s α değerini, birleşik güvenilirliği, ortalama açıklanan varyansı, gizil korelasyonları ve HTMT değerlerini rapor etmektedir. N = 300. Dört faktörlü model alternatiflerden daha iyi uyum göstermiş, ancak RMSEA ve SRMR zayıf mutlak uyuma işaret etmiş ve iki HTMT değeri .90'ı aşmıştır. Kısaltmalar: CR = birleşik güvenilirlik; AVE = ortalama açıklanan varyans; HTMT = heterotrait-monotrait oranı. Bu tabloyu indirmek için lütfen buraya tıklayınız.
Tablo 2: Çalışma 1 için dört koşullu betimsel istatistikler ve tam 2 × 2 faktöriyel testler. Hücre girişleri n, ortalama, standart sapma ve %95 güven aralığını bildirmektedir; faktöriyel testler F, p ve kısmi η2 değerlerini bildirmektedir. N = 300; hücre başına n = 75. Rol çerçevelemesi 1 = uzman ve 2 = refakatçi olarak kodlanmıştır; görev bağlamı 1 = hastalık ve 2 = sağlık konsültasyonu olarak kodlanmıştır. Katsayılar ve güven aralıkları standardize edilmemiştir. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 3: Çalışma 1'deki paralel koşullu dolaylı ilişkiler. N = 300. Rol çerçevelemesi 1 = uzman ve 2 = arkadaş olarak; görev bağlamı ise 1 = hastalık konsültasyonu ve 2 = sağlık konsültasyonu olarak kodlanmıştır. Algılanan profesyonellik ve sosyal mevcudiyet aynı anda girilmiştir. Tahminler standartlaştırılmamıştır ve yüzdelik-bootstrap güven aralıklarında 5.000 yeniden örnekleme kullanılmıştır. Tablo; koşullu dolaylı ilişkileri, her iki moderatörlü aracılık indeksini ve bunların doğrudan bootstrap karşılaştırmasını içermektedir. Genel güven için iki moderatörlü-aracılık indeksi arasındaki doğrudan karşılaştırma 0,1864, %95 GA [-0,0856, 0,4447] olarak bulunmuştur. Bu tabloyu indirmek için lütfen buraya tıklayın.
Tablo 4: Çalışma 2'deki eşleştirilmiş EEG sonuçları.Final analitik örneklemde N = 39 eşleştirilmiş gözlem yer almaktadır. Tablo; frontal-midline theta ERS ve baseline-düzeltmeli FCz-F6 theta ΔPLV için koşul ortalamalarını, eşleştirilmiş ortalama farklarını, %95 güven aralıklarını, eşleştirilmiş t testlerini, Cohen’s dz, kısmi η2 ve Holm-düzeltmeli p değerlerini bildirmektedir. Holm düzeltmesi yalnızca rapor edilen iki eşleştirilmiş EEG sonucunu kapsar ve elektrotlar, bantlar veya zaman pencereleri üzerinde belgelenmemiş daha geniş bir taramayı yeniden yapılandırmaz. Bu tabloyu indirmek için lütfen buraya tıklayınız.
Ek Dosya 1: Çalışma 1'de kullanılan deneysel uyaranlar. Dosya, hastalık konsültasyonu ve sağlık konsültasyonu senaryolarında kullanılan uzman çerçeveli ve refakatçi çerçeveli tıbbi yapay zeka yanıtlarının tam metnini içermektedir. Hem orijinal Çince metin hem de İngilizce çevirisi sunulmuştur.Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo S1. Düzenleyici-aracılı model için post hoc simülasyon tabanlı güç analizi. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Tablo S2. Çalışma 1 için manipülasyon kontrol istatistikleri ve tamamlanma süresi duyarlılık analizleri. Bu dosyayı indirmek için lütfen buraya tıklayınız.
Ek Tablo S3. Çalışma 2 için davranışsal görev sonuçları, örnek hesaplamaları ve tanımlayıcı istatistikler. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Teorik çıkarımlar
İki çalışma farklı düzeylerde kanıt sunmaktadır. Çalışma 1, randomize bir senaryo deneyinde rol-görev ilişkilerini ve paralel dolaylı ilişkileri belirlerken; Çalışma 2, keşifsel bir süreç düzeyinde EEG karşılaştırması sunmaktadır. Dolayısıyla bu çalışmalar, tek bir ilerleyici mekanizmadan ziyade, rol çerçeveli değerlendirmenin sınırlı bir açıklamasını desteklemektedir. Bulgular, uyumu rol ipuçları ile görev açısından belirgin değerlendirme talepleri arasındaki hizalanma olarak ele alarak, rol uyumluluğu teorisini tıbbi yapay zekaya genişletmektedir22. Bu yorum, yetkinlik-sıcaklık içeriğinden ve görev-teknoloji uyumundan farklıdır. Algoritma karşıtlığı ve algoritma beğenisi bulguları, rol ve yetenek ipuçlarının göreve uygun olup olmadığına dair bağlama duyarlı değerlendirmeler olarak anlaşılabilir49,50.
Sonuçlar ayrıca rol çerçeveleme, algılanan profesyonellik, sosyal mevcudiyet ve güven arasındaki paralel, birbirini dışlamayan ilişkileri de desteklemektedir. Profesyonellik bilişsel güven ile, sosyal mevcudiyet ise duygusal güven ile örtüştüğü için, kanıtlar farklılaşmış değerlendirme içeriklerini desteklemekte ancak tamamen birbirinden ayrılmış iki mekanizmayı desteklememektedir. Algılanan profesyonellik üzerindeki rol-görev etkileşimi, önerilen rol uyumluluğu açıklamasıyla tutarlıdır. Kanıtlar, profesyonellik ile olan ilişkinin bağlamsal düzenlemesini desteklemektedir; ancak istatistiksel olarak asimetrik bağlamsal mekanizmaları veya sosyal mevcudiyet yolundaki değişmezliği kanıtlamamaktadır.
EEG bulguları, keşifsel bir süreç düzeyinde perspektif sunmaktadır. Uzman tarafından çerçevelenmiş ifadeler belirgin theta-bandı modelleriyle birlikte seyretmiş, ancak koşullar semantik içerik ve karmaşıklık açısından da farklılık göstermiş ve koşul düzeyindeki davranışlarda güven açısından güvenilir bir fark gözlemlenmemiştir. Bu nedenle, EEG ölçümleri belirgin bir bilişsel kontrol veya güven mekanizması ortaya koymamaktadır. Nöral bulgular, hipotez oluşturucu olarak değerlendirilmelidir. Çalışma 2, görev bağlamını manipüle etmemiş, algılanan profesyonelliği veya sosyal varlığı ölçmemiş ya da deneme düzeyindeki EEG indekslerini güven yargılarıyla ilişkilendirmemiştir; bu nedenle EEG sonuçları, koşullu dolaylı modeli doğrulamaktan ziyade onu tamamlamaktadır.
Bulgular, maksimumdan ziyade uygun bir güvene uyumludur. Otomatik sistem güveni; sistem yeteneklerine, sınırlarına ve görev gereksinimlerine göre kalibre edilmelidir35. İlgili çalışmalar, kalibre edilmiş güven ve itimatı destekleyebilecek adaptif bilişsel mekanizmaları tanımlamaktadır51. NeuroIS perspektifi, zamansal olarak çözümlenmiş süreçler incelenirken nöral ölçümlerin davranışsal kanıtlara tamamlayıcı olarak kullanılmasını desteklemektedir52. Önceki fMRI çalışmaları da çevrimiçi güven yargıları sırasındaki nöral aktivitenin, hedeflere ve bağlamlara göre farklılık gösterdiğini ortaya koymaktadır53.
Yönetimsel çıkarımlar
Çevrimiçi tıbbi platformlar için pratik çıkarım, basit bir güven maksimizasyonundan ziyade kalibre edilmiş bir güvenilirliktir. Rol ipuçları, görev gereksinimleriyle eşleştirilmeli; belirsizlik iletişimi, açık yetenek sınırları, risk temelli uyarılar ve kalifiye klinisyenlere yönlendirme ile birleştirilmelidir.
Tanı, anormal sonuçların yorumlanması, tıbbi tavsiye veya triyajı içeren yüksek riskli modüllerde, yetkinlik odaklı ipuçları, kullanıcılara haksız bir otorite vermeden kanıt ve eylem sınırlarını fark etmelerine yardımcı olabilir. Diyet, egzersiz, uyku, uyumluluk ve duygusal destek gibi düşük aciliyetli modüllerde ise ilişki odaklı ipuçları, yanlış bir güven duygusu veya uygunsuz bir antropomorfizm yaratmadan etkileşimi destekleyebilir.
Rol tasarımı, sabit bir kişilik ayarı yerine modüler ve senaryo tabanlı olmalıdır. Rol yapılandırması; açıklama, gizlilik istemleri, risk etiketleri ve üst makama yönlendirme mekanizmalarıyla entegre edilmelidir. Yönetişim araştırmaları; şeffaflık, hesap verebilirlik, yanlılık yönetimi ve gizliliğin birlikte tasarlanması gerektiğini, böylece güvenilir ön uç rol ipuçlarının arka uç risklerini gizlemesinin önleneceğini vurgulamaktadır6,20,21.
Araştırma kısıtlamaları ve gelecek yönelimler
Çalışma 1, gerçek bir konsültasyondan ziyade bir senaryo deneyidir. Koşullar; uzunluk, kelime sıklığı, okunabilirlik, doğruluk, uygulanabilirlik, duygusal değer, uyarılma, risk, aşinalık veya karmaşıklık açısından bağımsız olarak ön testten geçirilmemiştir. Gelecekteki çalışmalar; birden fazla senaryo, nötr sistem isimleri, içerik açısından eşleştirilmiş uyaranlar, bağımsız manipülasyon veya zamansal olarak ayrılmış ölçümler ile katılımcı ve uyaran düzeyinde rastgele etkiler kullanmalıdır.
Çalışma 2 süreç düzeyinde EEG kanıtları sağlamıştır, ancak 39 kişiden oluşan nihai demografik bağlantı eksikti, EEG ifadeleri cümle uzunluğu, kelime frekansı, okunabilirlik, duygusal valans, uyarılmışlık, algılanan risk, aşinalık ve karmaşıklık açısından bağımsız olarak eşleştirilmemiş veya ön testten geçirilmemişti ve açık rol etiketleri talep özellikleri yaratmış olabilir. Mevcut çalışmada, fonksiyonel bağlantılığın önceden tanımlanmış ölçütü olarak baz çizgisi düzeltmeli faz kilitleme değeri (ΔPLV) kullanılmıştır. Ağırlıklı faz gecikme indeksi (wPLI) hacim iletimine karşı daha az duyarlı olsa da orijinal analiz hattına dahil edilmemiştir. Gelecek çalışmalar, mevcut bulguların wPLI veya diğer tamamlayıcı bağlantı ölçümleri kullanılarak tekrarlanıp tekrarlanmadığını incelemelidir. Mevcut nöral çıktılar koşullar üzerinden toplanmıştır ve deneme düzeyindeki güven yargılarıyla ilişkilendirilemez; bu nedenle deneme düzeyinde bir EEG-davranış karma modeli tahmin edilmemiştir. Kafa derisi PLV'si ayrıca ortak referans ve hacim iletim etkilerine karşı duyarlıdır. Bu kısıtlamalar, nöral bulguların keşifsel kalması gerektiği ve benzersiz bir bilişsel kontrol veya güven mekanizması için kanıt olarak yorumlanmaması gerektiği anlamına gelmektedir.
Açıklamalar
Yazarların beyan edecekleri herhangi bir çıkar çatışması bulunmamaktadır.
Bu çalışmanın hazırlanması sırasında yazarlar, dili geliştirmek için ChatGPT kullandılar. Bu araç/servisi kullandıktan sonra yazarlar, içeriği gerektiği şekilde gözden geçirip düzenlemişlerdir ve yayının içeriği için tüm sorumluluğu üstlenmektedirler.
Teşekkürler
Bu araştırma projesi, PRC Ulusal Sosyal Bilimler Fonlu Genel Projeleri tarafından desteklenmiştir (Hibe No. 22BGL006).
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Credamo online anket platformu | Credamo (Jianshu), Çin | Uygulanamaz | Çalışma 1'de kullanılan çevrimiçi anket, rastgele atama ve katılımcı alım platformu. |
| CURRY yeniden referanslama fonksiyonu | Compumedics Neuroscan, ABD | Versiyon belirtilmemiş | FCz çevrimiçi referansından bilateral mastoid ortalamasına yerleşik çevrimdışı yeniden referanslama; FCz, yeni referansa göre otomatik olarak yeniden yapılandırılmıştır. |
| EEG elektrot başlığı, 64 kanallı | Compumedics Neuroscan (Compumedics Limited), Avustralya | Model/katalog numarası belirtilmemiş | Sürekli EEG kaydı için kullanılan 64 kanallı Ag/AgCl elektrot başlığı. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, ABD | Versiyon 2023.0 | EEG ön işleme ve bağımsız bileşen analizi için kullanılan MATLAB araç kutusu. |
| E-Prime | Psychology Software Tools, Inc., ABD | Versiyon 2.1 | Çalışma 2'de uyaran sunumu ve yanıt toplama. |
| G*Power | Heinrich Heine University Dusseldorf, Almanya | Versiyon 3.1.9.7 | Çalışma 1 için orijinal a priori örneklem büyüklüğü hesaplaması, etkileşim duyarlılık analizi ve post hoc model tabanlı güç analizi. |
| IBM SPSS Statistics | IBM Corp., ABD | Versiyon 27 | PROCESS makrosunu çalıştırmak için kullanılan istatistiksel ortam. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, ABD | Versiyon 1.7 | Artefakt bağımsız bileşenleri sınıflandırmak için kullanılan EEGLAB eklentisi. |
| MATLAB | The MathWorks, Inc., ABD | Sürüm R2020b | EEG işleme ve analizi için kullanılan hesaplama ortamı. |
| SPSS için PROCESS makrosu | Andrew F. Hayes, Kanada | Versiyon 4.2 beta | Çalışma 1'de, algılanan profesyonellik ve sosyal mevcudiyetin paralel aracı değişkenler olarak eş zamanlı olarak girildiği, 5,000 yüzdelik bootstrap örneğinin kullanıldığı Model 7. |
| Quik-Gel iletken elektrolit jel | Compumedics Neuroscan (Compumedics Limited), Avustralya | Katalog numarası belirtilmemiş; 32 oz | EEG kaydı sırasında elektrot-cilt empedansını azaltmak için kullanılan iletken jel. |
| SynAmps2 EEG amplifikatörü | Compumedics Neuroscan (Compumedics Limited), Avustralya | SynAmps2; katalog numarası belirtilmemiş | 64 kanallı kayıt için yapılandırılmış 64-256 kanallı EEG amplifikatörü. |
Kaynaklar
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.